Aria 消息总线用索引与树分裂策略优化:生产环境 CPU 占用下降 30%
Scaling and benchmarking a critical message bus using a new indexing strategy
Jane Street 实习生 Theodor Totev 为内部消息框架 Aria 引入按 topic partition 划分的索引结构,配合 min-heap 做 n 路归并,使生产负载下 CPU 占用下降 30%。
以下是一系列关于2026年暑期实习生项目的文章之一——更多内容,请参阅“实习生们创造了什么,2026年特别巨无霸版”
Aria是我们的内部消息框架和托管系统,每天处理数TB的数据。客户端可以订阅Aria以获取实时消息流。随着Aria在公司内部使用量的快速增长,我们不得不寻找更多机会来优化和重新架构系统,以应对数据量和吞吐量的增长。与Aria团队合作的实习生Theodor Totev今年夏天专注于使用索引和树分割来改进一个特定用例:如何让客户端更便宜地只读取消息的一个子集?他的优化使得在生产工作负载上运行时CPU使用率降低了30%,同时保持了这样一个关键系统所需的极高正确性标准。
过滤消息使我们的服务器过载
当Aria通过TCP向客户端传递消息时,它会将最近的流(我们称之为流尖端)保存在内存中的环形缓冲区里。如果客户端落后了,它可以从这个环形缓冲区请求最近的消息以赶上进度。我们称这个过程为尖端恢复。
尖端恢复的一个挑战是,Aria存储了整个消息流,而客户端通常只关心其中很小的一部分消息。Aria将消息流划分为主题,这些主题形成一个类似文件系统的分层命名空间。客户端可以订阅单个主题或主题子树,主题子树由给定主题下的所有主题组成,类似于globstar。Aria将整个流过滤为仅包含来自订阅主题的消息,并将这些消息传递给客户端。
最初,我们做这种过滤只是简单的线性遍历,这没问题,因为虽然算法上效率不高,但循环遍历流对CPU缓存友好,因此速度相当快。然而,随着进行尖端恢复的客户端数量增长,我们注意到服务器在增加的负载下苦苦挣扎。一些服务器达到了100%的CPU利用率,导致客户端“脱离尖端”而无法赶上。我们增加了更多服务器作为临时解决方案,但很明显,我们迫切需要重新思考尖端恢复的代码。
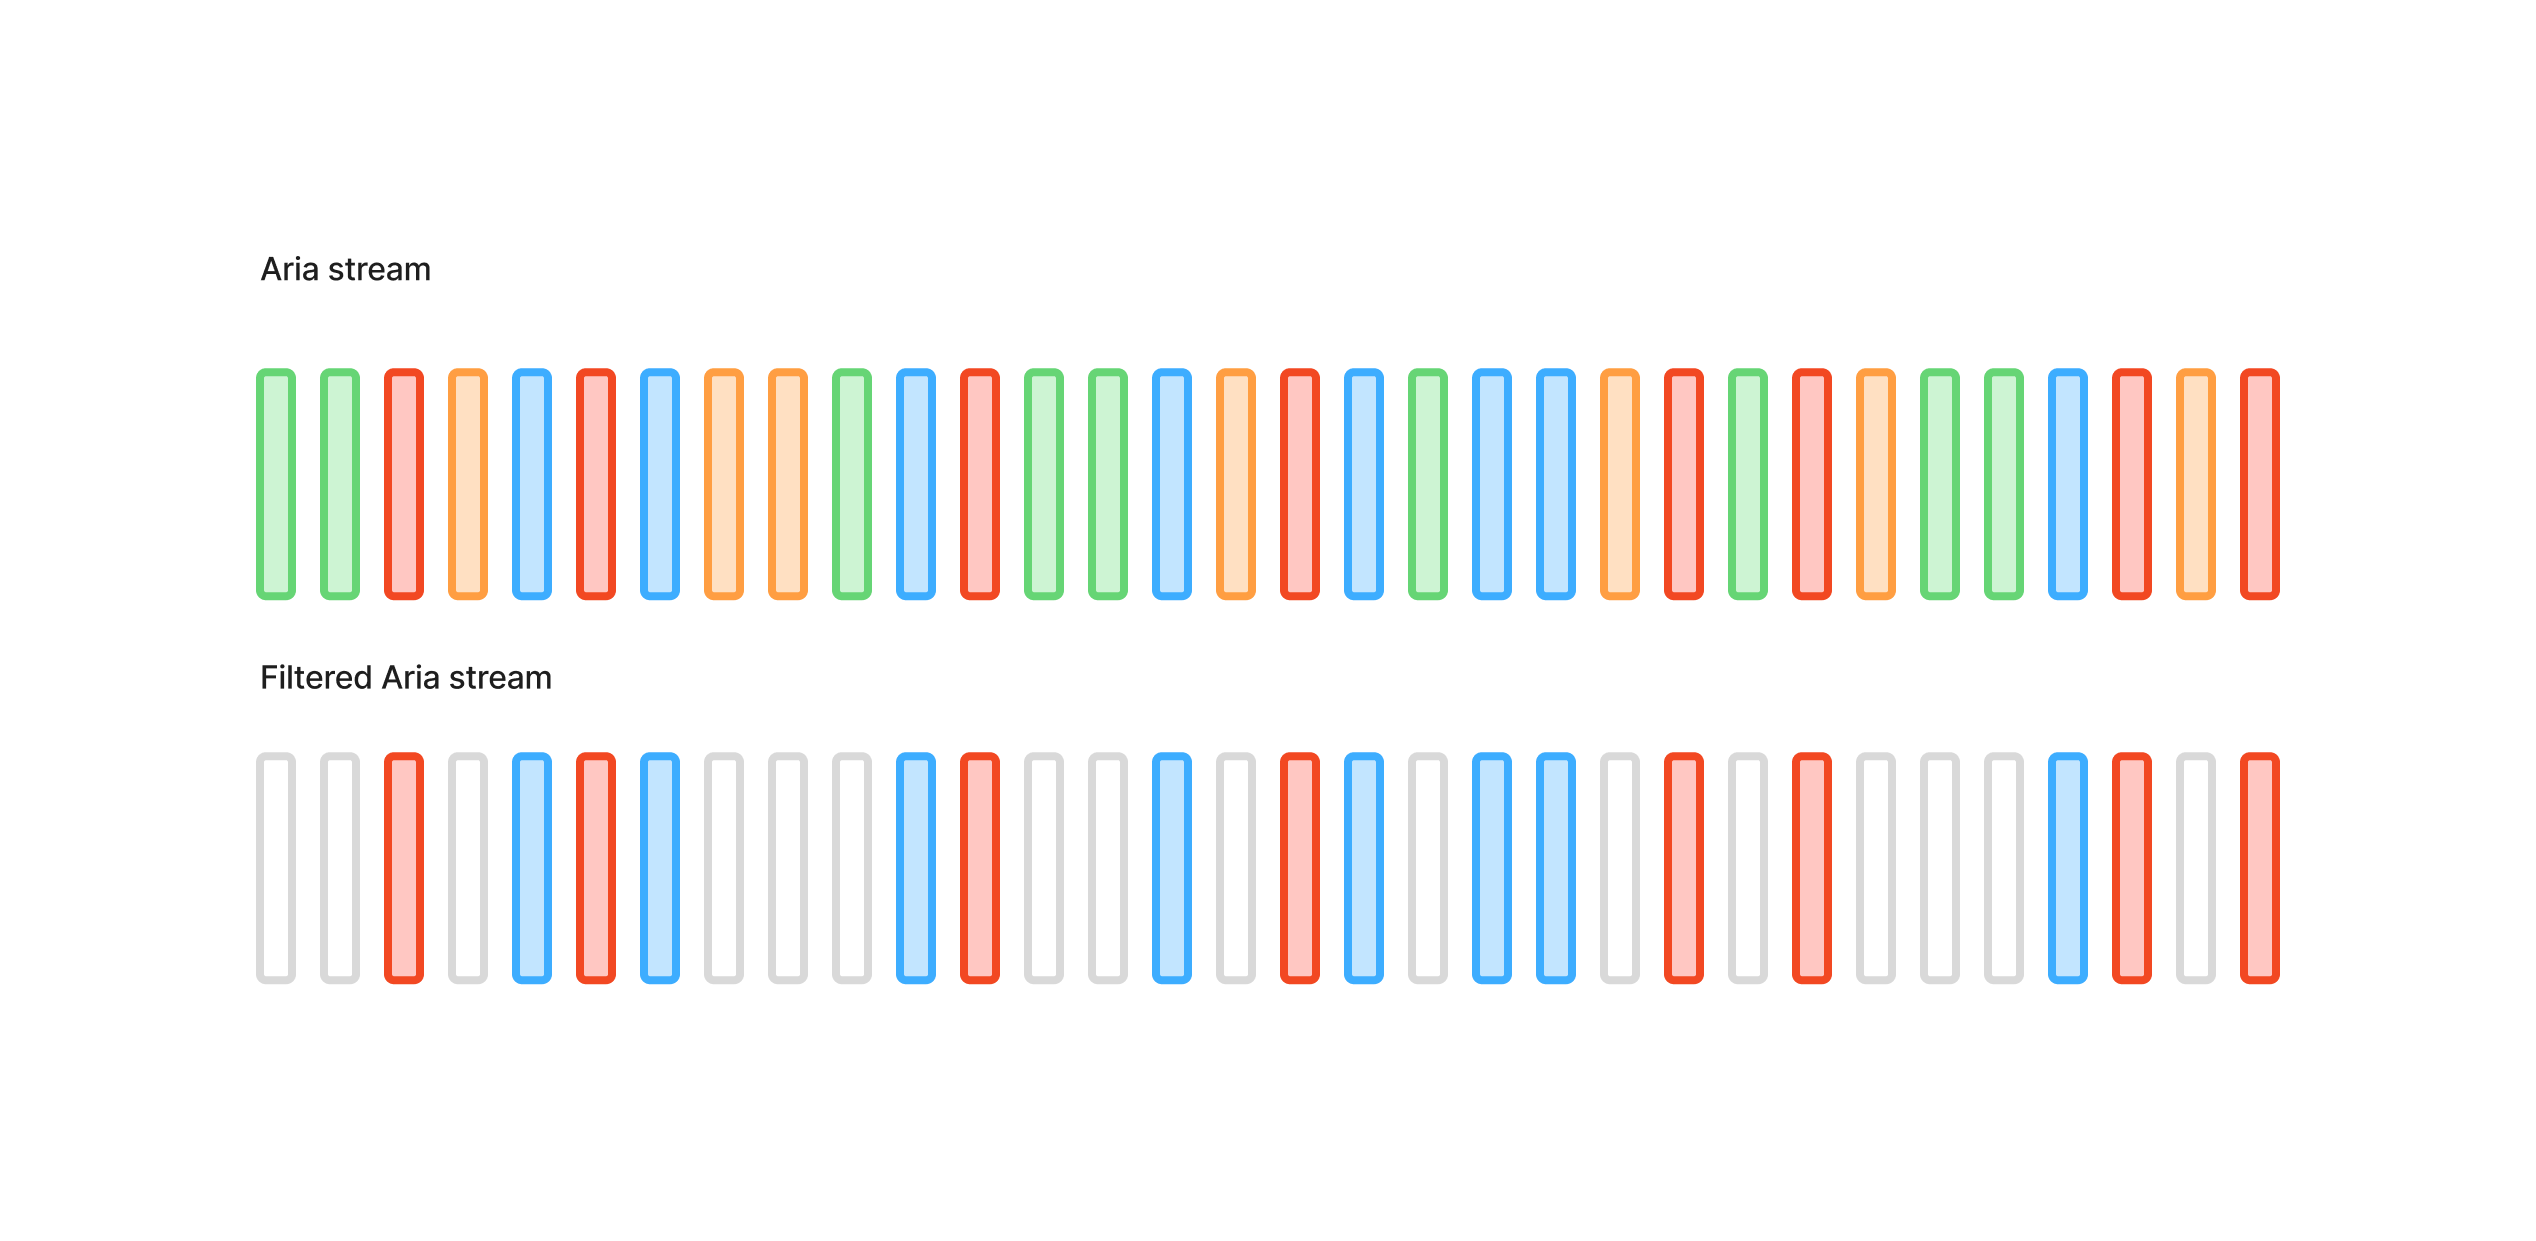
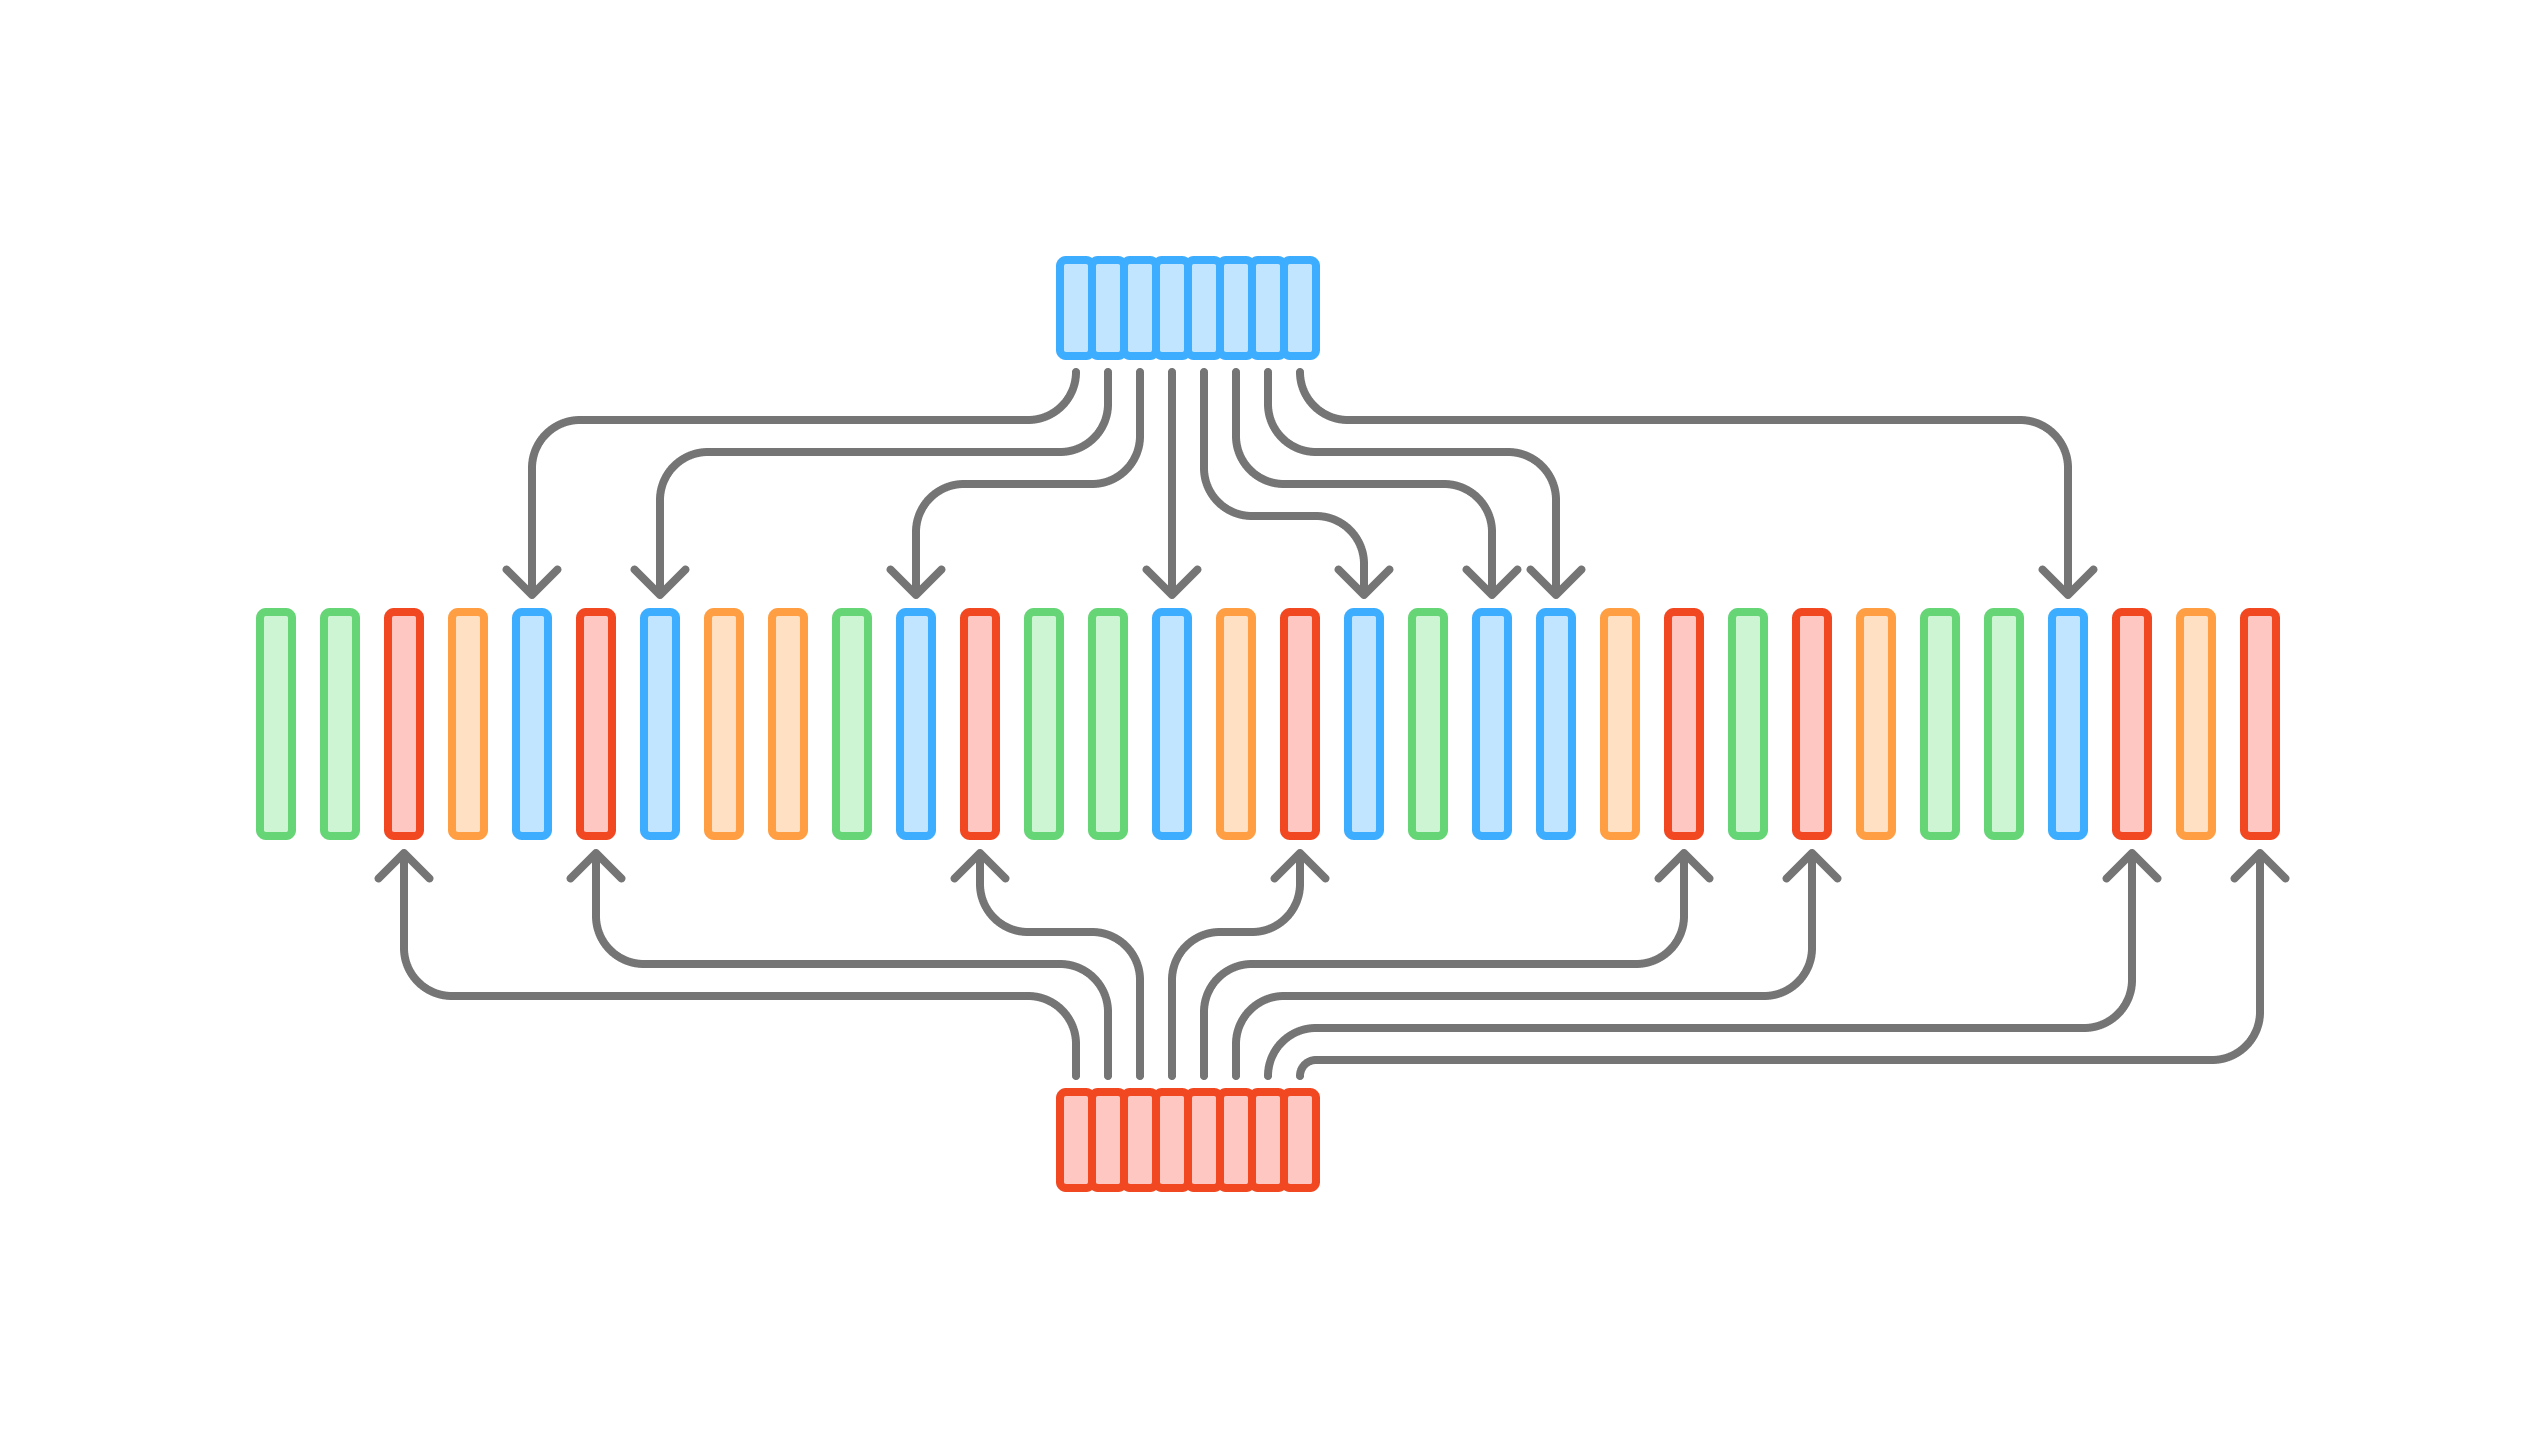
Theodor决定通过添加索引数据结构来解决这个问题,Aria可以使用这些结构来高效地过滤流中的消息。但是应该索引什么?一种简单的方法是为每个主题建立一个索引。然而,Aria实例可能有近百万个主题,这使得这种方法不可行。相反,Theodor为每个主题分区创建了一个索引。主题分区由具有相同两段前缀的所有主题组成,段是主题名称中由斜杠分隔的单个部分。例如,app/codestore/commits和app/codestore/features都将位于app/codestore主题分区下。
每个主题分区都会获得一个索引,记录其消息在Aria流中的位置:
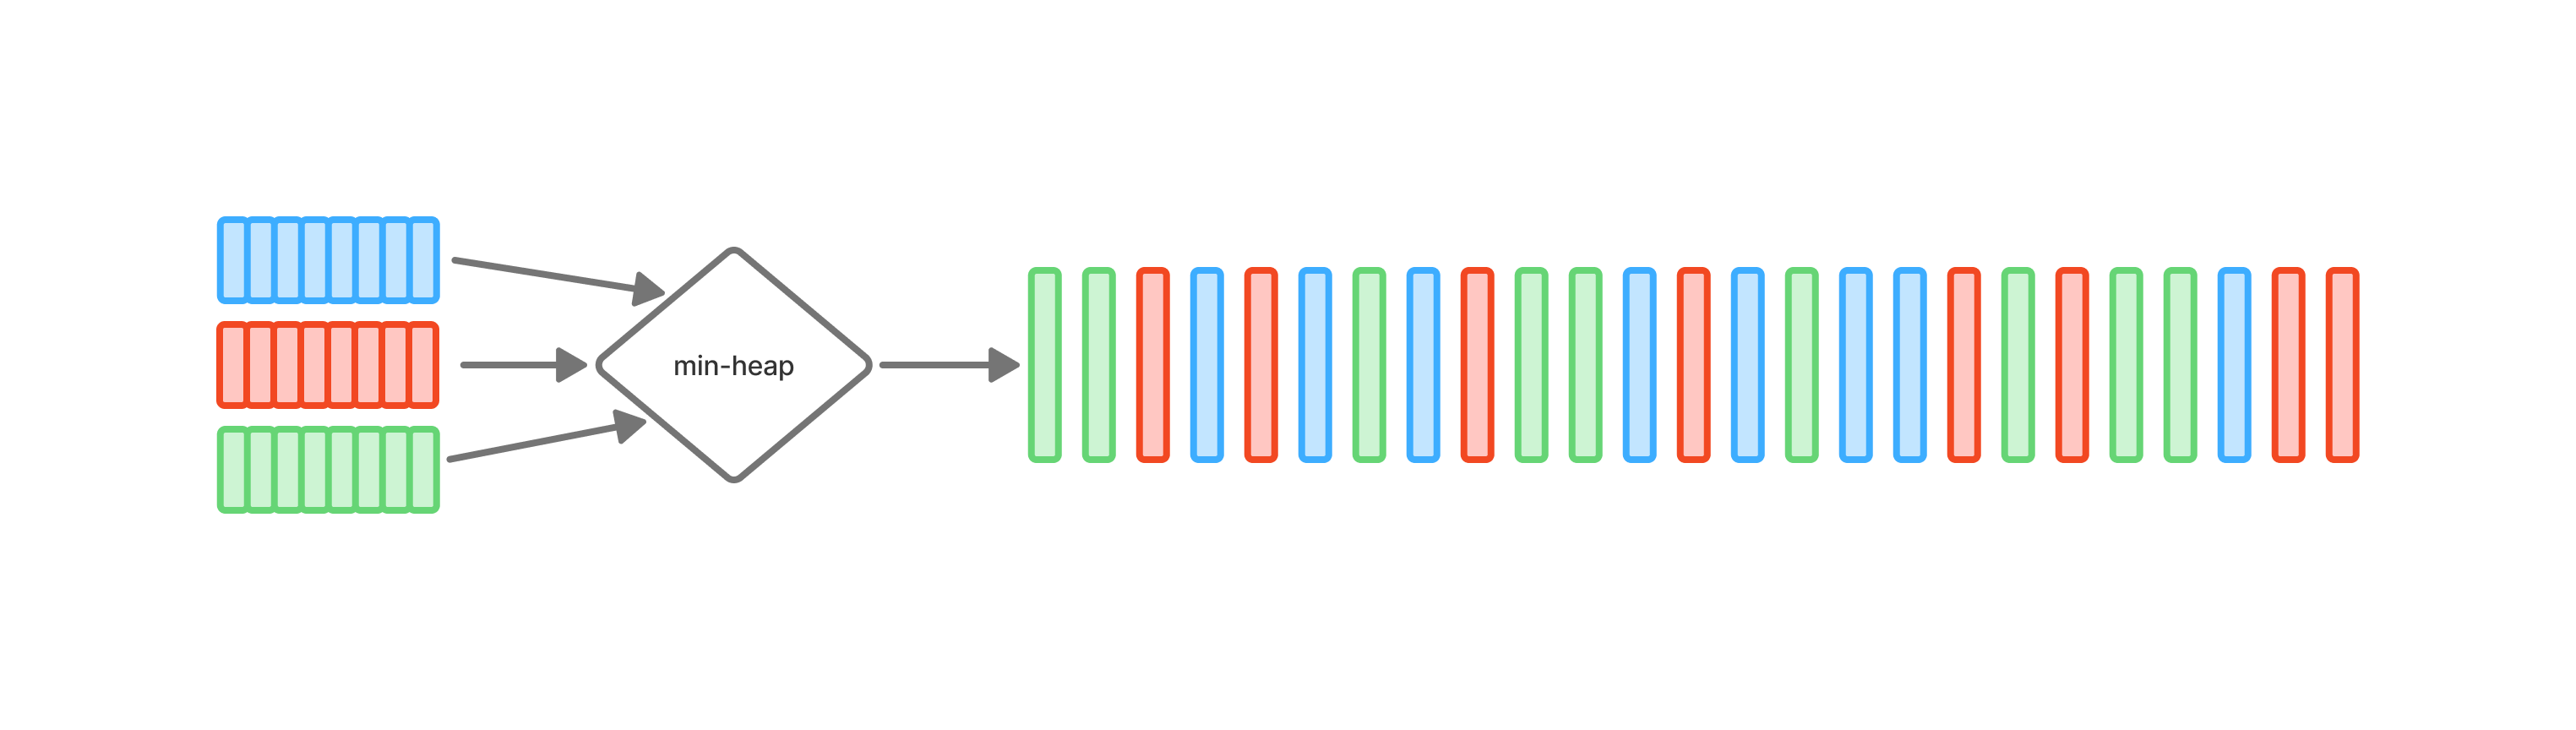
当客户端请求消息时,Aria使用最小堆对索引进行n路合并。这使Aria能够高效地为这些特定的主题分区按顺序重建消息流:
对索引进行原型设计和基准测试
与任何性能优化工作一样,我们必须进行基准测试,以验证我们确实在改进系统。我们还希望进行广泛的测试,因为消息发布逻辑位于 Aria 的关键路径上。
Theodor 首先编写了一个工具来分析各种恢复场景。这样,我们就可以测试不同的配置,例如主题分区的数量、交错程度、读取器的数量等,并观察改变这些变量如何影响系统性能。
有了基准测试,他实现了主题分区索引的初始版本。当我们分析这个实现时,发现最小堆是我们代码中最大的瓶颈。在 AI 出现之前,我们可能会选择一个看起来更好的实现。但如今,运行实验成本很低:Theodor 提示一个代理启动了五种不同的堆实现,并让它们通宵运行分析。第二天,我们得到了答案:fast_heap_unboxed 为我们的索引恢复代码带来了 2 倍的性能提升。
Theodor 用大量的 expect 测试 测试了新索引,在 Antithesis 中运行了新逻辑,最后让一群代理以高度严谨的态度分析了代码。
使用块池存储索引
一旦我们设计出索引数据结构,就需要找到一种高效的表示方法。我们不想为每个索引创建一个环形缓冲区,因为环形缓冲区实际上不能动态调整大小。因此,它们必须按最坏情况来设定大小。具体来说,索引大小与消息大小成反比(消息越小,尖端存储中能容纳的消息就越多,这意味着你需要更大的索引)。一条 Aria 消息可以小到 32 字节。如果整个尖端存储都由这么小的消息组成,相应的索引将达到 2GB。为每个主题分区保留 2GB 的索引会浪费太多内存。
相反,我们希望索引能随着其主题分区中消息数量的变化而动态收缩和增长。
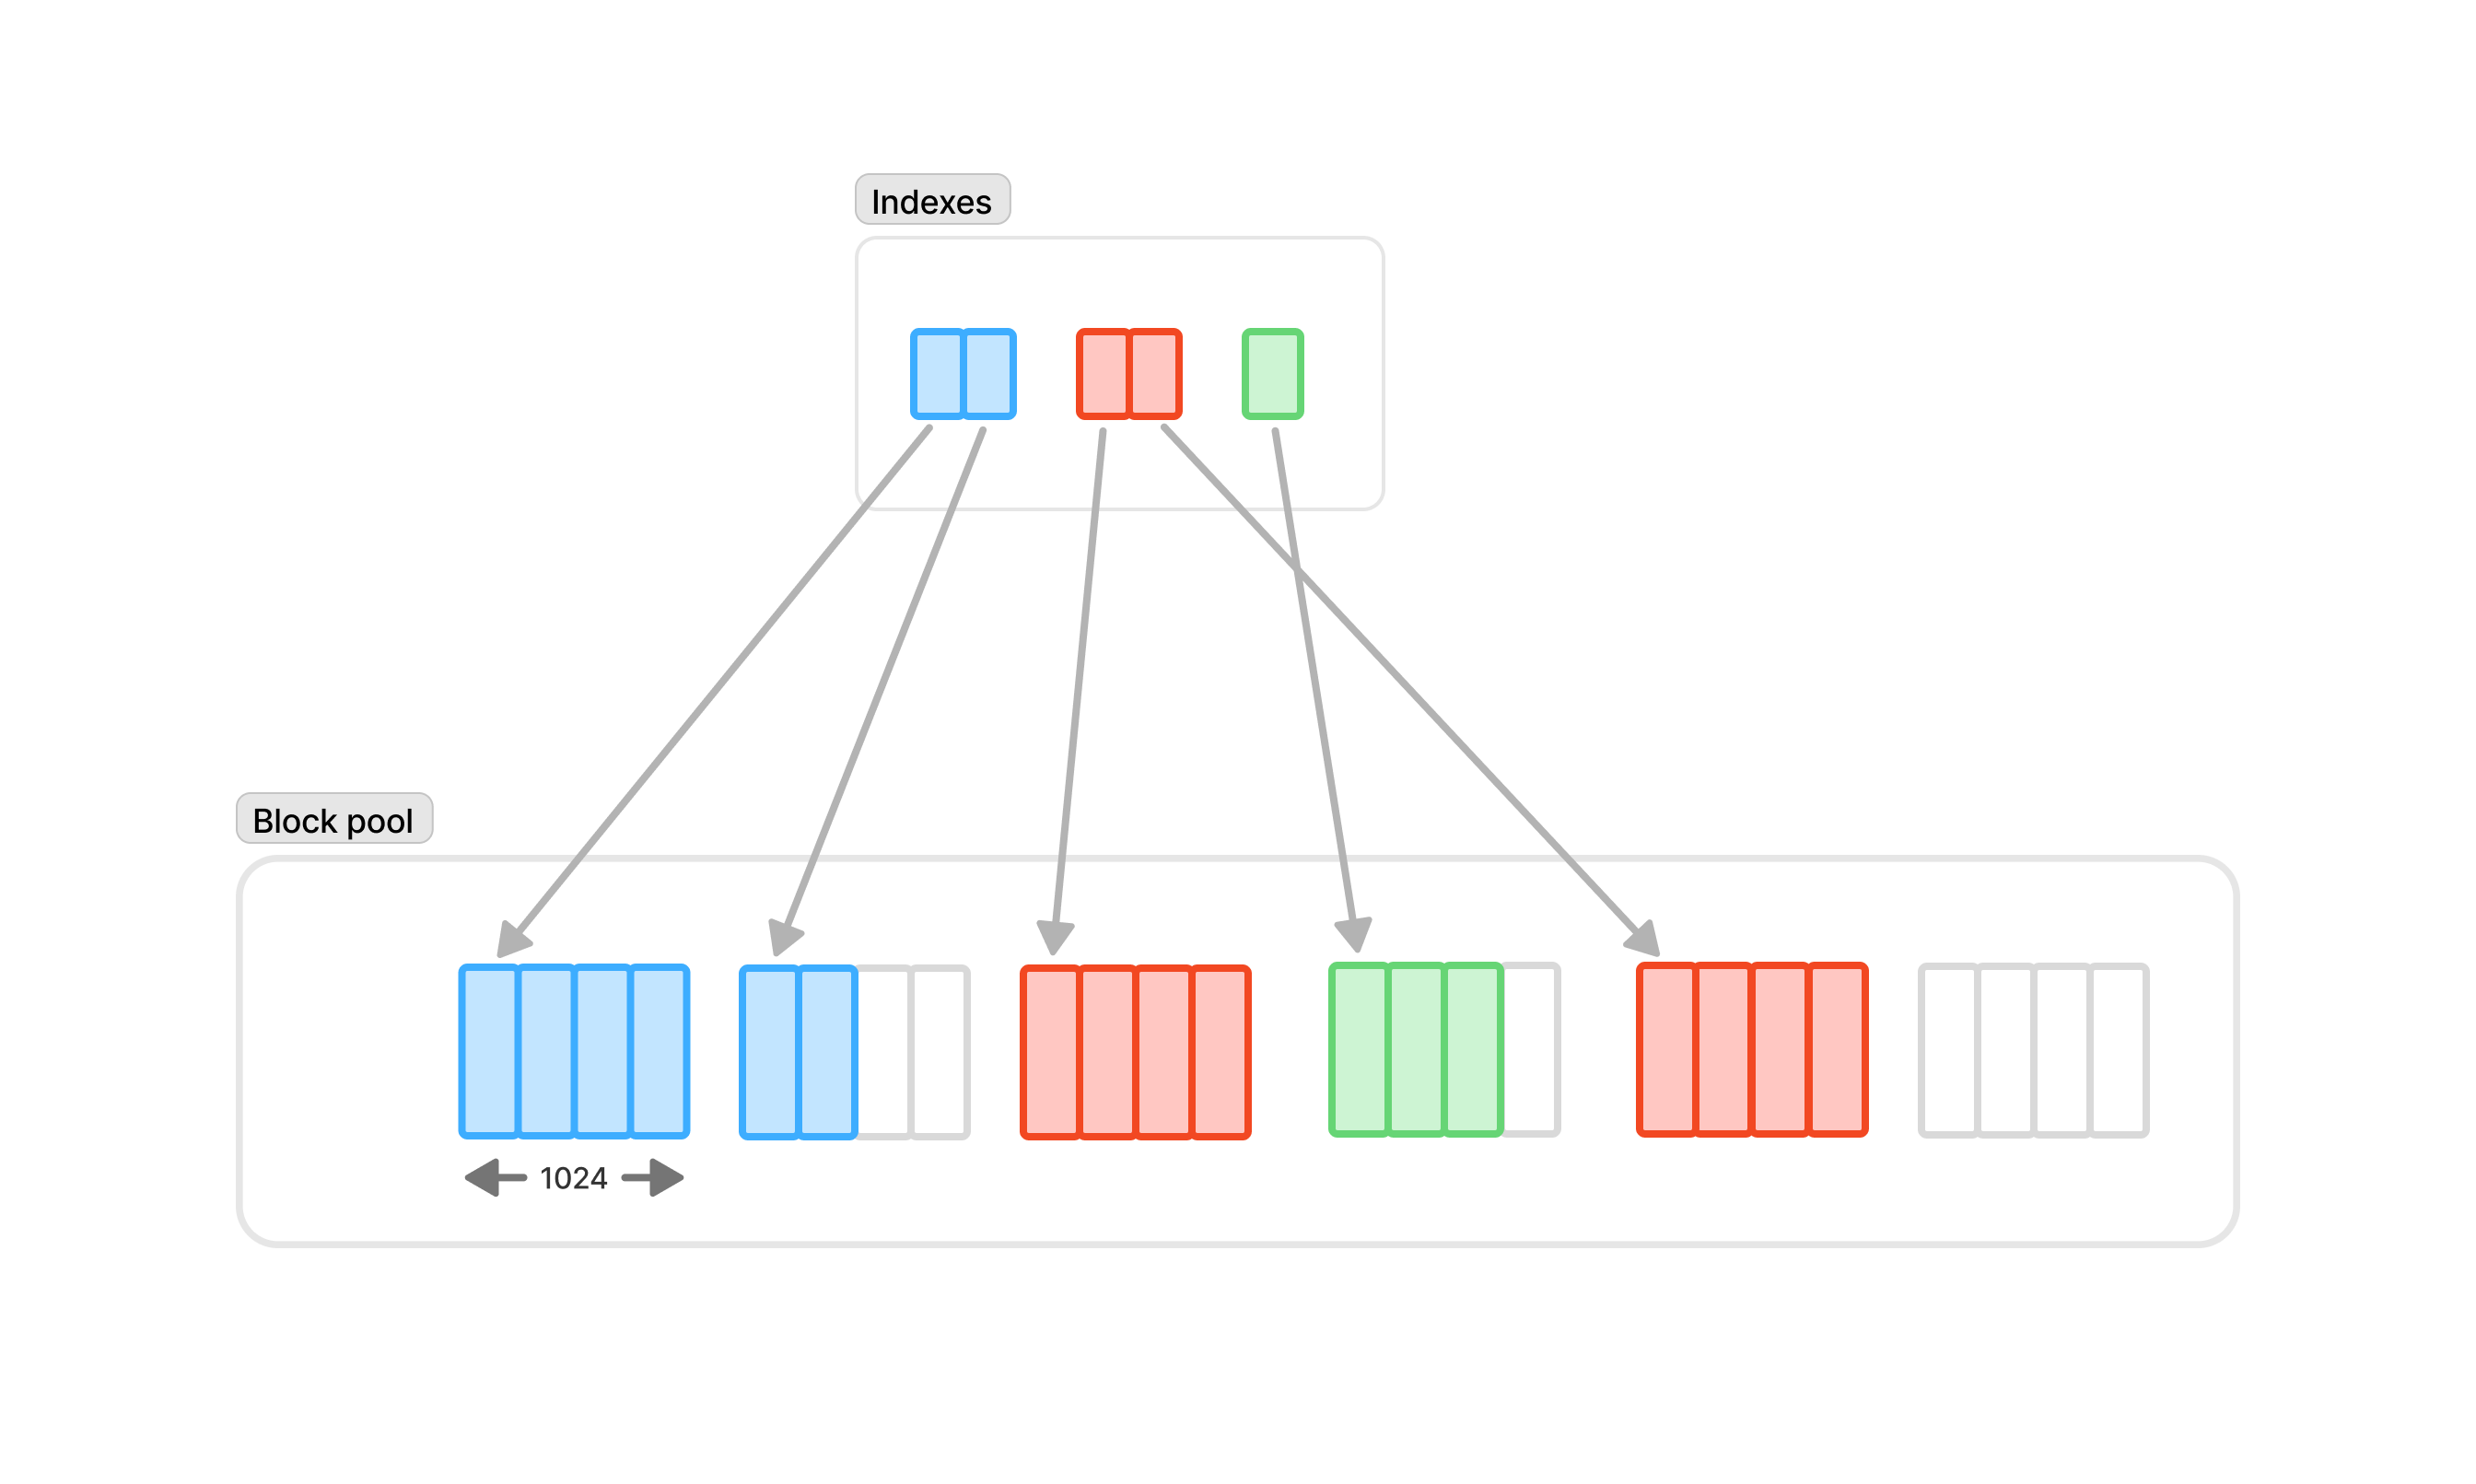
我们最终采用的方法是使用一个共享的块池,每个块包含 1024 个条目。索引指向一个块并向其中插入值。一旦一个块中的所有消息都离开了环形缓冲区,这些块就可以从索引中弹出,并重新用于其他索引:
读取旧消息耗时过长
Theodor 在索引方面的工作解决了我们的尖端恢复问题,但我们还有另一个消息传递问题:需要流尖端之前消息的客户端等待时间过长。
当客户端重启时,它通常会请求其订阅主题中自本周开始以来的所有消息。我们称这个过程为初始恢复。初始恢复可能涉及数百万甚至数十亿条消息。Aria 尽快读取这些消息并将其传递给客户端至关重要。此外,客户端往往会在同一时间重启,因此这个过程能够良好扩展尤为重要。
在一次特定事件中,通常耗时不到 2.5 秒的初始恢复却花了超过 13 分钟。当我们深入调查原因时,发现了困扰尖端存储的同样问题:Aria 读取和过滤的数据量是实际需要发送的 10 倍。显然,我们需要重新思考在磁盘上存储消息的方式。
Aria 将消息持久化在子树存储中
Aria 最初将消息按时间顺序分段存储在磁盘上,每个主题分区各一份。然后,一个单独的进程会读取这些分段,并将它们拆分成多个 子树存储,每个子树存储包含某个主题子树的消息。这些子树存储旨在在写入大量文件(过滤效率高,但重新组合成消息流需要更多工作)与写入较少文件(更容易重新组合,但过滤效率较低)之间取得平衡。
为了进行这种拆分,Aria 一直使用一种简单的启发式方法:它通过读取主题的前三个分段来选择子树存储。因此,如果我们有主题 app/options/orders/created 和 app/options/orders/cancelled,它们都会被放入 app/options/orders 的子树存储中。如果主题的分段少于三个,它会被放入自己的子树存储中;例如,app/options 会获得自己的存储。实际上,这种启发式方法为每个主题分区的直接子主题分配了单独的子树存储。
然而,当一个存储中的某个主题的消息量明显多于其他主题时,这种启发式方法效果不佳。如果客户端只订阅那个不太活跃的主题,Aria 就必须过滤掉其他主题的所有消息。与 tip 恢复类似,这种过滤会产生大量工作。
更广泛地说,我们并不乐见用户在设计主题结构时不得不理解 Aria 内部设计的这一具体方面。我们希望用户以对他们有意义的方式组织主题,并相信 Aria 会智能地进行拆分。
Theodor 受命开发一种算法,通过根据每个主题的消息量智能地拆分主题树来避免这个问题。Aria 能够计算每个主题的消息量,因为它在持久化消息流之后才执行这个分段处理步骤。
收集数据并测试不同算法
与 tip 恢复的实现类似,Theodor 在自适应拆分方面的工作需要探索不同的选项。他首先从各种 Aria 会话中收集数据,用于测试不同的算法。然后,他实现了几种不同的拆分算法,并在收集到的数据上运行它们。Theodor 从几个不同的角度分析了这些结果,例如:
- 如果我们读取一个主题,必须从存储中忽略多少字节?
- 这些“浪费的字节”在所有主题上的总和是多少?
- 读取哪个主题会导致最多的浪费字节?
- 读取哪个主题会导致总字节与有用字节之比最差?
和之前一样,这个探索过程得到了 LLM 的帮助。Theodor 能够快速通过 vibe-coding 构建一个 Web UI,在真实数据集上可视化不同的拆分算法。
最终算法
最终,Theodor 确定了一个将贪心聚类算法与二分搜索相结合的解决方案。这为我们提供了所期望的特性:消息量大的主题获得自己的子树存储,而较小的主题则被合并到一个存储中。
以下是使用先前启发式方法的一个主题树示例:
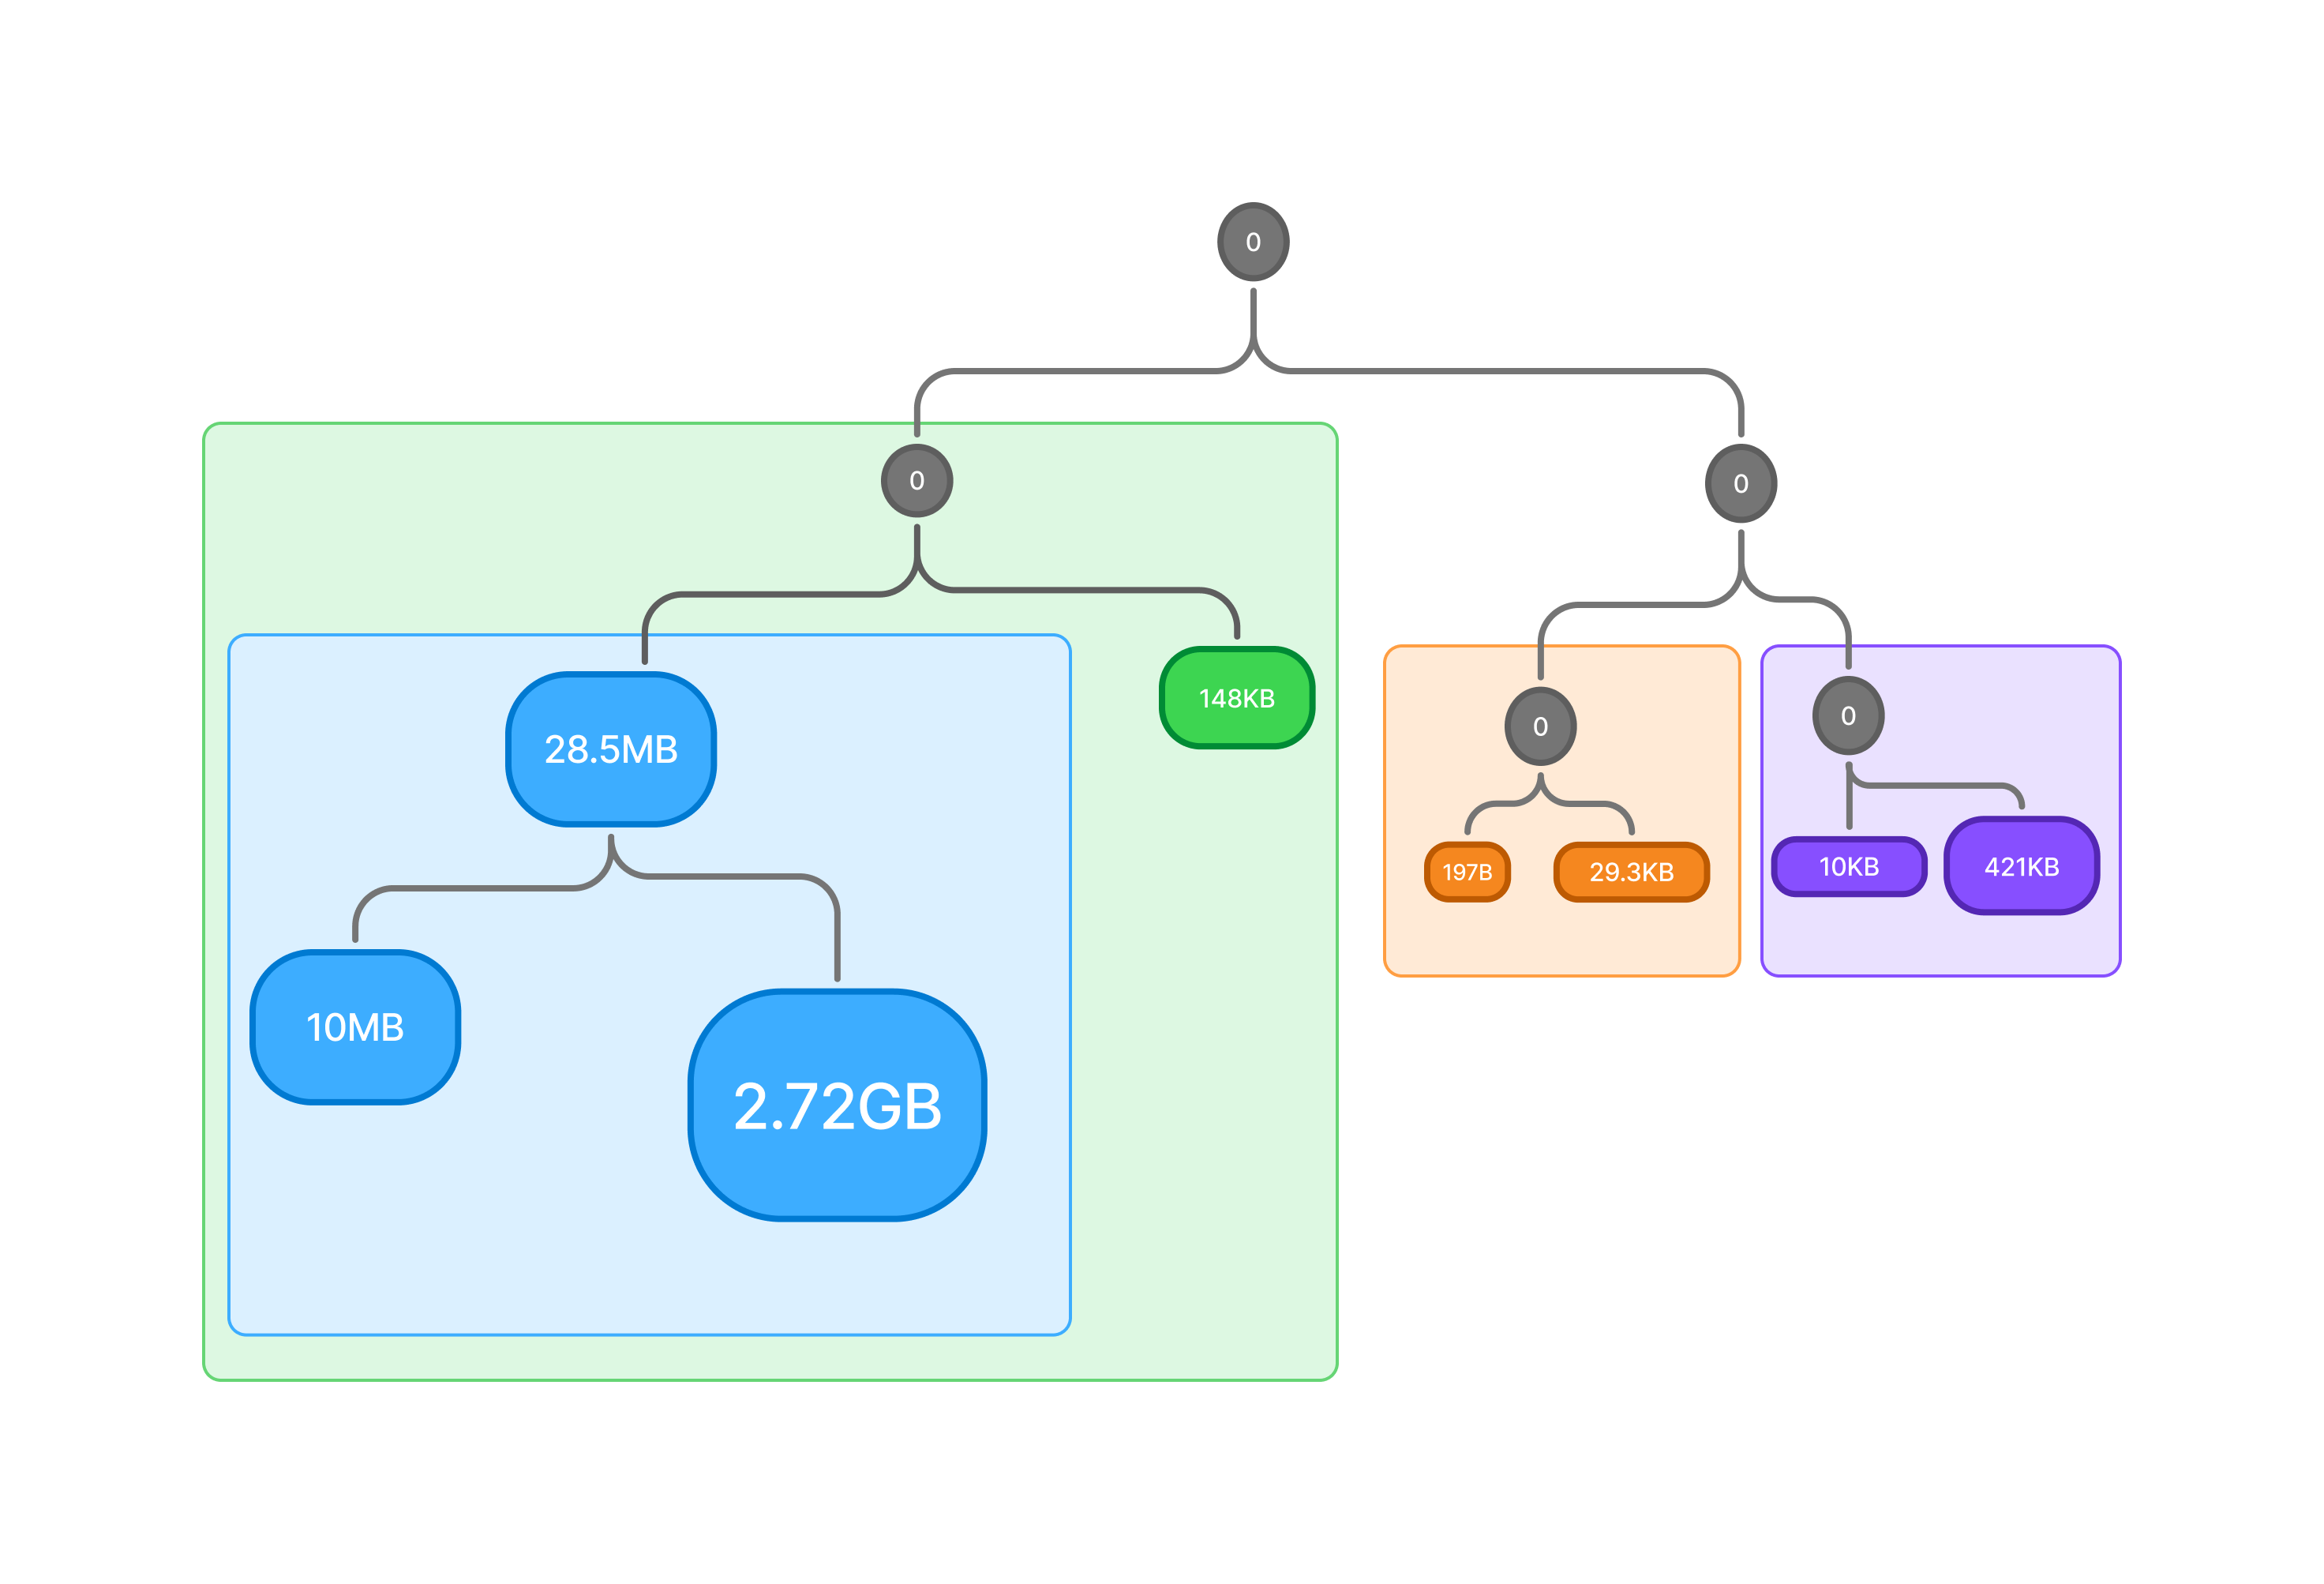
请注意,2.72GB 的主题与 10MB 和 28.5MB 的主题位于同一个存储中。这意味着,如果有人想读取 10MB 的主题,他们必须过滤掉所有其他消息。与此同时,较小的主题被分散在三个存储中,尽管它们比大主题小了几个数量级。
使用新的自适应拆分算法后,同一棵树看起来是这样的:
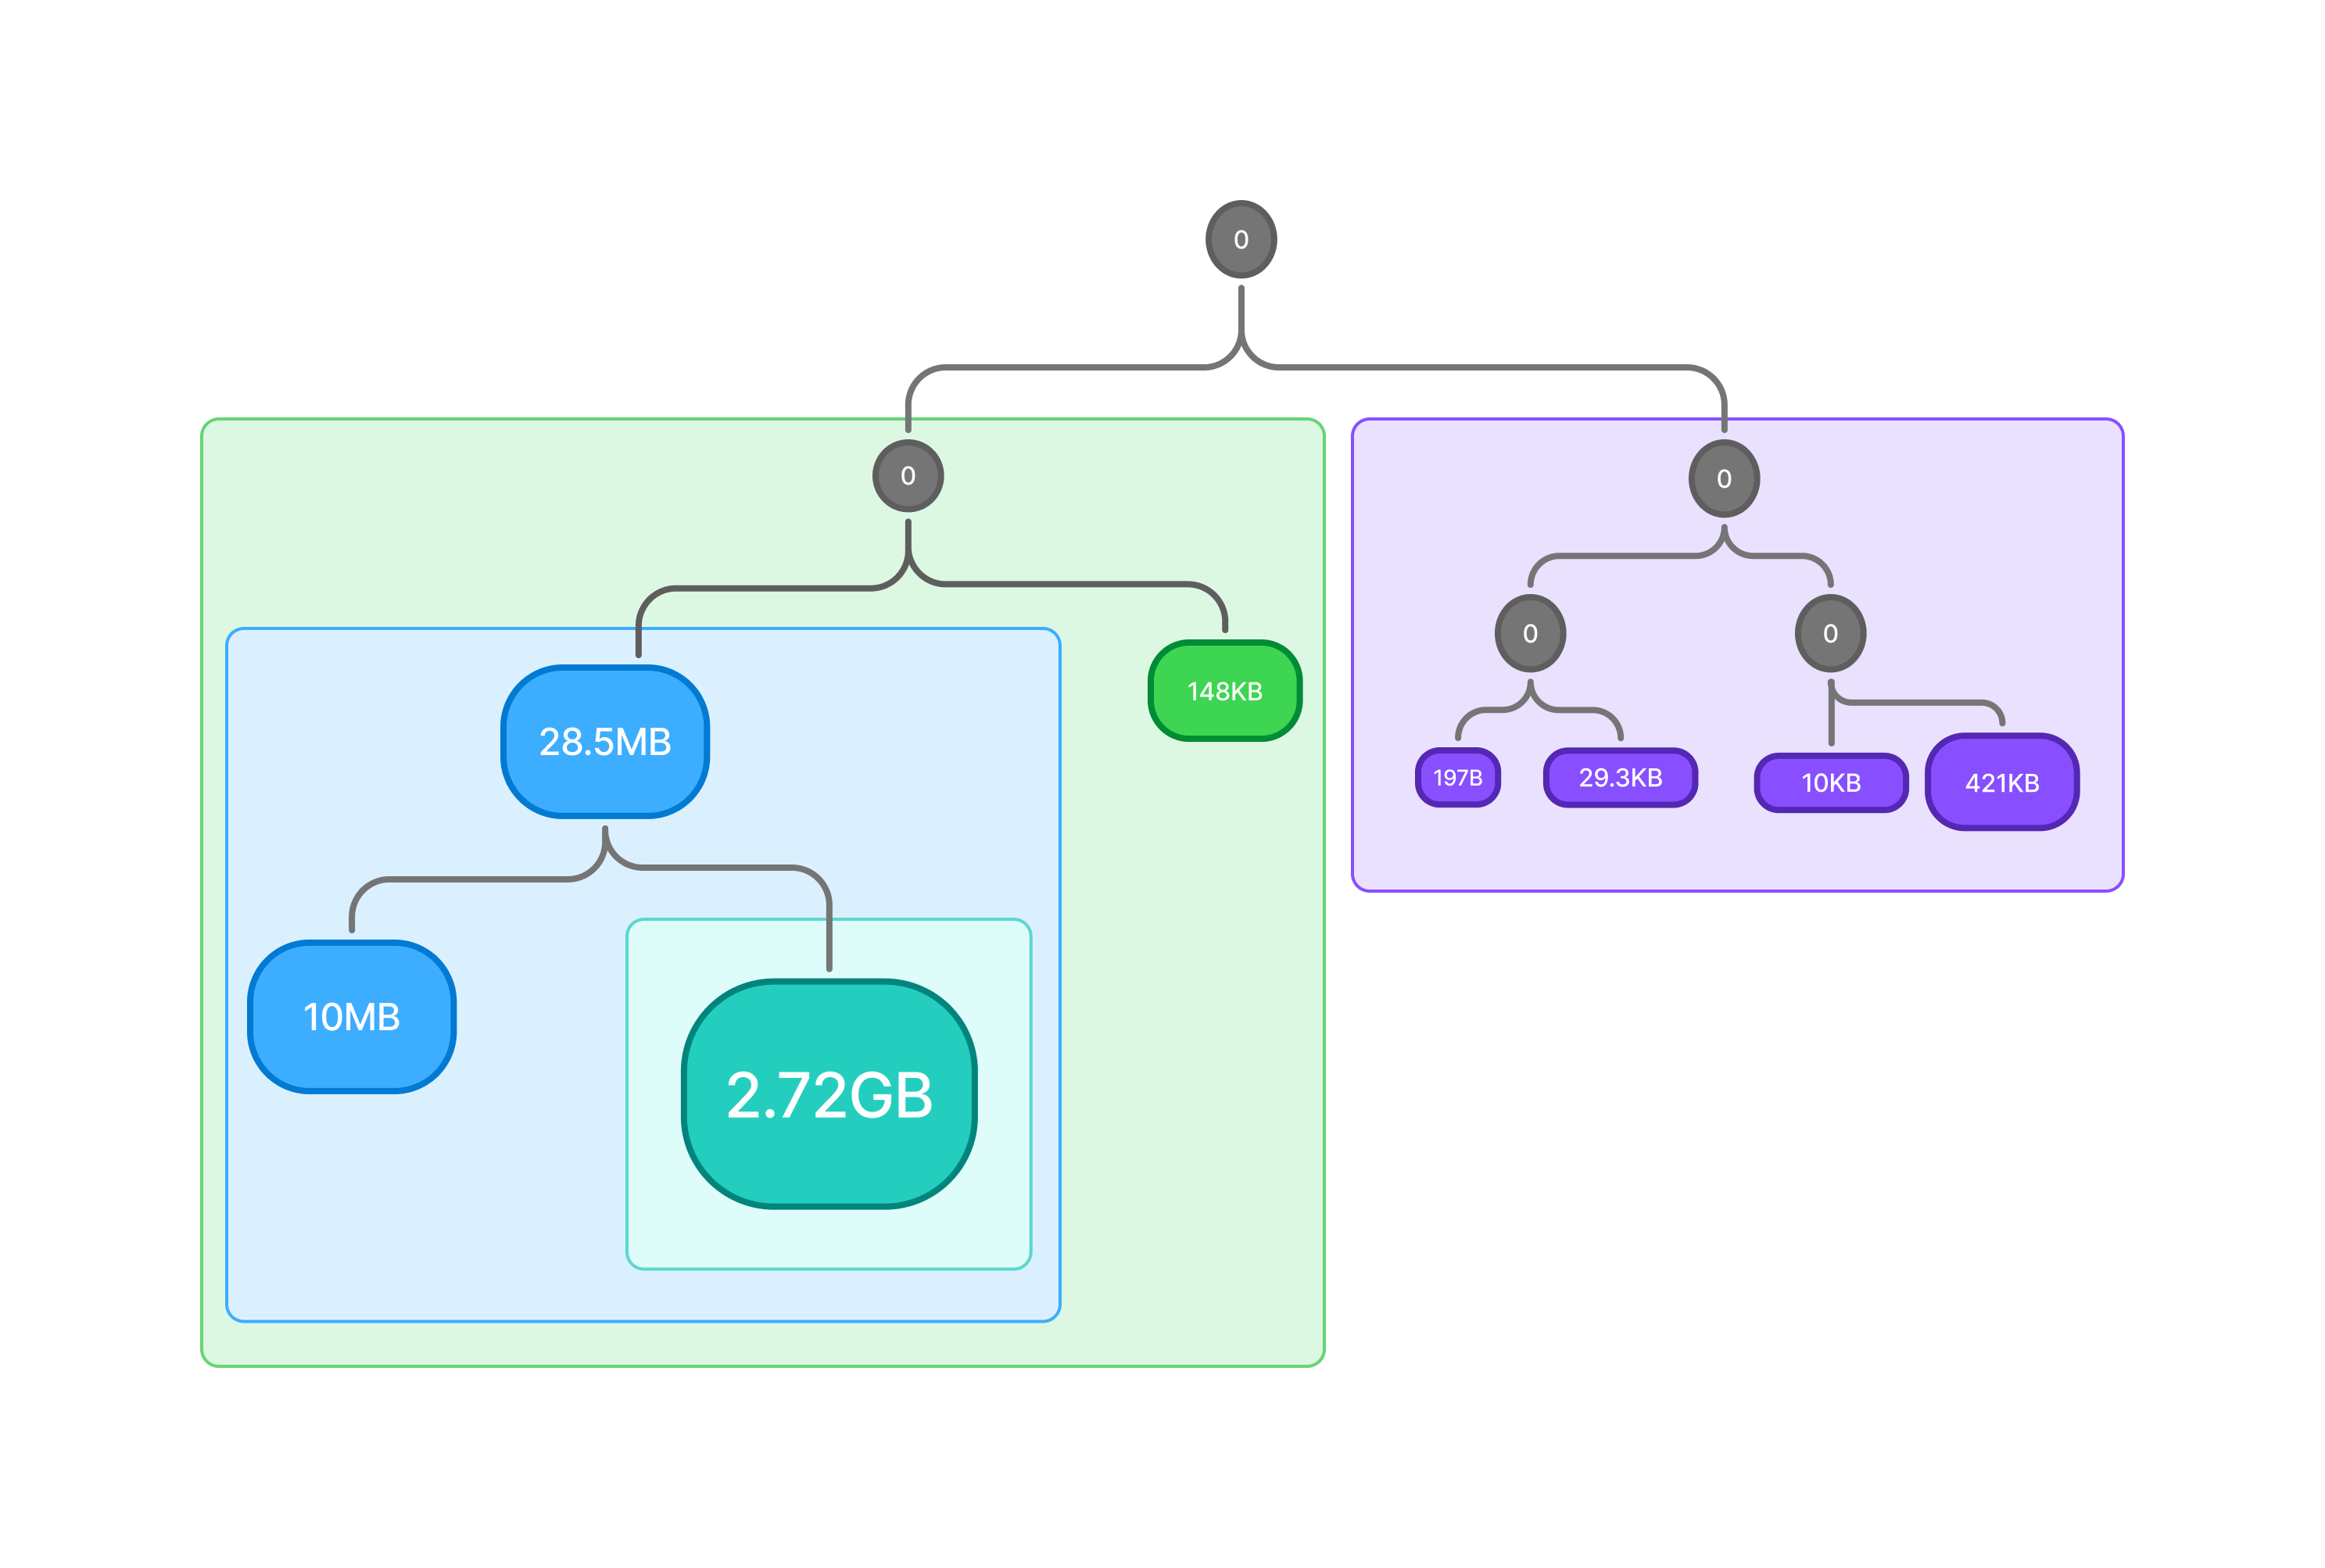
现在,2.72GB 的主题拥有独立于 28.5MB 和 10MB 主题的存储,而较小的主题则全部捆绑到一个共享存储中。
对算法使用多种测试策略
由于自适应拆分直接影响消息在 Aria 中的存储方式,我们希望以高度确定性确保没有 bug。丢弃或重新排序消息会带来严重后果。
我们首先使用 expect 测试来检查算法的各种属性,例如大型主题获得自己的存储、小型同级主题共享存储等等。
对于消息一致性,我们已有一个基于属性的测试,它在随机选择的主题上插入一系列随机生成的消息,然后运行拆分算法。该测试读取主题树的随机部分,并确认消息具有正确的顺序和内容。Theodor 扩展了该测试,使树拆分随机化,这确认了无论主题树如何拆分,消息内容都保持不变。
最后,我们在 Antithesis 中进行了多次运行,以确认这些更改没有破坏 Aria 中的其他任何内容。
优化效果如何?
tip 索引代码已部署到生产环境。我们在 staging 环境中看到了初步结果,显示在某些真实场景中 CPU 利用率降低了 30%。在这些时段,客户端的整体延迟显著下降。我们注意到未实现索引的服务器出现了一些多秒级的尾部延迟,而运行新代码的服务器则没有出现这些问题。
自适应拆分已部署到我们的 staging 环境,并将很快在生产环境中运行。
Nicholas 是 Jane Street 的软件工程师兼技术作家。他撰写了多篇关于辣椒油的博客文章。
来源:Hacker News · blog.janestreet.com