如何评估广告曝光(Impression)的合理价值
How to Find an Impression's Fair Value
转化建模中预测概率直接决定出价,但约 0.2% 的稀有事件率与跨 Banner、全屏、CTV 等异构流量使单一校准检查失效,误差相互抵消掩盖系统性偏差。文章提出三重视图:整体总量比、按预测概率分桶对比期望与实际、以及按垂直领域分 token 计算特征 ECE,并指出 Brier score 在 0.2% 基准率下无法区分好坏模型。
目标是让模型的预测概率与现实相符。在转化建模中,概率不是排序分数,而是你出价所依据的数字。如果模型说某次展示价值 0.2%,而真实转化率是 0.05,那么基于这个数字的每一次出价都错了四倍。排序质量救不了你。转化率就是生意本身。
构建这样的模型很难,因为事件很罕见,大约 0.2%,而且数据是异构的。横幅、全屏、CTV 和其他垂直领域的基准转化率和失败模式各不相同。一个模型在总体上看起来没问题,但在其中某一个领域却可能系统性地出错。
标准的答案是校准评估:检查预测概率是否与观测到的转化率相符。仅做一次检查是不够的,因为误差会相互抵消。一个地方的过度预测会掩盖另一个地方的预测不足,总体看起来干净,而模型在底层已经坏了。这就是生产环境中的辛普森悖论。
本文假设有一个带标签的展示数据集,包含安装结果。该数据如何收集不在讨论范围内。
总体合计
将所有预测概率求和,并与观测到的安装数比较。比值接近 1 意味着模型在总体上无偏。对于检查点选择,方差归一化的平方误差 (E−O)^2/E 很有用。安装计数大致服从泊松分布,因此除以期望值可将平方误差按其近似方差归一化。
合计仍然会受到抵消的影响。这就是为什么还需要另外两个视角。
概率分桶
按预测概率对展示进行分组,并在每个桶内比较期望值与实际值。围绕训练安装率翻倍的边界可以在关键位置保持分辨率。在 [0, 1] 上等宽分箱会把几乎所有内容都倒进最低的一两个箱中。几何间距则同时考察典型转化率和高概率尾部。
报告总体以及按垂直领域拆分的相同分桶。这个视角能揭示经典模式:低分预测不足、高分预测过度(或相反)。
特征 ECE
对于每个垂直领域内的每个 token 值(来源应用、广告包、创意、国家、活动等),计算预测安装数与观测安装数之间的绝对差距,然后将这些差距之和除以总展示数:
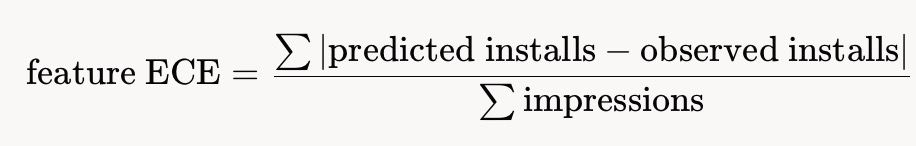
绝对值可以防止在一个 token 内部或跨 token 之间发生抵消。在聚合之前保持垂直领域分离,否则一种流量类型会掩盖另一种流量类型的问题。
这是最具运营相关性的视角。一个模型在总体上看起来校准良好,却可能对特定应用或卖家系统性地过度预测或预测不足。由于该模型是一个 transformer,对短序列(通常为 10 到 12 个 token)进行完全无掩码注意力计算,token 之间的交互已经由注意力层计算出来。因此,每个 token 的差距反映的是该 token 在上下文中的贡献,而不是孤立情况下的贡献。
为什么不用 Brier 分数?
Brier 分数是预测概率与结果之间平方差距的平均值。在 0.2% 的转化率下,一个到处都预测 0.002 的模型得分约为 0.002,任何接近该值的模型看起来都几乎一样。好模型和坏模型之间的差异淹没在小数点后第四位。
Brier 在这里不能作为主要的适应度函数。校准报告可以。特征 ECE 和分桶差距按曝光次数归一化,因此它们不会淹没在基准率中。训练集和验证集上的对数损失,按垂直领域拆分,可以同时捕捉过拟合和特定领域的失败。
智能体循环
同样的报告成为自主智能体的眼睛,它用不同的超参数和不同的特征集训练模型。注入的上下文是一份提炼后的摘要:总体比率、最差的分桶,以及每个类别中最差的 token 及其误差符号。不是原始输出。是模式,不是标量。
智能体读取诊断信息,定位失败,提出更改,重新训练,并重新运行报告。如果最差的 token 更接近观测值,那么这次更改就赢得了它的位置。如果没有,那么候选特征与误差相关但无用,就会被丢弃。
一个具体的例子:特征报告显示某个卖家 token 被高估了两倍。智能体检查是否有另一种可用的 token 类型与该残差相关,将其注入序列,重新训练,并观察差距从 2 倍缩小到 1.1 倍。第二个候选特征与残差相关,但注入后差距没有变化,因此被丢弃。
由于序列很短且长度固定,智能体优化的是组合而非长度。一个贡献信号很少的 token 会被替换为贡献更多的候选特征。它不是简单地追加。问题不是是否要添加特征。而是哪个 token 配得上它的位置。
两个保障措施让循环保持诚实。第一,每种配置重复运行。一个特征赢一次输四次是方差,不是信号。跟踪实验中的胜率,而不仅仅是最新结果。第二,一个智能体无法在其上训练的新评估窗口,因此任何注入的 token 都必须在那里存活才能保留。
局限性
这些报告衡量校准。它们不调整概率。残差偏差由单独的后处理阶段处理。低特征 ECE 仍可能隐藏仅在特定 token 组合中才出现的问题,即使注意力机制计算了交互。而且每次更改后都必须重新运行报告,以检查修复是泛化了还是仅仅移动了误差。
该设计(全局量、分数条件可靠性、特征条件绝对误差)让常见的失败模式保持可见,而不会让它们相互抵消。在实践中,这个循环改变了智能体的行为。它不再猜测保留哪个 epoch 或添加哪个 token,而是读取证据并据此行动。
来源:Hacker News · world.hey.com