NVIDIA Nemotron 3.5 Super VL 上线 Amazon SageMaker JumpStart
NVIDIA Nemotron 3.5 Super VL is now available in Amazon SageMaker JumpStart
NVIDIA Nemotron 3.5 Super VL 已在 Amazon SageMaker JumpStart 上线,可通过 SageMaker Studio 或 Python SDK 部署。
今天,我们宣布 NVIDIA Nemotron 3.5 Super VL 已在 Amazon SageMaker JumpStart 中可用。您可以在 SageMaker Studio 中通过几个步骤,或使用几行 SageMaker Python SDK 代码来部署它。Super VL 是 NVIDIA Nemotron 3.5 系列中的视觉语言模型(VLM)。它接受图像、视频和文本作为输入,并生成文本。
该模型将具有 120B 参数的混合专家(MoE)语言主干与 12B 激活参数和 C-RADIO 视觉编码器相结合。它支持高达 100 万 token 的上下文长度,并包含一个内置的多 token 预测(MTP)头,支持推测解码。您可以按请求配置推理。
NVIDIA 构建 Super VL 用于文档智能、面向计算机使用代理的 GUI 理解、视频问答和多模态代理应用。JumpStart 提供两种变体:NVFP4,通过量化感知蒸馏从 BF16 量化而来,用于优化推理;以及 BF16 全精度参考权重。在本文中,我们将介绍该模型的能力和 JumpStart 部署配置。然后展示实测推理性能,并演示文本、图像和视频推理。
模型概述
Nemotron 3.5 Super VL 是一个 120B 参数模型,每个 token 有 12B 激活参数。它将混合语言主干与专用视觉编码器相结合。
- 语言主干:88 层,交错 Mamba-2 和 MoE 层(512 个路由专家,每个 token 激活 22 个)与 8 个注意力层,外加一个共享 MTP 头。主干从 Nemotron 3 Super Base 初始化,并从 Nemotron 3 Ultra Base 蒸馏。
- 视觉编码器:C-RADIO 视觉编码器对图像和采样的视频帧进行编码,视觉语言连接器将它们映射到语言主干的嵌入空间。编码器和连接器在两种变体中均保持 BF16。
- 训练:模型首先经过持续预训练、长上下文和软件工程中期训练以及视觉语言训练。然后对视觉、推理、代码、工具、聊天、安全和长上下文数据进行两阶段多模态监督微调(SFT)。接下来是在 NeMo RL 和 NeMo Gym 中使用可验证奖励和人类反馈的强化学习(RL)、多教师同策略蒸馏,以及进一步训练 MTP 头的最后阶段。NVFP4 检查点使用 NVIDIA Model Optimizer 和量化感知蒸馏从 BF16 生成。它将视觉编码器、连接器、Mamba 卷积和嵌入保持在 BF16,将 MoE 路由器保持在 FP32。它在 Blackwell GPU 上以 4 位权重和激活(W4A4)运行。
下表比较了 JumpStart 中可用的两种变体的规格。
| 规格 | NVFP4 | BF16 |
| 参数 | 总计 120B,激活 12B | 总计 120B,激活 12B |
| 用途 | 优化推理(延迟和吞吐量) | 用于定制的全精度参考权重:SFT、RL、蒸馏、领域适应和自定义量化 |
| 输入/输出 | 图像、视频、文本/文本 | 图像、视频、文本/文本 |
| 上下文长度 | 高达 100 万 token(JumpStart 服务配置使用 520 至 15,600 token) | 相同 |
| 检查点大小 | 约 75 GB | 约 249 GB |
| JumpStart 实例 | ml.g7.24xlarge(默认)、ml.g7.48xlarge | ml.p5en.48xlarge |
| 推测解码 | 内置 MTP 头。在 JumpStart 服务配置中未启用 | 相同 |
| LoRA 适配器服务 | 否 | 否 |
| 语言 | 英语、法语、德语、意大利语、日语、西班牙语、中文 | 相同 |
| 推理 | 默认开启。可通过 enable_thinking 配置 |
相同 |
| 输出 | 工具调用、JSON schema 输出、可配置推理 | 相同 |
| 许可证 | OpenMDW 许可协议 1.1 版 | 相同 |
关键用例
Super VL 面向必须“看见并阅读”的智能体工作负载。其目标场景是融合推理、编码、工具使用、文档理解和视频理解的视觉语言智能体。
- 文档智能:光学字符识别(OCR)、图表、表格和多页文档。每张 1,536 x 1,024 的页面图像约消耗 1,536 个上下文 token。JumpStart 服务配置每次请求接受一张图像和一个视频。
- GUI 理解:面向在应用中导航的计算机使用智能体,提供屏幕定位与推理能力。
- 视频理解:分析和总结短 MP4 视频片段,包括回答关于视觉内容的问题。你可以以内联 base64 编码内容的形式提供视频,但受端点请求负载大小限制约束。
- 多模态智能体:工具调用、通过
response_format输出 JSON schema,以及可配置推理,共同支持多模态智能体工作流。 - 定制(BF16):下载 BF16 参考权重,用于 SFT、RL、蒸馏、领域适配,或创建你自己的量化变体。JumpStart 端点仅提供基础权重,不加载 LoRA 适配器。
模型质量基准
NVIDIA 模型卡报告了两个检查点在推理、编码、智能体、长上下文和多模态基准上的结果,评估设置保持一致,因此只有检查点不同。下表重点列出与视觉语言工作负载最相关的多模态基准(推理开启)。
| 基准 | 能力 | BF16 | NVFP4 |
| MMLongBench-Doc | 长文档多模态理解 | 62.82 | 62.82 |
| OCRBench v2,英文 | OCR 与文档理解 | 68.12 | 68.34 |
| CharXiv 推理 | 图表与图形推理 | 80.82 | 79.88 |
| Video-MME v2 | 视频理解 | 32.85 | 32.54 |
| OSWorld-Verified | 视觉计算机使用与智能体任务 | 51.14 | 52.30 |
JumpStart 默认的 NVFP4 在 MMLongBench-Doc 上与 BF16 持平,在其他基准上差距约在一个点以内,并在 OCRBench v2 和 OSWorld-Verified 上略高。完整对比其他公开可用模型及评估设置,请参阅 NVIDIA Nemotron 3.5 Super VL 与 Lightning 技术报告。
SageMaker JumpStart 上的推理性能
我们使用 JumpStart 发布容器,以 generate 工作负载配置测量推理性能:250 个输入 token、1,500 个输出 token,以及五个并发流式请求。吞吐量为每个请求的平均每秒输出 token 数,首 token 时间为各请求的平均值。
| 实例类型 | 变体 | 每请求输出吞吐量(均值) | 首 token 时间(均值) |
| ml.g7.24xlarge | NVFP4 | 63.07 tokens/sec | 0.45 sec |
| ml.g7.48xlarge | NVFP4 | 64.01 tokens/sec | 0.51 sec |
| ml.p5en.48xlarge | BF16 | 140.85 tokens/sec | 0.53 sec |
这些结果展示了通过 JumpStart 可用的部署选择。NVFP4 变体在 G7 实例上运行,GPU 占用更小。在此测试中,ml.p5en.48xlarge 上的 BF16 变体每请求每秒输出 140.85 个 token。在全部三种配置下,首 token 时间均保持在约半秒。由于各变体运行在不同的 GPU 系统和配置上,这些测量结果并非孤立的 BF16-versus-NVFP4 精度对比。更长的提示词会改变情况:在使用 summarize 配置文件(10,000 个输入 token)时,ml.g7.24xlarge 上的首 token 时间为 12.62 秒。
支持的实例
SageMaker JumpStart 在以下经过验证的实例类型上支持 Nemotron 3.5 Super VL。NVFP4 在配备 NVIDIA RTX PRO 4500 Blackwell Server Edition GPU 的 G7 实例上运行,BF16 在配备 NVIDIA H200 GPU 的 P5en 实例上运行。NVFP4 的 JumpStart 默认实例为 ml.g7.24xlarge,它是 generate 配置的推荐起点。
| 变体 | 实例类型 | GPU | GPU 内存 | 张量并行 |
| NVFP4 | ml.g7.24xlarge(默认) | 4x NVIDIA RTX PRO 4500 Blackwell Server Edition | 128 GB | 4 |
| NVFP4 | ml.g7.48xlarge | 8x NVIDIA RTX PRO 4500 Blackwell Server Edition | 256 GB | 8 |
| BF16 | ml.p5en.48xlarge | 8x NVIDIA H200 | 1,128 GB | 8 |
检查点包含 MTP 头,但 JumpStart 服务配置未启用推测解码。
使用 SageMaker JumpStart 部署 Nemotron 3.5 Super VL
你可以从 SageMaker Studio、使用 SageMaker Python SDK 或从 Hugging Face 模型页面部署该模型。
先决条件
部署之前,请确保你具备以下条件:
- 一个具有创建 Amazon SageMaker AI 端点权限的 AWS 账户。
- 一个可访问 SageMaker AI 的 AWS Identity and Access Management (IAM) 角色。
- ml.g7.24xlarge、ml.g7.48xlarge 或 ml.p5en.48xlarge 端点使用量的服务配额。新账户中 ml.g7 配额初始为零,因此请在部署前通过 Service Quotas 申请增加配额。
- 对于 SDK 方式,需要 SageMaker Python SDK v3(版本 3.25 或更高)。
从 SageMaker Studio 部署
要从 SageMaker Studio 部署模型,请完成以下步骤:
- 打开 SageMaker Studio,然后在导航窗格中选择 JumpStart。
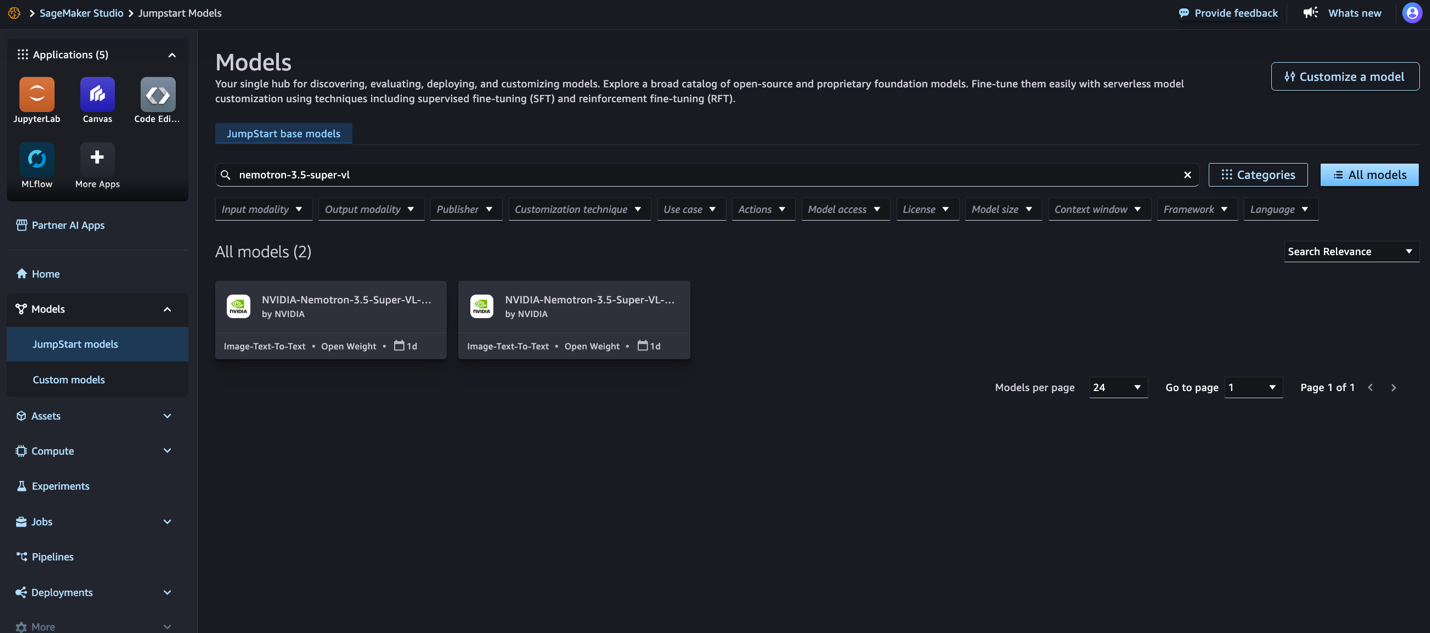
- In the search bar, enter Nemotron 3.5 Super VL. The search results list both variants, as shown in the following screenshot.

图 1:在 SageMaker JumpStart 中搜索 NVIDIA Nemotron 3.5 Super VL
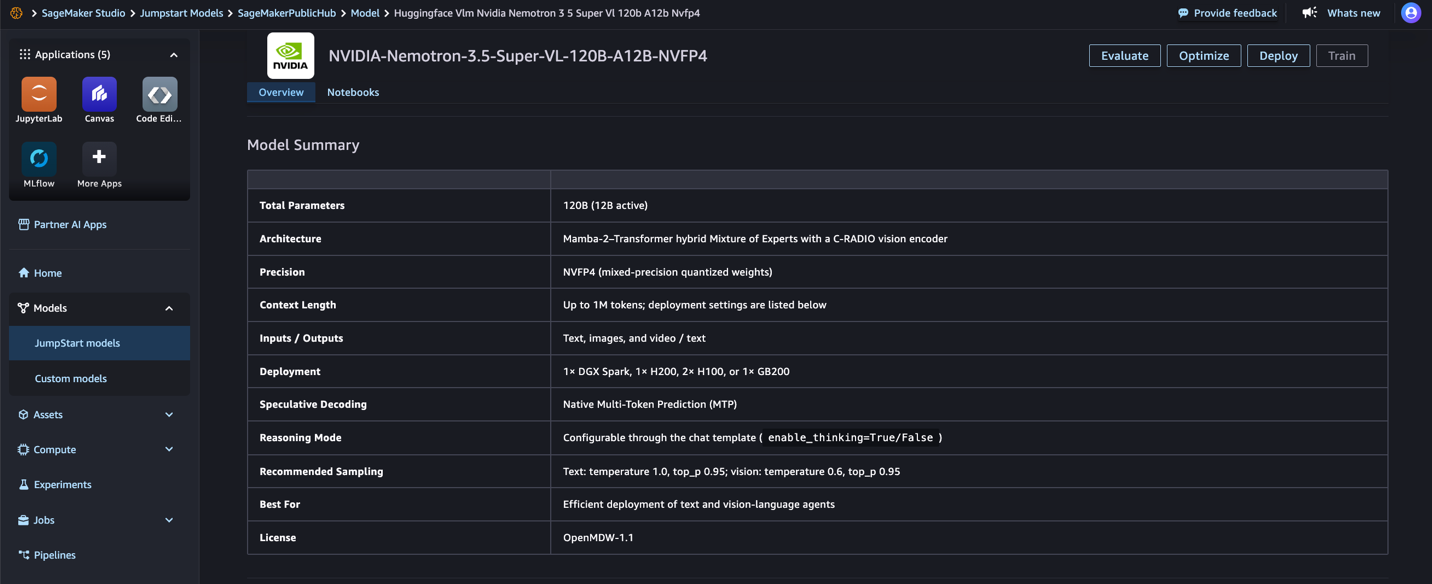
- Choose the model card for the variant you want to deploy. Choose NVFP4 for optimized inference on G7 instances. The following screenshot shows the NVFP4 model card.

图 2:SageMaker JumpStart 中的 NVIDIA Nemotron 3.5 Super VL NVFP4 模型卡
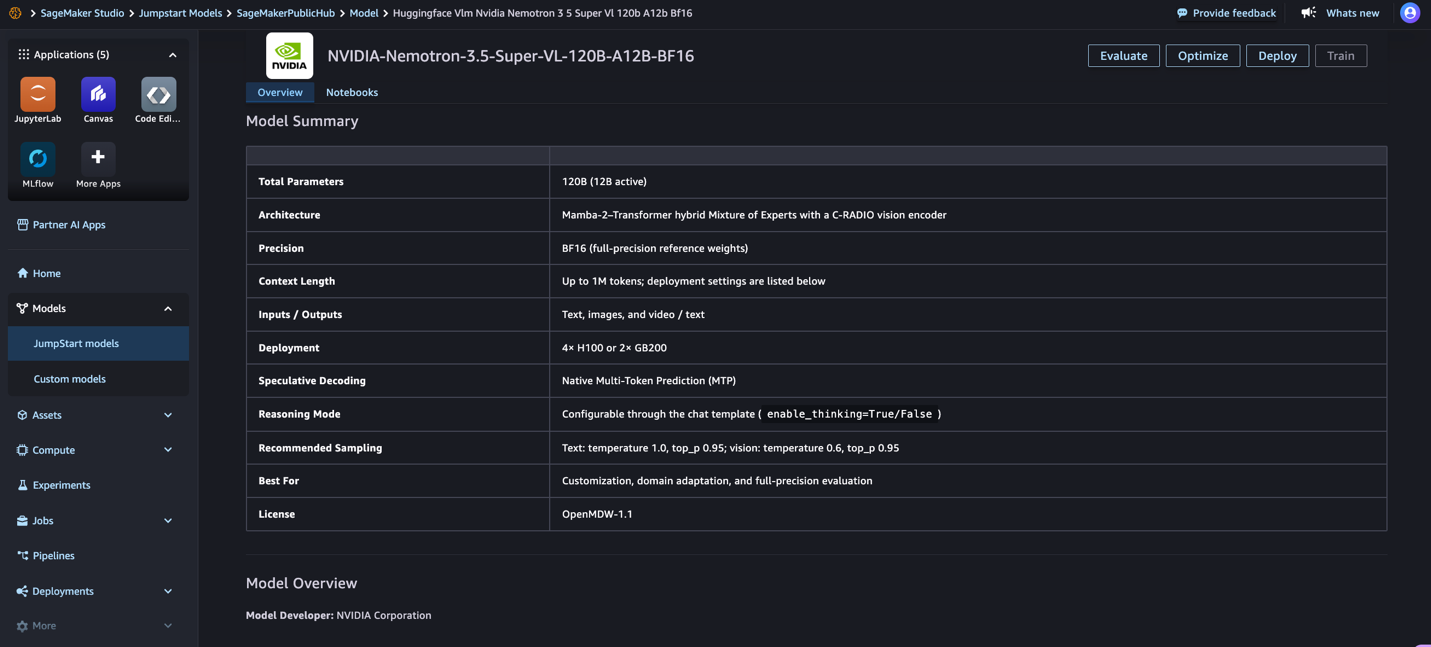
如果你需要在 ml.p5en.48xlarge 上使用全精度参考权重,请选择 BF16。以下截图显示了 BF16 模型卡。

图 3:SageMaker JumpStart 中的 NVIDIA Nemotron 3.5 Super VL BF16 模型卡
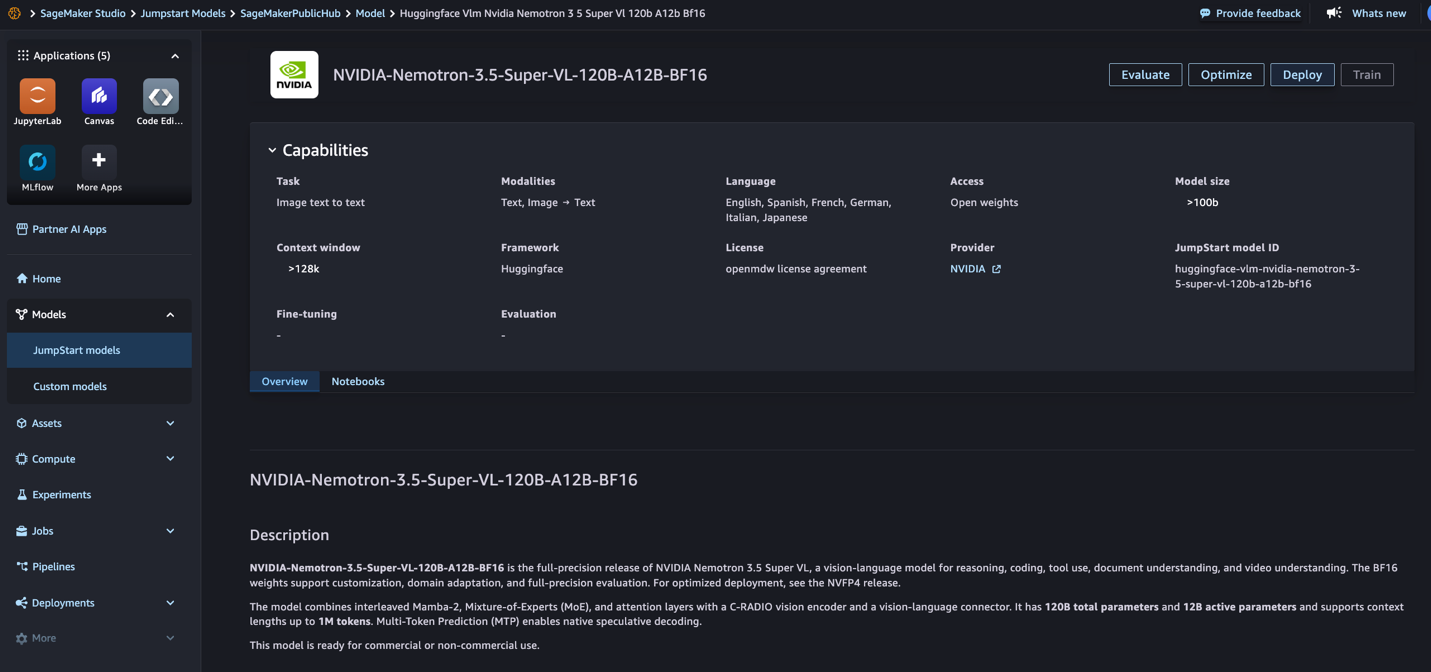
- On the model card, review the model details and license terms, then choose Deploy. The following screenshot shows the model details you can review before deployment.

图 4:部署前查看 Nemotron 3.5 Super VL 的功能和模型详细信息
- 对于 Instance type,保留默认值(NVFP4 为 ml.g7.24xlarge,BF16 为 ml.p5en.48xlarge),或选择其他受支持的实例类型。然后选择 Deploy。
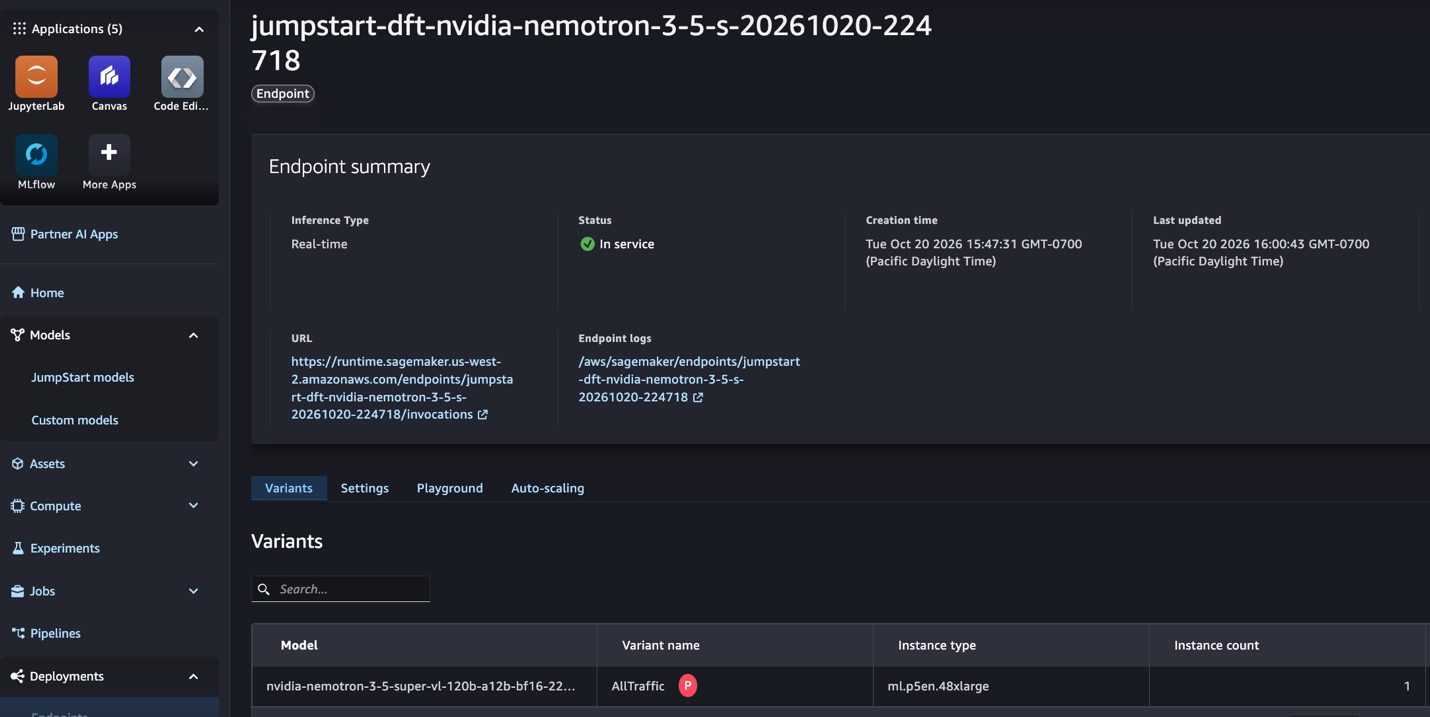
- Wait for the endpoint status to change to InService before you invoke the model. Deployment takes about 10 minutes on ml.g7.24xlarge. The following screenshot shows a deployment in progress.

图 5:SageMaker 端点部署进行中,状态尚未达到 InService
使用 SageMaker Python SDK 部署
# Install the SageMaker Python SDK v3: pip install "sagemaker>=3.25"
from sagemaker.core.helper.session_helper import get_execution_role
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.core.training.configs import Compute
from sagemaker.serve import ModelBuilder

# BF16 variant: model_id "huggingface-vlm-nvidia-nemotron-3-5-super-vl-120b-a12b-bf16" on ml.p5en.48xlarge.
jumpstart_config = JumpStartConfig(
    model_id="huggingface-vlm-nvidia-nemotron-3-5-super-vl-120b-a12b-nvfp4",
    inference_config_name="modify_best_price_performance",
)
model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    role_arn=get_execution_role(),
    compute=Compute(instance_type="ml.g7.24xlarge", instance_count=1),
)
model_builder.build()
endpoint = model_builder.deploy(endpoint_name="nemotron-3-5-super-vl")
该示例使用 SageMaker Python SDK v3 类:JumpStartConfig 指定模型,ModelBuilder 构建并部署模型,deploy 返回一个 Endpoint 资源。请在 Compute 中传入实例类型,因为当缺少实例类型时,SDK 会回退到 ml.m5.large,随后构建会失败。部署调用会等待端点进入 InService 状态,在 ml.g7.24xlarge 上大约需要 10 分钟。
inference_config_name 参数用于选择服务配置,每种配置会设置不同的上下文长度。默认的 generate 配置提供 2,275 个 token 的上下文,适用于短提示词。summarize 配置提供 13,650 个 token,modify 配置提供 15,600 个 token。本示例使用 modify 配置,因为本文中的推理示例(尤其是图像、视频和推理请求)需要更大的上下文。后续所有推理示例均假定使用 modify 配置。
从 Hugging Face 部署
你也可以从模型的 Hugging Face 模型页面进行部署:选择 Deploy,然后选择 Amazon SageMaker AI,并继续进入 SageMaker 部署工作流。
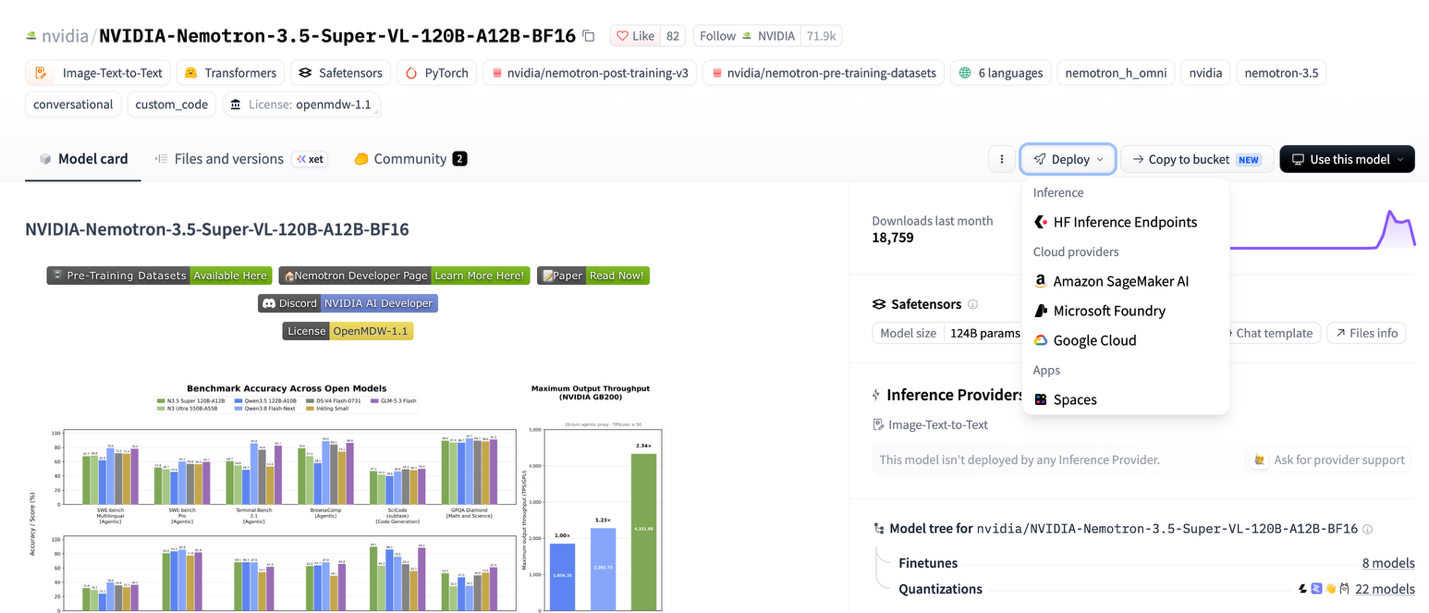
图 6:Hugging Face 上的 NVIDIA Nemotron 3.5 Super VL 模型页面及 Deploy 菜单
在部署菜单中,选择 Amazon SageMaker AI 以打开 SageMaker 部署工作流,如下图所示。
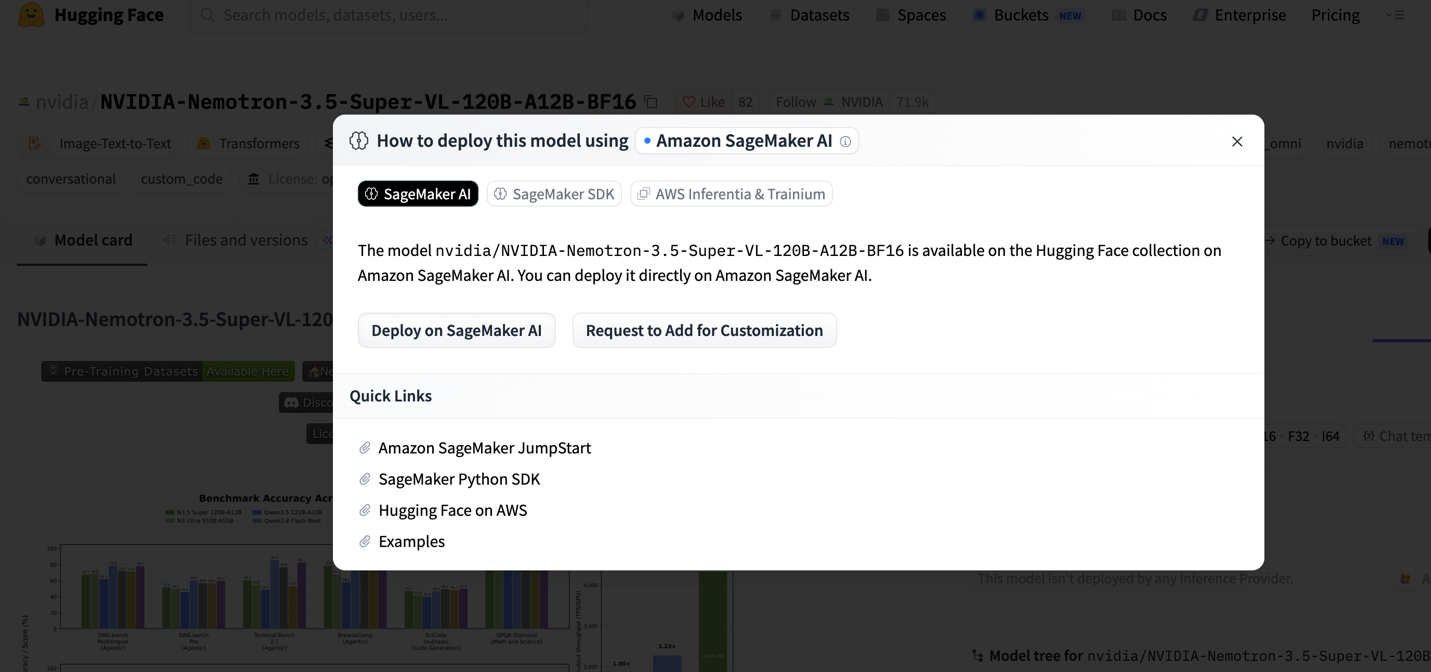
图 7:在 Hugging Face 部署工作流中选择 Amazon SageMaker AI
端点进入 InService 状态后,你就可以向其发送推理请求。
运行推理
JumpStart 端点提供由 vLLM 驱动的聊天补全 API,因此应用程序可以使用熟悉的聊天消息格式发送推理请求。NVIDIA 建议文本请求使用温度 1.0 和 top_p 0.95,图像和视频请求使用温度 0.6 和 top_p 0.95。你必须以内联 base64 数据 URL 的形式发送媒体,因为该端点运行在网络隔离环境中,无法获取 URL。
文本,开启推理
推理默认开启,你可以按请求进行配置。推理文本会在消息的 reasoning 字段中返回,与 content 分开。
import json

payload = {
    "messages": [{"role": "user", "content":
        "Explain the difference between OCR and document understanding."}],
    "max_tokens": 2000,
    "temperature": 1.0,
    "top_p": 0.95,
}
response = endpoint.invoke(
    body=json.dumps(payload), content_type="application/json", accept="application/json"
)
result = json.loads(response.body.read())
print(result["choices"][0]["message"]["reasoning"])
print(result["choices"][0]["message"]["content"])
图像,关闭推理
对于直接提取类任务,你可以在 chat_template_kwargs 中使用 enable_thinking=False 关闭推理。
import base64

with open("invoice.png", "rb") as f:
    image_b64 = base64.b64encode(f.read()).decode("utf-8")

payload = {
    "messages": [{
        "role": "user",
        "content": [
            {"type": "image_url",
             "image_url": {"url": f"data:image/png;base64,{image_b64}"}},
            {"type": "text",
             "text": "Extract the vendor, date, and total as JSON."},
        ],
    }],
    "max_tokens": 1024,
    "temperature": 0.6,
    "top_p": 0.95,
    "chat_template_kwargs": {"enable_thinking": False},
}
response = endpoint.invoke(
    body=json.dumps(payload), content_type="application/json", accept="application/json"
)
result = json.loads(response.body.read())
print(result["choices"][0]["message"]["content"])
模型接受图像,而不是原始 PDF 文件。要处理 PDF,请先将每一页渲染为图像(例如 PNG),再发送给模型。一页 1,536 x 1,024 的图像大约消耗 1,536 个 token 的上下文,且一个请求只能携带一张图像。
视频
以下示例将一段短 MP4 片段以 base64 编码的数据 URL 发送,并要求模型对其进行总结,同时关闭推理以获得直接响应。
import base64

with open("demo.mp4", "rb") as f:
    video_b64 = base64.b64encode(f.read()).decode("utf-8")

payload = {
    "messages": [{
        "role": "user",
        "content": [
            {"type": "video_url",
             "video_url": {"url": f"data:video/mp4;base64,{video_b64}"}},
            {"type": "text", "text": "Summarize what happens in this video."},
        ],
    }],
    "max_tokens": 2000,
    "temperature": 0.6,
    "top_p": 0.95,
    "chat_template_kwargs": {"enable_thinking": False},
}
response = endpoint.invoke(
    body=json.dumps(payload), content_type="application/json", accept="application/json"
)
result = json.loads(response.body.read())
print(result["choices"][0]["message"]["content"])
对于视频推理,请使用短小且经过压缩的片段,并确保编码后的请求处于端点支持的负载限制之内。对于推理密集型视频请求,请将 max_tokens 设置得足够高,以便模型完成推理,同时考虑响应长度和端点调用限制。
最佳实践
在 SageMaker JumpStart 上运行 Nemotron 3.5 Super VL 时,请考虑以下建议:
- 媒体输入:模型接受图像,而不是原始 PDF 文件,因此请先将 PDF 页面渲染为图像。
- 视频配置:帧采样在端点启动时设置,而不是按请求设置。JumpStart 端点使用 vLLM 默认采样,并拒绝按请求设置
media_io_kwargs。 - 带推理的视频:对于启用推理的视频,请将
max_tokens设置为至少 8,192;如果你希望获得直接响应,请关闭推理。 - 上下文预算:
max_tokens限制补全长度。提示词和补全内容合计必须符合服务配置的模型长度:generate 配置为 2,275 个 token,interact 为 520,summarize 为 13,650,modify 为 15,600。图像和视频帧也会消耗上下文。 - 多页文档:JumpStart 服务配置每次请求只接受一张图像。请每次请求发送一页,或将多页拼接成一张图像,并检查上下文预算。
- 推理模式:对于多步分析和智能体任务,请使用推理。当你需要更简短、直接的响应时,可在提取或生成图像描述时将其禁用。
- 采样:按照 NVIDIA 的建议,文本任务从温度 1.0 和
top_p0.95 开始,图像和视频任务从温度 0.6 和top_p0.95 开始。
清理
为避免持续产生费用,完成后请删除端点、端点配置和模型:
from sagemaker.core.resources import EndpointConfig, Model

endpoint_config = EndpointConfig.get(endpoint_config_name=endpoint.endpoint_config_name)
model_name = endpoint_config.production_variants[0].model_name
endpoint.delete()
endpoint_config.delete()
Model.get(model_name=model_name).delete()
结论
NVIDIA Nemotron 3.5 Super VL 将图像、视频和文档理解能力引入 SageMaker JumpStart。NVFP4 变体可在配备 NVIDIA RTX PRO 4500 Blackwell Server Edition GPU 的 G7 实例上使用。BF16 变体可在配备 NVIDIA H200 GPU 的 ml.p5en.48xlarge 上使用。选择 NVFP4 可获得优化推理,模型质量接近 BF16 检查点;若需要全精度参考权重,则选择 BF16。要开始使用,请在 SageMaker Studio 中打开 SageMaker JumpStart,或使用 SageMaker Python SDK。
要了解更多信息,请参阅 Amazon SageMaker AI 开发者指南中的 SageMaker JumpStart 预训练模型以及 Nemotron 3.5 Super VL 技术报告。
关于作者

Venu Kanamatareddy
Venu 是 Amazon Web Services 的 AI 专家解决方案架构师,他与高增长的 AI 原生初创公司合作,设计、扩展和运营生产级 AI 系统。他的工作涵盖生成式 AI、LLM 优化、智能体工作流以及生产环境中 AI 系统的评估和可观测性。他专注于构建能够大规模可靠运行的 AI 系统,在性能、成本和生产就绪度之间取得平衡。

Naidile Murali
Naidile 是 AWS 的产品经理,常驻华盛顿州贝尔维尤。她专注于提升 Amazon SageMaker AI 上的 AI/ML 开发者体验,包括入门引导、IDE 连接和 GPU 容量管理。Naidile 拥有乔治城大学的 MBA 学位。

Evan Kravitz
Evan 是 Amazon Web Services 的软件工程师,从事 SageMaker JumpStart 相关工作。他对机器学习与云计算的融合很感兴趣。业余时间,Evan 喜欢烹饪、旅行以及在纽约市跑步。
来源:AWS Machine Learning Blog · aws.amazon.com