STABL 成立:在 AI 回应中补上缺失的象限
非营利研究组织 STABL 成立,主张同时重视 AI 的变革潜力与其落地时的下游瓶颈,认为这一"右上象限"目前思考稀缺。STABL 提出四大研究主题,包括如何衡量递归自我改进(RSI)的进展、AI 扩散速度与制约能力转化为社会成果的瓶颈。该组织认为对齐只是 AI 风险管理的一部分,韧性应成为核心。
AI 作为常态技术· Sayash Kapoor·2026-11-11 02:37· 2 小时前AI 评分49
应对 AI 时缺失的象限
AI 导读
非营利研究组织 STABL 成立,主张同时重视 AI 的变革潜力与其落地时的下游瓶颈,认为这一"右上象限"目前思考稀缺。STABL 提出四大研究主题,包括如何衡量递归自我改进(RSI)的进展、AI 扩散速度与制约能力转化为社会成果的瓶颈。该组织认为对齐只是 AI 风险管理的一部分,韧性应成为核心。
正文 · 原文
我们正在创办一个非营利研究组织:STABL。
适应先进 AI 将需要剧烈的制度变革和广泛的社会韧性。它还需要关于 AI 进展与影响的证据——递归自我改进(RSI)的前景、AI 扩散的速度,以及制约 AI 能力转化为社会成果的瓶颈。
四个论点定义了我们的世界观:
我们将先进 AI 视为一种具有广泛社会效益潜力的变革性通用技术。
但我们认识到,社会转型的速度将更多受制于人类与组织变革的速度,而非能力进展,从而形成瓶颈。
我们的制度——我们组织知识、工作和治理的既定方式——是这一动荡时期的重要稳定来源,但它们也需要认真改革,以继续服务于其目的。
我们主张采用广泛的防御组合来管理 AI 风险,对齐只是其中一部分。韧性——当今最被忽视的组成部分——必须成为核心。
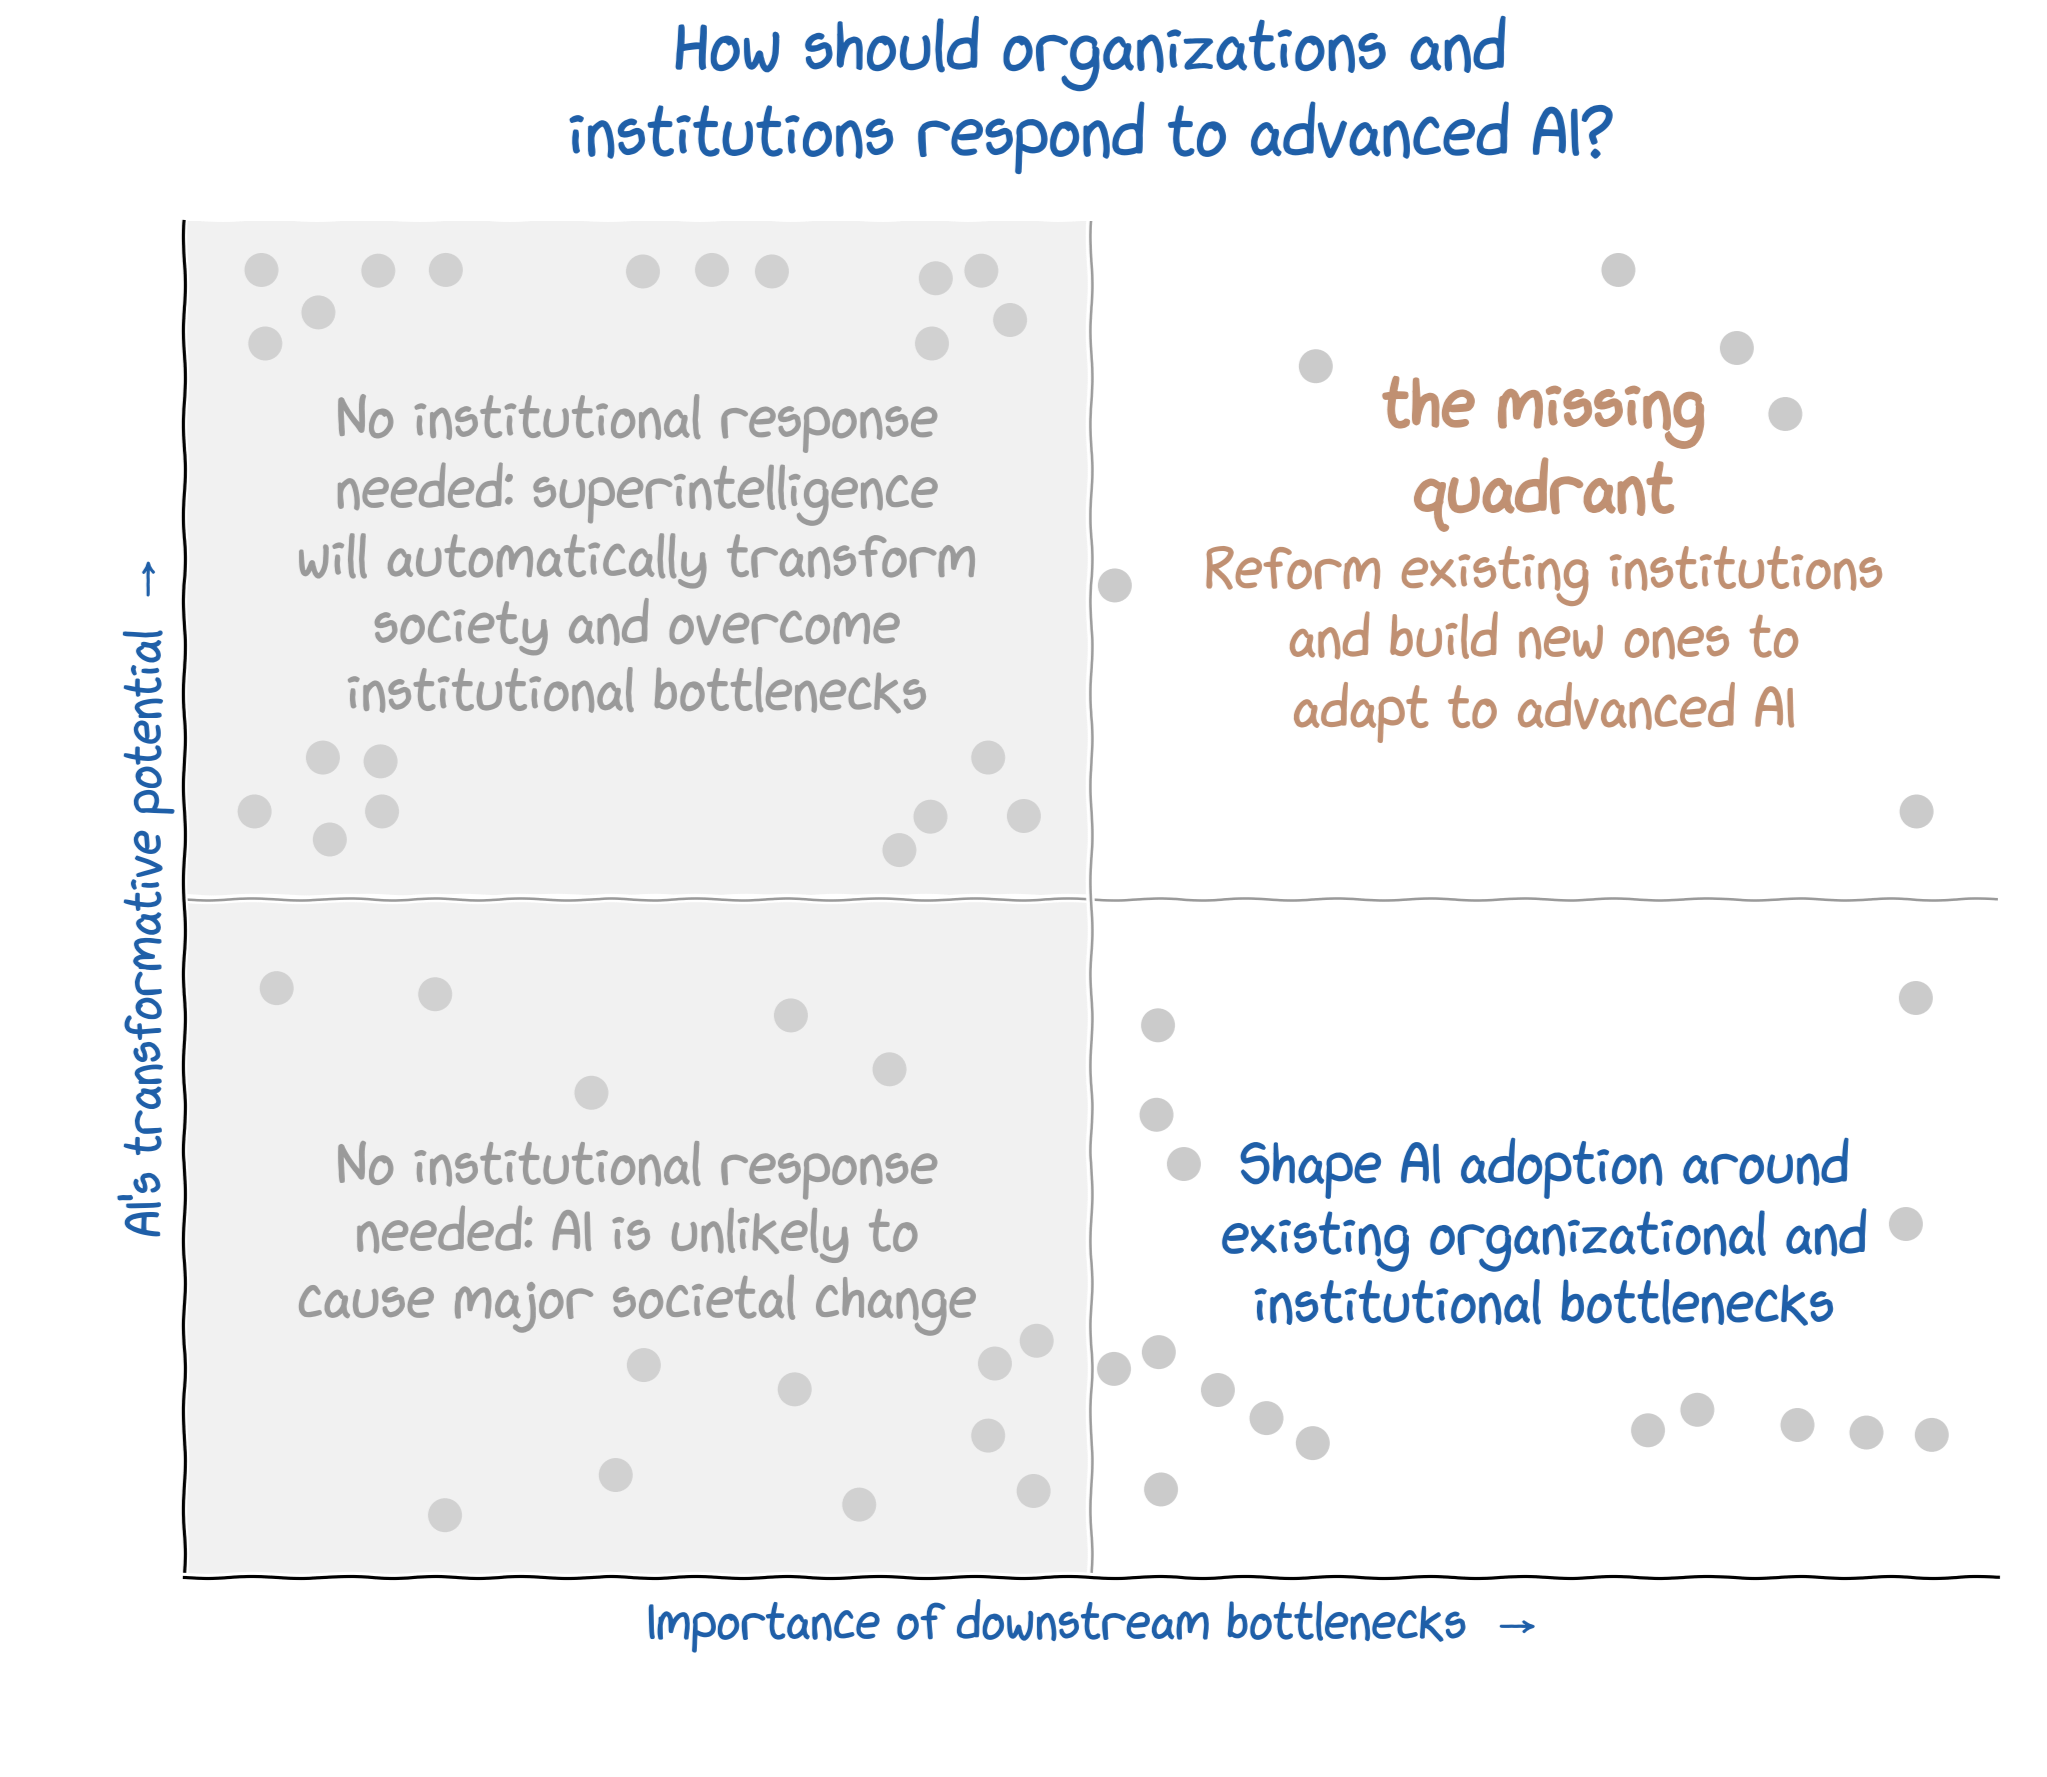
另一种表述我们世界观的方式是将其置于一个 2x2 图表中。纵轴表示认真对待 AI 的变革潜力。横轴表示认真对待 AI 影响的下游瓶颈。左上角是技术决定论:认为超级智能将单方面改造社会,消除下游瓶颈。许多 AI CEO 表达这一观点,例如预测一个世纪的进步将被压缩到未来几年。
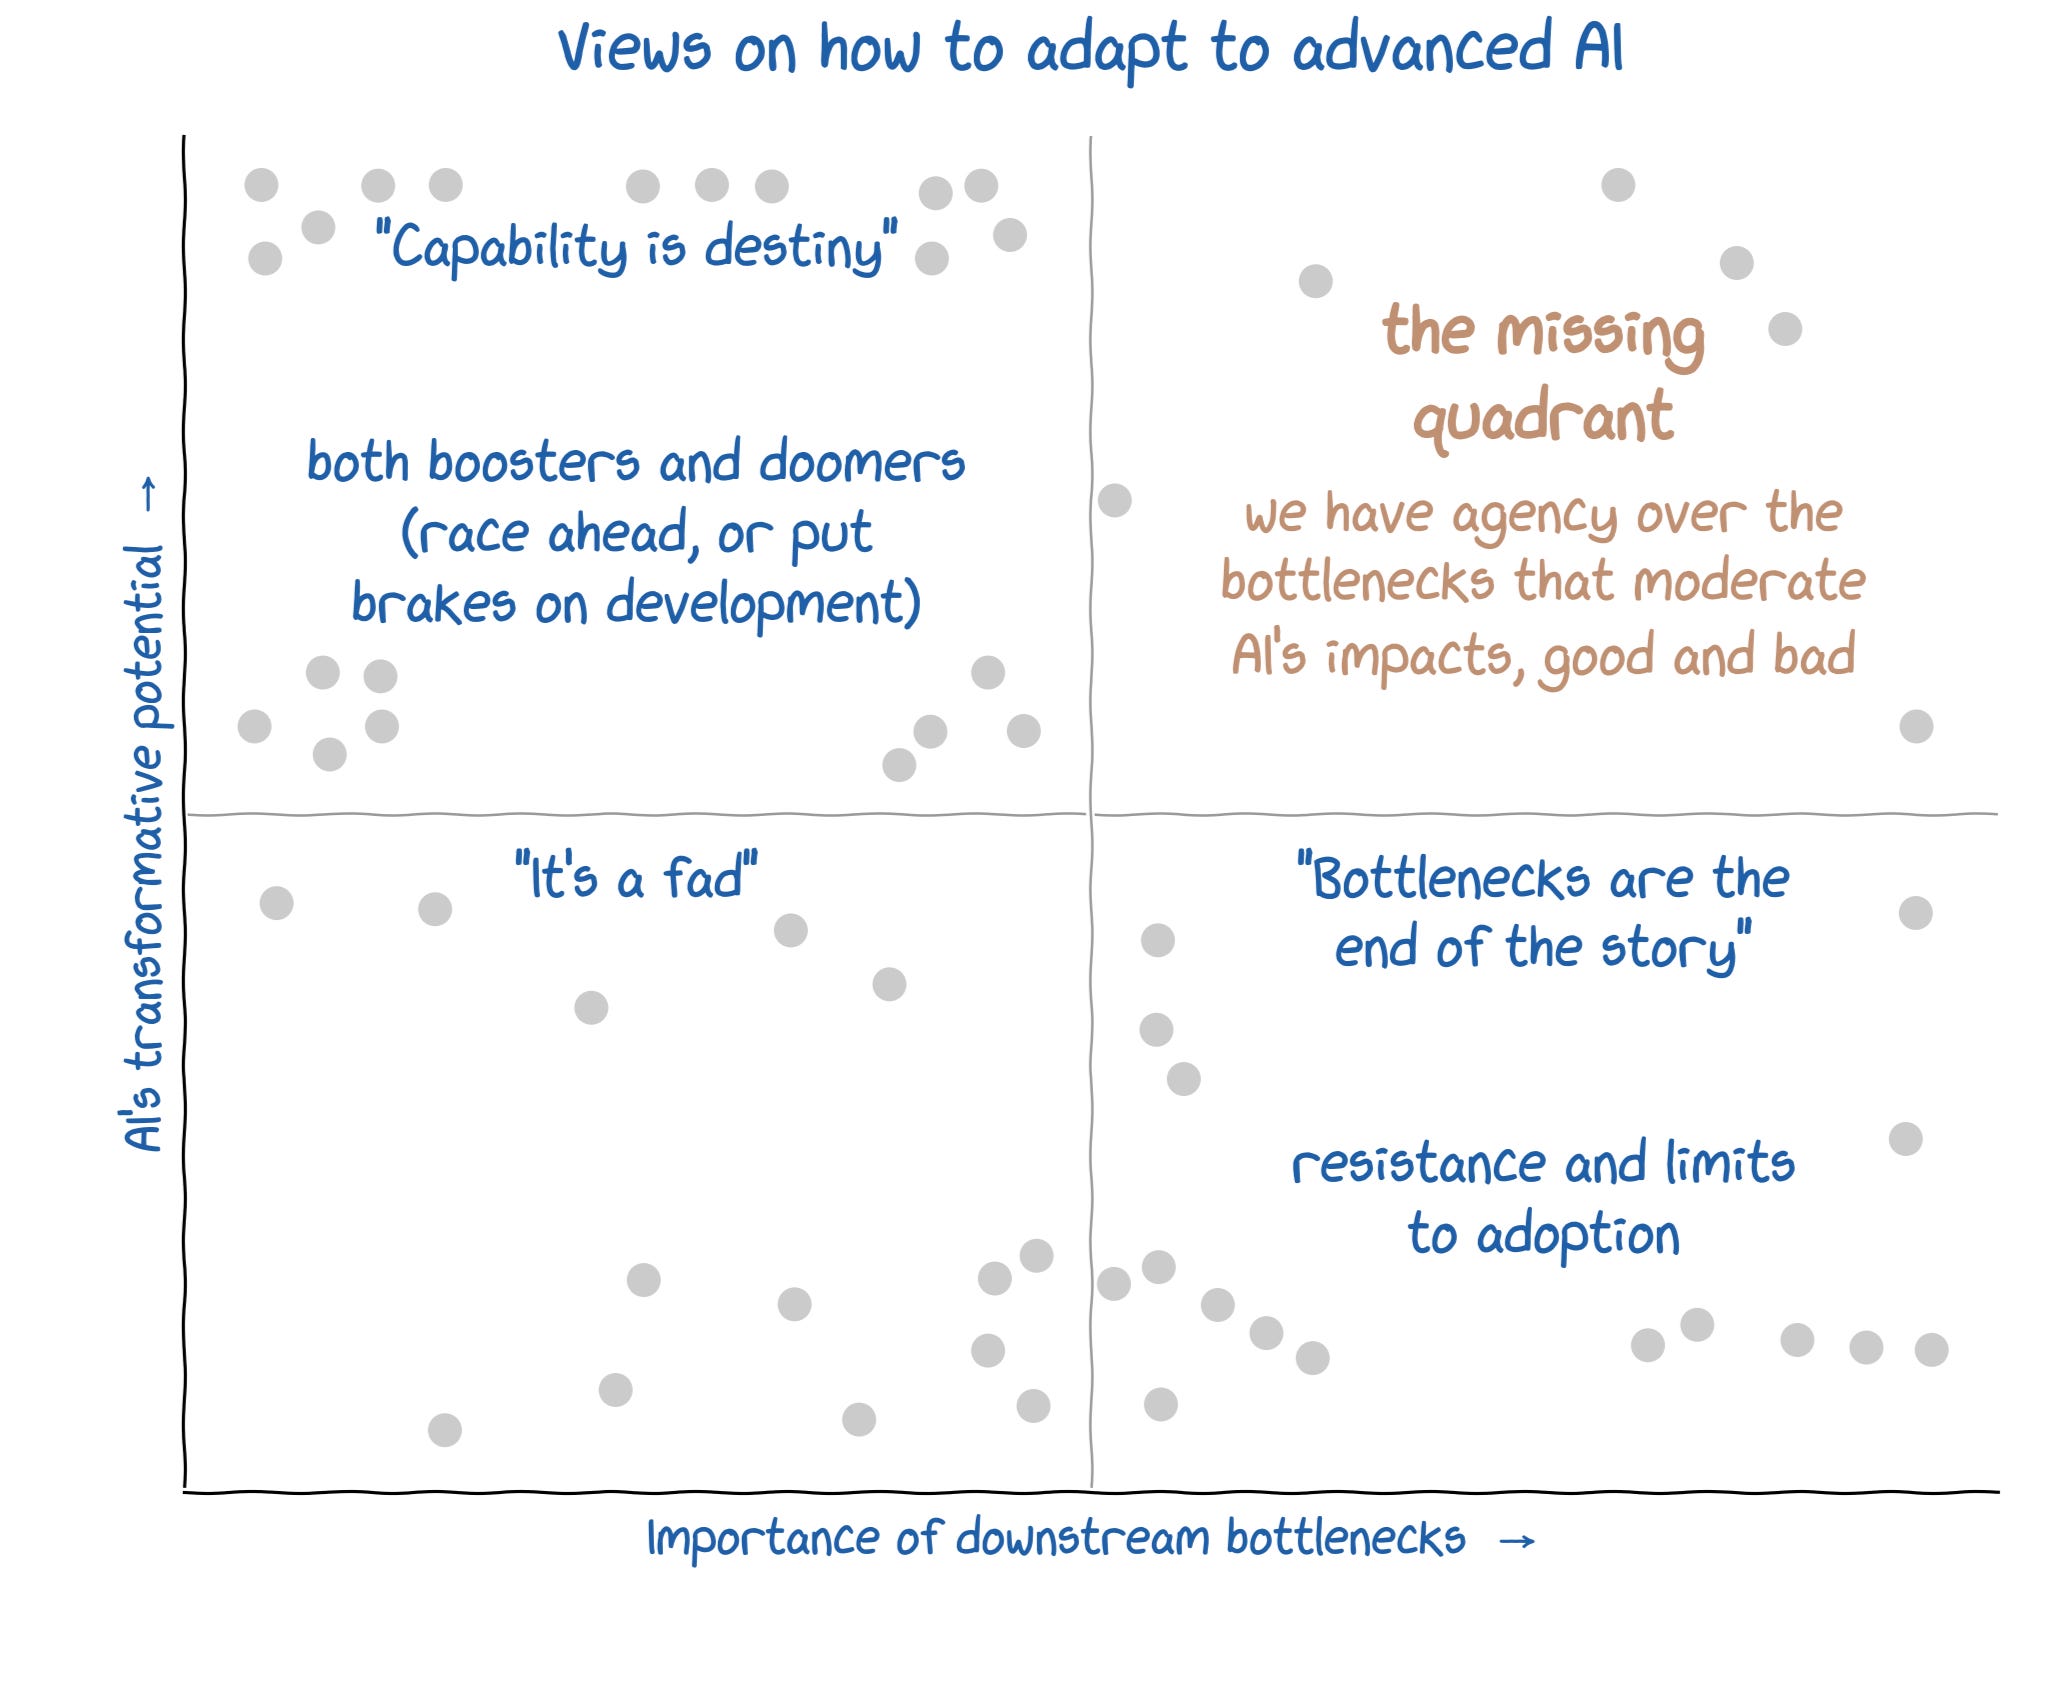
这一观点往往忽视这种转型所面临的组织、监管和社会瓶颈;在这一观点中,此类问题无关紧要,因为超级智能无所不能。令人惊讶的是,一些 AI 行业最强烈的批评者也持有这一世界观,将减缓 AI 能力提升作为保护社会免受 AI 危险的主要方式。
相反的观点位于图表右下角,将现有组织、流程、专业和治理视为固定点,并坚持技术必须被塑造以适应它们。持有这一观点的人通常致力于限制 AI 采用,并保护现有结构免受颠覆。他们擅长识别和利用削弱 AI 影响的瓶颈,如监管、专业规范、组织惯性和政治阻力。
减缓变革步伐可以为塑造技术影响赢得宝贵时间。但当维护现状本身成为目标时,它就会阻碍技术驱动的社会进步。(例如,考虑对自动驾驶汽车的抵制,尽管它们比人类更安全,或对 AI 辅助法律建议的禁令)。
STABL 属于右上象限。我们认真对待前沿 AI 作为一种变革性技术,同时认为制度——无论是新的还是现有的——在帮助社会度过转型中发挥重要作用。
例如,我们应当如何理解和改善 AI 对医学的影响?许多技术决定论者声称超级智能将迅速治愈几乎所有疾病。持相反观点的人可能会回应说,瓶颈不在于药物发现——AI 或许确实能加速这一环节——而在于临床试验,由于监管和安全风险,临床试验需要数年时间。
这一回应正确指出了 AI 影响的瓶颈所在。但这往往被视为讨论的终点。在我们看来,理解 AI 影响的瓶颈只是分析的起点。下一个问题是,能否让药物测试变得更快、更高效,从而切实实现 AI 的益处。例如,计算机模拟测试面临哪些障碍?我们如何重新思考监管机构和流程?遗憾的是,两种极端观点都没有密切关注这些关键问题。
需要明确的是,STABL 并非右上象限中唯一的组织;我们的许多工作建立在其他组织和思想家的基础之上,他们同样认真对待 AI 的潜力及其下游瓶颈。但与其他象限相比,这一象限的思考较为稀疏,这导致认真对待技术或认真对待瓶颈的群体之间出现两极分化。我们的最终目标是为这一象限贡献丰富的思想议程,为新组织创造空间,并与这一象限及其他象限的现有组织合作。
要关注我们的工作,请订阅 STABL 通讯:
我们的研究议程
右上象限引领我们走向许多有趣的研究方向。一方面,我们预计 AI 能力将继续快速提升,这促使我们对进展速度和 RSI 开展实证研究。我们预计能力极强的 AI 模型将继续广泛可用,这促使我们进行分析并倡导风险缓解,而不仅限于对齐 AI 模型和防扩散。
另一方面,我们认为制度对于引导向先进 AI 广泛普及的世界过渡十分重要。这促使我们关注理解先进 AI 应用的下游结果。我们计划衡量具体的益处和危害,研究劳动力市场及其他领域的颠覆,提出增强社会韧性和振兴制度的方法。
这些兴趣引出了四个关键研究方向,我们将在下文详细说明。尽管其他组织也研究过类似问题,但我们预计我们的研究在如何表述这些问题以及如何着手回答它们方面会有所不同,这源于我们的世界观和对 AI 进展的先验判断。
1. 我们应如何衡量迈向递归自我改进的进展?
许多关于 AI 爆炸式进展的预测都建立在递归自我改进(RSI)之上:即 AI 自动化 AI 研究本身。我们认真对待 RSI,正是因为我们的进展模型与大多数 RSI 预测所依据的模型不同,我们希望实证检验关于 RSI 的主张,以便对 AI 的潜在影响获得早期预警。但我们应如何衡量迈向 RSI 的进展?
大多数 RSI 评估衡量的是 AI 完成成功易于验证的任务的能力。在这方面,AI 系统已取得快速进展。但我们认为,AI 在可验证任务和开放式任务上的表现之间正出现日益扩大的鸿沟。
通过 CRUX,我们计划频繁开展开放式评估,以探测 AI 能力在冗长、杂乱任务上的上限,包括 AI 智能体能否开展开放式 AI 研究。我们的首批结果表明,它们目前还做不到;专家评审明确否决了前沿智能体产出的论文。我们计划随着模型和脚手架的改进定期重复这些评估。
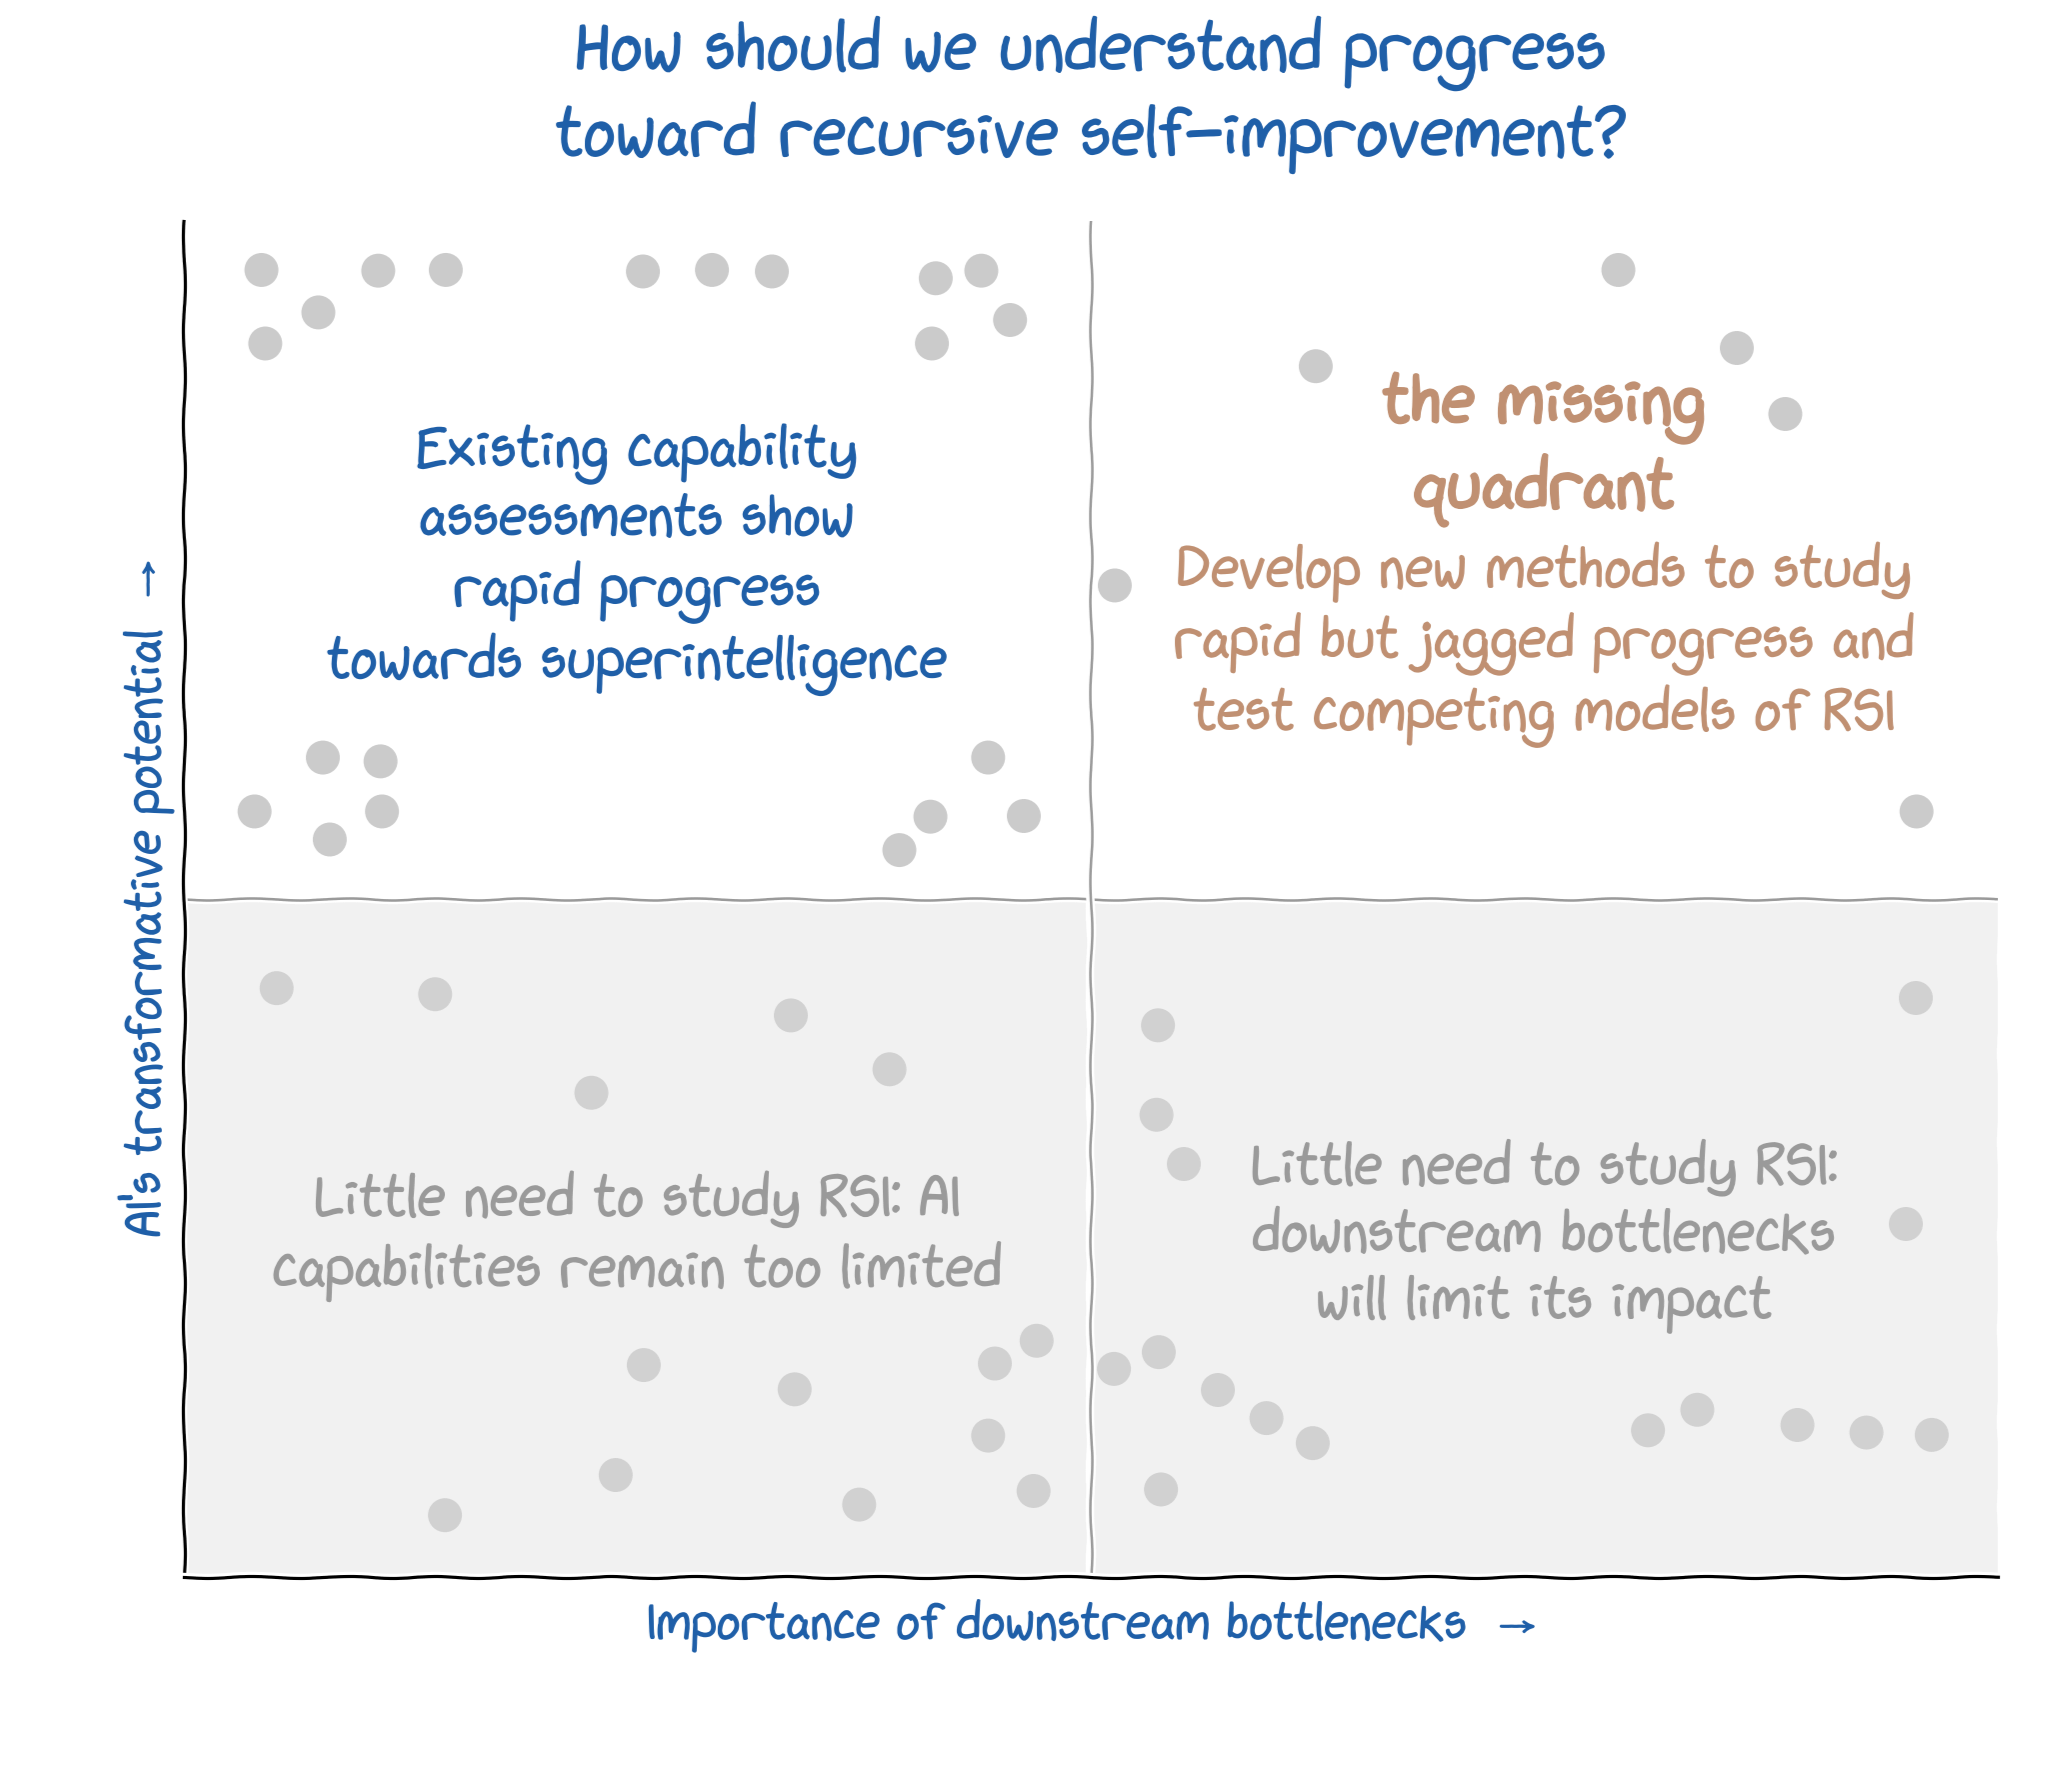
更广泛地说,关于 RSI 的讨论被左上象限的观点所主导。那些最担心超级智能的人,在认识到仔细研究 RSI 的重要性方面走在了前面。但社区和组织也自我选择进入了这项工作,导致缺乏思想多样性。当文献依赖于关于 AI 进展的相同(有争议的)假设时,其结论也容易犯同样的错误。
一个更多元的研究者和组织生态系统,包括那些对 AI 进展持有不同先验信念的人,可以检验这些假设是否成立,例如通过:
比较 AI 进展的因果模型。与其假设一个模型并基于该模型对世界做出预测,不如将不同的因果模型相互对照评估。例如,可验证任务上的表现是否会直接带来现实世界表现的提升?
研究数据瓶颈如何塑造递归改进。AI 在容易收集高质量数据的任务上取得的进展,是否会迁移到不容易收集数据的任务上?理解改进何时能跨领域迁移,有助于区分“RSI 导致广泛超级智能”的假设与“缺乏现实世界数据限制了某些领域进展”的替代解释。
拆解进展的不同维度。大多数 AI 进展的基准测试依赖自动验证,这也使它们更适合强化学习训练。超越自动基准测试可以帮助我们理解不可验证任务上的进展。这种拆解可以帮助我们理解 AI 进展的哪些方面适合递归改进,哪些不适合。
随着 RSI 式动态对于理解 AI 进展的重要性愈发清晰,我们希望出现一个充满活力的思想生态系统,由研究者和组织认真评估 RSI,而不一定将其默认结果视为超级智能。
2. 社会如何防御先进 AI 的风险?
AI 安全历来聚焦于模型本身,而对齐一直是该领域的技术重大挑战。安全社区对开放模型的回应——开放模型中的对齐可以被撤销——是推动防扩散政策。但随着时间的推移,已经清楚的是,先进 AI 将广泛可用,包括对可能想要滥用它的人。因此,我们对 AI 风险的应对需要超越对齐和防扩散。
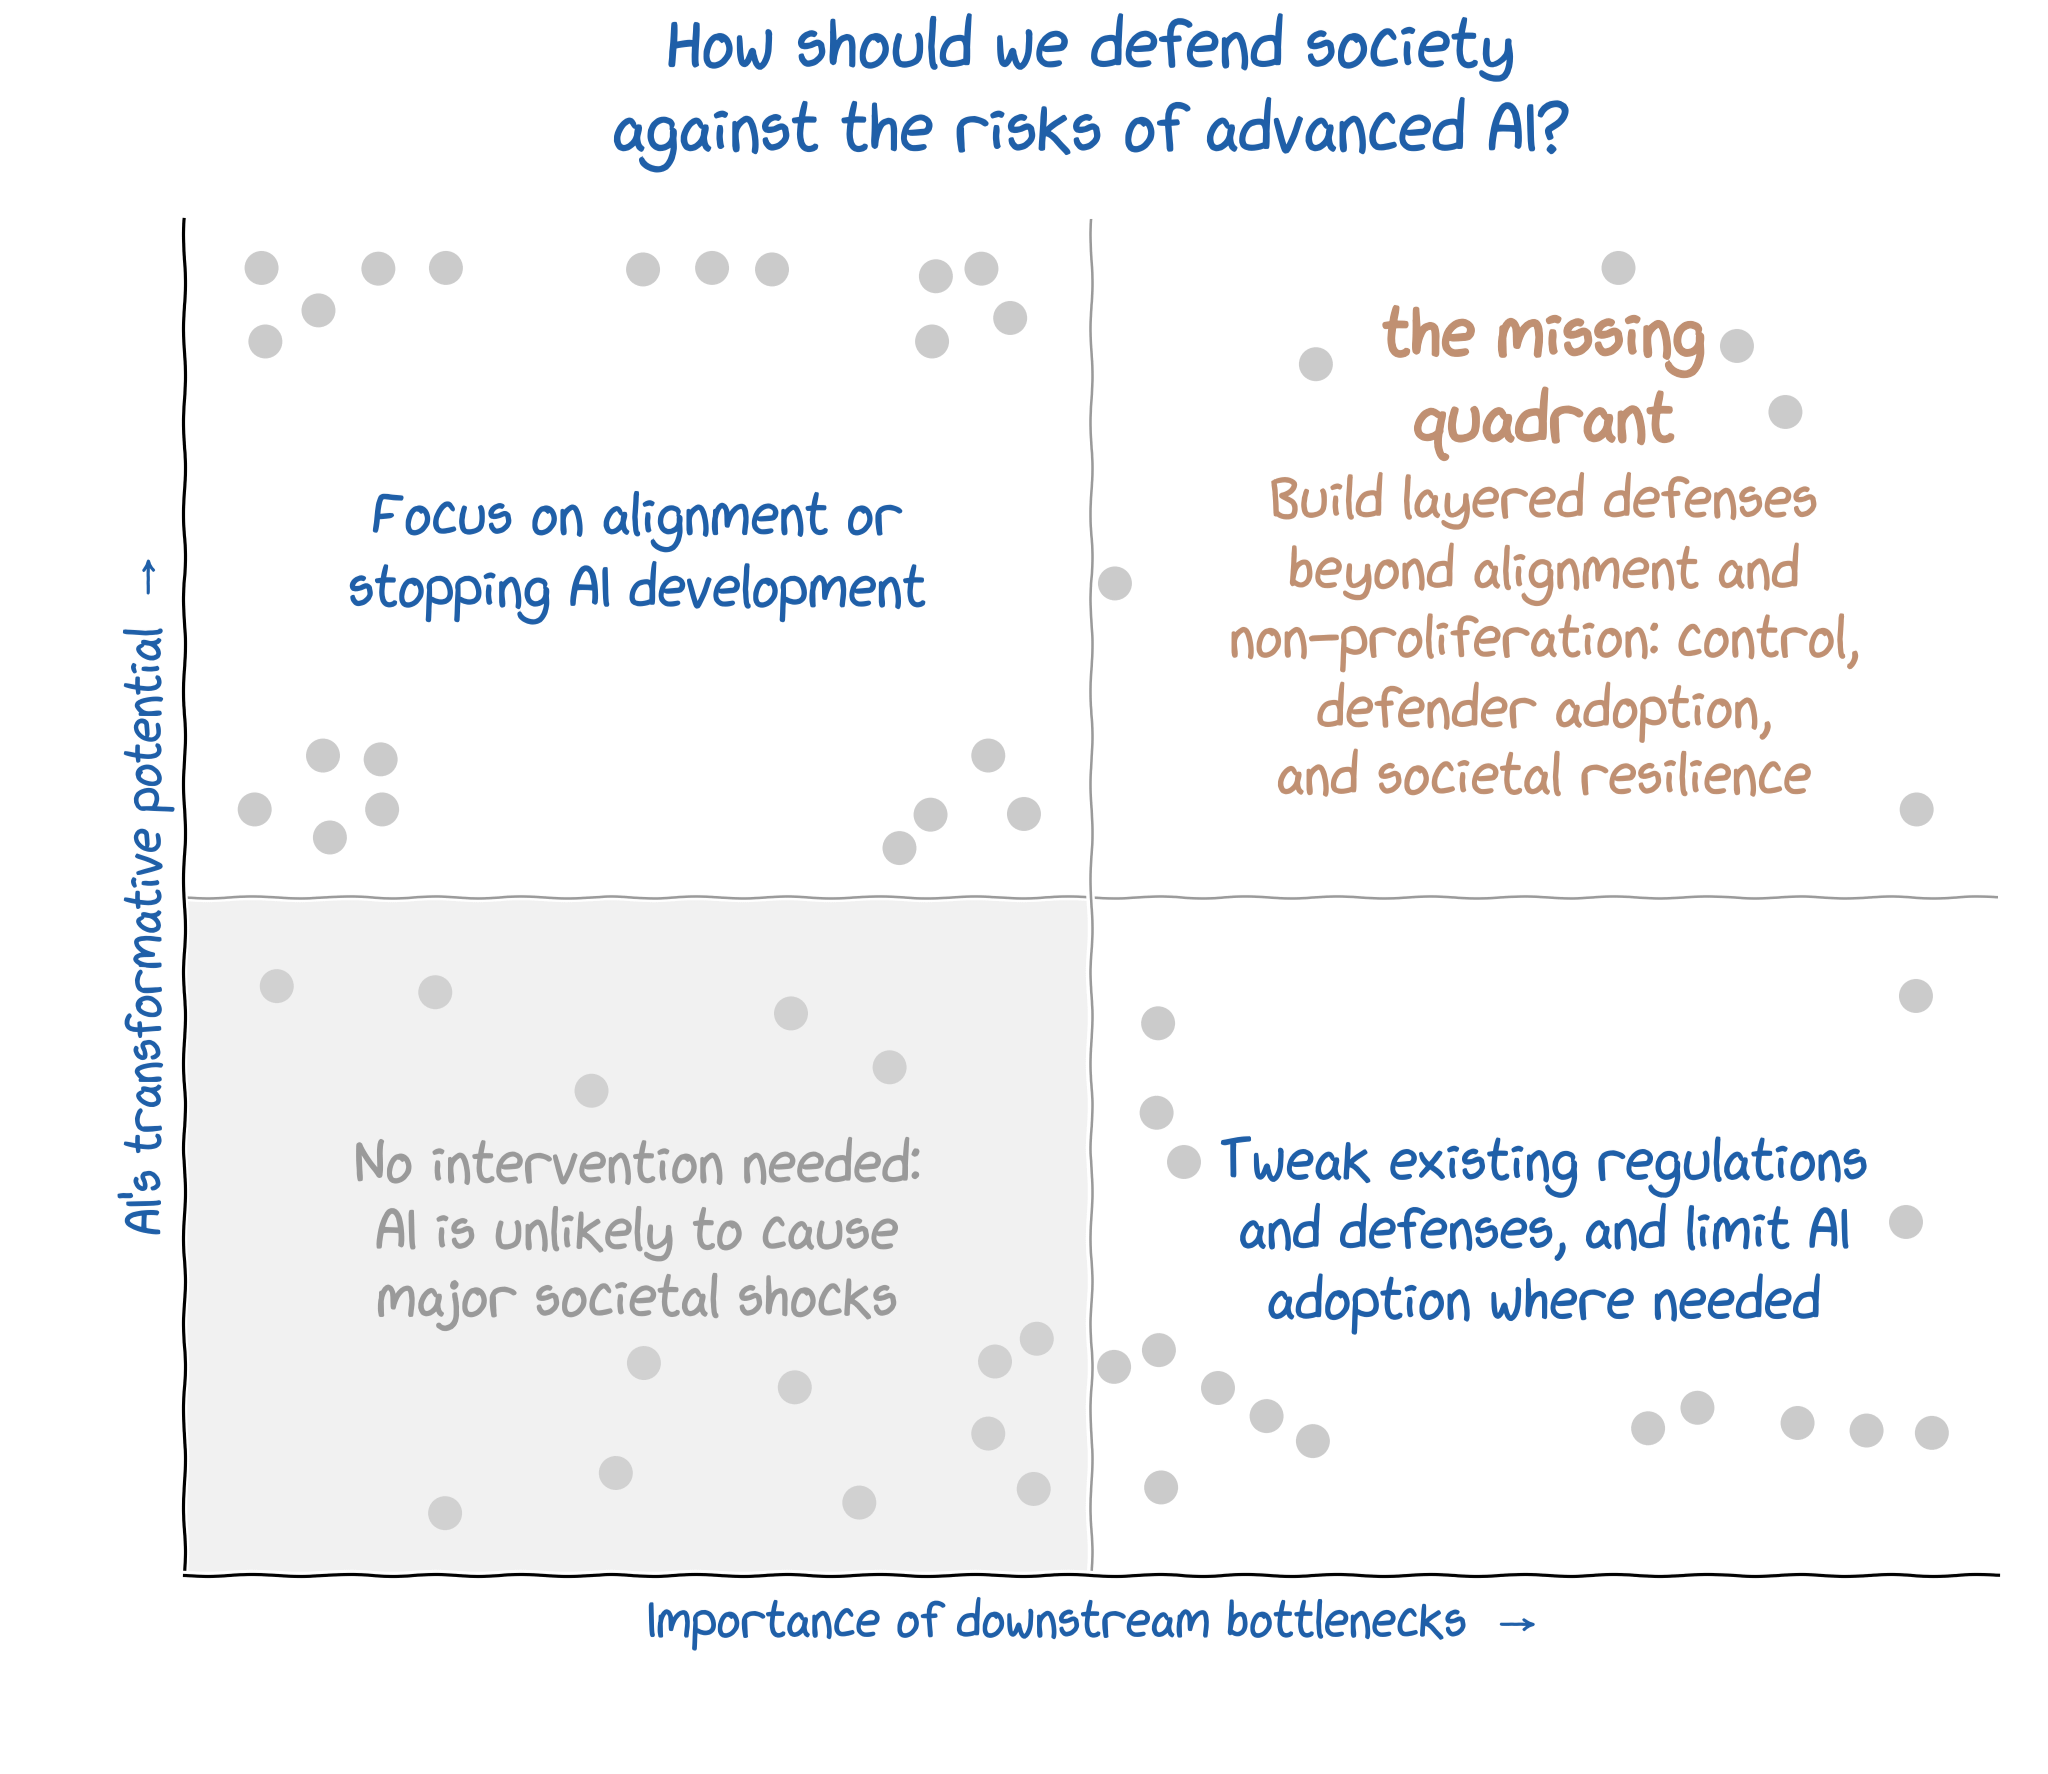
AI 安全将需要三项额外的应对措施。首先,我们需要投资于控制、监控和保护 AI 系统的能力,以便即使在 AI 系统出现对齐偏差时也能防止意外行为。其次,我们需要改进下游防御,例如关键基础设施的网络安全,以保护 AI 危害得以显现的攻击面。第三,我们需要增强社会韧性,以便在我们的防御失效时减轻危害的严重程度。
我们认为韧性是最被忽视的路径。虽然 AI 界原则上强调韧性,但在实践中,主要重点仍然是对齐和防扩散。我们经常听到这样的反应:韧性在理论上听起来不错,但没有人知道它具体意味着什么。STABL 的目标之一将是阐明一项可操作的韧性议程。我们假设,要使韧性有效,它必须具备以下特性:
领域特定:我们不会以通用方式解决韧性。我们必须理解并改善特定行业对特定威胁的韧性。例如,保护一个州的医院系统免受网络攻击的成本是多少?哪些行为者最适合部署这些防御措施?大规模实施网络防御的最可行行动计划是什么?
高雄心:认真尝试韧性(如大流行病防范和大规模网络防御)所需的投资远超我们当前的投资。我们将提出与威胁规模相称的可扩展、雄心勃勃的应对措施。
最坏情况规划:尽管人们对灾难性 AI 风险广泛担忧,但针对特定 AI 灾难场景(直至包括文明崩溃)的响应和恢复计划的工作却很少。提高韧性需要直面潜在的 AI 灾难并制定响应计划。
3. 我们如何引导先进 AI 的经济影响?
尽管先进 AI 已被客户、工人和企业广泛采用,但我们尚未对这种采用的收益或成本有清晰的核算。虽然有大量证据表明工作场所采用了 AI,但该投资的回报尚未体现为广泛的生产率提升。而且,尽管许多人担心即将出现的大规模失业,但美国和其他国家的总体失业率在很大程度上仍保持不变。
这些趋势与我们的观点一致,即主导经济转型的瓶颈在很大程度上超出了能力提升的范围,无法通过 AI 能力评估直接理解。因此,为了更好地理解 AI 的影响,这些瓶颈本身需要专门研究。另一方面,我们认为,通过传统经济指标的视角,AI 已经引发的转型可能被掩盖了。
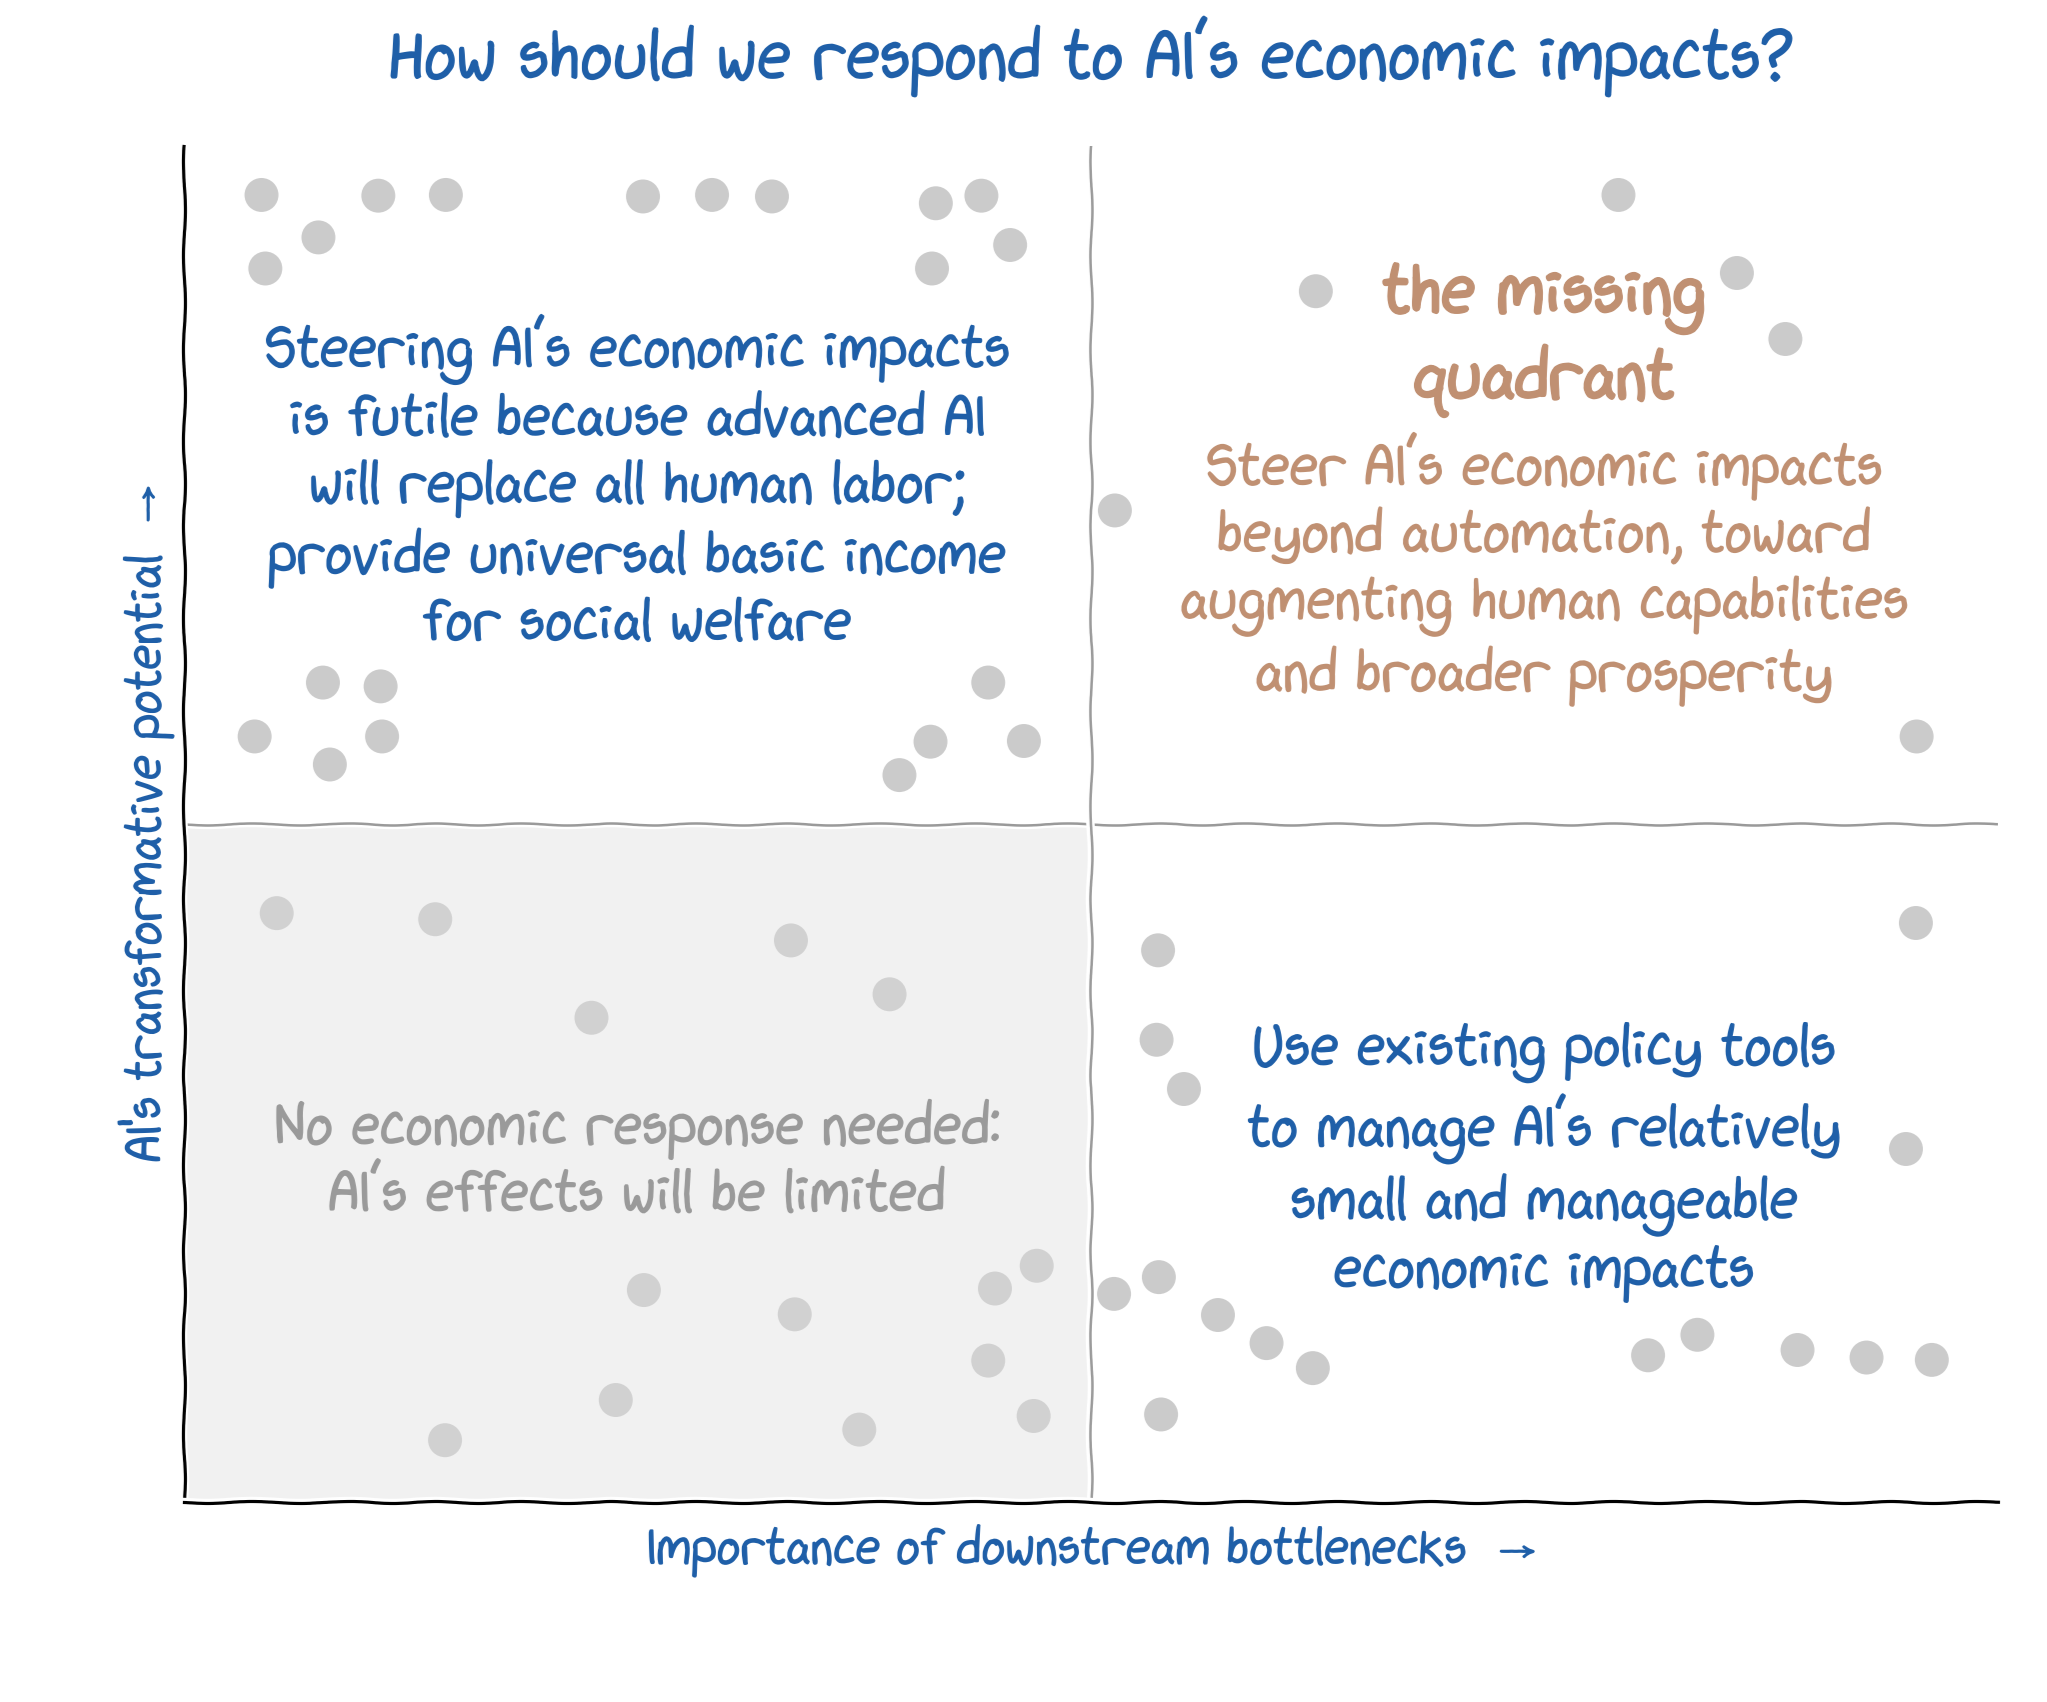
这些观点推动了我们的工作:引导 AI 走向增强,构建改善 AI 与工人关系的原型,以及理解 AI 如何影响工作的本质,而不仅仅是就业统计等总体指标。我们预计该领域的大部分工作将与越来越多关注先进 AI 经济影响的组织合作开展。我们感兴趣的几个方向:
在开发和采用 AI 的公司中,主流做法是试图用相对更便宜的 AI 来自动化昂贵的人力劳动。我们预计这种做法会带来一些进展,就像农业自动化带来了增长一样。但如果没有结构性转型,自动化所能带来的收益是有限的。我们的目标是将关注点从扩大当今经济的规模,转向发现能够带来更广泛繁荣的新想法、新商品和新产业。具体而言,我们希望引导 AI 的开发和部署更多地聚焦于增强(augmentation),我们认为这在经济上更有前景。
增强也尊重人类的贡献和能动性,而自动化则优先考虑企业最大化生产力的目标。为了更直接地顾及劳动者的意愿,我们将为劳动者构建原型,帮助他们更好地驾驭不断演进的 AI 能力,并找到利用 AI 提升工作满意度的方法。
生产率、就业统计等既有经济指标是理解和应对先进 AI 带来的经济冲击的关键输入。但过度依赖这些指标可能会掩盖重要后果。即使由于编程智能体的出现,软件工程师的数量没有太大变化,这一职业也已截然不同。本科生对于应该学什么、毕业后有哪些就业机会的担忧同样值得关注。
最后,我们预计 AI 在工作场所之外的个人使用将产生显著的经济影响,例如人们从 AI 获取税务建议。这可能在为消费者创造盈余的同时减少劳动力需求。
4. 特定职业和行业应如何应对 AI?
能力基准和暴露度指标都无法决定先进 AI 可能如何影响特定工作、行业和机构,以及它们应如何适应。有必要结合具体情境考察不同职业和机构。在近期的工作中,我们深入研究了 AI 对科学、法律服务和软件工程的影响,并计划继续分析其他类型知识工作的持续转型及可能的未来。
我们的目标是制定原则和政策,使知识工作者和民主机构保持掌控,同时实现生产力提升、转变工作流程和过程、消除不必要的准入门槛,并提升国家能力。我们将提出方案,促进现有企业与 AI 赋能的新兴企业之间的健康竞争——是在组织形态层面,而不仅仅是单个组织层面。与此同时,我们认识到在许多情况下,机构中的摩擦是可取的。我们的目标是找到一条中间道路,既欢迎有益的变革,又避免现有结构的彻底取代。
STABL 的下一步是什么?
STABL 正在积极筹款,并在全部四个工作方向上招聘。我们很高兴拥有一个由 AI 社会影响领域顶尖专家组成的顾问委员会:Erik Brynjolfsson、Michael R. Strain、Audrey Tang、Helen Toner 和 Robb Willer,以及一群优秀的研究者和合作者。
与我们三人此前的工作一样,STABL 将产出四类主要成果。
概念性工作与公共写作。关于 AI 的讨论呈现两极分化。我们希望通过概念性工作找出分歧点,并通过实证工作加以解决,从而改善这一状况。我们撰写了一本获奖著作(AI Snake Oil),在《华尔街日报》和《连线》上发表过文章,并运营一份拥有超过 90,000 名读者的通讯。
实证研究。我们计划收集关于 AI 进展及其社会影响的证据。我们通过CRUX项目对 RSI 进行的开放式评估,是最早评估 AI 在开放式 AI 研究任务上进展的工作之一。我们的智能体基准已被领先的 AI 公司采用,而基础模型透明度指数已成为 AI 公司负责任披露的标准。我们的研究成果已被《纽约时报》、《金融时报》、《大西洋月刊》等媒体报道。
证据综合。我们计划综合各领域中 AI 影响的证据。我们关于开放基础模型的工作为理解其社会影响奠定了基础,我们还分析了 AI 对科学、法律和软件工程的影响。
政策指导。我们提供独立专业知识,为 AI 政策提供参考。我们的工作直接影响了美国和欧盟在透明度、第三方评估和开放性方面的 AI 治理。我们为国际 AI 安全报告的两个版本都做出了贡献。我们还帮助定义并实现了基于证据的 AI 政策愿景。
要关注我们的工作,请订阅我们的通讯。我们很想了解右上象限的其他组织。我们知道许多人与我们想法相同,所缺少的是一个系统性的研究计划、一个由组织和运动构建而成的生态系统,以及维持并扩大这项工作的资金。我们希望能在构建这一知识项目的过程中发挥作用。
来源:AI as Normal Technology · normaltech.ai
来源:RadarAI · aihot.news