基于 Amazon Bedrock AgentCore 的可插拔 Agentic AI 框架:七层可组合企业级智能体参考架构
Pluggable Agentic AI Framework: A seven-layer composable enterprise agentic AI reference architecture on Amazon Bedrock AgentCore
AWS 提出 Pluggable Agentic AI Framework,一套运行在 Amazon Bedrock AgentCore 上的七层可组合参考架构,用于把多智能体应用从原型推向生产规模。
“如何在生产环境中大规模运行我们的 AI agent?”这是每位客户最终都会问的问题。它伴随着若干其他问题。我们如何安全且自信地处理数千个并发用户请求?我们如何确保 agent 在真实流量下保持可靠,而不是静默失败?我们如何知道某个 agent 是否仍然符合它在测试期间所通过的质量和安全标准?agent 安全的最佳实践有哪些?这应该是确定性的还是非确定性的?以及更多。概念验证无法回答这些问题中的任何一个,因为它的构建目的是展示 agent 模型能够完成任务,而不是为了承受生产流量、成本压力和安全审查。
一个可用的原型与一个能够大规模可靠、安全、节俭且负责任地运行的系统之间的差距,正是大多数 agentic AI 计划停滞的地方,而这很少是模型的过错。每个构建 agent 的团队都倾向于从头重建相同的脚手架:自己的路由逻辑、自己的护栏、自己的可观测性,所有这些都是在事后应用,而不是从一开始就内置。团队需要一个共享的、生产就绪的架构,每个 agent 都可以在其上构建。
本文介绍了一个七层可组合参考架构,旨在将多 agent AI 应用从原型推向生产规模。
可组合架构
可插拔 Agentic AI 框架是一个面向多 agent 应用的参考架构,组织为七个层,每一层都有明确的职责和稳定的契约。每一层中展示的服务和技术反映的是参考实现,而非强制选择。组织可以替换为与其现有基础设施和要求相一致的替代方案。这些层共同提供了一个蓝图,用于在生产规模上构建、保护和运营 agentic AI 应用。
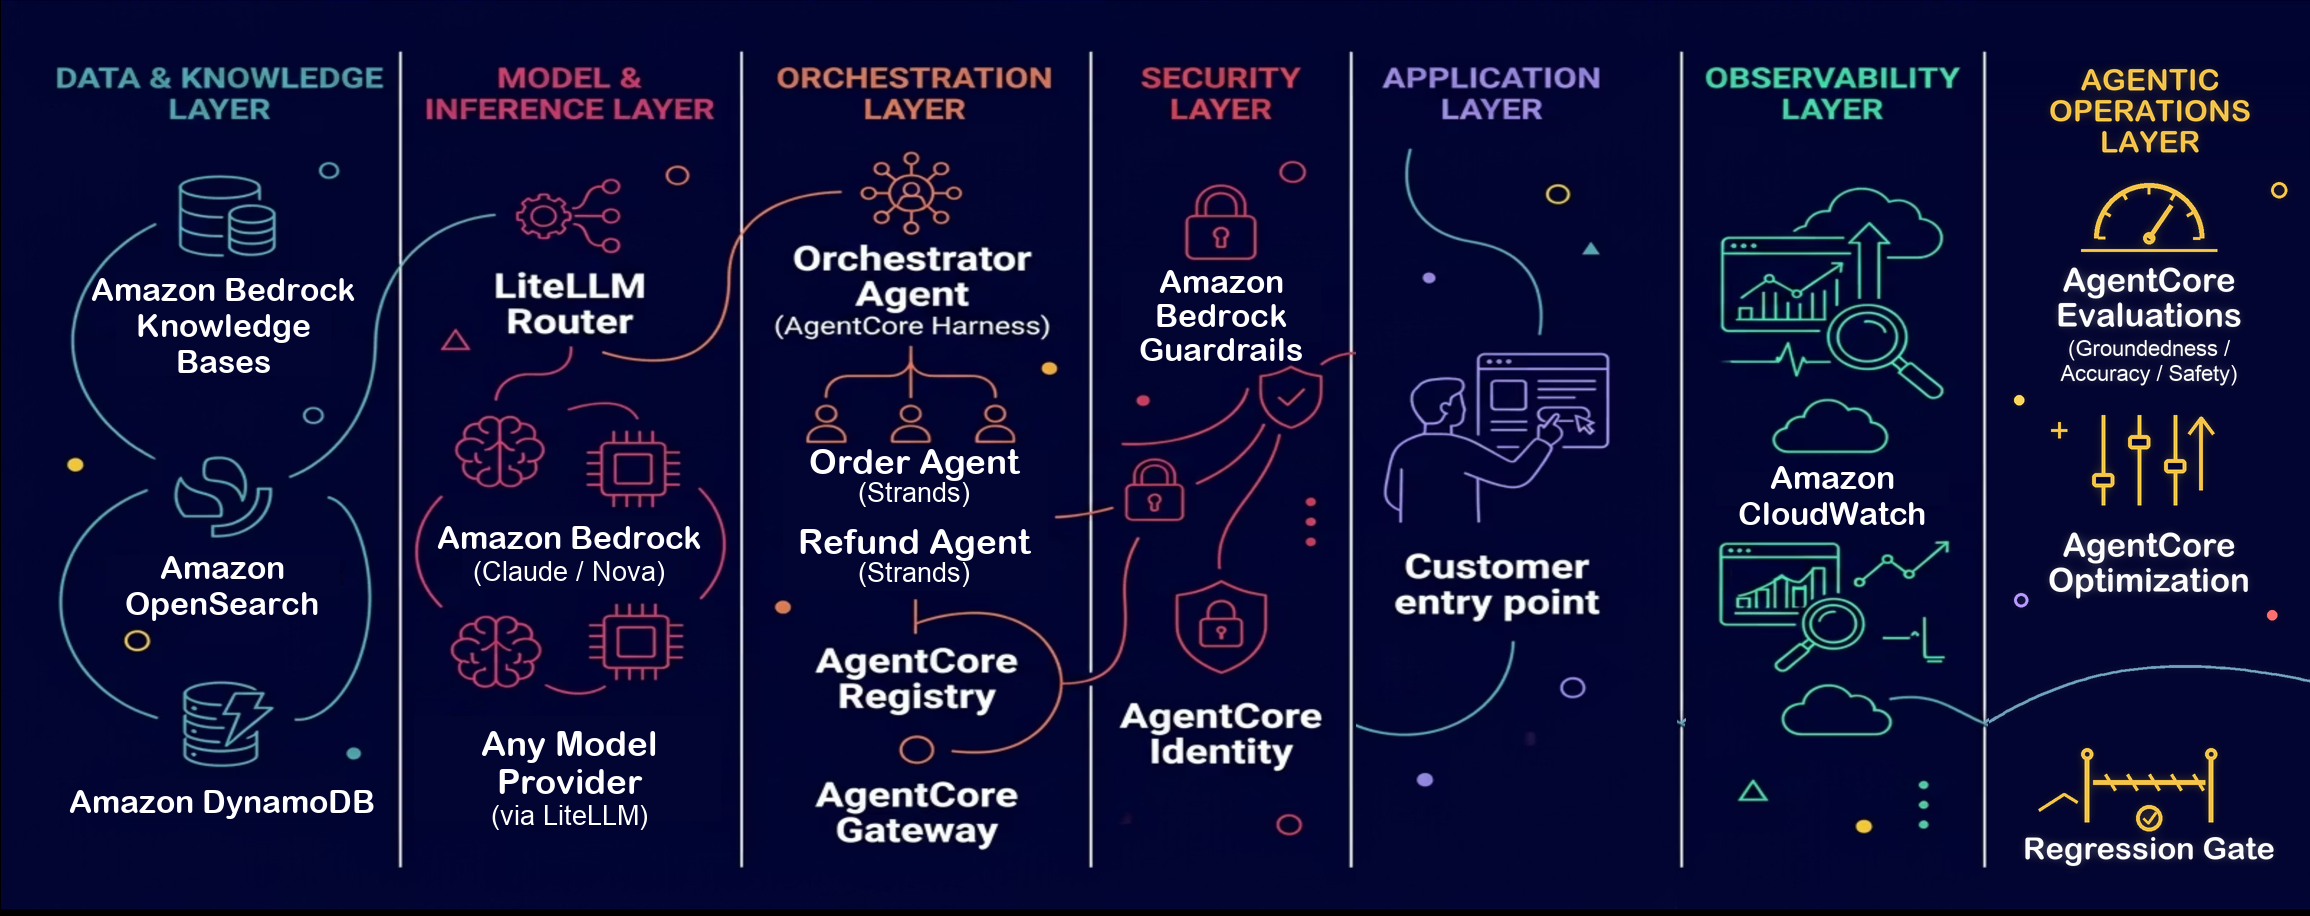
图 1:可插拔 Agentic AI 框架的七个层
数据与知识是 Agentic AI 的基础。agent 的优劣取决于它能够访问的数据。无论 agent 是在检查医疗处方集、跟踪库存,还是解释合规规则,它都需要相关且最新的信息才能正确回答。这一层通过清晰的契约和协议负责检索、嵌入以及对结构化和非结构化数据的访问:接受查询并返回最相关的信息,作为 agent 的上下文。Amazon Bedrock Knowledge Base、Vector Engine for Amazon OpenSearch Serverless、Amazon S3 Vectors 和 Amazon DynamoDB 是这一基础的示例构建块。
模型与推理的选择应由配置驱动,而不是硬编码到 agent 或应用逻辑中。对简单任务使用更小、更快的模型,对需要更细致推理的请求使用更大的模型。重要的是,要使用真实且有代表性的业务数据,针对你正在构建的用例进行彻底的模型评估。模型路由层通过依赖一致的请求-响应契约,使 AI agent 与模型托管环境和特定于提供商的 API 解耦。诸如 LiteLLM 之类的代理提供了跨提供商的通用接口,因此你可以根据评估结果切换模型,而无需重写应用逻辑。
编排决定了工作如何分配,选择正确的方法至关重要。对于简单的任务,使用单个智能体端到端地处理工作。对于复杂的跨领域工作流,使用监督者来委派专家智能体,每个专家智能体都限定于特定能力并绑定到特定工具集。避免构建一个包揽一切的智能体。随着工具、指令和上下文的累积,上下文窗口会增大,延迟会增加,准确性也可能下降。工具泛滥随之出现,这可能将智能体推出其预期边界,导致意外操作和安全漏洞。拆分职责可使每个智能体的上下文保持聚焦,并使延迟更可预测。你还可以独立测试每个智能体的行为、对其进行扩展并定义其安全模型。实施有界自主性:专家智能体应严格在其被授予的工具范围内执行,不得越界。
除了分解为特定专家智能体并设定其边界之外,还要将专家智能体与监督者智能体解耦。允许监督者从集中式智能体注册表中发现专家智能体,并通过标准化协议(如 MCP(Model Context Protocol)和 A2A(Agent to Agent))调用它们。维护一个集中式智能体注册表,编目每个智能体的工具、技能和所有者。这为你的组织提供了大规模治理所需的可见性,通过可复用性提高了 AI 智能体实施的速度,并避免了重复开发的成本。考虑使用 Strands Agents 作为专家智能体,使用 Amazon Bedrock AgentCore harness 作为编排器,使用 AWS Agent Registry 和 Amazon Bedrock AgentCore Gateway 进行集中式发现和路由。
安全与护栏应作为首要关注点,从第一天起就融入设计中。智能体 AI 使组织面临一类传统安全框架无法应对的新型风险,从提示注入和工具滥用到记忆与数据投毒。默认将所有外部内容视为不可信。通过 Amazon Bedrock AgentCore Identity 之类的服务对每个请求进行身份验证,无论请求来自用户、另一个智能体还是自动化工作流。然后使用细粒度访问控制,在执行前确定每次工具调用是否被允许。授予智能体临时的、限定范围的凭证,而不是持久性密钥。在数据保护方面,对智能体和工具请求与响应中的敏感数据(如 PHI(个人健康信息)和 PII(个人可识别信息))进行掩码处理,使敏感客户信息不会出现在智能体输出中或在记忆中残留。为实现问责,将每个重要决策记录在防篡改审计跟踪中,将高影响操作通过人工审批关卡,并部署断路器以在异常行为升级之前将其停止。考虑使用 Amazon Bedrock Guardrails 处理用户输入,使用 Amazon Bedrock AgentCore Identity 和 Policy in Amazon Bedrock AgentCore 进行身份验证和访问控制,并结合 AWS 安全与治理控制来实现纵深防御安全。
应用层是最终用户体验所在之处,无论是聊天界面、API 接口,还是嵌入式小组件。请有意保持这一层轻薄。它唯一的职责应当是呈现对话,并将请求传递给其下方的编排层。要克制住在此处嵌入业务逻辑的冲动。分离得越干净,你就越容易在不破坏后端稳定性的前提下迭代用户体验。可以在这一边界上放置一个决策模型,作为快速、低成本的检查:在一次调用中,它评估某个请求是否在范围内、是否需要人工介入、是否紧急,并返回概率而非自由文本。你的代码用简单的阈值对这些分数采取行动,直接回答离题请求并标记升级事项,因此完整的智能体循环只在能带来价值时才运行。在构建应用层时,请思考另一个 AI 智能体需要什么才能与你的 AI 智能体以及人类一起消费和交互。据此构建你的外部接口。
可观测性应当从第一天起就监控每一层,而不是等到第一次事故之后。除了日志和指标之外,端到端的智能体追踪对于衡量智能体是否正确执行任务至关重要。除了追踪之外,还要收集每次请求的成本和 token 用量、首 token 时间、调用是否安全,并在上线前提供延迟、错误率和支出的仪表盘。主动监控比被动救火成本更低。可以考虑将 Amazon CloudWatch 与 OpenTelemetry 结合使用,并配合 Amazon CloudWatch Omni 进行追踪和指标采集,从而在整个技术栈中获得全面的可见性。
智能体运维通过持续评估形成闭环,因此要从第一天起就建立起来。对每个生产会话在事实依据、准确性和安全性方面进行评分,并设置回归门禁,在质量下降到达客户之前将其拦截。没有它,你只知道智能体在上线时能正常工作。有了它,你就能证明它在之后每次发布后仍然正常工作。可以考虑使用 Amazon Bedrock AgentCore Evaluations 进行评分,并使用 Amazon Bedrock AgentCore optimization 进行持续性能调优。
零售客户支持智能体的参考实现
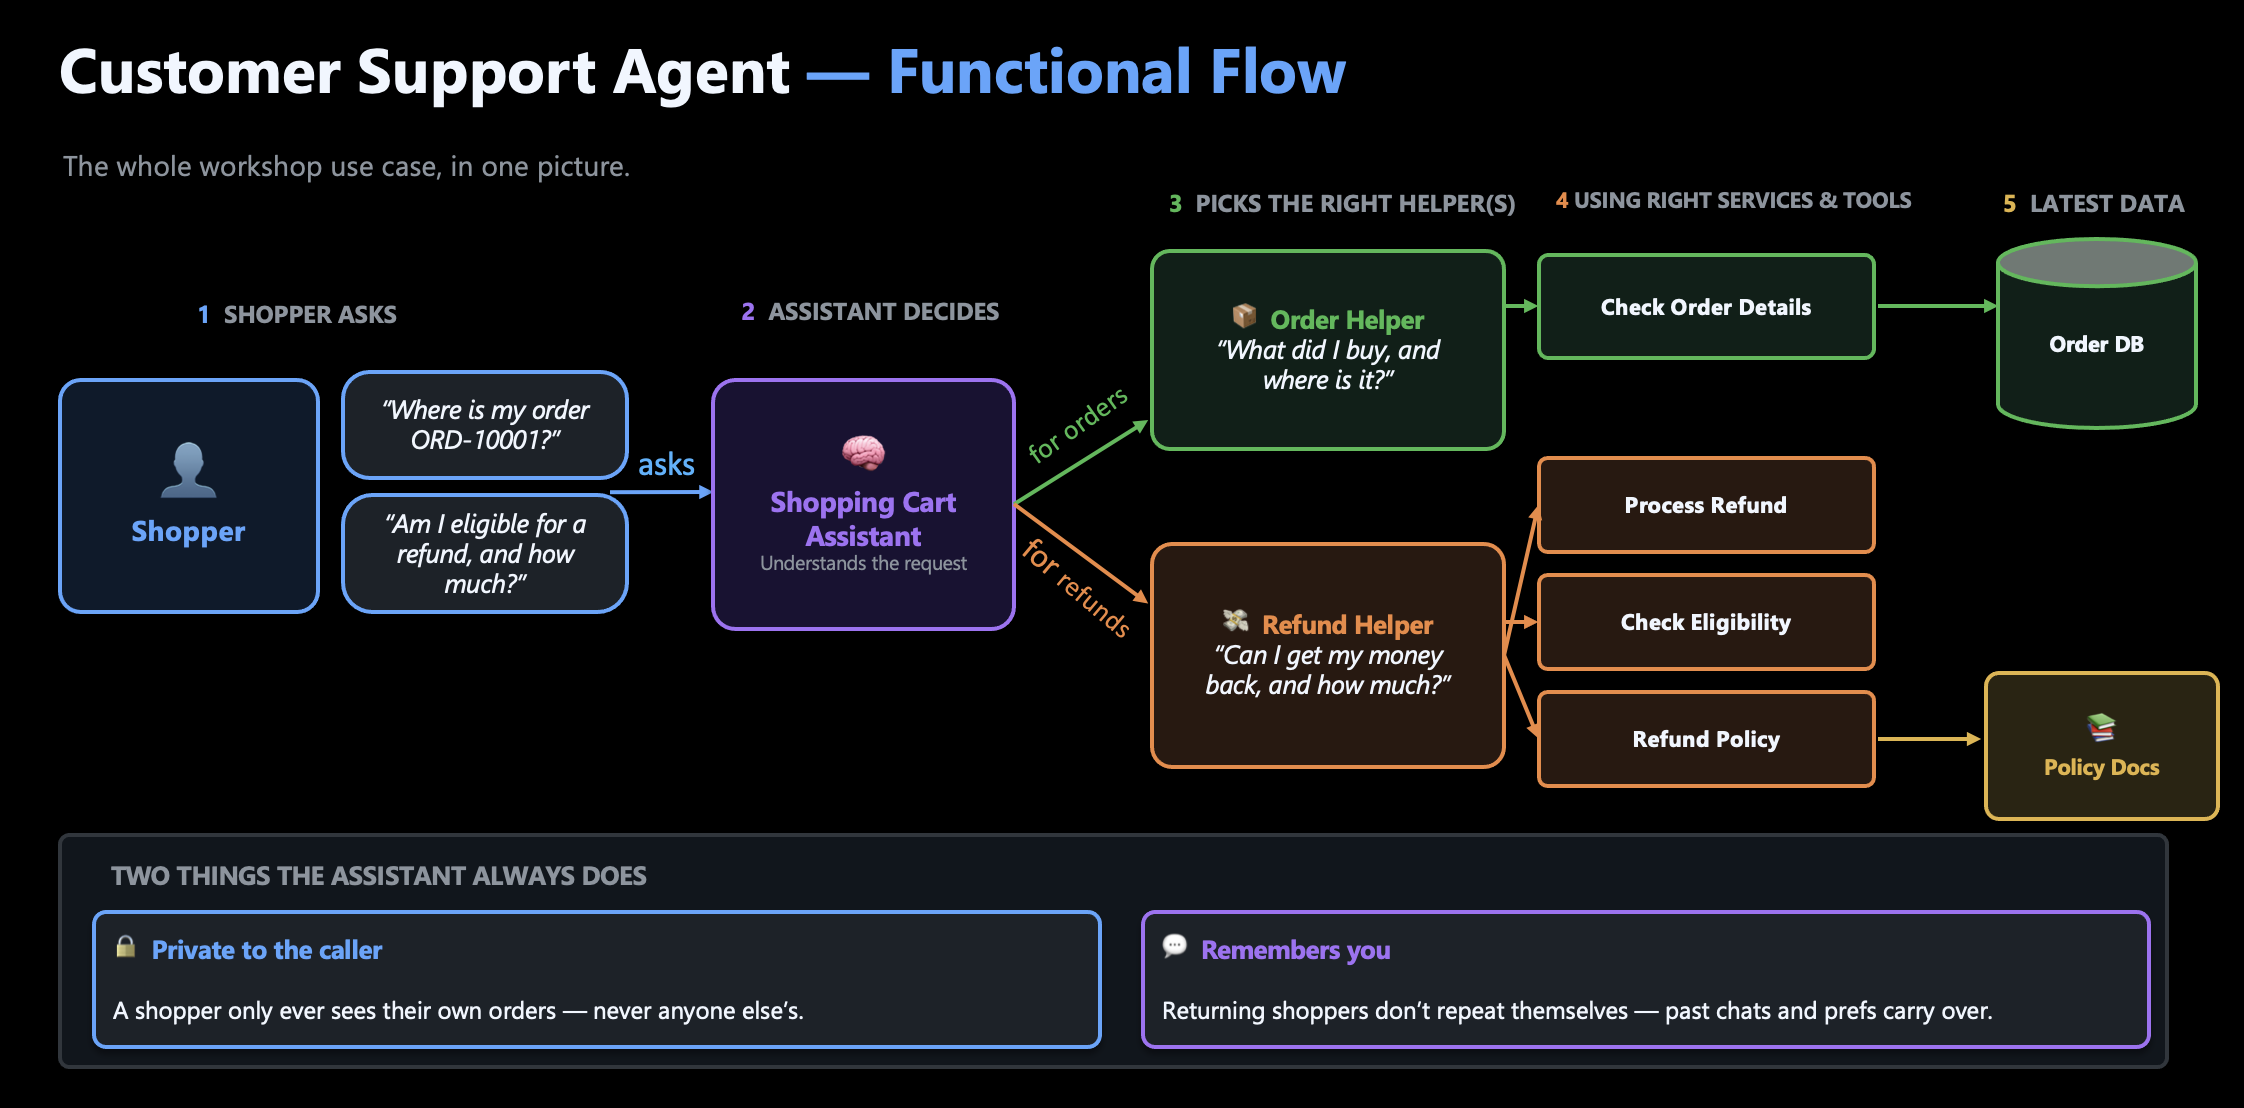
图 2:零售客户支持参考实现的功能流程
为了让架构落地,该框架包含一个可直接运行的参考实现,基于涵盖订单状态和退款资格的零售客户支持场景。我们选择这个用例,是因为它覆盖了技术栈的每一层,同时又足够直观,便于团队理解和适配自身需求。
主管智能体接收客户的退款请求,并将其委派给订单智能体和退款智能体,二者都是拥有限定工具集的专家。订单智能体从 Amazon DynamoDB 查询配送和购买详情。退款智能体从知识库中检索基于层级的政策规则,并使用配送日期、当前日期和客户的忠诚度层级计算资格。这些调用中的每一次都经过 AgentCore Gateway,它在工具执行前通过 Policy in AgentCore 强制执行细粒度访问控制,并且每一次调用都通过可观测性层进行端到端追踪,因此当计算出现错误时,追踪能准确显示是哪个层、哪个决策点导致的。
任何构建类似“监督者—专家”模式的人,都可以克隆参考实现,并逐层替换为自己的领域逻辑。
为什么可插拔性与各层本身同样重要
七层架构的价值不仅在于它如何划分职责,还在于每一层能够多快地演进。可插拔性让这一点成为可能。层边界上的稳定契约——从身份校验和访问策略到遥测接口——让你能够更换底层技术,而无需重新设计技术栈的其余部分。本质上,构建智能体 AI 系统要采用架构优先的方法,而不是技术驱动的方法。
该框架通过在各层与第三方提供商集成来践行这一点,从而展示可插拔性:推理层的模型与托管提供商、编排层的搜索能力、应用层的决策 API、安全层的护栏,以及可观测层的智能体追踪与监控方案,同时还包括业务价值与成本追踪。它在每一层都支持行业标准提供商,因此你可以组合出满足自身具体需求的解决方案。
对企业而言,灵活性可以保护既有投资。团队可以保留他们已经信任的可观测性、安全性和推理工具,在需要的地方填补空白,并逐步采用新能力。该架构提供了一致的基础,而不要求每一项技术决策都来自同一家供应商。
结论
一个可运行的原型证明了智能体能做什么。而一个设计良好的架构决定了你的企业能否依赖它。迈向 AI 运营意味着从第一天起就把安全性、治理、可见性、成本控制、可靠性和适应性设计进去,而不是在系统建成之后再补上。
可插拔智能体 AI 框架将这些关切纳入一个架构,其原则清晰明确:构建稳定的基础,同时不把每一项技术选择都锁死。模型会变。工具会演进。业务需求会变化。你的架构应当让这些变化可控,而不是让每一次变化都变成一次重建。
把这个原则付诸实践。从 Workshop Studio 体验开始,探索公开示例仓库,并以这个动手实现作为你自己架构的起点。它不能替代生产环境的安全加固、测试和审查。
构建你今天所需的能力,以及你明天将需要的灵活性。
关于作者

Sindhura Palakodety
Sindhura 是 Amazon Web Services (AWS) 的高级解决方案架构师,也是 ISV 生成式 AI 的单线程负责人(STL),致力于帮助客户开发企业级、架构良好的解决方案。她专注于生成式 AI 和数据分析领域,帮助组织利用创新技术实现变革性业务成果。

Sujatha Kuppuraju
Sujatha 是 AWS 的首席解决方案架构师,专注于云和智能体 AI 解决方案。她与软件公司高管合作,在 AWS 上设计安全、可扩展的产品,并指导战略性产品开发。

Mythili Annamalai Sekar
Mythili 是 Amazon Web Services (AWS) 的解决方案架构师,负责与独立软件供应商 (ISV) 合作,指导客户基于 AWS 最佳实践设计安全的企业级架构。她的工作聚焦于无服务器和生成式 AI,帮助软件公司将新的云能力转化为切实可落地、可用于生产环境的业务成果。

Madhu Samhitha Vangara
Madhu 是 AWS 的全球生成式 AI 专家解决方案架构师,专注于 Amazon Bedrock AgentCore 和 Strands Agents 的 Agentic AI 技术 GTM。她拥有丰富的企业经验,善于将新兴 AI 能力转化为可衡量的客户成果。Madhu 是 AI 会议的演讲嘉宾,专长于生产级 Agentic AI。
来源:AWS Machine Learning Blog · aws.amazon.com