MoEngage 如何用 AgentCore Gateway 将 400 多个 API 变成智能体工具
How MoEngage turned over 400 APIs into agent tools with AgentCore Gateway
MoEngage 借助 Amazon Bedrock AgentCore 的 AgentCore Gateway,把 25 个工程团队在 7 个 AWS Region 私有 VPC 中维护的约 400 个内部 REST API 转成权限受控的智能体工具,节省约 6 个月平台工程投入,新 API 接入从数天缩短到数小时。
本文由 MoEngage 的 Nikhil Kumar 和 Shakir Khan 共同撰写。
当工程团队开始构建 AI 智能体时,这些智能体所需的能力通常已经以内部 API 的形式存在。活动创建、分群查询、投递统计。挑战不在于构建新功能。挑战在于让数百个私有 API 能够被智能体安全访问,同时不将它们暴露在公共互联网上,不让模型控制身份,也不让数百个工具定义淹没上下文窗口。
MoEngage 是一个智能体客户互动平台,超过 1,350 个消费品牌使用它通过推送、电子邮件、应用内消息、短信、WhatsApp 和 RCS 提供个性化体验,它正面临着这个问题。产品背后运行着约 400 个内部 REST API,由 25 个工程团队构建,运行在横跨七个 AWS 区域的私有虚拟私有云(VPC)中。MoEngage 按区域隔离这些 API,以履行数据驻留承诺,并且不将它们暴露在公共互联网上。智能体所需的能力已经在生产环境中运行。安全地使其可访问,才是困难的部分。
在本文中,我们将介绍 MoEngage 如何使用 AgentCore Gateway(Amazon Bedrock AgentCore 的一项能力)将这些私有 API 转变为权限范围受限的智能体工具。该方法为 MoEngage 节省了估计六个月的平台工程工作,现在接入一个新 API 只需数小时而非数天。没有产品团队编写 Model Context Protocol(MCP)服务器代码,没有为每个集成配置网络,路径中任何地方都不存在公共端点。
为什么 20 个 MCP 服务器是错误的答案
Model Context Protocol(MCP)为智能体提供了一种发现和调用工具的标准方式。采用它的直接路径是让每个团队暴露自己的 MCP 服务器。MoEngage 对此进行了成本核算并否决了它。
超过 20 个 MCP 服务器意味着超过 20 个部署需要监控、修补,并在 MCP 演进时保持协议兼容。跨域智能体——那些读取活动、检查其分群并查看投递统计的有用智能体——需要连接多个服务器并进行协调。而且每个团队都需要与其实际产品工作无关的 MCP 专业知识。
因此,MoEngage 确立了塑造后续一切的原则:各个工程团队不实现 MCP。团队构建 REST API 并声明哪些操作应作为工具。AI 平台团队端到端拥有 MCP 层。团队的责任止于一份描述良好的 OpenAPI 规范。
这一原则立即产生了三项要求:一个智能体只需连接一次的中央工具界面,而非按服务连接;按智能体授权在服务器端强制执行,而非依赖约定;以及无需为每个新 API 重建的私有连接。
从零开始构建所有这些都是一个选项。自定义中央 MCP 服务器可以解决 20 个服务器的问题,但会让 MoEngage 需要构建工具生成流水线、策略文件格式、用于重命名的工具别名注册表以及断路器。所有自定义代码,全部由一个团队拥有,全都是无差异的工作,不会让 MoEngage 的智能体更智能,也不会让客户的营销活动更好。
塑造架构的四个约束
在评估任何解决方案之前,MoEngage 定义了四个约束。所有四个约束必须同时满足。一个解决了两个但破坏了第三和第四个的解决方案是不可行的。
没有任何服务会获得公共端点。MoEngage 的内部 API 按策略仅限 VPC 私有访问。任何需要将它们暴露出去的方案,哪怕再加一层认证,都不可接受。常规的变通做法是按集成逐个处理网络:这里一个 NAT 网关,那里一个反向代理,第三个再来一条 VPN 隧道。再乘以七个区域,运维面增长的速度比智能体集合还快。每新增一个 API,就意味着又一次网络变更申请、又一轮安全评审、又一份需要维护的基础设施。
身份不能由智能体来决定。每一次内部 API 调用都携带租户、用户、角色和数据库上下文。如果这个上下文成为大语言模型(LLM)可见的工具参数,模型就可能弄错,或者被诱导去修改它。MoEngage 需要让身份在结构上处于模型触及不到的范围,由调用方服务注入,而不是作为模型可以设置或覆盖的东西暴露出来。
400 个工具的目录塞不进上下文窗口。按每个工具约 50 个 token 的 JSON schema 计算,整个资产范围内完整的 tools/list 在每次连接时都要传输超过 20,000 个 token。这笔 token 预算在智能体做任何有用的事之前就花掉了,还挤占了智能体真正用于推理任务所需的上下文。客户端过滤(ADK 或 MCP SDK 中的 tool_filter)解决不了这个问题。完整目录早已通过网络传输过去,而按客户端约定过滤并不构成授权边界。一个本不该看到写操作的智能体,一开始就不应该收到它们。
最后这条约束正是让那些显而易见的替代方案出局的原因。自建的中央 MCP 服务器解决了 20 个服务器的问题,但仍然要 MoEngage 去构建工具生成流水线、策略文件格式、用于重命名的工具别名注册表以及熔断器。全是自定义代码,全由一个团队维护,没有一样能让 MoEngage 的产品变得更好。
AgentCore Gateway 如何对应这些约束
Amazon Bedrock AgentCore Gateway 是一个全托管的 MCP 服务器。你把 OpenAPI 规范注册为目标,网关据此生成 MCP 工具,然后把调用路由到后端服务。有四个特性直接对应 MoEngage 的约束。
输入 OpenAPI,输出 MCP 工具。无需构建或运维 MCP 服务器,也没有需要与 API 保持同步的独立产物。各团队已经在维护的规范就是工具定义。每个操作都会变成一个名为 Target___operationId 的工具,例如 CampaignsAPI___searchCampaigns。规范变了,工具就变。团队新增一个端点,工具就出现。团队删除一个端点,工具就消失。无需部署,无需协议专业知识,也无需与 AI 平台团队协调。
Cedar 策略在目录序列化之前完成评估。AgentCore 策略引擎使用部分求值,按主体过滤 tools/list。每个智能体以自己的 IAM 角色进行身份验证,其 Cedar 策略决定它能看见和调用哪些工具。这正是 400 个工具变得可管理的原因。它不是事后的客户端过滤,而是在构建响应之前完成的服务端范围限定。
例如,一个营销活动 QA 机器人获得对营销活动和分群工具的读取权限,但不能调用写操作:
permit(
    principal == Agent::"campaign-qa-bot-v1",
    action == Action::"tools/call",
    resource in ToolGroup::"campaigns-read"
);

forbid(
    principal == Agent::"campaign-qa-bot-v1",
    action == Action::"tools/call",
    resource in ToolGroup::"write-actions"
);
该机器人在其 tools/list 响应中看不到写工具。客户端没有任何需要过滤的东西,因为这些工具根本没有被发送。
通过 Amazon VPC Lattice 实现托管出口。网关通过 AgentCore 托管出口访问 MoEngage 的内部服务,而不是通过 MoEngage 自行构建和运营的网络。在入站方向,网关只能通过带有私有 DNS 的 VPC 接口端点访问。不存在通往它的公网路径。接入新 API 只需添加一个目标,而无需更改网络拓扑。正是这一特性解决了乘以七个区域的问题。网络只存在一次,每个 API 都使用它。
语义搜索作为网关能力。借助 x_amz_bedrock_agentcore_search 能力,智能体可以通过描述任务来查找工具,而无需指定工具名称。这消除了对自定义发现层的需求。它还顺带消除了重命名带来的脆弱性:如果 get_segment_user_count 变为 get_segment_size,搜索分群用户数的智能体仍然能找到它,因为匹配基于描述而非标识符。
实践中的架构
从智能体到内部 API 的请求流程很短,每一层都有明确的职责。智能体服务通过 VPC 接口端点连接到 AgentCore Gateway,后者评估 Cedar 策略,并通过 Amazon VPC Lattice 上的托管出口将工具调用路由到内部 API。
下图展示了各组件之间的连接方式。
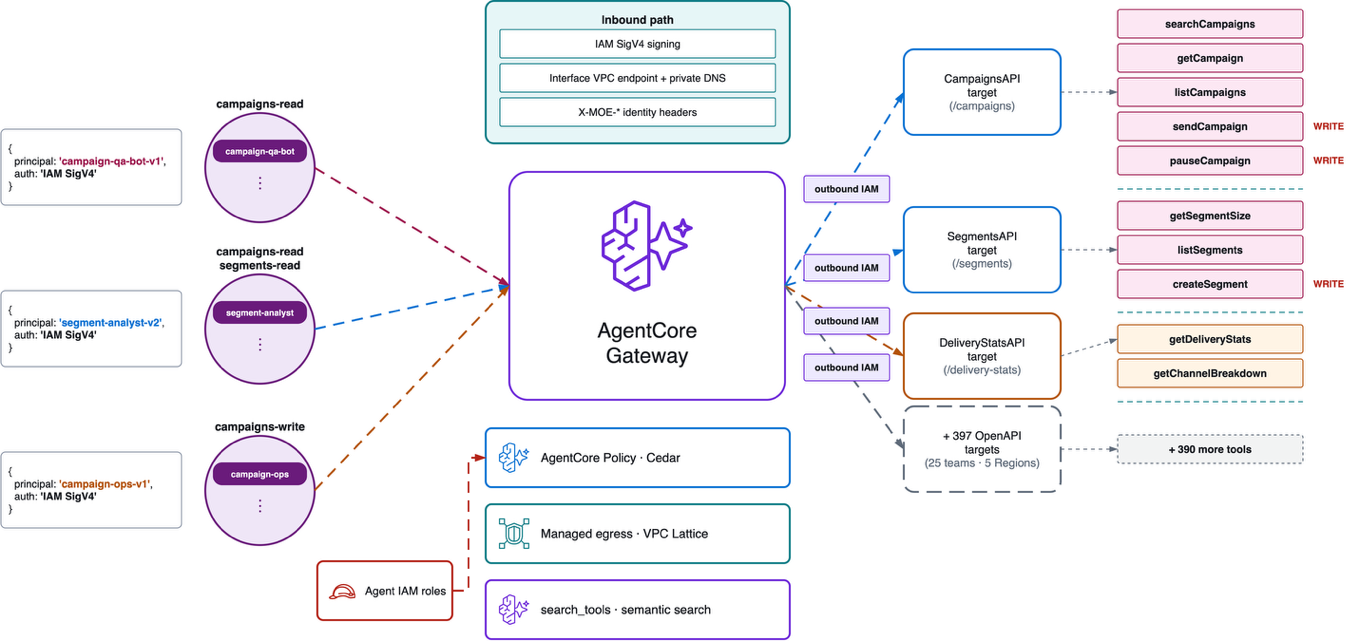
图 1:MoEngage AgentCore Gateway 架构
运行在 Amazon Elastic Compute Cloud(Amazon EC2)上或容器中的智能体服务调用 MCP 客户端。该客户端可以是官方 MCP SDK、LangChain、Google ADK 或 MoEngage 自有的智能体运行器。客户端使用该服务已有的 AWS Identity and Access Management(IAM)角色,通过 SigV4 对请求进行签名。请求通过 HTTPS 传输到带有私有 DNS 的 VPC 接口端点。不存在公网跳转。AgentCore Gateway 接收请求并评估 Cedar 策略,以确定该主体可以查看或调用哪些内容。然后,它通过 Amazon VPC Lattice 上的托管出口将工具调用路由到内部 API。
MoEngage 做出了两个值得特别说明的身份验证决策。
第一,他们为内部网关选择了 SigV4 而非 JWT。这里的智能体是已经拥有 IAM 角色的服务。使用 SigV4,它们可以用已有的凭证进行签名。无需签发、轮换或存储任何新内容。MoEngage 单独的公共 MCP 服务器为来自 Claude 和其他客户端的人工认证会话提供服务,它在 AgentCore 运行时上使用 OIDC JWT。那是具有不同要求的另一个界面。
第二,身份以标头形式传递,而不是作为工具参数。租户、用户、角色和数据库上下文由客户端库从一个小的 Identity 对象转换为 X-MOE-* 标头。模型看不到它们,也无法设置它们。对于构建类似系统的人来说,有一个细节很重要:由于 SigV4 签名占用 Authorization 标头,调用方转发的持有者令牌必须移到其他地方。MoEngage 将其作为专用的 MoEngage 前缀标头进行传播。标头传播也有上限,因此标头集合是经过精心设计的,而不是累积而成的。
发现和执行具有不同的身份要求。列出和搜索工具不携带租户身份。只有 tools/call 携带。这种分离使发现成本低廉,并使审计线索清晰明确。每个携带身份的请求都是一次实际的数据访问。
即使 Cedar 将某个 agent 的作用域限定在目录的一个子集内,这个子集也可能很大。MoEngage 的客户端库向模型暴露了一个单一的元工具 search_tools。模型描述它需要什么,网关的语义搜索返回候选工具,只有这些候选工具在当轮对话的剩余时间内可被调用。完整目录不会进入上下文。agent 的上下文在开始时只包含一个工具定义,搜索后包含少量相关工具定义,而不是数百个它永远不会用到的定义。
接入新 API
团队将某个 API 作为 agent 工具暴露时,会在其现有的 OpenAPI spec 中添加一个块:
paths:
  /campaigns:
    get:
      operationId: listCampaigns
      description: |
        Returns a paginated list of campaigns. Supports filtering by
        status, channel, date range, and tags.
      x-moe-mcp:
        expose:
          external: false
          internal: true
        tool_description: |
          Find campaigns by status or channel. Returns campaign ID, name,
          status, and channel. Use the returned campaign_id with
          get_campaign for full details, or send_campaign to launch it.
        param_overrides:
          status:
            description: |
              Filter by campaign status. Use 'active' for running
              campaigns, 'scheduled' for upcoming. Omit for all.
该块中有四个设计选择值得解释。
暴露是显式的主动选择。没有 x-moe-mcp 块的端点不是工具。持续集成(CI)不会因其缺失而发出警告,因为对大多数端点而言,缺失才是正确状态。缓存预热路由和迁移触发器不是 agent 工具,不应有任何机制推动团队将它们变成工具。借助 internal 和 external 标志,团队可以独立地将某个操作暴露给内部 agent、公开的 MCP 服务器,或同时暴露给两者。
工具描述不是 API 描述。API 描述告诉阅读文档的开发者某个端点返回什么。工具描述告诉模型何时应使用此工具以及应传入什么。MoEngage 发现,逐字复用 API 描述会导致工具选择效果不佳。模型基于实现细节(“返回分页列表”)而非意图(“按状态或渠道查找营销活动”)来选择工具。tool_description 和 param_overrides 字段的存在,正是为了给团队一个地方来编写面向模型的文本,而不改变面向开发者的文档。
CI 流水线处理从 spec 到运行中工具的一切。当团队推送 spec 变更时,流水线会验证 x-moe-mcp 块、向 AgentCore Gateway 注册目标,并应用 Cedar 策略。无需手动步骤,无需向 AI Platform 团队提交工单。一个从未考虑过 MCP 的团队,可以在流水线运行的时间内让某个操作作为 agent 工具可用。
客户端库有两种模式。插件模式将 AgentCore Gateway MCP 服务器包装在 LangChain、Google ADK 或兼容 MCP 的框架内,作为工具提供者。agent 运行器模式为希望在不采用框架的情况下获得独立 agent 的团队运行完整的 agent 循环。
MoEngage 目前运行的内容
MoEngage 的 AgentCore Gateway 部署目前运行在七个 AWS 区域。该网关向 10 个内部 agent 提供约 400 个已注册的 API 操作。没有产品团队编写过 MCP 服务器代码。没有产品团队为 agent 集成配置过网络。没有产品团队实现过 Cedar 策略。AI Platform 团队负责所有这些工作,接入新 API 的成本只是一条 spec 注解和一次 CI 运行。AgentCore 功能的可用性因区域而异。有关支持的区域,请参阅 Amazon Bedrock AgentCore 文档。
该系统已在生产环境中运行三个月。这些智能体覆盖了营销团队成员日常接触的整个工作流。一个活动 QA 智能体在发布前验证定向规则和内容。一个投递健康智能体跨渠道监控发送速率和退信模式。一个分群构建智能体将自然语言受众描述转换为分群查询。每个智能体都使用自己的 IAM 角色进行身份验证,只能看到其 Cedar 策略允许的工具,并通过描述任务而非记忆工具名称来发现工具。通过消除构建和运营 20 个独立 MCP 服务器以及跨七个区域为每个 API 配置网络的需求,MoEngage 估计该方法节省了约六个月的工程工作量。现在接入一个新 API 只需数小时的规范标注,而不再是数天的网络配置和安全审查。
搜索优先的模式改变了 MoEngage 对智能体设计的思考方式。新智能体从零硬编码工具引用开始。它们描述意图,接收候选工具,并调用它们找到的工具。当团队重命名某个操作或发布新操作时,现有智能体无需更改代码即可识别。
结论
MoEngage 方法背后的关键洞察是一种关注点分离,它映射到工程组织的实际运作方式。产品团队拥有 API 并对其进行良好描述。平台团队拥有协议层、策略层和连接层。AgentCore Gateway 通过消除中间的无差别工作使这种分工变得可行:无需 MCP 服务器代码,无需为每个 API 配置网络,无需在客户端进行伪装成授权的过滤。
其结果是这样一个智能体系统:添加新工具是规范变更,限制访问是策略变更,两者都不需要另一个团队参与。
要开始使用 AgentCore Gateway,请参阅 Amazon Bedrock AgentCore 文档。有关 Cedar 策略编写,请参阅 Cedar 策略语言参考。有关私有连接模式,请参阅 Amazon VPC Lattice 文档。
要为您的组织讨论类似架构,请联系您的 AWS 客户团队或 联系 AWS。
关于作者

Nikhil Kumar
Nikhil 是 MoEngage CTO 办公室的首席软件工程师,领导 AI Labs 团队构建智能体 AI 能力。他的工作涵盖 MCP 服务器和工具目录架构、LLM 网关和路由基础设施,以及为内部工具和公共智能体体验评估智能体框架。他拥有超过 4 年构建大规模软件和云基础设施的经验。

Shakir Khan
Shakir 是 MoEngage 的架构师,领导 API 治理并构建支撑公司客户互动平台的核心流式基础设施。他的工作涵盖网关架构、使用 Flink 和 Kafka 的实时流处理以及大规模数据迁移。他拥有超过 11 年设计服务数十亿客户交互系统的经验,其中 5 年在 MoEngage。

Bhupesh Chadha
Bhupesh 是 Amazon Web Services 的客户总监,与独立软件供应商(ISV)合作,使其平台战略与业务目标保持一致。他与高管层和高级领导层合作,加速增长、将新能力推向市场,并将技术投资转化为客户覆盖和差异化优势。

Anant Murarka
Anant 是 Amazon Web Services 的解决方案架构师,他与 ISV 客户合作设计多租户架构,并将 AI 驱动的解决方案投入生产。他的专业领域包括代理式 AI、代理编排模式、负责任 AI,以及帮助产品公司在 AWS 上采用生成式 AI。工作之余,Anant 热衷于探索新兴 AI 范式如何重塑软件产品的构建与交付方式。
来源:AWS Machine Learning Blog · aws.amazon.com