Sebastian Raschka 发布 8 集从零构建推理模型视频课程
Sebastian Raschka 发布 8 集共 11 小时的 Build a Reasoning Model (From Scratch) 编码视频课程,配套其同名书籍,从预训练 Qwen3 0.6B 模型出发用 Python 和 PyTorch 实现推理方法。
Ahead of AI· Sebastian Raschka, PhD·2026-10-24 19:14· 33 分钟前AI 评分59
从零开始构建推理模型:视频课程
AI 导读
Sebastian Raschka 发布 8 集共 11 小时的 Build a Reasoning Model (From Scratch) 编码视频课程,配套其同名书籍,从预训练 Qwen3 0.6B 模型出发用 Python 和 PyTorch 实现推理方法。
正文 · 原文
过去两年里,我在 Ahead of AI 上写了很多关于推理模型的内容,包括最近一篇关于控制当代 LLM 中推理努力程度机制的文章。推理模型依然和以往一样重要。事实上,如今几乎所有当代 LLM 都是推理模型,或者提供推理模式。
对于那些对推理模型工作原理感兴趣的人,包括推理扩展、强化学习和蒸馏,我最近写了Build Reasoning Model (From Scratch),其中用 PyTorch 从零实现这些内容,根据我的经验,这仍然是理解和学习事物真正运作方式的最佳途径。
现在,在过去几个月里,我也坐下来录制了配套讲座,想与大家分享。因此,下面你将看到八个从零构建推理模型的编码视频(共 11 小时内容)。
我们从预训练 LLM 开始,用 Python 和 PyTorch 实现评估和改进它的方法。所以,如果你喜欢我去年推出的Coding LLMs from the Ground Up课程,这基本上就是续集(但你也可以在没有先修课程的情况下观看)。
我目前正在短暂休息,下个月会带着更多激动人心的 LLM 研究综述回来。在此期间,希望你喜欢跟着一起编码!
LLM、推理模型和智能体如何关联并契合在一起
作为一个小注,由于我经常被问到推理模型与当今 AI 智能体的关系,这里在开始视频之前先简短说明一下。
推理模型本质上是对传统 LLM 的升级,即通过带可验证奖励的强化学习(以及可选的推理扩展技术)增加更多后训练,使其更有能力解决更具挑战性的问题。传统上,推理模型是为数学和代码开发的,但这些能力也可以泛化到其他问题领域。
推理模型随后作为智能体框架内部的引擎发挥作用,其中智能体框架是围绕 LLM/推理模型的软件或工具框架,用于解决更具挑战性的问题(更大的编码任务、旅行预订以及各种其他个人助理任务)。框架的任务是复杂的上下文管理,并让 LLM 能够访问工具。
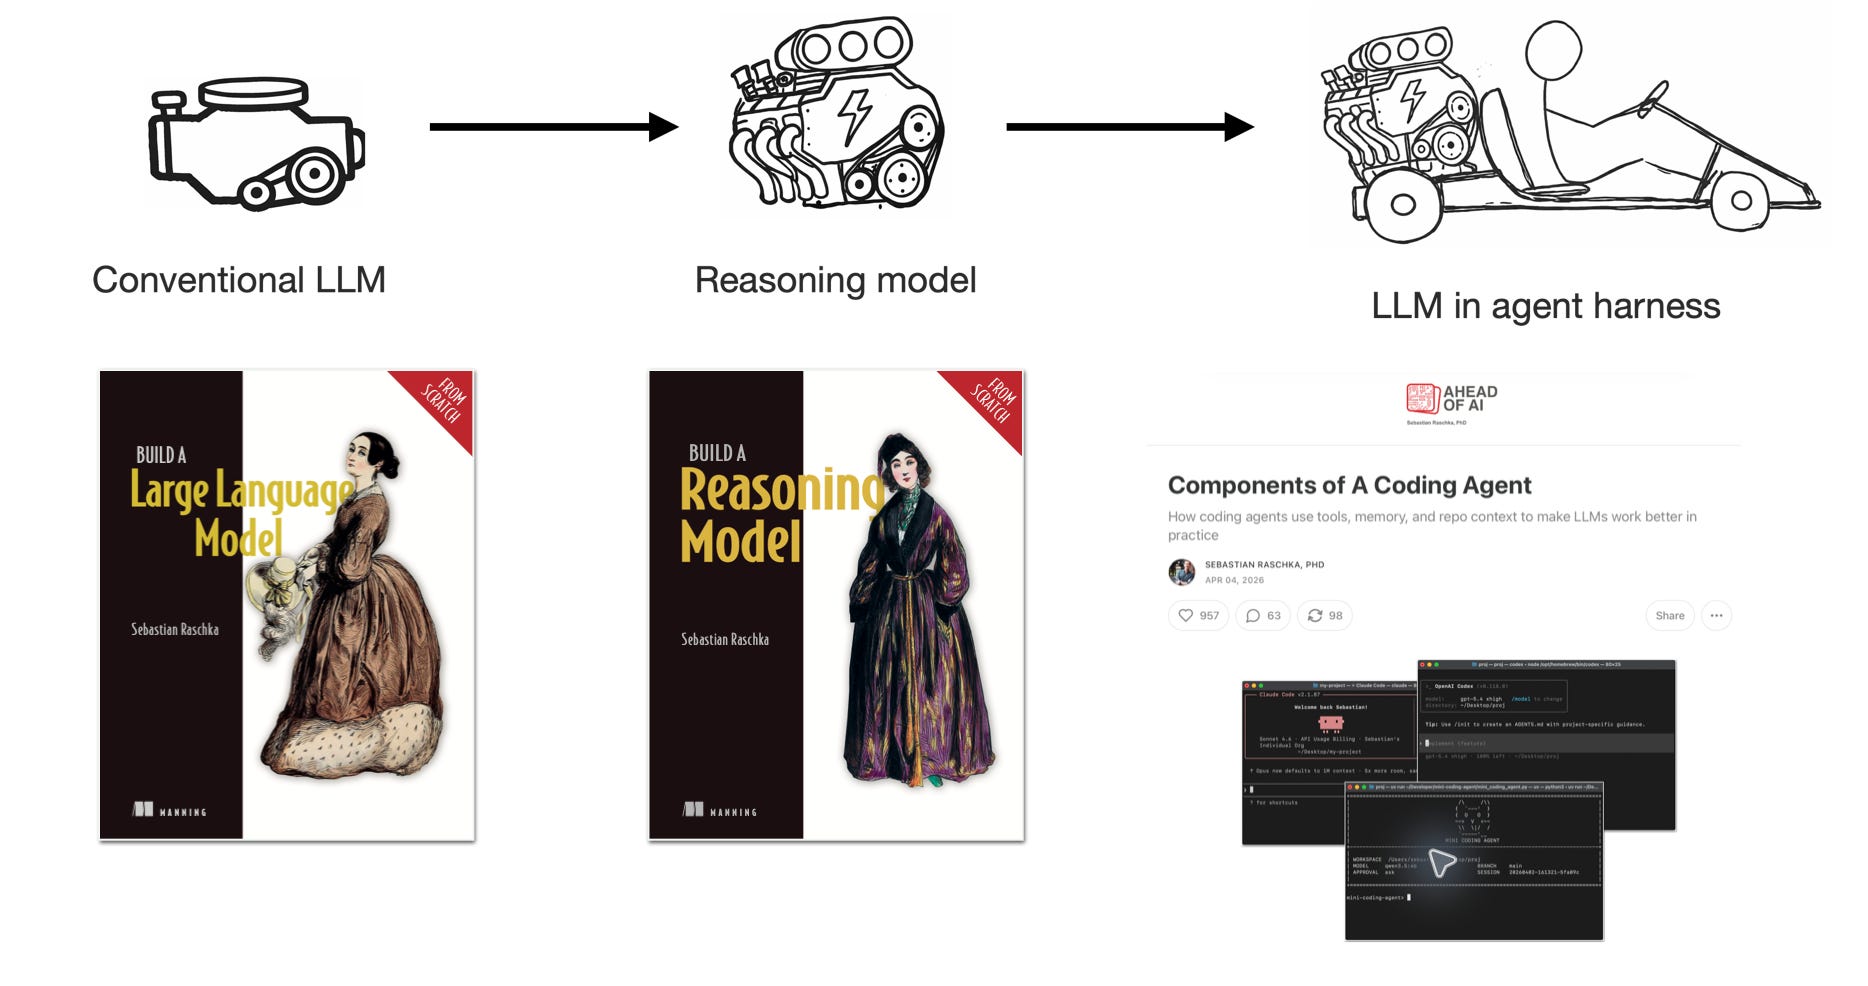
图 1:传统 LLM、推理模型和智能体框架的引擎类比。图来自我的Components of a Coding Agent文章。
在上图描绘的类比中,模型是引擎,智能体框架增加了机械装置,让我们能将其用于各种用途(作为简单聊天机器人界面的升级)。智能体可以使用传统 LLM 或推理模型,但推理模型是更典型的选择,因为它们能力更强。(如上所述,大多数当代 LLM 都是带有可变推理努力设置的推理模型。)
所以,底线是,推理模型作为“引擎”,仍然是理解现代 LLM 智能体的重要部分。
上述主题附带的资源如下:
下方视频重点介绍如何开发能够支撑此类系统的推理模型。
范围与先决条件
这些从零构建推理模型的视频聚焦于一个小型预训练 Qwen3 模型,我们将用 Python 和 PyTorch 自行实现推理方法。从预训练模型入手,可以让我们专注于有趣的部分:评估、推理时扩展、强化学习和蒸馏。
关于先决条件,我建议你熟悉 Python 和 PyTorch。我将推理部分的内容设计为独立材料,因此之前 Build A Large Language Model (From Scratch) 的内容是推荐但并非严格要求。
在计算资源方面,早期的文本生成和评估示例可以在 CPU 上完成。对于后续实验,尤其是训练,使用 GPU 会让工作实用得多。第一个视频介绍了环境配置以及更多建议;代码仓库中还包含硬件与环境建议。
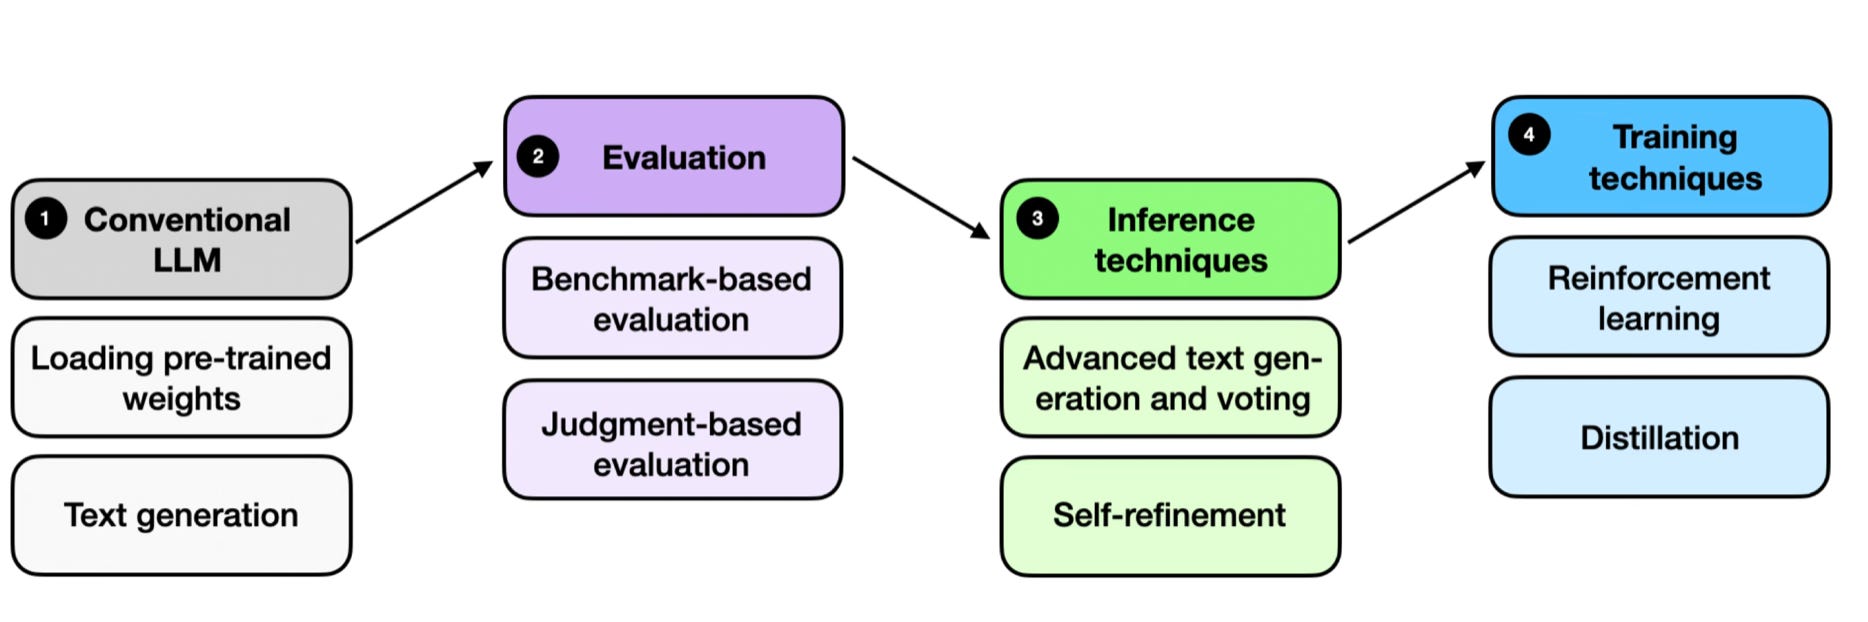
图 2:所涵盖主题的概览。
配套书籍
这些视频是我所著Build a Reasoning Model (From Scratch)一书的配套内容。如果你想更详细、按自己的节奏阅读讲解、完成练习等,我推荐将这本书作为配套材料。
为了获得最深入的学习体验,我的建议是阅读一章,结合对应视频完成其代码,然后尝试练习。
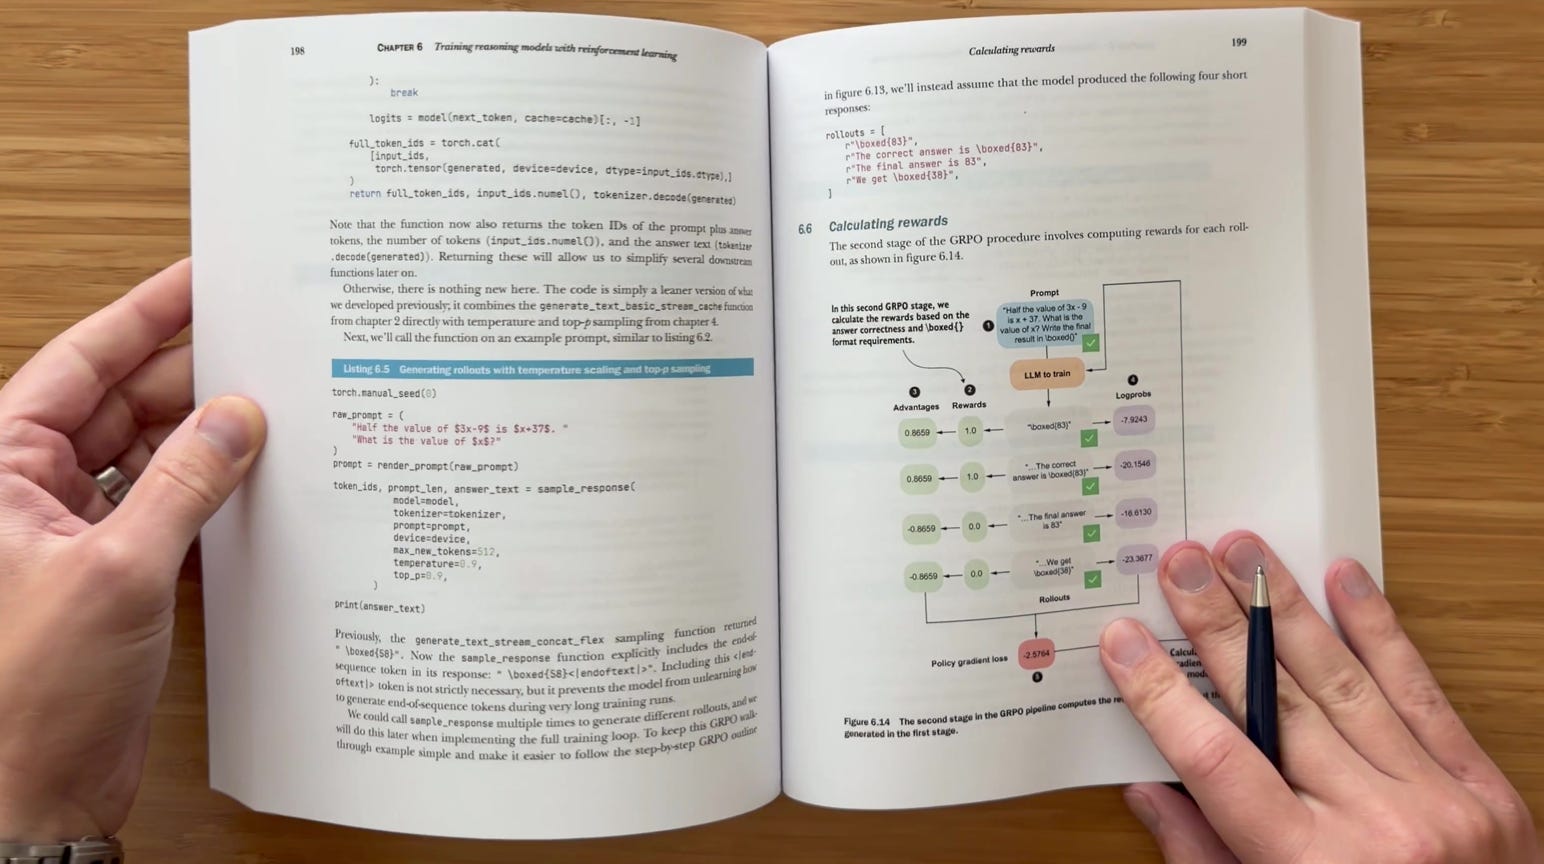
图 3:Build a Reasoning Model (From Scratch)印刷版中的随机摘录。
感谢每一位购买本书或将其推荐给朋友的人。你们的支持帮助我持续创作这些材料。
视频
在进入下方主要视频之前,最后再简单提一句:如需更简短、更偏概念性的概览,我还推荐我在LinkedIn Learning 上的 AI Reasoning Models 课程(通过该链接访问时,24 小时内应可免费观看,且无需 LinkedIn Premium 订阅)。
该课程约 90 分钟,讲解推理模型的工作原理,涵盖推理时扩展、强化学习和蒸馏背后的主要思想。如果你只想了解主要思想而不想完成下方的完整实现,这是一个不错的可选预览。
进入本文的主要部分,以下是八个主要讲座视频。
1. 动机与代码配置
第一个视频首先解释传统 LLM、推理模型和智能体之间的关系。接着,视频的主要主题是配置编程环境,包括安装 Python 和 PyTorch 依赖(使用 uv)等。我还讨论了硬件选择和常见配置问题。
涵盖主题
传统 LLM、推理模型和智能体框架之间的关系
通过代码实现来学习的好处
本视频系列的范围
安装 Python 依赖
选择硬件并检查 CUDA 或 Apple Silicon 支持
使用 VS Code 连接远程 GPU 并排查环境问题
2. 加载基础模型、文本生成与 KV 缓存
在后续视频中加入推理方法之前,我们需要一个可用的基础模型。与其从头训练它——那将是另一本书的内容(参见 Build A Large Language Model (From Scratch))——我们从预训练模型开始。
这里,我们加载 Qwen3 0.6B 模型的预训练权重。然后,我们通过流式文本生成器实现文本生成过程,并加入 KV 缓存和模型编译,使文本生成更加高效。
这些实现为我们提供了基线以及基础组件,我们将在后续视频中对其进行评估和改进。
涵盖主题
将文本编码为 token 并将其解码回文本
下载 Qwen3 权重并在选定的计算设备上加载模型
讲解张量形状、logits 和下一 token 预测
实现贪心解码和流式文本生成
处理序列结束 token 并测量生成速度
添加 KV 缓存以复用注意力键和值
将 KV 缓存与
torch.compile结合并比较硬件性能
3. 构建用于评估和强化学习的验证器
在本讲中,我们逐步构建一个数学答案验证器,从答案提取到归一化再到检查数学等价性。然后我们用它来在 MATH-500 上评估模型。
我们使用该验证器在 MATH-500 评估数据集上评估基础模型的性能。
然而,该验证器在本系列后续还有第二项任务:为带可验证奖励的强化学习(RLVR)提供奖励信号。
涵盖主题
验证器简介及其如何融入 LLM 评估方法(其他方法见本书附录)
复用答案验证作为 RLVR 的奖励信号(第 6 章将详细讨论)
验证器流程,包括提取最终答案、归一化答案和检查数学等价性
构建答案评分器和 MATH-500 的评估循环
在 MATH-500 上比较基础模型和推理模型
4. 推理时扩展:采样与自一致性
现在我们探索在保持模型权重不变的情况下改进答案的方法。但在实现具体的推理扩展技术之前,我们首先实现从同一提示生成多样化答案的方法(这是专有 LLM 聊天机器人如 ChatGPT 的标准做法)。
具体来说,我们实现温度缩放、多项式采样和 top-p 过滤以生成多样化回复。然后我们通过自一致性将多个回复结合起来,对其最终答案使用多数投票。
我们还考察答案准确性与生成更多候选所需的额外计算之间的权衡。
涵盖主题
比较额外计算在训练期间和推理期间对模型性能的益处
通过思维链提示对推理扩展进行简要介绍
实现温度缩放和多项式采样以生成多样化答案
添加 top-p 过滤以控制多样化答案的质量
通过自一致性组合候选答案,这是最流行的推理扩展技术之一
评估 MATH-500 准确率与额外推理计算成本之间的关系
5. 推理时扩展:评分与自我改进
在上一视频的基础上,我们实现评分函数来比较同一提示生成的多个答案。我们也可以使用这些评分方法在自一致性中打破平局(上一讲已介绍)。
这里介绍的评分方法包括计算 token 和序列对数概率(这在后续强化学习章节中也会用到)。然后我们实现一个自我改进循环,模型在其中对答案进行批判并尝试修订。
评估让我们检查这些额外步骤对模型有多大帮助。
涵盖主题
使用评分函数比较多个答案并打破平局
实现一个简单的启发式评分器
计算 token 概率和序列似然(对后续课程也有用)
使用对数概率提高数值稳定性
构建自我改进循环以生成批判和修订答案
在 MATH-500 上评估自我改进
6. 强化学习:为 RLVR 实现 GRPO
在本讲中,我们转向实现一种称为可验证奖励强化学习(RLVR)的训练技术。我们首先实现一个简化版的组相对策略优化(GRPO),生成成组的响应,用验证器对其评分,并在训练期间使用它们的相对奖励来更新模型权重。
涵盖主题
生成推理轨迹并理解答案长度与问题解决能力之间的关系
讨论和比较两种重要的 LLM 后训练方法:基于人类反馈的强化学习(RLHF)和可验证奖励强化学习(RLVR)
将验证器分数转化为奖励和相对优势
计算序列对数概率和简化的 GRPO 损失
组装训练循环,包含日志记录和检查点保存
评估检查点并检查训练稳定性和内存需求
7. 强化学习:跟踪、裁剪策略比率和 KL 项
既然我们在上一讲中实现了训练循环,现在可以重新审视它并更详细地分析训练运行。
具体来说,本视频添加了更多训练指标用于检查和分析,包括熵和优势统计、裁剪策略比率、KL 损失项值和格式化奖励。
然后我们查看训练日志和评估结果,以了解这些新增内容的作用,以及裁剪策略比率和 KL 损失项等新增内容是否有帮助。
涵盖主题
运行更长的训练实验并解读其日志
跟踪优势和熵以理解训练行为
在策略损失中实现裁剪并分析其效果
添加 KL 损失项并讨论奖励黑客
理解简化 KL 公式的局限性
实现格式奖励并使其以答案正确性为条件
在 MATH-500 上比较检查点并探索进一步的 GRPO 研究
8. 蒸馏推理模型
最后,我们探索另一种训练小型推理模型的方法,即从更强大(也更大)的教师模型生成的答案中学习。我们讨论不同形式的蒸馏,准备推理数据,并实现监督训练循环。
我们通过评估蒸馏模型在 MATH-500 上的表现并比较结果来结束本讲和本课程。这为通过强化学习开发推理能力提供了一种替代方案,从而完善了整个系列。
涵盖主题
比较蒸馏的不同组合和方法,包括软蒸馏和硬蒸馏,以及同策略和离策略蒸馏
为 MATH 数据集创建和收集教师生成的答案(使用 DeepSeek R1)
准备蒸馏数据集,包括分词和训练/验证/测试划分
计算答案 token 的对数概率并理解交叉熵损失
实现监督训练并跟踪训练和验证损失
在 MATH-500 上评估检查点并比较蒸馏结果
结语
在观看这些讲座时,我鼓励你偶尔暂停一下,如果想到什么有趣的东西,就自己尝试做个小实验。
例如,你可以随意更改采样设置,检查一些失败的答案,或者尝试与练习中建议类似的不同想法的变体。
如果你想要完整的书面讲解、图表和与视频配套的练习,可以在 Manning 和 Amazon 上找到《Build a Reasoning Model (From Scratch)》。
感谢阅读和支持 Ahead of AI。我要短暂休息一下恢复精力,期待下个月带着下一轮 LLM 研究文章回来。
在此期间,祝你观看和动手愉快!
来源:Ahead of AI · magazine.sebastianraschka.com
来源:RadarAI · aihot.news