如何用 Amazon SageMaker HyperPod 实现 GPU 集群的团队隔离与公平共享
Share GPU clusters across teams with isolation and fairness using Amazon SageMaker HyperPod
AWS 发布基于 Amazon SageMaker HyperPod 与 EKS 的多租户参考架构,让多个团队共享同一 GPU 集群。
同一家公司内的多个团队越来越需要共享访问昂贵的 GPU 集群来支持其生成式 AI 业务,同时还要保持隔离边界、资源公平性和运营独立性。设想一个训练大语言模型的数据科学团队、一个运行推理工作负载的计算机视觉团队,以及一个试验新模型架构的研究团队。他们可能都需要访问同一个集群。如果没有精心设计的多租户(多团队)架构,组织将面临资源消耗失控、团队间隔离薄弱、无法将共享 GPU 成本归因到产生成本的团队,以及拖慢创新的管理开销。
Amazon SageMaker HyperPod 是一项专门构建的 AI 服务,可简化生成式 AI 工作负载大规模计算集群的管理。它提供由 Amazon Elastic Kubernetes Service(Amazon EKS)或 Slurm 编排的弹性、优化集群,使组织能够大规模运行分布式训练、交互式开发和模型推理。同时,它自动处理节点健康监控、故障恢复和集群生命周期管理。
在本文中,我们介绍一种在 Amazon SageMaker HyperPod 上使用 EKS 构建多租户环境的参考架构。该架构使用 AWS IAM Identity Center 进行集中式身份验证,为每个团队使用独立的 SageMaker AI 域以提供量身定制的用户体验,使用 Kubernetes 命名空间进行工作负载隔离,使用 HyperPod Task Governance 实现公平的资源分配,并使用命名空间级成本分配来实现按团队的费用可见性和分摊。读完本文后,您将获得一份清晰的蓝图,让多个团队高效共享单个 HyperPod EKS 集群。
架构概览
下图展示了多租户 HyperPod EKS 部署的高层架构。在此示例中,两个团队(Team A 和 Team B)共享单个 HyperPod EKS 集群,各自在独立的命名空间中运行。
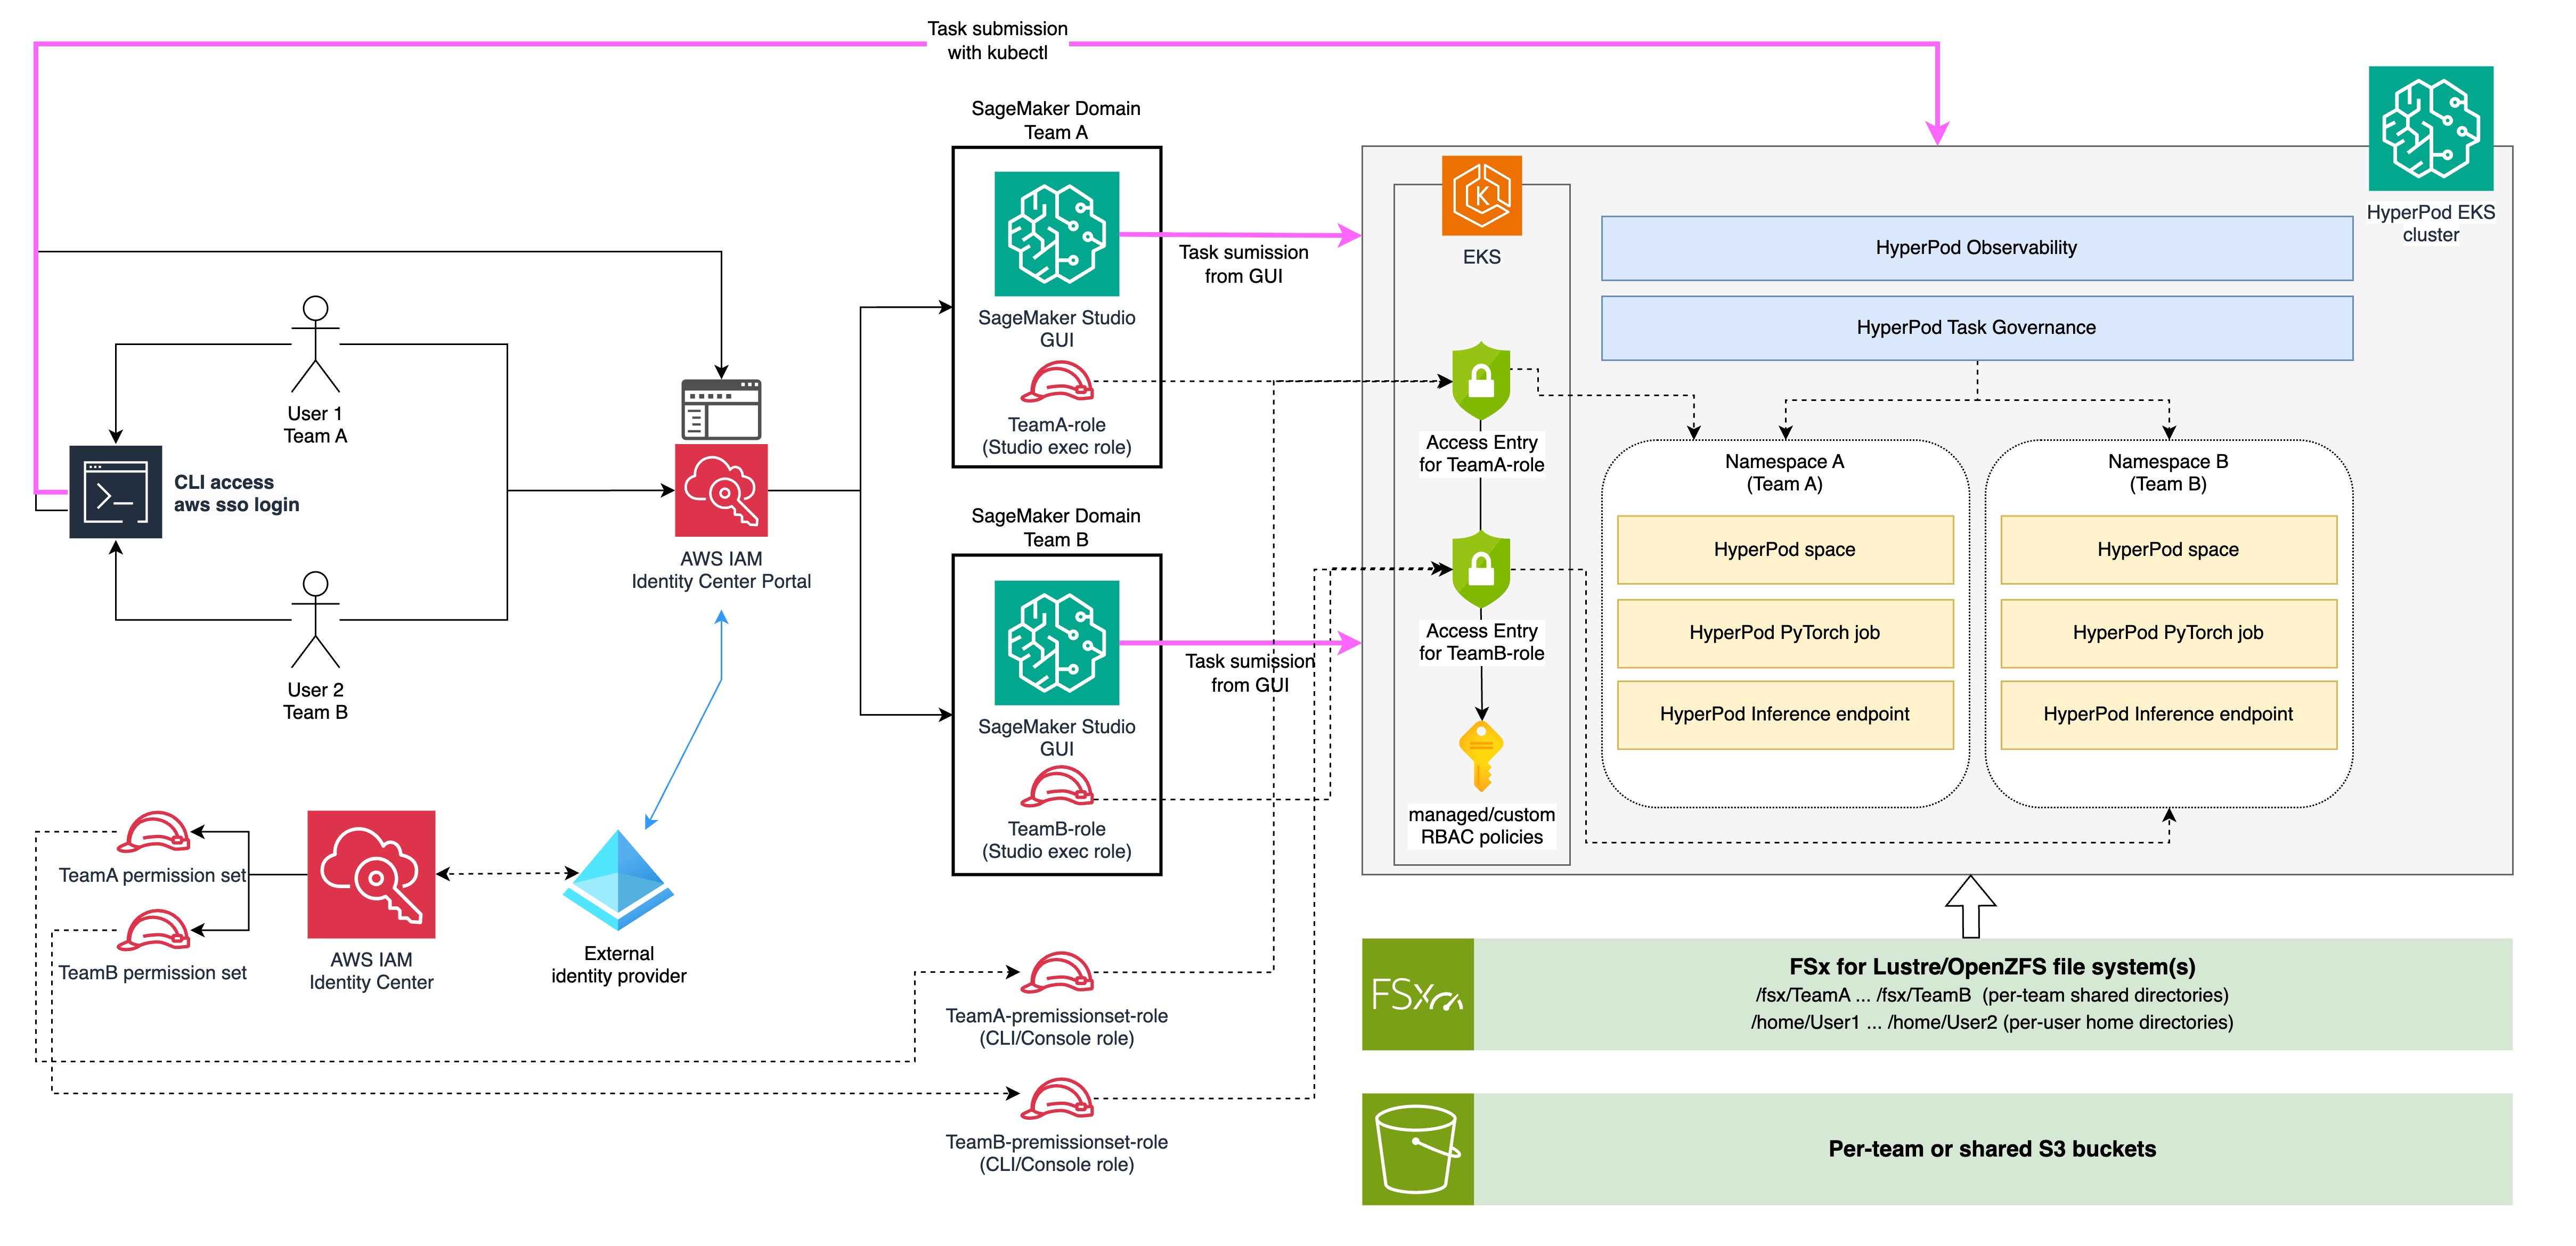
图 1:两个团队共享一个 HyperPod EKS 集群的高层多租户架构
该架构采用从左到右的分层流程,将用户身份通过授权控制连接到集群上隔离的工作负载命名空间。
用户与身份验证
在最左侧,每个团队中的单个用户(Team A 的 User 1、Team B 的 User 2)通过两条路径与系统交互。两条路径都通过 AWS IAM Identity Center 门户进行身份验证,该门户与左下角所示的外部身份提供商(例如 Microsoft Entra ID)联合。
第一条路径是通过 CLI 访问。用户使用 aws sso login 进行身份验证,这会将其重定向到 Identity Center 门户,然后从所在团队的权限集获取临时凭证,使用 kubectl 直接将任务提交到 EKS 集群。在图中,粉色箭头从 CLI 终端沿顶部直接流入 HyperPod EKS 集群。
第二条路径是直接通过 Identity Center 门户,用户选择 SageMaker Studio 应用程序登录到其团队专属的 SageMaker AI 域。
每个团队都有一个对应的权限集(TeamA 权限集、TeamB 权限集),其中包含 CLI 工作流所需的 AWS Identity and Access Management (IAM) 策略。Identity Center 会为每个权限集自动预置一个 IAM 角色,在图中显示为 TeamA-permissionset-role 和 TeamB-permissionset-role(标记为“CLI/Console 角色”)。当用户通过 aws sso login 进行身份验证时,该角色充当 IAM 主体。
SageMaker AI 域
从 Identity Center 门户,用户会被路由到其团队专属的 SageMaker AI 域。每个域(SageMaker AI 域 Team A 和 SageMaker AI 域 Team B)都提供一个专用的 Amazon SageMaker Studio GUI,并配置有团队专属的执行角色(分别为 TeamA-role 和 TeamB-role)。这些域作为主要的工作区界面,因此用户可以从 GUI 提交任务(由流向 EKS 的粉色箭头表示)。
EKS 访问控制
在 EKS 边界处,访问条目将 IAM 角色映射到 Kubernetes 权限。图中显示了 TeamA-role 和 TeamB-role(Studio 执行角色)的访问条目,它们授权来自 SageMaker Studio GUI 的请求。还必须为 Identity Center 预置的 CLI/Console 角色(TeamA-permissionset-role 和 TeamB-permissionset-role)配置访问条目,以授权通过 kubectl 到达的请求。所有访问条目都与托管或自定义的基于角色的访问控制 (RBAC) 策略关联(由钥匙图标表示),并限定在团队指定的命名空间内。因此,无论访问来自 Studio 还是 CLI,用户都只能与其自己命名空间中的资源进行交互。
HyperPod EKS 集群
集群本身在顶部描绘了两个横切平台层:HyperPod Observability(用于监控和仪表板)和 HyperPod Task Governance(用于计算配额管理和调度优先级)。在这些层之下,集群被划分为 Namespace A(Team A)和 Namespace B(Team B)。在每个命名空间内,团队可以运行自己的 HyperPod Spaces(交互式开发环境)、HyperPod PyTorch 作业(分布式训练工作负载)和 HyperPod Inference 端点(模型服务)。
存储
在集群之下,该架构包含两个存储层。第一个是符合 POSIX 的文件系统(Amazon FSx for Lustre 或 Amazon FSx for OpenZFS),组织为按团队共享的目录(/fsx/TeamA、/fsx/TeamB)和按用户的主目录(/home/User1、/home/User2)。第二个是按团队或共享的 Amazon Simple Storage Service (Amazon S3) 存储桶,用于对象存储,由团队的 IAM 执行角色管理。
该架构将每个团队从身份验证到授权再到工作负载执行的过程隔离开来,同时高效地共享昂贵的 GPU 基础设施。
身份验证与访问控制
任何多租户系统的基础都是稳健的身份验证:在用户与任何资源交互之前验证其身份。在此架构中,AWS IAM Identity Center 作为集中式身份验证层,与外部身份提供商联合以管理用户身份和组成员资格。
为什么选择 AWS IAM Identity Center
AWS IAM Identity Center(AWS Single Sign-On 的继任者)提供了一个单一位置来管理跨 AWS 账户和应用程序的员工身份。对于多租户 HyperPod 部署,它提供了多项关键能力:
- 集中式身份管理 – Identity Center 无需为每个 AWS 服务维护单独的用户数据库,而是为所有用户身份及其组成员资格提供单一事实来源。
- 与现有身份提供商联合 – 大多数企业已经在 Microsoft Entra ID(原 Azure AD)、Okta 或 Ping Identity 等系统中管理其员工身份。Identity Center 可与这些提供商集成,因此组织可以复用其现有身份基础设施,而无需重复创建用户账户。
- 与 SageMaker AI 原生集成 – SageMaker AI 域支持 Identity Center 身份验证,因此用户可以通过其企业身份提供商使用单点登录(SSO)登录 SageMaker Studio。
- AWS 账户访问 – Identity Center 还可以通过特定权限集授予用户对底层 AWS 账户的访问权限,这些权限集支持 CLI 工作流以及 Studio GUI 体验。
- Amazon Managed Grafana 的必需项 – Amazon Managed Grafana 使用 Identity Center 作为其员工用户身份验证机制,因此当团队还需要访问可观测性仪表板来监控其工作负载时,它是自然之选。
使用外部身份提供商配置 Identity Center
在此参考架构中,我们使用 Microsoft Entra ID 作为外部身份提供商,但同样的模式适用于大多数标准 Security Assertion Markup Language (SAML) 2.0 提供商。
配置涉及:
- 身份提供商中的组结构 – 在 Entra ID 中,创建与您的组织团队相对应的组。在我们的示例中,我们定义了三个组:
TeamA、TeamB和Admin。每个组包含属于该团队的用户(例如,TeamA组中的user1-teamA@example.com)。 - SCIM 预配 – 在 Entra ID 与 AWS IAM Identity Center 之间启用 SCIM(跨域身份管理系统)同步。SCIM 提供用户和组的自动预配与取消预配。当新用户被添加到 Entra ID 中的
TeamA组时,他们会自动同步到 Identity Center 并获得相应访问权限,无需手动干预。 - 基于 SAML 的身份验证 – 配置 SAML 2.0 联合,以便用户进行身份验证时针对 Entra ID 进行。Identity Center 充当服务提供商,信任来自您的 Entra ID 租户的断言。
通过此配置,您在现有企业目录中管理团队成员资格(这驱动所有下游授权决策),并自动传播到 AWS。
下图展示了组织团队如何在 Microsoft Entra ID 中表示,其中为 TeamA、TeamB 和 Admin 设有专用组。
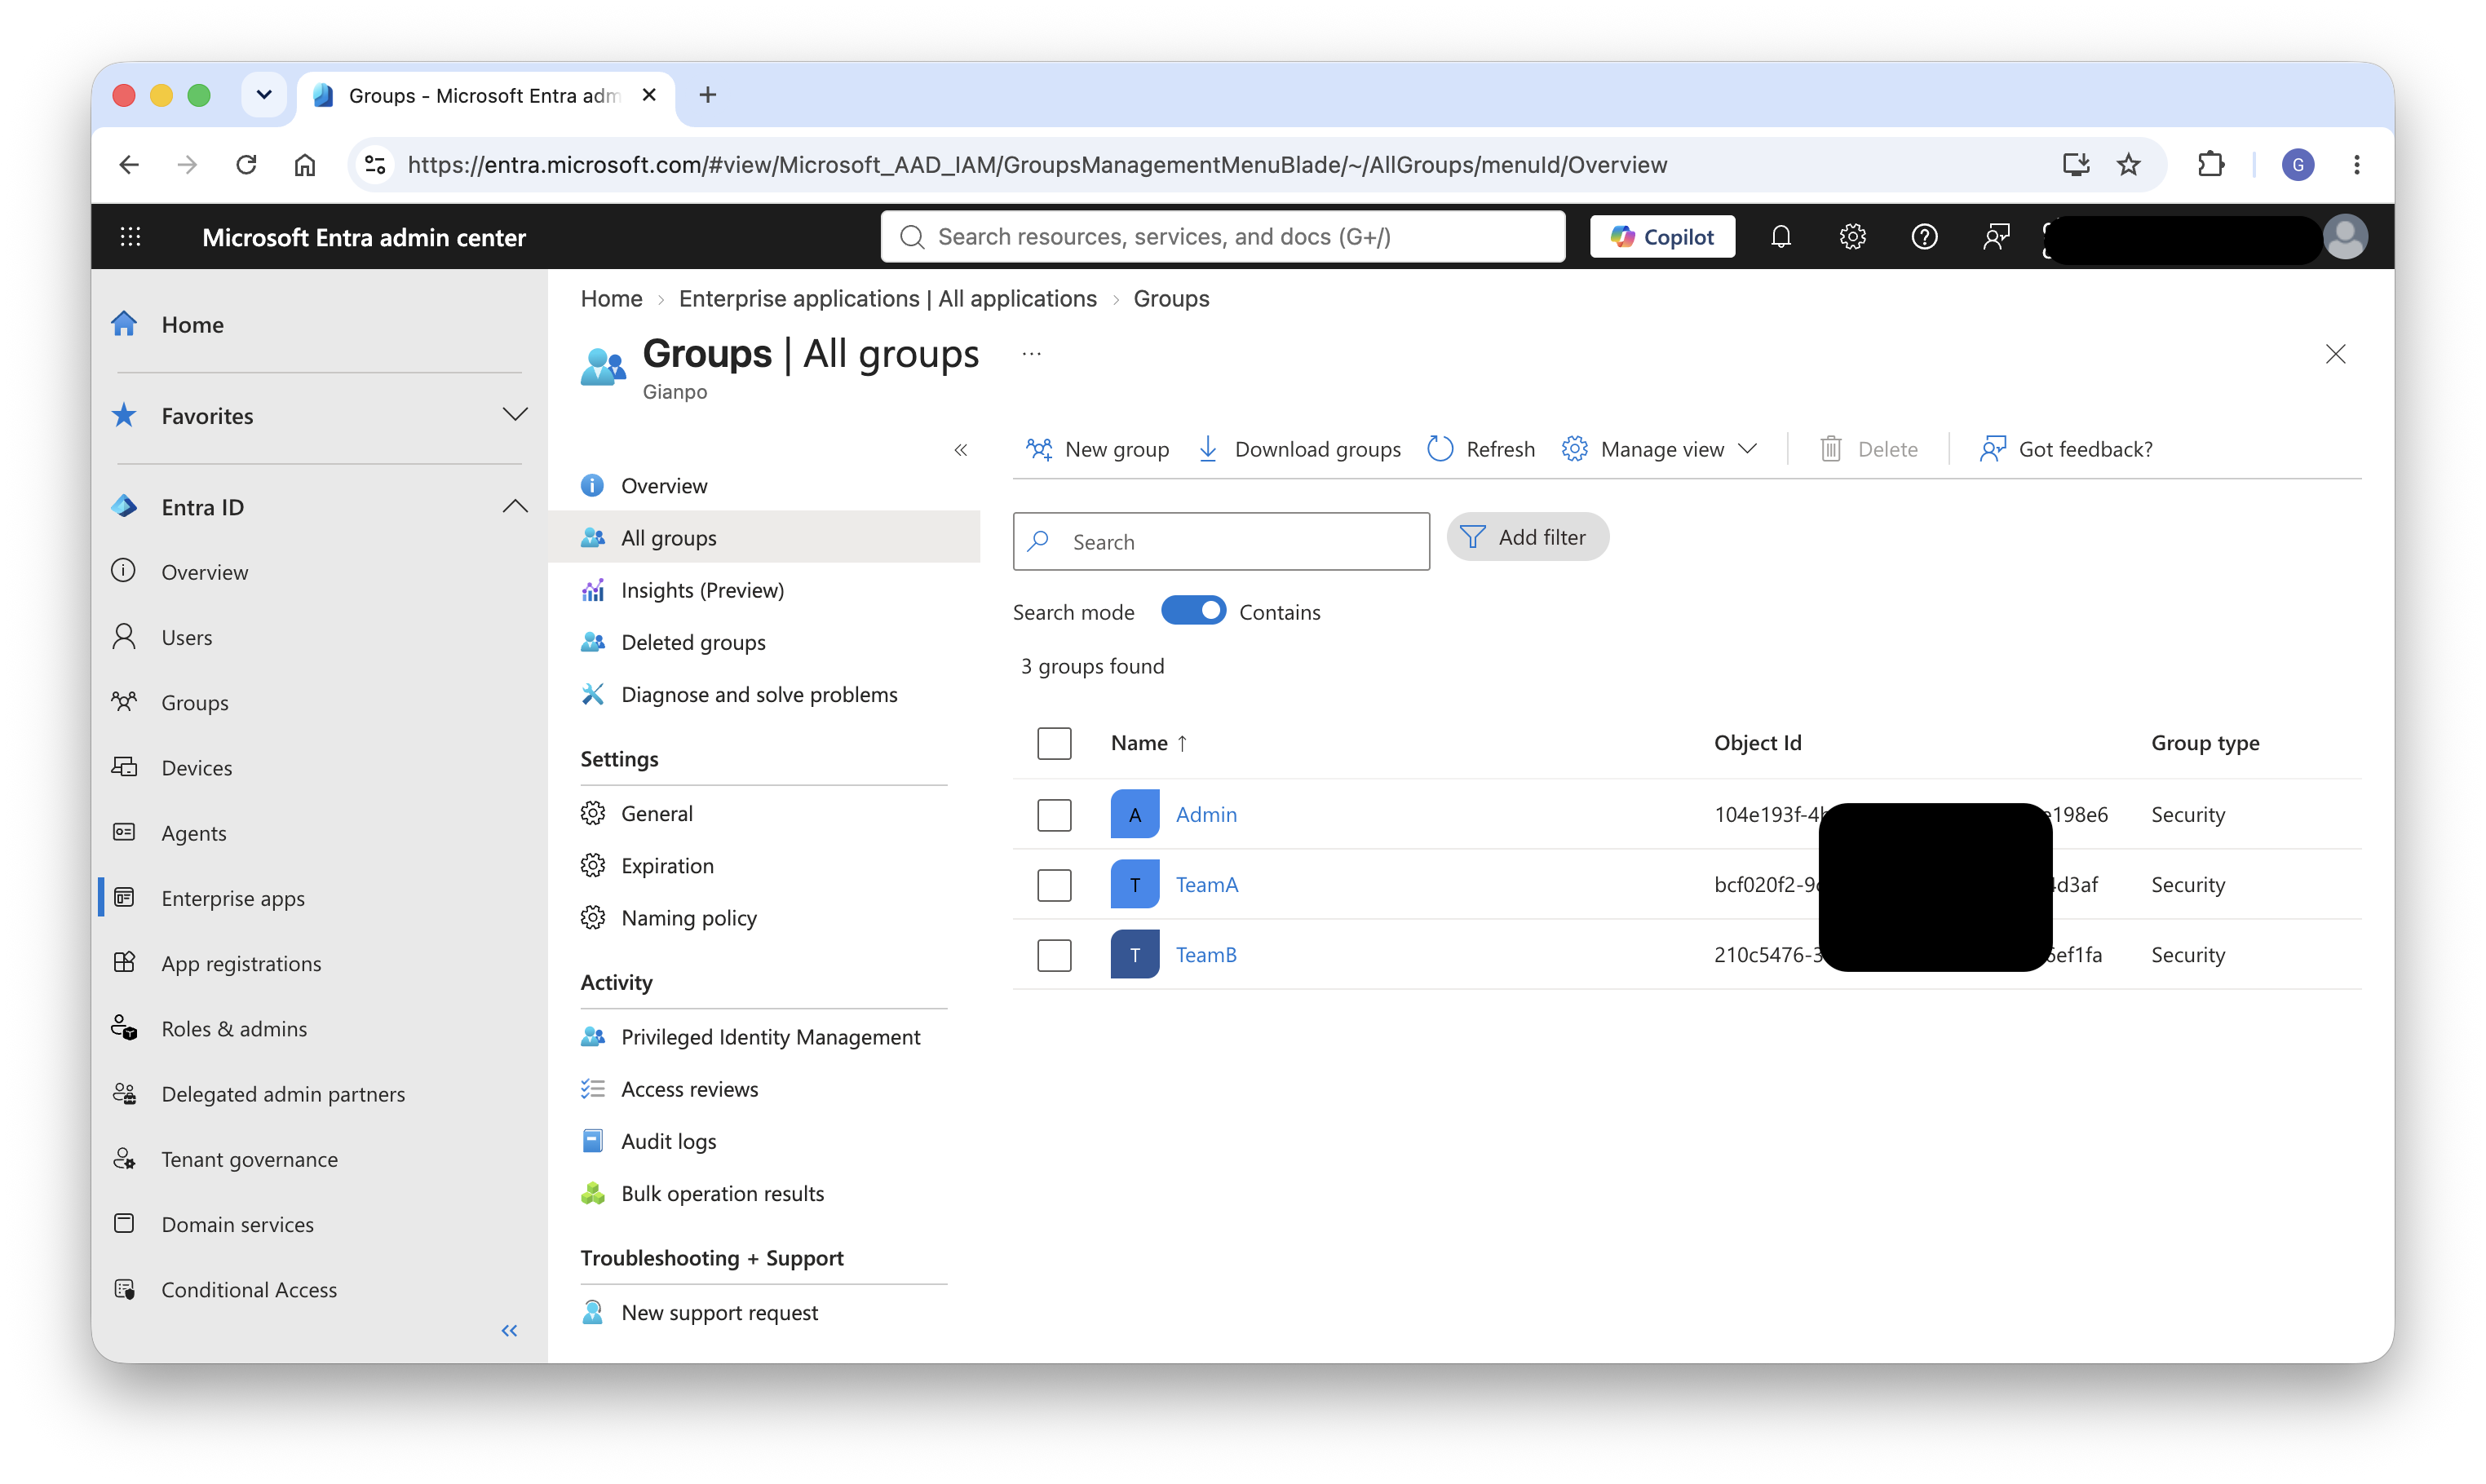
图 2:在 Microsoft Entra ID 中表示为组的组织团队
然后,下图展示了 AWS IAM Identity Center 中对应的组,这些组通过 SCIM 同步从 Entra ID 自动预配。
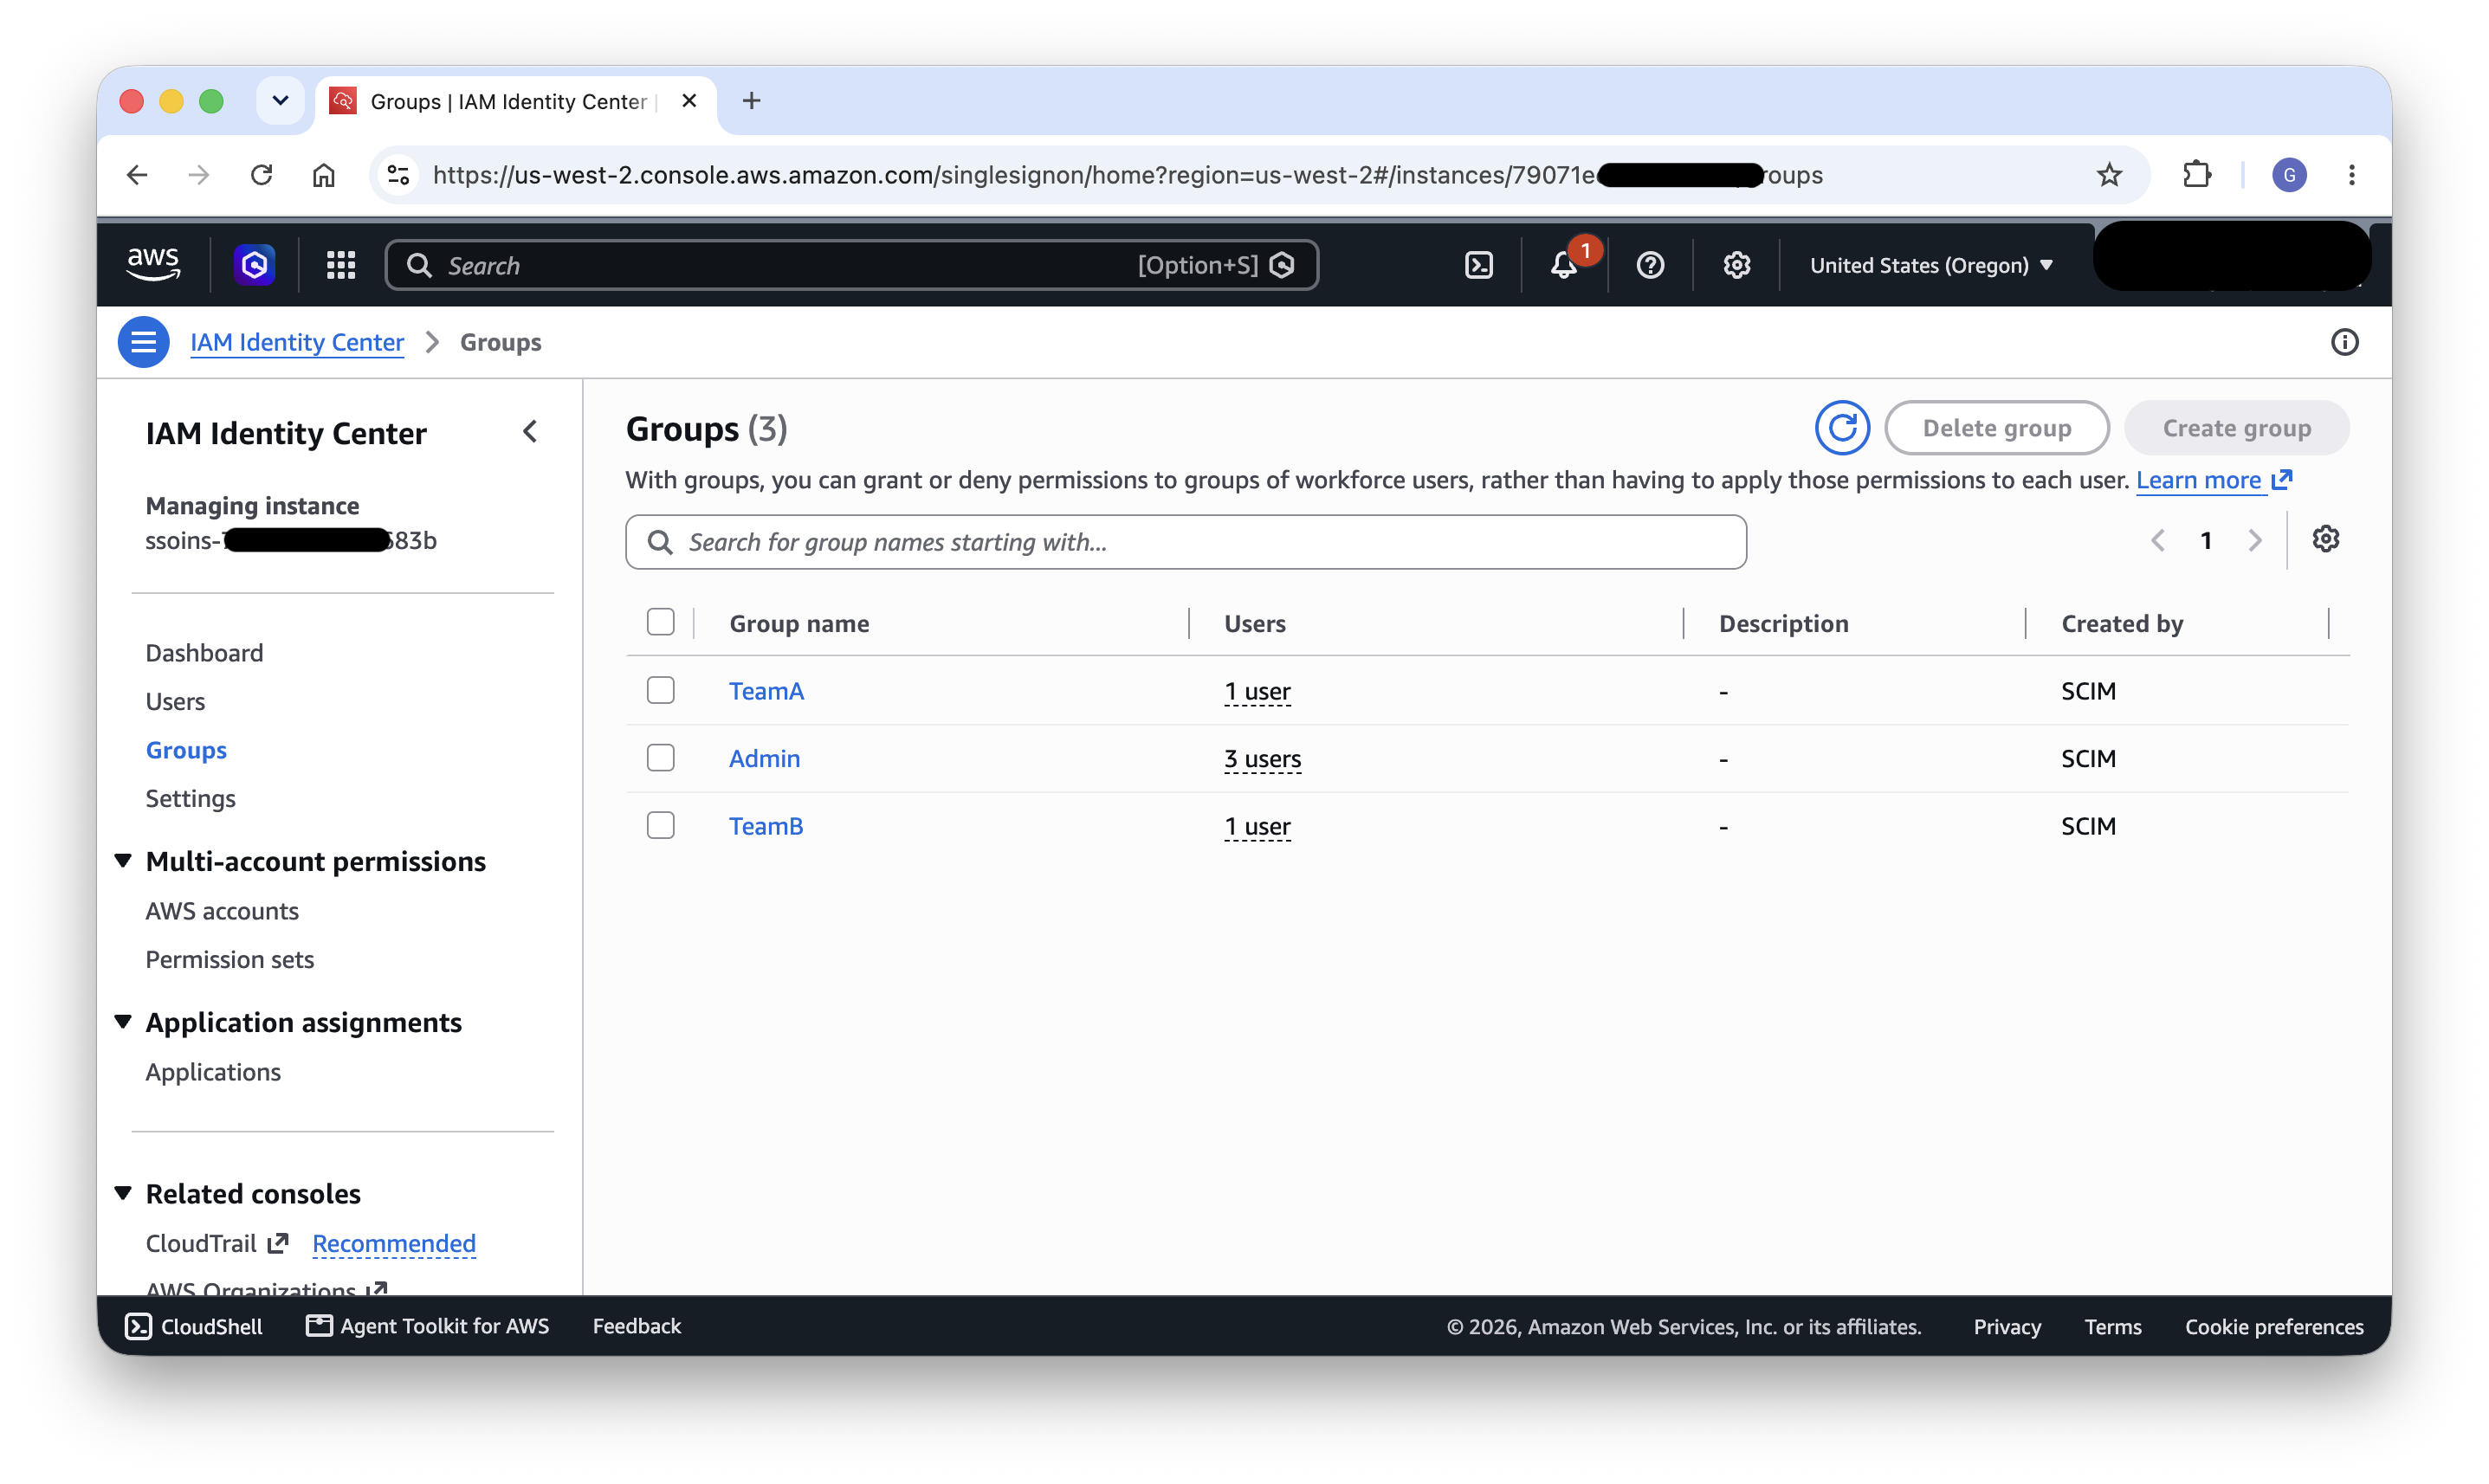
图 3:AWS IAM Identity Center 中通过 SCIM 预配的对应组
了解更多:连接外部身份提供商 · SCIM 配置文件和 SAML 2.0 实现
授权
身份验证建立后,下一层是授权:控制每个团队可以在 AWS 服务和 Kubernetes 集群上执行哪些操作。此架构中的授权在两个级别运作:用于服务级访问的 IAM,以及用于集群级访问的 Kubernetes RBAC。
按团队的 IAM 角色
每个团队都需要一个专用的 IAM 角色,用于封装其 AI 和机器学习(ML)工作流所需的 AWS 级别权限。这些角色充当 SageMaker AI 域执行角色,并定义团队可以访问哪些 AWS 服务。
一个典型的团队 IAM 角色应包含授予以下访问权限的策略:
- Amazon SageMaker AI – 用于通过 SageMaker AI API 管理 HyperPod 集群、MLflow 跟踪服务器和其他 SageMaker AI 资源。
- Amazon S3 – 用于读取训练数据集并写入模型产物、检查点和日志。将这些权限限定到团队特定的存储桶前缀。
- Amazon CloudWatch – 用于查看与团队工作负载相关的日志和指标。
- Amazon EKS – 具体来说,是
eks:AccessKubernetesApi和eks:MutateViaKubernetesApi权限,SageMaker Studio GUI 需要这些权限来代表用户进行 Kubernetes API 调用(例如,列出 Spaces 或提交作业)。
每个 IAM 角色上的信任策略必须包含 sagemaker.amazonaws.com 作为受信任主体,以便 SageMaker AI 在用户通过 Studio 操作时代表用户代入该角色。如果你计划将同一执行角色复用为集群内工作负载的 EKS Pod Identity 关联(如后文 Amazon S3 存储部分所述),则信任策略还必须包含 pods.eks.amazonaws.com 作为受信任主体。通过 Identity Center 进行的 CLI 访问使用具有自己策略的单独权限集(请参阅“通过 Identity Center 访问 AWS 账户”部分),因此 CLI 权限可以独立限定范围。
通过 Identity Center 访问 AWS 账户
除了 SageMaker Studio 之外,团队通常还需要直接访问 AWS 账户以进行 CLI 操作,例如运行 kubectl 命令、编写工作流脚本或以编程方式访问资源。Identity Center 权限集提供了此能力。
对于 Admin 组,根据贵公司政策的要求分配具有管理访问权限的权限集,授予集群管理和管理操作所需的账户访问权限。
对于 Team A 和 Team B,创建带有内联或托管策略的权限集,直接授予 CLI 工作流所需的权限。典型的团队权限集包括 eks:AccessKubernetesApi 的权限(用于从 AWS 控制台查看 Kubernetes 资源)、团队数据的限定范围 S3 访问权限,以及用于监控的 CloudWatch 读取访问权限。这些策略独立于 Studio 执行角色定义,因此管理员可以根据团队从命令行执行的具体操作来定制 CLI 权限。
用户通过 AWS 命令行界面(AWS CLI)使用 aws sso login 获取临时凭证,然后可以使用这些凭证配置 kubectl,以便直接与 EKS 集群交互。
下图显示了 AWS IAM Identity Center 中按团队划分的权限集,为 CLI 工作流(例如针对 EKS 集群运行 kubectl 和 aws sso login)提供限定范围的 AWS 账户访问权限。
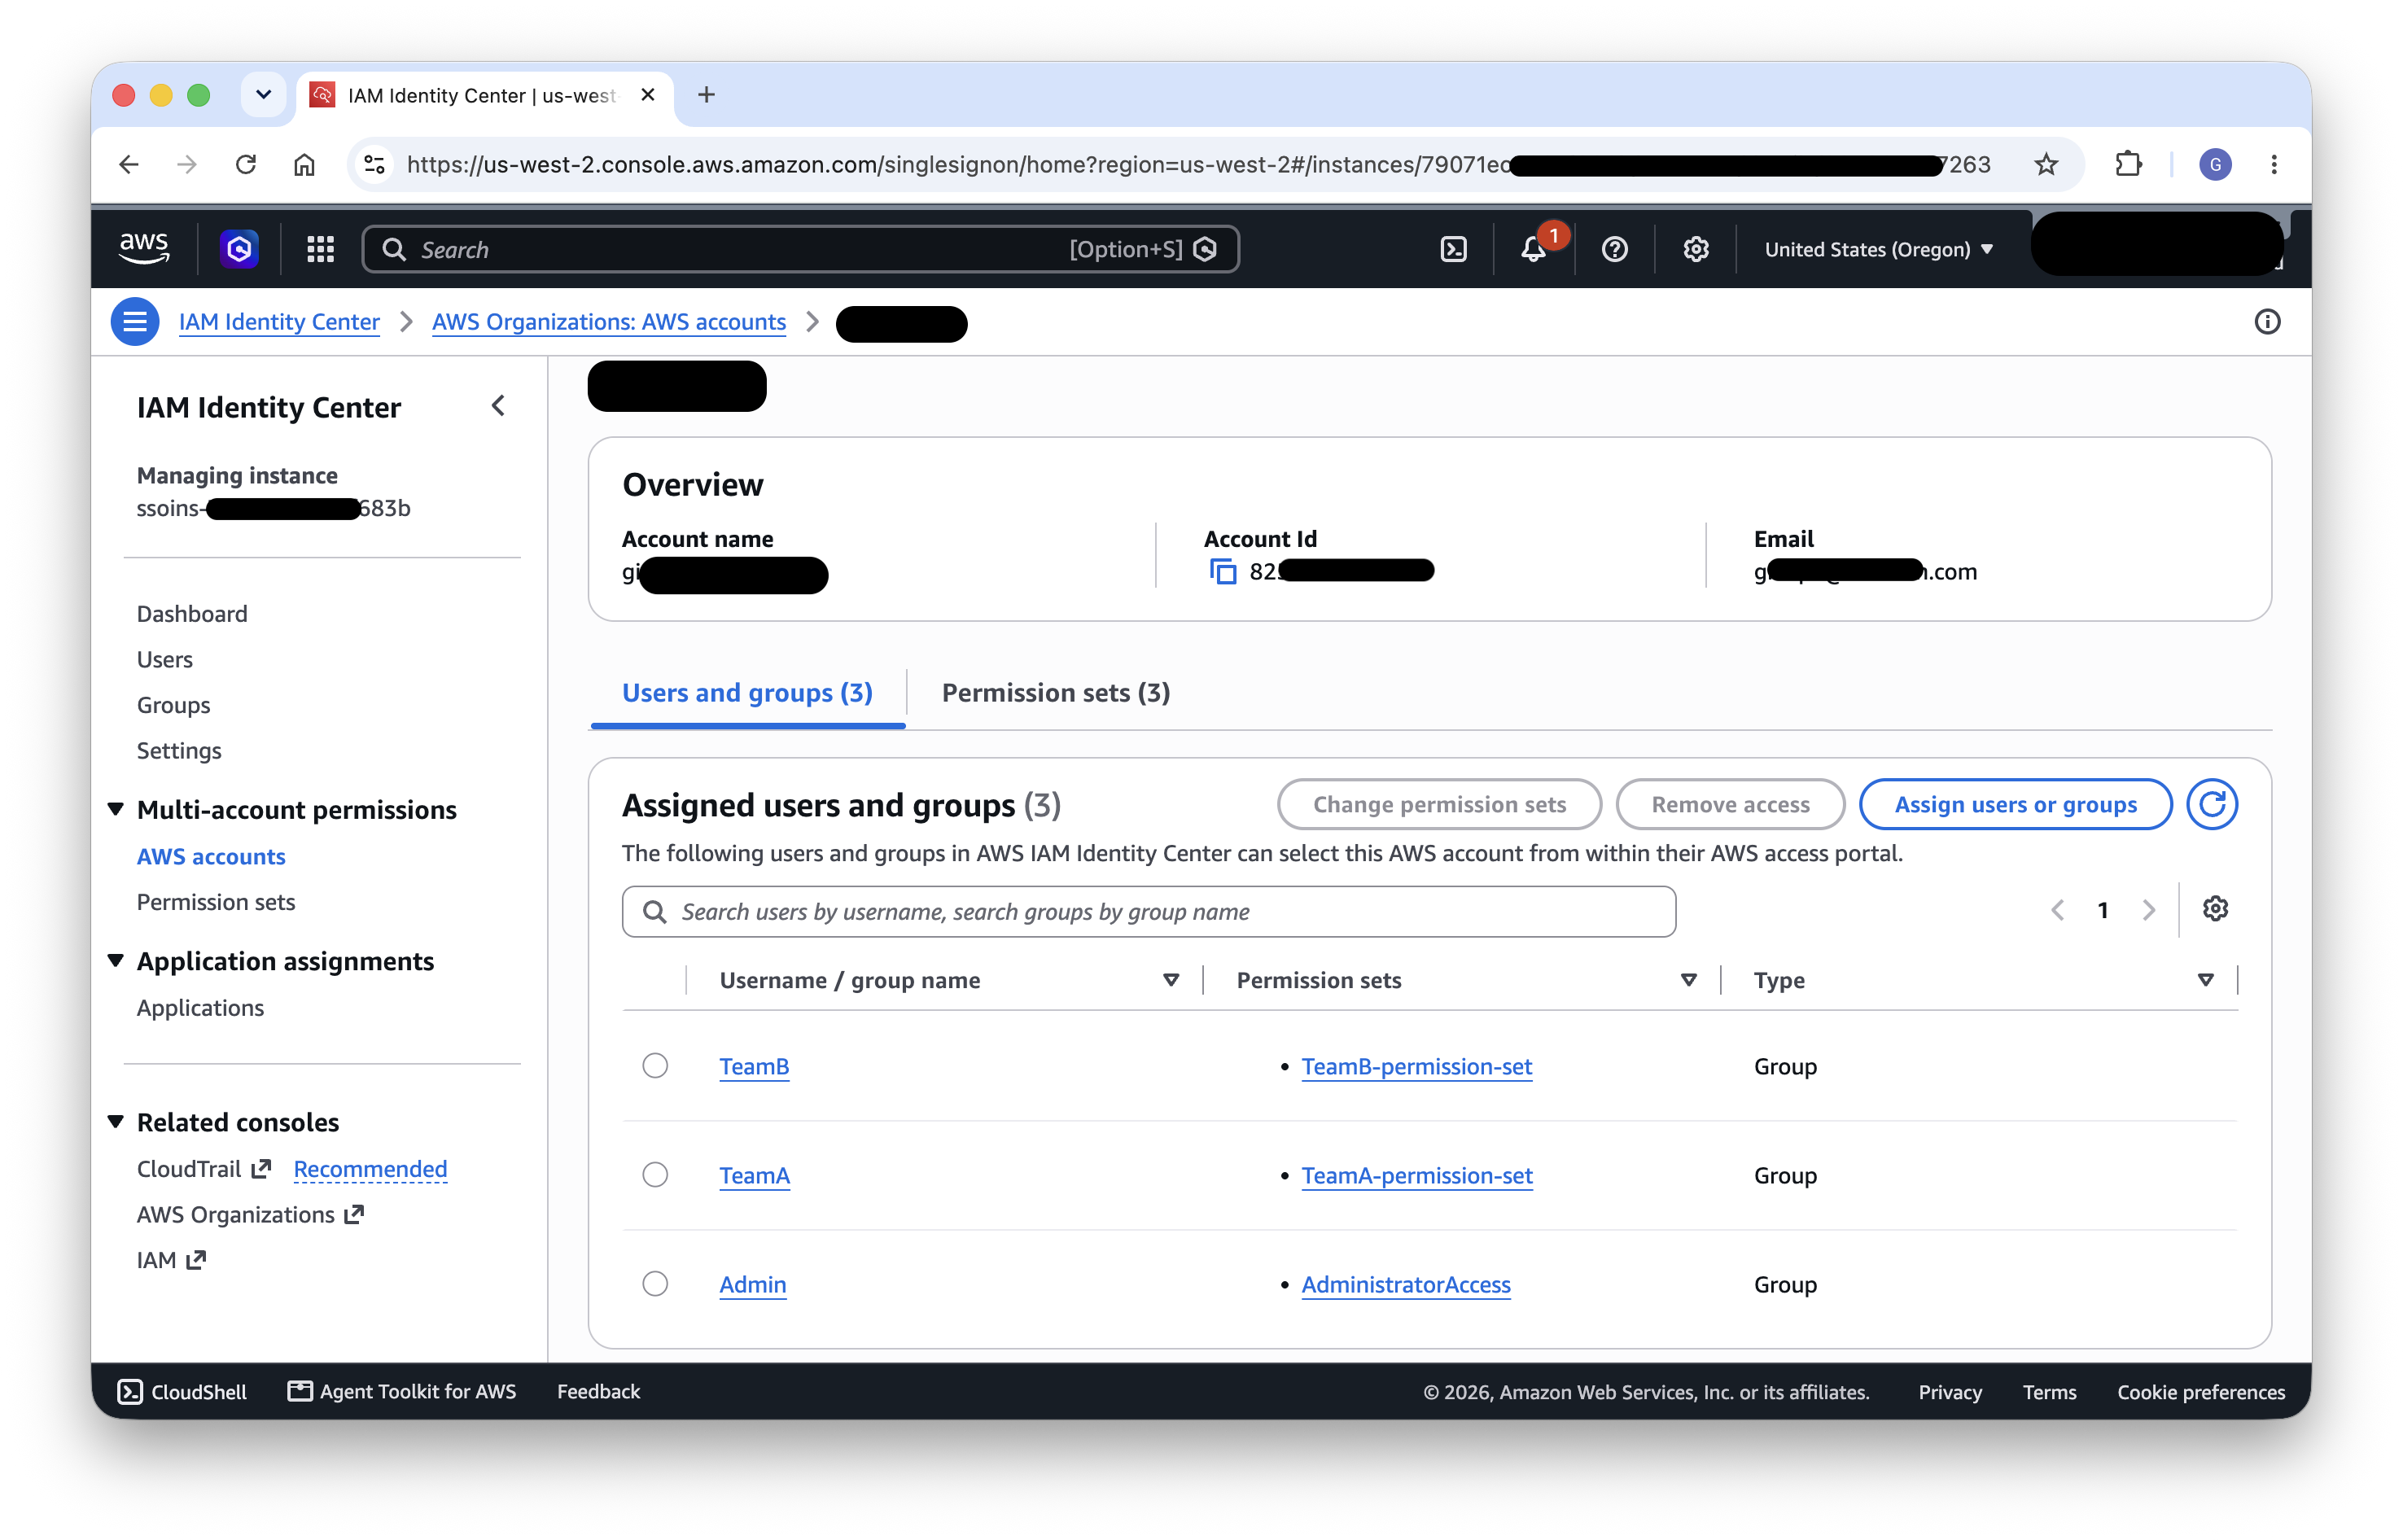
图 4:AWS IAM Identity Center 中用于 CLI 工作流的按团队权限集
了解更多:使用权限集管理 AWS 账户
配置 AWS CLI
团队成员通过运行 aws configure sso 来配置 AWS CLI,使其通过 Identity Center 进行身份验证。这会在 ~/.aws/config 中创建配置文件,这些配置文件引用相应的 Identity Center 会话和权限集。每个团队成员在从命令行与集群交互时使用其团队专属的配置文件,无论访问来自 Studio 还是本地终端,都能维持授权边界。
生成的配置为 Identity Center 门户定义了一个共享的 sso-session 块,并为每个团队定义了一个命名配置文件,每个配置文件都指向该团队的权限集。然后,团队成员运行 aws sso login --profile <team> 来获取限定在其权限集范围内的临时凭证:
[sso-session my-sso]
sso_start_url = https://d-xxxxxxxxxx.awsapps.com/start
sso_region = us-west-2
sso_registration_scopes = sso:account:access

[default]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = OpsAdmin
region = us-west-2

[profile team-a]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamA-permission-set
region = us-west-2

[profile team-b]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamB-permission-set
region = us-west-2了解更多:使用 AWS CLI 配置 IAM Identity Center 身份验证
SageMaker AI 域
SageMaker AI 域为每个团队提供工作空间边界,提供量身定制的用户体验、预配置的执行角色,以及与 Identity Center 身份验证的内置集成。
为什么使用 SageMaker AI 域
为每个团队使用一个 SageMaker AI 域是组织多团队环境的成熟模式。这种方法具有多项优势:
- 成熟的多团队模式 – AWS 已广泛记录了这种方法,用于通过多个域分离业务线或团队,使其成为经过验证且受支持的配置。
- 原生 Identity Center 身份验证 – 每个域都可以配置 Identity Center 身份验证,这意味着用户通过其企业身份提供商登录一次,即可直接进入其团队的 Studio 环境。
- 内置团队配置 – 域已经提供了为用户和团队指定配置的机制,无需额外的自定义实体。例如,团队执行角色等设置可以在域级别指定,并在用户配置文件级别覆盖,以实现最大灵活性。
- 导航自定义 – 通过域设置,管理员可以隐藏与团队工作流无关的导航项,呈现为 HyperPod 用例量身定制的聚焦界面。
了解更多:SageMaker AI 域实体和状态 · 多域概述
设置按团队划分的域
为每个团队创建一个使用 Identity Center 身份验证的 SageMaker AI 域。在我们的示例中,我们创建 TeamA-domain 和 TeamB-domain。每个域的配置如下:
- 默认执行角色 – 将域的默认执行角色设置为授权步骤中创建的团队专属 IAM 角色。因此,通过 Studio 执行的所有操作都会继承相应的权限。
- Identity Center 组分配 – 将相应的 Identity Center 组(例如
TeamA组)添加到域中。这会为该组的所有成员激活 SageMaker Studio 应用程序,授予他们访问 Studio 界面的权限。 - 应用程序分配验证 – 配置组访问权限后,在 Identity Center 中查看应用程序分配,以确认正确的组已映射到正确的域。
- 导航自定义 – 为每个域配置默认导航设置,仅呈现相关功能。例如,您可以隐藏与 HyperPod 工作流无关的项,提供简化的以 HyperPod 为中心的用户体验,从而减少只需使用 HyperPod 资源的团队成员的认知负担。
下图展示了 SageMaker AI 控制台,每个团队一个域(TeamA-domain 和 TeamB-domain),每个域都提供隔离的工作区边界。
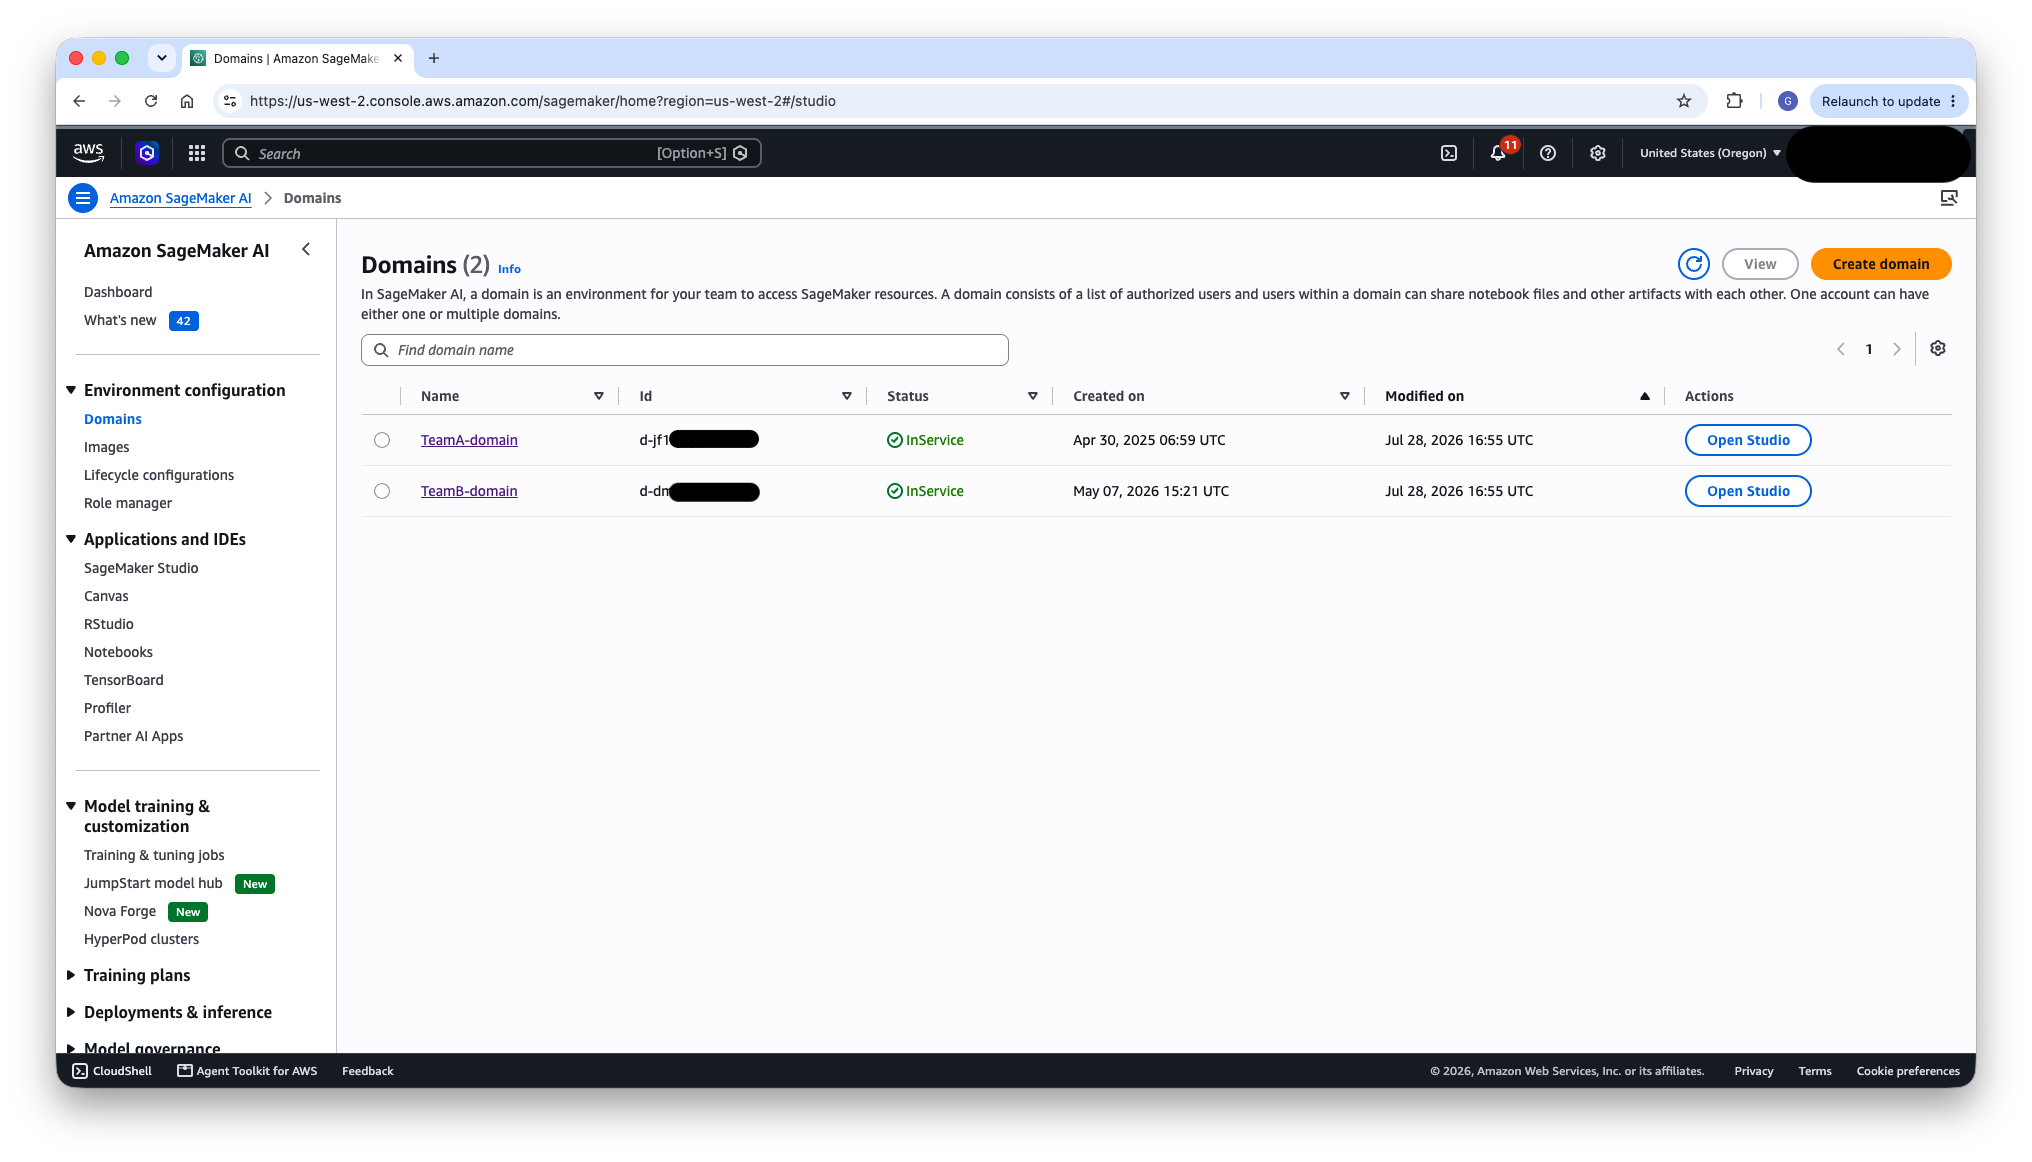
图 5:SageMaker 控制台中每个团队一个 SageMaker 域
接下来的图片展示了 TeamA-domain 的详细信息,包括已分配的 Identity Center 组。
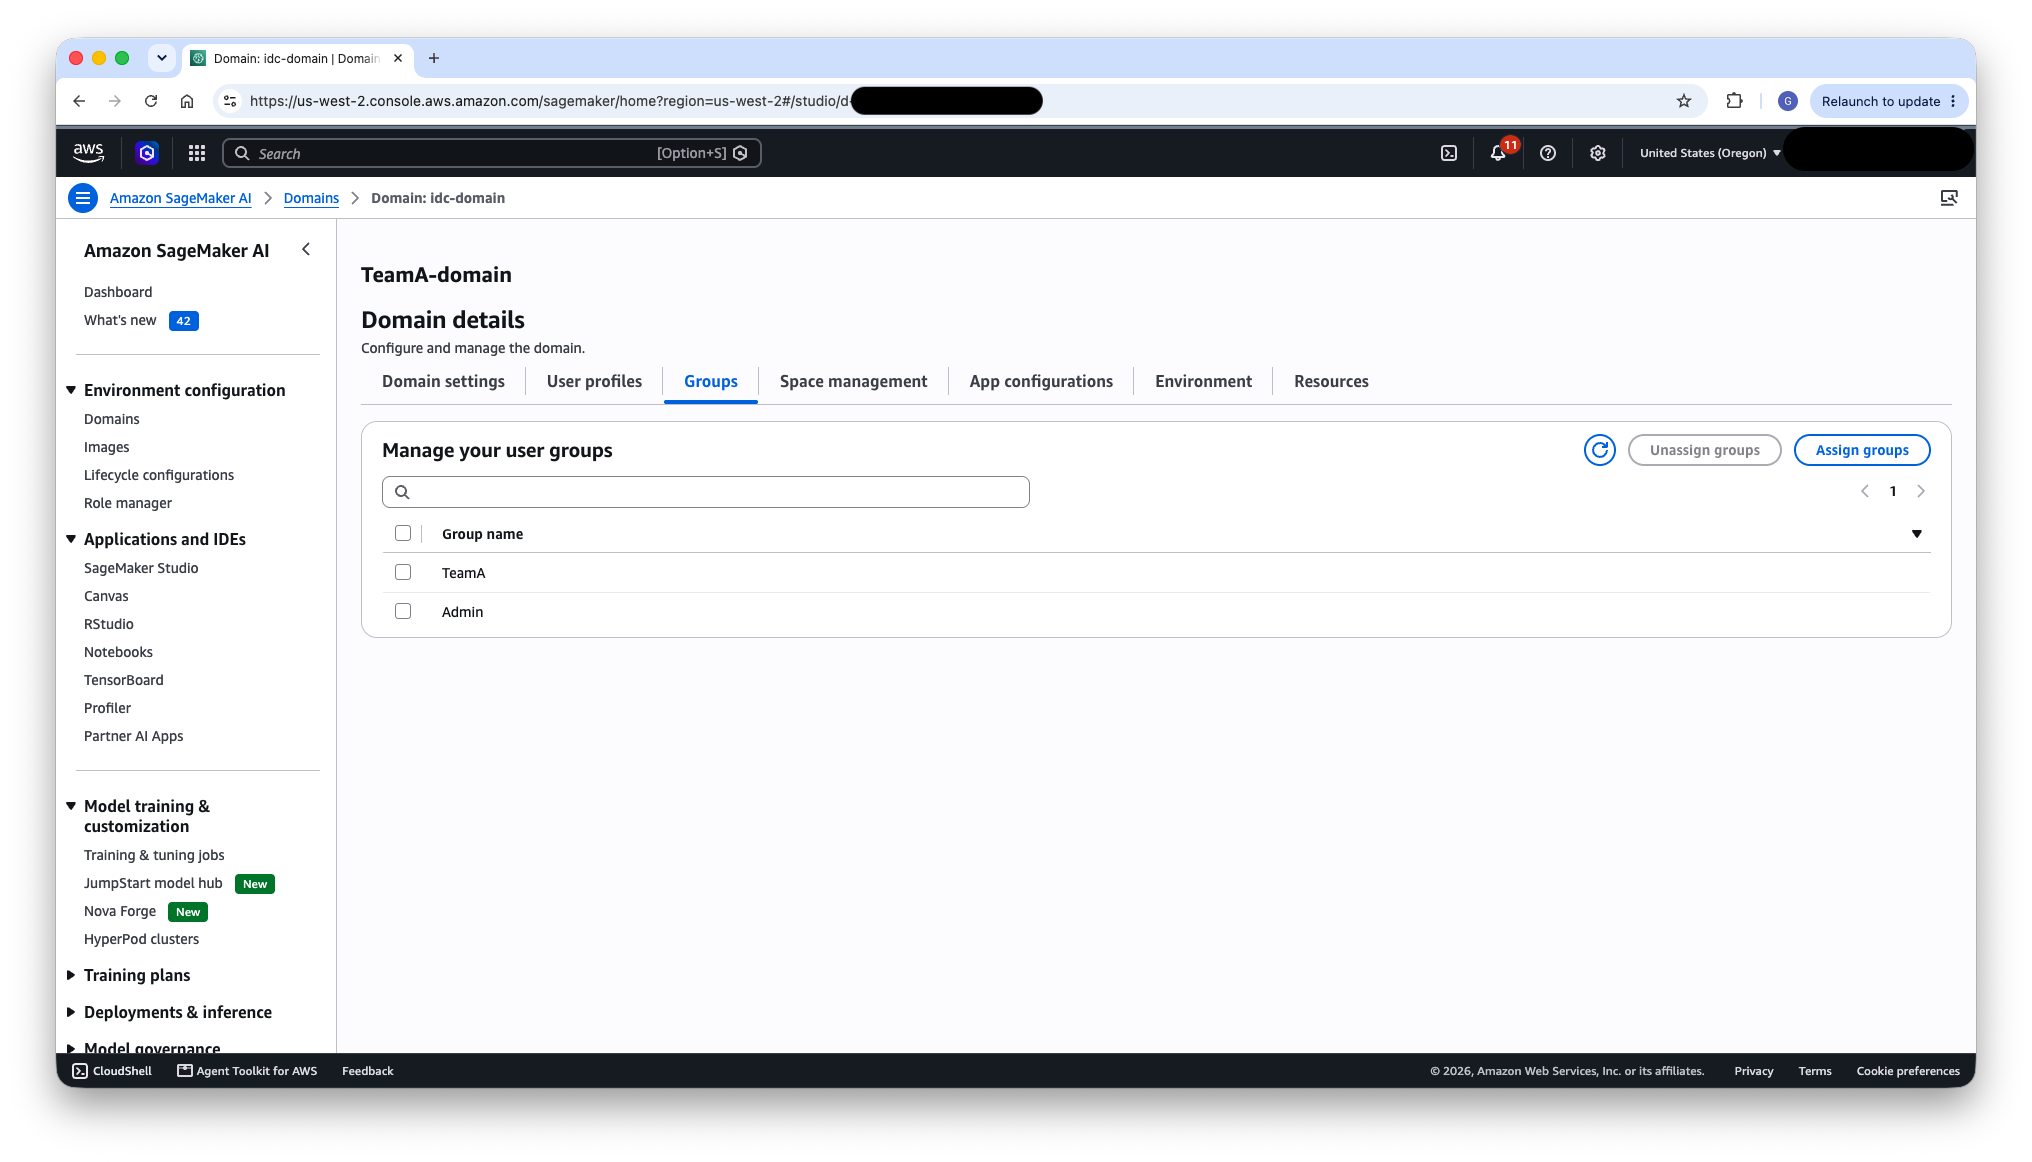
图 6:TeamA 域的配置及其已分配的 Identity Center 组
HyperPod EKS 集群配置
HyperPod EKS 集群是执行工作负载的地方。集群级别的多租户通过 Kubernetes 命名空间实现隔离,并通过 EKS 访问条目实现授权。
命名空间隔离
为每个团队创建一个专用的 Kubernetes 命名空间,例如 hyperpod-ns-team-a 和 hyperpod-ns-team-b。命名空间在集群内提供逻辑边界,将每个团队的工作负载(Spaces、训练作业、推理端点)彼此隔离。
注意:命名空间是隔离边界,而非硬性安全边界。此架构面向单一组织内的多团队:即在共同管理域和相互信任基线之下共享集群的团队。它并非为互不信任的租户之间的多客户隔离而设计。
命名空间、RBAC 和配额可防止意外干扰(团队覆盖彼此的资源或超出其计算分配),但无法防御蓄意恶意租户:命名空间中的 Pod 共享相同的节点和内核,而集群范围的资源(节点、
PersistentVolumes、CRD、部分 operator 组件)位于任何命名空间之外。对于不受信任的租户或严格的监管隔离,请使用更强的边界,例如独立的集群或账户、专用节点池以及运行时沙箱。对于此处的多团队场景,命名空间隔离结合 RBAC、Task Governance 配额以及后文所述的 POSIX 身份控制,可在隔离性与运维简便性之间取得适当平衡。
命名空间可以使用 kubectl create namespace 手动创建,也可以通过 HyperPod Task Governance 自动预置,后者将命名空间作为其配额和调度配置的一部分进行管理。
下图展示了集群命名空间(由 HyperPod Task Governance 管理),每个团队一个专用命名空间(hyperpod-ns-team-a 和 hyperpod-ns-team-b),提供工作负载隔离。
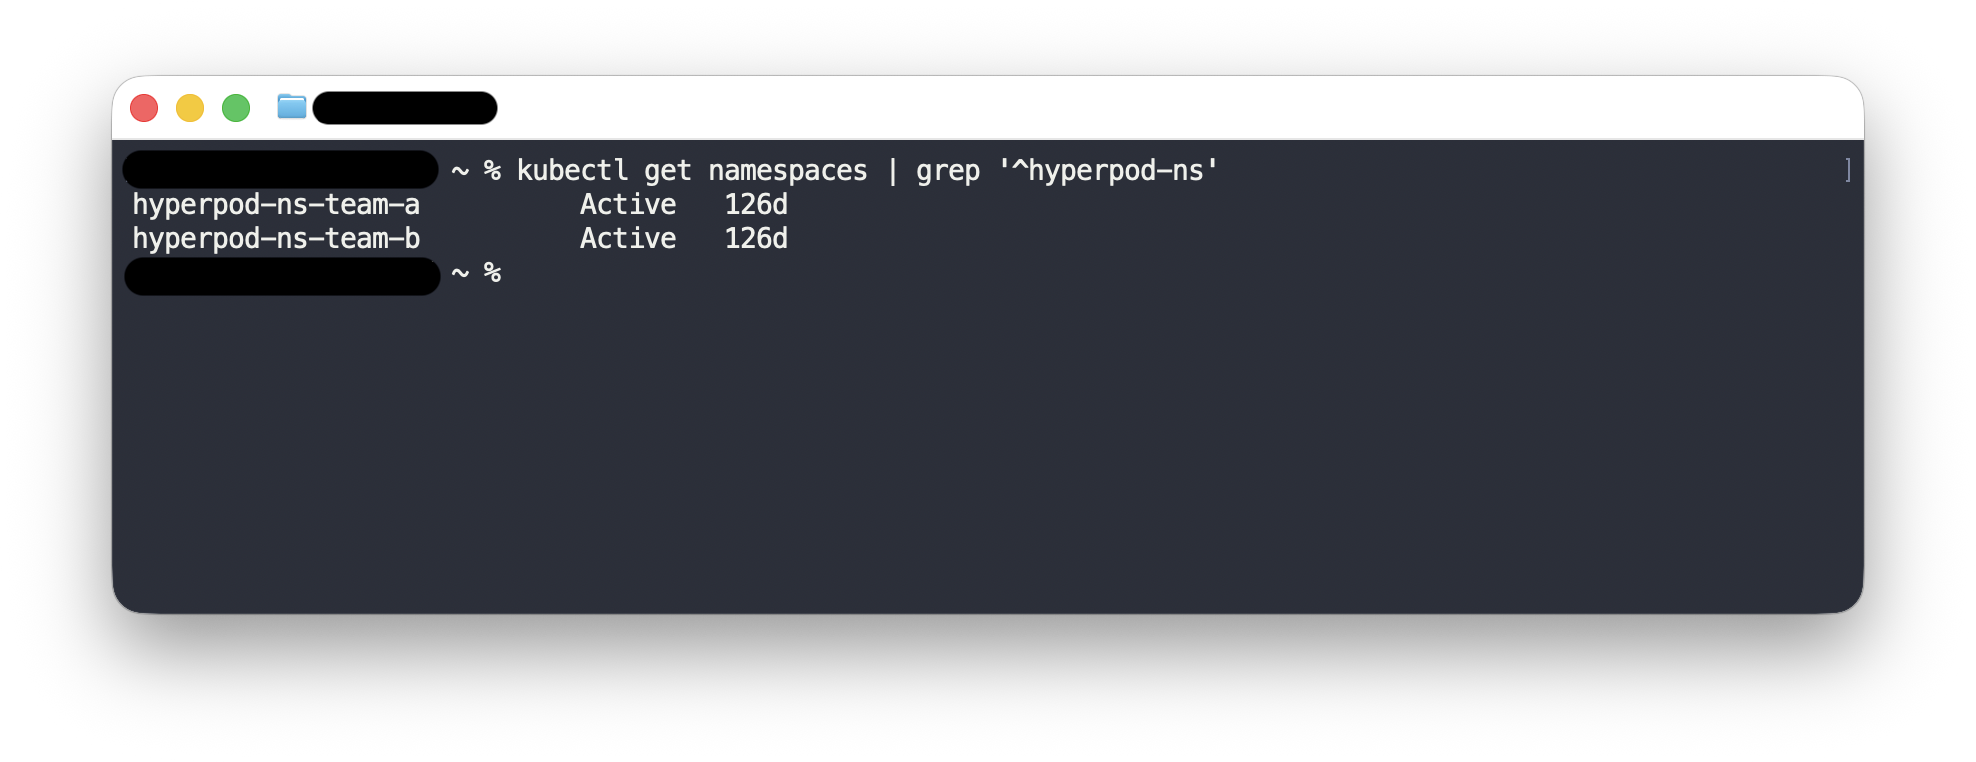
图 7:每个团队一个专用 Kubernetes 命名空间以实现工作负载隔离
了解更多:Kubernetes 命名空间
网络隔离
命名空间不会限制网络流量。默认情况下,Kubernetes 网络是扁平的:每个 Pod 都可以跨所有命名空间访问其他任何 Pod。因此,除非添加控制措施,hyperpod-ns-team-a 中的 Pod 可以打开与 hyperpod-ns-team-b 中 Pod 的连接。要按团队边界限定 Pod 到 Pod 的可达性,请使用 Kubernetes NetworkPolicy 资源。
推荐模式是每个命名空间采用默认拒绝:首先拒绝所有入站流量(可选地拒绝出站流量),然后明确允许每个团队所需的流量,通常是命名空间内通信加上所需的出站流量,例如 DNS、存储端点和 AWS API。以下示例拒绝团队命名空间中的所有入站流量,然后仅允许来自同一命名空间内 Pod 的流量:
# 1. Default-deny all ingress in the team's namespace.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}  # applies to all pods in the namespace
  policyTypes:
  - Ingress
---
# 2. Allow ingress only from pods within the same namespace.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-same-namespace
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector: {}  # any pod in this namespace
NetworkPolicy 的执行依赖于支持它的容器网络接口(CNI)。在 EKS 上,您可以在 Amazon Virtual Private Cloud(Amazon VPC)CNI 中启用网络策略支持。
与命名空间一样,NetworkPolicies 可以减少意外的跨团队可达性并缩小范围,但它们本身并不是共享节点上的对抗性安全边界。如需更强的隔离,如前所述,可考虑为每个团队使用专用节点池或独立集群。
了解更多:Kubernetes 网络策略 · Amazon VPC CNI 网络策略
EKS 访问条目
EKS 访问条目将 IAM 主体连接到 Kubernetes RBAC 权限。为每个团队创建两个访问条目:
- Studio 访问条目 – IAM 主体是该团队的 SageMaker AI 域执行角色。当操作源自 SageMaker Studio GUI 时使用此条目。
- CLI 访问条目 – IAM 主体是 Identity Center 为该团队权限集创建的 SSO 预置角色(遵循
AWSReservedSSO_<permission-set-name>_<unique-id>模式)。当用户通过kubectl与集群交互时使用此条目。
两个条目都通过托管或自定义 Kubernetes 策略限定到团队的命名空间。例如,Team A 的两个条目都仅在 hyperpod-ns-team-a 内授予权限。如果需要,这两个条目可以携带不同的 RBAC 策略。例如,CLI 条目可能限制对某些资源类型的写入访问,而 Studio 条目允许完全访问。
通过这种范围限定,无论访问源自 Studio 还是 CLI,用户都只能与其自己命名空间中的资源交互。尝试列出或修改另一个团队命名空间中的资源会导致 Kubernetes Forbidden 错误。
对于更高级的场景,您可以在访问条目中使用 Kubernetes 组,将用户映射到自定义 ClusterRoles 或 Roles,以提供超出标准托管策略的细粒度权限。
下图显示了 Team B 角色的 EKS 访问条目,范围缩小到 hyperpod-ns-team-b 命名空间,因此其权限仅适用于 Team B 的命名空间内。
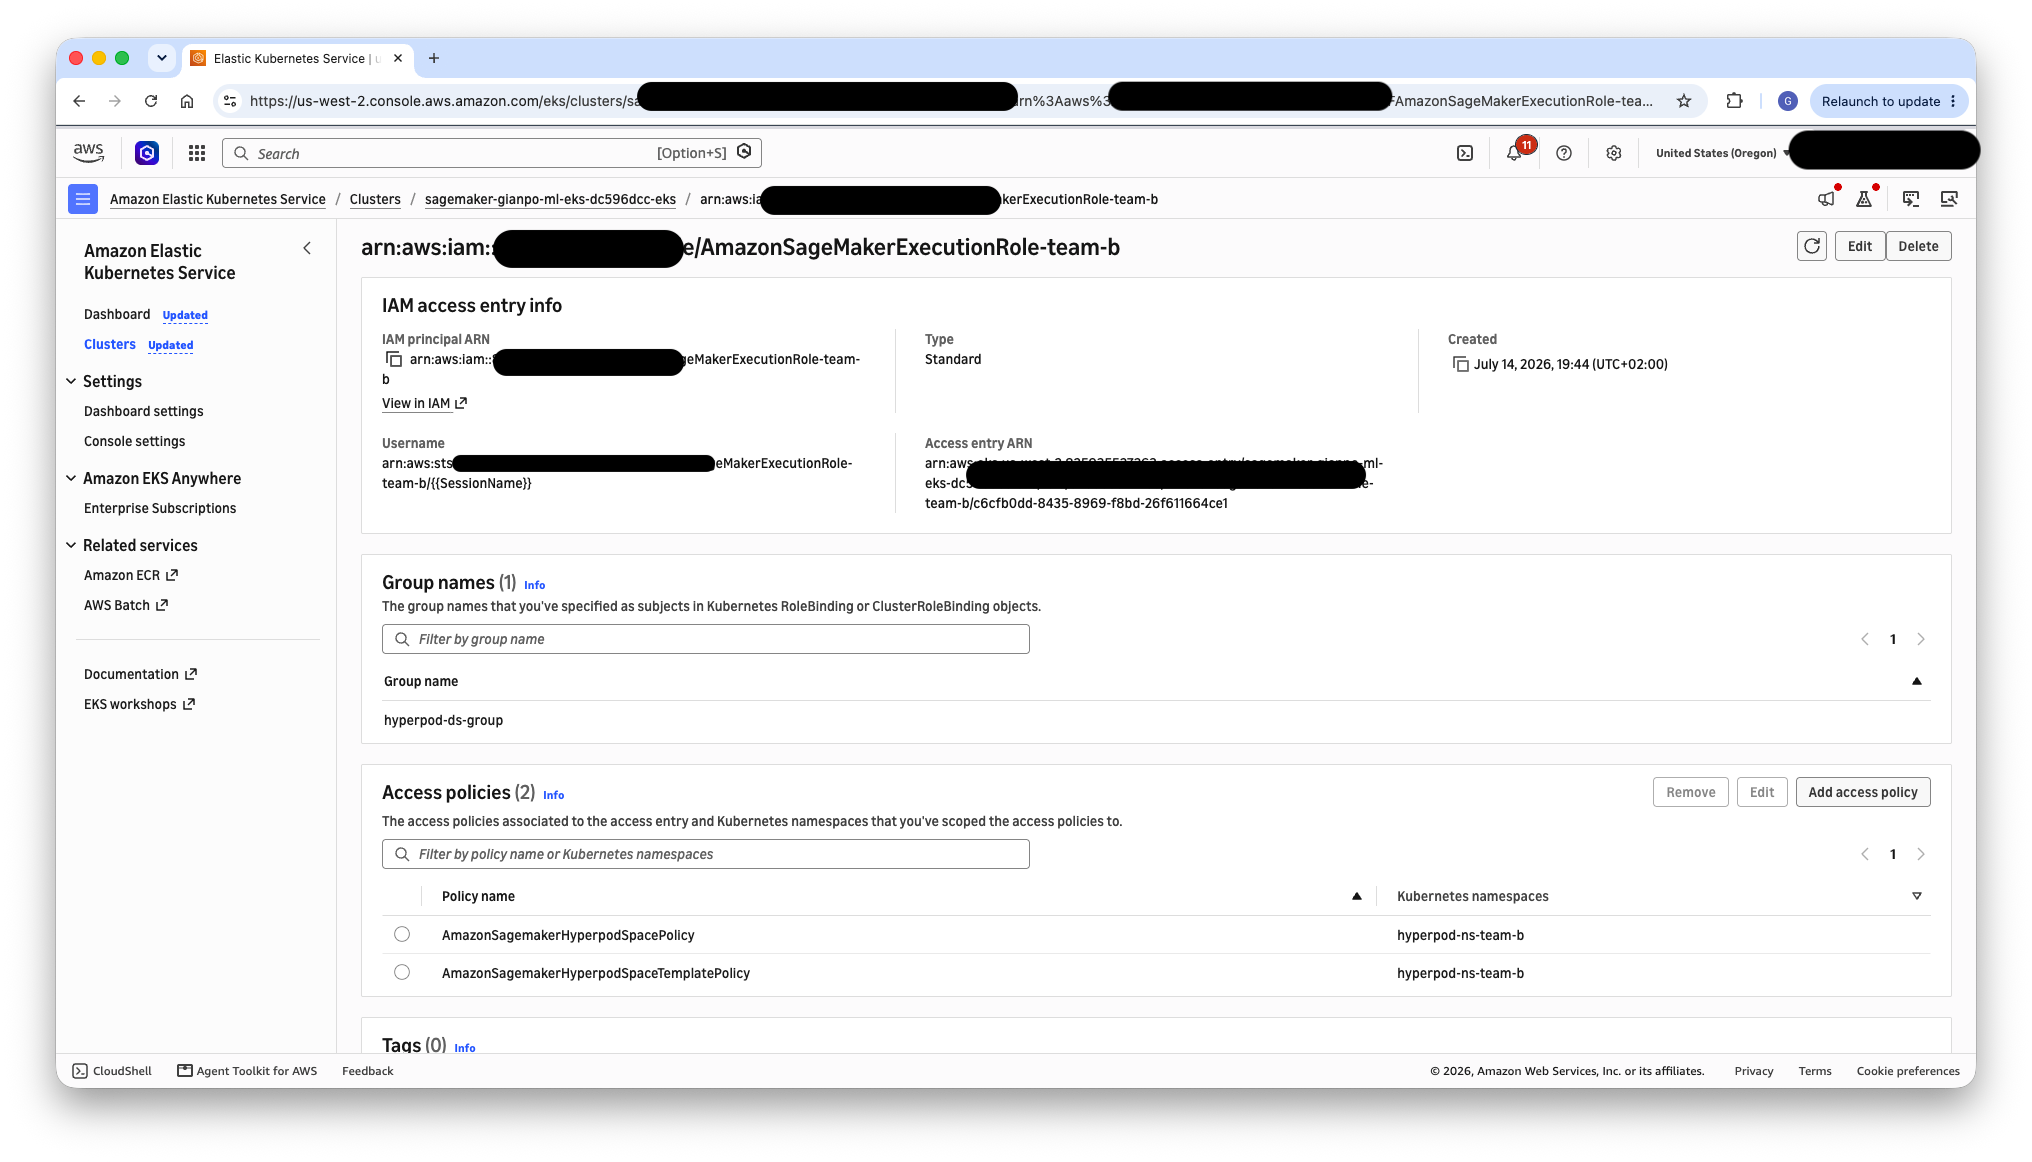
图 8:限定到 Team B 命名空间的 EKS 访问条目
了解更多:使用 EKS 访问条目授予 IAM 用户访问 Kubernetes 的权限
HyperPod 任务治理
在集群上启用任务治理后,它提供了额外的资源管理层:
- 计算配额 – 定义每个团队可以消耗多少 GPU 和 CPU 容量。这可以防止单个团队在训练运行期间独占共享硬件。
- 优先级 – 为每个团队或工作负载类型分配调度优先级,允许关键生产推理工作负载在资源受限时抢占实验性训练作业。
- 公平调度 – 借助任务治理,当多个团队竞争资源时,分配遵循配置的策略,而不是先到先得模型。
为每个团队命名空间配置具有适当配额和优先级的任务治理,在保证最低分配和突发工作负载的突发容量之间取得平衡。
下图显示了两个团队的任务治理计算分配,每个团队的命名空间都分配了自己的集群计算容量配额。
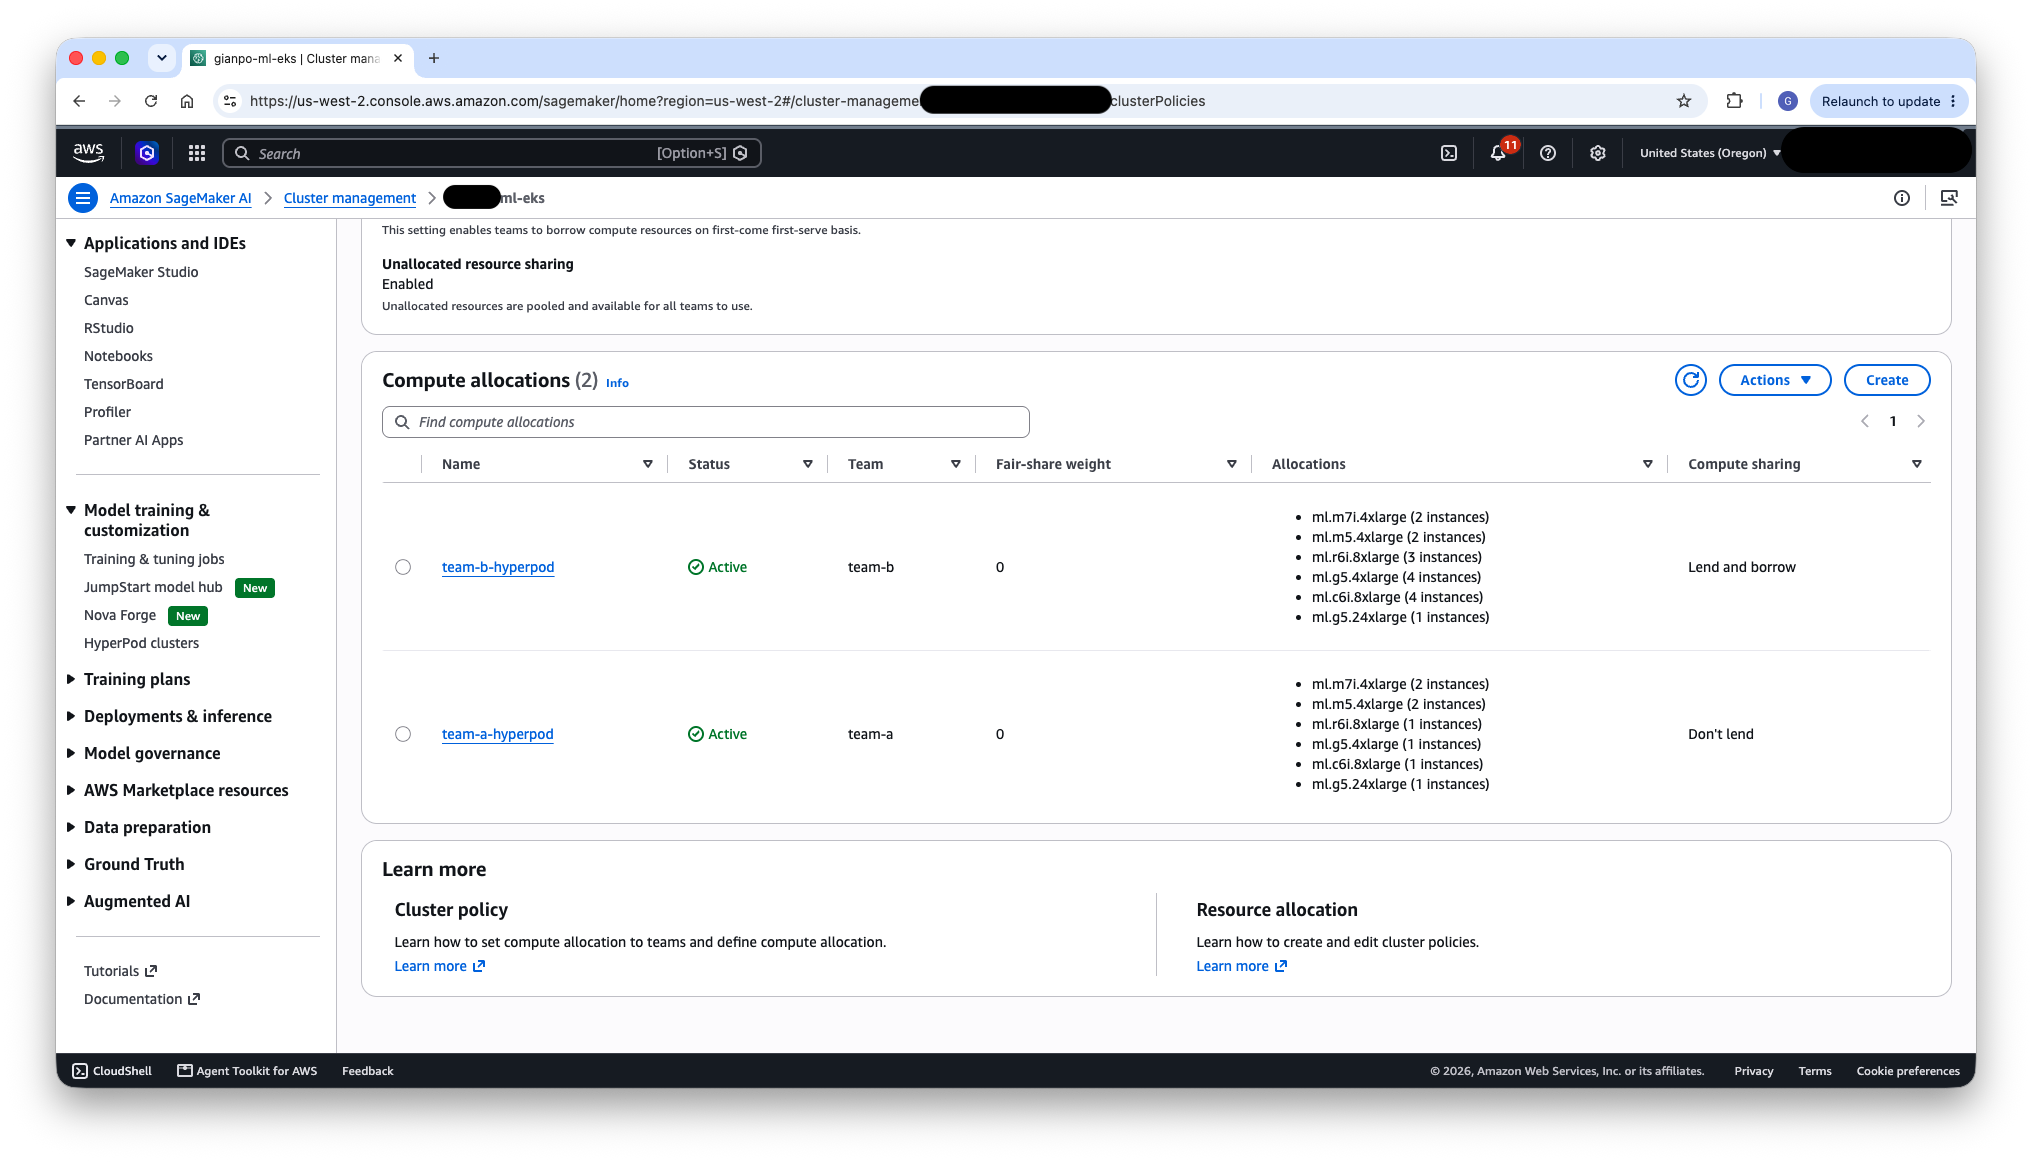
图 9:每个团队命名空间的任务治理计算分配
存储
存储是跨团队共享的人工智能和机器学习(AI/ML)环境的关键组成部分。团队需要高性能文件系统来存储训练数据、检查点和模型产物,同时保持团队之间适当的访问边界。
符合 POSIX 标准的文件系统
对于需要共享、高性能 POSIX 文件系统的工作负载(在分布式训练中很常见,多个节点读取同一数据集或写入检查点),请考虑以下选项:
- Amazon FSx for Lustre – 提供高吞吐量、低延迟的并行文件系统访问,非常适合需要高速读取大型数据集的大规模训练工作负载。
- Amazon FSx for OpenZFS – 提供具有强 POSIX 语义、快照和压缩的通用文件系统。非常适合需要传统文件系统功能以及高性能的工作负载。
- Amazon Elastic File System (Amazon EFS) – 提供完全托管、弹性的网络文件系统 (NFS) 存储。EFS 还支持访问点,通过将不同的挂载点映射到具有强制 UID 和 GID 的不同目录,可以简化按团队隔离目录。
存储布局通常遵循以下结构:
- 按团队共享目录 – 每个团队都有一个共享目录(例如,
/fsx/TeamA、/fsx/TeamB),用于存放所有团队成员都需要访问的数据集、模型和工件。 - 按用户主目录 – 每个用户都有一个个人主目录(例如,
/home/User1、/home/User2),用于个人工作、实验和笔记本。
这些文件系统上的 POSIX 权限模型依赖 UID、GID 和补充组来强制执行访问边界。当用户启动 HyperPod Space 或提交训练作业时,这些 POSIX 身份应传播到 Pod 安全上下文,以便文件系统访问遵循配置的所有权和权限。我们建议使用 Kubernetes 变更准入 Webhook 从您的身份存储中检索 POSIX 身份信息。当提交工作负载时,Webhook 在运行时查找身份并相应地修改 Pod 的安全上下文。
# 1. Extract the caller's session identity from the admission request.
# On EKS, requests from IAM-assumed roles (including IAM Identity Center)
# surface the STS session name in userInfo.extra["sessionName"]. Its format
# depends on how the session is created (e.g., an SSO short name, an email,
# or a role-session-name); align your identity mapping with this value.
def extract_username(admission_request):
    extra = admission_request["userInfo"]["extra"]
    ...
    return extra["sessionName"][0]

# 2. Look up the POSIX identity from a mapping table (e.g. DynamoDB).
def lookup_posix_identity(username):
    item = posix_table.get_item(Key={"username": username})["Item"]
    ...
    return {
        "uid": int(item["uid"]),
        "gid": int(item["gid"]),
        "supplementalGroups": [int(g) for g in item["supplementalGroups"]],
    }

# 3. Patch the Pod security context with the resolved POSIX identity.
def build_security_context_patch(pod, posix):
    ...
    return [{
        "op": "add",
        "path": "/spec/securityContext",
        "value": {
            "runAsUser": posix["uid"],
            "runAsGroup": posix["gid"],
            "fsGroup": posix["gid"],
            "supplementalGroups": posix["supplementalGroups"],
        },
}]了解更多:FSx for Lustre · FSx for OpenZFS · Amazon EFS
Amazon S3 存储
对于对象存储,对 S3 存储桶的访问由团队的 IAM 执行角色控制。您可以创建按团队的存储桶,或使用带有按团队前缀的共享存储桶,依靠 IAM 策略来强制执行隔离。集群中的 Pod 需要配置适当的服务账户,并使用服务账户的 IAM 角色 (IRSA) 或 Pod Identity 向 S3 进行身份验证。为简单起见,您可以将 SageMaker AI 域上配置的同一执行角色关联到团队命名空间内的 Kubernetes 服务账户,从而从 Studio 和集群工作负载提供一致的 S3 访问。
了解更多:服务账户的 IAM 角色 (IRSA) · EKS Pod Identity
HyperPod Spaces
HyperPod Spaces 提供直接在集群节点上运行的交互式开发环境 (IDE)。在共享集群上,Spaces 必须正确限定到每个团队的命名空间,并配置适当的资源模板。
Space 模板
为每个团队创建命名空间范围的 Space 模板。这些模板定义了团队成员在创建 Spaces 时可用的资源配置(实例类型、存储卷、环境变量)。通过将模板限定到命名空间,您可以确保每个团队只能在其指定的边界内启动 Spaces。
启用 HyperPod Task Governance 后,模板应包含治理系统所需的默认标签(例如团队标识符和优先级标签)。集群管理员预先配置这些标签,这样团队成员在启动 Spaces 时就无需手动指定。
以下示例展示了一个限定为 Team A 的 JupyterLab Space 模板。团队特定的部分包括 metadata.namespace、baseLabels 下的 Task Governance 队列标签,以及用于挂载团队共享文件系统和用户主目录的 defaultVolumes:
apiVersion: workspace.jupyter.org/v1alpha1
kind: WorkspaceTemplate
metadata:
  name: jl-smd-custom
  namespace: hyperpod-ns-team-a  # scopes the template to Team A's namespace
spec:
  displayName: "JupyterLab (team-a)"
  description: "SageMaker Distribution"
  appType: jupyterlab
  baseLabels:
  - key: kueue.x-k8s.io/queue-name  # Task Governance (Kueue) local queue for Team A
    value: hyperpod-ns-team-a-localqueue
  ...
  # container command, default CPU/memory resources, security context, access type, etc.
  ...
  defaultVolumes:
  - name: home-dir  # per-user home directory
    mountPath: /home
    persistentVolumeClaimName: fsx-openzfs-claim
  - name: shared-data  # Team A's shared directory
    mountPath: /fsx
    persistentVolumeClaimName: fsx-lustre-claim
  ...
  # primary (EBS) storage defaults and limits
  ...
持久卷声明
在每个团队的命名空间中创建相应的持久卷声明(PVC),引用共享文件系统。这些 PVC 将团队的共享目录和用户的主目录挂载到 Space 中,从而提供对训练数据、检查点和个人工作区的访问。
仅所有者可访问的 Spaces 与共享 Spaces
请考虑贵组织对 Space 共享的要求:
- 仅所有者可访问的 Spaces – 每个 Space 仅创建它的用户可访问。这是默认配置,适用于团队处理敏感或独立项目的情况。
- 共享 Spaces – 多个团队成员可以访问同一个 Space,适用于结对编程、协作调试或共享开发环境。启用共享 Spaces 时,请确保配置好 POSIX 权限和补充组,以便对 Space 内创建的文件授予适当的访问权限。
了解更多:Amazon SageMaker HyperPod EKS 集群上的交互式开发环境
Studio 体验
虽然团队可以完全通过 CLI 使用 kubectl 与集群交互,但 SageMaker Studio 为偏好托管式、GUI 驱动工作流的用户提供了一个图形化入口来访问集群。在此架构中,每个团队通过自己的 SageMaker AI 域访问 Studio(如前所述),使用相同的 Identity Center 凭证登录,并在团队命名空间的边界内操作。
下图展示了用户使用企业凭证登录后进入的 IAM Identity Center 访问门户,该门户为其分配的 SageMaker Studio 应用程序和 Amazon Managed Grafana 应用程序提供单点登录访问。
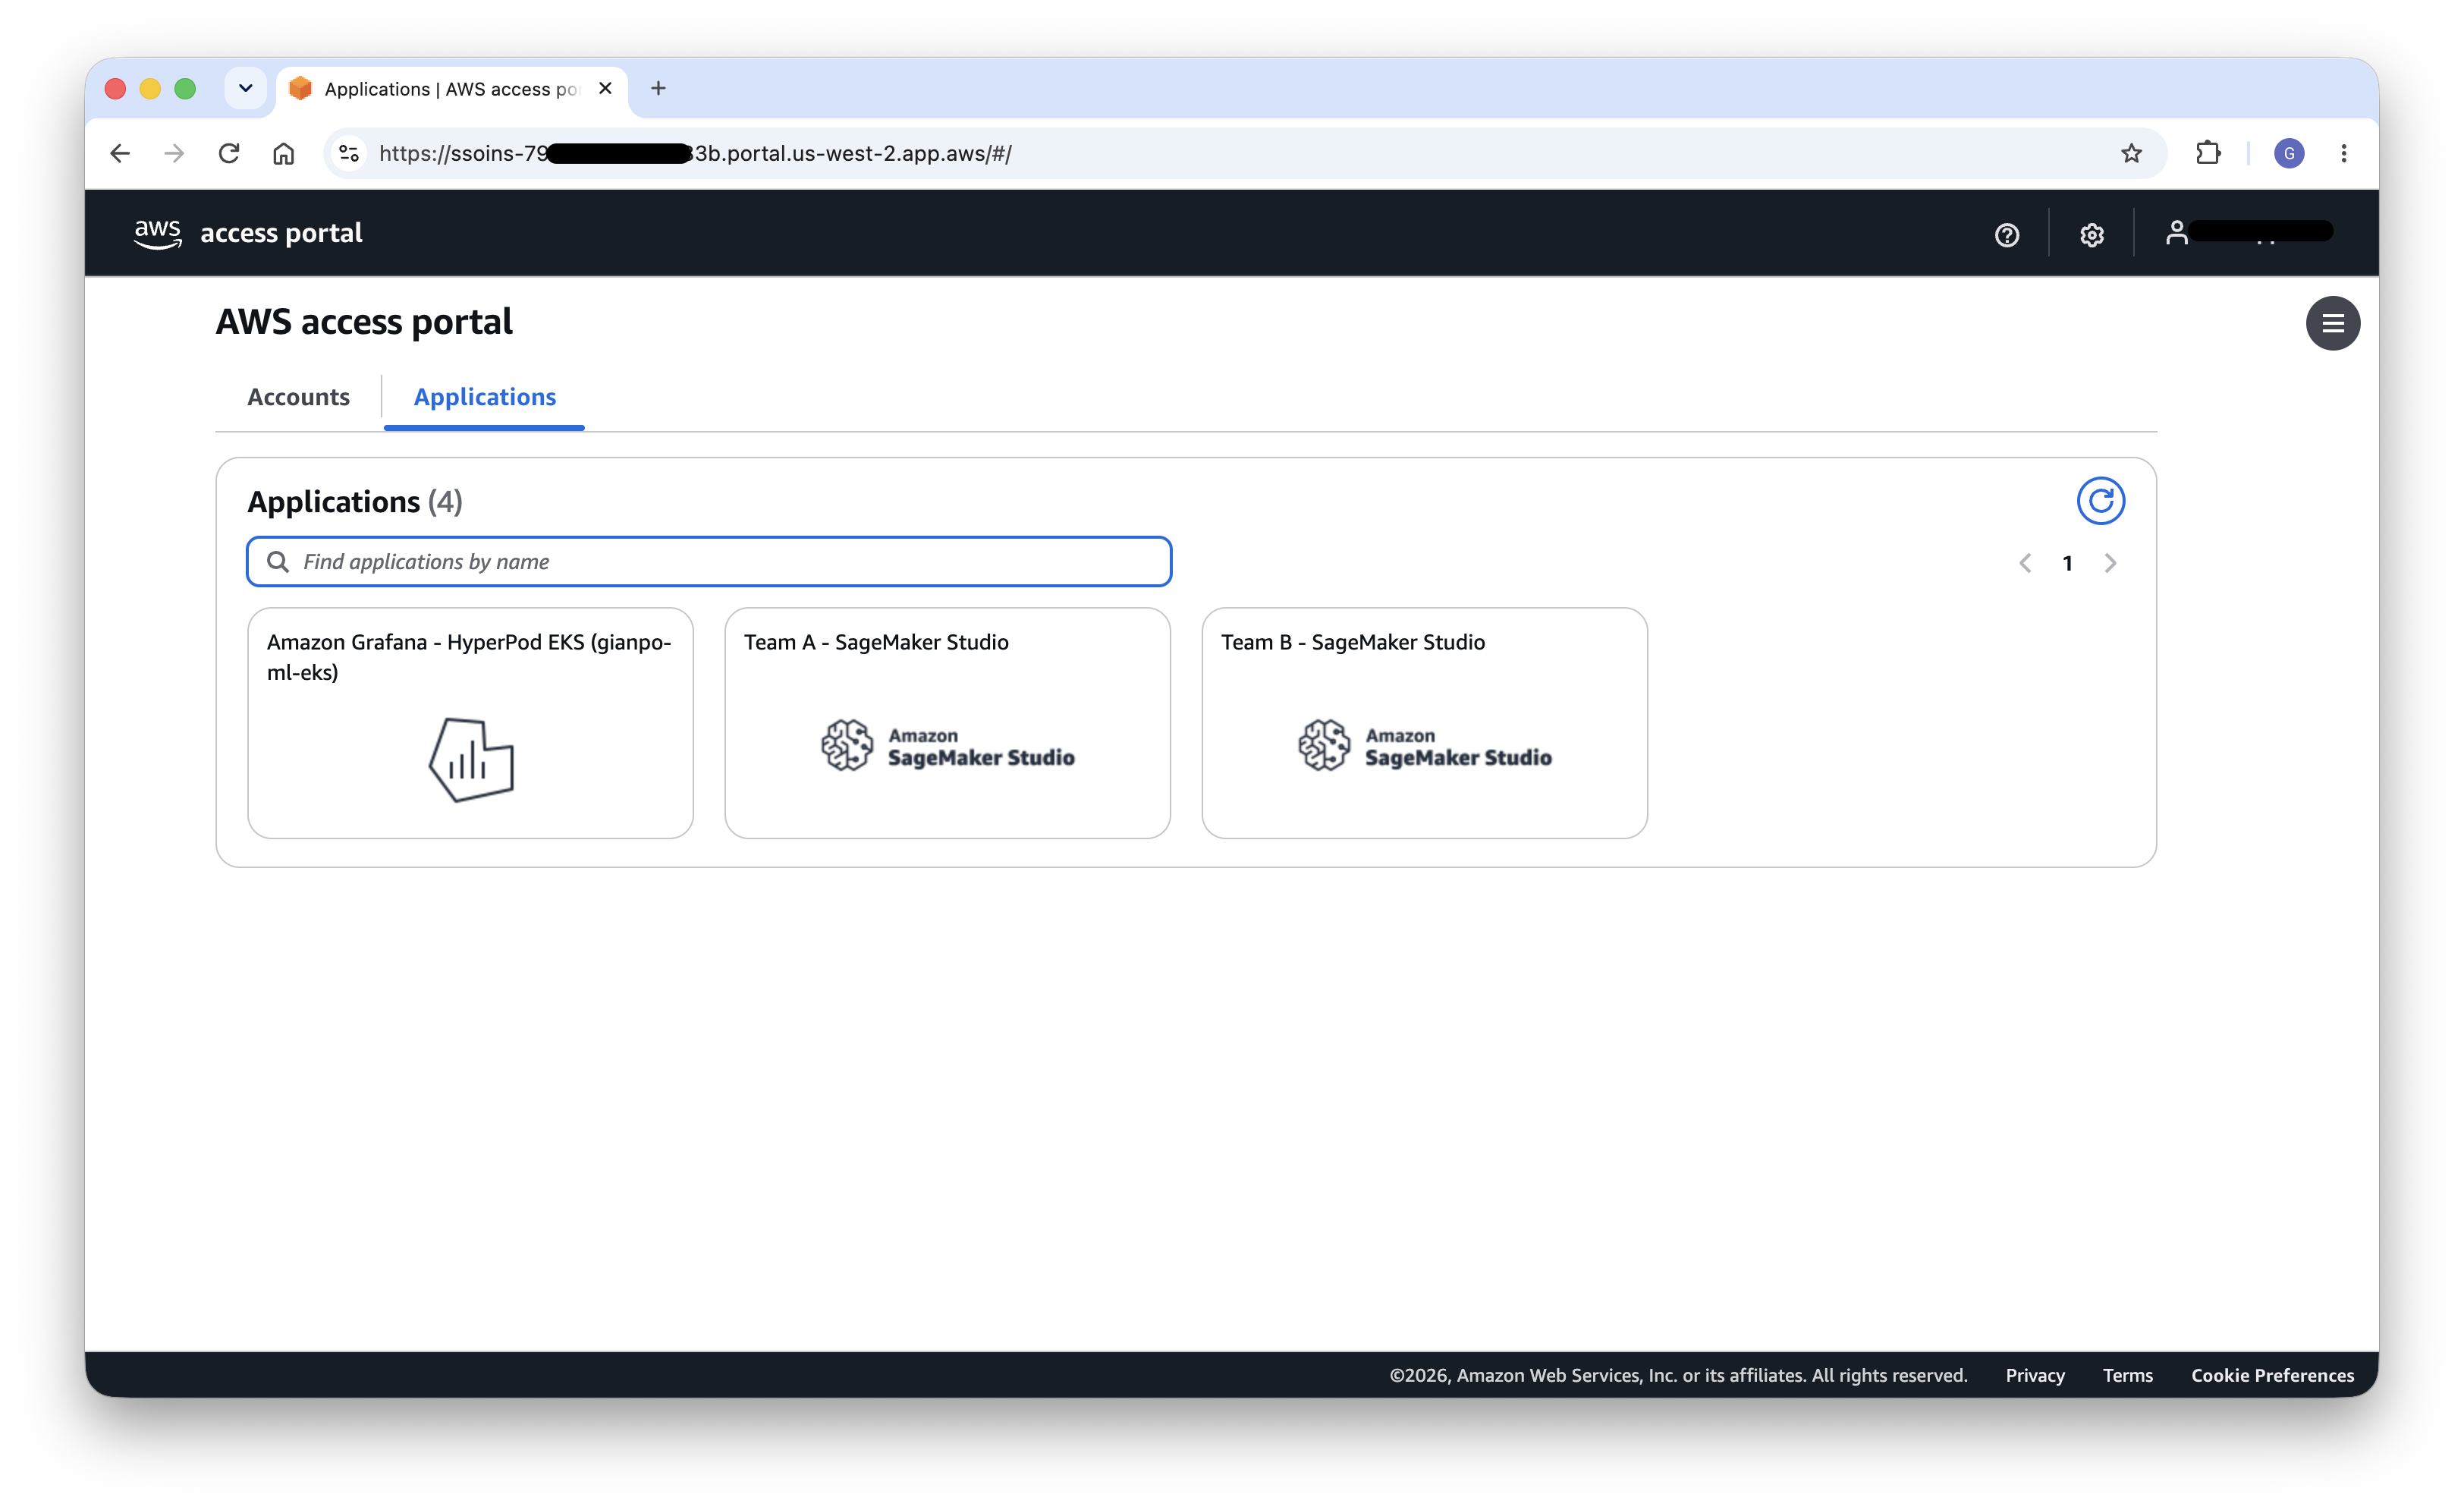
图 10:IAM Identity Center 访问门户,通过单点登录访问已分配的应用程序
在 Studio UI 中,团队成员可以:
- 管理 HyperPod Spaces – 从管理员配置的命名空间范围的 Space 模板启动交互式开发环境,无需编写 Kubernetes 清单或手动指定 Task Governance 标签。团队成员还可以启动、停止和连接其正在运行的 Spaces,直接在浏览器中打开关联的 IDE(例如 JupyterLab)。
- 管理 Ray 工作负载 – 创建和监控 Ray 集群,将 JupyterLab 或 Code Editor 工作区连接到集群,提交分布式作业,并打开 Ray Dashboard 和 Amazon Managed Grafana 可观测性仪表板,全程无需编写 Kubernetes 清单或运行
kubectl命令。
由于 Studio 通过团队的 Domain 执行角色和相应的 EKS 访问条目运行,所有操作都限定在团队的命名空间内。用户从 Studio 启动 Space 或 Ray 集群时,只能在自己的团队边界内创建,这与 CLI 访问所实施的隔离模型一致。
下图展示了如何从 SageMaker Studio UI 创建 HyperPod Space,团队成员无需编写 Kubernetes 清单或手动指定 Task Governance 标签,即可选择命名空间范围的 Space 模板。
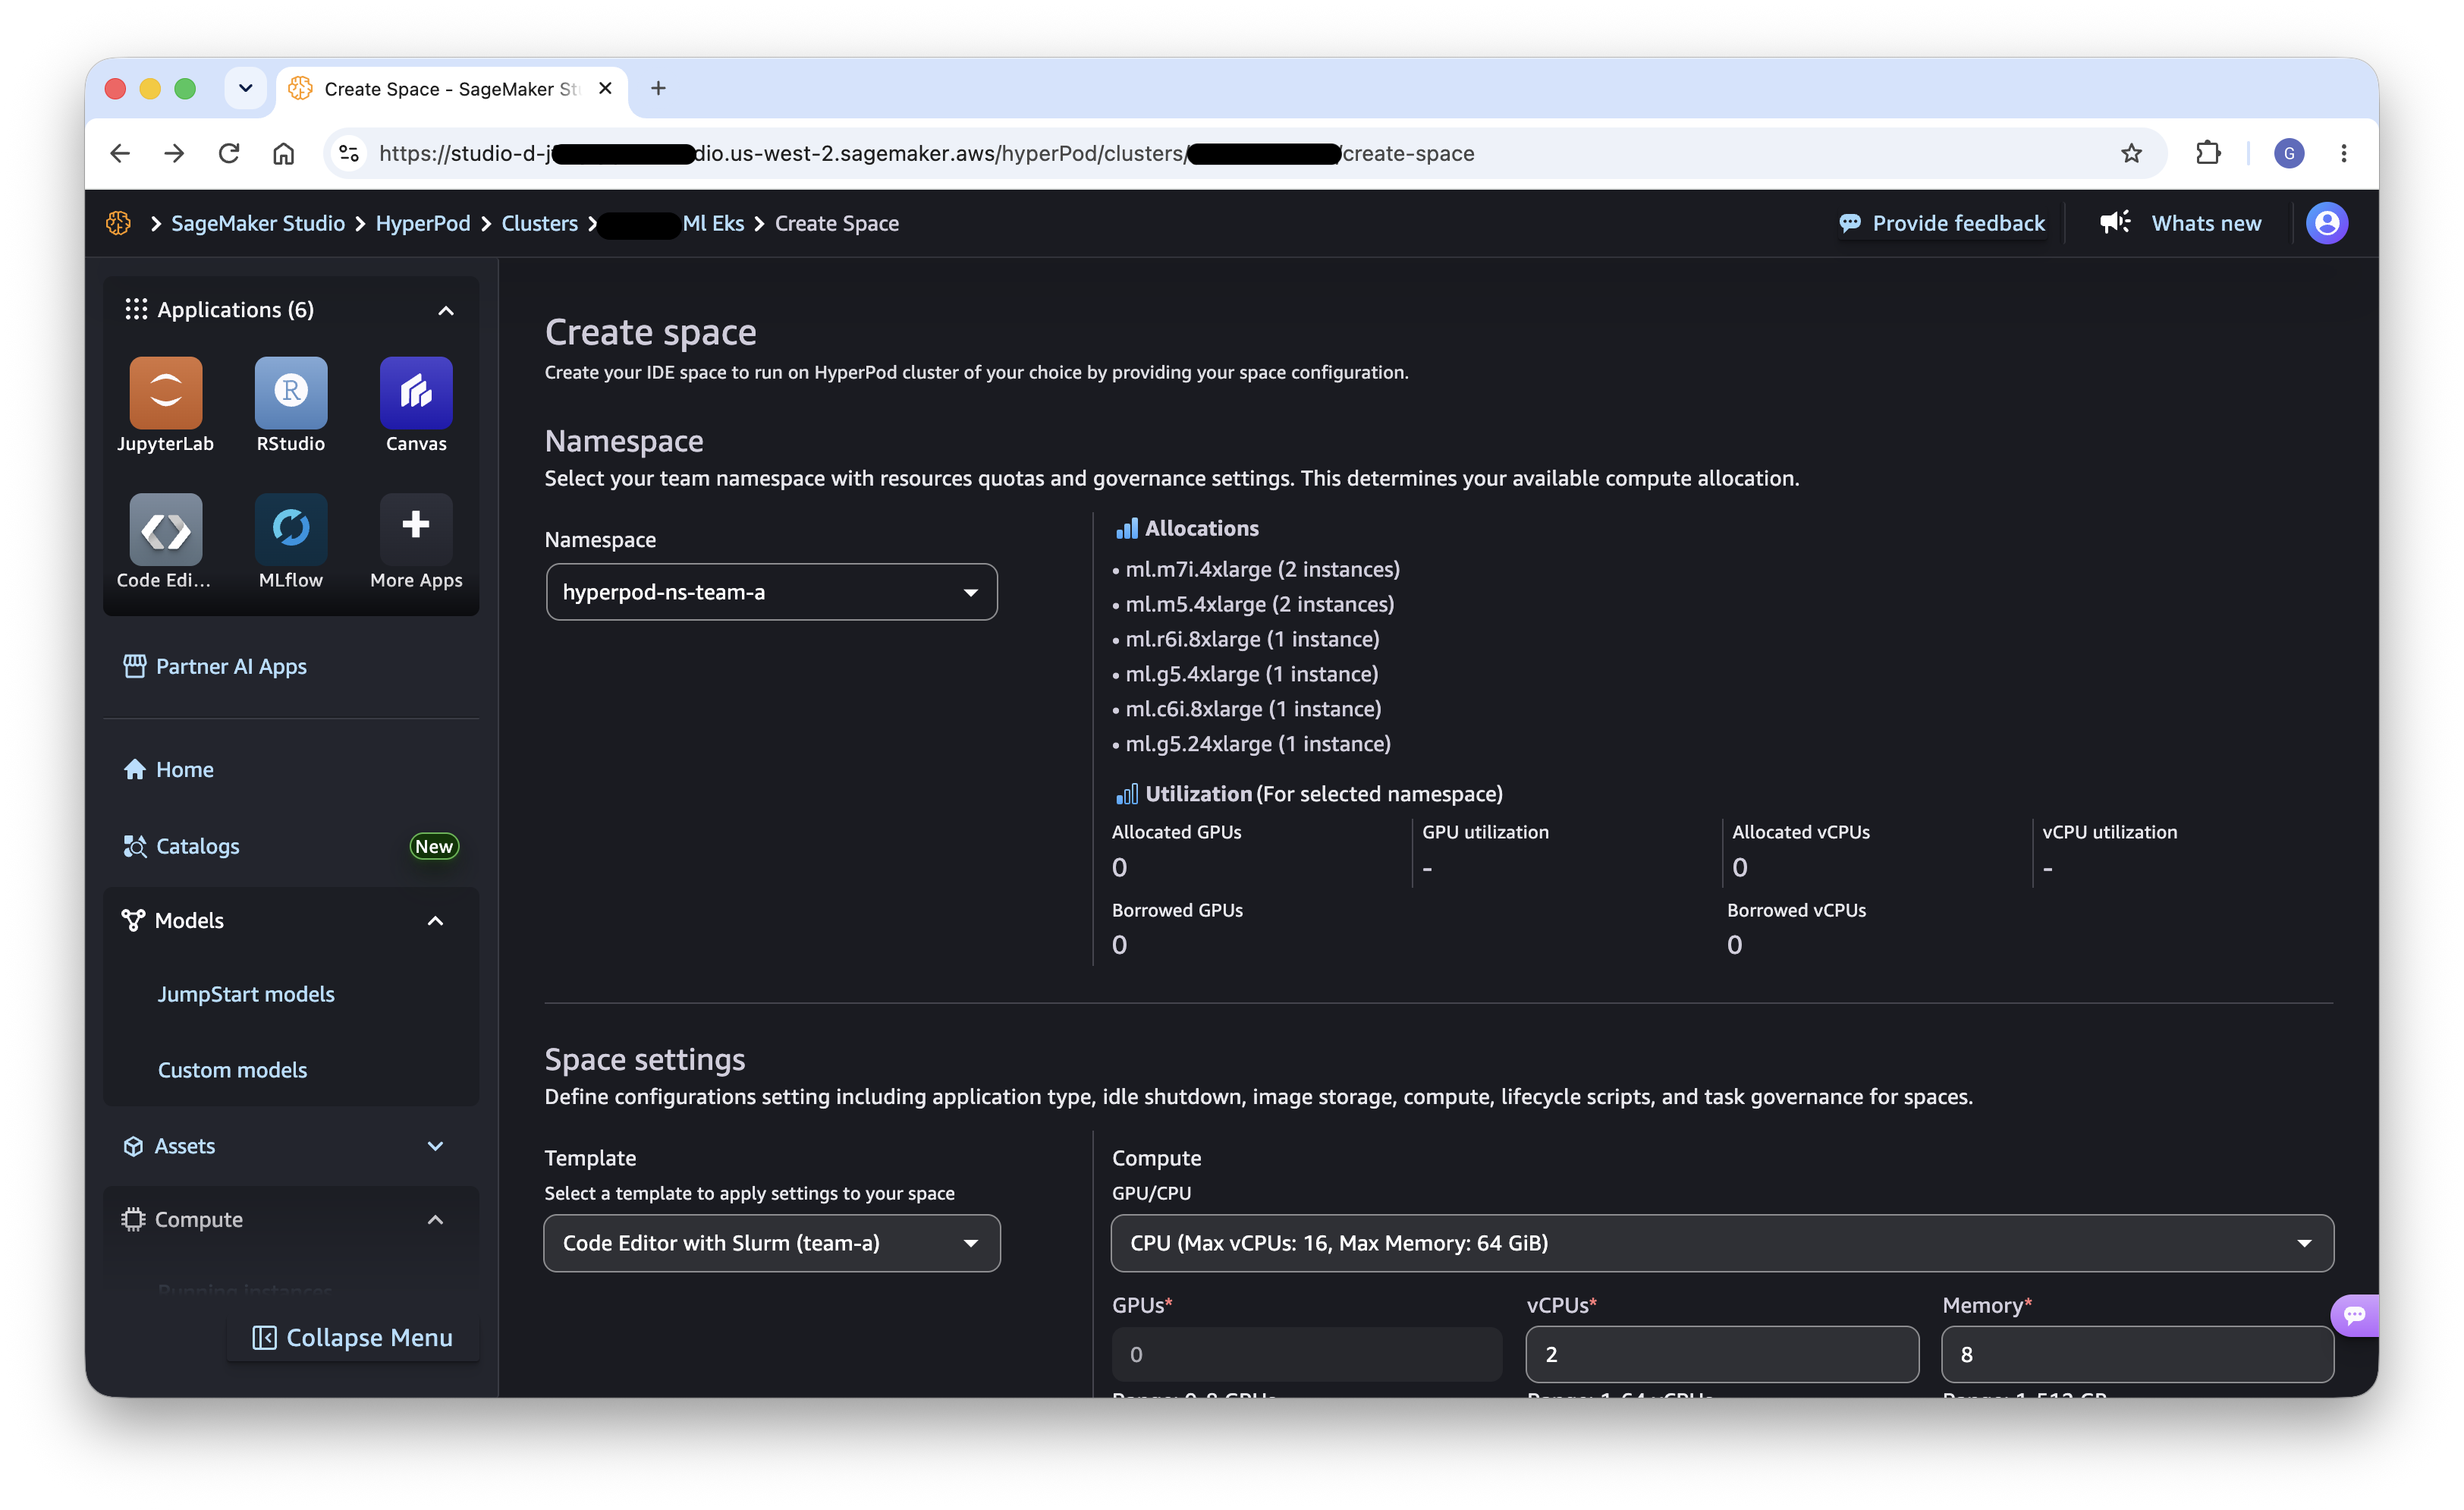
图 11:在 SageMaker Studio 中从命名空间范围的模板创建 HyperPod Space
了解更多:Amazon SageMaker HyperPod EKS 集群上的交互式开发环境 · 在 SageMaker HyperPod 上推出新的 Ray 功能
HyperPod Training Operator
HyperPod Training Operator 使团队能够以 Kubernetes 自定义资源(例如 HyperPodPyTorchJob)的形式提交分布式训练作业。在多租户架构中,训练作业是命名空间范围的,这意味着它们会自动继承团队的隔离边界。
团队可以使用 kubectl apply 和相应的作业清单从 CLI 提交训练作业。作业在团队的命名空间中运行,使用团队的计算配额(如果启用了 Task Governance),并可以访问团队的存储卷。
启用 Task Governance 后,训练作业受团队分配的配额和优先级设置约束。如果团队已用完其保证分配量,作业可能会排队,直到资源可用或直到低优先级工作负载被抢占。
将作业锚定到团队的两个要素是 metadata.namespace(将作业限定在团队的隔离边界内)和 Task Governance 标签。Task Governance 构建在 Kueue 之上,因此作业通过 kueue.x-k8s.io/queue-name 路由到团队的本地队列。它通过 kueue.x-k8s.io/priority-class 被分配调度优先级,其值是集群上定义的 WorkloadPriorityClass 的名称:
apiVersion: sagemaker.amazonaws.com/v1
kind: HyperPodPyTorchJob
metadata:
  name: team-a-training-job
  namespace: hyperpod-ns-team-a  # scopes the job to Team A's namespace
  labels:
    kueue.x-k8s.io/queue-name: hyperpod-ns-team-a-localqueue  # Task Governance (Kueue) local queue
    kueue.x-k8s.io/priority-class: training-priority  # name of a WorkloadPriorityClass
spec:
  ...
  # replicaSpecs, container image, command, resources, volumes, etc.
...了解更多:使用 HyperPod 训练算子
HyperPod Inference Operator
HyperPod Inference Operator 允许团队直接在集群上将模型部署为推理端点。与训练作业类似,推理端点是命名空间范围的,并受团队的 RBAC 策略和 Task Governance 配额约束。
团队可以通过在其命名空间中创建推理端点自定义资源,从 CLI 部署模型。端点按命名空间隔离,这意味着团队 A 无法访问或干扰团队 B 的推理端点。
对于需要高可用性的生产推理工作负载,考虑为推理端点分配比训练作业更高的调度优先级,这样模型服务就不会被批处理训练工作负载中断。
与训练作业一样,推理端点被放置在团队的 metadata.namespace 中,并带有 Task Governance 标签。在这里,kueue.x-k8s.io/priority-class 引用了一个更高优先级的 WorkloadPriorityClass,以便在团队资源受限时模型服务可以抢占批处理训练:
apiVersion: inference.sagemaker.aws.amazon.com/v1
kind: InferenceEndpointConfig
metadata:
  name: team-a-inference-endpoint
  namespace: hyperpod-ns-team-a  # scopes the endpoint to Team A's namespace
  labels:
    kueue.x-k8s.io/queue-name: hyperpod-ns-team-a-localqueue  # Task Governance (Kueue) local queue
    kueue.x-k8s.io/priority-class: inference-priority  # higher-priority WorkloadPriorityClass
spec:
  ...
  # model source, instance type, replica count, autoscaling, etc.
...了解更多:在 Amazon SageMaker HyperPod 上部署模型
HyperPod Observability
对集群健康状况、工作负载性能和资源利用率的可见性对所有团队都至关重要。HyperPod Observability 通过 Amazon Managed Grafana 提供内置的监控和仪表板功能。
配置团队对 Grafana 的访问权限
团队需要访问可观测性仪表板,以监控其工作负载、排查性能问题并了解资源消耗情况。然而,在多租户环境中,这种访问通常应为只读:
- 为 Amazon Managed Grafana 配置 Identity Center 身份验证 – 在 Amazon Managed Grafana 控制台上,导航到 Authentication 并启用 AWS IAM Identity Center。随后,用户即可使用与 SageMaker Studio 相同的企业凭据登录 Grafana。
- 将团队组分配为 Viewer – 将 Identity Center 组(
TeamA、TeamB)映射到 Grafana Viewer 角色。这样即可授予团队成员对仪表板和指标的只读访问权限,而无法修改仪表板或数据源。 - 管理员访问权限 – 将
Admin组分配为 Grafana Admin 或 Editor 角色,使其能够创建和修改仪表板、配置告警以及管理数据源。 - 团队专属仪表板 – 考虑创建按命名空间过滤数据的专用仪表板,让每个团队只能看到自己的工作负载指标。Amazon Managed Grafana 支持 Grafana Teams(Grafana 原生的 RBAC 概念,与此架构中的组织团队不同),可以从 Identity Center 组映射而来,以限制仪表板可见性并提供额外的数据隔离层。
下图显示了 Amazon Managed Grafana 中的 Grafana 角色分配。团队组(TeamA、TeamB)被分配为 Viewer 角色,以获得对仪表板和指标的只读访问权限,而管理员组被分配为 Admin 角色,使其能够创建和修改仪表板、配置告警以及管理数据源。
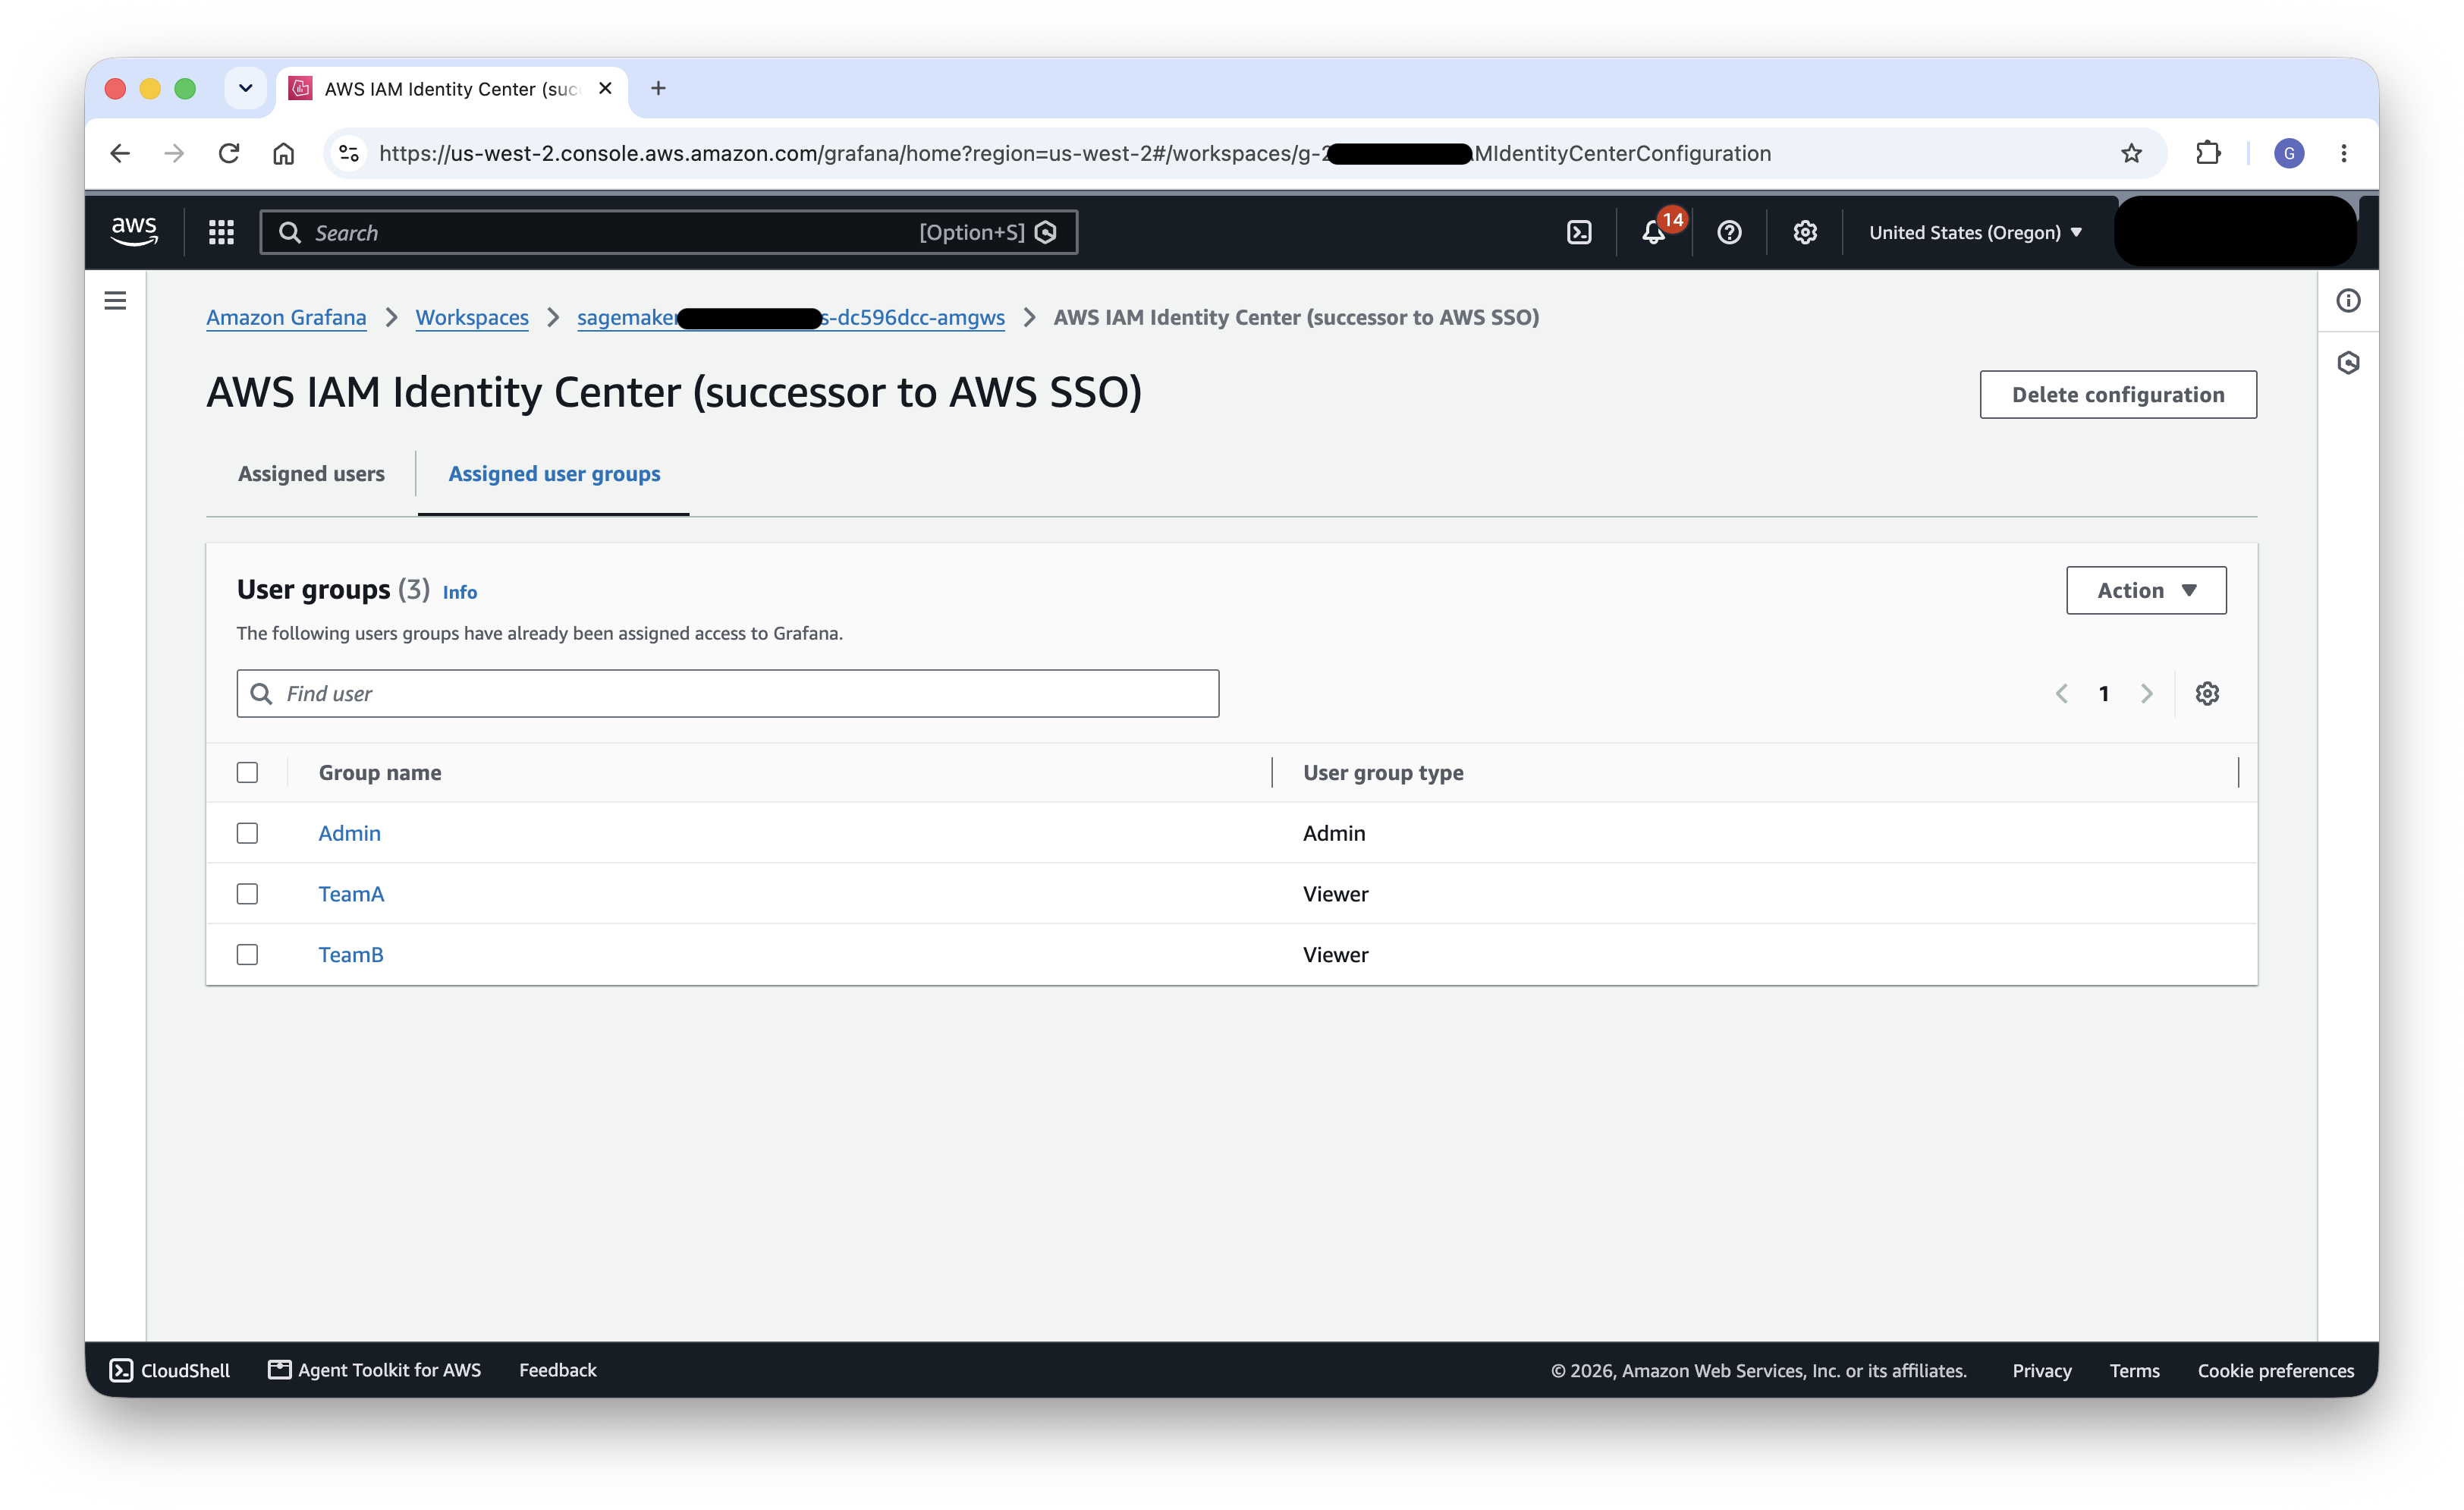
图 12:Grafana 角色分配,授予团队只读 Viewer 访问权限
了解更多:由 Amazon EKS 编排的 Amazon SageMaker HyperPod 集群可观测性
成本分配与分摊
在团队共享昂贵 GPU 基础设施的多租户环境中,了解谁消耗了什么对于问责、预算和分摊至关重要。Kubecost 通过按原生 Kubernetes 概念(命名空间、标签、部署和服务)细分集群内支出,并将其映射到团队、项目或环境等组织概念,来满足这一需求。
由于此架构已将每个团队隔离在专用命名空间(hyperpod-ns-team-a、hyperpod-ns-team-b)中,命名空间级别的成本分配与团队边界直接对应。这使平台管理员无需任何额外的工作负载标记,即可清晰地查看每个团队的 GPU、CPU、内存、存储和网络消耗情况。有关在 HyperPod 集群上部署和配置 Kubecost 的分步说明,请参阅 SageMaker HyperPod 上的 Kubecost。
启用团队可见性
在 Kubecost 开始收集数据后,在 Allocations 仪表板中按命名空间对成本进行分组,即可查看每个团队的支出。由于每个团队拥有一个命名空间,这直接生成涵盖计算、内存、存储和网络的按团队成本明细。与可观测性仪表板一样,团队也能从对自身成本数据的可见性中受益:
- 将视图限定到每个团队的命名空间 – Kubecost 支持按命名空间进行过滤和保存报告,因此每个团队都可以查看自己的消耗和趋势,而不会看到其他团队的数据。
- 设置预算和告警 – 配置按命名空间的预算阈值和告警,以便在支出接近既定限额时通知团队和平台管理员,从而支持与 HyperPod Task Governance 相同的资源公平性目标。
- 支持 chargeback 和 showback – 命名空间级别的分配报告可以支持内部 chargeback(向使用方团队计费)或 showback(报告用量但不计费)流程,为财务和平台团队提供所需数据,以便公平地分摊共享 GPU 成本。
下图展示了按命名空间分组的 Kubecost Allocations 仪表板,显示了每个团队命名空间在过去 7 天内的累计成本。
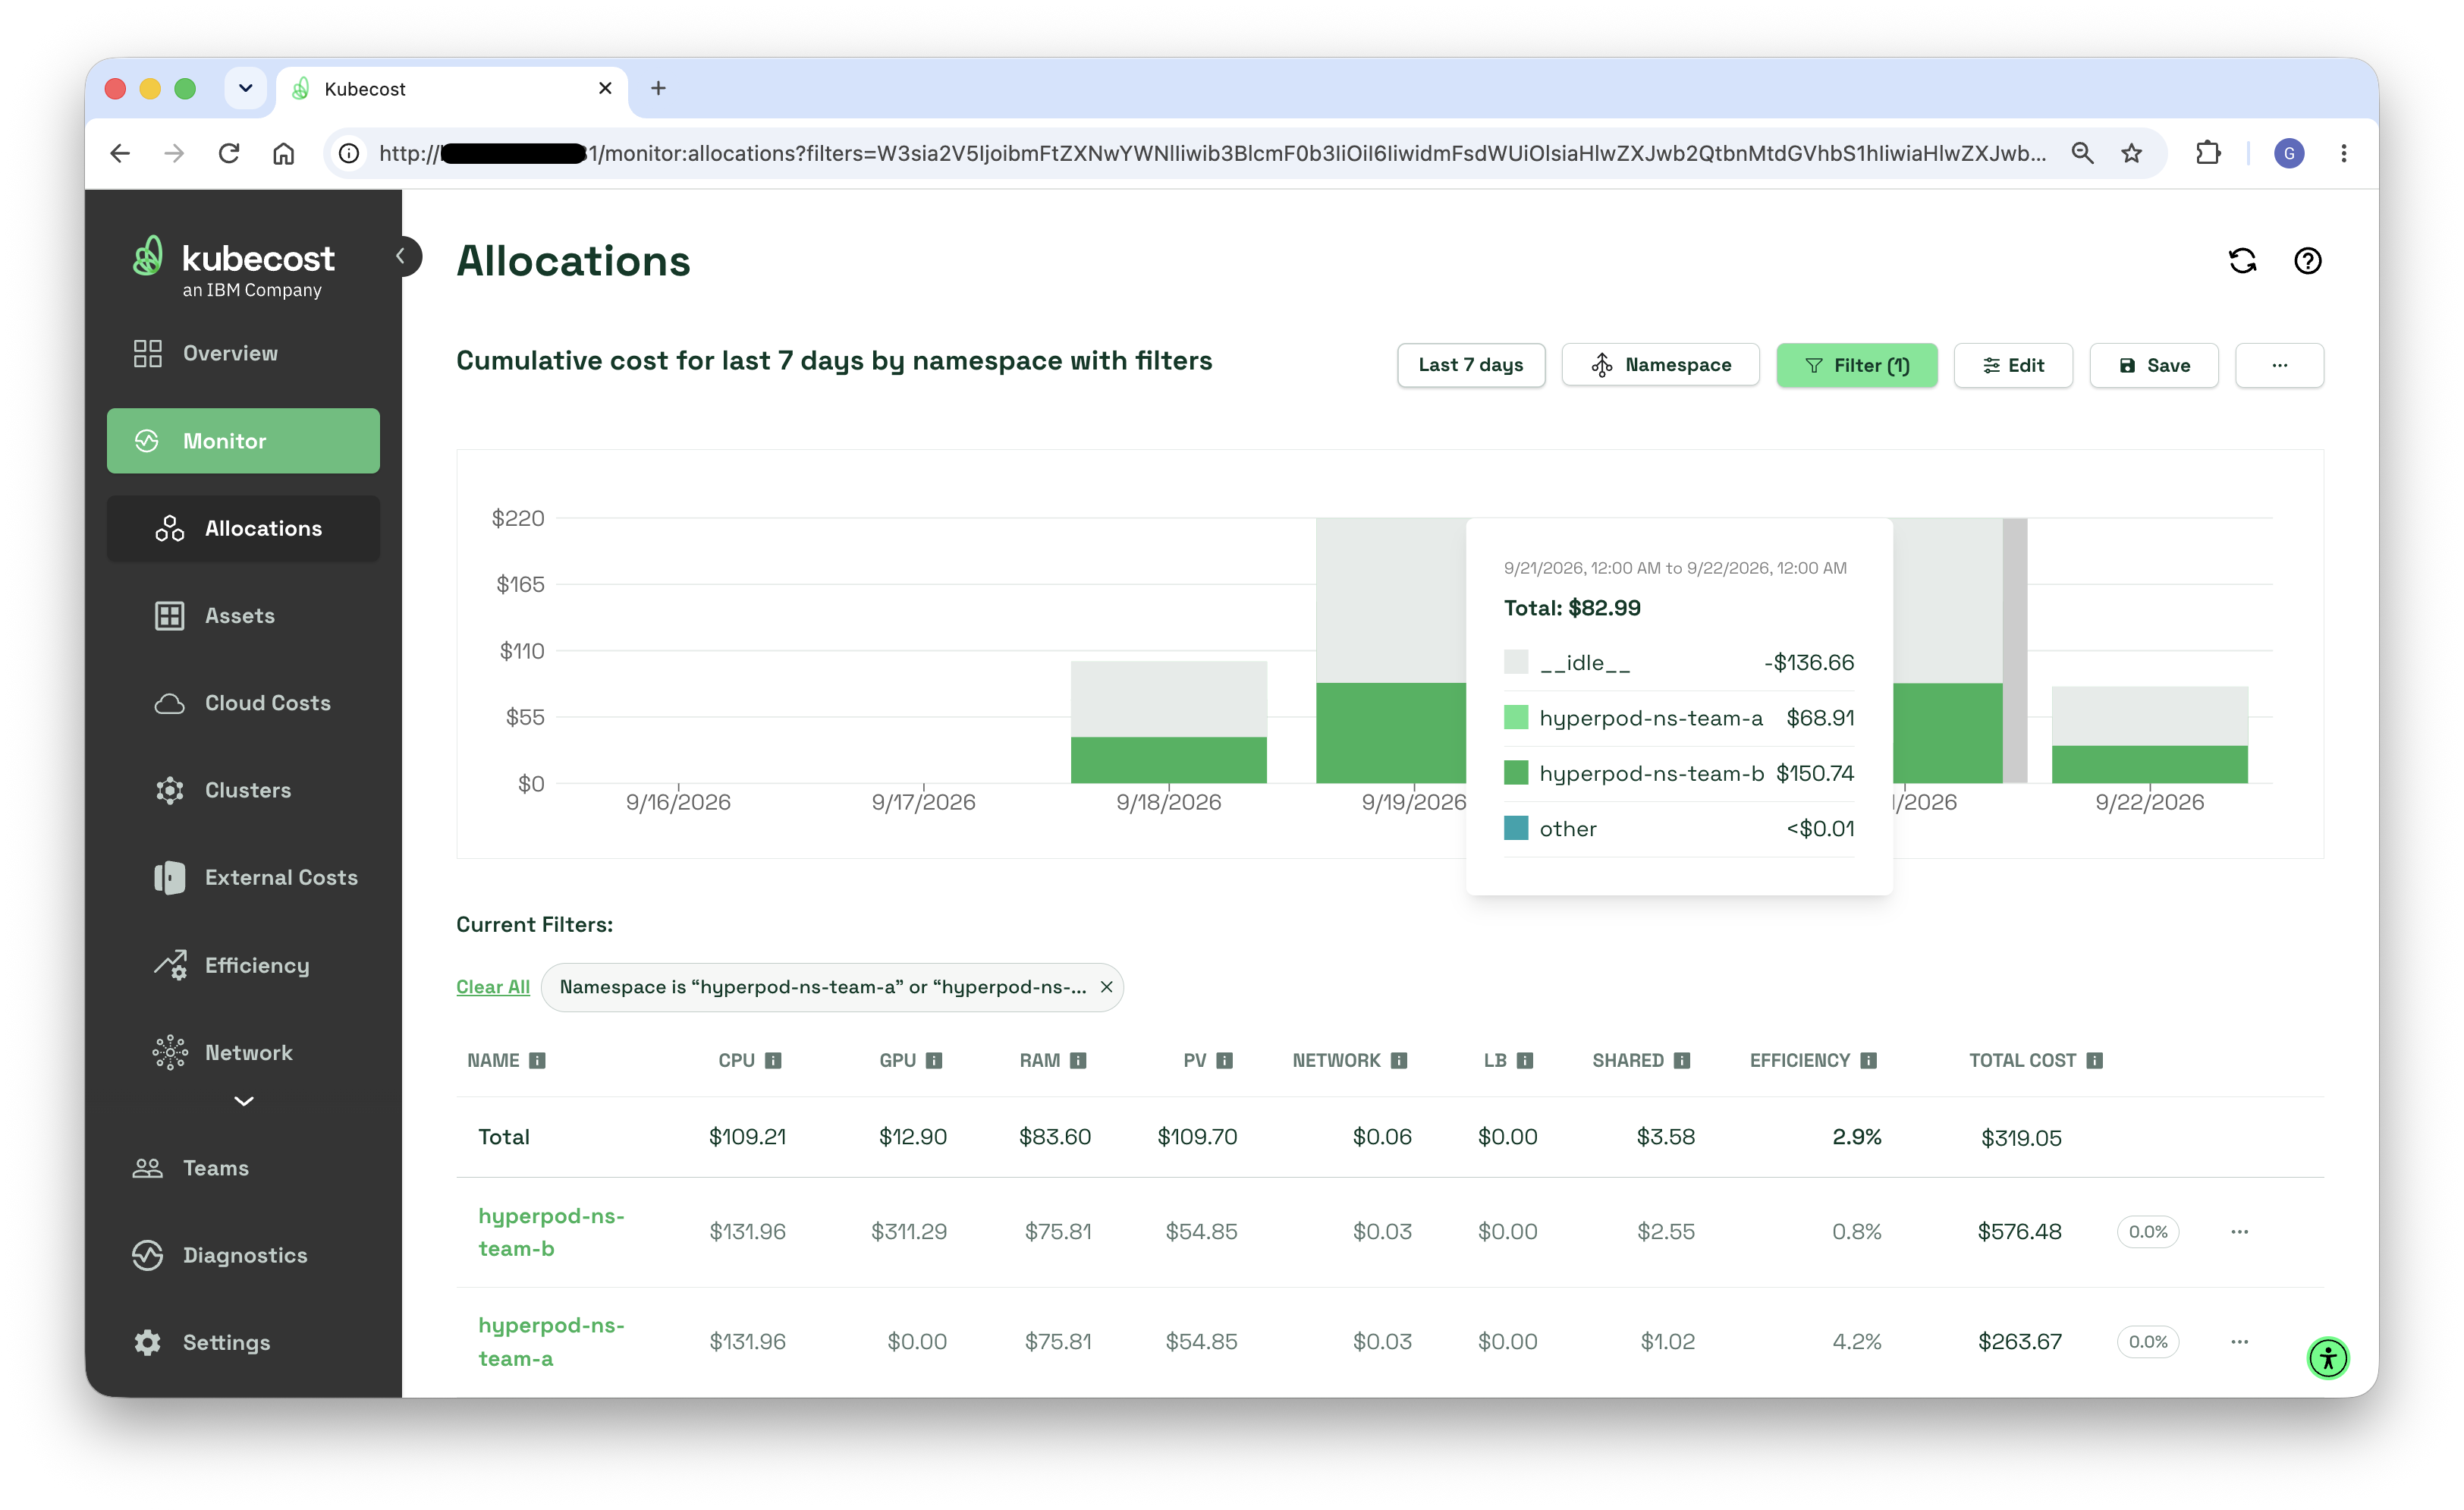
图 13:按命名空间分组的 Kubecost Allocations 仪表板,用于按团队查看成本
了解更多:SageMaker HyperPod 上的 Kubecost · Kubecost
结论
本文介绍了一种在 Amazon SageMaker HyperPod 上使用 EKS 构建多租户环境的参考架构。通过结合使用 AWS IAM Identity Center 进行身份验证、按团队划分的 IAM 角色进行 AWS 级授权、SageMaker AI 域提供定制化工作空间体验、Kubernetes 命名空间实现工作负载隔离、HyperPod Task Governance 实现公平的资源分配,以及命名空间级成本分配实现按团队的支出可见性,多个团队可以高效地共享单个 HyperPod EKS 集群。
这是一种灵活、可组合的方法,将多个构建块整合为一个内聚的解决方案。该架构可适应各种用例和组织结构。例如,组织可以扩展此模式,将团队连接到 HyperPod Slurm 集群以及 EKS,从而在不同编排后端之间提供统一的多租户体验。
虽然这种方法需要组装和配置多个组件,但结果是高度的控制和定制化,可以根据每个组织的特定隔离、合规和运营需求进行定制。基础模式(身份联合、命名空间隔离、RBAC、基于配额的治理和成本分配)仍将适用。
要开始使用,请尝试在您自己的 Amazon SageMaker HyperPod EKS 集群上构建此多租户设置,并根据您组织的隔离、治理和成本分配需求调整这些构建块。
关于作者

Giuseppe Angelo Porcelli
Giuseppe 是 Amazon Web Services 的首席机器学习专家解决方案架构师。凭借多年的软件工程和机器学习背景,他与各种规模的客户合作,深入了解其业务和技术需求,并设计充分利用 AWS Cloud 和 Amazon Machine Learning 堆栈的 AI 和机器学习解决方案。他参与过不同领域的项目,包括 MLOps、计算机视觉、NLP,并涉及广泛的 AWS 服务。业余时间,Giuseppe 喜欢踢足球。

Mayank Gupta
Mayank 是一位资深 AI/ML 专家,在机器学习框架和企业 AI 架构方面拥有深厚专业知识。他在 AWS AI 服务(包括 SageMaker AI 和 SageMaker HyperPod)方面拥有丰富的实践经验,并领导涵盖模型开发、分布式训练和生产规模部署的端到端 AI 解决方案的设计和交付。凭借在性能优化和可扩展 ML 架构方面的深厚经验,Mayank 与客户合作,将复杂的业务挑战转化为安全、高影响力、生产就绪的 AI 系统,从而推动可衡量的成果。
来源:AWS Machine Learning Blog · aws.amazon.com