用 LangGraph 和 Amazon Bedrock AgentCore Web Search 构建每日依赖监控
Build a daily dependency watcher with LangGraph and Amazon Bedrock AgentCore web search
Amazon Bedrock AgentCore 的 Web Search API 现已可用,通过单次 API 调用返回带标题、URL、发布日期和摘要的实时网页结果,查询由 Amazon 自建索引处理、不发送给第三方搜索引擎。
AI 智能体越来越多地处理依赖于当天变化情况的工作,例如安全公告、产品发布、价格和法规。模型的训练数据无法回答这些问题,因此智能体需要网络搜索。对于生产环境使用,团队还需要能够引用的结果,以及对哪些来源算数的控制权。他们希望搜索查询留在自己的云环境中,因为这些查询往往会暴露内部工作内容。
Amazon Bedrock AgentCore 中的 Web Search API 现已可用。它通过一次 API 调用为智能体和应用程序提供当前的网络结果,并使用它们已有的 AWS 凭证进行签名。AWS 从 Amazon 运营的网络索引中提供每一次查询,而不会将其发送给第三方搜索引擎。
每条结果包含页面标题、URL、发布日期以及与查询相关的摘录。请求可以包含或排除域名,并将结果限制在某个发布日期范围内。在 AWS Lambda、Amazon Elastic Container Service (Amazon ECS) 或 Amazon Bedrock AgentCore runtime 上,你的智能体使用其执行角色调用该 API。无需存储或轮换搜索 API 密钥。Web Search on Amazon Bedrock AgentCore 也可通过 AgentCore Gateway(Amazon Bedrock AgentCore 的一项能力)使用。在那里,一个管理员来源策略即可覆盖每个智能体和 Model Context Protocol (MCP) 客户端。
对于 LangChain 开发者,LangChain 的 AWS 集成中的 AgentCore 网络搜索工具现在会调用 Web Search API。一次函数调用即可为智能体提供当前、可引用的搜索结果。该工具还可以持有模型无法更改的规则,例如日期窗口、来源阻止列表和搜索预算。它将其结果作为数据返回,你的代码可以对其进行检查。它可与 LangChain 智能体、运行这些智能体的编排框架 LangGraph,以及增加了子智能体、虚拟文件系统和上下文压缩的 Deep Agents 配合使用。
在本文中,你将在 Web Search API 上以 LangGraph 图的形式为安全团队构建一个每日依赖监视器。每天早上,该监视器会检查是否有任何新情况影响团队交付的开源软件包和容器基础镜像。它会并行研究三个软件包生态系统,同时你的代码将日期窗口、阻止列表和搜索预算置于模型控制之外。它会对照每条发现所引用的来源进行检查,并记住已经报告过的内容。然后你在 AgentCore runtime 上运行该监视器,并通过 AgentCore Gateway 将其提供给各个团队。在我们的测试中,三个分支在 36 秒内完成,而逐个执行则需要 99 秒。
解决方案概述
模型决定搜索什么并撰写发现。所有必须遵守的规则,无论模型做什么,都保留在代码中:日期窗口、阻止列表、搜索预算以及对每条发现的检查。图 1 展示了当你从 notebook 运行该监视器时这些部分如何组合在一起。
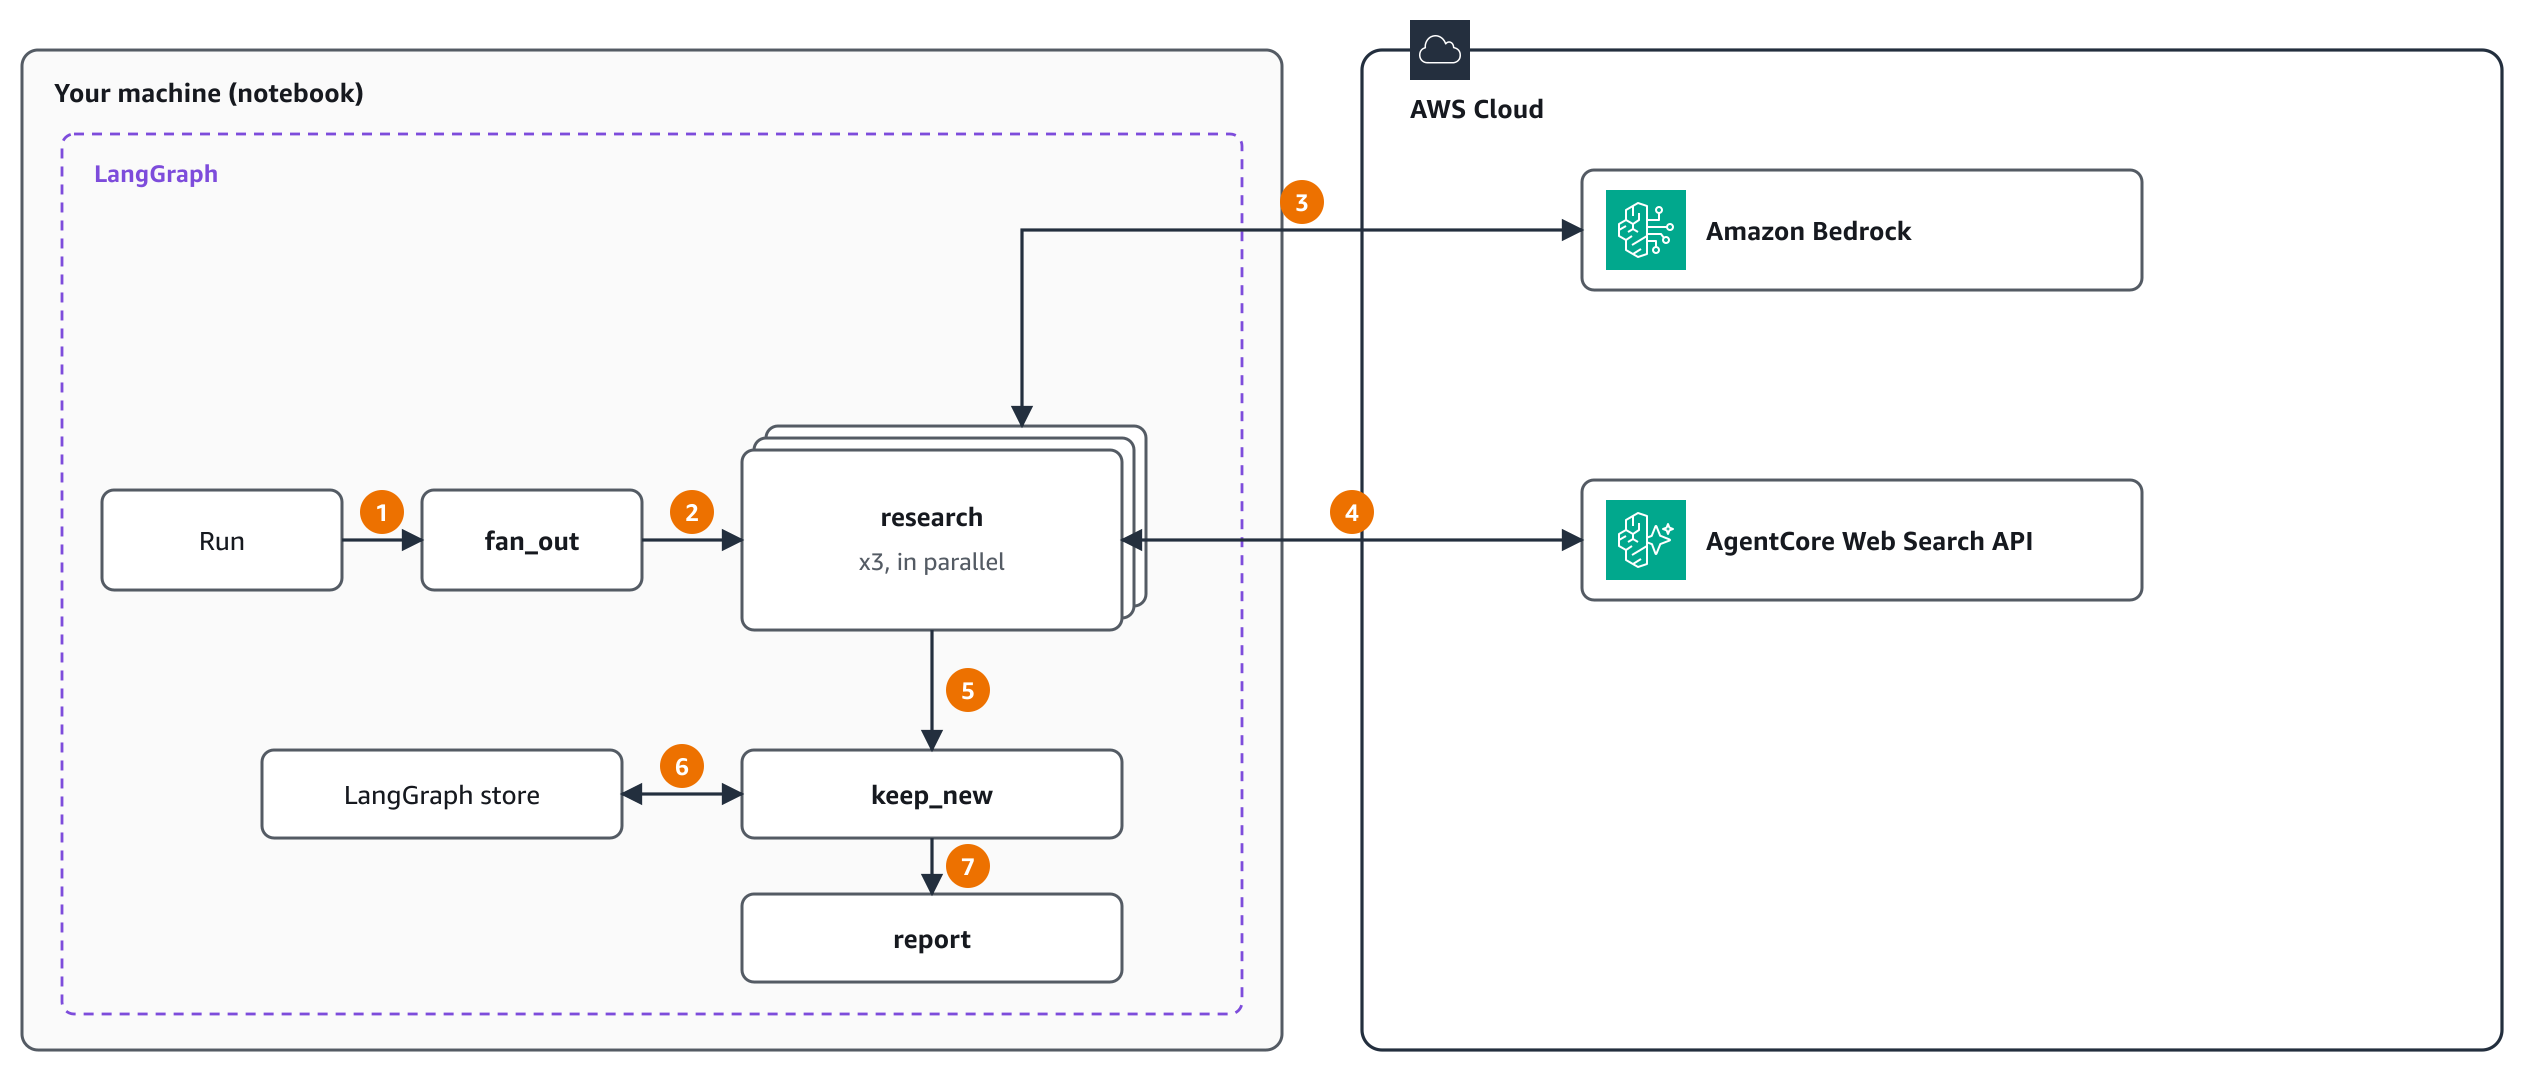
图 1:使用 LangGraph 和 Web Search API 的每日依赖监视器,从 notebook 运行
编号步骤如下:
- 一次运行以监视列表和监视窗口启动图。
fan_out为每个生态系统启动一个研究分支:npm、PyPI 和容器基础镜像。LangGraph 并行运行这三个分支。- 在每个分支内部,agent 会调用 Amazon Bedrock 中的 Anthropic Claude 模型。模型决定要搜索什么,并在最后生成结构化的发现结果。
- 该分支的搜索工具会把日期窗口和黑名单添加到每个查询中。它调用 Web Search API,请求使用 AWS Signature Version 4 (SigV4) 签名。步骤 3 和步骤 4 会重复执行,每个分支最多进行四次搜索,所有分支同时进行。
- 每个分支只保留其来源支持且落在窗口内的发现结果。当三个分支全部完成后,LangGraph 会合并它们的发现结果,并运行一次
keep_new。 keep_new会检查 LangGraph store 并记录新的发现结果,因此不会有任何内容被重复报告。- report 会为安全团队构建新发现结果的引用表格。
先决条件
在开始之前,你需要以下内容:
- 一个 AWS 账户,并在提供 Web Search API 的 AWS 区域中工作。示例使用美国东部(弗吉尼亚北部)区域(us-east-1)。对于其他区域,请参阅 支持的 AWS 区域。
- Python 3.10 或更高版本。
- 运行 notebook 的身份所需的 AWS 凭证,来自环境变量或 AWS Command Line Interface (AWS CLI) 配置文件。该身份需要步骤 1 中的 AWS Identity and Access Management (IAM) 权限,以及访问 Amazon Bedrock 中 Anthropic Claude 模型的权限。
- The following Python packages: boto3 1.43.127 or later, the AgentCore Python SDK (bedrock-agentcore) 1.26.0 or later, and langchain-aws 1.9.3 or later. Install them with this
pipcommand:pip install -U "boto3>=1.43.127" "bedrock-agentcore>=1.26.0" "langchain-aws[tools]>=1.9.3" langchain langgraph
Web Search 和模型调用按使用量计费。详情请参阅 Amazon Bedrock AgentCore 定价。一次 watch 运行最多进行 12 次搜索。
完整代码位于此 notebook 中。该 notebook 会运行每个单元格,包括设置。以下步骤涵盖与搜索相关的关键部分。
步骤 1:授予权限
首先,为你运行所用的身份授予搜索权限。Web Search API 需要对 AWS 拥有的一个资源执行一个 IAM 操作,因此该语句在每个账户中都相同。(完整设置请参阅 授予调用 API 的权限。)这使用的权限与网关的服务角色用于 Web 搜索的权限相同:
{
  "Effect": "Allow",
  "Action": "bedrock-agentcore:InvokeWebSearch",
  "Resource": "arn:aws:bedrock-agentcore:us-east-1:aws:tool/web-search.v1"
}
步骤 2:构建具有固定规则的搜索工具
现在构建每个研究分支使用的搜索工具。watch 不能让模型选择日期窗口、受信任来源或搜索次数。图还需要将返回的来源作为数据,以便稍后对照它们检查发现结果。langchain-aws 包中的 Web 搜索工具包通过其选项涵盖了所有这些内容:
toolkit, tools = create_web_search_toolkit(
    region="us-east-1",
    exclude_domains=BLOCKLIST,
    published_after=window_start.strftime("%Y-%m-%dT%H:%M:%SZ"),
    model_filters=False,
    max_searches=4,
    return_sources=True,
)
在没有 gateway 参数的情况下,该工具会调用 Web Search API。每次搜索都带有黑名单和日期下限,而模型自身的参数只能缩小它们。使用 model_filters=False 时,模型只能看到 query 参数。该工具在四次搜索后停止,并且会两次返回结果:一次作为文本供模型使用,一次作为 artifact 供图使用。每个分支都会创建自己的工具包,因此各分支会并行搜索。你可以将相同的工具提供给 Deep Agents 子代理。
步骤 3:定义发现结果 schema
搜索工具就位后,定义每个分支返回的内容。每个分支都是一个 create_agent agent,使用 Pydantic schema 作为其响应格式,因此它会返回发现结果而不是散文。一个发现结果包含包、一行标题,以及来源提供的 CVE 或公告 ID(如果有)。它还包含来源声明的严重性、来源是否表示其已被利用、建议的操作以及来源 URL。notebook 中有完整的 schema 和提示词。
步骤 4:构建图及其证据检查
现在组装图。fan_out 使用 LangGraph 中的 Send API 为每个生态系统发送一个分支,因此各分支并行运行。
在分支返回之前,代码会对每条发现执行四项检查。这些检查会将发现与该分支自身搜索返回的内容进行比对:
- 引用的 URL 来自该分支的某次搜索。
- 来源的标题或文本以完整单词形式提及该包。
- 发现中的任何 CVE 或公告 ID 都出现在该文本中。
- 来源的发布日期落在监视窗口内。工件中每个日期都已解析,缺失日期视为超出窗口。
所有分支完成后,keep_new 将存活的发现与 LangGraph 存储进行比较,report 构建表格。这些检查能捕获不支持的 URL、未提及包的来源、编造的 ID 以及超出窗口的来源。它们不确认严重性、利用状态、受影响版本或建议操作。它们也不能证明问题首次披露的时间:索引标注为本週的页面可能描述的是更早的事件。对于生产安全流程,请对照权威漏洞源验证发现。在任何人采取行动之前,请有人审查发现。
步骤 5:运行监视
你已准备好以 7 天窗口运行监视。在我们的运行中,三个分支进行了 12 次搜索,返回了 80 个来源。它们在 36 秒的实际时间内完成,而各分支相加为 99 秒。证据检查丢弃了两条发现:一条的来源未提及该包,另一条的 CVE ID 未出现在其来源中。没有任何来源来自被阻止的域。
四条发现通过了检查,keep_new 报告了其中两条。先前的测试运行已经报告了另外两条,因此存储将它们保留了下来。图 2 显示了在 LangGraph Studio(LangGraph 的可视化调试器)中的运行。报告的每一行都链接到其来源,这是 Web Search 可接受使用条款 对向用户展示的任何输出所要求的。
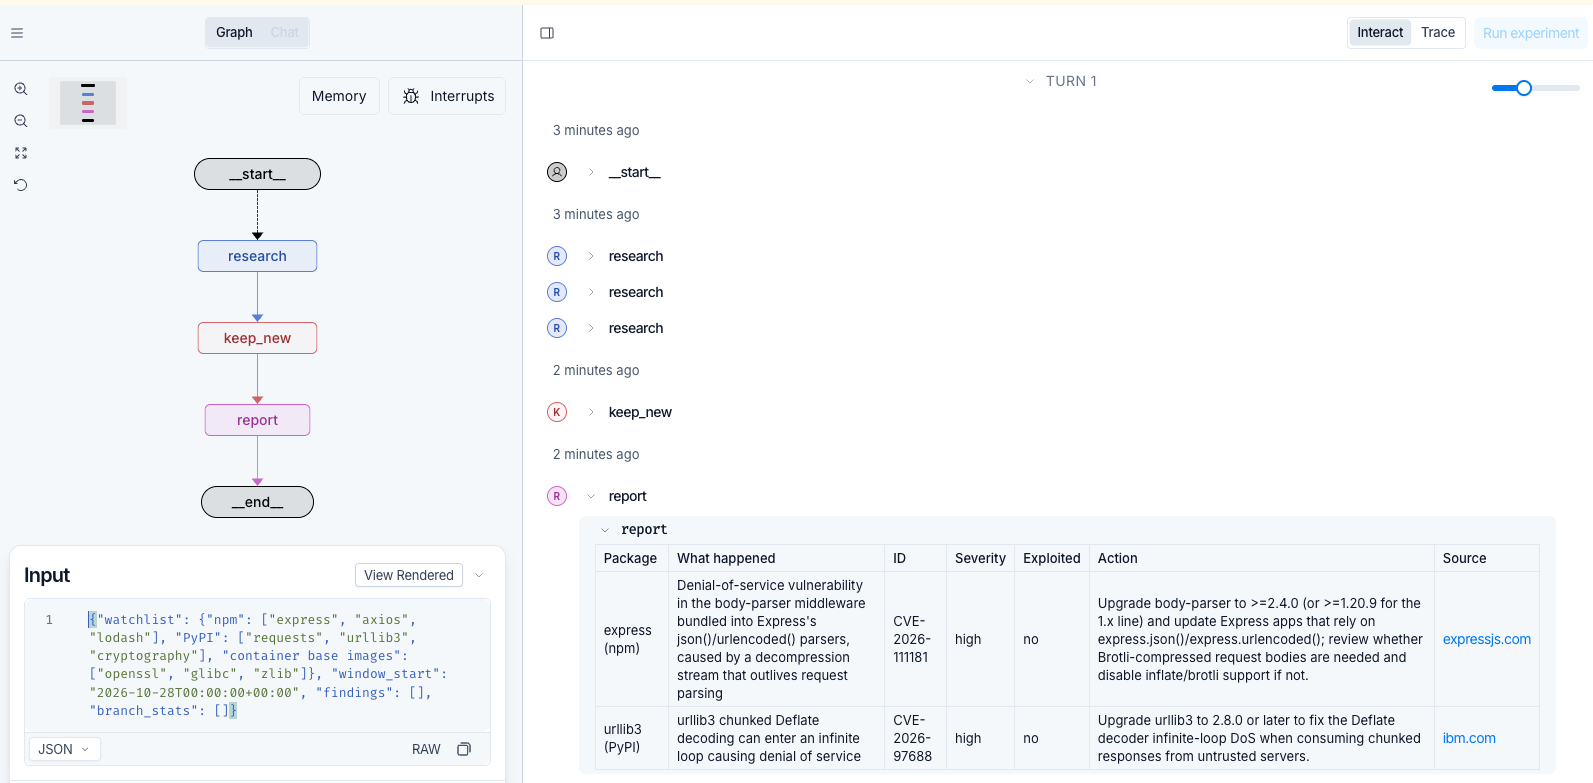
图 2:在 LangGraph Studio 中运行依赖监视。右侧的三个研究条目是三个生态系统分支,LangGraph 并行运行了它们。报告仅列出通过证据检查且之前未报告的发现,每条都链接到其来源
步骤 6:再次运行监视,仅查看新发现
最后,再次运行监视以查看存储的工作情况。计划监视每天运行,团队不应两次看到相同的公告。在我们的第二次运行中,分支再次搜索并保留了两条发现,而存储之前已报告过这两条。因此报告没有新内容,如图 3 所示。
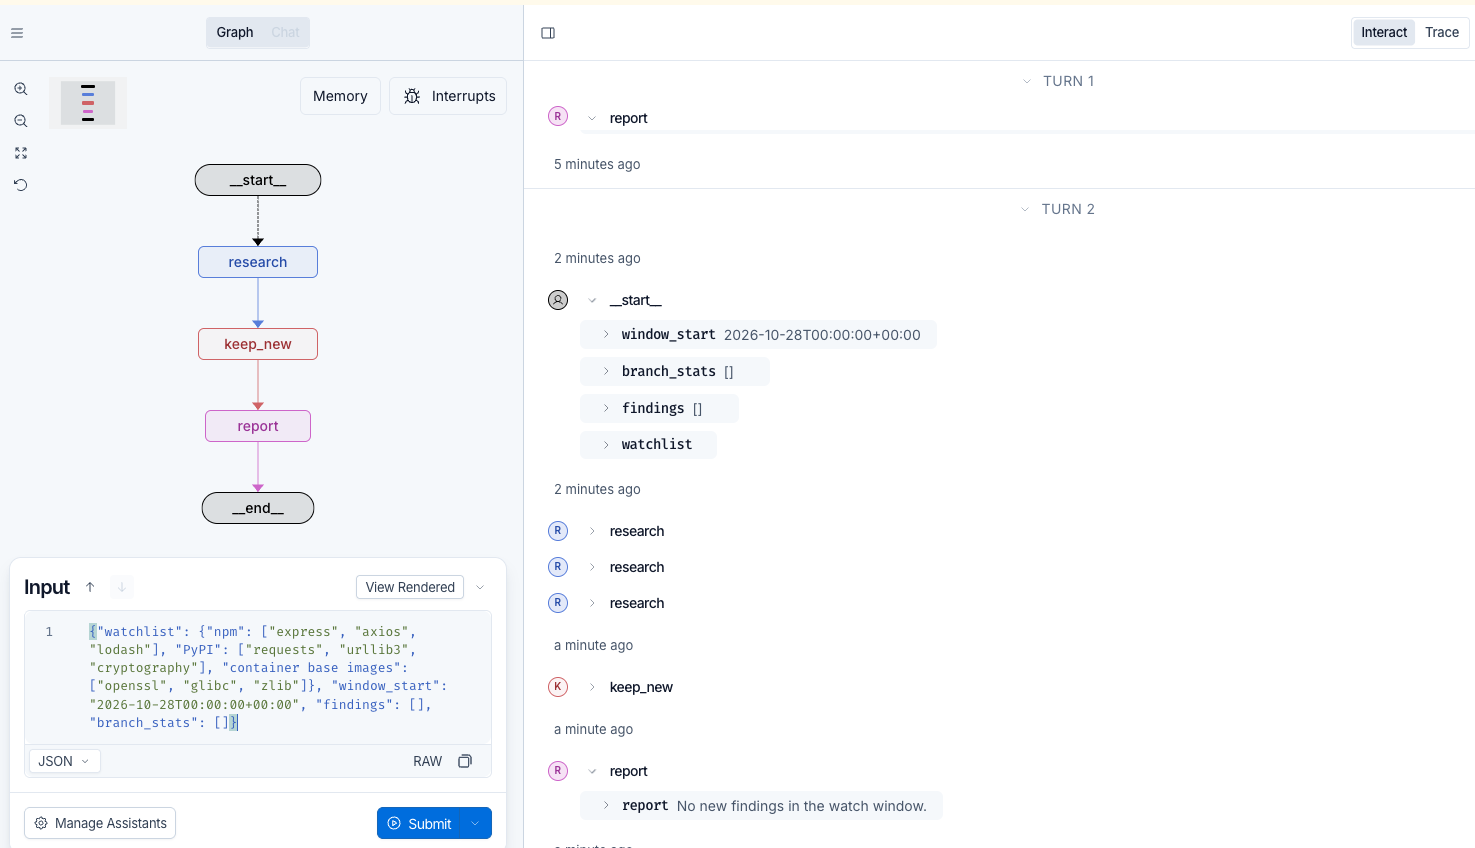
图 3:使用相同输入的第二次运行。分支再次搜索,但 keep_new 发现每个结果都已在 LangGraph 存储中,因此报告没有新内容
对于计划任务,将 InMemoryStore 替换为支持精确键查找的持久存储,例如来自 langgraph-checkpoint-aws 的 DynamoDBStore。
将 Web 搜索添加到现有的 LangChain 或 Deep Agents 应用
如果你已有 LangChain 代理,添加 Web 搜索只需几处更改。部署前请检查以下内容:
- 权限:将步骤 1 的语句添加到你的应用已使用的身份或执行角色中。无需创建其他任何内容。
- 区域:工具包的区域必须提供 Web Search API,并且它可以与你的模型或应用其余部分的区域不同。
- 工具名称:该工具名为
web_search。如果你的 agent 已经有同名工具,例如另一个搜索提供方,请在添加前为该工具设置一个不同的名称。 - 规则与预算:每个工具包都有自己的过滤器和搜索预算。为每个需要独立规则或独立预算的 agent 或分支创建一个工具包。
- 吞吐量:一个账户中的所有 agent 共享该账户的 Web Search 配额,因此并行分支会累加。默认情况下,一个账户在每个区域每秒可发送 10 个请求。详情请参阅 Amazon Bedrock AgentCore 的配额。
使用 Deep Agents 时,你通过 create_deep_agent 定义 agent:一个模型、工具、系统提示词和子 agent。将工具包的工具传入子 agent 的工具列表。将规则设置为工具包选项,因为无论模型要求什么,工具都会在每次搜索时应用这些规则。要像第 4 步那样对照来源核查发现,请对 agent 的输出运行该核查,或将其添加为中间件。在我们的测试中,一个 Deep Agents 协调器委派给带有这些工具的研究子 agent,并在约一分钟内返回了带引用的答案。
在 AgentCore runtime 上投入生产
当你准备好每天无需 notebook 运行该监控时,将其托管在 AgentCore runtime 上。Runtime 可运行用任何框架构建的 agent,包括 LangGraph,无需重写。它在相同的 API 背后提供两种计算类型。默认的 MicroVM 为每个会话提供独立的隔离 microVM,因此一次运行无法看到另一次运行的数据。实例在你自己的账户中的 AWS 托管 Amazon Elastic Compute Cloud (Amazon EC2) 实例上运行你的 agent。它们适合多天会话、GPU 工作负载或多个 agent 共享一个实例。
有关各自的限制,请参阅 为 agent 使用隔离会话 和 Runtime 实例与容量提供方。notebook 旁边的 Runtime 示例 包含与 Runtime 入口点相同的图。其策略授予 Runtime 执行角色第 1 步的权限,且不授予更广泛的访问权限。其 README 介绍了如何使用 AgentCore CLI 在任一计算类型上创建、部署和调用该项目。
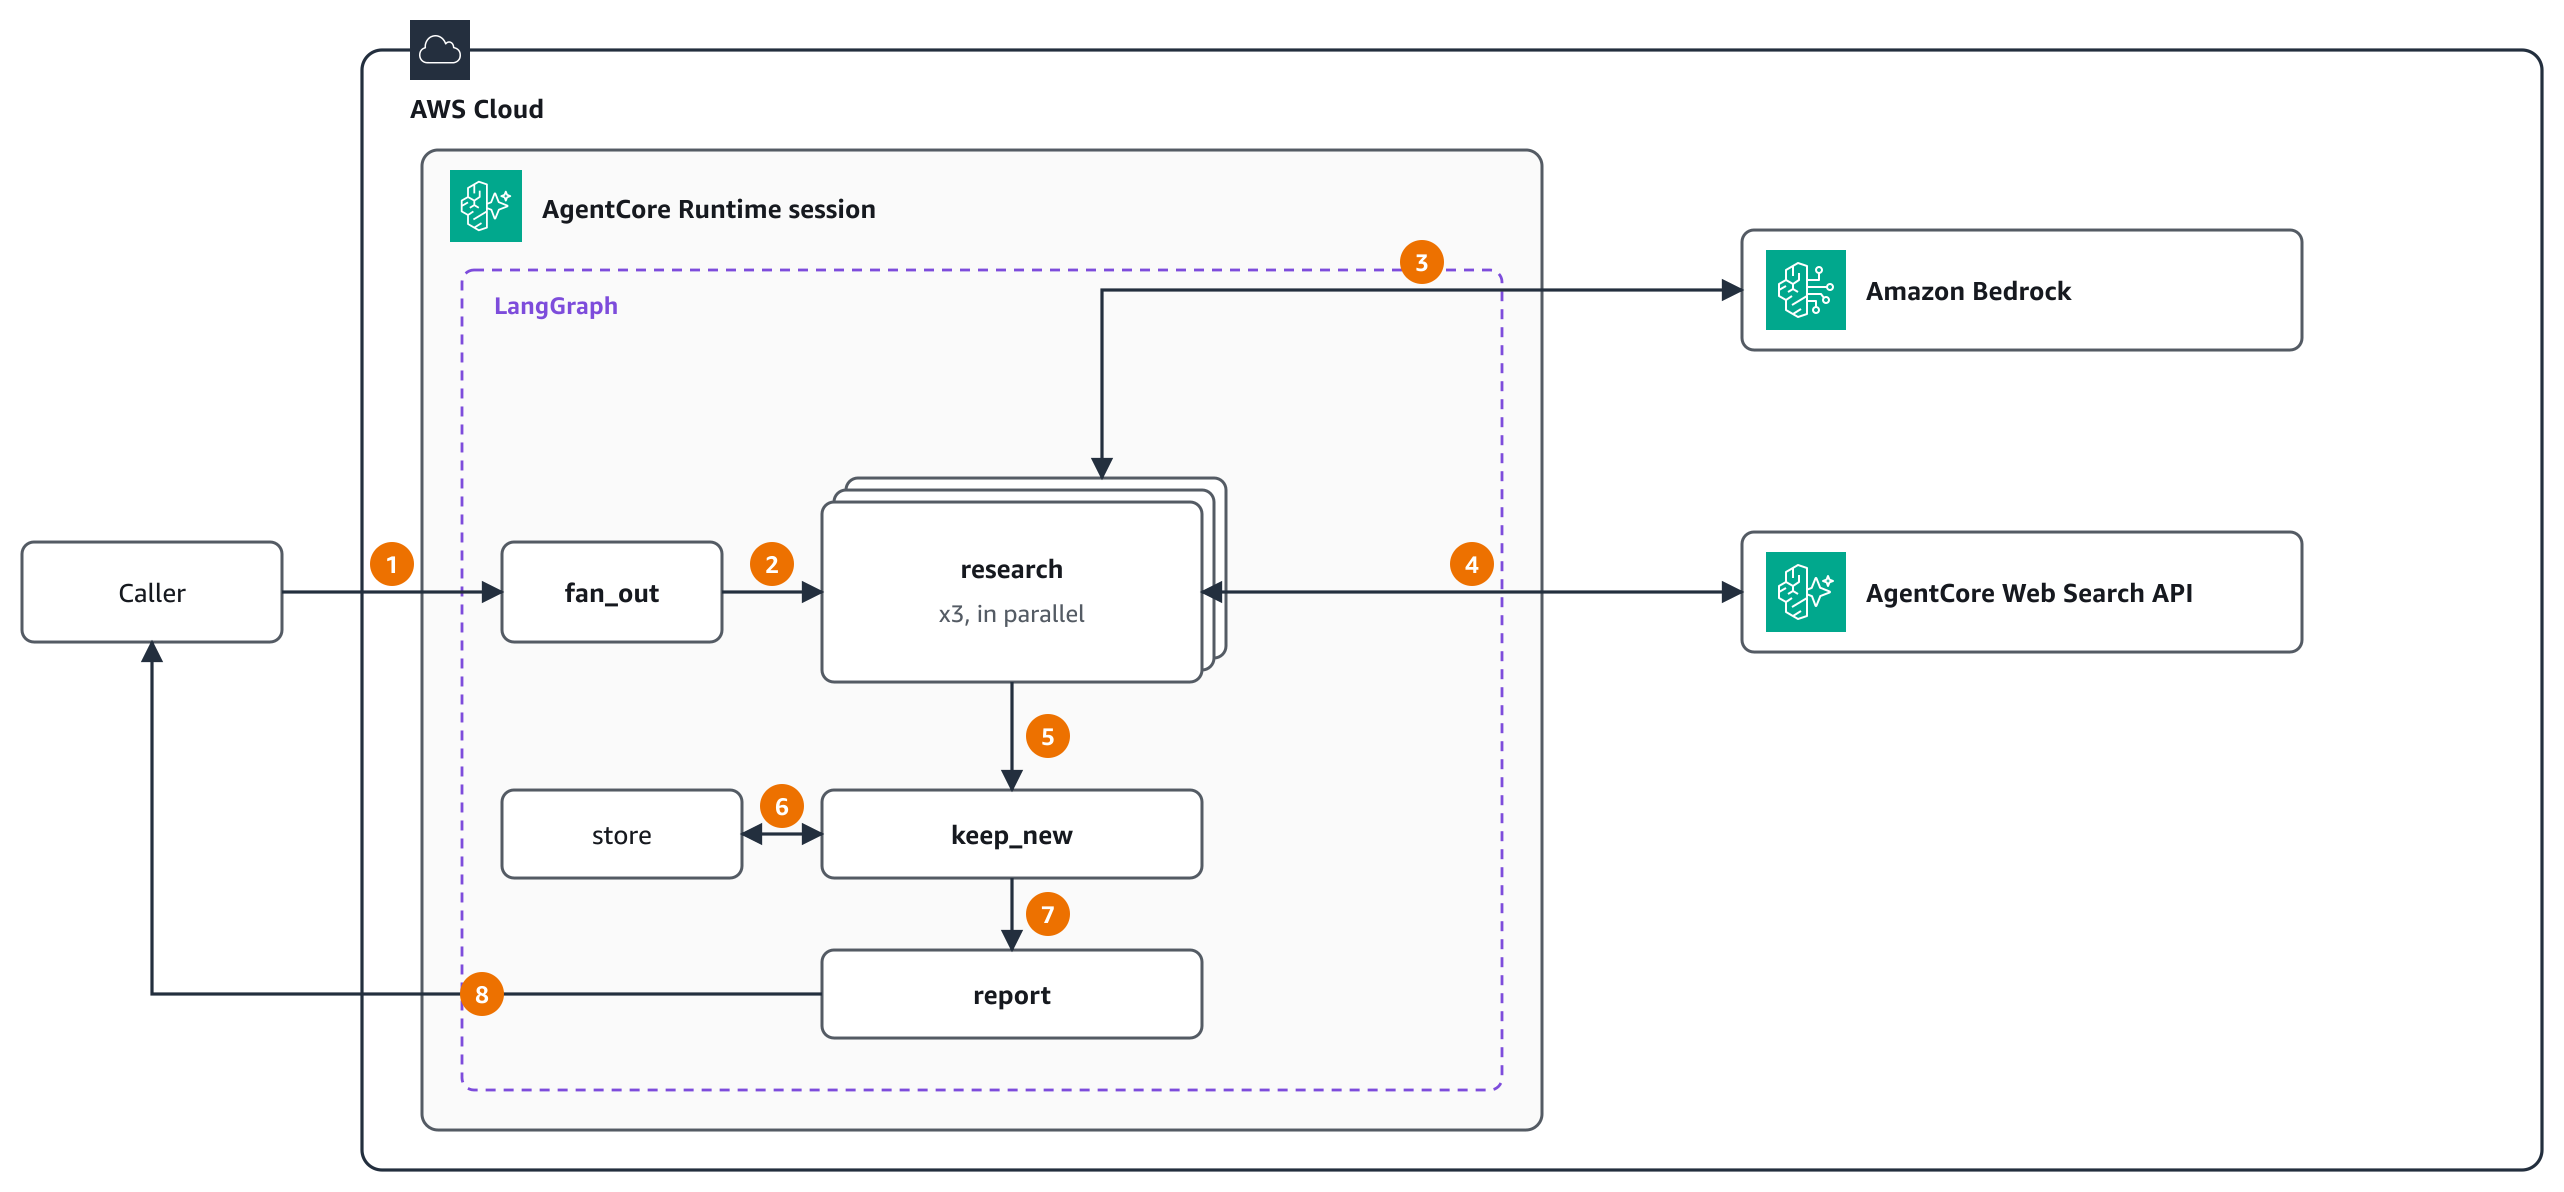
图 4:托管在 AgentCore runtime 上的同一依赖监控。第 2 步到第 7 步与图 1 一致,每次搜索都由 Runtime 执行角色签名。在第 1 步,调用方调用 runtime,例如使用 agentcore invoke。在第 8 步,runtime 返回报告
Runtime 会话状态是临时的,因此内存存储仅在会话期间持续。每日任务需要第 6 步中的持久存储,并按计划调用。
使用 AgentCore Gateway 跨团队扩展监控
Web Search API 和 AgentCore Gateway 上的 Web Search Tool 搜索同一索引,同一图在两者上均可工作。根据谁执行规则以及谁调用搜索来选择:
- 当你的自有应用程序调用搜索并执行自己的规则时,使用 Web Search API,如第 1 步到第 6 步所示。它只需要一个 IAM 权限。
- 当平台团队向许多 agent 或团队提供搜索,并希望 AWS 对每次搜索应用一个管理员源策略时,使用 AgentCore Gateway。该策略位于网关目标上,对 agent 隐藏,agent 无法解除它。
- 当 Claude 等 MCP 客户端需要搜索时,或者当你希望将 Web 搜索与其他工具放在一个 MCP 端点后面时,使用 AgentCore Gateway。
笔记本中可选的步骤 7 会让 watch 通过网关运行。它会创建一个 Web 搜索目标,并将阻止列表作为管理员策略附加到该目标上,因此搜索客户端不再添加该阻止列表。此路线需要在两个不同的主体上授予两项 IAM 权限。网关的服务角色需要在 Web 搜索工具上具有 bedrock-agentcore:InvokeWebSearch 权限。你的代理用于签名的凭证需要在网关上具有 bedrock-agentcore:InvokeGateway 权限。图 5 展示了该流程。
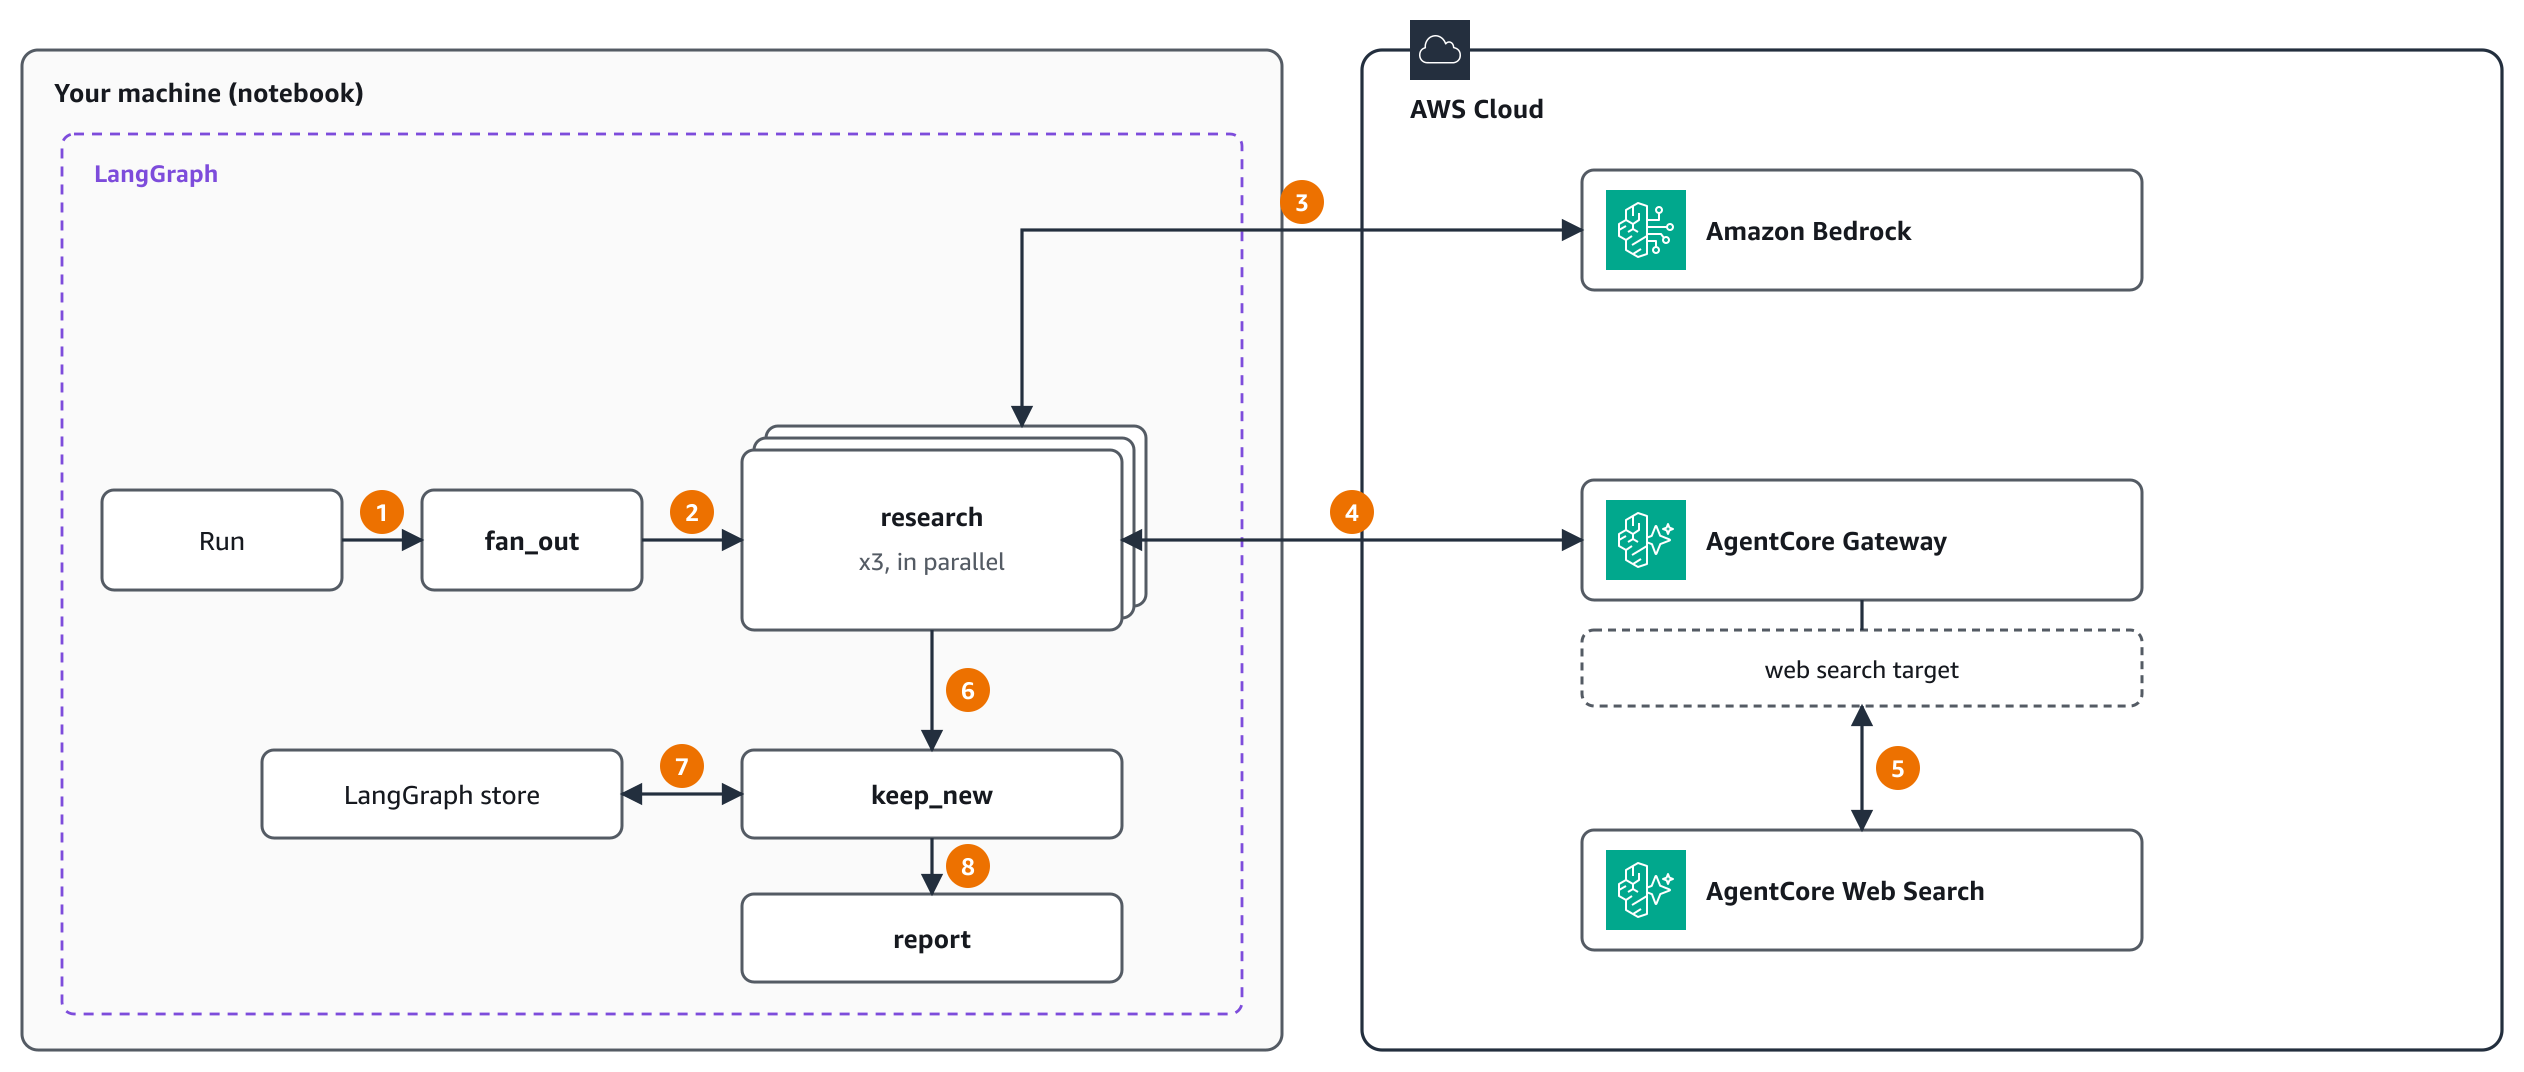
图 5:通过 AgentCore Gateway 执行同样的依赖 watch。图与图 1 相同。在步骤 4 中,搜索工具通过 MCP 调用 AgentCore Gateway,并使用 SigV4 签名。在步骤 5 中,Web 搜索目标应用管理员阻止列表并调用 AgentCore Web Search
要为每个团队提供各自的策略,请为每个团队添加一个 Web 搜索目标,每个目标都有自己的阻止列表。此演练笔记本展示了该模式。有关此路线的更多信息,请参阅Web Search Tool。
清理
步骤 1–6 不会创建任何 AWS 资源。如果你仅为本文添加了步骤 1 的权限,请将其从你附加该权限的身份中移除。如果你运行了步骤 7,请删除目标和网关以避免持续产生费用。当你设置 DELETE_GATEWAY = True 时,笔记本的最后一个单元格会执行此操作:
target = gateway_client.get_gateway_target_by_name(GATEWAY_ID, "security-sources")
gateway_client.delete_gateway_target_and_wait(gatewayIdentifier=GATEWAY_ID, targetId=target["targetId"])
gateway_client.delete_gateway_and_wait(gatewayIdentifier=GATEWAY_ID)
笔记本会保留网关的服务角色,以便其他网关可以使用它。当你不再需要它时,请在 IAM 控制台中将其删除。如果你部署到了 Runtime,请从项目文件夹运行 agentcore remove all,然后运行 agentcore deploy -y。
结论
Amazon Bedrock AgentCore 中的 Web Search API 让 LangChain 代理使用它们已有的 AWS 凭证获取最新且带引用的 Web 结果。依赖 watch 展示了如何超越单次工具调用。将模型不得更改的规则保留在代码中,并将返回的来源作为数据保留在模型上下文之外。检查可以检查的内容,并在用户看到的所有内容中保留引用。当更多团队需要相同的搜索时,AgentCore Gateway 会对所有团队应用同一策略。
要开始使用,请打开笔记本。作为参考,请参阅 LangChain 文档中的Amazon Bedrock AgentCore Web Search 集成页面以及Search the web using Amazon Bedrock AgentCore Web Search。
关于作者

Sundar Raghavan
Sundar 是 AWS Agentic AI Foundations 团队的高级解决方案架构师。他负责 Amazon Bedrock AgentCore 的开发者体验,掌管 SDK 和 CLI,并推动框架与生态系统集成策略。他专注于开发者如何在 AWS 上构建、部署和扩展生产 AI 代理。他还通过 Strands Robots 将同样的代理开发者体验带到 Physical AI。

Omar Abdelwahab
Omar 是 Amazon Web Services (AWS) 的技术产品营销经理,专注于包括 Agentic AI 和 Web Search 在内的 AI 产品。他拥有计算机科学博士学位,乐于在 AI、技术和市场推广策略的交叉领域工作,帮助客户构建创新应用。
来源:AWS Machine Learning Blog · aws.amazon.com