如何用 Ray LLM Deep Learning Containers 在 Amazon EKS 上运行多节点推理
Run multi-node inference workloads using Ray LLM Deep Learning Containers
AWS 发布 Ray LLM Deep Learning Containers,可在 Amazon EKS 上用两个 GPU 节点部署单个大语言模型,将 prefill 与 decode 阶段分离并统一在一个 OpenAI 兼容端点后。该容器内置 vLLM、Ray Serve LLM、NIXL 和 EFA 栈,整个服务应用仅需一段 YAML,无需编写 handler 或构建自定义镜像。
本文将介绍如何在 Amazon Elastic Kubernetes Service(Amazon EKS)上,使用多节点 Ray LLM Deep Learning Containers 将一个大语言模型(LLM)部署到两个 GPU 节点上。它在单个 OpenAI 兼容端点后面使用独立的 prefill 和 decode 节点。这种多节点设置常见于张量并行、流水线并行和数据并行,以及 prefill/decode 分离式推理工作负载。在上一篇文章中,我们介绍了 Ray Serve DLC,并用它在单个 GPU 节点上通过 HTTP 端点部署了一个小模型。你获得了一个可用的推理端点,而且该容器保持 GPU 栈(包括 CUDA 库)兼容,因此你无需编写样板代码。
Ray 是一个分布式计算框架,因此 Ray Serve 部署可以跨多个节点。客户使用多节点 Ray Serve 有多种原因。有些客户希望运行单个 GPU 无法容纳的基础模型或开放权重模型。另一些客户需要比单个副本所能提供的更高吞吐量。还有一些客户希望将推理的两个阶段分开以提升性能。在每种情况下,客户都必须自行构建依赖链:为 GPU 栈选择兼容的库,并在某个组件出现偏差时调试问题。这是一项非差异化工作,会耗费时间和精力,影响模型交付。
AWS Deep Learning Containers(DLC)长期以来一直为训练和推理工作负载解决这类问题。DLC 是预构建、性能优化的 Docker 镜像,将框架、其依赖项和 GPU 栈打包为一个经过测试和修补的组合,你可以立即拉取并使用。随着用于多节点部署的 Ray LLM DLC 的推出,同样的方法现在也扩展到了多节点推理。你将获得一个专为在 HTTP 端点后面提供模型服务而构建的容器,由 AWS 维护和测试,并且完整的推理栈已经组装完毕。
本文将介绍如何使用多节点 Ray LLM DLC 实现多节点分离式推理:在 Amazon EKS 上将单个大语言模型部署到两个 GPU 节点上,并在单个端点后面协同工作。其中一个 GPU 节点处理 prefill 阶段,另一个 GPU 节点处理 decode 阶段。将这两个阶段分开可以防止计算密集的长提示词阻塞已在处理中的请求的 token 生成。这种方法非常适合检索增强生成(RAG)、文档摘要和智能体应用等工作负载。我们使用多节点 Ray LLM DLC,它内置了 Ray Serve LLM、NVIDIA Inference Transfer Library(NIXL) 和 Elastic Fabric Adapter(EFA) 栈,并对外暴露 OpenAI 兼容 API,无需应用程序代码。完整代码可在配套仓库中获取。
为什么需要 prefill/decode(PD)分离
LLM 推理有两个不同的阶段。Prefill 并行处理整个输入提示并构建键值(KV)缓存。Decode 随后一次生成一个 token 的响应,读取并扩展该缓存。Prefill 受计算能力限制,而 Decode 受内存带宽限制。当两个阶段共享同一块 GPU 时,它们会争用相同的资源,突发性的、计算密集型的 prefill 工作会干扰稳定的、对延迟敏感的 decode 工作。将 prefill 阶段与 decode 阶段分离,意味着你可以为每个阶段选择硬件和服务属性,从而在大规模下提升整体性能。
PD 分离将两个阶段放在不同的节点上,因此每个阶段运行时互不干扰,并且可以独立扩展。代价是 prefill 期间构建的 KV 缓存必须传递给 decode 节点,而且该传输必须足够快,以免抵消收益。这正是节点之间的互连至关重要的原因。
Ray LLM DLC 提供的内容
AWS DLC 是预构建的、经过性能优化的 Docker 镜像,将框架、其依赖项以及 GPU 软件栈打包为一个经过测试和修补的组合,你可以立即拉取并使用。所有组件在每次发布前都会一起验证,因此 CUDA 运行时、框架和服务层之间不会出现版本漂移。安全补丁在构建时应用。
Ray LLM DLC 将此扩展到分布式 LLM 服务。它提供 vLLM 作为推理引擎、Ray Serve 的 HTTP 作为服务层、用于节点间 KV 缓存传输的 NIXL,以及用于高带宽节点间通信的 EFA 栈(libfabric 和 aws-ofi-nccl)。由于 Ray Serve LLM 库包含内置的应用程序构建器,整个服务应用程序就是一段 YAML。没有处理程序类,没有模型归档器,也不需要构建自定义镜像。一个辅助工具 build_pd_openai_app 接收 prefill 配置和 decode 配置,并在一个兼容 OpenAI 的端点后面连接它们之间的 KV 缓存传输。
架构
下图展示了部署在 Amazon EKS 上的布局。用户请求到达 CPU 系统节点上的 Ray 头节点,两个 GPU 工作节点运行模型的 prefill 和 decode 阶段。
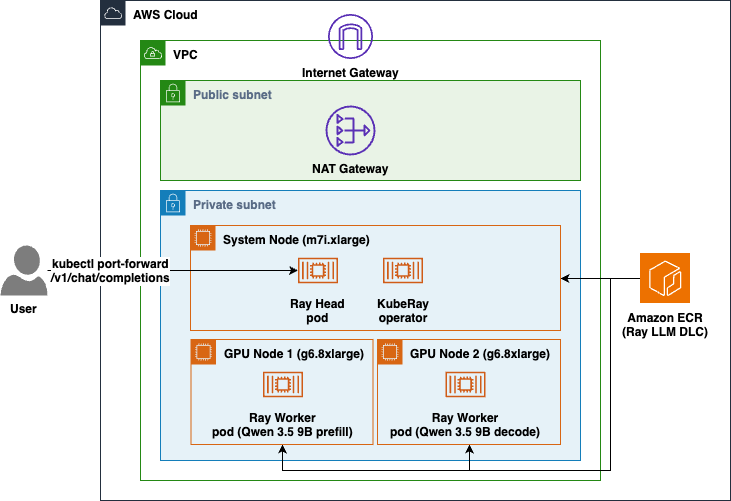
图 1:Amazon EKS 上的多节点推理架构,Ray 头节点位于 CPU 系统节点上,prefill 和 decode 阶段位于两个 GPU 工作节点上
该部署是虚拟私有云(VPC)内的一个 EKS 集群。节点在私有子网中运行,通过 NAT 网关进行出站访问。一个 CPU 系统节点(m7i.xlarge)承载系统工作负载、KubeRay 操作器以及仅使用 CPU 的 Ray 头 Pod。两个 GPU 工作节点(g6.8xlarge)运行 Ray 工作进程:一个服务于 prefill 阶段,另一个服务于 decode 阶段。两个节点都从 Amazon Elastic Container Registry (Amazon ECR) 拉取 Ray LLM DLC。
KubeRay 会监视你应用的 RayService,并自动连接头节点与工作节点的加入。Ray Serve 将 prefill 和 decode 部署放置在两个 GPU 工作节点上。KV 缓存通过 NIXL 从 prefill 工作进程流向 decode 工作进程,使用 EFA 通过 NIXL 的 libfabric 后端。GPU 节点组被固定到单个可用区(AZ),因为 EFA 无法跨 AZ。
先决条件
要跟随本文进行操作,你需要:
- 已启用计费的 AWS 账户。
- 在目标区域运行两个 g6.8xlarge 实例(至少 64 vCPU)所需的足够服务配额。
- 已配置凭证的 AWS 命令行界面(AWS CLI)。
- 用于与 Kubernetes 集群控制平面通信的 kubectl CLI。
- 用于在 EKS 上创建和管理集群的 eksctl CLI。
- 用于安装 KubeRay operator 的 helm(Kubernetes 包管理器)。
- 用于渲染清单的 envsubst 工具(GNU gettext 的一部分)。
使用以下命令验证您的 AWS 凭证是否有效:
aws sts get-caller-identity使用预构建的应用程序来提供推理服务
该应用程序是 manifest/rayservice.yaml 中的 serveConfigV2 块。它使用 build_pd_openai_app,该组件接收一个 prefill_config 和一个 decode_config,并在它们之间建立 KV 缓存传输连接:
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
deployment_config: { num_replicas: 1 }有几个设置起着决定性作用。max_model_len: 4096 将上下文大小调整为适配 GPU 上实测的 KV 缓存。dtype: bfloat16 和 gpu_memory_utilization: 0.90 设置精度以及 vLLM 可以占用的显存大小。enforce_eager: true 跳过 CUDA 图捕获以降低峰值 GPU 内存(取决于模型和输入)。kv_transfer_config 设置是使分离式架构得以工作的关键:两个阶段都使用 NixlConnector,配合 kv_role: kv_both 和各自不同的 engine_id(一个用于 prefill,另一个用于 decode)。关键设置是 kv_connector_extra_config: { backends: ["LIBFABRIC"] }。如果没有这一行,NIXL 会默认使用 UCX,即使在 EFA 上也只能以 TCP 速度运行。
清单的其余部分在 rayClusterConfig 中,描述了各个 pod。head pod 仅使用 CPU(num-gpus: "0")并固定到系统节点组。每个 worker pod 请求一个 GPU 和一个 EFA 接口(nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1"),并通过 nodeSelector: { role: gpu-worker } 定位到 GPU 节点。它运行 privileged: true,因为 NIXL 会将 CUDA 显存注册到 EFA 网卡。仅靠 IPC_LOCK 能力是不够的。worker 设置 FI_PROVIDER=efa,从 pod IP 读取 VLLM_HOST_IP,并挂载一个共享内存卷。内存限制远高于约 18 GiB 的检查点,以便操作系统页面缓存可以容纳它。对于在 g6.8xlarge 上使用上述缓存配置加载 Qwen3.5-9B 模型,重启时模型权重的加载时间从约 145 秒降至约 2 秒。
在 Amazon EKS 上部署
所有脚本共享一个配置文件 scripts/env.sh。该脚本包含 CLUSTER_NAME、REGION、K8S_VERSION 和 NAMESPACE 的默认值。其他默认值涵盖系统节点组和 GPU 节点组、KubeRay 版本以及模型。在运行脚本之前,通过导出变量来覆盖任何变量。
从项目根目录设置基础目录,然后加载变量:
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
步骤 1:创建 EKS 集群
./deploy_cluster.sh这会配置 EKS 集群(VPC、OIDC 提供商、核心附加组件)以及一个 CPU 系统节点组,用于运行系统工作负载、KubeRay operator 和 Ray head。节点运行在私有子网中,通过 NAT 网关进行出口访问,集群子网放置在提供 GPU 实例类型的可用区中。该脚本是幂等的,全新运行需要 15–20 分钟。
步骤 2:添加 GPU worker 节点
./deploy_node_group.sh这会创建 GPU 节点组:两个启用了 EFA 的 g6.8xlarge 实例,固定到单个可用区并标记为 role=gpu-worker,以便 Ray worker 定位到它们。启用 EFA 还会安装 EFA 设备插件,该插件会在每个节点上通告 vpc.amazonaws.com/efa。此步骤大约需要 5-20 分钟,首次运行时通常更长。
步骤 3:安装 KubeRay operator
./install_kuberay.sh这会使用 Helm 安装 KubeRay operator,并将其固定到系统节点组,以保持 GPU 节点可用于推理。KubeRay 会监视您接下来应用的 RayService,并自动连接 head 到 worker 的加入过程。此步骤大约需要 1–2 分钟。
步骤 4:部署 RayService
./deploy_ray_service.sh这会使用 envsubst 将你的镜像、模型和命名变量渲染到 manifest/rayservice.yaml 中并应用它。KubeRay 会创建 head 和两个 worker pod,Ray Serve LLM 会启动 prefill 和 decode 部署。脚本会等待 head 变为 Ready、两个 worker 都处于 Running 状态,最后等待 Serve 应用报告 RUNNING。由于每个节点都要加载模型,预计此步骤需要几分钟。
随时检查状态,包括每个 pod 落在哪个节点上以及可用的 GPU 容量:
./deploy_ray_service.sh status调用模型
Serve 应用健康后,KubeRay 会创建一个稳定的 <rayservice-name>-serve-svc Service。对其进行端口转发:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000由于 DLC 暴露了兼容 OpenAI 的 API,你可以列出模型并发送标准的聊天补全请求,无需自定义 schema:
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
验证 EFA 正在被使用
如果 NIXL 无法使用 libfabric,它会回退到 TCP 速度的传输,而且不会报错,因此值得确认它选择了哪个后端。在 worker 日志中 grep:
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh 在创建组时已经会打印每个节点的 vpc.amazonaws.com/efa 计数。要获得跨节点带宽数字,DLC 在 /usr/local/bin/all_reduce_perf 处附带了一个预构建的 NVIDIA Collective Communications Library (NCCL) 基准测试。
清理
为避免持续产生费用,请按相反顺序拆除资源:
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
结论与后续步骤
你在两个 GPU 节点上服务了单个模型,并实现了 prefill/decode 分离,整个应用只是一段 YAML,没有 handler 代码、没有模型归档器,也没有手工组装的 GPU 和 EFA 栈。多节点 Ray LLM DLC 提供了经过测试的推理栈,KubeRay 编排了 Ray 集群,EFA 上的 NIXL 在节点之间传输 KV 缓存。你的工作是配置它,而不是构建它。
运行多节点推理的常见模式包括张量并行和流水线并行(分片一个对单个实例来说太大的模型)、数据并行(复制模型以提高吞吐量)以及 prefill/decode 分离(将推理的两个阶段分离到不同节点上)。
从这里开始,你可以扩展 decode 副本以提高吞吐量,在更大的 GPU 实例上使用张量并行或流水线并行来运行更大的模型,或者为需要它们的模型在同一个经过测试的基础上叠加额外的库。有关完整代码、当前镜像标签列表以及底层机制,请参阅配套仓库、Ray LLM DLC 可用镜像页面、Ray Serve LLM prefill/decode 文档和EFA 文档。
关于作者

Ananth Raghavendra
Ananth 是 AWS 的高级 AI 解决方案架构师。他专注于使用 Amazon SageMaker HyperPod、Amazon EKS、Ray、SageMaker Serverless Inference、Amazon Nova Forge 和 Slurm 等平台和编排器,架构在 NVIDIA GPU、AWS Trainium 和 AWS Inferentia 上运行的分布式 Gen AI 应用。

Jinyan Li
Jinyan 是 AWS 深度学习容器团队的软件开发工程师,她构建和维护 ML 容器镜像,将 PyTorch、vLLM、Ray 和其他框架交付给在 Amazon SageMaker、Amazon Elastic Compute Cloud (Amazon EC2) 和 Amazon EKS 上运行工作负载的客户,包括本文中使用的 Ray LLM DLC。

Felipe Lopez
Felipe 是 AWS 的首席 AI/ML 专家解决方案架构师。在加入 AWS 之前,Felipe 曾在 GE Digital 和 SLB 工作,专注于工业应用的建模和优化产品。
来源:AWS Machine Learning Blog · aws.amazon.com