AWS 如何用 23 个可复用资产加速生成式 AI 交付
Accelerating generative AI delivery with reusable assets
AWS Generative AI Innovation Center(现属 AWS Frontier AI Engineering & Services)提供 23 个生产级可复用资产,可将生成式 AI 开发时间从数月缩短到数周。
如果你正在构建生成式 AI 解决方案,可复用资产可以帮助你避免重复构建已经存在的组件:检索增强生成(RAG)流水线、文档处理器、智能体脚手架等。这会带来累积成本:本应用于解决客户实际问题的時間被浪费了。
本文介绍如何访问来自 AWS 生成式 AI 创新中心(现隶属于 AWS Frontier AI Engineering & Services)的 23 个生产就绪资产精选目录。这些资产可以将你的开发时间从数月缩短到数周,并有来自 DoorDash、Lyft 和 Ricoh 等公司的证据支持。
自 2023 年以来,AWS 生成式 AI 创新中心已发布开源可复用资产。这些生产级构建块为你提供了一个经过验证的基础,而不是从空白文件开始。这些资产已为客户的解决方案提供支持,并带来了可衡量的成果:测试容量提升 50 倍、工程时间减少 90%、部署时间从数月压缩到数周。在本文中,你将了解为什么团队会不断重建生成式 AI 组件、是什么让资产真正可复用、像 DoorDash 和 Ricoh 这样的公司如何通过使用这些资产取得可衡量的成果,以及如何访问和部署目录中的 23 个开源资产。有关所有可用资产的完整列表,请参阅本文末尾的资产目录。
问题:为什么团队会不断重建
三个根本原因导致生成式 AI 团队中的重复开发:
- 没有单一事实来源 – 资产分散在代码仓库、wiki 和驱动器中。构建者找不到已有的内容,因此从头开始重建。
- 没有质量信号 – 如果没有对生产就绪性、安全审查或维护状态的验证,构建者就无法信任现有解决方案,只能默认编写自己的代码。
- 没有复用文化 – 共享仍然是非正式且缺乏治理的。一个团队构建的内容只留在该团队中,问题被反复解决。
重建的成本会累积。每次冗余构建都会消耗工程时间、延迟客户交付并造成维护负担。即使是 AI 生成的代码也需要生产加固、安全审查、大规模测试和持续维护。这些资产在交付时已经过验证、安全审查和生产级打磨,避免了这种验证负担。当团队最终进入生产环境时,他们已经花费数周时间在无差别的繁重工作上,而这些工作本应从第一天起就可复用。AWS Frontier AI Engineering & Services 通过可复用资产解决了这一挑战。
可复用资产究竟是什么
可复用资产不是代码片段或示例。它是一个生产级、可组合的构建块,实现了一项离散的生成式 AI 能力。可复用资产在发布前会经过质量和安全验证。它们包含清晰的部署指南以便于发现,并经过埋点以跟踪跨客户参与度的采用情况。这些资产在其整个生命周期中都会得到维护。
目录中的示例包括 RAG 流水线组件、文档摄取模块、智能体脚手架模板、评估框架和提示词管理模式。这些资产在生产环境中经过测试、接受安全合规审查,并根据真实客户反馈进行改进。
这就是一次性产物与可信赖构建模块之间的区别。
真实成果:客户成功案例
可复用资产的价值并非理论。以下是团队基于经过验证的基础构建、而非从零开始时发生的情况。
Contact Center GenAI Agent:DoorDash 与 Lyft
根据 AWS 案例研究,DoorDash 使用 Contact Center GenAI Agent 资产构建了完全语音操作的自助式生成式 AI 联络中心解决方案。据报道,该解决方案每天处理超过 100,000 通电话,响应延迟为 2.5 秒,测试容量提升了 50 倍。使用 Amazon Bedrock 将开发时间缩短了 50%。该团队在 2 个月内达到了实时测试就绪状态。
Lyft 使用相同的 Contact Center GenAI Agent 资产,为乘客和司机实现了代理式 AI,展示了该资产在不同客户互动模式下的多功能性。
Contact Center GenAI Agent 为文本和语音渠道提供自动问答能力。它采用 RAG 架构来促进多轮对话并保持上下文。该解决方案与 Amazon Connect 集成,并使用 Amazon Bedrock Knowledge Bases(一项完全托管的 RAG 能力)进行混合搜索和元数据过滤。
了解更多:
GenAI 智能文档处理:Ricoh
Ricoh 为大型健康保险支付方、管理式医疗组织和医疗保健提供商提供服务。这些客户每月处理数十万份关键文档,包括保险理赔、申诉、上诉和临床记录。随着 Ricoh 扩大规模以服务更多医疗保健客户,他们需要一种标准化的多租户文档处理方法。该方法必须能够接入新的实施,而无需为每一个实施进行独特的开发和调优。
以 Accelerated Intelligent Document Processing on AWS 资产为基础,Ricoh 构建了一个标准化的多租户解决方案,用于自动化文档分类和提取。这将其文档处理从定制工程的瓶颈转变为可扩展、可重复的服务。
成果:如已发布的案例研究所述,Ricoh 实现了 7 倍的吞吐量增长,从每月 10,000–70,000 份文档提升。每次部署的工程工时下降了 90% 以上(从 80 小时降至 5 小时以下)。接入时间从 4–6 周缩短至 2–3 天。该系统现在可在流量高峰期间于几分钟内处理 1,000 份文档,每年可节省超过 1,900 个潜在人工工时。
GenAI IDP Accelerator 在这篇 2025 年博客文章中介绍,是一个可扩展的无服务器解决方案,使用 AWS 服务进行自动化文档处理和信息提取。该系统将光学字符识别(OCR)与生成式 AI 相结合,大规模地将非结构化文档转换为结构化数据。AWS Frontier AI Engineering & Services 也持续维护这些资产。
了解更多:
- 博客文章:AWS GenAI Intelligent Document Processing (IDP) Accelerator
- 博客文章:Ricoh 如何在 AWS 上构建可扩展的智能文档处理解决方案。
- 源代码:accelerated-intelligent-document-processing-on-aws
新资产:构建智能体 AI 的未来
随着团队将重心从基础设施转向业务逻辑,可复用资产变得更有价值。最近发布的两项资产展示了可复用构建块如何加速下一代智能体应用的开发。
全栈 AgentCore 解决方案模板(FAST)
全栈 AgentCore 解决方案模板(FAST)是一个入门项目仓库。借助 FAST,你可以快速部署一个安全的 React 前端,并连接到 Amazon Bedrock AgentCore——这是一个可使用任意框架或模型大规模构建、连接和优化智能体的平台。在此实现中,FAST 使用基于 React 的前端和 AgentCore 的托管基础设施,将全栈智能体应用的构建时间从数周缩短至数天。
FAST 使用基础设施即代码(IaC)在 30 分钟内完成部署,并内置了与 AgentCore memory(Amazon Bedrock AgentCore 的一项能力)以及 Gateway、Code Interpreter 和 Observability 的集成。身份验证使用 Amazon Cognito,并按企业安全最佳实践进行配置;该模板专为 AI 辅助开发而设计,配有详尽的文档和引导文档。
借助 FAST,你可以获得完整的参考架构,了解各部分如何集成,并得到一个可运行的全栈应用,供你学习和在此基础上构建。得益于模块化设计,你可以随着需求变化替换主要组件(身份提供商、前端框架、托管解决方案或智能体框架)。
了解更多:
智能体聊天机器人加速器
智能体聊天机器人加速器是一种 Web 应用部署解决方案,使用 AWS Cloud Development Kit(AWS CDK)实现基础设施即代码,以便你创建智能体聊天机器人。该解决方案基于 Strands Agents 和 Amazon Bedrock AgentCore 构建,简化了智能体聊天机器人应用的开发。
该加速器使用 AWS CDK 实现快速部署,并通过 Strands Agents 和 Amazon Bedrock AgentCore 提供可扩展的智能体运行时管理。它可配置、可扩展,适用于多种聊天机器人用例,内置了身份验证、托管和扩展的预配置模式,并已在客户部署中得到验证。
了解更多:
演练:使用库中的资产
让我们通过一个具体示例,演示如何从开源目录中选择并使用联络中心 GenAI 智能体资产。
前提条件
要完成本演练,你需要:
- 一个 AWS 账户,并具有创建 AWS CloudFormation 堆栈、Amazon Connect 实例、Amazon Bedrock 资源和 Amazon Quick Sight 控制面板的权限。
- 已安装并配置了适当凭证的 AWS Command Line Interface(AWS CLI)。
- 一个 Amazon Connect 实例(或创建该实例的权限)。
- 在 Amazon Bedrock 上访问 Anthropic Claude Sonnet 和 Anthropic Claude Haiku 的权限。
- 一个用于验证测试的 Jupyter notebook 环境。
场景
你正在构建一个客户支持解决方案,需要处理语音和文本交互、使用公司知识库回答问题,并将复杂问题升级给人工坐席。
查找资产
在 GitHub 上导航到 Contact Center GenAI Agent。README 清晰概述了功能、架构和部署步骤。下图展示了 Contact Center GenAI Agent 的解决方案架构。
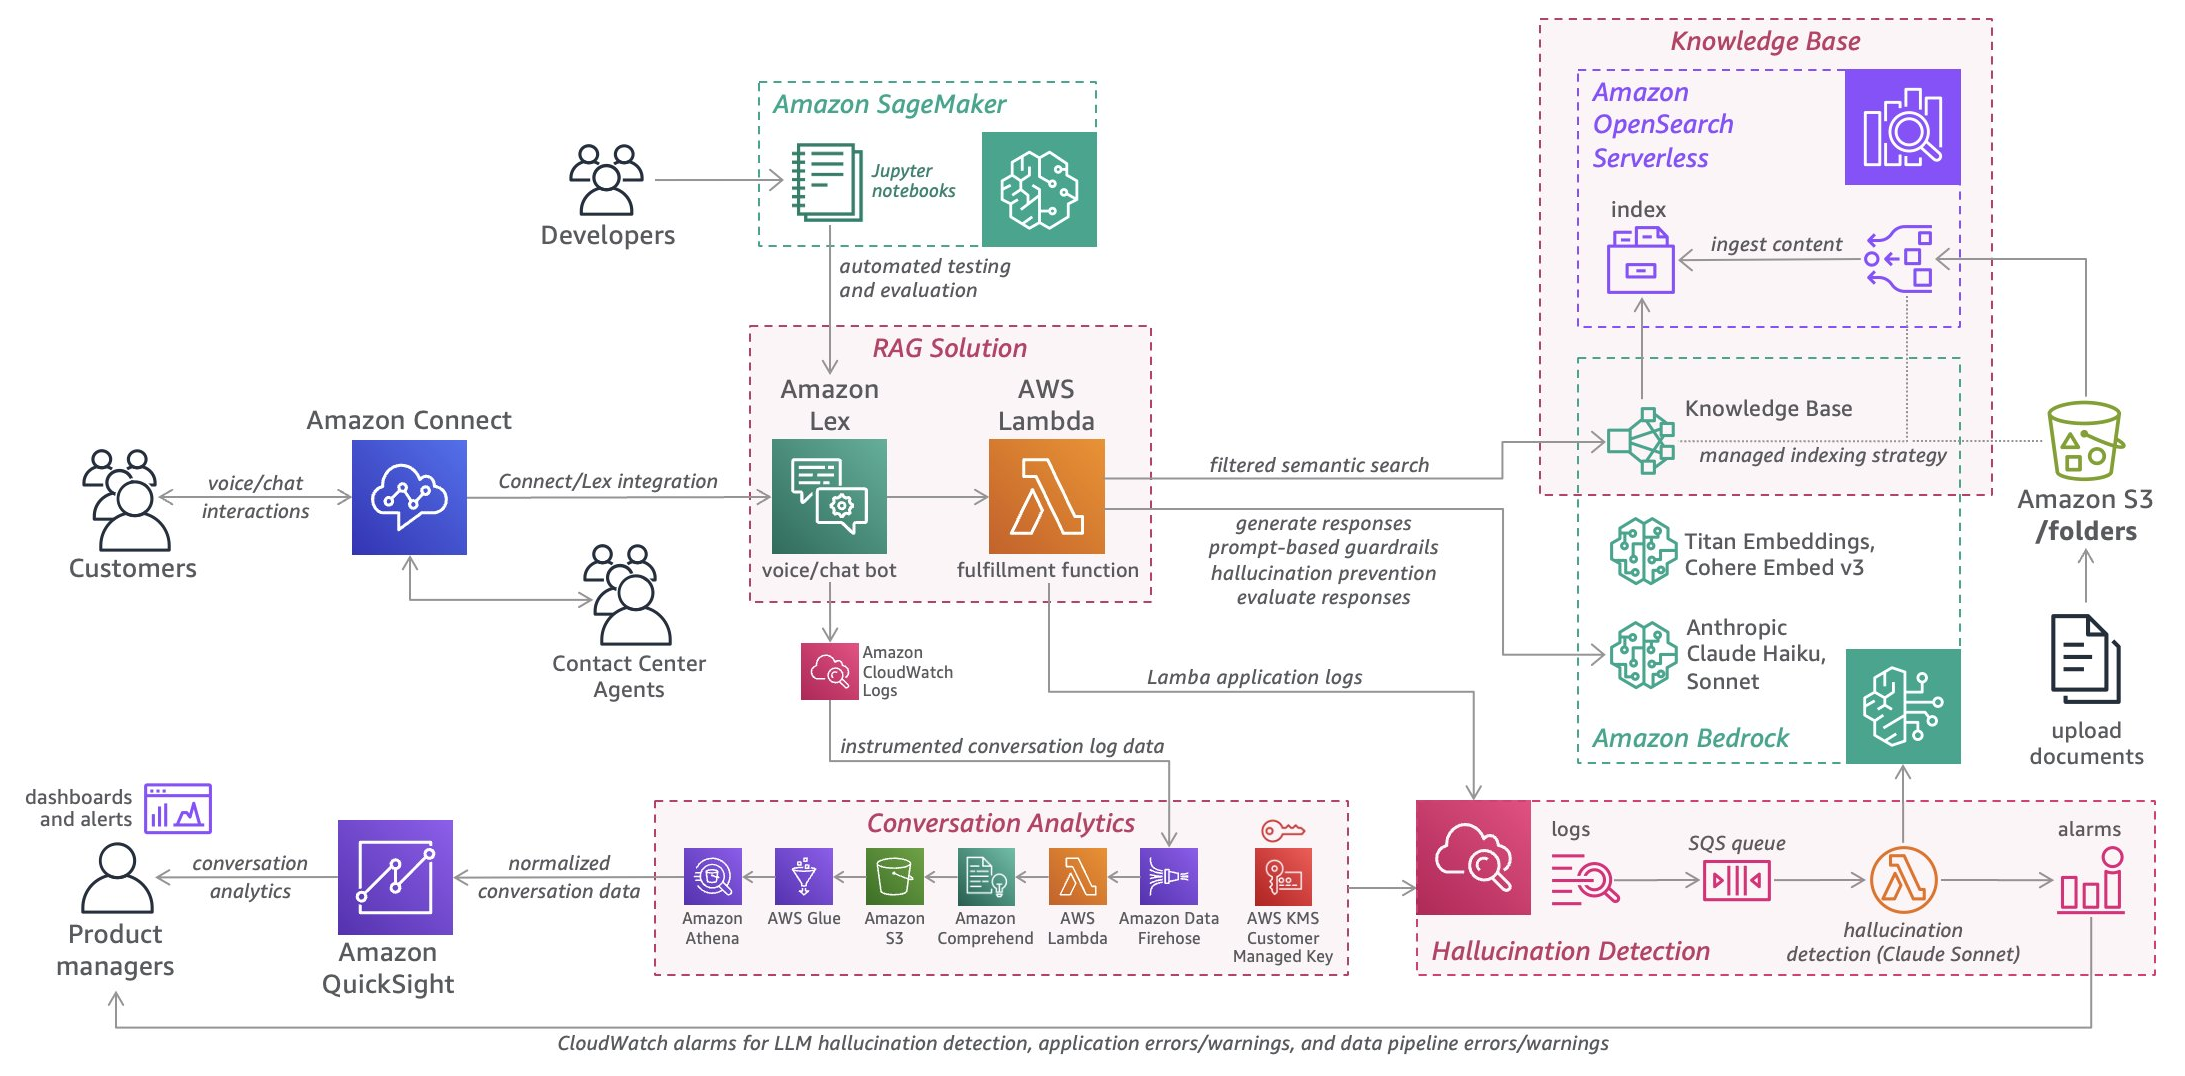
图 1:Contact Center GenAI Agent 的解决方案架构
评估该资产
该资产包含经过安全审查的代码,采用 AWS CDK 基础设施即代码,与 Amazon Connect 集成以支持语音和聊天,并使用 Amazon Bedrock Knowledge Bases(一项完全托管的 RAG 能力)进行问答。内置了自动化测试框架和对话分析仪表板。
负责任 AI 控制是该架构不可或缺的一部分。Amazon Bedrock Guardrails 实施生产级安全控制,包括幻觉检测、内容过滤和主题级边界,确保智能体从第一天起就在定义的安全参数内运行。
该仓库显示出活跃的维护、全面的文档,以及指向验证生产就绪性的客户成功案例(DoorDash、Lyft)的链接。
部署解决方案
部署遵循四个步骤:
- 克隆仓库并安装依赖项。
- 部署两个 AWS CloudFormation 模板:一个用于 Knowledge Base 堆栈,一个用于 RAG 解决方案堆栈。
- 使用仓库中包含的预构建联系流与 Amazon Connect 集成。
- 使用包含的 Jupyter notebook 验证部署。
整个过程耗时不到一小时。该解决方案还包括一个 Amazon Quick Sight 仪表板,用于实时对话分析。
有关详细的部署说明和先决条件,请参阅部署指南。
清理
为避免持续产生费用,请删除本演练期间创建的资源。部署使用两个 AWS CloudFormation 堆栈,因此删除按相反顺序进行:
- 从 AWS CloudFormation 控制台删除 RAG 解决方案堆栈。
- 从 AWS CloudFormation 控制台删除 Knowledge Base 堆栈。
- 删除集成期间创建的 Amazon Connect 联系流。
- 删除 Amazon Quick Sight 仪表板及任何关联的 SPICE 数据集。
- 有关详细的清理说明,请参阅部署指南。
成果
无需花费数周从头构建联络中心解决方案,您可以在几天内部署一个经过安全审查、经过测试的基础。您的团队专注于定制知识库、为您的领域优化提示词,以及与现有系统集成。这才是让您的解决方案脱颖而出的高价值工作。
预计节省时间:4–6 周开发时间
您转而专注于:领域特定定制、提示词工程、业务逻辑集成
访问 AWS Generative AI Innovation Center 开源资产
您可以在 GitHub 和 AWS Labs 上以开源形式访问 23 个可复用资产。每个资产都包含部署指南、示例代码和文档,帮助您快速上手。
文档处理与提取
- GenAI Intelligent Document Processing (GenAIDP) – 可扩展的无服务器解决方案,用于自动化文档处理。
- Multi-lingual Document Processor (MDP) – 将复杂的多模态文档转换为结构化文本。
- Intelligent Document Processing with Generative AI – 从自定义文档中提取信息。
- Extracting Information From Complex Documents – 文档提取动手实践研讨会。
- 半结构化文档自动预标注工具 – 为 Amazon Comprehend 自动执行预标注。
联络中心与语音
- 联络中心 GenAI 智能体 – 为语音和文本渠道提供自动问答。
- 带坐席辅助的实时通话分析(LCA) – 为客户与坐席语音通话提供实时生成式 AI。
- 联络中心:通话后分析(PCA) – 对通话后录音进行生成式 AI 分析。
- 实时会议助手(LMA) – 从基于浏览器的会议中捕获音频,并提供转录与洞察。
- 录音语音洞察提取 Web 应用(ReVIEW) – 上传录音并使用生成式 AI 回答问题。
智能体 AI 与聊天机器人
- 全栈 AgentCore 解决方案模板(FAST) – 部署带 AgentCore 后端的安全 React 前端。
- 智能体聊天机器人加速器 – 为智能体聊天机器人部署 Web 应用。
- 时尚助手智能体 – 基于 Amazon Bedrock AgentCore 上的 Amazon Titan 构建的时尚助手。
- 自然语言数据库智能体 – 使用 LangGraph 以自然语言查询数据库。
RAG 与知识库
- 使用 Terraform 部署 Amazon Bedrock 知识库 – 知识库的基础设施即代码。
- 利用用户改进 RAG 用例中的智能体 – 用于对话式 RAG 的自定义 LangChain 工具。
- 重排序器微调与部署 – 微调 BAAI BGE Reranker 以改进检索。
- Amazon MemoryDB 中的持久语义缓存 – 为 GenAI 应用提供持久语义缓存。
开发与迁移
- C 到 Java 代码转换 – 用于遗留代码迁移的智能体工作流。
- OpenAI 迁移框架 – 用于大语言模型(LLM)迁移的系统化框架。
- 微调 ModernBERT 用于意图分类 – 创建智能 LLM 路由系统。
基础设施与运维
- Bedrock 日志记录自动化 – 自动为 Amazon Bedrock 设置日志记录。
- 数据分析师 BI – 面向非专家的 AI 驱动商业智能工具。
开始使用:
- 选择前面列出的某个资产。
- 查看与你的用例相关的资产的 README 和部署指南。
- 克隆仓库并按照部署说明操作。
- 根据你的具体需求自定义该资产。
- 联系 AWS Frontier AI Engineering & Services 团队获取咨询支持。
结论
重建的成本是真实存在的,而且会不断累积。当团队重建 RAG 管道、重新创建文档处理逻辑或从头开始时,这些时间会累积成工程时间,而这些时间本可以用于解决实际的客户问题。
经过整理和验证的资产目录改变了生成式 AI 交付的经济性。不是替你完成工作,而是确保你不会重复做已经完成的工作。自 2023 年以来发布的 23 个开源资产代表了数千个工程小时、数十个客户合作以及无数经验教训。它们被打包成你今天就可以部署的构建模块。
这些资产是开源的。部署指南很全面。客户的成功案例是真实的。从与你当前挑战相匹配的一个资产开始。如需专家协助,请联系 AWS Generative AI Innovation Center。
关于作者

Sabine Khan
Sabine 是 AWS Frontier AI Engineering & Services 中生成式 AI 可复用资产与资产治理的全球技术负责人。她通过交付生产就绪的 AI 系统并推动智能体 AI 项目从概念到部署,帮助 AWS 客户扩展其生成式 AI 战略。她在技术创新、机器学习和计算机视觉领域拥有超过 20 年的经验,将先进研究与企级生产系统相连接。在加入 AWS 之前,她曾在休斯顿能源行业领导跨职能工程组织和大型数字化转型计划。Sabine 拥有地球科学硕士学位和信息技术 MBA 学位。

Harshit Kumar Gupta
Harshit 是 Amazon 的机器学习工程师,拥有超过 10 年跨越软件开发、生成式 AI 和自然语言处理的经验。他专注于构建智能体和负责任 AI 系统,弥合先进研究与生产就绪解决方案之间的差距。在 Amazon、Intel Security、CognitiveScale 和 Cadence 的职业生涯中,他有机会接触深度学习、NLP 和大规模分布式系统。他拥有 IIT Delhi 的技术硕士学位。他在 AI Assets 的工作为 AWS 从业者提供了从研究到现实世界影响的洞见。

Sanchita Basak
Sanchita 是 AWS Frontier AI Engineering & Services 的数据科学家,她将自身专长应用于智能体系统、物理 AI 和大规模机器学习不断演变的领域。她拥有 Vanderbilt University 的理学硕士学位,多年来构建了涵盖自然语言处理、预测分析和预测应用的机器学习系统。她的同行评审研究已发表在多个国际期刊和会议上,并获得了最佳论文奖。她专注于将 AI 研究转化为解决业务问题的生产系统,帮助企业客户实施推动运营效率和战略成果的 ML 解决方案。
来源:AWS Machine Learning Blog · aws.amazon.com