Epoch AI 用内部工作任务评测前沿模型:Claude Fable 5.1 与 GPT-6 Astra 平均只得 65%
Epoch AI 推出 Epoch Automation Reports,把图形设计、研究项目规划等日常工作交给 AI,并按人类员工标准评分,领先的 Claude Fable 5.1 和 GPT-6 Astra 平均得分 65%,即只满足 65% 的评分项,仍算任务失败。
Epoch AI:Gradient Updates· Kelly Hong·2026-10-27 00:33· 1 小时前AI 评分59
AI 能自动化 Epoch 吗?
AI 导读
Epoch AI 介绍其 Epoch Automation Reports,将图形设计、研究项目规划等日常工作交给 AI,按对人类员工的评分标准评估。领先的 Claude Fable 5.1 和 GPT-6 Astra 平均得分 65%,即达到人类标准中 65% 的评分项,仍算任务失败。
正文 · 原文
这是更长的报告的摘要 ,发布在我们的网站上。
AI 年复一年地不断刷新新的基准测试。然而,即便 AI 超越人类的基准测试清单持续增长,AI 实际的经济影响似乎增长得更慢。
这种“生产力悖论”反映了基准测试的几个事实:它们通常被校准为衡量前沿 AI 相较过去能力的进步(而非与人类表现对比);它们往往局限于性能易于评分的任务;而且 AI 有时会针对基准测试进行训练,就像高中生被教导应对 SAT 一样。所有这些都在 AI 的基准测试得分与其在现实世界中实际能做的事情之间造成了差距。
为了更好地理解 AI 距离胜任真实人类工作还有多远,我们需要弥合这一差距的方法。
去年二月,Epoch 高级研究员 Anson Ho 尝试将自己的工作自动化,测试 AI 能在哪些任务上胜任——又在哪些地方力有不逮。答案是:它在所有任务上都失败了,但他预测到本十年末情况将不再如此。
最近,我们将这一初步尝试扩展为 Epoch Automation Reports,这是一组我们在 Epoch 定期执行的任务,例如图形设计和研究项目规划,我们按照对人工工作的相同标准来评估 AI。
在这些任务上评估 AI 比大多数标准基准测试更费功夫,但更能代表真实工作的挑战:它们要求模型收集上下文、使用工具,并处理 Epoch 人类员工所面对的复杂性。
那么,模型表现如何?
领先的 Claude Fable 5.1 和 GPT-6 Astra 平均得分 65%。这意味着它们的输出满足了人类员工将被评估的 65% 的评分项——100% 的得分意味着可以放心地将该任务自动化。
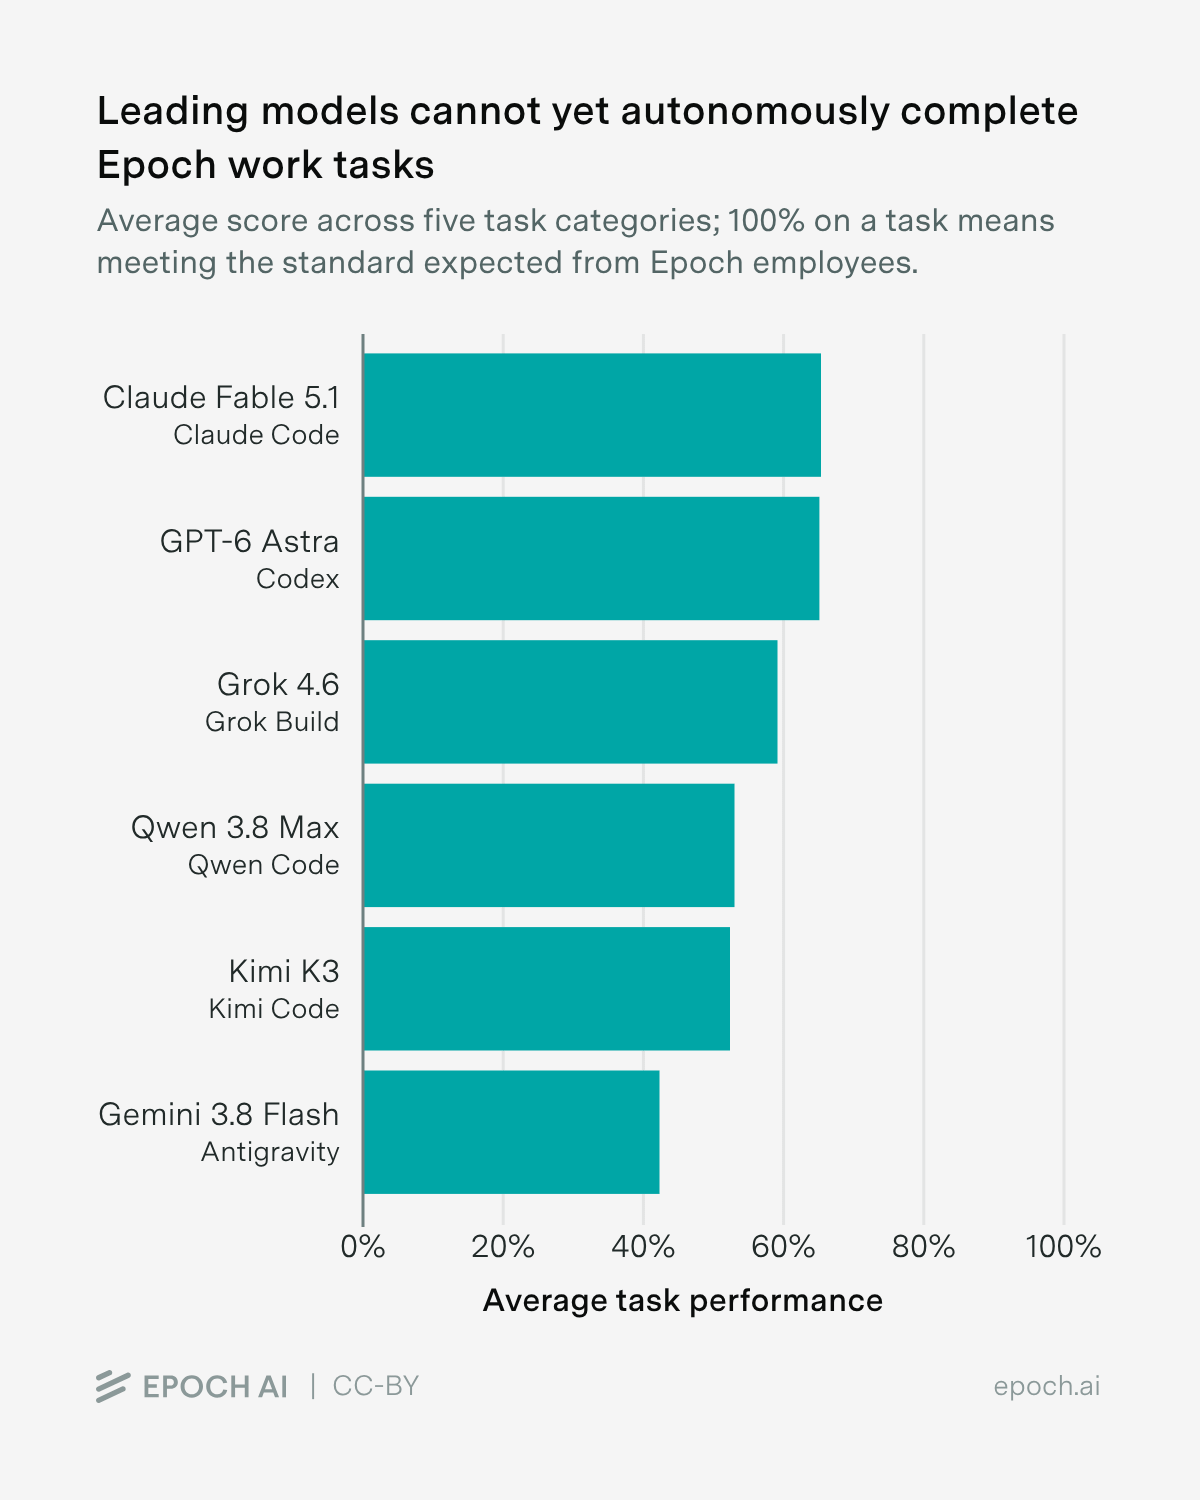
65% 的得分仍算任务失败
这些结果并不一定意味着我们在时间或任务难度上已走完自动化的 65%,尽管领先的 AI 能达到 Epoch 人类员工所需质量的 65%。
首先,这些得分可能反映的是在较容易的评分项上的成功。例如,AI 能生成有前景的研究方向,但在创建可执行实验这一更难的任务上表现不佳。在进行一项试点实验时,GPT-6 Astra 为其评估的模型设置的 token 预算过低,导致 22% 的运行无法返回任何答案。但它随后将这些失败视为关于模型能力的关键发现,而非设置缺陷。
总体而言,AI 在定义明确的任务(如编码和数据分析)上表现更好,在开放式任务(如从示例中归纳模式以及涉及判断的任务)上表现更差。当被要求设计一张图形并提供许多 Epoch 风格的示例时,Fable 5.1 生成了一张杂乱无章的图表,塞满了过多信息,无法有效传达。相比之下,一位 Epoch 设计师接到该任务后,提供了一张干净简洁的图表。
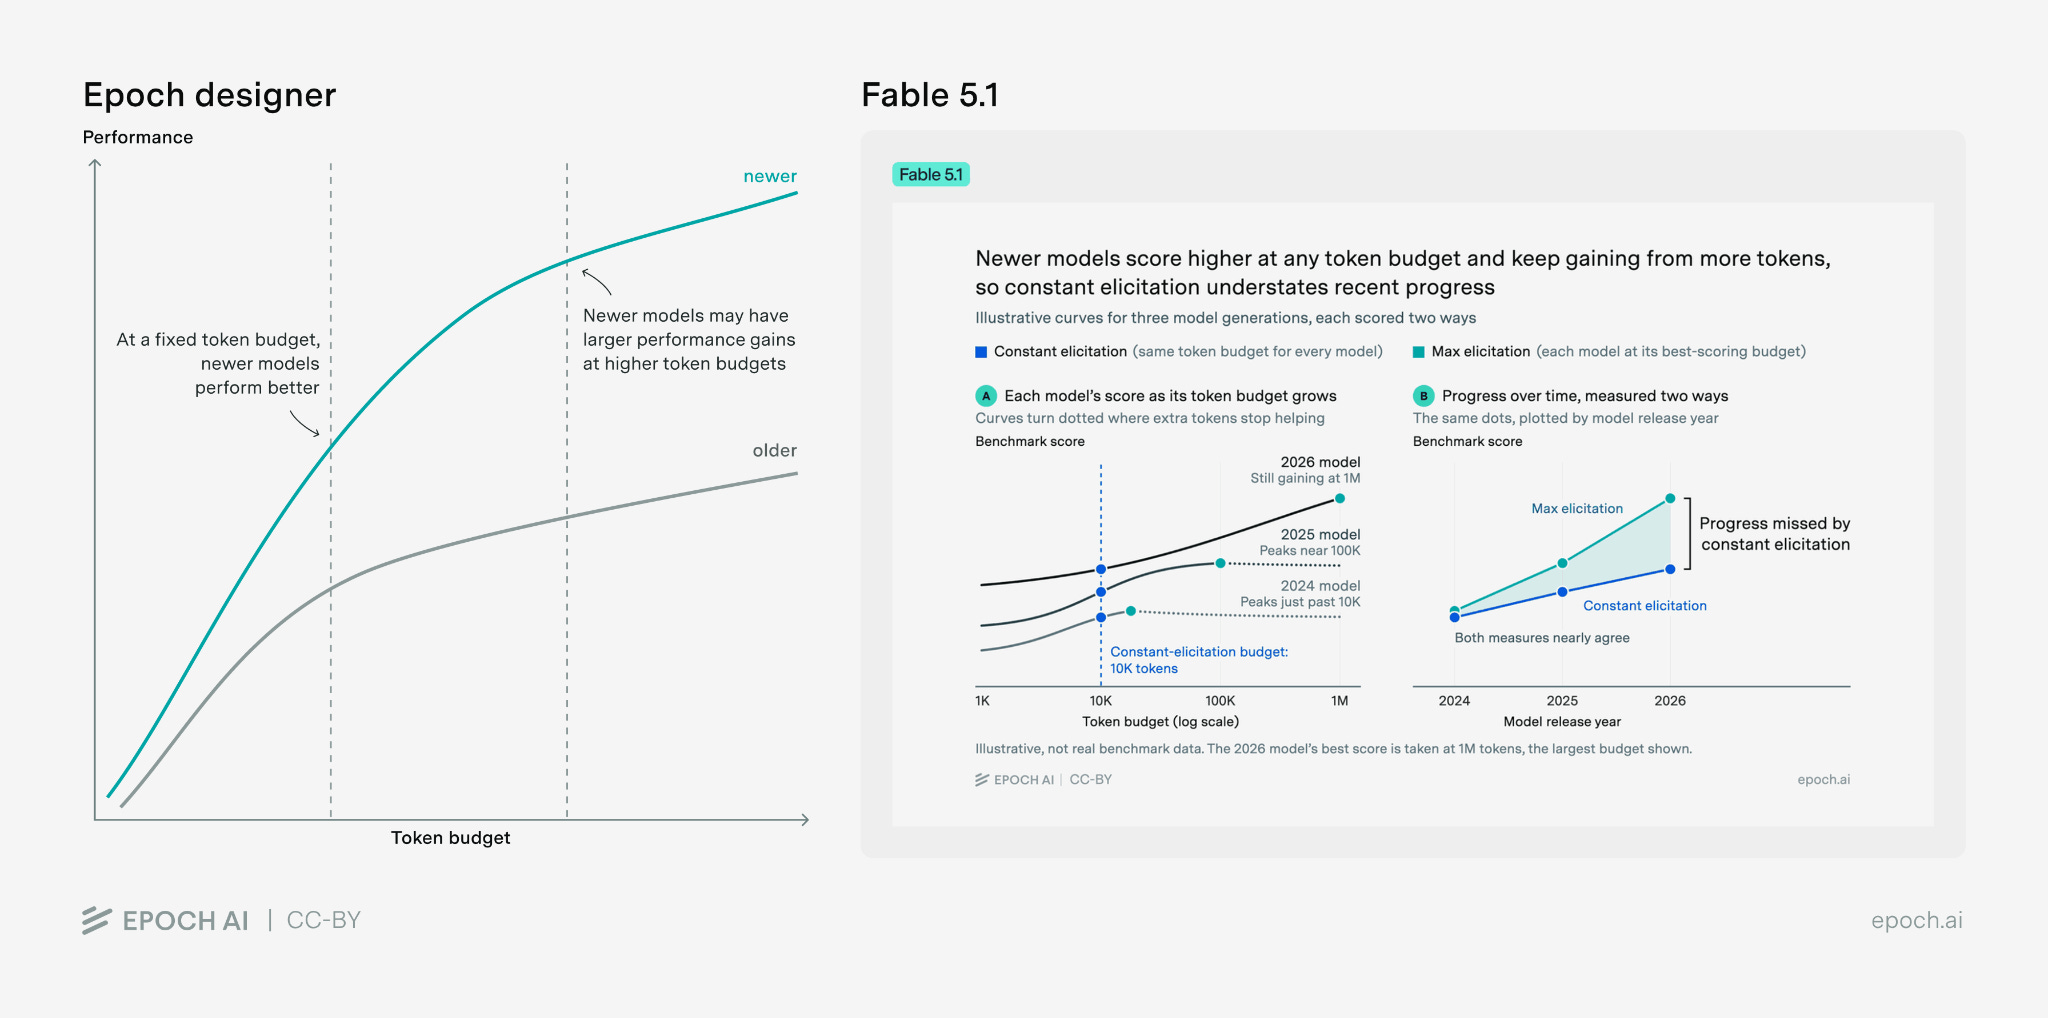
这些发现为经济影响为何滞后提供了一种可能的解释——65% 并不足够。如果这些任务由人类提交,每一个都会被拒绝或修改。虽然此类输出可能有所帮助,但它们仍然需要人类来评估并修正每一个错误。但随着 AI 持续进步,它将在更多任务上突破 100% 的门槛,届时人类会把那项任务交给 AI。
在这次评估中,已经有一项任务出现了这种情况。我们移除了一项基础图表生成任务,因为 Fable 5.1 大多数时候能在一次尝试中生成可接受的图表。Epoch 现在已将这一步骤部分自动化到我们的日常工作中。随着 AI 在更多任务上达到人类质量门槛,我们预计会看到更大的经济影响。
感谢阅读!免费订阅以接收新文章。
来源:Epoch AI:Gradient Updates · epochai.substack.com
来源:RadarAI · aihot.news