LLMxRay:面向本地 LLM 的开源可观测性工具
Show HN: LLMxRay an open-source observability tool for LLMs
LLMxRay 是一款面向本地 LLM 的开源可观测性工具,通过 npx llmxray 或 Docker 一条命令启动,无需云端、API key 和费用。

看看你的 AI 实际在做什么。
面向本地 LLM 的实时 token 流式输出、质量分析、性能剖析与成本追踪。
无需云端。无需 API 密钥。零成本。
🌐 English • Français • 中文 • العربية • Srpski
快速开始 • 功能特性 • 截图 • 适用人群 • 更新日志
你将获得
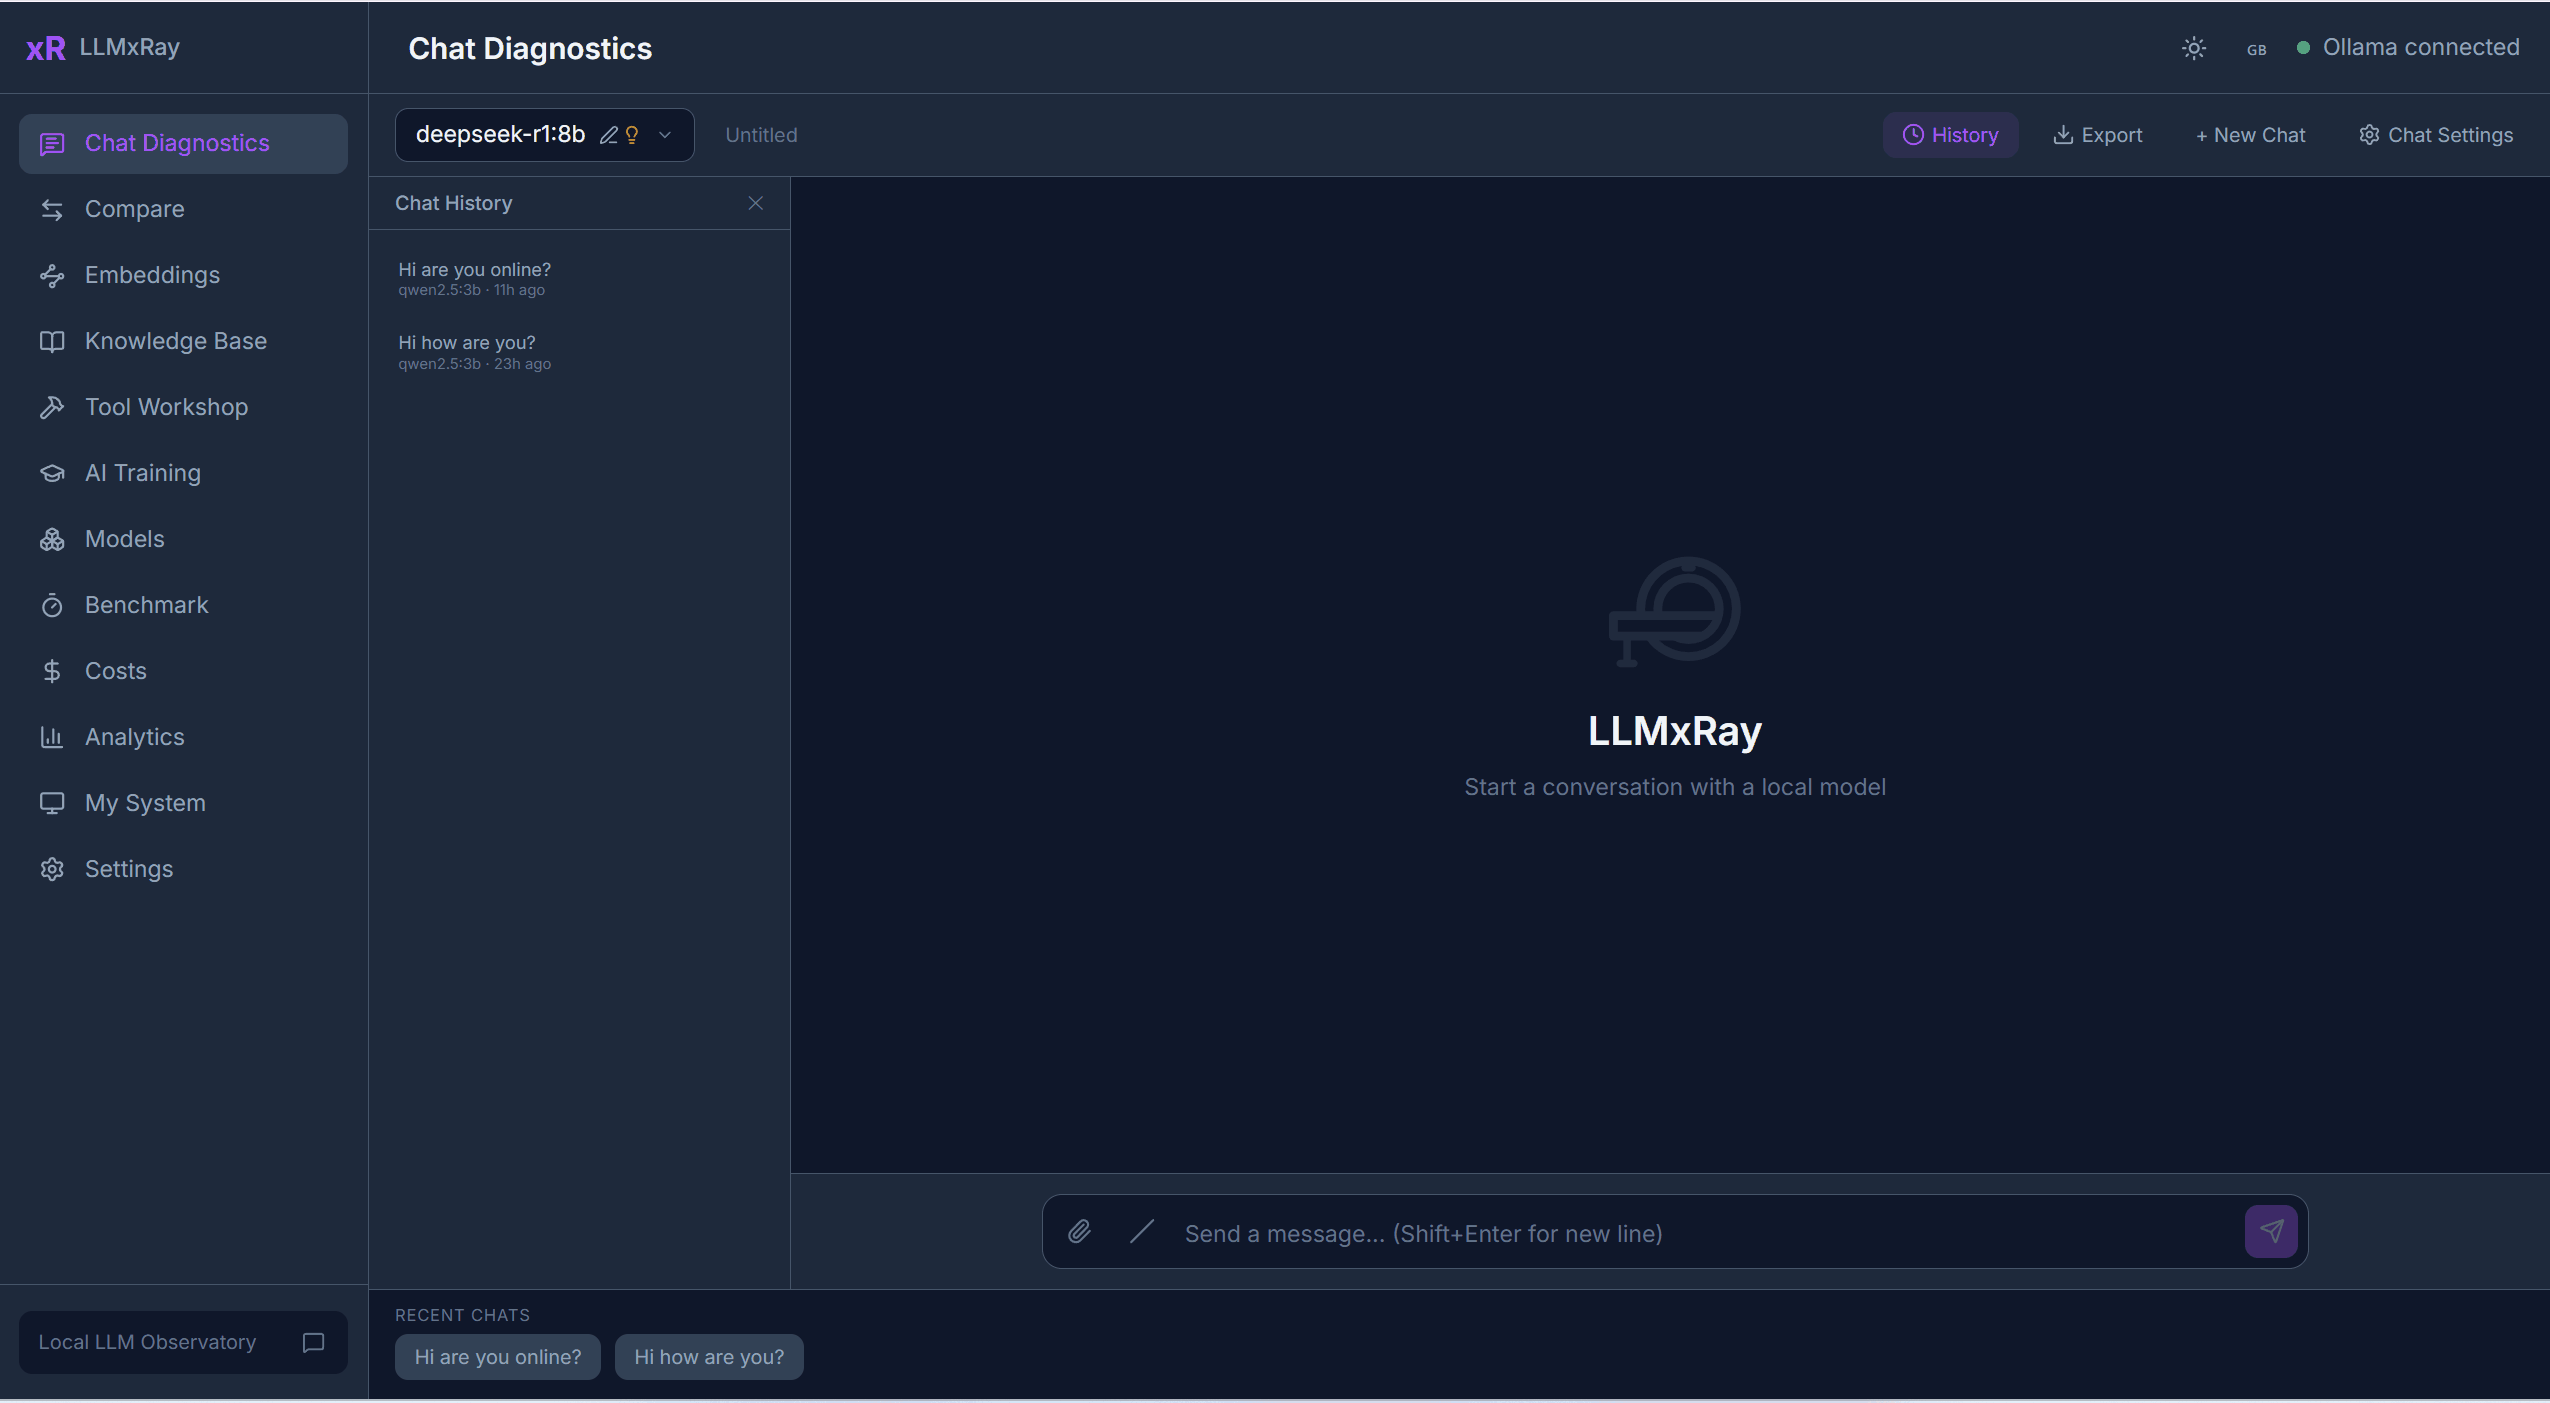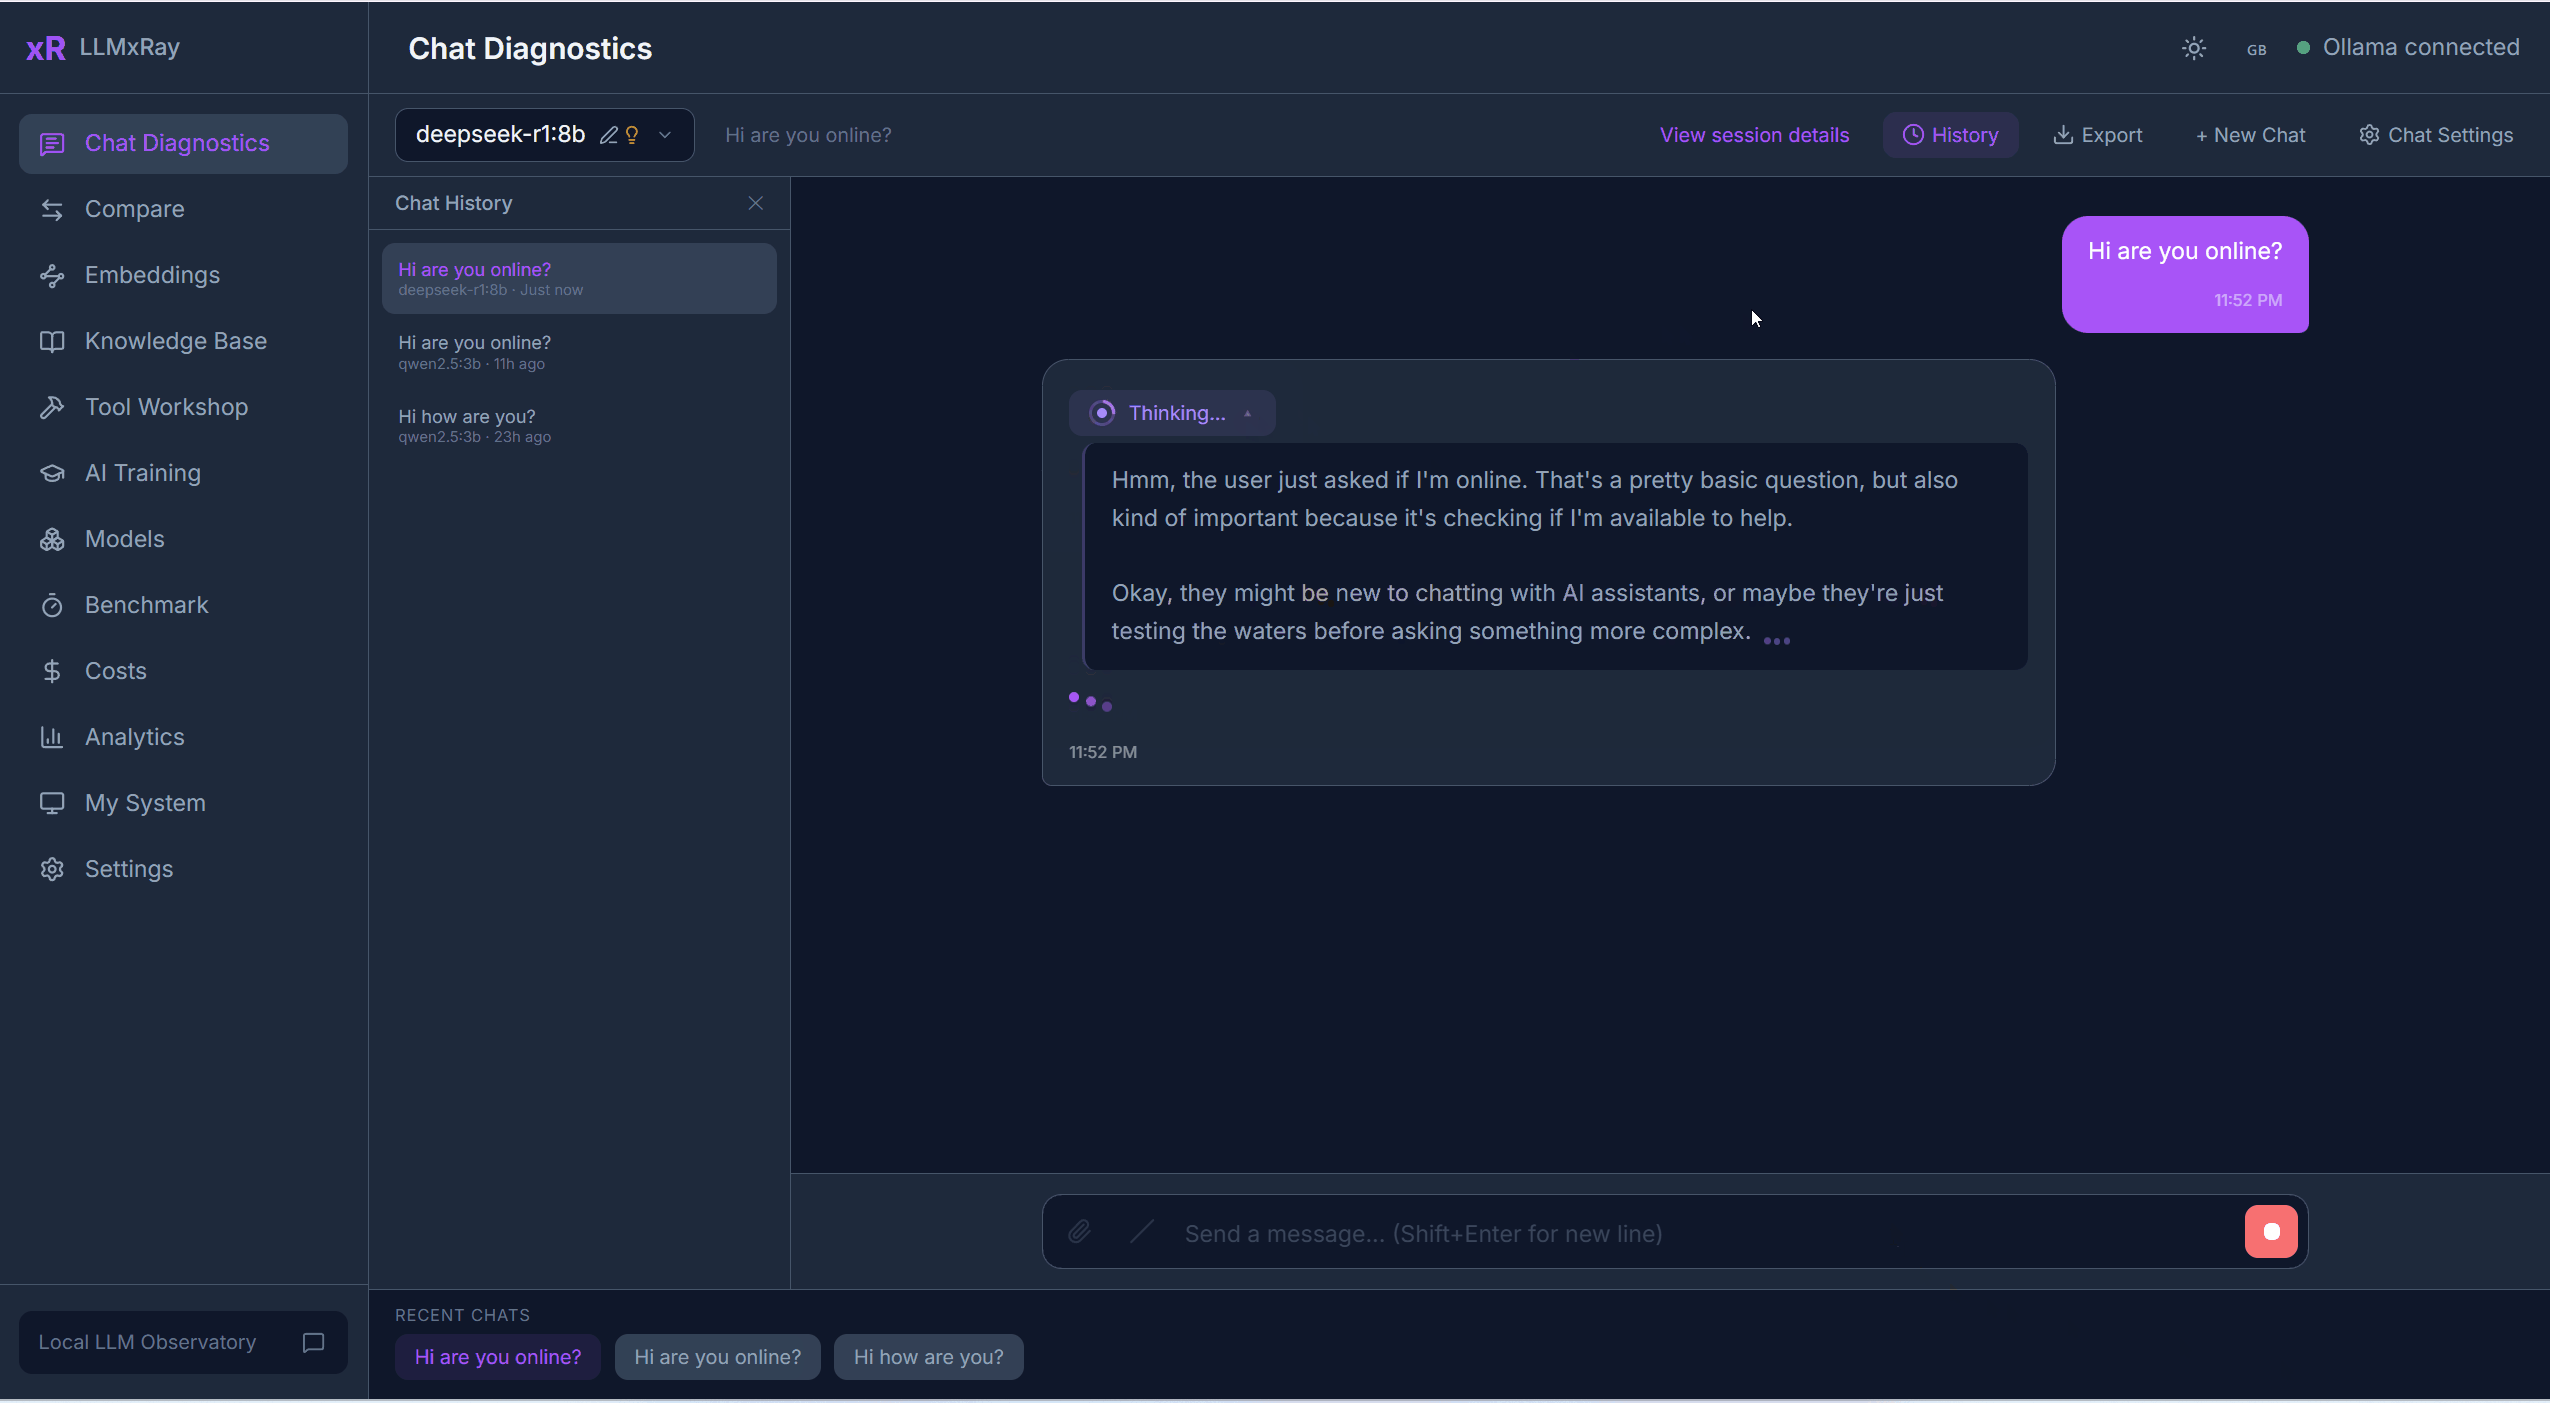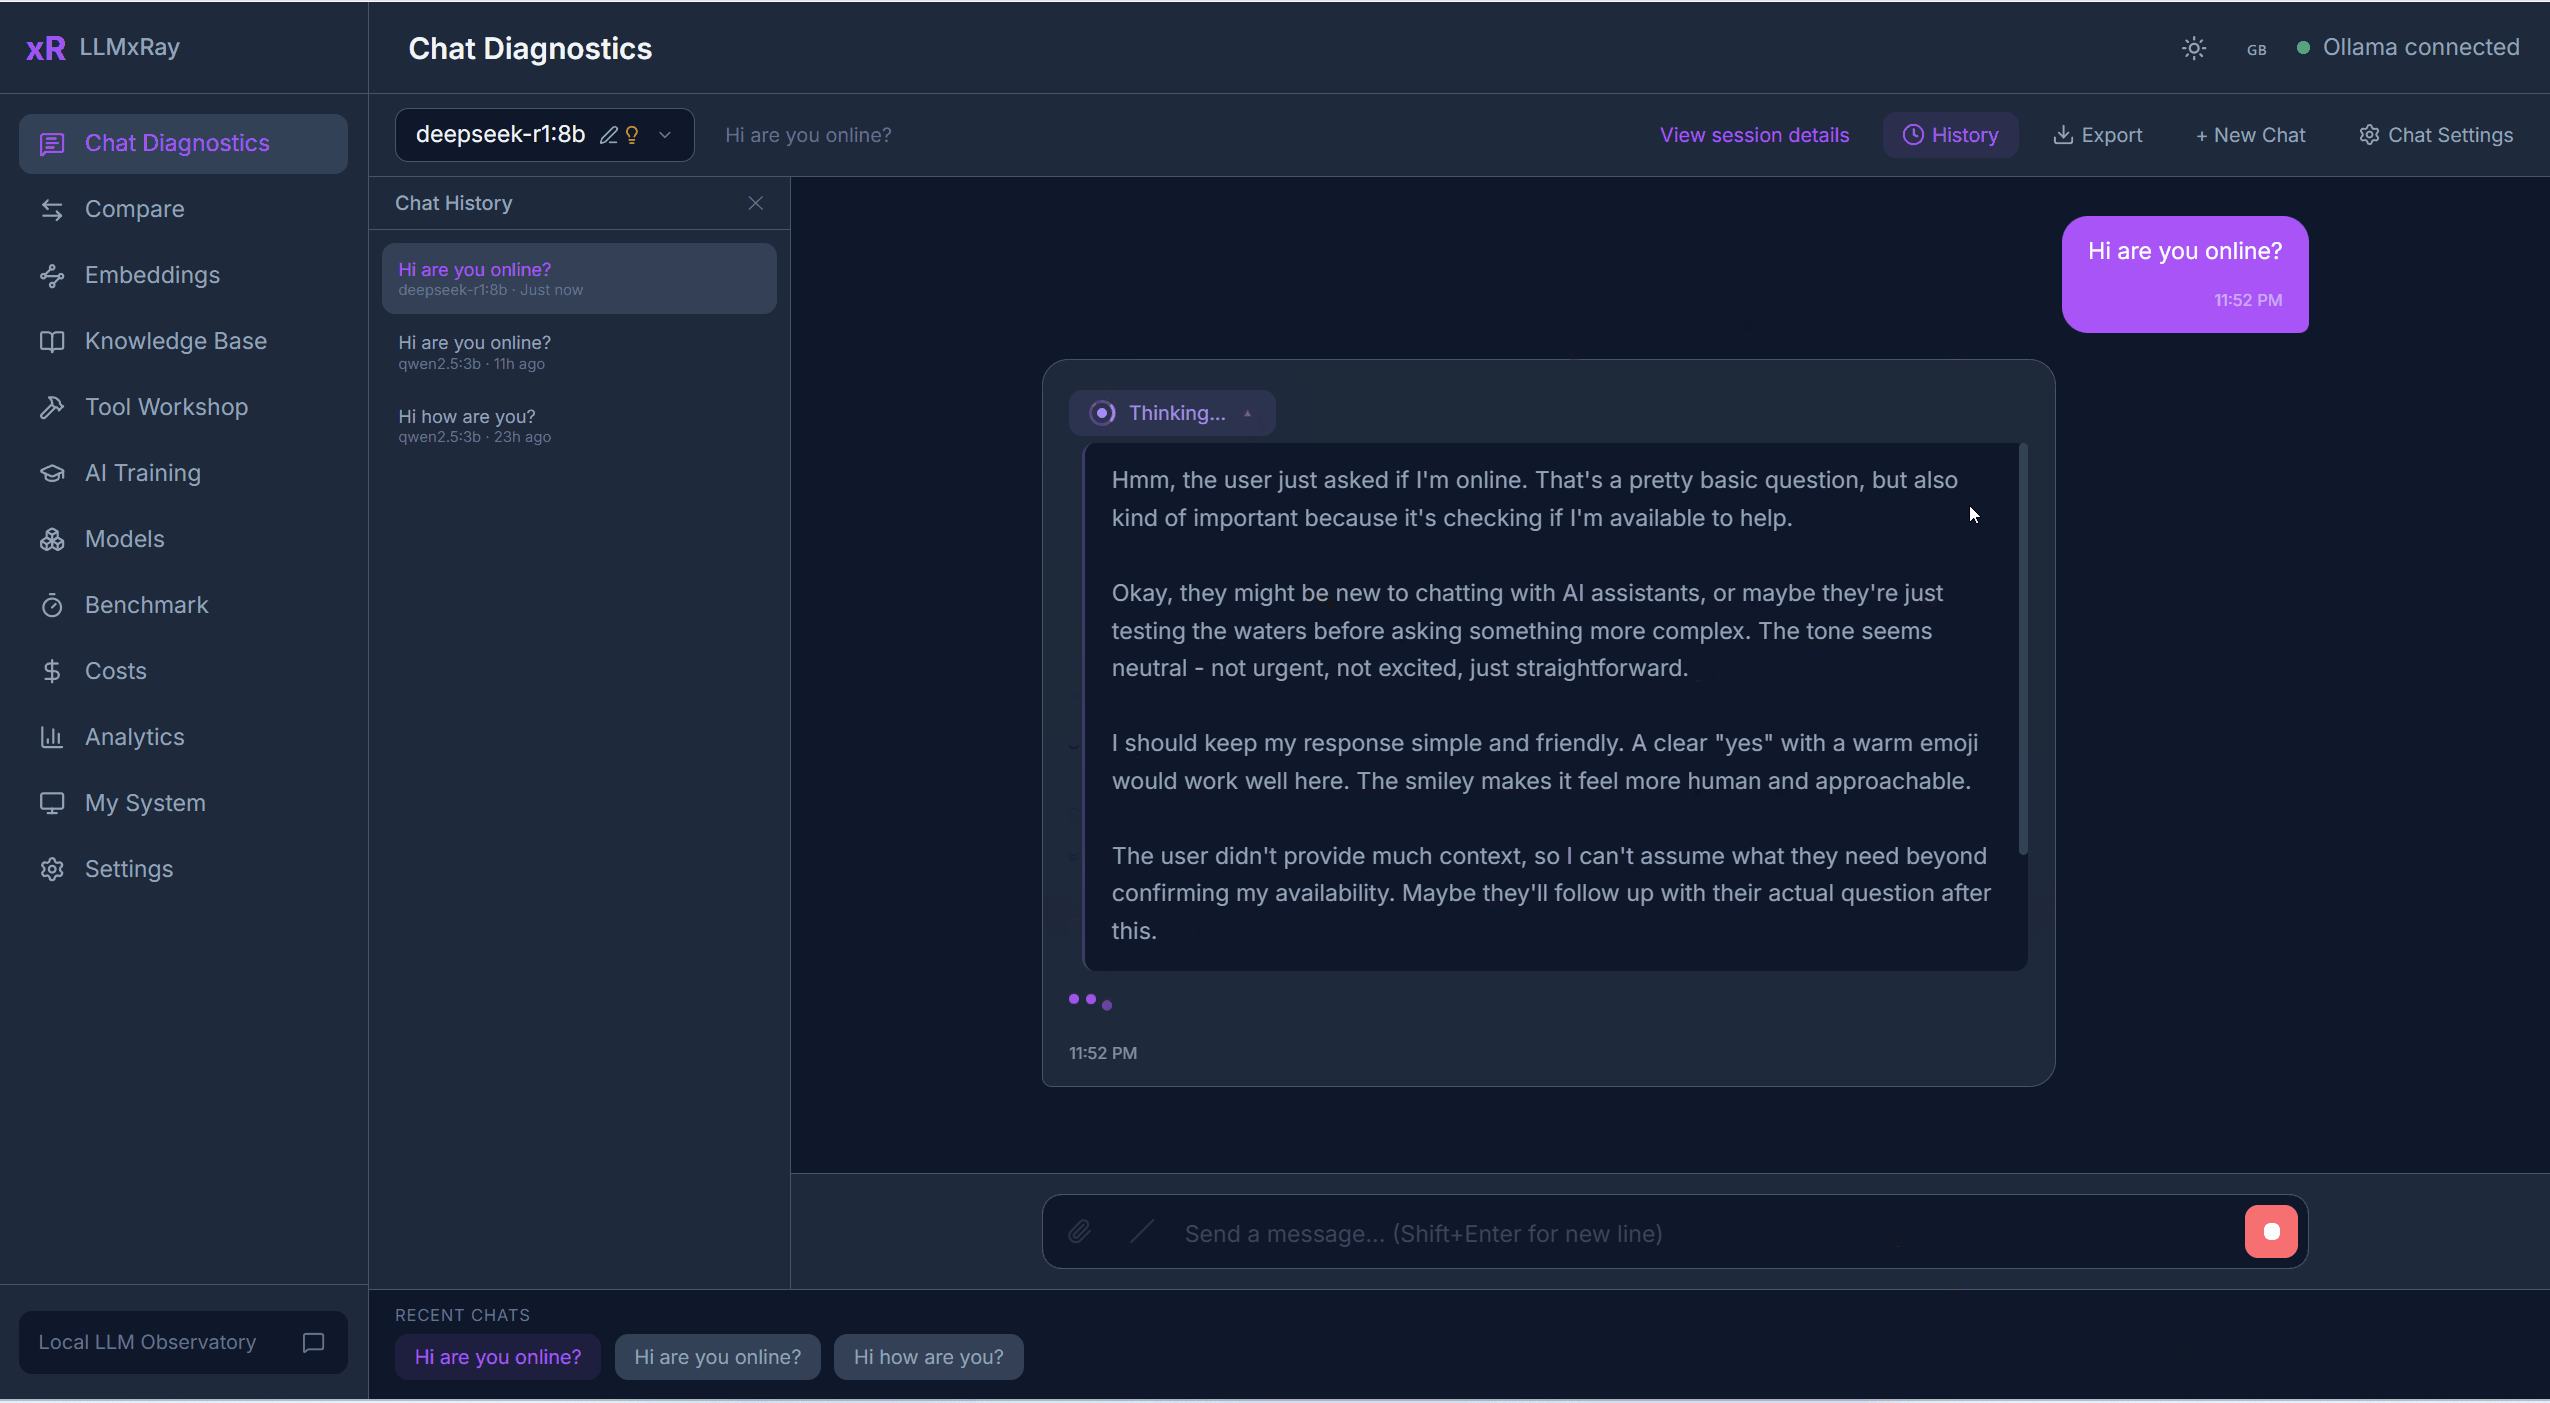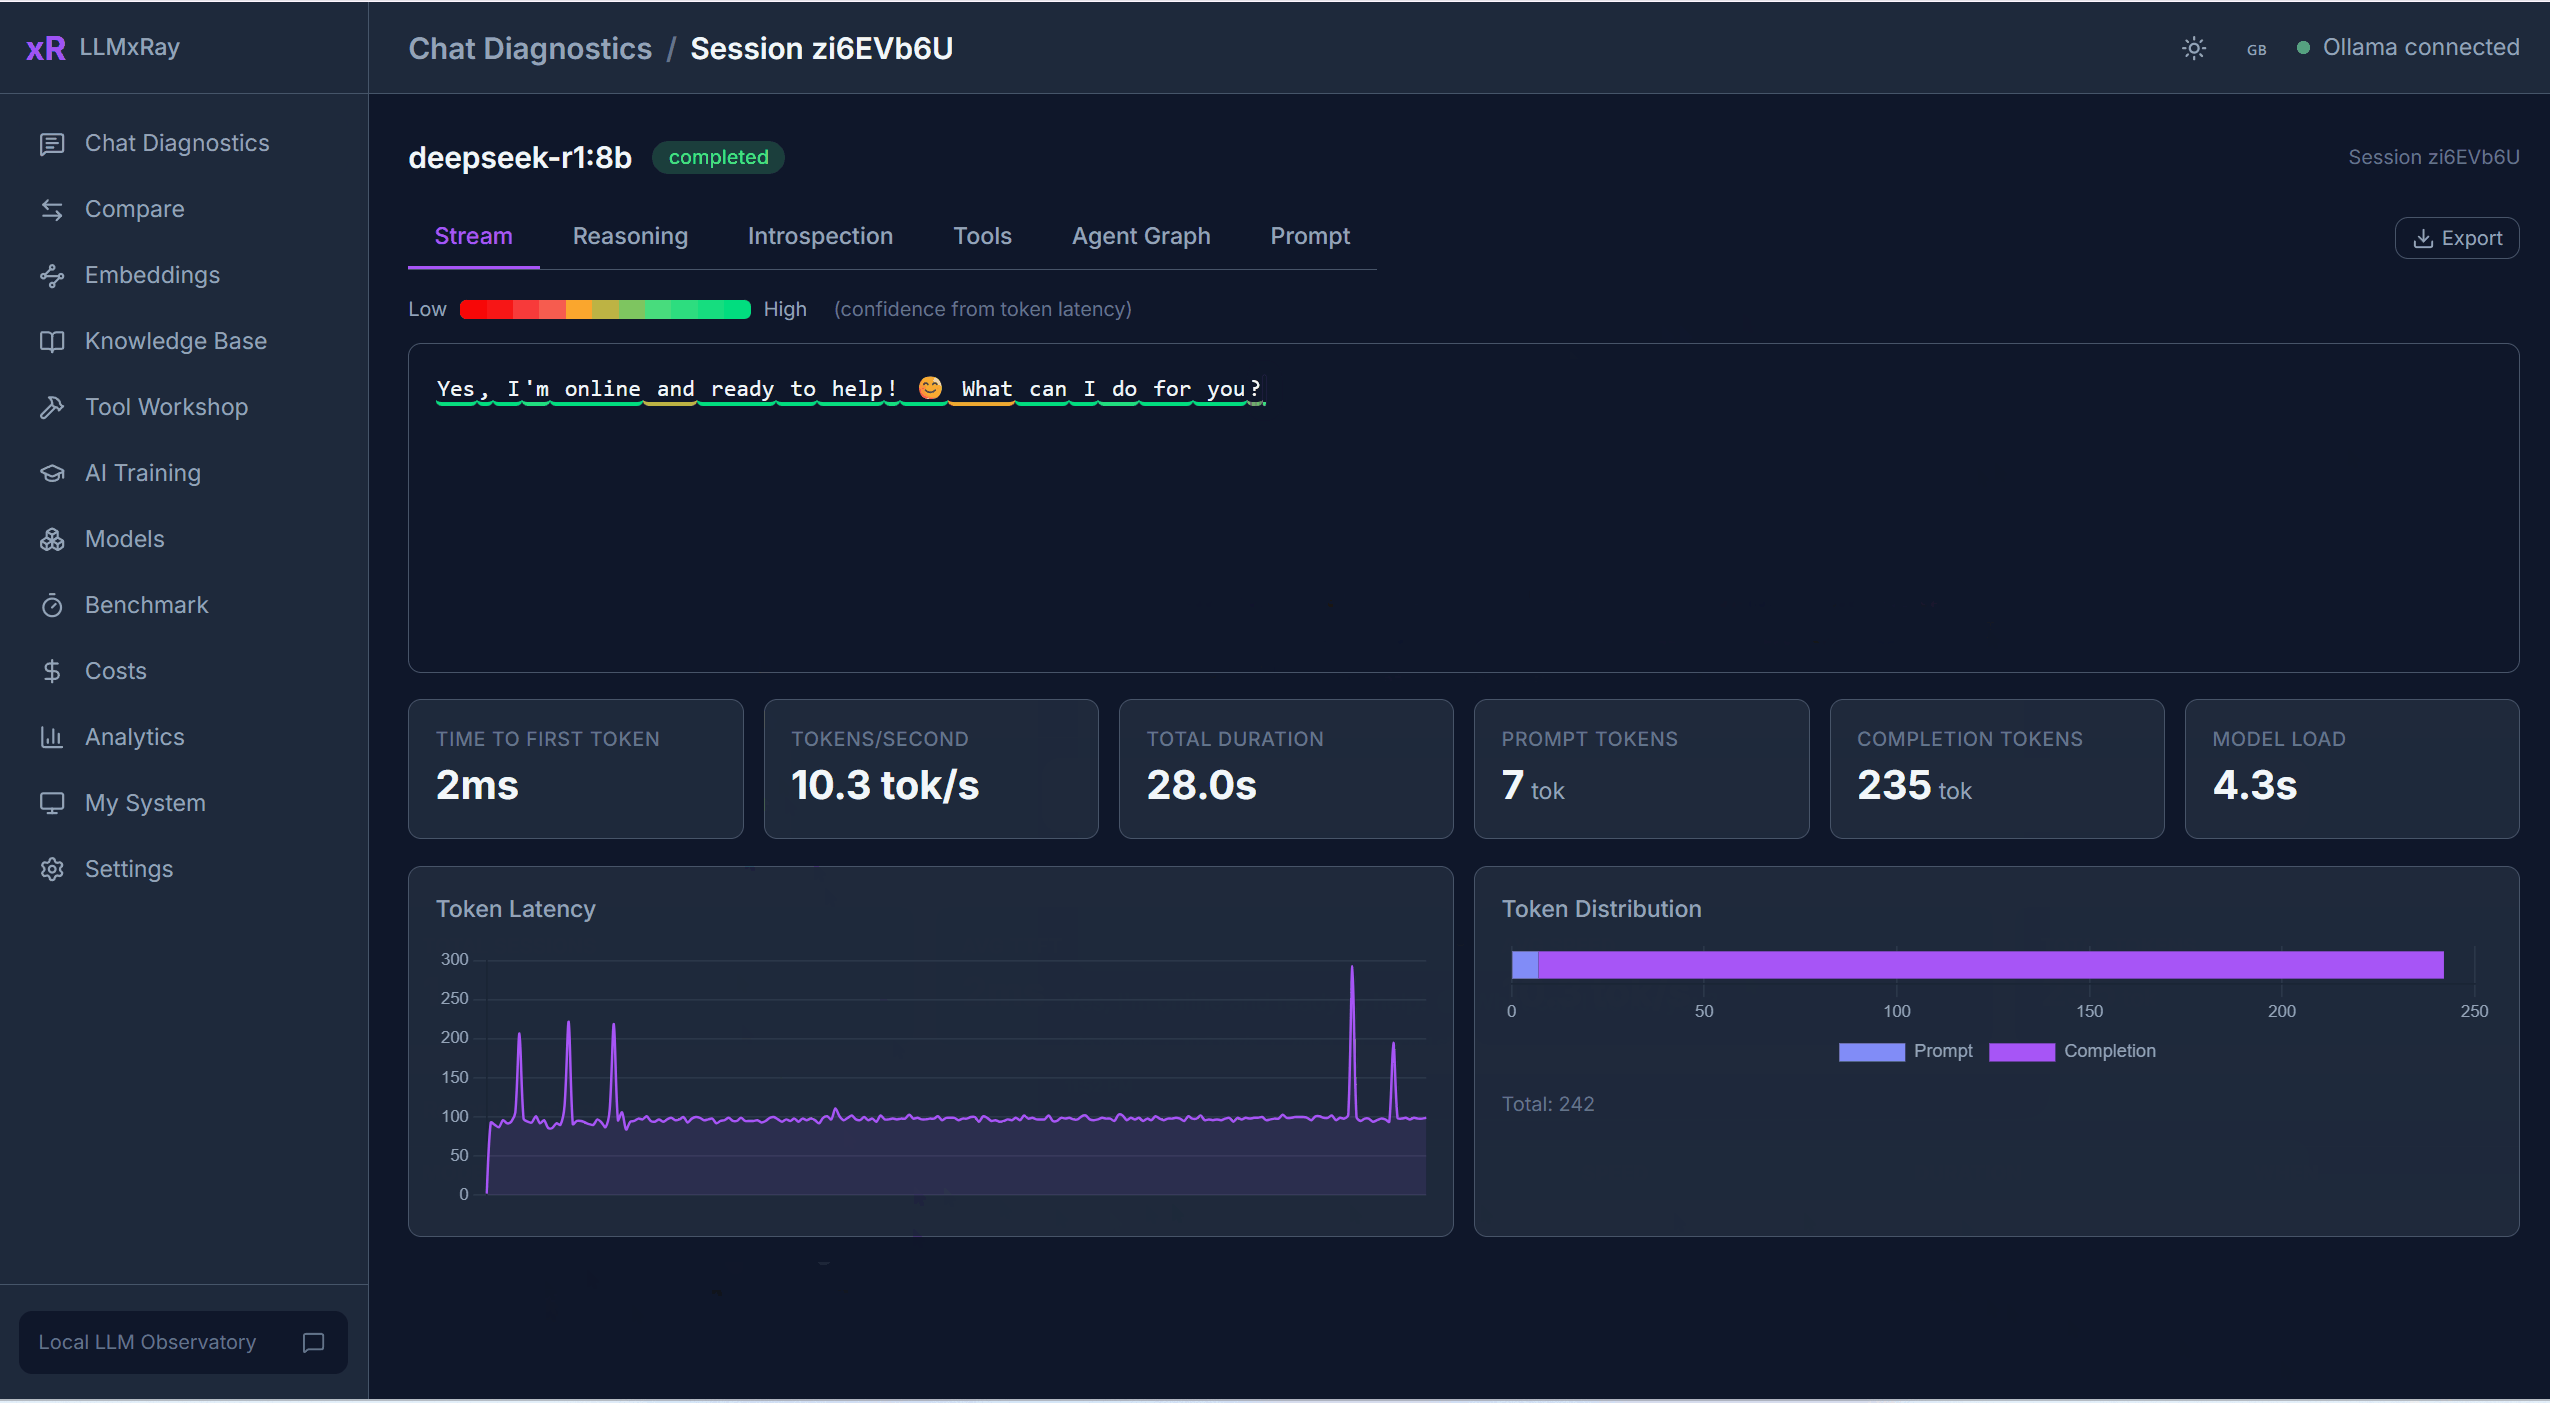
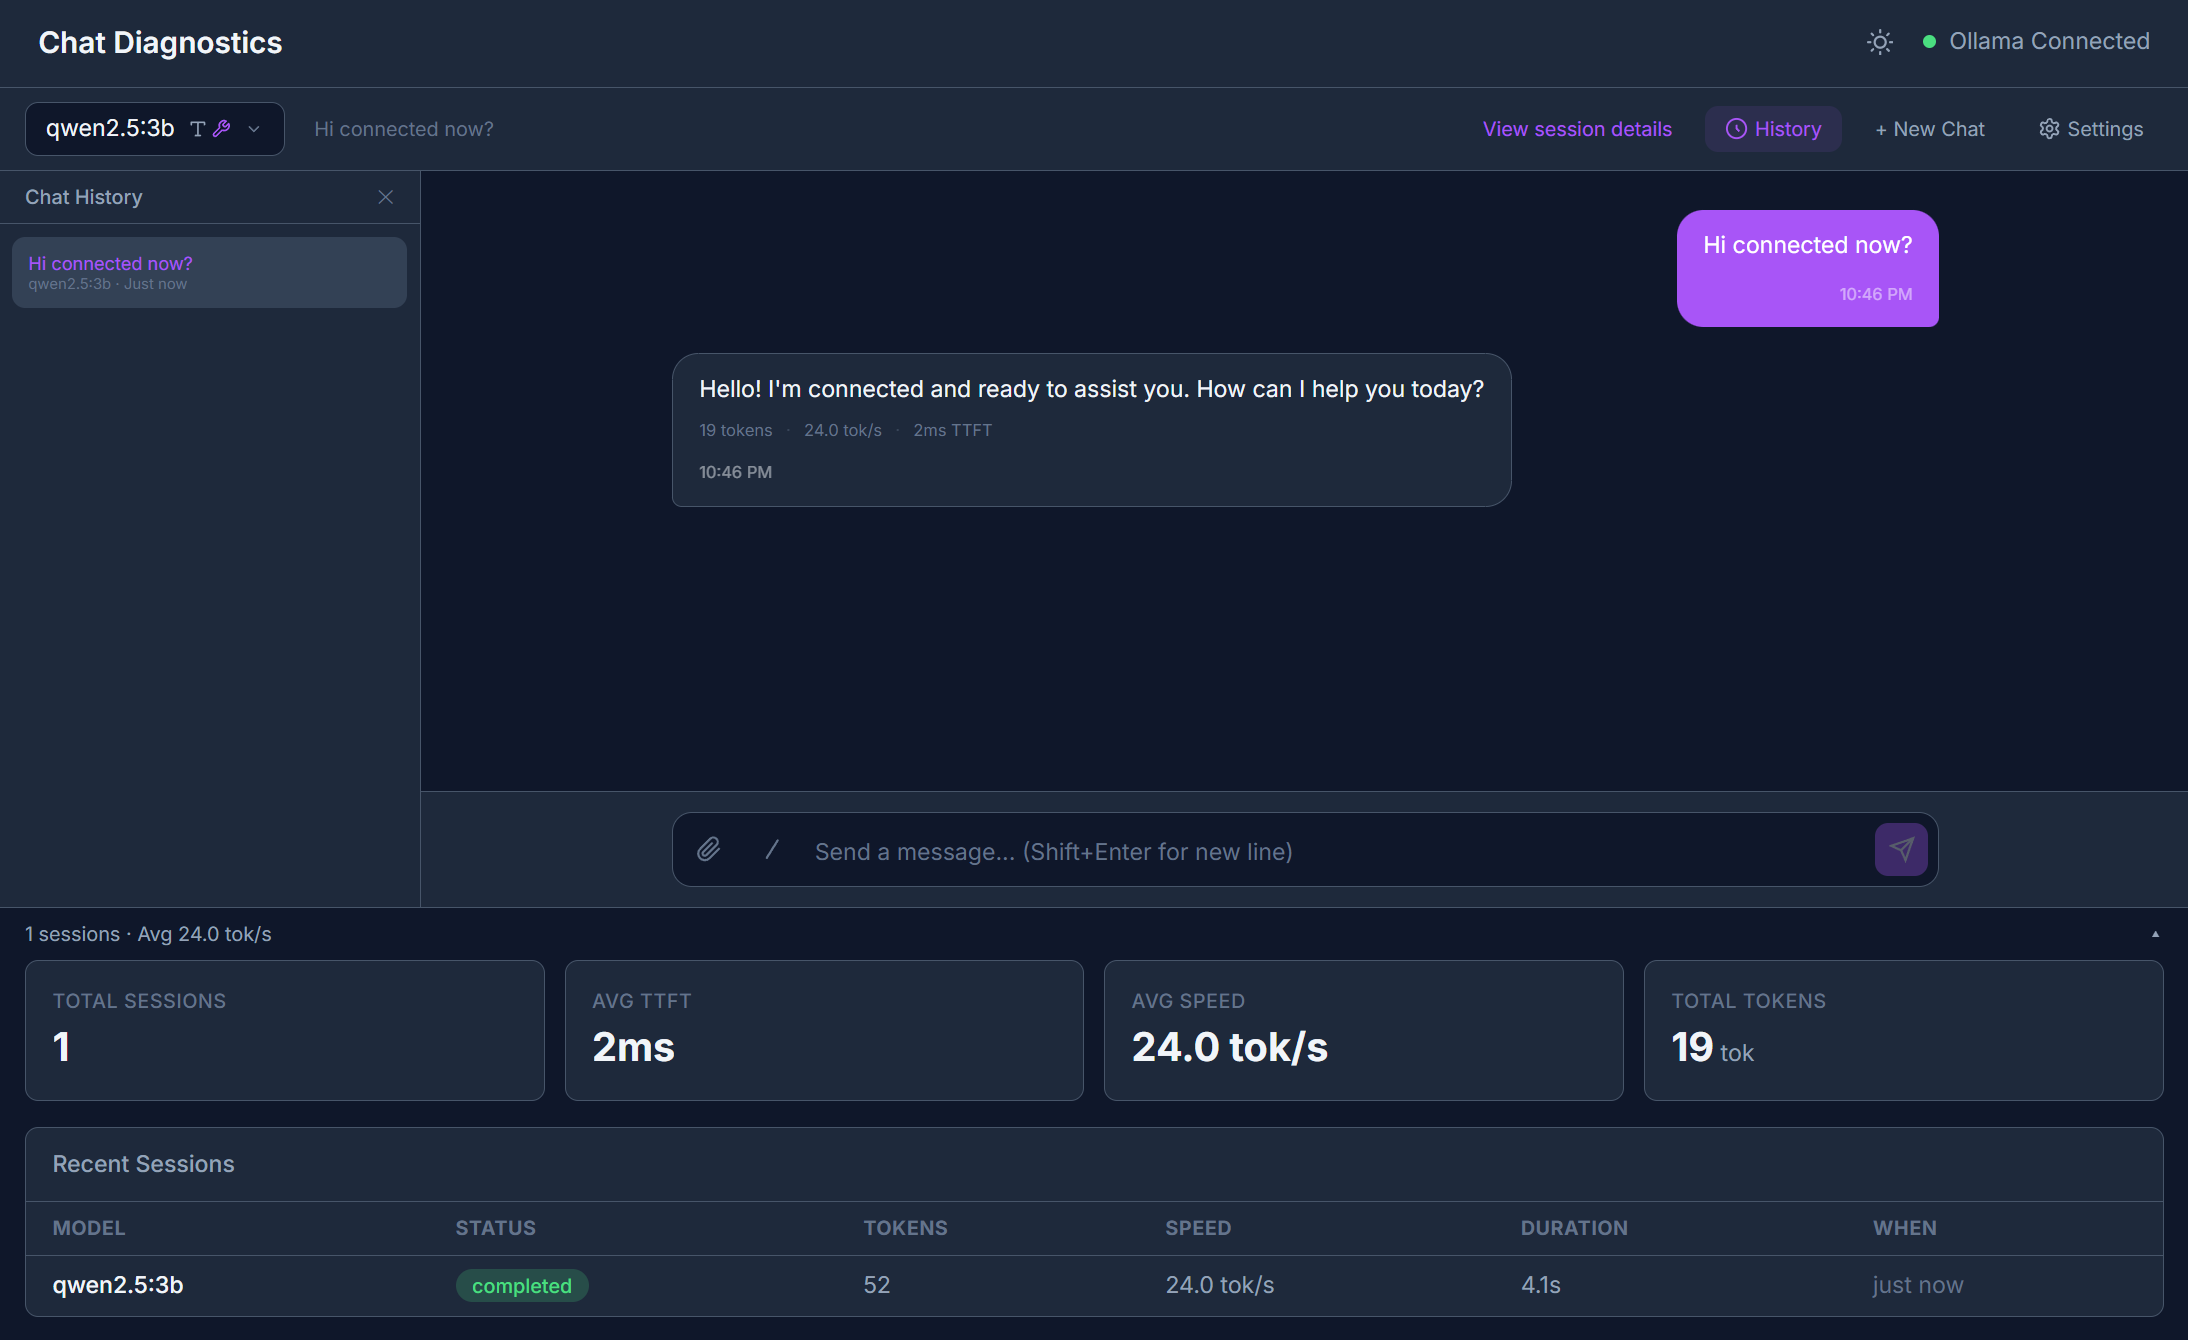
对话诊断 — 观看 token 逐个到达,并按速度着色。看清模型在何处迟疑,以及它对什么感到不确定。
缓存实验室 (0.6.0 新增) — 你的系统提示词很可能每一轮都在从头重新计算。30 秒内查明真相,并量化修复效果。(在我们的测试中预填充速度提升 3.5 倍。)
决策实验室 — 向决策模型(nimble、tev1、clef)提出关于工单或消息的带类型问题,看到每个答案背后的概率,而不是一个简单的“是”。
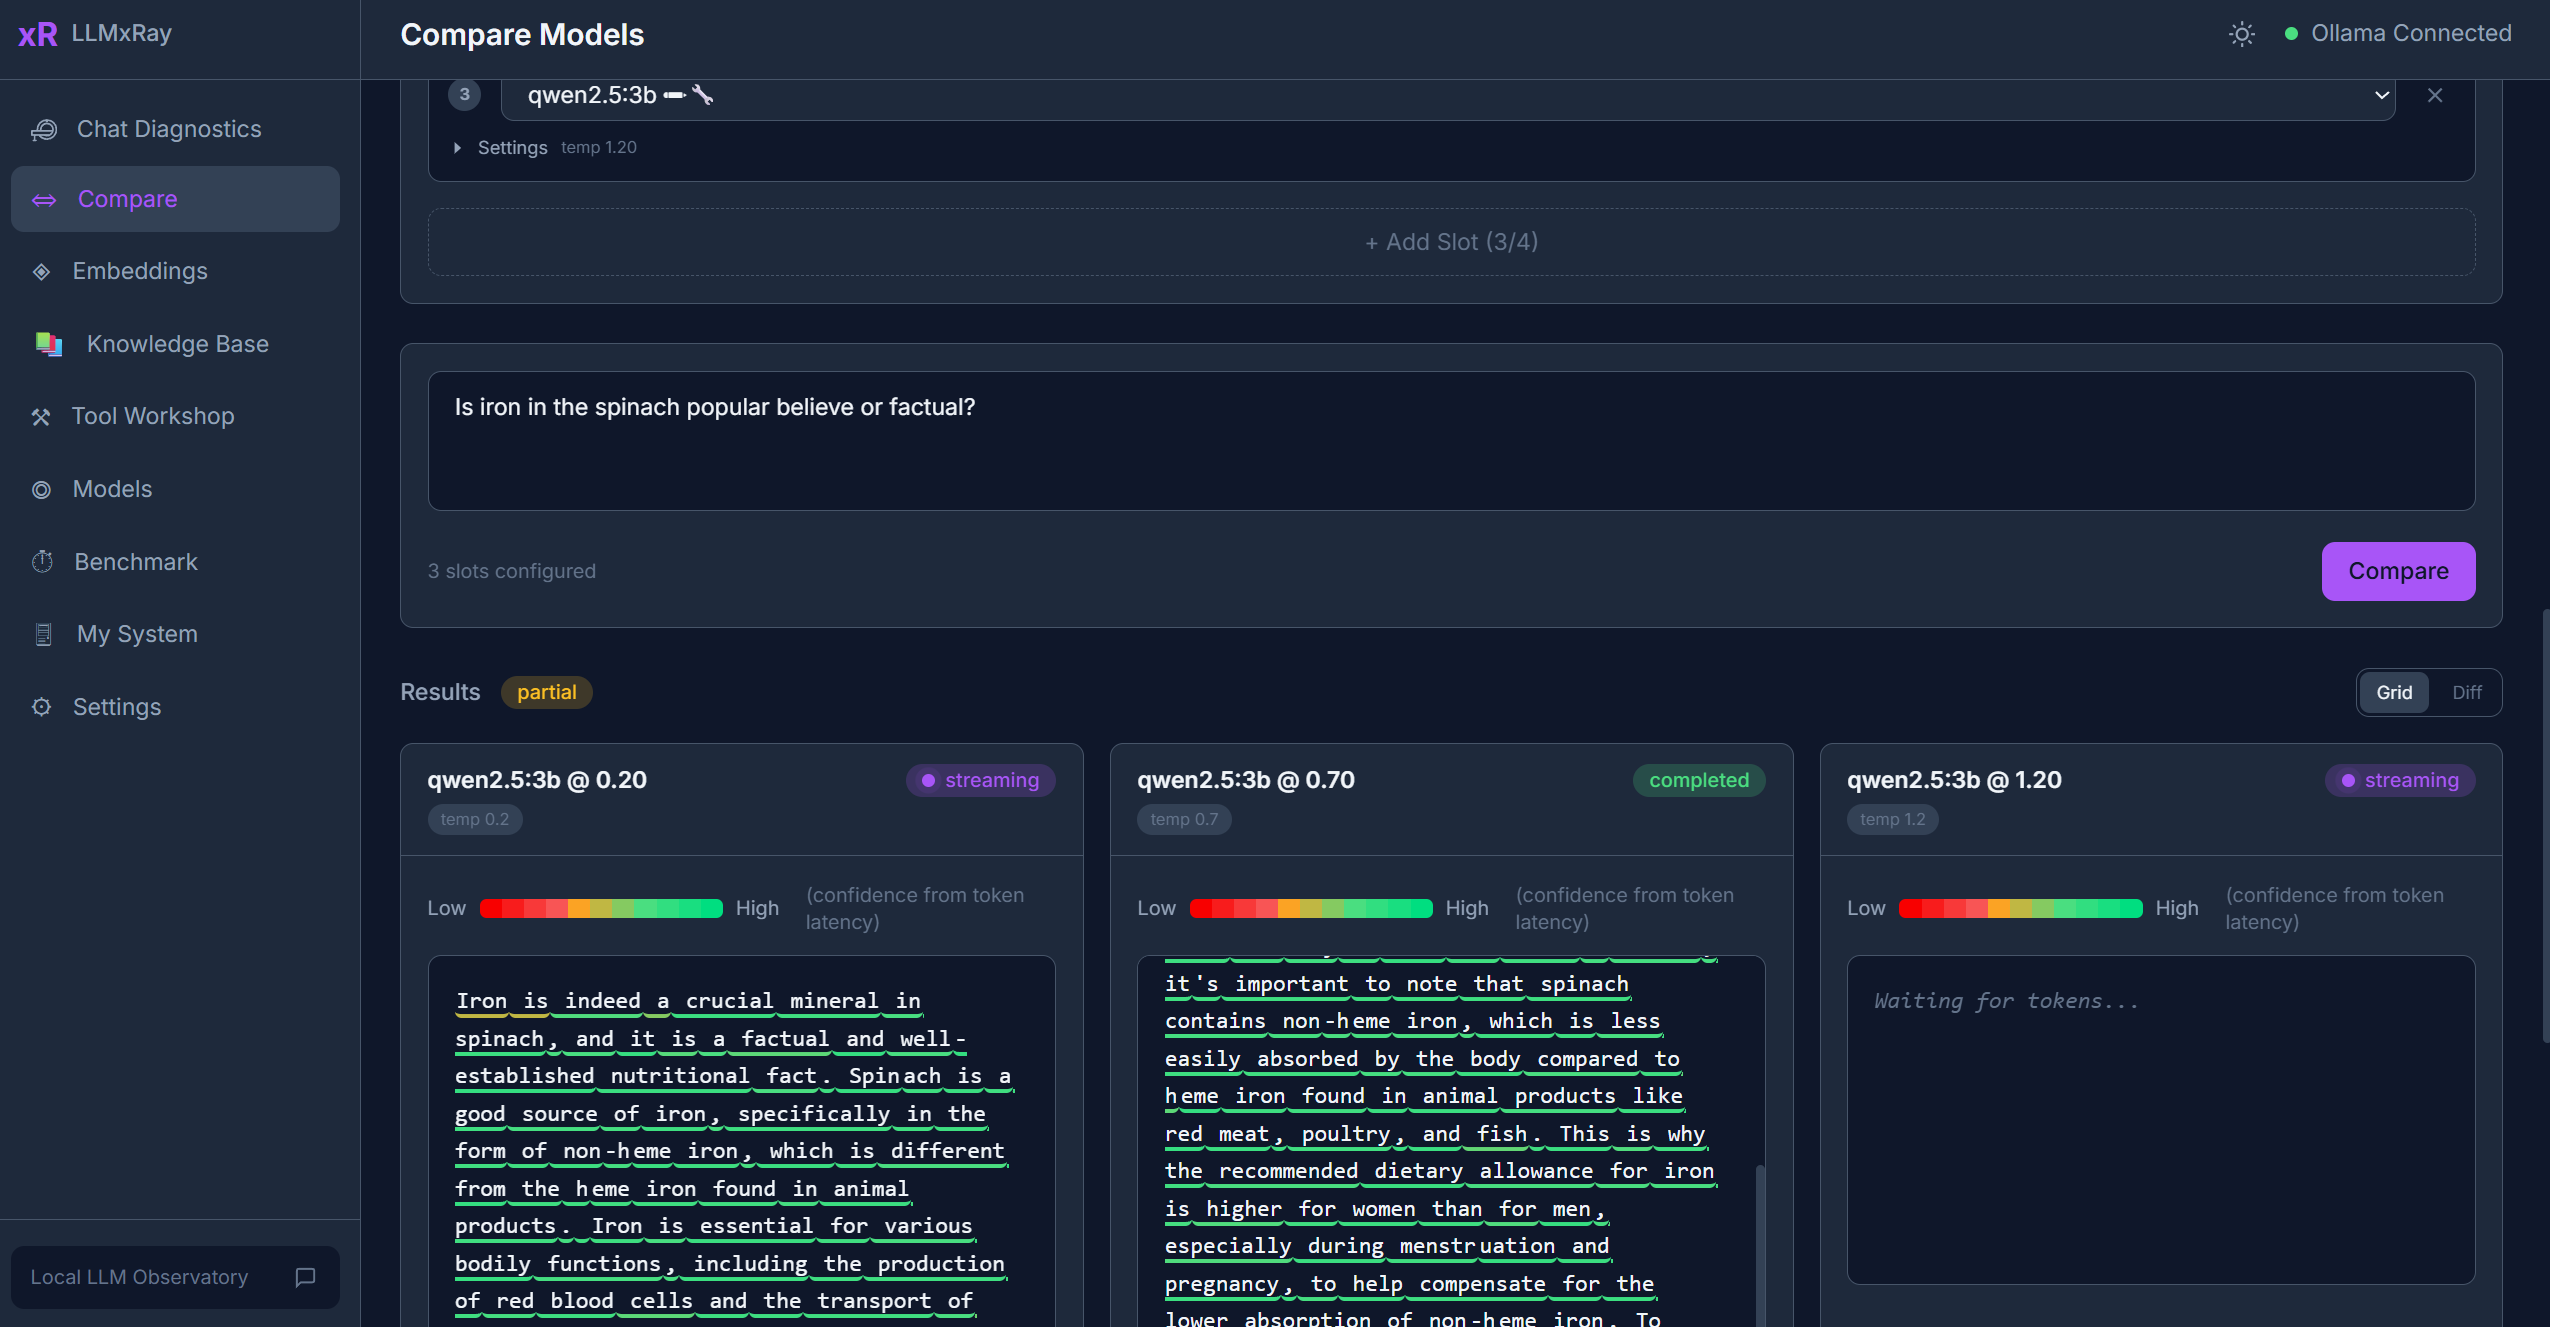
对比 — 将同一提示词分别用于两个模型,或两个温度值,并排比较。别再猜测哪个设置实际上更好。
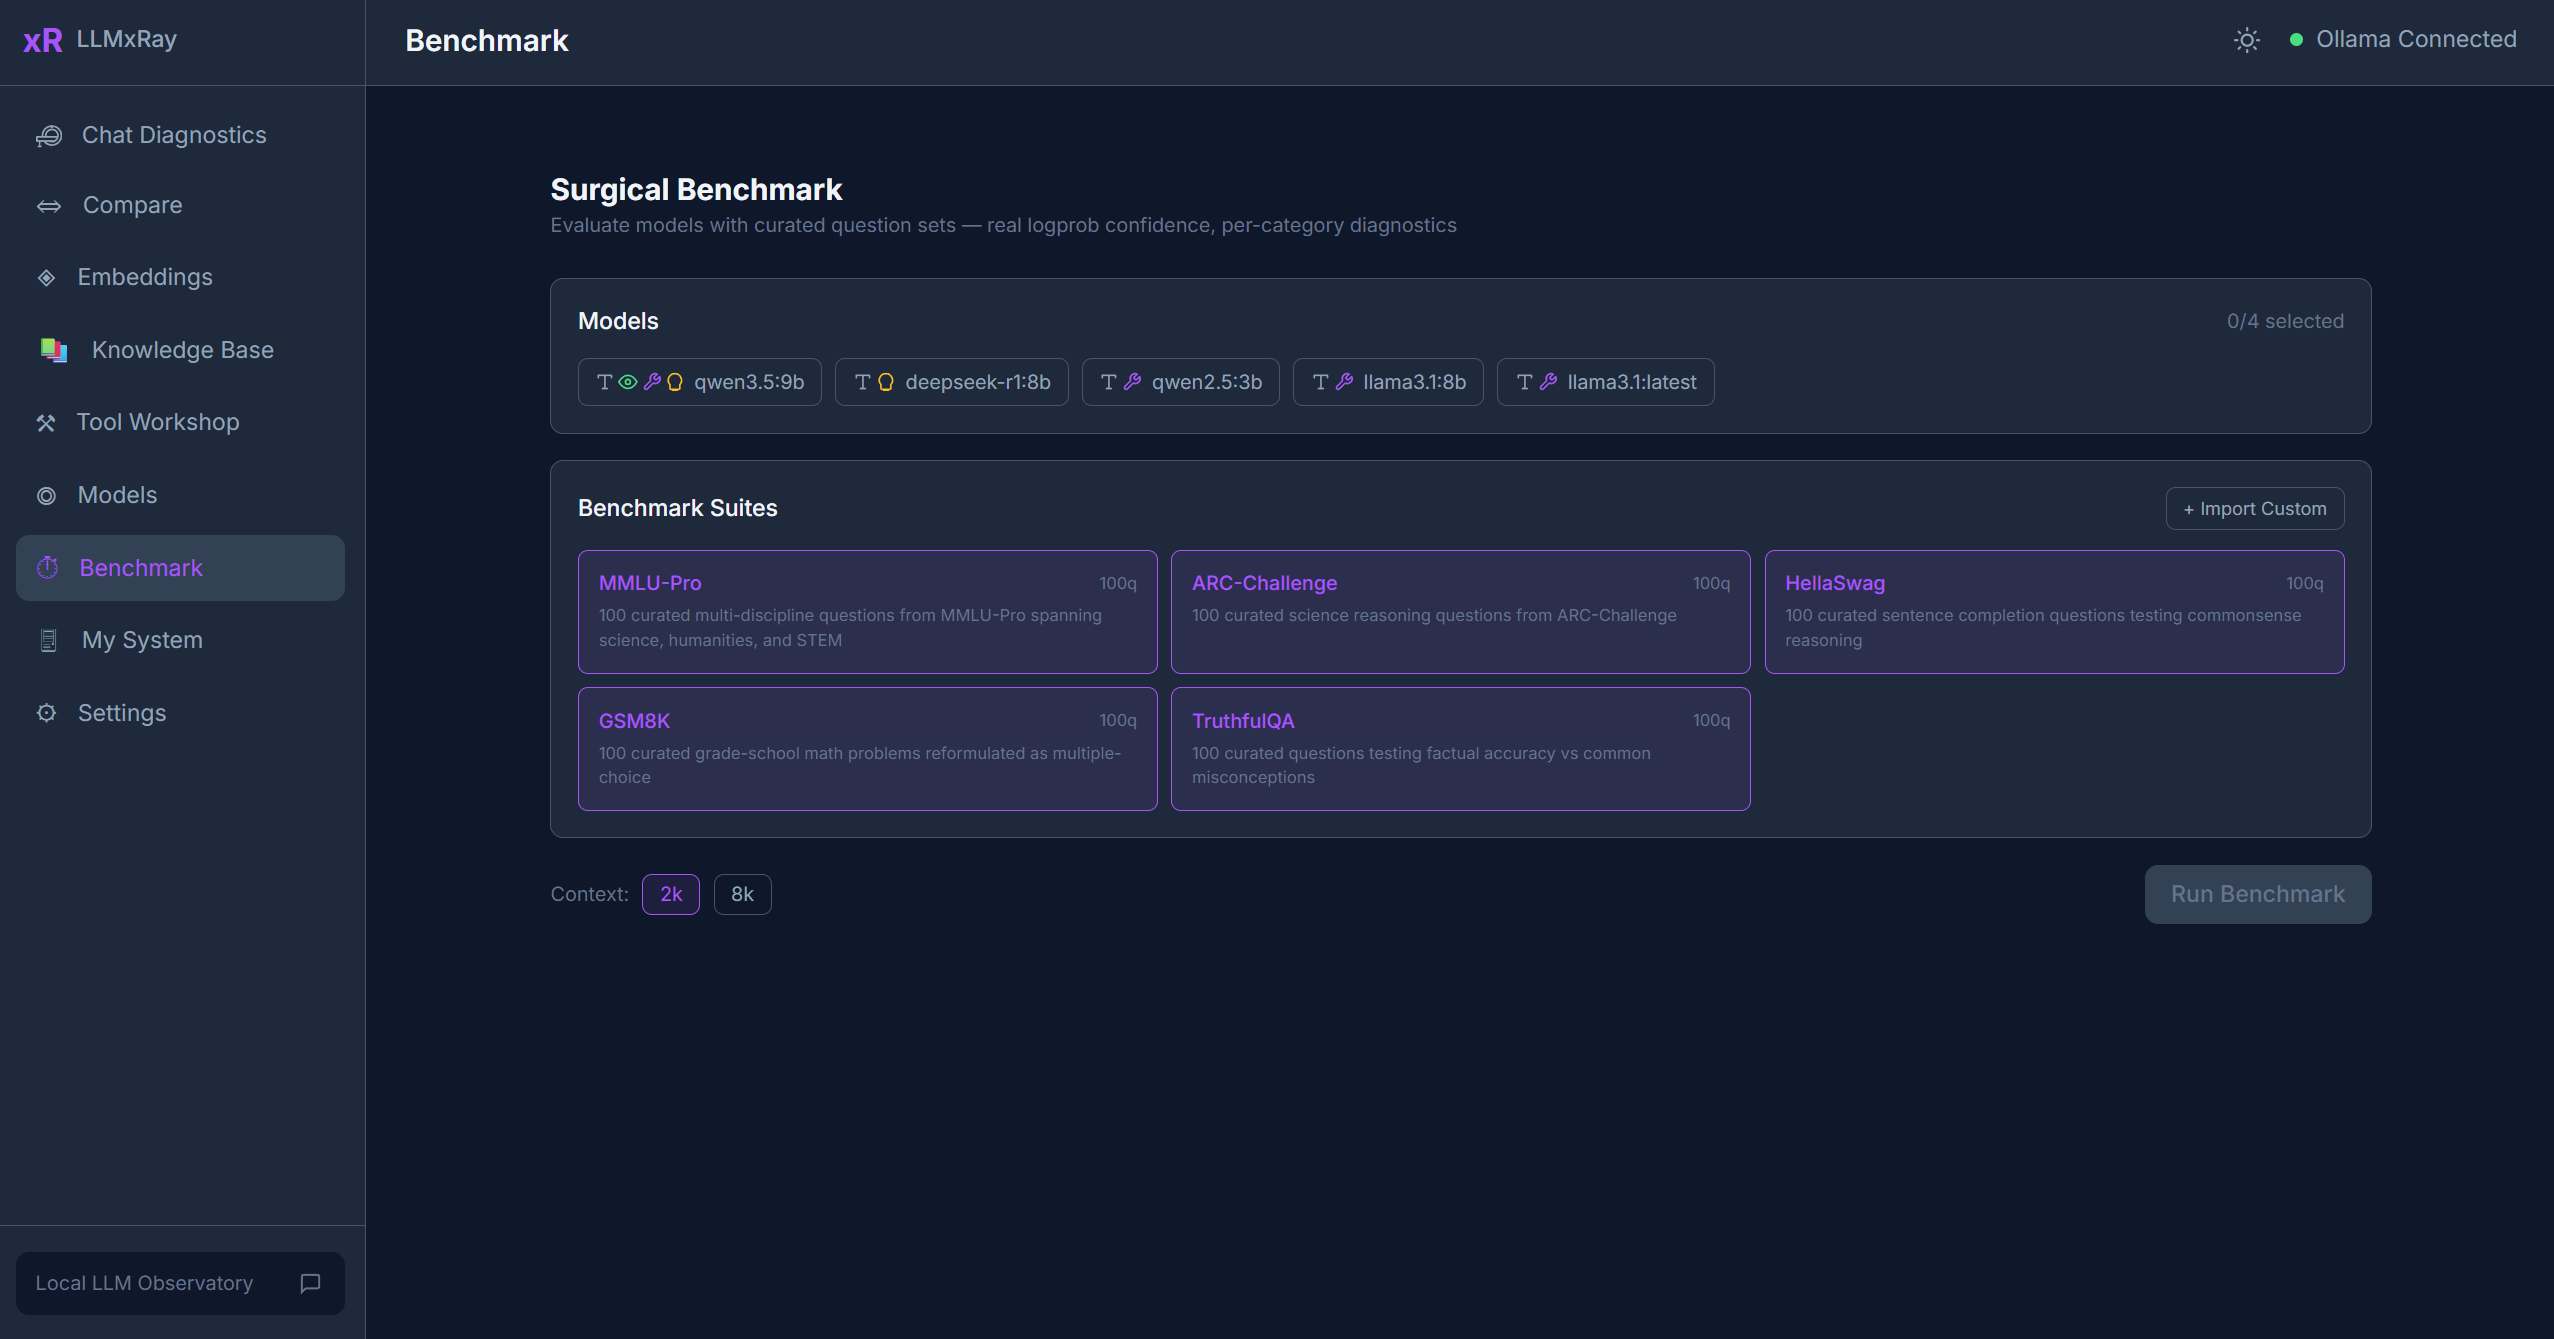
精准基准测试 — 基于真实的 token logprobs 为模型打分,而不是看答案是否碰巧看起来正确。
协议观测台 — 查看同一个本地模型通过 Ollama 原生、OpenAI 兼容和 Anthropic 兼容 API 分别如何回复,以及它们究竟在何处出现分歧。
知识库 — 导入 PDF 和文档,进行分块,并在模型看到之前先查看 RAG 实际检索到了什么。
此外还有嵌入、成本追踪、分析、工具构建器和本地历史数据库。完整功能列表见下方。
快速开始
一条命令。30 秒。
npx llmxray
或使用 Docker:
docker run -p 5174:5174 djovaneli/llmxray
打开 http://localhost:5174 即可开始对话。就这么简单。
前提条件:本地运行 Ollama,并至少拉取一个模型(
ollama pull llama3.2)。
为什么选择 LLMxRay?
你运行着一个本地 LLM。你与它对话。但实际发生了什么?
- 每个 token 有多快?模型对哪些 token 有信心?
- 在长对话中,回复质量是否在下降?
- 如果放在云端运行,这要花多少钱?
- 模型是否在重复自己?在拒绝回答?在生成乱码?
- 在同一个提示词上,温度 0.3 与 0.9 相比如何?
LLMxRay 以可视化、实时、免费的方式回答所有这些问题。
功能特性
具备 Token 智能的实时对话
与任何 Ollama 模型对话,观看 token 以置信度着色到达——每个 token 根据生成速度着色。支持 markdown、多轮对话、文件附件、视觉模型和斜杠命令。对于推理模型,可按对话设置思考预算——关闭、由模型决定,或明确的低 / 中 / 高 / 最高强度。
回复质量门控
每条回复都会被自动分析。仅当出现问题时才会显示彩色徽章:
- 重复 — 过度重复的短语(4-gram 分析)
- 拒绝 — “as an AI language model”及其他 7 种模式
- 乱码 — 非 ASCII 字符比例过高
- 空回复 — 少于 10 个词
- 截断 — 达到 token 上限而未完成
模型对比工作台
最多支持 4 个槽位,每个槽位可独立设置模型、温度和系统提示词。功能包括并排流式输出、词级差异高亮、指标对比,以及一键预设(温度扫描、确定性配对、带 Token 税可视化的语言对比)。
性能分析
- 延迟百分位数(P50/P95/P99),涵盖总时长和 TTFT
- 错误智能分析 — 7 类分类器,带时间线
- 使用热力图 — 7x24 网格展示你的活跃时段
- 设置影响 — 温度与 tokens/秒 的散点图
- 冷启动与热启动跟踪,带模型加载历史
成本仪表盘
按模型/天统计 Token 用量,并估算云端等效价格。看看你在本地运行省下了多少。
精准基准测试
用多选题套件测试模型知识。通过 OpenAI 兼容端点使用真实 logprobs,实现准确的置信度测量。可视化构建自定义套件,或让 AI 根据主题生成。
嵌入实验室与 RAG 流水线
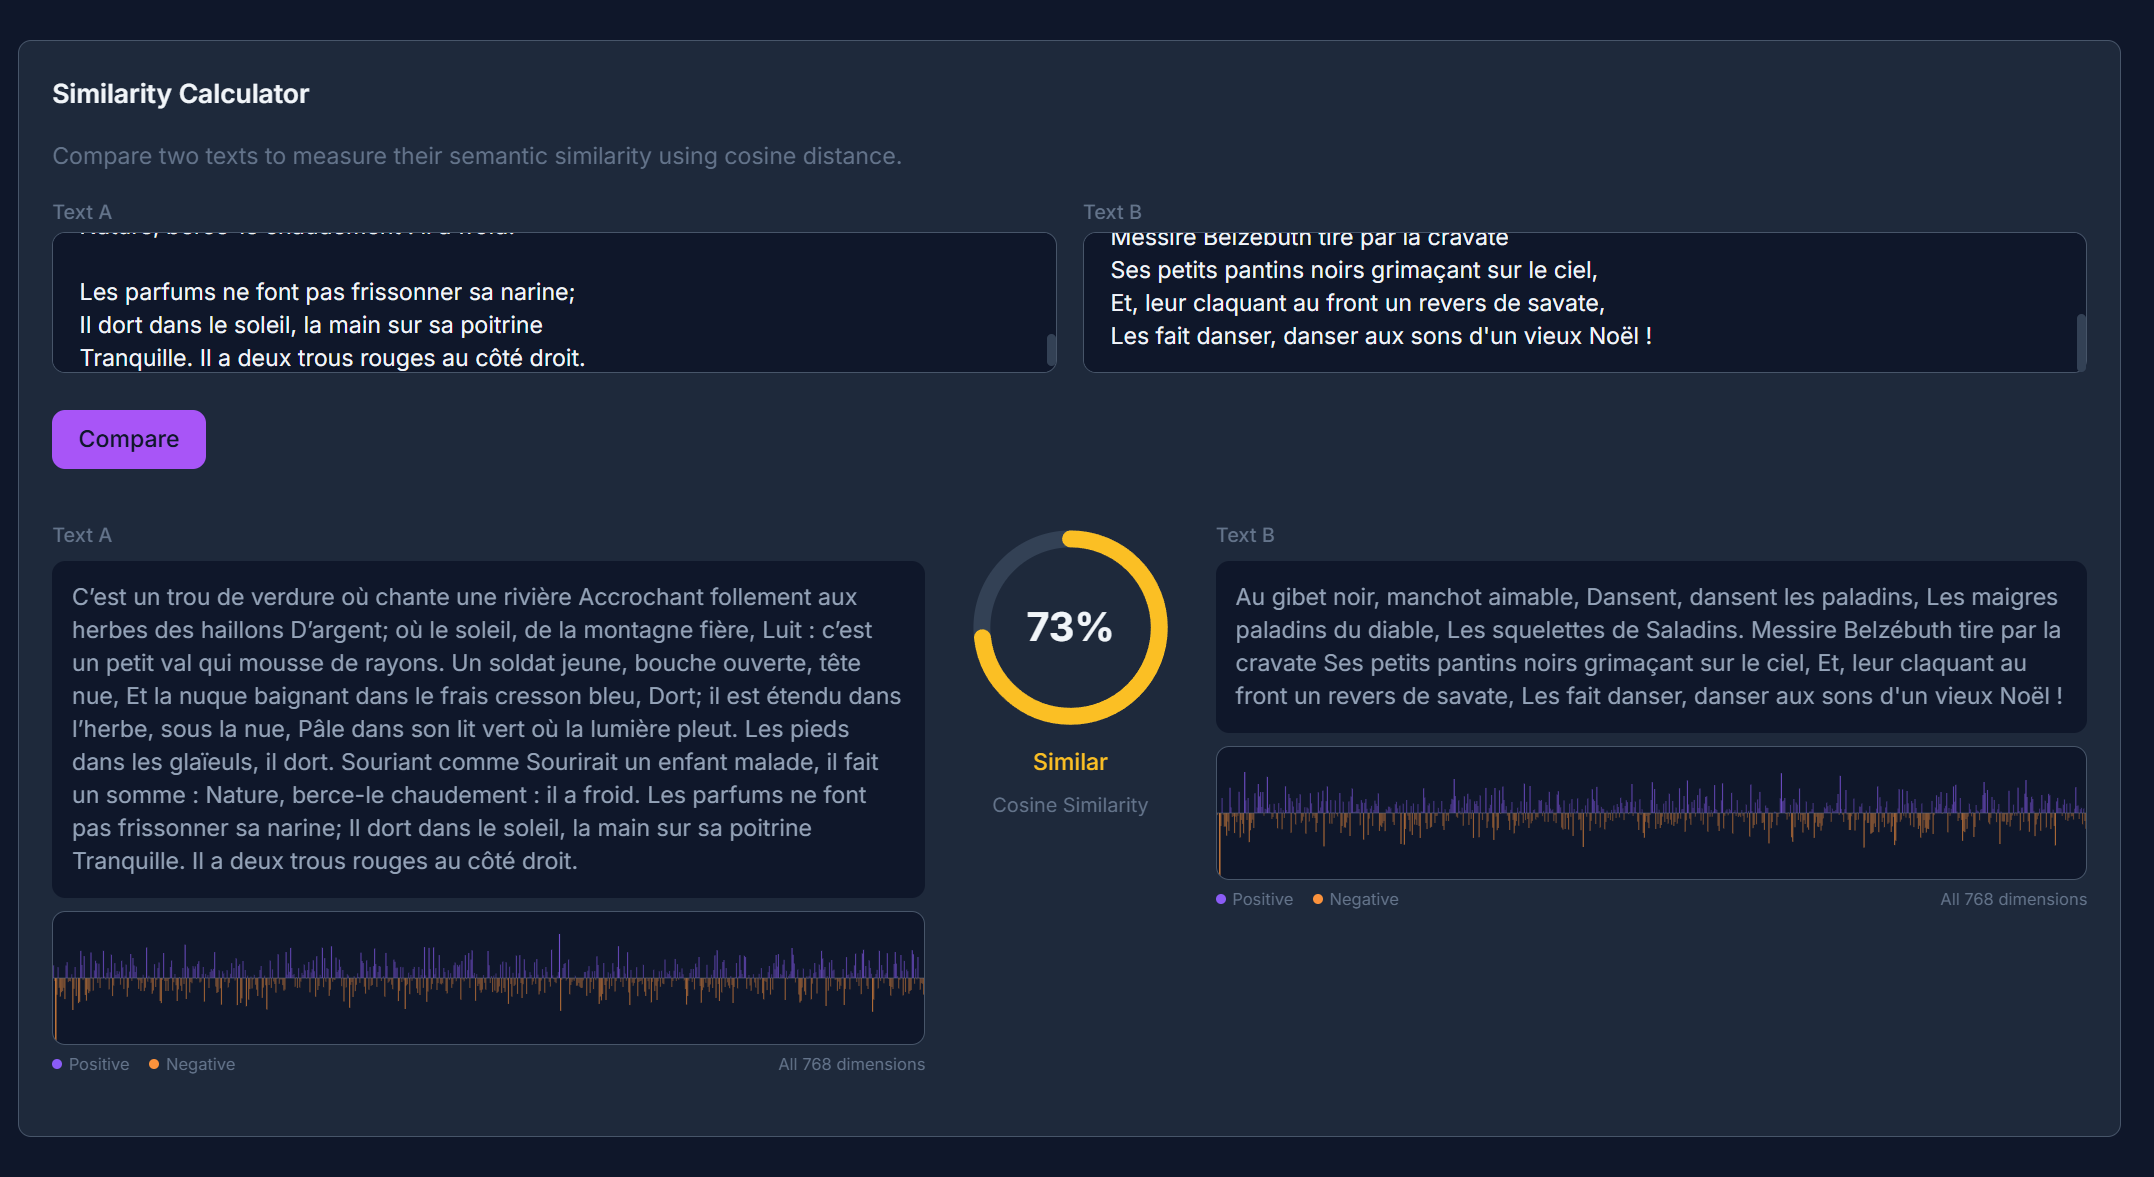
嵌入文本、可视化向量、测量余弦相似度。请求更窄的输出向量,看看 Matryoshka 截断在相似度上损失了多少。从 PDF、DOCX 和 CSV 构建本地知识库 — 分块、嵌入、可搜索。全部存储在 IndexedDB 中。零成本。
工具工坊(可视化画布)
拖放式节点画布,用于构建工具定义。双向代码同步(编辑节点或 TypeScript — 两者都会更新)。探测 API、自动生成 schema、实时执行测试。
中间填充游乐场 (v0.4.7 新增)
为 Qwen-Coder、CodeLlama、Codestral、DeepSeek-Coder 和 StarCoder 提供代码补全。两个文本区域(前缀/后缀),模型填充中间部分。在 /api/generate 上使用 Ollama 的 suffix 字段。拼接预览展示结果在编辑器中的实际效果。
缓存实验室 (v0.6.0 新增)
找出你的提示词为何无法命中模型的 KV 缓存,并测量每一轮的实际代价。本地模型只有在提示词从第一个 token 起仍然匹配时才会复用缓存,因此顶部附近的一个时间戳就会让下面所有内容失效。实验室会找出轮次之间变化的那些值,显示复用失效的确切位置,然后测量 — 将每种布局发送两次并改变一个值,针对你自己的守护进程 — 把它们移到末尾实际能节省多少。在真实的 324-token 提示词上测得:时间戳在前时复用 4 个 token、预填充 64.6 ms;放在末尾时复用 290 个、预填充 18.6 ms。快 3.5 倍,同样的文字。需要 Ollama 0.33.3+。
决策实验室
Ollama 0.35.1 新增了决策模型 — nimble、tev1、clef、clef-flash — 它们在 /v1/systemone 上以选项、概率和分数而非文本作答。给实验室一个状态(一张工单、一条消息、一行日志)和带类型的问题:在命名候选中做出选择、给出是/否概率,或在有序量表上给出分数。每个答案都以模型自身的概率分布返回,以条形图绘制并高亮所选候选。决策模型报告 decision 为其唯一能力,因此 LLMxRay 将它们排除在聊天选择器之外,并在此处列出。
协议观测台 (v0.4.7 新增)
通过 Ollama 的三种服务协议——原生 /api/chat、OpenAI 兼容 /v1/chat/completions 和 Anthropic 兼容 /v1/messages——并行向你的本地模型发送同一提示词。并排流式输出、按协议划分的指标,以及一个信封差异标签页,展示每种协议如何组织结束原因、token 计数和错误信封。无需云端,无需 API 密钥——三个端点都在 localhost:11434 上本地运行。
AI 训练流水线
从你的对话中整理训练数据。打标签、审核,并导出为 JSONL 用于微调。
本地 AI 历史数据库
每个实验(基准测试、对比、聊天、训练对)都会自动归档到一个可查询的 IndexedDB 数据库中,支持筛选、趋势、导出和保留策略。
多语言
提供英语、法语、塞尔维亚语(拉丁字母 + 西里尔字母)、中文和阿拉伯语的完整翻译。支持 RTL 布局。希伯来语和日语有社区脚手架。
Ollama 兼容性
已针对 Ollama 0.40.x 测试并验证(在 0.40.3 上验证,2026 年 10 月)。LLMxRay 使用以下 Ollama 端点:
| 端点 | 用于 |
|---|---|
/api/chat |
流式聊天(NDJSON,支持 tools、think 努力级别、format schema) |
/api/generate |
生成 + 中间填充,通过 suffix |
/api/tags |
模型列表 + 能力、上下文长度和嵌入宽度 |
/api/show |
参数、模板、许可证和架构元数据 |
/api/embed |
用于 RAG 的向量嵌入,可选 dimensions 截断 |
/api/pull、/api/delete、/api/ps、/api/version |
模型管理 + 状态 |
/v1/chat/completions |
Surgical Benchmark 使用的 OpenAI 兼容路径,用于获取真实 logprobs 和用量总计 |
/v1/messages |
Protocol Observatory 使用的 Anthropic 兼容路径 |
兼容:Ollama 0.20 及更新版本(更旧版本可用于聊天/生成,但缺少 think 和 JSON-schema format)。推荐:Ollama 0.33.3+——据报告支持提示缓存复用(prompt_eval_cached_count,以及 OpenAI 兼容端点上的 usage.prompt_tokens_details.cached_tokens),因此预填充吞吐量是按实际评估的 token 来测量的。从 0.32 起:能力和上下文长度随模型列表一起返回,think 接受分级努力级别,嵌入接受 dimensions 宽度。
截图
|
带 token 流式输出和置信度的聊天
|
模型对比——并排
|
|
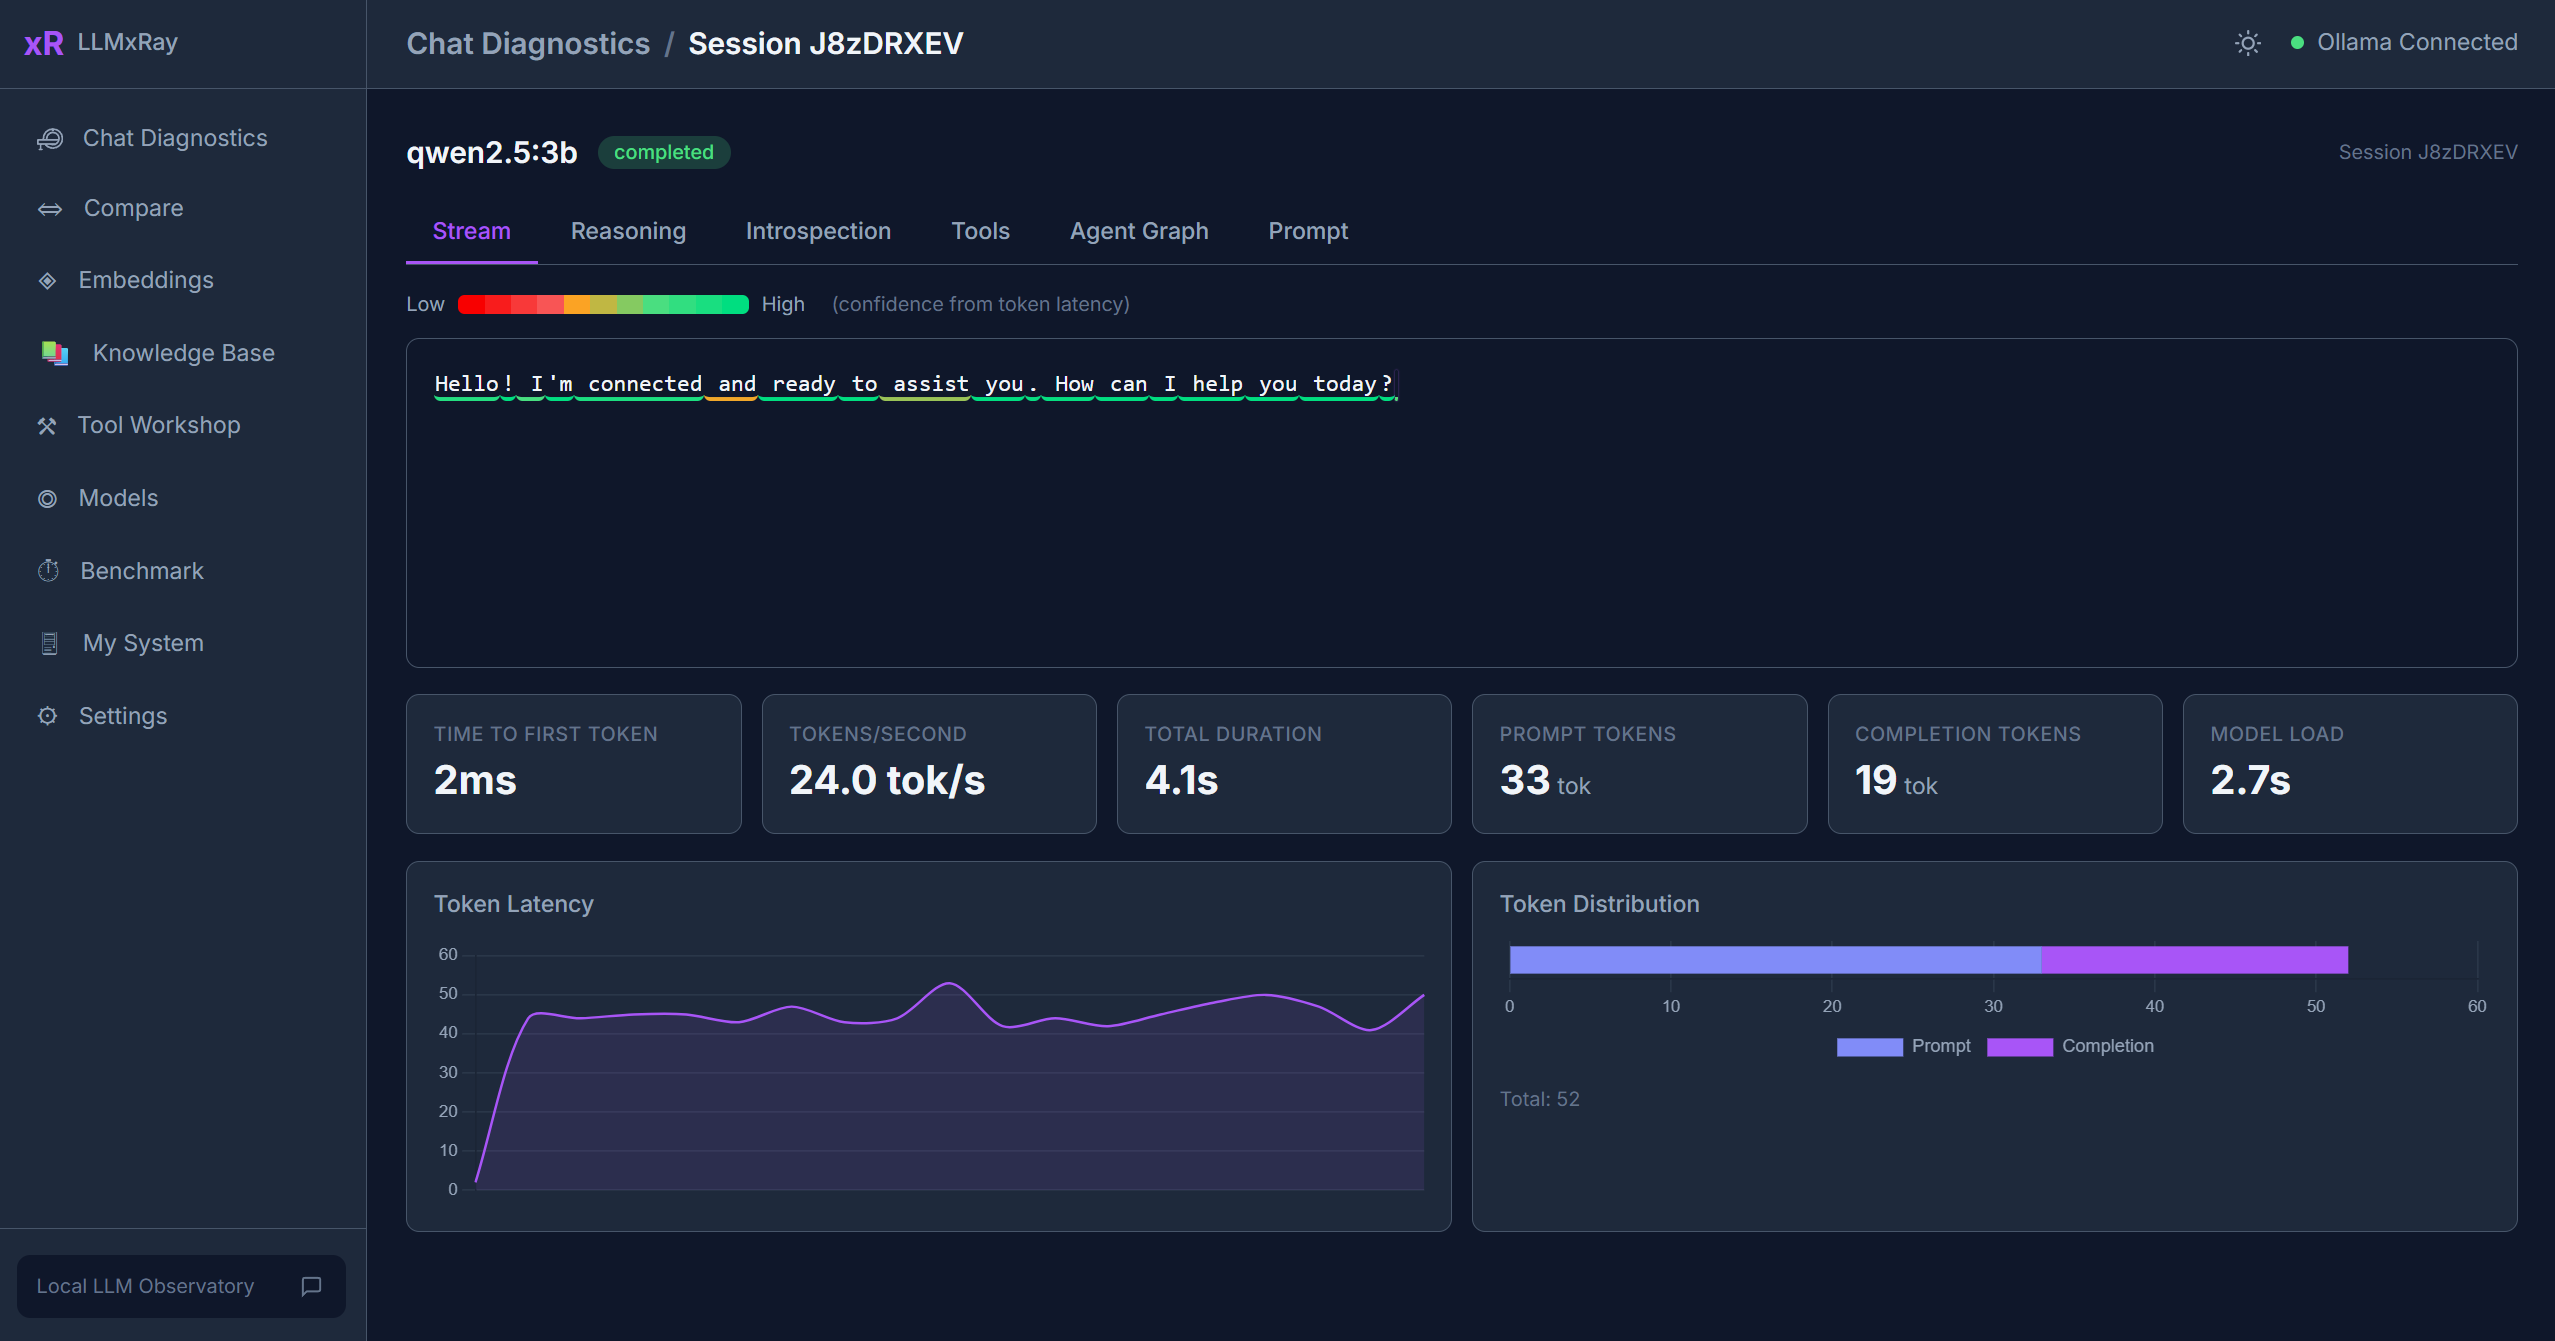
会话深入分析——指标和计时
|
带置信度雷达的基准测试
|
|
嵌入——余弦相似度
|
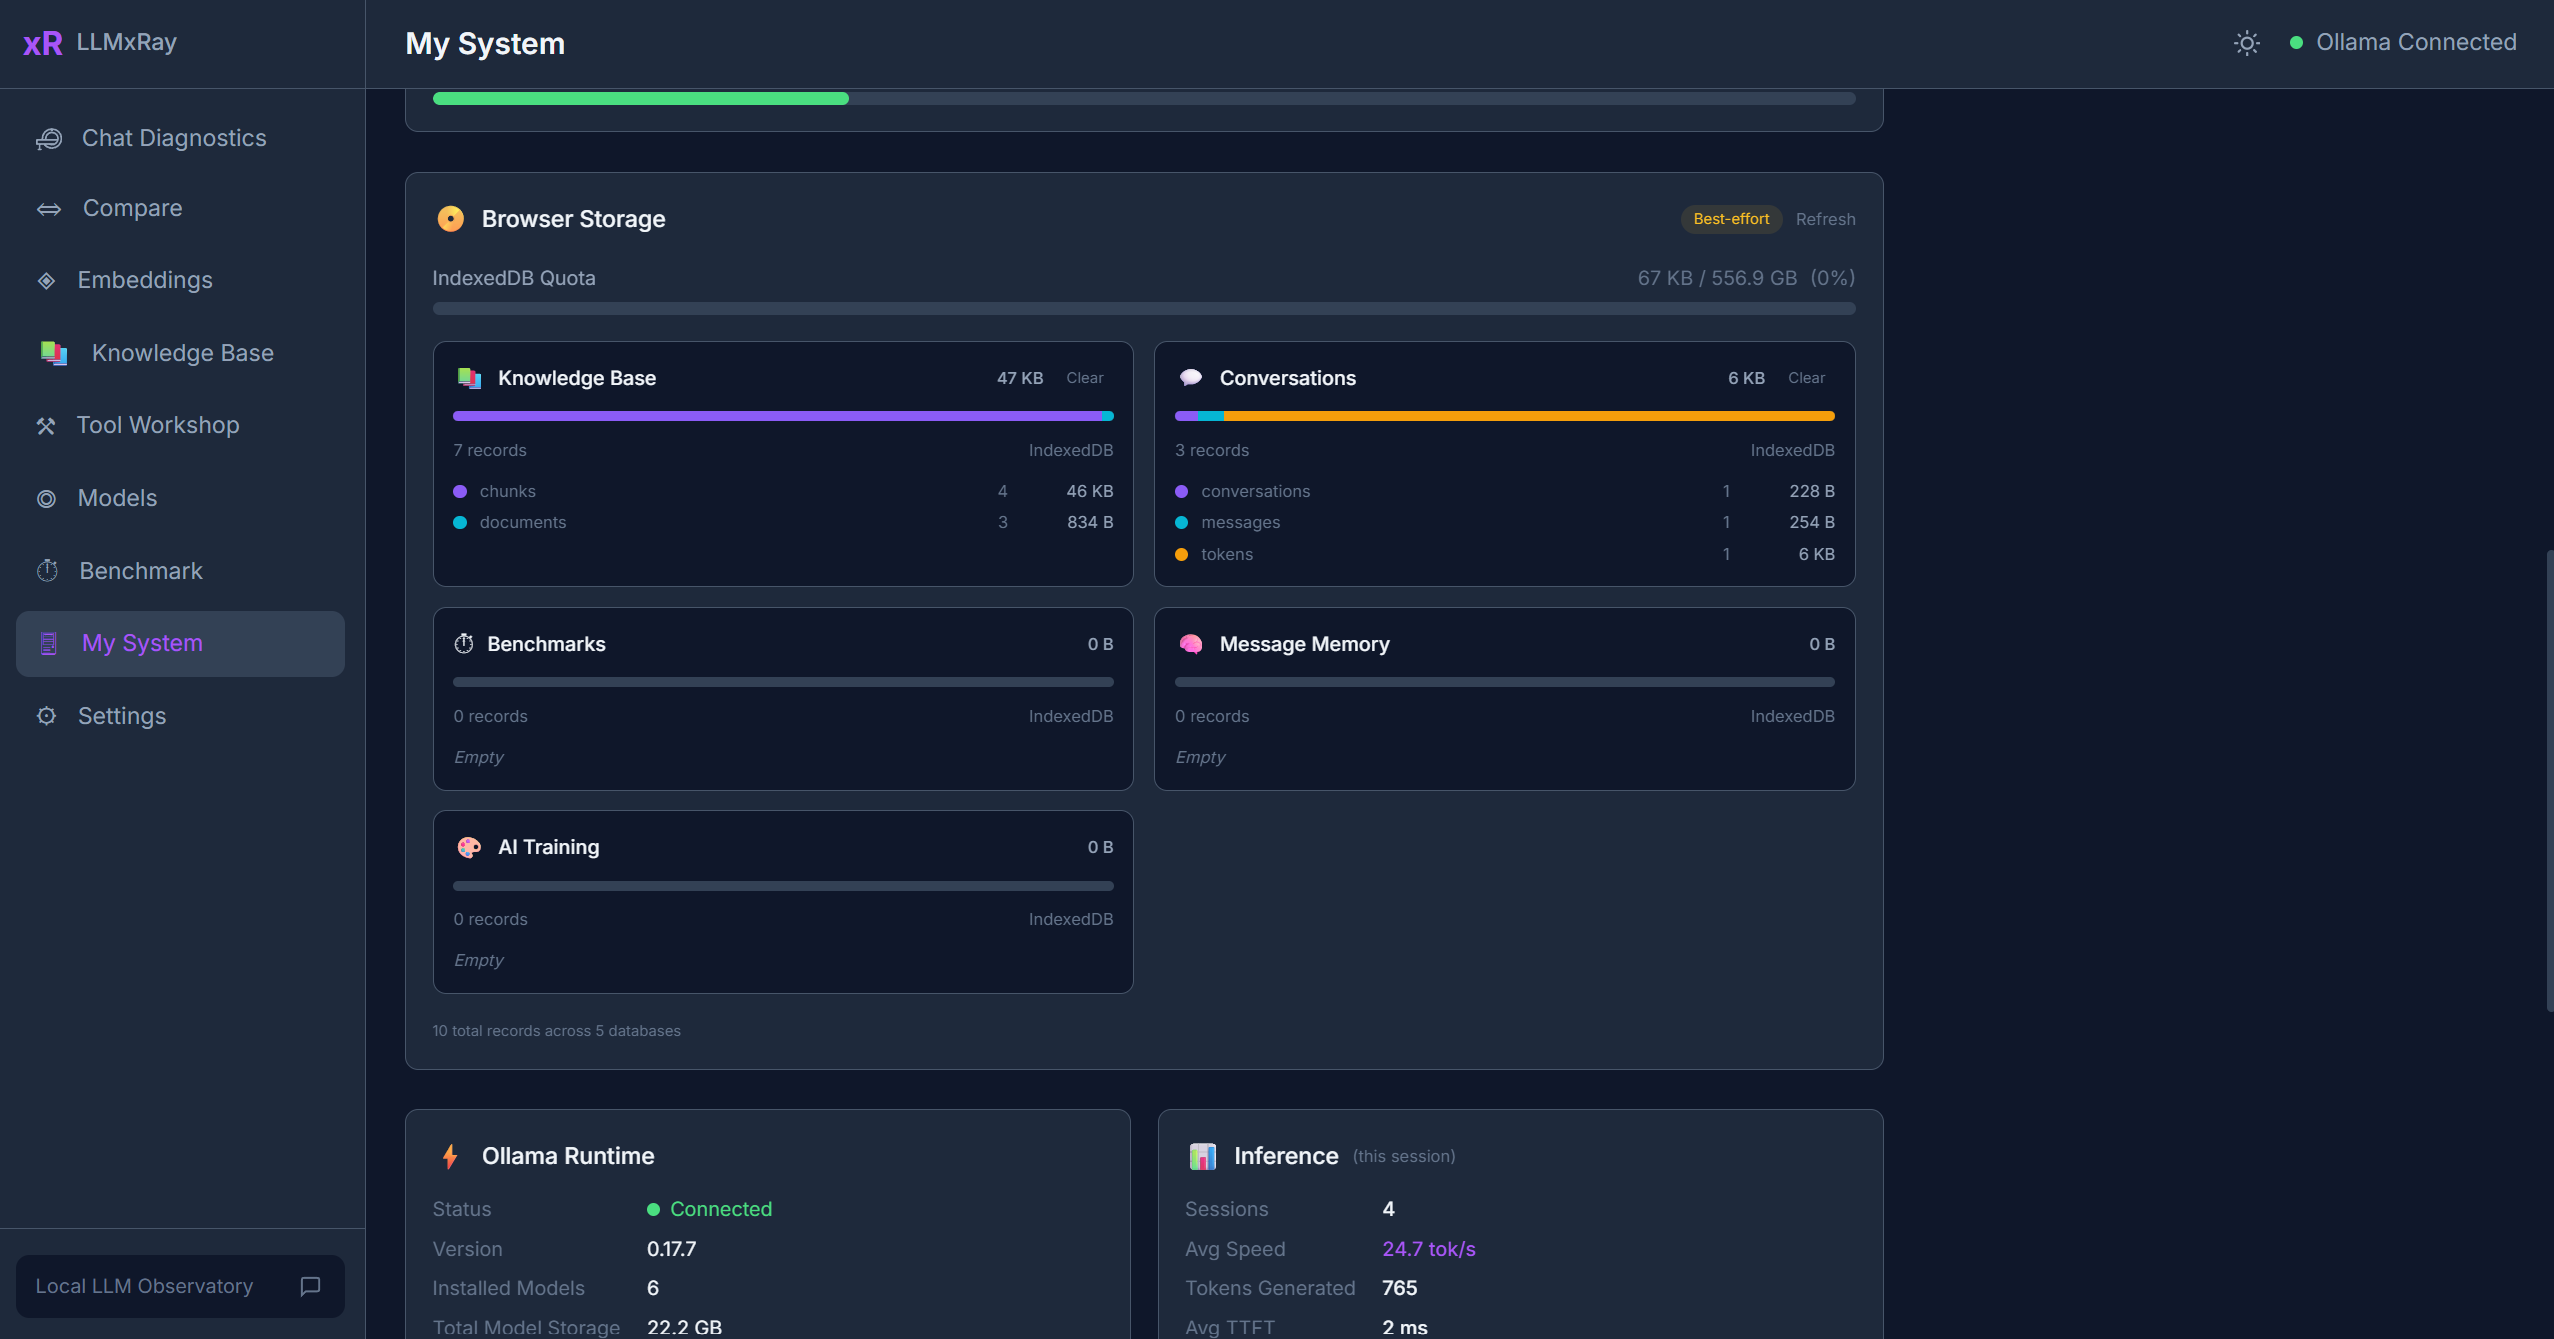
系统监视器——硬件和 Ollama 状态
|
适合谁使用
| 你是…… | LLMxRay 帮你…… |
|---|---|
| 开发者 | 调试提示词、分析延迟、对比模型、检查工具调用、跟踪成本 |
| 研究者 | 在跨模型和温度的一致设置下运行受控实验 |
| 学生 / 教育者 | 以可视化方式探索模型行为——内置教育者工具包,含 9 个交互模块 |
| AI 团队负责人 | 了解本地集群中的质量趋势、错误模式和资源使用情况 |
安装选项
npx(推荐)
npx llmxray
npx llmxray --port 3000
npx llmxray --ollama-url http://192.168.1.50:11434
Docker
docker run -p 5174:5174 djovaneli/llmxray
docker run -p 5174:5174 -e OLLAMA_URL=http://host.docker.internal:11434 djovaneli/llmxray
从源码
git clone https://github.com/LogneBudo/llmxray.git
cd llmxray
npm install
npm run dev     # http://localhost:5173
技术栈
| 层 | 技术 |
|---|---|
| 框架 | Vue 3.5 + Composition API |
| 语言 | TypeScript 5.9(严格模式) |
| 构建 | Vite 7.3 |
| 样式 | Tailwind CSS 4.2 |
| 状态 | Pinia 3(按关注点划分 store) |
| 图表 | Chart.js 4、D3.js 7 |
| 画布 | Vue Flow(可视化节点编辑器) |
| 代码编辑器 | CodeMirror 6 |
| 存储 | IndexedDB(浏览器原生) |
| LLM 后端 | Ollama(本地) |
架构
流式传输——通过 fetch() + ReadableStream 读取 Ollama NDJSON。Token 通过 Pinia store 响应式更新 UI。
Token 置信度 — 根据 token 间延迟近似估算(越快 = 越自信)。已明确标注为近似值。基准测试通过 OpenAI 兼容端点使用真实 logprobs。
按关注点分 store — 每个领域都有自己的 Pinia store:tokens、sessions、metrics、reasoning、comparison、embeddings、quality、cost 等。
硬件检测 — 自定义 Vite 插件直接查询操作系统(PowerShell/proc/sysctl)以获取准确的硬件规格。
开发
| 命令 | 作用 |
|---|---|
npm run dev |
开发服务器(端口 5173) |
npm run build |
类型检查 + 生产构建 |
npm run test |
单元测试(Vitest) |
npm run test:e2e |
端到端测试(Playwright) |
贡献
欢迎贡献!请参阅 CONTRIBUTING.md 了解设置和指南。
尤其欢迎社区翻译 — 希伯来语和日语的脚手架文件已就绪。
许可证
商标
LLMxRay 是 Ivan Stankovic(LogneBudo)的商标。请参阅 TRADEMARK.md。
如果 LLMxRay 能帮助你更好地理解你的 AI,不妨给它点个 star。
这能帮助更多人发现这个项目。
来源:Hacker News · github.com