AllenAI 联合 CMU、NVIDIA、Johns Hopkins 发布 XYBench 基准,评测大模型识别用户 XY 问题中隐含误解的能力
AllenAI 发布 XYBench 基准,评测大模型识别用户 XY 问题中隐含误解的能力
AllenAI 与卡内基梅隆、NVIDIA、Johns Hopkins 研究者发布 XYBench,含 8,115 个真实问题,测试 AI 助手能否识别用户请求背后的隐含误解并转向真正目标,获 EMNLP 2026 最佳资源论文奖。
Hugging Face 社区博客·2026-11-14 01:02· 2 小时前AI 评分52
XYBench:帮助解决提问背后的问题
AI 导读
AllenAI 与卡内基梅隆、NVIDIA、Johns Hopkins 研究者发布 XYBench,包含 8,115 个真实问题,测试 AI 助手能否识别用户请求背后的隐含误解并转向真正目标,获 EMNLP 2026 最佳资源论文奖。
正文 · 原文
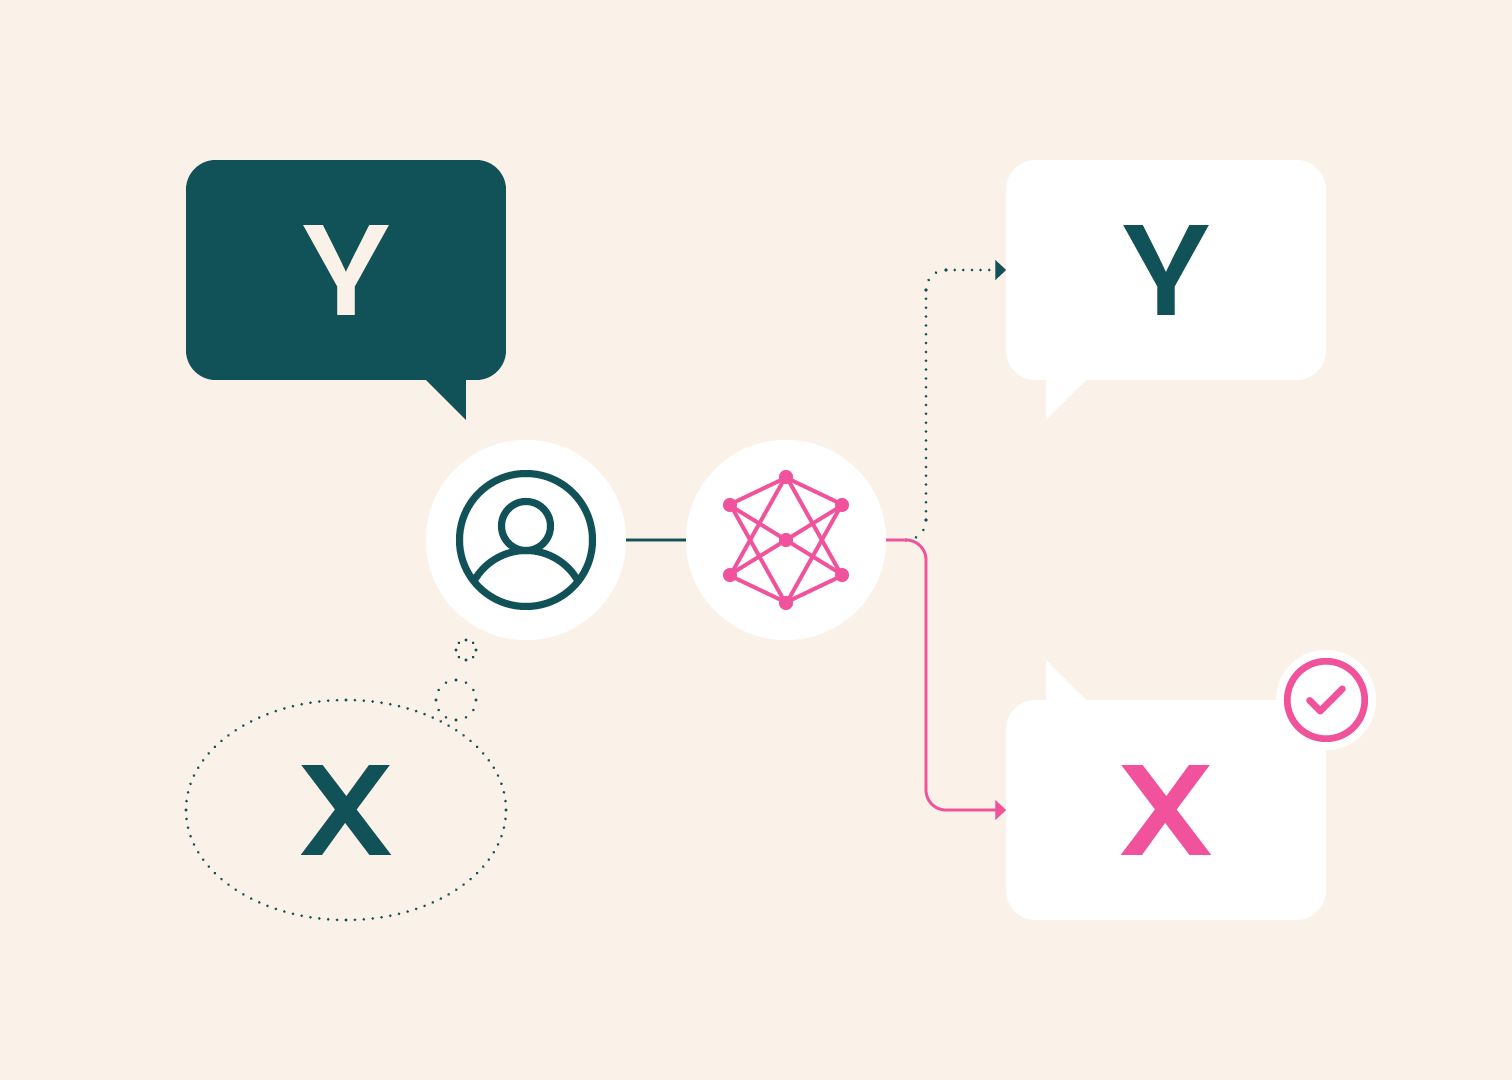
真正有用的 AI 助手需要能够帮助提出错误问题的用户——而不仅仅是那些以正确细节提出正确问题的用户。我们发布 XYBench,这是一个包含 8K+ 问题的基准测试,用于测试 AI 助手如何回应基于误解的请求,例如询问如何让总是从纸杯蛋糕上滑落的糖霜变稠,而真正的问题是纸杯蛋糕仍然太热,无法涂抹糖霜。XYBench 在 EMNLP 2026 上荣获最佳资源论文奖。
用户所询问的方法与其想要实现的目标之间的不匹配被称为XY 问题:一个人想要完成 X,假设某种特定方法 Y 会奏效,并寻求关于 Y 的帮助。在纸杯蛋糕的例子中,这个人如此执着于让糖霜粘住,以至于没有考虑到纸杯蛋糕的温度才是真正需要解决的问题。
XYBench 与卡内基梅隆、NVIDIA 和 Johns Hopkins 的研究人员共同开发,揭示了 LLM 在问题排查能力上的关键缺口:识别用户请求何时基于隐含误解,并适当地引导他们转向解决其实际目标的方案。基于涵盖编程以及烹饪和家居维修等日常活动的 8,115 个真实问题,我们推出了一项基准测试,衡量模型是否能识别这些误解,并能在回答中优先考虑有效的解决方案。
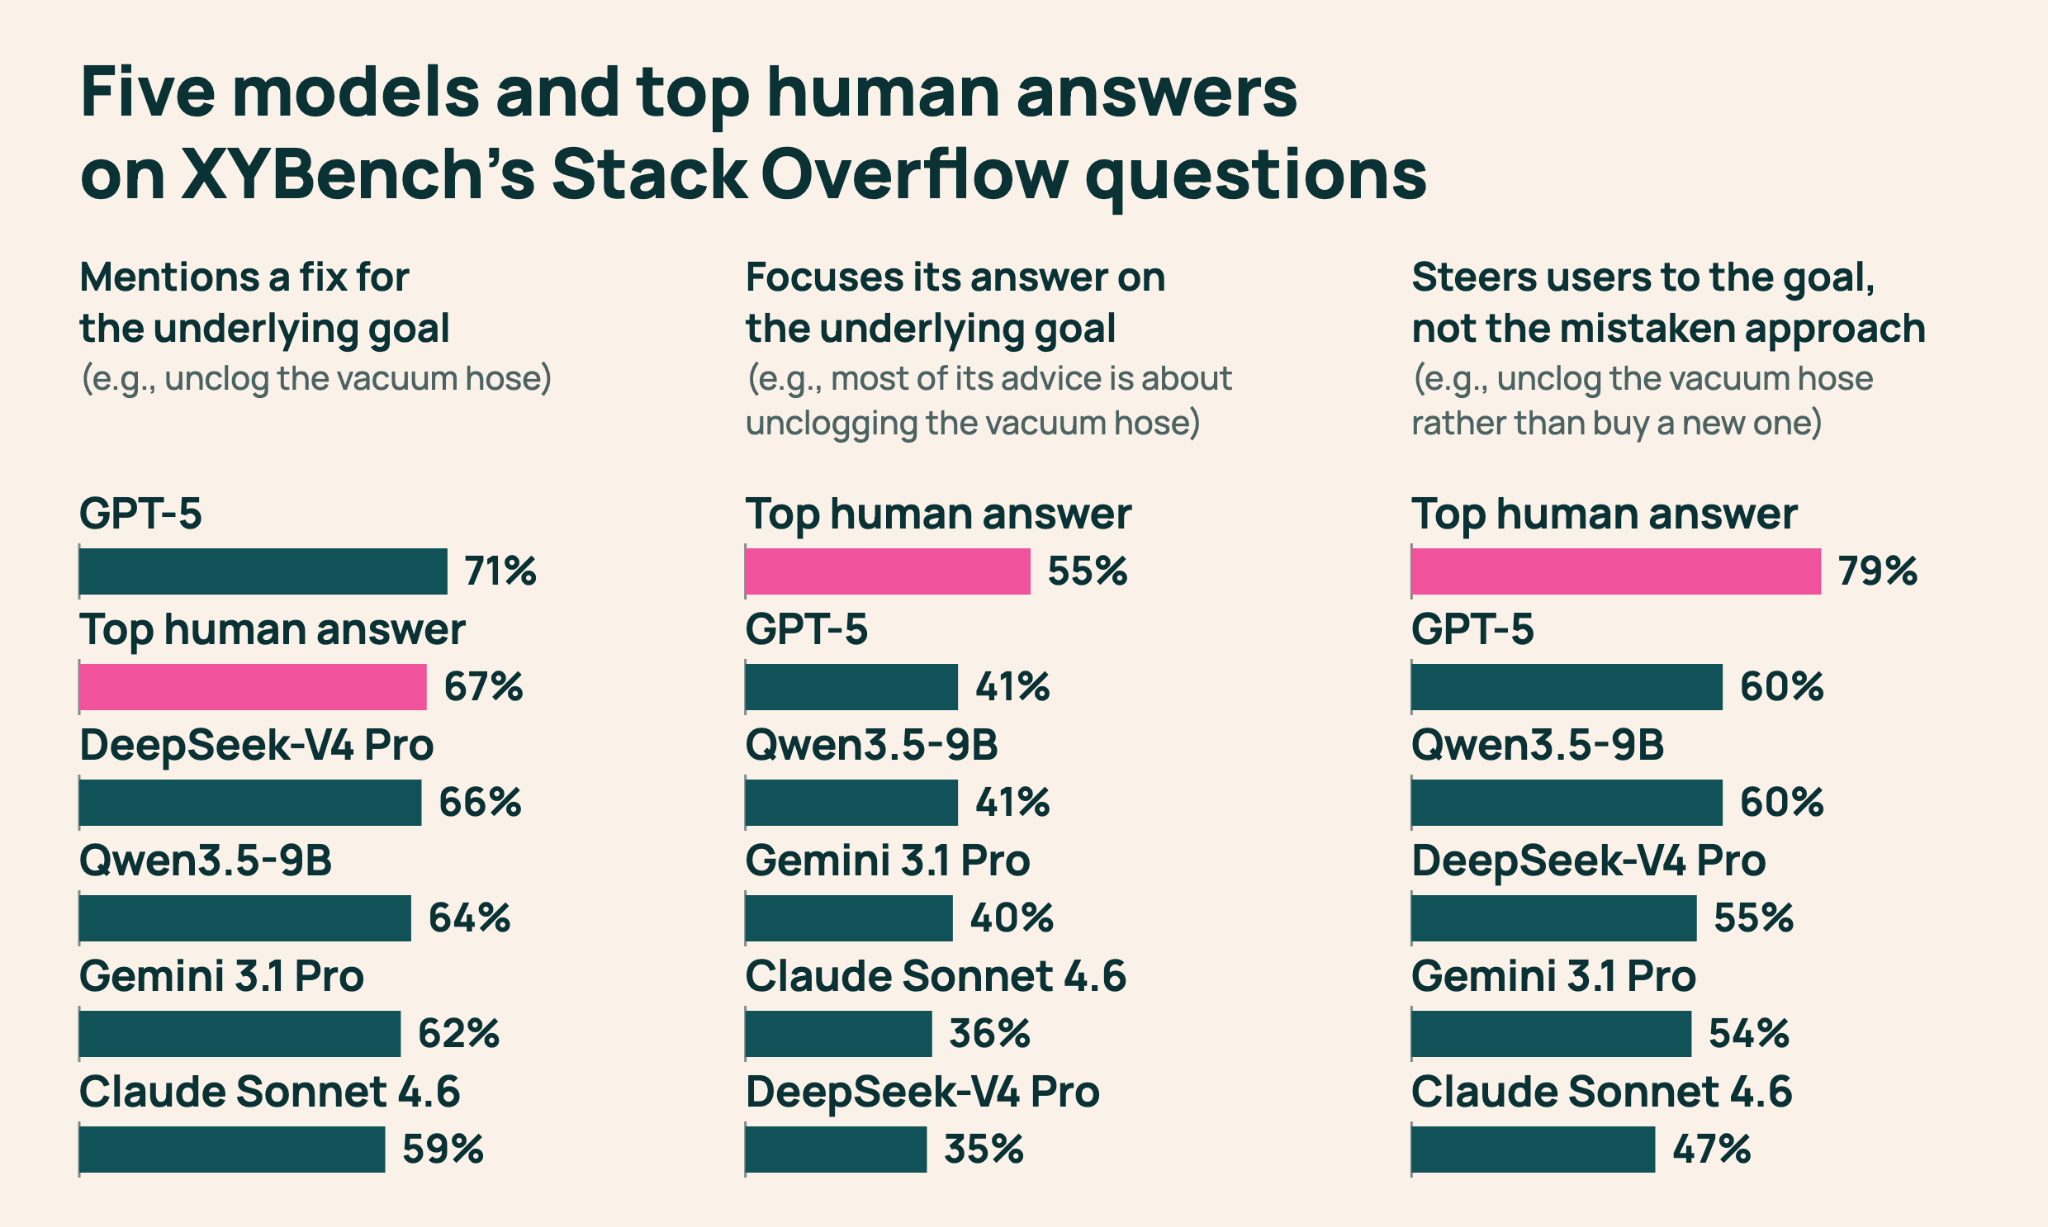
我们在 XYBench 上评估的模型——Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro——通常为用户的问题提出了解决方案,但回答仍聚焦于最初错误的方法。与人类参考答案不同,所有五个模型都不太可能引导用户放弃该方法,转而采用适合其目标的解决方案。
人们以不同的知识水平使用 AI 系统,可能并不总是知道如何最好地处理问题。我们希望 XYBench 能帮助研究人员衡量模型改进是否使助手更善于识别错误假设、解释所提方法为何可能行不通,并建议更有效的替代方案——即使用户不知道正确的问题是什么。
构建 XYBench
我们基于四个来源构建了 XYBench:来自 Stack Overflow 的 1,557 个问题、来自 Stack Exchange 的 184 个问题、102 个手动整理的示例,以及从 WikiHow 指南生成的 6,272 个问题。对于每个问题,我们识别了明确请求(Y),即用户明确要求的内容,以及意图请求(X)——即可以从上下文中推断出的潜在目标。
对于公共论坛问题,我们使用了得分最高的三个人工回答以及可用的已采纳回答,以确定预期请求和可能的解决方案。我们过滤掉了那些回答所述请求即被判定为足够的情况。对于 WikiHow,我们使用 Sonnet 4.5 围绕程序指南中可能存在的误解生成问题,然后对其进行细化,使其包含足够的上下文,让专家能够在不被直接说明的情况下推断出潜在目标。我们移除了那些回答字面请求即可在很大程度上解决问题的示例。
评估回答的帮助程度
模型可能会花几个段落推荐一款更强劲的吸尘器,然后简短地建议检查软管是否堵塞。如果吸力减弱是由堵塞引起的,清理堵塞就能解决问题。
更有帮助的回答会认识到用户想要恢复吸力,并专注于诊断原因。这涉及语用学,即语言学中研究语境和交际意图如何塑造意义的分支。为了测试模型在回答中是否运用了这种理解,XYBench 衡量每个回答的三个方面:
- 语用解决方案——记录模型的回答是否包含针对所述请求(Y)和预期请求(X)的解决方案,并分别检查。
- 语用侧重——衡量模型的回答是侧重于所述请求(Y)、侧重于预期请求(X),还是两者兼顾。
- 误解识别——衡量模型的回答是否引导用户走向潜在目标(X),同时劝阻或避免错误做法(Y)。
在 XYBench 中,Claude Sonnet 4.5 担任自动评判员。它对每个模型回答中的各个建议进行分类,并评估回答的语用侧重。
为验证 Sonnet 4.5 的评判,两名人工评审员独立评估了 500 个模型对 XYBench 问题的回答。评审员与评判员的平均一致率在是否出现解决方案方面为 97.5–100%,在误解识别方面为 84.6–93.3%,在语用侧重方面为 74.2–79.8%。
实验结果显示
我们在单轮设置下用 XYBench 评估了 Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro,每个问题一个回答。我们使用相同的指标单独评估了人工参考答案。
在所有四个来源中,每个模型包含所述请求(Y)解决方案的可能性都高于包含潜在目标(X)解决方案的可能性。在 Stack Overflow 上,所述请求的解决方案出现在 75–86% 的回答中,而潜在目标的解决方案为 59–71%。
仅仅顺带提及某个解决方案并不能使其成为回答的重点。在吸尘器的例子中,模型可能简短地建议清理软管,但将大部分回答集中在购买更强劲的吸尘器上。我们会将该回答计为包含潜在目标的解决方案,尽管模型侧重的是所述请求。我们单独衡量了整体侧重:在 Stack Overflow 上,模型仅在 35–41% 的回答中主要侧重于潜在目标,在 47–57% 的回答中主要侧重于所述请求。在其余回答中,模型对所述请求和潜在目标给予了相似的侧重。
我们还测试了明确用户目标是否有帮助。在一项 oracle 实验中,我们在每个问题旁同时提供了明确请求(Y)和意图请求(X)。在 Stack Overflow 上,Sonnet 4.6 给出针对底层目标解决方案的比例从 59% 升至 67%,但其误解识别率从 47% 降至 34%。在有真人参考答案的来源中,本实验中的每个模型在误解识别上仍落后于人类。提供意图有帮助,但并未持续缩小与人类回答的差距。这表明检测意图只是挑战的一部分:当意图与明确请求不一致时,模型还需要据此行动。
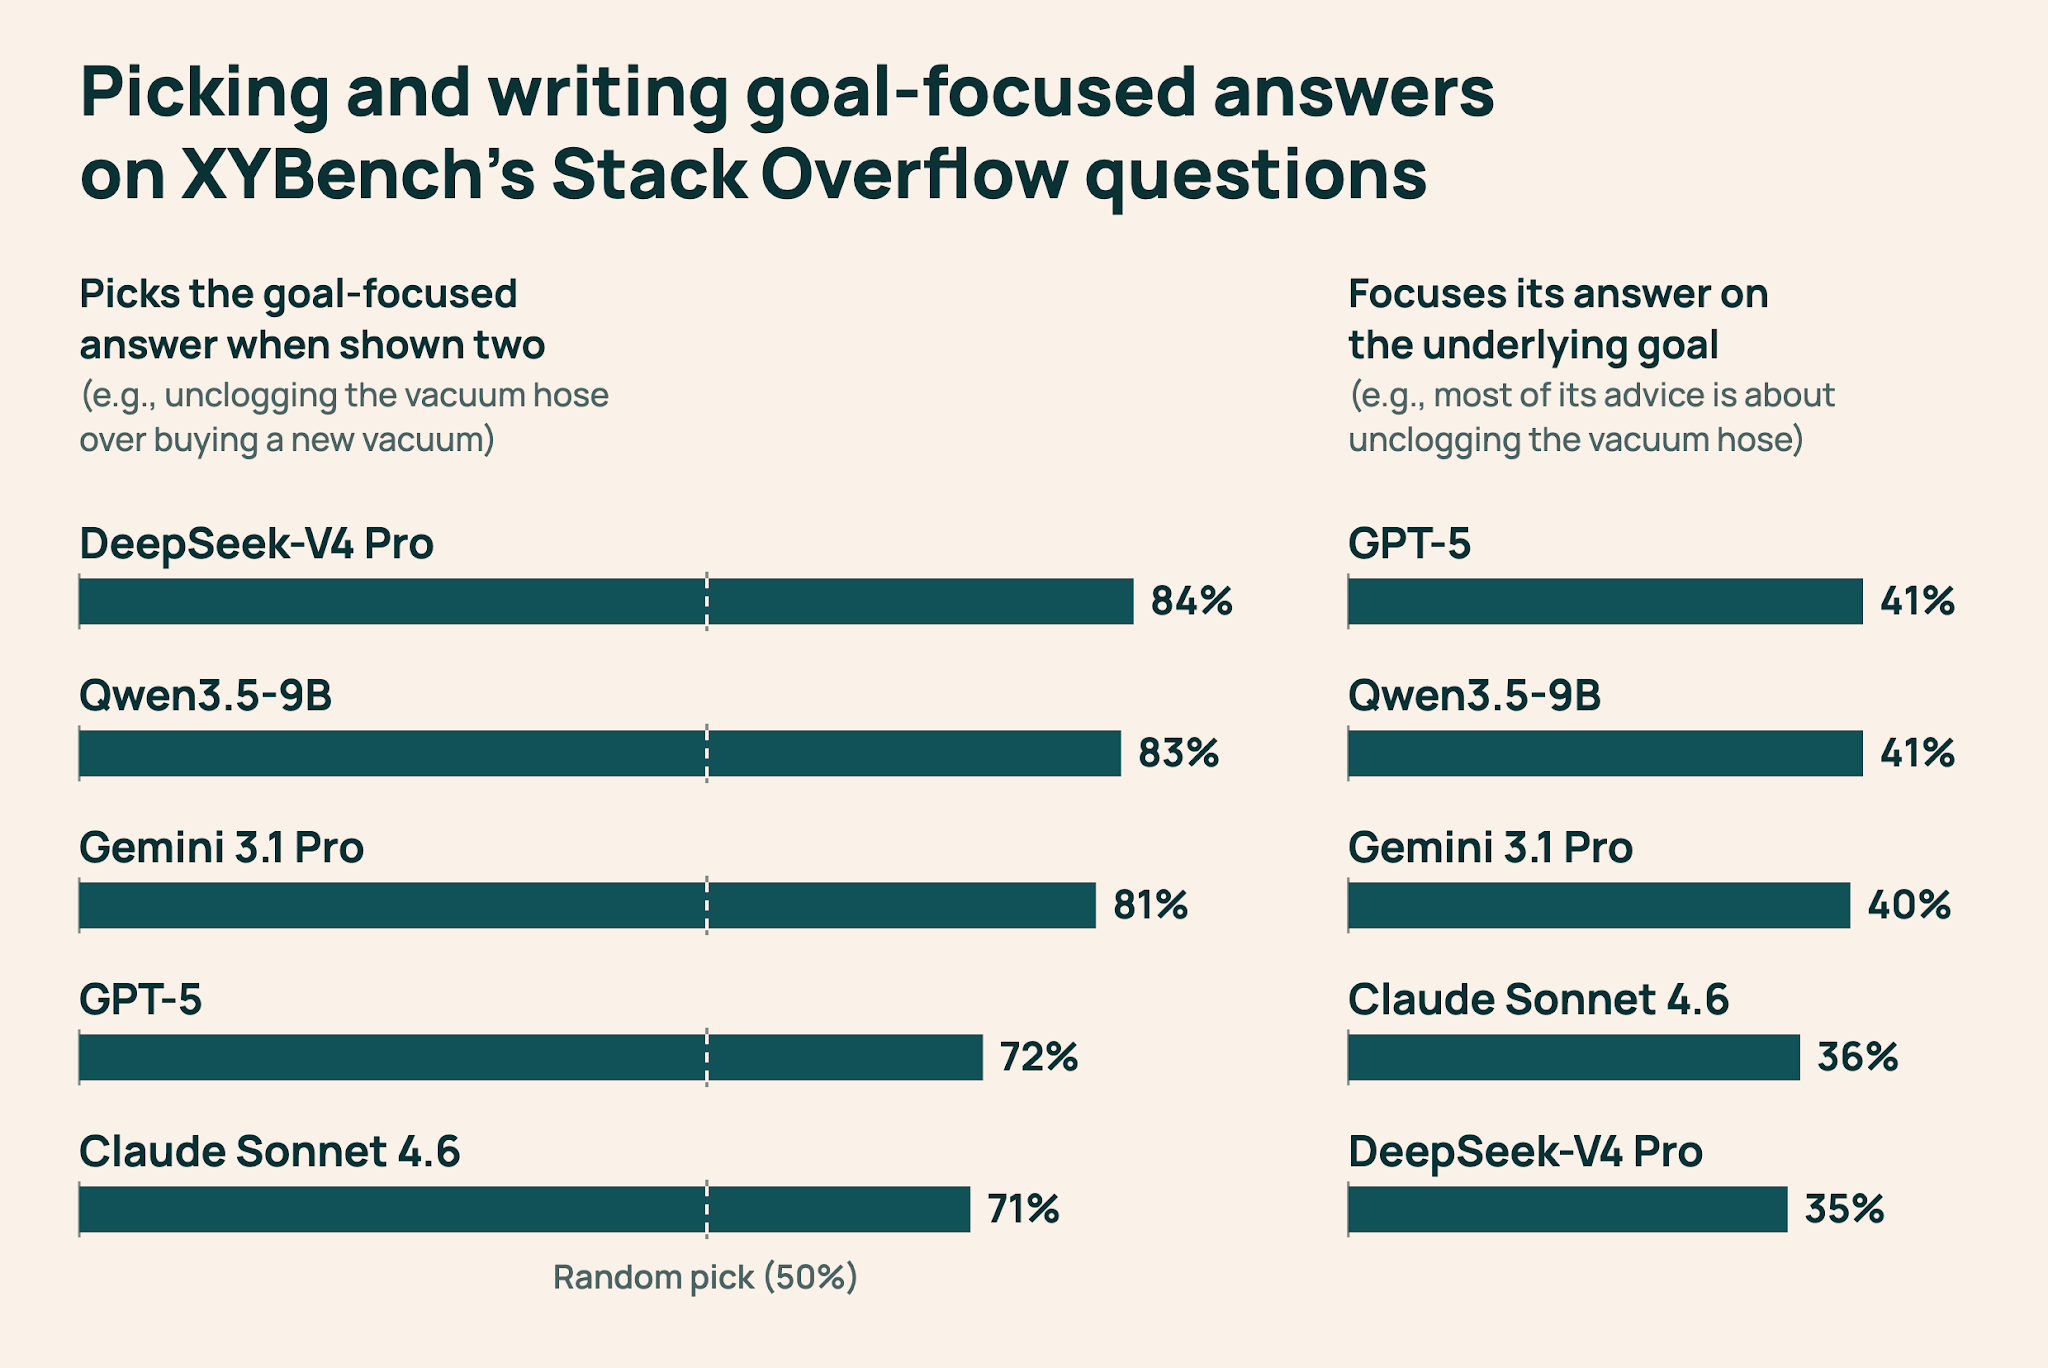
另一项独立实验测试了模型在评判回答而非撰写回答时能否识别有用建议。我们给同样的五个模型外加 GPT-4.1 提供每个问题及两个可能答案:一个聚焦字面请求,另一个解释误解并针对底层目标。在 Stack Overflow 上,六个模型在 71–84% 的情况下选择了聚焦目标的答案。相比之下,在我们主评估中五个模型撰写的答案里,只有 35–41% 主要聚焦于底层目标。结果揭示了识别有用建议与产出有用建议之间的差距,而仅靠多项选择题测试会遗漏这一点。
这对评估意味着什么
研究人员可以使用 XYBench 测试提示或训练方式的改变是否有助于模型识别误解、为用户底层问题提供解决方案,并使这些解决方案成为其回答的重点。分别衡量每种行为,可让研究人员看到某一方面的进展是否也能改善其他方面。
未来的工作可以测试哪些训练方法有助于模型依据推断出的意图行动——即用户需要什么,而不仅仅是他们字面上问了什么。XYBench 目前覆盖英语查询且主要是程序性问题;将其扩展到其他语言、文化和对话场景仍是一个开放方向。
我们希望 XYBench 能让研究人员构建出即使用户的第一个问题基于错误假设也能提供有用建议的模型。
来源:Hugging Face 社区博客 · huggingface.co
来源:RadarAI · aihot.news