Phobos v0.1.0 发布:自研内核语言在 2019 年的 RTX 2080 SUPER 上跑通 LLM 推理
Show HN: Phobos – a tiny kernel language that now runs LLMs on a 2019 GPU
作者发布 Phobos v0.1.0,这是其自研小型内核语言的第一个版本,所有内核在运行时编译,不依赖 cuBLAS 或 CUDA toolkit,仅需驱动。
TLDR: Phobos,我上一篇帖子1里那个小小的内核语言,现在能端到端运行 LLM 了。每个内核都在运行时由 Phobos 编译。不需要 cuBLAS 或 CUDA 工具包,只要驱动。在我那台老 RTX 2080 SUPER 上,它生成文本的速度在我试过的每个模型上都与 llama.cpp 相当或更快,只有两个例外:在 0.8B 模型上是每秒 324 对 247 个 token,在 35B 混合专家模型上是 54 对 30。这两个例外是:一个是三元 27B,PrismML 最新的 llama.cpp 分支现在解码比 Phobos 快 7%(49 对 45),不过 Phobos 读取提示词仍然快 1.24 倍;另一个是 GLM-4.6V-Flash,llama.cpp 解码快 6%。当桌面在会话中途拿走 2 GiB 时,得益于其动态缓存策略,Phobos 保留了四分之三的解码速度,而 llama.cpp 只保留 30%。小模型上的提示词处理仍然落后,只有 llama.cpp 的 60% 到 80%。另外,现在有了首个发布版。
Phobos v0.1.0
我很高兴地宣布,我创建了 Phobos 的第一个发布版,它已经从一次学习练习成长为一个 LLM 推理栈。对我来说,它仍然是一次学习练习。
背景:我的工作站里恰好有一块 RTX 2080 SUPER。那是 2019 年的卡,有 8 GB 显存。不算很花哨。它能完成任务。现代推理框架大多忽略这种老卡2,或者不太在意重量化。所以它本来就是块慢卡,而且我猜这些内核并没有为它调优过。
Phobos 在 1-bit 领域的量化上表现非常好。它也能运行 PrismML 的 Ternary-Bonsai-2-27B,而且在他们最新构建之前,比他们自己的 llama.cpp 分支还快。当然,这只是在我的卡上测得的。
你可以在 GitHub 上获取你的 Phobos 副本。
Phobos 的一次完整运行,加速 2×。
这篇帖子讲的是从编译器走向推理引擎的故事。追逐(错误的)基准测试,并优化你自己 JIT 编译的内核。Phobos 推理完全运行在运行时编译的 Phobos 内核上。
好奇心的诅咒
我上一篇帖子1以“现在我真的要停下来了”结尾。好吧。算是吧。你看,当我在 SGEMM 上达到 cuBLAS 的 76% 时,我觉得再去追逐更多性能已经没有意义了。我已经到了收益递减的地步。一开始,我想更多地了解 AI,尤其是 GPU 方面。但我已经穷尽了我的卡 ISA 所提供的东西。在新 GPU 上你可以玩一些很酷的技巧,但最终,对我来说真的就到此为止了。
所以我选了一个不同的目标。我在 Phobos 中实现了 FlashAttention3,然后是 FlashAttention-2 对在线 softmax 的调整4。等那能用了,我又实现了 Kimi Delta Attention5。 当然,我对这些内核做了基准测试。但我不知道这个实现到底好不好。不过,既然注意力内核已经在我手上了,运行一个完整的 LLM 又能有多难呢?
所以我给自己定了两个目标:
- 使用 Phobos 语言和编译器端到端运行一个完整的 LLM
- 达到 llama.cpp 性能的 80%
如果你还记得上一篇帖子:
GGUF 文件 ⟶ 分词器 ⟶ 前向传播 ⟶ 内核 ⟶ MLIR ⟶ PTX ⟶ GPU ⟶ 采样器 ⟶ 文本
那条链的中间部分就是上一篇帖子。这篇讲的是它周围的一切。
支线任务: GGUF,不是 ONNX
我从 ONNX 开始,因为它自带完整的计算图。这对我来说很合理。然而,我并没有沿着这条路走下去。那个图需要大量优化才能有不错的性能。而最重要的原因是:我需要运行量化模型,如果你看看 Hugging Face,找到 GGUF6 版本的概率相当高,但如今没人在乎 ONNX。
GGUF 更容易处理。它包含一些元数据、一个聊天模板,当然还有张量,但计算是隐含的。也就是说:GGUF 文件声明“嘿,我是 llama 系列模型”,而你必须知道如何处理这些信息。理论上,ONNX 更优越。实践中,简单的方案胜出。
GGUF 还提供了分词器(ONNX 没有),而一次前向传播只需几百行 Rust 代码。
Oracle
我下载的第一个模型是 Qwen3.5-0.8B 的 Q8_0 版本。没什么特别原因。我只是觉得它足够小,能装进我的 8 GB 显卡。最大的缺点是,这个模型的大部分块是 Gated DeltaNet5 线性注意力,它携带的是循环状态,而不是不断增长的 KV 缓存。
在 CPU 端构建了内核和参考 oracle(速度高达 4.5 tok/s)之后,oracle 生成的 token 看起来正确,但毫无意义且退化了。
幸运的是,我可以偷看 llama.cpp 的 qwen35.cpp。有几个 bug,但最突出的是查询上缺少(隐式的)1/√d 缩放,这搞乱了 DeltaNet 块。
解决之后,Phobos oracle 和 llama.cpp 在大多数提示上选择了相同的 token,在其他提示上,最高候选的 logits 相差约 0.03(在噪声范围内)。这足以让我把它作为我的基线。
全模型 Bug
转到 GPU 后反而更慢了。真是个美妙的开始。
有两个问题花了我不少时间。第一个是重用已分配的内存会损坏模型。第二个是长度超过单个 token 的提示从第一个块开始就退化。 当我单独检查每个操作时,一切都产生了正确的值。
但其实是同一个 bug。内核写超出了其输出的末尾。当内核的最后一个 tile 运行超出张量末尾时,编译器根本没有处理这种情况的机制。我在编写编译器初始版本时走了很多捷径。这就是其中之一。一个五行提示在其输出之后多写了 27 行。但由于检查只查看预期的输出,即前五行,一切看起来都正确。内存中接下来的任何内容都被破坏了。每次使用 cudaMalloc 时,这不会发生。
一个 tile · 32 行
一个五行的输出仍然会得到一个完整的 32 行 tile,如果没有掩码,其他 27 行会写入垃圾数据。检查只读取自己的五行,所以无论如何都能通过。
修复进入了编译器:正确的掩码(加上 @aligned,用于调用者可以保证形状的内核)。对我来说,令人不安的教训是,我总是必须运行(缓慢的)全模型检查。孤立测试根本不够好。
MiniCPM5-1B 使用普通的 llama 架构,遇到了另一个微妙的 bug。几乎没有新代码。我能够正常解码到大约 512 个 token,但之后就崩溃成噪声。512 正是旋转表和 KV 缓存都增长的地方。它们的大小完全匹配:
2 kv heads x 128 dims x 512 positions = 131072 floats
1024 positions x 128 rope dims        = 131072 floats
新的旋转表拿到了旧 KV 缓存刚释放的缓冲区,而本应向前传递缓存的副本却拿到了旋转角度。Qwen 从未遇到这个问题,纯粹是因为它的两个尺寸相差八倍。MiniCPM 又暴露了几个 bug。有一次,token 生成从未停止。MiniCPM 的结束 token 是 </s>,而它的聊天模板每一轮都以 <|im_end|> 结束。
快速解码
解码(或 token 生成)和提示处理(或预填充)是非常不同的问题。不过解码的数学其实相当简单。
要生成一个 token,解码步骤必须将模型中的每个权重读取一次,然后对每个权重做一次乘法和一次加法。这大约相当于我们从内存加载的每字节进行 2 次运算。
我的 GPU 大约能跑 11 TFLOP/s。内存带宽测得为 400 GB/s。11 万亿次运算/秒除以 4000 亿字节/秒等于 27.5。显卡标称的速度略有不同,会得到 22.5。为了这篇博文的目的,我们取中间值:要让 GPU 的数学单元保持忙碌,每字节需要 25 次运算。但我们每字节只用了 2 次运算。因此数学单元大部分时间都在等待新数据。这就是为什么人们说解码是内存受限的。
token 生成的上限也很容易计算。如果你有一个模型,比如我们的朋友 Qwen3.5-0.8B,每个 token 读取 0.83 GB,你可以计算 0.83 GB / 400 GB/s,大约是 2 毫秒,即每秒 500 个 token。这是我们的物理极限。Phobos 目前是每秒 324 个 token。
提示处理则相反。对于 512 个 token,每个权重被重用 512 次。这是计算密集型的工作,你需要让张量核心饱和。我们先来看解码。
字节 vs 数学 · RTX 2080 SUPER
解码每生成一个 token 就将每个权重通过内存总线推送一次,几乎不做任何数学运算,因此总线决定了节奏,数学单元大多在等待。提示处理则对全部 512 个 token 重用每个权重,瓶颈就反转了。
第一个明显的步骤是保持权重量化。我最初在加载时将它们扩展为 f32。保持量化将内存减少了近四分之三,但……什么也没换来。内核在相乘之前仍然将每个块扩展回共享内存中的 f32,所以它从未接近带宽限制。但使用 dp4a 在 int8 中端到端地进行数学运算达到了预期效果。性能跃升了 30%。由于所需的共享内存少得多,更多的块可以同时放在 GPU 上。
另一个重要问题是线程映射。一个 Q8_0 块自带缩放因子。内核必须每 32 个元素停下来应用它,每个输出一个线程,而线程块的大部分都处于空闲状态。修复方法是引入一个新的内建函数 qdot_t,它完成一整行的乘加运算,包括缩放因子。现在一个 warp 负责一个输出,并将工作分配到它的 32 个通道上,无需共享内存,最后只需一次 shuffle。几个内核的解码速度提高了两到七倍,总体提高了 1.4 倍。
解码 · 矩阵 × 向量 · 示意图
解码是矩阵乘以向量。以前,每个线程遍历自己的行,每 32 个权重就停下来处理该块的缩放因子。使用 qdot_t 后,整个 warp 以连续的 512 字节片段读取一行,每个通道直接在寄存器中将自己的部分和乘以它所在块的缩放因子,最后通过一次 shuffle 将各通道的结果相加。
随后是一些众所周知的启动优化。例如,可以将一次完整的执行过程记录下来,并作为 CUDA graph 重放7。接着是更少、更胖的 kernel:将激活量化一次并共享,把读取相同输入的投影堆叠起来,将残差加法融合进矩阵乘法。
| Qwen3.5-0.8B,解码 | tokens/s |
|---|---|
| 起点 | 76 |
qdot_t,融合后的量化点积 | 106 |
| 将整个执行过程作为单个 CUDA graph 重放 | 170 |
| 录制时停止分配内存(它每步要分配 5000 次) | 191 |
| 十几个小型融合 | 260 |
| 今天:更新的驱动,加上本文后续的所有内容 | 324 |
打开闸门
在开发 Phobos 期间,我读了 Sankalp 关于自动研究的文章,也就是 Karpathy 推广的那个循环:智能体修改代码、测量、保留或丢弃改动,然后重复。我非常喜欢同时保持三条或更多想法活跃的束这一理念,写下假设、改动了什么以及下一步尝试什么。
我复制了提示词,稍作调整,然后让 Claude 自由发挥。我让它跑了一整夜,因为它需要我的 GPU 以及桌面环境平时占用的宝贵显存。
它在约两次会话中发现的内容:
- 解码注意力只用了 256 个线程中的 32 个。七个 warp 坐在那里看着第八个干活。一个新的内置函数
warp_partial将循环分散到全部八个 warp 上,该 kernel 的耗时下降了一半以上。 - 使用 FlashAttention。一次 trace 显示注意力占整个执行过程的约 37.5%,而模型甚至没有使用我一开始就构建好的 FlashAttention kernel。切换到它之后快了很多。
- 向量化注意力。主要的提示词注意力 kernel 上没有
@aligned。分析器打印出“预计加速:36%”。加上两个属性后,它几乎快了一倍。 - megakernel 是条死路。其思路是为整个解码步骤使用一个 kernel。但启动开销完全没有减少。那时我已经在使用 CUDA graphs,而已发表的 megakernel 之所以胜出,是因为消除了 kernel 之间的气泡,而不是消除了启动8。我仍然认为这里面有东西可挖,比如更大的优化潜力,但眼下我会把精力放在别处。融合 pass 仍然是这项工作的成果。
一个 block · 8 个 warp × 32 个线程
一个 block 有八个 warp,而解码注意力循环只在一个 warp 上运行。warp_partial 让每个 warp 拥有自己那部分 key,并在最后合并结果。只有循环获得了八倍的人手,这就是为什么该 kernel 的耗时下降了一半以上,而不是 8 倍。
智能体产出自信但错误的数据
- 同时运行的两个基准测试会悄无声息地互相破坏。两个引擎在每一轮中都只能以一半速度读取,包括测试框架标记为“无争用”的那些轮次,因为它只在轮次之间检查显卡。我修改了 Claude 的提示词,要求始终将绝对数值与已知基线进行核对。
- 共享同一个 Cargo 目标目录的两棵代码树会互相竞争,你会得到随机失败,而没有任何冲突的改动。
- 智能体可以完成真实、正确的工作,却从不汇报。这种情况在我身上发生过很多次。所以现在,在三次恢复并等待的循环之后,协调器会接管:读取 diff、重新运行检查、重新运行基准测试。
更多量化
所以现在 Phobos 在 Q8_0 上凭借自动研究的魔力击败了 llama.cpp。不过没人跑 Q8_0。大家跑的是 Q4_K_M,再往下还有一大堆 1 位、2 位和 3 位格式,其中最小的那些能让一个 27B 模型塞进我这样的显卡里。所以我想支持更多格式。
CPU 解码器最先完成,直接照着 ggml-quants.c9 写的,还配了一个验证正确性的工具。quant_check 会把量化文件与同一模型的更高精度副本逐张量进行对比。因为我了解到,即使解码器写错了,模型仍然能生成流畅的文本,所以这是我找到的唯一可靠的查错方法。
我的目标是支持 Unsloth 的 IQ1_M 量化版 Qwen3.8-27B。那大约是每个权重两比特。6.27 GiB 的权重放在一张 8 GiB 的显卡上(这张卡还要驱动我的桌面)。llama.cpp 大约能跑到每秒 22 个 token。而 Phobos 第一天,读取一个 128 token 的提示要花 11 秒,然后生成速度在每秒 0.6 到 2.4 个 token 之间,全看它心情。……耶 :)
GPU 性能海森堡 bug
海森堡 bug 一盯着看就消失。关于 V8 在这方面的故事,可以读我 2015 年的文章。
每秒 0.6 个 token 慢得离谱,大约比 llama.cpp 慢 37 倍。性能分析器显示,输出头在每 token 读取一次 521 MiB 张量时,只跑到了显卡带宽的 1.1%。在 Claude 的帮助下,我尝试攻克它,但毫无进展。不同的 tile 宽度、手动提升的索引运算、为更宽加载重新映射的 lane。全都没用。
理论上,这个 kernel 受指令发射限制,应该只要大约 3.6ms。但实际却花了 96.7ms。这个 kernel 比它估计的最坏情况还慢 27 倍。可当我单独运行这个 kernel 来检查发生了什么时,它只花了 3.2ms。
输出头在每一个 token 上都要通过 PCIe 从系统内存换页进来10。nvidia-smi 报告说它是常驻的,GPU 也是 100% 忙碌,所以我就没去查。原因是,被逐出/换页的分配仍然算作“已使用”,而一个等待总线的 kernel 会被显示为“忙碌”。这让我非常困惑,我在这上面花了不少时间和 token。此外,这个问题在单独运行时消失,是因为其余权重没有加载。或者是因为我碰巧少开了几个桌面应用,有更多显存空着。
RTX 2080 SUPER · 8 GiB
nvidia-smi:已用内存 · GPU 100% 忙碌
27B 模型需要的一切都塞进一张 8 GiB 的显卡,再加上桌面正在用的部分。把桌面占用往上拖:Windows 不会让任何东西失败,它会悄悄把一个分配挪到系统内存,每次 kernel 访问它时再通过 PCIe 拉回来,而 nvidia-smi 却一直说内存已使用、GPU 忙碌。
一旦知道了问题所在,我就开始着手内存管理。Windows 显示驱动按分配来管理内存驻留。如果你有几百个小分配,它们很可能在几个大分配之前就被换页出去。Phobos 现在改用了一个大块 slab 分配器。此外,prefill 在内存池里留下了一个 542 MiB 的 slab,decode 用不了(后面再细说)。做了这些改动之后,速度只取决于桌面占用了多少显存。Decode 从每秒 0.6 个 token 提升到了大约 18 个。当桌面占用更多显存时,每秒 token 数会下降,但这是意料之中的,在我的机器上 llama.cpp 也是如此。
有趣的事实:我在自己的台式机上发现了许多我根本不知道存在的应用程序。某个我不记得安装过的 Xbox 游戏覆盖层正在 吞噬大量 VRAM(大量是指:相对于我拥有的量而言吧 :>)。还有那个我根本不用的愚蠢小组件面板。 然后还有那些烦人的 Electron 应用。不过,我真的很想弄明白另外那约 800 MiB 去了哪里。当我关闭所有应用、只开着空闲桌面时, 我始终无法让桌面的 VRAM 占用降到 910 MiB 以下,而其中大约 100 MiB 是我对原生 4K 桌面的预期值。显卡上实际活跃或分页出去的有多少,我就不知道了。
内存得到控制后,焦点又回到了内核上。IQ 格式会解码为精确的 int8 值,因此提示词会直接在整数张量核心上运行它们,而将权重按八列一组存储,可以让解码 warp 读取完整的缓存行。目前的情况是:
| Qwen3.8-27B-UD-IQ1_M | Phobos | llama.cpp |
|---|---|---|
| 提示词,128 个 token | 532.6 | 477.0 |
| 解码,128 个 token | 31.4 | 22.0 |
token 生成速度提升了 43%,而且这也是提示词处理首次变得更快。
但是:我没有花任何时间来优化桌面占用过多 VRAM 的情况。一旦模型不再能装进显卡,驱动程序就会通过 PCIe 对它进行分页,速度会降到大约每秒 7 个 token。但最终,我现在能够在消费级显卡上以不错的速度运行 Qwen3.8-27B-UD-IQ1_M 了。
PrismML Ternary-Bonsai-2-27B
PrismML 及时发布了 Ternary-Bonsai-2-27B。当然,我想看看自己能否运行这个模型,以及速度如何。我也很好奇,因为到目前为止,我一直不太喜欢 1.x 位量化。Ternary-Bonsai-2-27B 使用三值权重(-1、0 或 +1)。PTQ1_0 格式将 128 个权重打包进 28 字节,并且在此基础上使用 Hadamard 矩阵变换,对激活值进行旋转。它将离群值分散到整个块中,因此量化据说损失会小得多11。在撰写本文时,原版 llama.cpp 无法运行这个模型,但 PrismML 的分支可以12。
由于我早期就在 1 位格式上进行了爬山优化,所以我抱有很高的期望。第一个可用的版本从一开始就领先,达到每秒 34 个 token,而该分支为 29 个。一个技巧是:旋转后的激活值可以计算一次,并由读取相同输入的每个投影共享。
PrismML 的最新构建(b10754)也做到了这一点,效果显而易见:它以每秒 48.5 个 token 解码,而 Phobos 为 45.2。Phobos 处理提示词的速度仍然快 1.24 倍。
先旋转,再舍入 · 一个 16 宽度的玩具示例
三值权重每个块共享一个缩放因子,因此单个离群值就可能毁掉它:最佳缩放因子会迁就离群值,而每个小权重都会舍入为零。Hadamard 旋转——先随机翻转符号,再进行多级加减——会将离群值分散到整个块中,因此舍入造成的损失会小得多。激活值在运行时也会进行同样的旋转,因此乘积不变,而且一次旋转就能服务于读取相同输入的每个投影。
然后还需要移除若干“人为错误”。每次内核启动都会读取一个环境变量。std::env::var 会在每次调用时,在全局锁下搜索整个环境,导致卡片在 token 之间空闲约 2ms。猜猜那段时间去哪了。接着,CUDA 图被修补的次数远超必要。缓冲区池以任意顺序分发缓冲区,因此图中大多数节点(>1000)每一步都被重新修补,而实际上只有 80 个节点需要新地址。现在缓冲区池按地址排序,因此每一步都能拿回相同的缓冲区,只有那 80 个节点需要修补。仅此一项就带来了 5% 的提升。
| Ternary-Bonsai-2-27B-PTQ1_0 | Phobos | llama.cpp(PrismML 分支) |
|---|---|---|
| 提示词,128 tokens | 584.0 | 469.8 |
| 解码,128 tokens | 45.2 | 48.5 |
Q4_K_M
在有了足够的理解、且早期的大部分问题都已解决之后,是时候看看性能究竟如何了。Q4_K_M 是 llama.cpp 表现最好的地方。这不是别人的分支。 这个格式才是大多数使用 llama.cpp 的人实际运行的。他们的内核受带宽限制,所以真的无处可藏。
在 Qwen3.5-4B 上以 llama.cpp 的速度,一个 token 需要 9.2ms。其中约 2ms 用于在任何一个权重字节移动之前启动内核。剩下约 7ms 用来读取 2.7 GB,这已经大约达到我显卡纯内存拷贝带宽的 90%。
因此要达到同等水平,内核需要比我之前拥有的任何东西都更快,并且启动次数不能超过 llama.cpp。
我写下了这些目标,然后开始了自动研究循环。这些是 Claude 必须优化的硬性事实。
到了某个时候,我不得不引入编译器缓存:编译成 PTX 的内核数量之多,使得冷启动大约需要 20 分钟。缓存以每个内核的 Phobos 源码和编译器(及其依赖项)的哈希为键。内层循环用 CPU 预言机检查内核,并使用小规模运行,以全模型检查作为门禁,把完整的基准测试套件(又需要一小时)留到最后。这得到了回报:第一次运行完整套件时,解码速度就已经达到 llama.cpp 的 85%。
将整个多层感知机(MLP)融合为一个持久内核带来了 6% 的提升。一些遗留问题也拖慢了速度。有一个快速归一化内核,但只适用于模型宽度为 1024 的倍数的情况,而这个模型的宽度是 2560。将其泛化又带来了 4.5% 的提升,在已经融合的内核中使用它又带来了 4.2%。
| Qwen3.5-4B-Q4_K_M | Phobos | llama.cpp |
|---|---|---|
| 提示词,128 tokens | 2305 | 2296 |
| 提示词,512 tokens | 2372 | 2956 |
| 解码,128 tokens | 111.8 | 106.5 |
现在在 llama.cpp 的最佳格式上,解码已达到同等水平。更长的提示词仍然落后。
图 IR
我一直怀疑我的编译器生成的 MLIR 不够优化,进而导致 LLVM IR 不够优化,再进而导致 PTX 不够优化。我认为主要问题在于我的代码生成只是一个简单的 AST 遍历,在向下遍历树时生成 MLIR。没有活跃性信息,没有支配边界。这意味着,例如,内存屏障比必要的更多。
所以合乎逻辑的做法是先把 AST 降为 SSA 图 IR,在它上面运行若干遍,然后再生成 MLIR。我通过 Rust melior crate 使用 MLIR 越多,就越不想构建自己的方言。对于少数几遍处理来说,一个普通的图 IR 就足够了,方言会显得过度设计。现在,一遍处理通过活跃性分析来放置共享内存。另一遍处理可以在访问实际冲突的地方插入屏障。Triton 也做了类似的事情13。
在所有 724 个内核中,内存屏障的数量从 1092 个减少到 888 个,现在有 84 个内核需要的共享内存更少。不过它并没有改变基准测试结果,这让我很惊讶。但它消除了许多特殊情况以及非常丑陋的机制(let 绑定的 tile 在 AST 代码生成中从不释放内存),并且它是更多编译器工作的基础。话虽如此,我更愿意先弄清楚冷编译的 20 分钟到底花在哪里,然后再让它变得更慢 :)
最慢的内核在 LLVM 的 NVPTX 后端中花费了 5 分钟。我还得看看如何加快这个速度。我也想尝试一下
libNVVM,尽管对于sm_75(我的显卡)来说,它只接受旧版 LLVM 7 方言的 NVVM IR;现代版本仅支持 Blackwell。理论上libNVVM应该能生成更好的 PTX,如果我能免费获得另一次性能提升,我会接受的。
专家混合
到目前为止,所有模型都(勉强)能装进我的显卡。Qwen3.6-35B-A3B 不行,但它是一个专家混合模型。我知道所有那些很酷的“流式 MoE”帖子14,所以我想看看有什么可能。
Qwen3.6-35B-A3B 的 40 层中每一层都有 256 个小型前馈网络,即专家,而路由器会为每个 token 选择其中八个。这些专家占 19.5 GB。如果只有 8 GB(理论上),我若想运行这个模型,就必须将它们流式传输。模型的另外 2 GB 必须常驻在显卡上。那就是所有非路由专家的部分:注意力层和 DeltaNet 层、路由器、共享专家和输出头。每个 token 都需要全部这些,所以没有命中率可玩,而流式传输它会在每个 token 上通过我的 PCIe 总线推送 2 GB,该总线传输速度约为 6.4 GB/s。在任何数学运算发生之前,每个 token 大约需要 0.3 秒。所以 Phobos 和 llama.cpp 都把它留在 GPU 上。但对于专家,两者的决定截然不同。
对于 llama.cpp,你在加载时通过 -ncmoe N 决定有多少层将它们的专家保留在 CPU 上。找到 N 是你自己的问题(或者通过 --fit 完成,这是默认值)。有时网上的人会分享他们为获得最大性能而使用的 llama.cpp 调用方式。如果你要照搬,请确保你拥有完全相同的硬件。所以我写了一个脚本来寻找参数的最佳组合,它输出了 -ncmoe 31 -t 8。只有 29 层的专家在 CPU 上时,GPU 就开始分页,我们已经知道那有多糟糕。
我不喜欢这样。我希望我的软件为我完成工作。我知道有些人喜欢显式开关。你寻找一个配置,并认为你有可预测的性能,但只有当你的环境完全可预测时,这才是真的。一台有时占用 900 MiB、然后 1.5 GiB 的台式机对我来说并不是真正可预测的。这就是 Phobos 使用不同设计的原因。
我在 GPU 上保留一个专家缓存。因为专家选择在任务中会大量重复,大约 80% 的专家会命中缓存。但未命中时会发生什么?嗯,专家要么通过 PCIe 复制到显卡(除非有空间,否则会驱逐另一个),要么在 CPU 上计算。由于我的显卡位于 PCIe 3.0 x8 总线上,每次复制都非常痛苦。
Qwen3.6-35B-A3B · 一层
Qwen3.6-35B-A3B 的一层:256 个专家,每个 token 八个,而显卡上只能容纳它们的缓存。大多数选择已经在缓存中;其余的要么穿过 PCIe 总线,要么由 CPU 直接从系统 RAM 计算。路由是模拟的,并针对真实模型大约 80% 的命中率进行了调整。
这也是我最初的想法没有成功的原因。前瞻预取。思路是提前运行下一层的路由器,然后猜测它的专家,并在当前层仍在计算时把它们复制过来。猜测的准确率也大约有 80%,缓存命中率也提高了。但解码速度从每秒 32 个 token 降到了 25 个。在这么慢的总线上,猜错的代价实在太高了。即使后来由 CPU 接管了未命中(详见下文),它仍然会输:每秒 35 个而不是 57 个 token。我还是想在更宽的总线上对此进行基准测试。但如果没有新的 GPU 和主板,我无法验证我的假设是否成立。
下一个显而易见的想法起初看起来也是错的。我用 Claude 编写了 SIMD 内核,以便在 CPU 上进行计算是可行的。思路是让未命中在 CPU 上运行,而缓存命中在 GPU 上运行。结果这也是一种损失:每秒 16 个 token,而仅仅将专家复制到 GPU 就能达到 32 个。起初我以为 CPU 内核太慢了。但我错了。nsys 显示了一次 8 KiB 的回读,即 CPU 完成工作所需的激活值,每次都要等待整整一毫秒。因此,当 CPU 的输入卡在专家复制后面的队列中时,CPU 只能空转。
这是我不知道的:在这块卡上,在 Windows 下,一个复制操作会等待所有已经在途的其他复制操作。无论方向,无论哪个流。我的 8 KiB 激活值排在了数兆字节的专家重新填充后面。这块卡报告有两个复制引擎,所以我最好的猜测是 Windows 对工作进行了批处理,而不是硬件无法重叠它们。但无论如何这对我都没帮助。
所以复制引擎必须离开关键路径。那 8 KiB 仍然需要穿过总线,只是不再作为复制操作。现在计算该行的内核用普通的存储指令直接将其写入主机内存。这些数据作为普通的内存流量通过 PCIe 传输,永远不会进入复制引擎的队列。双方需要达成一致的其他所有内容(哪些专家、它们的权重、哪个缓存槽存放什么、CPU 的结果)也都移到了固定主机内存中,GPU 内核可以直接读写。
而且没有人再礼貌地等待了。CPU 线程忙等而不是让出,在 GPU 上,一个小内核在主机内存中的标志上自旋,直到 CPU 的结果到达。烧掉一个核心来节省一毫秒。值得。
解码速度从每秒 16 个 token 提升到了 54 个,是仅靠复制所能达到的 1.7 倍。这是内存和调度的问题,不是数学问题。CPU 现在计算当前 token 的每一次未命中,耗时大约是一次复制所需时间的四分之一。除此之外,每一层都会将其权重最高的未命中复制到卡上,这样下一个 token 就能命中。
解码步骤的一层 · 示意图
解码步骤的一层,未按比例绘制。CPU 在获得 8 KiB 的激活值行之前无法开始处理它的专家,而那个微小的回读过去与专家重新填充位于同一个复制引擎队列中。现在 GPU 将该行直接写入固定主机内存,一个小内核在标志上自旋,直到 CPU 的答案返回。
| Qwen3.6-35B-A3B-UD-Q4_K_M | Phobos | llama.cpp -ncmoe 31 -t 8 |
|---|---|---|
| 提示词,128 个 token | 311.5 | 76.3 |
| 提示词,512 个 token | 577.9 | 257.6 |
| 解码,128 个 token | 54.3 | 29.9 |
我真正喜欢这一点:无需任何配置。Phobos 会根据显卡上的空闲显存来设定专家缓存的大小,并且每 16 个 token 重新检查一次。当剩余不足 512 MiB 时——比如你打开了一个 Electron 应用,或者上下文变长了——它就会逐出专家,直到再次释放出 1 GiB 空闲空间。当内存恢复后,缓存又会重新增长。为了公平起见,基准测试当然是在无争用的情况下运行的。有争用时会发生什么,后面再说。
Je déteste les benchmarks
骂人的话用法语说总是更好听。我在 25 年多的软件开发中学到的是,你绝对不应该相信基准测试。在基准测试上爬山并不意味着你的代码在生产环境中真的更快。Phobos 也是如此。
在完成所有这些优化之后,我把 pi 编程智能体指向 Phobos,感觉它比应有的速度要慢。于是我给 Phobos 加了一个仪表盘,用来显示实际的预填充和解码速度。我是对的。Phobos 慢得让人难受。为什么?嗯。Phobos 累积了 15 GiB 的 GPU 内存,而众所周知,这会导致分页,而分页 == 慢。
不过原因相当愚蠢。内存池只会为大小完全相同的请求复用缓冲区。对于基准测试来说,提示词大小总是完全相同,你不会注意到这一点。但当真正的编程智能体带着真正的提示词,让引擎请求不同大小的缓冲区,而你当前的池无法满足时,你基本上就在泄漏内存。假设池中有一个 87 MiB 的缓冲区,但智能体这一轮需要 84 MiB。Phobos 会愉快地再分配一个 84 MiB,并把那个 87 MiB 留着,等有人请求完全相同的大小(永远不会)。几次请求下来,这就累积到了好几个 GB。修复方法很无聊:当一次提示词处理的行数与上一次不同时,Phobos 会把池中多余的缓冲区交还给驱动。长度相同的处理,比如基准测试或长提示词的完整批次,则保留它们的缓冲区,因为那正是下一次处理所需要的。
缓冲区池 · 按精确大小归档
池只会为大小完全相同的请求交还缓冲区。基准测试总是请求相同的大小,智能体则从不如此,所以每次提示词都会留下一整轮处理所需的缓冲区,直到显卡溢出到系统内存。大小仅为示意。
基于实际使用的基准测试揭示了更多问题。采样器过去会为每个 token 对词表进行排序,而贪婪解码基准测试从不这样做。智能体还会在每一轮重新发送整个对话记录,而理想情况下你只应处理新增部分(前缀缓存)。对于 Qwen 的 DeltaNet 块来说,这要难一些。
最终,我创建了一个基准测试套件(哦,真是讽刺!),它通过代理运行 pi,在完成一组定义好的问题(比如修复某段代码中的 bug)时记录所有交互。然后向每个引擎重放这些记录,并将每个回答限制在记录的长度内。这意味着我们拥有相同顺序的相同提示词。两个引擎在请求之间都保留各自的会话。目前有三个任务,每个测试不同的方面。不启用思考,各跑三轮:
| 重放 pi 会话,Qwen3.6-35B-A3B | 引擎 | 墙钟时间 | 提示词 | 解码 |
|---|---|---|---|---|
fib,6 次请求 | llama.cpp -ncmoe 31 -t 8 | 53.2 s | 105 t/s | 30.7 t/s |
| Phobos | 26.9 s | 254 t/s | 42.3 t/s | |
law,2 次请求 | llama.cpp -ncmoe 31 -t 8 | 66.6 s | 148 t/s | 30.0 t/s |
| Phobos | 47.2 s | 246 t/s | 42.5 t/s | |
pelican,2 次请求 | llama.cpp -ncmoe 31 -t 8 | 132.8 s | 149 t/s | 29.3 t/s |
| Phobos | 81.2 s | 347 t/s | 47.4 t/s |
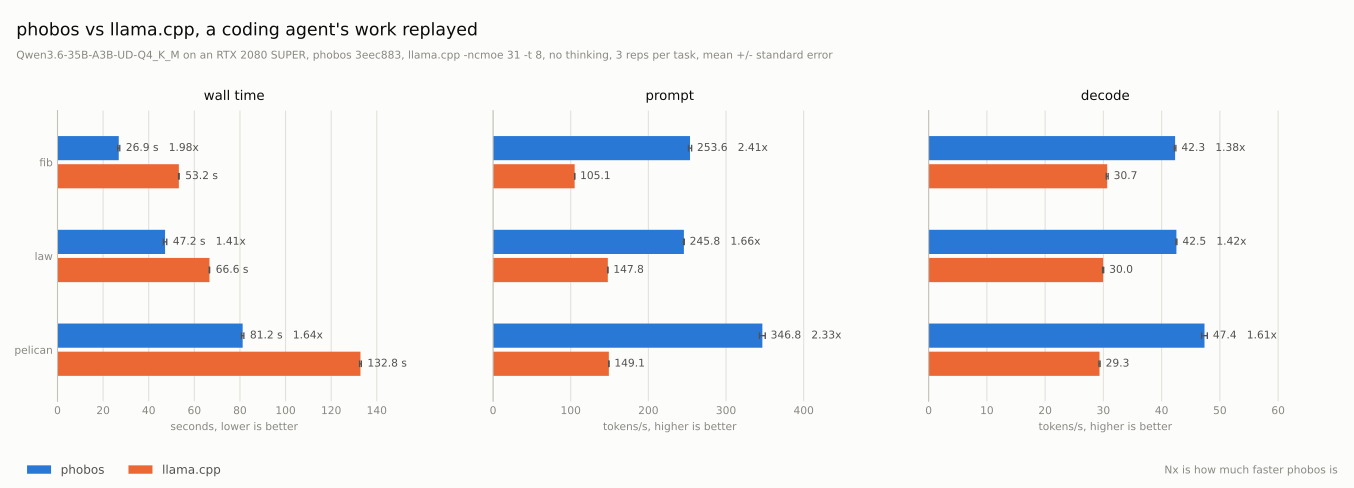
每个重放任务进行三轮,取均值和标准误。蓝色为 Phobos,橙色为 llama.cpp 在这张卡上的最佳设置,-ncmoe 31 -t 8。每个 Phobos 柱旁的比例表示 Phobos 快多少。
Phobos 在每项任务的每项指标上都胜出。它完成速度快 1.4 到 2 倍,三项任务每轮 155 秒,而对手为 253 秒。各引擎的速率在轮次间波动保持在 2% 以内。关于 fib 有一点需要注意:Phobos 提前一个答案结束,每轮写入约 640 个 token,而 llama.cpp 为 733 个,因此其墙钟时间覆盖的工作量略少。速率是按 token 计算的,可直接比较。
还记得那台一天用 900 MiB、第二天用 1.5 GiB 的桌面吗?我又重放了那段 8 请求的 fib 录制,没多想,这次另一个进程从第四个请求起占用了卡上 2 GiB 内存,每 250 ms 重写一次,让驱动无法将其换出。这是我的合成内存压力测试。各进行三轮:
| 重放一个 pi 会话,从第 4 个请求起占用 2 GiB | 墙钟时间 | 解码前 | 解码后 | 提示前 | 提示后 |
|---|---|---|---|---|---|
llama.cpp -ncmoe 31 -t 8 | 170 s | 32.3 t/s | 9.2 t/s | 126 t/s | 29 t/s |
llama.cpp -ncmoe 36 -t 8 | 78 s | 27.7 t/s | 28.2 t/s | 116 t/s | 107 t/s |
| Phobos | 55 s | 44.8 t/s | 33.3 t/s | 289 t/s | 120 t/s |
llama.cpp 保留了约 30% 的解码速度,因为原本为闲置显卡划分的分片现在要通过 PCIe 分页。Phobos 保留了约四分之三:它察觉到空闲内存已耗尽,将专家缓存从每层 38 个缩减到 14 个,CPU 承担了额外的未命中。在第二次运行中,另一个进程在第六个请求后释放内存,Phobos 将缓存从每层 14 个恢复到 39 个,速度又回到每秒 45 个 token。整个会话完成速度快了三倍。为公平对待 llama.cpp,-ncmoe 31 是它在闲置显卡上的最快设置。再多五层放到 CPU 上(-ncmoe 36)就留出了足够的余量,然后 llama.cpp 甚至察觉不到。但它一直为这份保险付出代价,速度为 28 而非 32 token 每秒,而 Phobos 仍以 1.4 倍的速度完成会话。
写这类文章的美妙之处:v0.1.0 本不会通过这项测试。它向驱动询问有多少空闲内存,而在 Windows 下该答案只统计你自己的进程,因此 Phobos 从未察觉桌面进程的侵入。 它现在改为询问 NVML,后者能看到整张卡,与
nvidia-smi的方式相同。该修复已在 v0.1.1 中发布。
发布!
9 月 25 日我打了 v0.1.0 标签,这是首个版本,v0.1.1 紧随其后于 10 月 6 日发布15。phobos-cli(推理引擎和服务器)、phobos-bench、phobos-compile 和 phobos-cache 的 Windows 和 Linux 构建版。唯一的依赖是足够新、支持 CUDA 13.0 的 NVIDIA 驱动(R580 或更新)。
Phobos 捆绑了针对六个芯片目标的预热内核缓存,从 Turing(sm_75)到消费级 Blackwell(sm_120)。我已用 2080 测试过 Phobos,还有人好心确认它也能在 3090(sm_86)上运行。
我们达到 llama.cpp 了吗?
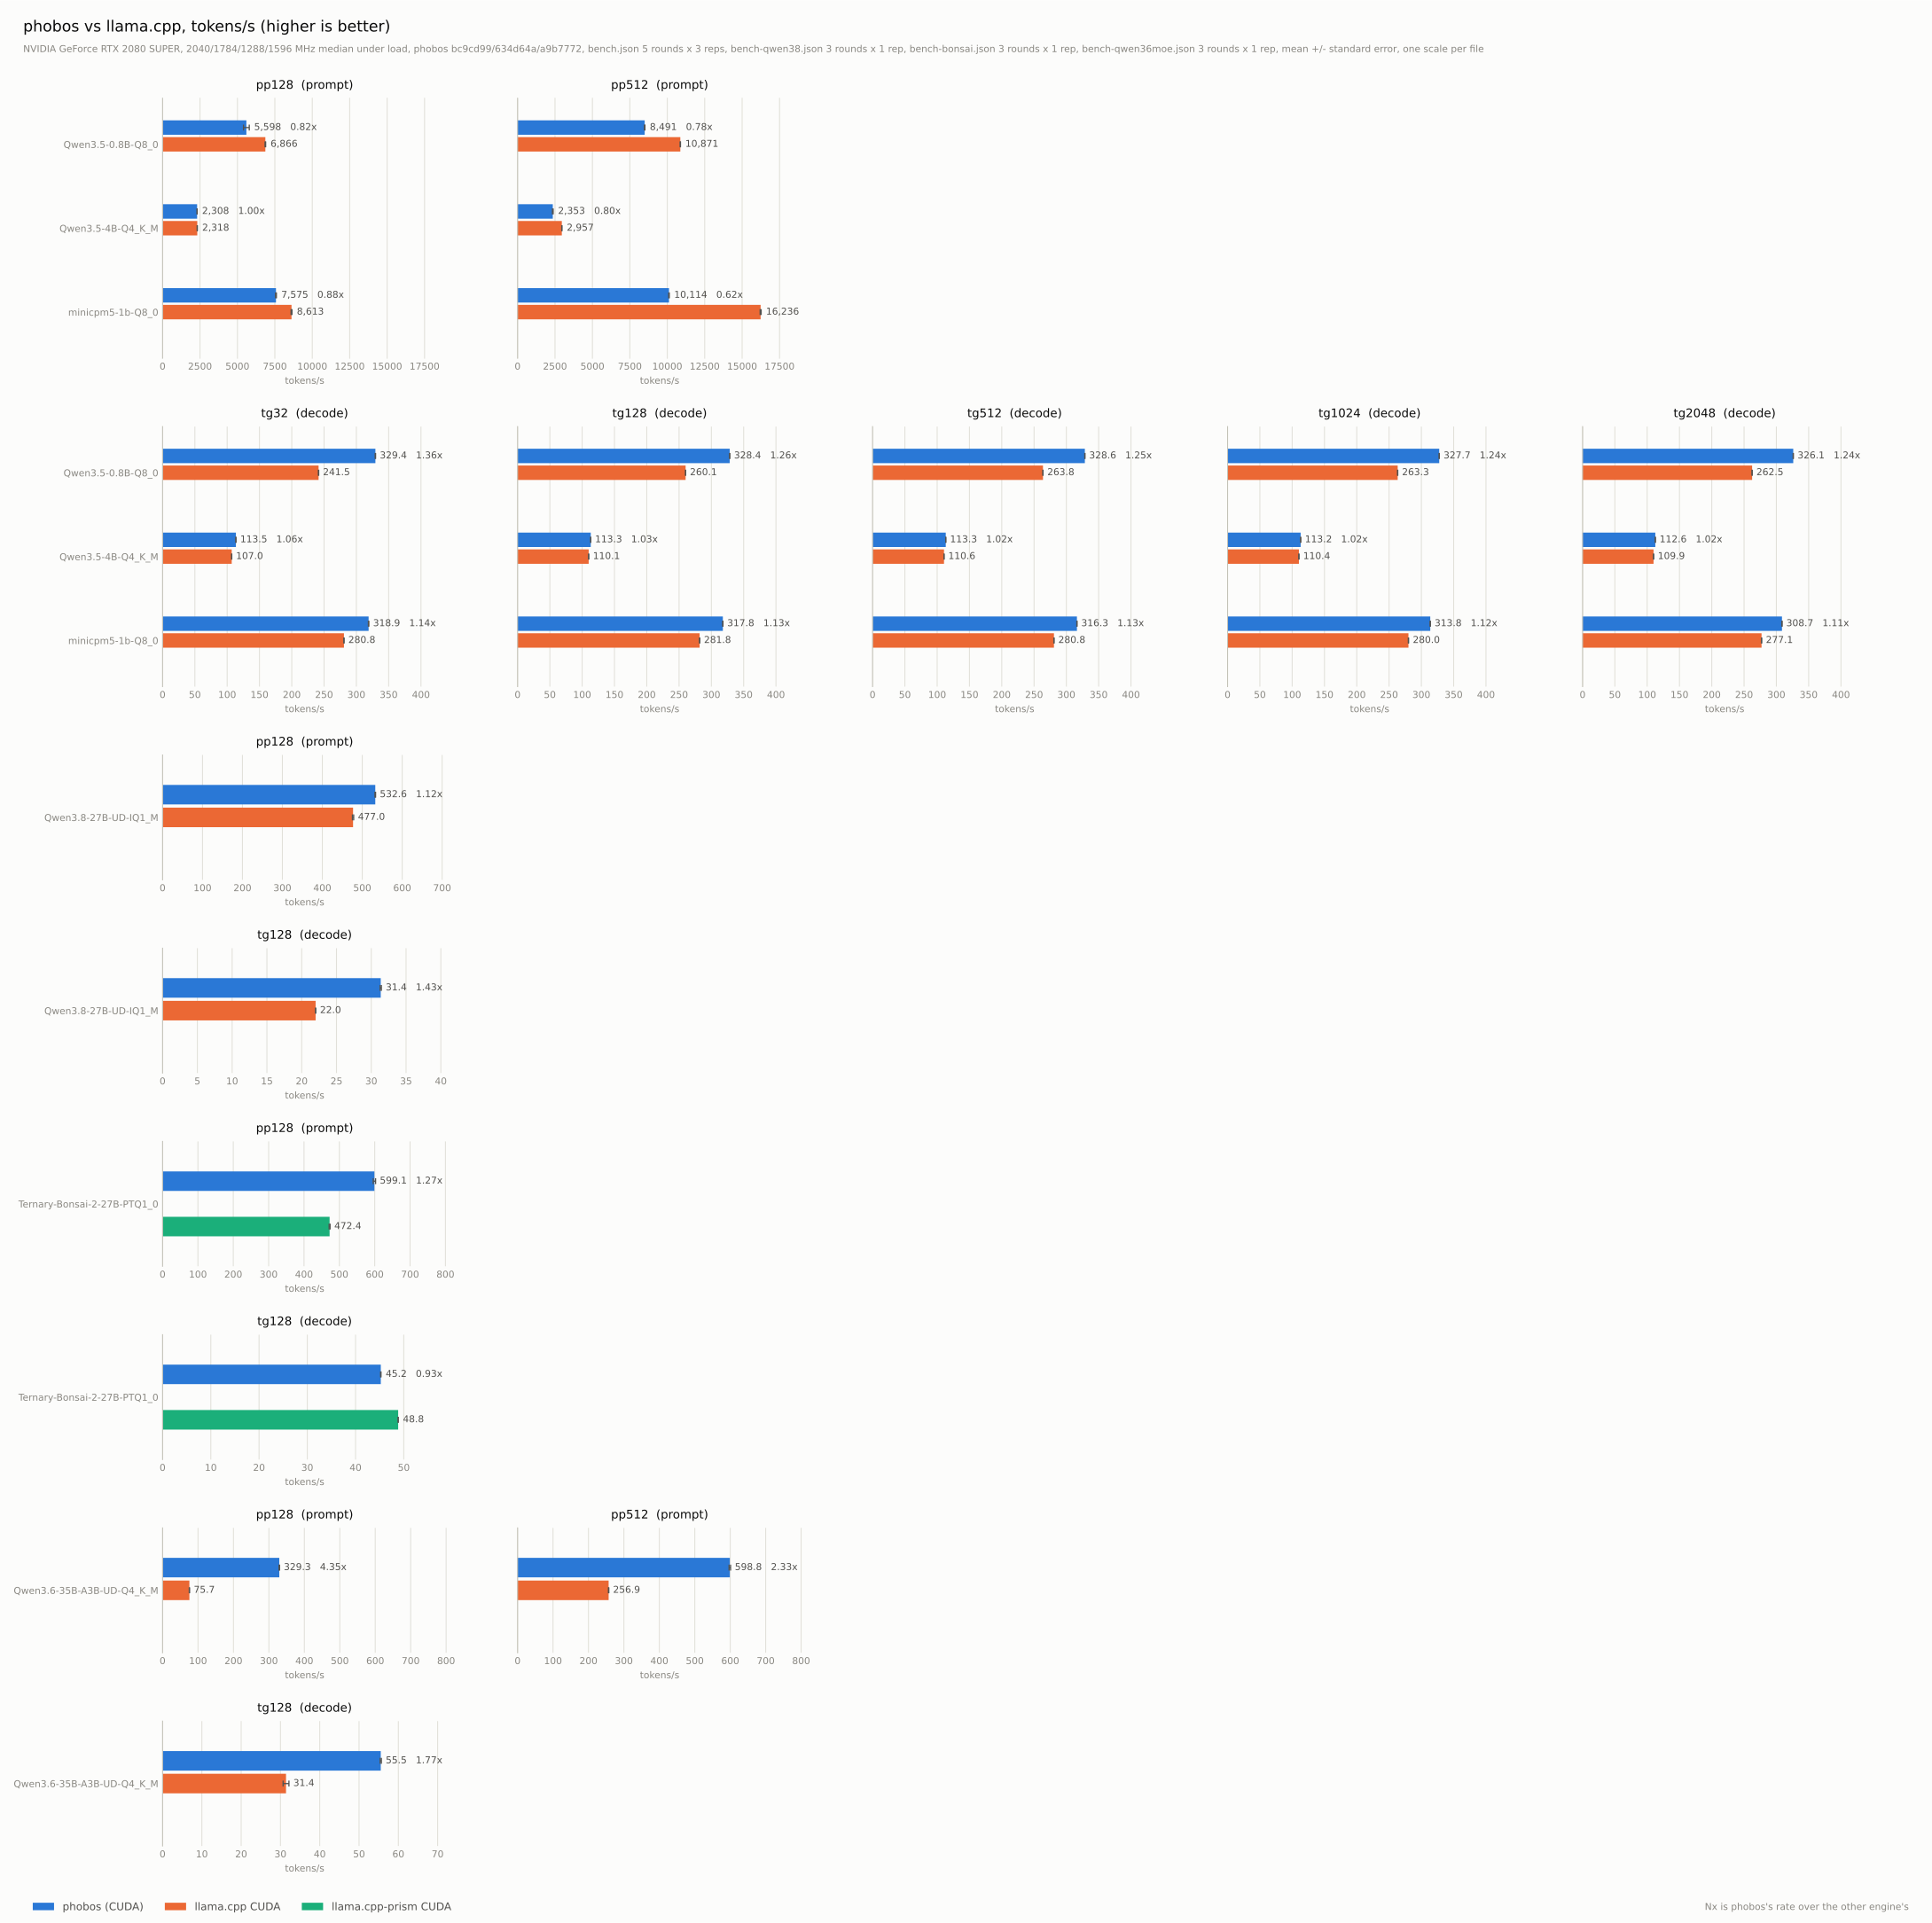
各引擎在 RTX 2080 SUPER、驱动 617.1416 上交错运行。蓝色为 Phobos,橙色为 llama.cpp 的 CUDA 后端,绿色为 PrismML 的 llama.cpp 分支,后者最初引入了三值格式。每个 Phobos 柱旁的比例是其速率与另一引擎速率之比,因此高于 1.0x 表示 Phobos 更快。35B 模型对比 llama.cpp 在这张卡上的最佳设置,-ncmoe 31 -t 8。
Phobos 相对 llama.cpp 的速率:
| 模型 | 解码 | 提示 |
|---|---|---|
| Qwen3.5-0.8B-Q8_0 | 1.31x | 0.81x |
| MiniCPM5-1B-Q8_0 | 1.16x | 0.62x |
| Qwen3.5-4B-Q4_K_M | 1.05x | 0.80x |
| GLM-4.6V-Flash-Q4_K_M,仅文本 | 0.94x | 0.59x |
| Qwen3.8-27B-UD-IQ1_M | 1.43x | 1.14x |
| Ternary-Bonsai-2-27B-PTQ1_0(对比 PrismML 的 fork) | 0.93x | 1.24x |
Qwen3.6-35B-A3B-UD-Q4_K_M(对比 -ncmoe 31 -t 8) | 1.82x | 2.24x |
所有地方的解码都是 128 个 token。提示词是 512 个 token,除了两个 27B 模型,那里我只能塞下 128 个。
这些数字别太当真。在 35B 上,llama.cpp 根本没有专家缓存,所以那个数字比较的是两种设计,而不是两组 kernel。对于受带宽限制的 Q4_K_M,这几乎是个平局:Phobos 在 Qwen3.5-4B 上领先 5%,在 GLM-4.6V-Flash 上落后 6%。小模型上的提示词处理仍然落后。提示词越长,差距越大。我还没真正开始搞那个。
我引以为豪的是,大部分收益都不是针对特定模型的。我的通用引擎为带 DeltaNet 的 Qwen3.5 生成了一个融合 kernel。这个融合过程并不知道自己在看什么,也没有专门化。它只知道,一个从不离开 block 的值可以留在共享内存里,而当另一个 block 读取它时就需要一个 barrier。同一个引擎无需改动就能用于 llama。
Q4_K_M 开箱即用,而且收益通常适用于所有模型。从某种意义上说,整个练习很傻:如果你只想要最高性能,你可以让 Claude 吐出 CUDA 代码。但这是我的小实验,目标从来不是打败什么。而是去学习、去理解,看看什么是可能的。
结论
你实际上可以把一个真正的编码 agent 指向 Phobos。一个装不进七年前消费级显卡的 35B 混合专家模型,会以约 40 tokens 每秒的速度修复你的 JavaScript 代码,同时一个花哨的 TUI 会让你玩得开心,并显示内存都去了哪里。
phobos-cli --listen 127.0.0.1:8080 --gguf Qwen3.6-35B-A3B-UD-Q4_K_M.gguf

推理背后的每个 kernel 都是在运行时编译的,用的是一种我为了搞懂 kernel 到底是什么而写的语言。没有 cuBLAS,没有 CUTLASS,没有 CUDA toolkit。
我在这篇文章里多次提到 llama.cpp,因为我把我的引擎和它做了比较。我认为它比 llama.cpp 更好吗?当然不。 llama.cpp 到处都能跑,支持多得多的格式。而我针对的是一张几乎没人在乎的显卡。 不过,对于那张卡,我可以确切地告诉你时间花在了哪里。几个月前,在进入这个兔子洞之前,我甚至不知道 prefill 和提示词处理之间的区别(剧透:没有区别)。
源码和发布版可在 github.com/joa/phobos-lang 获取。
AI 免责声明:本博文中展示的图表、其说明文字和动画均由 AI 创建。你可以在 GitHub 仓库 中找到所有提示词。文章由人类撰写。AI 用于事实核查等。你可以在此找到完整提示词。
FlashAttention-2 支持 Ampere 及更新架构,把 Turing 留给了一个单独的仓库,而 vLLM 的 FlashAttention 后端 需要 sm_80,所以 Turing 回退到 Triton attention。 ↩︎
delta 规则的分块并行形式是 Parallelizing Linear Transformers with the Delta Rule over Sequence Length — Yang et al., 2024;Qwen3.5 使用的门控变体是 Gated Delta Networks — Yang et al., 2024。Kimi Delta Attention 来自 Kimi Linear — Kimi Team, 2025,它在 Gated DeltaNet 的基础上扩展了更细粒度的门控。 ↩︎ ↩︎
Look Ma, No Bubbles! — Hazy Research, 2025 和 Mirage Persistent Kernel — Cheng et al., 2025。两者都发现 CUDA graphs 仍有很大优化空间。 ↩︎
每种格式的块布局都在
ggml-quants.c中,这是此处每个解码器编写和校验时所依据的参考,并用quant_check进行了检查。 ↩︎NVIDIA 称之为 sysmem fallback。自驱动程序 536.40 起,Windows 上 VRAM 耗尽的 CUDA 分配会回退到系统内存,而不是失败;自 546.01 起,你可以按程序关闭该功能(NVIDIA 控制面板,CUDA - Sysmem Fallback Policy)。参见 NVIDIA 的支持文章。 ↩︎
量化前使用随机 Hadamard 变换进行旋转来自 QuIP# — Tseng et al., 2024;QuaRot — Ashkboos et al., 2024 也在运行时旋转激活值。SpinQuant — Liu et al., 2024 表明某些随机旋转比其他旋转好得多。 ↩︎
PrismML 的 llama.cpp 分支添加了 PTQ1_0 和 Hadamard 旋转。 ↩︎
Triton 的
Allocation.cpp放置共享内存,Membar.cpp插入其所需的屏障。 ↩︎专家 LRU 缓存加上来自下一层路由器的前瞻猜测来自 Eliseev & Mazur, 2023。在 CPU 上计算未命中而不是复制它们来自 Fiddler — Kamahori et al., 2024 和 KTransformers — Chen et al., SOSP 2025。MoE-Infinity 和 ProMoE 都报告了错误的预取挤占了按需复制。 ↩︎
撰写这篇文章揭示了一些不足。v0.1.1 使专家缓存具有弹性:它能看到整张卡的内存,当其他程序进入时收缩,离开时恢复。它还添加了 squeeze 基准测试。 ↩︎
使用
scripts/bench.py测量,它交错运行两个引擎并首先检查显卡是否存在争用。llama.cpp 是构建 4d19b2876 (10636),PrismML 的分支是构建 b10754,均在驱动程序 617.14 上测量。每个表格、确切的命令和代理重放都在仓库的 BENCHMARKS.md 中。 ↩︎
来源:Hacker News · joa-ebert.com