Cornerstone OnDemand 如何用 Amazon Bedrock 将数据库诊断时间缩短 78%
How Cornerstone OnDemand cut database diagnosis by 78% with Amazon Bedrock
Cornerstone OnDemand 基于 Amazon Bedrock 和 Strands Agents 构建多智能体系统 Orion AI,将数据库诊断时间从 45 分钟降至 10 分钟,缩短 78%。该系统还把手动生命周期步骤从 10 步以上减至 1 次交互,冗余告警中位数减少 65%,SRE 与数据团队间的 15 分钟报告延迟降为实时。三人团队用六个月完成交付。
Cornerstone OnDemand, Inc.(Cornerstone)是劳动力就绪解决方案领域的全球领导者,为 186 个国家的 1.4 亿用户提供服务。该公司构建了一个多智能体 AI 系统,将数据库运维从被动救火转变为主动的、自我编排的工作流。该系统名为 Orion AI,使用 Amazon Bedrock 和 Strands Agents(AWS 的开源智能体编排框架)来协调专用智能体。
在 Orion AI 之前,Cornerstone 的企业 DataOps 团队每次数据库事件最多要花 45 分钟手动查询系统视图并交叉比对日志,然后才能跨团队交接。借助 Orion AI,数据库诊断时间从 45 分钟降至 10 分钟,减少了 78%。一个三人团队在六个月内交付了该系统。
在本文中,我们将介绍 Cornerstone 面临的运维问题、他们如何设计 Orion AI、他们衡量的成果,以及其他团队可以复用的设计决策。
运维挑战
在 Orion AI 之前,Cornerstone 的企业 DataOps 团队以被动方式运作,存在四个反复出现的痛点:
- 每次数据库性能调查大约需要 45 分钟,涉及多个工具和系统视图。
- 数据库生命周期工作流需要 10 个或更多手动步骤,从建立连接到沟通状态更新。
- 站点可靠性工程(SRE)团队与数据团队之间的报告存在 15 分钟的延迟。
- 冗余和重叠的告警制造了噪音,淹没了真正重要的信号。
综合来看,这意味着工程师把时间花在了手动协调上,而不是解决问题上。
解决方案:Orion AI
Orion AI 是一个多智能体系统,其中协调智能体(元编排器)将工作委派给按中心辐射式拓扑排列的专用子智能体。工程师通过 Web 应用程序与之交互,在他们已经用于协调运维工作的地方提问并批准操作。这些智能体涵盖基础设施监控、数据库诊断、数据库生命周期操作、客户分析和知识驱动的支持。
构建过程遵循两条原则:在责任共担模型下使用 AWS 控制措施保障数据隐私,以及与现有运维工具深度集成。Amazon Bedrock 提供对基础模型的托管访问,Strands Agents 提供编排层。
成果
Orion AI 在诊断速度和准确性方面都带来了可衡量的改进,并将团队从手动协调中解放出来。通过自动化手动瓶颈并简化跨团队工作流,Cornerstone 取得了以下成果。
| 指标 | 之前 | 之后 | 改进 |
| 数据库诊断时间 | 45 分钟 | 10 分钟 | 快 78% |
| 手动生命周期步骤 | 10+ 步 | 1 次交互 | 减少 70% |
SRE-to-data-team 报告延迟 |
15 分钟 | 即时 | 实时 |
| 冗余告警 | 基线量大 | 已过滤 | 减少 65%(中位数) |
更快的性能故障排查
缩短数据库诊断时间是 Orion AI 迄今为止最大的单项效率提升。此前,工程师需要手动连接到受影响的 SQL Server 实例,查询系统视图以查找阻塞链和等待类型,交叉比对日志以隔离长时间运行的查询,并关联证据以形成根因假设。这平均每次事件大约需要 45 分钟。
借助 Orion AI,三个专用智能体分担调查工作,各自负责一个不同的阶段。除诊断之外,Orion AI 还会将问题推进至修复:识别根本原因、推荐修复方案,并创建一张已填充内容的 Jira 工单,指派给合适的值班工程师。原本需要四步的人工交接,被压缩为一次交互。
自动化数据库生命周期管理
过去需要 10 多个手动步骤的任务——从建立数据库连接、运行跨系统查询到沟通状态更新——现在只需一次自然语言交互即可完成。Orion AI 会识别合适的工具和数据源,跨系统运行查询,验证结果,并返回统一的响应。从工程师的角度来看,工作简化为向 Orion AI 发出提示,并验证它反馈的发现。
实时监控与减少告警疲劳
Orion AI 消除了 15 分钟的 SRE-to-data-team 报告延迟,用持续的跨系统可见性取代了周期性的手动检查。
Orion AI 通过去重、阈值过滤和跨信号关联,将冗余告警的中位数减少了 65%。此前每产生 10 条告警,现在只有 3–4 条会到达工程师。告警直接路由到负责团队,无需中间告警层。
关键设计原则
有三项决策塑造了 Orion AI,你也可以将它们应用到自己的多智能体项目中:
- 按领域而非任务复杂度拆分智能体:每个智能体针对一个运营领域携带一小组工具集成。这能让模型的上下文保持聚焦,并提高工具选择的准确性,而不是让一个通用智能体包揽一切。
- 默认使用关键词路由,回退到语义搜索:可预测的请求通过关键词匹配以提升速度。模糊的请求回退到语义搜索以保证准确性。这样既能保持低延迟,又不会在较难的查询上牺牲正确性。
- 将会话记忆限定在会话范围内,并对实时指标绕过它:持久记忆支持多轮对话,但运营类问题始终读取当前系统状态。对实时指标绕过记忆,有助于防止陈旧数据污染实时诊断。
架构概览
Orion AI 以容器化服务的形式部署在 Amazon Elastic Container Service(Amazon ECS)上。用户通过一个 Web 应用程序进行交互,该应用将每个请求路由到合适的智能体,调用所需的工具,并组装响应。下图展示了这些组件在 AWS Cloud 中如何连接。
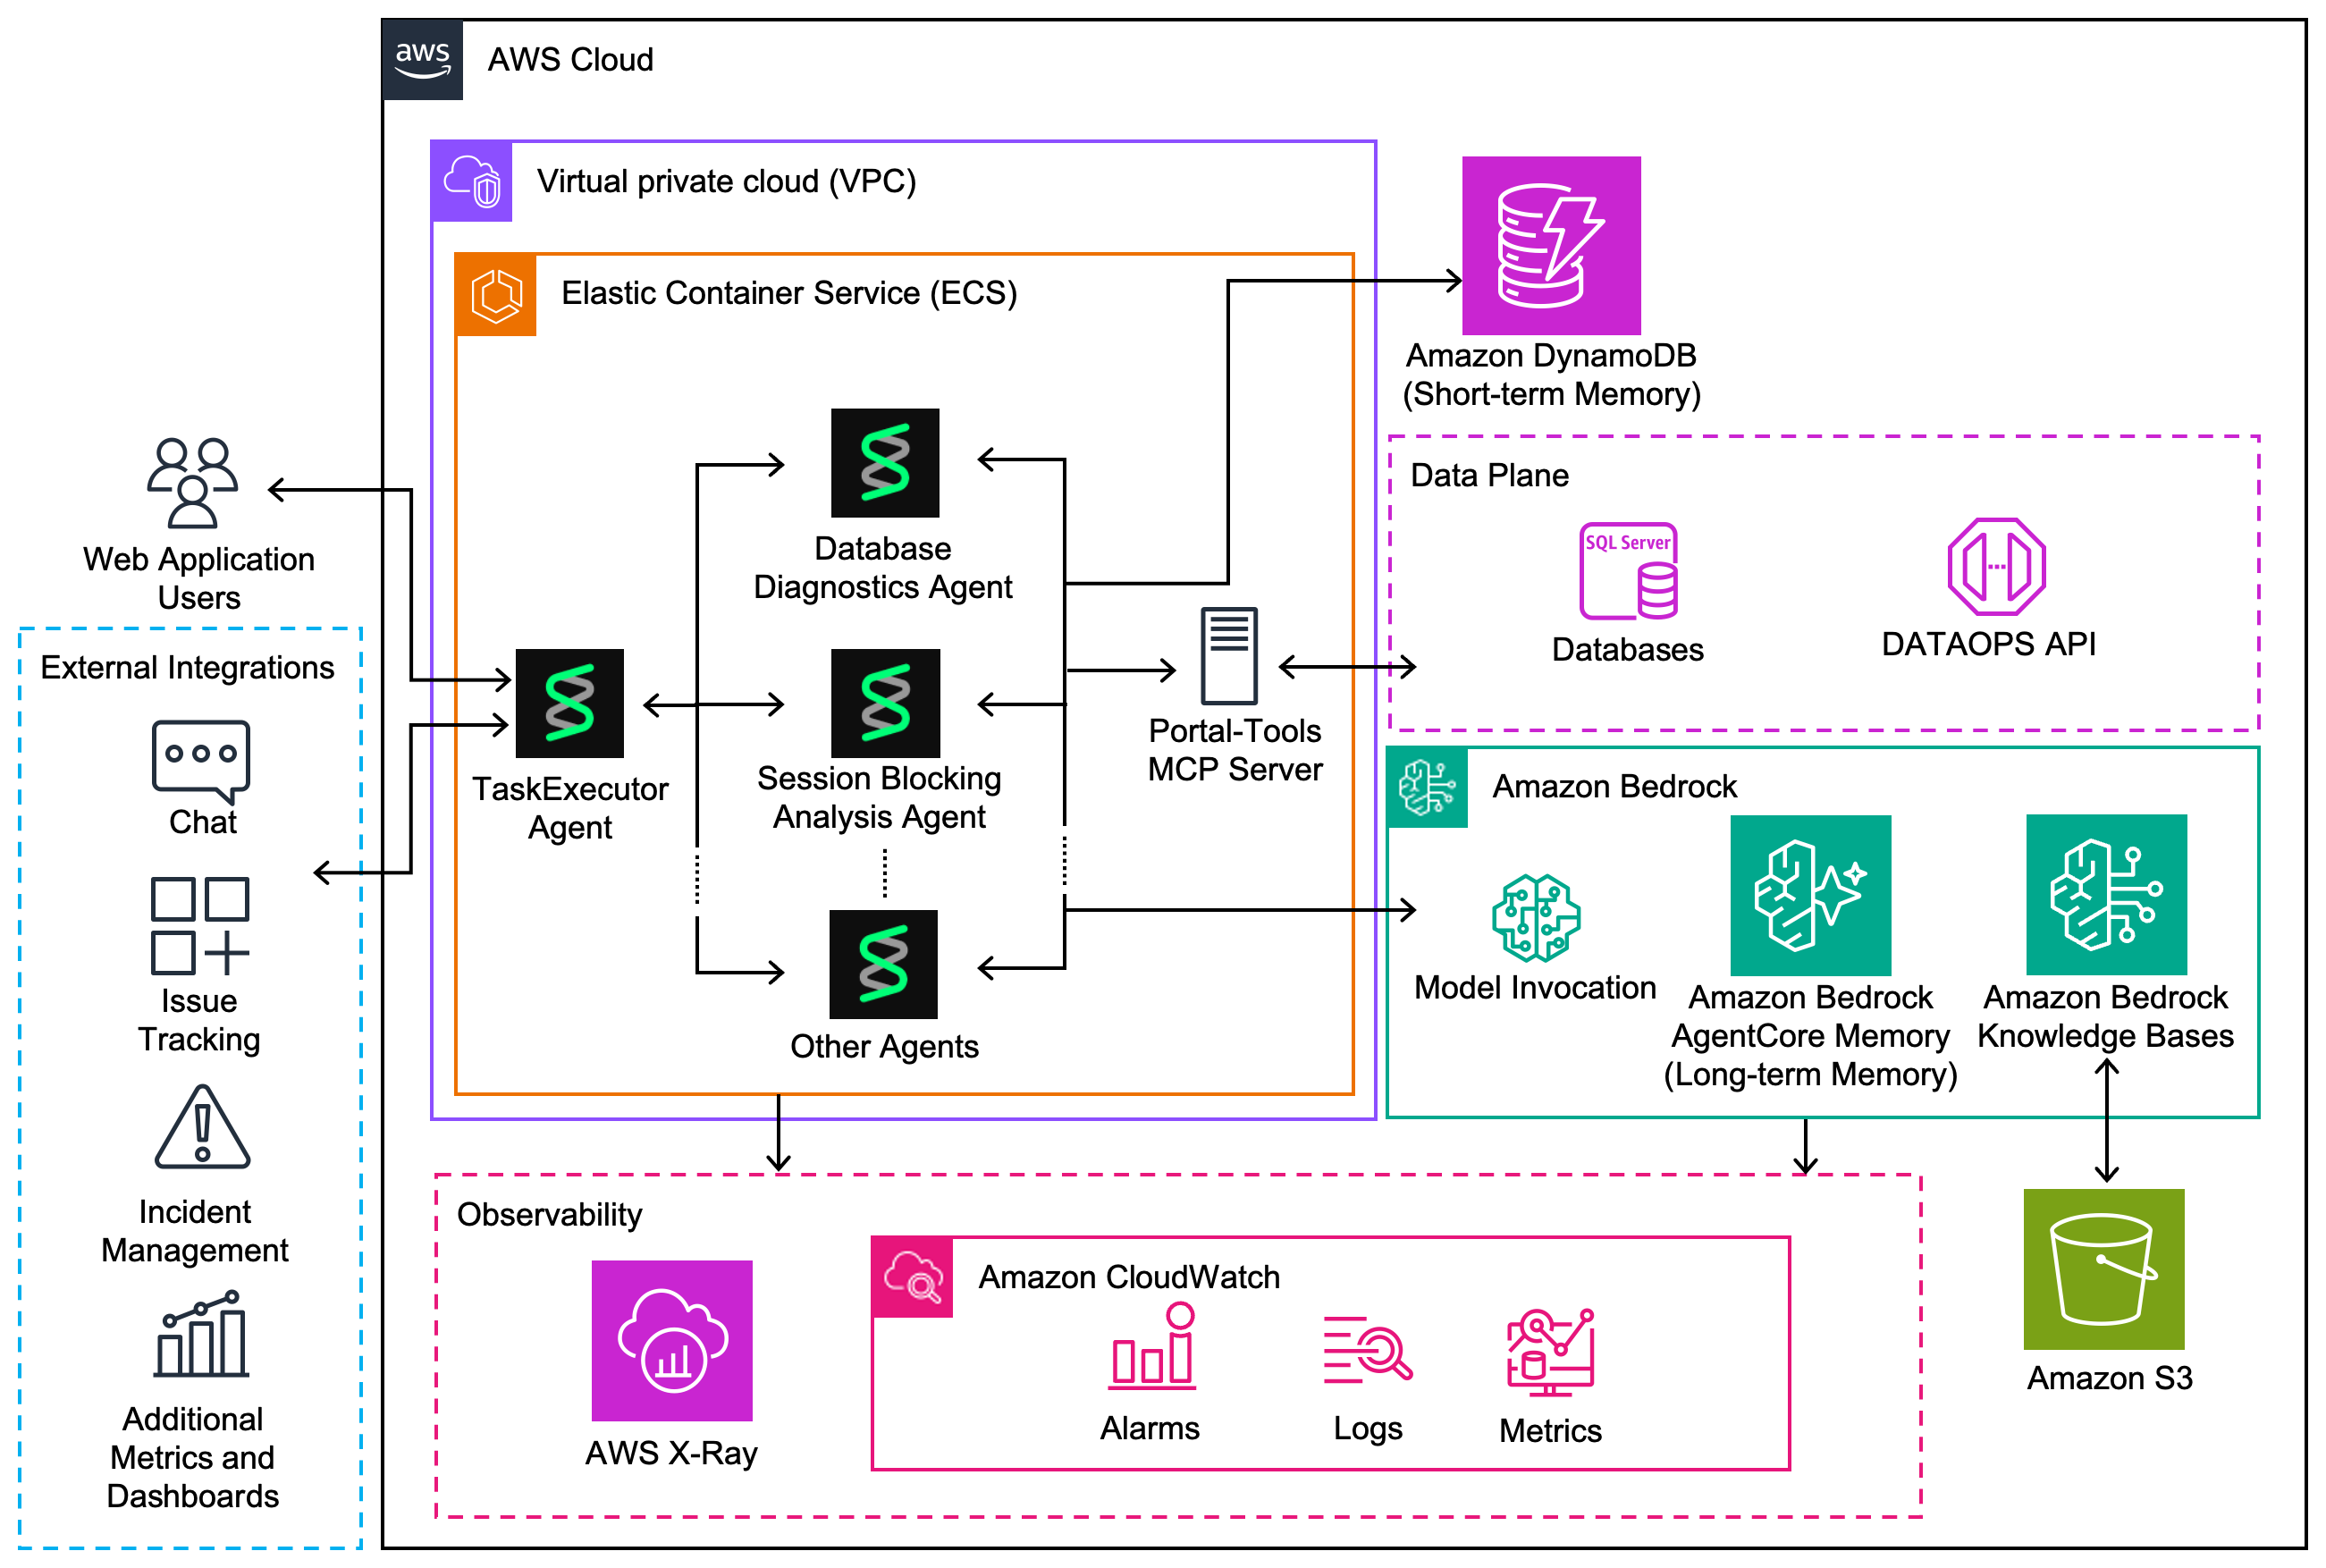
图 1:Orion AI 架构:Amazon ECS 上的元编排器将请求路由到专用智能体,这些智能体通过 Portal-Tools MCP 服务器访问数据源,并使用 Amazon Bedrock 进行模型推理、长期记忆和检索增强生成
架构深入剖析
上述设计原则在架构中得到了具体体现。本节其余部分将逐一介绍 Orion AI 的核心组件。
使用 Strands Agents 构建中心辐射模式
Orion AI 用少量 Strands Agents 原语来表达其拓扑结构。Agent 类是专家代理和元编排器的构建块。每个代理的工具都是带有 @tool 装饰器的普通 Python 函数。这会从函数的类型提示和文档字符串中推导出工具规范,意味着无需维护单独的 schema。BedrockModel 封装了每个代理所运行的 Amazon Bedrock 模型,MCPClient 将代理连接到外部工具服务器。
拓扑结构:
- 中心是一个充当元编排器(TaskExecutor)的单一 Strands Agent。它不持有任何领域工具——只有路由工具(
find_relevant_agents、call_agent)和控制流工具(emit_plan_step、emit_confirmation_gate),以便能够逐步推理请求。 - 分支是独立的
Agent实例,通过基于装饰器的注册表惰性加载。每个实例都携带自己的模型、领域工具和本地化系统提示。
在运行时,中心通过注册的 call_agent 工具按名称调用专家。每个专家运行自己的工具调用循环,并将综合后的文本返回给中心,由中心组装最终响应。
混合路由
Orion AI 使用关键字优先路由,并以语义搜索作为回退。大约 80% 的查询通过内存中的关键字快速路径在不到一毫秒内解决。当关键字不足以确定意图时,系统回退到由 Amazon Titan Text Embeddings V2 提供支持的语义搜索,以按含义进行路由。有关按 AWS 区域划分的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型。
当直接工具调用不合适时,会激活回退链:Amazon Bedrock Knowledge Bases 这一完全托管的检索增强生成(RAG)能力会检索操作文档,使响应基于已批准的流程,而不是在没有上下文的情况下生成。
领域特定代理及其边界
Orion AI 使用 13 个领域特定代理。三个 SQL Server 代理说明了领域拆分如何映射到真实调查的各个阶段:
- 数据库诊断代理 呈现阻塞链、等待类型和长时间运行的查询,然后将技术发现转化为业务影响并提供修复建议。它回答“正在发生什么以及这意味着什么”。
- 会话阻塞分析代理 使用推理模型运行多步调查,将阻塞链映射到根阻塞者。它回答“为什么会发生这种情况以及根本原因是什么”,提供从立即终止会话到长期架构修复的优先建议。
- 实时 SQL 诊断代理 通过 Cornerstone 的 DATAOPS API 直接查询 SQL Server 实例,以获取实时阻塞数据和高 CPU 会话分析。它回答“现在真实情况是什么”。
其余代理遵循相同的窄所有权原则:基础设施监控、运营分析、数据库生命周期管理、客户分析、从运行手册中检索知识、通知路由、复合查询分解、可用性组侦听器解析以及模型连接预热。
工具集成和服务连接
Orion AI 通过两种模式访问数据源:
- Model Context Protocol (MCP) 用于多个 agent 共享的工具(例如实时 SQL 诊断)。Strands
@tool函数通过可流式 HTTP 调用MCPClient到 Portal-Tools MCP 服务器,该服务器再访问 SQL Server 和 DATAOPS API。Jira 集成通过外部 Atlassian MCP 工具采用相同方式。 - 直接 SDK 或 REST API 调用 用于不需要共享 MCP 接口的数据源。这包括指标和仪表盘、值班排班,以及通过 AWS SDK for Python (Boto3) 访问的 Amazon Bedrock Knowledge Bases。
这种拆分意味着每个 agent 都使用最适合其数据源的最轻量机制,而 MCP 服务器则集中管理多个 agent 共享的工具。这些连接通过 TLS 运行,MCP token 和 REST API 授权等凭证按请求提供,而非嵌入 agent 代码中。
对话记忆
Amazon Bedrock AgentCore 是一个可使用任意框架或模型大规模构建、连接和优化 agent 的平台,它提供跨会话记忆层。Orion AI 通过一个中央记忆管理器协调上下文,该管理器并行读取三个层级,每个层级都有自己的超时和 token 分配。
Orion AI 跨三个层级协调上下文。短期记忆将同一会话的上下文保存在 Amazon DynamoDB 中,默认静态加密,并配有一个由 Amazon Nova 2 Lite 异步生成的滚动对话摘要。长期记忆通过 AgentCore memory(Amazon Bedrock AgentCore 的一项能力)提供跨会话回忆,并按用户 ID 命名空间划分。任务完成时,Orion AI 调用 create_event 触发自动提取、摘要和整合。第三层是 agent 间记忆,它是一个临时的内存暂存区,在单个任务内跨子 agent 步骤传递发现结果。
记忆管理器在 500 毫秒硬超时和 4,000 token 预算内跨层级检索,并由最近最少使用缓存提供支持。当请求涉及当前系统状态时,agent 会完全绕过记忆并读取实时数据,因此过时上下文不会污染实时诊断。
负责任 AI 与护栏
由于 DataOps 安全依赖于特定领域规则,例如哪些数据库操作具有破坏性,团队构建了自定义护栏逻辑,而不是依赖通用内容过滤器。Orion AI 在四个层面应用控制:
- 提示级安全约束 注入每个 agent 的系统提示中,阻止危险建议(例如终止关键数据库进程)并强制采用非破坏性方法。
- 人在回路确认门 会暂停破坏性操作,直到用户在五分钟窗口内确认,超时则默认拒绝。
- 用于输入验证的自定义护栏模块(长度限制、提示注入和 SQL 注入拦截)、输出净化(脱敏密钥和个人身份信息)、速率限制、基于角色的访问控制,以及按请求成本跟踪。
- 路由级保护 阻止从记忆中回答运维查询,强制对当前状态问题执行实时工具调用。
可观测性
Orion AI 使用标准 AWS 可观测性服务进行监控和调试。Amazon CloudWatch 提供指标和结构化日志,用于路由置信度、延迟和代理调用活动。AWS X-Ray 跟踪跨代理执行的分布式调用,实现端到端请求路径可见性。
经验教训
使 Orion AI 成为可能的设计决策,你也可以复用。按领域拆分代理,让每个代理携带狭窄的工具集成,而不会使单个模型的上下文膨胀。默认使用关键词路由,并以语义搜索作为回退,在保持低延迟的同时不牺牲对模糊请求的准确性。将会话记忆限定在会话范围内,同时为实时指标绕过它,使实时诊断保持可信。
团队还做出了务实的基础设施选择。他们将计算部署在 Amazon ECS 上,因为 Amazon Bedrock AgentCore runtime(Amazon Bedrock AgentCore 的一项能力)在项目开始时尚不可用,他们现在正在评估将其作为未来的迁移选项。如果你今天在构建,请为你的技术栈权衡同样的取舍:从当前稳定且可用的方案开始,并随着托管能力的成熟重新审视。
结论
Orion AI 将数据库诊断时间从 45 分钟缩短到 10 分钟,避免了 70% 的手动生命周期步骤,并将告警噪音减少了 65%。一个三人团队在 Amazon Bedrock 上于六个月内交付了它。这些结果背后的模式是其他运维团队可以采用的:领域范围的代理、混合路由,以及带实时指标旁路的会话范围记忆。
要开始在 AWS 上进行多代理编排,请查看 AWS Solutions Library 指南。
关于作者

Harpreet Chawla
Harpreet,Cornerstone OnDemand, Inc.,是一位战略数据与 AI 基础设施高管,拥有超过 20 年推动全球企业大规模数字化转型和卓越运营的经验。他专注于在 AWS 上扩展关键任务数据平台,同时引领向代理式 AI 和自主平台工程的转变。

Derek Ziehl
Derek 是 AWS 的高级技术客户经理(TAM)。他拥有设计大规模网络系统和管理云迁移的背景。作为 TAM,他乐于帮助客户在 AWS 上运行弹性、优化的工作负载。

Madhu Pai
Madhu 是 AWS 的生成式 AI 和机器学习首席专家解决方案架构师,他帮助 ISV 和企业将 AI 从实验推向大规模生产。他与各行业的组织合作,应对 AI 采用的实际障碍:治理、合规、数据就绪和信任。凭借深厚的现场经验,Madhu 以务实、供应商中立的视角看待团队如何负责任地扩展 AI。

Nishchai JM
Nishchai 是 Amazon Web Services 的高级解决方案架构师,专攻面向独立软件供应商(ISV)的数据、分析和生成式 AI。他帮助客户现代化其数据平台、构建大规模分布式应用程序,并在云上从 AI/ML 工作负载中释放价值。
来源:AWS Machine Learning Blog · aws.amazon.com