ArisGlobal 如何在 Amazon Bedrock 上扩展生成式 AI 推理
How ArisGlobal scaled generative AI inference on Amazon Bedrock
ArisGlobal 通过调整 Amazon Bedrock 提示词缓存顺序,将共享提示词前缀而非源文档放入缓存,从而降低有效输入成本,支撑更多租户而不带来成本等比增长。
ArisGlobal 是一家生命科学领域的技术提供商,业务覆盖药物警戒、法规事务、医学事务、临床和质量职能。该公司在 Amazon Bedrock 上开发了专为生命科学打造的 AI 引擎 NavaX,用于自动化不良事件病例处理。ArisGlobal 选择 Amazon Bedrock,是看中其托管式基础模型访问、欧盟地理跨区域推理以及托管式提示缓存能力。随着企业客户不断增加各自的合规要求,共享提示前缀在 6 个月内增长了约 150%,而单病例推理成本上涨了超过 200%。
ArisGlobal 最初缓存的是每份源文档,因为它是请求中占比最大的部分。这样一来,不断增长的共享提示前缀就被排除在缓存之外。通过反转顺序、改为缓存共享前缀,ArisGlobal 降低了有效输入成本,并在不产生成比例成本增长的情况下支持了更多租户。
ArisGlobal 是谁?
ArisGlobal 是 LifeSphere 的开发者。LifeSphere 是一个统一的 SaaS 平台,面向药物警戒、法规事务、质量和医学信息。LifeSphere 服务于全球制药公司,其中包括多家按营收排名前 20 的制药组织(来源:ArisGlobal 新闻稿)。整个系统运行在 AWS 上。
LifeSphere NavaX 是 ArisGlobal 的 AI 引擎,它将药物安全从记录系统转变为战略优势系统。ArisGlobal 于 2025 年 3 月在 Amazon Bedrock 上使用 Anthropic 的 Claude 将其首个生成式 AI 解决方案投入生产。根据 ArisGlobal 的内部生产遥测数据,他们已在受监管的制药环境中处理了超过 100 万笔真实交易,在多个企业租户中处理了数十亿个 token。模型可用性因区域而异。请参阅 按 AWS 区域划分的模型支持。
NavaX 如何处理不良事件病例
当制药公司收到不良事件报告时(通常是一份描述患者对药物反应的多页 PDF),NavaX 的动态数据提取(DDE)代理会提取约 130 个字段。这些字段包括患者人口统计信息、可疑药物、报告者信息、事件时间线、严重性标准和监管分类。由于这些内容包含受保护的健康信息,ArisGlobal 将负责任 AI 控制作为其生产部署的标准组成部分。它借助 Amazon Bedrock Guardrails 等能力来过滤内容,并检测或遮蔽敏感信息。提取出的字段还会根据 schema 进行验证,并以源文档为依据。
这一提取过程通过向模型发出的多个顺序请求完成。每个请求聚焦于病例表单的不同部分,并且每个请求都携带:
- 系统指令——模型行为规则、输出格式规范以及监管合规约束。
- 客户特定规则——按租户区分的提取逻辑、字段映射以及因制药公司而异的业务规则。
- 提取 schema——约 130 个目标字段,包含类型、验证规则和少样本示例。
- 源文档——不良事件 PDF(通常为 10–200 页)。
有两类输入在不同范围内重复出现。共享提示前缀包括系统规则、提取 schema 和少样本示例。它会在使用同一代理的请求、病例和租户之间重复。源文档仅在与单个病例相关的请求中重复。
提示膨胀问题
当 NavaX 携首个企业租户上线时,系统提示词还很精简。随着 ArisGlobal 接入更多制药公司,每家都带来了特定需求:
- 自定义字段映射(租户 A 对反应发生时间的映射方式与租户 B 不同)。
- 监管辖区规则(EU ICSR 与 FDA MedWatch 及 PMDA 格式的对比)。
- 针对严重性评估和因果关系的公司特定业务逻辑。
- 按各公司历史案例校准的每租户少样本示例。
在 6 个月里,共享提示词前缀从约 72,000 个 token 增长到 180,000 个 token,增幅 150%。由于每个案例需要多次顺序请求,单案例推理成本增加了 200% 以上。
前缀随每个租户增长,并在每次请求时被重新处理,因此提示词增长与交易量叠加放大。
表 1 对比了最初的文档优先请求顺序与生产环境的提示词优先设计。
| 方面 | 最初方案 | 生产设计 |
| 请求顺序 | 每案例文档、缓存检查点、共享提示词前缀 | 共享提示词前缀、缓存检查点、每案例文档 |
| 缓存前缀 | 每案例都会变化的文档 | 跨请求重复的共享提示词前缀 |
| 复用范围 | 仅限单个案例的剩余请求 | 使用同一智能体的跨案例、跨租户请求 |
| 成本影响 | 不断增长的前缀按完整输入费率被反复处理 | 全集群提示词复用支持次线性成本增长 |
| EU 路由 | EU 地理跨区域推理保持不变 | EU 地理跨区域推理保持不变 |
Amazon Bedrock 提示词缓存策略
Amazon Bedrock 提示词缓存通过缓存从请求开头到缓存检查点的连续提示词前缀,降低延迟和输入 token 成本。后续具有相同前缀的请求可以按较低费率读取缓存 token,而无需重新处理。缓存条目具有生存时间(TTL),在成功命中缓存后重置。
缓存基于前缀而非基于块。请求各部分按顺序评估——工具、系统、消息——因此更改较早的部分会使后续匹配内容失效。
缓存检查点(显式控制)
使用显式缓存检查点,您可以选择确切的前缀边界。支持的 Claude 模型允许每个请求最多四个检查点。
- 将每个检查点放在稳定、可复用的前缀之后。
- 满足模型特定的最小前缀大小。对于 Claude Sonnet 4.5,最小值为 1,024 个 token(参见支持的模型和区域)。
- 检查点按以下顺序评估:工具、系统、消息。
- 更改较早的部分会使后续部分的缓存匹配失效。
- 默认 TTL 为 5 分钟。部分模型通过设置
"ttl": "1h"支持 1 小时 TTL。较长 TTL 的条目必须位于较短 TTL 的条目之前。
简化缓存管理(自动化)
使用简化缓存管理,您在静态内容之后放置一个检查点。Amazon Bedrock 从该点向后搜索最长匹配前缀,最多约 20 个内容块。
- 一个检查点即可自动定位最长匹配前缀。
- 当稳定内容超出回溯范围时,请使用显式检查点。
ArisGlobal 缓存了什么,以及刻意不缓存什么
ArisGlobal 在最先发送的共享提示词前缀之后立即使用一个显式检查点。每案例文档位于检查点之后,并在每次请求时处理。
这颠倒了最初的请求顺序。由于只有前缀可以被缓存,顺序决定了哪些内容可以被复用。
上线时的设计:优先考虑文档复用
最初的设计将 10–200 页的源文档放在每个请求的开头,并将检查点放在其后。共享提示前缀和分节特定问题位于检查点之后。
{
  "modelId": "anthropic.claude-sonnet-4-5-20250929-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "text": "[Full adverse event PDF content]..." // <-- Document sent FIRST
        },
        {
          "cachePoint": {"type": "default"} // <-- Checkpoint right after the document
        },
        {
          "text": "[System instructions + compliance rules + schema +
          few-shot examples + customer-specific prompt]..."
          // <-- After the checkpoint: never cached
        },
        {
          "text": "Extract fields for Section 3: Suspect Drug Information"
        }
      ]
    }
  ]
}
该设计在单个案例内复用了文档:第一个请求将其写入缓存,该案例的后续请求以折扣费率读取它。
下一个案例使用了不同的文档,需要新的缓存写入,因此复用从未扩展到跨案例或跨租户。
更重要的是,共享提示前缀仍位于检查点之后,并在每个请求中按完整输入费率处理。驱动成本曲线的内容被排除在缓存之外。
演进后的生产设计:优先考虑共享前缀复用
生产设计改变了顺序,而不是增加另一个检查点:共享提示前缀放在最前,检查点紧随其后,文档放在最后。
同一个检查点现在创建了一个可复用的全集群缓存条目:
- 之前——缓存的文档前缀对单个案例唯一,共享提示从未被缓存。
- 之后——缓存的共享提示前缀在使用同一智能体的请求、案例和租户之间重复出现。
ArisGlobal 放弃了单个案例内有限的文档复用,换来了全集群的提示复用。共享前缀也是随着客户增加而增长的部分。
更新后的实现
{
  "modelId": "anthropic.claude-sonnet-4-5-20250929-v1:0",
  "system": [
    {
      "text": "[Shared system instructions + compliance rules +
      base extraction schema + few-shot examples]..."
    },
    {
      "cachePoint": {"type": "default"} // <-- Checkpoint after the stable prompt
    }
  ],
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "text": "[Full adverse event PDF content — sits after the
          checkpoint, not cached]..."
        },
        {
          "text": "Extract fields for Section 5: Event Assessment"
          // <-- Only this changes per request
        }
      ]
    }
  ]
}
对于大多数活跃账户,每个租户大约每 5 分钟到达一个案例,且多个租户并发运行。这种流量在营业时间内保持共享前缀处于热状态,因为每次缓存命中都会重置 TTL。
同时缓存提示和文档
在文档之后设置第二个检查点将缓存由共享提示和该案例文档组成的组合前缀。该条目仍将仅对单个案例唯一。
因此,ArisGlobal 优先选择了读取可在全集群范围内摊销的前缀。共享提示前缀可跨案例和租户扩展。而每个案例的文档则不能。
在生产环境中,典型请求中 65% 的输入 token 由共享提示缓存提供。图 1 显示缓存读取持续超过缓存写入。
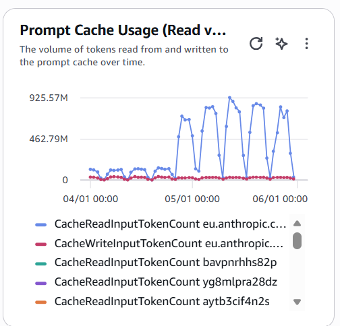
图 1:Amazon CloudWatch 提示缓存使用情况。在生产流量期间,蓝色缓存读取序列上升至缓存写入序列的约 10 倍
结果
在保留 EU 地理跨区域推理配置文件的情况下,缓存共享提示前缀产生了以下结果:
- 65% 的输入 token 以折扣读取费率从缓存提供。
- 缓存的生产请求端到端延迟最多降低 25%。
- 有效输入成本降低约 50%。
- 在每月超过 190 亿 token 的情况下,整体月度推理支出降低约 40%。
- 新增约 15% 的企业租户,而成本未成比例增加。
- EU 地理路由保持不变。提示缓存在现有推理配置内运行。
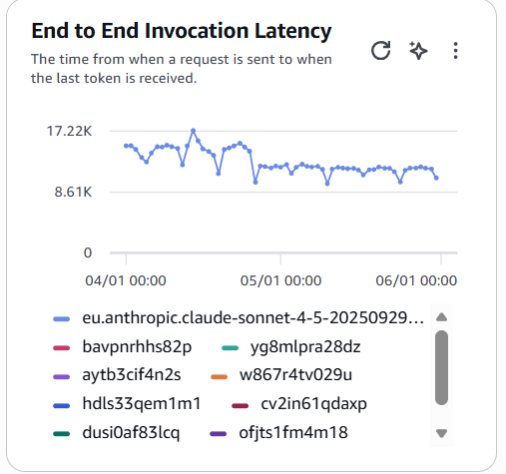
图 2:端到端调用延迟。该图显示采用提示缓存后延迟范围更低且更稳定
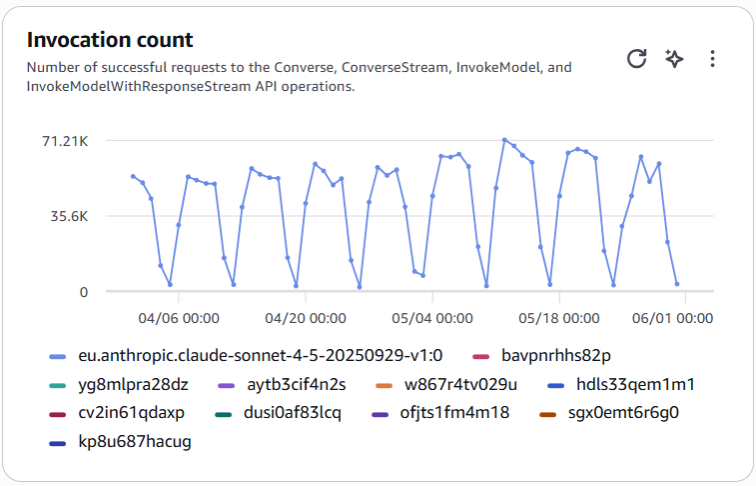
图 3:调用次数。该图显示生产请求量持续增长,而推理支出增长低于比例
基于 ArisGlobal 的生产计费数据,从缓存中提供 65% 的输入 token,使有效输入成本降低了约 50%。在每月超过 190 亿 token 的规模下,这带来了约 40% 的推理支出整体月度节省。
注:本节中的所有性能和成本数据均反映 ArisGlobal 向 AWS 报告的生产指标。结果将因提示结构、流量模式和缓存命中率而异。
生产环境经验
ArisGlobal 的经验为许多具有大型、重复提示前缀的工作负载提供了指导:
缓存重复的内容,而不是最大的内容。 大型的单个案例文档复用有限,而字节完全相同的共享提示前缀可以服务整个集群的请求。
将稳定内容放在前面。 将工具定义、系统指令、schema 和示例放在检查点之前。将租户标识符、案例数据和每个请求的问题放在之后。
利用集群流量分摊缓存写入成本。 来自使用同一 agent 的租户的请求可以读取相同的前缀,而缓存命中会重置 TTL。对于零散流量,请在支持的模型上评估 1 小时 TTL。
减少可避免的调用。 每次调用仍会处理未缓存的文档,因此在输出限制和 schema 要求允许的情况下,将连续问题合并处理。
保持前缀字节完全相同。 时间戳、请求 ID、租户名称和重新排序的工具定义都可能导致未命中。将每个动态元素移到检查点之后。
监控生产基线。 在 CloudWatch 中跟踪缓存读取、缓存写入和总输入 token。当持续低于正常的 65% 缓存命中基线时发出告警,而不是使用不兼容的 80% 阈值。
检查模型特定的限制。 前缀最小值和 TTL 选项因模型而异。Claude Sonnet 4.5 要求缓存检查点至少为 1,024 个 token。
结论
ArisGlobal 将 EU 地理跨区域推理与针对正确内容的提示缓存相结合。缓存稳定的共享前缀而非单个案例文档,使有效输入成本降低了约 50%,促成了约 40% 的推理整体月度节省,并在不增加成比例成本的情况下多支持了约 15% 的企业租户。
关键教训是,缓存价值取决于复用,而非大小。对于多租户 agentic 工作负载,重复的共享提示前缀可能比每个案例都会变化的大型文档更有价值。
如需了解更多,请参阅 Amazon Bedrock 提示缓存文档、跨区域推理指南,以及 AWS 博客文章 在 Amazon Bedrock 上有效使用提示缓存。
关于作者

Hitesh Sharma
Hitesh 是一位技术领导者,在软件工程和产品创新方面拥有 25 年经验,其中 20 年深耕生命科学行业。他专注于应用生成式 AI、AI/ML 和云原生技术,解决药物警戒、药物安全、法规合规和患者安全领域的复杂挑战。Hitesh 曾领导开发可扩展的 AI 平台,交付业务价值。他对 GenAI、创新以及组建高绩效团队以推动生命科学技术发展充满热情。

Rakesh Kumar Sharma
Rakesh Kumar Sharma 是一位 AI/ML 领导者和研究者,在生成式 AI、Agentic AI 和企业 AI 架构方面拥有深厚专长。他专注于使用 LLM、AI 智能体、RAG 和现代 ML 框架设计和部署可扩展的 AI 解决方案,实现智能自动化、知识驱动的决策以及生产就绪的 AI 平台。他的工作重点是架构智能体系统,将推理、检索、工具和自主工作流相结合,以解决复杂的企业挑战。

Shubham Gupta
Shubham 是 AWS 驻印度班加罗尔的解决方案架构师,支持独立软件供应商(ISV)。他与工程和领导团队合作,在 AWS 上设计、构建和运行他们的产品,从初始架构到生产环境,重点关注生成式 AI 和大规模韧性。工作之外,Shubham 是一位热衷的徒步爱好者,他将徒步中的充分准备和坚持不懈带入构建持久系统的实践中。

Vibhu Pareek
Vibhu 是 AWS 的资深解决方案架构师。自 2016 年以来,他使用架构良好、可重复的模式指导客户采用云。凭借在数据库、数据分析和 AI 方面的专长,他擅长将复杂挑战转化为创新解决方案。工作之外,他喜欢短途徒步以及羽毛球、足球和游泳等运动。
来源:AWS Machine Learning Blog · aws.amazon.com