NVIDIA 发布 StreamRender-H3:用代码游戏引擎加实时流式扩散渲染构建交互世界
Interactive Coding Worlds with Real-Time Streaming Diffusion Render
NVIDIA 发布 StreamRender-H3,用代码游戏引擎维护世界状态、由流式扩散模型实时生成画面,在 8 张 GB200 上把每步扩散渲染从 799.7 ms 降到 218 ms,提速 3.67 倍。
Sol-Engine · 研究博客
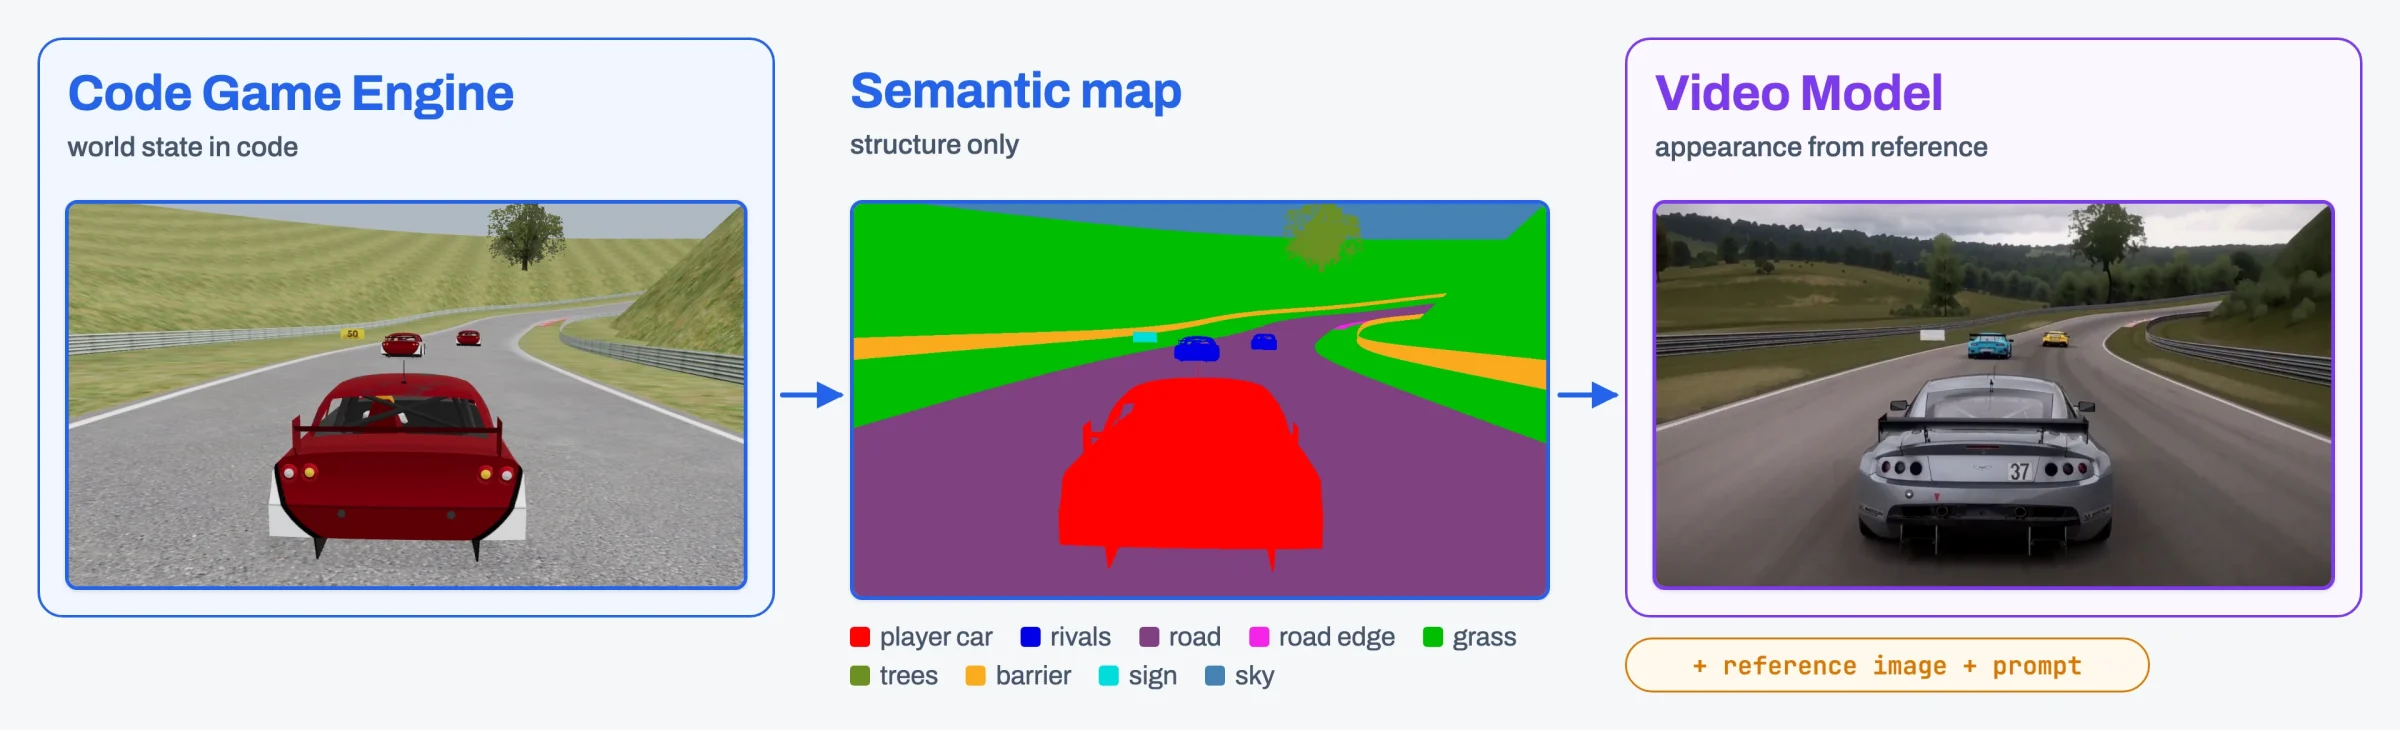
代码运行世界;视频模型将其渲染出来。代码游戏引擎维护交互世界的状态与规则,两步流式视频模型则实时将每一帧转化为照片级真实视频。
2 步部署生成器中每个 chunk 的去噪步数
218ms在 8 块 GB200 GPU 上每个流式步骤的扩散渲染耗时,从 799.7 ms 降低而来
3.67×扩散渲染相对 PyTorch 基线的加速比
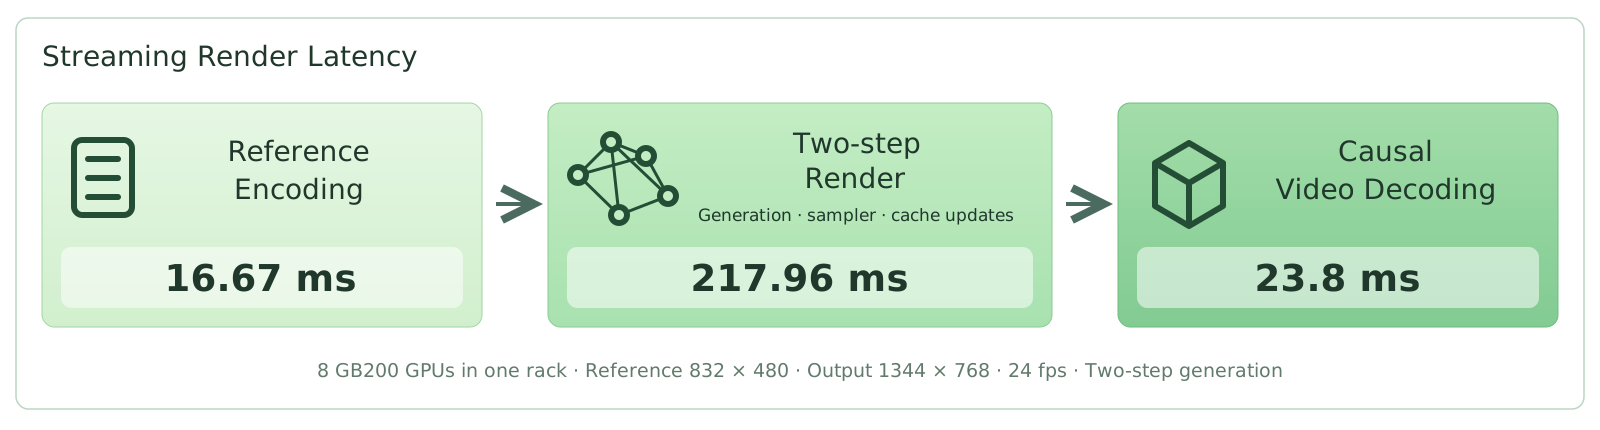
23.8ms在单块 GB200 上对 2 个 latent 帧进行 720p 快速因果 H3 VAE 解码
为什么将世界逻辑与视觉生成分离
交互世界必须确定玩家行为如何改变其状态,以及这些变化如何呈现在屏幕上。世界逻辑管理地图、物理、规则和物体状态。视觉生成决定外观、材质、光照和风格。游戏引擎已经将这些职责分离,而视频模型提供了一种生成视觉内容的新方式。
世界逻辑需要显式、可控的状态。道路位置应当可查询,碰撞应当遵循可执行规则,重新访问某个地点应当返回相同的地图。代码直接表示并维护这些信息,使开发者能够修改规则、调试行为并复现交互。视频模型可以使用参考条件,为相同的场景结构和运动赋予不同的外观。
StreamRender-H3 将这些职责分离到一个 代码游戏引擎 和一个 流式扩散渲染器 之间。引擎维护世界状态并响应玩家输入,而视频模型持续生成视觉内容。一个中间状态表示连接两者。这样既保留了对世界的控制,又实现了灵活、高保真的视觉效果,而无需依赖传统 3D 管线进行最终渲染。
NVIDIA DLSS 5 在游戏中开创了这一方向:一个实时神经渲染模型,接收每个渲染帧的颜色和运动矢量,并添加照片级光照和材质,锚定于源 3D 内容,且逐帧保持一致。StreamRender-H3 遵循在游戏引擎之上进行生成式渲染的相同思路,并将其向前推进一步。引擎只向视频模型提供语义图,因此模型生成每一帧的完整外观,而一张参考图像和一段提示词可以完全改变该外观。
状态表示 · 来自代码
扩散渲染 · 黄昏新参考图像
扩散渲染 · 雪景新参考图像
整体架构:代码游戏引擎 × 流式扩散渲染
2.1代码游戏引擎:地图、物理与交互反馈
代码游戏引擎维护世界中所有代码能够精确表述的部分。在本文中,我们以赛车游戏作为贯穿演示。它仅作为示例,设计中没有任何内容专属于赛车。在赛车演示中,引擎是一个用 three.js 编写的浏览器游戏。总体而言,引擎维护三类信息。
地图。地图描述场景的几何结构与布局、其中放置的物体,以及每个物体所属的类别。在赛车演示中,地图保存赛道及其边缘和护栏,以及沿途的景物。由于地图存在于代码中,它的任何部分都可以随时查询,返回某个位置时会显示完全相同的场景。
物理与规则。物理与规则决定物体如何移动和交互,例如物体如何响应玩家的输入、碰撞时会发生什么,以及非玩家角色的行为方式。它们以固定时间步推进,因此相同的输入序列总是产生相同的轨迹,这使得行为易于调试和回放。脚本化的智能体也可以自行玩游戏,这让我们能够在没有人类玩家的情况下录制可复现的会话。在赛车场景中,录制的训练会话中的每辆车都由 AI 驾驶员驾驶。
交互反馈。每一步,引擎都会读取玩家的输入、推进世界,并报告每个物体的位置以及摄像机的朝向。然后它从摄像机视角绘制当前状态。这种绘制不需要好看。它只需要按照第 2.2 节所述的形式精确传达场景的结构,因为生成玩家所看到的图像是视频模型的任务。
2.2中间状态表示:连接世界状态与视觉生成
引擎和视频模型需要一个共同的表示。这种表示必须承载世界逻辑所决定的一切,例如物体在哪里、它们具有什么形状、它们如何移动,以及摄像机朝向哪里。同时,它不应携带任何关于物体外观的信息,从而将外观完全留给视频模型。深度图、边缘图以及游戏本身的低保真渲染都在某种程度上满足这些要求。
我们目前使用语义图,其中每个像素都用一种平涂颜色绘制,以标识其所展示物体的类别,不包含光照、纹理或明暗。语义图包含场景的布局、每个物体的轮廓和位置、它们的运动以及摄像机路径,这些正是世界逻辑所决定的量。由于它不包含外观,同一个游玩会话可以用不同风格渲染。语义图的生成成本也很低,因为任何能够按类别用一种平涂颜色绘制其场景的引擎都可以驱动渲染器,这使该接口对其他游戏和引擎保持开放。在赛车演示中,语义图区分 13 个类别,即道路、道路边缘、地形、草地、植被、岩石、护栏、建筑、看台、广告牌、天空、玩家车辆和对手车辆。这些类别及其颜色是固定的,并在训练和部署之间共享。
视频模型基于 MiniMax-H3 Ref2VA 构建,该模型根据提示词以及参考图像和参考视频生成视频和音频。语义流作为参考视频输入其中。它的每个潜帧都与同一时间步的输出潜帧对齐,因此语义视频决定了每个生成帧的结构。
2.3从玩家输入到视频反馈的实时交互循环
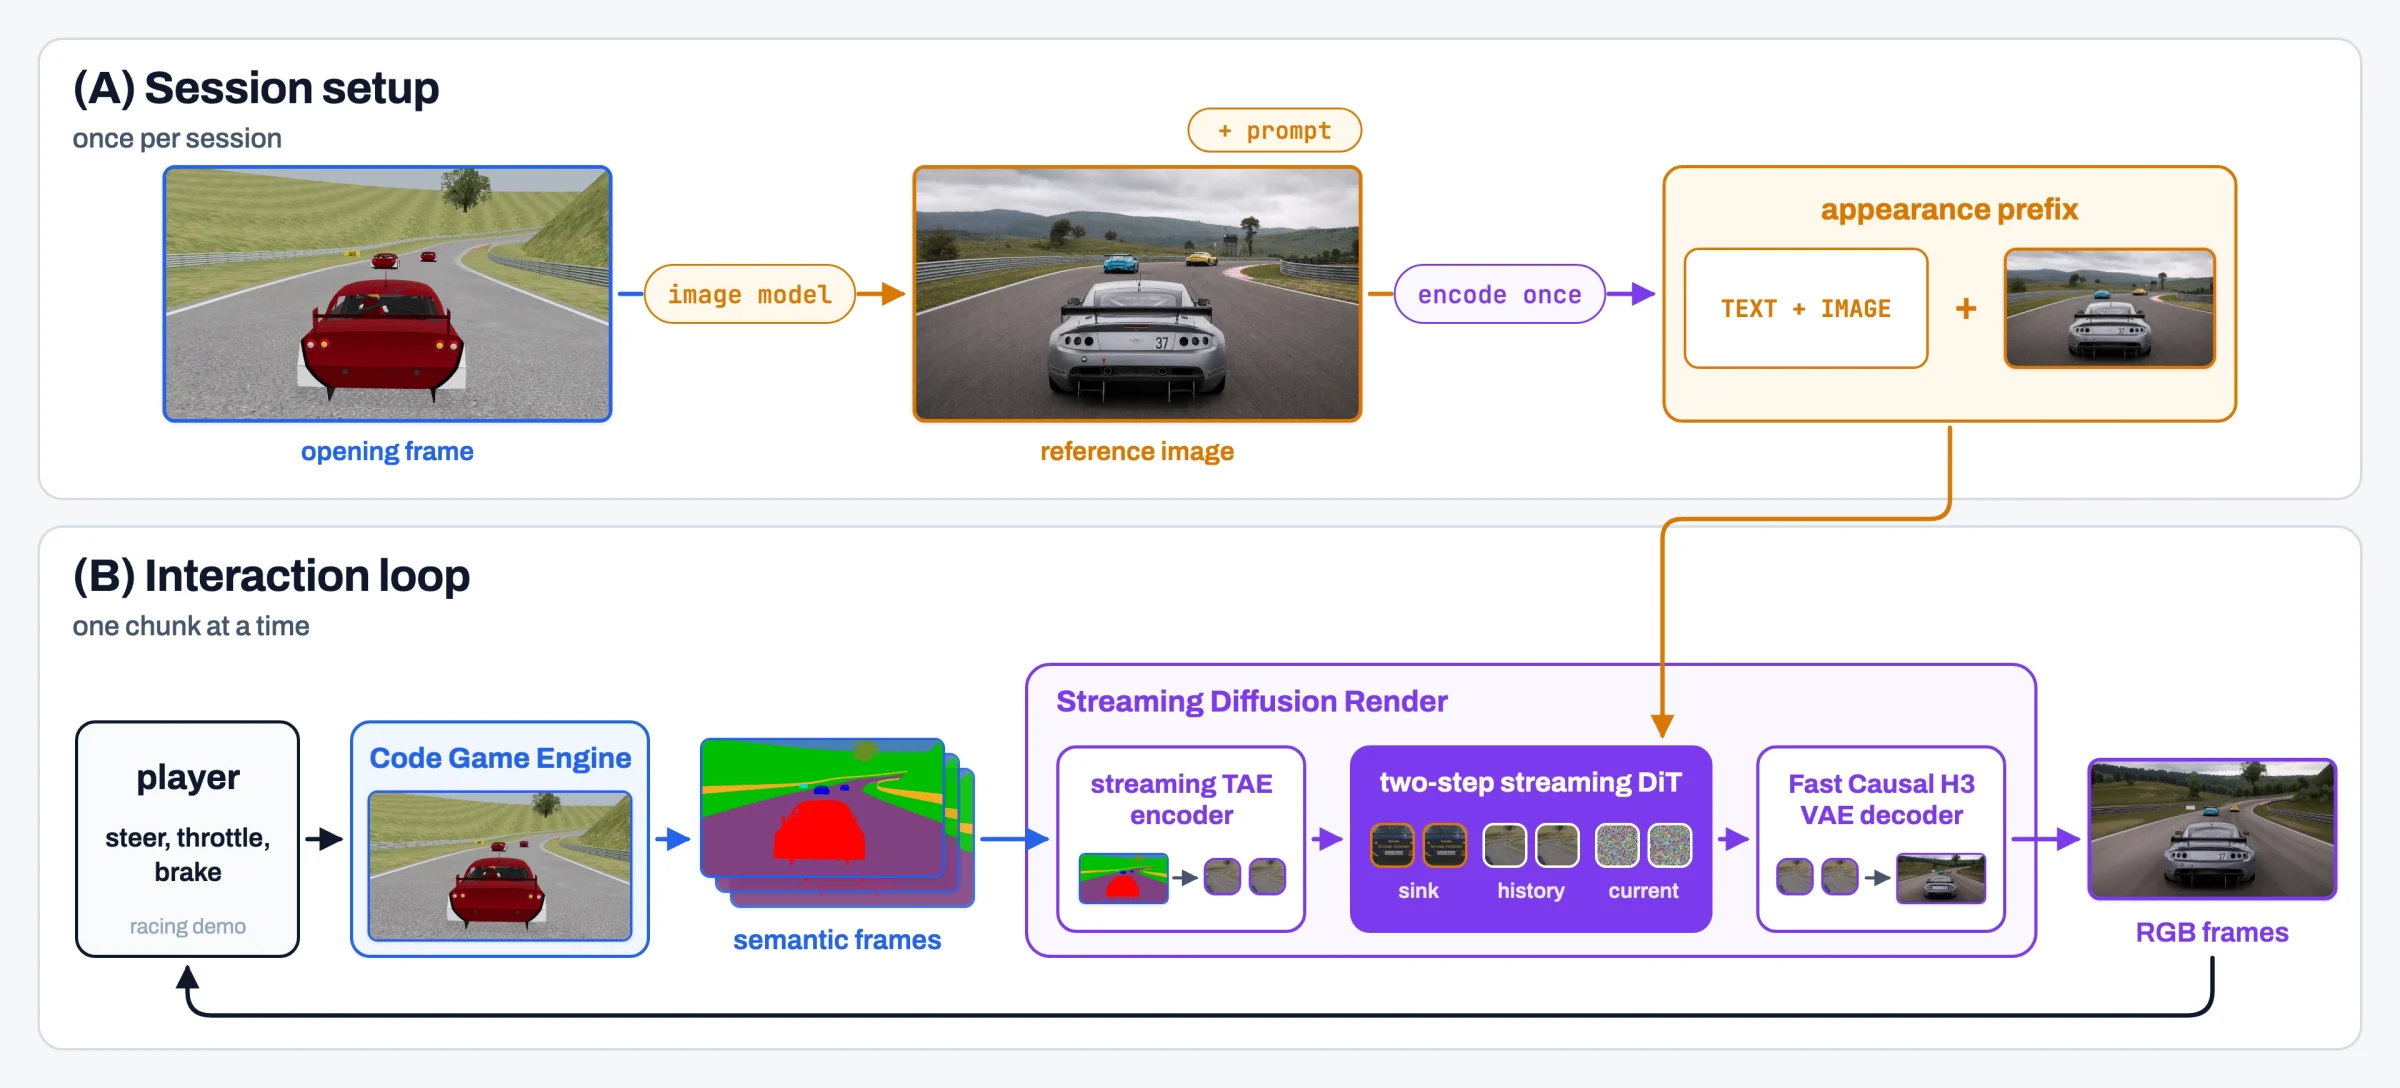
交互式游玩与离线视频生成有两点不同。视频无法提前生成,因为其内容取决于玩家尚未给出的输入。每个输入还必须足够快地出现在屏幕上,以便玩家对其做出反应。因此,StreamRender-H3 以循环方式运行,引擎和渲染器同时处理同一条流,玩家在下一部分仍在生成时就能看到结果。
一个会话包含两个阶段。设置阶段在开始时进行一次。引擎绘制场景的开场帧,图像生成模型将此帧转换为逼真的参考图像,参考图像和提示词被编码一次并在整个会话期间保留(第 3.1.1 节)。随后交互循环不间断地运行,每次循环包含五个步骤。
- 玩家通过键盘或控制器给出输入。在赛车演示中,此输入用于转向、加速或刹车玩家的赛车。
- 引擎在其下一个物理步中应用该输入并推进世界。
- 引擎为每个视频帧绘制一个语义帧,并将这些帧流式传输给渲染器。
- 渲染器收集一个块的语义帧,该块覆盖视频的一小部分时间。它以会话的外观和自身最近的输出为条件,在几个去噪步骤中生成该块,赛车演示中为两步,并将结果解码为 RGB 帧。
- 这些帧被显示出来,玩家在循环的下一轮中对其做出反应。
当每个块在前一个块播放完毕之前就绪时,循环便实时运行。此时视频与游玩保持同步,每个输入在其效果所在的块生成后立即显现。引擎和渲染器仅共享语义帧流和会话的外观条件,因此任一侧都可以独立替换。例如,不同的游戏只需以相同格式生成语义帧。第 3.2 节和第 3.3 节描述了解码和生成如何适应每个块的播放时间。
▶20 个场景,1 分钟展示
来自 20 个场景的每个连续一分钟,全部由同一个 StreamRender-H3 模型渲染,每个场景都有自己的赛道、外观和赛车涂装。引擎仅提供语义流;下方每个像素都来自流式渲染。
关键技术
3.1流式扩散渲染
流式扩散渲染将引擎的语义流转换为逼真的视频。本节描述其如何被条件化和训练。第 3.1.1 节解释了参考图像和提示词如何固定世界的外观。视频由扩散生成器生成,该生成器分三个阶段训练。第 3.1.2 节解释了每个块如何与其之前的流保持一致,并涵盖两个预训练阶段:教师强制和重采样强制。第 3.1.3 节涵盖最后一个阶段 DMD,它让生成器以两步生成每个块以实现实时游玩。渲染器在开发过程中以 SoL-Pi 作为主要编码代理,在数据准备、训练和评估中大规模使用。
3.1.1由参考图像和提示词驱动的外观控制
语义地图告诉渲染器每个物体在哪里,但不会告诉它看起来是什么样。例如在赛车演示中,同一道路类别在正午可能是干燥的沥青路面,在夜晚则可能是湿滑的街道;同一车辆类别可以是任意颜色、任意款式的汽车。因此渲染器需要第二个信息来源来确定世界的外观。这一信息还必须在整个会话期间保持不变,这样随着视频流推进,物体才能保持其外观。仅靠提示词对于这一目的来说过于粗略,因为几句话无法精确指定特定的材质、配色方案或光照。因此,我们在每次会话开始时给渲染器提供两个输入:一张展示预期外观的参考图像,以及一段说明这些输入之间如何相互关联的提示词。
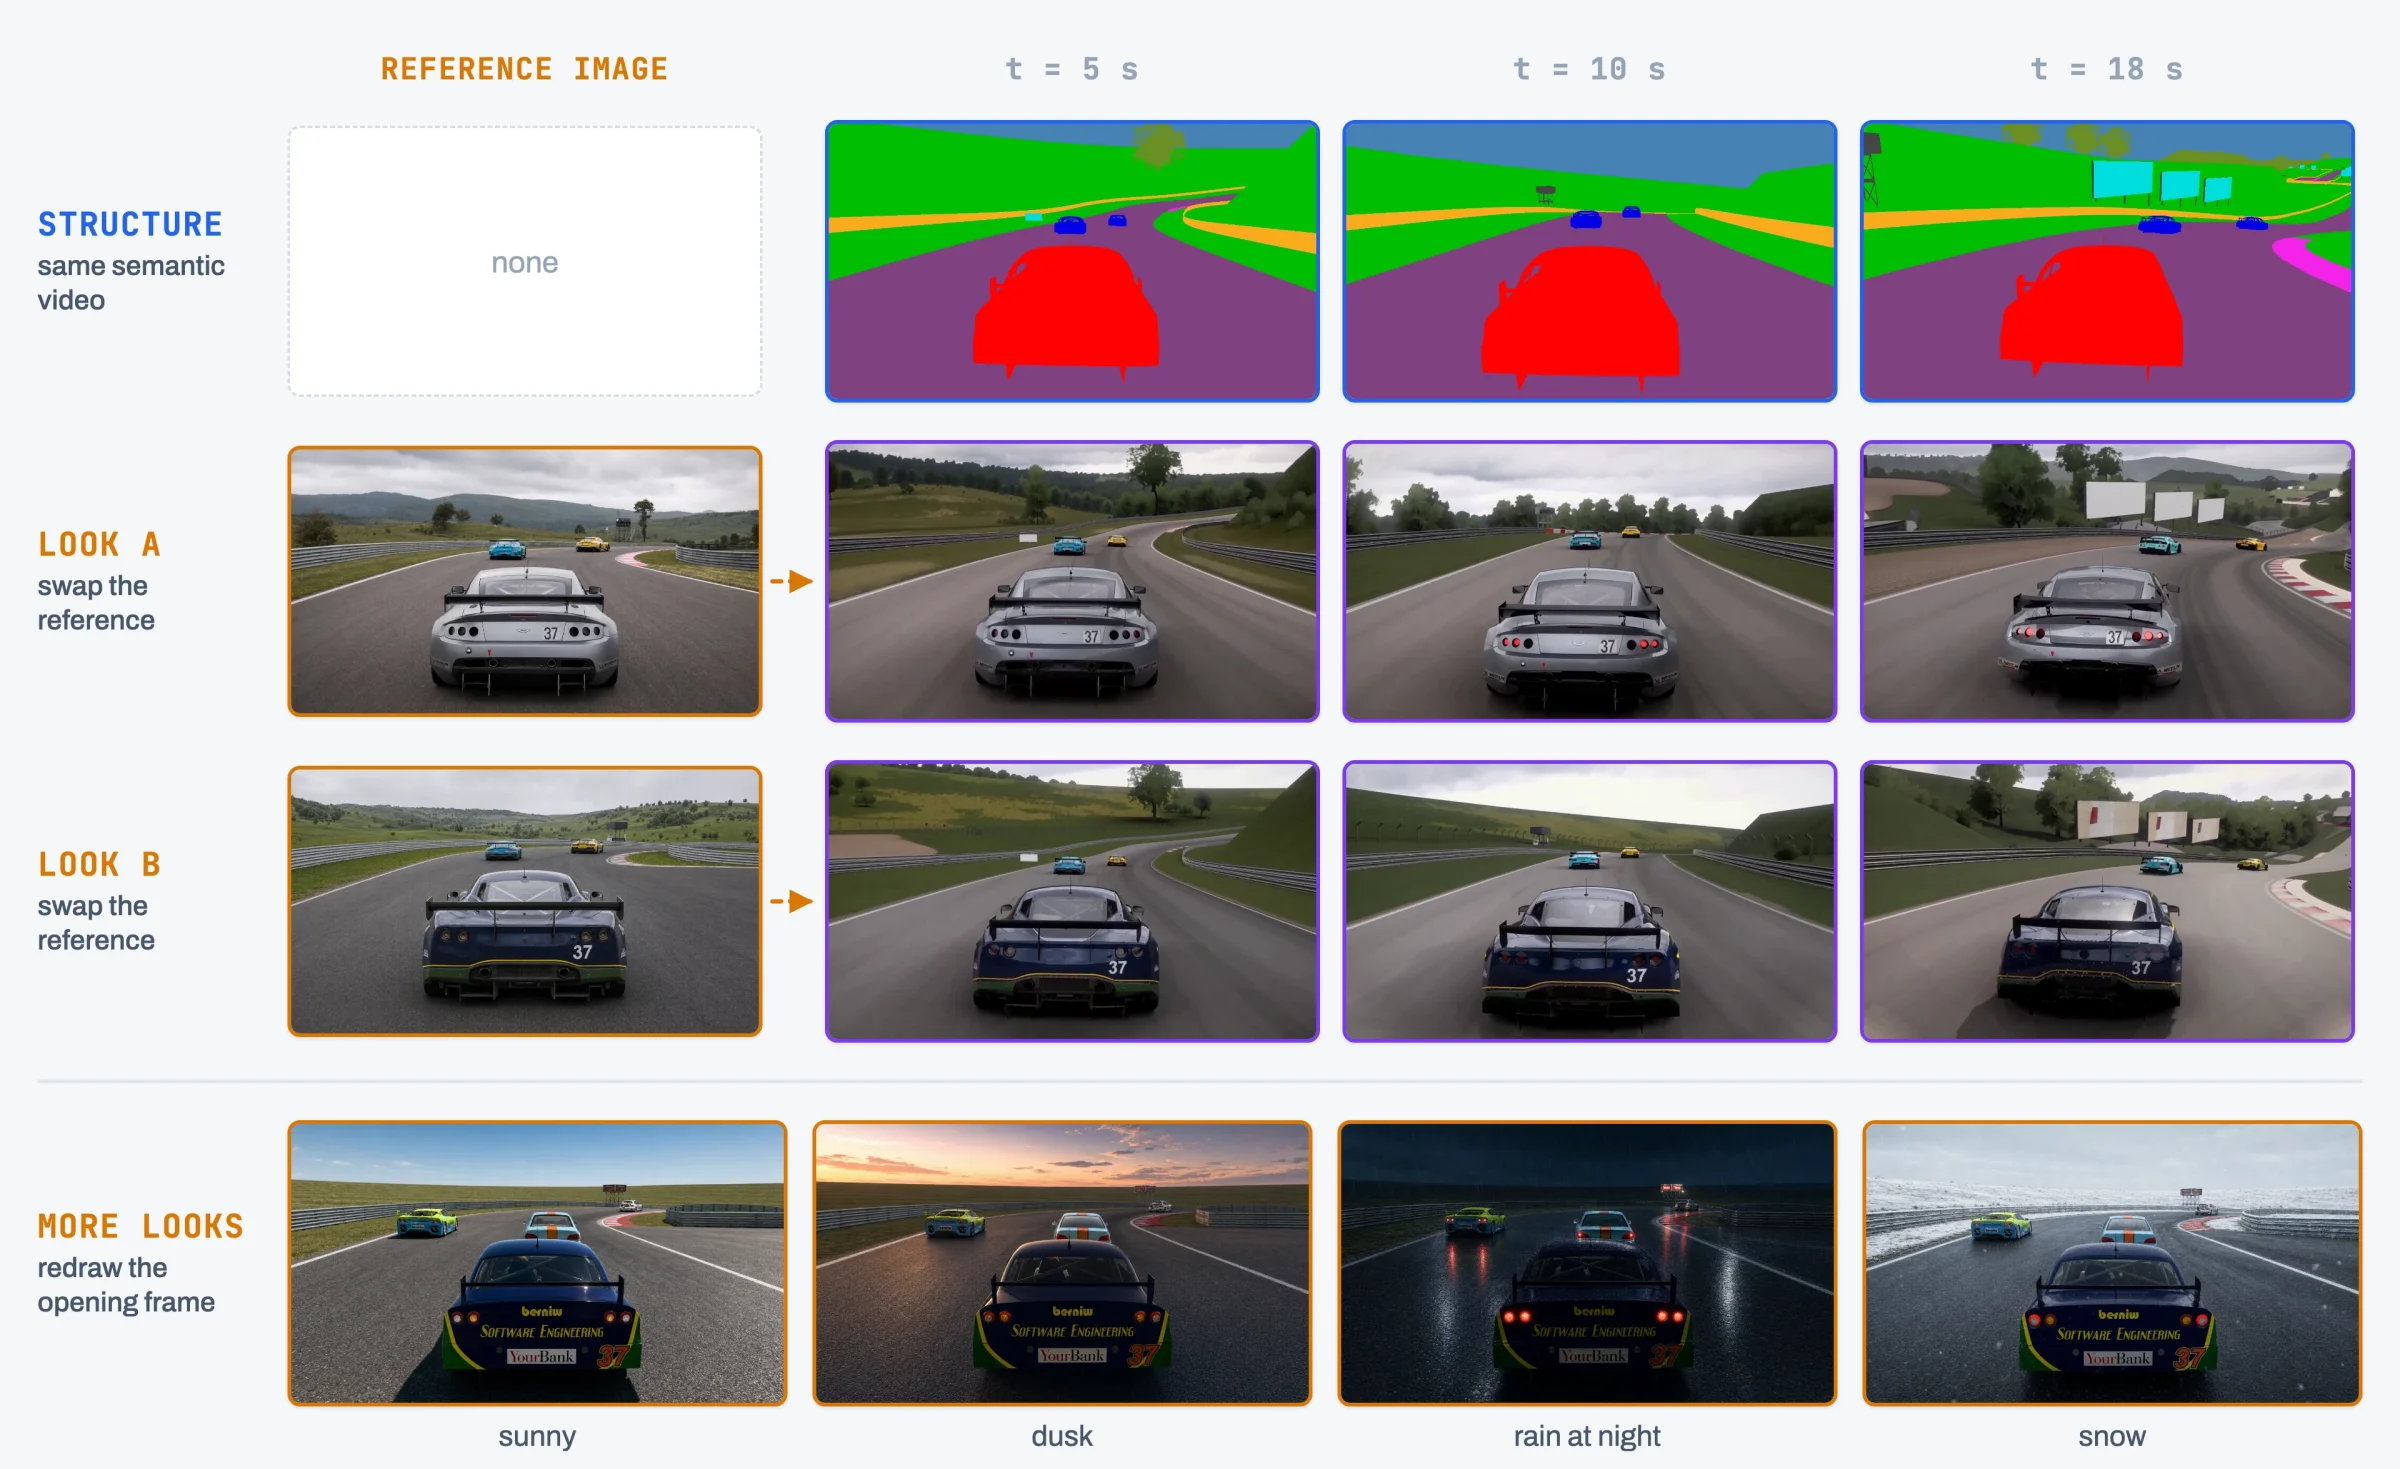
参考图像。图像生成模型将游戏的开场帧重新绘制为一张照片级真实的图片。重绘后的图片保留该帧的构图,包括相机视角、场景布局以及每个物体的位置,同时由它来选择材质、物体的颜色与标记、天气、光照以及整体风格。由于该图片与第一个语义帧对齐,图片中的每个物体都对应一个已知类别的区域,因此渲染器能够判断哪种外观属于哪个类别。只需改变给图像模型的指令,就能为同一开场帧生成不同的外观。
提示词。提示词遵循 MiniMax-H3 的结构化模板。它定义场景中的主体,并说明每个输入的哪些属性由哪个输入控制。每个主体的外观来自参考图像,而其轮廓、位置和运动以及相机路径则来自语义视频。在赛车演示中,提示词定义了三个主体,即玩家车辆、对手车辆以及赛道及其周边环境。提示词还说明了语义视频中每种颜色代表哪个物体类别,并描述了渲染风格、光照和声音。
替换参考图像和提示词即可改变同一游戏的外观,而引擎和语义流保持不变。
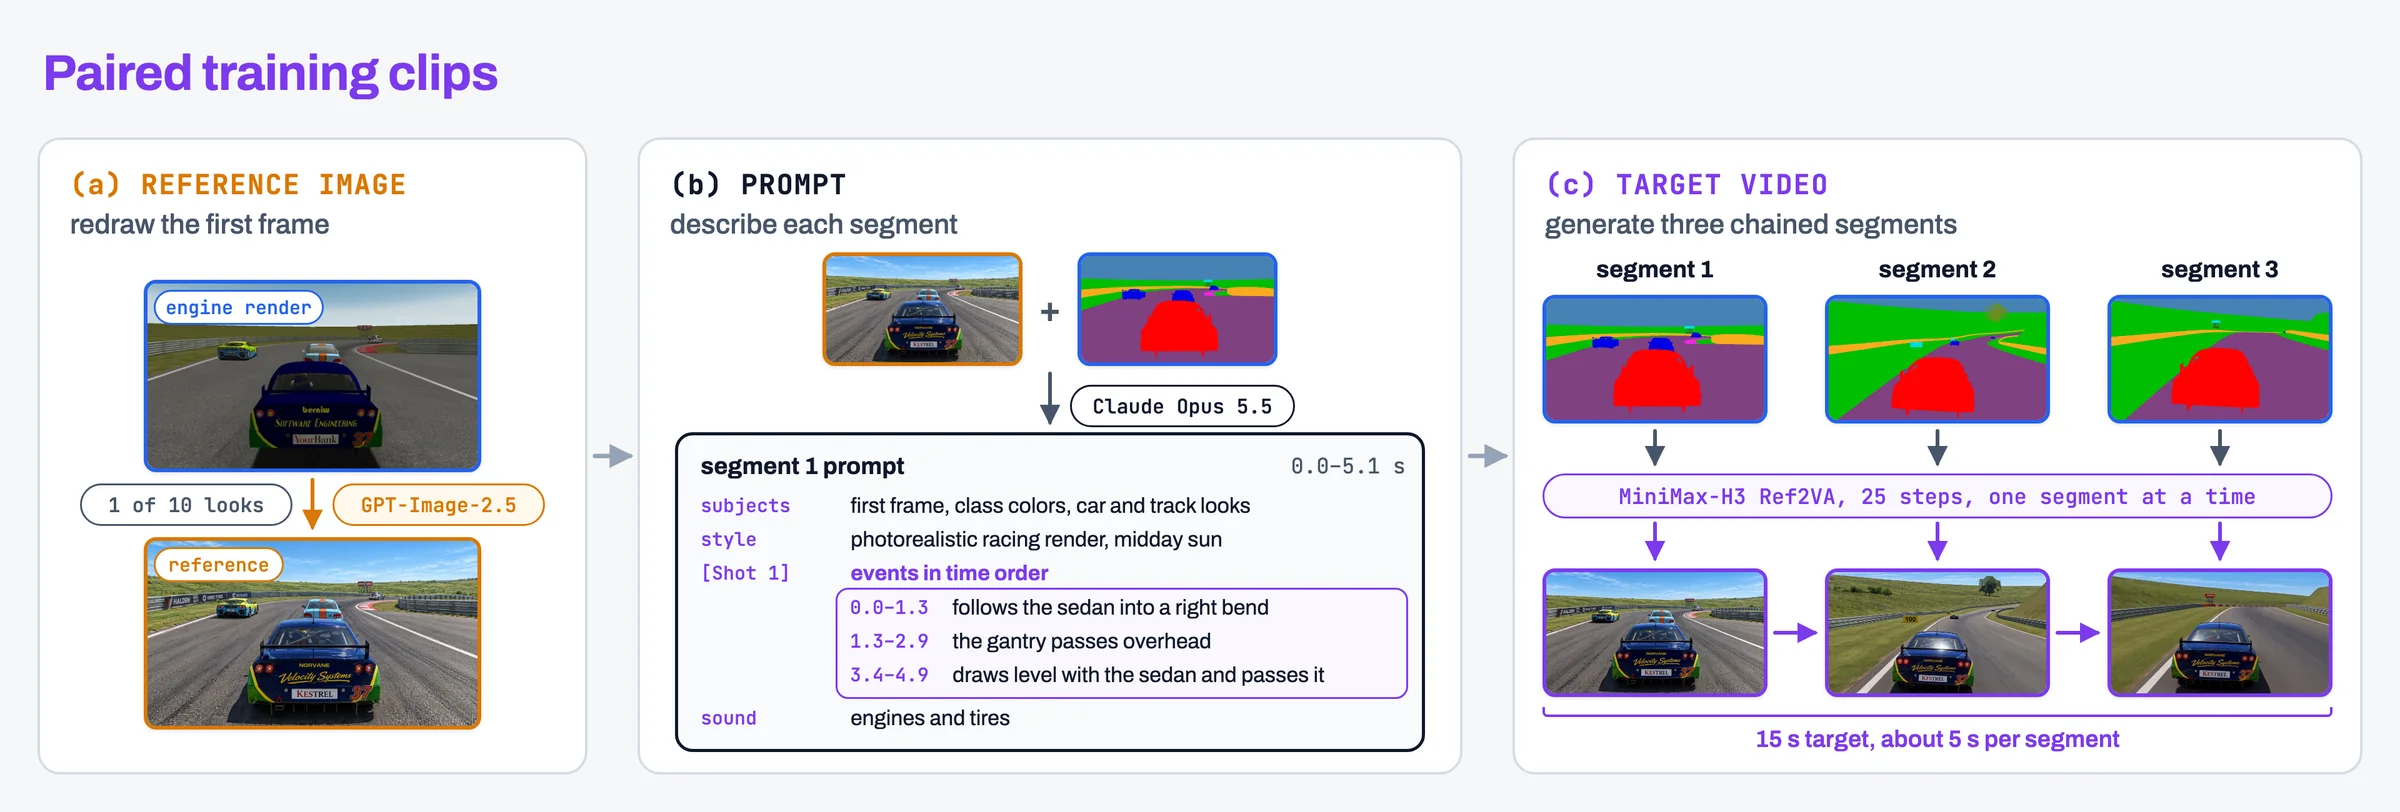
赛车场景中的训练数据。对于赛车演示,渲染器从 10,000 段成对的赛车游戏片段中学习这种分工,每段约 15 秒长。这些片段截取自 39 条赛道上的约 5,100 场录制比赛,赛道包括公路赛道、泥土赛道和椭圆形赛道。这些比赛中的每辆车都由 AI 车手驾驶,每场比赛有零到十五辆对手车辆,相机从后方跟随玩家车辆。对于每个片段,引擎以 1344×768 分辨率和每秒 24 帧记录其常规渲染结果和语义视频。每个片段随后获得三个条件和一个目标。
- 参考图像。 一个图像编辑模型(GPT-Image-2.5)将正常渲染的第一帧重绘为现代写实赛车游戏的截图。它保留摄像机、赛道、每辆车的位置和大小以及对手车辆的颜色,玩家车辆保留其涂装颜色和游戏中的编号。其他一切都被重新设计,细节丰富。诸如看台上的观众之类的精细细节,只添加到已经包含该类物体的区域,且不添加任何车辆。这些片段依次被分配十种光照效果,使每种效果覆盖 1,000 个片段。这些效果分别是:晴朗正午阳光、清晨阳光、黄金时刻、日落、蓝调时刻、阴天、碎云、夏季薄雾、晨雾,以及带有阳光光束的暴风云。
- 提示词。 一个 LLM 智能体(Claude Opus 5.5)准备参考图像和提示词。它观看正常渲染和语义视频,将第一帧发送给图像模型,并为目标的每个片段按照上述模板编写一条提示词。除了主体、风格和声音之外,每条提示词还按时间顺序用时间戳叙述其片段中的事件,例如玩家车辆何时进入弯道或超越对手。
- 目标视频。 原生 MiniMax-H3 Ref2VA 模型根据参考图像、语义视频和提示词,以 25 个去噪步骤生成写实目标。原生模型可以一次性生成完整的 15 秒片段,但我们发现大约五秒之后,生成的视频不再紧密跟随语义视频和参考图像。因此,每个 15 秒片段被生成为三个连续片段,每个约五秒,且每个片段从前一个片段的最后一帧开始。
第 3.1.2 节的预训练使用这些目标。第 3.1.3 节的 DMD 阶段从评论家而非目标中学习,因此它在不需要目标的更长录制上进行训练。在赛车场景中,这些是来自同一批录制比赛的 5,000 次 60 秒驾驶,每次都有其语义视频、参考图像和提示词。
3.1.2历史上下文与时间一致性
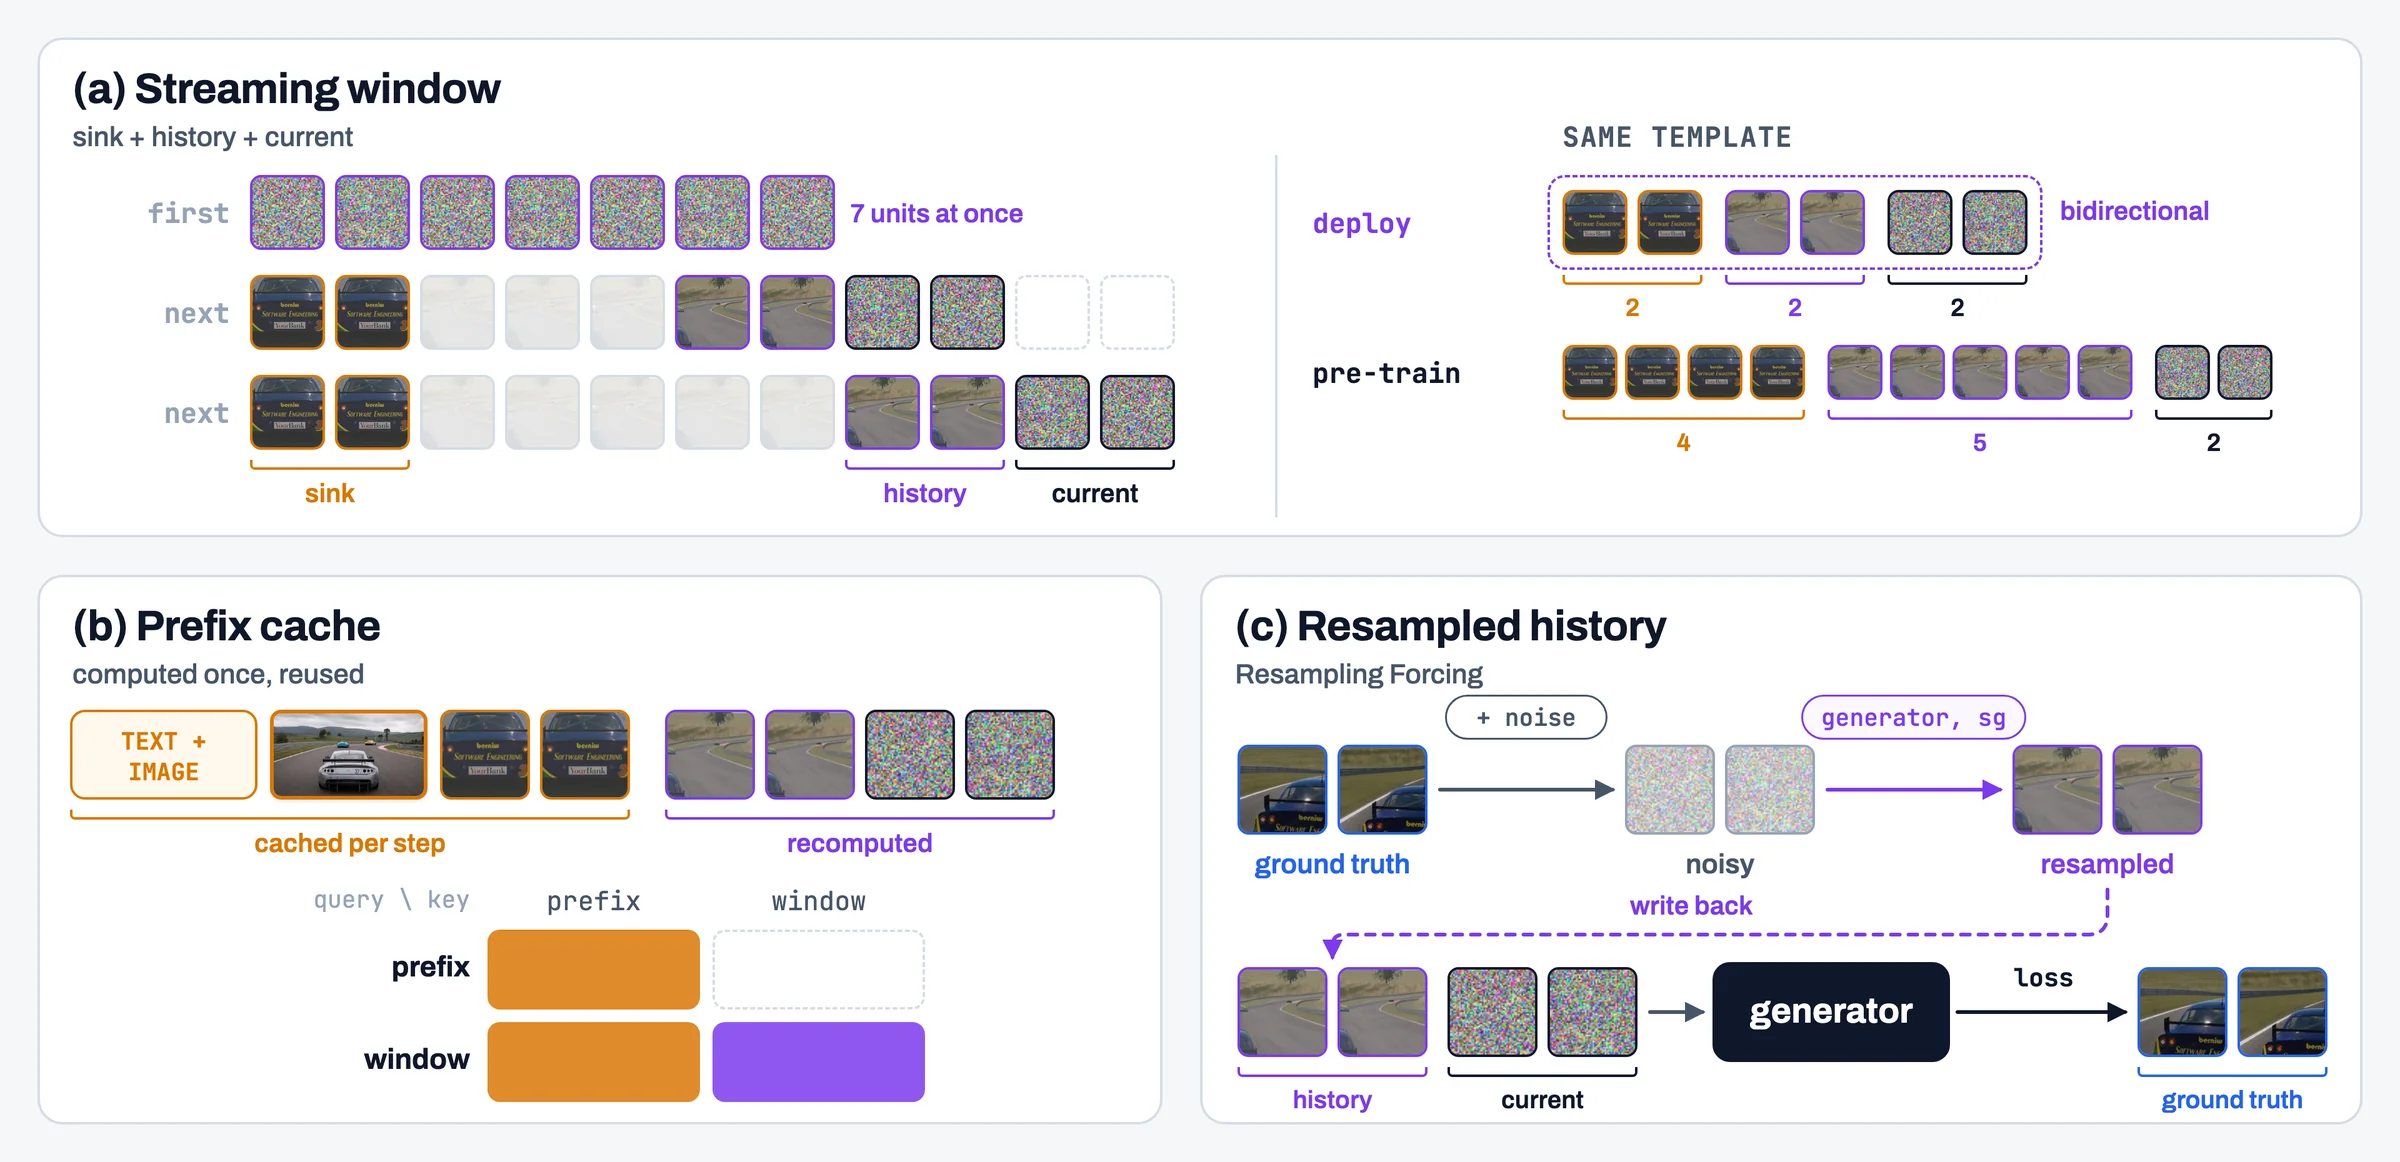
渲染器逐块生成视频,每个块都必须与之前的内容保持一致。遵循 LynnReal-Omni 的流式设计,我们在单个窗口中结合两种上下文对每个块进行去噪。第一种是 sink,即流的开头部分,在整个会话期间保留在每个窗口中。它锚定场景及其对象的身份,其精神与 StreamingLLM 的注意力 sink 和 LongLive 的帧 sink 相同。第二种是 近期历史,即紧接当前块之前生成的部分,它承载跨块边界的运动。窗口内的注意力是双向的。第一个之后的每个窗口都被映射到相同的位置模板上,因此流中较晚的窗口对生成器来说看起来与较早的窗口完全相同。
在竞速演示中,部署的生成器每个 chunk 产生两个调度单元,每个单元包含一或两个 latent 帧,并保留两个 sink 单元和两个近期历史单元。流的第一个窗口一次性生成七个单元,从而从一开始就为后续窗口提供完整上下文。在预训练期间,生成器使用更宽的窗口,包含四个 sink 单元和五个近期历史单元。
前缀缓存。 文本和图像条件、参考图像以及 sink 在第一次续写之后不再变化。因此我们将每个窗口拆分为固定前缀和移动部分,并让前缀只关注自身,而移动部分关注整个窗口。在推理时,前缀的键和值在每个去噪步骤中计算一次,并在之后的每个 chunk 中复用,因此只有近期历史和当前 chunk 会被重新计算(第 3.3 节)。第 3.1.3 节的 DMD 阶段使用相同的注意力掩码进行训练,并用当前权重重新计算前缀,因此生成器训练时所执行的计算与推理时完全一致。在预训练期间,每个窗口内的注意力是稠密的。
流式训练。 生成器从 MiniMax-H3 Ref2VA 开始,分三个阶段进行微调。先进行 Teacher forcing,然后进行 Resampling Forcing,将其预训练为普通的多步扩散模型,随后 DMD 训练它以两步生成每个 chunk,用于实时播放(第 3.1.3 节)。在竞速演示中,预训练使用第 3.1.1 节中的配对竞速片段。每个阶段都在与推理时具有相同 sink、近期历史和当前 chunk 布局的窗口上进行训练,各阶段的区别在于历史来自何处。Teacher forcing 从每个片段中采样一个窗口,并从真值中获取其历史。Resampling Forcing 和 DMD 则沿着流运行。每个训练片段形成由连续窗口组成的流。每个训练步骤处理每个流的一个窗口,该窗口的输出被写回作为下一个窗口的历史,由后续步骤处理。Resampling Forcing 写回真值的重采样版本,如下所述,而 DMD 写回生成器自身产生的 chunk(第 3.1.3 节)。
Resampling Forcing。 在 teacher forcing 之后,生成器只见过真值历史。然而在推理时,其上下文是自身不完美的输出,其误差会沿着流累积。我们用 Resampling Forcing 的重采样操作来弥合这一差距。Resampling Forcing 端到端地训练因果自回归视频模型,并使用自重采样使其暴露于历史帧上的自身误差。我们的生成器在每个窗口内保持双向注意力,因此我们只借用重采样本身,并将其应用于每个窗口的历史。对于每个流,从偏移的 logit-normal 分布中抽取一个噪声水平。在每个窗口,真值 chunk 被加噪到该水平,并由生成器自身在不带梯度的情况下重采样,写回作为历史的是这个重采样后的 chunk,而不是真值。当前 chunk 在以重采样历史为条件的同时,针对真值进行训练,因此生成器学会从包含自身误差的上下文中继续。
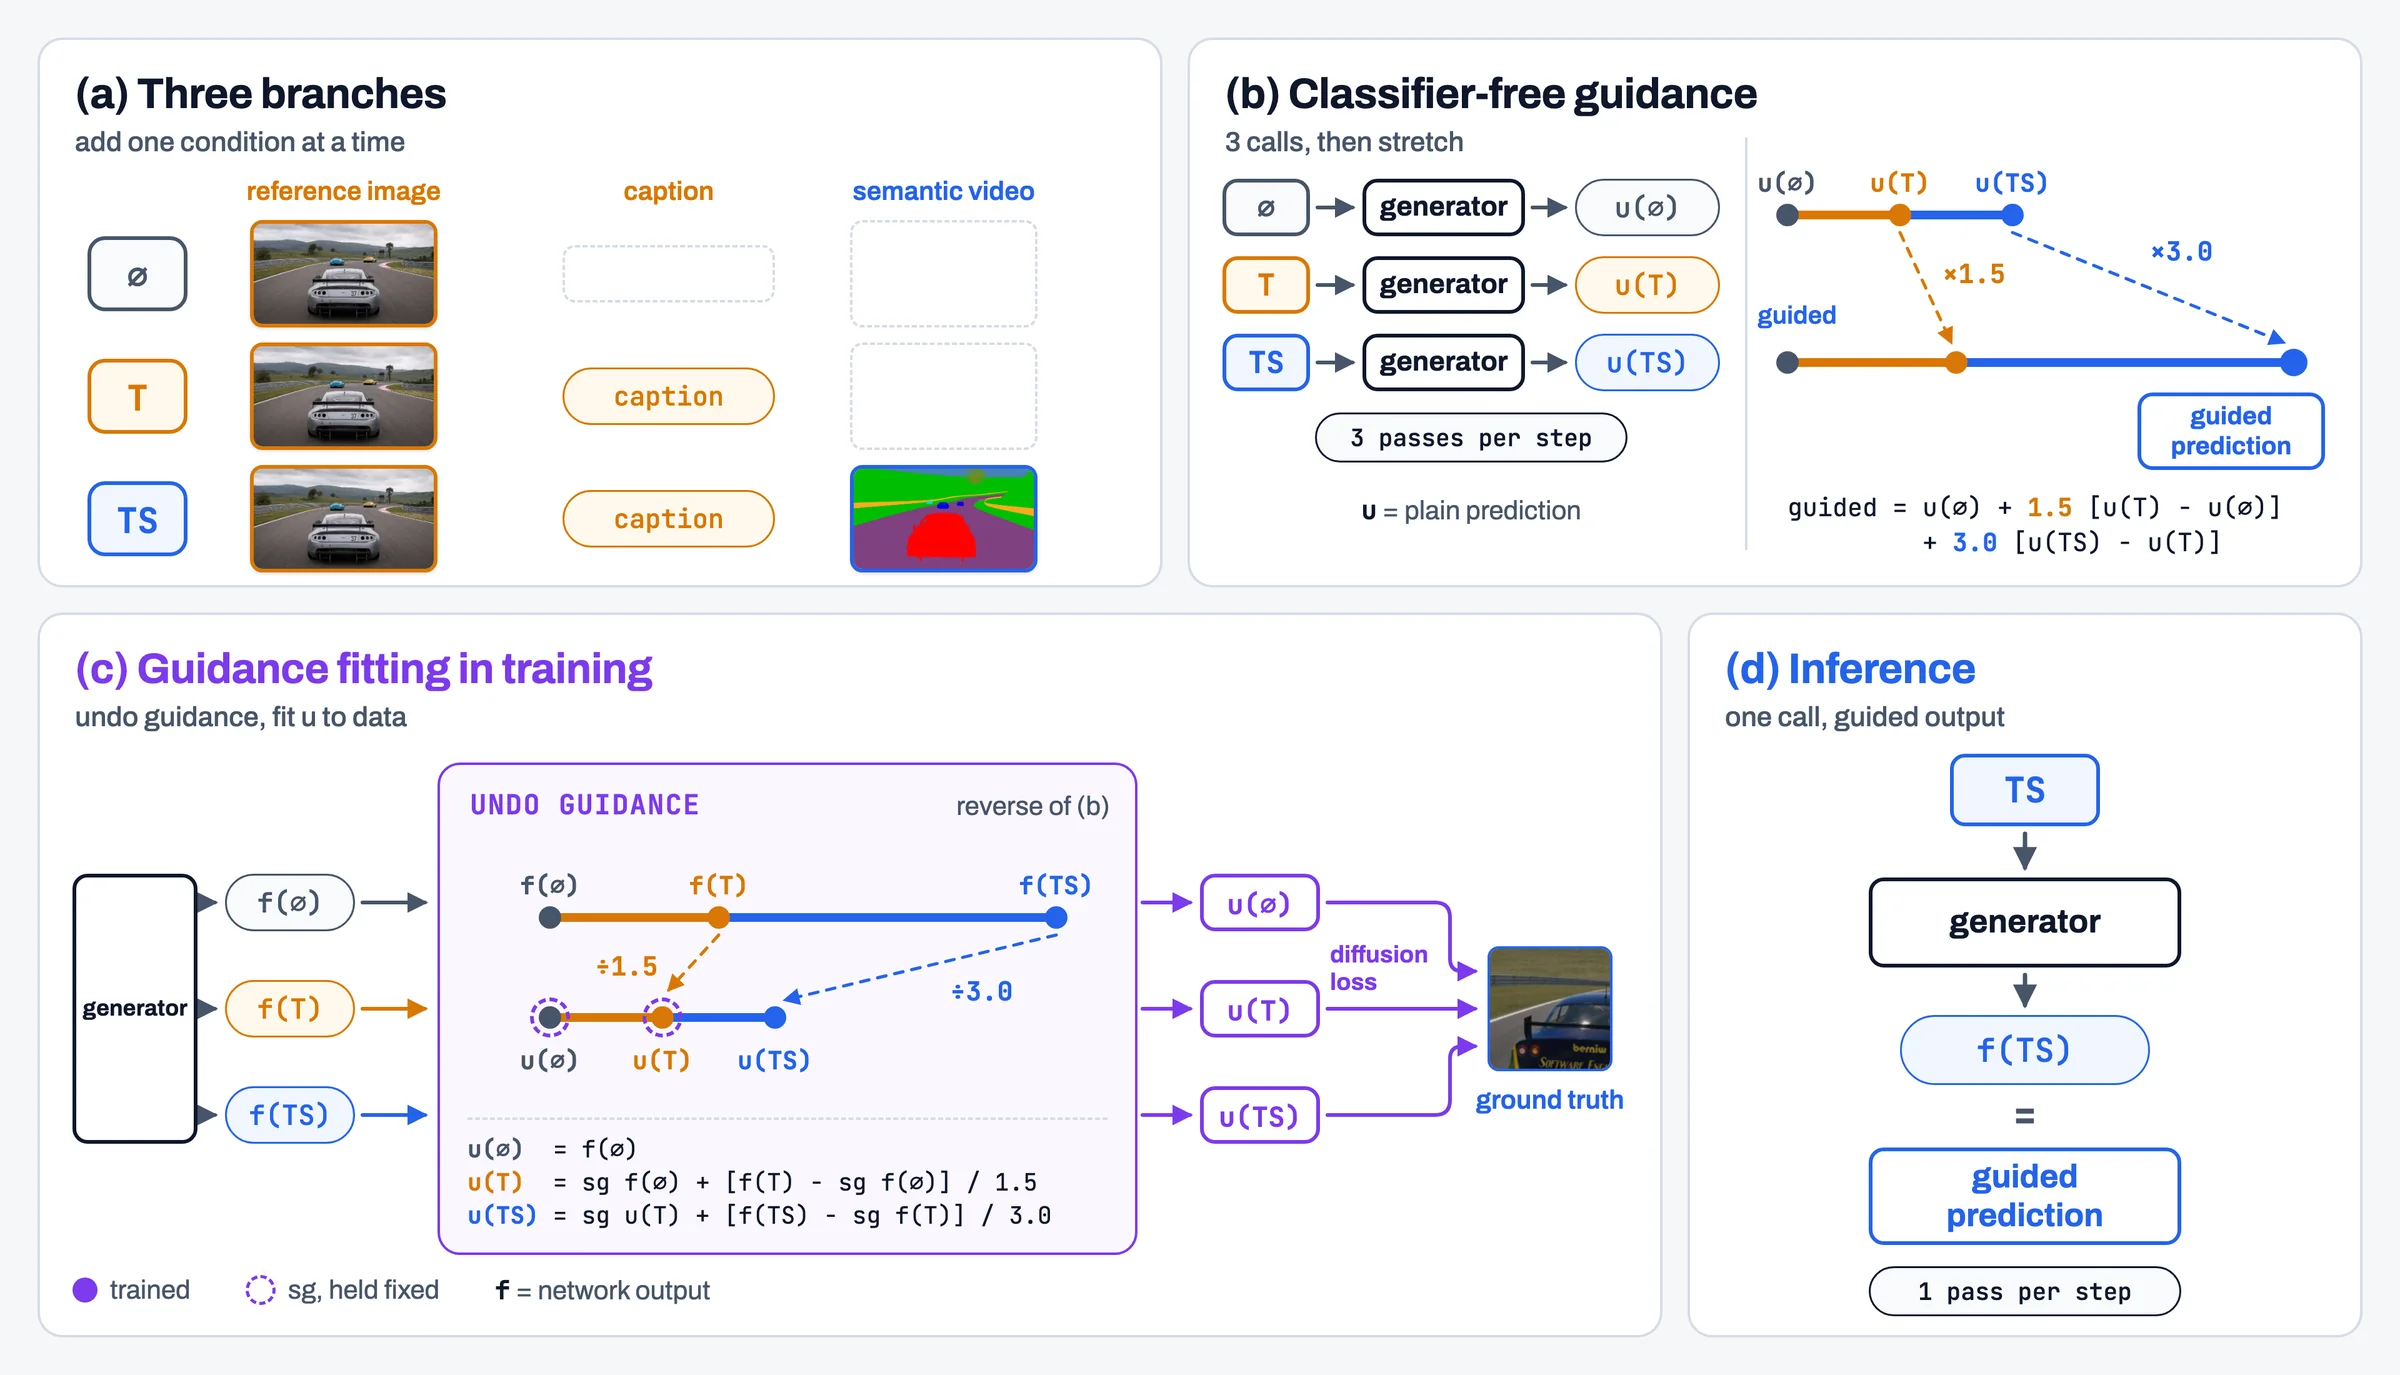
将引导融入生成器。 发布的 MiniMax-H3 检查点是引导蒸馏的,因此每个去噪步骤只需一次前向传播即可采样。然而,要紧密跟随语义视频,还需要对结构条件进行引导,而针对字幕和语义视频的无分类器引导每步需要三次前向传播。LynnReal-Omni 通过将引导训练进模型来避免这一开销。它将模型的条件预测与停止梯度的无字幕预测相结合,并将该组合拟合到数据,使得在收敛时仅条件预测就等于引导预测。LynnReal-Omni 在字幕上拟合单步引导。我们将此方法扩展到结构控制,使用三分支链。分支 ∅ 既不接收字幕也不接收语义视频,分支 T 添加字幕,分支 TS 添加语义视频,而参考图像存在于每个分支中。沿此链的无分类器引导从普通条件预测 u(∅)、u(T) 和 u(TS) 开始。它将字幕步从 u(∅) 拉伸到 u(T) 的 1.5 倍,将结构步从 u(T) 拉伸到 u(TS) 的 3.0 倍,这是赛车演示的设置。引导拟合反向运行此链。我们将网络的原始输出 f(∅)、f(T) 和 f(TS) 视为引导预测,并通过按比例缩小每一步来撤销引导,得到 u(∅) = f(∅)、u(T) = f(∅) + [f(T) − f(∅)] / 1.5,以及 u(TS) = u(T) + [f(TS) − f(T)] / 3.0。每一步的起点通过停止梯度保持固定,因此 u(T) = (2 f(T) + sg f(∅)) / 3 且 u(TS) = (f(TS) + sg f(T) + sg f(∅)) / 3,并且每个 u 都使用普通扩散损失针对数据进行训练。一旦每个 u 与普通条件预测匹配,对 u 应用引导就返回 f,因此单次调用 f(TS) 即可得到引导预测。将最强的引导放在添加语义视频的步骤上,可使生成视频的布局、物体和相机与引擎状态保持一致。生成器在同一预训练运行中与 Resampling Forcing 一起学习引导拟合,因此其每个去噪步骤只需一次前向传播。
3.1.3两步蒸馏与自回归流式生成
即使拟合了引导,预训练生成器对于实时游玩来说仍然太慢。在赛车演示中,它用 16 个去噪步骤采样每个块,而实时游玩只留下不到一秒的时间来生成一个块。因此,我们继续用 DMD 训练它,使其在两步内生成每个块,同时继续自己的流。
两步生成。 在赛车演示中,生成器用两个去噪步骤生成每个块,首先从纯噪声到中间噪声水平,然后到干净的块,并在块与块之间使用第 3.1.2 节的窗口和前缀缓存从自己的输出块继续。其窗口包含两个汇单元、两个历史单元和两个当前单元,比预训练中使用的窗口更小,这使每一步开销低廉。它像 Resampling Forcing 一样沿流训练,但没有任何真实数据。在赛车演示中,其每个训练流覆盖 60 秒驾驶的前 30 秒(第 3.1.1 节)。
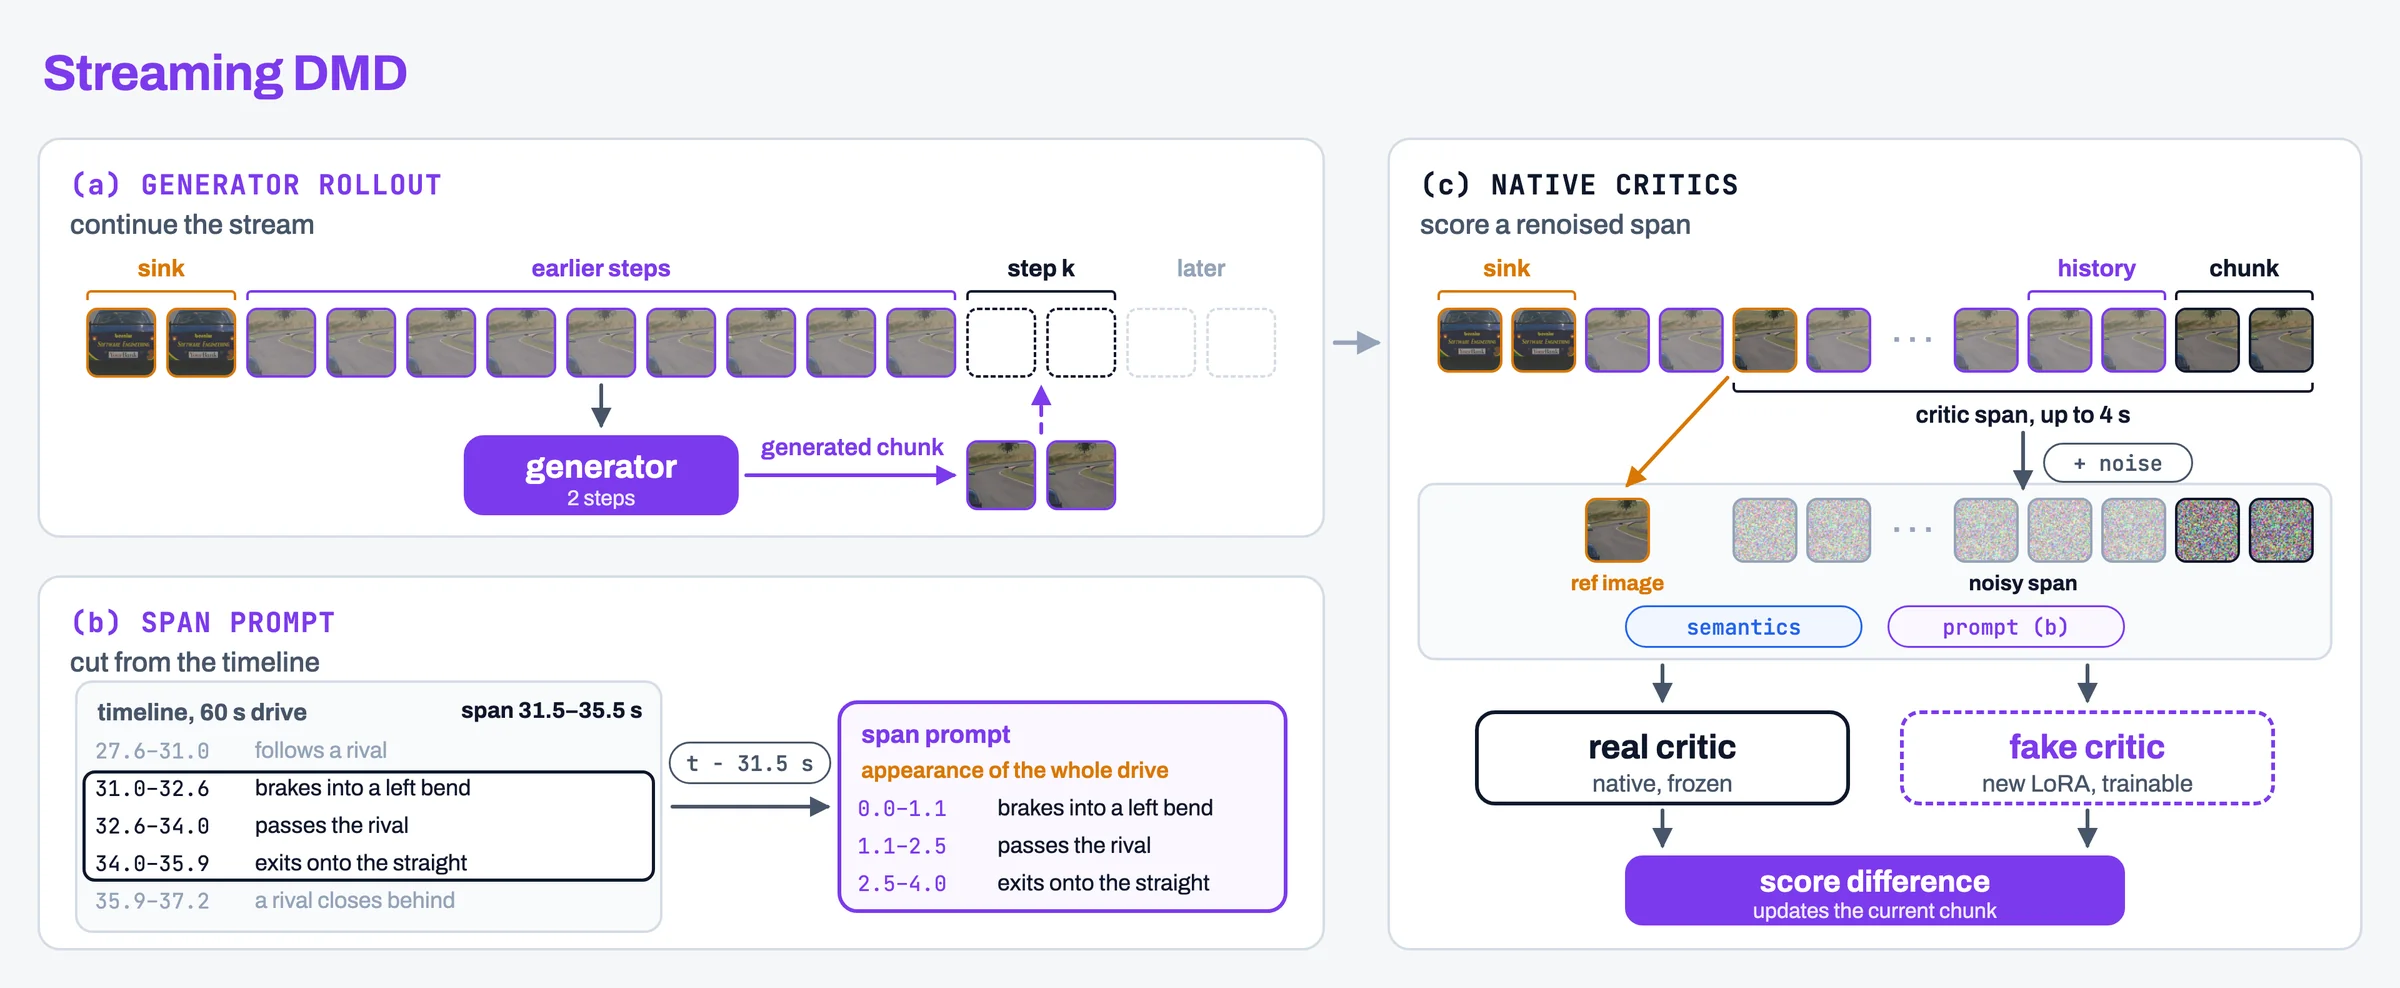
流式分布匹配蒸馏。我们使用分布匹配蒸馏(DMD、DMD2)训练生成器。一个冻结的真实评论器代表生成器应达到的分布,一个可训练的虚假评论器追踪生成器当前产生的分布。二者对重新加噪的生成片段给出的分数之差,告诉生成器如何向真实评论器靠拢。与 Self Forcing 一样,生成器是在自己的 rollout 上训练,而非在真值上训练。按照 3.1.2 节的流式训练,每一步都从生成器自己更早的输出生成每条流的当前窗口,仅在该片段上计算损失,并将生成的片段写回,使下一步继续同一条流。因此,后续窗口的历史是由生成器更早的版本生成的,没有梯度流入其中。这与 LongLive 的流式长时微调思路相同,后者从上一轮迭代扩展片段,并仅对新生成的部分应用 DMD。然而,我们的流每一步前进一个片段,而不是前进数秒。
短跨度上的评论器。两个评论器都是原生的双向 MiniMax-H3 Ref2VA,各自对 rollout 中一段以当前片段结尾的短连续跨度打分。跨度起始处的 rollout 帧作为参考图像,同一跨度的语义视频作为参考视频。在赛车演示中,一个跨度最多包含 29 个潜帧,约四秒。真实评论器就是已发布的模型本身,冻结且不带适配器。已发布的检查点经过引导蒸馏,因此单次前向传播即可给出其预测。虚假评论器从相同的已发布权重出发,配以全新的 LoRA,在生成的跨度上以 3.0 和 4.0 的尺度进行 3.1.2 节的引导拟合训练,并用其普通条件预测 u(TS) 打分。因此,DMD 使生成器向已发布模型对每个跨度所生成的结果靠拢。虚假评论器在整个跨度上学习,而生成器仅通过其当前片段被更新。
从时间线上截取的提示词。每个 critic 看到的是长驾驶过程中不同的几秒,因此它的提示词必须精确描述那一段。仅用笼统的措辞描述整段驾驶是不够的。我们发现,如果不用时间戳描述该时间段的动作,模型就不知道参考图像在时间线上属于哪里,有时甚至会把语义视频反向渲染。在提示词中描述玩家车辆的外观也能保持其颜色正确。因此,我们对每段 60 秒的驾驶都标注一次时间线。在赛车演示中,运行 GPT-6.1 Sol 的 agent 会同时观看语义视频和两张每四分之一秒采样的表格——引擎记录的玩家车辆的速度、加速度和偏航率,以及语义视频中每辆车的位置和大小。它还会看到重绘的第一帧和该驾驶段早先的通用提示词,并从中获取车辆和赛道的外观。它写出每辆车和赛道的外观(适用于整段驾驶)、描述路线的 2 到 10 秒阶段、带绝对时间戳的 0.3 到 2.5 秒事件,以及每半秒的场景状态。对于每个评分时间段,落入其中的事件被截取出来并平移到该时间段的时钟上,然后与外观、与该时间段重叠的阶段以及其起点和终点的状态一起,按照 3.1.1 节的模板组装成提示词。生成器在整个会话中保持其单一提示词不变,因此 3.1.2 节的前缀缓存仍然适用。
3.2快速因果 H3 VAE:用 Agent 循环自我改进流式解码器
流式渲染产生 latent,解码器将其转换为玩家看到的帧。在交互循环中,每个新的 latent 帧必须立即变成像素,且只能使用已经生成的内容。已发布的 H3 VAE 解码器能提供最佳图像质量,但它是为离线视频构建的。它是一个 36 层 Transformer,拥有 2.42B 参数,依赖两种重叠。空间分块将每帧切成 256 像素的块,块之间至少重叠 64 像素并混合接缝,因此在 720p 下它解码 28 个块,每个像素大约计算两次。带重叠的时间分块一次解码五个 latent 帧(17 个视频帧)以及接下来的两个 latent 帧,因此它会等待尚不存在的 latent 帧,并且每个 latent 帧要计算 1.4 次。在 720p 下,它每五个 latent 帧的块需要约 870 毫秒。像 TAE 这样的小型流式解码器运行时间约为 10 毫秒,但在我们的流式运行中,相对于完整 VAE 它仅达到 27 dB PSNR,保留了 80% 的精细细节,并且使草地、植被和道路纹理逐帧闪烁。
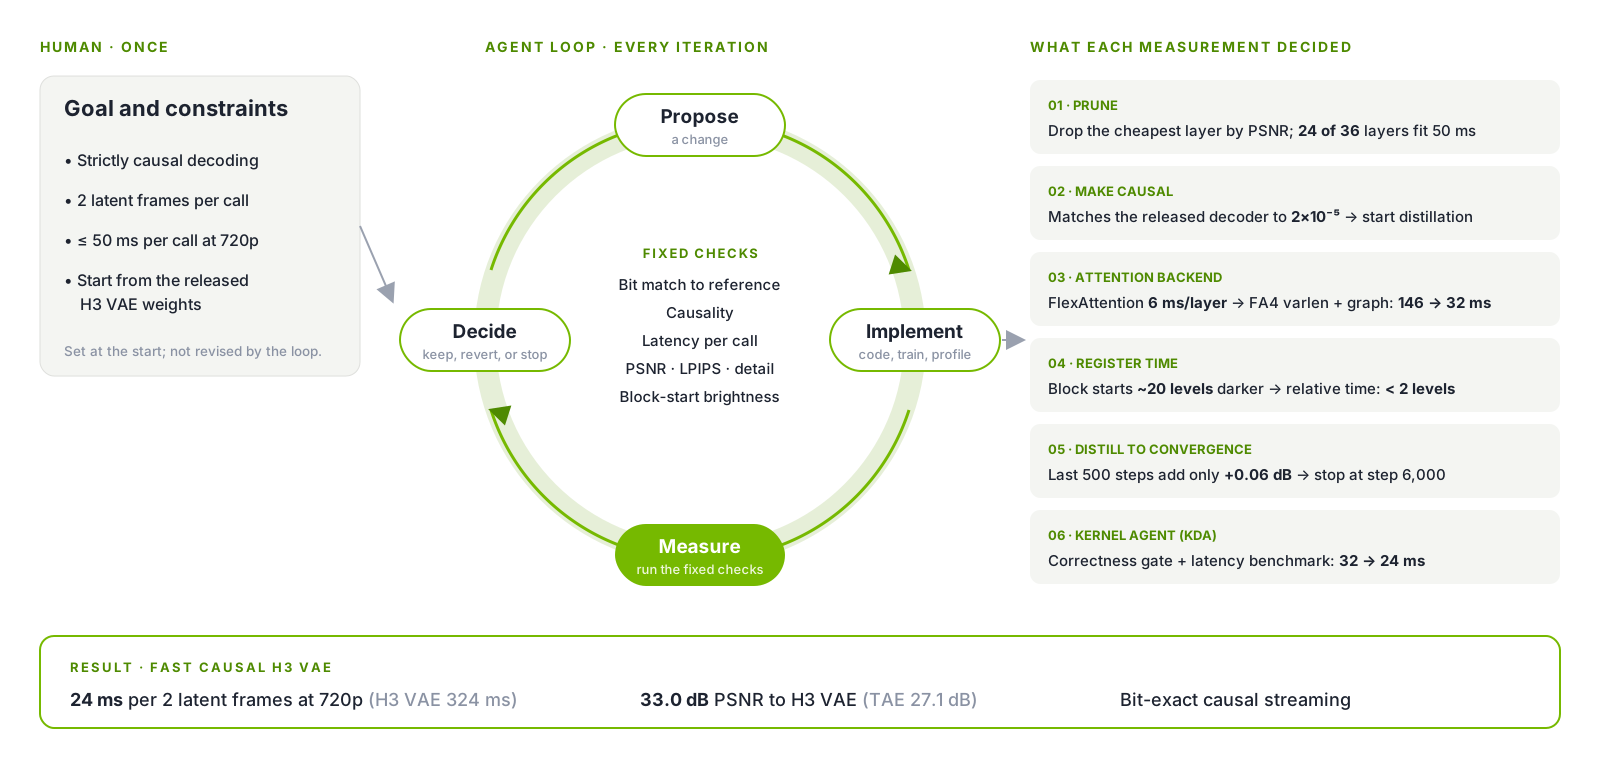
由循环构建的解码器。 我们并没有手工设计这个新解码器。我们给一个编码智能体(Claude Code)设定了一个目标和四项约束:严格因果解码、每次调用处理两个潜帧、在 720p 下每次调用不超过 50 毫秒,并从已发布的 H3 VAE 权重出发。此后工作便以循环方式运行。在每一轮迭代中,智能体提出一项改动、实现它,并运行相同的检查:与参考解码器对比、通过扰动未来潜帧来验证因果性、解码延迟,以及相对于 H3 VAE 的 PSNR、LPIPS 和细节表现。这些数字决定了一项改动是保留、回退,还是终止搜索。目标设定约三小时后,因果解码器已在流式管线中运行,随后蒸馏继续进行直至收敛。以下段落按迭代顺序展开。
迭代 1:剪枝以适配预算。 智能体在不重新训练的情况下贪心地移除层。在每个深度上,它移除使重建 PSNR 损失最小的那一层,并对结果计时。36 层中有 24 层在 720p 和 540p 下满足 50 毫秒预算,因此搜索就此停止。保留的层为 0–17、19–21、31、32 和 35,并保留其原始权重,这使解码器达到 1.62B 参数。
迭代 2:使其因果化,然后在训练前检查。 智能体重写了解码器看待时间和空间的方式。
- 时间。 DiT 每轮输出两个或三个潜帧,因此解码器以两个潜帧为一个块进行处理。每个块在每一层中关注自身的两个潜帧以及前四个潜帧的缓存键和值,约 0.7 秒视频,并且从不关注更晚的潜帧。每次调用返回八帧视频。当一个块包含原生五潜帧块中的第一个潜帧时,该潜帧产生一帧视频,与已发布的 VAE 完全一致,因此该流仍能每五个潜帧产生 17 帧视频。上下文来自缓存的过去潜帧,而不是重新计算的未来潜帧,因此每个潜帧只计算一次。
- 空间。 空间分块被移除。注意力在 16×16 个 token 的非重叠窗口内运行,这些窗口覆盖与一个分块相同的 256 像素,并且每隔一层将窗口偏移半个窗口,使相邻窗口在网络内部交换信息。每个像素只计算一次,无需接缝混合。空间位置相对于窗口进行编码,与已发布的分块解码一致。
在任何训练之前,重写后的解码器以非因果参考模式运行,并与已发布的解码器进行比较。两者匹配到 2×10⁻⁵ 以内,因此重写本身没有引入误差,蒸馏可以开始。
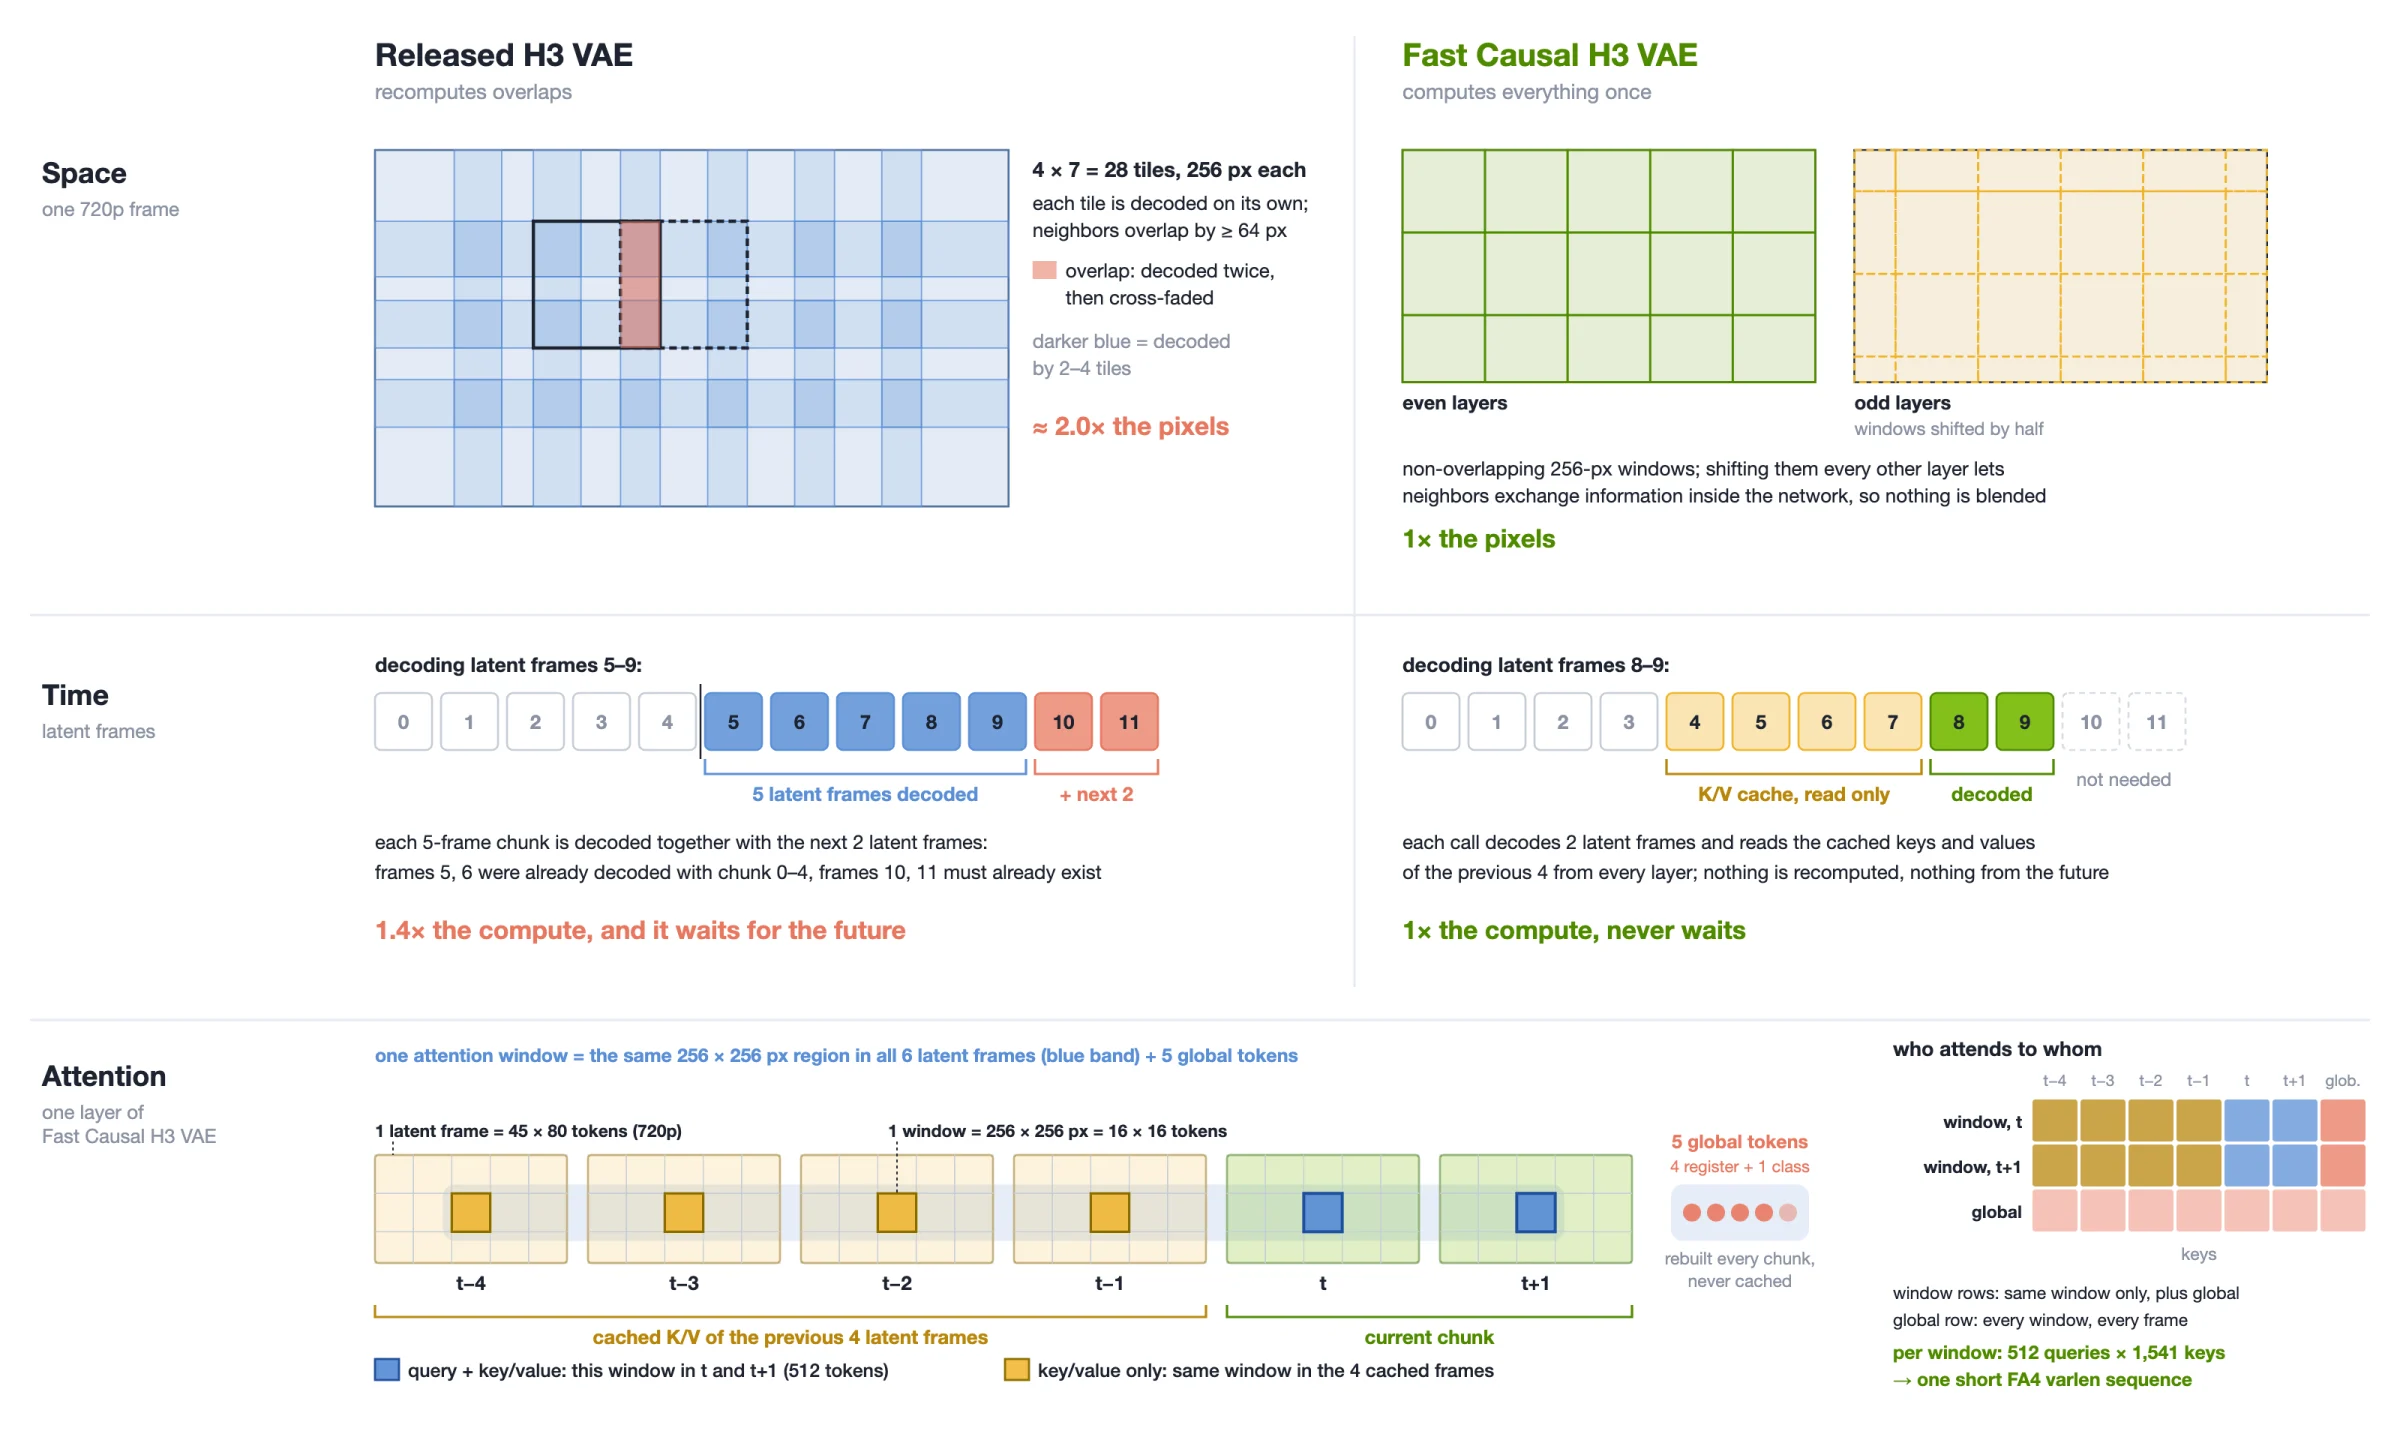
迭代 3:测量时间花在哪里。 在 PyTorch 中朴素运行,模型在 720p 下每两个潜帧需要 146 ms,是预算的三倍。性能分析显示,矩阵乘法只占其中约 15 ms。其余时间花在复制缓存和重新划分窗口(36 ms)、在慢速内核上做掩码注意力(30 ms),以及许多小的逐元素内核(30 ms)上,包括每次调用时将所有权重从 fp32 转换为 bf16。每一项测量到的开销都成为下一次改动,而这些改动都不改变计算:
- 线性层权重一次性以 bf16 存储,而不是每次调用时转换。残差流保持 fp32,与训练时一致。
- 键值缓存按窗口保存在预分配的环形缓冲区中。每个新的潜帧只接收一次旋转位置,并就地写入其槽位,因此缓存永远不会被拼接或重新划分。
- 将 token 划分到窗口以及将它们合并回来变成单次索引收集,由
torch.compile与归一化和旋转嵌入融合。 - 注意力后端在实际形状上计时。带块掩码的 FlexAttention 每层需要 6 ms,在 24 层上超过整个预算,因此窗口注意力改为通过 FlashAttention-4 的变长接口运行。每个窗口是一个短序列,约 512 个查询对 1,541 个键,填充位置被排除在打包数组之外,
seqused_k隐藏流开始时仍为空的缓存槽,因此不需要掩码。 - 每个块具有相同的形状,因此整个块被一次性捕获为 CUDA 图并重放,从而消除了内核启动开销(37 ms → 32 ms)。
迭代 4:平均值遗漏的失败。 解码器带有四个寄存器 token 和一个类 token,它们关注整个帧。它们为每个块重建且从不缓存,因此无法从后续块向后传递信息。在发布的解码器中,这些 token 没有时间位置,这在那里是无害的:每个时间块独立解码,其帧从 0 开始编号,因此帧 token 与寄存器 token 之间的注意力只会看到相同的几个时间位置。因果解码器无法重新编号其帧,因为缓存的键必须保持计算时使用的位置,所以帧 token 采用流的绝对潜帧索引。第一个版本保留了没有时间位置的寄存器 token,因此它们对帧 token 的注意力取决于绝对时间。训练片段包含十个潜帧,从第十一个潜帧开始,每五个潜帧块的第一个视频帧变暗约 20 个灰度级。平均指标没有显示这一点;当我们观看解码流时它出现了。给寄存器 token 赋予其块的时间位置,使每个注意力分数只取决于时间差,差距降至两个灰度级以下。这次迭代产生了两个检查:逐帧测量块起始亮度,以及从不同的流时钟解码相同的潜帧。现在无论时钟从 0、100 还是 1000 开始,输出都相同。
迭代 5:蒸馏至收敛。教师模型是对相同潜变量进行完整 H3 VAE 解码的结果。学生模型使用与部署时相同的代码逐块解码,在三个五潜帧块(51 个视频帧,384×384 裁剪)的片段上进行,因此它既会遇到空缓存的块起始,也会遇到满缓存的块起始。损失函数结合了 L1、LPIPS(权重 1.0)、帧差项(权重 1.0,在潜变量边界处三倍加权)以及边缘项(权重 0.1)。训练使用八块 GPU 和 AdamW,学习率为 2×10⁻⁵,在最后 3,500 步中按余弦调度衰减至 10⁻⁶。训练在第 6,000 步停止,此时最后 500 步在评估用例上仅将 PSNR 提升了 0.06 dB。作为因果性的检验,改变任何未来的潜帧都不会使任何更早的输出帧发生逐位变化。
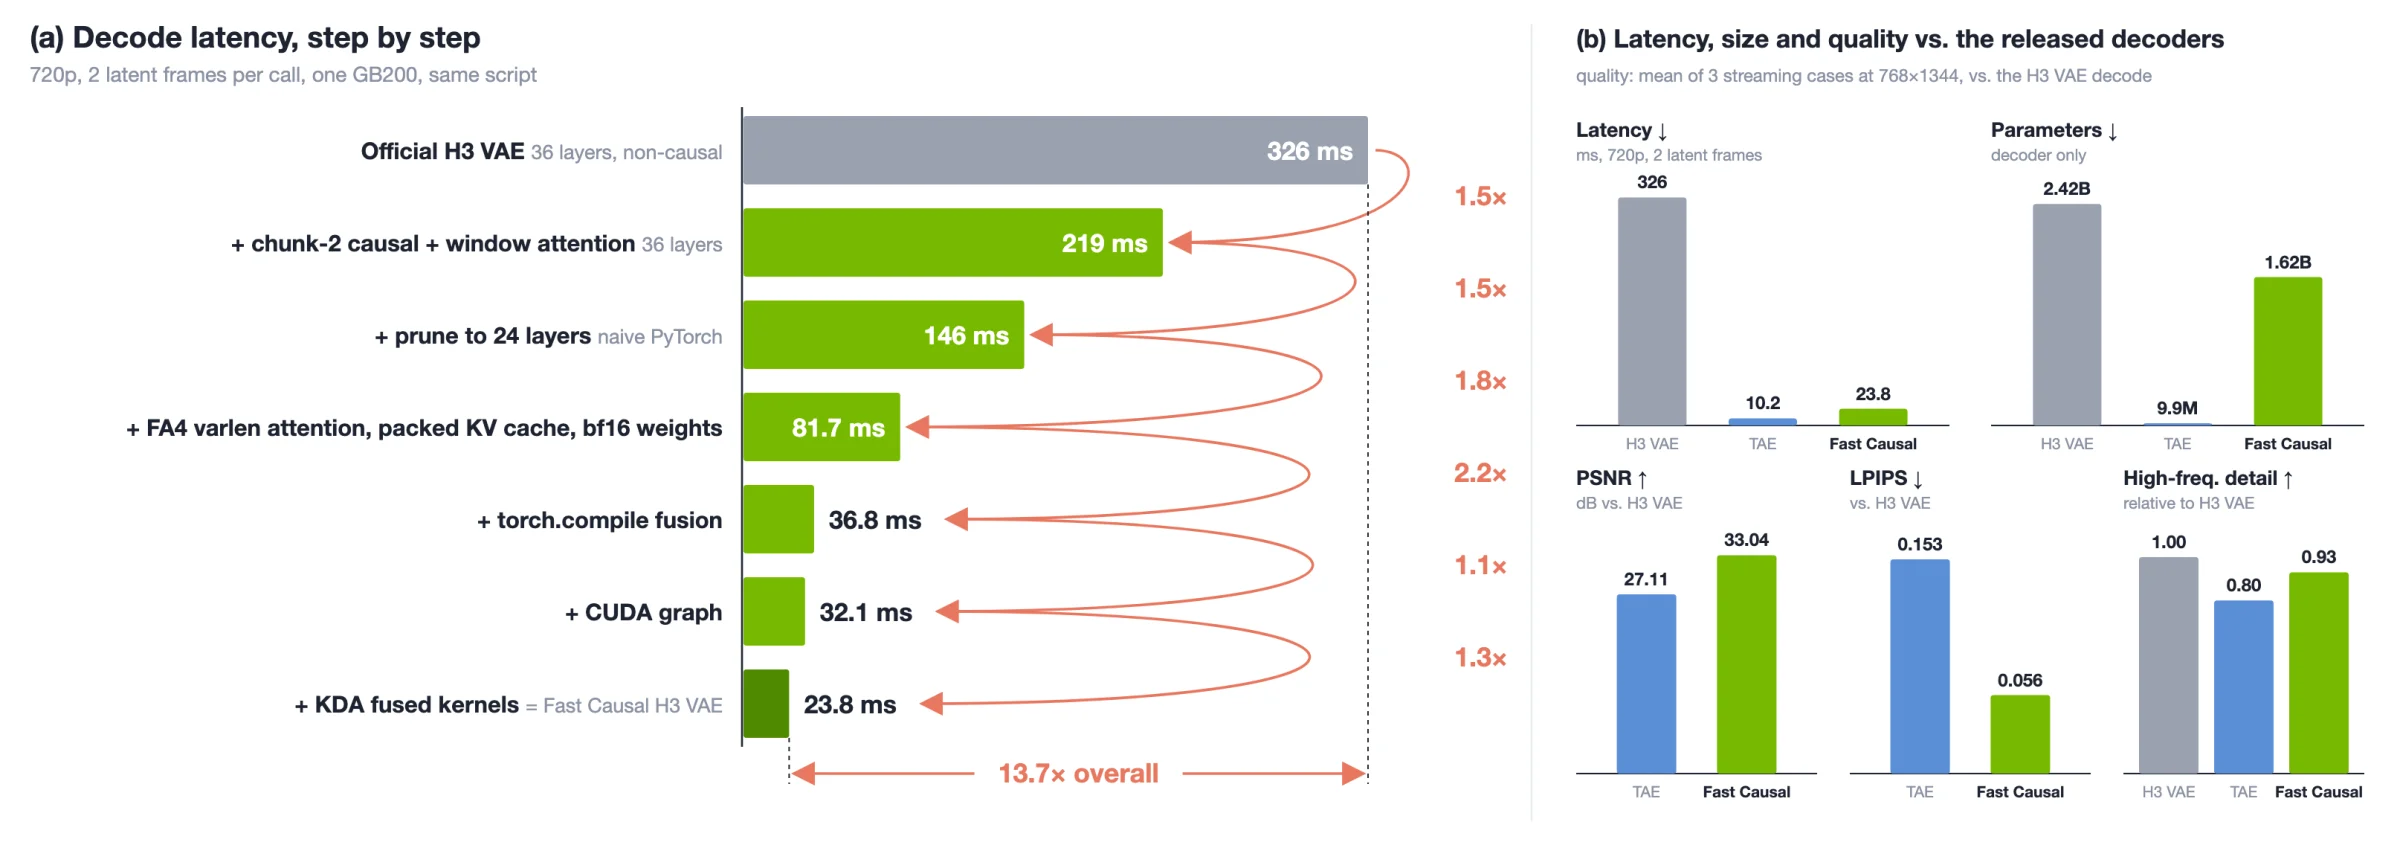
迭代 6:为内核进行第二轮循环。我们将 32 ms 版本交给了 Kernel Design Agents(KDA),这是一个形状相同的循环,使用 Claude Code 和 Opus 5.5 在一个 GB200 节点上运行了 2.5 小时。其任务契约是针对参考实现的正确性门控和延迟基准测试。该智能体将五个全局 token 追加到 token 行中,使每个线性层只运行一次;在 qkv GEMM 之后,将 qk-norm、RoPE 和 K/V 缓存写入融合到一个 Triton 内核中;将全局 token 注意力重写为 split-K Triton 内核;将残差加法与下一个 RMSNorm 以及 SwiGLU 融合到上投影 GEMM(quack)中;将 fp32 输出头计算为在 hi/lo 拆分上的单个 bf16 张量核心 GEMM;并将流状态移至 GPU 上,使单个 CUDA 图能够服务每个块(32 ms → 23.8 ms)。矩阵乘法现在约占剩余 23.8 ms 中的 14 ms。
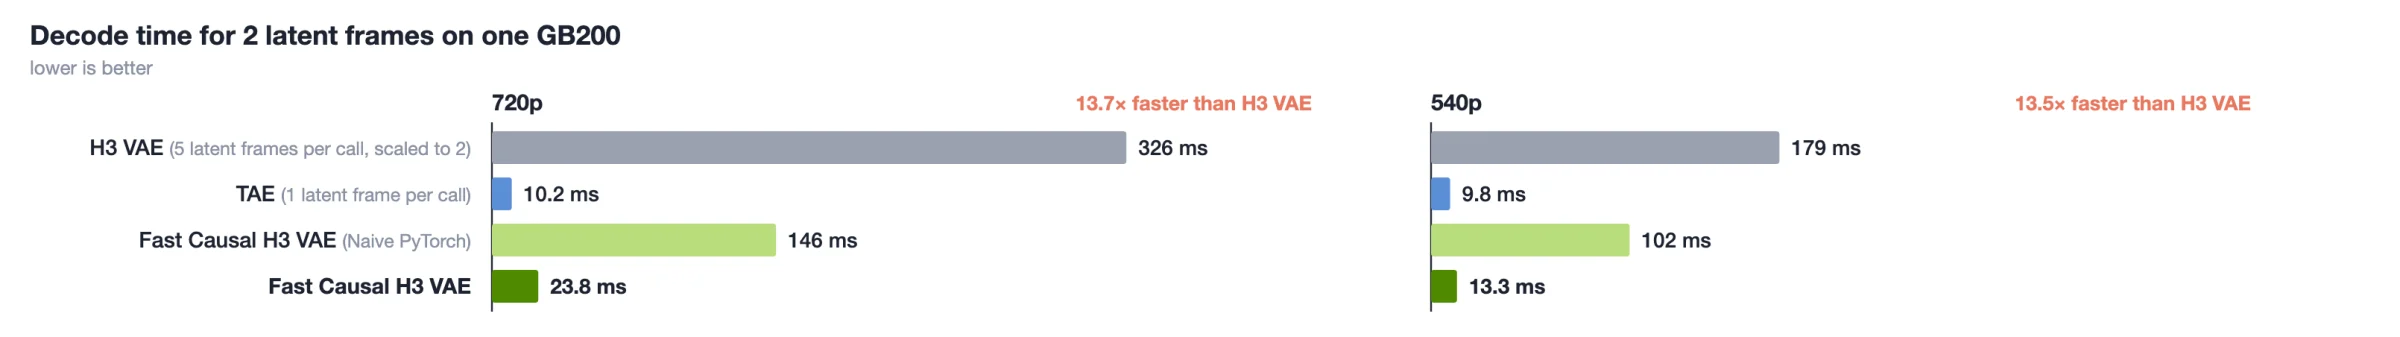
两个优化版本与朴素 PyTorch 实现匹配到 64–71 dB PSNR,差异来自 bf16 舍入。
在流式循环中。解码器仅替换流水线的视频解码器;参考帧的 TAE 编码器和两步 DiT 保持不变。其接口一次接收一个潜帧:一对中的第一个潜帧被缓冲,当第二个到达时,该对被立即解码。在八 GPU 循环上以 768×1344 运行时,32 ms 版本(KDA 步骤之前)在 36.8–37.3 ms 内解码 2 个潜帧,而同一轮中 DiT 需要 264–329 ms,并且没有任何块起始视频帧与 VAE 的差异超过两个灰度级。
3.3推理加速与端到端部署
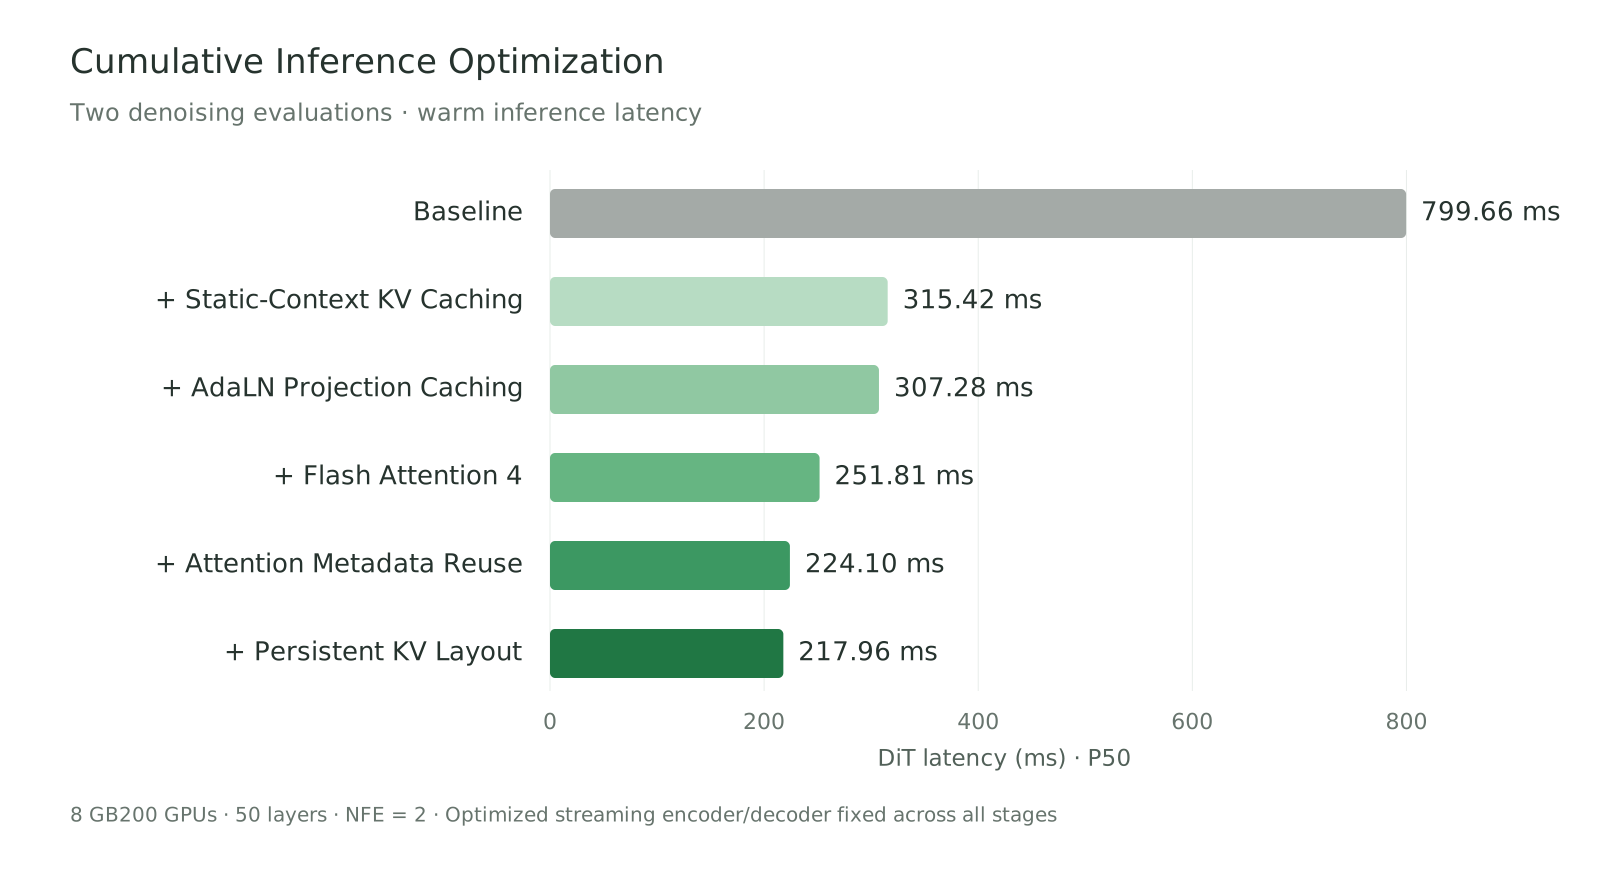
StreamRender-H3 的整个推理栈运行在 Sol-Engine(论文)之上,这是我们面向智能体的视频生成全栈加速框架;下述优化均构建于其上。实时交互要求每个流式步骤都在严格的延迟预算内返回渲染帧。从 PyTorch 原生基线出发,我们对扩散渲染施加了一系列互补的优化,每一项都消除了不同来源的冗余计算或数据搬运。下图展示了它们的累积效果。扩散渲染时间从 799.7 ms 降至 218 ms,实现了 3.67× 加速。
多 GPU 并行推理。 为达到尽可能低的延迟,我们在八块 GPU 上部署该模型。每块 GPU 都保留一份完整常驻的模型权重副本,因此推理过程中无需收集或交换权重。我们采用 Ulysses 风格的上下文并行来拆分工作。每个流式步骤的 token 序列被划分到八块 GPU 上,每块 GPU 在其本地分片上运行前馈层。对于注意力,一次 all-to-all 交换按 head 重新组织数据。随后每块 GPU 针对其 head 子集在完整序列上执行注意力,再将结果恢复到序列布局。
静态上下文 KV 缓存。 每一步的上下文分为两部分。静态上下文包含文本–图像条件特征、参考图像和 sink token。它在整个会话期间保持固定。动态上下文包含当前帧和最近若干帧,随流式推进而变化。我们只计算一次静态上下文的 key/value 状态,并在后续每个 chunk 中复用。每个去噪时间步都保有自己的缓存,因此每一步所关注的上下文都与其精确匹配。每个请求直接读取自己的缓存库,从而避免了沿途任何通用目的的合并。只有动态上下文在每一步重新计算。这大幅减少了注意力层和前馈层处理的 token 数量。仅此一项改动就将扩散渲染时间从 799.66 ms 降至 315.42 ms。
AdaLN 投影缓存。 每个 DiT 块通过自适应层归一化(AdaLN)进行条件化。它将条件信号投影为调制该块激活的 shift、scale 和 gate 参数。在流式生成中,会话条件固定不变,去噪调度对每个 chunk 重复执行。因此相同的输入会逐层、逐 chunk 地不断产生相同的投影。我们缓存这些投影,并在条件输入完全相同时复用。只缓存投影结果;随每个 token 变化的隐藏激活则不予缓存。这将一项重复的逐层计算移出关键路径,使扩散渲染时间进一步降至 307.28 ms。
注意力优化。 将模型如此细粒度地拆分到八块 GPU 上,改变了时间开销的分布。前馈层在各分片上本地运行,扩展性良好。相比之下,注意力则同时包含最重的计算、跨 GPU 通信以及最复杂的数据搬运。在这种并行设置下,注意力成为剩余最大的优化目标,我们从三个层面进行优化:
- 形状感知的核函数调优。 我们使用针对 Blackwell 优化的 FlashAttention-4 核函数运行注意力,并针对流式推理中出现的精确 query 和 key/value 形状进行调优。由于每个 GPU 处理的工作负载相对较小,我们将 key/value 拆分计数设为 1,避免拆分带来的开销。这将扩散渲染时间从 307.28 ms 降至 251.81 ms。
- 注意力元数据复用。 除了 query、key 和 value 之外,每次注意力调用都需要结构元数据:序列长度、累积偏移量和最大长度。在一次前向传播中,具有相同序列结构的层现在只准备一次这些元数据并复用。这消除了重复的逐层设置及其导致的主机-设备同步,并将扩散渲染时间降至 224.10 ms。
- 持久化 KV 布局。 缓存的 key 和 value 存放在每层持久化缓冲区中,直接以注意力核函数读取的布局存储。静态上下文只写入一次。之后每一步只就地更新动态区域,从而消除了重复的内存分配和历史重打包。这将扩散渲染时间降至最终的 218 ms。
这些优化共同实现了跨多个 GPU 的实时渲染,使用户能够进行交互式、实时的流式视频体验。
当前局限与未来方向
目前仅一个场景。 本文报告的所有内容均来自赛车演示。渲染器、两步学生模型和评判器仅在赛车数据上训练,使用玩家车后的第三人称摄像机。测试驾驶也来自同一款游戏,因此模型仅拟合了这一场景。接口本身并不局限于赛车,因为任何能够用每个类别一种纯色绘制其场景的引擎都可以驱动该渲染器。覆盖更多游戏和场景,并衡量每个场景需要多少新数据,是下一步工作。
更小、更快、更锐利的渲染器。 流式渲染仍在八块 GPU 上使用完整的 MiniMax-H3 DiT。减少其参数量、进一步降低每个流式步骤的成本,以及提升渲染视频的视觉质量,是我们正在追求的其他方向。
致谢
鸣谢
我们感谢那些帮助将 StreamRender-H3 从代码游戏引擎和视频模型转变为一个实时交互世界的团队和开源项目。
核心贡献者
Yanzuo LuTian YeYitong LiShuchen XueHaozhe LiuSong HanEnze Xie
- Sol-Engine用于流式渲染及其加速的推理栈。
- SoL-Pi在流式渲染器开发过程中使用的主要编码智能体。
- NVIDIA DLSS 5在游戏引擎之上开创了实时生成式渲染。
- MiniMaxMiniMax-H3 Ref2VA 开放权重和代码,是流式渲染器和 H3 VAE 的基础。
- LynnReal-Omni带 sink 和近期历史的流式窗口,并将 guidance fitting 扩展到这里以实现结构控制。
- LongLive帧 sink 与流式长时调优,我们的流式 DMD 蒸馏即遵循此方案。
- Humanize + KDAFast Causal H3 VAE 解码器的融合内核优化。
如何引用
引用
如果 StreamRender-H3 对您的工作有帮助,请引用本项目的页面以及底层的 Sol-Engine 论文。
BibTeX · 项目页面 + Sol-Engine
@misc{streamrenderh3_2026,
  title        = {StreamRender-H3: Interactive Coding Worlds with Real-time Streaming Diffusion Render},
  author       = {Yanzuo Lu and Tian Ye and Yitong Li and Shuchen Xue and Haozhe Liu and Song Han and Enze Xie},
  year         = {2026},
  howpublished = {\url{https://nvlabs.github.io/Sana/Sol-Engine/StreamRender-H3/}},
  note         = {Project page}
}

@misc{li2026solvideoinferenceengine,
  title         = {Sol Video Inference Engine: Agent-Native Full-Stack Acceleration Framework for Efficient Video Generation},
  author        = {Yitong Li and Junsong Chen and Haopeng Li and Haozhe Liu and Jincheng Yu and Ligeng Zhu and Ping Luo and Song Han and Enze Xie},
  year          = {2026},
  eprint        = {2606.23743},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  doi           = {10.48550/arXiv.2606.23743},
  url           = {https://arxiv.org/abs/2606.23743}
}来源:Hacker News · nvlabs.github.io