Princeton 等机构发布论文《Emerging Trends in AI Agent Evaluation》,梳理智能体评测 33 个新趋势
Princeton 等机构发布论文《Emerging Trends in AI Agent Evaluation》,梳理智能体评测的 33 个新趋势
Princeton 团队联合 Stanford、UK AI Security Institute 和 Brookings 的研究者发布论文《Emerging Trends in AI Agent Evaluation》,从评测科学与方法、研究议程、评测生态三个维度总结出 33 个新兴趋势。
AI 作为常态技术· Sayash Kapoor·2026-10-20 04:11· 1 小时前AI 评分52
新论文:AI 智能体评测的新兴趋势
AI 导读
Princeton 团队联合 Stanford、UK AI Security Institute 和 Brookings 的研究者发布论文《Emerging Trends in AI Agent Evaluation》,从评测科学与方法、研究议程和评测生态三个维度总结 33 个新兴趋势。
正文 · 原文
作者:Felix Chen、Stephan Rabanser、Sayash Kapoor 和 Arvind Narayanan。完整作者名单与所属机构见此处。
越来越多的呼声要求开展独立且嵌入式的 AI 评测,尤其是对 AI 智能体的评测。但许多问题仍不明确:“好”的评测由什么构成、首先需要评测什么,以及如何最好地协调和支持涌入这一新兴评测生态的大量人员。
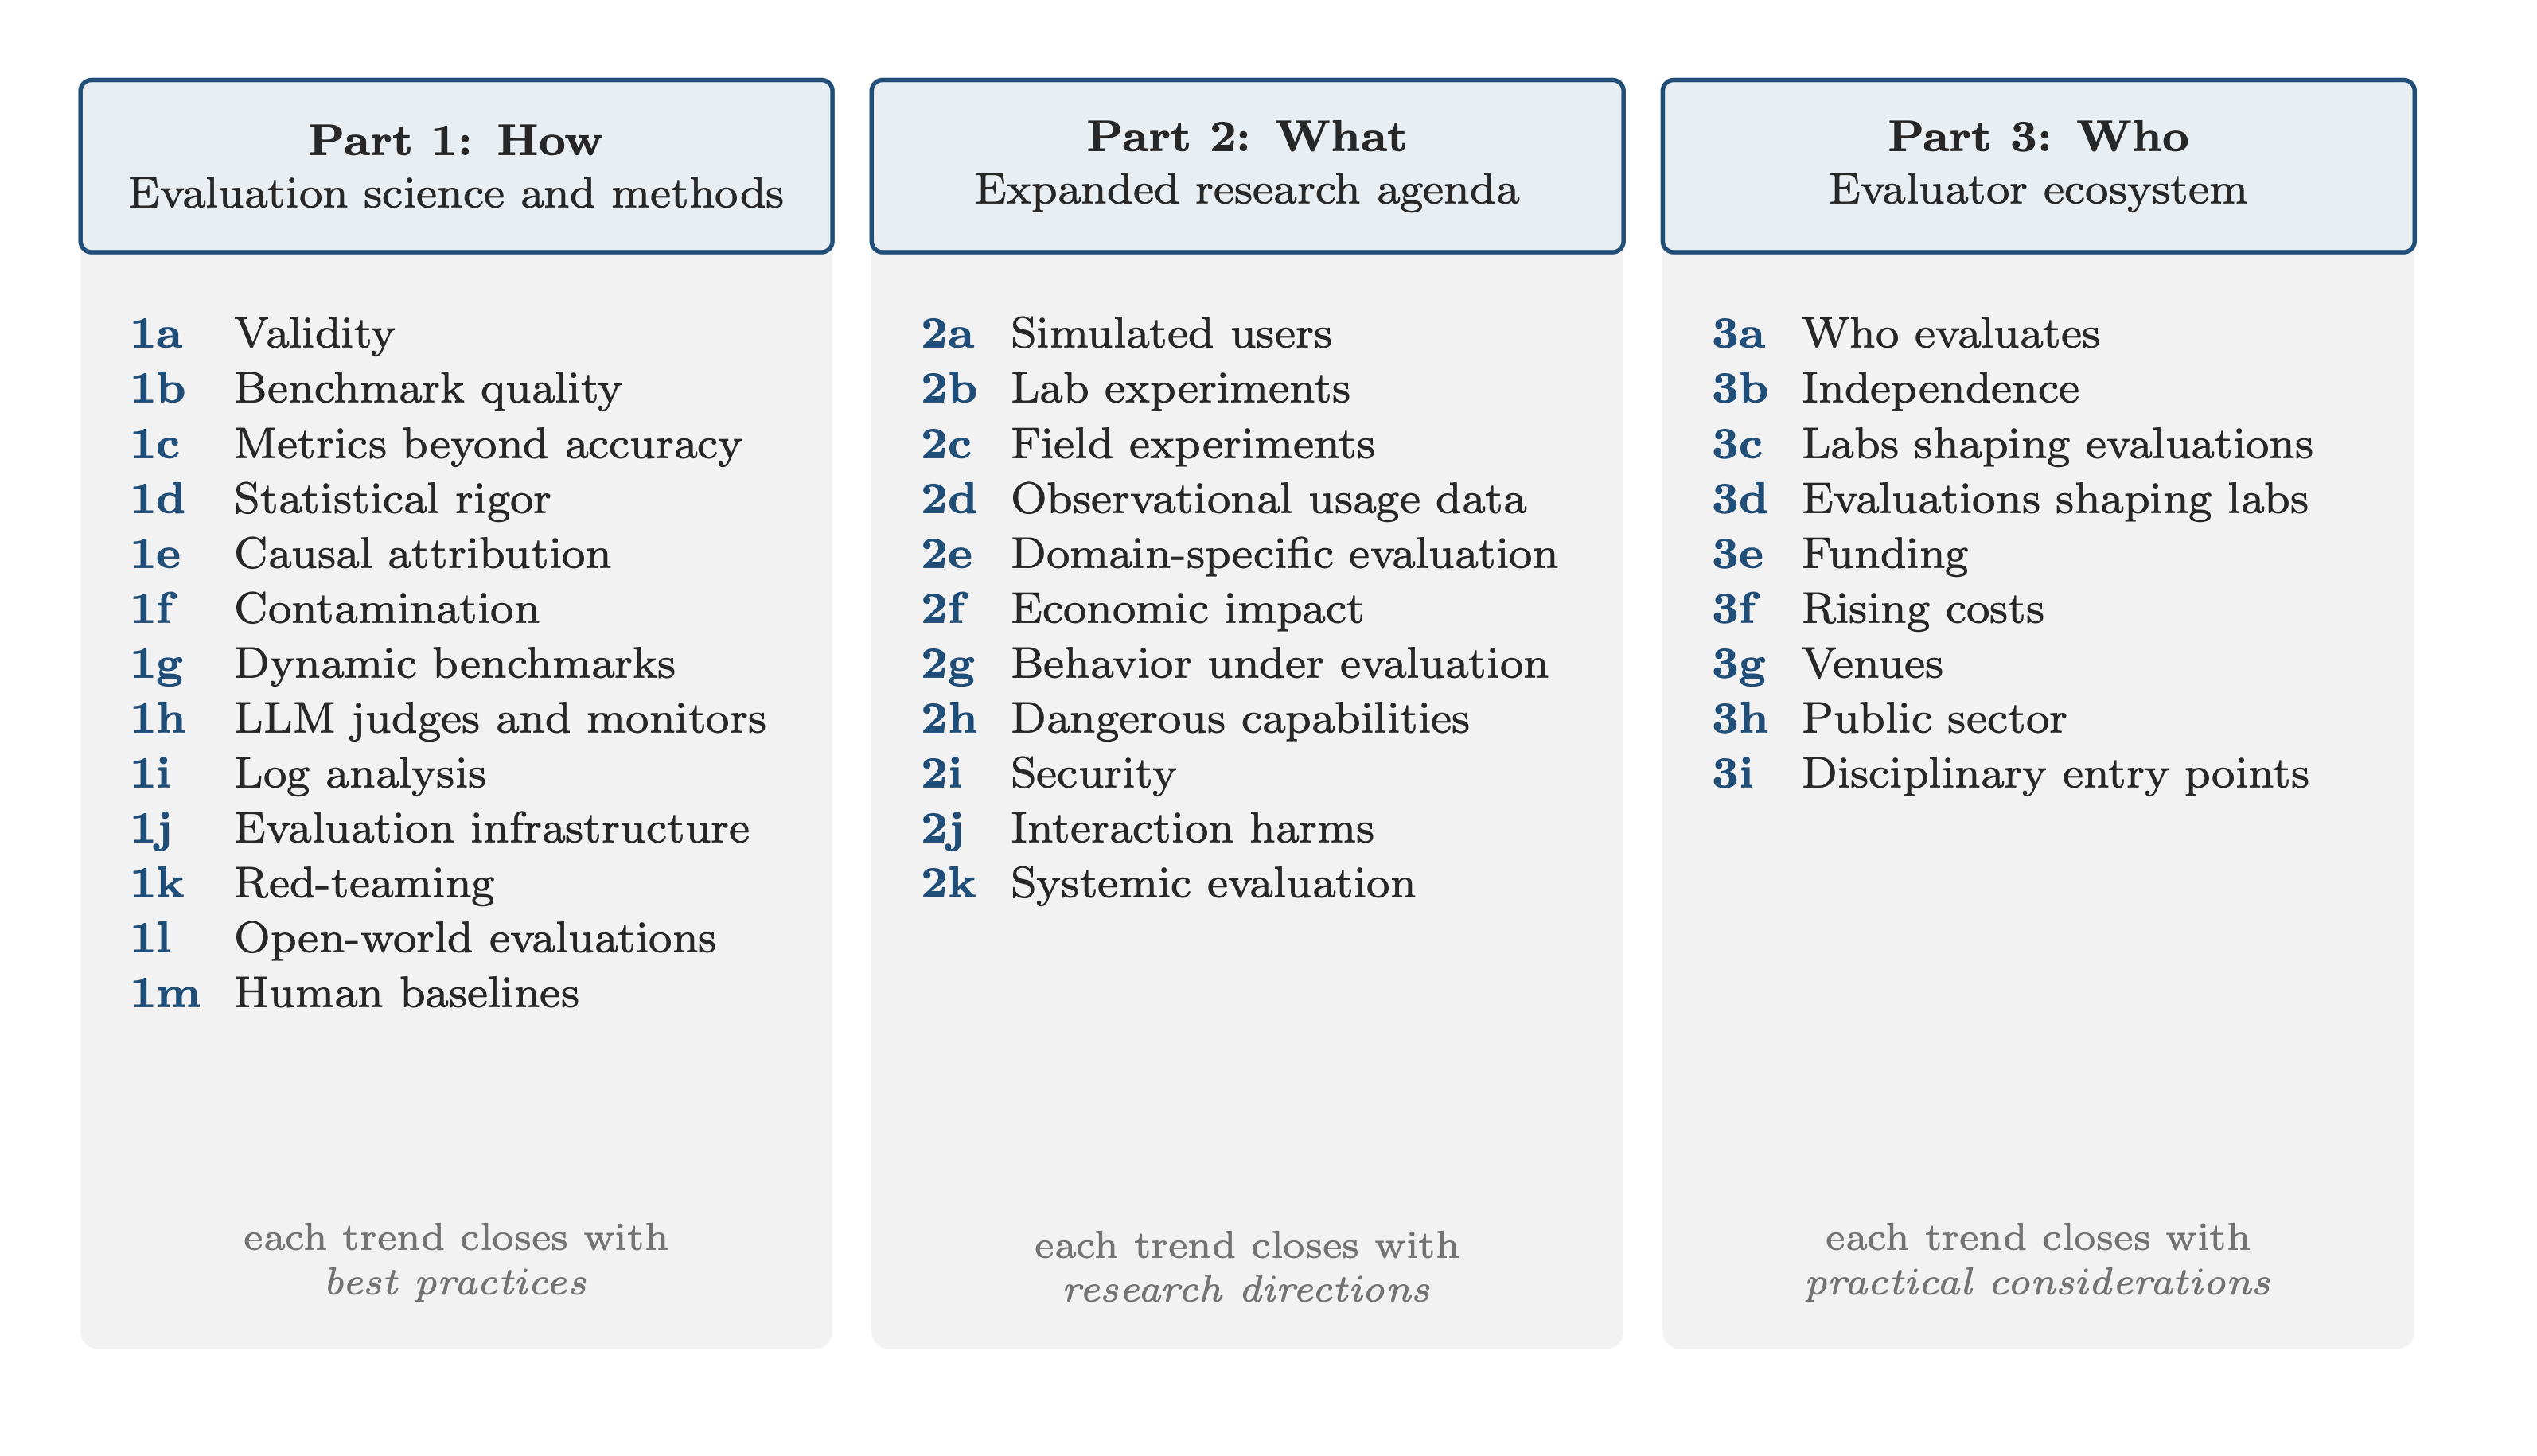
我们 Princeton 的团队致力于改进 AI 智能体评测的现状已有约三年。我们与在 Stanford、UK AI Security Institute 和 Brookings 从事评测基础工作的人士合作。我们的论文题为 Emerging Trends in AI Agent Evaluation。我们从三个维度——评测科学与方法、研究议程和评测生态——综合了我们观察到的趋势,目标是帮助那些正在为这一新范式提升技能的人。我们还希望为评测者、资助方和公众提供一套可提出的问题,并给出可操作的建议。
智能体面临的新旧挑战
AI 开发者长期以来一直依据基准分数来宣称其系统在真实世界中的表现。如今,要评估所收集的证据是否支持关于智能体的宣称变得更加困难。评测者必须审视整个轨迹,而不仅仅是最终结果。例如,了解智能体是否走了捷径很重要,尤其是因为它们可以访问工具和环境。而当智能体表现更好或更差时,也更难将这些变化归因于智能体的不同组件。解决这些问题需要大量的工程投入,而且相关工作正变得越来越昂贵——例如,ExploitBench 基准上的若干智能体花费了数万美元的额度用于评测。这些数字还没有计入搭建和维护评测基础设施本身所需的大量工程投入。
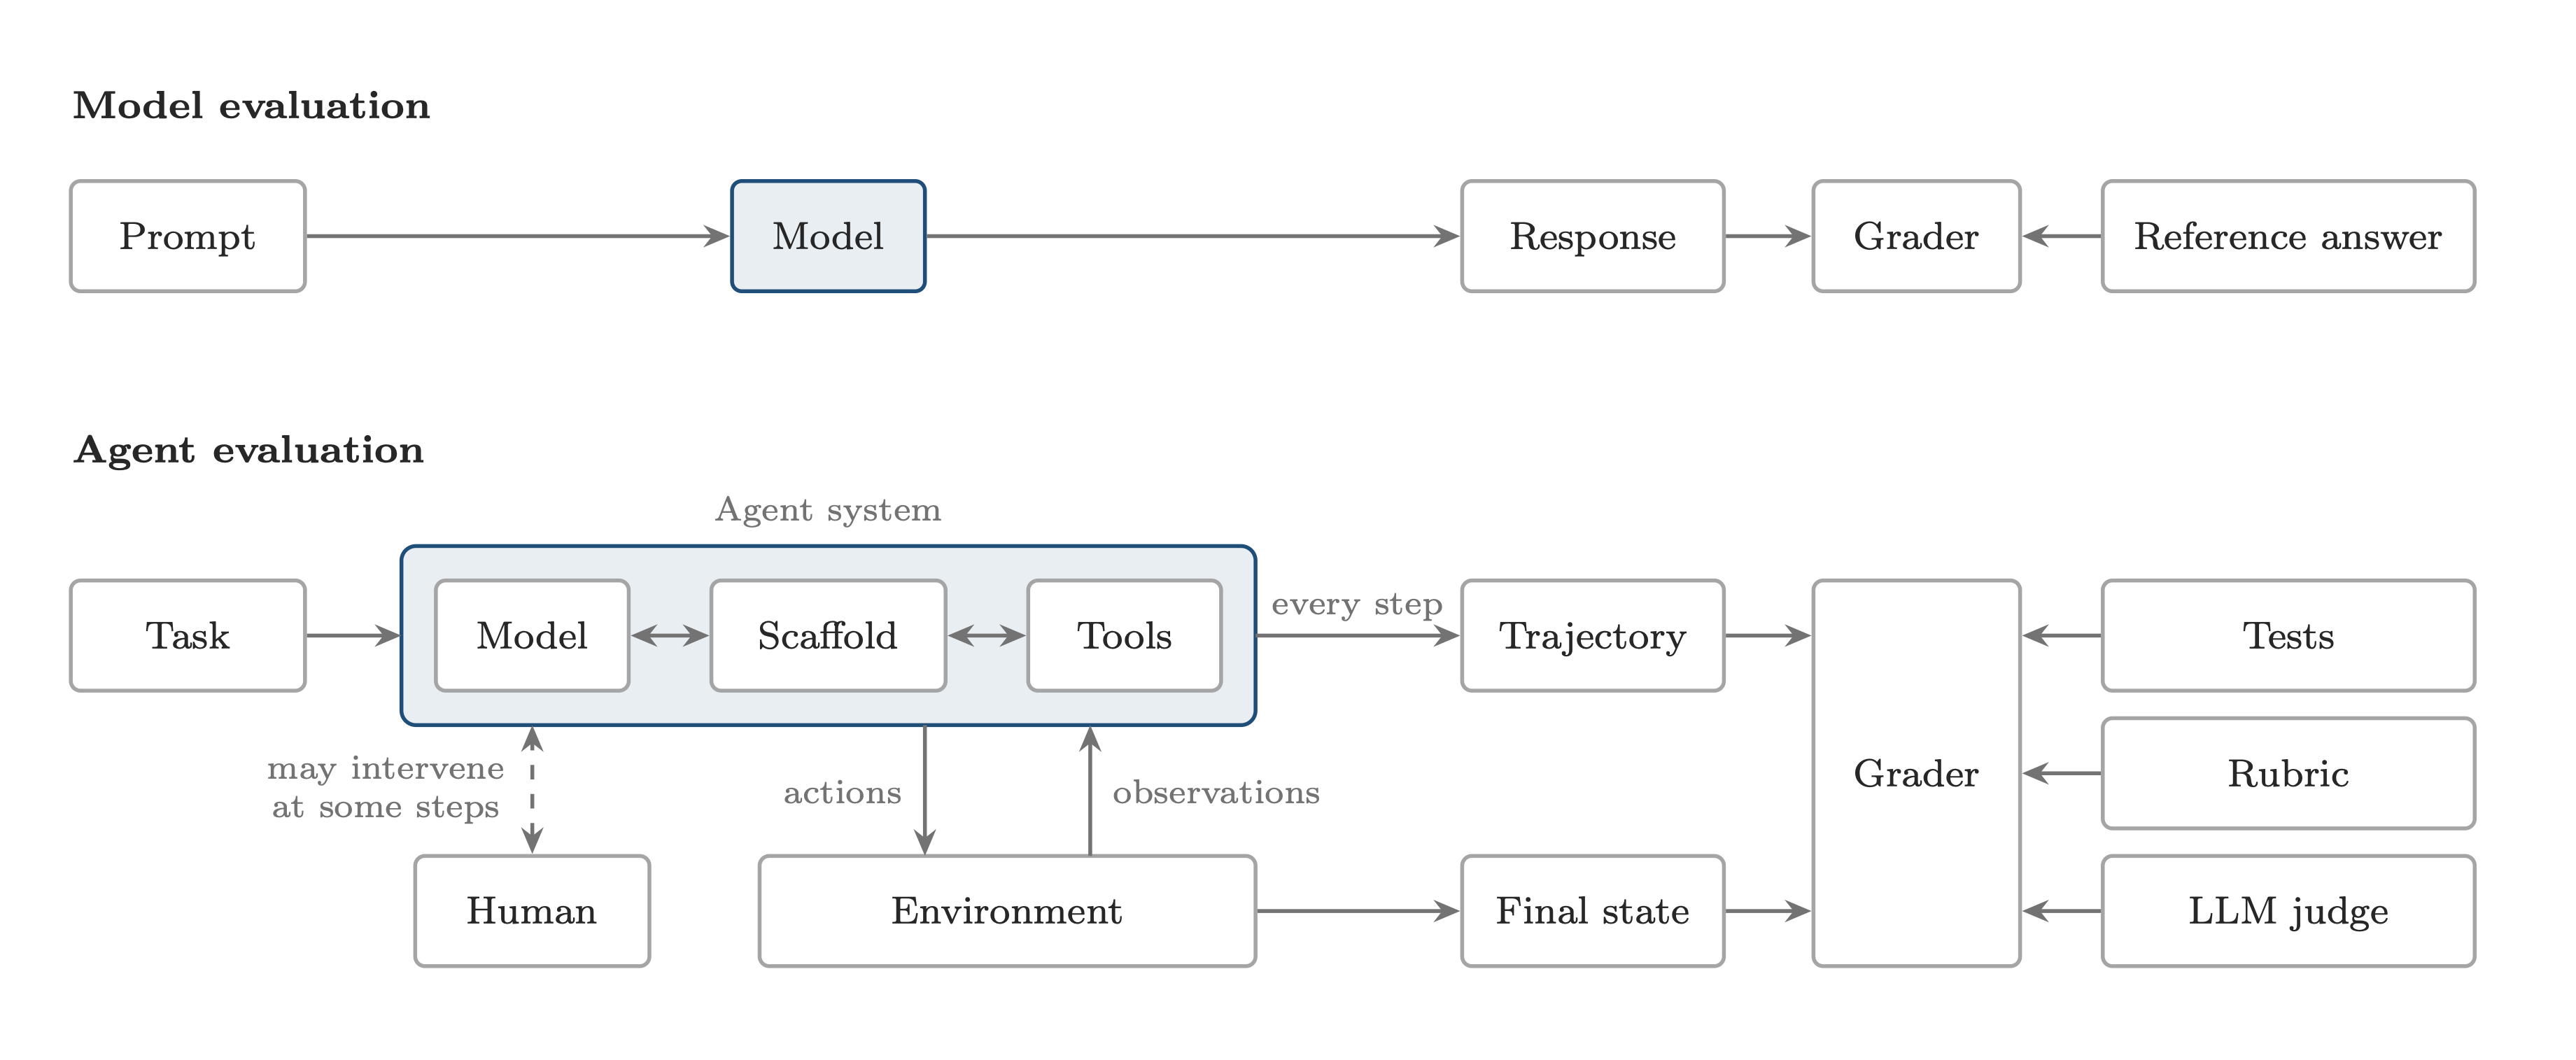
面对智能体产生的大量轨迹,评测者也在艰难地大规模检查和监控这些智能体。评测者如今依赖的此类工具并非万无一失——它们本身也需要被评测。为了事后调查最近的 OpenAI-HuggingFace 事件,评测者依赖其他智能体来查找和识别有害行为的实例,他们承认这种方法有其自身的局限性和偏差。
由于智能体被部署在动态环境中(并且越来越多地与其他智能体一起部署),设计出能够捕捉所关注的底层概念的良好指标,并创造有效条件来实施这些指标,变得更加困难。应对这些挑战需要更好的工具、更严格的基准测试,以及对不同方法和形式的实验,例如通过开放世界评估以及不断增长的真实世界使用观测数据。
评估需求的范围正在扩大
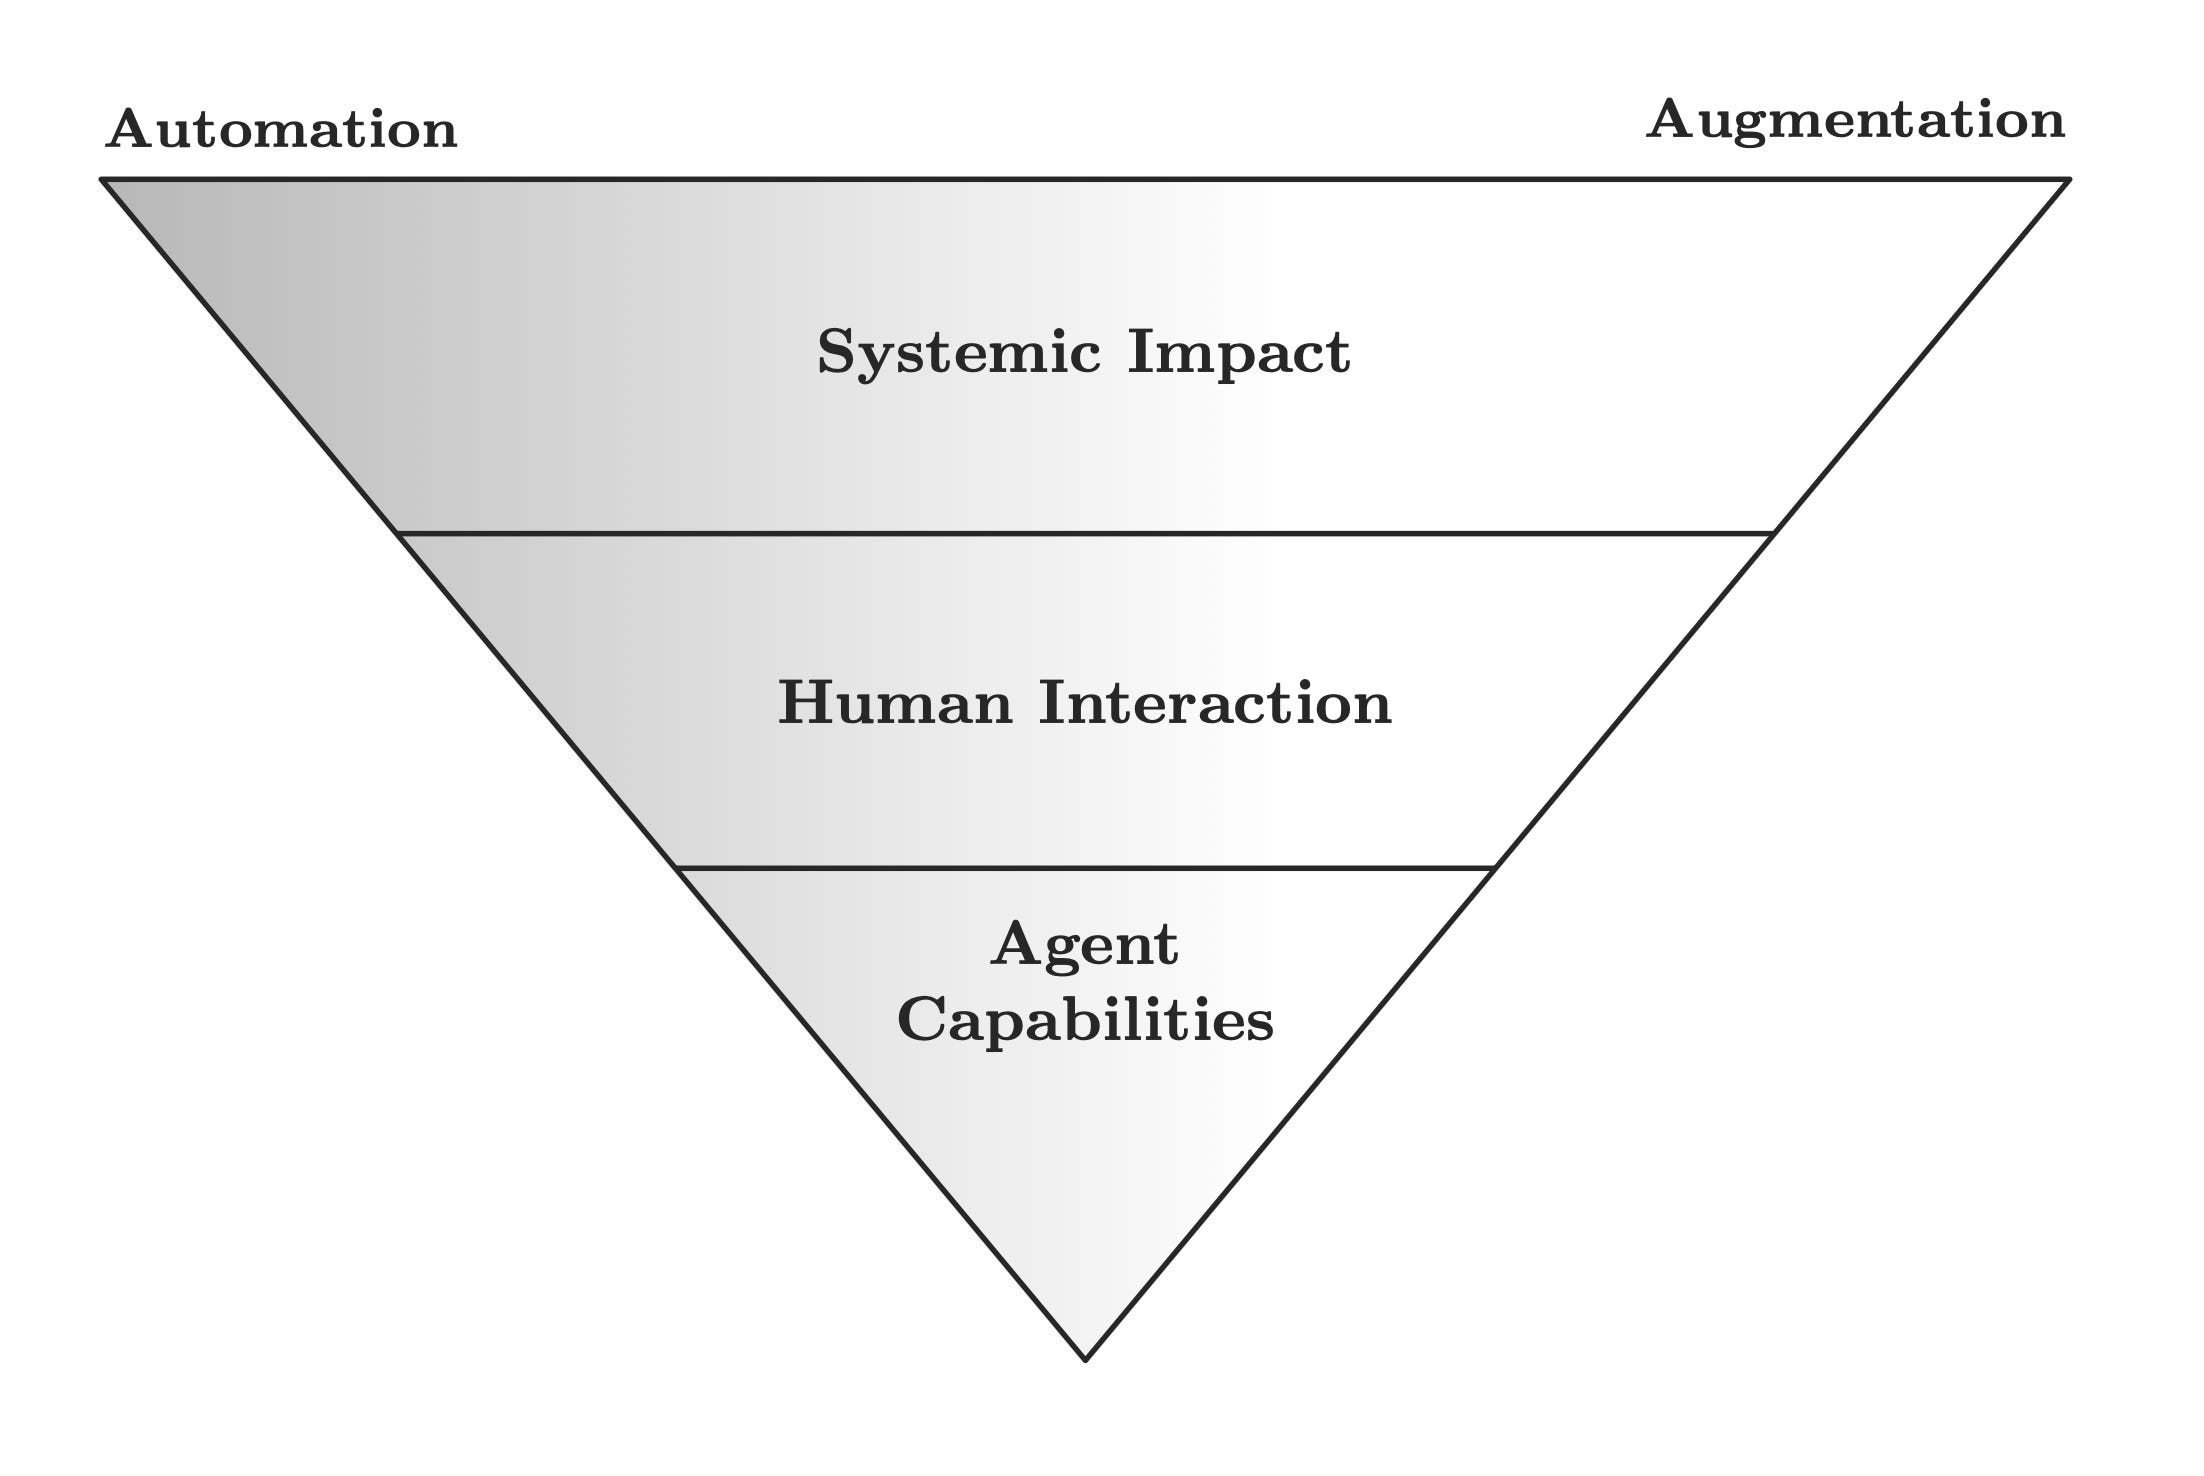
关键在于,在某一范围层面上的评估结果并不保证能转化到另一个层面。一个智能体可能在实验室中展现出能力,但在被置于特定用例中时会面临限制。以 METR 的随机对照试验为例,该试验发现,尽管有预期,但使用智能体工具进行软件开发实际上增加了手头任务的总体完成时间。智能体或许能够执行某些任务,但这种能力如何转化为现实世界中人类的表现,需要在具体情境中进行评估。因此,需要一项扩展的研究议程,以理解各个层面的智能体:它们的能力、它们与人类的交互,以及它们对机构和激励结构的影响。这项工作既需要技术评估,也需要社会技术评估,不仅研究智能体本身,还要研究情境中的智能体。
在这些不同层面之间,评估者在构建所提出的问题和所产生的研究结果时拥有选择权。智能体能否自动化一项任务或流程?或者,智能体能否增强人类的工作?这是两个互补的视角。如果评估主要关注智能体如何自动化某些任务,我们将更好地理解人类工作可以在何处以及如何被替代。但这不会告诉我们人类如何利用智能体更好地协作,或者智能体如何改善人类的工作。
谁来评估以及如何评估?
这一扩展的研究议程将需要来自不同学科的更广泛的评估者群体。它还将要求评估者拥有选择追求哪些问题以及如何追求的自由。当采用不同方法的评估者达成一致时,我们可能会对这些结果获得更大的信心。而当他们产生冲突时,评估者可以识别出模糊的定义及其研究结果的局限性。
谁能够参与以及以何种独立性参与,将塑造评估者提出的问题及其使用的方法。有意义的独立性受到若干因素的影响。随着前沿评估的成本不断上升,独立评估者参与的能力将越来越取决于他们能否获得更多资金。独立评估者能否充分获取模型也影响他们测量和评估真实前沿的能力。获取问题现在也延伸到智能体的思维链轨迹,因为前沿实验室现在发布的是摘要版本而非原始轨迹。除了这些挑战之外,评估者还需要应对能否在不必担心报复的情况下开展工作,以及如何透明地分享他们的研究结果。
我们从这里走向何方?
现在有一个明确的窗口期,可以引入新的参与者、方法和理念来开展智能体评估,并满足这个快速发展的领域对严谨证据的迫切需求。我们希望这篇论文能让读者对该领域的发展方向有一个初步的认识。AI 评估社区的各方利益相关者可以采取许多步骤来推进 AI 评估的科学与实践。
对于潜在评估者,需要确定这一生态系统中哪些角色或问题最适合其专业能力,并考察该工作对独立性的哪些维度有要求。我们尤其鼓励尚未参与 AI 评估的学科参与进来;有许多开放挑战可以从它们的视角中受益。
对于现有评估者,有机会审视自身的方法论假设,并接纳其他学科的视角;智能体评估这一领域本质上是跨学科的,必然涉及对既有思想和洞见的某种重新发现与重新创造。
对于领域建设者——资助方、联盟和会议组织者——智能体评估需要形成自己的实践领域,一个对有效性和严谨性有更高标准的领域。提高这一标准可以通过凝聚最佳实践、促进不同学科视角之间的对话与交流来实现。
对于排行榜聚合者,它们通过塑造哪些评估维度受到关注以及以何种方式受到关注,在这一新兴生态系统中处于核心位置,因此有绝佳机会纳入关于报告的最佳实践以供下游采用,并帮助公众理解评估成本不断上升的问题。
对于部署方和行业评估者,现实世界场景在为评估工作提供信息方面存在关键缺口。通过贡献一线洞见并参与实验室工作,他们可以加强这一快速发展领域的讨论。
对于实验室,有机会与独立评估者建立桥梁,并考察社区的最佳实践。成功的嵌入式评估者需要通过独立性、透明度和方法论严谨性来获得公共合法性。
对于政策制定者,需要清晰认识当前生态系统以及良好评估应具备的形态。而对于公共部门部署,评估需要从第一天起就成为流程中一个整合且持续的组成部分。AISI 可以通过开创新的协作模式,并在当前生态系统中邀请新的利益相关者参与其公共意见征集机制,发挥关键作用。
阅读论文此处。
来源:AI as Normal Technology · normaltech.ai
来源:RadarAI · aihot.news