Amazon SageMaker HyperPod 管理与治理最佳实践
Best practices for Amazon SageMaker HyperPod administration and governance
在 SageMaker Unified Studio 中管理 SageMaker HyperPod 集群时,需按组织、项目、集群、工作负载四层控制设计治理策略。
Amazon SageMaker HyperPod 让机器学习(ML)团队能够访问大规模加速计算资源,用于训练和微调模型。当多个团队共享一个集群时,技术搭建通常很直接。真正有挑战的是治理。你必须决定哪些团队可以使用该集群、每个团队获得多少容量、当一个团队的工作负载与另一个团队竞争时会发生什么,以及当使用偏离策略时由谁负责。Amazon SageMaker Unified Studio 带来了另一个考量:你可以将 SageMaker HyperPod 集群连接到项目,使团队成员能够从他们的项目工作区启动工作负载。这种便利很有价值,但当多个团队共享对同一集群的可见性后,管理谁可以做什么的控制措施就变得更加重要。在本文中,我们展示如何通过 SageMaker Unified Studio 管理 SageMaker HyperPod,同时保留底层的治理控制。我们涵盖四个控制层:组织、项目、集群和工作负载。我们还解释如何跨这些层设计身份、容量和可观测性策略。最终,你将获得一个可重复的模型,在项目上下文中向 ML 团队提供经过批准的 SageMaker HyperPod 计算资源,同时将集群运维保留在基础设施团队手中。
Amazon SageMaker HyperPod 是 Amazon SageMaker AI 的一项能力。Amazon SageMaker Unified Studio 是数据和 AI 开发环境,团队在其中使用自己的数据和工具进行构建。借助 SageMaker Unified Studio,你可以将项目连接到现有的 SageMaker HyperPod 集群。成员随后可以启动机器学习工作负载、查看集群和任务信息,并打开 JupyterLab 工作流。你继续通过 Amazon SageMaker AI 界面和 API 管理集群。
这种分离为基础设施团队提供了一种有用的运营模式。你可以通过既定的云运维流程管理集群基础设施。同时,你可以在项目上下文中向机器学习团队提供经过批准的计算资源。在本文中,我们描述如何设计基础设施边界、治理访问、分配共享容量,并通过 SageMaker Unified Studio 一致地运营 SageMaker HyperPod。
理解管理边界
治理良好的环境将组织管理、项目访问和集群运维分开。每一层回答不同的问题并使用不同的控制。下表总结了每个边界、其主要控制及其管理目的。
| 边界 | 主要控制 | 管理目的 |
| 组织 | SageMaker Unified Studio 域、域单元、关联账户、项目配置文件和授权策略 | 决定谁可以创建项目、项目可以使用哪些账户和区域,以及哪些工具可用 |
| 项目 | 项目成员资格、项目角色和 SageMaker HyperPod 连接 | 定义协作上下文以及项目成员可以访问的 AWS 资源 |
| 集群 | SageMaker HyperPod 集群管理员角色、Amazon EKS 访问条目、基于角色的访问控制(RBAC)和 EKS Pod Identity,或 Slurm 控制 | 治理集群配置、调度器访问、命名空间、任务和基础设施运维 |
| 工作负载 | 计算分配、优先级类、借出和借用策略以及任务权限 | 控制谁可以提交工作以及共享容量如何分配 |
将这些控制视为分层。SageMaker HyperPod 连接会将一个已批准的集群添加到项目中。它不会取代集群的 AWS Identity and Access Management (IAM)、Amazon Elastic Kubernetes Service (Amazon EKS) 或 Slurm 控制。请一并审查项目角色、连接访问角色、EKS 访问条目和 RBAC 或 Slurm 控制、工作负载身份、数据和 AWS Key Management Service (AWS KMS) 密钥策略、网络策略、任务视图限制以及调度器策略。只有在这些控制协调一致后,才使集群可用。
这些控制构成四个层,如下图所示。
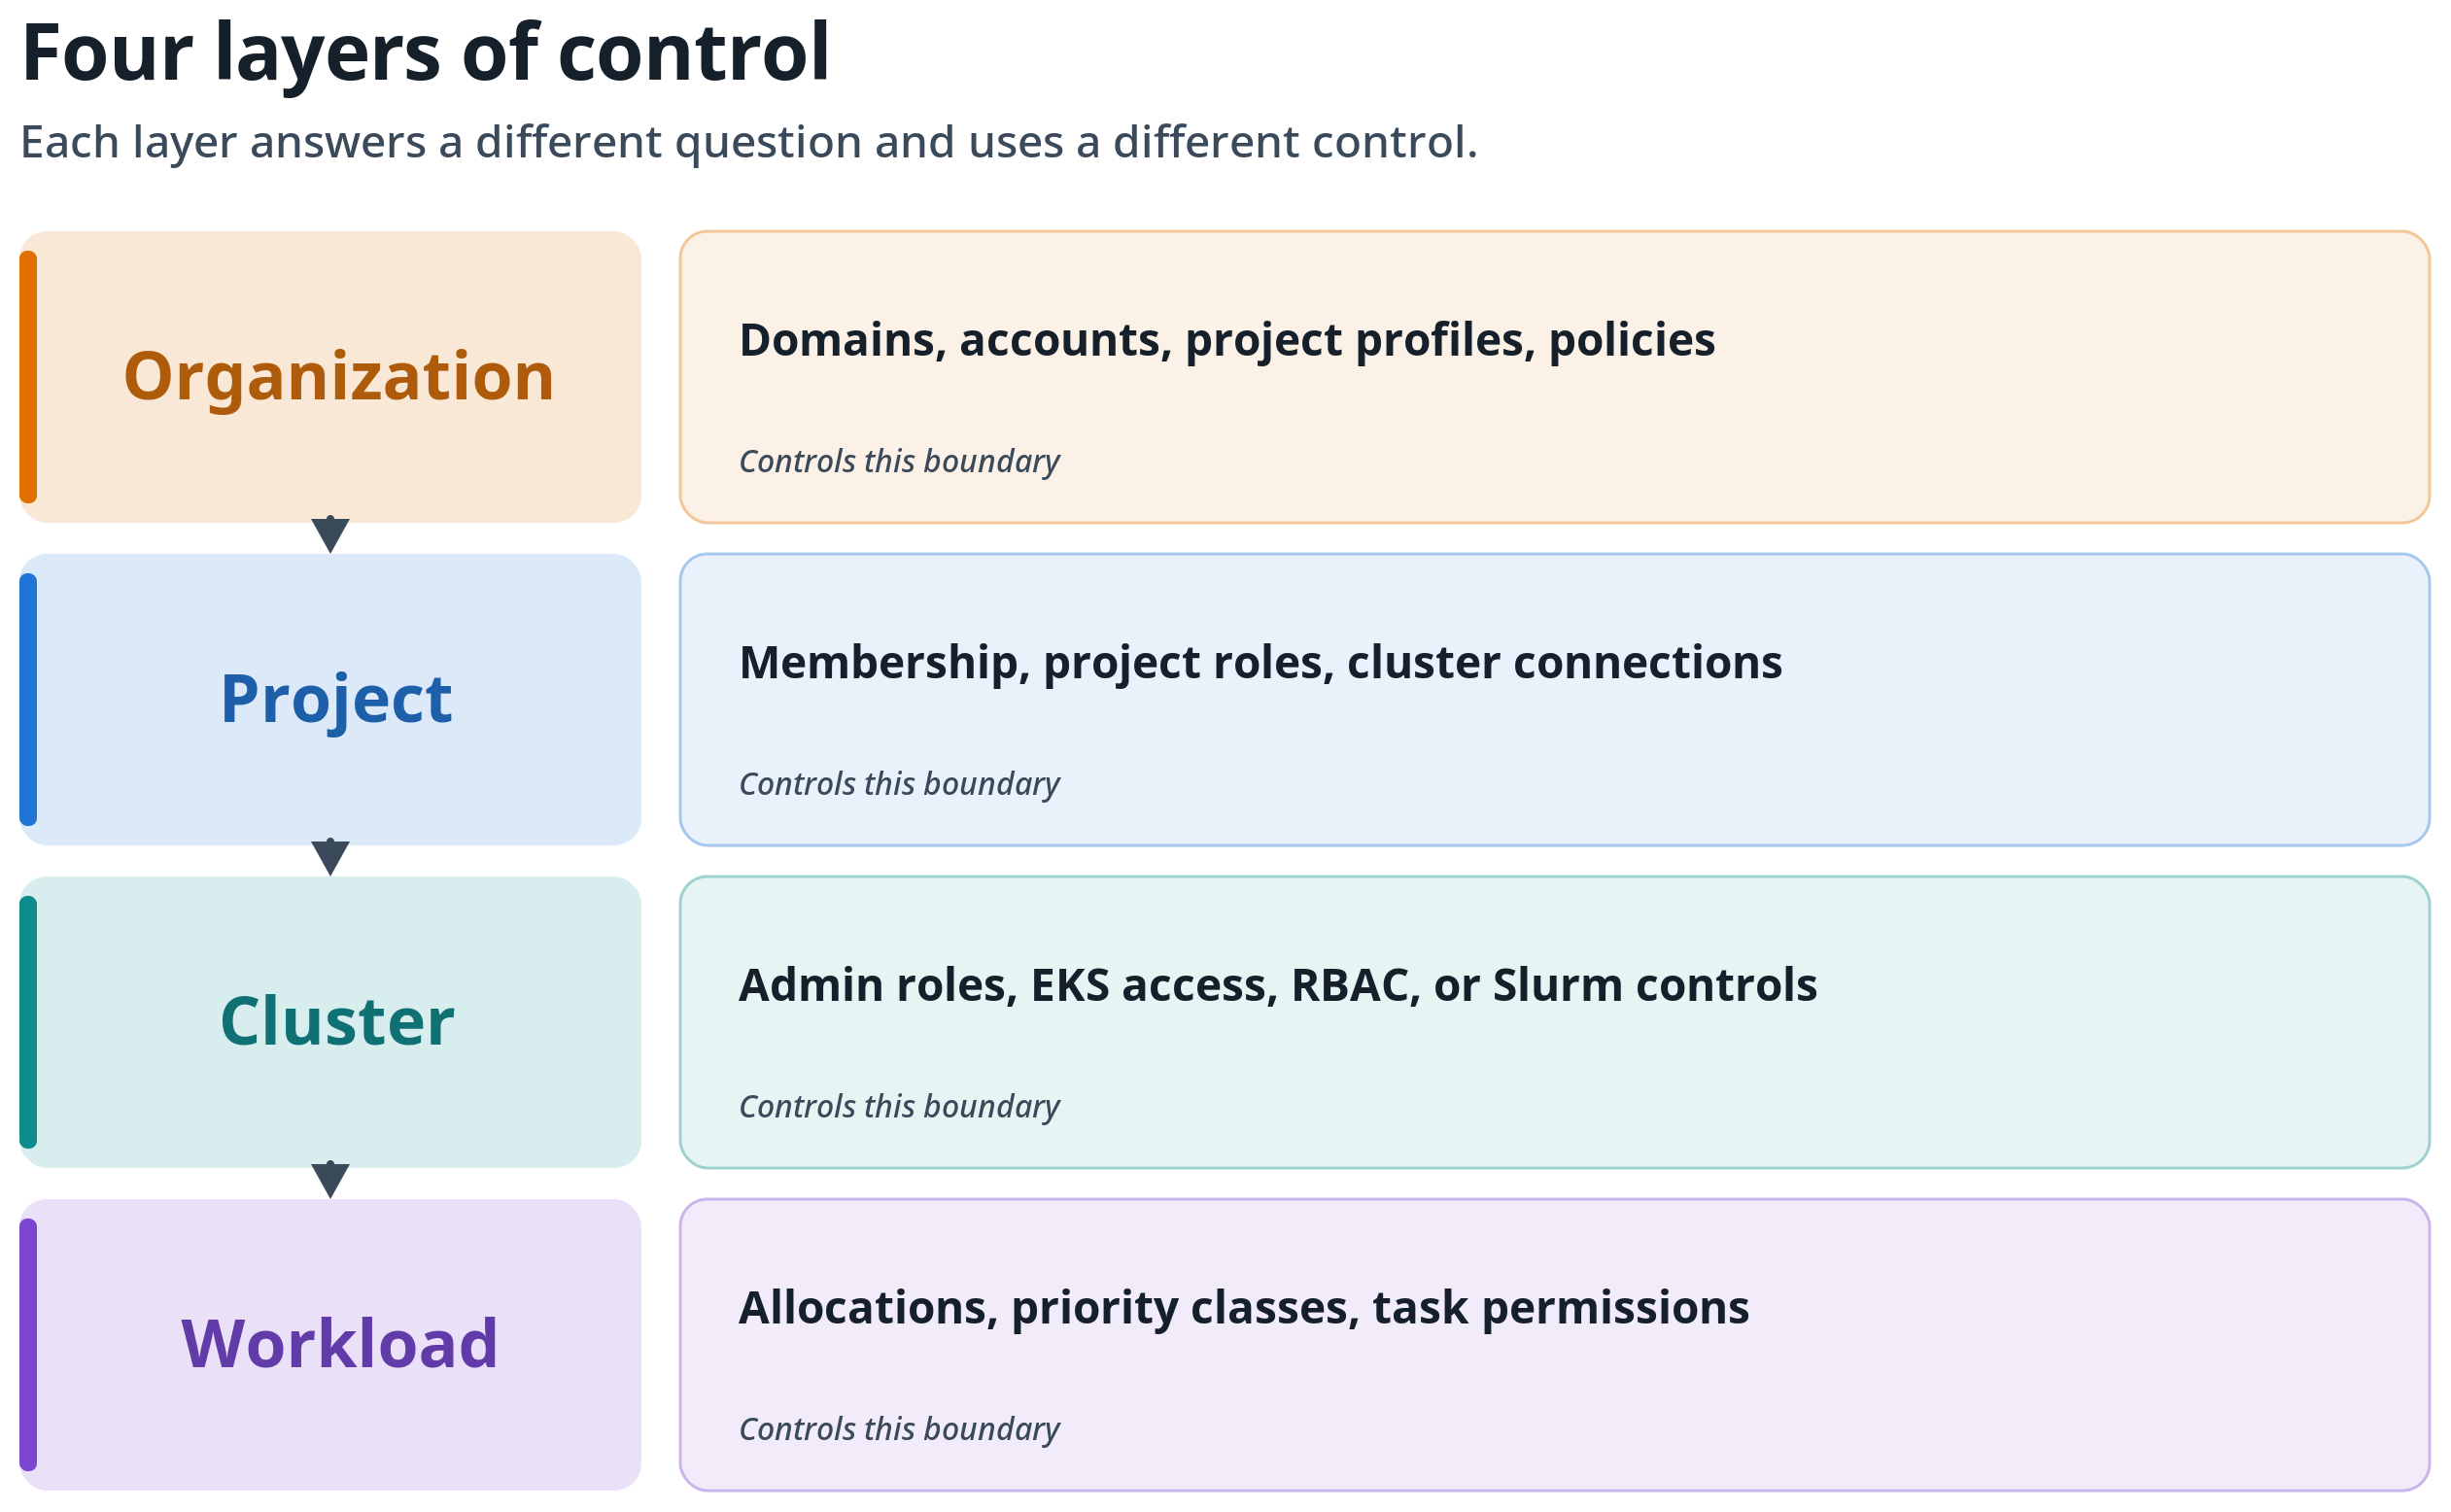
图 1:控制的四个层:组织、项目、集群和工作负载。每一层回答不同的问题并使用不同的控制,因此请在各自的边界上审查每一层。
SageMaker Unified Studio 项目是协作边界。它们不是强运行时安全边界。将 SageMaker HyperPod 集群、调度器和稀缺的加速器容量保留在一个指定的容量账户下。已批准的用户和数据集可以保留在同一账户中,也可以位于单独的消费者账户和数据账户中。AWS 记录了 Amazon EKS 集群上 SageMaker HyperPod 任务治理的多账户支持。尽管 On-Demand Capacity Reservations 可以跨账户共享,但请将 SageMaker HyperPod 集群所有权和容量管理集中在容量账户中。使用已批准的跨账户访问,而不是让每个消费者账户成为独立的容量管理员。
- 对于 Amazon EKS,请为每个租户使用一个命名空间,并结合 RBAC、每租户服务账户和 EKS Pod Identity 角色、默认拒绝网络策略以及租户特定的存储和 AWS KMS 权限。对于 Slurm,请使用带有分层账户和关联的 Slurm 记账、服务质量 (QoS)、优先级和公平共享策略以及分区。同时使用操作系统身份和文件权限、网络控制以及租户特定的数据路径。
- 使用 IAM 角色和资源策略(而非仅项目成员身份)来控制对 Amazon Simple Storage Service (Amazon S3) 存储桶、AWS KMS 密钥、密钥、容器注册表和其他数据服务的访问。使用项目和域单元策略进行协作和委派。
- 对于 Amazon EKS 集群,请使用 SageMaker HyperPod 任务治理(包括配额、优先级类、借出和借入以及抢占)来公平地共享中央加速器池。对于 Slurm 集群,请使用原生分区、服务质量 (QoS)、优先级、公平共享和抢占控制。Slurm 不提供相同的借出和借入模型。这些调度控制决定已授权工作负载何时获得计算资源。它们不授予命名空间或数据访问权限。
为了在集群内实现更强的隔离,请在适当的情况下使用专用节点或节点组以及准入控制。当法律、法规或安全要求需要硬性基础设施隔离时,请使用单独的集群或账户。跨账户消费者访问可以保留账户级所有权,而无需复制中央 SageMaker HyperPod 集群。在容量账户内,使用项目配置文件和域单元以及项目授权策略来委派项目创建和所有权。
下图展示了具有租户特定工作负载、身份、数据、网络和可见性控制的集中式容量。
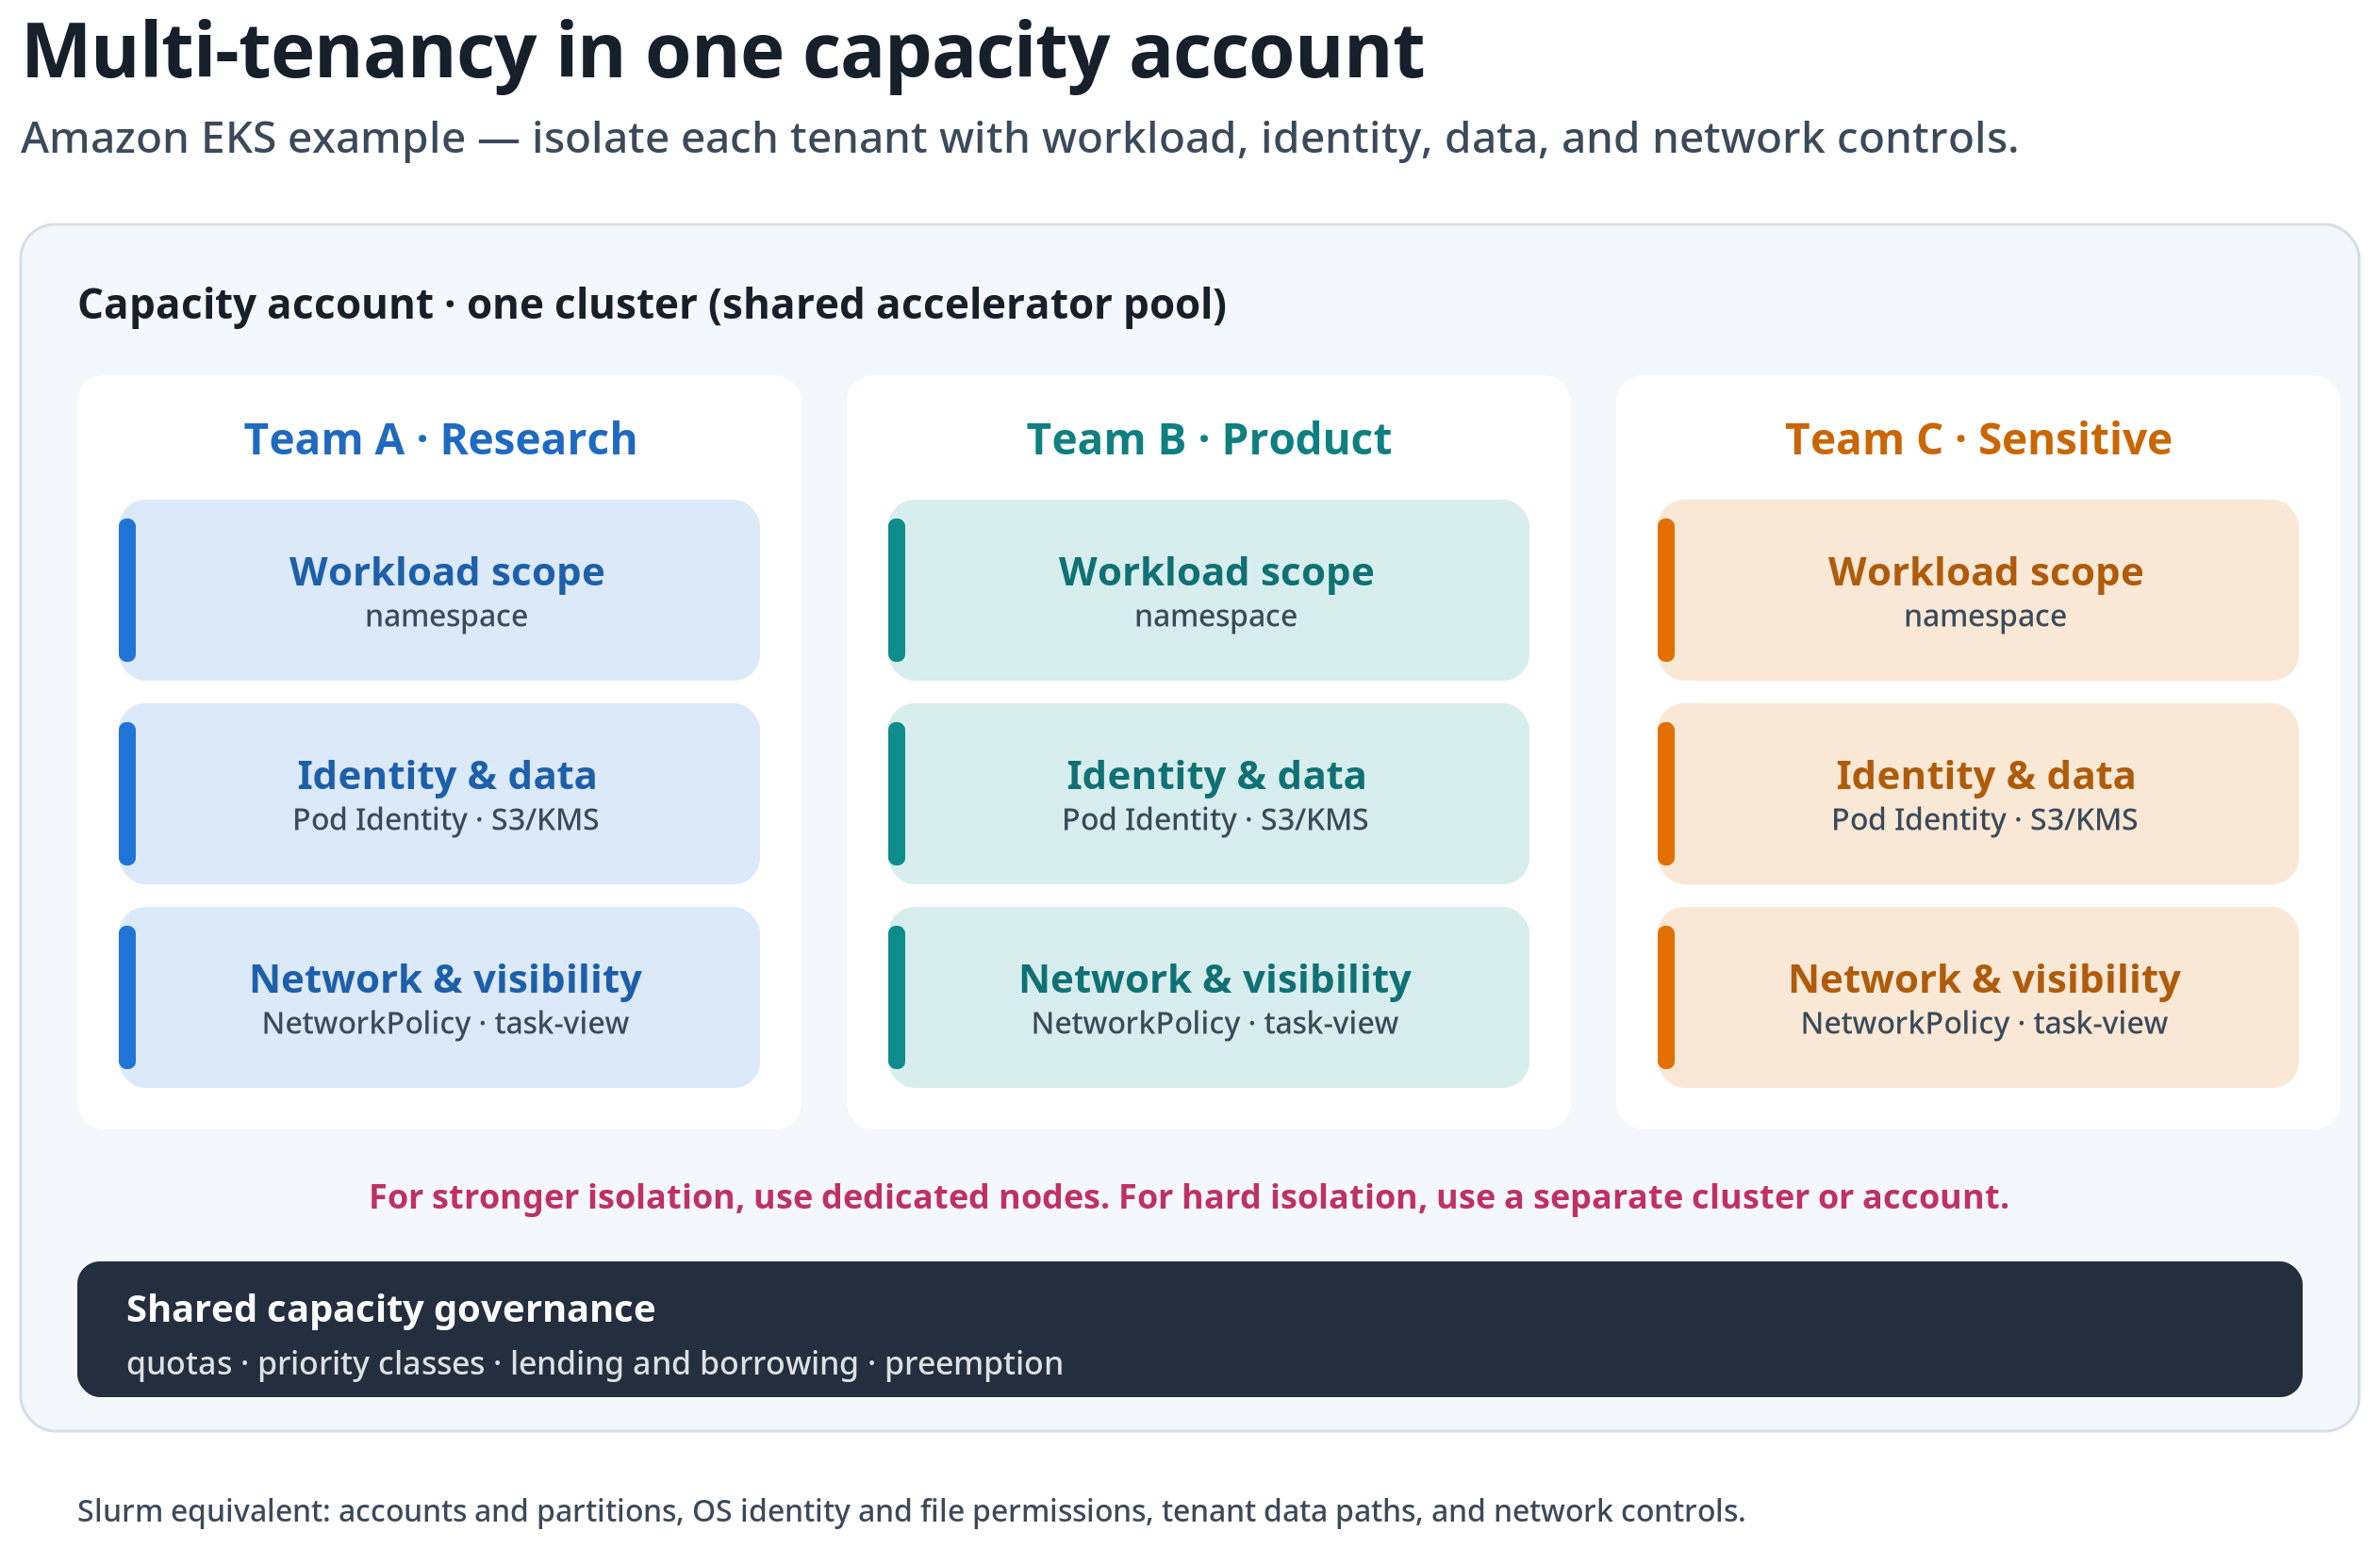
图 2:集中式 SageMaker HyperPod 容量。集群和调度器保留在一个容量账户中。每个租户获得工作负载、身份、数据、网络和任务可见性控制。硬隔离需求使用专用基础设施。
图 3 展示了当 SageMaker Unified Studio 向项目成员公开已批准的 SageMaker HyperPod 计算资源时,这些边界如何连接。
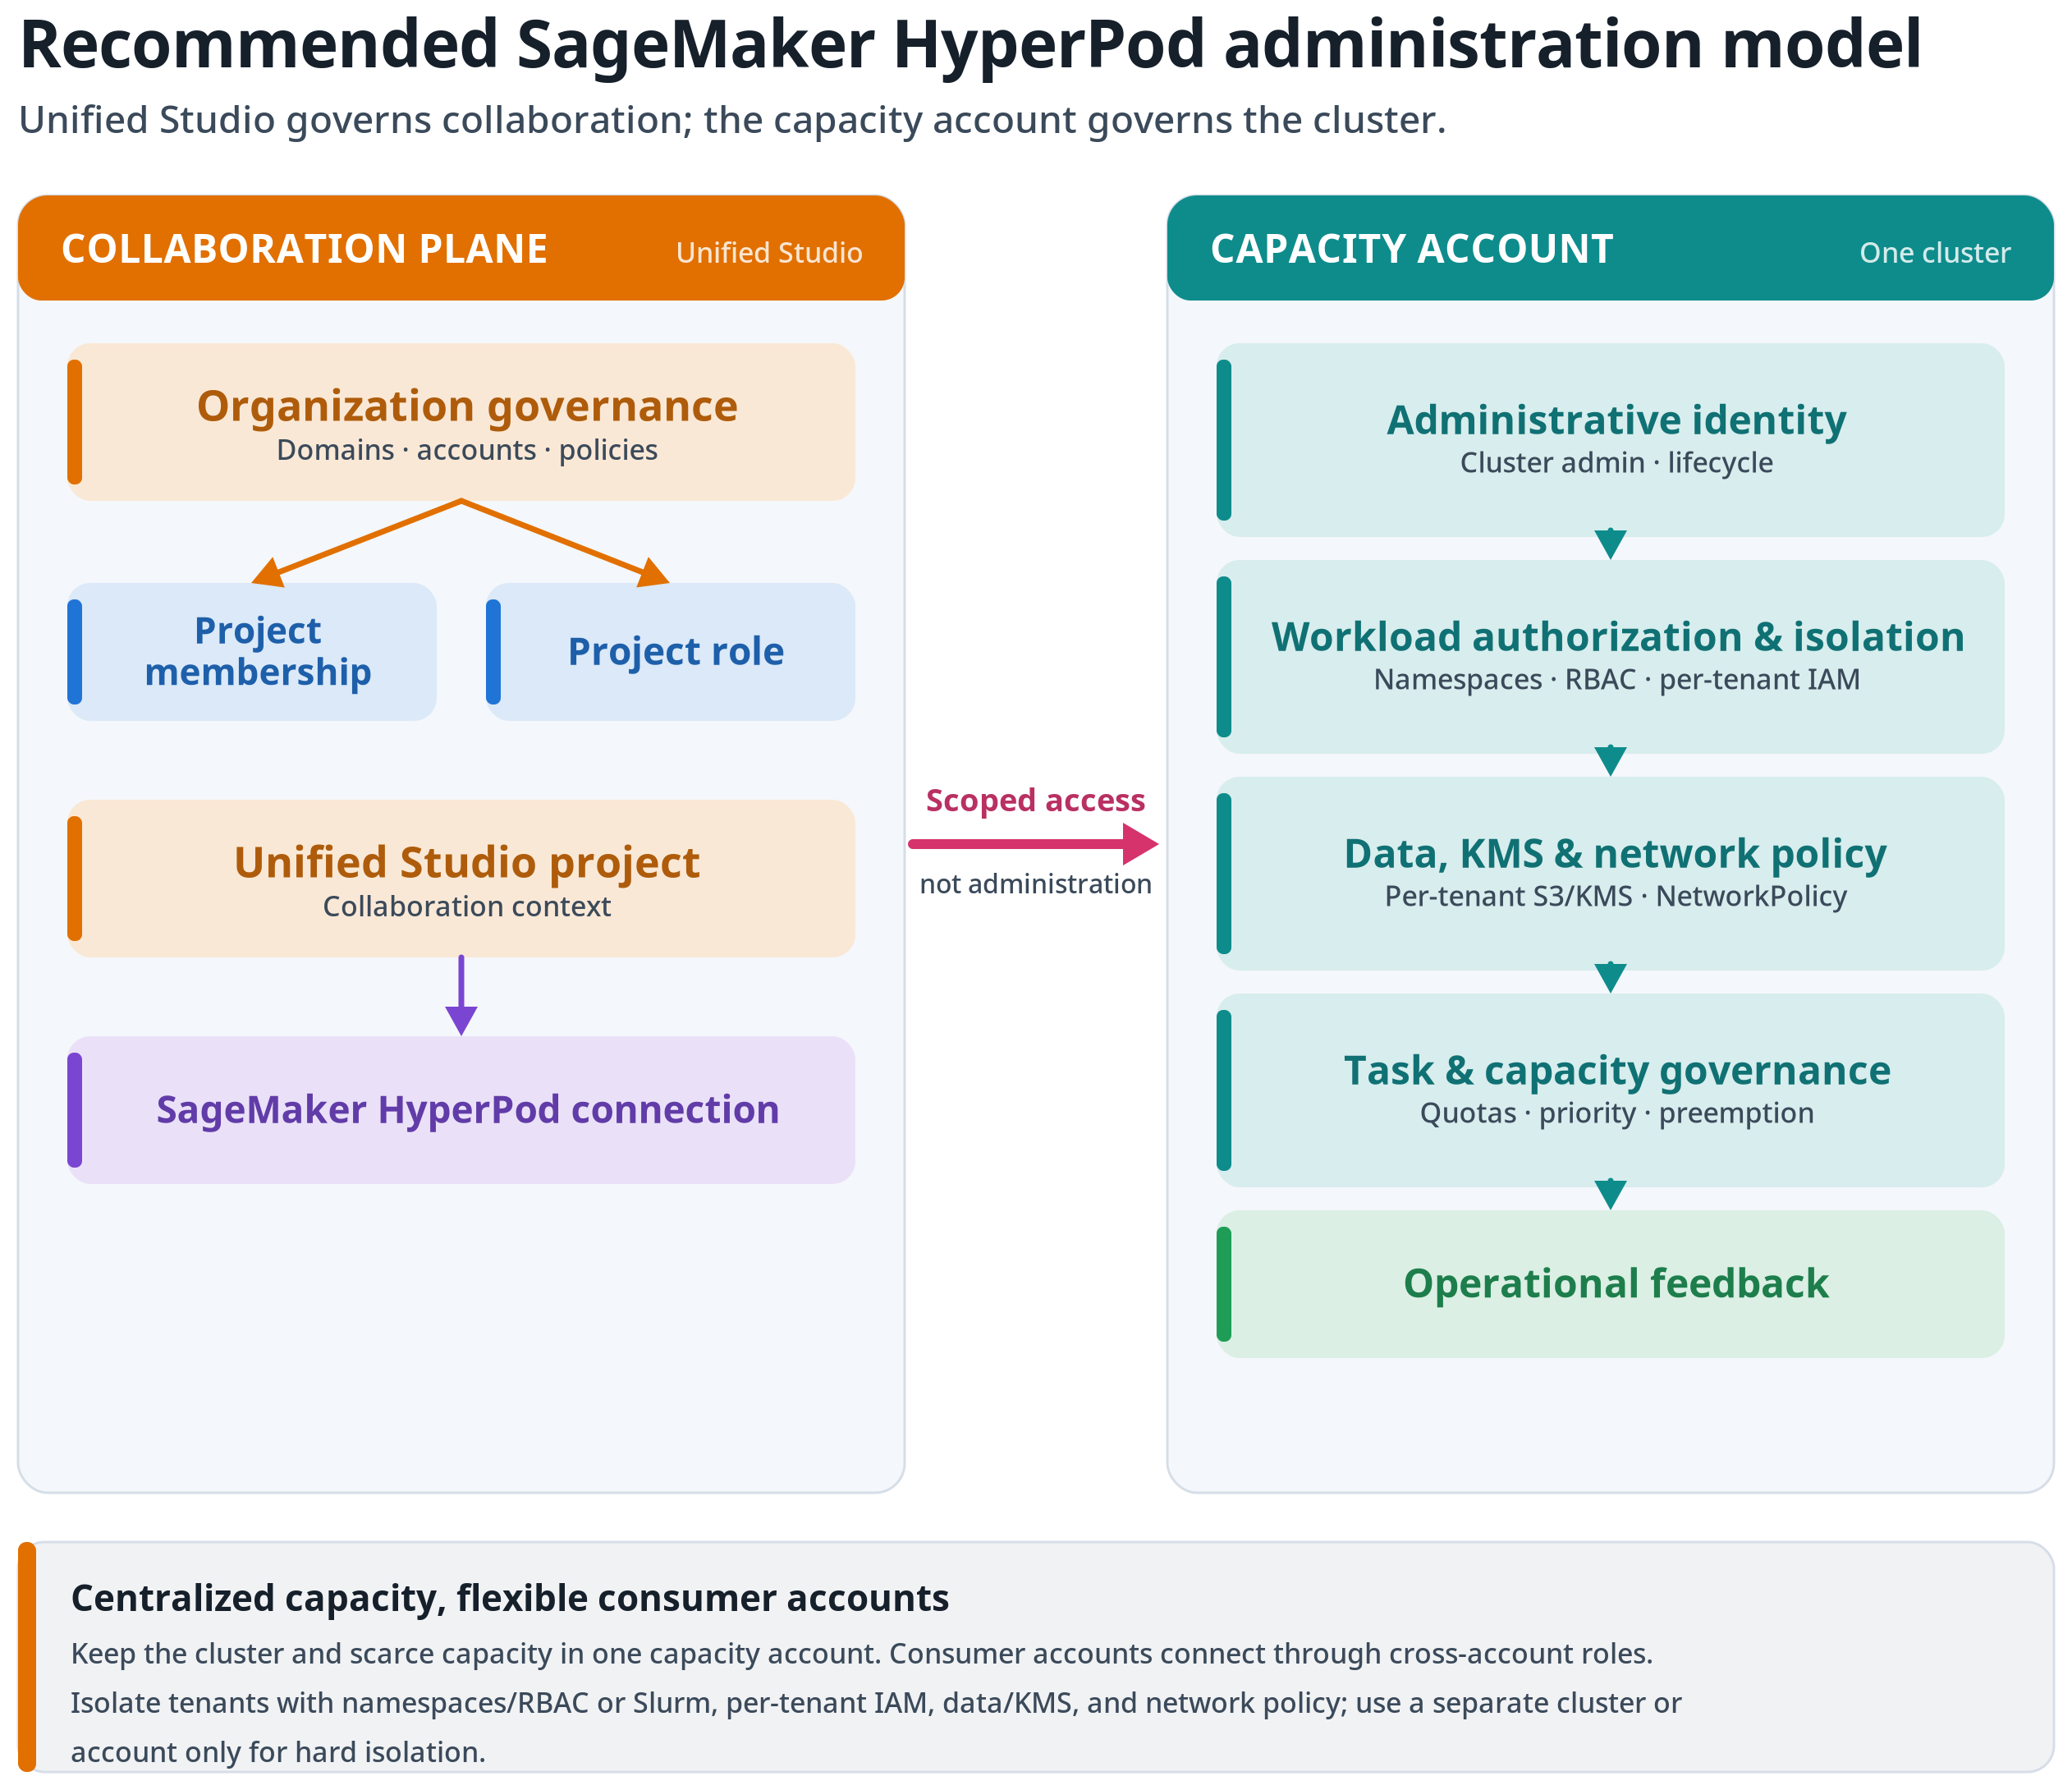
图 3:推荐的 SageMaker HyperPod 管理模型。SageMaker Unified Studio 管理协作上下文,而集群身份、工作负载授权、调度器策略和运维控制保持独立。
确定何时 SageMaker Unified Studio 是合适的管理体验
借助 SageMaker Unified Studio,已在项目中工作的机器学习团队可以遵循已批准的路径访问共享的 SageMaker HyperPod 计算资源。成员可以查找已连接的集群、查看状态和元数据、检查支持的任务和指标,并进入 JupyterLab,而无需使用单独的基础设施清单。
此体验不会取代集群管理。下表展示了每个人物角色应如何将 SageMaker Unified Studio 与特定于服务的界面配合使用。
| 人物角色 | 使用 SageMaker Unified Studio 进行 | 继续使用特定于服务的工具进行 |
| 域或基础设施管理员 | 域单元、项目创建策略、项目配置文件、成员资格策略和账户放置 | 组织级控制、账户预置和基础设施自动化 |
| SageMaker HyperPod 集群管理员 | 呈现已批准的集群连接并查看集群、任务、设置和元数据视图 | 集群创建、更新、弹性配置、附加组件、EKS 或 Slurm 管理以及事件响应 |
| 项目所有者 | 管理项目成员资格并为用户提供已批准计算资源的一致项目上下文 | 请求基础设施变更并批准特定于业务的访问要求 |
| ML 工程师或数据科学家 | 查找已批准的计算资源、查看工作负载状态并打开 JupyterLab 工作流 | 通过 SageMaker HyperPod CLI、kubectl 或 Slurm 工具(视情况而定)提交和管理详细工作负载 |
当项目成员资格、数据访问、开发工具和计算资源需要共同上下文时,使用 SageMaker Unified Studio。对于集群变更和可重复的自动化,继续使用 SageMaker AI API、基础设施即代码和编排工具。有关参考实现和集成,请参阅 AI on SageMaker HyperPod 站点。
在连接集群之前做出基础设施决策
在批准连接之前,记录容量账户、任何消费者或数据账户、AWS 区域、网络路径、身份、所有者、工作负载边界和隔离要求。如果您需要创建集群的指导,请参阅 Amazon SageMaker HyperPod 文档或 AI on SageMaker HyperPod 站点。
分离管理身份与工作负载身份。在创建项目和访问角色时,保留 SageMaker HyperPod 对集群管理员与数据科学家用户的区分。面向项目的角色不应仅因其用户运行工作负载而获得集群生命周期权限。有关支持的权限模型,请参阅 AWS Identity and Access Management for SageMaker HyperPod。
将网络视为端到端控制。将 Amazon EKS Kubernetes API 端点访问限制为经批准的管理网络路径,控制 Pod 的入站和出站流量,并验证项目、连接角色、工作负载角色和集群网络仅支持预期的数据路径。有关编排器特定的配置,请参阅 Orchestrating SageMaker HyperPod clusters with Amazon EKS。
例如,配置对 Amazon EKS API 端点的私有访问,并仅允许来自经批准的管理员或工作负载子网的访问。应用默认拒绝的 Kubernetes NetworkPolicy,并显式允许所需的服务间通信和出站路径。在适当情况下,为 Amazon S3、Amazon Elastic Container Registry (Amazon ECR) 和 Amazon CloudWatch 等服务使用虚拟私有云 (VPC) 端点,并为每个租户分配专用的工作负载角色以进行数据访问。
创建连接契约。连接契约是客户管理的治理记录,例如 wiki 页面、工单、服务目录记录或基础设施即代码仓库中跟踪的文件。它不是平台功能。为每个经批准的项目到集群连接记录以下信息:
- 业务负责人、运营负责人和成本负责人。
- SageMaker Unified Studio 域单元和项目。
- 集群账户、区域、名称和编排器。
- 项目角色以及连接使用的访问角色 Amazon Resource Name (ARN)。
- 经批准的工作负载类型和数据分类。
- EKS 命名空间或 Slurm 访问范围。
- 调度策略和例外负责人。
- 监控、支持和退役预期。
该契约为审查者提供了一条记录,用于评估和批准完整的访问路径。
治理身份与任务可见性
同时控制操作和可见性。任务名称、命名空间、资源请求和使用模式的不当设置可能会泄露其他团队工作的信息。
在可能的情况下,使用组而非个人授权来进行项目成员资格和集群访问。在各自的边界上审查每个角色,而不是创建一个跨越域、项目、集群和工作负载策略的宽泛角色。
以下工作流展示了如何将用户可以看到的内容与用户可以执行的操作分开。
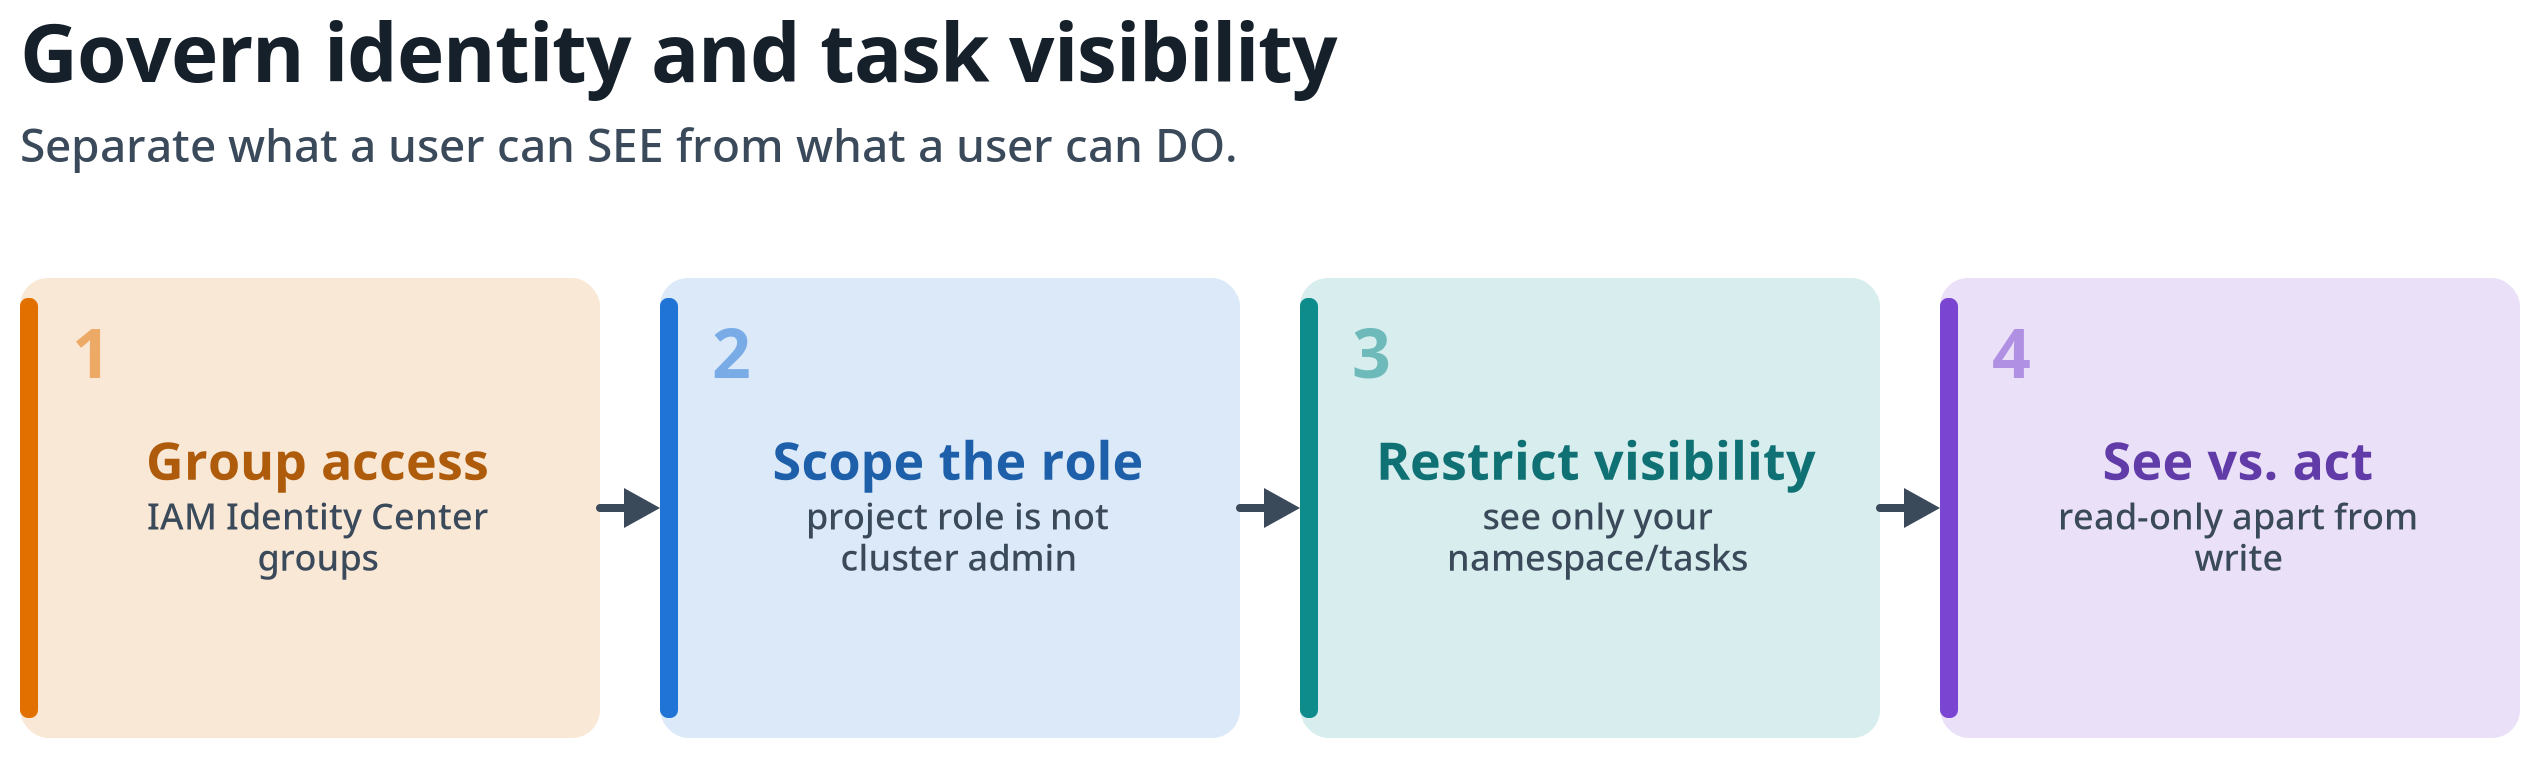
图 4:治理身份与任务可见性。通过组分配访问权限,将每个角色限定在其边界内,限制任务可见性,并将查看工作的能力与对工作采取操作的能力分开。
在载入用户之前审查默认任务可见性。SageMaker AI Studio 中 SageMaker HyperPod 的文档说明,SageMaker AI Studio 用户默认可以看到所有 Amazon EKS 集群任务。对于 Slurm 集群,每个 SageMaker AI Studio 用户都可以查看、管理和交互可用任务。在载入多个团队之前配置任务查看限制:对于 Amazon EKS,请参阅 Restrict task view in Studio for EKS clusters;对于 Slurm,请参阅 Restrict task view in Studio for Slurm clusters。项目成员资格不是集群级安全边界。
对于 Amazon EKS 集群,将每个团队映射到一个已批准的命名空间和 RBAC 权限,并将每个工作负载服务账户映射到一个租户专属的 IAM 角色。对于跨账户数据访问,在容量(集群)账户中将服务账户与 EKS Pod Identity 角色关联,并在关联上设置目标 IAM 角色(targetRoleArn)。随后 EKS Pod Identity 会自动执行跨账户角色代入,因此应用程序代码无需调用 AssumeRole。目标角色位于消费者或数据账户中。将只读可见性与创建、更新或删除工作负载的权限分开。对于 Slurm 集群,定义等效的用户、账户、分区、文件系统和任务可见性控制。
例如,以下 Kubernetes RBAC Role 授予某个团队仅对其自身命名空间中的作业的只读访问权限。创建或删除工作负载需要单独的角色,从而将“查看”与“操作”分开。
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: team-research
  name: research-job-viewer
rules:
  - apiGroups: ["batch"]
    resources: ["jobs"]
    verbs: ["get", "list", "watch"]
  - apiGroups: ["kubeflow.org"]
    resources: ["pytorchjobs"]
    verbs: ["get", "list", "watch"]
将业务优先级转化为调度策略
对于 Amazon EKS 集群,只有在身份和工作负载访问控制到位后,才应用任务治理。
下图区分了这涉及的两个决策。
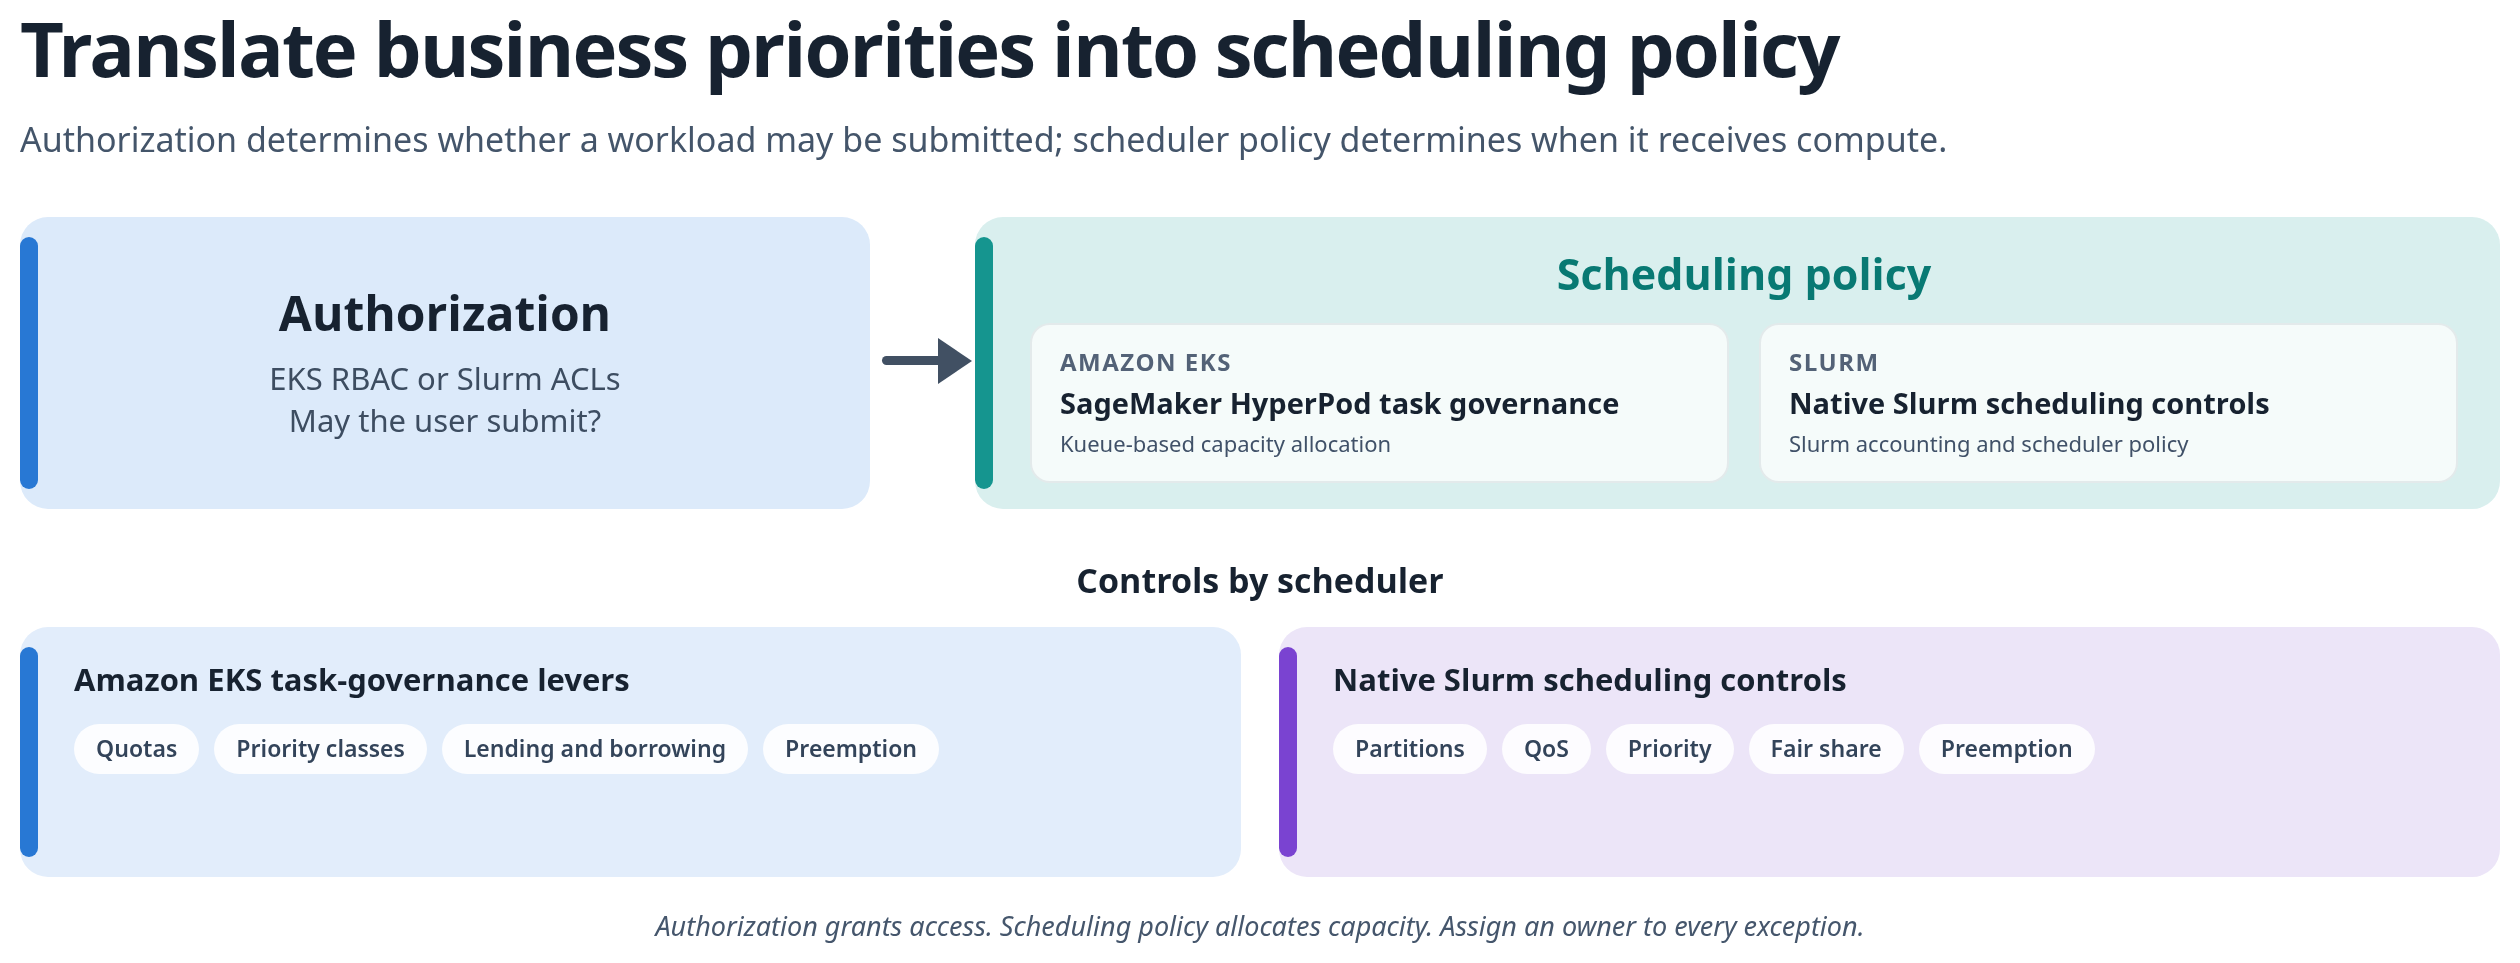
图 5:将授权与调度策略分开。EKS RBAC 或 Slurm ACL 决定用户是否可以提交工作负载。适用于 Amazon EKS 的 SageMaker HyperPod 任务治理或原生 Slurm 调度控制决定工作负载何时获得计算资源。
记录保证容量和共享容量、优先级类别,以及团队是否可以使用其他团队的闲置分配。为每个例外指定负责人。任务治理也适用于 SageMaker HyperPod 空间(直接在集群上运行的自包含 JupyterLab 或 Code Editor 环境),因此请将这些交互式开发工作负载纳入分配策略。
例如,在 Amazon EKS 集群上,你可以为生产训练团队提供 60% 的保证分配和高优先级类别,让研究团队以较低优先级借用闲置容量,并允许在生产团队提交工作时抢占该借用容量。指定一名负责人来批准此策略的任何例外,以免一次性请求悄然成为常态。
将授权与调度策略分开。EKS RBAC 或 Slurm ACL 决定用户是否可以提交工作负载。适用于 Amazon EKS 的 SageMaker HyperPod 任务治理或原生 Slurm 调度控制决定该已授权工作负载何时获得计算资源。将调度器配额用作访问控制,或将授权控制用作调度策略,会导致行为不明确,并使事件更难诊断。
文章 Amazon SageMaker HyperPod 任务治理最佳实践 解释了公平份额权重、配额、借出和借用、优先级类别以及常见分配场景。对于 Amazon EKS 集群,在定义分配策略时使用这些模式。对于 Slurm 集群,使用前面描述的原生调度器控制。
将可观测性用作治理反馈循环
使用 SageMaker Unified Studio,你可以查看 SageMaker HyperPod 集群的任务、指标、设置和元数据详细信息。对于 Amazon EKS 集群,任务治理指标包括硬件、团队和任务视图。这些视图可帮助你比较策略意图与实际消耗。
将可观测性视为一个循环,如下图所示。
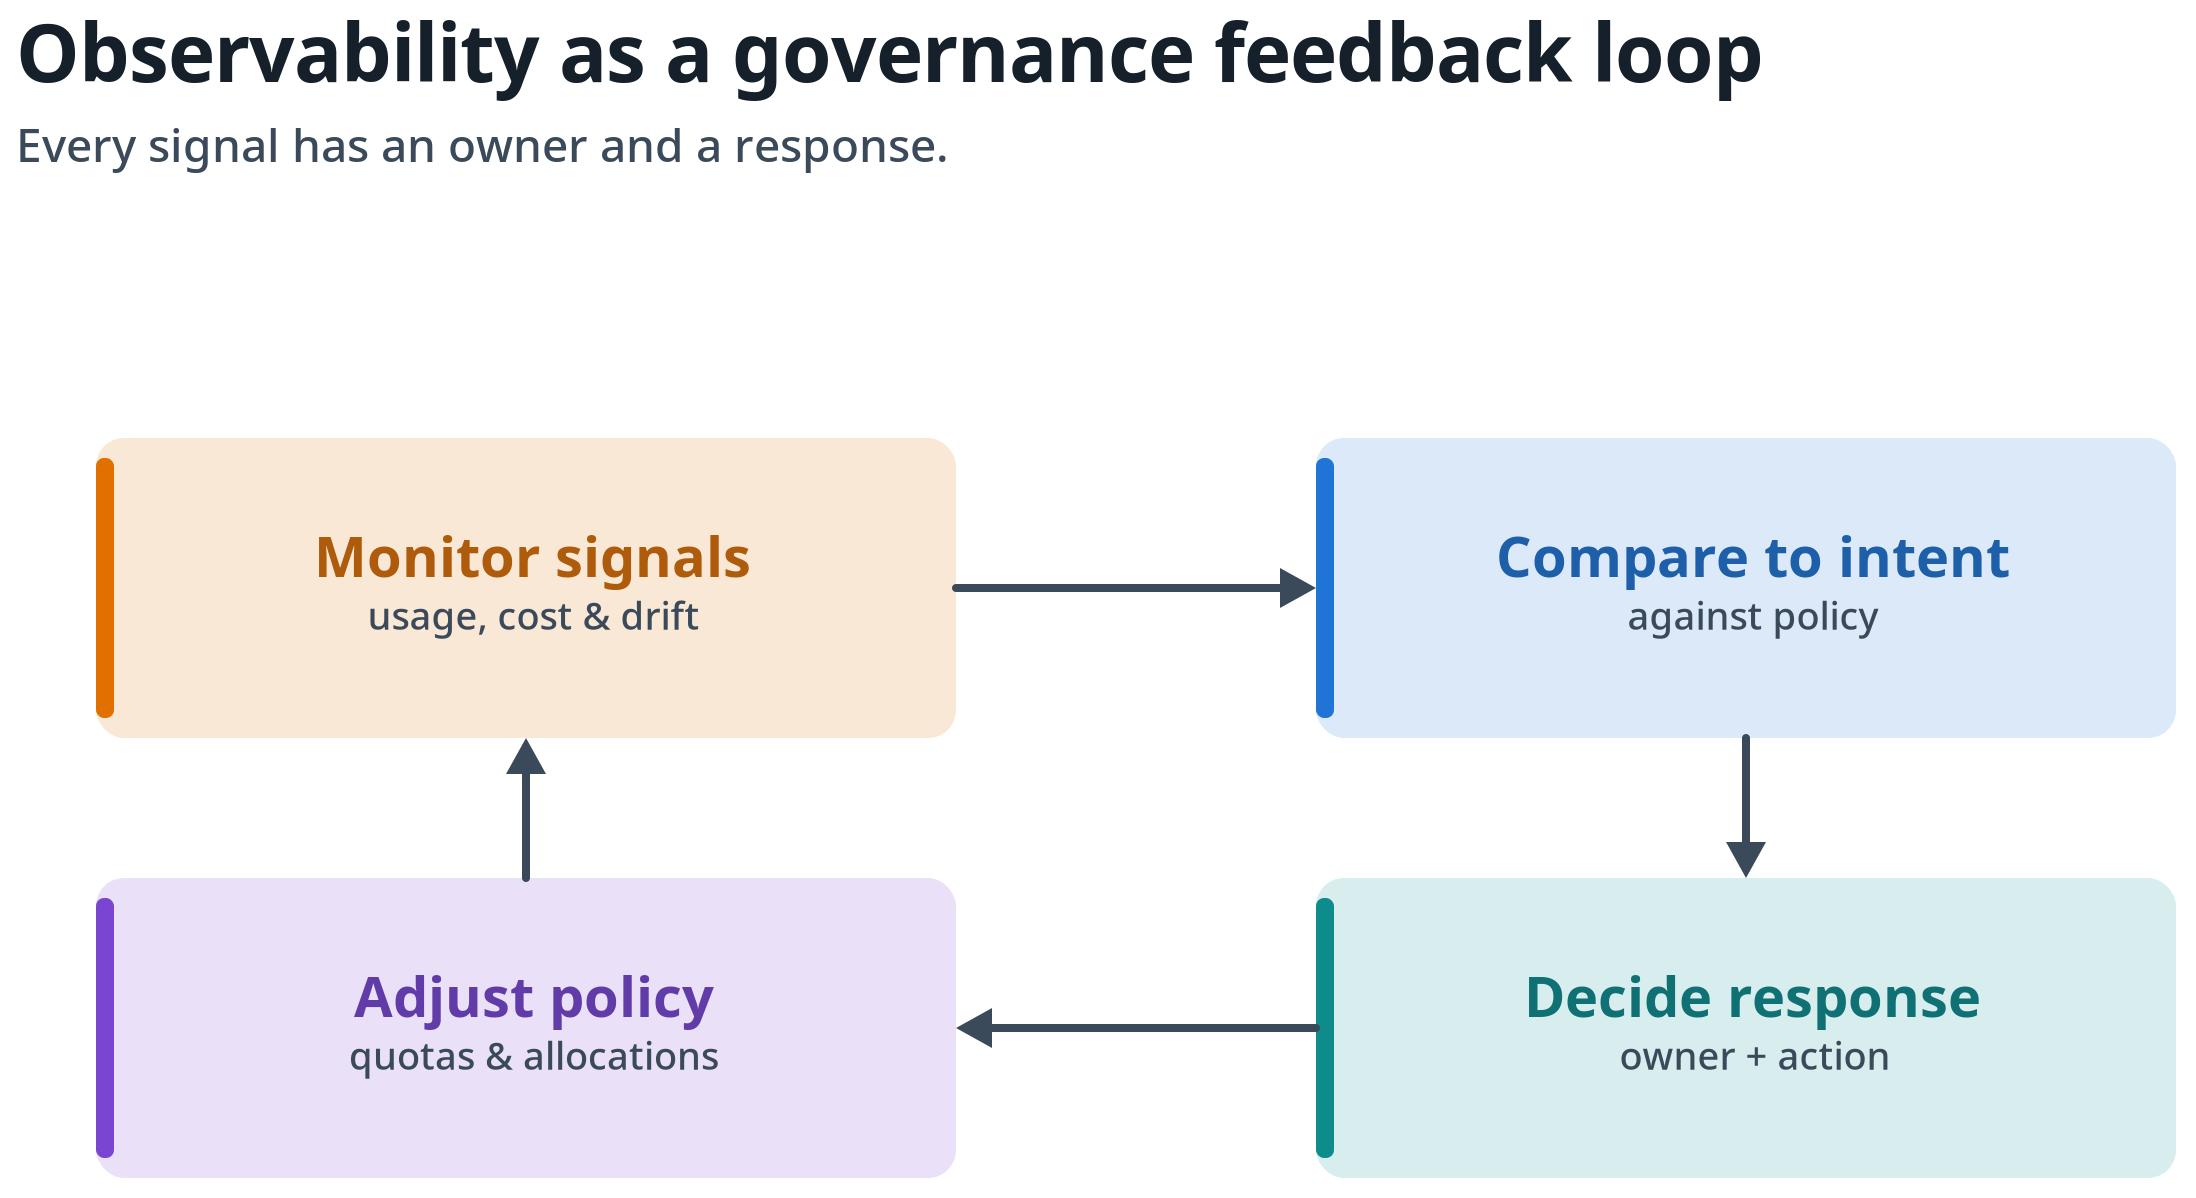
图 6:可观测性作为治理反馈循环。监控信号,将其与策略意图进行比较,决定响应,并调整策略和分配,为每个信号指定负责人和响应。
为每个监控的信号定义负责人和响应。以下示例将仪表板数据转化为管理决策。
| 信号 | 管理决策 |
| 集群容量和加速器利用率 | 确定低利用率是暂时的、由策略驱动的,还是由工作负载约束引起的 |
| 团队分配和利用率 | 审查预留和共享容量是否仍反映业务需求 |
| 任务运行时间和等待时间 | 调查优先级策略、工作负载规模或容量争用 |
| 待处理和已抢占的任务 | 确认调度器结果与已批准的优先级模型一致 |
| 节点健康和恢复事件 | 调用集群事件流程并验证恢复目标 |
对于 Amazon EKS 集群,任务表显示 Kubeflow 任务(PyTorch、MPI 和 TensorFlow),默认显示 PyTorch 任务。通过其他机制提交的工作负载可能不会显示在那里。对于 Slurm 集群,任务表显示当前调度器队列中的作业,而 Slurm 记账通过诸如 sacct 之类的工具提供历史作业数据。定义你从何处获取历史任务数据、审计证据和事件详情。
文档化的指标视图需要 Amazon CloudWatch Observability EKS 附加组件。该附加组件有其自身的前提条件:版本 2.4.0 或更高版本,以及附加到 Kubernetes 工作节点角色的 CloudWatchAgentServerPolicy IAM 策略。提供任务治理视图的 Kueue 指标在免费套餐之后可能会产生 CloudWatch 指标费用。有关当前设置和定价注意事项,请参阅 SageMaker HyperPod 仪表板文档。
在整个生命周期中审查连接
为每个连接设置审查计划。同时为项目所有权、访问角色、账户或区域、集群容量、编排器版本、数据分类或监控覆盖范围的变化定义事件驱动的审查。使用连接契约记录每个决策。
下图显示了生命周期阶段。
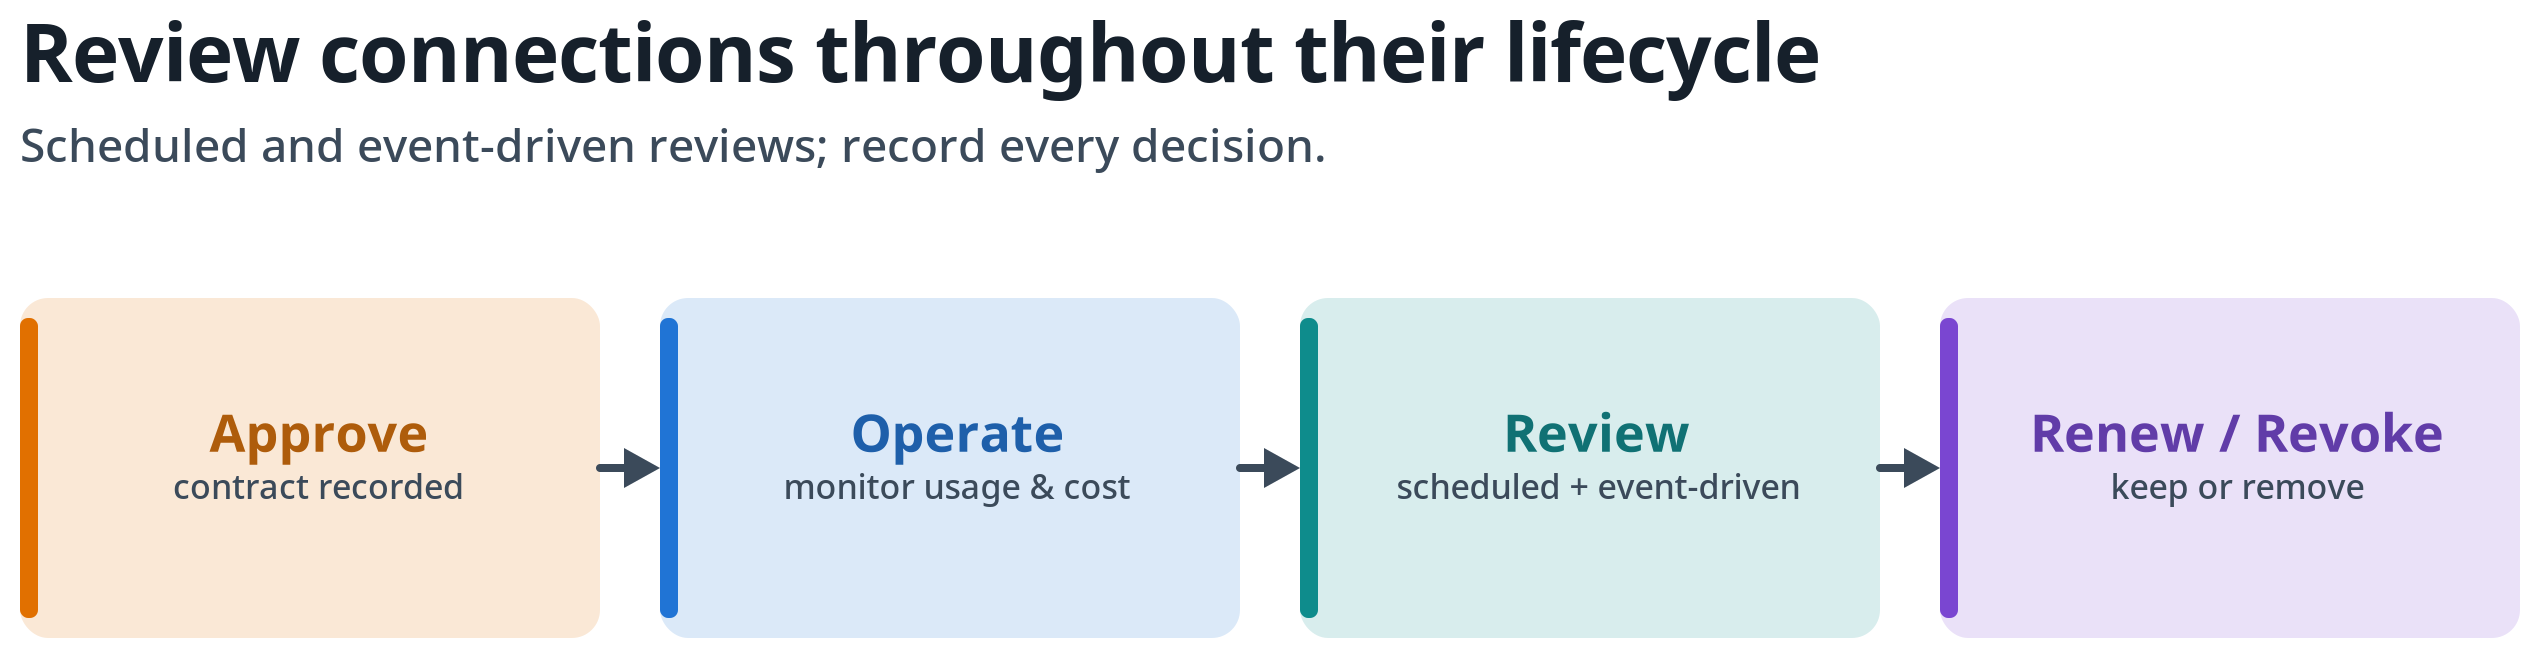
图 7:连接生命周期。通过记录的连接契约批准连接,对其进行运营和监控,按计划和定义的事件进行审查,然后续订或撤销它。
在能减少手动工作的地方自动化清单和证据收集,但将审批权留给负责任的管理员。撤销不再具有业务目的或没有责任负责人的连接。
结论
借助 Amazon SageMaker Unified Studio,机器学习团队可以遵循以项目为中心的路径,获得经批准的 SageMaker HyperPod 计算资源,同时基础设施团队保留对集中式集群的控制。从一个非生产集群和一个测试项目开始。在添加成员之前,为 Amazon EKS 配置工作负载身份、命名空间或 Slurm 范围、数据权限、网络策略、任务视图限制和任务治理,或为 Slurm 配置原生调度控制。安装 Amazon CloudWatch Observability EKS 附加组件以使指标视图填充,并在连接契约中记录完整的审批。对经批准的消费者账户使用跨账户角色,并在需要硬隔离时使用专用基础设施。有关实施步骤,请遵循 SageMaker HyperPod 连接过程。
关于作者

Geethanjali Banoth
Geethanjali 是 Amazon Web Services 的技术客户经理,专注于生成式 AI、人工智能和机器学习。作为 Amazon Bedrock 和 Amazon SageMaker AI 的主题专家,她帮助企业客户在 AWS 上设计、构建、现代化和扩展 AI/ML 及生成式 AI 工作负载。工作之余,她喜欢阅读。

Sai Deepika Bankapalli
Sai 是 Amazon Web Services 的云支持工程师 II(AI/ML),也是 Amazon Bedrock 和 Amazon SageMaker AI 的主题专家。她对生成式 AI 充满热情,帮助客户解决 AI 工作流中的挑战,同时为其业务需求构建定制化解决方案。工作之余,她喜欢与家人共度时光。

Reshma Chikati
Reshma 是 Amazon Web Services 的领域专家工程师,拥有深厚的机器学习背景。作为 Amazon SageMaker AI 和 Amazon Bedrock 的主题专家,她帮助客户应对复杂场景、扫清障碍,并加速在 AWS 上实现生产就绪解决方案的进程。工作之余,她喜欢运动、健身和旅行。
来源:AWS Machine Learning Blog · aws.amazon.com