Amazon Polly 语音克隆正式可用:几分钟录音即可生成品牌专属音色
Amazon Polly launches voice cloning: A unique voice for your brand
Amazon Polly 语音克隆以受限开放形式正式可用,用户提供某位说话人几分钟的录音,即可在 Amazon Polly 生成式引擎上构建该说话人的克隆音色。
原文给出了克隆语音的录制要求、API 调用流程与配额限制,可据此评估接入自有语音品牌的实际成本。
Amazon Polly 的语音克隆功能现已正式可用,采用受限发布形式。只需向 Amazon Polly 提供某位已同意克隆其声音的说话人几分钟的录音,Amazon Polly 就能构建出该说话人声音的专属克隆语音。克隆语音运行在 Amazon Polly 生成式引擎上,其自然度和准确度与其他生成式语音相当。Amazon Polly 语音克隆发布时支持七种语言:英语、西班牙语、德语、法语、意大利语、葡萄牙语和印地语。每个克隆语音只能说出其录制时所用的语言。克隆语音会自动加密并受访问控制:只有您本人才能访问您的克隆语音。
Amazon Polly 语音克隆已在 Amazon Polly 生成式引擎支持的所有 AWS 区域推出,包括 AWS GovCloud(美国)区域。部分 Amazon Polly 客户已可直接使用。其他客户可联系其 AWS 账户团队或申请访问权限以获取使用资格。
借助这一新增功能,您可以将克隆生命周期集成到 AWS 应用中。为 Amazon Polly 客户构建克隆语音是免费的,Amazon Polly 按使用量对克隆语音计费,详情请参阅Amazon Polly 定价页面。
亲耳听一听
点击播放:前几秒是说话人的真实录音,随后其克隆语音会接着说出他们从未录制过的话语。
- From recordings to TTS voice. A few minutes of our science lead Trevor’s source audio, and the resulting generative voice.
- 录音:“大家好,我是来自 Science 的 Trevor。”克隆语音:“第一句是我的真实声音。这是我的克隆语音,由我几分钟的录音生成。它可以朗读你给它的任何文本。”
- Supports seven languages. Hear Jonas, one of the authors, speaking German in his recording and then in his cloned voice:
- 录音:“Hallo, ich bin Jonas. Das ist meine echte Stimme.”(嗨,我是 Jonas。这是我的真实声音。)克隆语音:“Und das ist meine geklonte Stimme! Gleiche Stimme, neue Worte: Diesen Satz habe ich geschrieben, aber nie aufgenommen.”(这就是我的克隆语音!同样的声音,全新的话语:这句话是我写的,但从未录过音。)
- Use in a variety of applications. Here’s Trevor in a new job he hasn’t had: a non-player character in a game.
- “是谁在过我的桥?哦,又是你。和上次一样:回答我的谜语,或者把三明治交出来。”
- Expand your voice library with voice cloning. Hear this audio sample from AWS Chief Evangelist Jeff Barr: a real recording, then his cloned voice.
- 录音:“嗨,我是 Jeff,这是我真实的声音。”克隆语音:“这就是我克隆语音的声音,正在朗读一句我从未录过的话。”
- Hannah: a real recording, then her cloned voice on a support line.
- 录音:“你好,我是 Hannah。这是我的真实声音。”克隆语音:“感谢致电 AnyCompany。您的订单 4471 9902 将于今天发货,预计周四上午 9 点至下午 1 点之间送达。您的确认码是 K-7-Q-2-X-9。”
- Joely: a real recording, then her cloned voice narrating a lesson.
- 录音:“嗨,我是 Joely,这是我真实的声音。”克隆语音:“在本模块中,我们将了解神经网络如何学习。首先,它做出一个猜测。然后,它衡量这个猜测偏差有多大,并一点一点地调整。”
您可以构建什么
跨渠道一致的品牌声音
建立一个可识别的声音,并将其用于您的交互式语音应答(IVR)系统、级联语音智能体、移动应用、店内广播、广告和联网设备。无需依赖通用的库存语音,也无需在每次脚本变更时重新预约录音,您可以按需生成符合品牌调性的音频,在每个渠道中保持一致的音色。
联络中心
在自助服务流程中提供独特且符合品牌调性的声音,并可在优惠和政策变化时更新提示词,无需重新进行录音棚会话。你可以从源文本创建提示词,在全面推广前进行测试,并在问候、路由和通知体验中使用相同的声音。
大规模媒体与内容
创作者、出版商和工作室可以使用多种自定义声音创建有声书、课程、播客、游戏角色和视频,以增强聆听体验,并快速制作后续章节或更新。
保持一致人设的本地化
在内容库中保持可辨识的声音身份,使旁白在各标题和更新之间保持连贯。每个克隆声音仅能说出其录制时所使用的语言。对于多语言体验,请为每种支持的语言创建并审核经批准的声音。
无障碍与个性化
为阅读体验、辅助工具和个性化交互提供自然、拟人化的声音。每次创建声音时,你都需要确认说话者的同意。
声音克隆的工作原理
通过声音克隆,你可以根据单个说话者的录音构建自定义 Amazon Polly 声音,然后通过 Amazon Polly 生成式引擎使用该声音合成语音。该声音需经过四个步骤,从录制说话者到使用成品声音:
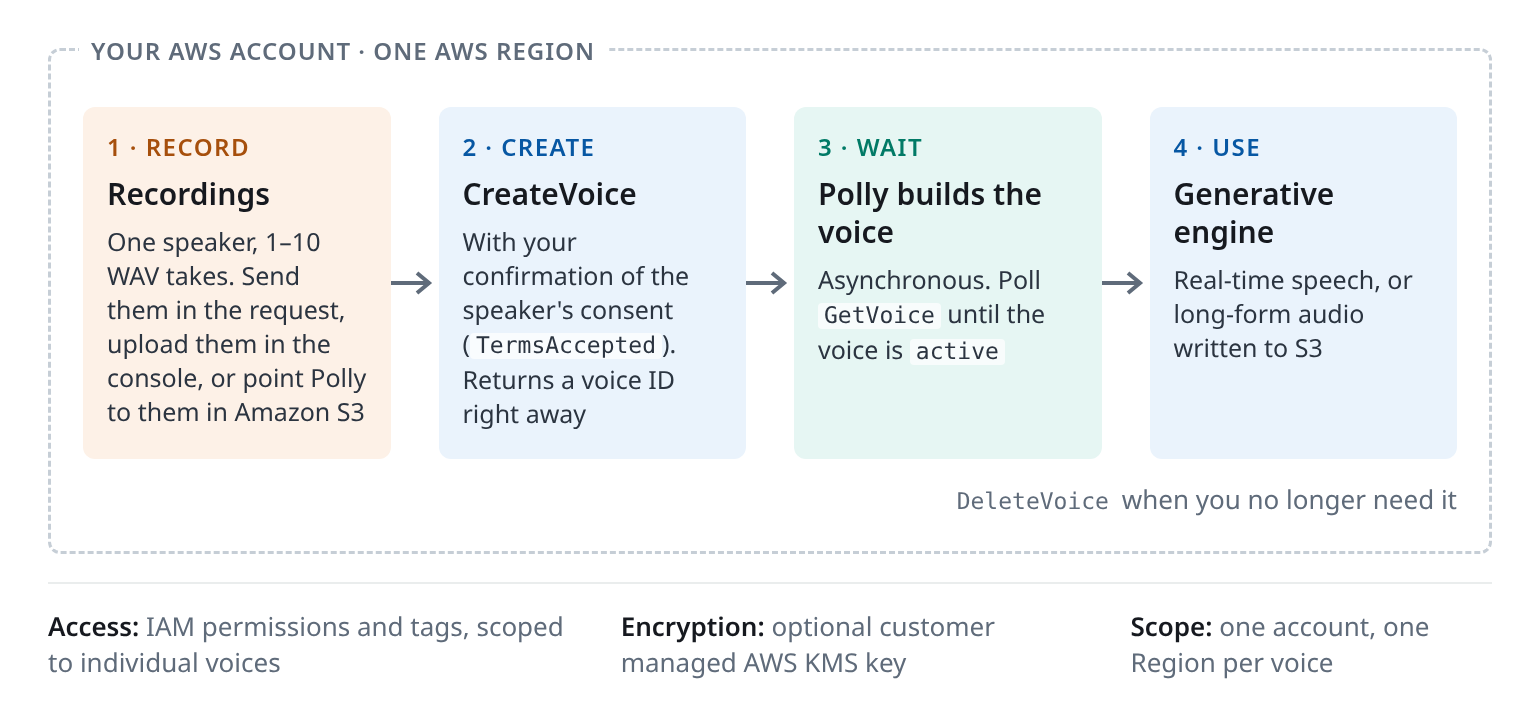
图 1:声音克隆生命周期,从录制说话者到使用成品声音
克隆声音需经过四个步骤:
- 录制。你录制一位说话者(请参阅以下录制提示)。你可以直接在
CreateVoice请求中发送录音,或在控制台上传录音。你也可以将录音存储在所需声音所在 AWS 区域的 Amazon Simple Storage Service(Amazon S3)存储桶中,并让 Amazon Polly 指向这些录音。 - 创建。你使用 1-10 个录音、录音所用语言以及
TermsAccepted=True(你确认已获得说话者同意的声明)调用CreateVoice。Amazon Polly 会立即返回声音 ID(vc-…),并在后台构建声音。 - 等待。创建过程是异步的,通常需要 5-10 分钟。在此期间,Amazon Polly 还会检查你的文本转语音(TTS)声音的说话者相似度质量。你需调用
GetVoice,直到状态从pending变为active或failed。 - 使用。你将声音 ID 传递给
SynthesizeSpeech以获取实时音频,或传递给StartSpeechSynthesisTask以将长格式音频写入 S3,并配合Engine="generative",方式与调用 Amazon Polly 中其他生成式声音相同。当你不再需要该声音时,调用DeleteVoice。
同意与控制
克隆声音基于一个人的录音制作。你需确认已获得说话者对全部录音的同意,并且你控制谁可以使用该声音以及何时删除该声音。
- 你需为创建的每个声音确认同意。在控制台上或通过 API 中的
TermsAccepted=True创建声音时,你需确认已获得创建和使用克隆声音所需的所有权利和同意。你对声音克隆的使用受 AWS 服务条款、生物识别通知与同意条款、AWS 负责任 AI 政策 和 AWS 可接受使用政策 的约束。 - 生成的语音带有水印。Amazon Polly 会为使用克隆声音生成的文本转语音音频添加水印。
- 只有你的账户可以使用它。克隆语音的作用域限定为创建它的 AWS 账户,你可以通过 AWS Identity and Access Management (IAM) 控制访问权限。你可以使用自己的 AWS Key Management Service (AWS KMS) 密钥加密语音并为其添加标签。
- 由你决定何时删除。语音处于活跃状态或创建失败后,只需一次
DeleteVoice调用或在控制台上即可删除语音。 - 语音创建完成后,Amazon Polly 不会保留你的录音副本,也不会使用这些录音来训练 Amazon Polly 模型。它只保留合成语音所需的语音数据,并以加密方式存储。你可以使用自己的 AWS KMS 密钥进行该加密,
DeleteVoice会立即删除数据。
我们建议你:
- 保留每位说话者的同意记录。
- 如果说话者撤回同意,请删除该语音。
- 在适当的情况下,告知听众他们听到的是合成语音。
- 仅向需要的人员和系统授予语音权限。
有关预期用途和限制的详细信息,请参阅 Amazon Polly AI Service Card 和 AWS Responsible Use of AI 指南。
录音最佳实践
你的克隆语音会从录音中学习,包括那些你宁愿它不要学到的部分:笔记本电脑风扇声、房间回声、会议应用的噪声滤波器。
- 录制两到十分钟的自然语音,分成每段不超过一分钟的片段。每个语音最多可发送 10 段录音,音频总时长最多 15 分钟。质量比长度更重要:更多音频可能不会改变语音的声音。
- 一位说话者、一个安静的房间、与麦克风保持相同距离。使用 USB 麦克风,或可以录制 WAV 的手机应用。从一开始就以 24 kHz、16 位、单声道 WAV 录制,这样之后无需转换。Amazon Polly 接受其他音频格式,但我们推荐 WAV。有关支持的格式和限制,请参阅 Amazon Polly Developer Guide。
- 避免使用会议应用和浏览器录音器。它们的回声消除和噪声抑制会改变声音,而克隆也会学习这些改变。
- 以你希望语音具有的风格录制每一段。克隆语音会从录音中获取风格,无法混合多种风格,因此欢快、悲伤和愤怒的片段不会给你一个能同时表现这三种风格的语音。
- 用语音应说的语言录制。语音克隆已使用美国英语、德语、美国西班牙语、法语、意大利语、巴西葡萄牙语和印地语的录音进行测试。这些语言其他口音的录音(如英国英语或加拿大法语)也可使用,但测试较少,因此请用你自己的内容检查语音。
入门
在控制台上:为你的账户启用语音克隆后(参见可用性),展开左侧面板并选择 Voice cloning,上传最多 10 段录音或从 Amazon S3 中选择它们,确认条款,然后选择 Create。每次上传最大可达 5 MB。语音准备就绪后,可在其详情页上试用。
在代码中,你需要:
- 最新版本的 boto3(
pip install --upgrade boto3)。 polly:CreateVoice、polly:GetVoice、polly:DescribeVoices、polly:SynthesizeSpeech和polly:DeleteVoice的 IAM 权限。对于长音频,还需要输出存储桶上的polly:StartSpeechSynthesisTask、polly:GetSpeechSynthesisTask和s3:PutObject。- 对于以下 Amazon S3 示例:你的录音位于创建语音所在区域的存储桶中,并且调用
CreateVoice的 IAM 角色或用户具有s3:GetObject权限。
import time

import boto3

# Use the Region of your S3 recordings.
polly = boto3.client("polly", region_name="us-east-1")

# 1. Create a voice from recordings of a speaker who has given consent.
#    Use 1-10 clean WAV takes of up to a minute each.
takes = [
    "s3://amzn-s3-demo-bucket/brand-voice/take-1.wav",
    "s3://amzn-s3-demo-bucket/brand-voice/take-2.wav",
    "s3://amzn-s3-demo-bucket/brand-voice/take-3.wav",
]
voice = polly.create_voice(
    Name="MyBrandVoice",    # letters, digits, - and _, up to 64 characters
    LanguageCode="en-US",   # the language spoken in the recordings
    TermsAccepted=True,     # you confirm the speaker's consent and the terms of use
    VoiceCreationData={
        "Recordings": [{"Format": "wav", "Data": {"S3Url": url}} for url in takes],
    },
    Tags={"consent-record": "speaker-0042"},  # optional: the ID of your own consent record, e.g. a signed release
    # Optional: encrypt the voice with your own KMS key (symmetric, same Region).
    # Callers who create or use the voice need kms:DescribeKey,
    # kms:GenerateDataKey and kms:Decrypt on the key.
    # CustomerManagedEncryption={
    #     "KmsKeyArn": "arn:aws:kms:us-east-1:111122223333:key/EXAMPLE"
    # },
)["Voice"]
voice_id = voice["Id"]      # for example "vc-0123456789"

# 2. Check the status every 30 seconds until the voice is active or failed
#    (usually a few minutes). Stop with an error after 20 minutes.
deadline = time.monotonic() + 20 * 60
while voice["Status"] not in ("active", "failed"):
    if time.monotonic() > deadline:
        raise TimeoutError(f"{voice_id} is still {voice['Status']}")
    time.sleep(30)
    voice = polly.get_voice(VoiceId=voice_id)["Voice"]
if voice["Status"] == "failed":
    # Check the recordings, delete this voice and create a new one.
    raise RuntimeError(f"{voice_id}: {voice.get('StatusReason', 'creation failed')}")

# 3. Synthesize speech with your new voice.
speech = polly.synthesize_speech(
    VoiceId=voice_id,
    Engine="generative",
    LanguageCode="en-US",
    OutputFormat="mp3",
    Text="Hello! This is my very own Amazon Polly voice.",
)
with open("my-voice.mp3", "wb") as f:
    f.write(speech["AudioStream"].read())

# When you no longer need the voice:
# polly.delete_voice(VoiceId=voice_id)
如果 Python 报告 Polly 对象没有属性 create_voice,请升级 boto3。
对于有声书章节或课程模块等长文本,请使用异步合成任务将音频写入 S3:
from pathlib import Path

task = polly.start_speech_synthesis_task(
    VoiceId=voice_id,
    Engine="generative",
    LanguageCode="en-US",
    OutputFormat="mp3",
    OutputS3BucketName="amzn-s3-demo-bucket",
    OutputS3KeyPrefix="narration/chapter-01",
    Text=Path("chapter-01.txt").read_text(encoding="utf-8"),
    # SnsTopicArn="arn:aws:sns:us-east-1:111122223333:polly-tasks",  # notify instead of polling
)["SynthesisTask"]
print(task["TaskId"], task["OutputUri"])  # poll get_speech_synthesis_task until "completed" or "failed"
如需了解可使用 Amazon Polly 构建的更多端到端语音 AI 应用(包括语音克隆功能,例如级联语音代理和实时语音翻译器),请前往 Amazon Polly GitHub 仓库。
生产环境注意事项
提前创建语音
语音创建需要几分钟,因此应将其视为预置步骤,而不是用户请求的一部分。一个小型工作流(例如 AWS Step Functions 或作业队列)可以调用 CreateVoice,每 30 秒检查一次 GetVoice,直到语音处于活动状态,然后将语音 ID 存入配置。CreateVoice 和 DeleteVoice 共享每秒 1 次请求的限制,因此请将批量创建和删除操作排队。
维护清单
DescribeVoices 会列出你克隆的语音以及 Amazon Polly 内置的语音。克隆语音的 Origin 设置为 customer。请为每个语音存储语音 ID、区域、语言、同意书引用和所有者,并为每个语音指定唯一的 Name。如果 CreateVoice 调用超时或返回服务器错误,该语音可能已经存在,而 SDK 的自动重试可能会创建第二个语音。重试前请检查 DescribeVoices 中是否已有该名称。
为错误做好准备
当你超过与 DeleteVoice 共享的每秒 1 次请求限制时,CreateVoice 会返回 ThrottlingException;当账户在该区域达到克隆语音配额时,会返回 ServiceQuotaExceededException。对仍在创建中的语音进行合成或删除会返回 ConflictException。如果语音使用你自己的 KMS 密钥,无权访问该密钥的调用方会收到访问被拒绝错误。创建失败时,StatusReason 只给出一般性消息,因此请按照前述录音最佳实践检查录音,然后删除失败的语音并创建新语音。
将权限限定到语音
克隆语音是 IAM 资源,因此你可以授予处理流量的角色仅使用所选的一个语音进行合成的权限。如果该语音使用你自己的 KMS 密钥,该角色还需要访问该密钥。请将 polly:CreateVoice 和 polly:DeleteVoice 保留给单独的预置角色。以下是服务角色的示例策略:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "polly:SynthesizeSpeech",
      "Resource": "arn:aws:polly:us-east-1:111122223333:voice/vc-0123456789"
    }
  ]
}
使用标签,你可以通过 aws:ResourceTag 条件为一整组语音编写一次相同的规则。同时请检查现有策略:允许对所有资源执行 polly:SynthesizeSpeech 的语句("Resource": "*")也会覆盖账户中的每个克隆语音。
规划配额和区域
每个账户在每个区域的初始配额为 10 个克隆语音。如需申请增加配额,请联系你的客户团队或 AWS Support。语音仅存在于你创建它的账户和区域中。如需在其他区域或账户中使用,请使用相同的录音在该区域重新创建语音,并确保说话者的同意书涵盖每一份副本。
用真实脚本进行测试
在语音上线之前,请听它朗读你自己的内容:产品名称、数字、地址以及你拥有的最长句子。同一文本在不同请求之间可能略有不同。对于固定提示(例如电话线路问候语),请生成一次音频,经说话者和品牌团队批准后,提供存储的文件。如果某个名称或术语读错,请在文本中以不同方式拼写,或使用语音合成标记语言 (SSML) 的 <phoneme> 标签。音素标签适用于英语、法语、意大利语、德语和西班牙语的克隆语音。请参阅 支持的 SSML 标签。
须知
| 可用性 | 访问权限按 AWS 账户启用。如果你在 Amazon Polly 控制台中看到 Voice cloning(展开左侧面板,查看是否列出了 Voice cloning),则说明你的账户已启用该功能。如果没有,你可以联系你的 AWS 账户团队或申请访问权限以请求访问。支持的 AWS 区域与生成式引擎相同:美国东部(弗吉尼亚北部)、美国西部(俄勒冈)、欧洲(法兰克福)、欧洲(苏黎世)、欧洲(伦敦)、亚太地区(悉尼)、亚太地区(首尔)、亚太地区(新加坡)、亚太地区(东京)、加拿大(中部)以及 AWS GovCloud(美国西部)。克隆语音存储在你创建它所在的 AWS 区域。 |
| 语言 | 英语、德语、西班牙语、法语、意大利语、葡萄牙语和印地语。已测试的录音地区:美国英语(en-US)、德语(de-DE)、美国西班牙语(es-US)、法语(fr-FR)、意大利语(it-IT)、巴西葡萄牙语(pt-BR)和印地语(hi-IN)。这些语言的其他口音也可使用,但测试较少。每个语音说其录制时所用的语言。 |
| 录音 | 每个语音 1-10 段录音,总计最长 15 分钟。推荐使用 WAV:单声道、16 位、24 kHz 或 44.1/48 kHz。Amazon Polly 也接受其他音频格式。控制台上传每个文件限制为 5 MB。对于更大的文件,请使用 Amazon S3。 |
| 数据处理 | 语音创建完成后,Amazon Polly 会删除其保存的录音副本,并且不会将其用于训练 Amazon Polly 模型。它仅保留合成所需的语音数据,并以加密方式存储(你可以使用自己的 AWS KMS 密钥),直到你调用 DeleteVoice。 |
| 创建时间 | 构建 TTS 语音通常需要 5-10 分钟,异步进行。 |
| 合成延迟 | 与 Amazon Polly 中的生成式语音相同。 |
| 配额 | 初始情况下,每个账户在每个 AWS 区域可拥有 10 个克隆语音。如需申请提高配额,请联系 AWS Support。CreateVoice 和 DeleteVoice 共享每秒 1 个请求的限制。 |
| 合成 | 克隆语音遵循 Amazon Polly 针对生成式语音的配额,包括每次请求和每个合成任务的文本限制。请参阅Amazon Polly 配额。 |
| 定价 | 创建克隆语音是免费的。Amazon Polly 按需对克隆语音的使用收费。请参阅Amazon Polly 定价。 |
| API | 使用 CreateVoice、GetVoice、DeleteVoice 和 DescribeVoices 管理语音。使用 SynthesizeSpeech 和 StartSpeechSynthesisTask 配合 Engine="generative" 来使用这些语音。请参阅Amazon Polly API 参考。 |
结论
Amazon Polly 中的语音克隆为你的应用提供人们熟悉的声音:只需录制一次,并获得说话者同意,即可通过 Amazon Polly API 使用。要在控制台上开始使用,请确保你的账户已启用 Voice cloning,准备一段录音和所需的同意书,打开Amazon Polly 控制台,然后创建你的第一个克隆语音。如果你是新客户并希望启用语音克隆,请联系你的 AWS 账户团队或申请访问权限以获取访问权限。
有关开发人员指南,请参阅Amazon Polly 文档。有关定价,请参阅Amazon Polly 定价页面。有关你可以使用 Amazon Polly 构建的其他语音 AI 用例(包括语音克隆),请查看GitHub 仓库。
我们迫不及待想听到你的作品。
感谢 Trevor Wood、Jonas Rohnke、Suyin Wang、Hannah Barrett、Nikie Xiong、Jeff Barr 和 Joely Huang 献声。
关于作者

Suyin Wang
Suyin 是 AWS 的高级生成式 AI 解决方案架构师。她拥有多年构建数据驱动和机器学习应用以解决实际问题的经验。她乐于帮助客户识别需要解决的正确问题,并构建能带来业务价值的生成式 AI 解决方案。业余时间,她喜欢唱歌,或在厨房里尝试新食谱。

Jonas Rohnke
Jonas 是 Amazon Polly 的高级技术项目经理。他将科学、工程和产品结合在一起,把研究中的新声音送到客户手中,包括本文中介绍的克隆声音。他喜欢保持简单的计划和人们真正能听到的发布。工作之外,他操控无人机飞越英国乡村拍摄短片,还会制作比他所承认的辣得多的辣椒油。

Nikie Xiong
Nikie 是 Amazon Polly 的高级技术产品经理。她在 AI、语音技术以及将创新产品从想法推向发布方面拥有 10 多年经验,覆盖消费者和企业领域。凭借产品设计和媒体娱乐制作背景,她擅长打造令客户愉悦的产品和体验。工作之外,她创作互动艺术,并喜欢 techno 音乐。
来源:AWS Machine Learning Blog · aws.amazon.com