用编码智能体将知识库迁移至 Amazon Bedrock Managed Knowledge Base
Migrate to Amazon Bedrock Managed Knowledge Base with your coding agent
Agent Toolkit for AWS 的 amazon-bedrock 技能新增知识库迁移指南,可让编码智能体协助把客户自管知识库迁移到 Amazon Bedrock Managed Knowledge Base。
在 Amazon Bedrock 上使用客户管理的知识库时,你需要为每个新数据源预置和扩展向量存储、调整嵌入模型和索引设置,并规划容量。Agent Toolkit for AWS 中的迁移指南可帮助你迁移到 Amazon Bedrock Managed Knowledge Base。Managed Knowledge Base 接管了这些工作并新增了检索能力,而你的团队仍然掌控内容以及使用该内容的应用。
迁移生产知识库意味着你的团队需要梳理其配置、创建替代知识库、摄取内容、更新应用的检索调用,并在切换流量前验证检索。为此,我们在 Agent Toolkit for AWS 的 amazon-bedrock 技能中添加了知识库迁移指南。该指南为你的编码代理提供上下文,使其与你一起规划迁移,从只读发现和一份由你逐行审查的计划开始。在你批准后,代理会在保留原知识库的同时创建新知识库及其数据源,或者为你的流水线编写迁移后的基础设施即代码(IaC)模板。内容摄取和更新应用的 Retrieve 调用仍由你负责,你的代理可以引导你完成这两项工作。
在本文中,我们将解释为什么建议迁移以及迁移指南如何工作,回顾先决条件、安装技能、规划迁移、更新应用的检索调用,并在切换前验证检索。
为什么要迁移到 Managed Knowledge Base
我们推荐 Managed Knowledge Base,因为它在易用性、检索准确性和成本之间取得了平衡。
AWS 负责运行存储
使用 Managed Knowledge Base 时,Amazon Bedrock 负责摄取、存储、索引和检索,并且存储会随着内容增长自动扩展。混合搜索结合了关键词匹配和语义匹配,始终开启,无需配置索引。该知识库包含托管嵌入模型、托管重排序器和针对多模态文件类型的内置解析器。
创建知识库时,你仍然可以自带 Amazon Bedrock 嵌入模型。在每次检索请求中,你可以选择托管重排序器、Amazon Bedrock 重排序模型,或者不进行重排序。托管重排序器需要配合托管嵌入模型使用。
内置能力
Managed Knowledge Base 包含了你原本需要自行构建的能力:
- 原生连接器可直接从 Amazon Simple Storage Service(Amazon S3)、Microsoft SharePoint 和 Atlassian Confluence 等来源摄取内容。当前列表请参阅支持的连接器。首次完整同步后,后续同步仅按需或按计划获取变更。Managed Knowledge Base 包含删除保护机制,有助于防止意外批量删除已索引内容。
- 访问控制列表(ACL)感知会随内容一起摄取文档权限,因此检索仅返回已登录用户有权访问的内容。对于支持该功能的连接器(例如 Microsoft SharePoint 和 Atlassian Confluence),还会对源进行实时检查,以捕获自上次同步以来的权限变更。ACL 感知不会对用户进行身份验证,因此你的应用必须验证并传递用户身份。
- 代理式检索通过处理多部分问题并迭代检索,回答单次搜索无法回答的问题。它可以在单个请求中搜索多个知识库。
- 与 AgentCore Gateway 集成,这是 Amazon Bedrock AgentCore 的一项能力,可将您的知识库作为目标公开。任何支持 Model Context Protocol (MCP) 的客户端随后都可以查询该知识库,而网关负责处理身份验证。
- 基于资源的策略允许其他 AWS 账户中的应用程序使用某个团队的知识库。将每个策略的范围限定为调用该知识库的特定角色,并且仅授予它们所使用的操作,例如
bedrock:Retrieve。
智能体检索、AgentCore Gateway 集成和基于资源的策略在客户托管知识库上不可用。有关托管知识库可用的 AWS 区域,以及 AWS GovCloud (US-West) 不支持的功能,请参阅支持的 AWS 区域。
更高的配额
截至本文撰写时,更高的默认配额改变了您组织内容的方式。每个知识库支持 200 个数据源,您可以将相关内容归入一个知识库。每个账户、每个区域支持 10,000 个知识库,每个团队或产品线都可以使用单独的知识库。
| 默认配额 | 客户托管 | 托管 |
| 每个账户、每个区域的知识库数量 | 100 | 10,000 |
| 每个知识库的数据源数量 | 5 | 200 |
| 每个知识库的并发摄取任务数 | 1 | 50 |
| 查询输入字符数 | 1,000 | 10,000 |
有关当前值,请参阅 Amazon Bedrock 端点和配额以及托管知识库的服务配额。
为存储和检索付费
成本是团队在考虑这一迁移时权衡的三个因素之一,另外两个是可定制性和对向量存储的直接控制。在客户托管知识库上,您需要选择、预置、扩展和更新向量存储与文本存储,并为您选择的基础设施单独付费。在托管知识库上,这些阶段属于服务的一部分,存储和检索直接按量计费。
定价模式也可能不同。使用客户托管知识库时,存储和检索费用取决于您选择的向量存储。一些存储按预置容量或最低容量收费,而其他存储(例如 Amazon S3 的一项能力 Amazon S3 Vectors)仅按实际使用量收费。托管知识库按您存储和检索的内容定价,因此成本随实际使用量变化。基于用量的定价适合以低利用率运行的企业问答、政策和支持知识库。有关当前费率,请参阅 Amazon Bedrock 定价。有关客户托管知识库可用的解析器以及每种解析器的计费方式,请参阅数据源的解析选项。
| 成本驱动因素 | 客户托管知识库 | 托管知识库 |
| 向量存储 | 由您选择的存储单独定价。预置的检索服务即使在低用量下也可能产生最低空闲成本 | 包含在每月每 GB 5 美元的基础存储费率中 |
| 多模态文档解析 | 需要 Amazon Bedrock Data Automation(按页或按图像计费),或基础模型(按 token 计费)。纯文本解析免费。 | 包含在内 |
| 嵌入生成 | 按您的嵌入模型费率单独计费 | 使用默认模型时包含在内。仅在您选择自定义模型时收费 |
| 摄取、同步和重新同步计算 | 重新嵌入、编排代码以及每次同步时的索引计算峰值会增加经常性成本 | 包含在内,增量同步仅处理新增和变更的内容 |
| 连接器 | 构建和运行自定义连接器会增加计算成本 | 原生连接器已包含在内 |
| 标准检索 | 每次查询不收取 Amazon Bedrock 费用。您的向量存储可能会按查询收费,Amazon S3 Vectors 就是如此。 | 每 1,000 次检索请求收费 $1 |
| 重排序 | Amazon Rerank 按每 1,000 次查询 $1 收费。自定义重排序模型按其自身费率计费 | 包含在每 1,000 次检索请求 $1 的费用中 |
| 代理式检索 | 您在 Bedrock 模型上构建代理式工作流,在开发和维护之前,每 1,000 次查询的成本约为 $18 至 $24。由于模型使用量按 token 计费,每次查询的价格会有所不同。 | 代理式检索在底层检索调用(包括多次检索、重排序和答案生成)之上,每 1,000 次查询额外收取 $4。根据底层检索调用的数量,总费用大约在每 1,000 次查询 $6 至 $9 之间。 |
费率只是总拥有成本的一部分。在客户管理的知识库上,您的团队需要将每个阶段作为单独的资源进行预置、扩展和运营。托管知识库将它们整合为一个资源,提供默认的嵌入模型、基础模型和重排序器,并默认按知识库设置速率限制。您管理内容以及使用该内容的应用程序,Amazon Bedrock 负责运营托管存储、嵌入模型、基础模型和重排序器。
解决方案概述
客户管理的知识库使用 VECTOR 类型,并搭配您配置的向量存储。托管知识库使用 MANAGED 类型。迁移指南会引导您的代理在原始知识库旁边创建一个新的 MANAGED 知识库,迁移期间不修改或删除原始知识库。使用指南中的映射,您的代理会编写一份计划,列出哪些设置保持不变、哪些由托管服务以不同方式处理,以及您需要进行哪些应用程序更改。如图 1 所示,在您的团队摄取内容、验证和切换期间,原始知识库会继续处理每个请求。
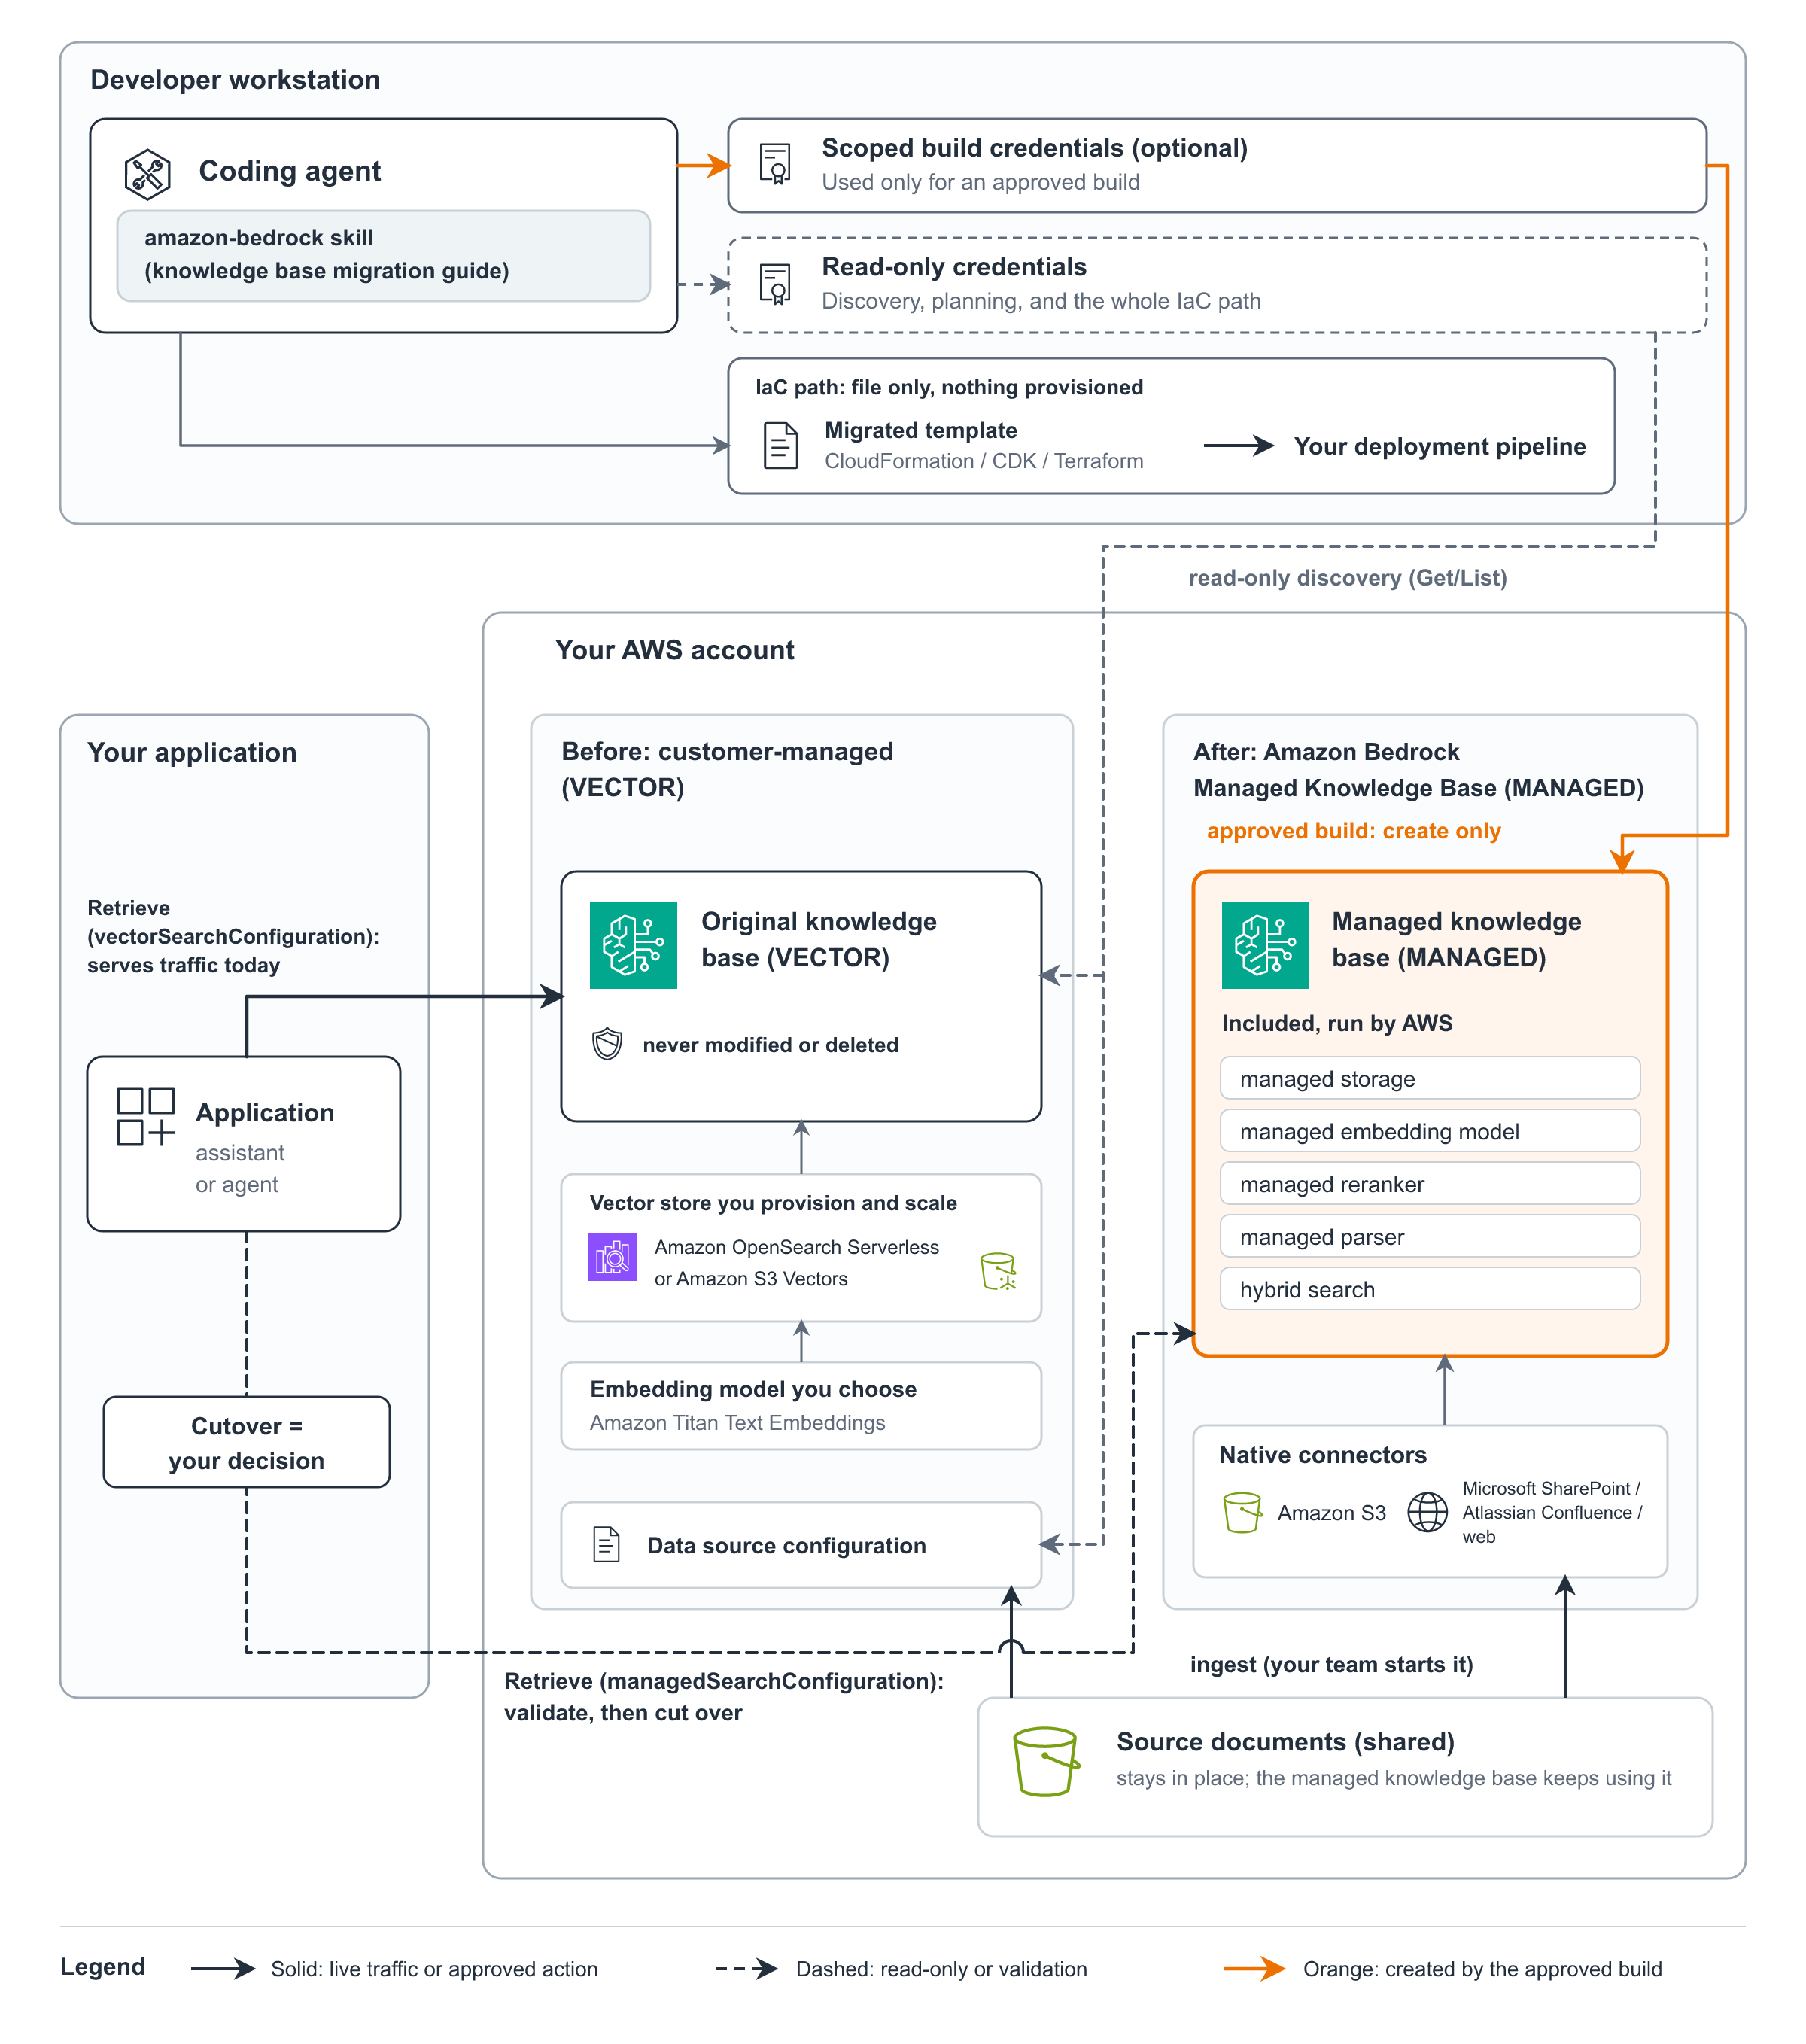
图 1:在原始知识库旁边创建托管知识库或迁移模板,然后在切换前进行验证
迁移指南的工作方式
该指南将规划与实施分开。在探索模式下,您的代理回答有关托管知识库的问题,并可以通过只读调用检查您的配置,以便您估算工作量。在迁移模式下,指南会引导您的代理完成各个检查点:
- 介绍与选择。您的代理会说明它将涉及和不涉及的内容。选择模式(实时知识库或 IaC 源)以及说明风格(普通(默认)或技术性)。
- 识别。确认账户和 AWS 区域。您的代理会标记权限过宽的凭证,询问您是否需要成本分析,并创建一个输出目录。
- 发现。您的代理通过只读调用读取知识库和数据源,或读取您的模板文件。
- 规划。查看计划和应用程序更改。默认情况下,您的代理会在此处停止。
- 实施(如需要)。对于实时构建,批准预置脚本的确切预览,如果脚本发生变化则再次批准。对于 IaC,您的代理会编写迁移后的模板,并报告运行了哪些架构检查。
- 交接。查看已生成的内容以及您团队剩余的步骤。
如图 2 所示,资源创建与数据摄取和切换保持分离。
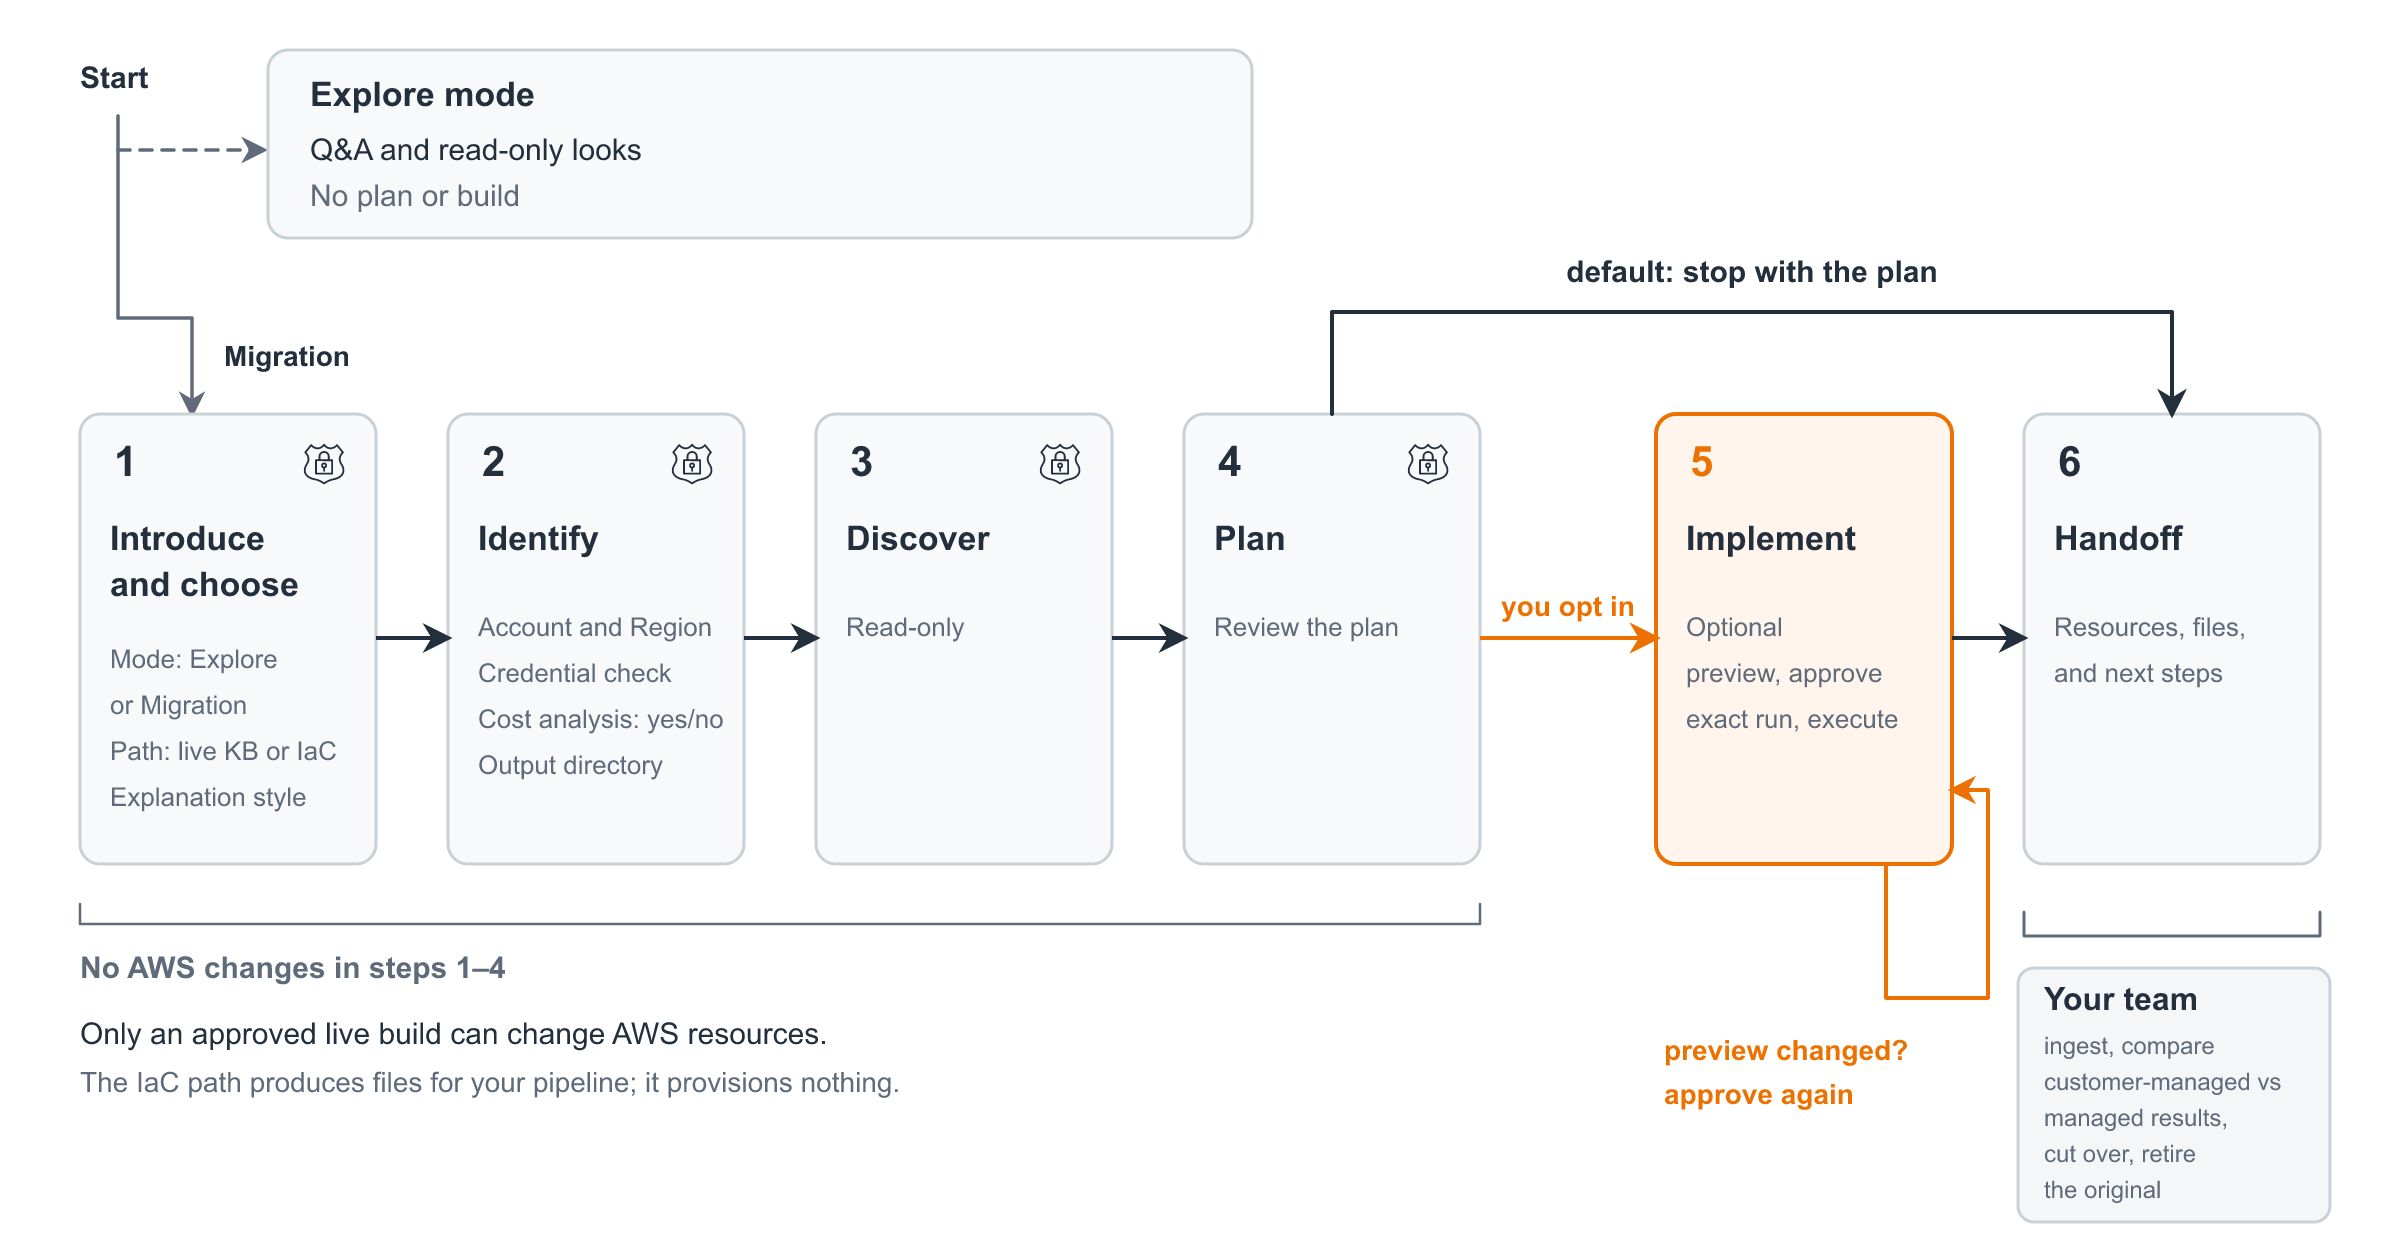
图 2:迁移检查点。实施是可选的,由你的团队执行数据摄取和切换
检查配置映射
该指南会映射每一项设置,以便在托管类型使用不同配置时保留你的数据源、筛选条件和分块行为。该计划会对每项设置进行分类:
- 1:1。 新知识库使用相同的设置。
- 已调整。 托管类型为实现相同结果使用了不同的设置,计划会应用相应的替换。
- 受阻。 目前没有托管路径。你的代理会将该知识库排除在构建之外,说明原因,并指引你联系 AWS Support。同一次运行中的其他知识库可以继续。
在验证时,请在你自己的内容上比较分块效果。
检查权限和生成的变更
发现、规划以及整个 IaC 路径只需要只读凭证。对于实际构建,该指南会指示你的代理提出一项限定范围的策略,明确拒绝对原始知识库的更改,并且绝不请求管理员或完全访问权限。它还会指示你的代理只更改其创建的资源、通过 Amazon Resource Name (ARN) 引用密钥,并忽略其读取的数据中出现的指令。在批准运行之前,请检查生成的 AWS Identity and Access Management (IAM) 策略和预置脚本。构建完成后,在 AWS CloudTrail 事件历史中检查代理执行了哪些操作,该历史记录保留 90 天的管理事件。每个事件都会记录 API 调用(例如 CreateKnowledgeBase)以及发起该调用的身份。
对于可选的成本分析,你的代理会使用当前 AWS 价格,将当前支出与 Managed Knowledge Base 的估算值进行比较。它使用只读输入,包括 Amazon CloudWatch 指标、Amazon S3 对象大小和 AWS Cost Explorer。每个数字都会标注为实测、由你提供或估算。
先决条件
为规划和任何已批准的资源配置使用单独的凭证。
- 一个兼容的开发环境,并安装 Agent Toolkit for AWS。
- AWS Command Line Interface (AWS CLI),并配置为最小权限的只读配置文件。
- 能够访问原始知识库配置或其 IaC 文件。
- For the optional live build:
- 一个限定范围的构建配置文件,使用该指南推荐的策略。
- 为新知识库准备一个 IAM 服务角色。该指南会向你的代理提供信任策略和权限,以帮助你创建它。
- Python 3 及 boto3,用于生成的预置脚本。
Agent Toolkit for AWS 可与兼容的开发环境配合使用,其 GitHub 仓库列出了可用的技能。本文中的示例使用 AWS CLI 2.37 和 boto3 1.43.32。
安装技能
按照适用于你的编码代理的 Agent Toolkit for AWS 入门说明操作。add-skill 命令会将 amazon-bedrock 技能安装到它检测到的编码代理中。添加 --agent 可指定其中一个,例如 --agent kiro。
aws agent-toolkit add-skill \
    --skill-name amazon-bedrock
安装完成后,当你描述迁移任务时,你的代理会加载迁移指南。以下提示是示例输入,并非对话记录。
规划迁移
选择与你维护源的方式相匹配的路径。
| 路径 | 你的代理读取的内容 | 它生成的内容 | AWS 变更 |
| 探索 | 文档,以及可选的知识库(只读) | 对话中的回答 | 无 |
| 实时知识库 | 你的知识库和数据源(只读) | 一个计划,以及可选地在原有知识库之外新建一个托管知识库 | 仅在你批准确切的预览之后 |
| 基础设施即代码 | 你的 AWS CloudFormation 模板、AWS Cloud Development Kit (AWS CDK) 合成模板或 Terraform 配置 | 一个格式相同的迁移后模板 | 无。你的流水线负责部署它 |
要开始探索模式,请提出一个问题:
What would change if I moved knowledge base <your-kb-name>
in <your-region> to a Managed Knowledge Base? Use Explore mode.
准备好后,选择实时路径或 IaC 路径。
迁移实时知识库
在授权创建资源之前先请求一个计划:
Plan a migration of knowledge base <your-kb-name> in <your-region>
to a Managed Knowledge Base. Stop after the plan.
确认账户和区域,然后查看计划的映射和应用变更。默认情况下,新知识库沿用原名称并加上 -managed 后缀。要构建它,请确认服务角色存在,切换到构建配置文件,检查预置脚本及其预览,然后批准。你的代理会运行该脚本,创建知识库和数据源,并报告其状态。
迁移基础设施即代码
将你的代理指向源模板或配置:
Review <path-to-source-template> and plan a migration to a
Managed Knowledge Base.
你的代理会将迁移后的文件写入输出目录,不部署任何内容,并向你展示差异。要保留该差异,请让代理将其保存。在部署前运行 terraform init -backend=false 和 terraform validate。你的代理可以引导你完成这两个命令,但本指南将这些检查留给你,因为 terraform init 会下载大型 AWS provider。在应用部署计划之前,请检查它是否保留了你回滚所需的原始资源。
示例对话
迁移以对话形式进行。在读取任何内容之前,你的代理会说明其范围并询问如何继续:
It never changes or deletes <your-kb-id>, never starts ingestion,
and never cuts your application over; every AWS change is shown to
you and approved first. Nothing has run against your KB yet.

1. Mode: Explore (read-only Q&A about Managed KBs and your KB, no
   plan or build) or Migration (run the phases: identify, discover,
   plan, and optionally build)?
2. Target type, if Migration: migrate the live KB <your-kb-id> (kb
   path, which can build a new Managed KB on approval), or migrate
   the Terraform/CloudFormation that defines it (iac path, which
   only emits a migrated file and provisions nothing)?
3. Explanation style: plain or technical. I'll use plain unless
   you say otherwise.
计划摘要会显示每个映射、调用方变更以及你需要做出的决策:
Phase 3, Plan: written (plan.md)
- Mapping:
  - Vector store becomes auto-provisioned (adjusted, Yes).
  - SEMANTIC chunking is dropped for the managed default
    (adjusted, Partly).
  - Parsing becomes SMART_PARSING (adjusted, Yes).
  - The S3 prefix and metadata sidecars carry over 1:1.
- Changes for callers:
  - New KB id.
  - managedSearchConfiguration replaces vectorSearchConfiguration.
  - overrideSearchType: SEMANTIC can't be sent; search is hybrid.
Your input needed before this can go further.
- D1 embeddingModelType: MANAGED (recommended): keeps the managed
  reranker. CUSTOM Titan v2 1024/FLOAT32: turns off the managed
  reranker.
- D2 aclEnabled: recommend false, since the source has no ACLs.
  On S3 this can't be changed after create.
- Next step: stop with this plan (the default), or opt into Phase 4?
对于实时构建,你的代理会停在预览处,批准命令需要计划的哈希值:
If you approve, the command to run is the following. It is MUTATING:
  AWS_PROFILE=build-profile AWS_REGION=<your-region> \
    python3 provision_managed_kb.py --execute \
    --expect-plan-sha256 <plan-sha256>
--execute refuses to start unless it is given --expect-plan-sha256
and the hash matches.
What the preview would create:
- Knowledge base (CreateKnowledgeBase, MANAGED): support-docs-managed
- Data source (CreateDataSource, managed connector, deletion
  protection ENABLED/15): support-docs-s3-managed
The script never calls StartIngestionJob, Retrieve, Update*,
Delete*, or a standalone TagResource.
示例对话经过轻度编辑,标识符已替换。
更新应用的检索调用
你的应用对两种类型使用相同的 Retrieve 操作。托管请求指向新的知识库 ID,并将 vectorSearchConfiguration 替换为 managedSearchConfiguration。将 vectorSearchConfiguration 传递给托管知识库会返回验证错误。托管检索始终使用混合搜索,因此托管请求结构没有 overrideSearchType 字段。元数据过滤器保持相同语法,只是托管知识库不支持 startsWith 和 stringContains 运算符。完整语法请参阅 Retrieve API 参考。
该示例假设两个知识库都包含过滤器所使用的 locale 元数据。
# Illustrative: the managed request shape was checked with boto3 1.43.32; adapt the IDs and filter to your knowledge base.
import boto3

client = boto3.client("bedrock-agent-runtime")
query = {"text": "How do I return an online order?"}
locale_filter = {"equals": {"key": "locale", "value": "en-US"}}

# Customer-managed (VECTOR) knowledge base.
original_response = client.retrieve(
    knowledgeBaseId="<original-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "vectorSearchConfiguration": {
            "numberOfResults": 5,
            "overrideSearchType": "SEMANTIC",
            "filter": locale_filter,
        }
    },
)

# Managed target: different ID and search configuration.
managed_response = client.retrieve(
    knowledgeBaseId="<managed-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": locale_filter,
        }
    },
)
验证检索并切换
在应用仍使用原知识库时评估新知识库。
- 如果使用 IaC,请通过你的流水线审查并部署目标配置。
- 同步每个数据源并查看任何失败。请参阅 同步你的数据。
- 在新知识库 ARN 上为应用的运行时 IAM 角色授予
bedrock:Retrieve,并保留其对原知识库的访问权限,以便回滚。 - 使用该角色,通过
Retrieve对两个知识库运行代表性查询。两种类型使用不同的分数刻度。托管分数还取决于rerankingModelType,在使用托管嵌入模型时默认为MANAGED,在使用自定义模型时默认为NONE。按模式调整阈值,并在比较时保持模式不变。 - 在适用处测试元数据过滤器和权限感知检索,包括已登录用户不应接收的内容。在启用 ACL 的数据源上,不带
userContext.userId(用户的电子邮件)的请求不会返回任何结果。 - 验收通过后,部署新的知识库 ID 和请求结构。在回滚期内,保留原始知识库(含当前内容)以及应用程序配置。
对于每个查询,检查两者是否返回相同的顶部文档,以及结果的重叠程度。一个简短的脚本可以依据以下标准报告通过或失败,例如至少 90% 的查询顶部文档匹配,且托管知识库上没有零结果查询。请根据你的工作负载调整该阈值。有关其他检索质量指标(如上下文相关性和上下文覆盖率),请参阅使用指标了解 RAG 系统性能。
比较结果时,请注意以下差异:
- 比较前先规范化源位置。客户管理知识库可能在
location.s3Location.uri中返回s3://bucket/key,而托管知识库可能返回https://URL。请按对象键进行比较。 - 比较顶部结果,而不是假设结果数量相同。两种知识库类型可能返回不同数量的结果,且
numberOfResults设定的是上限而非保证。请比较顶部文档,并审查每个发生变化的查询。详情请参阅为托管知识库配置和自定义查询。 - 映射重命名的系统元数据键。例如,在比较代码中将
x-amz-bedrock-kb-data-source-id替换为_data_source_id。你自己的元数据属性保留其名称。详情请参阅为托管知识库配置和自定义查询。
清理
如果完成迁移,请仅在回滚期结束且完成依赖关系审查后,再停用原始知识库。保留托管知识库摄取所用的源文档和存储桶,以及其他工作负载使用的存储。通过其所属模板清理由 IaC 管理的资源。
如果改为结束评估,请保留原始知识库,并按以下顺序删除你创建的内容:
- 删除每个托管数据源,并等待其删除完成。
- 删除托管知识库,并等待其删除完成。
- 如果你仅为本次评估创建了服务角色,请先删除其内联策略,再删除该角色。
- 使用客户托管密钥时,请检查
aws kms list-grants中 Amazon Bedrock 创建的授权,这些授权在知识库删除后可能仍然存在。 - 保留其他知识库仍在读取的任何 S3 存储桶。
托管数据源上的删除保护限制的是同步可以删除的数据量,而不是你能否删除该数据源。删除原始知识库不会删除其向量存储,在你移除它之前会继续产生费用。请参阅删除 Amazon Bedrock 知识库。
结论
借助 Amazon Bedrock Managed Knowledge Base,你的团队不再需要运行向量存储或管理底层检索基础设施。借助 amazon-bedrock 技能中的迁移指南,你可以向智能体索取计划、进行审查,并仅批准你希望构建的资源。
要开始使用,请设置适用于 AWS 的 Agent Toolkit,并向你的智能体索取知识库的只读评估。迁移后,可探索智能体检索以处理多部分问题。要了解更多信息,请参阅 AWS 机器学习博客上的使用 Amazon Bedrock Managed Knowledge Base 为智能体构建企业搜索。
关于作者

Josh DeMuth
Josh 是 AWS 的生成式 AI 解决方案架构师。他在科技行业拥有超过 20 年的经验,其中包括数年的系统集成经验,一直专注于让不同的系统协同工作。他现在帮助客户构建生成式 AI 应用,使其能够与他们已有的系统和数据配合工作。

Siddhant Sahu
Siddhant 是 AWS 的高级产品经理,也是 Amazon Bedrock Managed Knowledge Base 的唯一负责人,作为产品负责人对其战略、路线图和发布负责。他构思并推出了其代理式检索和应用连接器,使 AI 代理能够在 Microsoft SharePoint、Atlassian Confluence 和 Amazon S3 等关键业务应用中对企业数据执行复杂的搜索查询。自 2026 年 6 月发布以来,该服务已被 OpenAI、Syngenta、MRH Trowe、Sony 以及其他在企业数据上构建 AI 代理的企业采用。

Arjun Tapde
Arjun 是 Amazon Web Services (AWS) 的软件工程师,为 Amazon Bedrock Knowledge Bases 和 AWS Quick 构建 AI 代理系统和企业检索基础设施。他专注于检索增强生成 (RAG) 以及对企业数据的安全、可扩展访问,帮助客户构建以自身业务知识为基础的可靠 AI 应用和代理。

Ibhan Aggarwal
Ibhan 是 AWS 的软件开发工程师。他为 Amazon Bedrock Knowledge Bases 构建 AI 代理评估框架,专注于在实时 AWS 环境中测试代理,并通过 LLM-as-a-judge 工作流、工具调用轨迹分析以及跨前沿模型的对抗性测试来评估其行为。他的工作帮助客户信任其代理能够准确、安全地行动。

Aniket Panda
Aniket 是 AWS 的软件开发工程师,为 Amazon Bedrock Knowledge Bases、Amazon Bedrock AgentCore 和 AWS Quick 构建 AI 和企业检索系统。他专注于代理式工作流、检索增强生成 (RAG),以及为代理提供对企业数据的安全、可扩展访问,使客户能够构建以自身业务知识为基础的可靠 AI 应用。
来源:AWS Machine Learning Blog · aws.amazon.com