用 Amazon Bedrock 和 LiteLLM 构建自助式 LLM 网关
Building a self-service LLM gateway with Amazon Bedrock and LiteLLM
文章演示如何用 Amazon Bedrock Application Inference Profiles 配合运行在 AWS Fargate 上的 LiteLLM,搭建一个把 Amazon Bedrock 封装为 OpenAI 兼容 API 的自助式 LLM 网关。
开发者希望 AI 编程助手能够以最少的配置即可使用。借助大语言模型(LLM)网关和 LiteLLM,他们可以快速访问 Amazon Bedrock 上可用的基础模型(FM),同时你也能获得可见性和使用控制。平台团队需要监控延迟和错误,财务团队需要将推理成本归属到团队和项目,安全团队需要一致的访问控制。LLM 网关可以通过提供对驱动编程助手的模型的集中管理访问点来帮助满足这些需求。
在本文中,我们展示如何使用 Amazon Bedrock Application Inference Profiles 配合运行在 AWS Fargate 上的 LiteLLM 构建自助式 LLM 网关,将 Amazon Bedrock 抽象在兼容 OpenAI 的 API 之后。采用此模式,开发者可以通过单一 API 和专用密钥访问基础模型,同时你获得按用户的成本控制和模型性能可观测性。读到最后,你将充分理解该模式,能够根据示例代码片段和 AWS Cloud Development Kit(AWS CDK)构造构建自己的版本。本文以 Claude Sonnet 和 Claude Haiku 模型为例。有关模型列表及各 AWS 区域的可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型。
此 LLM 网关模式遵循从开发者出发,经过 LiteLLM 层,到达 Amazon Bedrock 及底层 FM 的简单请求流程。下图展示了该流程背后的生产拓扑。为简洁起见,我们未涵盖 Amazon Bedrock Guardrails(如内容过滤和接地)的添加,但在部署到生产环境之前,你通常会纳入适当的负责任 AI 控制措施。
开发者的兼容 OpenAI 客户端通过 Amazon Route 53、Amazon CloudFront 和 Application Load Balancer(ALB)到达 LLM 网关。它使用按用户的 API 密钥向 Fargate 上的 LiteLLM 进行身份验证。在此之后,请求利用 Amazon Relational Database Service(Amazon RDS)(PostgreSQL)获取虚拟密钥和支出状态。它还与 Amazon ElastiCache for Valkey 作为缓存交互,并使用 AWS Secrets Manager 管理密钥。随后,LiteLLM 最终使用限定范围的 AWS Identity and Access Management(IAM)任务角色调用 Amazon Bedrock Application Inference Profiles。Amazon CloudWatch 捕获每分钟请求数(RPM)和每分钟令牌数(TPM)指标以及配额告警。
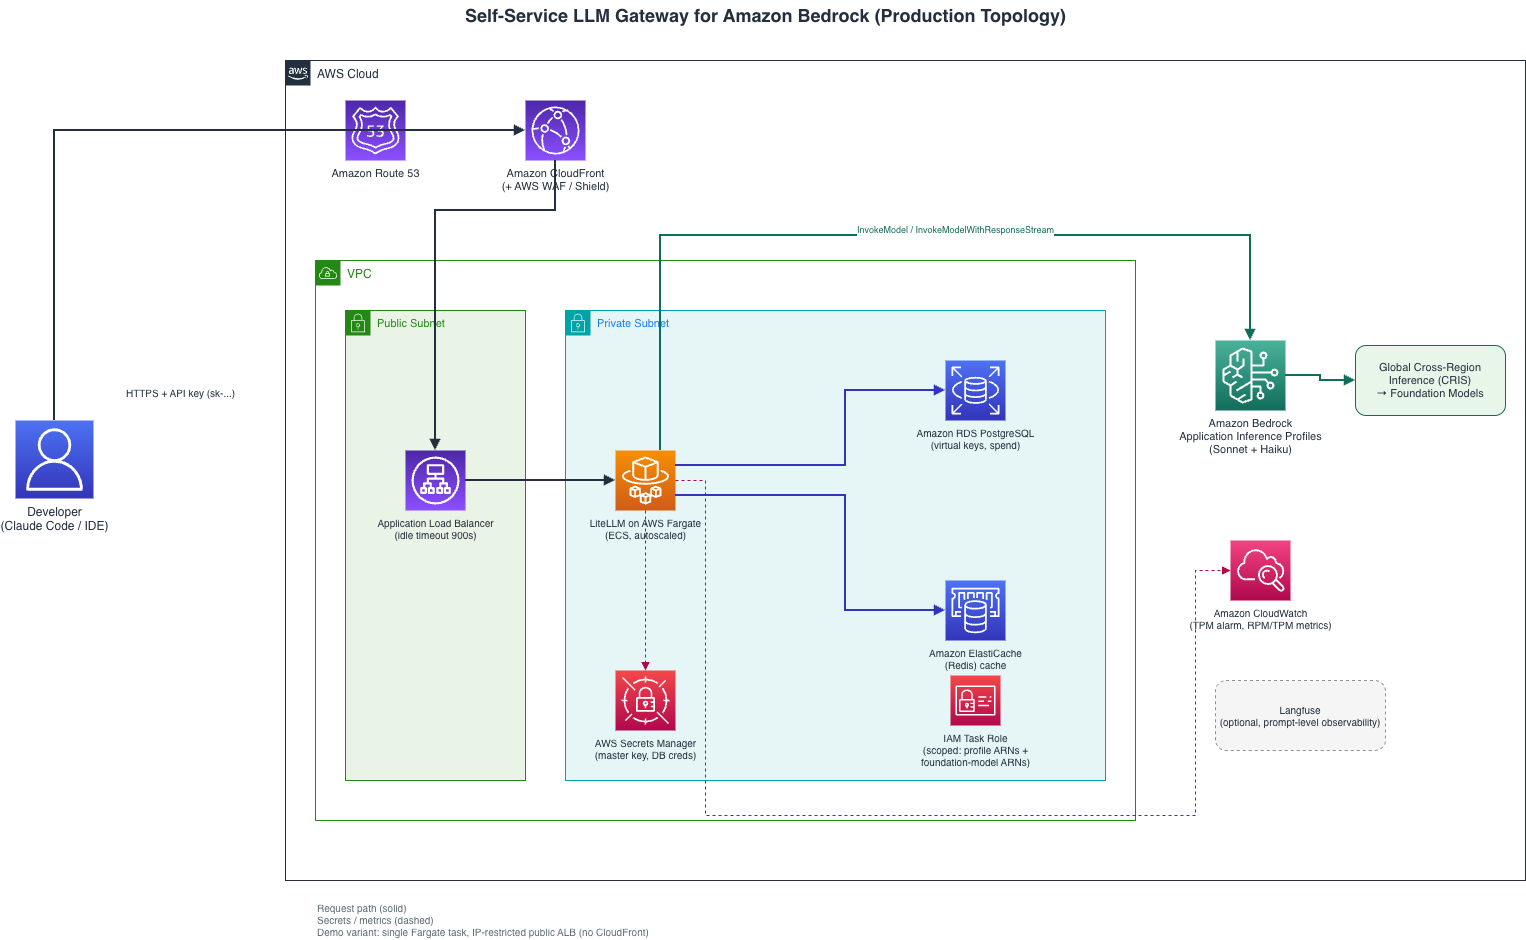
图 1:LLM 网关架构(生产拓扑)
该架构由以下核心组件组成:
- AWS Fargate 上的 LiteLLM:LiteLLM 提供暴露兼容 OpenAI API 的代理。我们将其运行在 AWS Fargate 任务上,并基于 CPU 利用率进行目标跟踪 Auto Scaling。开发者将其工具指向此端点,不直接与 Amazon Bedrock 交互。
- 自助服务门户:LiteLLM 包含一个用于管理员和开发者自助服务的轻量级门户。此 Web 应用可与你的企业单点登录(SSO)集成。通过该门户,运维工程师设置支出策略,而开发者在此参数范围内自行配置 API 密钥。
- 持久化和缓存存储:LiteLLM 使用 Amazon ElastiCache for Valkey 进行非持久化响应缓存。它还在 AWS Fargate 任务之间协调速率限制。单独的 Amazon RDS(PostgreSQL)数据库是持久化状态(如 API 密钥元数据和支出跟踪)的记录数据库。
- Amazon Bedrock 应用程序推理配置文件:每个模型(例如 Claude Sonnet 和 Claude Haiku)都有各自的推理配置文件,您可以使用 AWS Cloud Development Kit(AWS CDK)进行管理。借此,您可以实现按模型隔离配额,并在 LiteLLM 的配置与 Amazon Bedrock 的模型版本管理之间建立清晰的抽象层。
- Langfuse:开源 LLM 可观测性工具,用于提示词级遥测、延迟跟踪和调试。它以应用层洞察补充 Amazon CloudWatch 的基础设施级指标。
通过使用 OpenAI 兼容协议,开发者可以用单一的 base URL 和 API key 配置其工具,例如 Claude Code、Continue 和 Cursor。这样开发者就在 Amazon Bedrock 后端之上的一层进行操作,可以更换模型、添加回退或迁移模型提供商,而无需改动开发者配置。
先决条件
您需要一个 AWS 账户、Amazon Bedrock 模型访问权限以及适当的 IAM 权限来部署此项目。您还需要 LiteLLM。LiteLLM AI Gateway 组件是开源的,适合小规模试点,但存在一些限制。LiteLLM 文档说明 AI Gateway 最多可供五名用户免费使用,超出则需许可证。LiteLLM Enterprise 是可扩展、面向生产的许可版本,包含开源网关以及单点登录、审计日志、委派管理员角色和支持。虽然免费层支持虚拟密钥,但本文所述的自助密钥签发需要 Enterprise 版本。
端到端配置:从左到右
我们将逐一介绍从开发者机器到基础模型的每个配置层。
步骤 1:开发者 IDE 配置(例如 Claude Code)
开发者配置其编码助手指向 LLM 网关。这是开发者对其工具唯一需要进行的配置:
{
  "apiProvider": "openai-compatible",
  "apiBaseUrl": "https://llm-gateway.internal.example.com/v1",
  "apiKey": "sk-user-abc123",
  "model": "claude-sonnet-4-20250514"
}
通过该配置,每位开发者从自助门户获取自己的 API key,并将其填入工具配置中。
步骤 2:LiteLLM 网关配置
按照LiteLLM 文档将 LiteLLM 部署到容器服务。本示例中我们使用 AWS Fargate。这将包含门户,您可以在本地测试期间通过 http://localhost:4000/ui 打开它。
LiteLLM 网关是您将模型名称映射到 Amazon Bedrock 推理配置文件 ARN 并强制执行按密钥支出限制的地方:
model_list:
  - model_name: claude-sonnet-4-20250514
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/sonnet-profile-id
      aws_region_name: us-east-1
      max_retries: 3
      timeout: 900  # 15 min for extended thinking
    # REQUIRED for spend tracking: when `model` is a raw inference-profile ARN,
    # LiteLLM can't find it in its built-in cost map and defaults the cost to $0
    # which means per-key `spend` stays 0 and budgets NEVER enforce. Set the
    # per-token costs explicitly.
    model_info:
      input_cost_per_token: 0.000003        # example cost
      output_cost_per_token: 0.000015    # example cost

  - model_name: claude-haiku-4-5
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/haiku-profile-id
      aws_region_name: us-east-1
      timeout: 120
    model_info:
      input_cost_per_token: 0.000001       # example cost
      output_cost_per_token: 0.000005    # example cost

litellm_settings:
  max_budget: 250            # example per key cost
  budget_duration: 7d      # Rolling 7-day window
  max_parallel_requests: 10
  set_verbose: false
  cache: true
  cache_params:
    type: redis    # Valkey is protocol-compatible, so this stays "redis"
    host: elasticache-endpoint
    port: 6379
master_key: os.environ/LITELLM_MASTER_KEY
database_url: os.environ/DATABASE_URL
在 Fargate 任务上从 AWS Secrets Manager 设置:
LITELLM_MASTER_KEY=sk-platform-admin-... DATABASE_URL=postgresql://user:password@rds-endpoint:5432/litellm注意:不要在 config.yaml 中硬编码 master_key 或数据库凭证。LiteLLM 在加载时解析 os.environ/VAR_NAME 引用,因此请在 Fargate 任务上将 LITELLM_MASTER_KEY 和 DATABASE_URL 设置为环境变量,并从 AWS Secrets Manager 获取。在步骤 5 中以相同方式设置 Langfuse 凭证。
例如,当开发者调用 claude-sonnet-4-20250514 时,LiteLLM 会将其解析为推理配置文件 ARN。然后它使用 AWS Fargate 任务的 IAM 角色向 Amazon Bedrock 进行身份验证,并以 OpenAI 格式流式返回响应。
步骤 3:Bedrock 推理配置文件(CDK)
借助 Amazon Bedrock 应用程序推理配置文件,您可以为特定模型创建命名端点,从而获得配额隔离和细粒度 IAM 控制。
选择跨区域推理(CRIS):地理或全球
Amazon Bedrock CRIS 避免了自行实现跨区域请求路由的开销。其他优势包括:
- 访问更广泛的区域容量池。
- 自动将请求路由到具有可用容量的受支持区域。
- 更广泛的模型选择,因为某些模型只能通过推理配置文件使用。
对于此代理模式,当所选模型支持且组织策略允许在受支持的 AWS 商业区域范围内进行推理处理时,我们建议使用 Global 跨区域推理。地理跨区域推理会将处理限制在定义的地理范围内。例如,美国推理配置文件仅将请求路由到受支持的美国区域。与地理跨区域推理相比,Global 跨区域推理可访问更广泛的区域容量池,并可能带来定价优势。您可以通过当前的 AWS 文档和 AWS 定价页面核实模型可用性、适用的服务配额以及特定模型的定价。
CDK 构造
import * as cdk from 'aws-cdk-lib';
import * as bedrock from 'aws-cdk-lib/aws-bedrock';
import * as iam from 'aws-cdk-lib/aws-iam';

// Create an Application Inference Profile pointing to the Global CRIS
// system-defined inference profile (note the `global.` prefix in the ARN).
const sonnetProfile = new bedrock.CfnApplicationInferenceProfile(this, 'SonnetProfile', {
  inferenceProfileName: 'claude-sonnet-gateway',
  modelSource: {
    copyFrom: `arn:aws:bedrock:us-east-1:${this.account}:inference-profile/global.anthropic.claude-sonnet-4-20250514-v1:0`,
  },
  description: 'Claude Sonnet for developer coding assistants (Global CRIS)',
});

// Grant LiteLLM's task role access to invoke the profile.
// For Global CRIS, include the inference profile, the regional FM, and the global FM resources.
litellmTaskRole.addToPolicy(new iam.PolicyStatement({
  effect: iam.Effect.ALLOW,
  actions: ['bedrock:InvokeModel', 'bedrock:InvokeModelWithResponseStream'],
  resources: [
    sonnetProfile.attrInferenceProfileArn,
    'arn:aws:bedrock:us-east-1::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
    'arn:aws:bedrock:*::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
  ],
}));重要:对于 Global CRIS,copyFrom ARN 必须引用以 global. 为前缀的系统定义推理配置文件,而不是直接引用基础模型 ARN。使用基础模型 ARN 会创建一个没有跨区域路由的单区域配置文件。此外,IAM 策略必须包含调用实际触及的资源 ARN:应用程序推理配置文件以及它可能路由到的任何区域中的底层基础模型(区域通配符)。仅限定到 application-inference-profile ARN 会在调用时返回 not authorized to perform: bedrock:InvokeModel on resource: arn:aws:bedrock:us-east-1::foundation-model/...。这是按最小权限范围限定的:它指定了正在使用的确切模型,而不是 bedrock:* 或 *。
步骤 4:Bedrock 调用基础模型
推理配置文件会透明地处理模型解析和跨区域路由,无需额外配置。当 LiteLLM 调用推理配置文件 ARN 时,Amazon Bedrock 会路由到已配置的 AWS 区域中的可用容量并返回响应。
步骤 5:Langfuse 可观测性
LiteLLM 通过日志记录回调与 Langfuse 集成,无需更改开发人员工具配置即可提供对模型调用的可见性。要启用该集成,请将以下条目合并到步骤 2 配置中现有的 litellm_settings 块中,并保留现有的回调条目:
litellm_settings:
  success_callback: ["langfuse"]
  failure_callback: ["langfuse"]  # also log failed requests
在 Fargate 任务上将 Langfuse 公钥、密钥和部署端点配置为环境变量。将凭证存储在 AWS Secrets Manager 中:
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://us.cloud.langfuse.com  # or your self-hosted URL
端点必须与所选的 Langfuse Cloud 区域或自托管部署匹配。根据数据治理和运营要求选择托管选项。在启用提示和响应日志记录之前,请查看集成捕获的内容,并配置适当的脱敏、保留和访问控制。
根据集成和日志记录配置,Langfuse 跟踪可以包含提示、响应、模型参数、令牌使用量和延迟。此信息有助于调查意外的模型响应,并补充 Amazon CloudWatch 中收集的运营指标。
实施成本控制
成本控制是成功 AI 战略的重要维度。如果没有成本控制,大量使用扩展思考功能可能会导致意外的高额费用,我们在早期试点中观察到了这一点。
第 2 步中配置的支出限额(max_budget: 250、budget_duration: 7d)会为每个 API 密钥强制执行滚动 7 天窗口,前提是设置了按模型的 model_info 成本(请参阅第 2 步的说明)。当用户达到其限额时,LiteLLM 会返回 HTTP 429 代码,并附带一条清晰的消息,说明其预算已超支。不会出现静默降级或意外账单。开发者和工程团队可以通过以下任一方式查看当前支出和重置时间:
- 每日支出:使用
start_date和end_date范围查询 GET /user/daily/activity,以获取按天统计的指标:支出、提示词 token 数、补全 token 数和 API 请求数,并按模型、提供商和 API 密钥细分。 - 按用户支出:查询 GET /user/info?user_id=…,以获取用户总支出及其每个关联 API 密钥支出的摘要。
- 门户仪表盘:Admin UI(位于
https://<proxy-host>/ui)包含一个 Usage 标签页,开发人员和管理员可以在其中按模型、用户和标签浏览支出,而无需直接调用 API。
你的财务团队正是通过这些相同的端点获得按用户归因,而无需你构建自定义计量基础设施。一个定时任务调用 /user/daily/activity 或 /global/spend/report 就足以向成本仪表盘或计费报告提供数据。
开发者自助服务门户
自助服务门户还处理密钥生命周期流程。开发者通过企业 SSO 进行身份验证,以生成与其身份绑定的密钥;如果密钥泄露或为了符合轮换策略,他们之后可以重新生成该密钥。平台工程师只需为单个开发者配置一次预算策略,开发者便可在其约束范围内自主操作。开发者直接使用该门户的两项功能:
- 密钥生成:在 Admin UI 的 Virtual Keys 页面(
https://<proxy-host>/ui)上,通过 SSO 身份验证的开发者选择 Generate Key 来创建自己的密钥,并与其身份绑定。 - 速率限制可见性:每个
/chat/completions响应都包含x-litellm-key-remaining-requests-{model}和x-litellm-key-remaining-tokens-{model}标头,因此开发者可以直接在其工具的响应中看到该模型剩余的 RPM 和 TPM 余量。这与本文前面基于美元的支出跟踪不同。
监控与可观测性
对于 LLM 网关,延迟百分位数等传统指标可能会产生误导,尤其是在扩展思考模型中,单个请求可能需要几分钟。相反,我们将 每分钟请求数(RPM) 和 每分钟 token 数(TPM) 作为主要信号。在这里,Amazon CloudWatch 可以通过以下配置帮助你监控这些信号并设置告警。
用于配额管理的 Amazon CloudWatch 告警
new cloudwatch.Alarm(this, 'BedrockTPMAlarm', {
  metric: new cloudwatch.Metric({
    namespace: 'LiteLLM/Gateway',
    metricName: 'TokensPerMinute',
    statistic: 'Sum',
    period: cdk.Duration.minutes(1),
  }),
  // Alert at ~60% of your account's TPM quota (check Service Quotas for your
  // actual limit, defaults vary by model and account).
  threshold: 600000,
  evaluationPeriods: 3,
  comparisonOperator: cloudwatch.ComparisonOperator.GREATER_THAN_THRESHOLD,
  alarmDescription: 'TPM approaching Bedrock quota - request increase proactively',
});
请注意,该告警配置在配额利用率达到 60–70% 时发出警报,而不是等到发生限流。这为在用户体验下降之前扩展 Amazon Bedrock 配额提供了提前量。
发出指标: LiteLLM 没有内置回调可将名为 TokensPerMinute 的指标发布到 LiteLLM/Gateway 命名空间,因此告警需要一个来源。一个在每次请求时调用 CloudWatch PutMetricData 的小型自定义日志记录器回调即可完成此任务。请通过 litellm_settings.success_callback(它是附加的)注册它,而不是 callbacks。callbacks 列表会替换 LiteLLM 的内部日志记录器列表(其中包含内置的支出跟踪日志记录器),并会静默禁用预算强制执行。
以下是该回调的最小版本,使用 LiteLLM 的 CustomLogger 类:
import boto3
from litellm.integrations.custom_logger import CustomLogger

cloudwatch = boto3.client("cloudwatch")

class TPMEmitter(CustomLogger):
    async def async_log_success_event(self, kwargs, response_obj, start_time, end_time):
        total_tokens = kwargs.get("standard_logging_object", {}).get("total_tokens", 0)
        cloudwatch.put_metric_data(
            Namespace="LiteLLM/Gateway",
            MetricData=[{
                "MetricName": "TokensPerMinute",
                "Value": total_tokens,
                "Unit": "Count",
            }],
        )

# Register alongside success_callback, not in place of it:
import litellm
litellm.callbacks = [TPMEmitter()]
对于提示词级别的调试,我们将 Langfuse 与 CloudWatch 配合使用。当开发者反馈“模型给出了糟糕的响应”时,你可以使用 Langfuse 检查确切的提示词、token 计数和模型参数。对于合规敏感的环境,Amazon Bedrock 原生的调用日志记录到 Amazon Simple Storage Service(Amazon S3)可提供不可篡改的审计追踪。
大规模部署的经验教训
我们在一个全新的 AWS 账户上端到端部署了这一模式,以确认示例代码片段可以正常工作。在我们自己的部署中,我们将这个 LLM 网关扩展到数百名开发者,并总结出若干经验教训。
运维经验
大规模运行的主要发现如下:
- 扩展思考会彻底改变延迟表现。使用 Claude 扩展思考的请求可能需要数分钟甚至更长时间,具体取决于思考预算。如果你的负载均衡器空闲超时为 60 秒,这些请求会静默失败。为解决这个问题,你可以将负载均衡器空闲超时设置为至少 900 秒,并相应配置 LiteLLM 的请求超时(见本文前面第 2 步配置中的
timeout: 900)。 - 被限流时,先在同一模型上退避重试,再启动回退。我们最初的本能是在被限流时从 Sonnet 回退到 Haiku。但这对于编码助手而言并非最优,因为切换模型会破坏开发者所依赖的一致行为。相反,应在代理层对同一模型使用指数退避进行重试(见第 2 步中的
max_retries: 3)。当请求在重试后仍无法得到服务时,应清晰地暴露错误,而不是返回替代模型的补全结果。 - 将自动化工具调用与开发者流量分开。持续集成和持续交付(CI/CD)流水线以及自动化代码审查工具应使用各自的推理配置文件和配额直接调用 Amazon Bedrock。将自动化流量与交互式开发者流量混合会导致不可预测的延迟,并妨碍有意义的成本归因。
- 如果可行,从第一天起就使用 Global CRIS。我们最初使用 Geographic(US)CRIS,但在达到区域配额限制后最终迁移了推理配置文件。对于我们的用例,没有数据驻留限制,因此可以使用 Global CRIS。Global CRIS 跨区域路由请求,以利用更广泛的容量池,从而简化大规模管理。
部署注意事项
有两种配置错误很常见,而且在支出或连接性出问题之前很难察觉:
配置每模型成本是执行预算控制的必要条件。如果你想跟踪每用户成本控制,每个模型上的 model_info 块并非可选。当 model 指向 Amazon Bedrock 推理配置文件 ARN 时,LiteLLM 无法在其内置定价表中查找该 ARN。它会改为按每 token 记录 $0,因此 max_budget 和 429 的限流执行会静默地不触发。无论有多少 token 流过,支出都保持为 $0。通过设置 input_cost_per_token 和 output_cost_per_token(或 input_cost_per_million_tokens)来修复此问题。
数据库与缓存的比较:database_url 必须是 PostgreSQL。LiteLLM 的虚拟密钥(/key/generate)、store_model_in_db 和支出跟踪均由 Postgres 支持。
还有一些较小的部署细节完善了我们的检查清单:
- Global CRIS 的 IAM 需要基础模型资源,而不仅仅是应用推理配置文件 ARN。否则,调用会在运行时被拒绝。
- 为 Fargate 任务分配足够的内存。 LiteLLM 的网关镜像在 512 MB 内存下会耗尽内存并被终止(退出码 137),无法通过健康检查。约 2 GB 是安全下限。
- 覆盖容器的
entryPoint。 官方镜像的入口点是litellm。如果你在启动时用 shell 脚本渲染配置,请设置entryPoint: ['/bin/sh','-c'],否则你的脚本会被作为参数传给litellm。 - IAM 角色和安全组描述必须是 ASCII 字符。 IAM 和 Amazon EC2 会拒绝长破折号和
->箭头。 - 确认模型在你的账户和区域中可用。 模型 ID 和 CRIS 配置文件会变化。请用
aws bedrock list-inference-profiles验证(例如,我们使用了claude-haiku-4-5,因为claude-haiku-3-5不可用)。
清理
本文通过示例片段介绍该模式,而非一个可直接部署的完整栈,因此没有一键拆除命令。但该架构依赖若干资源,它们在运行期间会持续计费。这些资源包括 AWS Fargate 服务、Amazon RDS(PostgreSQL)、Amazon ElastiCache for Valkey 和 Application Load Balancer,以及配套的 Secrets Manager 密钥、CloudWatch 告警和 Amazon Bedrock 应用程序推理配置文件。测试完成后,请移除它们以避免持续产生费用。
如果你使用《AWS 多提供商生成式 AI 网关指南》部署了完整解决方案,请按照该解决方案的清理说明移除其创建的所有资源。对于 AWS CDK,运行 cdk destroy。对于 AWS CloudFormation,删除堆栈。
如果你根据本文中的片段自行构建了该模式,请逐个移除资源:
- AWS Fargate 服务和集群:删除 Amazon Elastic Container Service(Amazon ECS)服务以停止并排空任务,然后删除集群。
- Application Load Balancer:删除 ALB 及其监听器和目标组。
- Amazon RDS(PostgreSQL):删除数据库实例。仅当你需要保留 API 密钥和支出数据时,才先创建最终快照。
- Amazon ElastiCache for Valkey:删除复制组或集群。它只保存缓存数据,因此无需快照。
- Amazon Bedrock 应用程序推理配置文件:删除第 3 步中创建的配置文件,可以通过移除 AWS CDK 构造或运行
aws bedrock delete-inference-profile来完成。 - AWS Secrets Manager 密钥:安排删除代理的密钥,例如主密钥和数据库凭证。
- Amazon CloudWatch 告警和日志组:删除 TPM 告警和任何 LiteLLM 日志组。
请先删除 AWS Fargate 服务和 ALB,再删除它们依赖的 Amazon RDS 和 ElastiCache 端点,以免在拆除过程中运行中的任务因后端已被移除而报错。
结论
在本文中,我们详细介绍了一种 LLM 网关模式,它抽象了 Amazon Bedrock 的多模型架构,为你的团队提供可扩展、可观测的自助式访问。由于 Amazon Bedrock 通过单一接口跨模型路由而无需更改基础设施,你的开发者可以通过熟悉的 API 即时访问基础模型。成本治理、可观测性和单一控制平面交给你的工程和安全团队,而财务部门则获得按用户归因,无需你构建自定义计量基础设施。
请先通过本文中的模式和代码片段来理解各部分如何组合在一起。AWS CDK 片段涵盖 Amazon Bedrock 应用程序推理配置文件、其 IAM 策略以及 CloudWatch 告警。周围的 AWS Fargate 服务、Amazon RDS、Amazon ElastiCache、ALB 和 AWS Secrets Manager 资源遵循标准 AWS CDK 模式,未在此展示。
当您准备好进行完整、可部署的实现时,AWS 上的多提供商生成式 AI 网关指南与该模式高度一致。您可以在 AWS Solutions Library 中找到该指南,以及配套的博客文章和 GitHub 项目。虽然本文介绍了相同的核心模式,但重点在于面向开发者编码助手的 Amazon Bedrock。更大的解决方案架构增加了多提供商支持、Amazon ECS 或 Amazon Elastic Kubernetes Service(Amazon EKS)、Amazon CloudFront 和 AWS WAF 选项,以及管理 UI。
通过以下附加文档探索此架构的组件:Amazon Bedrock 推理配置文件、LiteLLM 网关、AWS Fargate 和 Langfuse。
在您的组织中尝试此模式。从一个试点团队开始,验证成本控制,然后逐步扩展。
关于作者

Sitaraman Vijay Krishna
Sitaraman Vijay Krishna 是 AWS 的高级技术客户经理,与客户合作开展生成式 AI、代理式 AI 和 AI 可观测性工作,包括亲身实践采用 AWS DevOps Agent。工作之外,他是一名终身体育迷,既喜欢在球场上运动,也喜欢在看台上观赛。

Saurav Bhattacharya
Saurav Bhattacharya 是 Amazon Web Services(AWS)的高级解决方案架构师,在电信、宽带和媒体领域拥有丰富经验。在目前的职位上,他专注于解决媒体和娱乐行业的挑战,加速技术销售并构建可扩展的解决方案,以加速客户的数字化转型。

Eric Christensen
Eric Christensen 是 Amazon Web Services(AWS)的技术客户经理,在云财务管理和成本优化方面拥有深厚经验。他已在 AWS Solutions Library 上发布了大量代码示例和多个成本与健康跟踪仪表板。
来源:AWS Machine Learning Blog · aws.amazon.com