在 Amazon EKS 与 SageMaker HyperPod EKS 上部署 NVIDIA Nemotron 模型加速智能体 AI
Accelerate agentic AI with NVIDIA Nemotron models on Amazon EKS and SageMaker HyperPod EKS
NVIDIA Nemotron 3.5 Super VL 已在 AWS 上线,这是一个 120B 参数、每 token 激活 12B 的 MoE 多模态模型,支持文本、图像、文档和视频输入,上下文长度最高 1M tokens。
NVIDIA Nemotron 3.5 Super VL 加入了已在 AWS 上提供的 NVIDIA Nemotron 3 Nano、Nano Omni、Super、Ultra 和 Nemotron 3.5 Lightning 模型系列。它是一个 120B 参数的混合专家(MoE)模型,每个 token 激活 12B 参数。它将推理和工具使用与文本、图像、文档和视频理解相结合,因此一个模型即可同时服务文本和视觉任务。本文探讨其架构和用例,然后展示如何在 Amazon Elastic Kubernetes Service (Amazon EKS)、Amazon EKS Auto Mode 和 Amazon SageMaker HyperPod EKS 上部署它。
关于 Nemotron 3.5 Super VL
NVIDIA Nemotron 3.5 Super VL 是一个从 Nemotron 3 Ultra 蒸馏而来的开放多模态模型。NVIDIA 发布了权重、训练数据集和后训练配方,因此你可以针对特定领域工作负载自定义该模型,并在你控制的 infrastructure 上运行它。模型详情:
- 120B 总参数,每个 token 激活 12B。
- 混合 Mamba-2、MoE 和注意力层,配备 RADIO 视觉编码器。
- 上下文长度最高 1M tokens。
- 输入:文本、图像、文档和视频。
- 输出:文本。
- BF16 和 NVFP4 检查点。
NVIDIA 报告在 Hermes Bench 上为 63.44%,在 LangChain 智能体评估中为 87.05%,在 CharXiv 图表推理基准上为 80.8%。(技术报告)
模型架构
Nemotron 3.5 Super VL 采用混合 Mamba-Transformer MoE 架构,交错排列 Mamba-2、注意力和专家层。稀疏路由在每个 token 上激活 120B 参数中的 12B,因此每个 token 的计算量相当于一个小得多的模型,而 GPU 内存仍可容纳全部权重。Mamba-2 层在生成过程中携带恒定大小的状态,因此其内存不会像 KV 缓存那样随序列长度增长,从而使长上下文保持可负担。递归共享的多 token 预测(MTP)头支持原生推测解码。
用例
Nemotron 3.5 Super VL 支持将推理与视觉理解相结合的智能体工作流:
- 编码:测试和验证代码,分析错误,推荐修复方案。
- 网络研究:交叉引用并验证搜索工具返回的来源。
- 文档智能:读取表格、图表和页面布局以生成摘要。
- 网络安全:识别漏洞并对威胁进行分诊。
- 视频理解:搜索、内容、审查和事件分析。
Nemotron 3.5 Super VL 通过 NVIDIA 参考实现、cookbooks 和 NVIDIA Agent Toolkit 与主流开放智能体框架和编排系统集成。有关支持框架的完整列表,请参阅 NVIDIA 开发者博客。
最低 GPU 配置
| vLLM(GPU 型号 / 最低数量) | BF16 | NVFP4 |
| B200/GB200 | 8 | 2 |
| B300/GB300 | 4 | 1 |
| H200 | 8 | 4 |
| H100 | 16 | 8 |
在 AWS 上部署
本节概述了架构、验证和性能评估方法。有关在 AWS 上部署 Nemotron 3.5 Super VL 和 Nemotron 3 Ultra 的详细 操作指南 可在 aws-do-eks 项目中获取,包括前提条件、集群创建、模型权重下载、部署、测试、基准测试和清理。同样的模式也可应用于 NVIDIA Nemotron 系列中的其他模型。
部署架构
参考实现 可在标准 Amazon EKS、EKS Auto Mode 和 SageMaker HyperPod EKS 上运行。使用 EKS Auto Mode 时,AWS 会代您管理集群中的扩缩容、GPU 和 EFA 支持。用于模型部署的 Kubernetes 清单对于每种编排器选项都相同。每个集群都有一个托管 Kubernetes API 的控制平面,以及由 CPU 和 GPU 节点组成的数据平面。CPU 节点运行系统和测试 Pod,GPU 节点运行模型。Amazon Elastic Container Registry (Amazon ECR) 存储容器镜像,共享的 Amazon FSx for Lustre 卷保存模型权重,Elastic Fabric Adapter (EFA) 连接 GPU 节点。下图展示了一个标准 Amazon EKS 集群。
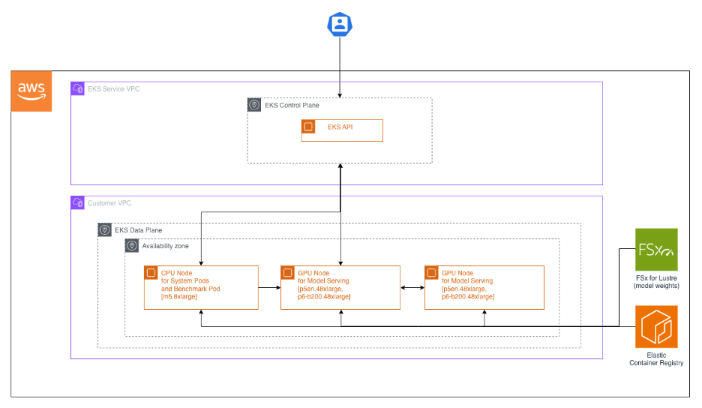
图 1:用于服务 NVIDIA Nemotron 模型的标准 Amazon EKS 集群架构
NVIDIA Dynamo 以聚合方式在单个节点上服务模型,或以分离方式在不同节点上分别进行预填充和解码。对于视觉语言模型,图像/视频编码阶段还可以在其自己的节点上以分离方式运行。
验证与性能
该架构已在 p6-b200.48xlarge(8 块 NVIDIA B200 GPU)和 p5en.48xlarge(8 块 NVIDIA H200 GPU)实例上完成验证。您可以使用 NVIDIA Collective Communications Library (NCCL) all-reduce 微基准测试来验证集群及其网络。
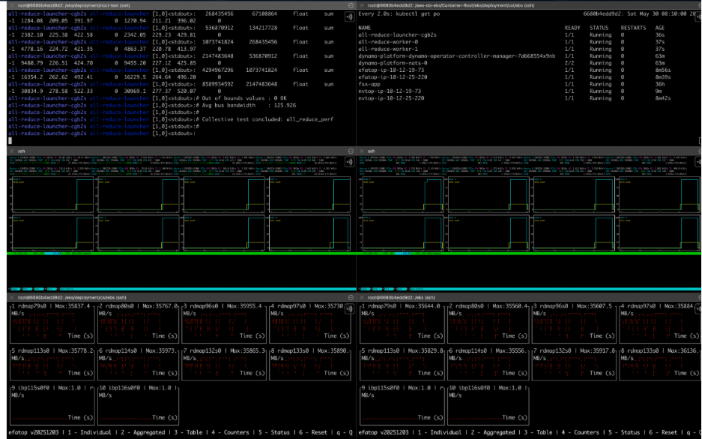
图 2:NCCL all-reduce 验证测试期间的 GPU 和 EFA 利用率
在 NCCL 测试运行期间,观察到所有 GPU 的利用率以及所有 EFA 适配器上的流量,即可验证集群按预期工作。
您可以使用 NVIDIA aiperf 工具测量集群上已部署模型的性能。
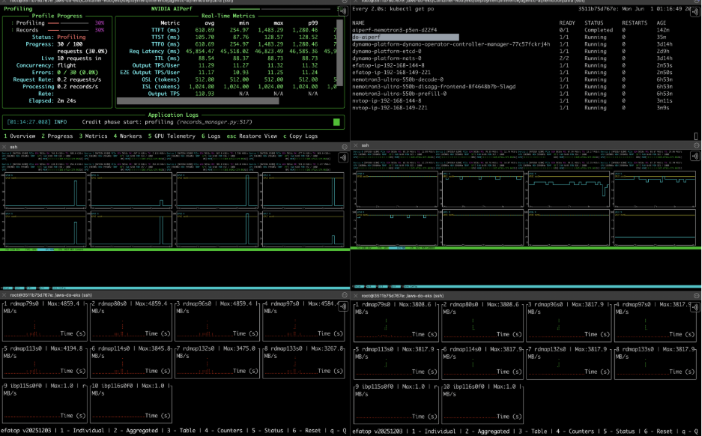
图 3:已部署模型的 aiperf 性能指标
左上窗格中的 aiperf 输出显示了关键性能指标 (KPI),例如首 token 时间 (TTFT)、token 间延迟 (ITL) 以及以每秒 token 数 (TPS) 表示的吞吐量。通过在不同并发水平下进行这些测量,我们可以研究延迟和吞吐量如何取决于并发请求数。这些信息对于审慎规划容量和模型部署拓扑至关重要。aws-do-eks 容器 提供了自动化功能,可通过单条命令可视化 GPU 和 EFA 利用率,并运行 aiperf 和并发扫描。
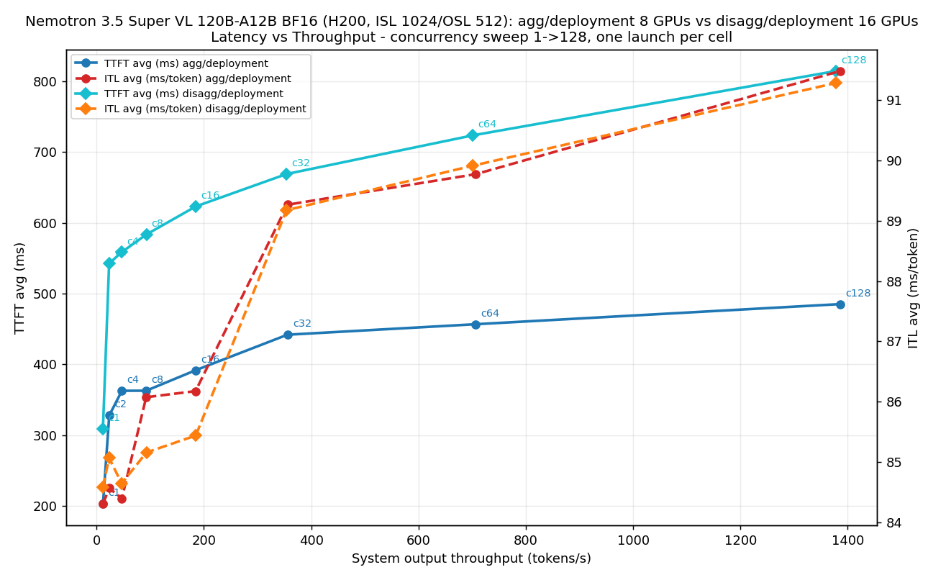
图 4:比较聚合部署与分离部署的并发扫描
上述并发扫描图显示,在两个节点上,聚合部署与分离部署相比,Nemotron 3.5 Super VL 的推理具有更低的 TTFT,而 ITL 大致相同。
这样的图表在做出部署决策时很有用。将你的延迟预算画成水平线,例如 TTFT 低于 600 毫秒(约 1 秒),ITL 低于每 token 100 毫秒。同时位于两条线下方的最右侧点,就是该拓扑的一个副本在服务等级目标(SLO)内所能提供的吞吐量,这里是 c32,即约每秒 320 个 token。要规划容量,用你的目标每秒 token 数除以这个每副本吞吐量,得出需要部署的 prefill-decode 对数。在做出变更(精度、TP/PP 形态、聚合式与分离式、新的 Dynamo 或 vLLM 版本)后重新运行同样的扫描,就能立即看到权衡关系。曲线向右下方移动就是收益。由于 TTFT 和 ITL 是分开绘制的,它还能告诉你该扩展哪一侧:ITL 上升说明需要增加 decode 容量,TTFT 上升说明需要增加 prefill 容量。
结论
本文介绍了在 Amazon EKS、EKS Auto Mode 和 SageMaker HyperPod EKS 上,使用 NVIDIA Dynamo 和 vLLM 为 NVIDIA Nemotron 模型提供服务的架构与性能评估模式。要开始使用,请借助参考实现在你自己的账户中部署 Nemotron 3.5 Super VL。AI on EKS 项目中还提供了更多推理蓝图。要获得更多 EKS 推理的实践经验,请注册我们即将举办的研讨会。
致谢
作者谨向所有参与开发、验证、审阅和发布本内容的人员致以特别感谢,包括但不限于:Eliuth Triana、Jiahong Liu、Kshitiz Gupta、Abhijeet Patil、Mike Stefaniak、Chris Splinter、Sheetal Joshi、Aditya Ramakrishnan、Natarajan Kumar、Anish Maddipoti。
关于作者

Alex Iankoulski
Alex 是 AWS 全球专家组织的首席解决方案架构师。他专注于使用容器编排 AI/ML 工作负载。Alex 是 do-framework 的作者,也是一位 Docker captain,热衷于应用容器技术来加快创新步伐,同时解决世界上的重大挑战。过去 10 年里,Alex 一直致力于帮助客户在 AWS 上做更多事情、推动 AI 和 ML 的普及、应对气候变化,并让出行更安全、医疗更优质、能源更智能。

Anton Alexander
Anton 是 AWS 的生成式 AI 高级专家,专注于使用 Amazon SageMaker HyperPod 扩展大型训练和推理工作负载。作为资深 CUDA 程序员和 Kubernetes 专家,他帮助企业集成 NVIDIA 技术进行分布式训练,专长于 EKS 和 Slurm 实现。Anton 与中东和北非地区及政府部门的客户密切合作,优化生成式 AI 解决方案。他持有一项机器学习边缘计算系统的待批专利。工作之外,Anton 是巴西柔术和大学拳击冠军,还喜欢驾驶飞机。

Leah Tucker
Leah 是高级 AI/ML 专家解决方案架构师,专注于在 EC2 和 EKS 上使用开源模型进行自管理的实时推理。她专长于推理工程、模型基准测试、生产架构设计,以及从冷启动到持续吞吐量的性能优化。她最近的工作包括 EKS 上的开源 TTS 推理栈,以及跨 G 和 P 实例系列的 GPU 基准测试工具。

Curt Lockhart
Curt 是 NVIDIA 的 AI 解决方案架构师,他帮助客户覆盖 AI 技术栈的各个环节,从推理和训练到智能体工作流。他骨子里是一位教师,乐于让 AI 的复杂性变得平易近人。

Abdullahi Olaoye
Abdullahi 是 NVIDIA 的高级 AI 解决方案架构师,专注于将 NVIDIA AI 库、框架和产品与云 AI 服务及开源工具集成,以优化 AI 模型部署、推理和生成式 AI 工作流。他与云提供商合作,提升 AI 工作负载性能,并推动 NVIDIA 驱动的 AI 和生成式 AI 解决方案的采用。

Wenhan Tan
Wenhan 是 NVIDIA 的解决方案架构师,帮助客户大规模采用 NVIDIA AI 解决方案。他的工作重点是加速深度学习应用,并解决推理和训练方面的挑战。
来源:AWS Machine Learning Blog · aws.amazon.com