ChinaTalk 调查美国数据公司向中国 AI 实验室出售 RL 环境的现象
ChinaTalk 作者 Aqib Zakaria 调查指出,Mercor、Surge AI、Turing、AfterQuery 等至少九家美国数据公司向中国 AI 实验室出售约五亿美元数据,其中包含用于后训练的强化学习(RL)环境,覆盖编码、金融、办公等任务。
译文尚不完整,完整内容请切换到原文。
ChinaTalk· Aqib Zakaria·2026-11-11 19:07· 42 分钟前AI 评分59
美国正向中国出售强化学习环境
AI 导读
ChinaTalk 作者 Aqib Zakaria 调查指出,Mercor、Surge AI、Turing、AfterQuery 等至少九家美国数据公司向中国 AI 实验室出售约五亿美元数据,其中包括用于后训练的强化学习(RL)环境,覆盖编码、金融、办公等任务。
正文 · 原文
Mercor、Surge AI、AfterQuery 和 Turing 等美国数据公司正向中国 AI 实验室出售价值约 五亿美元 的数据。其中很大一部分数据以强化学习(RL)环境的形式提供,实验室用这些环境对其模型进行后训练,使其在编码、网络安全、金融、法律和生物等特定领域表现出色。
后训练,尤其是强化学习,是模型最终性能最重要的指标之一。每当同一代内发布新模型时,相比上一版本的进步完全来自后训练。Opus 5 到 Opus 5.5,或 GPT 5.5 到 GPT 5.6 之间的差异并非来自新的预训练运行。由于它们拥有相同的基础模型,能力提升来自研究人员教导模型在特定领域变得更强。
美国公司向中国实验室提供支撑这种强化学习的数据,这一现象应当为政策制定者和关注美中 AI 竞赛的人敲响警钟:美国公司正在帮助中国实验室开发更好的模型,而我们至少找到了九家这样做的公司。 但数据供应商与中国实验室之间的商业关系比这句鹰派论断更为复杂,今天我们将深入探讨其中的情况。我们将涵盖:
出售强化学习环境意味着什么,以及它与蒸馏有何不同
当前与中国有关联的数据供应商生态系统
美国公司在多大程度上向中国出售强化学习环境
这是否是一个需要解决的问题
强化学习是什么样,又不是什么样
强化学习流程示例
强化学习环境本质上是模拟世界,模型可以在其中训练,以提升其在特定任务或环境中的表现。例如,模型开发者可能希望其模型更擅长制作美观且文字清晰的 PowerPoint 幻灯片。为实现这一能力,模型开发者可能会找数据供应商,要求他们制作一个 PowerPoint 的克隆,以便模型可以反复训练并学习如何使用工具制作出优秀的幻灯片。供应商出售的产品可能包括 PowerPoint 克隆本身,以及一个评分标准,用于判定模型的每个输出应被奖励还是抑制。
对于像“好”的 PowerPoint 这样模糊的概念,数据供应商通常会聘请人类专家来创建评分标准或为幻灯片样本评分。他们可能会聘请麦肯锡顾问、专业设计师和其他专家来创建完美的 PowerPoint 评分标准,模型开发者将在强化学习中使用该标准。
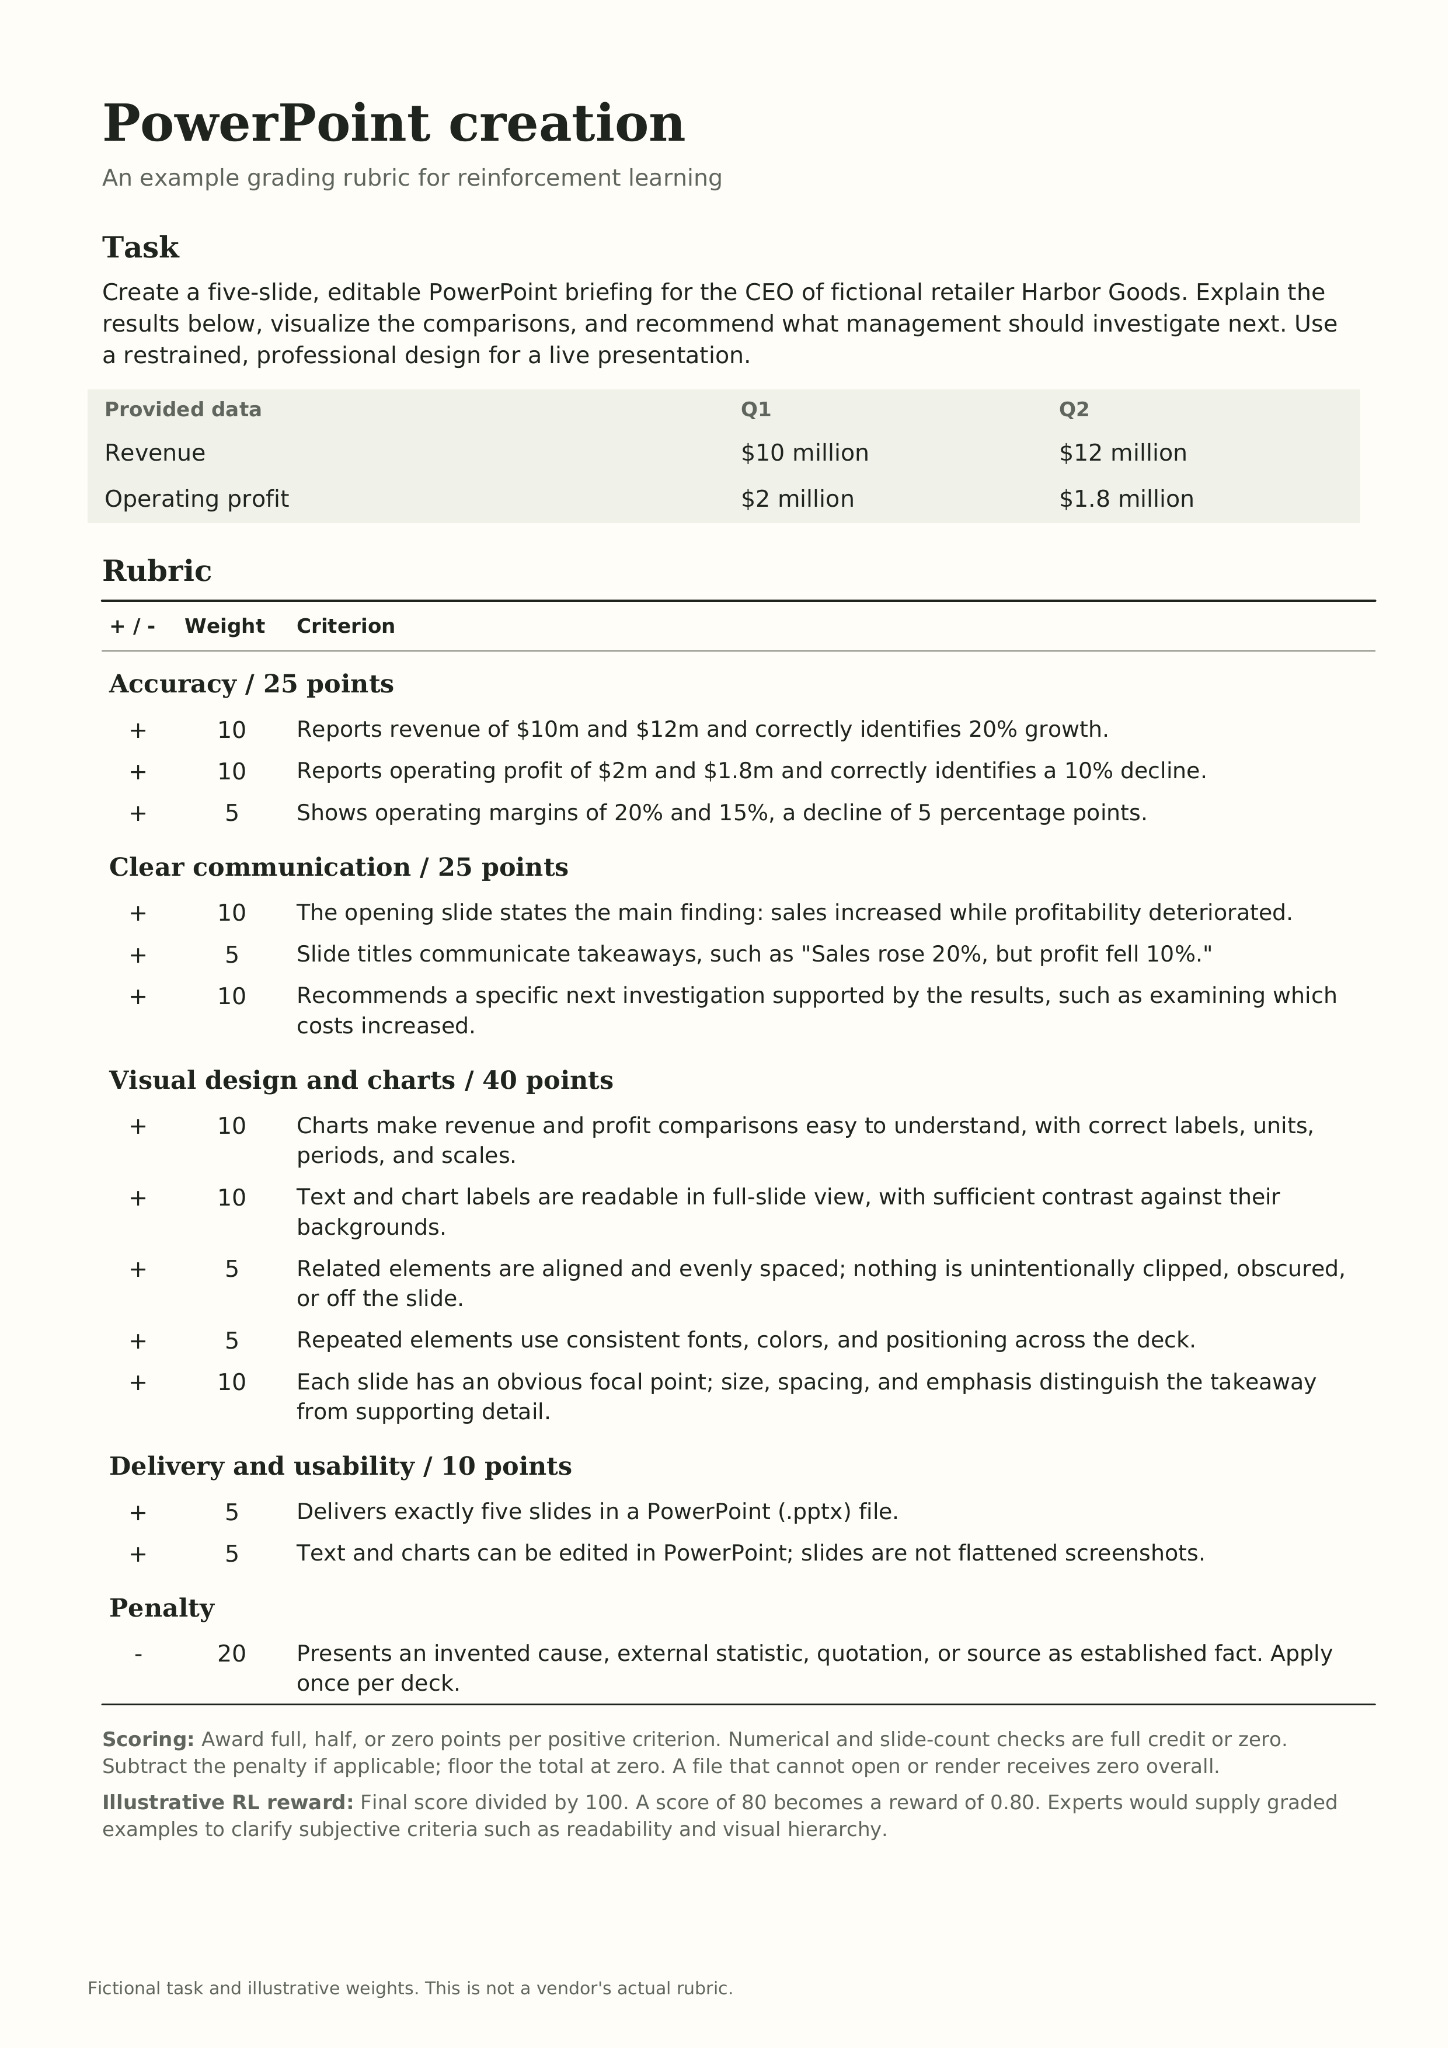
在后训练运行开始时,模型可能会生成低质量的幻灯片垃圾内容。这是早期“rollout”的典型表现,即模型解决(或尝试解决)任务的实例。但通过置身于类似 PowerPoint 的环境中并从评分标准信号中学习,模型会逐渐变得更擅长使用该应用,直到产出高质量成果。这就是“RL”的简要概括。它通常针对特定领域(如创建 PowerPoint、浏览实时网站,或使用电子表格进行数据分析),因此开发者会购买大量环境,以推动各种任务和领域的改进。当你的模型突然能在 Slack 或 Google Docs 中正常工作时,那是因为开发者对其进行了后训练,使其在这些环境中表现更好。
以 PowerPoint 为例,数据供应商提供的价值在于创建应用克隆,并拥有一个专家网络来制定良好的评分标准并对克隆进行压力测试。但其他环境所需的主动工作量较少,更多在于拥有合适的数据。例如,对于编程环境,数据供应商会花费巨资购买公司的 GitHub 仓库;这些数据将包含代码库中的 bug 以及公司工程师为修补这些 bug 所采用的修复方案。有了这些数据,开发者可以将存在 bug 的代码库(修补前)交给模型,并测试模型是否能找到修复方案。
RL 环境的价值在于它能够真正提升模型的能力。并非所有环境都是平等的,当供应商的环境具备足够的数据多样性、良好的任务选择以及针对特定模型的适当难度校准,它才变得有价值。
中国实验室可以搭美国实验室的便车以节省算力
美国供应商帮助中国模型改进幻灯片制作能力看似无害,但当中国实验室能够获取与敏感领域相关的环境,且这些环境使它们能够搭美国实验室的便车时,问题就出现了。例如,通过出售编程环境,数据供应商也在协助中国模型获得漏洞发现和进攻性网络攻击能力。与生物学任务相关的环境可能提升模型在基因合成和生物武器设计方面的能力。可接受的环境与危险环境之间的界限可能很模糊,而目前,几乎一切都是合规的。
RL environments are also not perfect on the first try. Perhaps the initial PowerPoint clone had bugs, the grading rubric was rewarding incorrect behavior, or some dataset was low quality. With the vast amount of data vendors out there and the even larger amount of products they sell, model developers can waste time and money procuring RL slop. Thus, Chinese labs have been reported to purchase exactly the same products as American labs like Anthropic and OpenAI so as to acquire what they know to be good data. The exact compute savings vary significantly depending on the exact environment, but one study suggests that rollouts (RL runs) consume more than 70% of RL post-training time, so these savings are not insignificant. This is especially true for Chinese labs, as rollouts rely on inference. Inference operations are memory-constrained compared to most training operations which are compute-constrained, and Chinese chips, more than lack of compute, suffer from a lack of high-bandwidth memory (HBM). Therefore, saving on memory-constrained operations is a huge boon to their model development.
美国实验室可能支付高达四到五倍的价格购买独家产品,以避免这种搭便车现象并对其后训练配方保密,但即便如此,隐性知识仍会流向中国实验室。如果数据供应商无法为中国客户制作完全相同的 PowerPoint 克隆,他们在为竞争对手创建类似环境时仍可避免犯同样的错误;这同样通过简化 rollout 和更快获得好产品,为中国实验室节省了时间和算力。供应商甚至炫耀这种动态,Surge AI 的网站宣传“由我们前沿实验室工作背后的同一批专家构建的 RL 环境”。
蒸馏 + RL 搭便车 = 问题
RL 搭便车使中国实验室能够在后训练的最后阶段改进模型,可以说比蒸馏更重要。监督微调(SFT)是 RL 之前发生蒸馏的过程。
蒸馏允许开发者使用更强的模型作为教师来制作更好的幻灯片,而不是创建整个 PowerPoint 克隆。中国实验室只需让 Astra 或 Fable 制作一堆好的 PowerPoint 演示文稿,中国模型就可以从这些示例中学习。就美元成本和算力而言,这比 RL 便宜得多。然而,在某种程度上,这也是在搭美国实验室用于让模型制作如此令人满意的演示文稿的 RL 环境的便车。
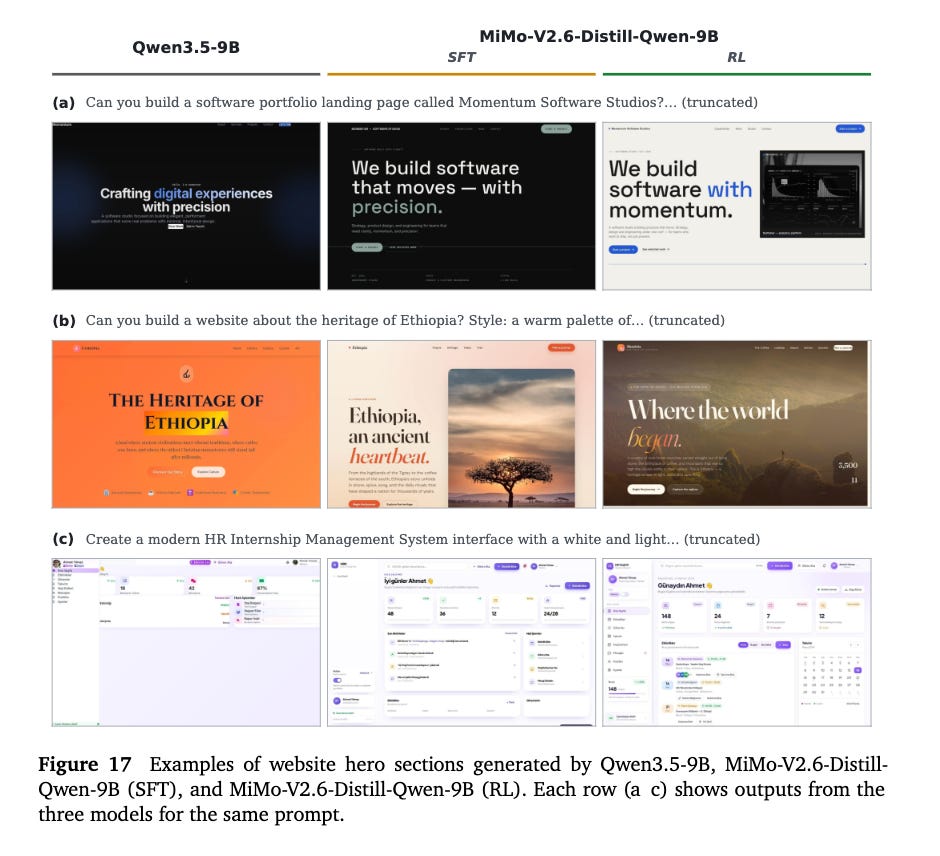
鉴于近期模型发布中相互矛盾的证据,目前尚不清楚 SFT 和 RL 哪个“更”重要。例如,Mistral Large 4 在多项基准测试中展示其主要收益来自 RL,而非 SFT。然而,对于小米的 MiMo-V2.6,SFT 似乎取得了更多收益。
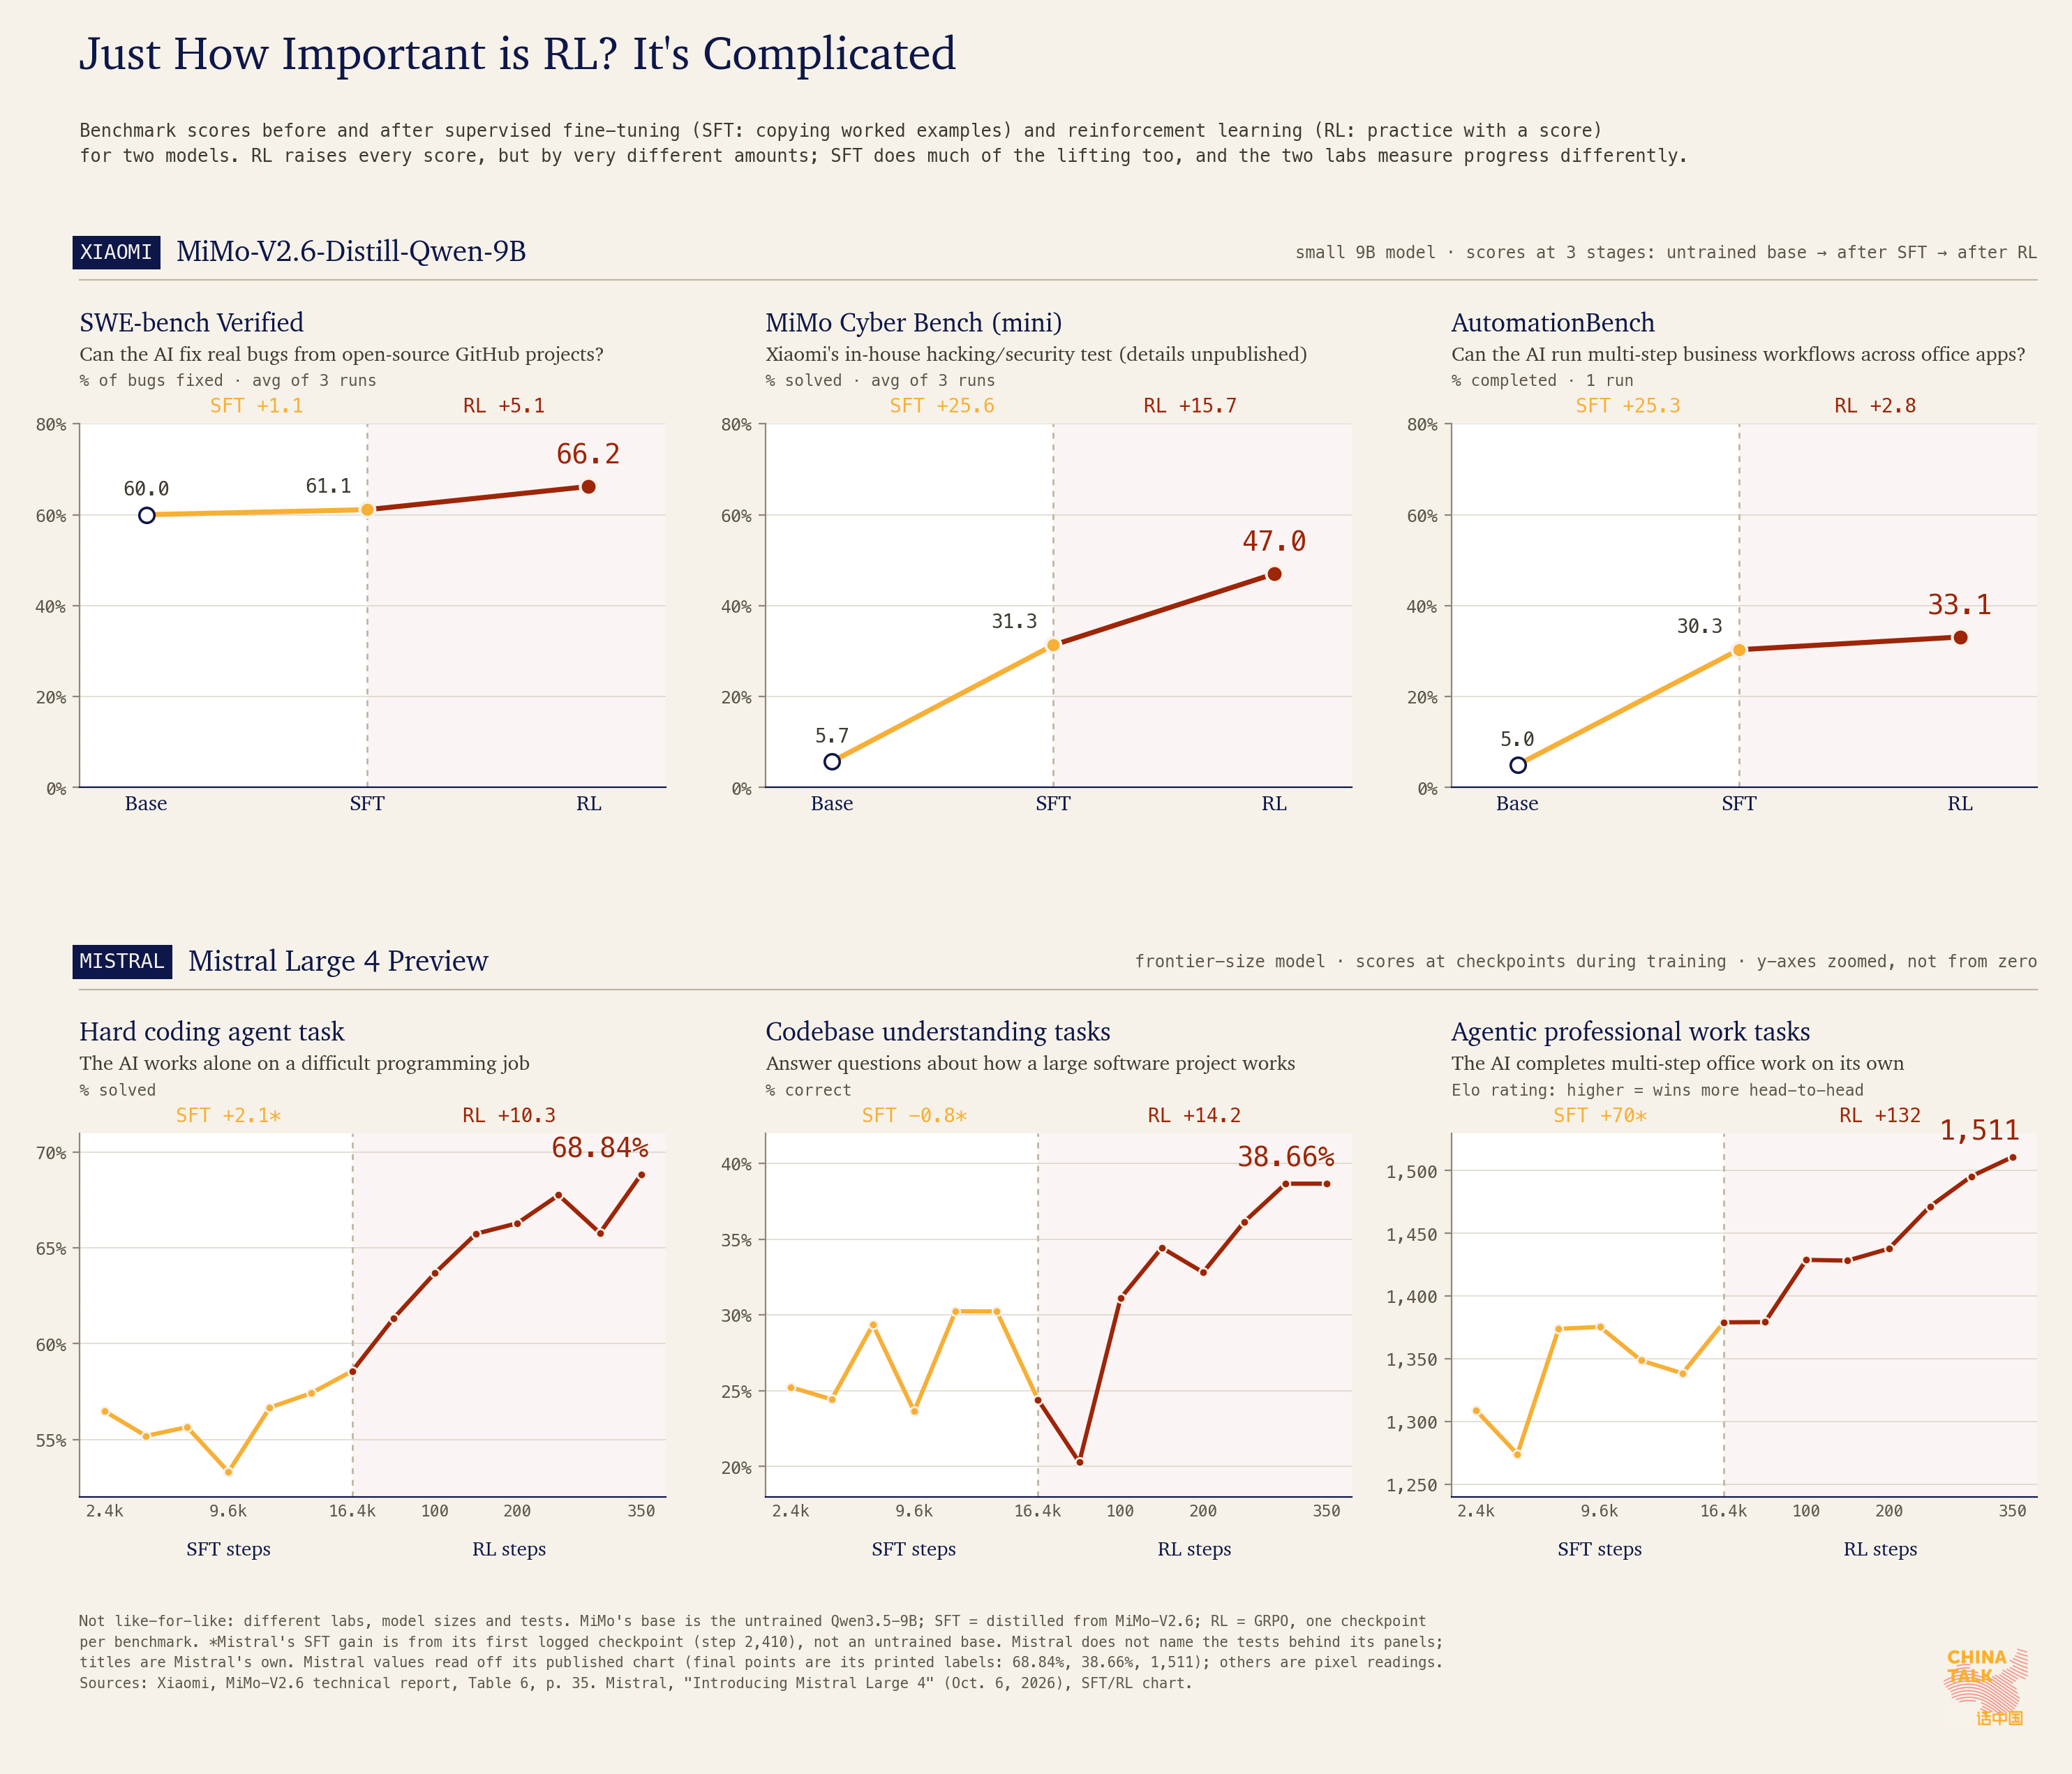
一种解释可能是,中国实验室只是做了更多的蒸馏,这就是为什么它们从 SFT 中获得的收益比非中国实验室更多。另一种解释可能在于公司除 RL 环境之外的后训练流程。无论如何,RL 才是让模型达到最终能力的关键,而 SFT 只是中间步骤。爬山过程的前 50% 明显比后 50% 容易得多。这正是区分“相当不错”与 SOTA 的关键所在。
数据公司的蛮荒西部
有数十家数据供应商,每家都有自己的专家网络、领域专长和数据池。新的数据公司每天都在涌现,试图从这场淘金热中分一杯羹。竞争如此激烈,许多公司可能会在中国实验室中找到收入来源,甚至变得依赖它们;一家美国供应商 AfterQuery 据报道其 1 亿美元 ARR 中有一半来自中国业务。其他供应商可能只是单纯因为这是白送的钱才卖;一个产品在首次制作并售出后,再卖给其他客户的间接成本实际上为零。此外,随着模型能力提升和扩散,产品的价值会随时间下降,这意味着供应商有动力在产品价值枯竭之前尽快将其倾销给尽可能多的客户。时间一长,模型开发者还不如用 GPT-6 Astra 来制作好的幻灯片用于 SFT 甚至幻灯片制作环境,而不是花钱从供应商那里购买环境。
我们尽最大努力搜遍了每一个角落,以查明哪些供应商在向中国销售,以下是我们能找到的公司:
Mercor,最大的数据供应商之一,根据我们能够获取的数据,其向阿里巴巴出售了 SWE RL 环境。Forbes 报道 其 2026 年第二季度收入的 2% 来自中国,一位来自中国实验室的匿名消息人士告诉我们,他们从 Mercor 采购。
SurgeAI,另一家大型数据供应商,据SemiAnalysis 和 Forbes 称,其向腾讯、Z.ai 和 Moonshot AI 出售 RL 环境。我们还发现了可能表明腾讯是其客户的证据,且同一来自中国实验室的匿名消息人士告诉我们,他们从 Surge 采购。
Turing,一家专注于代码的大型数据供应商,向腾讯和阿里巴巴等中国实验室出售数据。我们发现了多条证据以及 Turing 承包商描述其与中国实验室合作工作的帖子。
AfterQuery,一家中型数据供应商,据 Forbes 称严重依赖中国业务,尽管我们未能找到任何销售的独立验证。
Abundant,一家专注于代码的小型供应商,已向字节跳动出售。
Pareto,一家中型供应商,曾与字节跳动在人类数据收集方面合作。Pareto 的旧网站展示了来自字节跳动的客户证言。
DeccanAI,一家总部位于美国和印度的初创公司,已向腾讯和字节跳动出售。
Eaglepoint,一家总部位于美国和东非、专注于代码和医疗保健的小型供应商,已向字节跳动出售。Eaglepoint 可能是其他数据供应商的分包商,该公司由总部位于北京的 Mofy AI 多数控股。
据一家从他们那里采购的中国实验室的匿名消息源称,另一家美国供应商Invisible也向中国销售。
我们为消息源的模糊处理表示歉意,但决定不提及或链接它们,以防它们日后被修补或移除。如果政府中有任何人有意查看消息源,请联系 aqib@chinatalk.media 和 quinn@chinatalk.media。
这九家公司只是我们能够找到的公司,肯定还有更多存在。我们之所以能发现这些,仅仅是因为匿名消息源以及分包商草率的商业操作——这些分包商通常来自工资较低的较贫穷国家(最常见的是印度)。供应商将大部分环境创建和数据整理工作外包给这些报酬微薄的分包商,然后供应商再将这些产品以离谱的加价转售给客户。我们听说过产品以制作成本的千倍价格出售的情况。
在发展中国家雇佣数千名工人的缺点是,运营安全往往糟糕透顶。承包商本应使用代号,却泄露了客户名称。他们在LinkedIn帖子和简历中列出自己服务的客户。我们设想,随着运营安全状况改善——以及随着使用AI创建这些环境最终在价格和质量上开始与分包商匹敌——这类证据在未来会变得越来越少,但它仍是当今供应商行业的标志性特征。
如果你的厨房里有九只蚂蚁,那你面临的问题就不止是九只蚂蚁。据我们所知,唯一公开表示放弃任何中国业务的公司是Scale、micro1和fleet。
这一趋势广泛存在的一个迹象是中国需求旺盛。中国实验室极度渴求美国数据供应商的产品,尤其是专家评分的领域。通常,中国实验室更倾向于内部构建RL环境,尤其是因为其第三方供应商行业虽在增长但仍处于起步阶段。但对于任何需要专家评分者和更小众领域的事情,西方供应商填补了空白。StepFun的一则采购员招聘广告列出了供应商交付物,如“repo、docker、task、trajectory、reward、rubric、verification”。腾讯的CL-bench包含似乎由西方专家编写的评分标准。因此,中国获得了原本难以在国内获取的专家评分者。 这些专家被用于构建智能体编程、金融、写作以及各种办公任务中的模型能力。此外,尽管中国实验室可以在内部创建大量合成数据,但他们始终在寻求外部数据以抵消自身偏差并改善其分布。
我们还从美国和中国AI行业内部人士处获悉,中国的采购模式几乎完全建立在刷榜(benchmaxxing)之上。这一现象此前已有报道,但在业内仍备受争议。我们听说,刷榜现象可部分归因于中国实验室的内部竞争。团队之间的竞争可能非常激烈,在基准测试中取得好成绩是证明团队价值的一种切实手段。此外,为了提振股价,公司必须证明其模型足够优秀。而要证明模型优秀,就必须展示其在基准测试中的良好表现。因此,实验室有明确的经济动机去追逐基准分数。于是,供应商专门打包数据集和环境,将其作为能在特定基准上提升模型性能的产品来营销。这种采购模式表明,目前强化学习的迁移很可能是良性的;许多具有商业相关性的基准仅仅评估编程和办公任务。但随着模型变得更强、基准开始代表更危险的能力,刷榜就会成为一个问题。
然而,除了这些蛛丝马迹和泄露的消息之外,我们最终无法知道谁在卖什么——而问题恰恰就在这里。在法律层面,实际上几乎没有规则约束这些交易。大多数公司都有有限的客户政策,2026年5月,Mercor将其政策从所有权测试收窄为地点测试(之前、之后)。除被列入实体清单的买家(如智谱)外,强化学习环境基本不受出口管制约束,但未列入清单的中国境外关联公司可以轻易规避这一点(而且似乎很多人根本不在乎实体清单)。此外,由于工作以客户代号进行,构建环境的承包商往往不知道最终买家是谁。
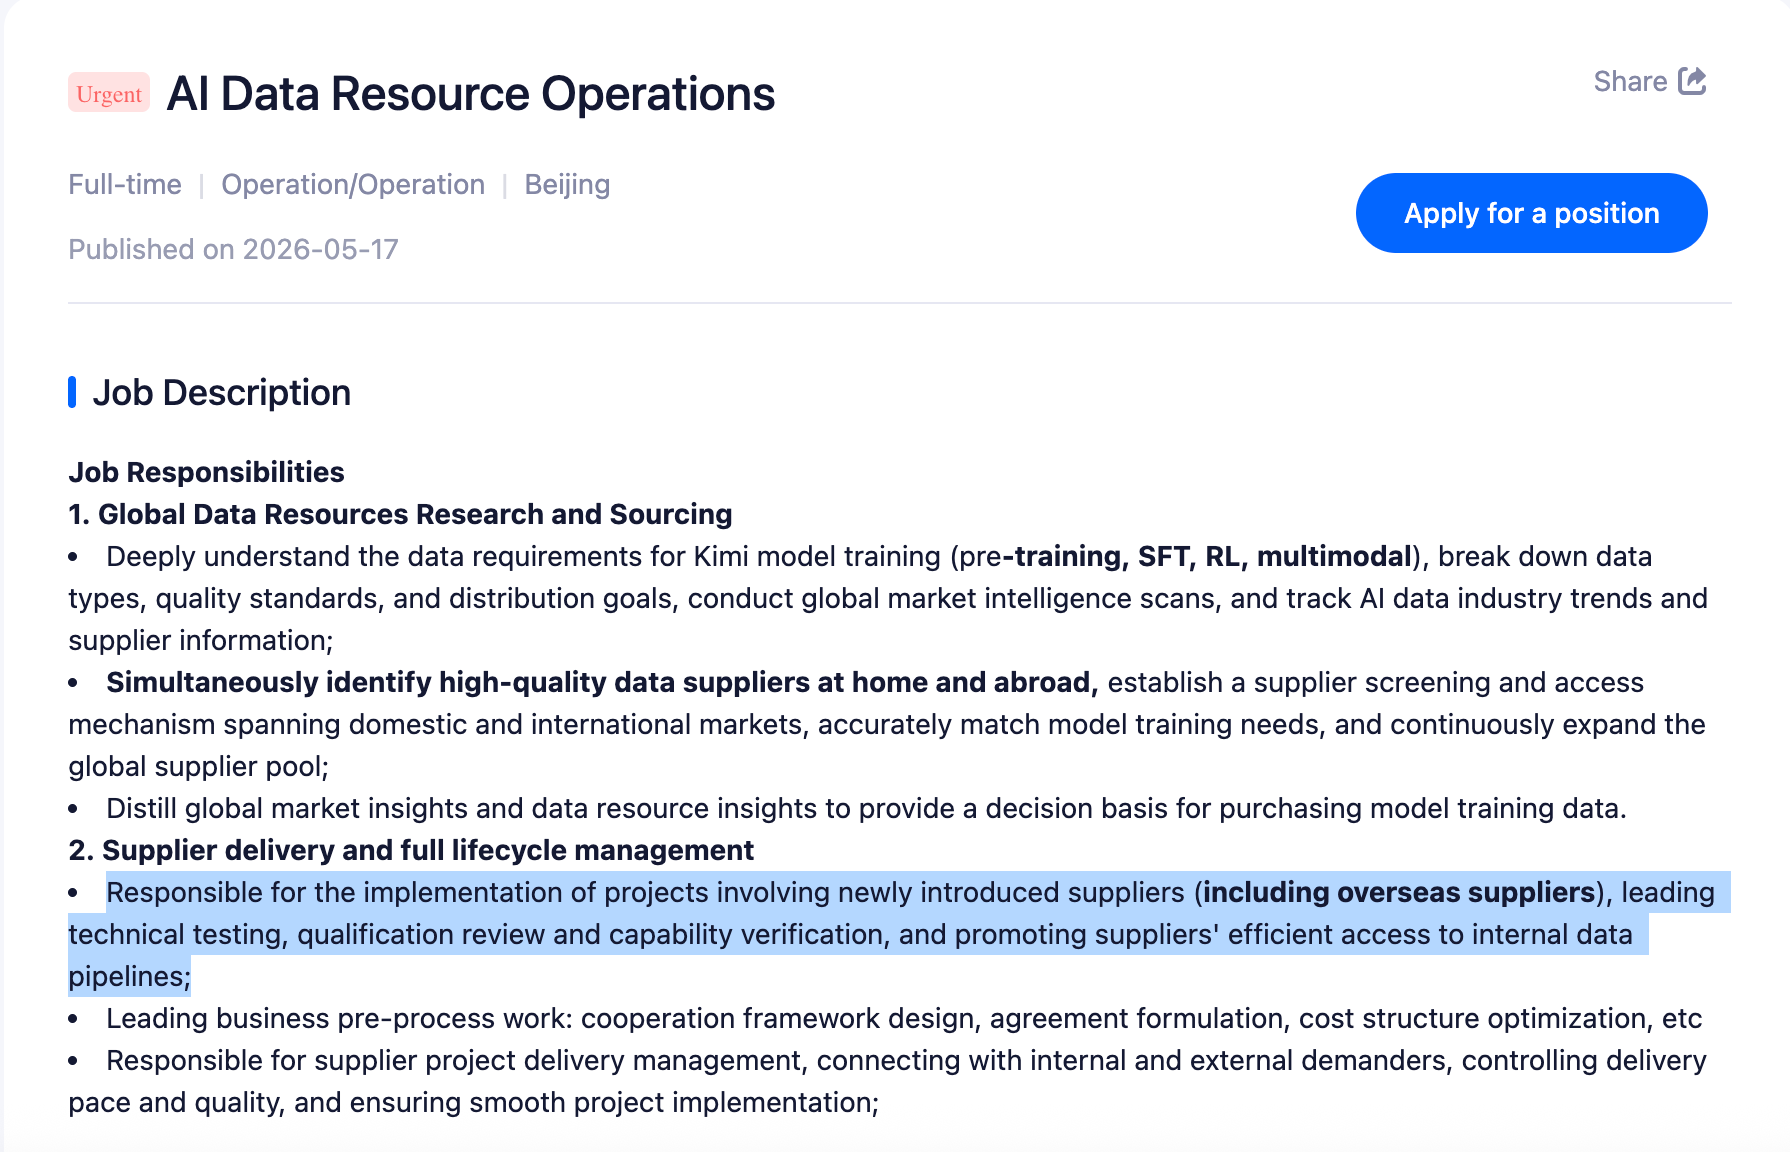
离岸外包也被用来让美国供应商无需在当地设立法律实体即可向中国公司销售。字节跳动的数据采购部门设在新加坡和圣何塞。中国实验室经常发布招聘广告,寻找有海外供应商经验的员工(腾讯混元、月之暗面、MiniMax、阿里巴巴等均如此)。这种外包使交易既游离于中国的采购记录之外,也避开了美国的大部分规则。
美国现行规则主要涵盖可识别的美国数据、医疗数据以及大量未识别数据。相关法规包括司法部的数据安全计划、《保护美国人数据免受外国对手侵害法案》(PADFAA)以及与医疗数据相关的州法律。这些规则可以解释为什么中国新兴的数据产业正聚焦于医疗数据,因为这是法规真正适用的唯一子集。然而,除这些规则外,一切似乎都是自由竞争,我们也不清楚这些规则是否得到严格遵守。
该怎么办?
我们应当采取行动
应当制定一些常识性政策,以限制这些交易带来的危害。也就是说,我们应努力限制两用环境向中国实验室的转移,而联邦政府有多种手段,可以以最低限度的干预方式实现这一目标。
两个常见的建议包括:
BIS 可依据相关现行规则限制两用环境。BIS 已有规则禁止出口可用于芯片设计、网络攻击能力和生物武器开发的产品;我们可以创造性地将相关 RL 环境归入这些规则之下。更广泛地说,BIS 可以向供应商发送 is-informed 信函,明确说明向军事最终用户销售以及用于生物武器最终用途需要许可证。
DoW 应改变采购标准,防止隐性知识转移给中国实验室。通过 FAR 和 DFARS,DoW 可以限制其签约供应商向令人担忧的中国实验室销售,从而防止中国公司搭上具有明确国家安全关联的 RL 环境的便车。
然而最重要的是,美国政府需要更清楚地了解正在发生的事情。如果我们发现供应商与中国实验室有更多业务往来,尤其是当这些业务越来越多地涉及两用领域时,我们可以选择采取更严格的措施。在关注哪些领域方面,中国实验室往往是美国实验室的快速跟随者。当一家美国实验室开始为办公任务或深度研究或其他任何事项购买数据和环境时,中国实验室接下来就会决定购买这些。我们可以借鉴商务部的做法,通过宣布潜在规则来收集行业现状数据,然后再真正采取行动。
既然我们正在追逐网络和生物能力,一些中国实验室可能也会决定将其作为下一个方向。当这种情况发生时,我们必须准备好保护这些敏感领域,同时又不让整个行业随之受损。
但值得庆幸的是,这并非世界末日
数据行业目前处于蛮荒时代,需要一些秩序,但归根结底,这些关系并非末日降临。我们认为灾难性后果可能被夸大了,原因有几个:
有害交易从根本上需要中国实验室和美国实验室之间存在滞后。为了节省算力,中国实验室必须首先等待美国实验室购买或创建一个环境,然后中国客户才能转购这些环境,这使中国实验室在模型能力上始终至少落后几个月。这些交易只能让中国在算力受限的情况下缩小差距,而无法领先,并降低了对强大的中国数据产业的需求。
英语语言和西方语境的环境对中国实验室的迁移价值可能有限。例如,为导航 Google 或 Slack 等应用而构建的环境,可能不容易转化为适用于百度或飞书。
Sensitive environments for domains like life sciences, experimental biology, chemistry, cybersecurity, chip design, and investment banking have increasingly become in-house products for American frontier companies, as evidenced by increased hiring of domain experts by Anthropic and OpenAI. Chinese labs, for their part, are also increasingly turning inward for certain domains. For example, ByteDance is attempting to bring STEM experts in house. This trend will only intensify as AI becomes more capable of making good RL environments. (This does not cancel the threat entirely, however. Mercor has been hiring biology specialists for gene sequencing purposes too.)
RL 环境具有极强的领域特定性。危险环境仅占全部环境的一小部分,而卖给中国的环境中这一比例可能更小。例如,并非所有编码任务都能转化为更强的网络攻击能力。
基于专有数据——即属于美国实验室财产的数据——构建的环境不得转售。实验室日益为自己购买数据,从而限制了向竞争对手的溢出收益,即便存在隐性知识也是如此。不过,我们应当关注供应商与企业(尤其是中小企业)之间数据经纪合同在多大程度上得到遵守。
此外,一个充满活力的国际化 RL 环境市场,很可能带来更好的模型!在办公任务等良性领域表现更出色的中国开源模型,为消费者创造了健康竞争和更多选择,即便我们想限制网络和生物等两用领域。面向 AI 安全与对齐的 RL 环境也在不断涌现,限制中国获取这类环境只会增加 AI 安全事故的风险。
要接收新文章并支持我们的工作,请订阅!
来源:ChinaTalk · chinatalk.media
来源:RadarAI · aihot.news