SemiAnalysis 发布 TPUv7 AgentX 智能体推理基准,对标 NVIDIA GPU
SemiAnalysis 发布 TPUv7 AgentX 智能体推理基准结果,对标 NVIDIA GPU
SemiAnalysis 发布首批 TPUv7 在 InferenceX/AgentX 长上下文、多轮智能体推理基准上的官方结果,覆盖 Muse Spark Open、GLM-5.2、Qwen3.5 397B 和 Kimi K3 四款模型。
SemiAnalysis 首次公开 TPUv7 在长上下文多轮智能体推理上的第三方基准,可与 NVIDIA 各代 GPU 逐项对照。
SemiAnalysis 长文 RSS· Bryan Shan·2026-11-06 03:03· 1 小时前AI 评分69
铁(木)王座:Google 的 TPU 在推理领域宣示主权
AI 导读
SemiAnalysis 发布首批 TPUv7 在 InferenceX/AgentX 长上下文、多轮智能体推理基准上的官方结果,覆盖 Muse Spark Open、GLM-5.2、Qwen3.5 397B 和 Kimi K3 四款模型。
正文 · 原文
2025 年 11 月,我们发布了一篇通讯,称 Google 正在向外部客户销售 TPU。此后,Oracle、OpenAI、Anthropic 和 Meta 都成为 TPU 客户,正如我们的加速器模型所预测的那样,我们一次又一次被证明是对的。
硬件需求只是故事的一半,因为 NVIDIA 的护城河历来是其软件和庞大的开发者生态。这正是 TPU 也在取得进展的地方,它与整个生态系统的上游维护者合作,包括 Meta PyTorch 团队、vLLM(Inferact、RedHat)、SGLang(RadixArk)、llm-d、Ray 等。对于读过我们 2026 年 9 月那篇阐述 Google TPU 外部化战略文章的人来说,这并不意外。
在我们 9 月的文章中,我们发布了首批第三方 TPUv7 在 InferenceX 上单轮工作负载的结果,显示在 Qwen 3.5 397B 上进行同等条件的 FP8 对比时,TPUv7 Ironwood 每美元性能比 B200 和 B300 高出多达 50%。
我们还报道称,许多 Google TPU 客户要求提供 AgentX 结果,因为长上下文、多轮智能体服务正是推理支出正在流向的方向。
此前,Jensen 做客 Dwarkesh Podcast,评论称没有其他芯片利用这个机会在 InferenceX 上展示性能。
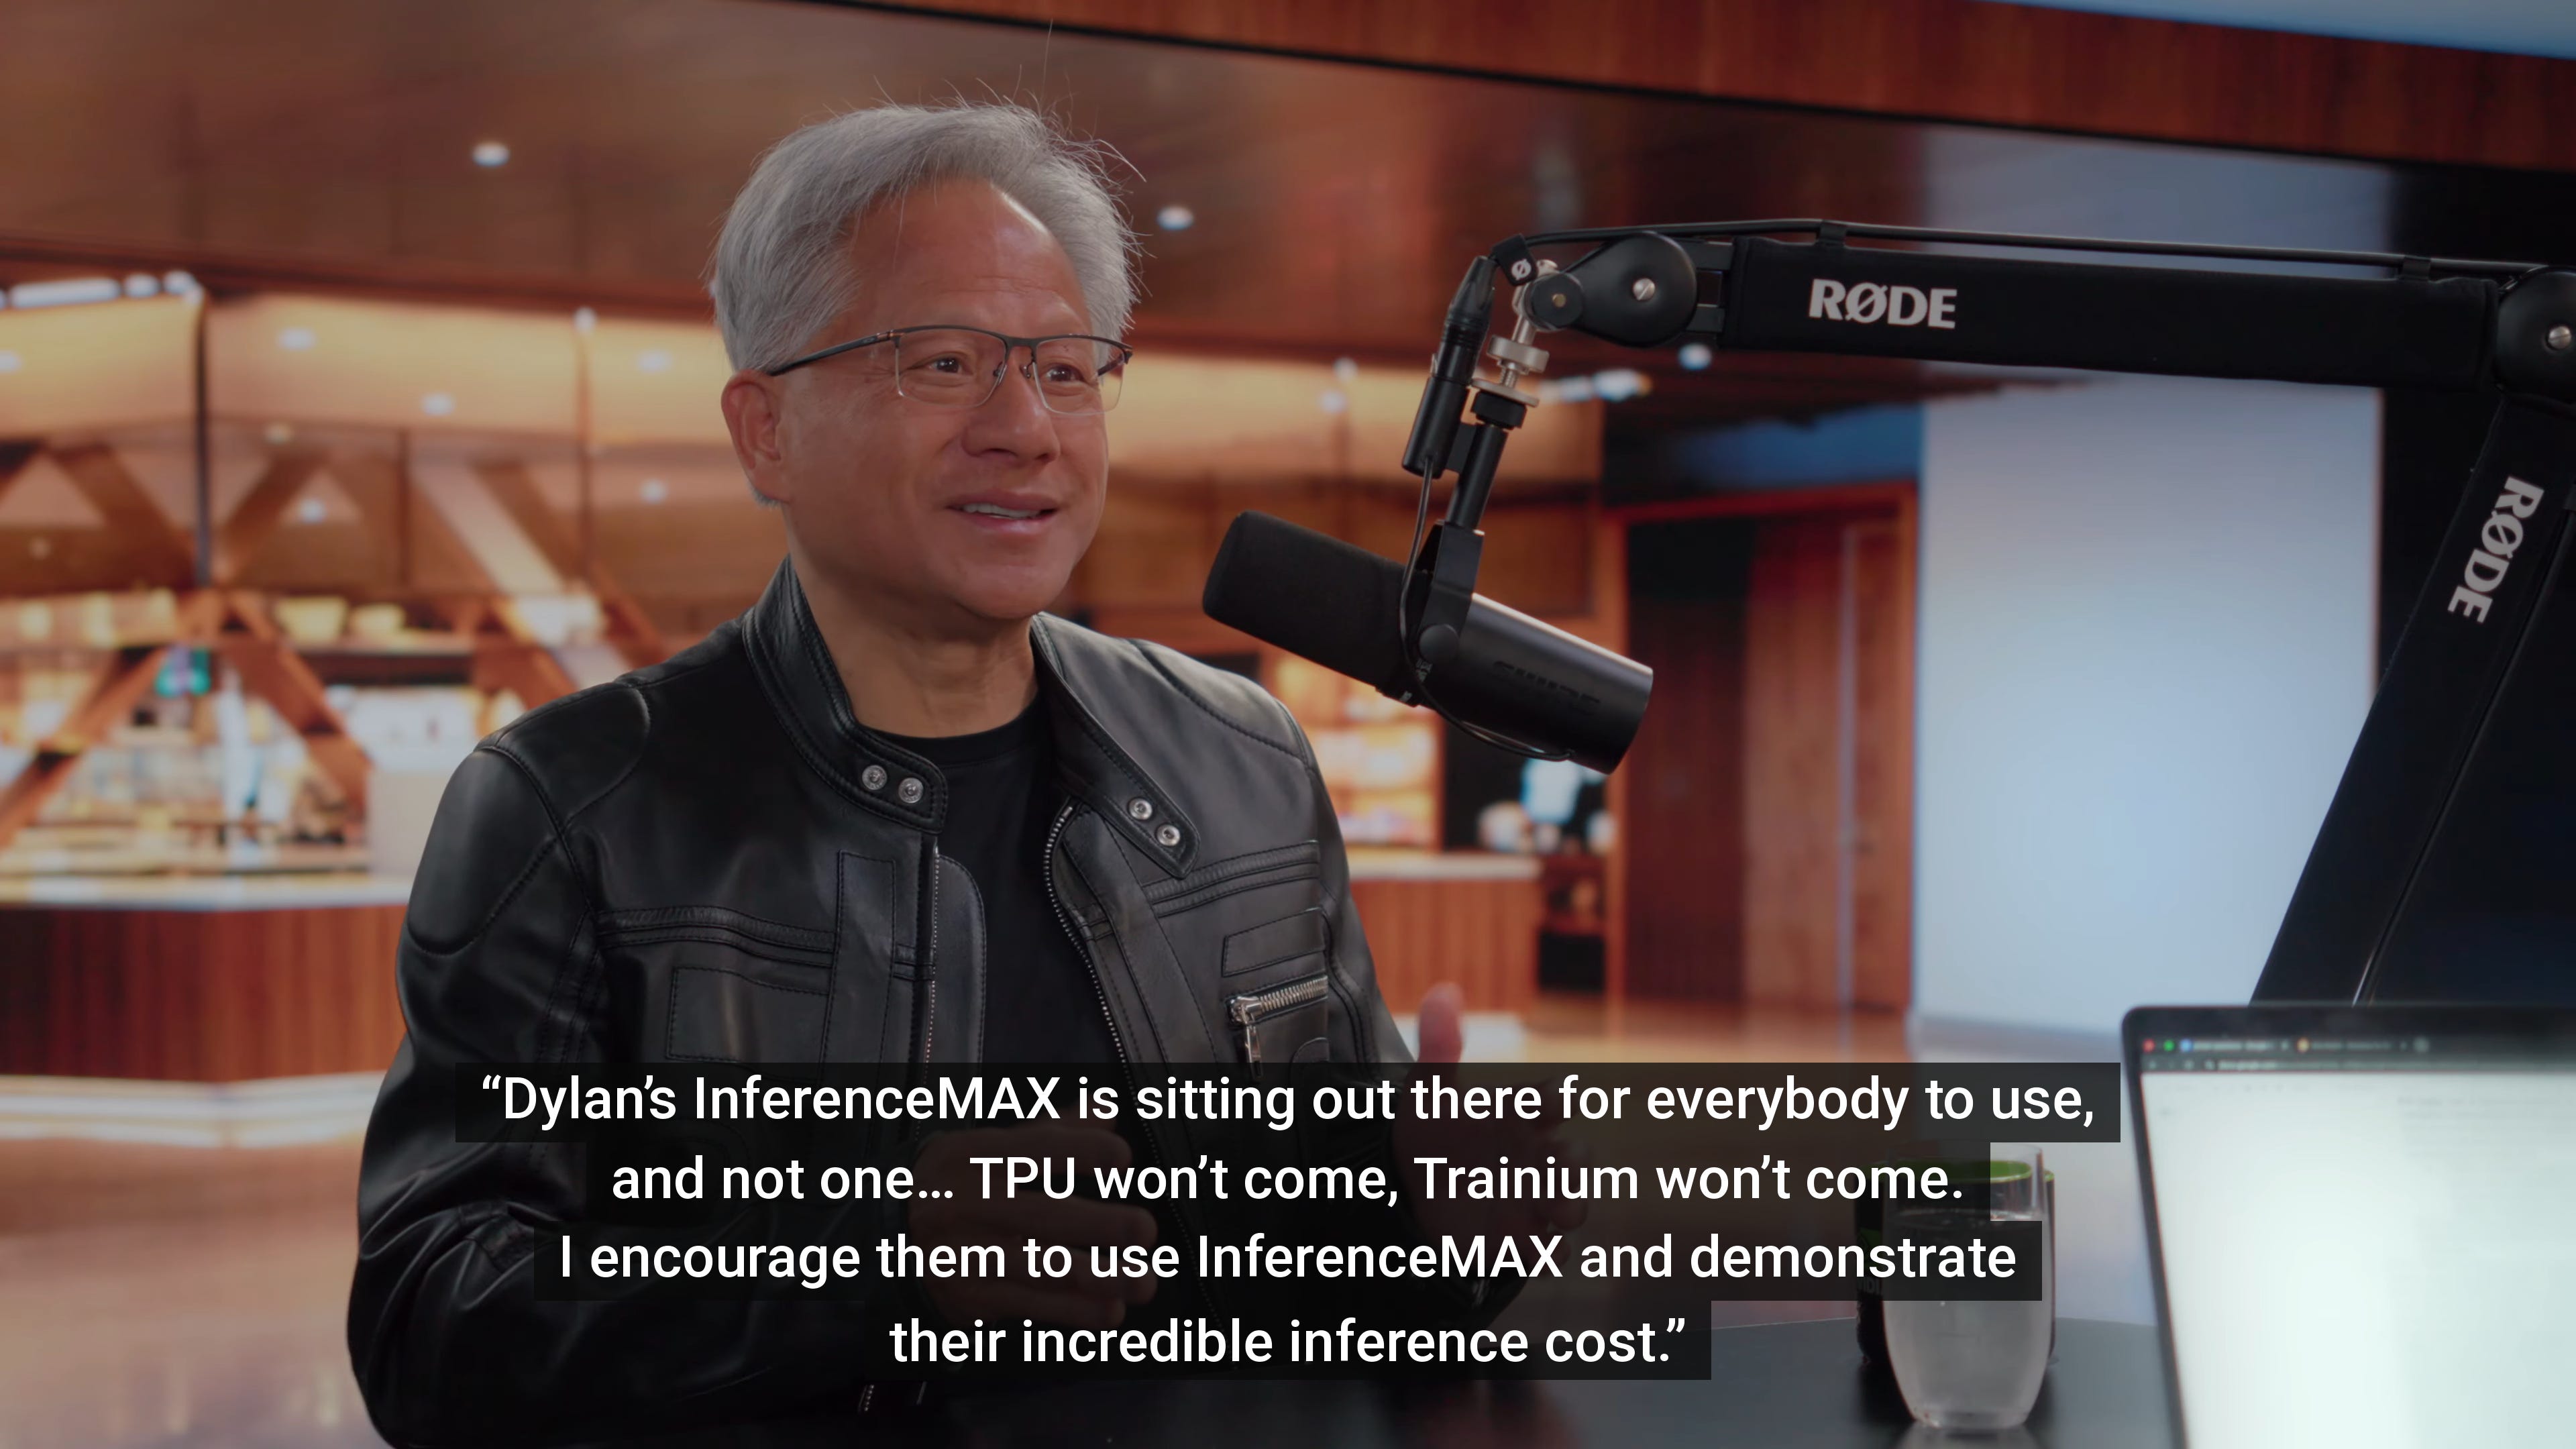
六个月后,Google 确实在充分利用这个机会。
今天我们发布首批 TPUv7 在四款模型上的官方长上下文、多轮、真实智能体推理基准结果,显示 TPUv7 在面向外部客户的每美元性能上要么具有竞争力,要么交付最佳的最先进结果:
Muse Spark Open SGLang AgentX(NVFP4 权重):尽管该架构是为 GPU 协同设计的,TPU 每美元性能仍具竞争力。由 OSS 生态开发者 RadixArk(SGLang 的开发者)提交。
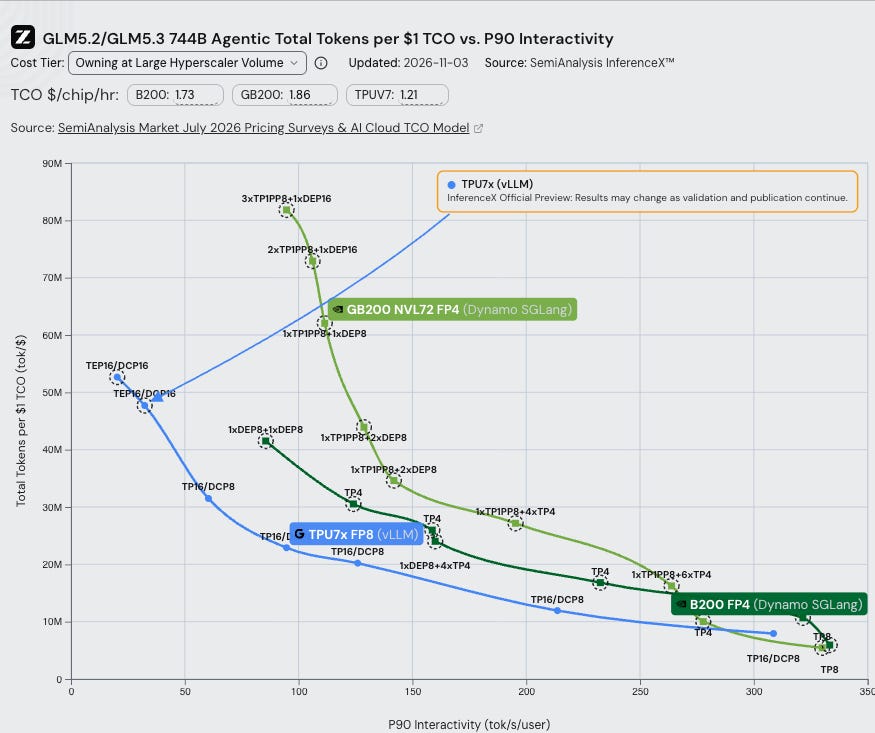
GLM-5.2 vLLM AgentX(FP8):TPUv7 是最便宜的 FP8 选项,在 60 至 300 tok/s/user 范围内,每美元 token 数是 B200、B300 和 MI355X 的 1.2 倍至 2.7 倍。NVIDIA NVFP4 仍胜过 TPUv7 FP8,但存在精度/质量损失。
Qwen3.5 vLLM AgentX(FP8):借助 llm-d 分离式服务,TPUv7 在每个交互级别上都胜过 GB300 FP8,并且即使在更高精度/质量下也能与 GB300 FP4 恢复持平。
Kimi K3 vLLM AgentX(MXFP4 权重):发布时与 GB300 NVL72 具有竞争力;TPUv7 每美元 token 数是 GB200、B200、B300 和 MI355X 的 1.15 倍至 2.5 倍。由 vLLM OSS 生态开发者 Inferact 提交。
该基准测试在 InferenceX/AgentX 上进行,这是行业标准推理基准,几乎得到所有主要算力买家的支持,从 Microsoft Azure 到 Oracle 再到 Meta 以及更多。此外,它还得到 ML 社区的支持,包括 vLLM、LMCache、SGLang、PyTorch 和 Huggingface,以及 OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi 等主要实验室的支持。
Google 的潜在 TPU 客户和现有 TPU 客户都在向 Google 索要 AgentX 的结果,因为 AgentX 基准测试非常贴近现实,而且与他们真实的推理工作负载高度相似。关于我们对 TPUv8i、TPUv8t、TPUv9、TPUv10 的 SemiAnalysis 供应链出货量估算,请查看我们的 Accelerator Model,获取完整的逐季度出货量明细。
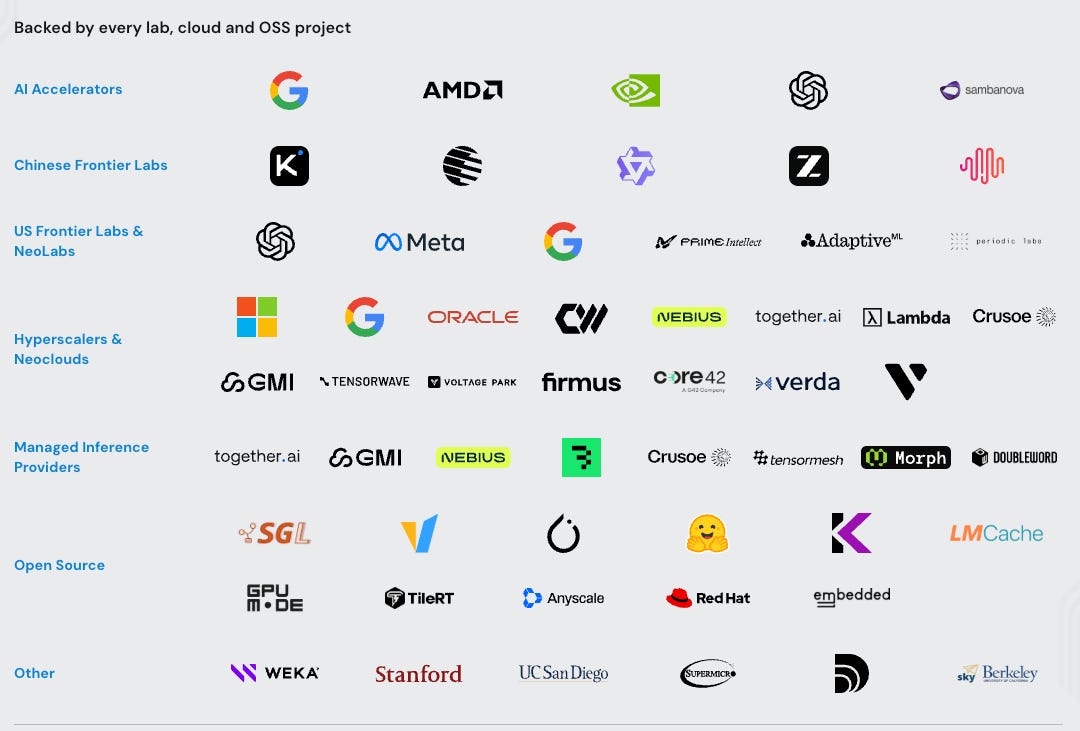
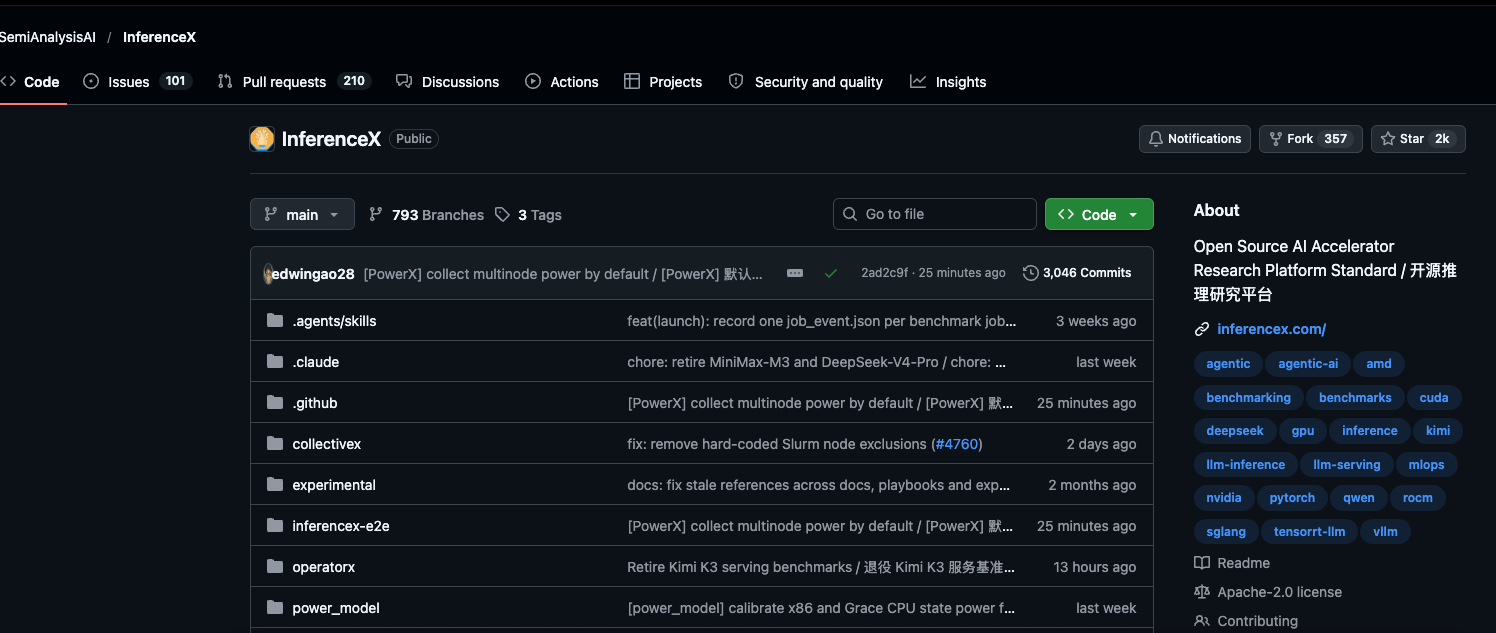
如果你觉得这个开源基准测试和数据有用,请给 InferenceX GitHub 仓库点个 Star!InferenceX 是世界上唯一一个同时涵盖 TPUv7、OpenAI Jalapeño、Nvidia Rubin NVL72、AMD,以及即将加入的 SambaNova 和 Trainium2/3 的推理基准测试。
给 Jensen 的建议
NVIDIA 只是偶尔在某些模型/场景上输给 AMD,但 TPU 能提供更高的每美元性能或具有竞争力的每美元性能,这对 NVIDIA 高层领导来说是一种不愿接受的新体验。TPU 在 Qwen3.5 397B FP8 上发布首个 AgentX 结果、显示即便是 TPUv7 FP8 也能击败 GB300 NVL72 FP4 之后,NVIDIA 立即派出一支由人类工程师和 agent 集群组成的突击队,实行 997 工作制,工作到当地时间凌晨 2 点,周末也不休息,横跨美国和中国大陆。对 NVIDIA 来说不幸的是,他们首次提交的 GB300 FP4 反击结果,在曲线的大部分区间上,对外部客户而言每美元性能仍比 TPUv7 FP8 差 1.64 倍。我们确实认为,凭借足够多的 agent 集群,NVIDIA 有可能在 GB300 NVL72 FP4 对 TPUv7 FP8 上重新夺回略微的性能领先,但在 NVIDIA FP8 对 TPUv7 FP8 上,我们认为 NVIDIA 不可能在某些模型上重新夺回 SOTA。
我们从 PyTorch 开源维护者和 NVIDIA 客户那里经常听到的一件事是,官僚主义严重;一些简单的事情,比如为 NVIDIA 驱动添加新功能以支持 PyTorch CudaGraph 捕获的某项特性,已经在“NVIDIA 内部法律审查”中卡了三个月。让律师成为技术驱动功能的阻碍者毫无道理。我们在试图让 NVIDIA 添加诸如改进 ConnectX、NVSwitch、HGX Board(Vulcan、Umbriel)DCGM 功耗遥测等功能时也遇到了类似的挑战,光是拿到时间表的时间表就要等很久。相比之下,像 AMD 这样具有创业心态的公司(在 Anush、Ramine、Vamsi、Lisa 的领导下)可以快速开发这些功能。
NVIDIA 需要在文化上做出转变,大幅减少官僚主义。这是 Jensen 必须应对的 NVIDIA 护城河最大风险之一。根据我们的经验和许多客户的经验,NVIDIA 现在在响应外部建议、git 提交和反馈方面比 AMD、Google 和 Amazon 都要慢。
话虽如此,NVIDIA 的某些团队正在打破官僚主义,比如 NVIDIA 前 CentML 的 vLLM 团队。AMD 和 TPU 为流行的生产级开源推理引擎添加了创新的 Megakernel 解码支持。一周之内,他们就通过迅速添加并合并 Megakernel 支持(PR 由 AMD vLLM 维护者批准)为 NVIDIA 完成了防守。
TPU 正在生态系统中取得重大进展,多个模型,例如 Day 0 Meta 的 Muse Spark Open 支持,以及 Kimi K3.1 Pro 已经具备 day 0 TPU 支持,因为它采用了 NVIDIA 的策略,即向开源维护者提供大量芯片。相比之下,NVIDIA 向社区维护者提供集群的做法越来越被 DMV 式的官僚作风所包裹,充其量也只是吝啬。对于一家市值 5 万亿美元的公司,人们会期望 NVIDIA 在向那些免费为改进 NVIDIA 技术栈而工作的 OSS 开发者贡献资源时更加慷慨。我们希望 Jensen 能找出消除拖慢进展的官僚作风的办法。
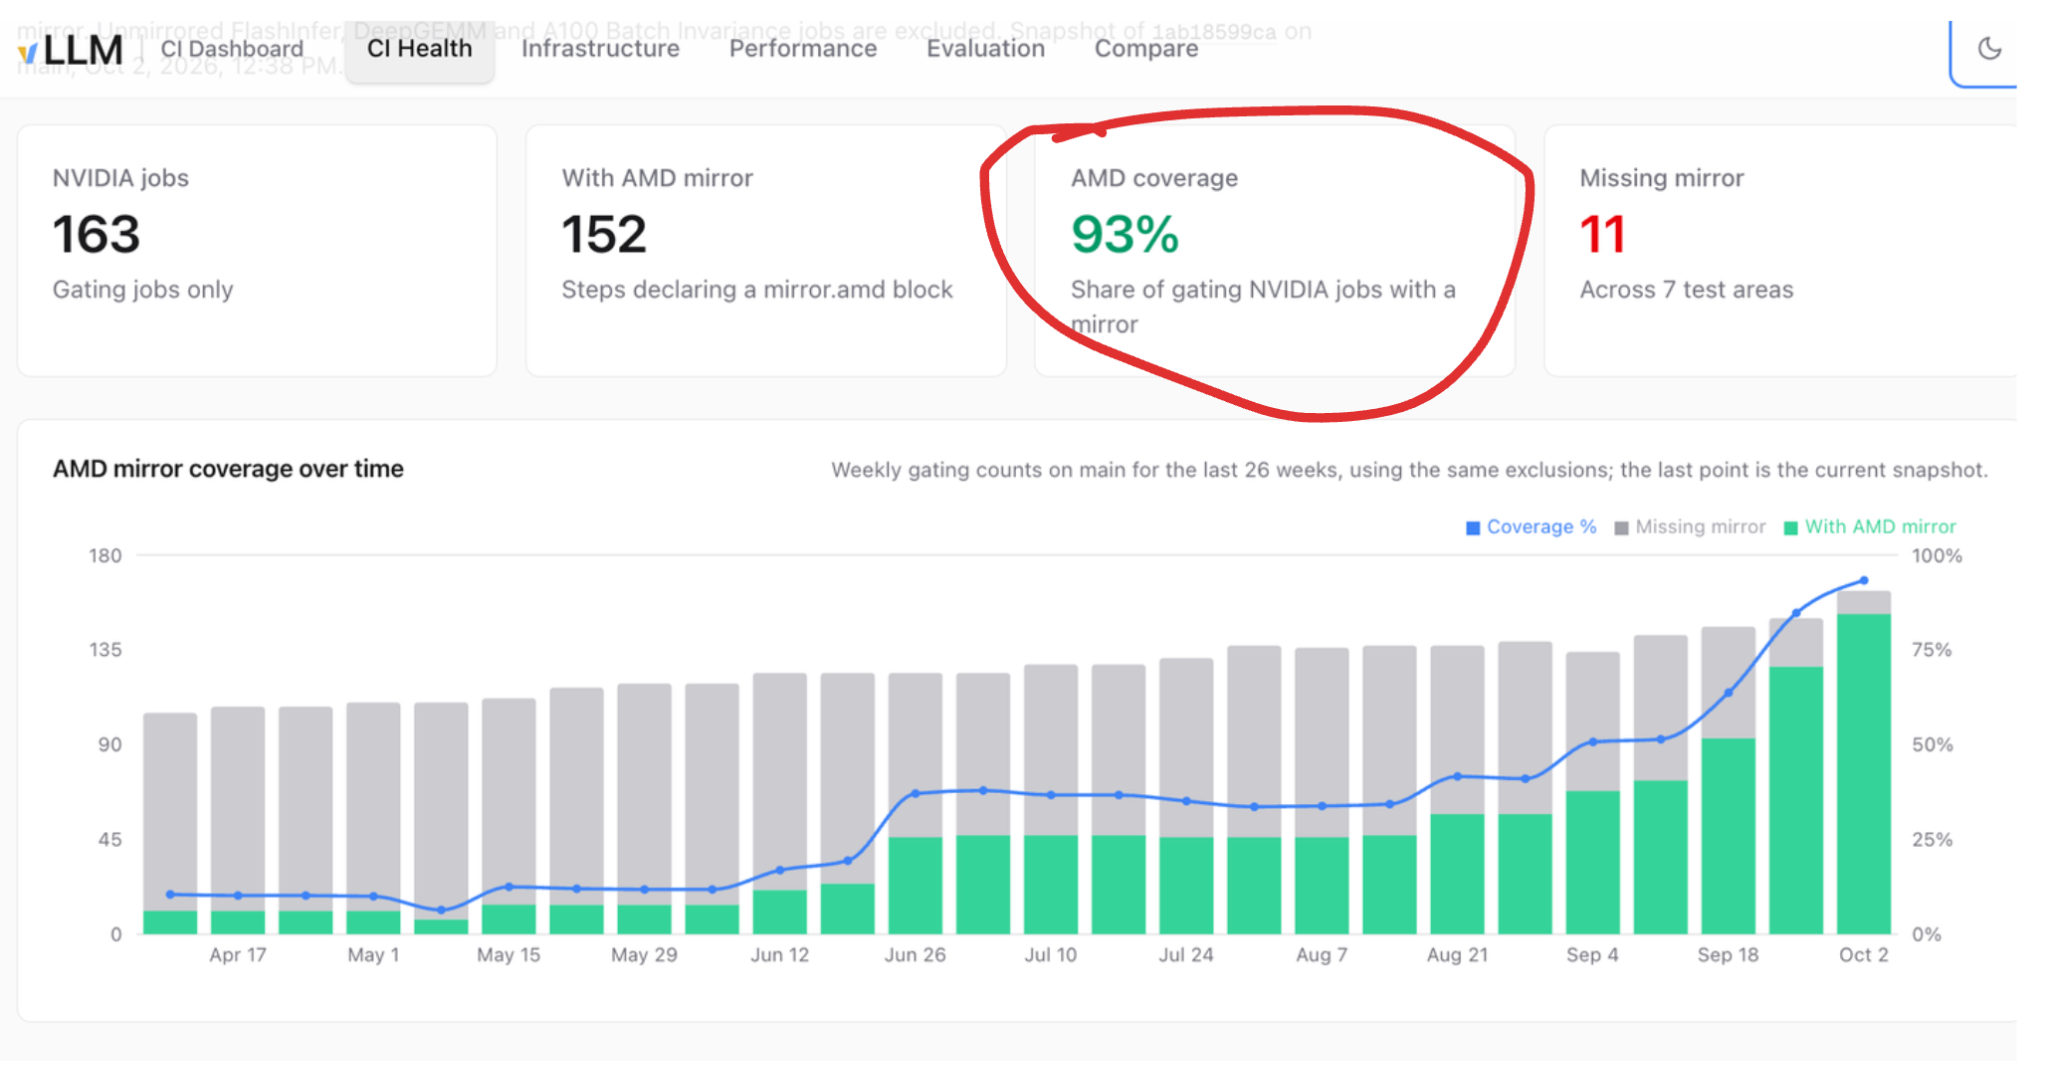
相比之下,AMD 越来越不那么吝啬,向上游 vLLM、TileRT、SGLang、Tokenspeed 等维护者慷慨提供集群访问权限,并迅速扩大 CI 集群规模,且官僚作风极少。
Meta 的 Muse Spark Open FP4 816B 在 SGLang TorchTPU 上的 Agentic 推理性能
Meta 是 TPU 的早期采用者之一,并且已经使用 SGLang-TorchTPU 在生产环境中部署 TPUv7。
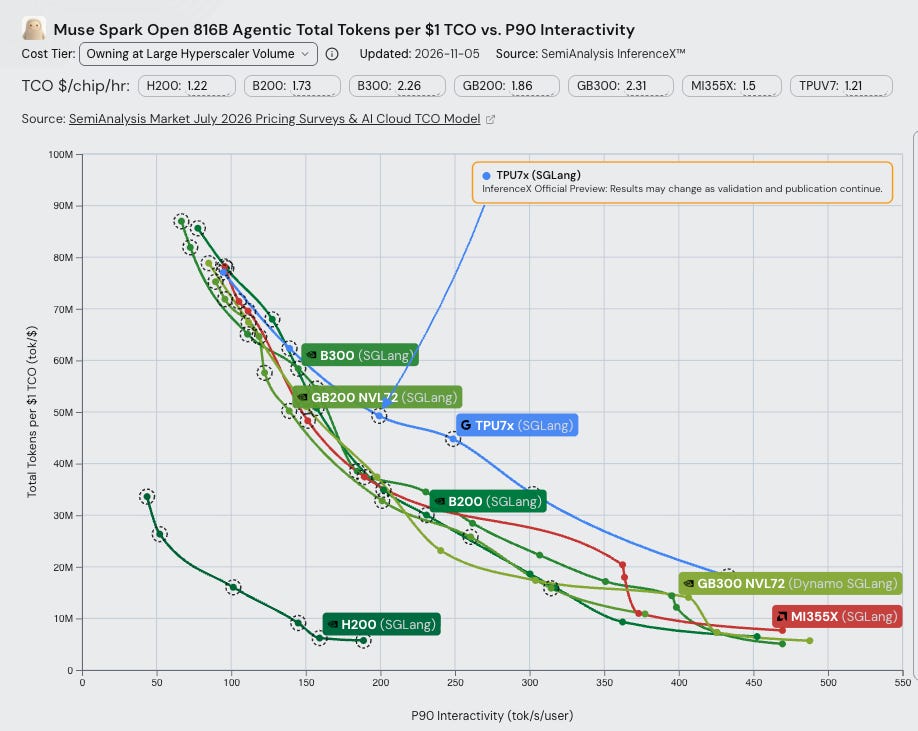
Muse Spark Open 是 Meta 最新的 816B 参数开放模型,也是 SGLang-TorchTPU 的首发模型之一。在 InferenceX 的 agentic 推理工作负载上,来自 RadixArk(社区开发者兼 SGLang 首席维护者)的提交显示,即使采用 Meta 购买 TPU 时的成本基准,TPUv7 在每美元解码性能上也具有竞争力。在生产推理中,Meta 使用 SGLang 进行 LLM 推理,并使用 vLLM 进行 RL 训练 rollout。从端到端延迟来看,TPUv7 仍需改进才能具备竞争力,例如继续优化其 prefill 内核。对于解码内核,TPUv7 SGLang 使用完全融合的 megakernel,从而消除了内核启动延迟。此外,该提交在高并发下使用 Google 开源的 TPU 原生 TPU-Sync 库进行 SGLang HiCache CPU DRAM 卸载,以提高前缀缓存命中率。
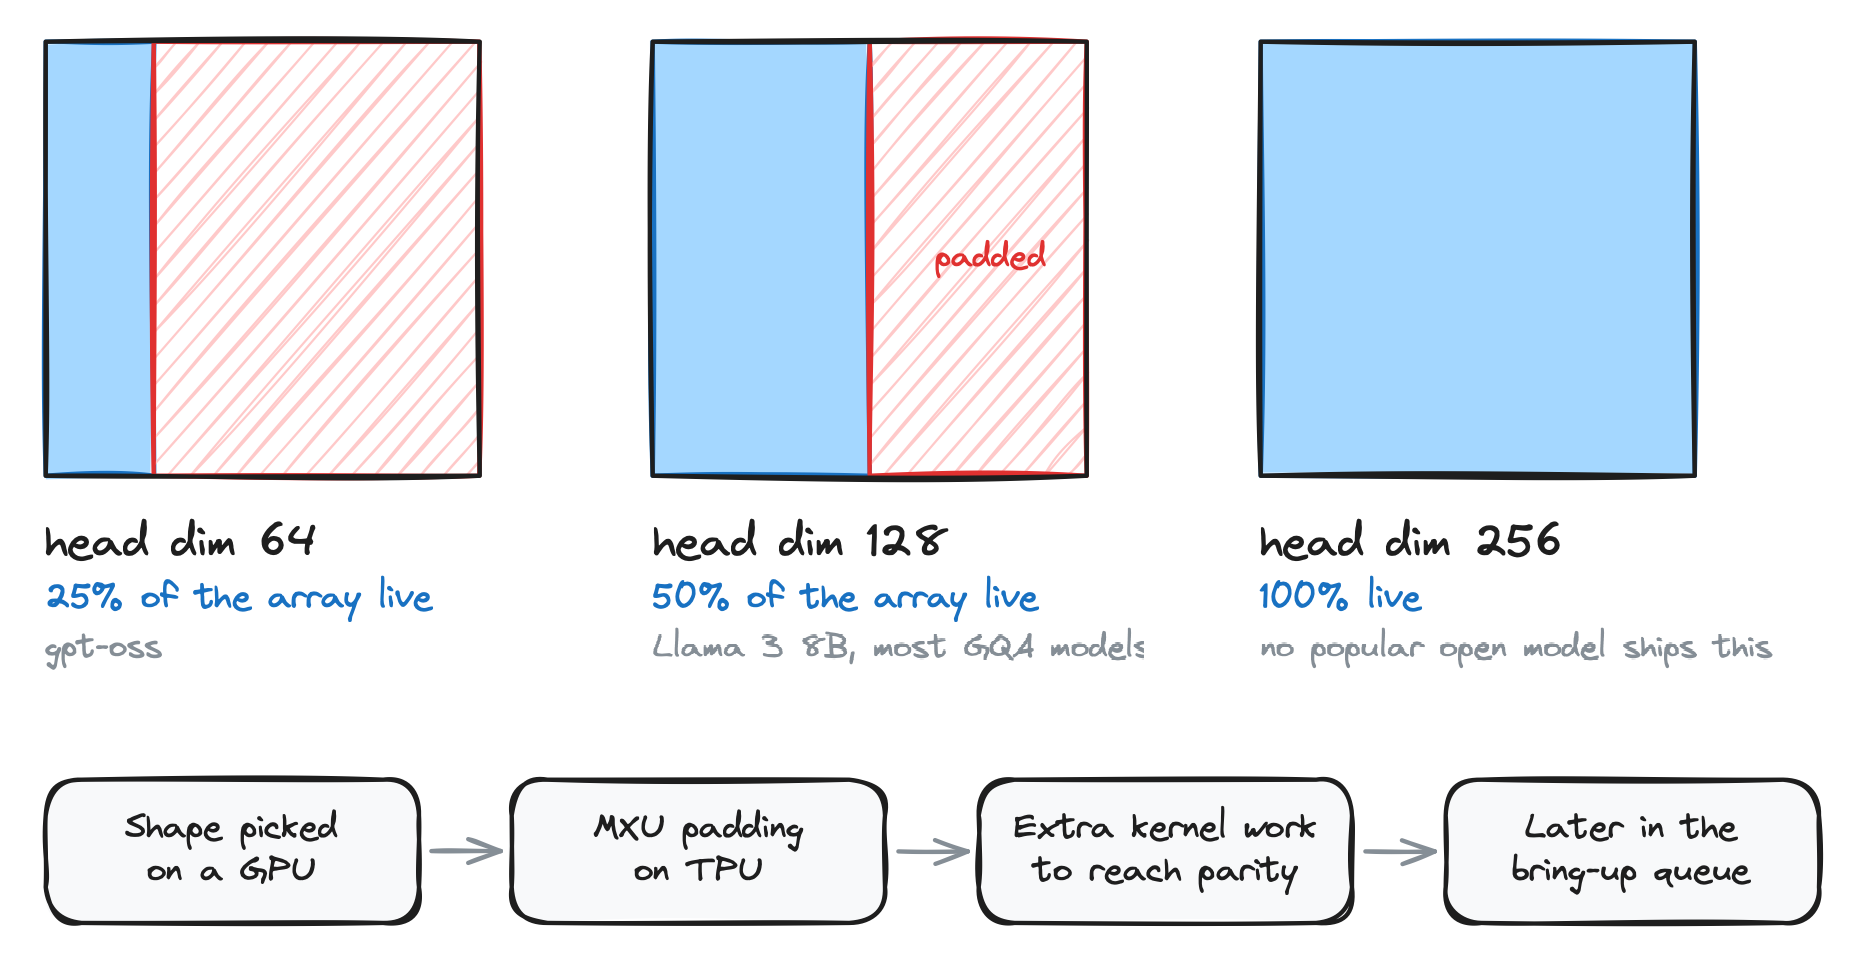
请注意,Muse Spark Open 是一个极度针对 GPU 优化的模型,理论上对 TPU 完全不友好。这是因为 Muse Spark Open 的 64 head dim,意味着对于长上下文注意力,25% 的脉动阵列被填充。
相比之下,GPU 矩阵核心消耗小 tile,因此各种 head 维度、专家宽度和分片后 KV head 数量都能接近峰值。在 H100 或 B200 上,使用 64 而非 128 的维度几乎不付出代价,并因此获得更便宜的注意力层。GPU 架构让研究人员能够优先考虑评估性能,而不损失推理性能。
这相当有趣,因为 TPU 在一个对 TPU 极度不友好的模型上也能获得相当有竞争力的性能。请注意,拥有大量 TPU 容量的 AI 实验室,如 Anthropic、Google Deepmind 以及即将加入的 OpenAI,通常会协同设计其模型,使注意力形状能很好地适配 TPU,以避免这个问题。
当 TPU 遇到 attention head_dim=256 的模型架构时,它们会进入全速模式。
祝贺 RadixArk 团队取得这一惊人成就!他们正在积极更新文档,以便所有人都能获得这一优化的 SGLang Muse Spark Open TPU 配置。我们预计 RadixArk 很快会带来更多 AgentX 结果,表明其 SGLang-TorchTPU 技术栈已为生产环境做好准备。
GLM5.2 / 5.3 vLLM AgentX FP8 智能体推理性能
GLM-5.2/5.3 是一款前沿开放模型。它是一个 MoE transformer,拥有 744B 参数,每个 token 约激活 39B。该模型通过 DeepSeek Sparse Attention (DSA) 支持 1M token 上下文:一个轻量级索引器对先前 token 进行评分,完整注意力仅对每个查询选中的 2,048 个 token 运行。
对于 FP8,TPUv7 是服务 GLM-5.2 AgentX 最便宜的方式。从 60 到 300 tok/s/user,它在 FP8 下提供 B200、B300 和 MI355X 每美元 token 数的 1.2 倍到 2.7 倍,在 150 tok/s/user 下是 H200 的 4.4 倍。
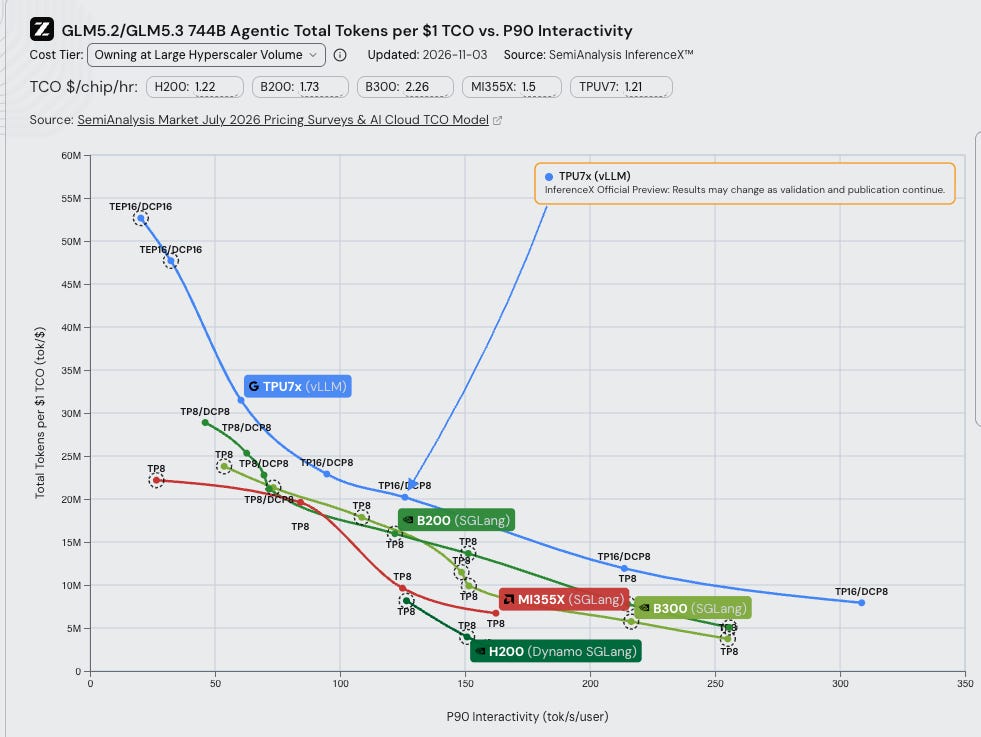
FP4 GPU 在每美元性能上仍然领先
由于 GLM-5.3 并非原生采用块缩放 FP4 进行 QAT,FP4 相比 FP8 有轻微精度下降。FP4 GPU 在大多数速度下仍提供更多每美元 token 数,因为 TPUv7 不支持原生 FP4,我们需要等到 2027 年第一季度才有支持 FP4 的 TPUv8,正如我们的加速器与 HBM 模型中所追踪的那样。在 100 tok/s/user 下,GB300 和 GB200 FP4 提供 TPUv7 每美元 token 数的 3.6 倍和 3.5 倍。FP4 将每个权重的字节数减半,而小批量解码受内存限制。
SemiAnalysis AI 云与 TCO 模型提供了 InferenceX 上所有加速器的全面定价明细,以及更多其他加速器,包括未来的 SKU,如 Nvidia Rubin Ultra 和 Feynman、AMD MI400 到 MI700、Google TPU v8 到 v12,以及 AWS Trainium3 到 Trainium6。
GLM-5.3 优化
GLM-5.3 AgentX 上下文达到 1M token,每个请求已有超过 90% 被缓存,因此 KV 缓存容量决定了能容纳多少用户。主要有四项变化:
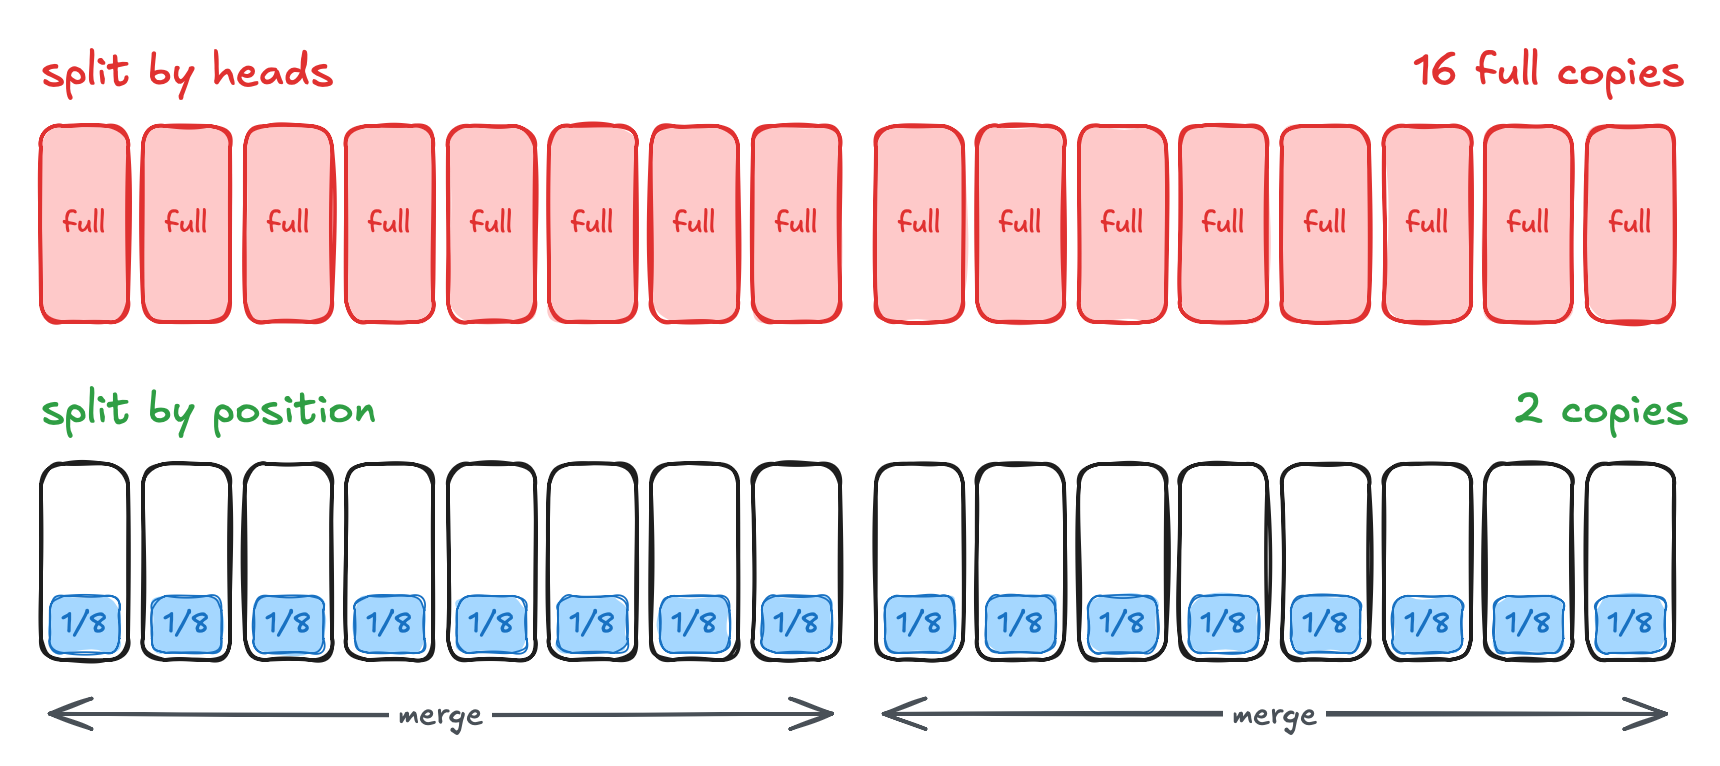
GLM-5.3 的注意力为每个 token 读取一个共享的压缩 KV 条目,因此将注意力头拆分到不同设备上会把整个缓存复制到每台设备。解码上下文并行 (DCP) 改为按序列位置拆分,并在每一层合并部分注意力结果。
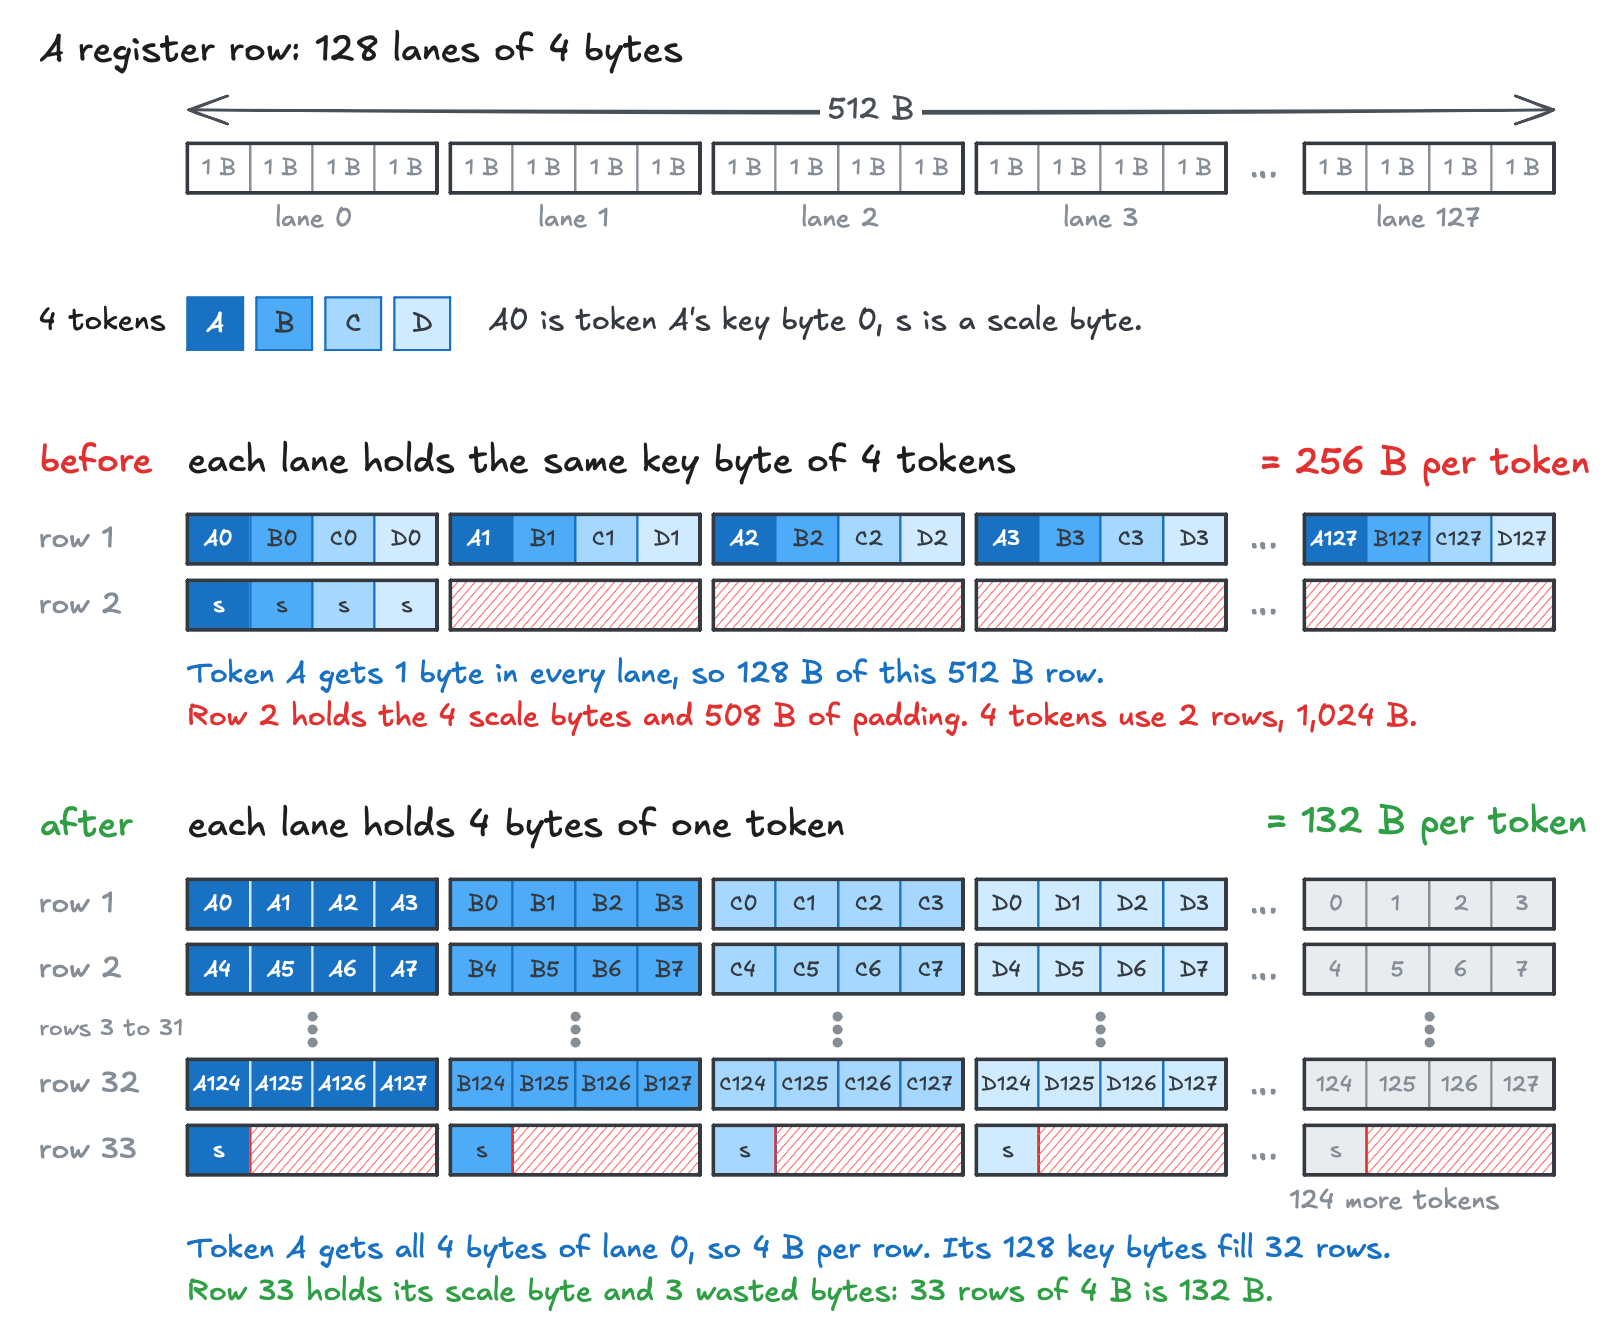
每个查询只读取索引器选中的 2,048 个缓存条目。TPUv7 的 SparseCore 专为分散内存访问而构建,负责挑选这些条目并在 TensorCore 运行注意力数学运算时收集它们。
TPUv7 使用的寄存器为 8 行乘 128 通道。数据必须打包到其中,这可能会产生碎片。128 个索引器键字节加上缩放字节总共 129,比 128 宽的行多一个字节,因此旧布局将其向上取整到 256。新布局将其横向排列:token 现在沿每一行排列,每个 token 的键沿 32 个四字节行向下排列,再加一行用于缩放。这样总共 132 字节,其中只有 3 个字节被浪费。
一个融合内核运行路由;专家、全归约和注意力合并成为单一集合通信。TPU 程序针对固定形状编译,因此 Google 为小解码步骤添加了 4 和 8 token 的形状,这些形状此前被填充到 16。
Qwen3.5 397B AgentX
两周前,Qwen3.5 397B 成为 Google 提交到 AgentX 的第一个模型。其在我们智能体推理基准上的 TPUv7 FP8 vLLM 结果表明,它的每美元性能甚至比 FP4 GB300 NVL72 好 1.67 倍。
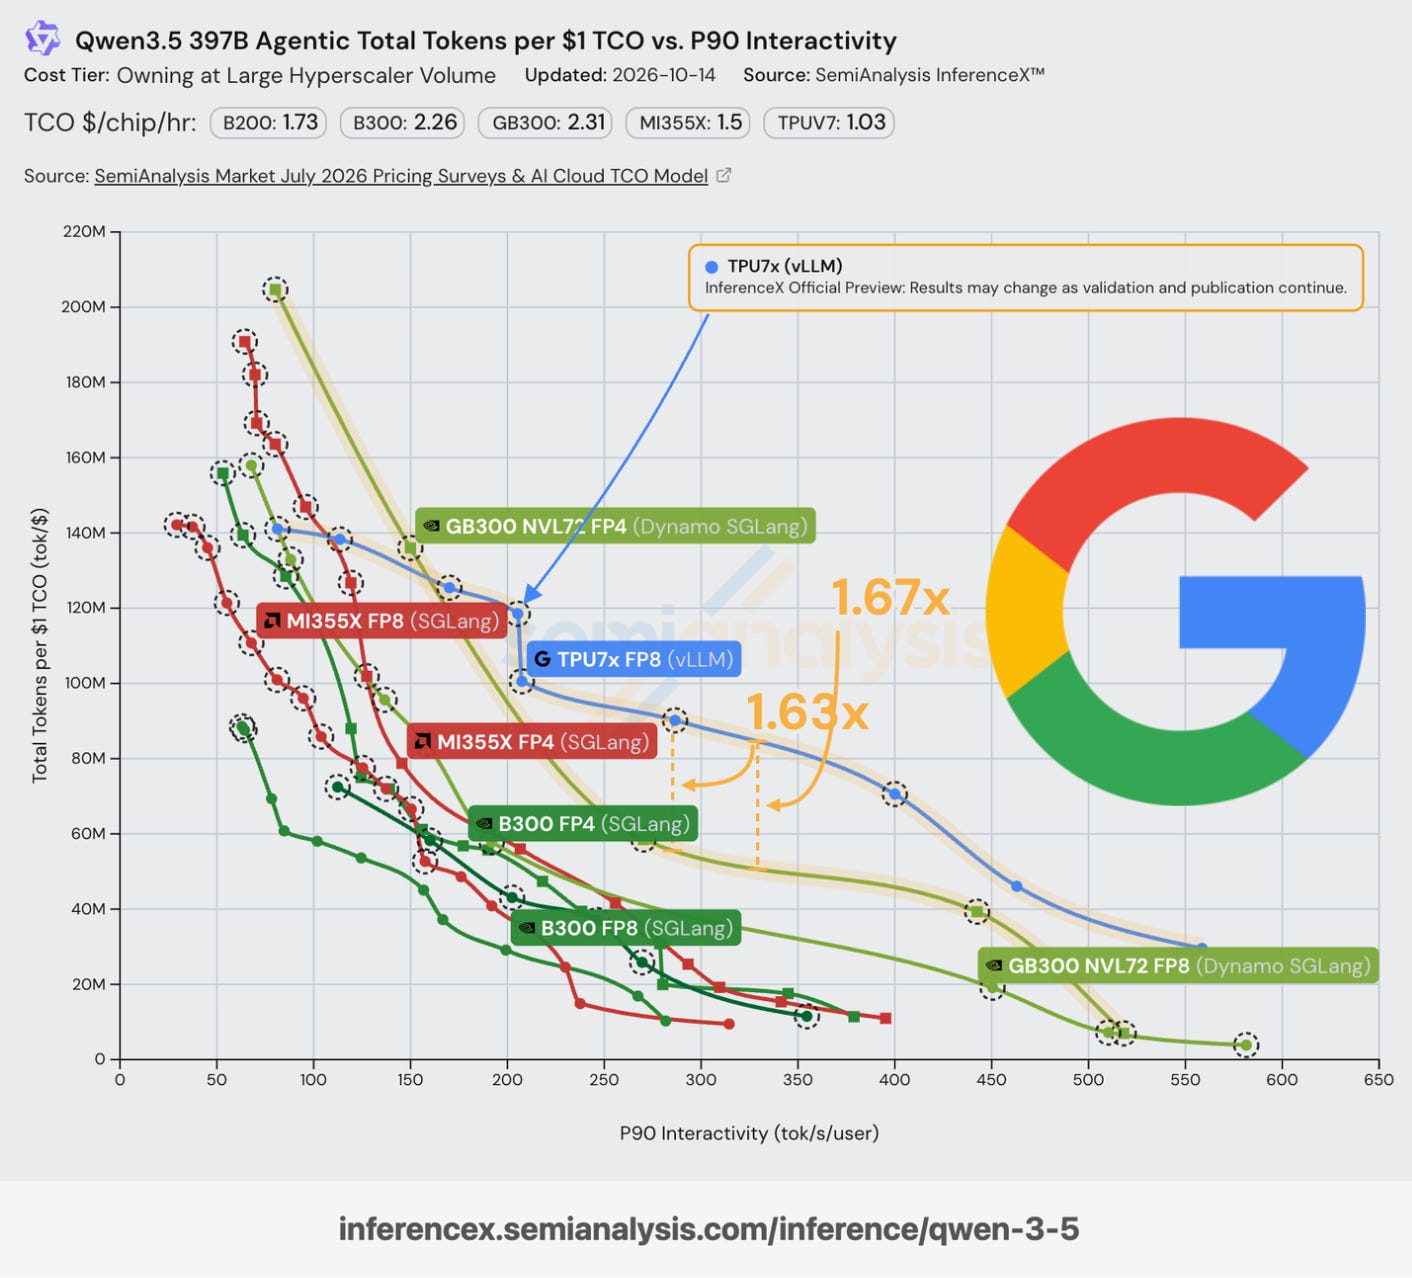
NVIDIA 可能会试图声称自己并不关心 Qwen3.5 397B 模型,但从分析我们的上游 InferenceX 提交分析数据湖来看,现实是:对于某些 NVIDIA GPU SKU,NVIDIA 已将超过 20% 的 sweep GPU 小时花在 Qwen3.5 上,因此 NVIDIA 很难声称自己不关心。此外,如果你看看被分配到 Qwen3.5 的 NVIDIA 工程师,他们是 NVIDIA 在中国大陆和美国的一些顶级 10x 推理性能工程师,所以很明显,NVIDIA 很在意优化这个模型。
此外,某些主要超大规模云厂商/AI 实验室在做出硬件采购和容量规划决策时,会将 Qwen3.5 397B 以及基于 Qwen3.5 397B 架构的万亿参数级扩展版本作为代理模型。因此,对于某些 token 工厂来说,这是一个非常重要的模型。
对于正在做采购决策的读者,我们的 AI Cloud & TCO Model 将分析扩展到集群经济性,包括现金流、投资回报和加速器残值。
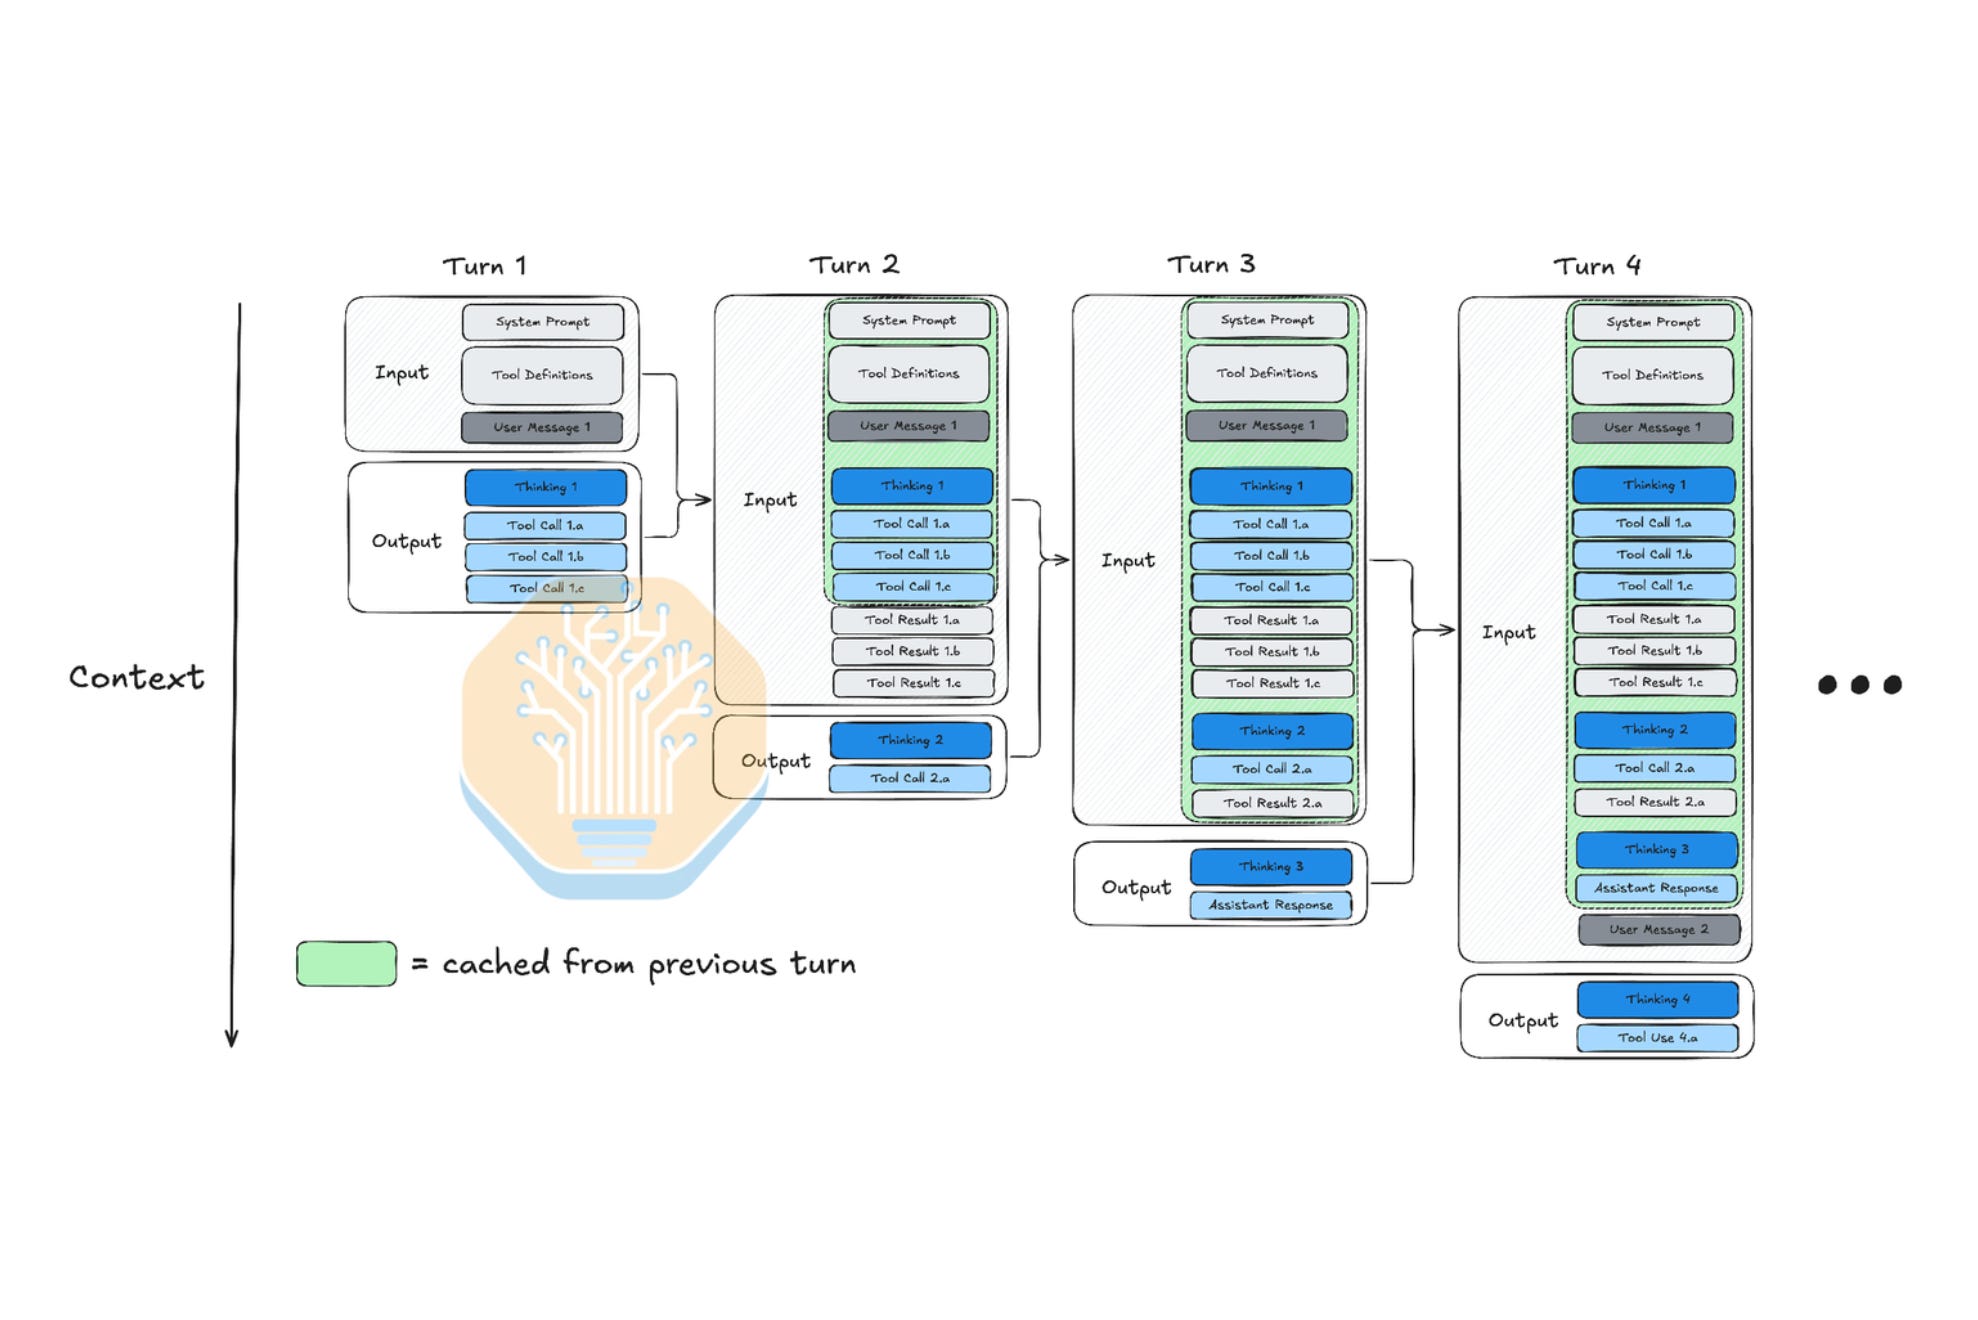
AgentX 捕捉了智能体工作负载的四个要素:
多轮:一个会话包含许多用户/助手交互(数十或数百次),而聊天机器人场景中只有少数几次。
长上下文:系统提示、工具定义以及大量轮次使上下文迅速累积。
高前缀复用:由于对话是线性推进的,第 n-1 轮的输出会拼接到第 n 轮
子智能体突发:一个会话会启动多个短生命周期的子智能体,每个都带有全新上下文,从而产生突发性的 KVCache 模式。
TPU 能够证明其即将推出的 TorchTPU vLLM 栈可以成功处理智能体工作负载。
NVIDIA 首次反击提交
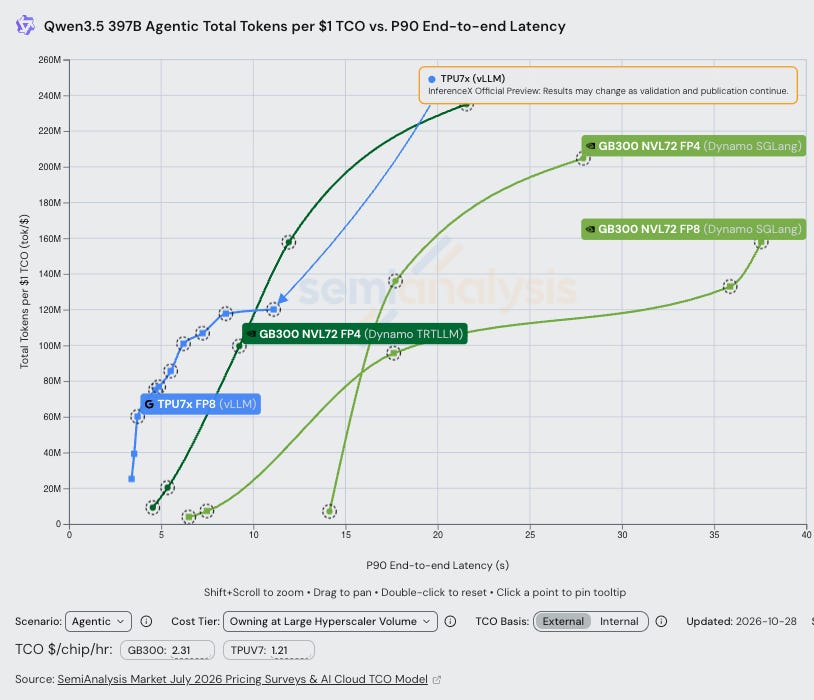
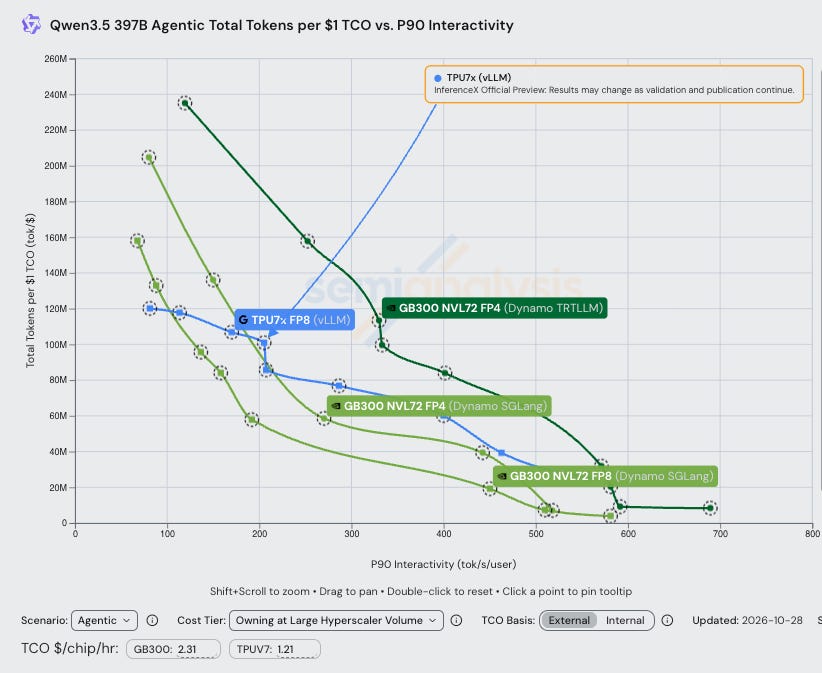
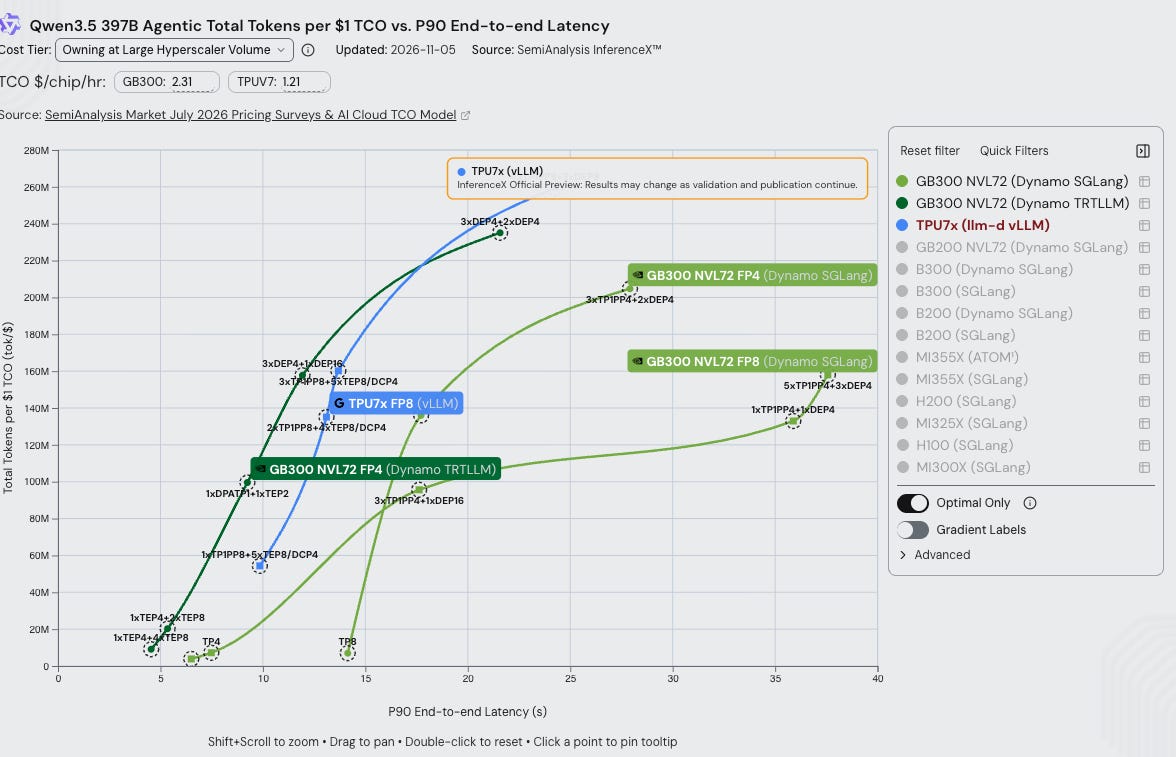
NVIDIA 工程师加班加点推出了他们的反击提交 FP4,其在解码性能上击败了 TPUv7 FP8,但有一个小问题:他们过度调优了解码,牺牲了预填充,损害了整体端到端性能。因此,在端到端性能上,TPU 的 FP8 目前仍然击败 GB300 NVL72 FP4。
开源 Kubernetes llm-d 使 TPUv7 在解码交互性上远超 GB300 FP8
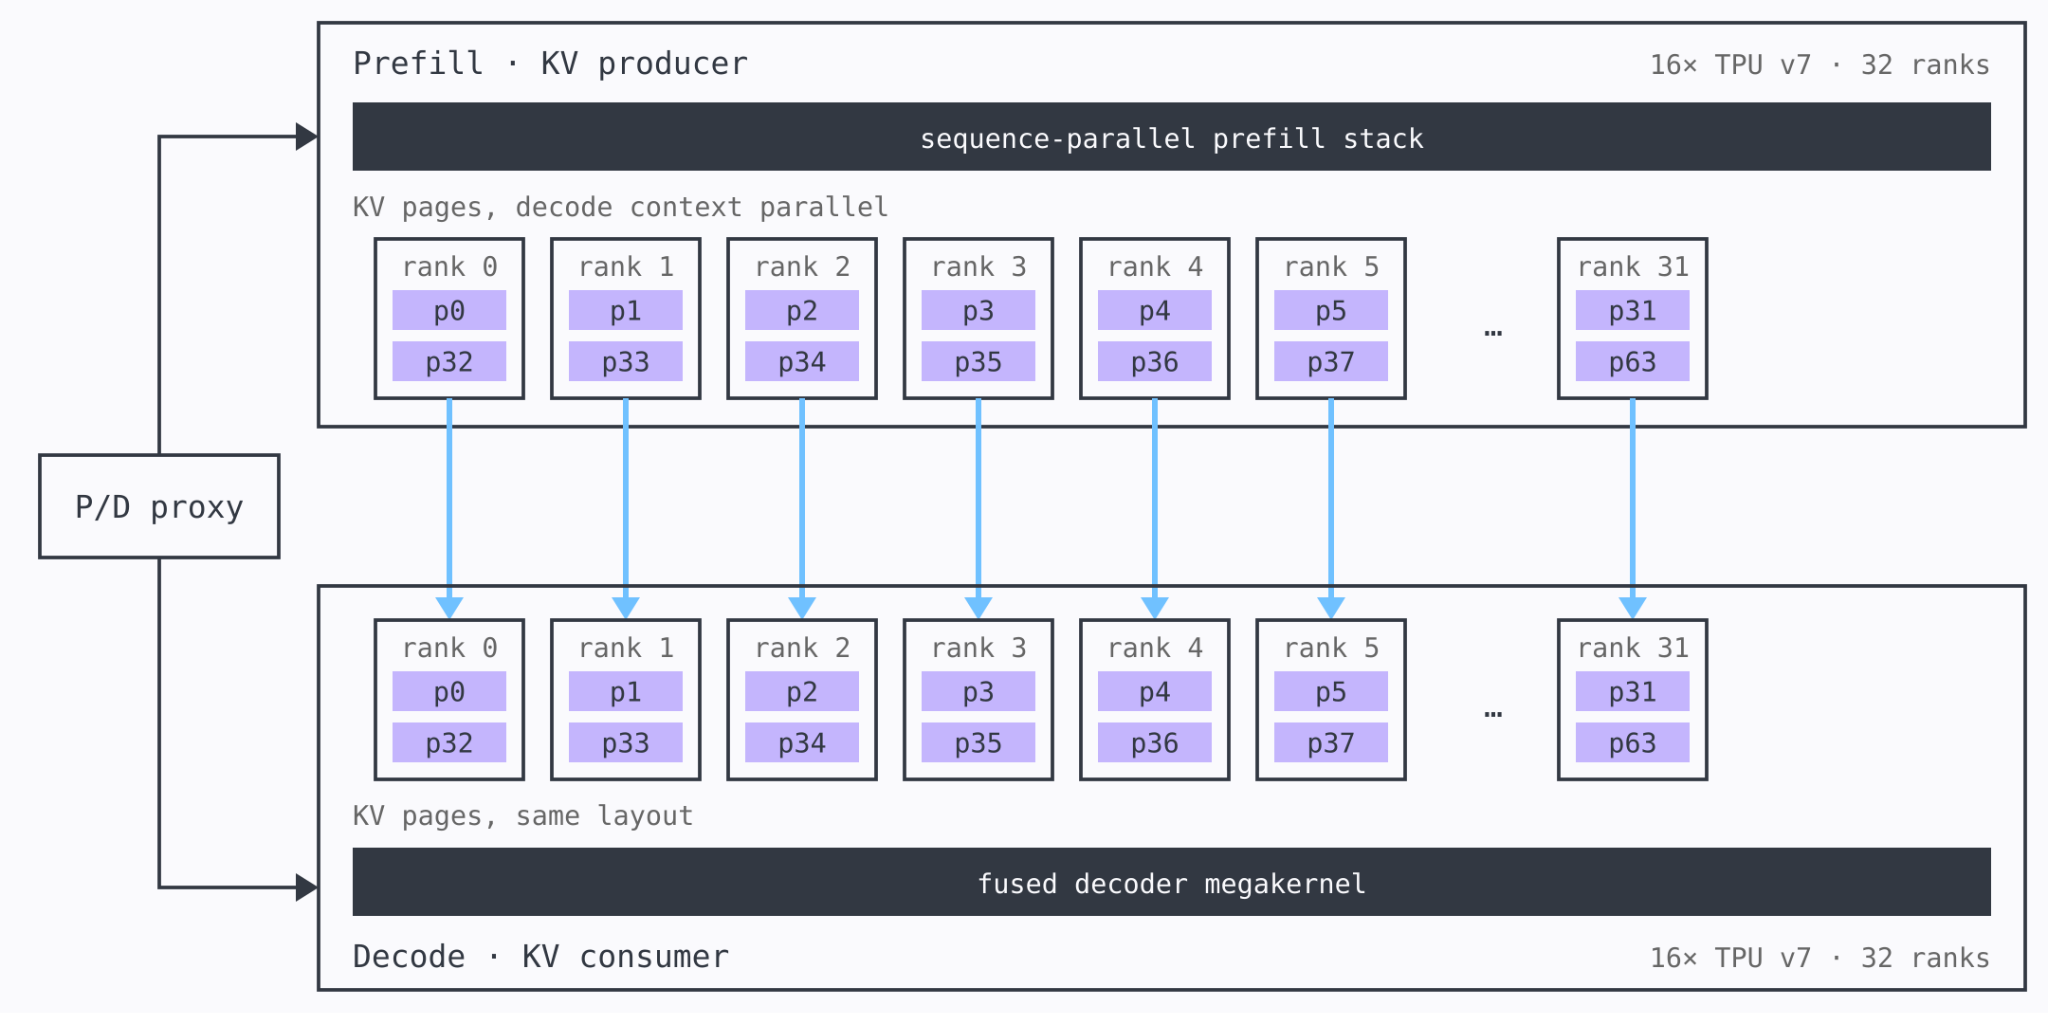
分离式服务将预填充和解码运行在独立主机上,因此长预填充不会阻塞生成。llm-d 是协调它们的开源 K8s 路由器,每台主机有 4 个 TPUv7 芯片,每个结果使用 24-32 个芯片。
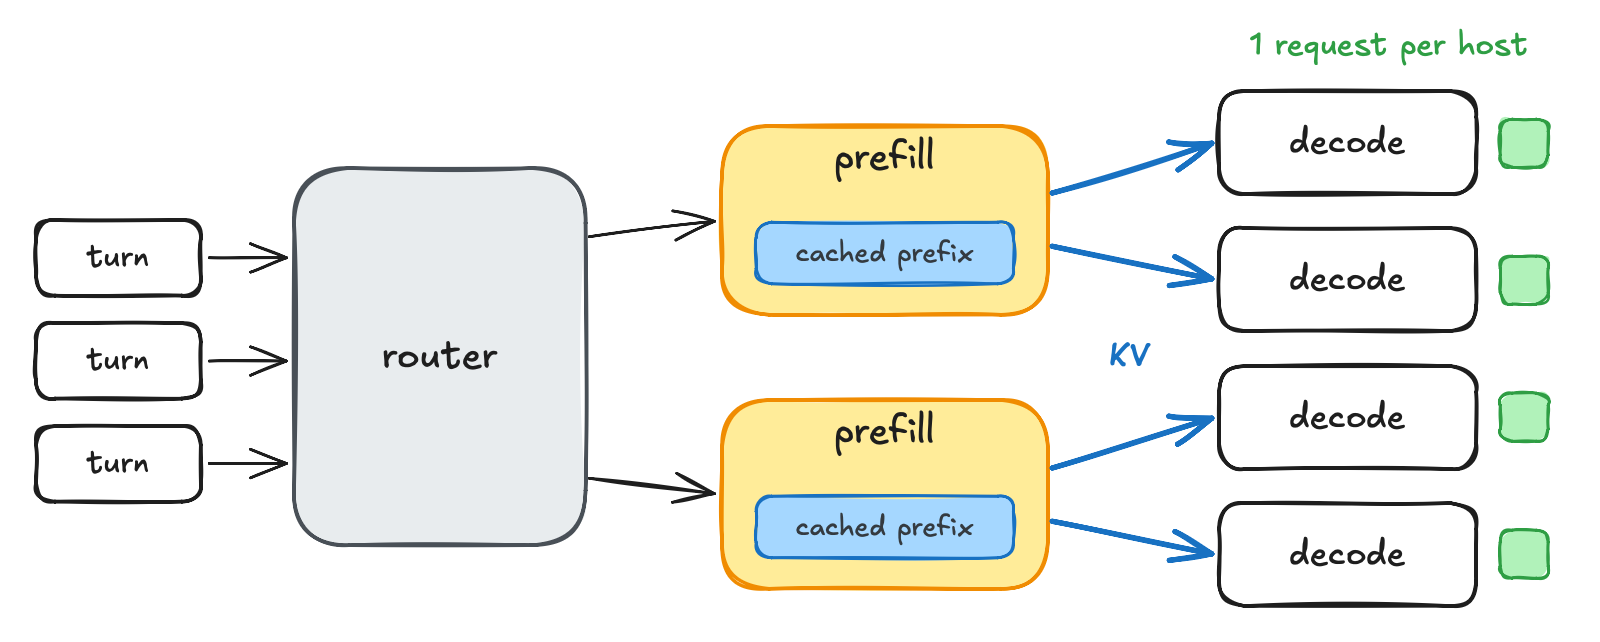
速度来自于限制每台解码主机运行的请求数量,从低延迟端的一次一个,到高吞吐端的 112 个。超过上限的请求会等待空闲主机,这增加了它们的 TTFT。即便如此,最快点位的 p90 首 token 时间为 8.6 秒,而 GB300 FP4 最快点位为 11.1 秒。
这使用了 llm-d,它是最大的基于生态系统的生产推理 Kubernetes 编排器之一。在最近的 Kimi K3.1 Pro 发布期间,他们在 llm-d 上实现了对 TPUv7 的 Day 0 支持。
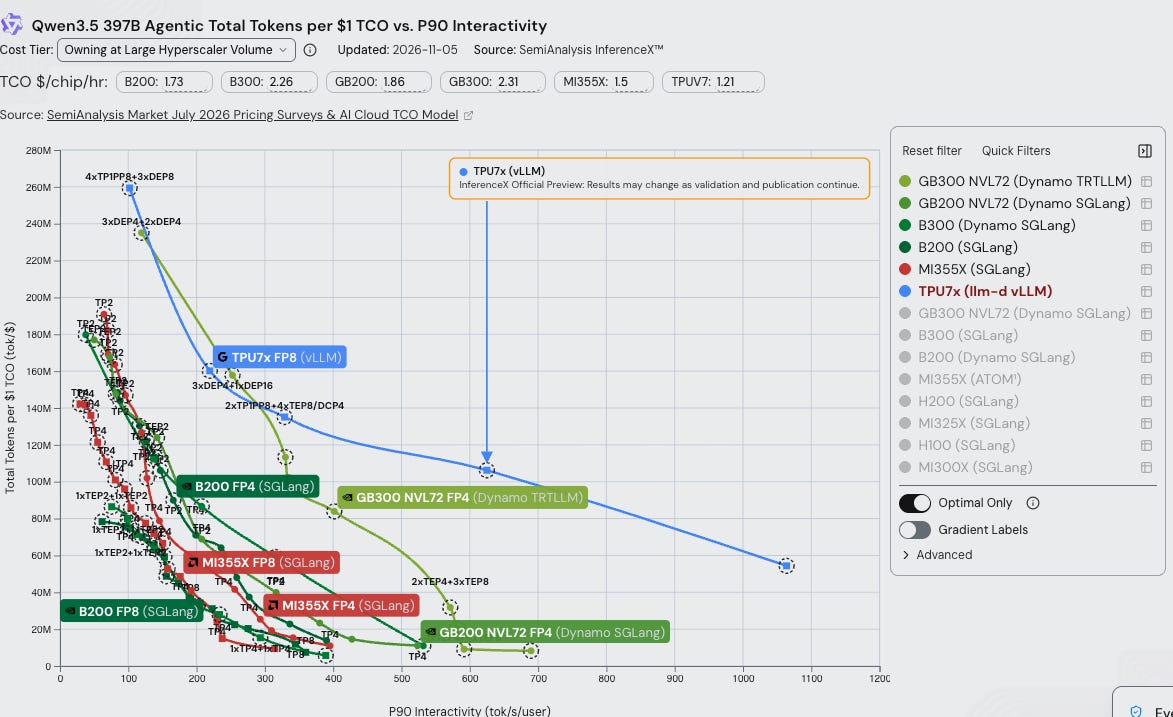
在 FP8 下,搭配 llm-d 的 TPUv7 在每个交互性水平上都击败 GB300,从高吞吐下的 >2 倍,到超快区域实现超过 1000tok/s/user。
不幸的是,与 GB300 TRTLLM FP4 相比,使用这种基于轮次的路由算法确实会导致 TPU 的端到端性能更差。然而,与 FP8 和 FP4 GB300 NVL72 SGLang 相比,它仍然好得多。
Qwen3.5 TPU 优化
Qwen3.5-397B 将 45 个线性注意力层(每个请求保持固定大小的状态)与 15 个全注意力层混合在一起。Google 描述了三个主要变化:
解码大内核。 一个内核运行整个解码步骤,并在当前层计算时预取下一层的权重。
主机 DRAM 卸载。 KV 缓存和线性注意力状态通过 TPU Sync(Google 新开源的卸载框架)溢出到主机 DRAM。
缓存感知路由。 llm-d 将每一轮发送到持有其前缀的预填充主机,并将每个会话保留在其解码主机上,除非该主机已满。Google 表示,路由到精确的数据并行 rank 将解码缓存命中率从 56% 提高到 76%。
Kimi K3 AgentX
来自 Inferact 的 TPU 和 AMD 率先在开源引擎中为前沿 MoE 模型提供了大内核。 NVIDIA 在一周内迅速跟进,推出了自己的大内核。
传统的解码步骤会启动数百到数千个内核,芯片在它们之间空闲。大内核在一个长时间运行的内核中运行多个层,在当前权重计算时预取下一批权重。AMD 将其版本称为 MonoKernel。在八块 MI350X GPU 上运行 GLM-5.2 时,AMD 报告称其将解码步骤从约 2,459 次启动减少到 210 次,并在批大小为 1 时运行速度提升 2.31 倍。
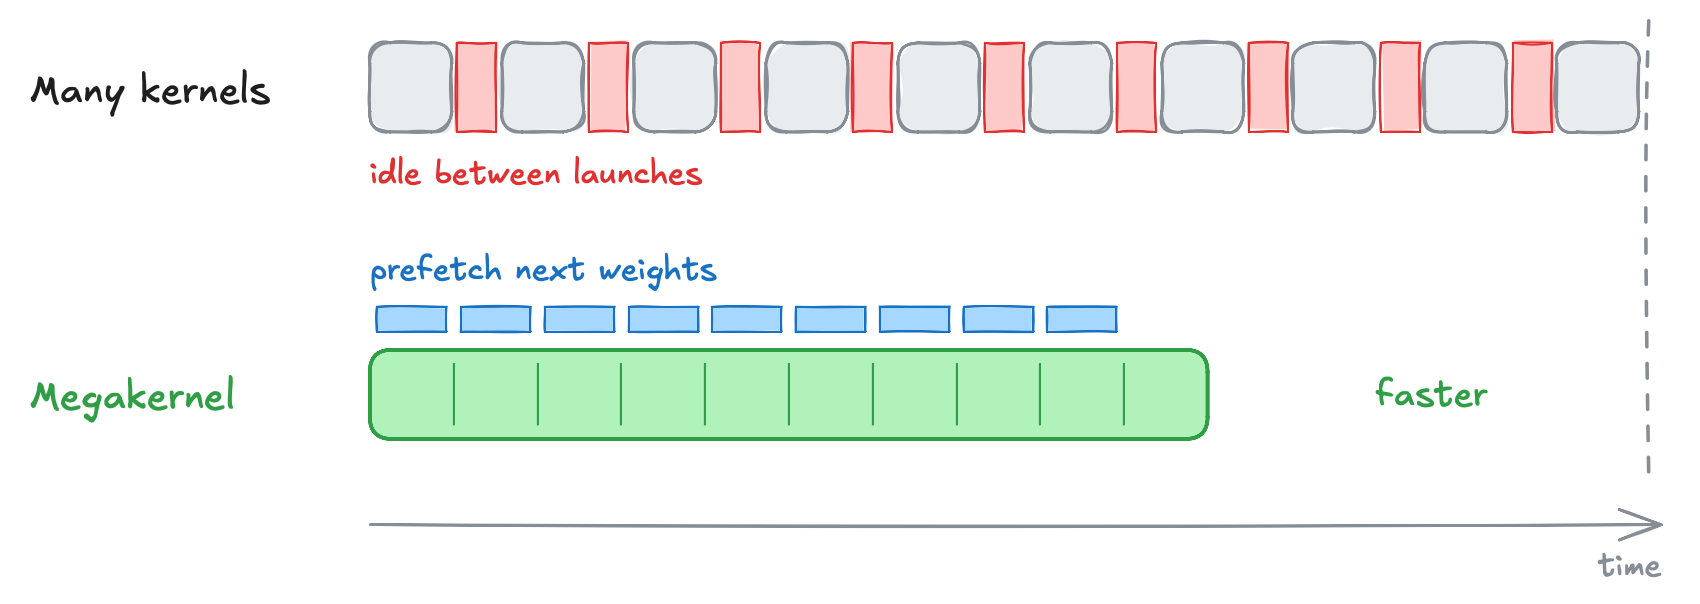
大内核消除了内核启动之间的空闲间隙。在我们的 TileRT 文章中阅读更多关于大内核的内容:
对于此设置,DCP 用于预填充。上下文并行的预填充和解码变体描述的是每种技术通常在何处有帮助,而不是它可以在何处运行。K3 使用 MLA,它将 KV 存储为跨头共享的一个潜在表示,因此 TP 无法拆分它,每个 TP rank 都持有完整副本。DCP 通过给每个 TP rank 分配不同的 token 切片来解决这个问题。预填充上下文并行需要更低的 TP 度,这会将权重复制到更多芯片上,并为 KV 缓存留下更少的 HBM,而 KV 缓存已经是这里的稀缺资源。
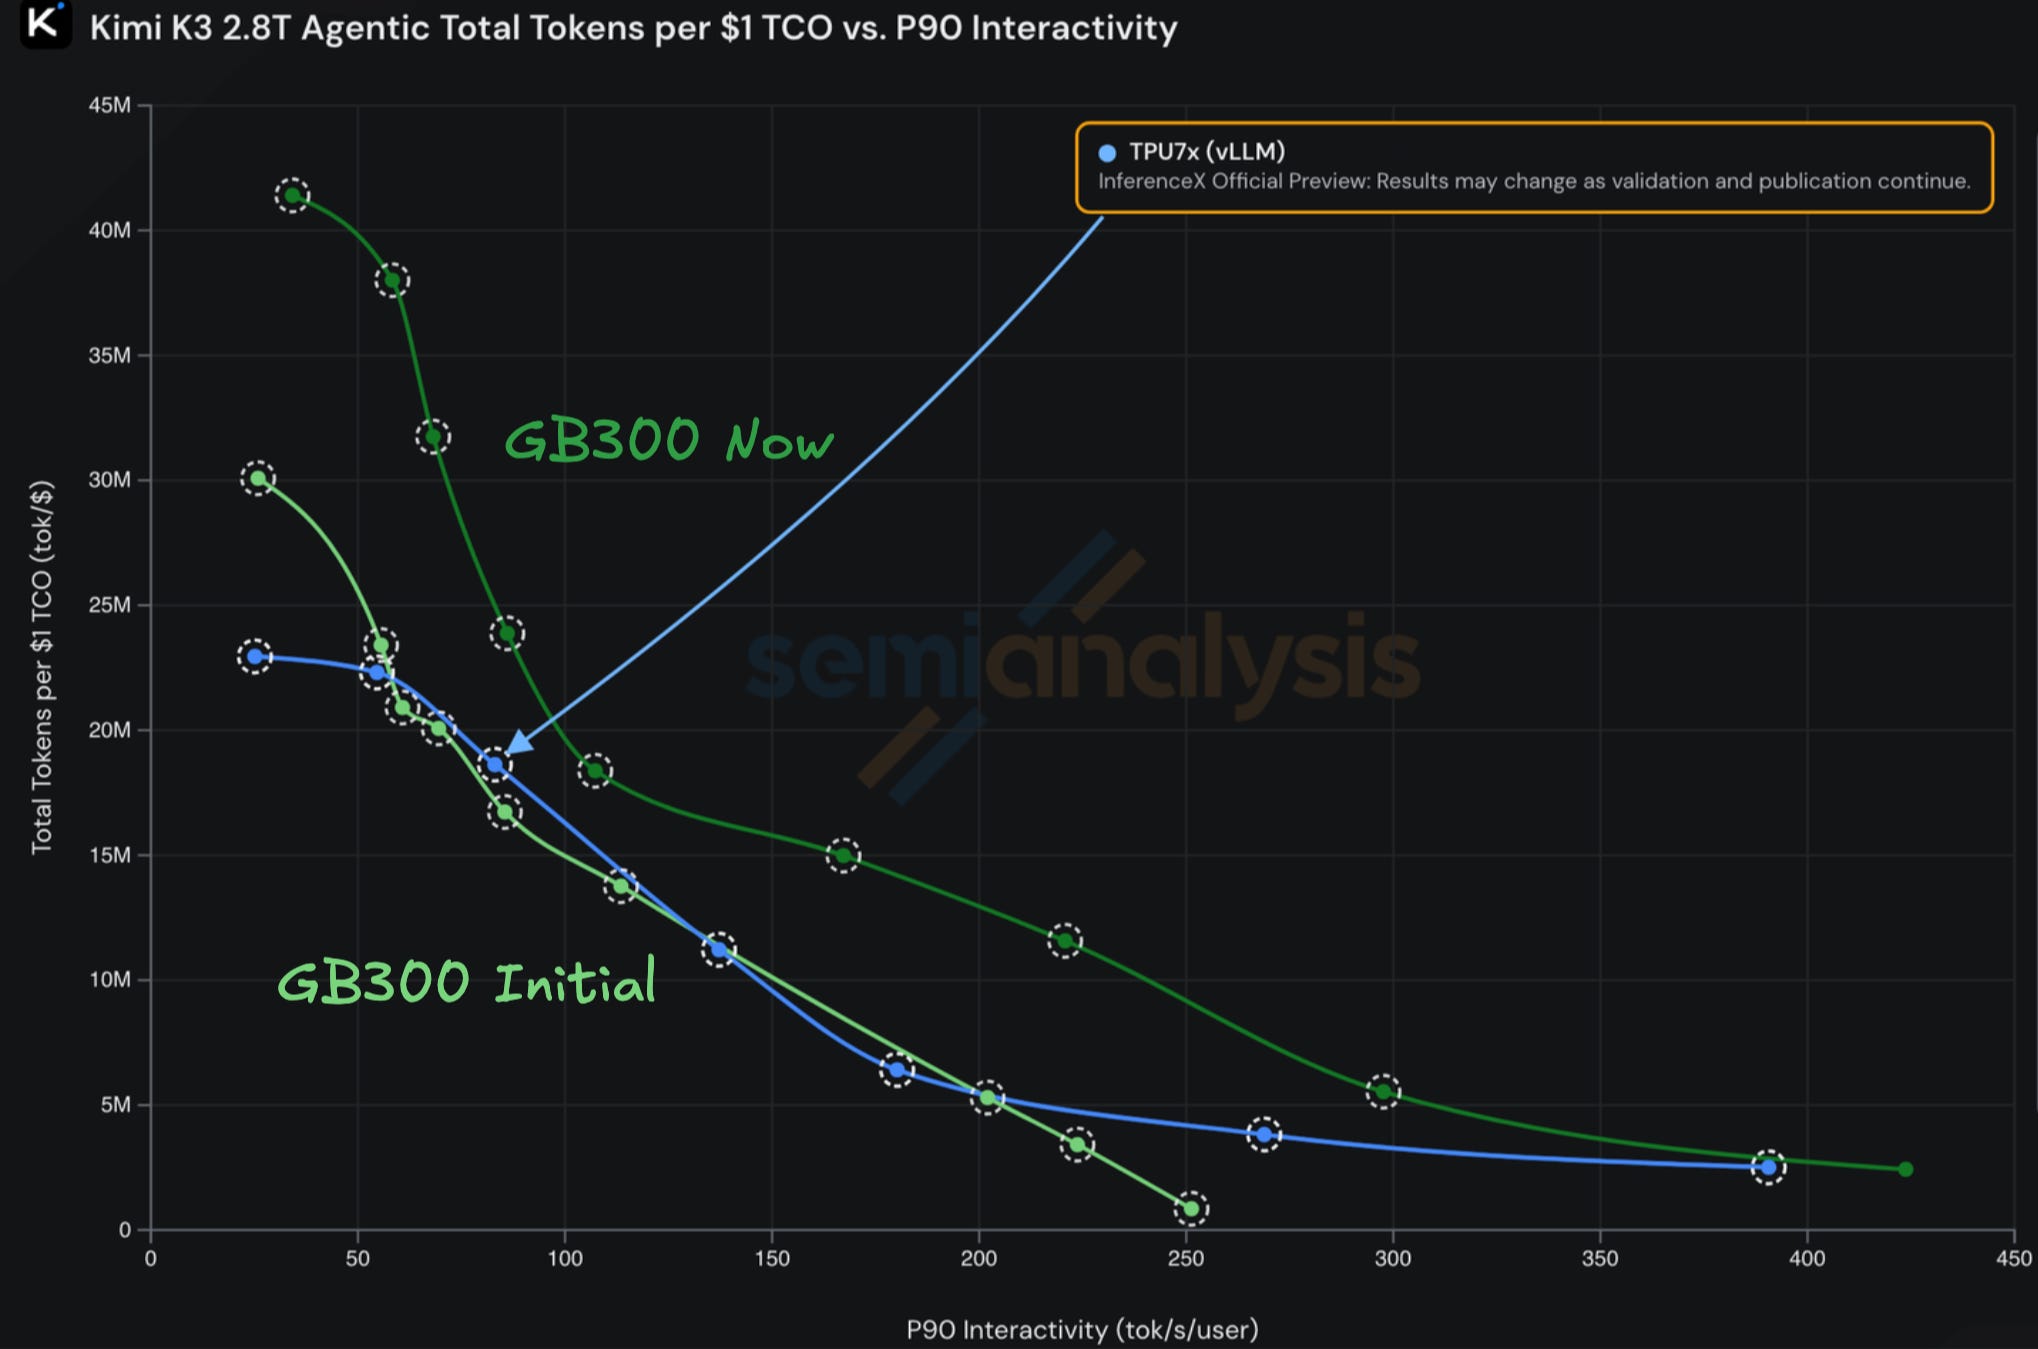
发布时与 GB300 FP4 相比具有竞争力
在 10 月 17 日发布时,TPUv7 在 50 到 200 tok/s/用户范围内提供了 GB300 每美元 token 数的 0.77 倍到 0.91 倍,并且对单个用户快 1.6 倍,为 391 tok/s/用户,而 GB300 为 251。按照 Google 的内部成本,它在 100 和 200 tok/s/用户时击败了 GB300。
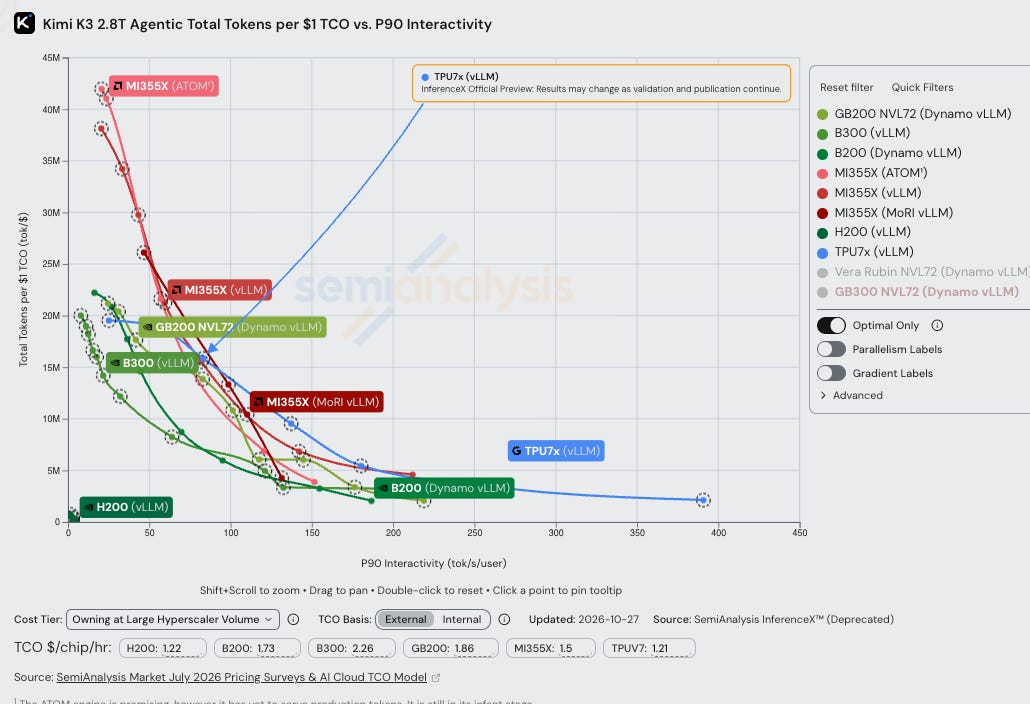
经过 NVIDIA 的四次刷新,GB300 FP4 现在领先 1.5 倍到 2.6 倍。TPUv7 仍然提供 GB200、B200 和 B300 每美元 token 数的 1.15 倍到 2.5 倍的竞争力,而 VR200 提供 TPUv7 的 4.3 倍到 5.6 倍。
在 TPUv7 与 Rubin NVL72 的苹果对香蕉比较中,Rubin 的每美元性能最高可好 6 倍。但请注意,这是一个不公平的比较,因为 Rubin 应该与 TPUv8i 进行比较,我们很快就会对其进行基准测试。
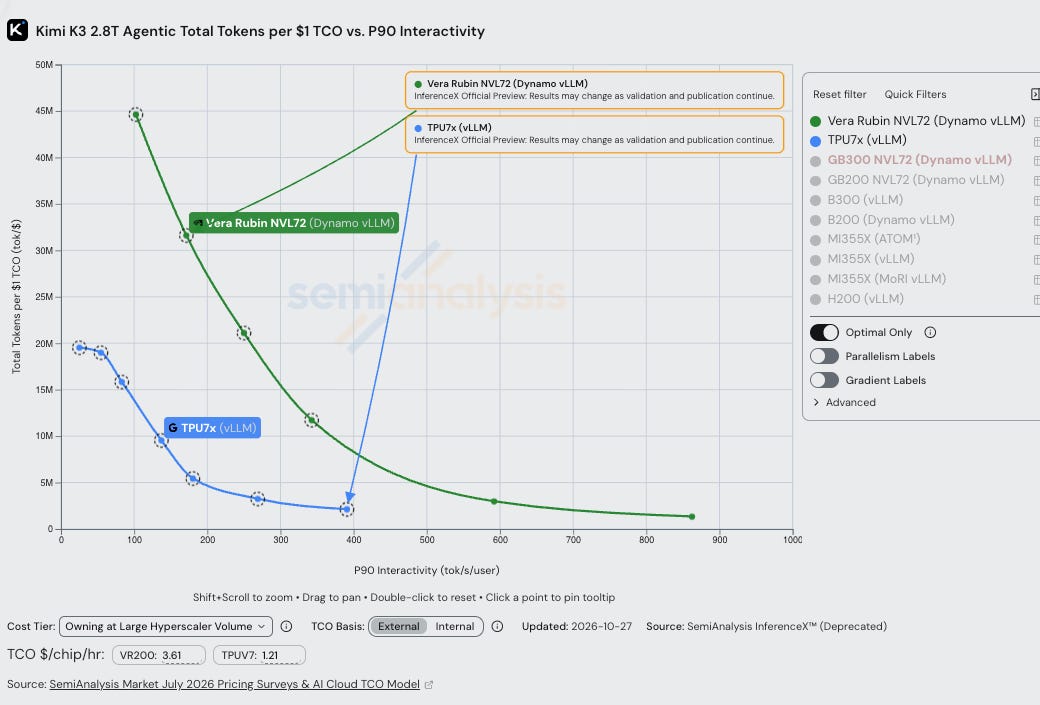
需要注意的是,Rubin 的结果仍然是预览提交。我们期待 NVIDIA 提供直接的 Rubin 访问权限,以便我们能够独立复现这些结果并运行完整的 InferenceX/AgentX 套件。
由生态系统构建
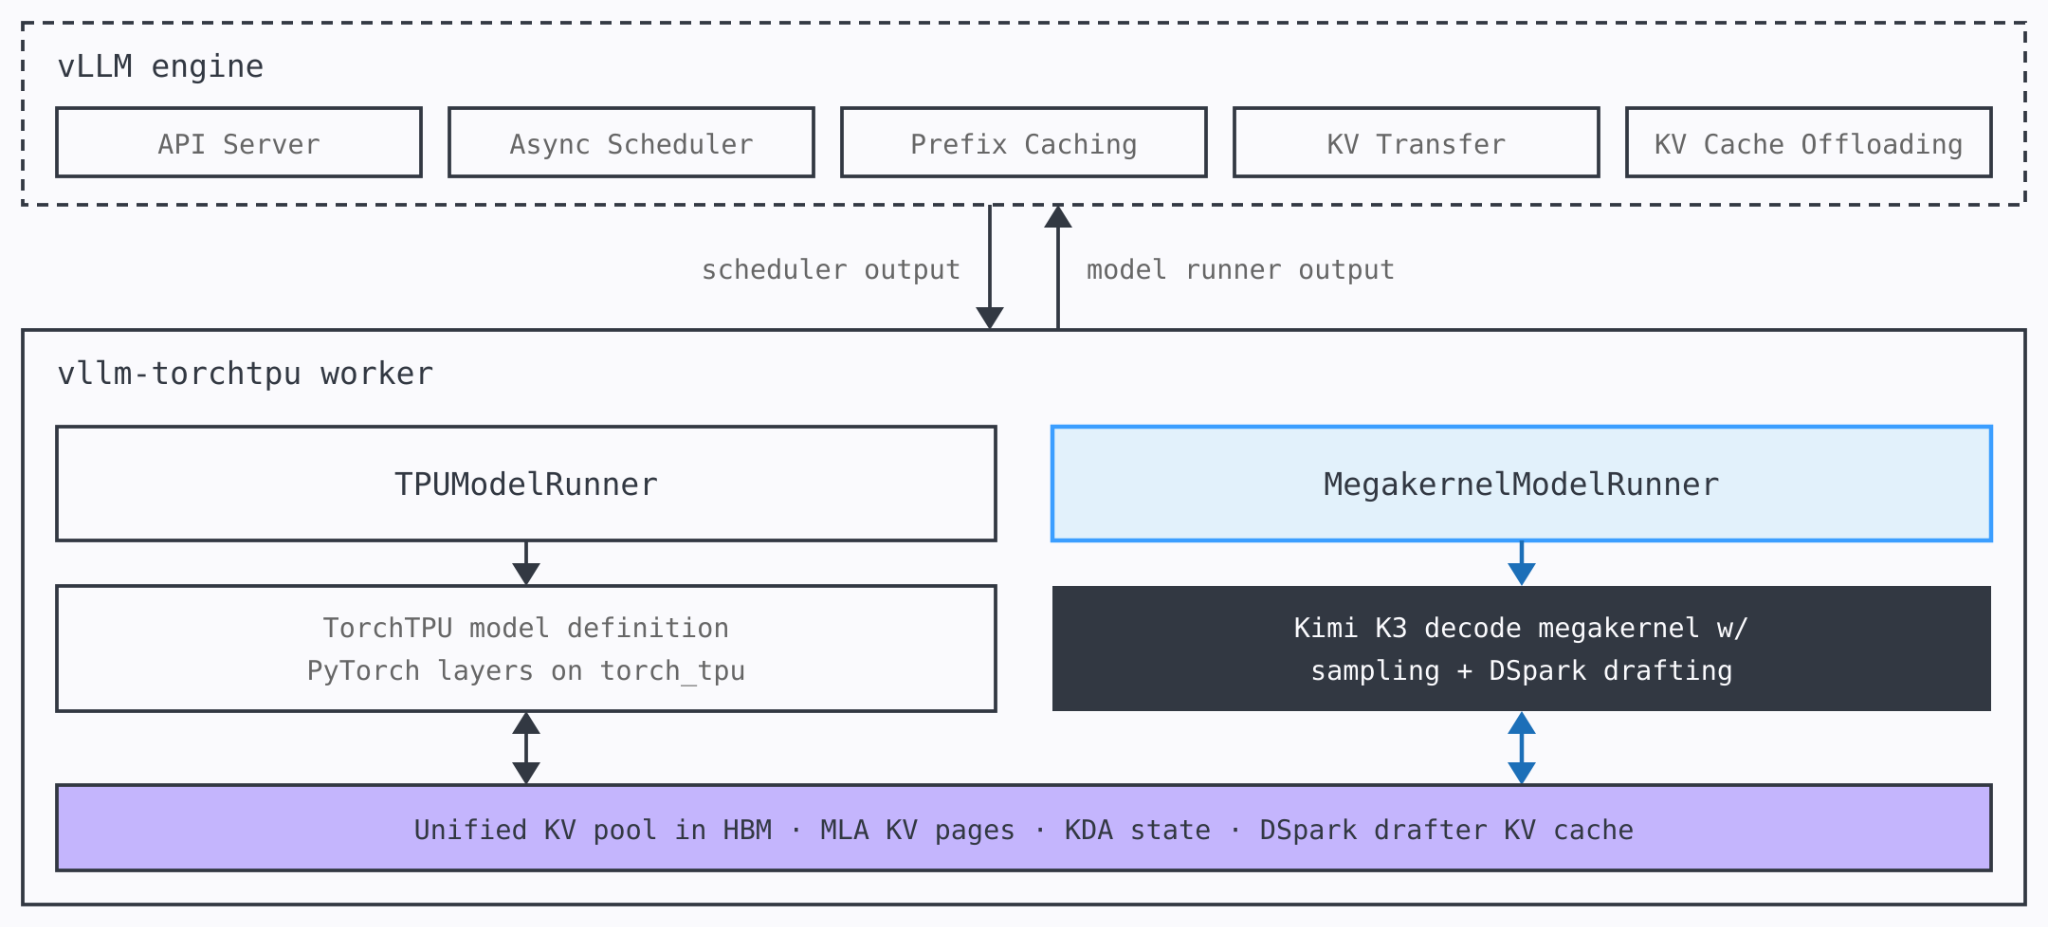
这一结果来自 vLLM 生态,而非仅来自 Google。由 vLLM 的创建者和维护者创立的 Inferact 与 Google 共同构建了 K3 megakernel,双方共同提交了这一结果。该 megakernel 作为模型运行器接入 vLLM,仅替换前向计算,因此 vLLM 的调度、前缀缓存和 KV 传输保持不变。该技术栈在 vLLM TorchTPU 上开源,Inferact 的复现指南可通过 Docker 镜像运行。此类生态开发此前大多发生在 CUDA 上。
来源:SemiAnalysis 长文 RSS · newsletter.semianalysis.com
来源:RadarAI · aihot.news