用 Qwen2.5-Code-7B 后训练一个 Dwitter 代码补全模型
I post trained a model on Demoscenes
作者以 Qwen2.5-Code-7B 为基座,在 25k 条 Dwitter 140 字符 JavaScript demo 上做继续预训练,30 条留出样本的困惑度从 28.63 降到 8.57。随后按 Dwitter 的“awesomeness”评分构建课程学习,400 步内将前 1000 名样本的采样概率从 20% 提升到约 67%,用于生成未完成 Dweet 的合理续写。
关于演示的语法与未完成代码的可能性
2026年10月31日
最近,我对demoscene和sizecoding的世界着迷不已,最终我偶然发现了HellMood那令人惊叹的MS DOS演示作品“Memories”。在阅读他的技术文章时,我对作者如何得出其中某些视觉效果产生了兴趣。我自己一直难以创造出任何类似的效果,所以希望能从中汲取一点灵感。
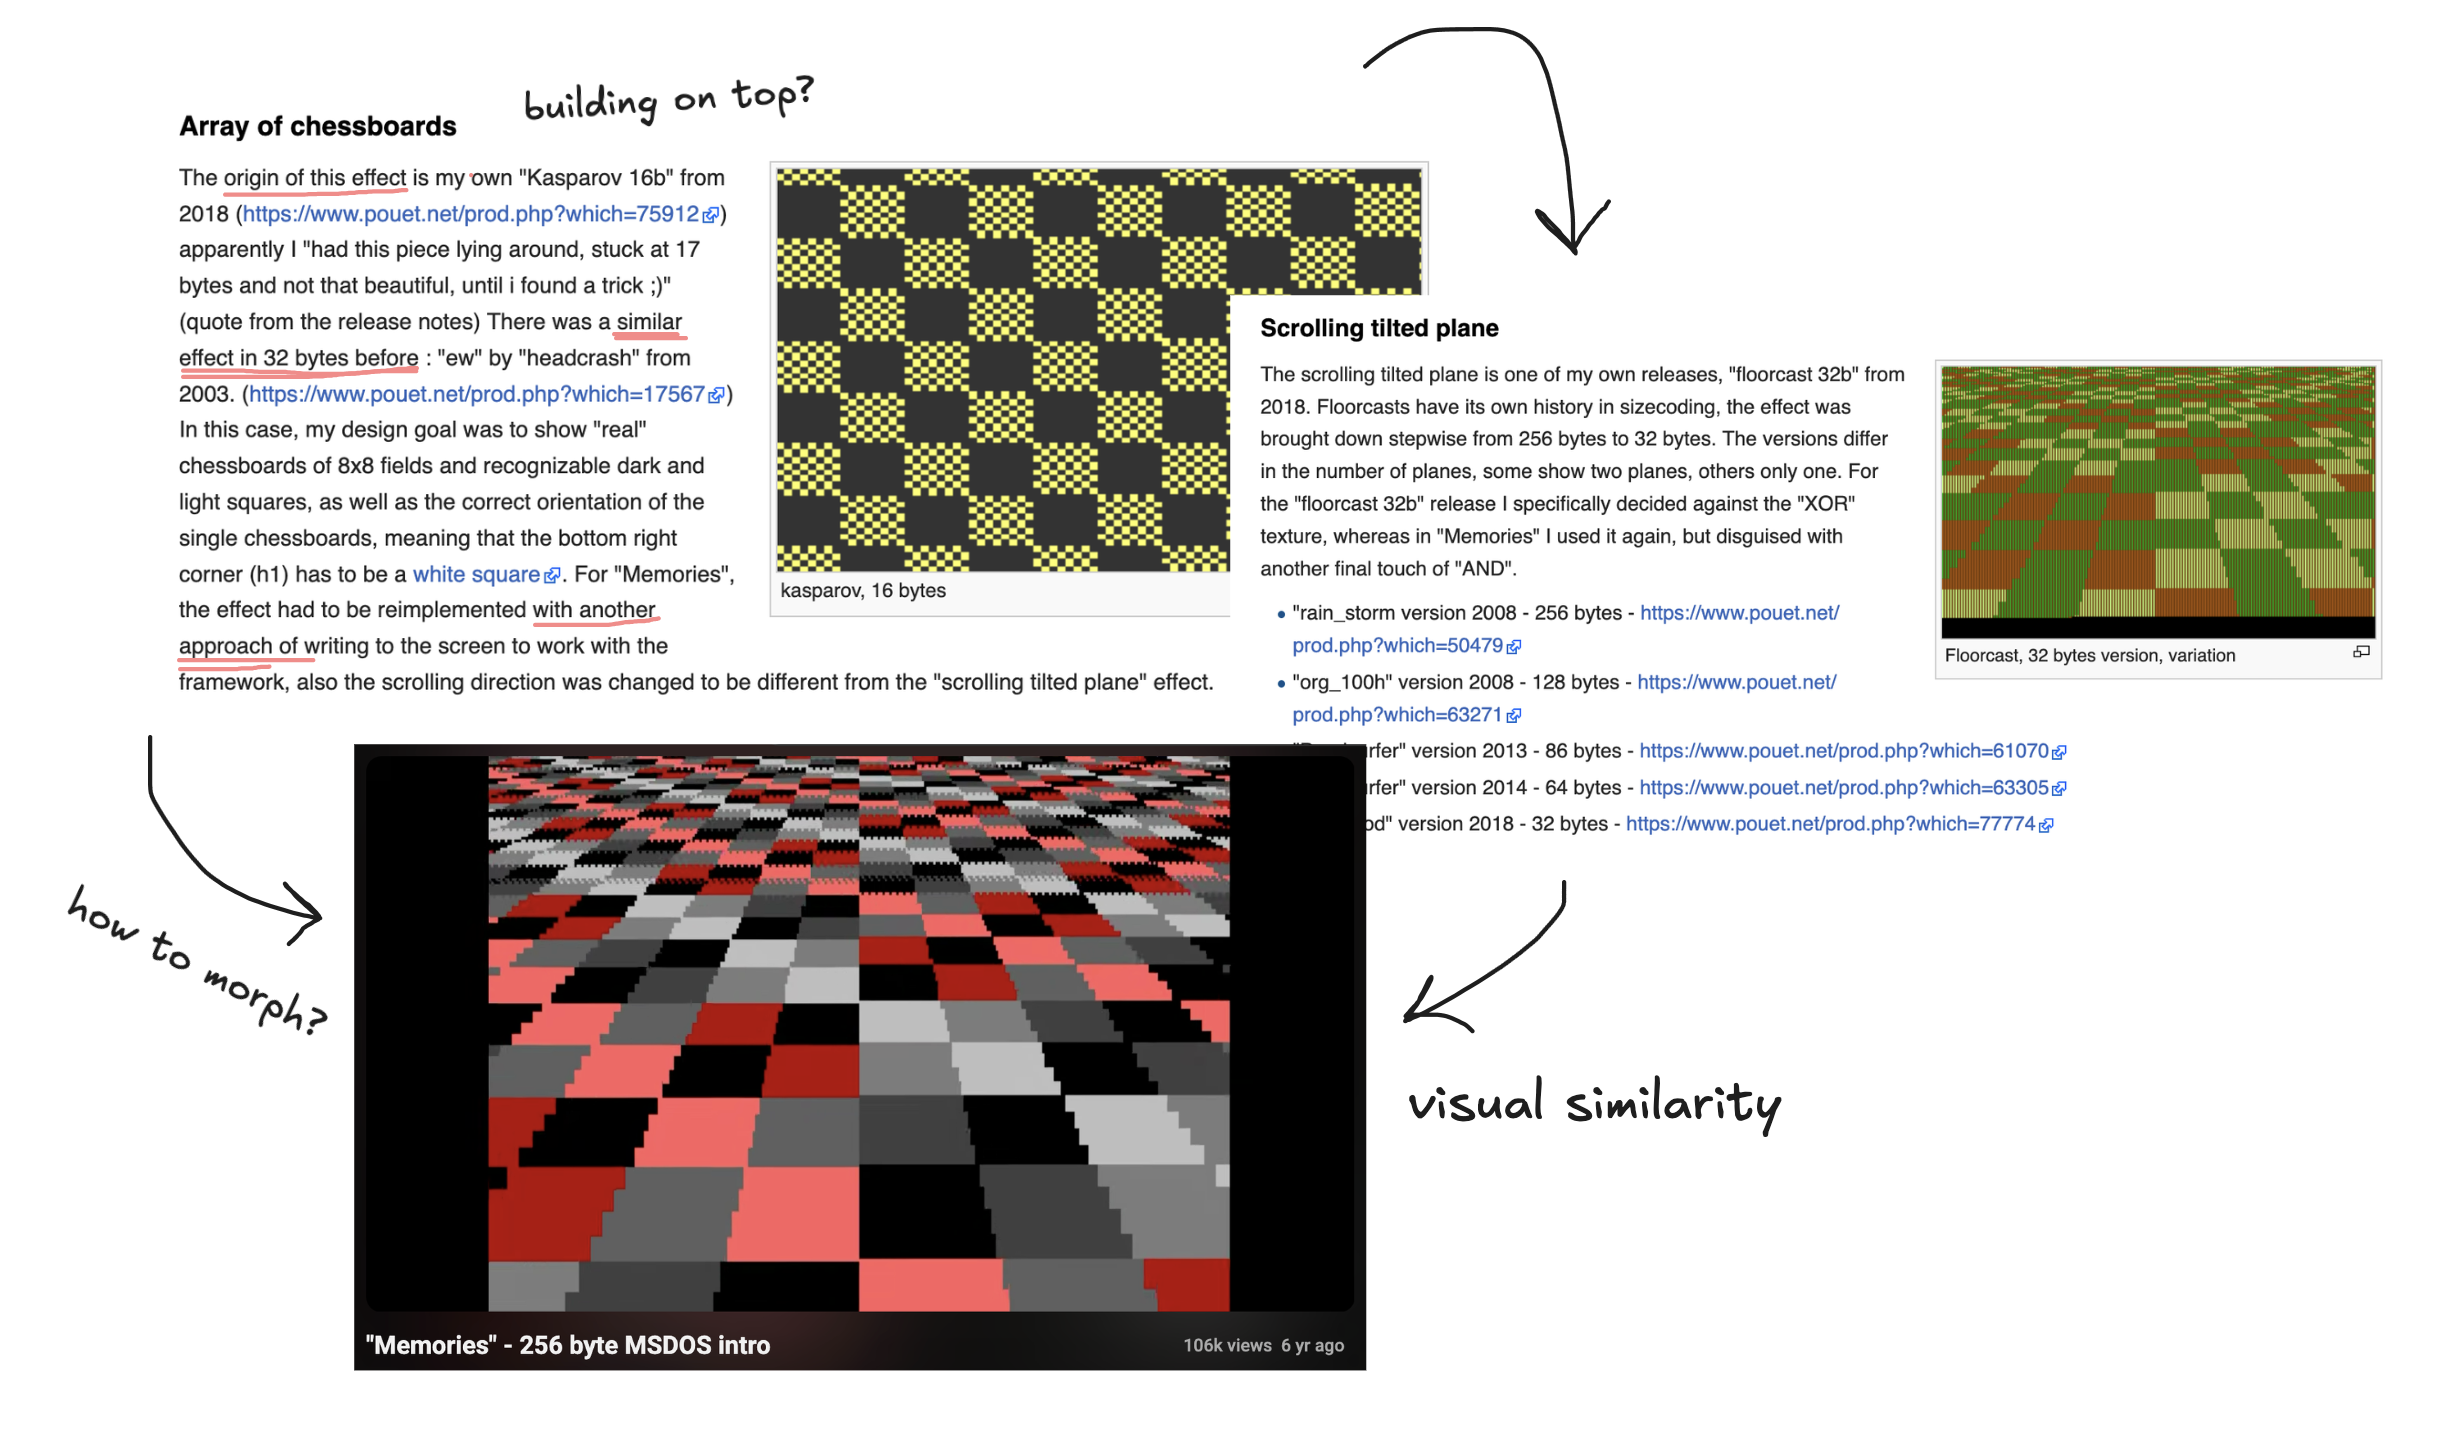
我注意到这些效果可以追溯到更早的实验,那些实验由替代实现方案和若干借鉴自先前演示作品的想法组成。我开始好奇,同样的底层想法还可能走向多少其他方向。我决定从几个现有的演示作品入手,选最简单的那些,逐字符地修改它们,观察这些改动会如何影响视觉感受。
我偶然发现了Dwitter.net,它就像Twitter,但专门用于140字符的JavaScript演示。它们已经支持对任意dweet进行“remix”,这样我们就能在它们的基础上继续构建。巧合的是,该网站上最受欢迎的Dweet与Memories中的视差棋盘格效果相同!
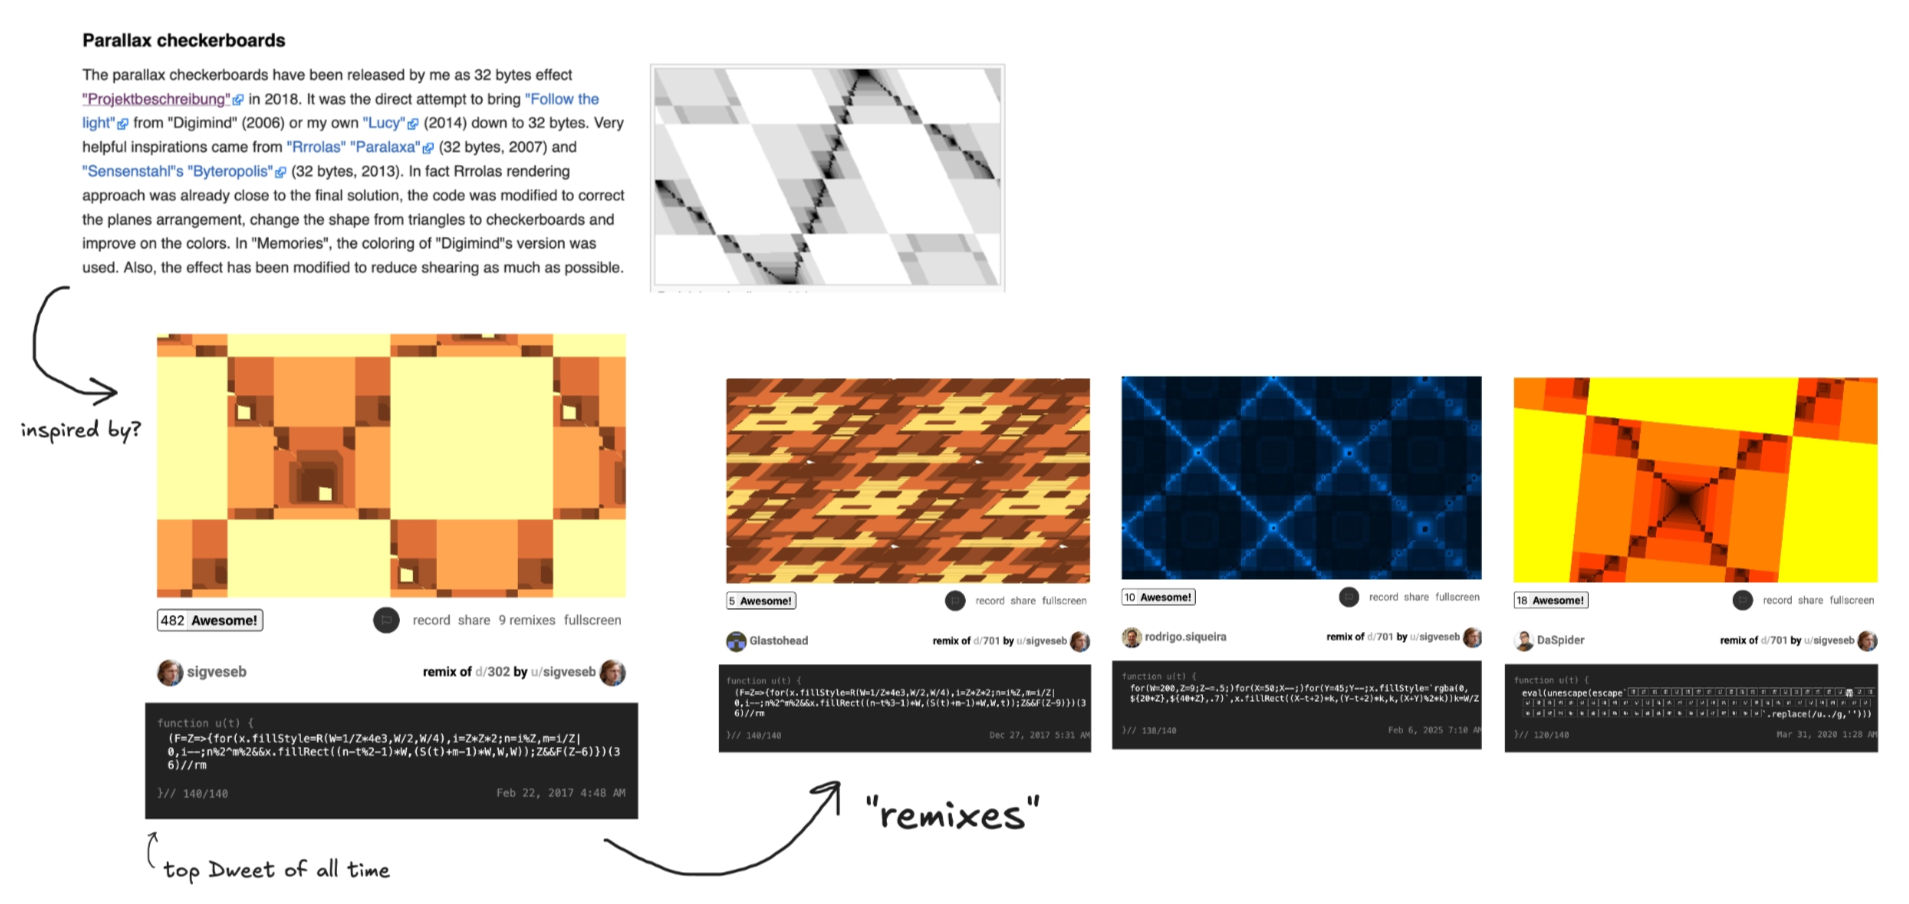
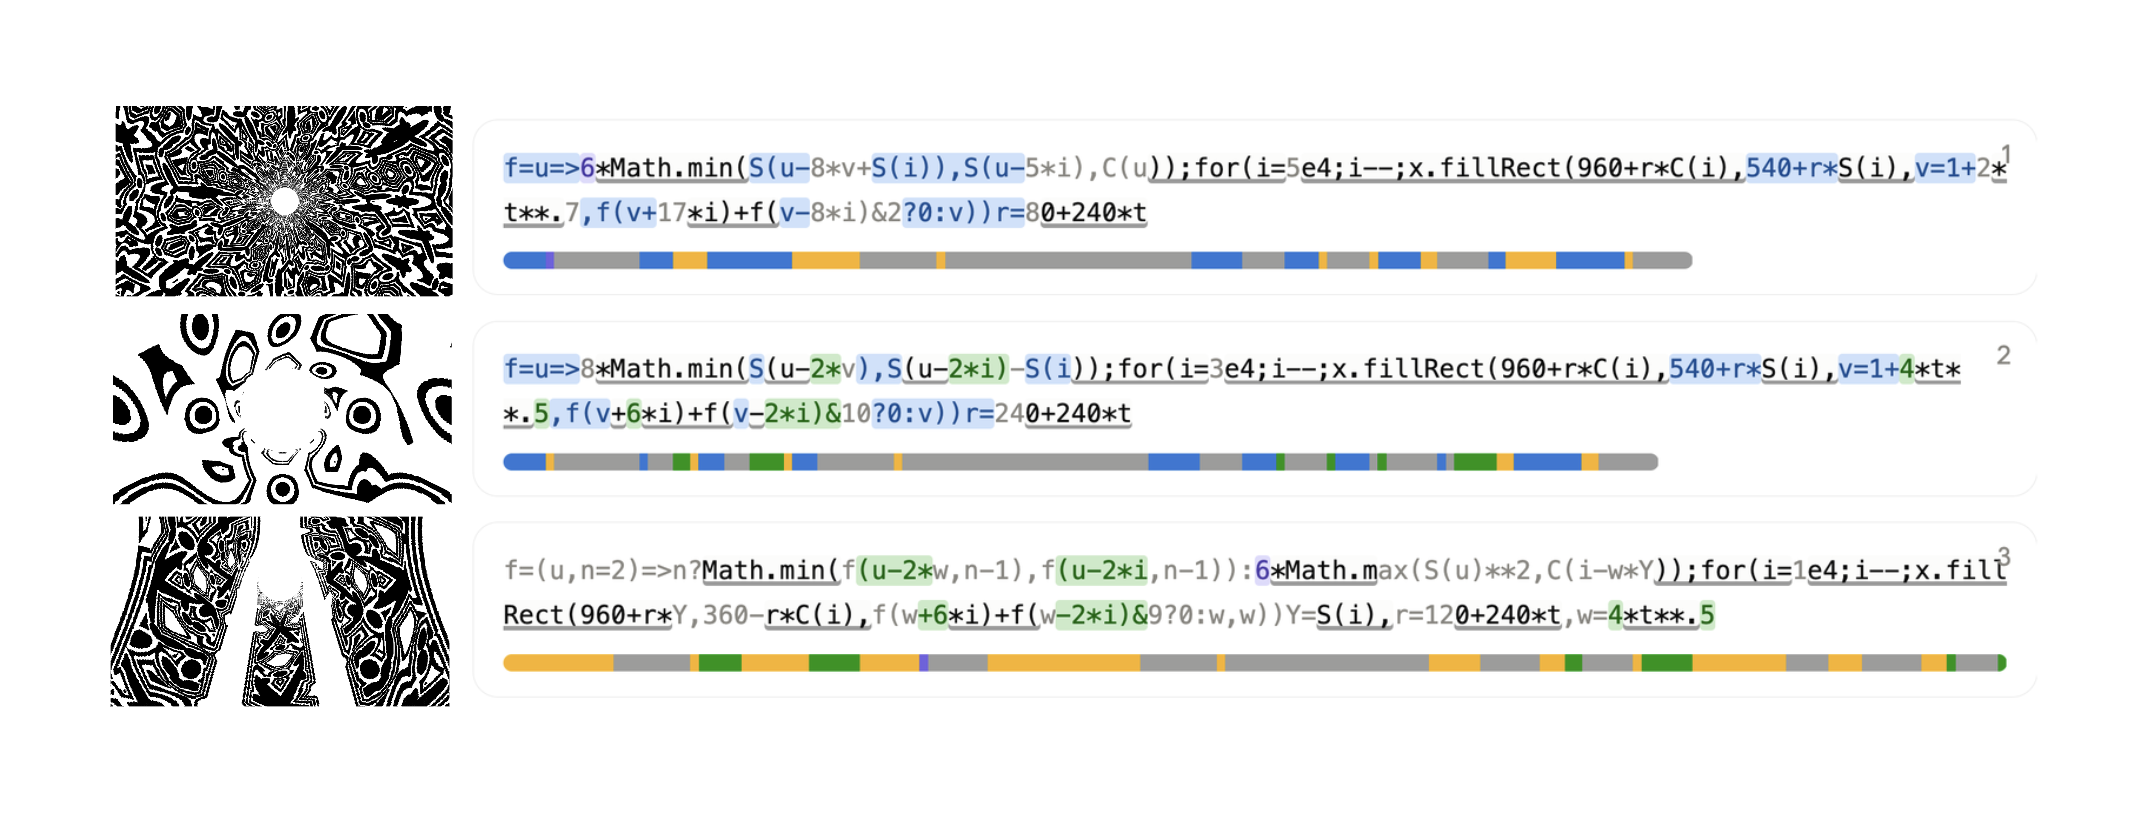
再深入挖掘一下,我注意到一些remix共享了相当大一部分源代码,仅相差几个字符,而另一些则通过完全不同的实现达到了相似的视觉效果。
这里有一个例子,我追溯了d/36555,它来自d/36547,而后者又源自d/36467。灰色下划线的子串显示了它们共有的部分。蓝色显示了前两者之间共有的部分,绿色则显示接下来两者之间共有的部分。
在语言学中,语言具有能产性,即有限的词汇和有限的语法规则允许产生数量庞大的不同表达。编程语言也具备这一特性。现在让我们考虑前面提到的那些Dweet。它们包含重叠的子串,但渲染结果却不同。假设你取一个140字符的程序,去掉它最后30个字符。即使假设字母表只有64个字符,可以形成的可能补全字符串也接近1.5 x 10^54个。几乎所有这些字符串在语法上都是无效的,或者产生无趣的结果。尽管如此,可能性的数量仍是天文数字。
人类不可能穷举所有可能性,生成并测试所有可能的字符串也是愚蠢的。然而,一个部分程序的各种续写并非同等合理。
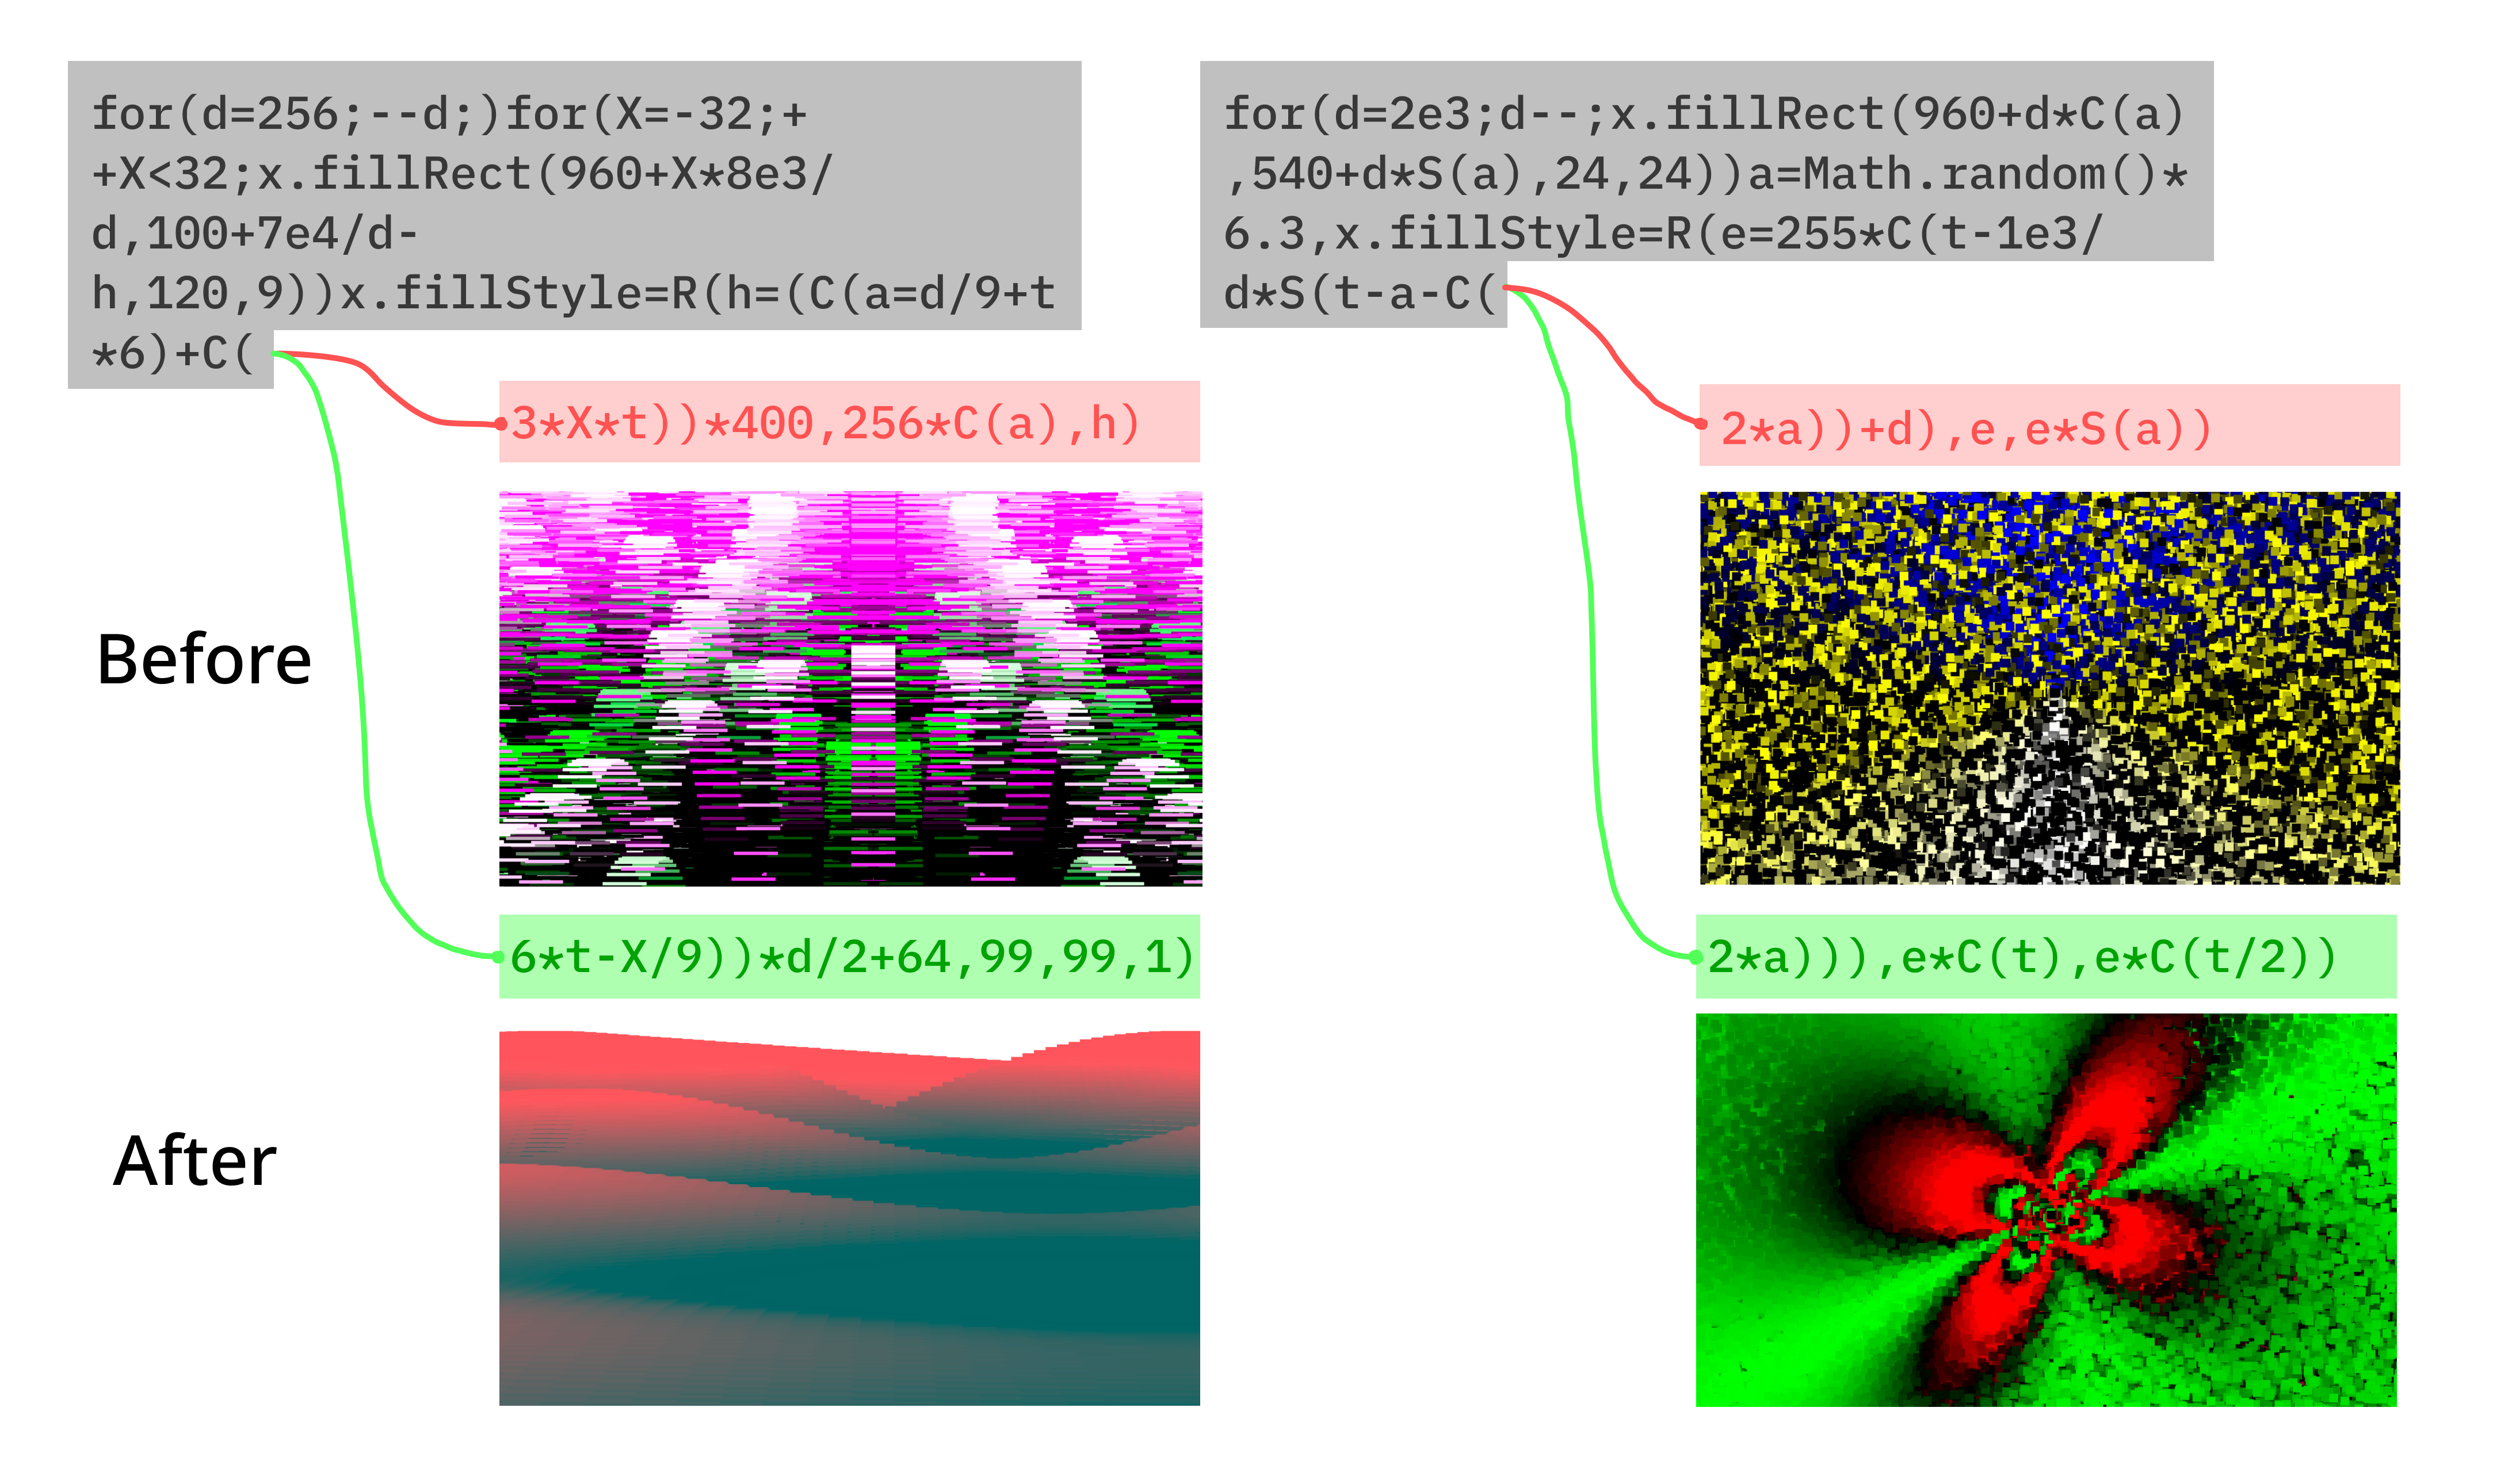
给定一个部分程序,某些字符和表达式紧随其后的可能性远高于其他。这基本上就是自回归语言模型的工作方式。我想知道,我能否用这样一个模型来采样未完成Dweet的合理续写,并将每个程序可能走向的不同方向可视化出来。
然后,我就可以按照自己的审美品味,精准地删除子串或将它们混搭组合。
此外,我对自己在开始一个演示作品后“完成”它的能力也感到相当沮丧,所以拥有一个能理解Dweeting独特语言的自动补全工具,对我来说似乎是个颇具吸引力的前景。
大约在同一时间,我看到了Mithil Vakde的推文(你可能最近在HackerNews上见过他)。
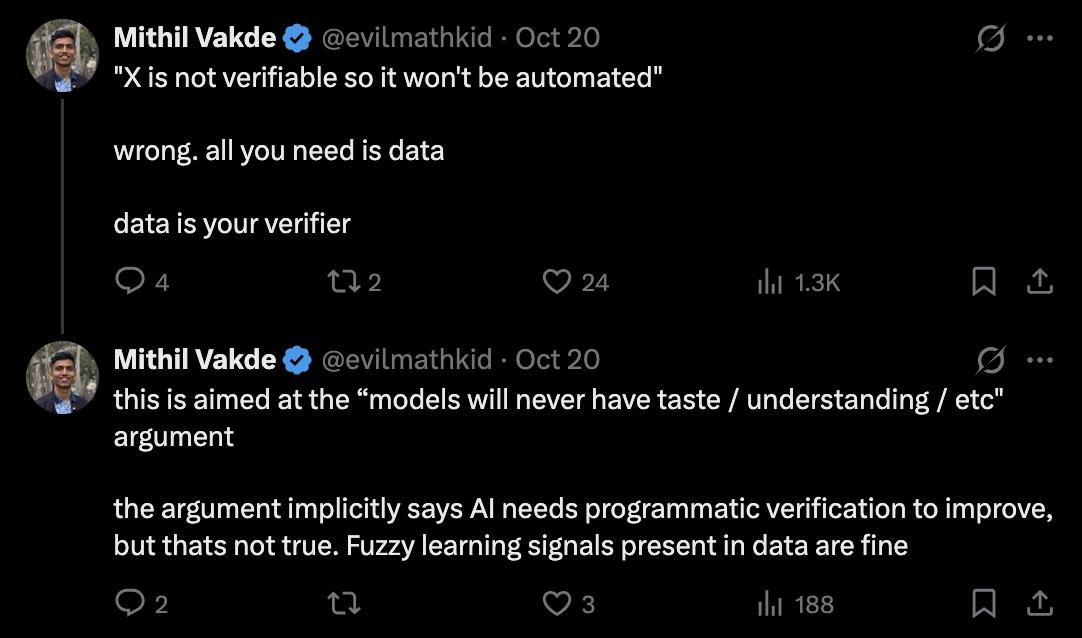
这给了我另一个做实验的借口——我能不能把我自己的审美品味作为先验注入到我的自动补全模型里?那一定会非常棒。
我明白没有人能写出一个判断 demo 是否美观的函数,但人们可以通过比较示例来表达自己的偏好,对吧?
带着这个想法,我决定把 GitHub Sponsors 的款项用于租用 GPU,并对自己的模型进行后训练。
第一个障碍是找到合适的数据集。我最初尝试用 Claude Sonnet 5.5 生成合成 Dweet,但发现它们完全不具备审美愉悦感。幸运的是,Dwitter.net 提供了 API,我用它构建了一个包含 2.5 万条 Dweet 的适度数据集用于训练,另外约 1.3 千条作为验证集。
我使用 Qwen2.5-Code-7B 作为基础模型。在我测试的大多数 Dweet 上,它都难以完成补全,考虑到这些代码的语法有多么奇特,这也是可以理解的。Dweet 大量使用代码高尔夫技巧和数学简写,这与通用编程模型通常遇到的代码相比相当不寻常。
我决定尝试在该语料库上进行持续预训练(CPT),希望将模型的概率分布转向 dweeting 的独特语言。为了检验是否奏效,我测量了训练前后各个 token 的惊奇度(surprisal)。惊奇度就是模型在给定前面所有内容的情况下赋予某个 token 的概率的负对数。一个 token 越不可能出现,对模型来说就越令人惊讶。
下图中,红色越深表示惊奇度越大。经过 CPT 后,大部分代码的惊奇度明显降低(尤其是不熟悉的编程惯用法)。
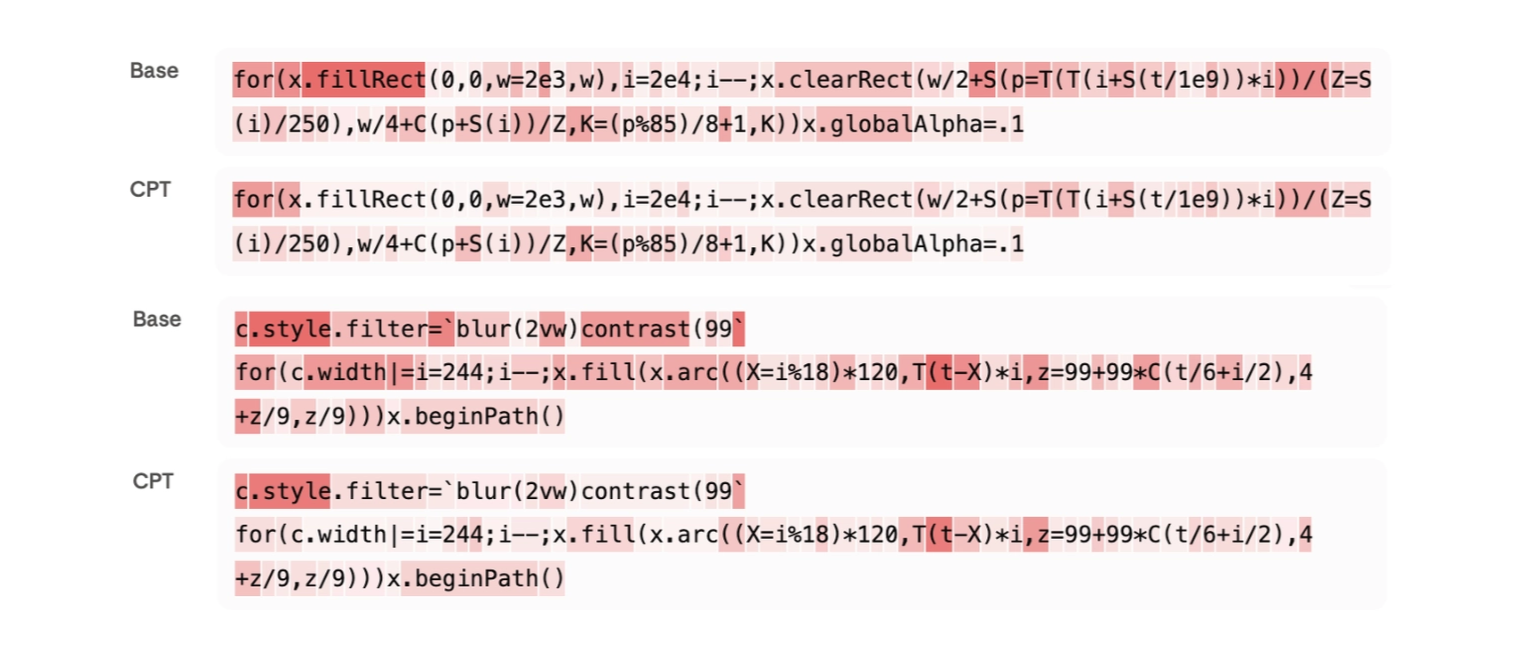
在 30 条留出的 dweet 上,困惑度从 28.63 降至 8.57,这意味着模型在预测这些微小怪异程序的结构方面有了显著提升。
尽管生成的程序更加一致,但它们仍然缺乏某种“魅力”。幸运的是,Dwitter 为每条 Dweet 都有一个“awesomeness”评分。我决定用它来构建一个课程。
我按“awesomeness”评分对前 5 千条 dweet 进行排序,并构建了一个逐渐偏向更受欣赏的程序的课程。最初,每条 dweet 被采样的概率相等。在 400 个训练步骤中,我逐步增加分配给排名更高程序的权重,直到前 1000 条约占采样概率的 67%。
| 排名分组 | 第 1 步 | 第 100 步 | 第 200 步 | 第 300 步 | 第 400 步 |
|---|---|---|---|---|---|
| 1-1000 | 20.00% | 35.89% | 48.74% | 59.01% | 67.23% |
| 1001-2000 | 20.00% | 27.97% | 29.60% | 28.01% | 24.99% |
| 2001-3000 | 20.00% | 20.03% | 15.23% | 10.41% | 6.75% |
| 3001-4000 | 20.00% | 12.06% | 5.63% | 2.41% | 0.99% |
| 4001-5000 | 20.00% | 4.05% | 0.81% | 0.16% | 0.03% |
这成了一个突破!生成的续写变得在视觉上有趣得多。
有趣的是,token 似然度的提升甚至扩展到了课程训练期间从未被采样的 Dweet。困惑度从 7.42 降至 5.65,尽管提升在各 awesomeness 排名之间分布得相当均匀。
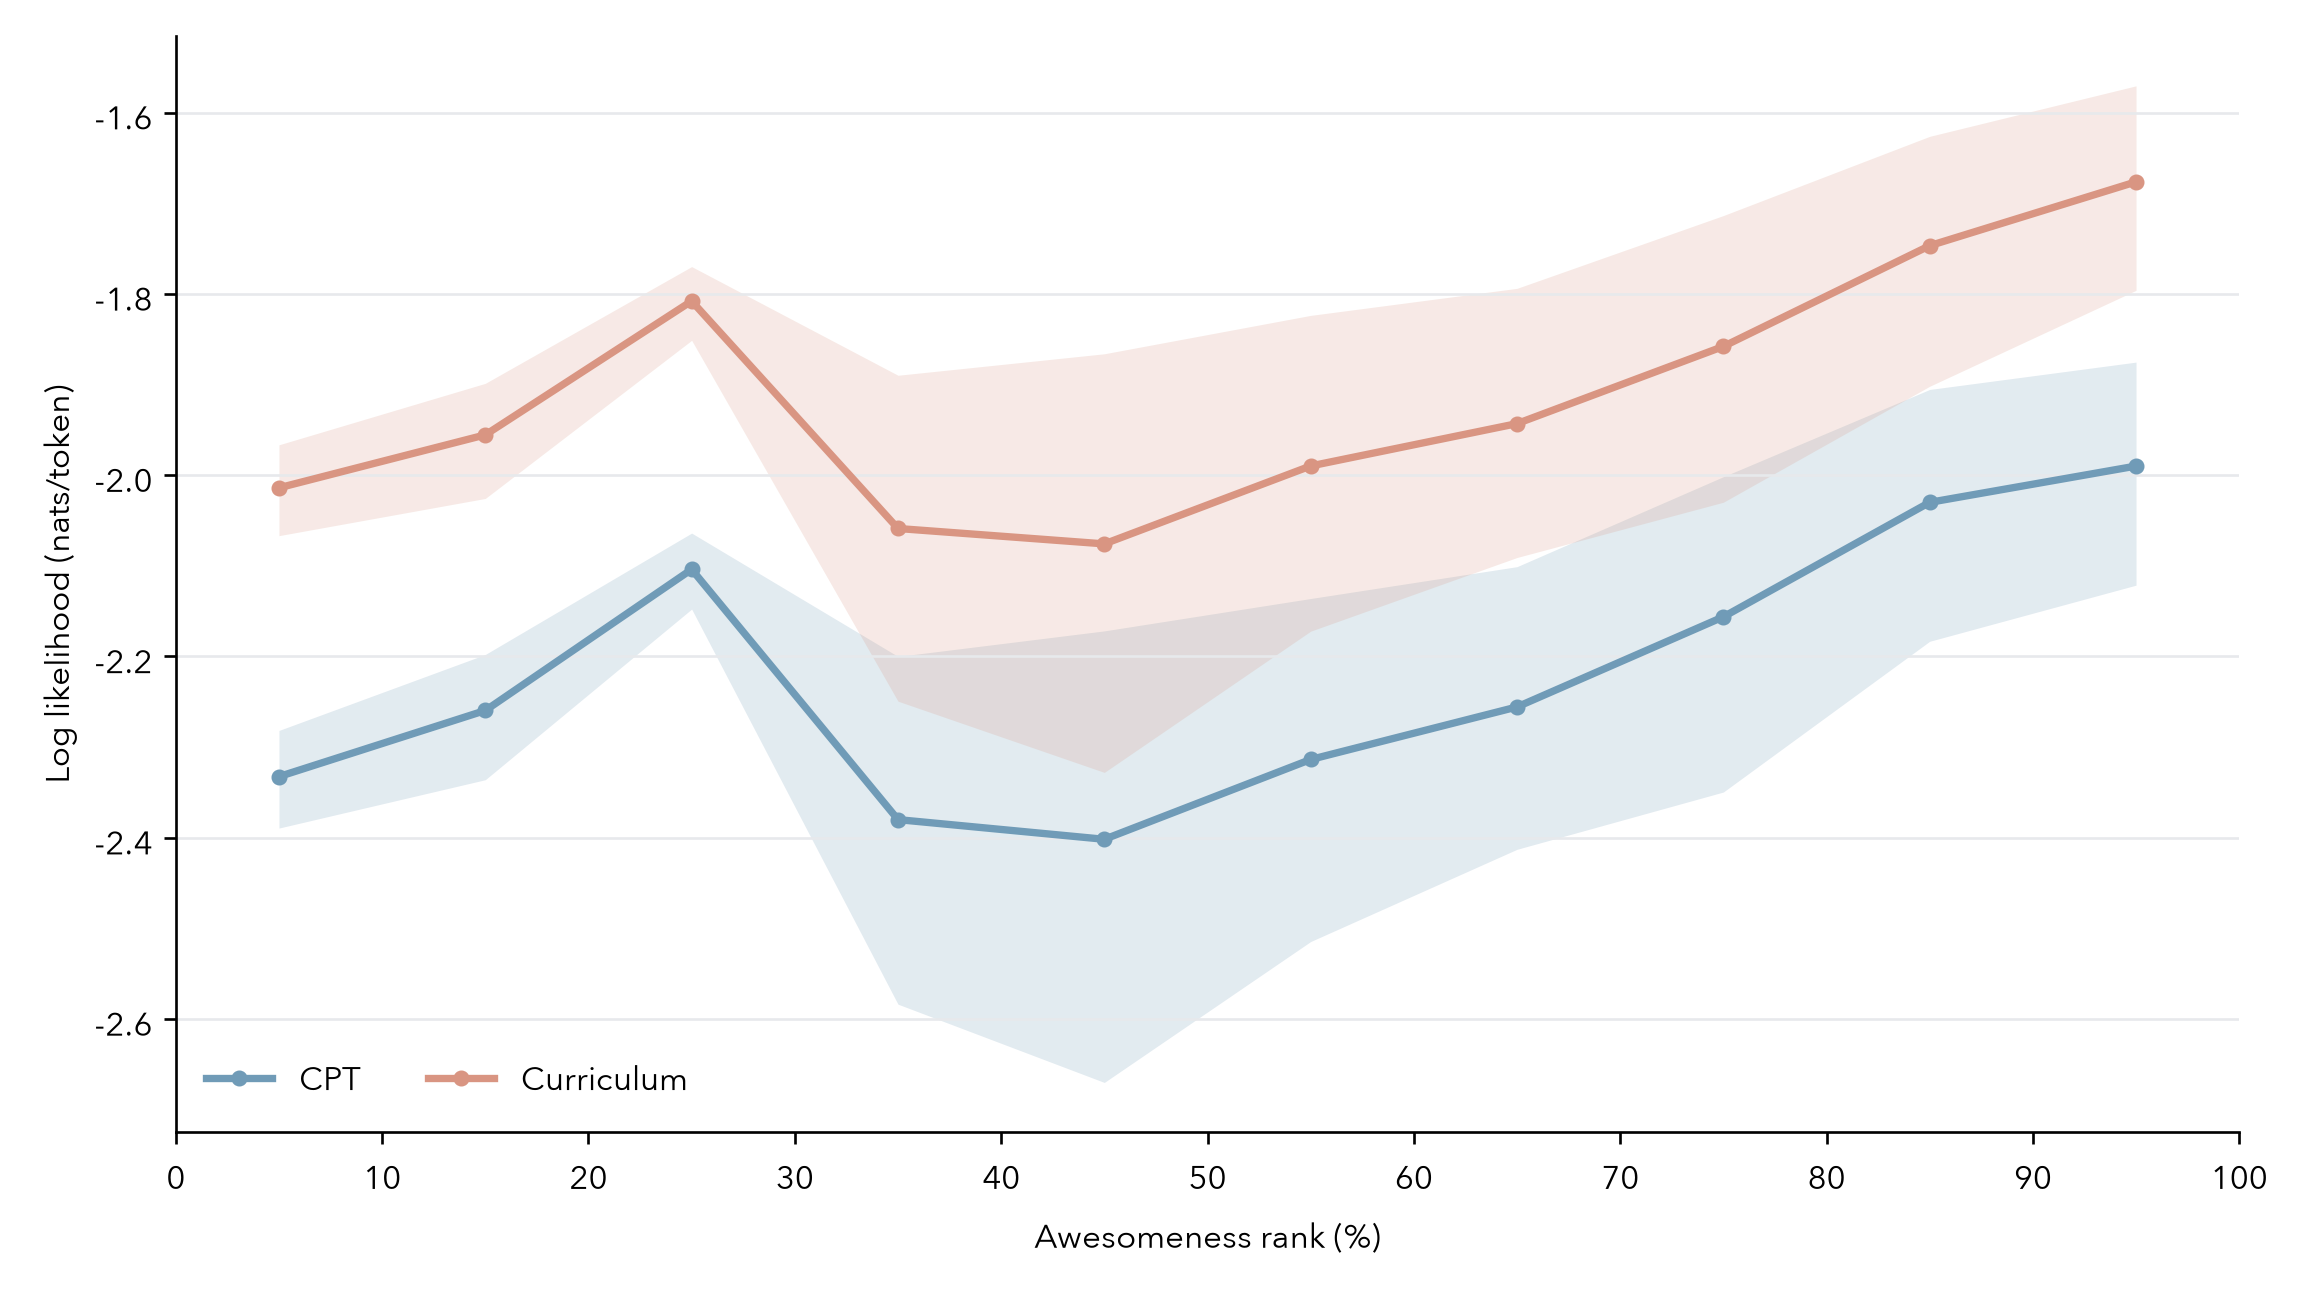
在 7000 条 Dweet 上,课程训练提升了所有 awesomeness 排名中的 token 似然度,包括训练期间从未采样的程序。对于原始模型觉得困难的程序,提升尤为明显。
现在我有了一个能生成相当优美续写的模型。我想知道能否通过融入我自己的审美偏好来更进一步。
九月中旬,我偶然读到 Surya 的文章 Training AI to Paint with Code,他们在文中用强化学习让 AI 借助 p5js 创作水彩画。他们尝试了不同的奖励函数,最终选定与一组人工评分的画作进行两两比较。我记住了这个想法,并想用 Demoscener 尝试类似的做法(反复称它为“模型”感觉不太合适)。
我选择用 GRPO 做 RLHF,由我自己充当奖励函数。
对于每个未完成的 Dweet,我采样一组八个补全结果,将它们并排渲染,然后选出我认为最美观的一个。如果都不合我意,我就跳过这一组。我用这些偏好来更新 Demoscener 的策略,然后重新采样续写,如此重复了大约 9–10 轮,每轮 500 组。总共我人工查看了大约 40,000 个动画。
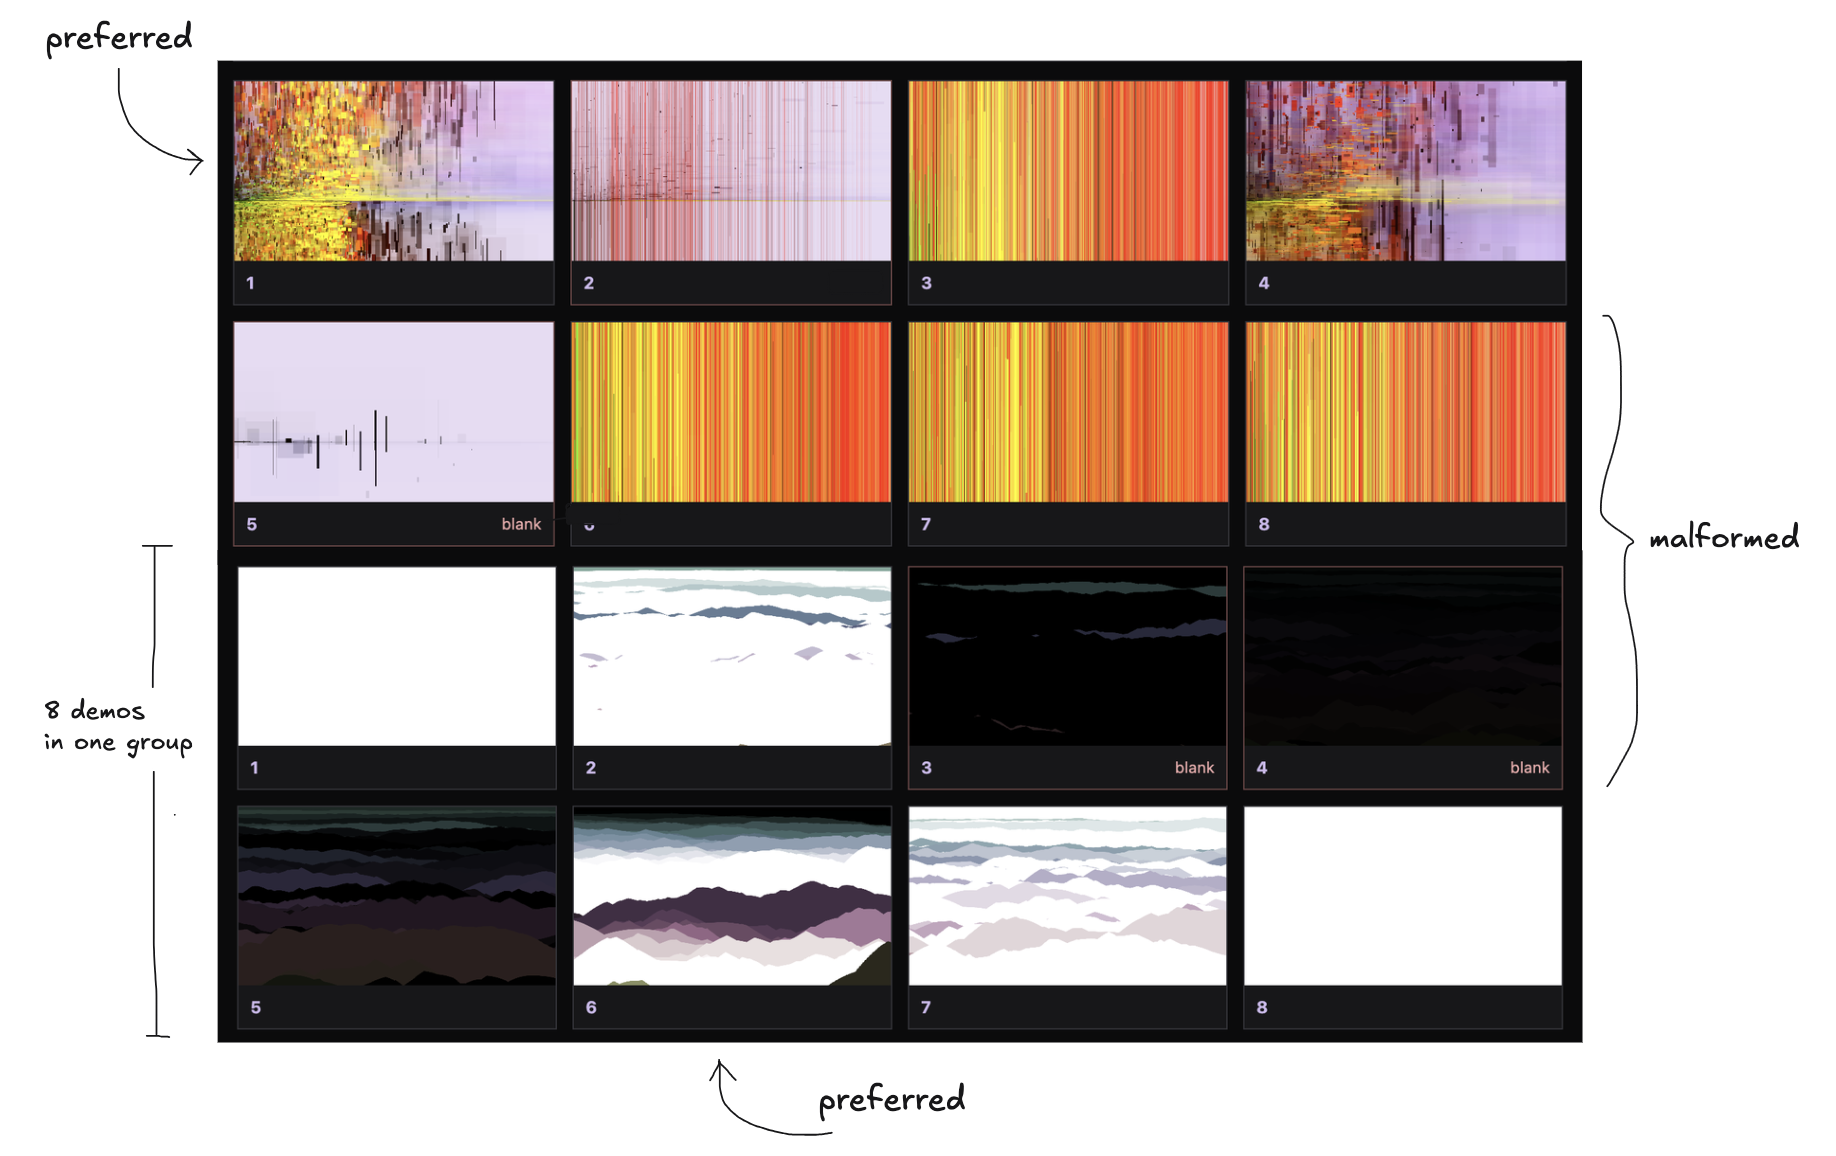
大约到第 10,000 个动画时,我开始体会到 VLM 和 HPSv3 的存在价值。可惜为时已晚。
经过几轮训练后,我想看看我的品味究竟有多少真正传递给了 Demoscener。我拉来一位不太情愿的朋友,让他在不知道哪个模型生成了哪组演示的情况下,对来自几个检查点(我随机选了 4 个)的 400 组演示进行评判。
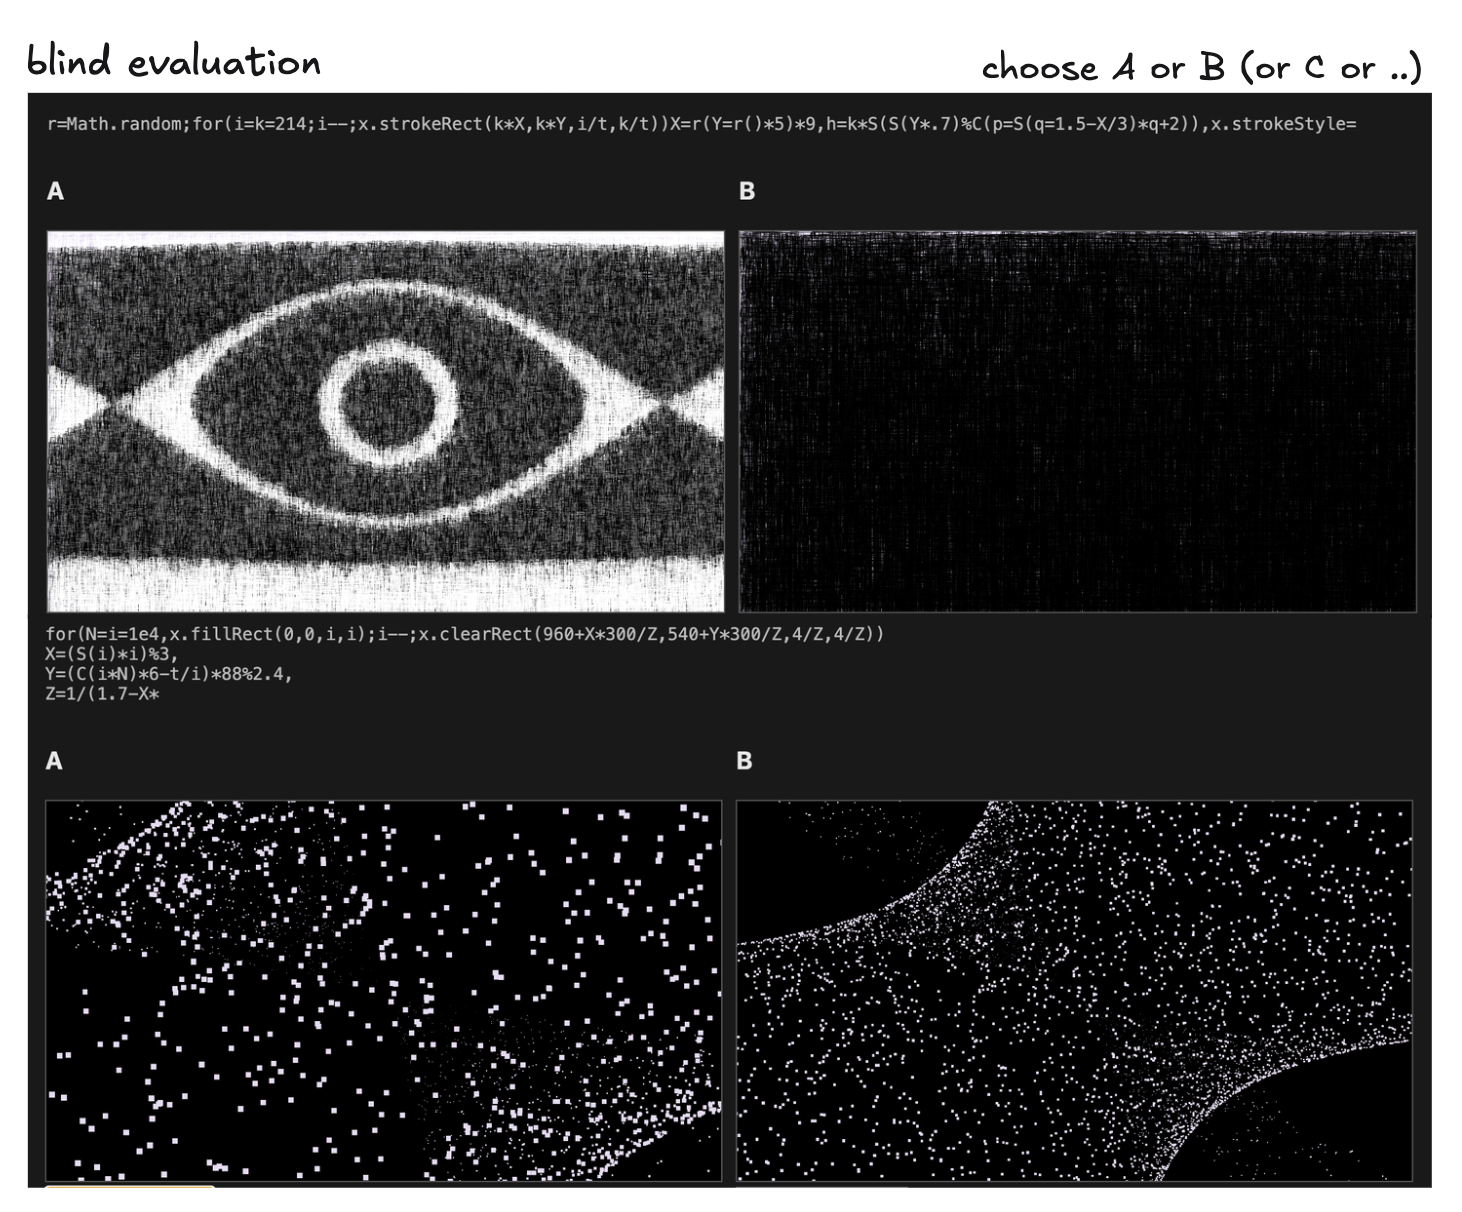
结果显示检查点 4 最受青睐,于是我用它在我的 Mac 上运行推理。
支线任务接近尾声时,我搭建了一个小界面,可以从同一前缀生成多个续写,将它们并排渲染,并从任何一个吸引我的结果分支出去。然后我可以调整代码、生成更多续写,继续探索。
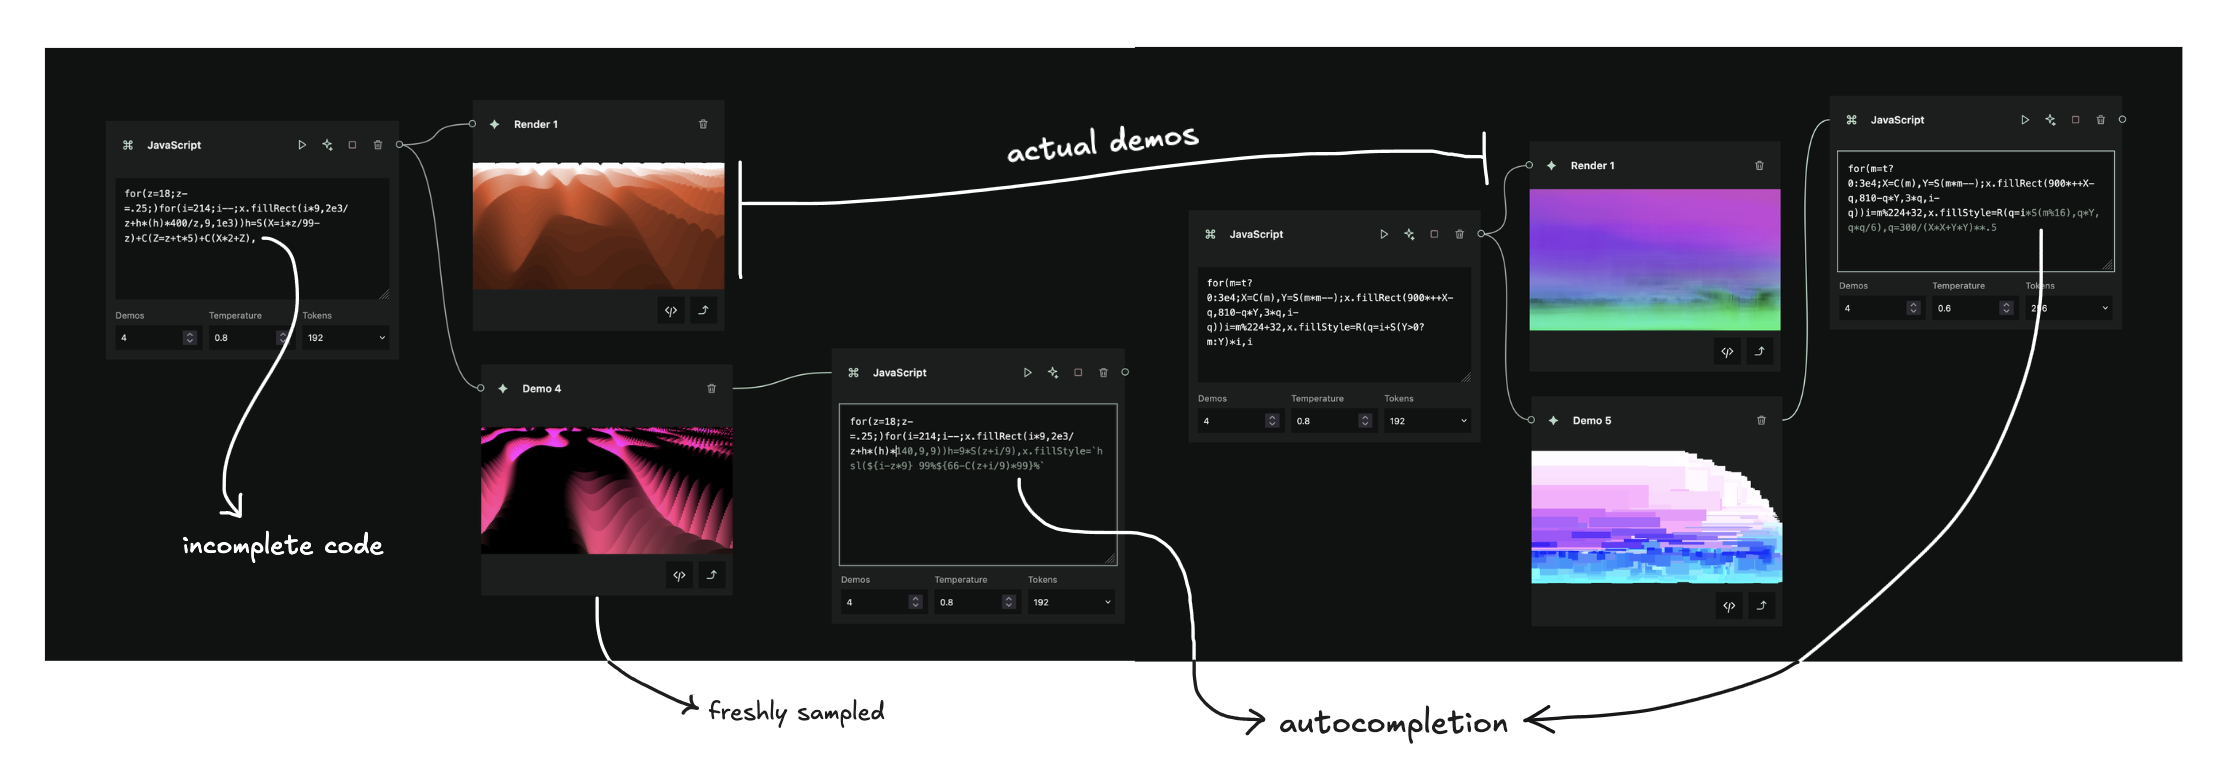
每个分支代表一种可能的续写,我可以直观地比较、手动调整,并将其作为进一步探索的起点。
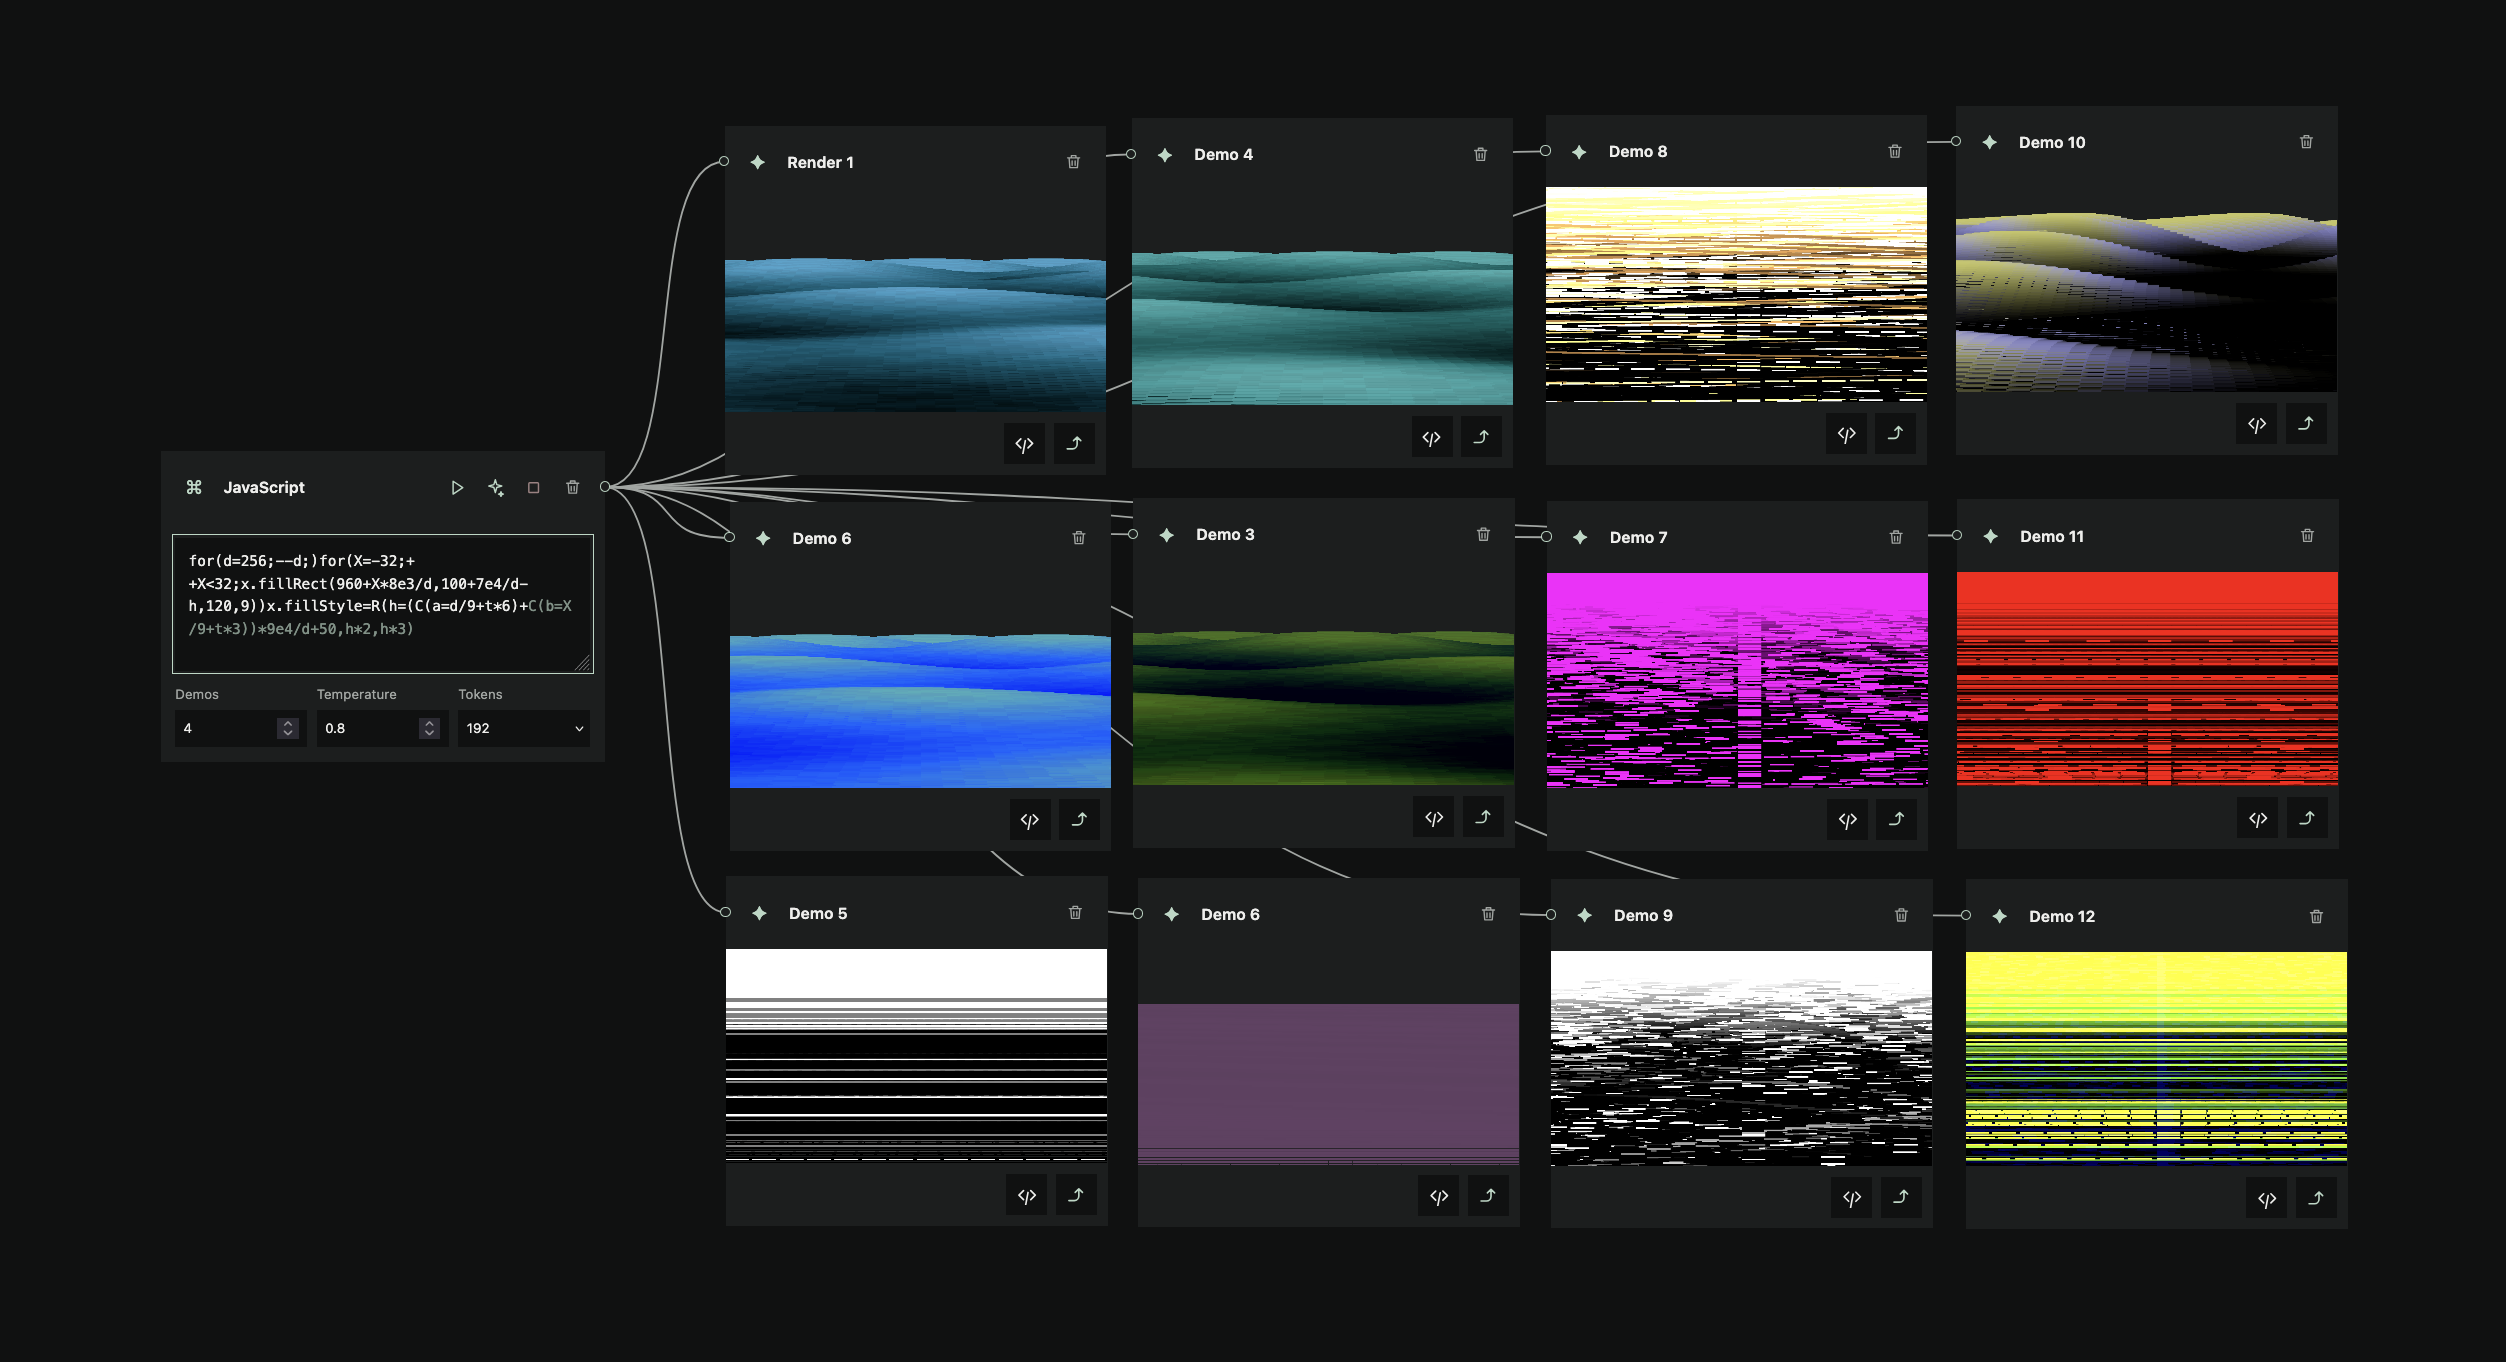
能够漫游于这些可能性之中,感觉相当美妙。我想我会再多花点时间做这件事。
你可以在 HuggingFace 上找到 Demoscener-7B 和数据集。
来源:Hacker News · datavorous.com