从 KTIR 到 SpyreCode:IBM Spyre 的 MLIR 数据流后端
From KTIR to SpyreCode: An MLIR Dataflow Backend for IBM Spyre
IBM Spyre 的 torch-spyre 后端编译器通过 KTIR(Kernel Tile IR)承接 Inductor 已确定的并行划分,再由开源 Dataflow Scheduler 将其转换为数据流流水线,最终生成 SpyreCode。
TL;DR
Torch-spyre 的 Inductor 决定每个 kernel 的工作如何在 Spyre 的各个核心之间划分,并管理张量在片上暂存器和片外内存之间的驻留,而后端编译器则将这些决策转化为硬件实际可执行的内容。二者之间的契约使用 KTIR(Kernel Tile IR)表示,这是一种基于加速器数据并行视图构建的 MLIR 表示,其中每个计算瓦片都能看到所有内存,单个逻辑张量可以分布在多个核心的暂存器上。一个新的开源 Dataflow Scheduler 消费 KTIR,并将每个瓦片的工作转化为数据流流水线:它将 kernel 拆分为程序,从简单的 load → compute → store 流水线开始,按照架构描述中给出的内存层次结构路由每一次传输,并将该流水线扩展为嵌套的、双缓冲的、多实例调度。调度器的输出使用 DataflowIR 表示,这是一种 MLIR 中间表示,Spyre 的设备特定阶段用它来生成 SpyreCode,即一个符号化的 SpyreBinary 加上一个作业计划,Spyre 运行时只需准备一次即可多次启动,并在启动时填入张量地址和形状。
本文是三篇系列文章中的中间一篇。Extending Inductor for the IBM Spyre Accelerator 介绍了 torch-spyre 的 Inductor 扩展如何确定布局、分块、工作划分和暂存器放置,而 Building Spyre as a Native PyTorch Device 介绍了运行时如何启动一个编译产物,其符号值直到最后一刻才被填入。本文介绍 Inductor 所做的决策如何真正变成一个运行时可以启动的程序。
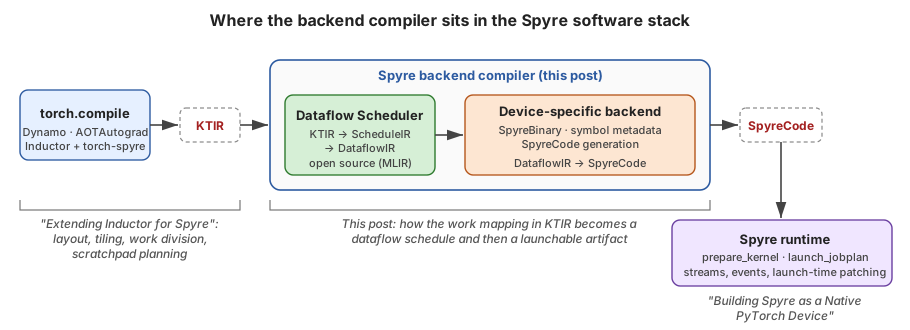 后端编译器在 Spyre 软件栈中的位置
设计贯穿了三个理念。
- 前端决定并行分解,后端使其运行。 KTIR 旨在承载 Inductor 已经选定的映射(哪个核心计算什么、基于哪些数据、从哪个内存中读取),以便后端永远不必重新发现它。后端的工作是在该映射内部进行数据流调度。
- 调度意味着构建流水线。 Spyre 是一台具有解耦访问和执行的数据流机器,因此加载、存储和计算在通过 FIFO 通信的独立引擎上运行。调度器从最简单的合法流水线开始,一次一个变换地对其进行精化,其中每一步都是可读的 MLIR 重写。
- 边界是 IR,而不是库调用。 KTIR、调度器的 ScheduleIR 和 DataflowIR 都是基于上游方言(
linalg、scf、arith、memref、tensor)构建的普通 MLIR,并且调度器及其方言在 Apache-2.0 下开源。用于代码生成的设备特定降级阶段从 DataflowIR 边界开始。
KTIR:Inductor 与后端之间的契约
为什么需要新接口
高效后端调度的关键需求之一,是 torch-spyre 的 Inductor 与后端编译器之间的一份契约,它需要具备能力和灵活性来捕获加速器的完整数据并行视图,其中每个计算瓦片都能看到所有内存,单个逻辑张量可以分布在多个核心的暂存器上。
KTIR(RFC 0682,在 torch-spyre/ktir-mlir-frontend 中实现)是一种基于 tile 的块结构 IR,构建在开源 MLIR 之上。我们的目标是让它具备足够的表达能力,以捕获来自两个截然不同来源的数据并行映射:一侧是 Inductor,另一侧是用 Triton 或 Helion 等语言手写的 Spyre 内核。
加速器的数据并行抽象
KTIR 是针对一个刻意简化的硬件图景编写的:一组核心,每个核心都有一个计算引擎和自己的片上暂存器,它们通过片上互连相连,该互连还连接到一个或多个片外存储器。最重要的特性是每个计算 tile 都能全局访问每一块存储器,这意味着它自己的暂存器、其他每个核心的暂存器以及设备内存。

KTIR 中体现的多核加速器硬件抽象(来自 RFC 0682)
这一图景与 Spyre 的形态高度吻合:环形结构上有 32 个核心,每个核心有 2 MB 暂存器,并由片外设备内存支撑。数据以 stick 为单位在设备内存和暂存器之间移动,每个 stick 是固定的 128 字节块,可容纳 64 个 fp16 值。该图景有意省略了 FIFO、加载/存储单元和解耦执行引擎等细节。KTIR 描述的是每个计算 tile 做什么以及它的数据位于何处,而不是数据如何到达那里,因为弄清楚数据如何到达那里正是调度器的职责。
KTIR 还具有组合性。算术、归约和控制流直接来自上游 MLIR 方言(arith、math、linalg、scf、tensor、memref),而一个专用方言 ktdp 则补充了这些方言无法表达的两件事:显式存储器和显式访问。第二个小得多的方言 spyreop 涵盖 Spyre 自身的 intrinsic。核心的 ktdp 操作包括:
ktdp 操作 |
它表达的内容 |
|---|---|
get_compute_tile_id |
这是哪个计算 tile;基于内核上的 grid 属性的一维或多维 |
construct_memory_view |
将命名内存空间中某个(可能是符号化的)地址处的区域解释为跨步张量;不分配、不移动数据 |
construct_distributed_memory_view |
将多个内存视图组合成一个逻辑张量,每个视图覆盖全局坐标空间的一部分 |
construct_access_tile |
视图中的一组结构化坐标:域用整数集表示,遍历顺序用仿射映射表示,因此 tile 可以是矩形、跨步、倾斜或三角形的 |
construct_indirect_access_tile |
同上,但某些维度通过另一个张量进行索引,例如分页 KV-cache 收集 |
load / store |
唯一的数据移动:消费一个访问 tile 并产生或写入一个数据 tile |
inter_tile_produce / inter_tile_reduce |
计算 tile 之间的通信,例如部分和的全归约 |
下面是一个完整的内核,对 96×64 个 fp16 张量进行逐元素加法,这些张量被分配给 32 个计算 tile,每个 tile 三行。
#tile = affine_set<(d0, d1) : (d0 >= 0, -d0 + 2 >= 0, d1 >= 0, -d1 + 63 >= 0)>   // 3x64
#full = affine_set<(d0, d1) : (d0 >= 0, -d0 + 95 >= 0, d1 >= 0, -d1 + 63 >= 0)>
#id   = affine_map<(d0, d1) -> (d0, d1)>

// The tensors' start addresses arrive as arguments: PyTorch's allocator owns them.
func.func @add(%A: index, %B: index, %C: index) attributes {grid = [32]} {
  %c0   = arith.constant 0 : index
  %c3   = arith.constant 3 : index
  %id   = ktdp.get_compute_tile_id : index
  %row0 = arith.muli %id, %c3 : index                 // this tile's 3-row slab

  %A_view = ktdp.construct_memory_view %A, sizes: [96, 64], strides: [64, 1] {
      coordinate_set = #full, memory_space = #ktdp.memory_space<global>
  } : memref<96x64xf16>
  // ... %B_view and %C_view alike

  %A_t = ktdp.construct_access_tile %A_view[%row0, %c0] {
      access_tile_set = #tile, access_tile_order = #id
  } : memref<96x64xf16> -> !ktdp.access_tile<3x64xindex>
  // ... %B_t and %C_t alike

  %a = ktdp.load %A_t : !ktdp.access_tile<3x64xindex> -> tensor<3x64xf16>
  %b = ktdp.load %B_t : !ktdp.access_tile<3x64xindex> -> tensor<3x64xf16>
  %e = tensor.empty() : tensor<3x64xf16>
  %c = linalg.add ins(%a, %b : tensor<3x64xf16>, tensor<3x64xf16>)
                  outs(%e : tensor<3x64xf16>) -> tensor<3x64xf16>
  ktdp.store %c, %C_t : tensor<3x64xf16>, !ktdp.access_tile<3x64xindex>
  return
}
该内核将四个关注点分开。视图说明应如何解释内存,访问 tile 说明给定 tile 触及哪些坐标,加载和存储是唯一移动数据的操作,而 linalg 负责算术。还要注意,工作划分已经确定:grid = [32] 连同对 %id 的算术运算就是划分,后端应当遵循它,而不是质疑它。
Spyre intrinsic:spyreop 方言
上游的 arith 和 math 覆盖了内核所需的大部分算术运算,但 Spyre 的计算单元还提供了一些通用方言没有命名的操作。想要使用其中某个操作的内核应当能够直接请求它,而不是寄希望于后端能识别 arith 操作的某种特定模式。为此,KTIR 附带了一个小得多的第二方言 spyreop,它将 Spyre 内建函数暴露为普通的 MLIR 操作。它涵盖了逐元素和激活函数(exp、gelu、sigmoid、silu、softplus、sqrt、rsqrt、reciprocal、realdiv)、归一化的构建模块(合并的均值和均方值,以及 LayerNorm 的归一化和缩放两半,部分带有融合变体)、整数和地址算术(包括 idx32toaddr,它为 gather 计算 base + stride × index),以及 compare 和 select。该方言还定义了 df16,即 IBM 的 16 位 DLFloat 格式,它将其位按 1-6-9 分配给符号、指数和尾数,而非 IEEE 半精度的 1-5-10,同时还定义了将一对浮点数作为单个值携带的“融合”类型。
内建函数出现在任何其他标量计算会出现的地方,即 linalg.generic 的主体内部:
%y = linalg.generic {indexing_maps = [#in, #out],
                     iterator_types = ["parallel", "parallel", "parallel", "parallel"]}
       ins(%x : tensor<6x64x64xf16>) outs(%init : tensor<1x6x64x64xf16>) {
  ^bb0(%a: f16, %out: f16):
    %g = spyreop.gelu %a : f16
    linalg.yield %g : f16
} -> tensor<1x6x64x64xf16>
由于它们只是 linalg 主体中的操作,内建函数会像其他任何东西一样与周围的逐元素工作融合,调度器将它们作为计算携带,直到准备好将它们降级。每个内建函数如何展开为硬件自身的指令序列完全不写在调度器中:它存在于架构描述中,作为本文后面描述的设备模式之一。
KTIR 如何捕获 Inductor 的工作映射
Inductor 那篇文章详细介绍了 torch-spyre 在生成任何代码之前所做的一系列决策。每一个决策在 KTIR 中都有直接对应:
| torch-spyre 的 Inductor pass 中的决策 | 它在 KTIR 中的呈现方式 |
|---|---|
| 工作划分:按操作的核心拆分,例如 matmul 的 16 × 2 网格 | 内核的 grid 属性,加上对 ktdp.get_compute_tile_id 的仿射算术,用于选取每个 tile 的切片 |
| Stick 粒度布局:哪个维度是 stick,以及其他维度的平铺顺序 | construct_memory_view 的步长,以及每个访问 tile 的 access_tile_order |
| 粗粒度平铺和工作集缩减 | 围绕加载、计算和存储的 scf.for 循环,它们逐 tile 运行链 |
| 由 scratchpad 分配器选择的 scratchpad 驻留 | #ktdp.memory_space<ct_local, ct_id = k> 中位于分配器所分配偏移处的内存视图 |
| 跨核心拆分的张量,使每个切片都能放入 scratchpad | 对每核心 ct_local 视图的 construct_distributed_memory_view |
核心到核心的重布局(lx_relayout) |
对一个分布式视图的访问 tile,存储到具有不同分布的视图中 |
| 跨核心拆分的归约(一个输出 tile 的部分和) | inter_tile_produce / inter_tile_reduce |
| 分页张量和 gather | construct_indirect_access_tile |
| 设备特定的激活和归一化步骤 | linalg.generic 主体内的 spyreop 内建函数 |
| 由 PyTorch 分配器拥有的张量地址 | 内核参数。它们一直保持符号化直到 SpyreCode,并在启动时由运行时替换 |
| 仅在运行时已知的张量形状,在某个界限内 | !ktdp.runtime_arg<index, granularity = G, upperbound = U>,保持符号化并以相同方式在启动时替换 |
最后两行是本文与运行时文章的交汇点。因为 KTIR 允许起始地址或大小是值而非常量,所以它下面的每一层都可以将该值保持符号化,直到运行时能够提供它。
固定在 scratchpad 中、跨核心分布的张量
KTIR 与面向 GPU 的 tile IR 最显著的区别在于它对待片上内存的方式。像 Triton 这样的 tile 语言描述的是每个程序实例从全局内存加载张量块、对其进行计算,再将结果存回。这些块如何经由共享内存、寄存器和缓存进行暂存,则交由编译器和硬件决定,而一个程序实例的片上存储是该实例私有的,且仅在其运行期间存在。在这种模型中,通常无法也几乎不需要表达这样的语义:当下一个操作读取某个张量时,它仍应驻留在某个特定核心的片上内存中;或者一个程序实例应读取另一个实例保存在片上的数据。这在缓存和动态调度器能够平滑处理数据移动的硬件上运行良好,但并不适合 Spyre。Spyre 没有可依赖的硬件管理缓存,而让张量从一个操作到下一个操作始终保持在片上,是可用性能杠杆中最大的一个。在 Spyre 上,暂存器并不是内核碰巧命中的缓存;它是编译器选择使用的内存,由 Inductor 的暂存器分配器决定哪些缓冲区保持驻留、位于什么地址以及位于哪个核心。因此,KTIR 将片上放置作为 IR 的一等组成部分,而非实现细节:它只是把这个决策写下来。
每个内存空间都命名一块物理内存:#ktdp.memory_space<global> 是设备内存,#ktdp.memory_space<ct_local, ct_id = k> 是属于计算 tile k 的暂存器。视图的 coordinate_set 记录它持有更大逻辑张量的哪一部分,因此如果将各核心的视图与 construct_distributed_memory_view 组合起来,就会得到一个按全局坐标索引、其存储分布在多个暂存器上的单一张量。
// X[128, 1024] f16, left in scratchpad by an earlier op of the kernel:
// 32 rows on each of four cores, at the offset the scratchpad allocator chose.
#rows0 = affine_set<(d0, d1) : (d0 >= 0,      -d0 + 31 >= 0,  d1 >= 0, -d1 + 1023 >= 0)>
#rows1 = affine_set<(d0, d1) : (d0 - 32 >= 0, -d0 + 63 >= 0,  d1 >= 0, -d1 + 1023 >= 0)>
// ... #rows2, #rows3

%X0 = ktdp.construct_memory_view %lx_off, sizes: [32, 1024], strides: [1024, 1] {
        coordinate_set = #rows0, memory_space = #ktdp.memory_space<ct_local, ct_id = 0>
      } : memref<32x1024xf16>
%X1 = ktdp.construct_memory_view %lx_off, sizes: [32, 1024], strides: [1024, 1] {
        coordinate_set = #rows1, memory_space = #ktdp.memory_space<ct_local, ct_id = 1>
      } : memref<32x1024xf16>
// ... %X2, %X3
%X = ktdp.construct_distributed_memory_view (%X0, %X1, %X2, %X3
        : memref<32x1024xf16>, memref<32x1024xf16>, memref<32x1024xf16>, memref<32x1024xf16>)
        : memref<128x1024xf16>

// Compute tile 1 reads rows 48-79: half from its own scratchpad, half from core 2's.
#rows32 = affine_set<(d0, d1) : (d0 >= 0, -d0 + 31 >= 0, d1 >= 0, -d1 + 1023 >= 0)>
%id  = ktdp.get_compute_tile_id : index
%row = affine.apply affine_map<(d0) -> (d0 * 32 + 16)>(%id)
%t = ktdp.construct_access_tile %X[%row, %c0] {
       access_tile_set = #rows32, access_tile_order = #id
     } : memref<128x1024xf16> -> !ktdp.access_tile<32x1024xindex>
%x = ktdp.load %t : !ktdp.access_tile<32x1024xindex> -> tensor<32x1024xf16>
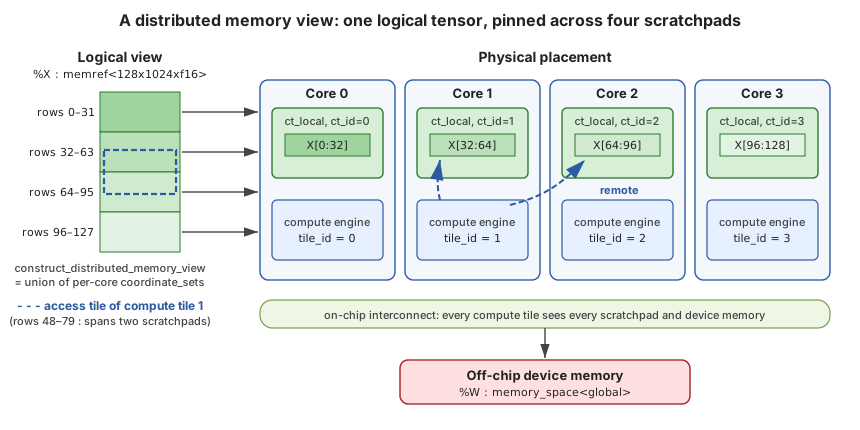 分布式内存视图:一个逻辑张量,固定分布在四个暂存器上
这一个构造承担了相当多的工作。首先,它让中间张量从一个操作到下一个操作始终保持在片上:生产者可以存入分布式 ct_local 视图,消费者可以从该视图加载,而两者都无需提及设备内存,这正是 Inductor 文章中 softmax 示例所围绕构建的那种无需往返的融合。其次,它将核心划分不匹配转化为普通的 IR。当生产者和消费者以不同方式划分张量时,消费者的访问 tile 只需跨越暂存器边界,而由于每个计算 tile 都能看到每个暂存器,这仍然不过是一个 load;torch-spyre 的协同优化分配器在权衡是否溢出时所考虑的片上重布局,无需任何专用操作。第三,它保持放置的绑定关系。运行时文章曾指出“放置必须显式且具有绑定力,因为编译后的代码可能依赖它”,而 KTIR 正是记录这种依赖关系的地方,因为视图上的内存空间和坐标集就是放置契约。
后端编译器一览
后端编译器是一个分为两部分的单一 MLIR 流水线。开源的 Dataflow Scheduler 将 KTIR 经由 ScheduleIR 降低为 DataflowIR,随后三个设备特定阶段(符号化 SpyreBinary 生成、用于运行时符号替换的元数据生成,以及 SpyreCode 生成)将 DataflowIR 转换为 SpyreCode。DataflowIR 是这两部分唯一的交汇点。
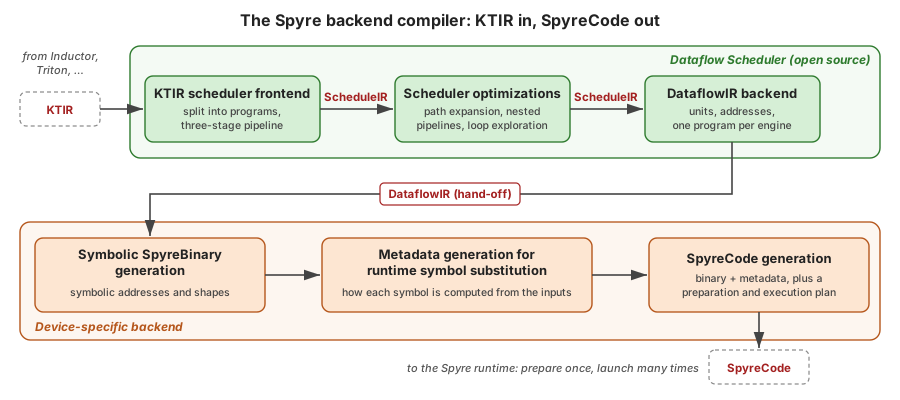 Spyre 后端编译器:输入 KTIR,输出 SpyreCode
文章剩余部分按从左到右的顺序跟随该图展开,大部分篇幅用于介绍调度器,随后更简要地介绍其下方的三个阶段。
数据流调度器:KTIR → ScheduleIR → DataflowIR
数据流加速器是由计算引擎和暂存存储器组成的分布式集合,它们通过带 FIFO 的宽数据通路相连。它遵循解耦访存-执行设计,即数据搬运(DMA、暂存器加载与存储)和对数据的计算在各自独立的引擎上进行,并同时运行。在这样的机器上,调度意味着构建一个跨空间与时间的数据流流水线,决定每一步由哪个引擎执行,以及各步骤之间如何重叠。
数据流调度器以 MLIR pass 流水线的形式完成这一工作,其构建方式受若干原则影响。它由架构描述驱动,而非针对某一芯片硬编码,我们将在下文进一步探讨这一点。每个调度都用单一的执行模型表达,该模型仅由三种构造组成:嵌套的 scf.for 循环、ktdf.pipeline(跨迭代重叠的阶段)和 ktdf.parallel(在彼此之间划分迭代空间的相同实例),所有分析和变换都以这些术语进行推理。调度器尽可能依赖上游 MLIR,将计算降低到 linalg.generic 并与上游 pass 融合,循环使用 scf,缓冲区使用 memref。并且自始至终遵循一个策略:从最朴素但正确的流水线开始,然后让后续每个 pass 要么使其在硬件上合法,要么以小步、可独立测试的方式将其扩大。
这些 pass 分为三组,每组在其边界处都有固定的 IR 契约,因此可以在组内添加或重排 pass,而不会干扰其他组。
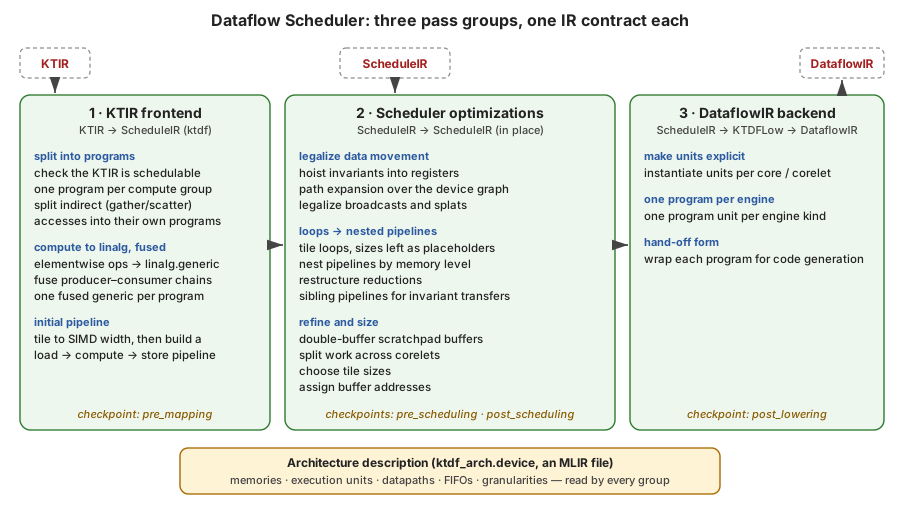 数据流调度器:三个 pass 组,每组一个 IR 契约
在四个命名的检查点(pre_mapping、pre_scheduling、post_scheduling 和 post_lowering)处,调度器应用以 PDL 编写的重写模式。这些模式位于架构描述中,而非调度器中,这意味着设备可以提供自己的 lowering,而无需分叉调度器。这里,每个 spyreop 内建函数(例如 spyreop.exp 或 spyreop.gelu)被替换为硬件的指令模板,内维归约则变为 SIMD 归约。
调度器的中间形式 ScheduleIR 是与 linalg、scf 和 memref 一起使用的 ktdf dialect。其词汇量小到可以完整列出:
ktdf 构造 |
含义 |
|---|---|
ktdf.pipeline [modulo(size: N)] |
跨迭代重叠的阶段链;modulo 在其资源的 N 个副本之间轮转(N 缓冲) |
ktdf.stage depends_in(...) depends_out(...) |
流水线的一个步骤,最终绑定到某一类执行单元(applicable_units) |
ktdf.private |
某条流水线私有的资源:FIFO 槽位、暂存缓冲区、令牌 |
!ktdf.token |
阶段之间的纯排序值,自身没有运行时开销 |
!ktdf.fifo.slot<SRC -> DST, 64xf16> |
两个单元之间硬件 FIFO 中的一个槽位 |
ktdf.data_transfer / ktdf.ind_data_transfer |
存储器与 FIFO 之间的显式移动,直接进行或通过间接地址缓冲区进行 |
ktdf.read_from_fifo / ktdf.write_to_fifo |
计算阶段如何消费和产生 FIFO 数据 |
ktdf.parallel ... distribute(num_instances = N) |
在 N 个相同硬件实例上将迭代空间划分为连续块 |
ktdf.tiling.reserve_size / derive_size / linearize_index |
稍后选择的 tile 大小、当前 tile 的范围以及原始索引的占位符 |
架构描述
调度器所知的关于硬件的一切都来自一个用 ktdf_arch 方言编写的 MLIR 文件。该文件将设备描述为一个图。其节点是内存(带有种类和大小)和执行单元(带有调度器关心的特性:每种元素类型的 SIMD 通道数、加载和存储单元的位宽与访问粒度、每个 FIFO 的深度)。其边是数据通路,每条数据通路都有一个传输粒度。组按照硬件的方式对资源进行作用域划分,例如一个核心拥有一个暂存器以及使用它的加载/存储和计算单元。以下是调度器测试中所用示例设备的精简简化版本:
#L1  = { kind = "L1", size = 1048576 }                           // 1 MB scratchpad
#SFU = { kind = "SFU", ktdf_arch.features = {
           ktdf_arch.feature.compute,
           ktdf_arch.feature.simd = { lanes = #ktdf_arch.map<f16 = 64, f32 = 32, i32 = 32> } } }
#L1LU_CORE_FIFO = { ktdf_arch.features = { ktdf_arch.feature.queue = { depth = 16, ordered } } }

ktdf_arch.device @sample_device {
  %ddr = memory #DDR
  group { kind = "core" } share(%ddr) {
    %l1 = memory #L1
    %mnilu = group { kind = "MNILU_Block" } share() { ... } -> exec_unit   // DMA load unit
    %mnisu = group { kind = "MNISU_Block" } share() { ... } -> exec_unit   // DMA store unit
    datapath #DDR_MNILU %ddr to %mnilu : memory, exec_unit
    datapath #MNILU_L1 %mnilu to %l1 : exec_unit, memory
    %sfu  = group { kind = "SFU_Block" } share() { ... } -> exec_unit   // compute unit
    %l1lu = exec_unit #L1LU                                              // scratchpad load unit
    %l1su = exec_unit #L1SU                                              // scratchpad store unit
    datapath #L1LU_CORE_FIFO %l1 to %l1lu : memory, exec_unit
    datapath %l1lu to %sfu : exec_unit, exec_unit
    ...
  }
  patterns ["pre_scheduling"] { ... }                   // device-specific rewrites, in PDL
  patterns ["post_scheduling"] { ... }
}
内核通过一行声明引用其目标,该声明导入此文件并将 KTIR 的内存空间映射到设备的内存上,例如将 global 映射到 DDR,将 ct_local 映射到 L1。此后,流水线中几乎每个决策都会从该描述中读取一些信息。SIMD 通道数决定了第一条流水线的宽度。数据通路构成路径扩展所搜索的路由图,因此一次传输所经过的跳数取决于图所允许的范围。访问粒度、传输粒度和 FIFO 深度约束了每次传输的形态。内存大小限定了地址分配可以放置的内容,从而决定了哪些 tile 尺寸能够适配。而 patterns 块在调度器的检查点处提供设备自身的 lowering,例如每个 spyreop 内建函数如何展开为硬件的指令。
因为所有这些都存在于描述中而非各个 pass 中,所以重定向调度器意味着编写新的描述,而不是修改调度器。Spyre 有自己的描述,调度器的测试针对上述示例设备运行,而相同的 pass 在两者上不加修改地运行。
步骤 1:将内核拆分为程序
一个 KTIR 内核是一序列操作,而一个 Spyre 程序是加载到设备上的单一流水线配置,因此调度器的第一个真正决策是在哪里将内核切分为可单独调度的程序。
调度器通过从每个 ktdp.store 出发,反向穿过为其提供输入的计算,直到其最终依赖的 ktdp.load,来完成这一切分。以这种方式连接起来的所有内容构成一个计算组,即一条经过内存的单一 加载 → 计算 → 存储 链,而一个组要么终止于属于不同组的加载,要么终止于任何带有区域的操作,例如循环或条件。然后每个组成为自己的嵌套 MLIR 模块 module @local_schedule_N,而原始内核则变成一个编排器,保留控制流和地址运算,并按顺序调用各个程序。因此,程序的数量恰好等于计算组的数量。
// KTIR: loads, compute and stores interleaved with a loop nest
func.func @kernel() {
  scf.for %i = %c1 to %c5 step %c1 {
    ... ktdp.load A ... linalg.add ... ktdp.store B ...
    scf.for %j = %c1 to %c3 step %c1 {
      ... ktdp.load B ... linalg.mul ... ktdp.store C ...
    }
    ... ktdp.load C ... linalg.sub ... ktdp.store D ...
  }
}

// ScheduleIR: an orchestrator that calls one program per compute group
module {
  func.func @kernel() {
    scf.for %i = %c1 to %c5 step %c1 {
      func.call @local_schedule_1() : () -> ()
      scf.for %j = %c1 to %c3 step %c1 {
        func.call @local_schedule_0() : () -> ()
      }
      func.call @local_schedule_2() : () -> ()
    }
    return
  }
  func.func private @local_schedule_0()
  ...
}
module @local_schedule_0 { func.func @local_schedule_0() { /* views, tile id, load, mul, store */ } }
module @local_schedule_1 { ... }
module @local_schedule_2 { ... }
这种拆分的一个后果值得明确说明,因为它区分了两种截然不同的循环。出现在 KTIR 中的循环(通常来自 Inductor 的粗粒度分块)留在编排器中,变成对各个 tile 的一系列程序启动。另一方面,程序内部的循环属于调度器:它通过将融合后的计算分块到硬件的向量宽度来创建这些循环,并且可以随意重构它们。
每个程序还会从内核中获取自己所需内容的副本,包括内存视图、常量、ktdp.get_compute_tile_id 以及 grid 属性,因此 Inductor 的工作划分能够完整地传递到每个程序。带有间接访问的内核会进一步拆分:第一个程序(使用 spyreop.idx32toaddr)将索引转换为间接地址缓冲区中的地址,第二个程序使用该缓冲区执行 gather 或 scatter。最后,在每个程序内部,逐元素运算会被转换为 linalg,泛化为 linalg.generic,并沿生产者–消费者链进行融合,使每个程序恰好得到一个融合后的 linalg.generic,这就是调度器后续工作的单元。
第 2 步:能工作的最简流水线
接下来,调度器为每个程序赋予其第一条数据流流水线。它将融合后的泛型运算按照默认计算单元的 SIMD 宽度进行分块,该宽度从架构描述中读取(示例设备上为 64 条 fp16 通道),将每个生成的循环标记为 parallel_loop 或 reduction_loop,然后在最内层循环中构建一个三阶段 ktdf.pipeline,从内存加载到 FIFO、进行计算,再从 FIFO 存储回内存。
scf.for %i ... { scf.for %j ... {
  ktdf.pipeline {
    %p:6 = ktdf.private -> (!ktdf.fifo.slot<"DDR" -> "SFU", 64xf16>, !ktdf.fifo.slot<"DDR" -> "SFU", 64xf16>,
                            !ktdf.fifo.slot<"SFU" -> "DDR", 64xf16>, !ktdf.token, !ktdf.token, !ktdf.token) {...}
    ktdf.stage depends_in(none) depends_out(%p#3) {
      ktdf.data_transfer from %A[%i, %j] size [1, 64] to %p#0 size [1, 64] : ...
      ktdf.data_transfer from %B[%i, %j] size [1, 64] to %p#1 size [1, 64] : ...
    }
    ktdf.stage depends_in(%p#3) depends_out(%p#4) {
      %a = ktdf.read_from_fifo %p#0 : <"DDR" -> "SFU", 64xf16> -> tensor<1x64xf16>
      %b = ktdf.read_from_fifo %p#1 : <"DDR" -> "SFU", 64xf16> -> tensor<1x64xf16>
      %r = linalg.generic {...} ins(%a, %b : ...) outs(%e : tensor<1x64xf16>) {...}
      ktdf.write_to_fifo %r, %p#2 : tensor<1x64xf16>, <"SFU" -> "DDR", 64xf16>
    } {applicable_units = ["SFU"]}
    ktdf.stage depends_in(%p#4) depends_out(%p#5) {
      ktdf.data_transfer from %p#2 size [1, 64] to %C[%i, %j] size [1, 64] : ...
    }
  }
} {loop_type = #ktdf.loop_type<parallel_loop>} } {loop_type = #ktdf.loop_type<parallel_loop>}
(本节中的代码片段取自调度器的 lit 测试,这些测试使用一个示例架构,其内存称为 DDR 和 L1,计算单元称为 SFU。在 Spyre 上,相同的角色由设备内存、每个核心的暂存区及其计算流水线承担。)
这条流水线在功能上是完整的,但尚不合法,因为硬件中没有任何东西能通过 FIFO 将设备内存直接连接到计算引擎。修复这一点是下一组 pass 的首要任务。
第 3 步:路径扩展通过内存层次结构路由数据
路径扩展使用架构描述使数据移动合法化。它从设备构建一个路由图,以内存、执行单元和加载/存储单元为节点,以数据通路为边,然后对每条流水线,取三阶段版本所隐含的端点(例如设备内存 → 计算 → 设备内存),在每对相邻端点之间运行最短路径搜索,并将各跳拼接起来。只要实际路径比端点所暗示的更长,该 pass 就会重写流水线,为每个中间跳插入一个传输阶段,在暂存区中分配暂存缓冲区,重新指定 FIFO 的类型以使每个 FIFO 连接两个实际相邻的单元,并为每个阶段标记将执行它的单元类型。
在示例中,三个阶段变为五个:DMA 加载单元将 tile 带入暂存区,暂存区加载单元将其送入 FIFO,计算引擎消费并产生数据,暂存区存储单元排空结果 FIFO,DMA 存储单元将结果写回。
ktdf.pipeline {
  %p:10 = ktdf.private -> (memref<1x64xf16, "L1">, memref<1x64xf16, "L1">,
                           !ktdf.fifo.slot<"L1LU" -> "SFU", 64xf16>, ..., !ktdf.fifo.slot<"SFU" -> "L1SU", 64xf16>,
                           memref<1x64xf16, "L1">, !ktdf.token, ...) {...}
  ktdf.stage ... { ktdf.data_transfer from %A[%i, %j] ... to %p#0[0, 0] ... }  {applicable_units = ["MNILU"]} // DDR -> L1
  ktdf.stage ... { ktdf.data_transfer from %p#0[0, 0] ... to %p#2 ... }         {applicable_units = ["L1LU"]}  // L1 -> FIFO
  ktdf.stage ... { ... read_from_fifo ... linalg.generic ... write_to_fifo ... } {applicable_units = ["SFU"]}   // compute
  ktdf.stage ... { ktdf.data_transfer from %p#4 ... to %p#5[0, 0] ... }         {applicable_units = ["L1SU"]}  // FIFO -> L1
  ktdf.stage ... { ktdf.data_transfer from %p#5[0, 0] ... to %C[%i, %j] ... }  {applicable_units = ["MNISU"]} // L1 -> DDR
}
这也是 KTIR 中的放置信息开始发挥作用的地方。如果某个操作数已经是 ct_local 视图,意味着 Inductor 已将其固定在暂存区中,那么它到计算引擎的路径就从暂存区开始,路径扩展完全不会为它添加任何 DMA 阶段。流水线直接从暂存区到 FIFO 再到计算,张量永远不会经过设备内存的往返。换句话说,在 Inductor 中决定的驻留性在调度器中变成了流水线结构,中间不需要任何额外的机制。
还有几条后续的合法化处理补全了这套方案:间接地址缓冲区的填充通过一个填充单元实际可读的内存来分阶段完成,标量操作数被扩展到完整向量宽度,并作为硬件 splat 传输。
第 4 步:嵌套流水线,一次处理一级内存层次
路径展开之后,每个阶段仍然按每 64 元素向量运行一次。这合法,但浪费:DMA 引擎批量搬运数据最高效,而 scratchpad 的全部意义就在于让数据在计算需要之前就位。因此调度器将程序的循环嵌套重塑为流水线层次结构,每一层都以其所在内存层次适合的粒度运行。
它首先将并行循环切分为 tile 循环和 point 循环,但在 IR 中将每个 tile 大小保留为占位符(ktdf.tiling.reserve_size),并附带其约束,以便稍后选择大小本身。然后它确定哪些阶段必须同步推进,因为它们通过 FIFO 或寄存器通信,以及哪些不需要,比如只访问设备内存和 scratchpad 的 DMA 阶段。对 tile 的循环被下沉到这些组中。DMA 阶段变成将整个 tile 批量传输到 scratchpad 的单一操作,而 scratchpad 加载 → 计算 → scratchpad 存储链变成一个包含自身嵌套 ktdf.pipeline 的阶段。最终得到的是一个外层流水线,一次处理一个 tile,包裹着一个内层流水线,一次处理一个向量。
并非每个新流水线都是嵌套的。在循环迭代之间不发生变化的传输,例如沿该循环维度广播的操作数或常量缓冲区,会被提升到一个同级流水线中,在循环之前运行一次,而不是在每次迭代时重新获取相同数据。归约也以同样的思路重构:大型归约被分块以适配 scratchpad,外层部分变成带有携带累加器的显式循环,而最内层、stick 宽度的部分留给设备模式映射到硬件自身的归约支持上。
scf.for %m0 ... { scf.for %n0 ... {
  ktdf.pipeline {                                            // outer: tile granularity
    %p0:5 = ktdf.private -> (memref<2x1x64xf16, "L1">, ..., !ktdf.token, !ktdf.token) {...}
    ktdf.stage depends_in(none) depends_out(%p0#3) {         // bulk DDR -> L1 for the tile
      scf.for %m1 ... { scf.for %n1 ... { ktdf.data_transfer from %A[..] ... to %p0#0[..] ... } }
    }
    ktdf.stage depends_in(%p0#3) depends_out(%p0#4) {        // compute stage holds a pipeline
      scf.for %m1 ... { scf.for %n1 ... {
        ktdf.pipeline {                                      // inner: vector granularity
          ktdf.stage ... { ktdf.data_transfer from %p0#0[..] ... to %fifo_in ... }   // L1 -> FIFO
          ktdf.stage ... { ... linalg.add ... }                                      // compute
          ktdf.stage ... { ktdf.data_transfer from %fifo_out ... to %p0#2[..] ... }  // FIFO -> L1
        }
      } }
    }
    ktdf.stage depends_in(%p0#4) depends_out(none) {         // bulk L1 -> DDR
      scf.for %m1 ... { scf.for %n1 ... { ktdf.data_transfer from %p0#2[..] ... to %C[..] ... } }
    }
  }
} }
第 5 步:探索循环空间
流水线形状确定后,剩下的问题是它有多少部分同时运行。一个阶段写入、另一个阶段在循环内读取的 scratchpad 缓冲区采用双缓冲,因此流水线在两份副本之间轮转(modulo(size: 2)),DMA 阶段可以在计算仍在排空 tile N 时填充 tile N+1。这正是解耦设计所要提供的加载/计算重叠。然后工作被拆分到每个核心内的子核实例(corelet)上,围绕 corelet 本地流水线的并行循环变成 ktdf.parallel ... distribute(num_instances = N),N 取自架构描述。这在 Inductor 的 grid 已分配的每个核心内部提供了第二级并行性。只有在这之后才填充 tile 大小占位符,以便所选大小已经考虑了并行实例。
综合来看,这是一个真正的循环空间。循环结构、流水线粒度、缓冲深度、实例拆分和 tile 大小在 IR 中都是各自独立、显式的决策,每一项都受架构描述所允许的范围约束。不过我们想明确说明它目前的状况:在 V1 调度器中,这些选择是由局部启发式做出的,而不是通过搜索或成本模型。把每个选择都显式地保留在 IR 中(作为占位符、modulo 因子和 distribute 计数)是有意为之,这样以后就可以添加成本模型或自动调优器,而无需改动流水线的结构。
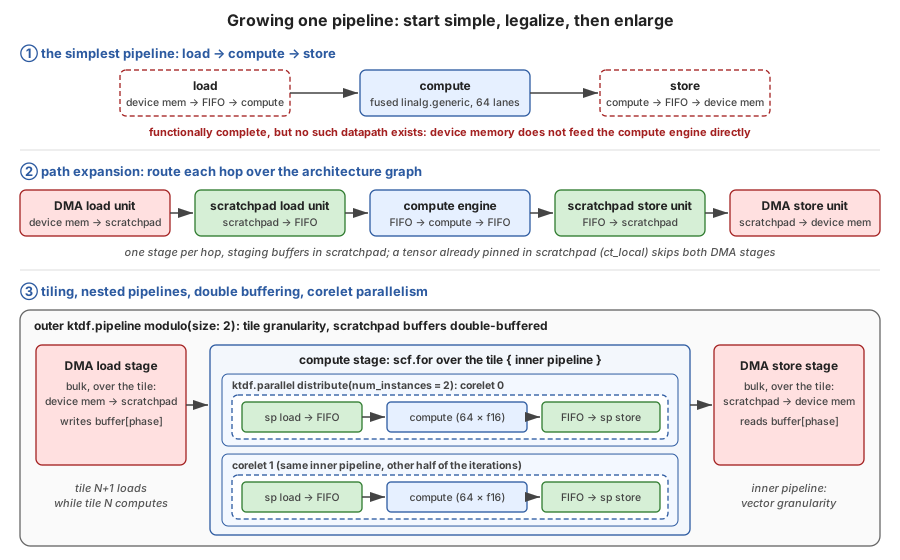 扩展一条流水线:从简单开始,合法化,然后扩大
第 6 步:地址、单元与 DataflowIR
最后一段把逻辑调度变成具体调度。每个缓冲区都在其内存中获得一个地址,并对照架构描述中的容量进行检查。Scratchpad 按程序分配,而设备内存分配则跨程序持续存在,因为一个程序正是这样把结果交给下一个程序的。然后为每个核心(以及在工作并行的每个 corelet)实例化抽象单元类型,token 依赖变成显式信号,每个程序被拆分为每种引擎一个 dataflow.program_unit,每个只保留在其上运行的那部分工作。在此过程中,传输变成地址生成和发送/接收操作,计算 tile id 变成按核心查找。每个程序最终都有两个层级:一个带有程序真实签名的外部函数,它声明其符号;以及一个内部的无参数函数,它持有 DataflowIR。
符号值,无论是张量地址还是张量形状,都能完整地通过这一切。以地址为例,由内核参数计算出的起始地址变成一个带 ID 的 symbol.create_symbol,而产生它的表达式(该参数加上此网格元素在张量中的份额,转换为该单元的地址粒度)则用 symbol.create_id 记录在上一层级。当不同网格元素从不同偏移开始时,每个元素都有自己的符号,通过按单元映射来选择。
// One level up: what each symbol is, as arithmetic over the kernel argument
func.func @local_schedule_0(%base: index) {
  symbol.create_id %base {symbol_id = -1}
  %w0 = arith.divsi %base, %c64 : index                   // grid element 0, in 64-byte words
  symbol.create_id %w0 {symbol_id = -2}
  %b1 = arith.addi %base, %c49152 : index                 // grid element 1: base + its slab
  %w1 = arith.divsi %b1, %c64 : index
  symbol.create_id %w1 {symbol_id = -3}
  call @local_schedule_0_body() : () -> ()
}
// The DataflowIR itself takes no arguments; it only names symbols.
%s0 = symbol.create_symbol {SymbolId = -2 : i64} : index
%s1 = symbol.create_symbol {SymbolId = -3 : i64} : index
%m  = uniform.def_immutable_mapping([%core0 -> %s0], [%core1 -> %s1]) : index
%a  = uniform.query_map(map: %m, key: %unit) : index
dataflow.get_logical_memory_view %ddr, %a ...
由此得到的符号表,每个符号都写成内核输入的表达式,就是运行时最终在启动时求值的内容。
DataflowIR 是交接点,由用 dataflow、vectorchain、agen、uniform、symbol 和 scf 方言构建的按引擎程序单元组成。开源调度器到此为止,它对后续环节的唯一义务是用这些方言发出有效的 DataflowIR,并带有稳定的程序单元标签。
从 DataflowIR 到 SpyreCode
其余阶段是设备特定的,因此我们只描述到足以将本文与运行时那篇文章连接起来的程度。
符号化 SpyreBinary 生成将每个程序的 DataflowIR 降级为 SpyreBinary:即在设备上配置并启动程序单元的二进制文件。任何依赖调用方张量的值,无论是张量地址还是张量形状,都作为符号保留在二进制文件中。用于运行时符号替换的元数据生成随后记录每个符号如何从内核输入计算得出。最后,SpyreCode 生成将 SpyreBinary 及其元数据与一个分两部分的作业计划打包在一起。
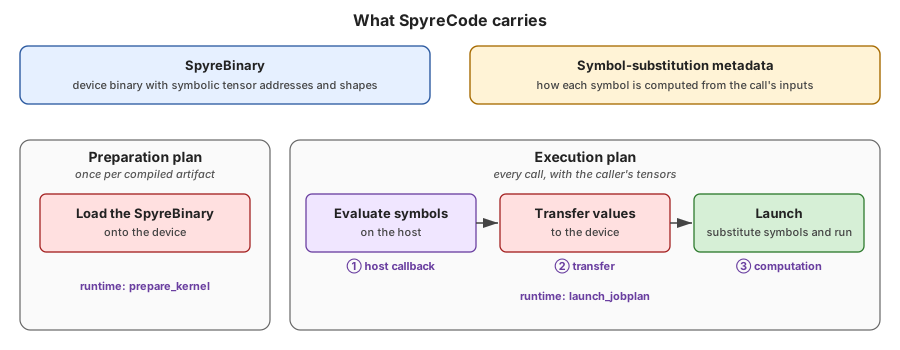 SpyreCode 携带的内容:一个符号化 SpyreBinary、其符号替换元数据,以及一个两阶段作业计划
这两部分与运行时文章在准备和启动之间划出的分界相对应。准备计划将 SpyreBinary 加载到设备上,不依赖调用的参数,因此运行时的 prepare_kernel 只运行它一次。执行计划在主机上针对实际的张量地址和形状求值符号,将解析后的值传输到设备,并启动计算,这正是运行时文章的三个启动时步骤,按顺序执行。launch_jobplan 在每次调用时都会走一遍,而地址和形状在编译时全部已知的内核只需要启动。
试一试
Dataflow Scheduler 基于上游 LLVM/MLIR 构建。README 给出了确切的 LLVM 修订版本以及构建方法。有了 MLIR 构建后,调度器只需几条命令:
git clone --recursive https://github.com/torch-spyre/dataflow-scheduler.git
cd dataflow-scheduler
cmake -S . -B build -G Ninja -DMLIR_DIR=$MLIR_INSTALL_PREFIX/lib/cmake/mlir
cmake --build build
一个很好的 hello world 是仓库测试中的简单逐元素加法,test/dataflow-scheduler-opt/ktir-to-dfir-sanity-check.mlir。它是一个小型、自包含的 KTIR 内核,与本帖前面的加法非常相似,分布在两个计算瓦片上,并面向上述示例设备。对其运行整个流水线会打印出它生成的 DataflowIR:
./build/bin/dataflow-scheduler-opt -ktir-to-dfir \
    test/dataflow-scheduler-opt/ktir-to-dfir-sanity-check.mlir
添加 --mlir-print-ir-after-all 会显示每个 pass 之后的 IR,这是观察程序拆分、三阶段流水线出现、路径扩展插入其跳转以及流水线嵌套的最简单方法。对于你自己的内核和设备,dataflow-scheduler 驱动程序直接接收架构描述,即 dataflow-scheduler -kEmitDFIR --device=<path-to-device.mlir> <kernel.mlir>,并将生成的 DataflowIR 写入文件。
结论
综合来看,这三篇文章描绘了一条从 torch.compile 一直到 Spyre 硅片的单一通路。Inductor 决定布局、瓦片划分、跨核的工作分配,以及哪些张量保持固定在暂存区中。KTIR 将这些决策记录在 MLIR 中,作为计算瓦片、显式内存、分布式视图、访问瓦片和 Spyre 内建函数,而不承诺任何数据流细节。随后 Dataflow Scheduler 让它们运行起来,将内核切分为程序、构建流水线、让每次传输经过内存层次结构,并对该流水线进行嵌套、缓冲和并行化,所有这些都由架构描述引导,而不是对某一芯片的硬编码知识。设备特定阶段将结果转换为 SpyreCode,即一个符号化的 SpyreBinary 加上一个两阶段作业计划,其张量地址和形状可以保持符号化直到启动,而运行时准备一次,并在每次调用时通过普通的 PyTorch 流启动它。
这条通路上的每个边界都是一个 IR,每个 IR 都陈述了下一阶段所需的事实:KTIR 中的放置、ScheduleIR 中的流水线、DataflowIR 中的每引擎程序,以及 SpyreCode 中的准备/执行拆分。将这些事实显式化,最终才使得数据流加速器能够置于 PyTorch 的普通接口之后。
Dataflow Scheduler 第 1 版已就绪。它能在多核 KTIR 程序中处理带有广播和归约维度的逐元素运算,并且已在具有代表性的 transformer 运算上完成了端到端验证,覆盖从 KTIR 到调度再到代码生成的完整流程。到目前为止,最明显的收益之一是启用一个算子所需的开发时间大幅减少:我们启用的第一个算子比在上一套技术栈上快约 4 倍,后续算子则快约 8 倍。同样的方法也让我们打通了来自 Inductor 和 Triton 两个前端的可用路径。接下来,我们正在完成 Dataflow Scheduler 中的矩阵乘法支持,并加入由成本模型驱动的性能优化,目标是端到端运行 LLM。
KTIR 和 Dataflow Scheduler 均已开源,上方的 Try it 部分是查看该流水线实际运行的最快方式。如果你正在为基于数据流或暂存器的加速器构建编译器,我们很乐意与你交流,因为这种架构描述方法旨在让调度器在 Spyre 之外也能广泛适用。
文章 From KTIR to SpyreCode: An MLIR Dataflow Backend for IBM Spyre 首次发表于 PyTorch。
来源:PyTorch Blog · pytorch.org