Salesforce 如何在 Amazon SageMaker AI 中用跨区域推理路由支撑全球模型服务
How Salesforce is advancing global-scale model serving with cross-Region inference routing in Amazon SageMaker AI
Salesforce 的 Agentforce Foundation 团队在 30+ 个全球 Region 为 Agentforce 等产品提供模型服务,通过 SageMaker AI 的跨区域推理路由把各 Region 和账号下已部署的端点注册到一次调用之后,本地端点无法承接的流量会转到其他 Region 的容量上。
感谢 Salesforce 的 AI/ML 高级总监 Amit Gupta 和软件工程 PMTS Mark Wang,感谢你们在 SageMaker AI 上跨区域推理路由的愿景与合作中所做的贡献。
Salesforce 的 Agentforce Foundation 团队为 Salesforce 旗下各类产品(包括 Agentforce 和 Salesforce Trust Layer)在 30 多个全球区域提供多种模型服务。这些模型既包括内部训练的模型,也包括开源模型。在每个区域分别托管模型会分割容量,使流量高峰更难被吸收,从而将容量短缺转变为可用性问题。
本文介绍 Salesforce 如何在 SageMaker AI 中设置跨区域推理路由,以及该机制如何让团队在遵守数据驻留承诺的同时安全地增加容量。文章还详细说明了 Salesforce 如何查看每个请求在何处被服务以及原因。跨区域推理路由为应用程序提供了一条跨多个区域和账户中 SageMaker AI 端点的统一调用路径,并将每个请求发送到能够为其提供服务的端点。这些端点都是 Salesforce 自有且已部署的端点。本文首先介绍 Salesforce 面临的容量问题,解释路由器的工作原理以及 Salesforce 如何将其集成到内部网关中,然后通过一个示例设置进行演示,最后描述团队的观察结果。
为什么服务这些模型使容量成为可靠性问题
Salesforce 的 Agentforce Foundation 团队从客户请求来源的区域为其提供服务,覆盖 30 多个全球区域和数百个 AWS 账户,并根据每个客户的流量来配置容量。每个客户都有自己的高峰时段,而这些时段经常重叠。为重叠的高峰配置容量是安全的选择,但成本太高。客户还会在短时间内引入新的业务部门,因此必须快速扩展资源池。逐区域快速增加容量会导致 Salesforce 面临容量碎片化:一些区域有空闲实例,而另一些区域则容量耗尽。
在 SageMaker AI 的跨区域推理路由出现之前,Salesforce 使用其内部网关将本地端点无法处理的流量发送到其他区域。该团队构建并运营了这条路径,并辅以基本的健康检查、重试和区域切换逻辑。这种方法存在两个缺陷。首先,网关没有来自本地或远程端点的容量信号,因此无法判断何时转移流量或目标区域是否有余量。其次,跨区域流量必须通过 NAT 网关和互联网网关离开虚拟私有云(VPC),并通过公共 AWS 网络传输。在设计评审中,团队还提出了级联故障的风险:在事件期间转移流量可能会使下一个区域过载,因此 Salesforce 需要对跨区域流量设置上限。
在每个应用程序中单独构建此逻辑无法在 Salesforce 范围内扩展。团队需要一条托管的、具备容量感知能力的路由路径。
推理路由器的作用
推理路由器是您账户中的一项区域 SageMaker AI 资源。您的应用程序调用路由器而不是端点,并传入一个路由目标名称,其请求体和内容类型与它今天发送到 InvokeEndpoint 的相同。路由目标是您为一个逻辑模型(例如毒性分类器)选择的名称,它按完整的 Amazon Resource Name(ARN)列出可为该模型提供服务的端点和推理组件。一个路由器为每个模型保留一个路由目标,某个模型的端点出现问题不会转移其他模型的流量。一个路由目标可以混合使用单模型端点和推理组件。
由于每个目标都以其 ARN 命名,因此它可以位于另一个区域或另一个 AWS 账户中。拥有端点的账户通过基于资源的端点策略授予访问权限,该策略允许一个指定的路由器调用它,Salesforce 就是这样运行的。
路由器优先选择其所在区域,只要本地目标成功提供服务,请求就会留在那里。路由器根据近期请求的结果来评判每个目标。平台故障、来自模型容器的 5xx 错误、限流和超时会降低目标的健康度。随着这些问题持续存在,路由器会将越来越多的新请求转移到健康的目标,通常在大约一分钟内开始。对于流量很少的目标,可能需要几分钟。扩缩容进度和实例启动失败等信号会影响路由器在错误出现后的响应速度,但它们本身不会转移流量。恢复后,流量会在几分钟内返回,比离开时更慢,因此不会来回摆动。当目标未运行模型就使请求失败时(例如对其限流),路由器会在另一个目标上重试该请求一次。
无效输入等客户端错误不会转移流量,因为它们在任何区域都会以相同方式失败。模型延迟也不会转移流量,因为响应缓慢通常反映的是提示或输出较长,本身并不意味着端点不健康。路由器也不会部署模型、复制构件或添加实例。它使用您已部署的容量,而每个端点自身的自动扩缩容会随着其流量增长而继续添加实例。
Salesforce 如何将路由器集成到其 Internal Gateway 中
在 Salesforce 的 Internal Gateway 中,路由器调用所处的位置正是过去直接调用 InvokeEndpoint 的位置:在每请求的出站路径中,位于数据驻留检查之后、响应处理之前。该检查是网关保留的唯一路由决策。带有驻留要求的请求会被固定到其区域内的路由目标,该目标的唯一目的地是本地端点,因此它永远不会跨边界故障转移。其他所有请求都会以网关原本发送的相同请求体、内容类型和接受类型发送到路由器。容量感知、健康评估和故障转移现在位于路由层,而不是 Salesforce 的代码中。
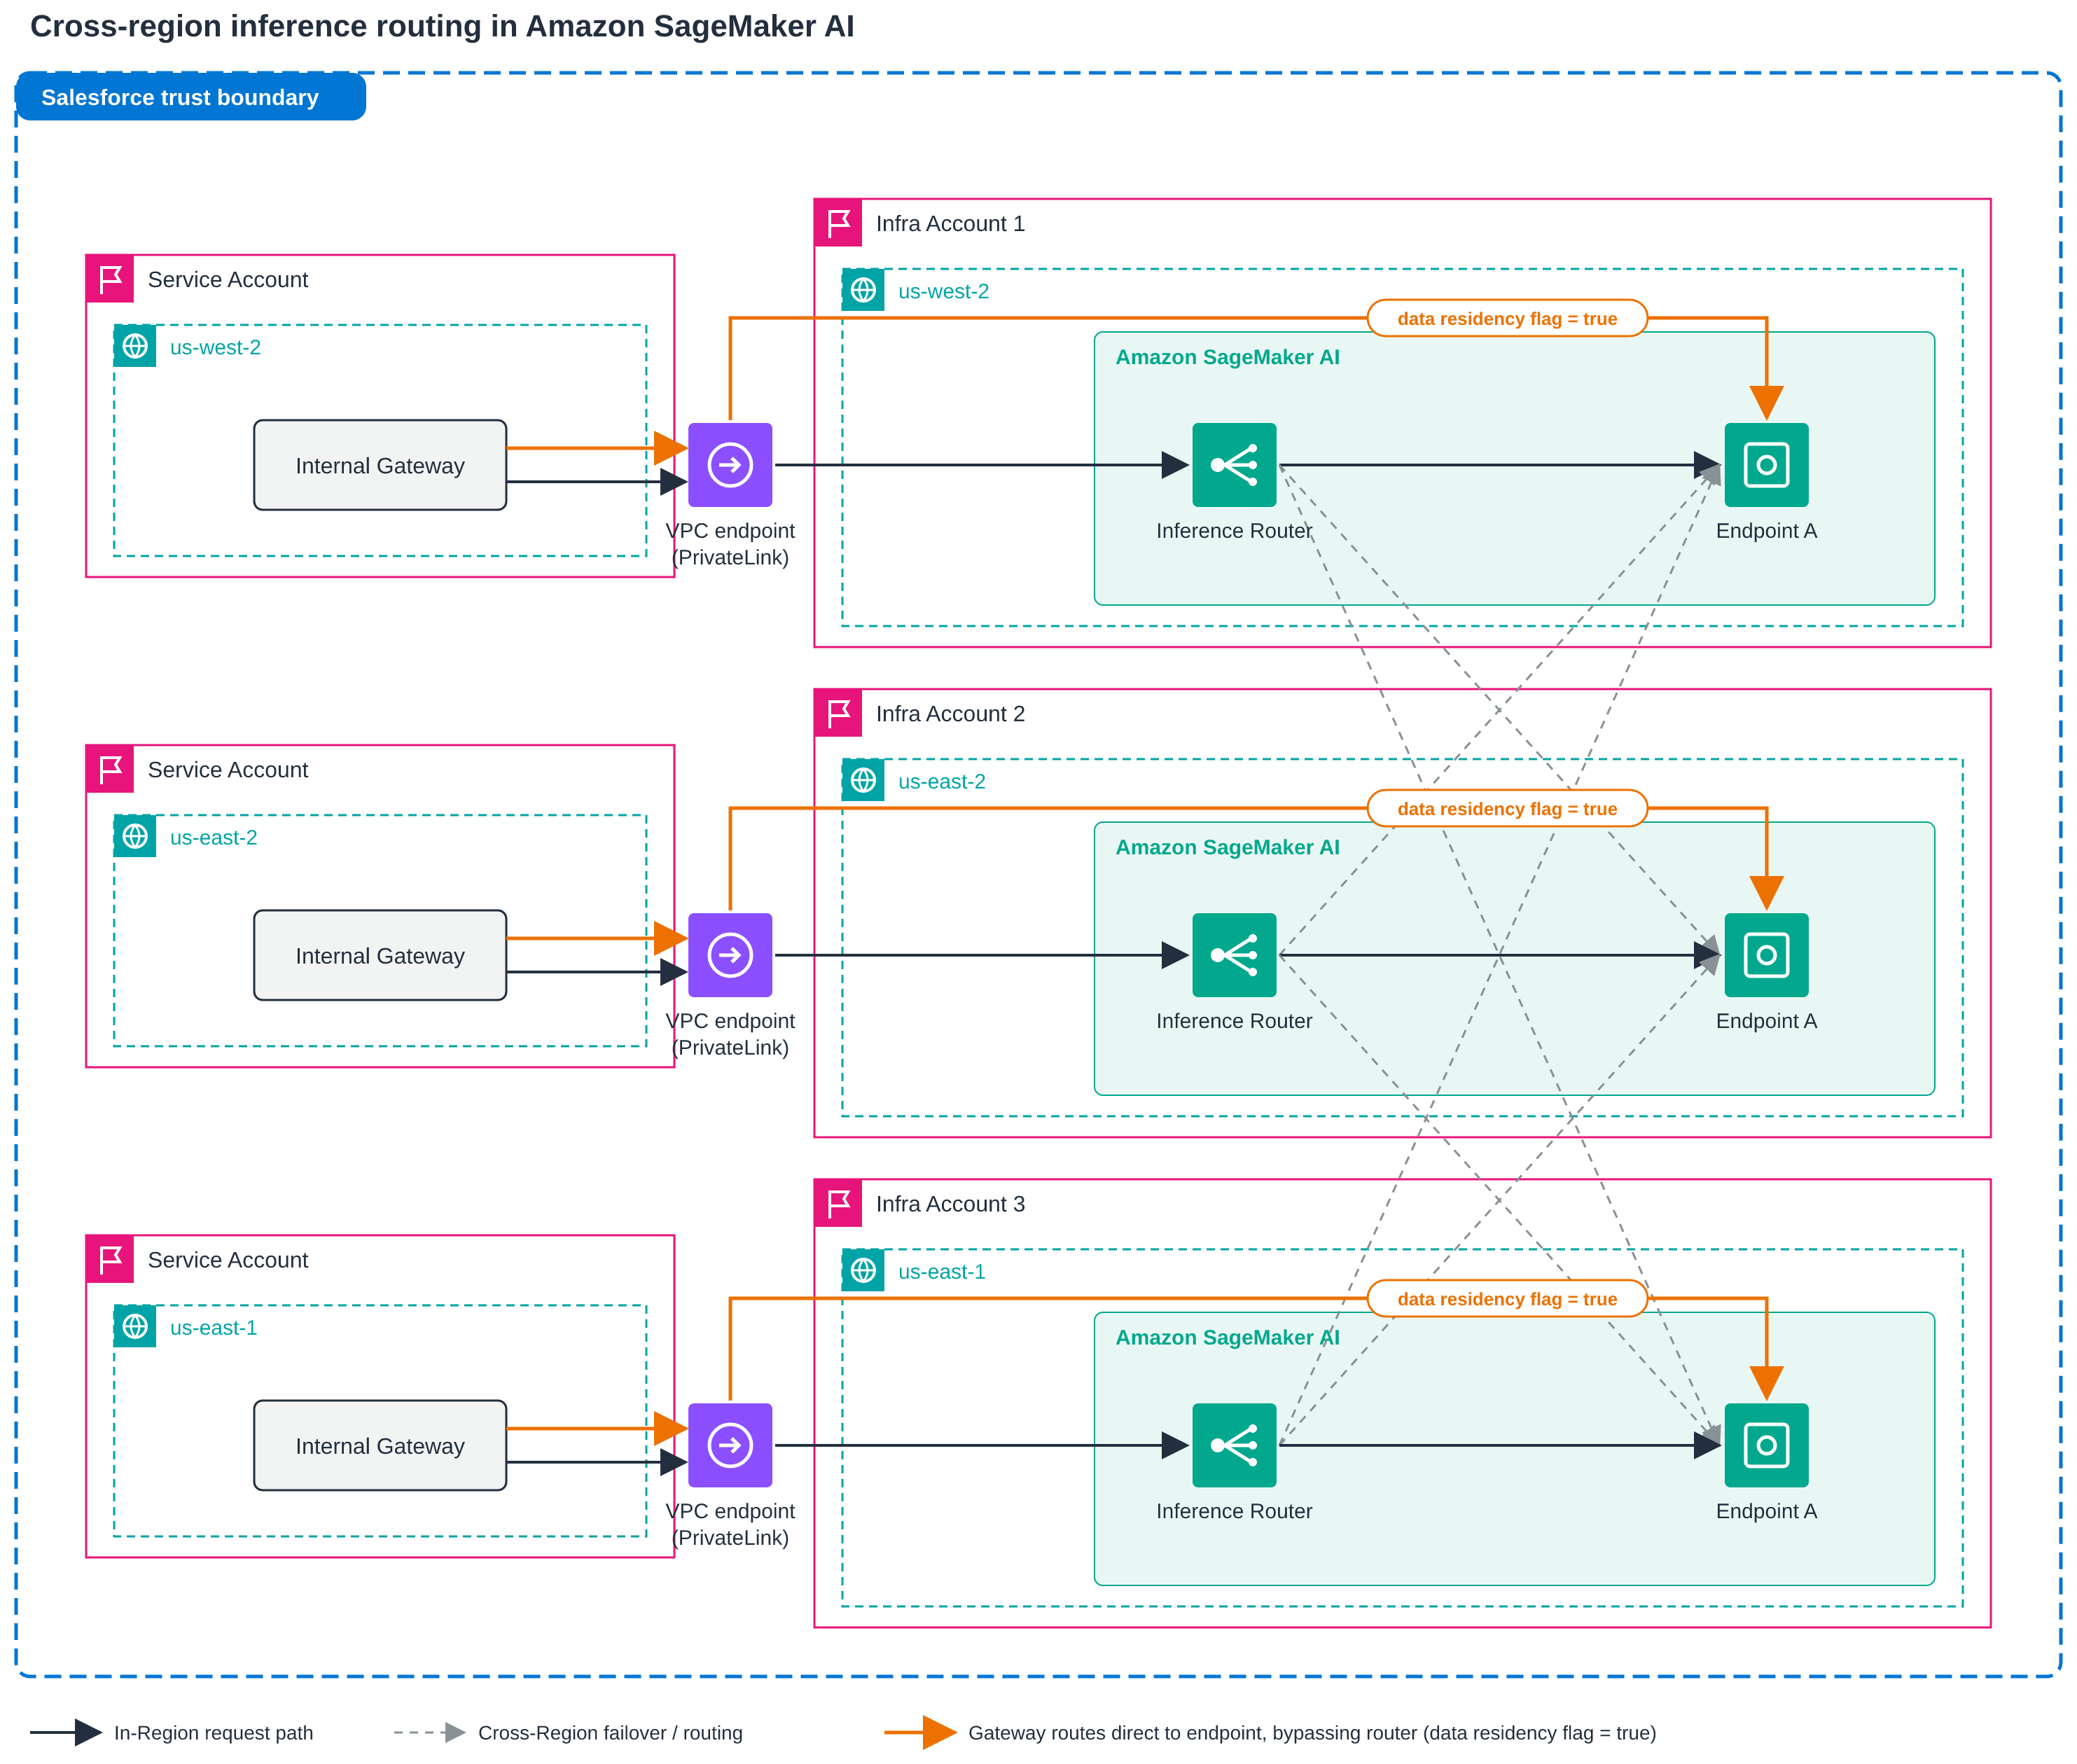
图 1:Salesforce 跨 Region 推理路由的端到端架构。在每个 Region 中,Internal Gateway 通过 VPC 端点(AWS PrivateLink)发送客户端请求。数据驻留标志设为 true 的请求直接发往本 Region 的 Endpoint A,绝不会离开其所在 Region。所有其他请求发往本地推理路由器,该路由器默认将流量发送到本地 Endpoint A,当本地端点出现容量受限迹象时,故障转移到另一个 Region 的 Endpoint A
Salesforce 将每个响应上的两个路由字段视为一等遥测数据。网关将 InvokedRoutedResourceArn 和 RoutingReason 与现有的请求 ID 和跟踪 ID 记录在同一结构化日志行中,并将它们作为应用性能监控(APM)标签发出。由于 ARN 携带 Region 和账户信息,单条日志行即可显示请求是在本地运行还是跨越了边界,以及原因:local-preferred、failover、capacity-available 或 only-healthy。团队在调查流量变化时,会将这些字段与路由器的 Amazon CloudWatch 指标进行关联分析。
网关的超时设置考虑了跨 Region 往返延迟,因此发生故障转移的请求有足够时间在远程 Region 完成。由于路由器已在另一个目标上重试一次,网关自身不再添加重试,从而避免在故障期间尝试次数成倍增加。
示例设置
以下演练展示了 Salesforce 测试过的配置,使用示例 ID 和名称。Salesforce 首先在美国西部(俄勒冈)Region(us-west-2)创建了一个带有本地目标的路由器,并确认请求被路由到该目标。随后,团队注册了一个位于美国东部(俄亥俄)Region(us-east-2)、由不同账户拥有的端点,移除了本地目标,并确认请求跨越账户和 Region 边界到达了远程端点。在示例中,路由器账户为 111122223333,拥有 us-east-2 端点的账户为 444455556666。
在目标端点上授权路由器
在拥有 us-east-2 端点的账户中,所有者附加一个基于资源的策略,允许路由器账户调用该端点,并附带条件将访问限制为一个指定的路由器。路由器尚不需要存在,因此可以使用你计划创建的路由器的 ARN。
{
  "Version": "2012-10-17",
  "Statement": [{
    "Sid": "AllowInferenceRouter",
    "Effect": "Allow",
    "Principal": {"AWS": "arn:aws:iam::111122223333:root"},
    "Action": "sagemaker:InvokeEndpoint",
    "Resource": "arn:aws:sagemaker:us-east-2:444455556666:endpoint/example-toxicity-use2",
    "Condition": {"ArnEquals": {"sagemaker:SourceInferenceRouterArn":
      "arn:aws:sagemaker:us-west-2:111122223333:inference-router/example-agent-router"}}
  }]
}
# Run in account 444455556666, in the endpoint's Region
aws sagemaker put-endpoint-policy \
--endpoint-name example-toxicity-use2 \
--resource-policy file://policy.json \
--region us-east-2sagemaker:SourceInferenceRouterArn 条件意味着路由器账户只能通过该路由器访问端点。端点所有者可随时使用 delete-endpoint-policy 撤销访问权限。
创建路由器
在路由器账户中,在 us-west-2 创建路由器,并配置一个路由目标,按 ARN 列出两个目标。
import boto3

ir = boto3.client("sagemaker", region_name="us-west-2")

response = ir.create_inference_router(
    InferenceRouterName="example-agent-router",
    RoutingTargets=[
        {
            "Name": "toxicity-detection",
            "Destinations": [
                {"ResourceArn": "arn:aws:sagemaker:us-west-2:111122223333:endpoint/example-toxicity-usw2"},
                {"ResourceArn": "arn:aws:sagemaker:us-east-2:444455556666:endpoint/example-toxicity-use2"},
            ],
        }
    ],
)
print(response["InferenceRouterArn"])
每个额外模型都会成为 RoutingTargets 中的另一个条目。
确认每个目标均可路由
在发送流量之前,调用 DescribeInferenceRouter 并检查每个目标的 RoutingStatus。Routable 表示 SageMaker AI 可以读取该目标且其可以处理流量。Unroutable 表示目标已被读取但当前无法处理流量,例如因为端点未处于 InService 状态。Unknown 表示 SageMaker AI 无法使用你的凭证读取目标,例如因为你缺少 sagemaker:DescribeEndpoint(对于推理组件则为 sagemaker:DescribeInferenceComponent),或者对于另一个账户中的目标,因为其端点策略未授予 Describe 权限。
desc = ir.describe_inference_router(InferenceRouterName="example-agent-router")
for target in desc["RoutingTargets"]:
    for dest in target["Destinations"]:
        print(target["Name"], dest["ResourceArn"], dest["RoutingStatus"])
调用路由器而非端点
调用代码的改动很小。请求体、内容类型和接受类型保持原样不变。客户端和操作发生变化,端点名称被路由器名称和路由目标名称取代。
import json
import boto3

payload = json.dumps({"inputs": "Example input"})

# Before: call one endpoint directly
smr = boto3.client("sagemaker-runtime", region_name="us-west-2")
resp = smr.invoke_endpoint(
    EndpointName="example-toxicity-usw2",
    ContentType="application/json",
    Body=payload,
)

# After: call the router
rt = boto3.client("sagemaker-inference-router-runtime", region_name="us-west-2")
resp = rt.invoke_inference_router(
    InferenceRouterName="example-agent-router",
    RoutingTargetName="toxicity-detection",
    ContentType="application/json",
    Body=payload,
)

print("Served by:", resp["InvokedRoutedResourceArn"])
print("Reason:   ", resp["RoutingReason"])
print("Output:   ", resp["Body"].read().decode())
InferenceId 和 CustomAttributes 会像 InvokeEndpoint 一样传递到目标,因此 trace ID 等标识符会随请求一起传递。TargetVariant 和 InferenceComponentName 等成员不会被使用,因为路由目标会取代它们。
查看请求的去向
大多数评估路由层的团队首先会问如何判断它做了什么。推理路由器会在每个响应中以及 Amazon CloudWatch 中给出答案。每个响应都会在 InvokedRoutedResourceArn 和 RoutingReason 字段中,以及对应的 X-Amzn-SageMaker-Invoked-Routed-Resource-Arn 和 X-Amzn-SageMaker-Invoked-Routing-Reason 标头中,携带为其提供服务的目标的 ARN 以及路由原因。由于 ARN 包含区域和账户,将这两个值与您自己的请求日志一起记录,就能获得每次请求的记录,说明每次调用是在本地运行还是跨越了边界。
路由原因取四个值之一。local-preferred 表示路由器所在区域中一个健康的目标处理了该请求。failover 表示路由器所在区域中存在一个目标,但其服务不可靠,因此路由器将请求发送到了其他地方。capacity-available 表示路由器所在区域中没有目标能够接收该请求,请求被发送到了其他区域中多个健康目标之一。only-healthy 表示它由唯一符合条件的健康目标提供服务。
在聚合层面,路由器会在其自己的账户和区域中向 CloudWatch 发布 OpenTelemetry 指标,每个指标都携带路由器名称和目标 ARN,因此可以从一个地方看到跨区域的全貌。aws.sagemaker.inference_router.invocations 统计每个目标的请求数,其 error.type 属性将失败分为 invocation_4xx、invocation_5xx(包括超时)以及针对模型返回错误的 invocation_model_error。
aws.sagemaker.inference_router.destination.duration 衡量每个目标所花费的时间,aws.sagemaker.inference_router.overhead.duration 衡量路由器增加的时间,包括往返远程区域的网络时间。aws.sagemaker.inference_router.destination.status 将每个目标的健康状态报告为 healthy、overloaded 或 degraded。您可以在 CloudWatch Query Studio 中使用 PromQL 查询这些指标,并可以将它们与每个端点现有的 SageMaker AI 指标一起放在跨账户、跨区域的仪表板上。
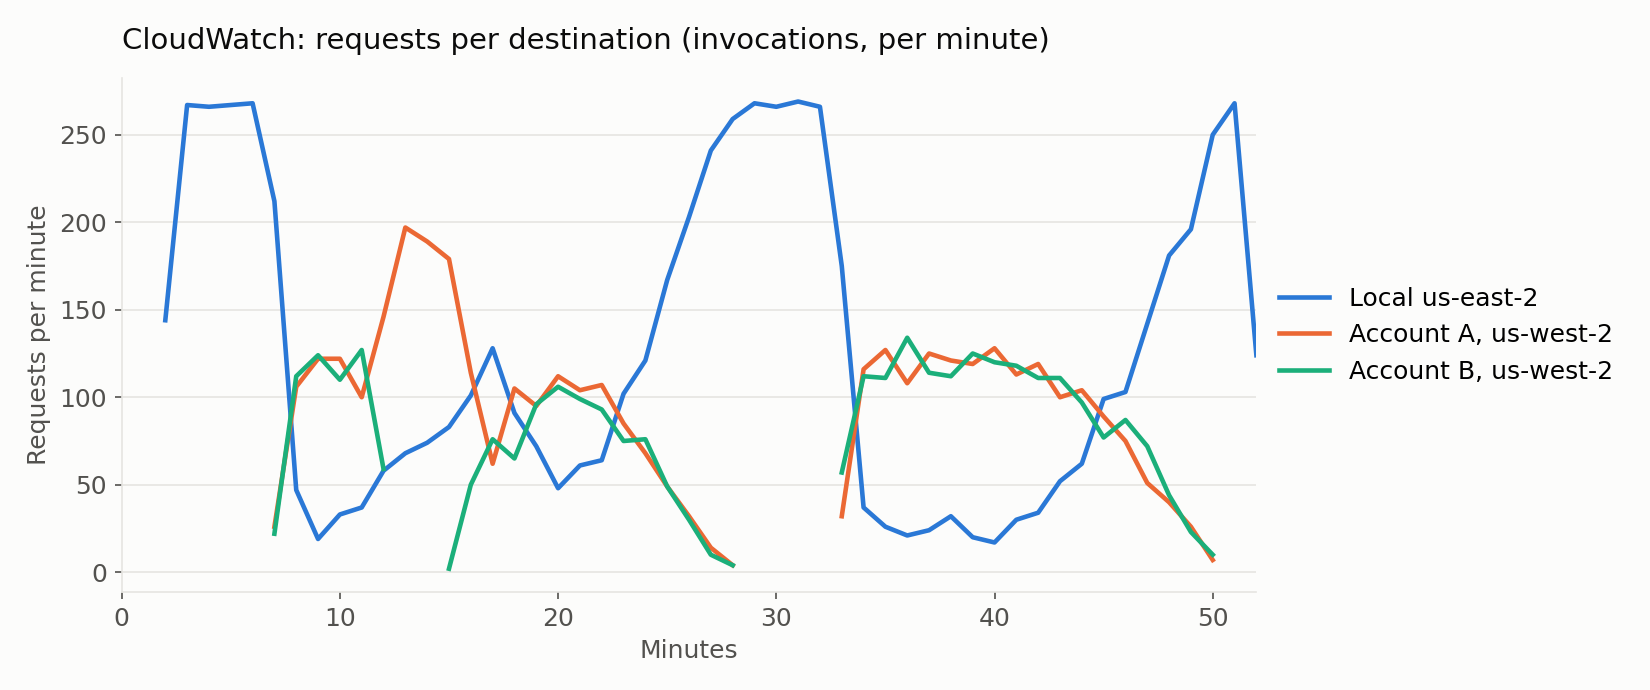
图 2:AWS 使用测试模型进行故障转移测试期间的 CloudWatch 仪表板。随着本地目标降级,每个目标的请求数从本地 us-east-2 端点转移到 us-west-2 中的端点,然后在恢复后逐渐返回
跨账户和跨区域测试故障转移
Salesforce 在两种配置中测试了路由器。第一种是 us-west-2 中的同区域路由,其中 Internal Gateway 调用本地推理路由器,路由器将请求发送到本地 Endpoint A。第二种是跨账户、跨区域路由,其中 us-west-2 中的路由器还列出了一个由独立基础设施账户拥有的 us-east-2 端点。在发送流量之前,团队调用了 DescribeInferenceRouter,并确认路由目标列出了两个目标,且两者都报告 RoutingStatus 为 Routable。随后发送到路由器的请求由本地端点提供服务,路由原因为 local-preferred。设置几乎不费力气:端点所有者添加了针对路由器账户的端点策略,路由器调用取代了网关出口路径中直接的 InvokeEndpoint 调用,请求体、内容类型和接受类型均相同。
为了测试故障转移,团队持续向 us-west-2 的本地端点灌入流量直至其饱和,同时另一个探针持续调用路由器,并记录每个请求由哪个区域处理以及耗时。在约五分钟的饱和期间,探针的 p50 延迟从 0.2 秒升至 45 至 58 秒,而流量仍留在 us-west-2。这是预期行为,因为仅凭延迟并不会转移流量。当请求开始超过模型容器的 60 秒处理超时并返回错误时,路由器开始转移流量。首批请求在首次出现错误约两分钟后到达 us-east-2,再过约一分钟,约 78% 的探针流量由 us-east-2 处理。其余 20% 至 25% 的流量留在本地,以便路由器检测恢复情况。
流量转移后,p50 延迟恢复到 0.2 秒,跨区域路径在 p50 上增加的延迟不到 100 毫秒。本地端点恢复后,流量在约 10 分钟内逐步回到 us-west-2,探针在故障转移和故障恢复期间均未记录到错误。每个响应上的 InvokedRoutedResourceArn 和 RoutingReason 字段,加上 CloudWatch 中路由器按目标统计的调用指标,无需任何额外埋点即可呈现整个过程。
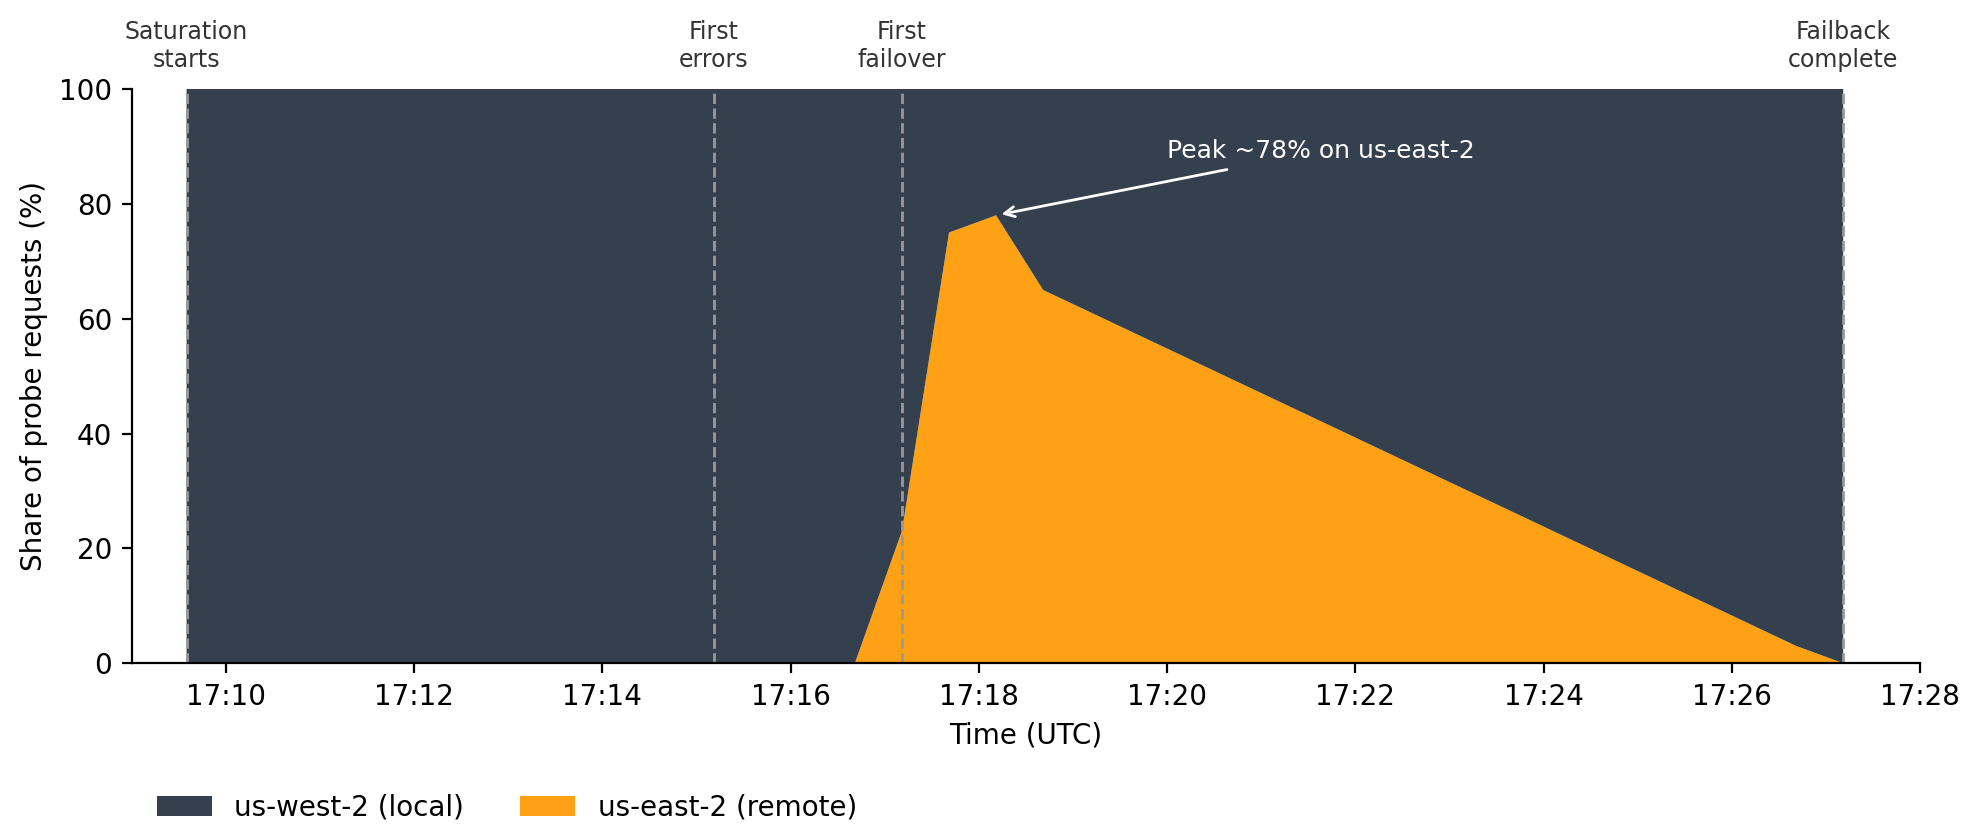
图 3:Salesforce 故障转移测试期间按区域划分的探针请求占比(UTC)。本地端点饱和时流量留在 us-west-2,请求开始返回错误后流量转向 us-east-2(峰值约 78%),恢复后流量在约 10 分钟内逐步回到 us-west-2
路由器让 Salesforce 得以替换团队过去自行构建和运行的运维逻辑:Internal Gateway 中的健康检查、重试和区域切换逻辑。容量信号和故障转移现在位于路由层,而非每个应用之中。
在更广泛采用之前,Salesforce 计划在本地端点保持饱和更长时间的情况下重复故障转移测试,以毫秒精度测量跨区域延迟,评估在跨区域上限下的级联区域行为,并将路由器推广到更多区域。
“借助 Amazon SageMaker AI 中新的跨区域推理路由,我们可以安全地增加容量,同时遵守数据驻留承诺。必须留在某个区域的工作负载就留在那里,只有符合条件的流量才能由其他区域处理。一次托管调用即可与我们现有的故障转移逻辑协同工作,因此我们无需重新架构应用或更改负载。SageMaker AI 负责路由、健康检测和回退,客户数据始终留在 Salesforce 信任边界内。我们决定哪些区域符合条件,并通过我们自有的端点策略控制访问。由于推理路由器可与 Amazon CloudWatch 和 AWS CloudTrail 配合使用,我们还为工作负载获得了完整的可观测性、成本跟踪和治理架构。”
— Richard Chang,Salesforce 软件工程架构师
最佳实践与注意事项
在你注册的每个区域中保持相同的模型、容器镜像和构件可用,因为路由器不会复制它们,而运行不同模型版本的目标会对同一请求返回不同的答案。
为每个目标区域按其自身流量加上你预期发送给它的溢出流量来规划容量。路由器不会创造容量,如果所有符合条件的目标都繁忙,你的应用程序会收到目标自身的错误。按照你目前的方式在每个目标上配置自动扩缩容,并留出足够的余量,使接收端点在来自其他区域的流量到达时能够按照自身策略横向扩展。
客户可以在接收端点的配置中(CrossRegionTrafficConfig)设置上限,即每实例请求速率以及远程流量可使用的端点容量最大份额。本地流量从不计入该上限。当远程流量达到上限时,端点停止接受来自其他区域的额外请求,路由器会将这些请求发送到其他目标,从而让本地调用方保留其容量。该上限适用于实时端点。
结论
Salesforce 在 30 多个全球区域为公司各产品提供多种模型,而在每个区域分别托管这些模型已将容量短缺变成了可用性问题。借助推理路由器,Salesforce 注册其已在不同区域运行的端点,并在一次调用背后关联多个账户,因此本地端点无法处理的流量会到达其他地方的容量,而不是失败。必须留在某个区域的请求会留在那里,端点所有者通过其控制的策略授权跨账户访问,并且每个响应都会显示请求在哪里运行以及原因。SageMaker AI 负责路由、健康评估以及恢复后逐步恢复流量,而不是让每个调用应用程序自行构建该逻辑。这使 Salesforce 能够在保持数据驻留承诺的同时安全地增加容量。
Amazon SageMaker AI 中的跨区域推理路由将于 2026 年 11 月 18 日正式可用,适用于所有支持实时端点推理的商业区域。要开始使用,请参阅 Amazon SageMaker AI 开发人员指南中的推理路由器文档和CreateInferenceRouter API 参考。
关于作者

Apoorva Chandra
Apoorva 是 Amazon SageMaker AI 推理团队的产品经理,专注于端点体验和托管体验。她与在生产中部署生成式 AI 模型的客户合作,使加速计算更易获取、运行更具成本效益、运营更可预测。工作之余,Apoorva 喜欢徒步、探索咖啡馆以及与朋友共度时光。

Hrushikesh Gangur
Hrushikesh 是 AWS 驻加利福尼亚州旧金山的首席解决方案架构师。他专攻生成式和代理式 AI 技术,帮助初创公司和 ISV 构建和部署 AI 应用程序。

Deepti Ragha
Deepti 是 Amazon SageMaker AI 团队的高级软件开发工程师,专攻机器学习(ML)推理基础设施和模型托管优化。她构建的功能可提升部署性能、可用性并降低推理成本,让各种规模的组织都能使用 ML。工作之余,她喜欢旅行、徒步和园艺。

Richard Chang
Richard 是 Salesforce 的软件架构师,负责领导公司级 AI 模型推理、训练和代理式运行时平台的设计与开发,在 Salesforce 的全球基础设施中提供可扩展且可靠的 AI 能力。

Scott Chang
Scott 是 Salesforce AI 云基础设施团队的首席工程师,负责构建支撑 Salesforce Agentforce 产品的 Amazon Bedrock 基础。Scott 的工作涵盖模型路由、跨账户访问以及大规模大语言模型(LLM)工作负载的可观测性。在转向 AI 基础设施之前,Scott 曾多年为全球企业设计和运营数据中心与云网络。
来源:AWS Machine Learning Blog · aws.amazon.com