vLLM 推出基于 push 的 KV 传输,提升分离式推理的 TTFT 与 TPOT
Push-based KV transfer to improve TTFT and TPOT for disaggregated inference in vLLM
vLLM 新增 push-based NIXL connector,把 prefill 后的传输协调与准备工作移出关键路径,从而降低 TTFT 并提升 TPOT。
vLLM 是一个面向大语言模型(LLM)的开源推理与服务引擎。LLM 推理包含两个不同阶段:prefill(预填充),处理输入提示并构建键值(KV)缓存;以及 decode(解码),利用该缓存逐个 token 生成输出。这两个阶段在计算、内存和扩展特性上各不相同。Prefill-decode(P-D)分离 将它们运行在独立的引擎实例上,使每个阶段都能独立扩展和优化。这可以在负载下提升资源利用率、吞吐量和延迟。然而,它也要求在 token 生成开始之前,将 KV 缓存从 prefill 实例传输到 decode 实例,因此高效的 KV 传输对首 token 延迟(TTFT)至关重要。
vLLM 执行这种传输的方式之一是通过 NVIDIA Inference Xfer Library(NIXL)连接器,它在支持远程直接内存访问(RDMA)的互连上移动 KV 块,例如 AWS Elastic Fabric Adapter(AWS EFA,即 AWS 中跨服务器使用的低延迟 RDMA 网络)。在受支持的实例类型上,AWS EFA 支持 GPUDirect RDMA 和 Neuron Direct RDMA。因此,NIXL 可以直接在 GPU 或 AWS Trainium 设备内存之间传输 KV 块,而无需经由主机内存中转。NIXL 连接器的默认模式是拉取式(pull-based):prefill 实例完成提示 KV 缓存的计算后,路由器将源元数据(包括 prefill 块 ID)转发给 decode 实例。随后 decode 实例分配目标块、准备 NIXL 传输,并发起 NIXL READ 从 prefill 实例拉取 KV 块。由于这些协调和设置步骤在 prefill 之后、解码开始之前串行发生,它们延长了 TTFT 关键路径,如下图所示。
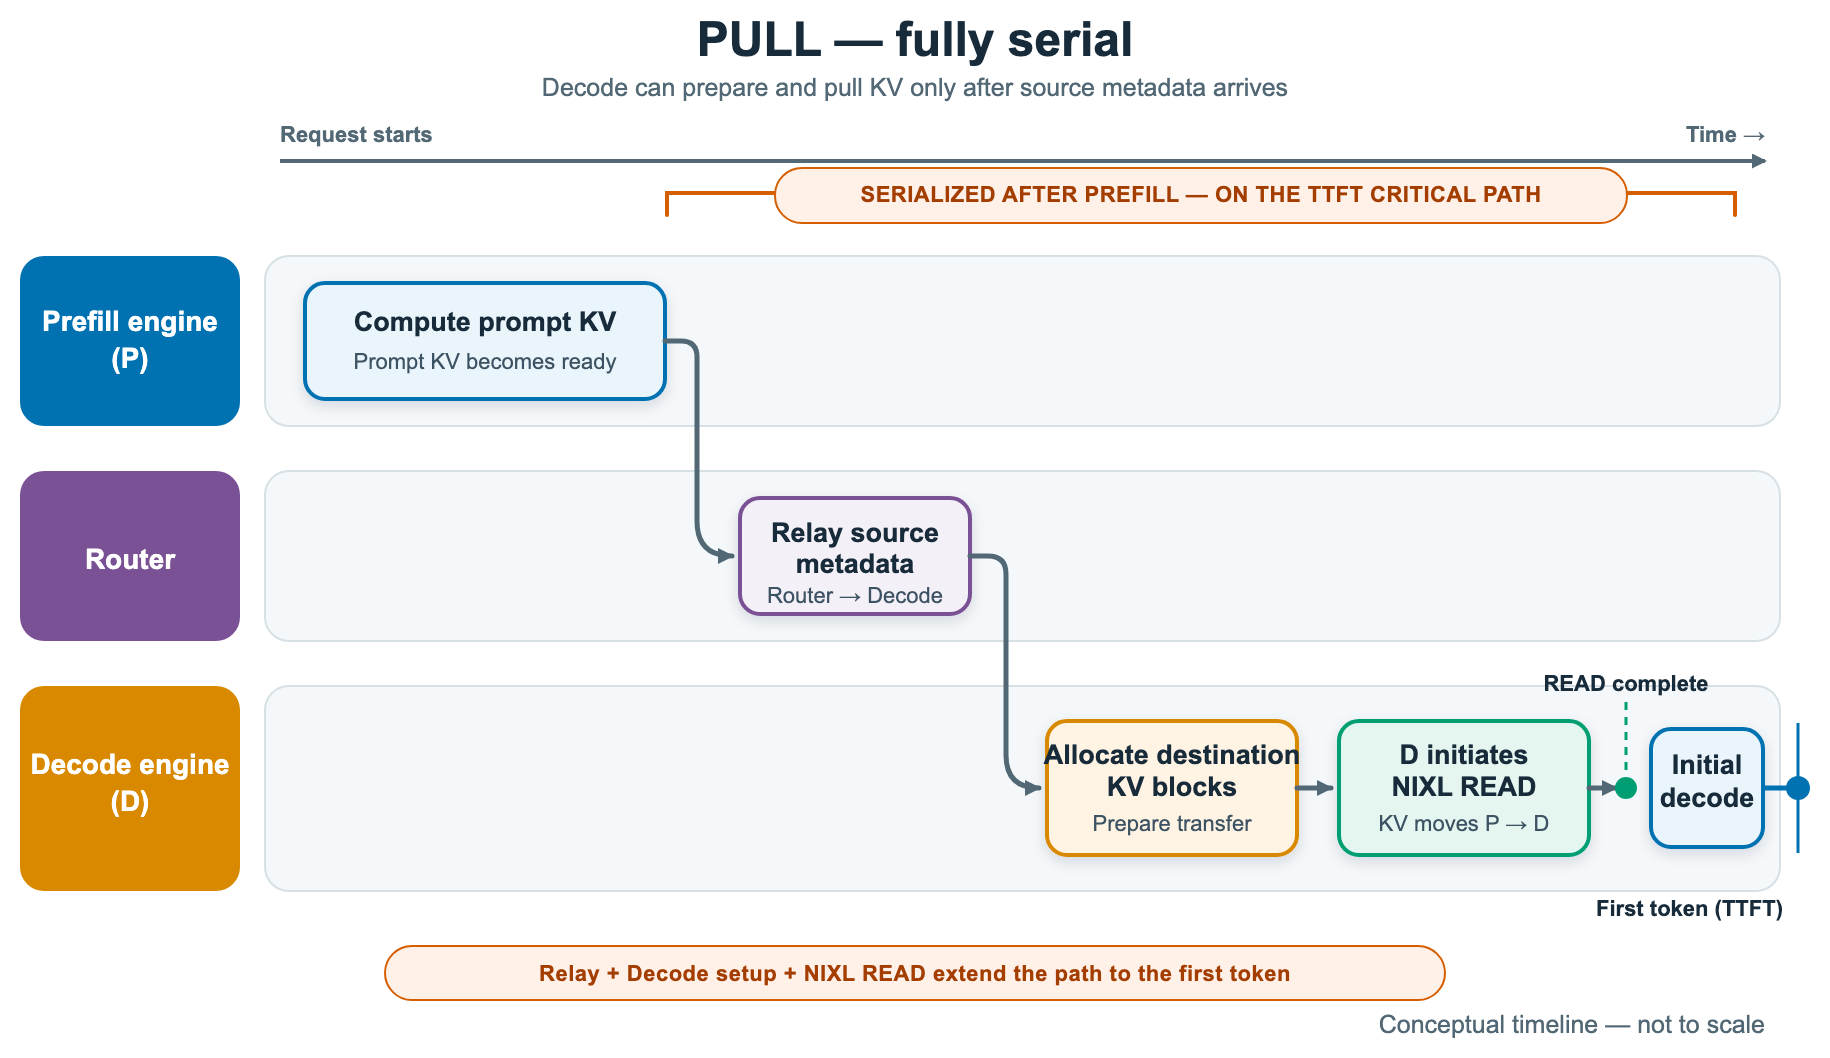
图 1:拉取模式下的 KV 传输时间线,其中路由器转发、decode 侧分配和 NIXL READ 在通往首 token 的路径上串行执行
本文介绍一种推送式(push-based) NIXL 连接器,它将 prefill 之后的传输协调和设置移出关键路径。如果你使用 vLLM 运行分离式 prefill/decode 推理,推送模式可以通过降低 TTFT 和 TPOT 来提升应用响应性,尤其在高请求速率下。
在我们使用通过 EFA 连接的 Amazon Elastic Compute Cloud(Amazon EC2)P5en 实例、采用 1P1D 部署的基准测试中,对于 Qwen3-32B 模型,推送模式相比拉取模式实现了最高 3 倍的 TTFT 提升和最高 30% 的每输出 token 时间(TPOT)提升(见性能数据部分)。结果取决于工作负载和配置。
我们在通过 EFA 连接的 AWS Trainium 实例集群上构建并验证了该功能,然后将其作为与加速器无关的功能贡献给 vLLM。此处的结果来自带 EFA 的 Amazon EC2 P5en(GPU)集群,表明这些收益同样适用于 GPU。本文解释推送式架构、传输流程、线程模型、性能结果以及如何复现基准测试。
推送式 KV 传输
本节解释推送式设计:其架构、传输协议,以及使 KV 传输远离关键路径的线程模型。
架构概览
推送式传输提升 TTFT 和解码吞吐量有两个原因:
- 它消除了拉取模型的串行化,通过重叠生产者与消费者的工作。解码实例在生产方仍在计算 KV 时提前注册其目标块。随后,一旦生产方的块就绪,传输便立即开始,而不是在消费者侧完成一次 ID 发现往返之后才开始,从而将这一往返从首 token 路径中移除。
- 它将传输建立时间从解码实例上移开。该建立过程在生产方一侧及后台线程上运行。它准备 NIXL 描述符并提交传输,因此解码实例无需在其延迟关键的 token 生成阶段耗费这些周期。
最终效果是解码实例上更低的 TTFT 和更高的输出 token 吞吐量。
推送连接器协调三个角色:解码实例预先注册其目标块,生产方实例匹配每个请求并发起传输,一个专用后台线程将 KV 写入从引擎的前向传播循环中移出。下图展示了这些部分如何协同工作。
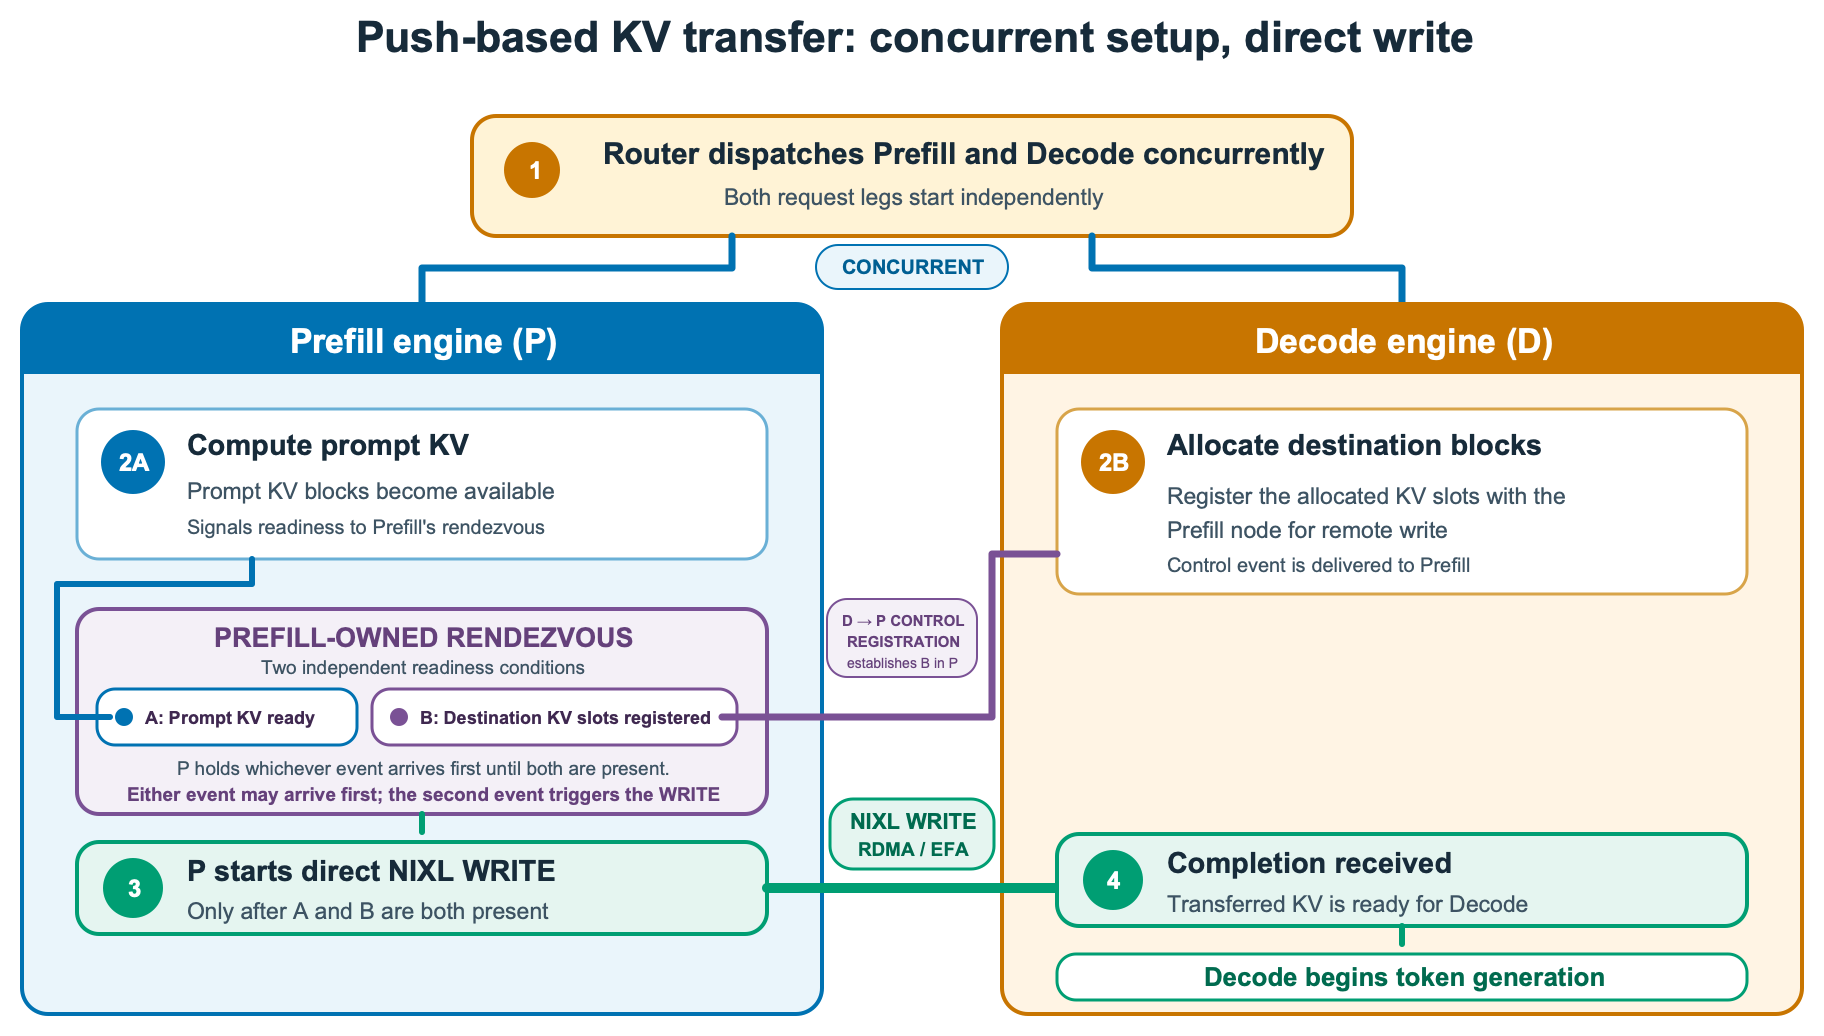
图 2:基于推送的 KV 传输架构,展示解码实例、生产方实例和后台传输线程如何协调
实现细节
该协议包含三个逻辑步骤。
1. 注册(解码侧)。当解码实例为需要远程预填充的请求分配本地块时,它会准备一份注册信息,描述生产方实例应将 KV 写入何处:其自身身份以及刚刚预留的块位置。在同一引擎步骤内,工作线程将此注册信息作为 NIXL 通知发送给生产方实例。由于注册发生在分配时,连接器在生产方实例完成预填充之前便已知晓目标块。
2. 会合(生产方侧)。来自解码器的注册信息与生产方预填充的完成可能以任意顺序到达,连接器对两者均能处理。若注册信息先到,生产方会保留它直至自身预填充完成。若预填充先完成,生产方会保留该请求的块直至注册信息到达。无论哪个事件后发生,都会触发传输。连接器按 ID 配对请求,匹配过程会考虑重新发出的请求,正确关联被抢占或重试的请求。
3. 传输(生产方侧)。一旦请求匹配成功,生产方建立到解码实例的连接(若尚不存在),并发出 NIXL WRITE,将 KV 块直接复制到解码器注册的内存中,寻址每个目标张量并行 rank。生产方和消费者可能使用不同的内部块布局。每一侧在传输时将块位置映射到自己的物理布局,从而允许两侧使用不同的块大小。每个 WRITE 携带完成通知,NIXL 在数据到达后将其投递给解码实例。解码器统计这些通知,每个向其写入的生产方 rank 对应一个通知。只有在所有预期通知到达后,它才认为 KV 已接收完毕,此时请求继续进入解码阶段。
线程模型
push 连接器通过在每个 prefill worker 上使用专用的后台传输线程,将模型执行与 KV 传输准备分离。在请求开始时,decode 主循环分配其目标 KV 块,并将它们注册到 prefill 实例,同时 prefill 主循环计算 prompt KV 缓存。在目标注册和 prompt KV 都就绪后,prefill 主循环将 KV 块交给后台线程,并迅速返回模型执行。
后台线程建立或复用 NIXL 连接,将请求的 KV 块 ID 映射到内存描述符,将连续块合并为更大的传输区域,并向 decode 实例提交 NIXL WRITE。当 NIXL 完成传输后,它会向 decode 实例发送完成通知,后者随后开始 token 生成。将描述符准备和传输提交保持在延迟关键的主循环之外,可防止这项每请求工作延迟模型执行。下图展示了单个请求的这些主循环与后台线程交接。
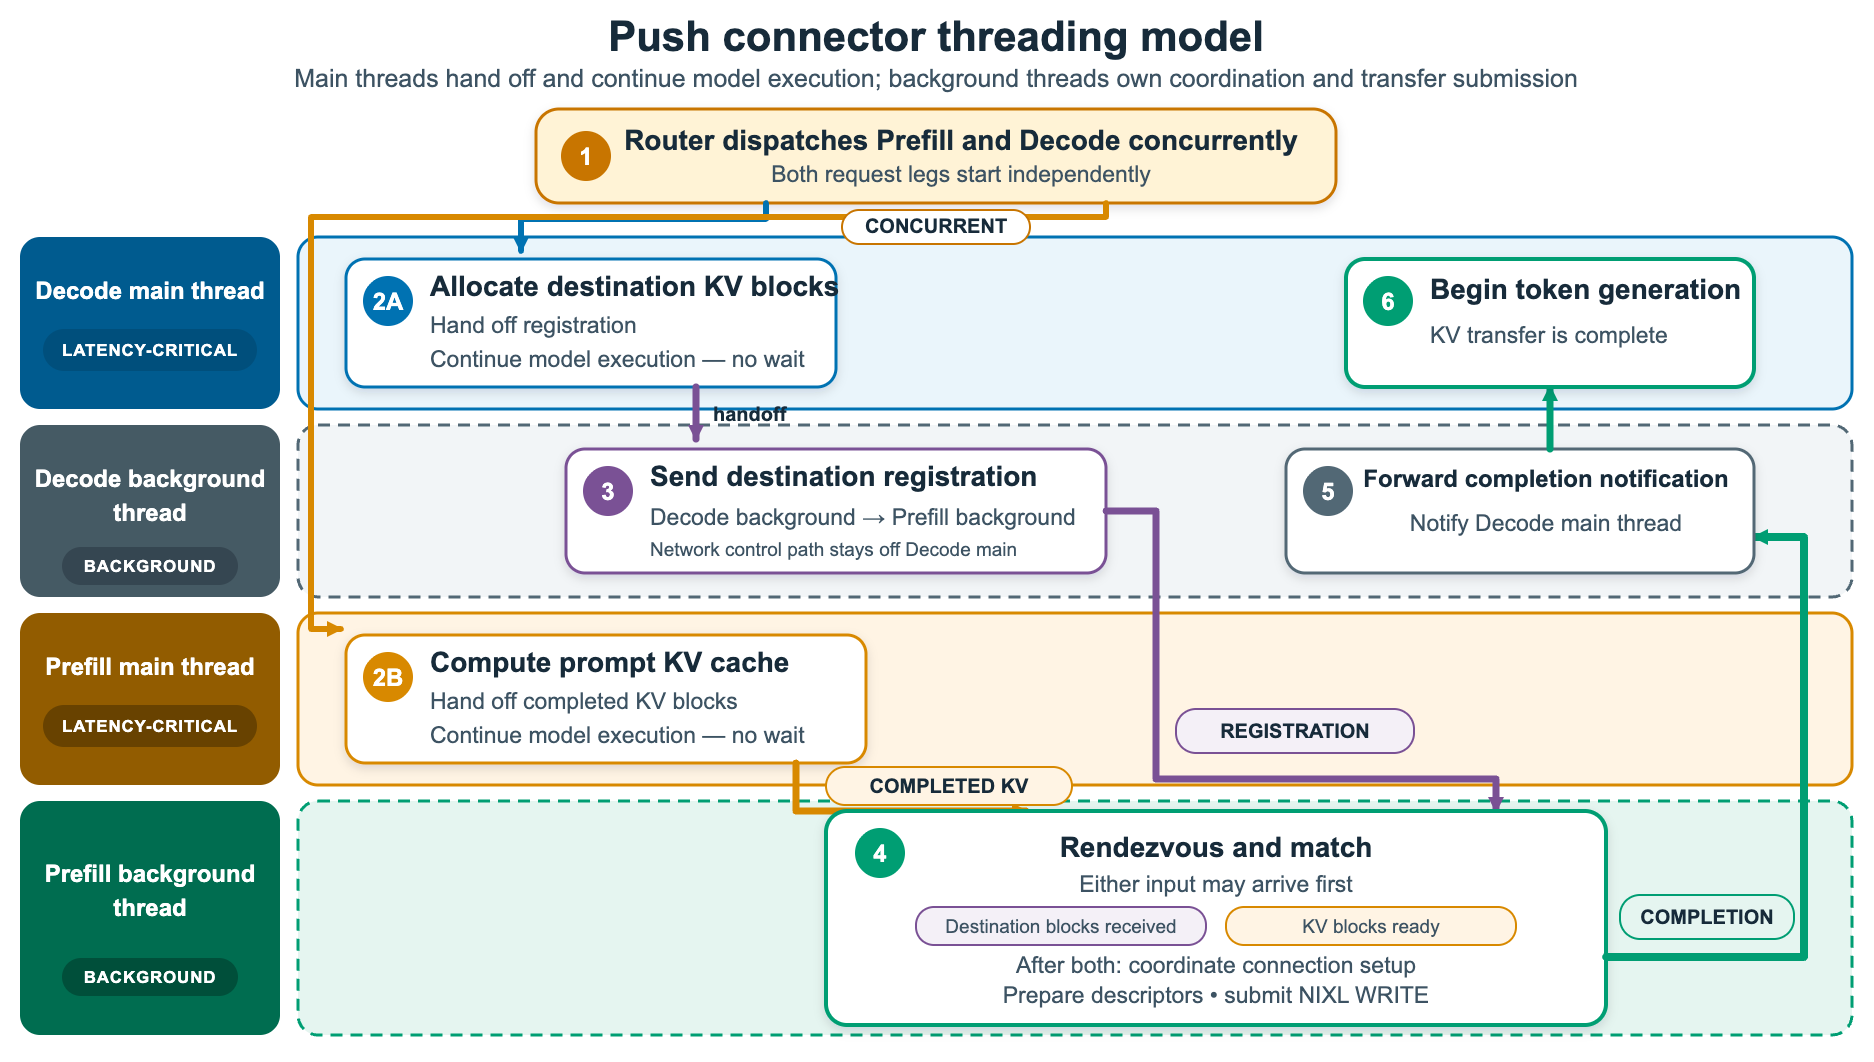
图 3:基于 push 的线程模型中单个请求的主循环与后台线程交接
pull 与 push 的时序比较
下图总结了前几节描述的 pull 和 push 传输流程,并突出了它们对 TTFT 的影响。尽管两种模式使用相同的 NIXL 和 EFA/RDMA 数据路径,但 pull 在 prefill 之后执行元数据中继和 decode 侧设置,而 push 将 decode 侧设置与 prefill 重叠。因此,push 将这些操作从 prefill 后的关键路径中移除,使解码能够更早开始。
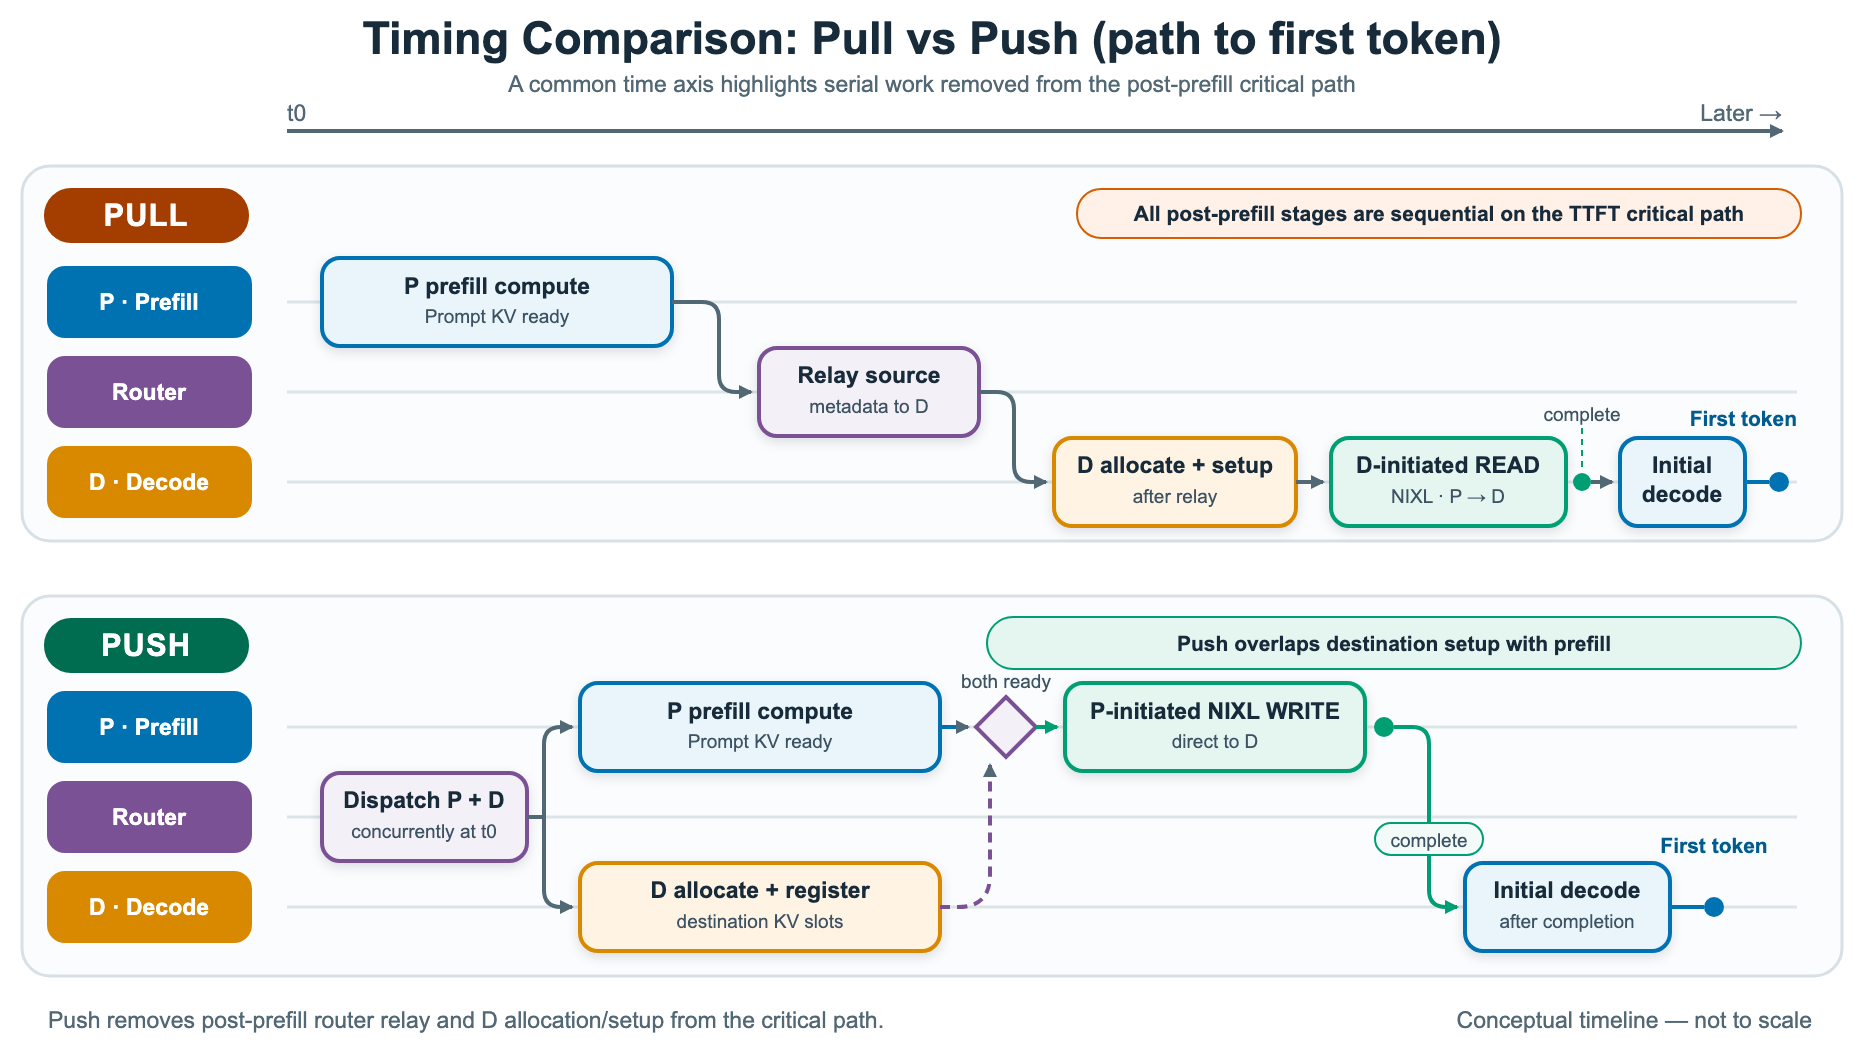
图 4:pull 与 push 传输流程比较,突出 push 如何将 decode 侧设置与 prefill 重叠
这两种模式还涉及路由权衡。pull 模式允许路由器在 prefill 完成后选择 decode 实例,这为负载感知路由和服务质量管理提供了更大的灵活性。push 模式更早选择 decode 实例,以便目标设置可以与 prefill 重叠。作为回报,在可比负载下,prefill 实例可以更早释放其 KV 块,因为一旦 prompt KV 和目标注册都就绪,传输就会开始。
性能数据
在评估中,我们在 1P1D 部署上使用 Qwen3-32B 模型,使用通过 EFA 连接的 Amazon EC2 P5en 实例。为了隔离 P→D 传输性能,我们将基准配置为使用 --no-enable-prefix-caching 禁用前缀缓存。此配置使 decode 节点为每个请求从 prefill 节点检索完整 KV 缓存。否则,重叠的 prompt 可能复用 decode 节点的本地缓存并绕过传输,从而产生误导性的比较结果。
下图比较了 push 和 pull KV 传输的 TTFT。我们扫描了 1k–16k 的输入长度和每秒 1–8 次查询(QPS)的请求速率。在低负载和短 prompt 下,两种模式的表现几乎相同。随着 QPS 和输入长度增长,pull 模式急剧下降,在 8 QPS 和 16k 时达到约 1,744 ms。push 模式则保持在约 540 ms 的远低水平,约减少 3 倍。差距之所以出现,是因为 pull 模式在 decode worker 上以内联方式、在其引擎循环内同步提交 NIXL 描述符,因此这项工作会停滞 token 生成。push 模式将其移到后台线程,脱离关键路径。
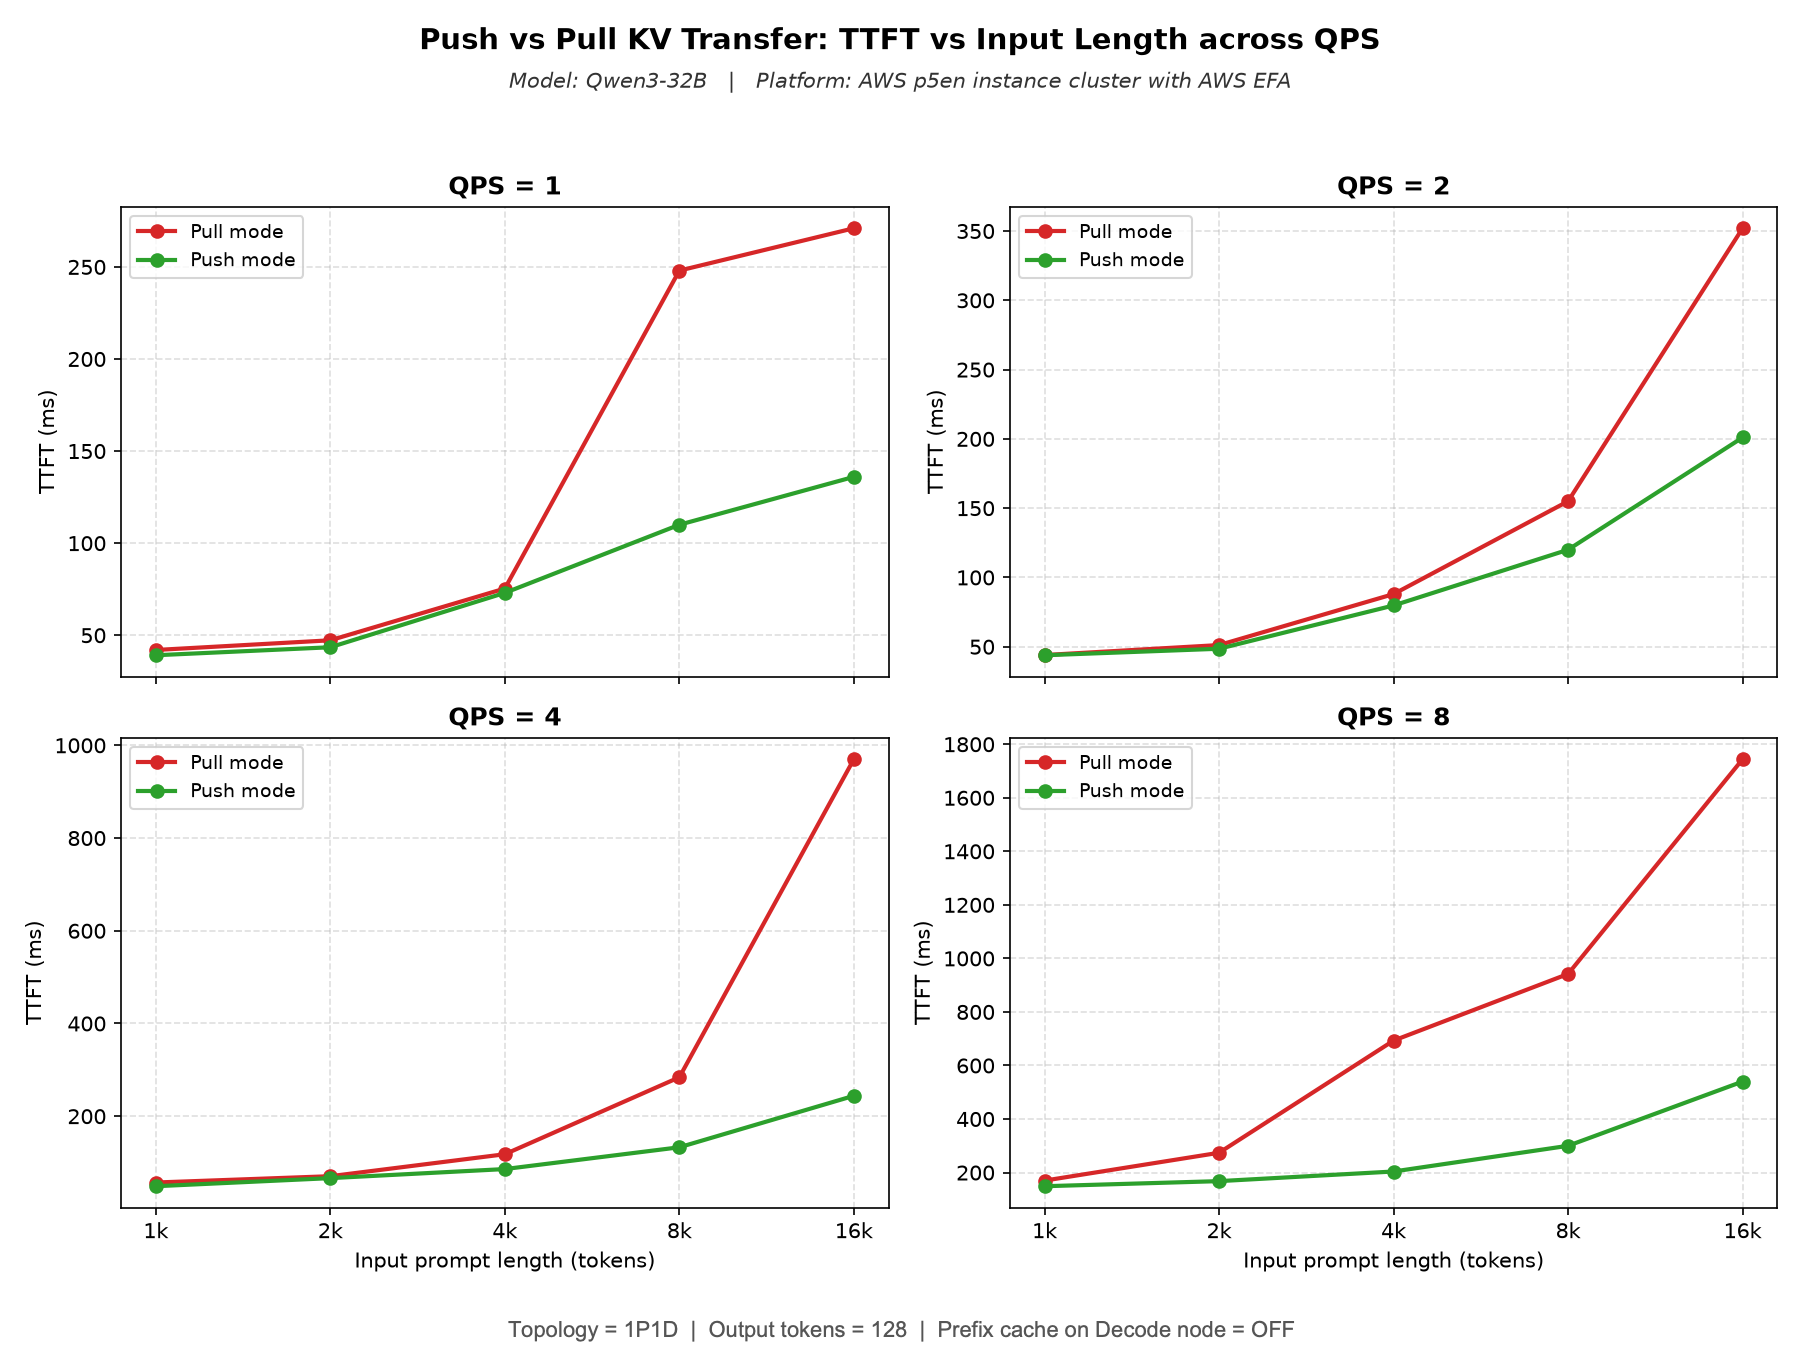
图 5:在 1P1D 拓扑、128 个输出 token、解码节点禁用前缀缓存的条件下,push 与 pull KV 传输在不同输入长度和请求速率下的 TTFT 对比
该图展示了相同条件下的 TPOT。其趋势与 TTFT 一致。在轻负载下,push 与 pull 接近,约为 5.6–5.8 ms。随着负载和输入长度增加,pull 在 4–8 QPS 和 16k 时升至约 10.4 ms,而 push 保持在 7 ms 附近。原因是 push 将描述符准备和传输提交从解码 worker 卸载。token 生成不会因资源不足而受阻,因此即使在高并发和长上下文下,每 token 延迟也保持平稳。
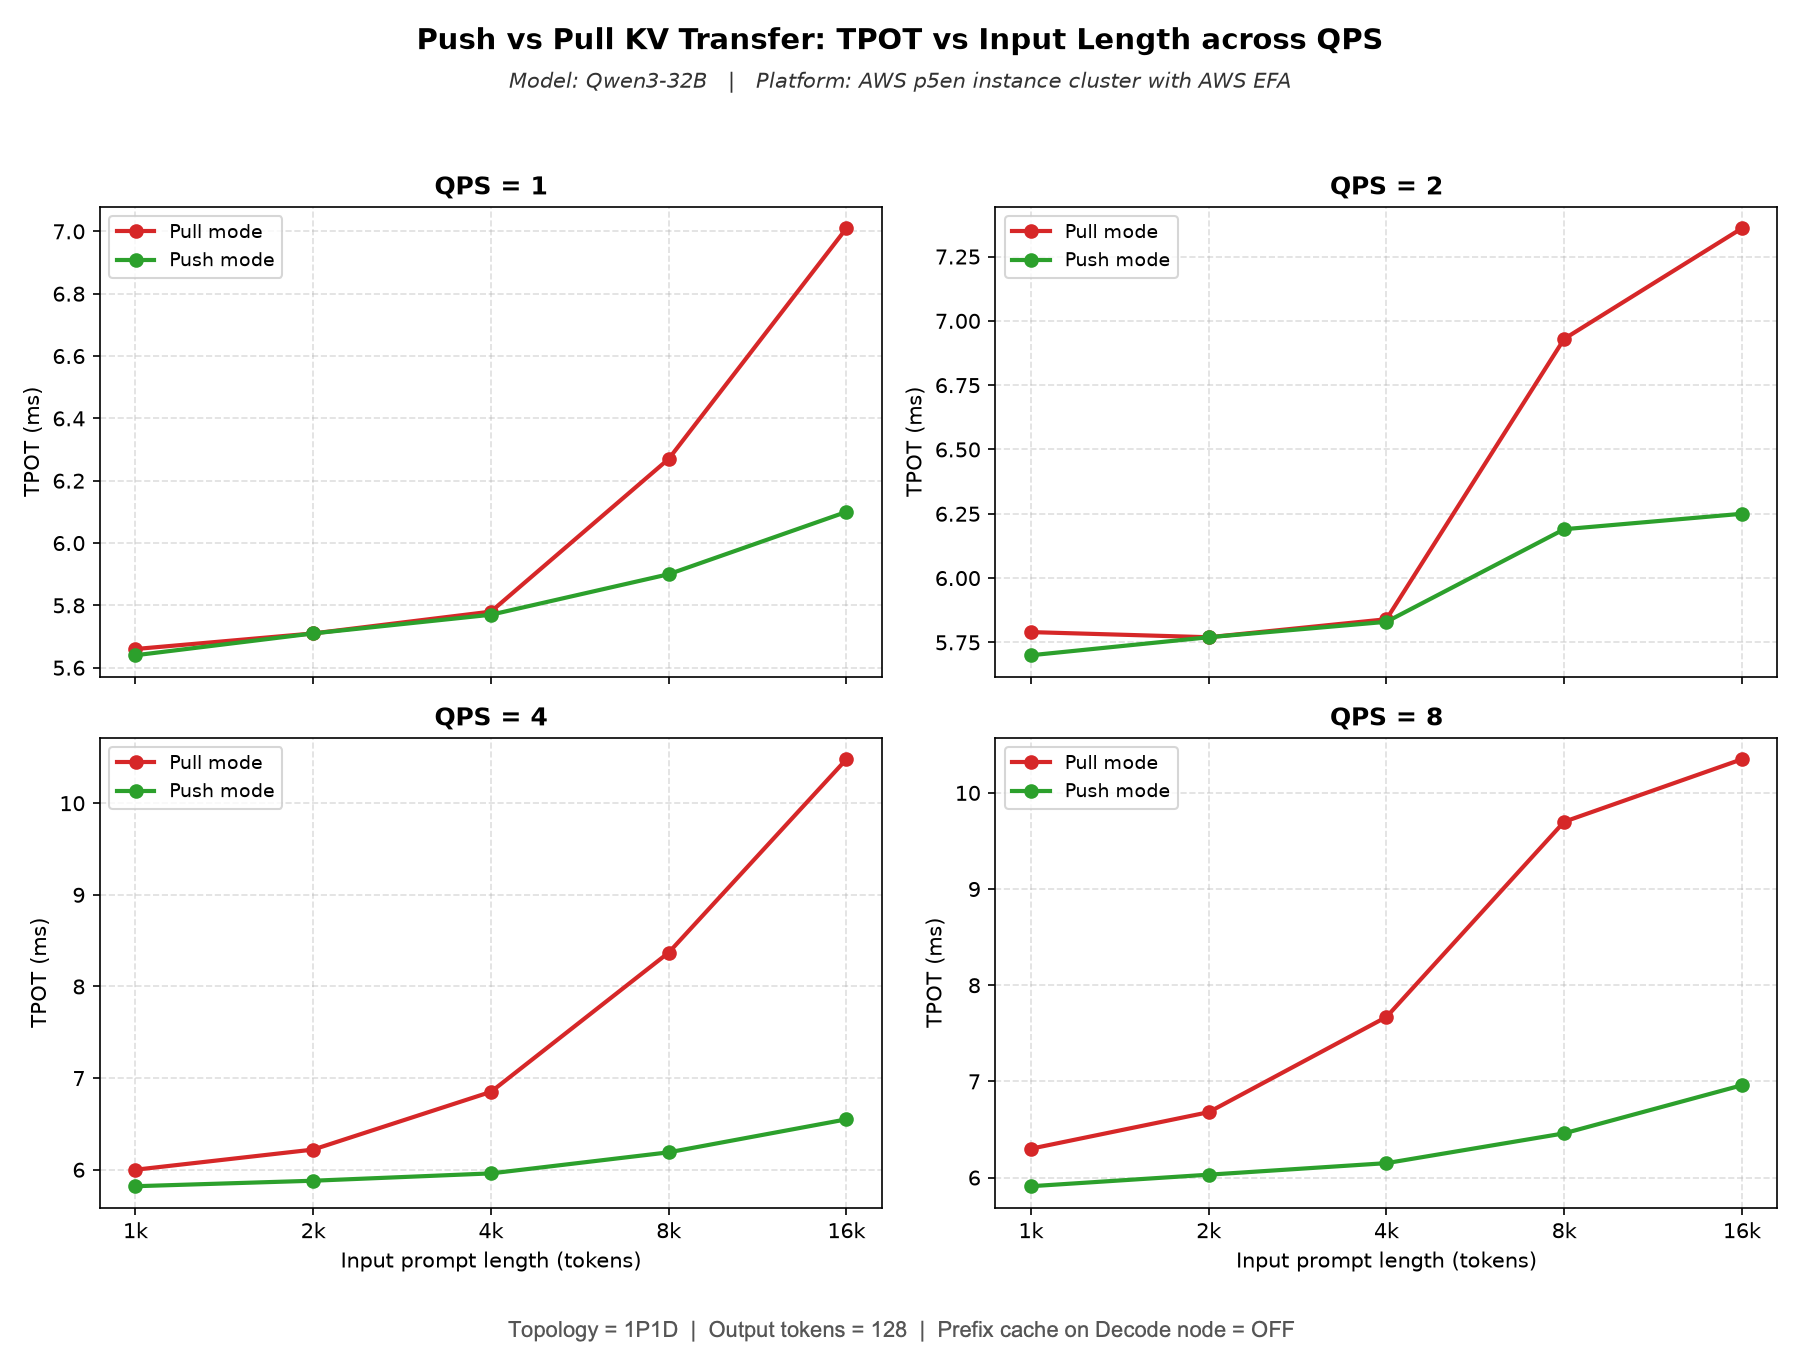
图 6:在 1P1D 拓扑、128 个输出 token、解码节点禁用前缀缓存的条件下,push 与 pull KV 传输在不同输入长度和请求速率下的 TPOT 对比
如何运行基准测试
要复现我们的 1P1D 基准配置(一个 prefill 节点和一个 decode 节点,使用通过 EFA 连接的 Amazon EC2 P5en 实例),请参阅 复现我们的结果 指南中的详细说明。该指南涵盖环境设置、启动 vLLM prefill 和 decode 服务器、运行基准测试以及收集结果。该功能可在其他受支持的配置上运行,但性能结果会因硬件、模型、工作负载和网络配置而异。
结论
在本文中,我们展示了基于 push 的 KV 连接器如何将 prefill 计算与解码侧的块分配和注册重叠,从而将 post-prefill 路由器往返和解码侧传输设置从关键路径中移除。这降低了 TTFT 和 TPOT,尤其是在高请求速率下。在我们使用通过 EFA 连接的 Amazon EC2 P5en 实例进行 1P1D 部署的 Qwen3-32B 基准测试中,与 pull 模式相比,push 模式将 TTFT 最多提升 3 倍,将 TPOT 提升 30%。结果因工作负载和配置而异。要使用 push 模式,请将 prefill 和 decode 服务器都配置为使用 NixlPushConnector 而不是 NixlConnector。
当可以接受提前选择解码节点且优先考虑降低 TTFT 时,请选择基于 push 的连接器。对于需要 双向 KV 传输 或在 prefill 之后才选择解码实例以实现负载感知路由的工作负载,基于 pull 的连接器仍然是更合适的选择。vLLM 同时支持基于 push 和基于 pull 的 KV 连接器,因此您可以选择最适合您部署的方法。
作为未来的改进,我们正在探索将后台 NIXL 线程模型引入 pull 模式连接器,将 NIXL 设置移出关键路径,以便 pull 模式工作负载也能受益于相同的优化。我们已提交一个 pull request 来探索这一点。
相关资源
致谢
我们感谢 vLLM 社区对维护此功能的支持。
关于作者

Sunita Nadampalli
Sunita 是 AWS 的首席工程师和 AI/ML 专家。她领导 AWS Trainium 和 AWS Graviton 针对 AI/ML 工作负载的软件性能优化。她热衷于开源软件开发,并致力于提供高性能且可持续的软件解决方案。

Nicolò Lucchesi
Nicolò 是 Mistral 的研究工程师,领导推理基础团队。他是 vLLM 的维护者,在 LLM 和计算机视觉的快速推理方面拥有背景。
来源:AWS Machine Learning Blog · aws.amazon.com