在 Amazon SageMaker HyperPod 上检测并恢复静默数据损坏
Detecting and recovering from silent data corruption on Amazon SageMaker HyperPod
AWS 团队介绍在 Amazon SageMaker HyperPod 的 PyTorch DDP 训练循环中加入三项检查来检测静默数据损坏:all-reduce 前后的 NaN/Inf 梯度检查、跨节点环形重放审计,以及优化器更新后的权重指纹比对。
静默数据损坏(SDC)是指 GPU 等硬件返回一个错误但看似合理的数值,却不报任何错误。在分布式训练中,这个错误数值会流入每个副本的梯度和权重。损失值可能连续数小时看起来正常,等到团队发现无法解释的发散或模型变弱时,算力已经消耗掉了。这种情况在大规模场景中确实会发生:在长达 54 天、最多使用 16K 块 H100 GPU 的 Llama 3 405B 预训练期间,Meta 将 419 次意外作业中断中的 6 次归因于静默数据损坏,而这还只是那些中断了作业并被追溯到 SDC 的案例。
Amazon SageMaker HyperPod 已经会替换报告故障的节点:健康监控代理会监视 GPU 错误,深度健康检查会对节点进行压力测试,自动节点恢复会换掉坏硬件。SDC 能绕过所有这些功能,因为硬件从不报告任何信息。检测必须来自训练作业本身。
在本文中,我们向 PyTorch DistributedDataParallel(DDP)训练循环添加三项检查来检测 SDC。当某项检查触发时,我们将可疑 rank 映射到其节点,控制损坏范围,并让 SageMaker HyperPod 替换该节点。每项检查覆盖故障可能出现的不同位置:
- 非有限梯度检查会在 GPU 前向或反向传播发生 NaN、Inf 和溢出的那一步捕获它们,也会捕获梯度 all-reduce 引入的 NaN 或 Inf。
- 环形重放审计会捕获有限的错误数值。在审计步骤中,每块 GPU 会重新计算来自另一个节点的微批次,并逐位比较损失值、按指纹比较梯度。
- 权重指纹比较会在更新后比较每个副本的权重,从而捕获优化器步骤和存储权重中的损坏。
我们在一个配有 4 台 ml.p5.48xlarge 实例(32 块 NVIDIA H100 GPU)的 SageMaker HyperPod 集群上,用软件注入故障测试了这些检查,并在三台实例上重复了每项测试,这是这些检查所需的最低数量。该解决方案的完整代码可在配套 GitHub 仓库中获取。
静默数据损坏如何发生,以及为什么常规检查会漏掉它
SDC 源于制造缺陷(逃过供应商筛选的临界晶体管)和特定计算单元中的硅老化,最常见的是张量核心中的乘加通道,而这正是模型训练反复压榨的硬件。那个临界电路大多数时候计算正确,只在压力下出错:高温、电压跌落或特定操作数模式。由于算术逻辑路径没有 ECC 或奇偶校验(与内存不同),错误结果(比如 4.0001 而不是 4.0000)永远不会被标记,并会通过激活值和梯度流入每个副本的权重。
它之所以如此难以捕获,是因为SDC 位于计算路径中,而你已经拥有的每一项完整性检查守护的都是不同的边界:
| 检查 | 它守护什么 | 为什么它会漏掉 SDC |
| ECC | 内存 | 捕获内存中的位翻转,而不是错误运算。张量核心结果上没有 ECC。 |
| Xid 错误(NVRM) | GPU 驱动/硬件故障 | GPU 在检测到故障时会引发 Xid。SDC 按定义不会引发任何错误,因此 /aws/sagemaker/Clusters/ HMA 日志中不会出现任何内容。 |
| DCGM 深度健康检查 | 硬件故障 | 会漏掉需要你的工作负载操作数、热状态或时序才能触发的缺陷。它在空闲节点上运行,位于你的作业之外。 |
| NVLink / PCIe / EFA 校验和 | 传输 | 验证字节按发送时的样子到达,而不是验证它们计算得是否正确。 |
| 检查点校验和 | 存储往返 | 一个被污染但一致的检查点校验和正常。 |
捕获 SDC 的方法是检查计算本身的结果。
解决方案概述
这个循环有四个步骤。你的训练任务执行前两步,后两步使用 Kubernetes 和 SageMaker HyperPod 功能:
步骤 1。检测:训练循环中的三项检查通过比较数据并行副本,指出可疑 GPU。
步骤 2。定位:在由 Amazon Elastic Kubernetes Service(Amazon EKS)编排的 SageMaker HyperPod 集群上,Kubernetes 节点名称包含实例 ID,因此将可疑 rank 映射到节点只需一次查找。
步骤 3。隔离并关联:停止任务,封锁节点,并在 SageMaker HyperPod 可观测性仪表板中查看其 GPU 指标。
步骤 4。确认并恢复:当告警不明确时进行确认,审查后更换节点,并从可疑窗口之前保存的检查点恢复。
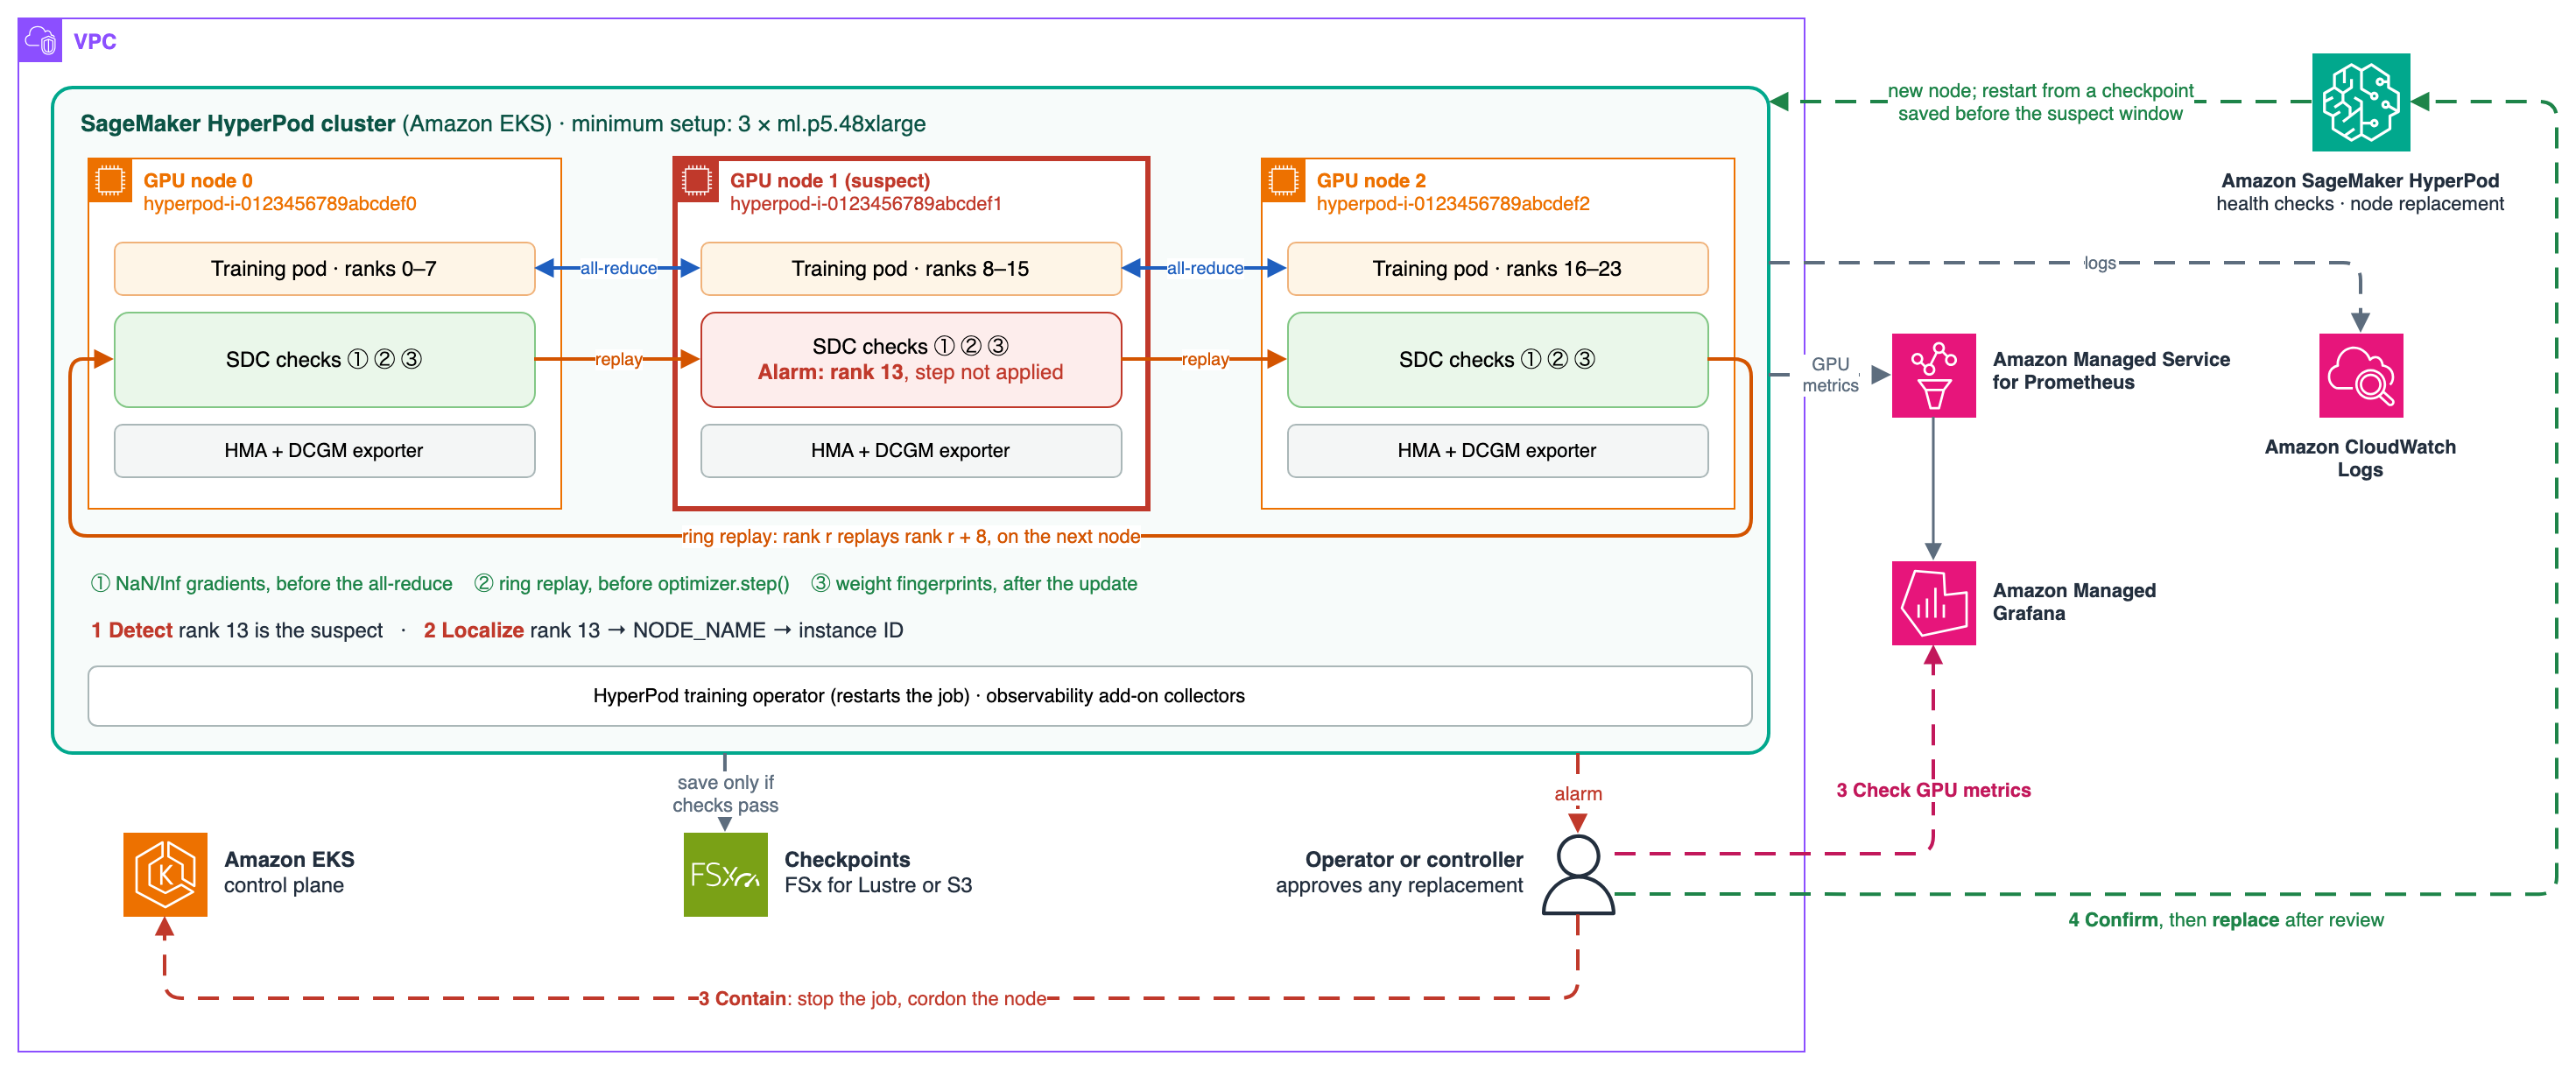
图 1:一个由 SageMaker HyperPod EKS 集群,包含三个运行训练 Pod 和 SDC 检查的 p5 节点。节点 1 对 rank 13 发出告警,建议的步骤会封锁该节点、检查 GPU 指标、更换它并重启训练
把循环看作分层结构会有所帮助,每一层都增加了不同的东西:
| 层 | 来源 | 它增加了什么 | 能捕获真正的静默 SDC 吗? |
| 1. 非有限梯度检查 | 你的训练脚本 | 在 all-reduce 之前,指出本地梯度为 NaN 或 Inf 的 GPU,并在归约后的梯度为 NaN 或 Inf 时停止该步骤 | 仅能捕获会变成 NaN、Inf 或溢出的故障 |
| 2. 环形重放审计 | 你的训练脚本 | 每个 GPU 重新计算另一个节点的微批次,并比较损失位和梯度指纹 | 能,对于会改变损失或梯度的有限计算路径故障,在审计步骤中有效 |
| 3. 权重指纹比较 | 你的训练脚本 | 在更新后,指出权重与严格多数不一致的副本 | 能,对于单个副本上的优化器步骤和存储权重故障有效。对计算路径故障和分片权重无效 |
| 4. 定位 | 你的训练脚本,使用 SageMaker HyperPod 节点名称 | 从 Kubernetes 节点名称将可疑 rank 映射到实例 ID | 不适用:它负责定位 |
| 5. DCGM 关联 | HyperPod 可观测性附加组件 | 告警前后可疑 GPU 的 DCGM 指标 | 它只在故障也出现在硬件计数器时确认故障。干净的遥测数据并不能排除节点。 |
| 6. 深度健康检查 | StartClusterHealthCheck(DCGM L4) |
对可疑节点按需进行硬件诊断 | 它能捕获其自身测试模式触发的硬件缺陷。属于分诊,而非证明 |
| 7. 重复违规历史 | 你基于保留的告警和遥测数据构建的查询 | 反复告警的节点 | 部分有效:它能提前发现值得检查的节点 |
第 1–3 层是唯一能检测静默 SDC 的层,它们位于你的训练代码中。第 4 层将其告警转换为实例 ID,HyperPod 各层则印证告警并闭环。
先决条件
要跟随操作,你需要:
- 一个由 Amazon EKS 编排的 SageMaker HyperPod 集群,至少有三个 GPU 节点。环形审计需要三个不同节点来处理它确定的每次比较,权重比较需要每个权重的三个副本才能指出异常者。参见 使用 Amazon EKS 编排 SageMaker HyperPod 集群。
- 一个 PyTorch DDP 训练作业,其中每个副本都运行自己的优化器步骤,数据管道能够为给定步骤重建任意 rank 的微批次,例如使用带种子的采样器。
- 检查点存放在共享存储、Amazon FSx for Lustre 或 Amazon Simple Storage Service(Amazon S3)上。替换节点会销毁其根卷和辅助卷,包括本地 NVMe 上的任何内容。
- 用于关联步骤的 SageMaker HyperPod 可观测性附加组件。如需 ECC、NVLink 和节流计数器,请开启高级 DCGM 指标。
- 通过
kubectl访问集群,并具备sagemaker:StartClusterHealthCheck和sagemaker:BatchReplaceClusterNodes所需的 AWS Identity and Access Management(IAM)权限。请参阅手动隔离、替换或重启节点。
步骤 1:在训练循环中用三项检查进行检测
数据并行会同时训练模型的多个副本,称为 replica。每个副本在批次的不同切片上训练。每次反向传播后,all-reduce 会对各副本的梯度求平均,每个副本在 optimizer.step() 中应用相同的平均值。下面是一个权重在三个副本上的情况,学习率为 0.1:
| 副本 0 | 副本 1 | 副本 2 | ||
| 起始权重 | 0.500 | 0.500 | 0.500 | 相同 |
| 本地梯度 | 0.20 | 0.40 | 0.30 | 不同(数据不同) |
| 平均梯度 | 0.30 | 0.30 | 0.30 | 相同,在 all-reduce 之后 |
| 步骤后的权重 | 0.470 | 0.470 | 0.470 | 相同 |
本地梯度不同,因为每个副本看到的数据不同。而在优化器步骤之后,权重必须逐位完全相同。
故障发生的位置决定了哪项检查能发现它。如果副本 1 计算出的本地梯度是 4.00 而不是 0.40,all-reduce 会将该错误传播到每个副本:三个副本都应用相同的错误更新,它们的权重仍然一致。只有副本 1 的本地梯度看起来不同,而且只在 all-reduce 之前。反之,如果副本 1 在优化器步骤期间或之后损坏了一个权重,它的权重就不再与其他副本一致。有一个例外:某个副本权重中的 NaN 或 Inf 会通过下一次 all-reduce 到达每个副本,此后各副本又恢复一致。all-reduce 本身内部的故障,例如某个 GPU 错误地累加部分和,也会以相同方式到达每个副本。
因此,计算路径上的故障必须在优化器步骤之前捕获,此时错误梯度仍可被丢弃;而更新或之后存储权重中的故障则要在其后捕获。有限的错误值需要重新计算:跨副本比较梯度范数只能捕获 NaN 和 Inf(参见为什么不比较本地梯度范数?)。这就需要在每个 DP rank 上、在每个训练步骤内按固定顺序执行三项检查:
- 非有限梯度检查 – 在 all-reduce 之前,标记本地梯度为 NaN 或 Inf 的任何 rank。这能在故障发生的步骤捕获 GPU 前向或反向传播中爆发的值,并指明是哪个 GPU。在 all-reduce 之后、更新之前,也要检查归约后的梯度是否为 NaN 或 Inf。
- 环形重放审计 – 在审计步骤中,优化器步骤之前,每个 rank 重新计算另一个节点上某个 rank 的微批次。它逐位比较损失,并在使用确定性内核时比较每个参数的梯度指纹。这能捕获计算路径中有限的错误值。
- 权重指纹比较 – 在优化器步骤之后,每 N 步以及每次检查点之前,比较每个副本的权重指纹。这能捕获优化器步骤和存储权重中的故障。
本步骤中的代码适用于 PyTorch DDP。对于张量并行、流水线并行或上下文并行,请参阅Beyond DDP。
执行顺序
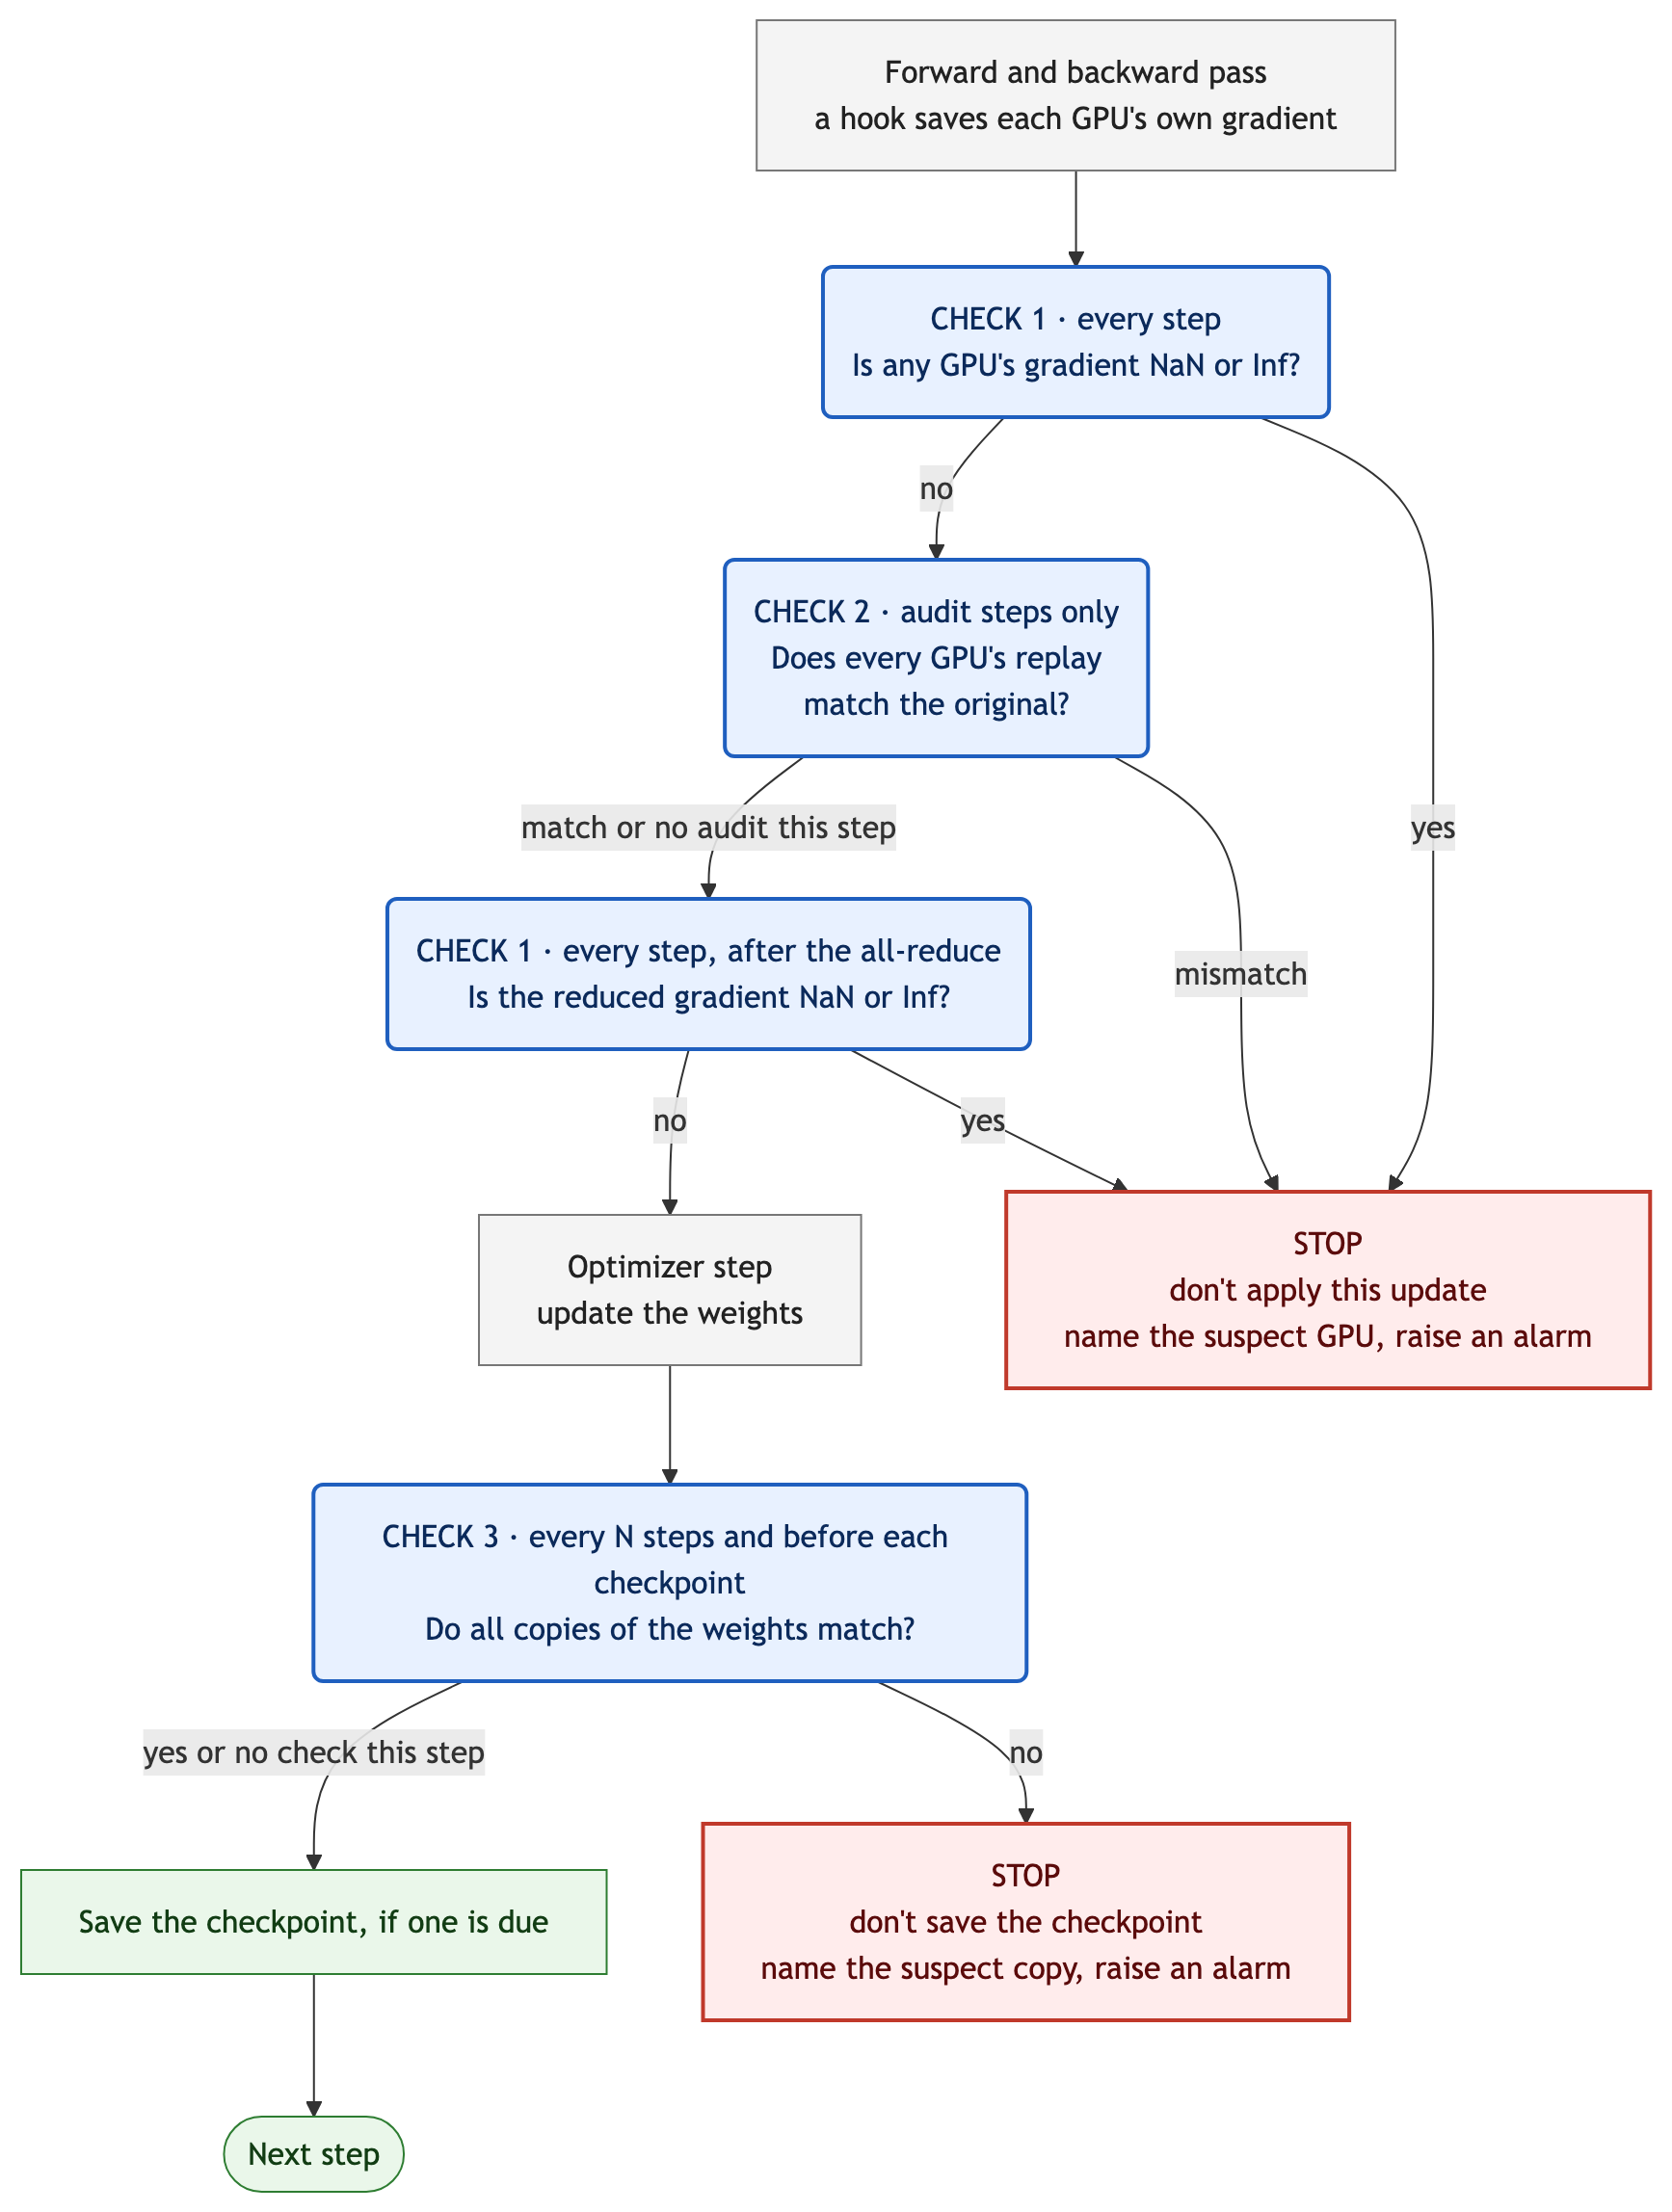
图 2:一个训练步骤的流程图。检查 1(NaN/Inf 梯度,在 all-reduce 前后)和检查 2(环形重放,在审计步骤上)在优化器步骤之前运行,如果触发则停止该步骤。检查 3(权重指纹)在其后运行,并阻止检查点保存
为什么不比较本地梯度范数?
一个自然的初始设计,也是我们最初采用的设计,会标记出本地梯度范数与该步骤中位数相差超过 k 个中位数绝对偏差(MAD)的 rank。我们在 4 个实例上(22,800 步,见无故障运行)使用 32 块 H100 训练一个 9.53 亿参数模型的三次无故障运行的每一步记录了每个 rank 的本地梯度范数,而该测试并不奏效:
- 健康数据的分布范围太宽—— 每个 rank 看到的数据不同,因此健康的本地范数在前 800 步内就已达到 224 MAD,在所有健康步骤中达到 1,240 MAD。
- 安静的阈值看不到任何有限值—— 在 k = 336(即前 800 个健康步骤中最高分数的 1.5 倍)时,它在剩余的 22,000 个健康步骤中触发了 11 次误报。而没有任何有限故障接近该值:即使将一个激活值乘以 10,000,故障 rank 的分数也从未超过 6.9。
通过指纹比较
检查 2 和检查 3 跨 GPU 比较张量。发送整个张量开销太大,因此每个张量被缩减为一个指纹:其原始位模式的两个 64 位和,一个普通和,一个按位置加权和。对于元素少于 2³² 个、每个元素最多 4 字节的张量,对张量中一个或两个元素的任何更改都会改变指纹。这涵盖了我们注入的所有权重故障。更大的更改原则上可能相互抵消,因此指纹相等是张量相等的有力证据,而非证明。位置加权和很重要:在我们的测试中,交换两个权重值并对另外两个值做补偿性更改后,普通和保持不变,只有加权和能捕获它们。
_INT_VIEW = {1: torch.uint8, 2: torch.int16, 4: torch.int32, 8: torch.int64}

@torch.no_grad()
def fingerprints(tensors, chunk=1 << 24):
    # ... picks the device and allocates out: one row of two int64 per tensor
    for k, t in enumerate(tensors):
        if t is None:
            continue
        bits = t.detach().contiguous().view(-1).view(_INT_VIEW[t.element_size()])
        for i in range(0, bits.numel(), chunk):  # chunked to bound temporary memory
            b = bits[i:i + chunk].to(torch.int64)
            pos = torch.arange(i + 1, i + 1 + b.numel(), dtype=torch.int64, device=dev)
            out[k, 0] += b.sum()
            out[k, 1] += (b * pos).sum()
    return out
检查 1:NaN/Inf 梯度,在 all-reduce 前后
DDP 通信钩子在每个 rank 的本地梯度被平均之前记录它。它存储每个梯度桶的平方范数,并在确定性审计步骤上存储每个参数梯度的指纹(供检查 2 使用)。然后它将桶传递给 PyTorch 的标准 all-reduce。
反向传播后,nonfinite_ranks 从每个 rank 收集一个标量,并返回本地梯度范数为 NaN 或 Inf 的 rank。第一个被标记的 rank 就是故障 rank。如果该步骤被应用,NaN 将在下一步到达每个 rank。
def local_stats_hook(stats, bucket):
    stats.sq.append(bucket.buffer().float().pow(2).sum())
    if stats.record_fingerprints:  # per parameter, before allreduce_hook divides in place
        rows = [stats.row[p.data_ptr()] for p in bucket.parameters()]
        stats.fp[rows] = fingerprints(bucket.gradients())
    return allreduce_hook(stats.dp_group, bucket)

def attach(ddp_model, dp_group):
    stats = LocalStats(dp_group, list(ddp_model.module.parameters()))
    ddp_model.register_comm_hook(state=stats, hook=local_stats_hook)
    return stats

def nonfinite_ranks(stats):
    """After backward: global ranks whose local gradient norm is NaN or Inf."""
    local = torch.stack(stats.sq).sum().sqrt().reshape(1)
    n = dist.get_world_size(stats.dp_group)
    gathered = [torch.empty_like(local) for _ in range(n)]
    dist.all_gather(gathered, local, group=stats.dp_group)
    bad = ~torch.isfinite(torch.cat(gathered).cpu())
    return [dist.get_global_rank(stats.dp_group, r) for r in bad.nonzero().flatten().tolist()]
train() 还会在 all-reduce 后检查梯度。在归约内部产生的 NaN 或 Inf 会以相同方式到达每个副本,因此副本仍然匹配,检查 3 会通过它们。如果没有此检查,NaN 会在每个副本上变成 NaN 权重,并且该步骤到期的检查点会连同这些权重一起保存,并被标记为通过。clip_grad_norm_ 已经计算了归约后梯度的范数,因此该检查每步只增加一次单元素 all-reduce。归约中的有限错误仍会通过所有检查。
如果你使用 fp16 和梯度缩放器进行训练,请排除缩放器已跳过的溢出步骤。bf16 没有这些步骤。
检查 2:环形重放,在优化器步骤之前
每个副本在optimizer.step()之前都持有相同的权重。因此,在反向传播和优化器步骤之间,任何 rank 都可以重新计算任何其他 rank 的 micro-batch,并且在确定性内核下,它必须得到相同的比特。
在审计步骤中,每个 rank r 重新计算 rank r + 8 的 micro-batch:向前 8 个位置,在 p5 实例上正好相隔一个节点。它使用未包装的模块,因此没有任何 all-reduce,并在之后恢复梯度、模块的缓冲区和随机数状态。无论有多少 rank 执行一次重放,重放都会阻塞作业,因此审计每个 rank 与审计一个 rank 的挂钟时间相同。
然后每个 rank 出现在两次比较中:它自己的 micro-batch 被一个对等节点重放,以及它为别人重放的那个 micro-batch。
- 两次比较都不匹配:该 rank 在两次计算中都出错,因此它就是罪魁祸首。
- 只有一次不匹配:任何一方都可能出错。
confirm就地解决:目标之后八个位置的 GPU(位于第三个节点上)和目标本身再次重放目标的 micro-batch。这也能区分持久性故障(目标能复现)和瞬态故障(目标不能复现)。
def ring_audit(module, compute_loss, rebuild_batch, step, stats, local_loss, offset, with_grads):
    # ... g is the DP group, n its size, and me this rank's position in it
    target = dist.get_global_rank(g, (me + offset) % n)
    replay = _replay(module, compute_loss, rebuild_batch(step, target), with_grads)
    # ... v = [this rank's own loss bits and gradient fingerprints, its replay of target]
    dist.all_gather_into_tensor(out, v, group=g)
    table = out.view(n, 2, -1).cpu()  # per DP rank: [own result, its replay of its target]
    pairs = [(dist.get_global_rank(g, (r + offset) % n), dist.get_global_rank(g, r))
             for r in range(n) if not torch.equal(table[(r + offset) % n, 0], table[r, 1])]
    return pairs, table

def localize(pairs):
    hits = Counter(r for p in pairs for r in p)
    culprits = sorted(r for r, c in hits.items() if c >= 2)
    ambiguous = [p for p in pairs if not set(p) & set(culprits)]
    return culprits, ambiguous

def confirm(module, compute_loss, rebuild_batch, step, pair, table, stats, offset, with_grads):
    # ... the third GPU (target + offset) and the target replay the target's micro-batch again
    third_r, self_r = v.cpu()
    orig, peer = table[ti, 0], table[ri, 1]
    if torch.equal(third_r, orig):
        return {"pair": pair, "third": third, "suspect": replayer, "kind": "replayer computed wrong"}
    if torch.equal(third_r, peer):
        kind = ("persistent" if torch.equal(self_r, orig) else
                "transient" if torch.equal(self_r, third_r) else "unclear")
        return {"pair": pair, "third": third, "suspect": target, "kind": kind}
    return {"pair": pair, "third": third, "suspect": None, "kind": "unattributable"}
只有当三个 GPU 位于三个不同节点上时,确认才是独立的。check_topology在训练开始前从每个 pod 的NODE_NAME中为每一对验证这一点,否则会报错。
选择审计模式:
- 默认内核:仅比较损失。这需要一次前向传播,其损失是逐位可复现的,这在我们的测试中成立:健康的重放与原始损失逐位匹配。梯度无法通过这种方式比较,因为注意力的默认反向传播不是确定性的。此模式能捕获改变损失的前向传播故障。
- 确定性内核(
deterministic_audits=True):整个审计步骤使用确定性算法和数学注意力内核运行。梯度指纹也能匹配,因此审计还能捕获仅反向传播的故障。没有确定性实现的算子会报错,而不是产生误报。在我们的模型上,确定性审计步骤的成本是默认步骤的 2.4 倍。
绝不要在可疑对象自身上重放其工作。有持久性缺陷的 GPU 可以复现自己的错误答案。
检查 3:优化器步骤后的权重指纹
在optimizer.step()之后,每个副本的权重必须完全相同,因此没有容差需要调整。每个 rank 为每个权重张量生成指纹,并收集所有人的指纹。
只有当某个 rank 的张量副本与严格多数(超过一半的副本)不同时,才会点名该 rank。如果有两个副本,或者分裂且没有严格多数,比较会报告不一致,但不点名任何 rank。
def find_divergent_ranks(params, dp_group):
    local = fingerprints(params).flatten()
    # ... all-gathers every rank's fingerprints into table: [dp_size, num_tensors, 2]
    differs = (table != table[0]).any(dim=2).any(dim=0)
    if not differs.any():
        return {"diverged": False, "suspects": []}
    suspects = set()
    for k in differs.nonzero().flatten().tolist():
        copies = [tuple(row) for row in table[:, k].tolist()]
        value, count = Counter(copies).most_common(1)[0]
        if 2 * count <= n:
            return {"diverged": True, "suspects": None}  # no strict majority for tensor k
        suspects.update(r for r, c in enumerate(copies) if c != value)
    return {"diverged": True,
            "suspects": sorted(dist.get_global_rank(dp_group, r) for r in suspects)}
每 N 步以及每个检查点步骤运行它。这是唯一在更新后运行的检查,因此也是唯一能阻止从损坏副本写出检查点的检查。在我们的测试中,一次更新后立即损坏的权重在下一个检查点步骤被捕获,保存没有发生。如果没有强制检查,保存会从损坏的副本继续,而环形审计直到下一次审计(五步之后)才注意到。
在一个 9.53 亿参数的模型上,每次检查花费 31.1 毫秒:每 10 步运行时占一步的 2%。
将检查放入训练循环
train 按图 2 的顺序执行每一步,并在第一个告警处停止。它在前向传播之前决定某一步是否为审计步,因为确定性比较需要原始计算也是确定性的。当检查 1 或 2 触发时,它将梯度置零并直接返回,不进行裁剪或应用更新,因此坏梯度永远不会到达权重或优化器状态,而确切的状态仍然保留以供确认。裁剪之后,它检查缩减后的梯度是否为 NaN 或 Inf,如果是,则在更新前返回。只有在没有任何告警触发时,它才保存检查点。
def train(ddp_model, stats, optimizer, batches, compute_loss, rebuild_batch, save_checkpoint,
          sched, start_step=0):
    # ... setup, including check_topology(dp_group, sched.peer_offset)
    for step, batch in enumerate(batches, start_step):
        audit = step % sched.audit_every == 0  # 0. decide first
        det = audit and sched.deterministic_audits
        # ... resets the hook's per-step state
        with deterministic() if det else nullcontext():
            loss = compute_loss(ddp_model, batch)  # 1. forward, backward
            loss.backward()
        nonfinite = nonfinite_ranks(stats)  # 2. non-finite check
        pairs, table = [], None
        if audit or nonfinite:  # 3. ring replay
            pairs, table = ring_audit(module, compute_loss, rebuild_batch, step, stats,
                                      loss, sched.peer_offset, with_grads=det)
        if nonfinite or pairs:  # 4. gate
            optimizer.zero_grad(set_to_none=True)  # step not applied
            culprits, ambiguous = localize(pairs)
            verdicts = [confirm(module, compute_loss, rebuild_batch, step, p, table, stats,
                                sched.peer_offset, with_grads=det) for p in ambiguous]
            return {"step": step, "check": "compute", "nonfinite": nonfinite,
                    "mismatched_pairs": pairs, "culprits": culprits, "verdicts": verdicts,
                    "suspect_window": _window(last_audit, step, start_step),
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        if audit:
            last_audit = step
        grad_norm = torch.nn.utils.clip_grad_norm_(params, sched.max_grad_norm)
        bad = (~torch.isfinite(grad_norm)).to(torch.int32).reshape(1)  # reduced gradient
        dist.all_reduce(bad, op=dist.ReduceOp.MAX, group=dp_group)
        if bad.item():
            optimizer.zero_grad(set_to_none=True)  # step not applied
            return {"step": step, "check": "reduced gradient", "suspect_window": [step, step],
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        ckpt = step % sched.ckpt_every == 0
        if step % sched.check_every == 0 or (ckpt and sched.check_on_checkpoint):
            wc = find_divergent_ranks(params, dp_group)  # 5. weight check
            if wc["diverged"]:
                return {"step": step, "check": "weights", "suspects": wc["suspects"],
                        "suspect_window": _window(last_weights, step, start_step),
                        "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
            last_weights = step
        if ckpt:  # 6. checkpoint
            save_checkpoint(step, tags={"last_audit_pass": last_audit,
                                        "last_weight_check_pass": last_weights})
    return None
告警的 suspect_window 是自上次通过触发检查以来经过的步数范围。自开始以来每一步都活跃的故障就始于该范围内。间歇性故障可能更早,而没有任何检查能发现的故障可能存在于任何检查点中,因此请将这些标签视为该步检查已通过的记录,而非保存状态干净的证明。
训练脚本这样调用它:
# ... imports, and the model, optimizer, and dataset setup
import sdc_order as S

stats = S.attach(ddp_model, dp_group)  # registers the comm hook, once
sched = S.Schedule(audit_every=10, deterministic_audits=True, check_every=10,
                   ckpt_every=100, peer_offset=8)  # 8 = GPUs per node

def compute_loss(model, batch):  # used for training AND replay
    x, y = batch
    with torch.autocast("cuda", dtype=torch.bfloat16):
        logits = model(x)
    return F.cross_entropy(logits.float().flatten(0, 1), y.flatten())

def rebuild_batch(step, rank):  # exactly the micro-batch `rank` trained on
    return dataset.micro_batch(step, rank)

# ... batches(start) yields this rank's micro-batches and sets the learning rate
alarm = S.train(ddp_model, stats, optimizer, batches(start), compute_loss, rebuild_batch,
                save_checkpoint, sched, start_step=start)
if alarm is not None:
    report_sdc(alarm)  # metric + log line; Step 2 maps the rank to a node
    sys.exit(3)
重放依赖于以下条件:
- 精确的微批次:
rebuild_batch(step, rank)必须返回 rank 训练时所用的确切微批次,例如来自带种子的采样器。 - 相同的损失函数:
compute_loss在训练和重放中必须是同一个函数,包括 autocast,并且其内部的任何随机性(如 dropout)必须按步和 rank 设置种子。 - 模型中无集合通信或影响输出的状态:确认重放仅在两个 rank 上运行,即目标和第三块 GPU,因此如果模型在前向或反向传播中调用集合通信(例如 SyncBatchNorm),就会在模糊告警时挂起。前向传播既读取又更新的缓冲区会使健康的重放产生差异。
- 确定性设置:在训练进程启动前设置
CUBLAS_WORKSPACE_CONFIG=:4096:8,并确保模型中的每个算子都有确定性实现。 - 对等偏移:逐节点编号 DP rank,使
peer_offset等于每节点 GPU 数时,每个重放器都位于另一个节点上。check_topology会拒绝不满足此条件的布局。 - 此处未测试:未使用的参数、梯度累积、BatchNorm 以及带副作用的前向钩子。对于未使用的参数,设置
deterministic_audits=False,它仅比较损失。
audit_every 是主要的成本与鲁棒性权衡设置:
- 检测延迟:如果持久性有限故障也出现在审计运行的内核中,则会在
audit_every步内被捕获。确定性审计运行确定性内核和数学注意力内核,因此仅局限于其他步骤所用默认内核的故障永远不会被审计。 - 损坏的更新:在审计捕获之前,最多可应用
audit_every− 1 次损坏的更新。它们位于告警的suspect_window内。 - 一次性故障:单个非审计步上不重复出现的有限故障完全不会被捕获。
使 ckpt_every 同时是 audit_every 和 check_every 的倍数,这样每个检查点步在更新前被审计,更新后被指纹化。
我们在 953M 模型和 32 块 H100 上,对每个调度端到端测量了 1,000 个连续步的平均步时间。每个带检查的调度还每 10 步运行一次权重检查:
| 调度 | 平均步时间 | 相对普通 DDP |
| 普通 DDP,无检查 | 157.4 ms | — |
| 有检查,无审计 | 169.0 ms | +7.4% |
| 每 10 步确定性审计 | 211.9 ms | +34.7% |
| 每 10 步默认内核审计 | 177.0 ms | +12.5% |
| 每 100 步确定性审计 | 173.3 ms | +10.1% |
| 每 100 步默认内核审计 | 169.3 ms | +7.6% |
每个调度方案中约有 7 个百分点的成本不依赖于审计:梯度钩子、每一步的两次 NaN/Inf 检查,以及每 10 步一次的权重检查。生产环境的一个合理起点是每 100 步执行一次确定性审计,在这里成本为 10%。它们仍能在 100 步内捕获持续性故障,包括仅发生在反向传播中的故障,代价是最多回滚 99 次被污染的更新。当你需要更快检测时,例如在新容量的 burn-in 期间或监视可疑节点时,每 10 步审计一次。在你自己的模型上测量成本:确定性注意力使用数学内核,其成本随序列长度的平方增长。
在无故障运行中,15,320 次审计步骤和 3,080 次权重检查均未触发警报,这将误报率上界限制在约每 5,100 次审计步骤 1 次(95% 置信度)。
第 2 步:将可疑 rank 定位到节点
rank 是一个逻辑 ID。要对其采取行动,你需要实例和物理 GPU。在 HyperPod EKS 上,Kubernetes 节点名称是带 hyperpod- 前缀的实例 ID。通过 Kubernetes downward API 将其传递给你的 pod:
env:
- name: NODE_NAME  # on HyperPod EKS, spec.nodeName is "hyperpod-<instance-id>"
  valueFrom:
    fieldRef:
      fieldPath: spec.nodeName
在作业启动时,记录一张将每个 rank 映射到其节点、实例和 GPU UUID 的表:
import os
import torch
import torch.distributed as dist

node = os.environ["NODE_NAME"]  # "hyperpod-i-0123456789abcdef0"
instance_id = node.removeprefix("hyperpod-")  # "i-0123456789abcdef0", what the Replace API takes
gpu_uuid = "GPU-" + str(torch.cuda.get_device_properties(torch.cuda.current_device()).uuid)
info = {"rank": dist.get_rank(), "node": node,
        "instance_id": instance_id, "gpu_uuid": gpu_uuid}
table = [None] * dist.get_world_size()
dist.all_gather_object(table, info)
if dist.get_rank() == 0:
    print("rank_map", table)  # log at every job start
如果作业已在没有 downward API 的情况下运行,你可以从外部使用 kubectl get pod <pod> -o jsonpath='{.spec.nodeName}' 将 pod 映射到其节点。
第 3 步:控制损害并检查 GPU 指标
警报触发时,首先停止作业。然后通过在你调查期间封锁节点,阻止新工作落到可疑节点上:
kubectl cordon <node-name> # marks the node unschedulable; existing pods keep running然后打开 SageMaker HyperPod 可观测性附加组件中的 GPU 健康仪表板,筛选到可疑节点和 GPU,并查看警报触发的时间。该 GPU 上可纠正 ECC 错误、PCIe 重放、降频或温度的上升会提高硬件故障的置信度。面板干净并不能排除该节点:纯 SDC 通常不会在硬件遥测中留下痕迹。
第 4 步:确认,然后更换节点
在步骤 1 的检查运行的情况下,警报已经指出了可疑 GPU。当你看到没有警报的症状(例如损失尖峰),或想在更换任何东西之前排除软件问题时,先从廉价的解释开始。大多数损失尖峰不是 SDC,在数据 bug 上追查 SDC 会浪费数天:
Loss anomaly / suspected corruption
- Reproduces with the same seed on DIFFERENT nodes? -> deterministic bug, not SDC
- Goes away, or follows one node, when you move the job? -> strong SDC candidate
- DP replicas that must be bitwise identical disagree? -> strong SDC signal
- One rank's step replayed on another node gives different bits? -> strong SDC signal
- One rank's pre-all-reduce gradient is NaN or Inf? -> SDC candidate (use the first step it fired)
- Fleet-wide and gradual? -> likely recipe or optimizer
- Started at a data, config, or library change? -> usually software, but not proof
区分 SDC 与软件问题的测试是问题是否跟随硬件:
- 可复现的故障不能排除 SDC—— Meta 将一个失败的负载固定到一个核心上,并针对特定输入每次都得到相同的错误答案。
- 从软件变更开始的故障也不能排除—— Google 将一起事件追溯到一个正确的库更新,该更新开始在缺陷核心上使用很少使用的指令。
- 不要指望全局损失能指向任何地方—— 前向故障首先改变故障 rank 自身的损失,然后 all-reduce 将其梯度传播到每个副本。逐 rank 检查和重放能给你局部性。
判断警报的含义
| 警报 | 含义 | 建议操作 |
check == "weights", suspects == [r] |
更新后 rank r 的副本与严格多数不一致 | 保持 r 的节点被封锁。审查后更换 |
check == "weights", suspects is None |
副本不一致,但没有严格多数 | 不明确:保持涉及的节点被封锁。检查 DCGM 并运行深度健康检查 |
culprits == [r] |
r 的两次环形比较都不匹配。这假设在互相重放的 GPU(本地索引相同的 GPU)中最多只有一个故障 GPU。如果有两个,则可以指出一个健康的 GPU | 保持隔离。审查后更换,或在故障重复后更换 |
| 判定:持续性 | 目标复现了自身的错误答案,且第三个 GPU 与重放者一致 | 保持隔离。审查后更换 |
| 判定:瞬时性 | 目标的重新计算结果正确,并与第三个 GPU 一致。间歇性故障可能看起来相同 | 保持隔离,直到以该节点为目标进行审计,或深度健康检查通过。如果再次发生则更换 |
| 判定:重放者计算错误 | 出错的是重放的 GPU,而不是目标 | 将重放者视为可疑对象,并再次确认 |
| 非有限集合,无不匹配对 | 反向传播中出现 NaN 或 Inf,而损失未显示,或梯度范数对 float32 来说过大(超过约 1.8 × 10¹⁹) | 不明确:以可疑对象为目标进行审计,或检查 DCGM 并运行深度健康检查 |
check == "reduced gradient" |
all-reduce 之后梯度为 NaN 或 Inf,尽管每个 rank 的本地梯度都是有限的。未指出任何 rank | 不明确:保持作业停止,检查 DCGM 并对作业中的每个节点运行深度健康检查,然后从告警步骤之前保存的检查点恢复 |
| 判定:无法归因或不明确 | 三个 GPU 不一致 | 不明确:检查 DCGM 并对涉及的节点运行深度健康检查 |
在生产环境中,在你有证据表明这些检查在你自己的工作负载上的精确度之前,每次更换都要保留人工审批。像我们这样的合成测试并不能确立这一点。
确认不明确的告警
深度健康检查是处理不明确告警的主要工具。其压力测试能捕获硬件报告的故障,而微妙的数据相关故障往往能通过。要在可疑实例组上运行一个:
aws sagemaker start-cluster-health-check \
    --cluster-name <cluster-name> \
    --deep-health-check-configurations '[{"InstanceGroupName":"<instance-group>","InstanceIds":["i-0123456789abcdef0"],"DeepHealthChecks":["InstanceStress"]}]'
更换节点
当你准备好更换节点时,有两种选择。两者都会触发相同的 SageMaker HyperPod 恢复流程,详见手动隔离、更换或重启节点。
如果开启了自动节点恢复,你可以给节点打标签并让 SageMaker HyperPod 更换它,这对自动化很方便:
kubectl label node <node-name> \
    sagemaker.amazonaws.com/node-health-status=UnschedulablePendingReplacement --overwrite
要改用 API,请运行:
aws sagemaker batch-replace-cluster-nodes --cluster-name <cluster-name> --node-ids <instance-id>在使用 Karpenter 进行自动扩缩的集群上,BatchReplaceClusterNodes 会终止节点,但只有在有挂起的 Pod 需要时才会创建替代节点。替代节点加入后,训练作业会通过 SageMaker HyperPod 训练操作符或作业的重启策略重新启动,你的训练脚本会从告警的 suspect_window 开始之前保存的最新检查点恢复。在加载后立即调用 find_divergent_ranks,在第一步之前。更换会销毁节点的根卷和辅助卷,因此请将检查点保存在共享存储上。
自动化工作流
手动步骤是为了理解。在生产环境中,将它们包装在一个运行在你自己的集群和账户中的小型控制器里:
- 触发: 训练作业将告警报告为 Kubernetes 事件、一个小型自定义资源(例如 SDCReport{rank, job, step, check}),或针对
sdc_nonfinite_grad、sdc_replay_mismatch和sdc_divergent_tensors等指标的 Amazon CloudWatch 告警。 - 解析: 控制器通过 Kubernetes API 将 rank → pod → node 映射,然后通过去掉
hyperpod-前缀将 node → 实例 ID 映射。 - 隔离: 它隔离该节点。
- Decide: 它应用第 4 步中的表格。环形审计已经就地确认了存在歧义的配对,因此告警会携带判定结果。对于有歧义的结果,它会运行一次节点范围的深度健康检查。
- Recover: 对于替换操作,它会请求人工批准,然后调用
BatchReplaceClusterNodes,或者在开启自动节点恢复时设置节点健康标签。之后它依赖训练操作员和你的检查点重新加载,并将每一步记录到 CloudWatch 中。
将其构建为轻量级 Kubernetes operator,或构建为 CloudWatch 告警上的 Amazon EventBridge 规则,由该规则调用 AWS Lambda 函数。
用例:在 SageMaker HyperPod 上测试这些检查
我们在一个由 Amazon EKS 编排的 SageMaker HyperPod 集群上运行了两次测试,先后使用 4 个和 3 个 ml.p5.48xlarge 实例,每个实例配备 8 块 NVIDIA H100 80GB HBM3 GPU,并使用来自 AWS Deep Learning Containers 训练镜像的 PyTorch 2.9.0(CUDA 13.0)。模型是一个 9.53 亿参数的 Llama 风格解码器,具有 16 层、隐藏层大小 2,048、16 个注意力头、32,000 词表以及 2,048 token 的序列。每块 GPU 每步处理 2 个序列(32 块 GPU 上每步 131,072 个 token),使用 fp32 权重、梯度和优化器状态,并在计算时使用 bf16 自动混合精度。我们使用 AdamW 训练,学习率为 3 × 10⁻⁴,经过 100 步线性预热,betas 为 (0.9, 0.95),权重衰减为 0.1,梯度裁剪为 1.0。数据是合成的:一个使用 Zipf 分布 token 的复制任务,其前半部分重复,并按 rank 和 step 设置种子,以便任何微批次都可以重建。
故障场景
故障被注入到一层中,即 16 个解码器块中第 8 个块的 MLP 下投影,注入发生在选定的 rank 和 step 上:
- 前向故障会改变该层的输出,但保留其梯度路径,例如前向传播中的乘法错误。
- 仅反向故障会改变该层输入或权重的梯度。
- 权重故障会在优化器步骤之后立即改变某块 GPU 上存储权重的副本:一个位翻转、两个值的交换,或对两个值进行补偿性更改。
- 持续性故障会在故障 GPU 计算的所有内容中反复出现,包括它为其他 rank 运行的重新计算。 瞬态故障只触发一次。
每个场景都从 400 个预热步骤后拍摄的快照重新开始,步骤编号从该快照开始计数。除非另有说明,审计每 10 步运行一次,使用确定性内核,权重检查每 10 步一次,检查点每 20 步一次。表中显示的是 4 实例的结果。在 3 实例上,每个场景都在相同的步骤、由相同的检查触发相同的告警,并指出相同的 rank。只有对等 rank 发生了变化。
| 注入的故障 | 结果 | 捕获方式 |
| rank 13 前向输出中一个元素出现 NaN,仅在步骤 25(不是审计步骤) | 在步骤 25 触发,并指出 rank 13。环形重放也运行了。由 rank 21 和 rank 13 确认:rank 13 上的瞬态故障。步骤 25 未被应用。可疑窗口:步骤 21–25 | 检查 1 |
| 从步骤 23 开始每一步,rank 13 前向输出中的一个元素 ×1,000 | 步骤 23–29 通过了检查 1 并被应用。步骤 30 的审计在 (13, 5) 和 (21, 13) 处不匹配,并指出 rank 13。步骤 30 未被应用。可疑窗口:步骤 21–30 | 检查 2 |
| 仅在审计步骤 30 上相同的 ×1,000 | 一对不匹配,(13, 5)。由第三个节点上的 rank 21 以及 rank 13 确认:rank 13 上的瞬态故障 | 检查 2 |
| 第 5 名上持续存在的 ×1,000,它重放了第 13 名的微批次 | 配对 (13, 5) 和 (5, 29) 不匹配。点名了第 5 名。由第 5 名对第 13 名进行一次重放,本会归咎于健康的第 13 名 | 检查 2 |
| 第 13 名上的其他前向故障,从第 23 步起每一步:一个元素 ×10,000,整个输出上 10% 的乘性噪声,一个 bf16 元素中翻转第 3 位,以及一个输出列 ×1.1 | 每一步都在第 30 步点名第 13 名。位翻转和 ×1.1 列也被默认内核审计捕获 | 检查 2 |
| 流入第 13 名层的梯度中的一个元素,或其权重梯度中的一个元素,×1,000,从第 23 步起每一步(仅反向) | 每一步都在第 30 步点名第 13 名,仅凭梯度指纹 | 检查 2 |
| 上述权重梯度故障,配合默认内核审计 | 50 步内无告警。第 20 步和第 40 步的检查点被标记为通过审计和权重检查,因为损失未受影响,且每个副本都应用了相同的损坏更新 | 未捕获 |
| 第 13 名和第 22 名上同时持续存在的前向 ×1,000 | 配对 (13, 5)、(21, 13)、(22, 14) 和 (30, 22) 不匹配。点名了第 13 名和第 22 名 | 检查 2 |
| 第 31 步更新后,第 0 名上一个 fp32 权重元素中翻转第 22 位,每 5 步保存一次检查点 | 在检查点第 35 步强制进行的权重检查点名了第 0 名,保存未发生。可疑窗口:第 31–35 步 | 检查 3 |
同上,配合 check_on_checkpoint=False |
第 35 步的保存从第 0 名的损坏副本继续进行了。其标签显示最后一次通过的权重检查在第 30 步。环形审计在第 40 步从配对 (8, 0) 和 (0, 24) 点名了第 0 名 | 检查 2 |
| 第 31 步更新后,第 0 名上一个权重张量中两个值被交换,或两个值的位模式分别加上 +4,096 和 −4,096,无审计,每 10 步进行一次权重检查 | 每一步都在第 40 步权重检查时点名第 0 名,尽管该张量的普通位和未变 | 检查 3 |
| 恢复快照(作为加载检查点的替代)后,第 7 名上一个注意力权重中翻转第 22 位 | find_divergent_ranks,在第一步之前运行,点名了第 7 名 |
检查 3 |
无故障运行
为测量误报,我们在两种集群规模上无故障训练,各用三种调度。每种调度每 10 步运行一次权重检查且不保存检查点,每次运行时长固定为分钟数,因此每步都审计的两种调度贡献了大部分审计步:
| 实例 | 审计 | 分钟 | 步数 | 审计步 | 权重检查 | 告警 |
| 4 | 确定性,每步 | 45 | 4,600 | 4,600 | 460 | 0 |
| 4 | 默认内核,每步 | 22.5 | 5,400 | 5,400 | 540 | 0 |
| 4 | 确定性,每 10 步 | 45 | 12,800 | 1,280 | 1,280 | 0 |
| 3 | 确定性,每步 | 15 | 1,600 | 1,600 | 160 | 0 |
| 3 | 默认内核,每步 | 7.5 | 2,000 | 2,000 | 200 | 0 |
| 3 | 确定性,每 10 步 | 15 | 4,400 | 440 | 440 | 0 |
| 总计 | 150 | 30,800 | 15,320 | 3,080 | 0 |
在 15,320 个审计步中 0 告警,三倍法则给出每审计步误报率的 95% 上界为 3 / 15,320,约 1/5,100。NaN/Inf 检查在任何无故障步上也未触发。为什么不比较局部梯度范数?中的梯度范数分析仅使用 4 实例运行。
超越 DDP
权重比较不限于 DDP。find_divergent_ranks 接受任何数据并行组,因此也适用于张量、流水线和上下文并行、HSDP 以及专家混合,这些都是保留每个权重独立副本的布局。在 ZeRO-1 或完全 FSDP 分片下它无能为力,因为每个分片的更新仅在一个 rank 上计算。本文中的检查和训练循环仅用 DDP 测试过。
要在另一种布局中使用它,请调用 find_divergent_ranks,并传入持有同一分片副本的组。只有两个副本时,它可以检测出不一致,但无法指出哪个副本有故障。
如果你更希望由服务来替你检查节点,SageMaker HyperPod 还提供 MultiNodeTraining 深度健康检查。它会在一批 GPU 节点上运行一个简短、固定的分布式训练作业,无需修改代码,并替换掉训练损失变为 NaN 或 Inf、发散或未按时完成的节点。你可以在创建实例组时将其与 InstanceStress 和 InstanceConnectivity 一起选择,或使用 StartClusterHealthCheck 按需运行。它是对本文所述检查的补充:用它在你作业落到新节点和替换节点之前进行筛查,而用作业内检查来捕获你自己训练中从未变成 NaN 或 Inf 的错误数值。详情请访问 SageMaker HyperPod Deep Health Checks。
清理
为避免持续产生费用,请删除你为测试而创建的资源。如果你创建了 HyperPod 集群,请使用 aws sagemaker delete-cluster --cluster-name <cluster-name> 将其删除。这只会删除 HyperPod 资源。请在删除 HyperPod 集群之后,单独删除 EKS 集群、其附加组件以及任何 Amazon FSx 卷。请参阅 Deleting a SageMaker HyperPod cluster。
结论
在本文中,我们展示了如何检测数据并行训练中的静默数据损坏,以及如何将可疑节点交给 SageMaker HyperPod 进行替换。三项检查覆盖了故障可能出现的三个位置:对每个 rank 的梯度和归约后的梯度进行 NaN/Inf 检查,通过环回重放将每个 GPU 的工作与另一节点上的 GPU 进行比较,以及在更新后比较权重指纹。在执行优化器步骤之前运行前两项检查,不要应用未通过检查的步骤,并在每次检查点之前比较权重。SageMaker HyperPod EKS 集群上的节点名称可将可疑 rank 转换为实例 ID。然后隔离该节点,回滚到可疑时间窗口之前的检查点,并让节点健康标签或 Replace API 完成恢复。
要开始使用,请查看 SageMaker HyperPod resiliency features for Amazon EKS,并试用 companion repository。如需深入了解,请参阅 deep health checks 和 observability add-on。
关于作者

Siddharth Senger
Siddharth 目前担任 Amazon Web Services(AWS)的高级软件开发工程师,具体在 SageMaker HyperPod 团队工作。Siddharth 拥有近十年的软件开发经验,曾在 Amazon 的多个团队做出贡献,包括 Retail、Amazon Rekognition、Amazon Textract 和 Amazon SageMaker。他热衷于构建可靠、可扩展且高效的分布式系统,帮助客户加速大规模机器学习和 AI 创新。

Roy Allela
Roy 是 AWS 的首席 AI/ML 专业解决方案架构师。他与从初创公司到大型企业的 AWS 客户合作,在 AWS 上高效地训练和部署基础模型。他拥有微处理器工程背景。他热衷于计算优化问题以及提升 AI 工作负载的性能。

Nilesh PS
Nilesh 是 AWS 的高级软件开发工程师,从事 Amazon SageMaker HyperPod 相关工作。他专注于 Kubernetes 上大规模分布式 ML 工作负载的 Ray 集群管理、训练韧性和可观测性。

Pradeep Cruz
Pradeep 是 AWS 的高级软件开发经理,负责领导面向企业 AI、训练、推理和模型定制的 SageMaker HyperPod 基础设施。他拥有超过 20 年的经验,曾在 AWS、T-Mobile 和 Ericsson 扩展了多个关键的 0 到 1 AI/ML 平台。作为分布式系统和基础设施领域的专家,他拥有密歇根大学罗斯商学院的 MBA 学位。
来源:AWS Machine Learning Blog · aws.amazon.com