加拿大 AWS 区域可通过跨区域推理在 Amazon Bedrock 上使用 OpenAI GPT 模型
Access OpenAI GPT models on Amazon Bedrock from Canada with cross-Region inference
加拿大组织现可通过 Amazon Bedrock 跨区域推理,从加拿大(中部)和加拿大西部(卡尔加里)区域访问 OpenAI GPT-5.6(Sol、Terra、Luna)、GPT-6(Astra、Sol、Luna)和 GPT-6.1 Sol。
在 Amazon Bedrock 上构建生成式 AI 应用的加拿大组织,通常需要能够从加拿大 AWS 区域访问最新的基础模型(FM),例如 OpenAI GPT-6.1、OpenAI GPT-6 和 GPT-5.6。借助 Amazon Bedrock 跨区域推理(CRIS),您现在可以从加拿大访问这些模型。OpenAI GPT-5.6 模型(Sol、Terra 和 Luna)、GPT-6(Astra、Sol 和 Luna)以及 GPT-6.1 Sol 可从加拿大(中部)和加拿大西部(卡尔加里)区域使用。推理在北美进行处理,数据驻留控制将在本文后面介绍。
跨区域推理是一种容量机制。您的应用程序调用源区域中的 Amazon Bedrock Runtime 端点。然后,Amazon Bedrock 将请求路由到受支持的目标区域进行处理。通过这种方法,您可以访问更广泛的容量池,帮助您的应用程序在需求高峰期间维持吞吐量。您无需在应用程序中管理目标区域路由。
在本文中,我们将介绍可从加拿大使用的 GPT-5.6、GPT-6 和 GPT-6.1 模型,以及为它们提供服务的跨区域推理配置文件。然后,我们将展示如何设置权限,并使用 OpenAI Responses API、Chat Completions API 和 Amazon Bedrock Converse API 调用这些模型。对于 Responses API,我们包含流式传输和工具使用示例。最后,我们将介绍如何请求增加配额、查看源区域中可用的可观测性信号,以及完成后如何清理。
可从加拿大使用的模型
借助 Amazon Bedrock,您可以通过跨区域推理在加拿大访问三个 OpenAI 模型系列。下表总结了每个模型及其定位。
| 模型 | 定位 |
| GPT-6.1 Sol | 强大的推理和编码能力,适用于性能和成本都很重要的任务 |
| GPT-6 Astra | 复杂的端到端推理和代理任务 |
| GPT-6 Sol | 强大的推理和编码能力,适用于经济性适合常规使用的重复性任务 |
| GPT-6 Luna | 快速、低成本的推理,适用于高容量重复性任务,可按请求调整推理力度 |
| GPT-5.6 Sol | 高推理、编码和代理工作负载 |
| GPT-5.6 Terra | 为日常生产提供均衡的性能和成本 |
| GPT-5.6 Luna | 快速且经济实惠,适用于高容量、延迟敏感的应用 |
这些模型接受文本和图像输入,返回文本,并支持 100 万 token 上下文窗口、推理模式和工具调用。GPT-6.1 Sol 支持相同的上下文窗口和工具调用,并具有其模型卡中记录的额外输入和输出模态。GPT-5.6、GPT-6 和 GPT-6.1 还支持 Amazon Bedrock 上的提示缓存(请参阅提示缓存部分)。这些模型可通过 bedrock-runtime 端点上的 OpenAI Responses API、OpenAI Chat Completions API 和 Amazon Bedrock Converse API 使用。
有关定价,请参阅 Amazon Bedrock 定价。有关各模型的区域可用性,请参阅 Amazon Bedrock 用户指南中的模型卡。
来自加拿大的跨区域推理配置文件
Amazon Bedrock 推理配置文件是逻辑标识符,您可以用它代替原始模型 ID 传入。每个配置文件定义一个模型以及 Amazon Bedrock 可将请求路由到的区域集合。加拿大提供两种配置文件类型:
- 美国地理范围(前缀为
us.)会将请求路由到您的加拿大源区域和美国区域。当您的工作负载要求推理处理保持在北美(加拿大和美国)境内时,请选择此配置文件。 - 全球范围(前缀为
global.)会将请求路由到已部署该模型且受支持的商业 AWS 区域。这会在请求时利用更广泛的容量池。
端点可用性因模型和源区域而异,如下表所示。
| 模型 | 美国地理范围配置文件 | 全球范围配置文件 |
| GPT-6.1 Sol | ca-central-1, ca-west-1 | ca-central-1, ca-west-1 |
| GPT-6 Astra / Sol / Luna | ca-central-1, ca-west-1 | ca-central-1, ca-west-1 |
| GPT-5.6 Sol / Terra / Luna | ca-central-1, ca-west-1 | ca-central-1 |
配置文件成员资格和模型可用性可能会发生变化。GPT-5.6 模型的全球范围配置文件仅可从 ca-central-1 使用。从 ca-west-1 起,请对 GPT-5.6 使用美国地理范围配置文件。部署前,请使用 AWS Command Line Interface (AWS CLI) 或控制台(参见下一节)验证源区域的活动配置文件,或参阅跨区域推理支持文档。
入门
以下各节将介绍从您的加拿大源区域调用这些模型所需的设置和代码。
先决条件
开始之前,请确认您具备以下条件:
- 一个已启用加拿大(中部)
ca-central-1或加拿大西部(卡尔加里)ca-west-1区域作为源区域的 AWS 账户。 - 一个具有调用推理配置文件权限的 AWS Identity and Access Management (IAM) 角色或用户(参见设置权限)。
- 如果您的组织强制执行 SCP,则需要一个允许源区域中推理配置文件的服务控制策略 (SCP)(参见 SCP 注意事项)。
- Python 3.9 或更高版本,并已安装
openai、boto3和aws-bedrock-token-generator包。
设置权限
如需快速探索,请附加 AWS 托管策略 AmazonBedrockLimitedAccess。对于具有更严格访问控制的已部署工作负载,请使用最小权限的自定义策略。以下示例授予从 ca-central-1 访问 GPT-6 Astra 全球范围配置文件的权限:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel*"],
      "Resource": [
        "arn:aws:bedrock:ca-central-1::inference-profile/global.openai.gpt-6-astra"
      ]
    },
    {
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel*"],
      "Resource": ["arn:aws:bedrock:*::foundation-model/openai.gpt-6-astra"],
      "Condition": {
        "StringLike": {
          "bedrock:InferenceProfileArn": "arn:aws:bedrock:ca-central-1::inference-profile/global.openai.gpt-6-astra"
        }
      }
    }
  ]
}
如果您通过 API 密钥路径(OpenAI SDK 的 bearer token)进行身份验证,还需授予 bedrock:CallWithBearerToken。对于 Responses API,请在 arn:aws:bedrock:ca-central-1:*:project/default 上添加 bedrock:InvokeModel。
SCP 注意事项
如果您的组织通过 SCP 限制区域,请使用 bedrock:InferenceProfileArn 条件键来允许 CRIS 流量,同时阻止对未批准区域的直接调用。以下 SCP 会拒绝您批准的源区域之外的 Amazon Bedrock 推理,除非请求使用 CRIS 推理配置文件:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "DenyBedrockOutsideCanadaUnlessCris",
      "Effect": "Deny",
      "Action": ["bedrock:InvokeModel*"],
      "Resource": "*",
      "Condition": {
        "StringNotEquals": {
          "aws:RequestedRegion": ["ca-central-1", "ca-west-1"]
        },
        "ArnNotLike": {
          "bedrock:InferenceProfileArn": [
            "arn:aws:bedrock:*:*:inference-profile/us.openai.*",
            "arn:aws:bedrock:*:*:inference-profile/global.openai.*"
          ]
        }
      }
    }
  ]
}
使用此条件,即使目标区域被您的 SCP 拒绝,Amazon Bedrock 也可以路由到配置文件的目標区域。您所选配置文件中的每个目标区域都必须被允许,请求才能成功。有关更多详细信息,请参阅在多账户环境中设置跨区域推理。
验证活动推理配置文件
调用模型之前,您可以使用 AWS CLI 验证源区域中哪些配置文件处于活动状态。以下命令列出 ca-central-1 中的活动 OpenAI 配置文件。如需从卡尔加里执行相同的检查,请将 ca-central-1 替换为 ca-west-1。
aws bedrock list-inference-profiles \
    --region ca-central-1 \
    --type-equals SYSTEM_DEFINED \
    --query "inferenceProfileSummaries[?contains(inferenceProfileId, 'openai')].[inferenceProfileId,status]" \
    --output table
Amazon Bedrock 控制台提供相同的视图。打开控制台,选择加拿大(中部)或加拿大西部(卡尔加里)作为您的区域,在推理下选择跨区域推理,然后查看可用的配置文件。
以下截图显示了 Amazon Bedrock 控制台中加拿大(中部)区域列出的活跃 OpenAI 推理配置文件。
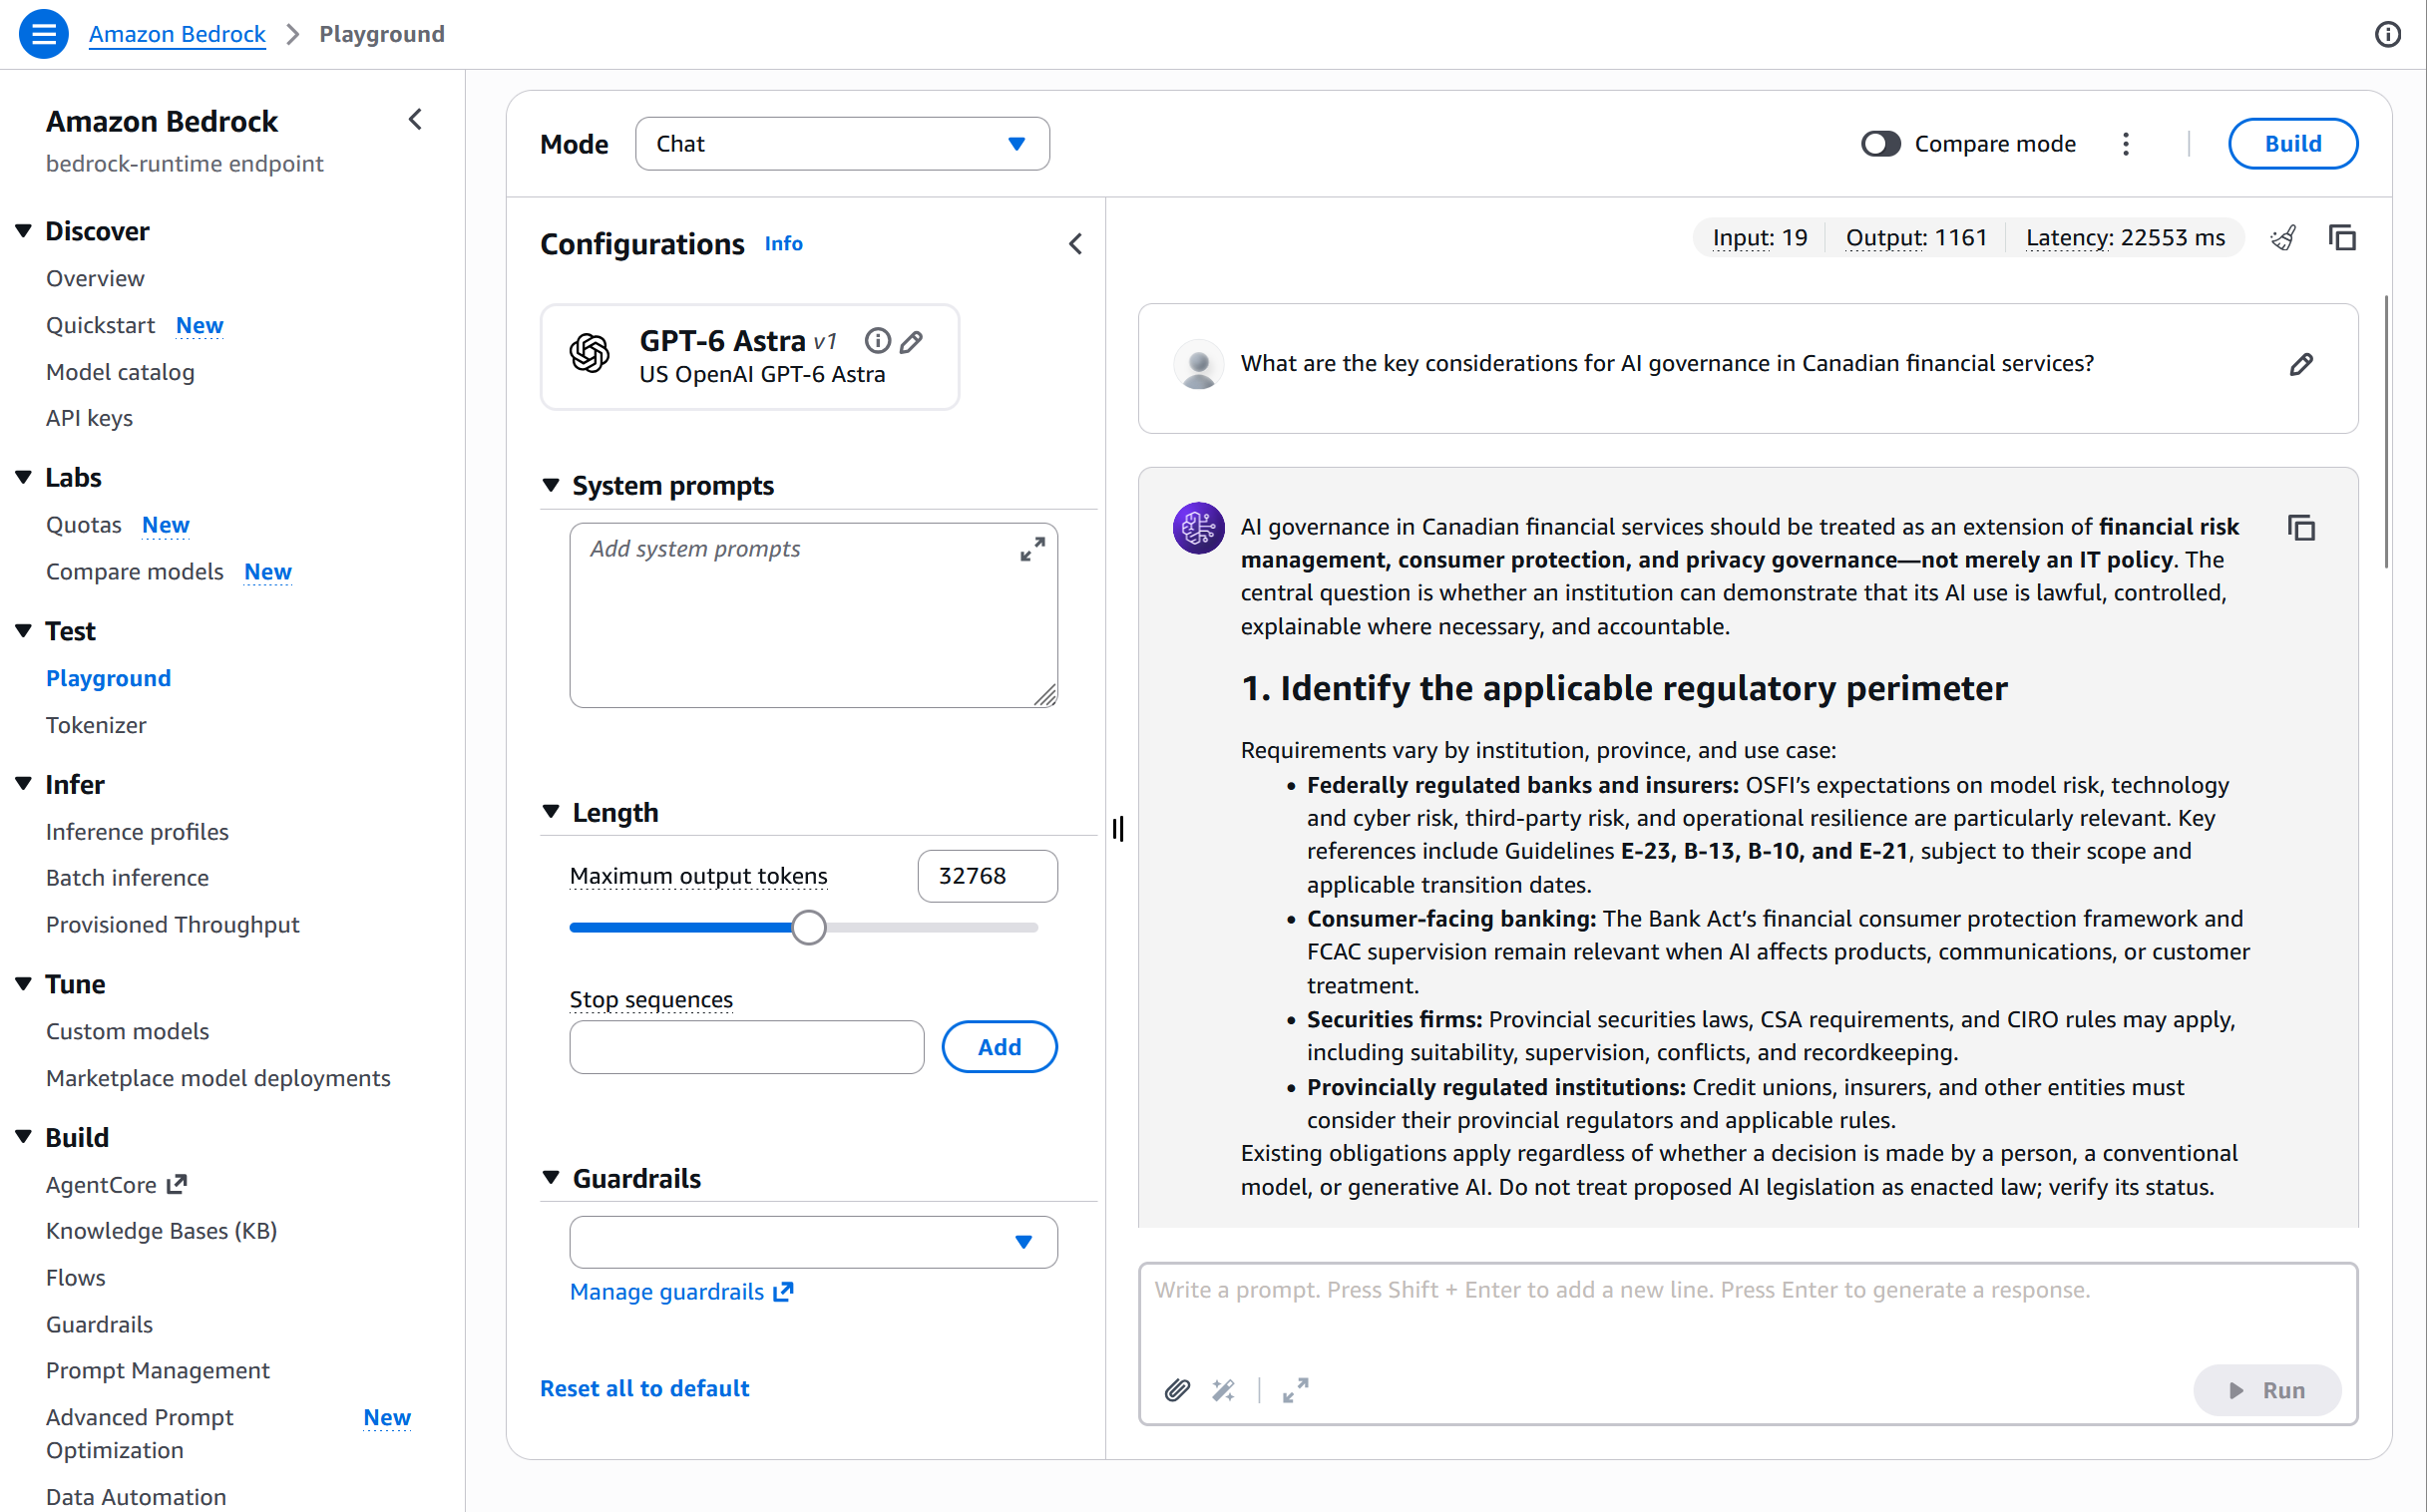
图 1:Amazon Bedrock 控制台中的活跃 OpenAI 跨区域推理配置文件(加拿大(中部))
通过 Amazon Bedrock Runtime 调用模型
GPT-5.6、GPT-6 和 GPT-6.1 在 bedrock-runtime 端点上支持三种访问路径:OpenAI Responses API、OpenAI Chat Completions API 和 Amazon Bedrock Converse API。OpenAI 兼容 API 通过该端点的 /openai/v1 路径调用。该端点接受 AWS Signature Version 4(SigV4)或 Amazon Bedrock API 密钥。
以下示例使用 适用于 Python 的 Amazon Bedrock 令牌生成器,根据您当前的 AWS 凭证创建短期 Amazon Bedrock API 密钥,因此您的应用程序无需存储静态密钥。
OpenAI Responses API
对于已使用 OpenAI SDK 和 Responses API 的应用程序,将客户端指向区域 Amazon Bedrock Runtime 端点,并将推理配置文件 ID 作为模型传入。
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

region = "ca-central-1"  # Use "ca-west-1" for Calgary
client = OpenAI(
    base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1",
    api_key=provide_token(region=region),
)

response = client.responses.create(
    model="global.openai.gpt-6-astra",
    input="What are the key considerations for AI governance in Canadian financial services?",
    max_output_tokens=1024,
)
print(response.output_text)
对于流式输出,设置 stream=True 并遍历响应事件,在文本到达时打印:
stream = client.responses.create(
    model="global.openai.gpt-6-luna",
    input="List five generative AI use cases for Canadian healthcare.",
    max_output_tokens=512,
    stream=True,
)
for event in stream:
    if event.type == "response.output_text.delta":
        print(event.delta, end="", flush=True)
OpenAI Chat Completions API
OpenAI Chat Completions 格式通过同一端点工作。
response = client.chat.completions.create(
    model="global.openai.gpt-5.6-terra",
    messages=[{"role": "user", "content": "Summarize recent AI regulatory trends in Canada."}],
    max_completion_tokens=1024,
    reasoning_effort="low",
)
print(response.choices[0].message.content)
有关支持的完整参数列表(包括推理工作量级别),请参阅 Amazon Bedrock 用户指南中的模型卡。
Amazon Bedrock Converse API
当您的应用程序通过 AWS SDK 调用 Amazon Bedrock 时,请使用 Converse API。Boto3 通过标准 AWS 凭证链解析凭证。
import boto3

bedrock = boto3.client("bedrock-runtime", region_name="ca-central-1")
response = bedrock.converse(
    modelId="us.openai.gpt-5.6-terra",
    messages=[{"role": "user", "content": [{"text": "Summarize recent AI regulatory trends in Canada."}]}],
    inferenceConfig={"maxTokens": 1024},
)
# GPT-5.6 and GPT-6 may return a reasoningContent block alongside the text.
# Select the block that contains the text output.
text_output = next(block["text"] for block in response["output"]["message"]["content"] if "text" in block)
print(text_output)
通过更改推理配置文件 ID,同一调用适用于 GPT-6 Sol、GPT-6 Luna 和 GPT-6.1 Sol。以下示例对 GPT-6 Sol 使用美国地理配置文件,对 GPT-6 Luna 使用全球配置文件。两者均已从 ca-central-1 验证。
# GPT-6 Sol, GPT-6 Luna, and GPT-6.1 Sol are called the same way. Swap the inference profile ID, and choose a us. (US geographic) or global. profile to match your data boundary.
# For example, GPT-6.1 Sol via the US geographic profile: modelId="us.openai.gpt-6.1-sol"
# GPT-6 Sol via the US geographic profile: strong reasoning and coding for complex work.
response = bedrock.converse(
    modelId="us.openai.gpt-6-sol",
    messages=[{"role": "user", "content": [{"text": "Summarize recent AI regulatory trends in Canada."}]}],
    inferenceConfig={"maxTokens": 512},
)

# GPT-6 Luna via the global profile: fast, low-cost inference for high-volume tasks such as classification.
response = bedrock.converse(
    modelId="global.openai.gpt-6-luna",
    messages=[{"role": "user", "content": [{"text": "Classify this ticket as BILLING, TECHNICAL, or OTHER: ..."}]}],
    inferenceConfig={"maxTokens": 256},
)
工具使用
这些模型支持客户端工具使用(函数调用)。在 tools 参数中定义工具,模型会返回结构化的工具调用请求,供您的应用程序执行。
response = client.responses.create(
    model="global.openai.gpt-6-astra",
    input="What's the current exchange rate from CAD to USD?",
    tools=[{
        "type": "function",
        "name": "get_exchange_rate",
        "parameters": {
            "type": "object",
            "properties": {
                "from_currency": {"type": "string"},
                "to_currency": {"type": "string"}
            }
        }
    }],
)

# The model returns a tool-call request rather than text.
for item in response.output:
    if item.type == "function_call":
        print(f"Tool: {item.name}, Args: {item.arguments}")
提示缓存
GPT-5.6、GPT-6 和 GPT-6.1 在 Amazon Bedrock 上支持提示缓存,以降低重复提示前缀的成本和延迟。隐式缓存无需更改代码:Amazon Bedrock 会自动缓存 1,024 个令牌或以上的符合条件的提示前缀。后续请求中读取的缓存令牌按折扣费率计费,且不计入您的每分钟令牌配额。缓存令牌会显示在响应 usage 对象和 Amazon CloudWatch 指标中,以便您跟踪使用情况。有关缓存写入定价、最小前缀大小以及对显式缓存断点的支持,请参阅提示缓存文档和各模型卡。
配额管理
bedrock-runtime 端点上的跨区域推理配额按每个模型的每分钟令牌数(TPM)计量。每个配额将输入和输出令牌合并计入单一限制。美国地理和全球推理配置文件有单独的配额分配,因此在它们之间切换会改变您使用的配额池。
令牌消耗合并计算输入令牌、缓存写入输入令牌和输出令牌。输出令牌会乘以模型的消耗速率,因此输出密集型工作负载消耗配额的速度比原始令牌计数所显示的更快。在生产部署之前,请尽早申请配额增加并监控配额利用率。使用有代表性的提示、输出长度、流式行为、并发和峰值流量进行测试。
要申请提高配额,请按以下步骤操作:
- 在
ca-central-1或ca-west-1中打开 Service Quotas 控制台。 - 选择 Amazon Bedrock,然后为您所需的模型选择名为“Cross-Region InvokeModel tokens per minute”的配额。
- 选择 Request increase at account level,输入目标值,然后提交请求。
有关 token 用量和成本如何跟踪的详细信息,请参阅 Track usage and costs in Amazon Bedrock。
可观测性
由于这些模型通过 Amazon Bedrock Runtime API 运行,通过推理配置文件发出的请求会像按需请求一样出现在您的可观测性工具中。调用日志和 Amazon CloudWatch 指标会记录在您的源区域中。无论请求在何处处理,这一点都成立。您的可观测性数据始终集中在一处。
- AWS CloudTrail logs every request, recording which destination Region served it in the
additionalEventData.inferenceRegionfield. For example:"additionalEventData": { "inferenceProfileArn": "arn:aws:bedrock:ca-central-1:111122223333:inference-profile/global.openai.gpt-6-astra", "inferenceRegion": "us-west-2" } - Amazon CloudWatch 指标按推理配置文件发布,涵盖调用次数、token 数量、延迟、限流和错误。
- 模型调用日志会将完整的请求和响应负载投递到 Amazon Simple Storage Service (Amazon S3) 或 Amazon CloudWatch Logs。要在 Amazon Bedrock 控制台上启用它,请选择 Settings,然后选择 Model invocation logging。您也可以调用
PutModelInvocationLoggingConfigurationAPI。该功能默认关闭。 - AWS Data Exports 按模型和配置文件逐项列出支出。
Amazon CloudWatch Coding Agent Insights
如果您使用这些模型为 OpenAI Codex 等 AI 编程助手提供支持,Amazon CloudWatch Coding Agent Insights 提供了一个专用仪表板。它按部门、团队和环境等维度展示 token 用量、API 请求数、活跃用户和成本归因。要启用它,请配置您的编程代理将遥测数据导出到 Amazon CloudWatch。有关设置步骤,请参阅 Set up OpenTelemetry for OpenAI Codex。
清理
为避免测试后产生持续费用,请移除您创建的资源:
- 关闭模型调用日志。在 Amazon Bedrock 控制台上,选择 Settings,然后选择 Model invocation logging,或调用
DeleteModelInvocationLoggingConfiguration。这会停止向 Amazon S3 和 Amazon CloudWatch Logs 投递日志。 - 删除或分离您为测试创建的 IAM 策略和任何 Amazon Bedrock API 密钥。
推理配置文件本身是系统定义的,未使用时不会产生费用。
安全与合规
跨区域推理旨在保护传输中和静态的数据。请求通过使用 TLS 1.2+ 加密的 AWS 私有骨干网传输,而非公共互联网。对于加拿大客户,您的静态数据默认保留在源区域。这包括调用日志、知识库和配置。只有临时的推理计算在目标区域进行,并且默认情况下模型提供商无法访问您的提示或补全内容。
有一项针对 OpenAI 模型的特殊考虑。被自动滥用分类器标记的内容可能会在目标区域保留最多 30 天以供审查。如果您希望将处理限制在北美(加拿大和美国),可以选择美国地理配置文件。我们建议与您的合规团队一起审阅 Amazon Bedrock abuse detection。
有关加拿大数据驻留模式的更详细介绍,请参阅 Cross-Region Inference and Canadian Data Residency: A Technical Architecture Guide。
结论
在本文中,我们展示了如何从加拿大访问 OpenAI GPT-5.6(Sol、Terra 和 Luna)、GPT-6(Astra、Sol 和 Luna)以及 GPT-6.1 Sol。这些模型可通过 Amazon Bedrock 上的跨区域推理,在加拿大(中部)和加拿大西部(卡尔加里)区域使用。我们介绍了可用的推理配置文件、如何设置权限和示例 SCP,以及如何使用 Responses、Chat Completions 和 Converse API 调用这些模型。对于 Responses API,我们提供了流式传输和工具使用示例。我们还展示了如何申请配额增加、查看使用情况以及清理测试资源。
要开始使用,请查看 Amazon Bedrock 用户指南中的 OpenAI 模型卡,然后打开 Amazon Bedrock 控制台并通过推理配置文件发送测试提示。有关定价,请参阅 Amazon Bedrock 定价页面。
如果您有任何问题或反馈,请在本文下留言。
关于作者

Roopesh Ramklass
Roopesh 是 AWS 的 AI/ML 专业首席解决方案架构师,常驻加拿大温哥华,帮助客户设计和扩展生成式 AI 解决方案。他在 AI/ML 领域拥有深厚专业知识,与各组织合作,将雄心勃勃的 AI 构想转化为可靠、高影响力的解决方案。

Dan MacKay
Dan 是 AWS 加拿大的金融服务合规专家。他就云和 AI 相关治理、风险与合规方面的推荐实践和实用解决方案为客户提供建议。Dan 专注于帮助 AWS 客户应对加拿大境内使用云和 AI 技术所适用的金融服务和隐私法规,重点关注数字主权、第三方风险管理和运营韧性。

Prasoon Gupta
Prasoon 是 Amazon Web Services (AWS) 加拿大的解决方案架构师。他乐于帮助公共部门客户实现现代化,并从云中获得最大价值。工作之余,他喜欢在 AWS 上构建全栈 AI 工具作为消遣,涵盖无服务器架构、代理式 AI 和开发者平台。

Saurabh Trikande
Saurabh 是 Amazon Bedrock 和 Amazon SageMaker Inference 的高级产品经理。他热衷于与客户和合作伙伴合作,以推动 AI 民主化为目标。他专注于部署复杂 AI 应用、多租户模型推理、成本优化以及让生成式 AI 模型的部署更易获取等核心挑战。业余时间,Saurabh 喜欢徒步、了解创新技术、关注 TechCrunch,并与家人共度时光。

Melanie Li
Melanie 博士是 AWS 驻澳大利亚悉尼的高级生成式 AI 专业解决方案架构师,专注于与客户合作,使用最先进的 AI/ML 工具构建解决方案。她积极参与亚太及日本地区的多个生成式 AI 计划,充分发挥 LLM 的能力。加入 AWS 之前,Li 博士曾在金融和零售行业担任数据科学职位。

Zohreh Norouzi
Zohreh 是 Amazon Web Services (AWS) 的高级安全解决方案架构师。她帮助客户做出良好的安全选择,并加速他们迁移到 AWS 云的进程。她积极参与 AI 安全计划,利用自己的专业知识帮助客户大规模构建安全的 AI 解决方案。
来源:AWS Machine Learning Blog · aws.amazon.com