用自回归扩散模型生成市场数据可行吗?Jane Street 实习生 Kavish 的探索
Can you use autoregressive diffusion to generate market data?
Jane Street 实习生 Kavish 用自回归扩散模型生成美股市场数据,发现完全连续的扩散模型难以拟合真实市场数据的尖峰分布,DDPM 训练不稳定、去噪轨迹爆炸,88-95% 的数值偏离分布均值 8 个标准差以上,改用 flow matching 后开箱即用。
以下是关于 2026 年暑期实习项目系列文章的一部分——更多内容,请见 “实习生们创造了什么,2026 特别巨献版”
在量化金融中,我们习惯于使用这样的模型:它接收给定符号(如订单簿中新增的挂单、这些订单的取消、成交)的一系列市场数据事件流,并预测该符号的未来价格。生成式模型则不那么常见。想象一个模型,它不仅能给出某个符号价格的点估计,还能真正合成订单簿事件——包括这些事件到达交易所的时间。当然,你会得到价格预测,但你的推演将拥有远比这丰富得多的质感。
但市场数据究竟是什么样的数据?生成式模型要求回答这个问题。它更像视频,还是文本?也就是说,它是连续的还是离散的?市场数据似乎兼具两者的特征。订单簿通过一系列轮次演变,市场参与者挂上或撤下挂单;毫无疑问存在一个离散的动作空间。然而,给定订单的许多最重要参数,比如其价格,基数如此之高,以至于它们基本上表现为连续的。有些则确实是连续的:一个容易被忽视但对生成式模型至关重要的参数是时间,即“新订单何时到达交易所”。即便如此也过于简化了。实际上,分布是尖峰状的:“pennying”(即你以一个最小变动价位改进价格)比改进两个最小变动价位要常见得多,而且订单往往成批到达,例如在整数时间附近。
探索这些复杂情况的一种方法是,把你的数据当作连续的来处理,看看它在哪些地方会出问题。今年夏天,研究实习生 Kavish 为市场数据构建了一个扩散模型。扩散模型和流匹配模型是在诸如图像、视频、机器人和音频等领域中表示序列化、多模态数据的强大工具。受Autoregressive Image Generation without Vector Quantization的启发,Kavish 使用自回归扩散创建了一个事件级的市场数据生成模型。
过程中有一些技术发现——例如,Kavish 发现 DDPM 虽然在理论上非常适合扩散模型中的去噪,却发散了,而流匹配的表现要好得多。但最重要的结果是,完全连续的扩散并不适应真实市场数据的锯齿状特征。Kavish 一方面通过平滑处理点质量,另一方面将模型的一些目标离散化,这些各种尝试极大地阐明了市场数据的最终生成模型可能是什么样子。
建模与设置
Kavish 研究了四年的美国股票数据,每一行数据包含时间戳、价格、类型(成交、订单、取消等)以及其他信息。扩散模型会尝试为下一个事件生成这些特征,然后该事件被自回归地追加到流中。
继上文引用的 Li 等人的论文之后,他采用了编码器–扩散器架构,具体来说是一个因果掩码的 transformer 编码器,用于在每个位置生成潜在嵌入。在训练过程中,每个位置的潜在表示被送入一个小型事件类型头,该头输出一个二分类概率分布,指示下一个事件是交易还是 BBO 更新(“最优买卖报价”)。连续目标,如价格、经过时间等,则通过扩散头生成,该扩散头以对应的潜在表示和真实事件类型为条件,采用标准的 AdaLN 条件化。
在推理时,你只将最后一个事件的编码潜在表示传入事件类型头,并从输出分布中采样一个事件。下一个事件的连续特征则通过扩散头生成,以最后一个事件的潜在表示和采样得到的事件为条件。
DDPM 与流匹配
DDPM 或“去噪扩散概率模型”预测添加到样本中的噪声,并通过减去缩放后的噪声预测值并除以剩余信号水平来推导出干净的估计。DDPM 在图像生成等领域非常成功,但在高噪声水平下,噪声预测中的小误差会导致干净目标估计中的大误差。流匹配则是在噪声和数据之间进行线性插值,并训练网络预测沿该线的速度(数据减去噪声)。因此,采样轨迹几乎是直线,流模型可以在相对较少的步骤中准确积分。
从根本上说,这是同一目标的两种不同参数化方式,但 Kavish 发现这些差异相当重要。他最初的扩散头在 1,000 步余弦调度上进行预测,正如 Improved DDPM 所推荐的那样。在推理时,生成过程遵循 DDIM 进行。不幸的是,这种配置不稳定,导致去噪轨迹爆炸,在所有 7 个连续目标上,88-95% 的值偏离分布均值超过 8 个标准差。请注意图中最左侧的方框,轨迹(那些细小的粉色丝线,在背景中几乎看不见)迅速发散到边缘。
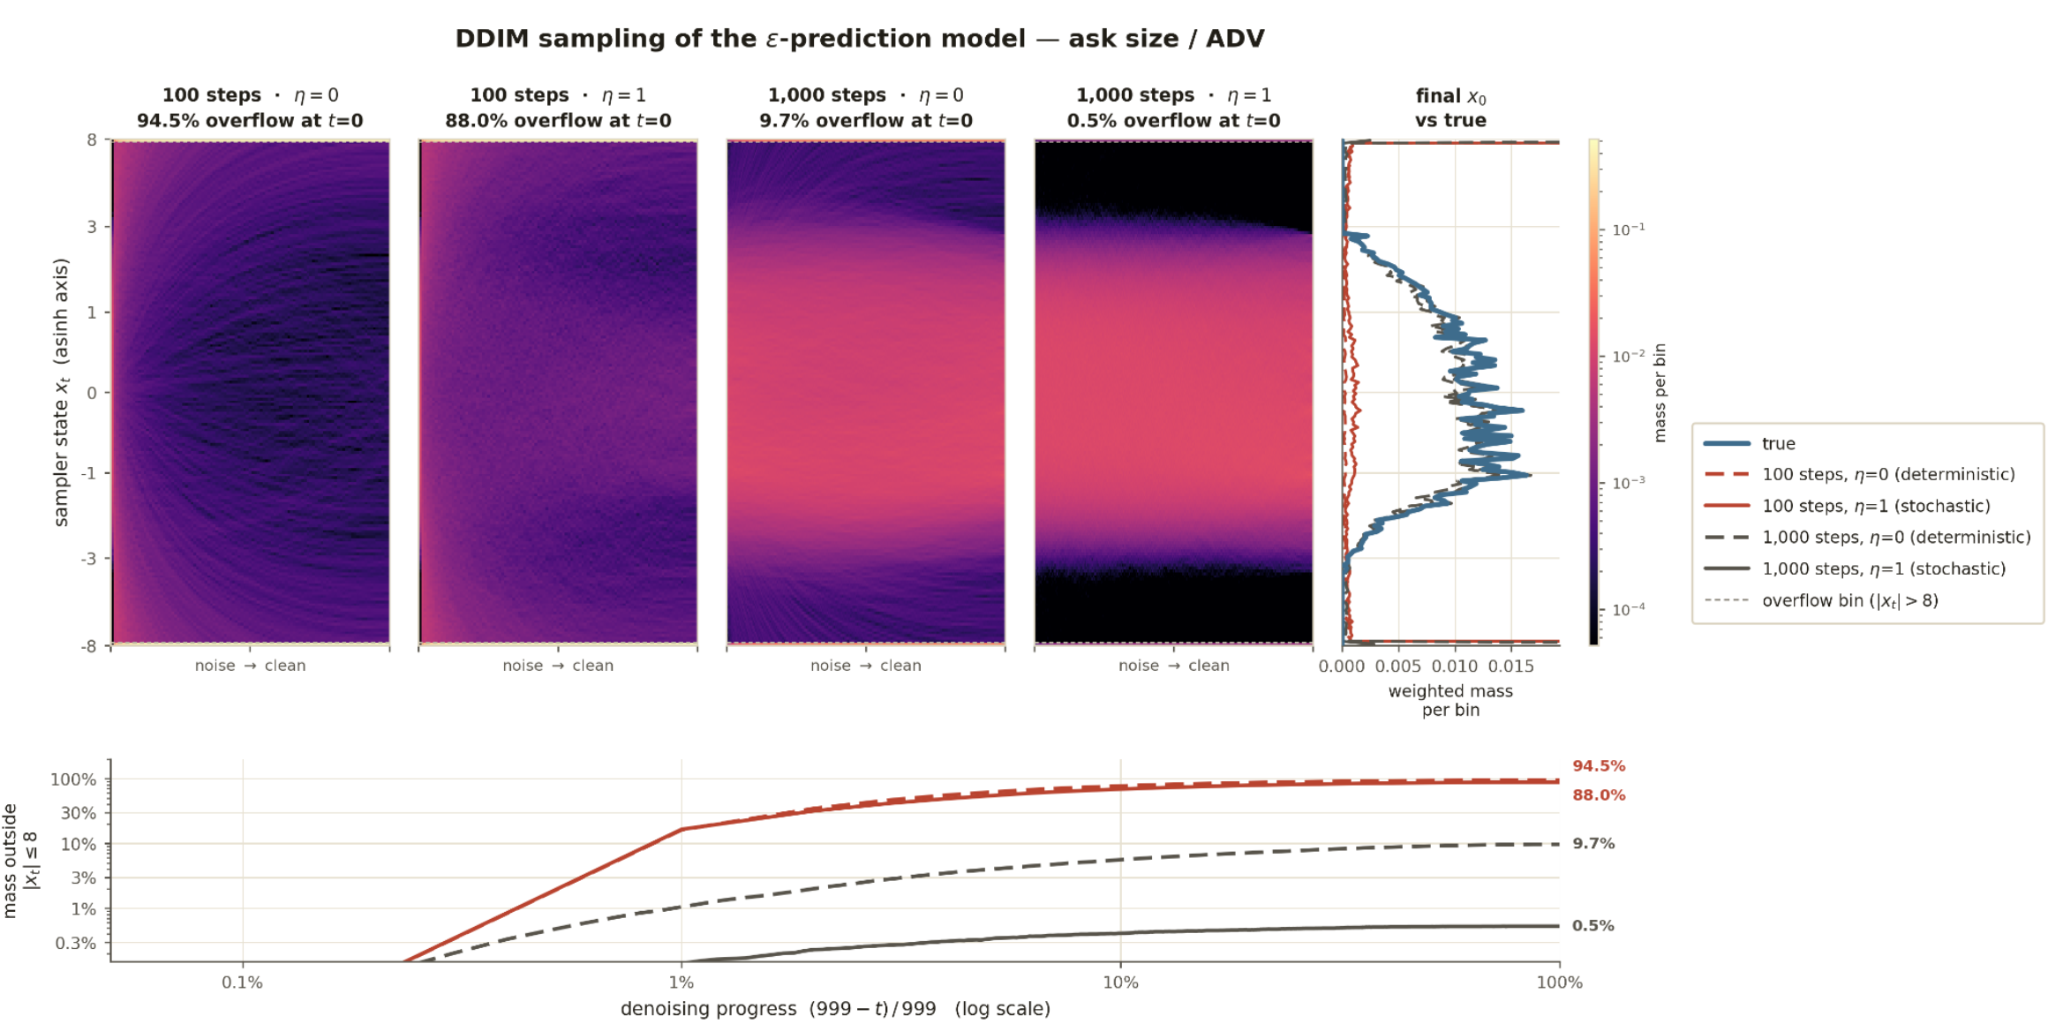
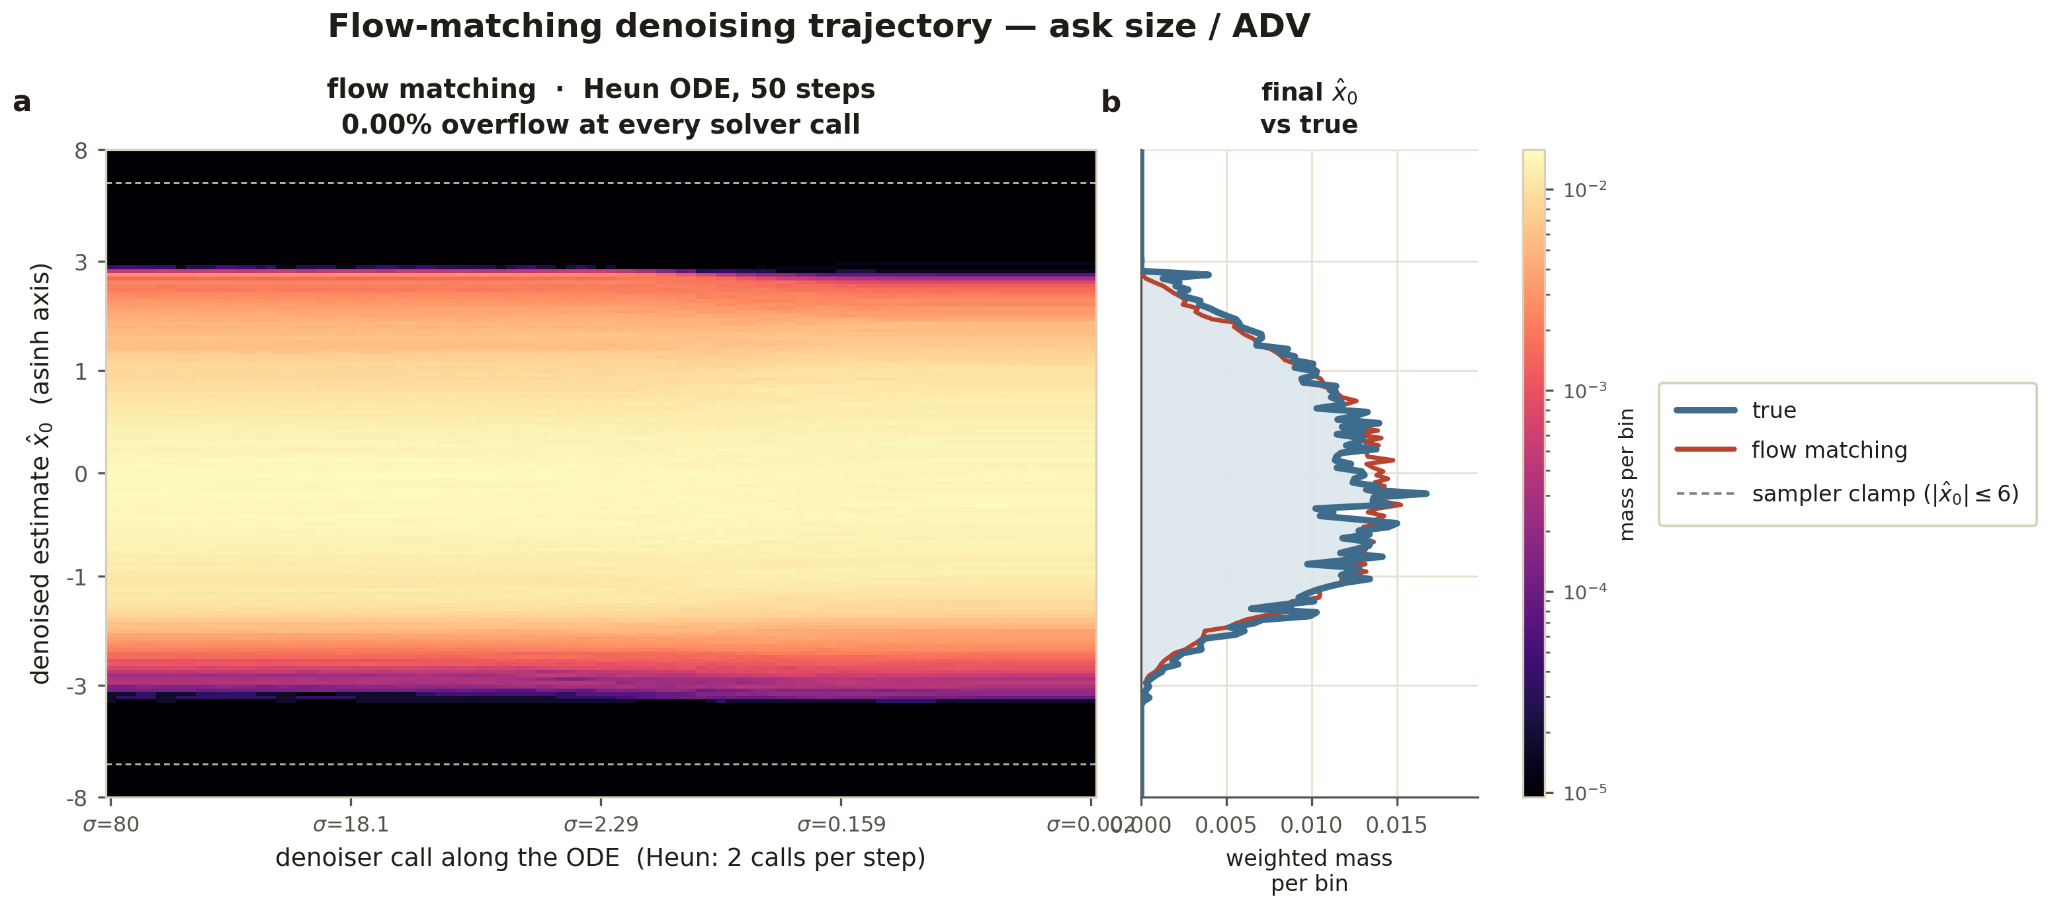
这是由计算 时的缩放引起的。如图所示,使用更多的采样步骤会减少每步的增量,从而防止溢出量。此外,在采样过程中添加随机性()会将去噪过程正则化为标准高斯分布,减少偏差。但是,虽然可以调整噪声调度来解决这种不稳定性,或在推理时进行干预以防止去噪爆炸,Kavish 发现修正流方法开箱即用效果很好。因此他切换到了流匹配模型。
处理不连续性
项目的大部分时间都在解决一个基本问题:市场数据既不完全连续也不完全离散。例如,视频——扩散模型非常适合处理——在快照(每一帧是一系列连续的像素强度和颜色)和演化(像素在帧与帧之间可以取任何连续值)上都是连续的。相比之下,市场数据具有连续快照,但以非常离散的方式演化,受市场微观结构支配。
当你查看特征的分布时,这一点很明显,这些分布的特点是具有 尖锐的边界:
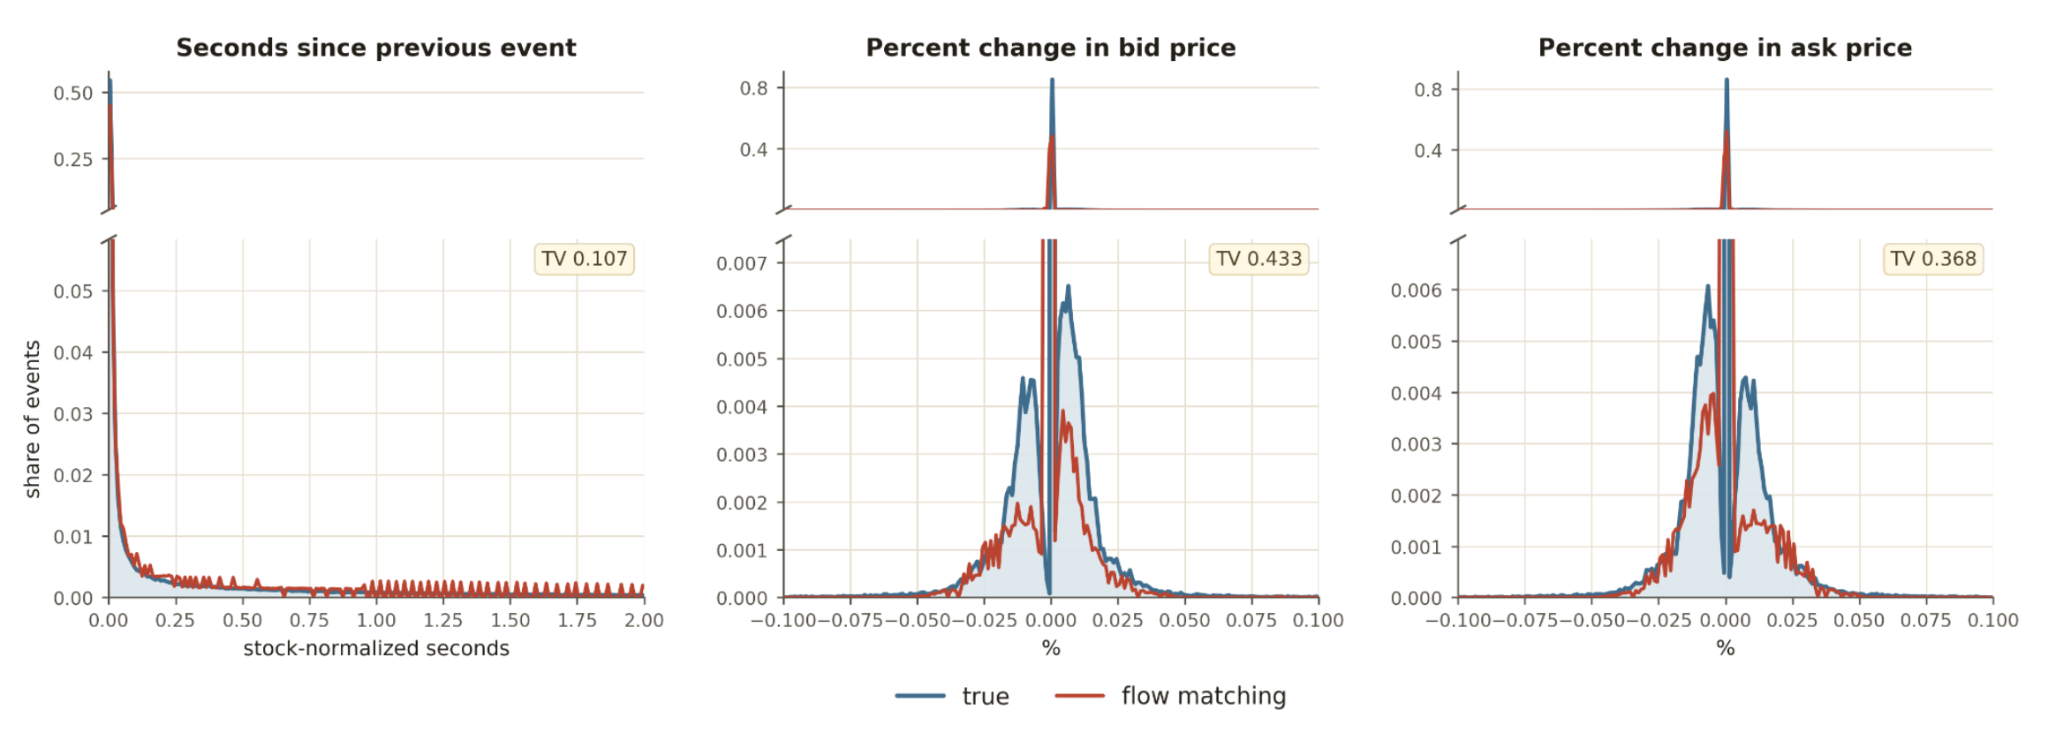
订单的时间分布并非正态分布,而是相当聚集,在零秒附近(同时到达的事件)、 最早可能反应时间以及整数秒处存在点质量。而价格往往聚集在 买卖报价的中点、当前买价或当前卖价附近,因此你也会在那里看到 尖锐的不连续性。
由于类别预测中也存在不平衡——只有 8% 的事件是交易, 其余是 BBO 变化;因此类别头会过度预测交易——Kavish 尝试拆分类别头预测的类别数量。他将 BBO 变化分解为一系列常见类别,如“仅数量”(价格无变化)或 “卖价上涨”、“买价下跌”等。这还有一个额外好处,使他能够分解出 某些特征中的“原子”(或尖锐的不连续性),从而可以将经过时间为零 预测为其自己的类别。他最终得到了一个 20 类的类别头,以及 更简单的扩散目标,如“非零时间间隔有多大”(因为零已由类别处理) 和“买价变化的幅度是多少”(因为方向是一个类别)。
这种方法使事件类型和连续目标的边际分布都得到了实质性改善, 但显然涉及大量手工工程。使用类别头来专门建模每个特征中的每个不连续性, 在更大的特征集中变得不可扩展。例如,真实数据可能包含多得多的变量,包括 像“这是在哪个交易所?”这样的高基数变量,可能使 类别数量爆炸式增长。
因此 Kavish 开始寻找另一种处理不连续性的方法。
原子平滑
他使用了一种他最终称之为“原子平滑”的方法。其思路是取真实的、 尖峰分布,将其平滑,然后重新雕刻出尖峰,以一种能够捕捉那里的概率质量 而不产生不连续性的方式。例如:
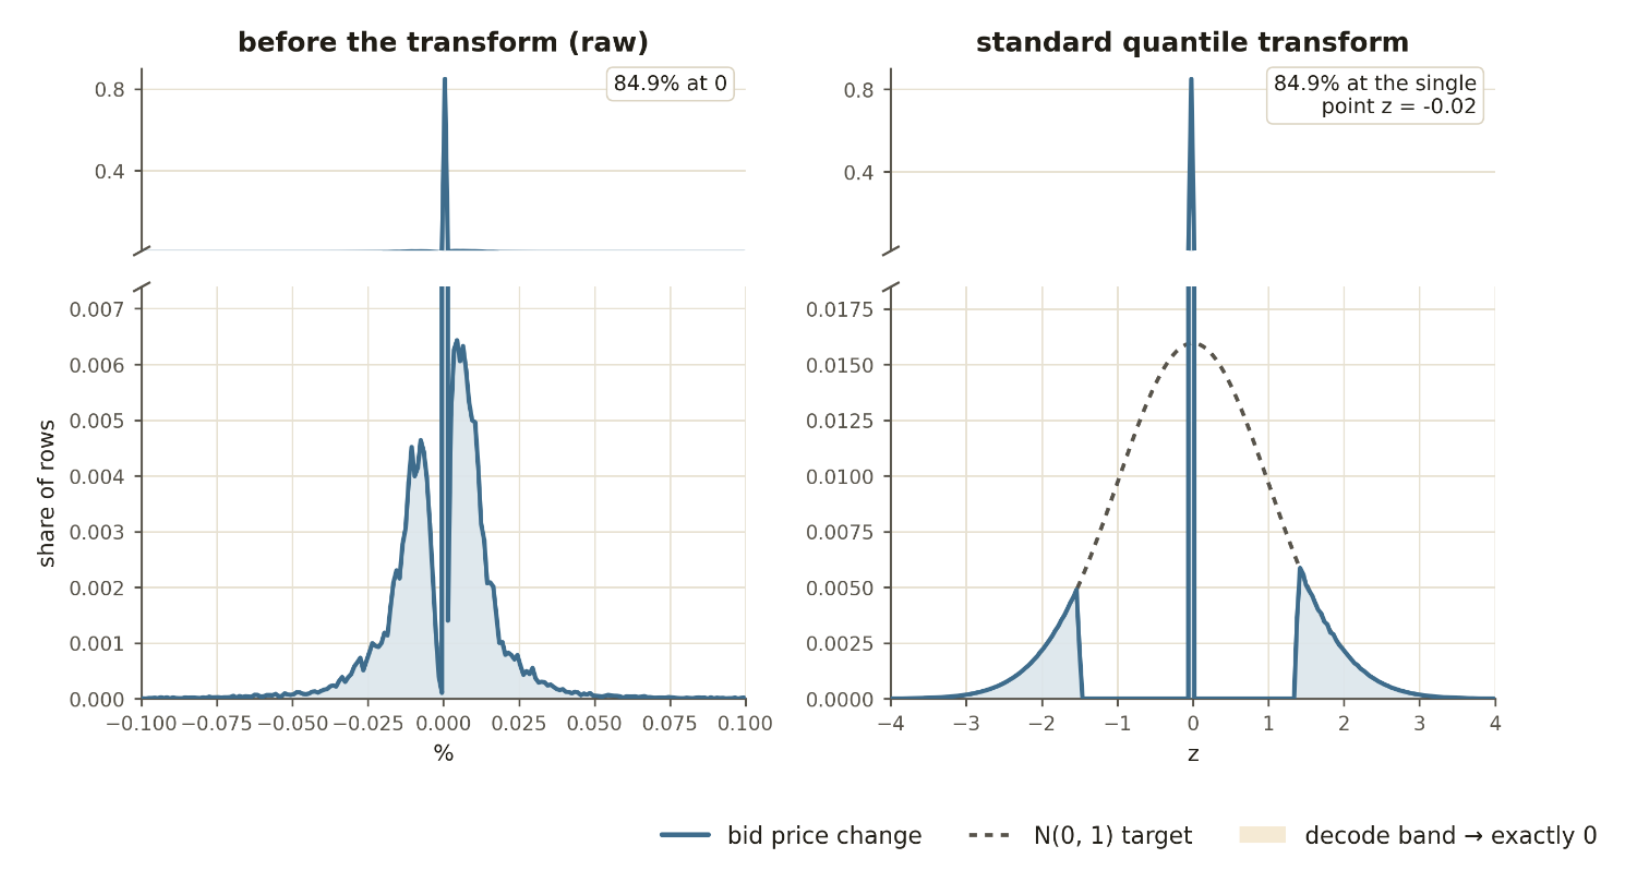
为了使其良好运作,你必须确保为变量选择正确的表示: 在某些表示下的尖锐尖峰在另一种表示下会不那么尖锐, 你需要暴露并平滑任何尖锐尖峰。
结果与部署
Kavish 发现,采用流匹配和原子平滑的扩散模型效果相当 不错。他将模型输出的每个目标的边际分布与 真实边际分布进行了比较。这是在一步设置中完成的:他以 10,240 个事件的真实 上下文为条件,从模型中抽取单个下一个事件,并将其与 实际发生的事件进行比较。他通过总变分(TV)散度量化了与真实每个目标 边际分布的偏差,计算为 两个分布 和 之间的。
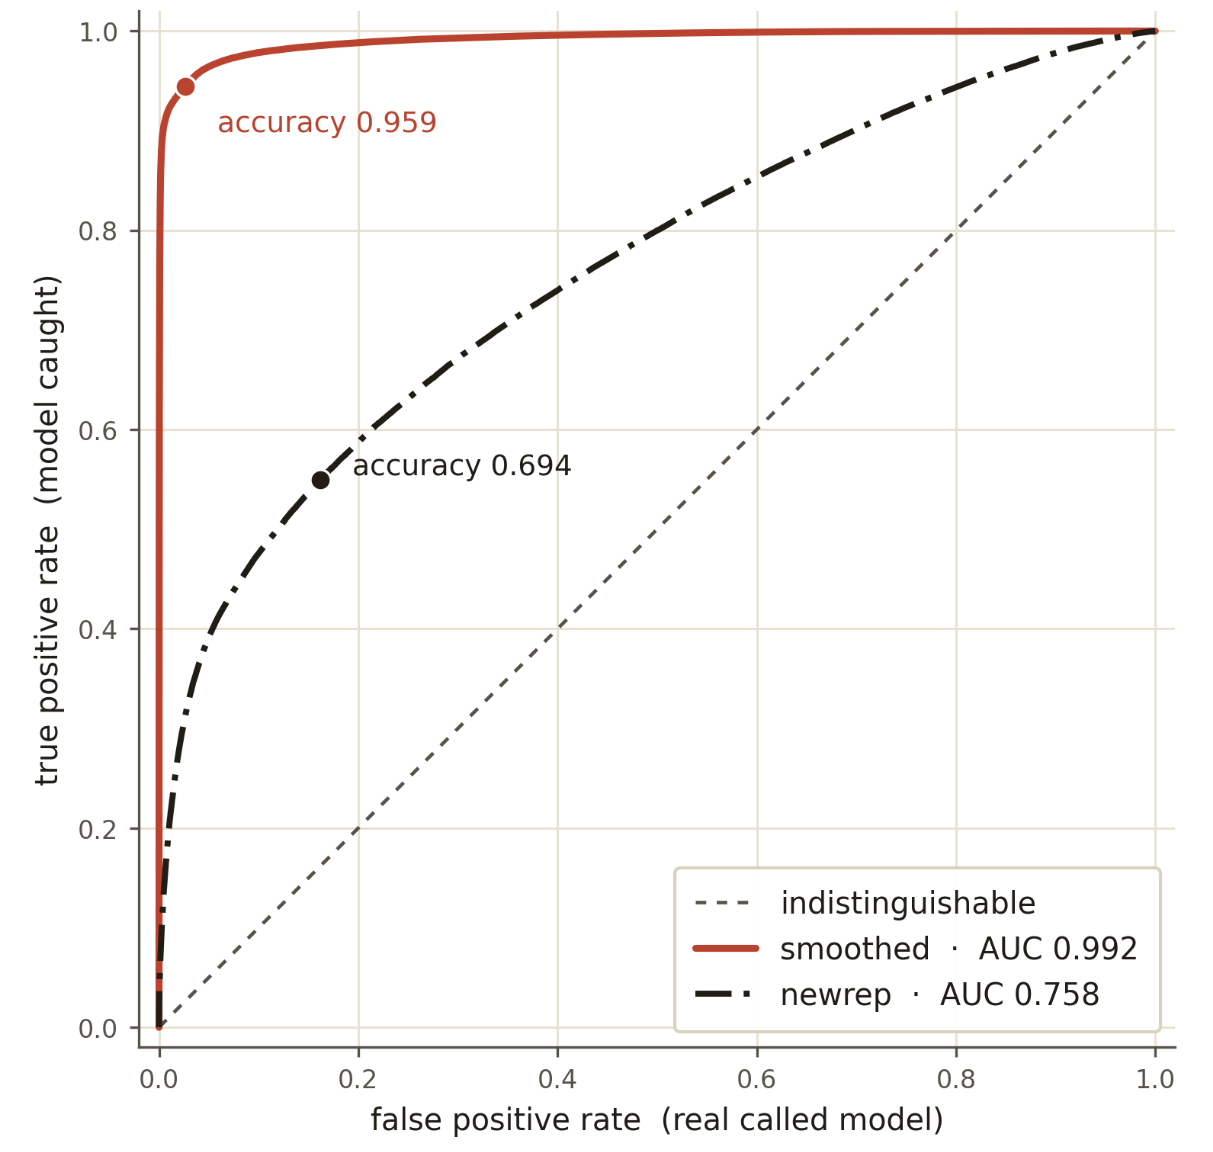
尽管边际分布的对齐很重要,但它并不能捕捉特征之间的联合 关系,或与先前上下文的时间一致性。因此 Kavish 还 训练了一个分类器来区分模型生成的预测和真实 事件。该分类器读取一个真实上下文事件窗口,后跟一个 候选下一个事件,并预测该候选是来自模型还是来自 数据。针对原子平滑优化了特征表示的生成器 产生了更加逼真的样本:
当然,该模型的最终目标是生成自回归的推演结果:
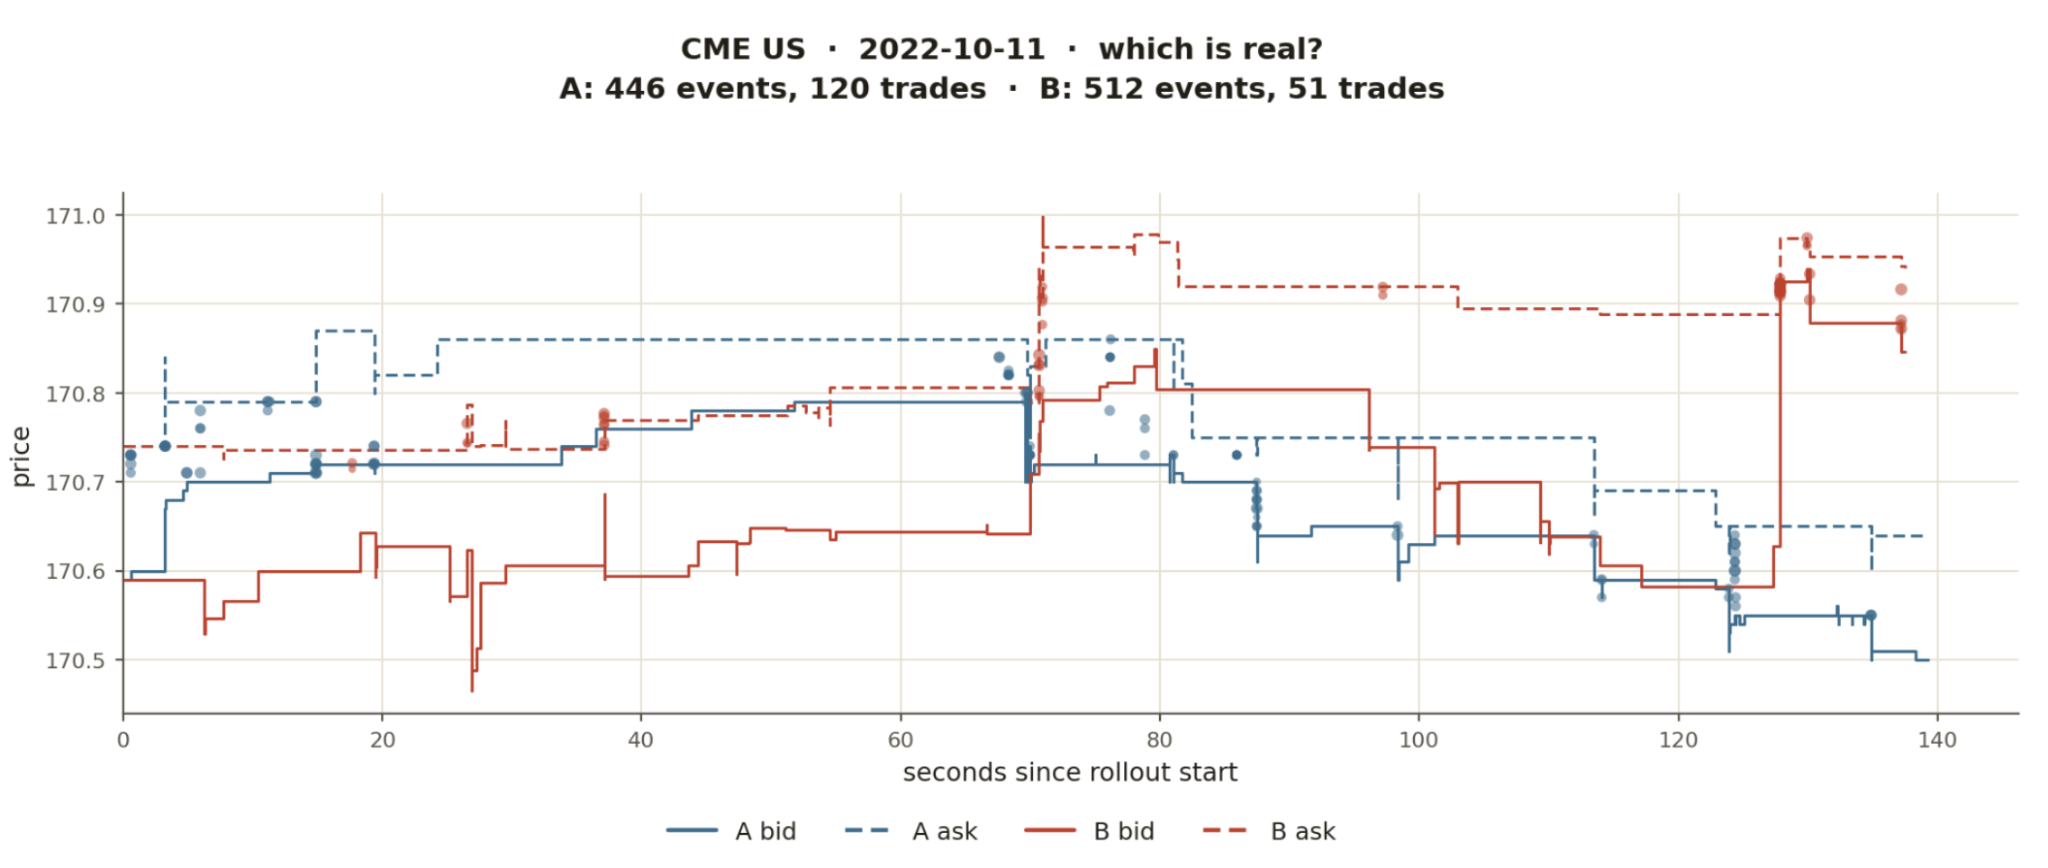
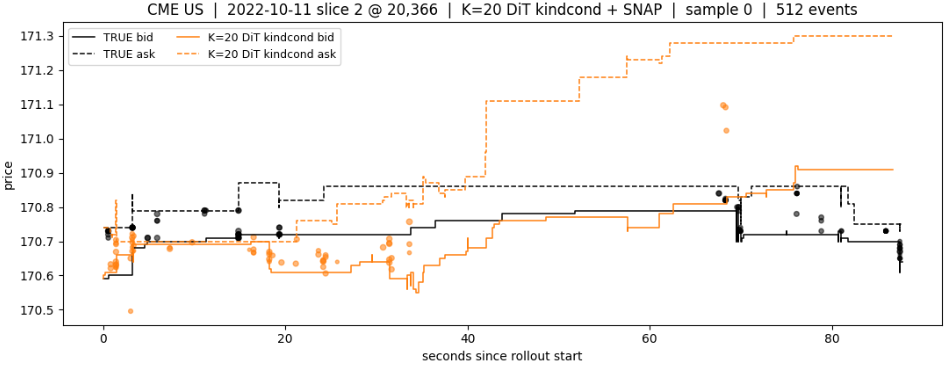
随着预测时间越往后,模型的预测自然会退化,进一步研究的一个问题是:退化程度有多大?在第二张图中,你可以看到在合成推演中 CME US 的分布是如何变宽的。
Kavish 的模型还不够精确,尚不能作为现实的生成器,但他在实习期间的研究明确了哪些是关键调节点:你应当在模型中融入多少离散性?(也就是说,究竟哪些内容应当以分类方式预测,哪些应当用扩散方式预测?)以及你如何表示和平滑特征分布,从而为扩散提供最佳条件?
该项目帮助我们认识到,市场数据订单簿事件同时存在于连续空间(“卖价数量增加 10%”)和离散动作空间(“买价改为 penny”)中。这是看待同一事物的两种方式。如果你想生成市场数据,就必须正确地建模这种混合。
期待明年夏天……
如果你有兴趣从事类似的工作,欢迎申请!更多详情请见:Jane Street 实习项目。我们 2027 年 ML 研究实习的申请现已开放!
来源:Hacker News · blog.janestreet.com