用编码智能体在 FPGA 上跑 LLM:从 6 到 213 tokens/s 的 33 倍优化实录
Vibecoding an inference chip
作者 Ankit Gupta 用 Codex 等编码智能体在 AWS F2 FPGA 实例上跑通了一个三元权重 LLM,并经过 14 步优化把吞吐从 6.43 tokens/s 提升到 213.13 tokens/s,约 33 倍。
更准确地说,我用 vibe coding 的方式让一块 FPGA 跑起了 LLM。而且它……就这么跑通了。
2026年11月20日,星期五
最近编程领域比较有意思的一点是,编码智能体让我能够进入全新的领域,因为它们让我接触到新的编程语言和范式。最近,这意味着折腾硬件,因为现在写底层软件容易多了。所以,在这篇博客里,我打算试着回顾一下 vibe coding 一块 FPGA 的经历,其间经历了一连串“我靠”时刻,也让我对在有大量 token 预算(感谢 YC)和有趣问题可以丢给模型的情况下能做到什么,有了新的认识。
我最近无意中听到一些创始人谈论 FPGA 的工作原理。我承认自己对它们相对无知。我在创业公司或大学期间从未真正实验过它们,所以之前对它们了解甚少。我熟悉的基本概念是:你可以把电路编程进一块可重编程芯片。因此,你不需要通用计算架构(比如 CPU),而是可以拥有一个可重编程的架构,也就是说,加载到芯片上的配置决定了其逻辑和布线如何连接,而这(理论上)能带来性能优势。我也知道这需要写一大堆 C++,还涉及手动分析波形来进行仿真和验证。不过我以前从没做过,而且这看起来挺繁琐。
这大概就是我入门时的认知。
自然,我的 ML 大脑想:“我们能不能把这些用于 AI 推理”。我不是第一个这么想的人——GitHub 上有几个仓库尝试把 ML 模型移植到 FPGA 上。但我还没真正看到过一篇写清楚的报告,说明编码智能体是否擅长编写底层 C++ 和 Verilog 代码来给它们编程,并验证输出,使它们真正准确运行。(剧透:它们在给 FPGA 编程方面简直不可思议。)
所以我决定得弄一块来上手。AWS 有带 FPGA 硬件的 F2 实例,这似乎比去买物理硬件更容易,所以我让 Codex 启动了一个预留实例,然后就开始动手了。它的内存相对有限,只有 16 GB 的 FPGA HBM。差不多同一时间,我在和 DeepGrove 的创始人们合作,他们正在讨论他们新的三值权重架构,这种架构非常适合内存受限的场景。它在 Mac 硬件上配合实际的智能体工具调用达到了 SOTA,所以我想,为什么不呢,看看我能不能让它在 FPGA 上跑起来,而且快到足够有用。
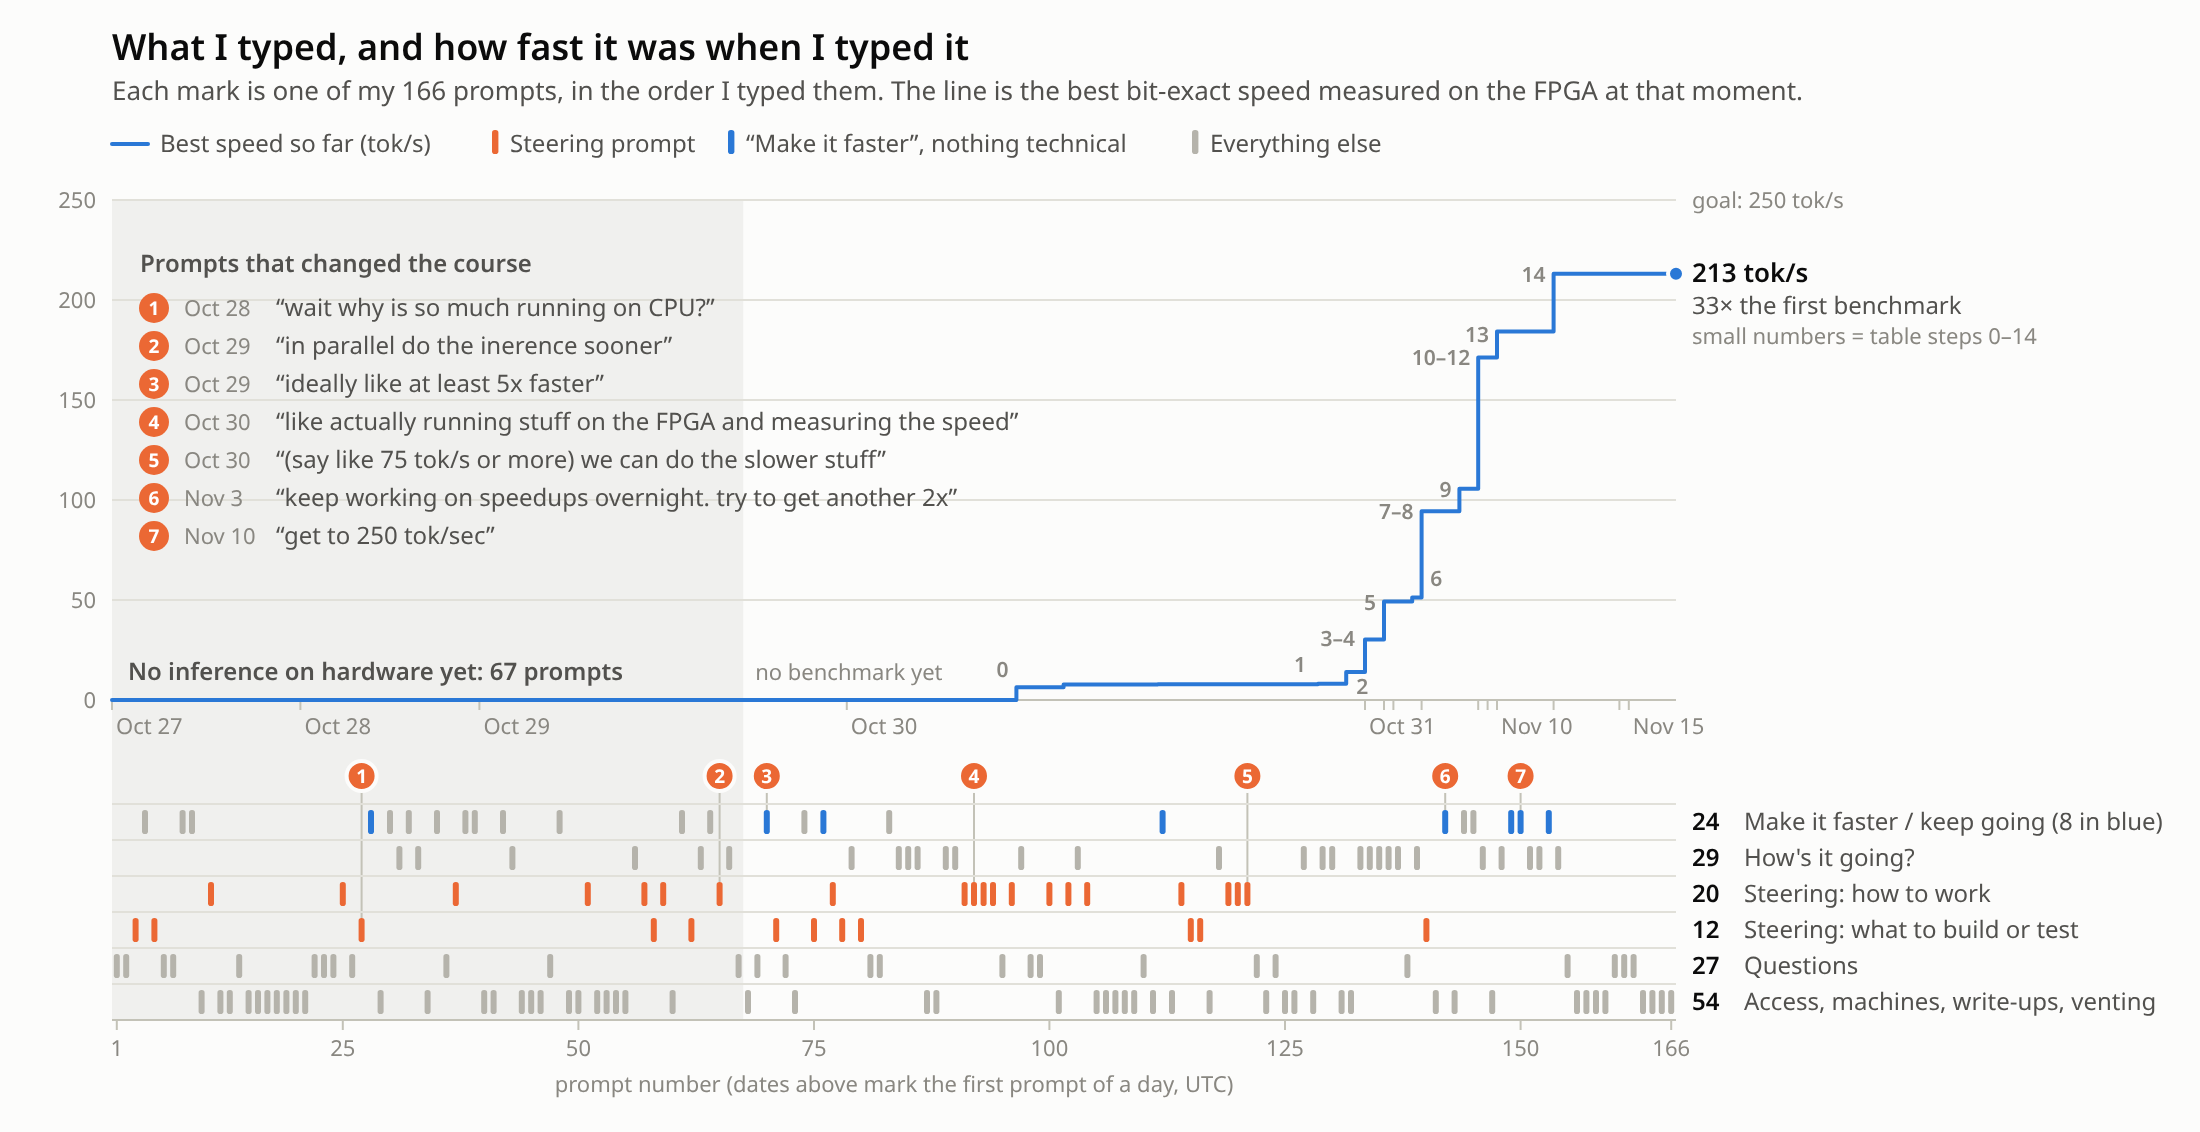
接下来发生的事情是:一个云代理在 Conductor 中运行了数天,我大多只是时不时地鼓励它,而它同时(1)让一个模型完全跑起来,并且(2)从第一个全模型位精确基线开始,把速度提升了 33 倍,使其达到实时相关的速度。这是我运行过的最令人震撼的自动研究循环之一,最终在实验历史中写下了大约 300 万行代码,并解析了 3000 万行输出文件,只花了 1 万美元的 Claude 和 OpenAI token 费用就运行了数百次实验。大部分代码是 C++,还有一些 Verilog。我大概有十年没写过任何严肃数量的 C++ 了,而且我从未写过 Verilog。老实说,我对 Verilog 一窍不通。我的大多数提示词并不是特别巧妙:它们大多只是我说些像“你是一个超级智能模型,是时候更有创造力了”和“让我们争取快 2 倍,你能做到的”这样的话。有时我会带入一些机器学习方面的知识,比如“嘿,是时候考虑投机解码了”或者“为什么那个在 CPU 上运行,你应该把它移植过去”。但大多数时候,只是凭感觉,而且我很确定只要有足够的时间,模型自己就能想出那些东西。另外,看起来 Astra 和 Opus(新的 Fable 还没发布)在这方面都相当有能力,我可以互换使用它们。我确信有人有很好的基准来评判哪个更聪明,但两者都通过了我“足够聪明”的门槛。
从“它能工作”到每秒 213 个 token
实测基准 tokens/s · 选择一个步骤查看变化
步骤 14 · 基线的 33.13 倍
一个同时读取两个内存库的头部加载器(+17.3%,在单张图像上开和关测量),一个运行时专家预取策略,以及路由任务时序修复;在浸泡测试发现 231.25 处有随机故障后,降低一个时钟步长运行(225/425 MHz)。
图表遵循实测的优化序列:6 → 213 tokens/s,即基线的 33 倍。
人类的建议有多大帮助?
在某个时候,大约当它达到 10 TPS 时,我发消息给 DeepGrove 的创始人谈了这件事,他们回复说很惊讶它竟然如此轻松地工作,说他们几个月前试过这个,模型还不够好,无法特别有效。他们发给我一个提示词,总结了他们的一些经验教训,我把它复制粘贴到我的会话中,看看是否有影响。这基本上是我在这次会话中添加的最重要的一条实际指导。该提示词转载如下。
阅读完整的 FPGA 设计提示词
这是别人为一个密集 bs=1 解码优化的 FPGA 实现所做的,针对一个带有三值权重的密集 qwen 风格模型。你应该对此持保留态度,挑选你认为实际上对添加到你的计划中有用的东西。也请不要做你认为没用且耗时的事情,比如运行非常长的周期精确模拟测试等,或者像物理设计,因为那些可能需要数小时。这里有一些想法,请挑选使用,将此作为上下文,而不是你必须严格遵循的东西,有些可能有所帮助。不过要优先考虑让它启动并运行的速度..
矩阵乘法(三值引擎)
- 没有乘法器。2 位权重驱动一个 3:1 多路复用器,选出 x、~x 或 0。 未使用的第 4 个编码会触发错误标志,因此损坏的权重会被捕获。
- 取负是 ~x + 1。各通道标记负值,行归约器每行加一次 +1,而不是每个通道加一次。
- 激活值按组量化为整数:INT12,或在需要更大范围时用 INT16(MLP 下投影)。按整数归约,应用 FP32 组缩放,在 FP32 中累加。
- 投影前的 RMSNorm 被延后:先量化激活值,累加后再应用归一化缩放。这样更便宜,且数值等价。
- 两个簇中共 8 个核心。相互独立的投影(gate/up)在各自的核心组上同时运行。
- 结果:在相同速率下,DSP 数量约为 INT8/INT16 设计的一半,代价是更多 LUT。
内存
- 权重以 2 位打包,每次传输量是 16 位的 8 倍。在 batch 1 时,权重取回消耗的能量和时间远超计算本身。
- 权重从 HBM 直接流入计算通道,跳过片上缓冲区(每个 token 只用一次)。激活值缓存在各核心旁,跨行复用。
- HBM 路由是每个内存通道一条链,而不是大型交叉开关。布局数据使全部 32 个通道保持忙碌。
- 片上缓冲区是带显式生命周期的类型化槽位(open -> write -> commit -> read -> release)。每个槽位有一个旁路存储器用于缩放/指数。缓冲区检查格式、范围和生产者,从而在硬件中捕获调度错误。
- KV 缓存是 MXINT8:8 位值,每 32 通道块共享一个指数。这足够小,可以流式传输,同时保持精度。
- 对于 MoE:将每个专家条带化到每个通道,并在运行时将专家 ID 映射到地址,而不是使用固定程序。
注意力
- 注意力以 64 token 的瓦片在缓存上流式处理,使用在线 softmax(FP32 运行最大值/和)。完整的分数矩阵从不存储。
- 概率是 UINT16,上下文在 FP32 中累加。
- 每个注意力单元在一条数据通路上交错执行两个独立任务(C-slow),在不复制硬件的情况下隐藏流水线延迟。
- Q/K 头归一化和 RoPE 有各自的小型向量单元,因此不会阻塞通用向量路径。V 投影与该工作重叠。
- 新的 K/V 一产生就追加到 HBM。我们使用滑动窗口来限制缓存读取。
调度
- 一个控制器按程序顺序发出工作,带有标签和屏障。引擎仅在缓冲区依赖明确时重叠,因此我们获得了重叠而没有竞争。
- 对于 MoE:路由器是新的关键路径,因为在其完成之前无法取任何东西。将其保持在 FP32(较低精度会改变选中的专家),并在其周围尽可能重叠。
正确性(可能不需要严格遵循)
- 我们首先固定了数值契约(格式、舍入点、操作顺序),并构建硬件来匹配它。向量操作必须匹配参考模型的顺序和精度,而不仅仅是“接近”。
- Verification ladder:
- 每块 cocotb 单元测试。
- 一个完整层与真实检查点进行协同仿真。
- 多 token、完整 24 层解码与参考 oracle 逐 token 比较。
- KV 缓存写入的字节级核算。
- 我们将仿真结果、时序签核和板级结果分开,从不声称一个来自另一个。
- 每个发布的数字都链接到其来源报告。
物理设计(可能对你不是必需的)
- 芯片有 3 个区域(SLR)。将宽数据通路保持在一个区域内,并对每个跨区域信号寄存。长链路使用信用,而不是组合就绪。
- 我们把引擎放在各自的数据旁边:内存逻辑靠近 HBM,注意力放在 DSP 密集的区域。
- 综合后立即检查屏幕逻辑深度(250 MHz 下最多 10 级),并通过流水线、分片或 C-slow 来修正。完整的布局布线留到集成阶段。
- 开发循环:小改动 -> lint -> 单元测试 -> 快速综合 -> 深度/时序检查 -> 重构。
编码智能体认真地考虑了这些要求,但似乎并没有在质量上带来多大差别。事实上,当我后来让它读取所有日志并确定它实际使用了哪些指令时,它说:
阅读智能体的回顾:它采纳和拒绝了什么
它最重要的设计想法在你粘贴之前就已经在我的计划里了。你在 10 月 29 日 21:50 UTC 粘贴了它:4,741 个字符,描述了别人为密集、batch-1、三值 FPGA 解码器所做的工作。在 70 秒内,我把它整理成十个要采纳的想法和五个要拒绝的想法,并写进了每个设计智能体的简报。你朋友 Edward 更早 24 分钟发来的那条更简短的评论,关于用查找表作为逻辑门,在速度方面没有留下任何东西。
我采纳的设计想法:大多是确认。
-
早已计划:将权重直接流式传入计算通道、并行运行行、以及以突发方式读取注意力缓存,这些都在我 35–40 分钟前启动的设计简报中。
- Match what was later built:
- 路由器中的交错通道(第 3 步);
- 用于头归一化和 RoPE 的独立单元(第 4 步);
- 程序顺序定序器(第 5 步);
- 每个 die 之间每个交叉点上的寄存边界(第 8 步和第 12 步)。
- 我无法证明没有这些笔记就不会发生这些。
我拒绝的想法:全部五个数值捷径。 更低精度的激活、延迟归一化、8 位 KV 缓存、在线 softmax 和 16 位概率,每一个都会改变输出位。这正是他们的设计获得效率的地方,而你的位精确规则排除了它。
流程建议:这立刻改变了事情。
-
你要求的:不要做需要数小时的事情。
-
我停止的:一个已经运行了约 24 小时的仿真,以及两个 250 MHz 构建。
-
我切换到的:一个由 C 测试、综合和逻辑深度检查组成的短循环,每次集成做一次布局布线。
-
可能的收益:它更快地得到了硬件结果。
-
可能的代价,我无法证明:两个只有 RTL 仿真才能发现的挂起在第二天到达了板子上,大型集成因此损失了 38 小时。
它触发的一个真正发现。 在检查他们的内存想法时,我发现了 AWS 自己的参考内存设计,它在全部 32 个内存通道上达到 426 GB/s。内存子系统就是基于它构建的。
换句话说,对于大多数实际的设计想法,情况并不明确,但有充分理由相信模型自己会想出来,尤其是因为它在许多个周期之后、经过几次压缩循环后才提出这些想法。但流程建议立即有用,可以更快地得到硬件结果并提高迭代速度。换句话说,人类在定义如何快速迭代以及正确性是什么样方面仍然有用,而智能体非常擅长管理探索。
优化日志
以下是自动研究循环发现的更改。有趣的是,它主要是一系列适度的改进,每次复合约 1.5 倍,而不是一两个巨大的改进。
0基线6.43 tok/s
基线:首个全模型位精确的 FPGA 镜像(R8),配合主机侧前缀缓存提供服务。
相对基线 1.0×
1主机开销8.07 tok/s
仅主机软件:每条命令的开销从约 10 ms 降至 0.9 ms(持久寄存器映射、流式读取、不再有逐命令的 SDK 调用或 fsync)。
本步 1.25× · 相对基线 1.25×
2突发注意力14.02 tok/s
一个 128 通道的注意力引擎,以突发方式而非逐字读取 KV 缓存,同时保持参考实现的精确求和顺序。
本步 1.74× · 相对基线 2.18×
3并行路由器20.53 tok/s
一个并行 MoE 路由器,带有精确的 GCC 排序平局决胜机制,外加一个内置 argmax 的流式输出头;中等强度的路由让它以 250 MHz 运行。
本步 1.46× · 相对基线 3.19×
4胶合引擎30.24 tok/s
一个胶合引擎,以经认证的精确顺序并行化归一化、RoPE、量化以及各引擎之间的拷贝。
本步 1.47× · 相对基线 4.70×
5新流水线49.21 tok/s
完整的新流水线(流式三值投影通道 + 取代 R8 控制路径的新定序器),此前修复了两个仅在硬件中出现的挂起问题。
本步 1.63× · 相对基线 7.65×
6提示推测51.25 tok/s
精确推测解码:主机通过提示查找起草 token,FPGA 在一次遍历中验证多个 token。
本步 1.04× · 相对基线 7.97×
7路由器中继58.43 tok/s
修复了一个以 1/6 速度在裸片间传输路由器权重的中继:每层路由器停顿从 43,862 周期降至 12,292 周期。
本步 1.14× · 相对基线 9.08×
8输出头影子94.44 tok/s
输出头影子 v2(基于临时猜测启动下一个 token;及早捕获未命中)加上跨裸片时序修复,实现 237.5 MHz 内核 / 450 MHz 内存。
本步 1.62× · 相对基线 14.68×
9草稿模型105.63 tok/s
使用真实草稿模型的精确推测解码:一个精简版 Maple 在 F2 的主机 CPU 上提前起草,FPGA 验证每个 token。
本步 1.12× · 相对基线 16.42×
10内存端口108.81 tok/s
内存端口从 4 个翻倍至 8 个(两条投影通道,输出头跨 bank 条带化):每时钟 1.39×,但拥塞使时钟降至 181/375 MHz。
本步 1.03× · 相对基线 16.91×
11注意力重叠134.99 tok/s
将注意力引擎的 KV 取数隐藏在计算之后,并用精确的顺序无关求和替代路由器 2,048 步的串行求和(每层从 12,292 周期降至 2,338 周期)。
本步 1.24× · 相对基线 20.98×
12权重打包171.3 tok/s
无损 5-trit 权重打包(权重字节减少 20%)、更短的串行步骤,以及将输出头移至远端裸片,从而缓解拥塞并允许 225/400 MHz。
本步 1.27× · 相对基线 26.63×
13重新推测184.19 tok/s
输出头影子未命中后的重新推测、路由器期间推测性 MoE 专家预填充,以及裸片再平衡(移除未使用的 DDR 控制器),在两次启动中均以 231.25/450 MHz 运行。
本步 1.08× · 相对基线 28.63×
14并行输出头加载器213.13 tok/s
一个头部加载器,可同时读取两个内存库(+17.3%,在单张图像上开/关测量),一个运行时专家预取策略,以及路由器任务时序修复;在浸泡测试发现 231.25 下的随机故障后,将时钟步进降低一档运行(225/425 MHz)。
本步 1.16× · 相对基线 33.13×
对比情况
在这些配置之间做 1:1 对比很困难。我并没有对每个替代方案都运行相同的自动研究循环,而且我假设如果那样做,还能提取出更多性能。重点在于展示 FPGA 在首次实现时有多慢,以及优化循环把它带到了多远。
以下测量来自 11 月 15 日的 AWS,重放相同的 8 聊天 × 3 轮基准测试。价格是随该实验记录的按需费率。“精确轮次”统计与固定 CPU 参考匹配的输出。GPU 实现仅作背景参考,未满足相同的位精确标准,但在实践中相当接近。
| 项目 | 实例 | 每小时价格 | 基准 tok/s | 精确轮次 | FPGA 快多少 |
|---|---|---|---|---|---|
| F2 FPGA,r9(最终镜像) | f2.6xlarge | $1.98 | 213.13 | 24/24 | — |
| 精确 CPU 孪生,32 线程 | m8a.8xlarge(32 个 Zen 5 核心) | $1.95 | 129.5 | 24/24 | 1.65× |
| 精确 CPU 孪生,24 线程 | c7i.12xlarge(24 个 Sapphire Rapids 核心) | $2.14 | 99.6 | 24/24 | 2.14× |
| 固定标量参考,全部 32 核心 | m8a.8xlarge | $1.95 | 40.6 | 24/24 | 5.25× |
| 固定标量参考按固定配置,1 线程 | r7i.2xlarge | $0.53 | 1.1 | 24/24 | 195× |
| 精确 CPU 孪生,4 线程(小型实例) | m8a.xlarge(4 个 Zen 5 核心) | $0.24 | 67.6 | 24/24 | 3.16× |
| DeepGrove 自有的 GPU 卸载分支(非位精确,仅供参考) | g4dn.xlarge(T4 GPU) | $0.53 | 35.7 | 1/24 | 5.97× |
| 社区 CUDA 移植(非位精确,仅供参考) | g4dn.xlarge(T4 GPU) | $0.53 | 166.3 | 0/24 | 1.28× |
随着上下文增长会发生什么?
这是一次从 16 token 提示开始,持续到 8,192 token 上下文填满的生成:生成 8,176 个 token。中间五列显示了若干代迭代在指定上下文长度下的解码速度(token/s)。最后一列是整个运行的挂钟时间/
| 图像 | 16–64 | 1–2k | 2–4k | 4–6k | 6–8k | 整个运行(秒) |
|---|---|---|---|---|---|---|
| r5 | 108 | 70 | 57 | 45 | 37 | 162.3 秒 |
| r6b | 142 | 111 | 90 | 72 | 60 | 102.3 秒 |
| r7 | 181 | 140 | 111 | 88 | 72 | 83.6 秒 |
| r8 | 186* | 155* | 121 | 94 | 77 | 77.6 秒 |
| r9 | 233* | 151* | 120 | 93 | 76 | 77.8 秒 |
* 对于 r8 和 r9,前两列来自单独的、生成 2,032 个 token 的较短运行。其他列来自完整上下文运行。
r9 提升了短上下文速度,而完整长上下文运行与 r8 大致持平。
模型实际说了什么
这些示例来自最终的 r9 镜像。
算术,含步骤
246 个 token · 229.7 token/s · 端到端 1.16 秒
阅读算术记录
USER: What is 37 × 48? Explain the steps briefly.

MODEL: <think>
We need to compute 37 × 48. The user asks to explain steps briefly. So I'll do multiplication: 37 × 48 = 37 × (50 - 2) = 37×50 - 37×2 = 1850 - 74 = 1776. Or directly: 37×40=1480, 37×8=296, sum=1776. I'll present a brief explanation.
</think>

To multiply 37 by 48, you can break it down:

- 37 × 48 = 37 × (50 – 2) = (37 × 50) – (37 × 2) = 1850 – 74 = 1776.

Alternatively, 37 × 40 = 1480 and 37 × 8 = 296, so 1480 + 296 = 1776.

The final answer is **1776**.
一点 Python
140 个 token · 220.0 token/s · 端到端 0.76 秒
系统提示:“你是一个有用的助手。回答前先简要思考,然后清晰简洁地回复。”
阅读 Python 记录
USER: Write a Python function is_palindrome(s) that ignores case, spaces and punctuation.

MODEL: <think>
We need to write a Python function is_palindrome(s) that ignores case, spaces, and punctuation. So we need to filter out non-alphanumeric characters, convert to lowercase, then check if the resulting string is equal to its reverse. Provide the code.
</think>

```python
def is_palindrome(s: str) -> bool:
    """
    Returns True if the string s is a palindrome, ignoring case, spaces, and punctuation.
    """
    # Filter to keep only alphanumeric characters and convert to lowercase
    filtered = ''.join(ch.lower() for ch in s if ch.isalnum())
    # Compare with its reverse
    return filtered == filtered[::-1]
```
这让我们处于什么位置
这是一个有趣的项目。我不确定我是否还会以这种特定方式使用这种特定的芯片架构,而且我当然不是在声称在 FPGA 上运行 8,192 token 上下文的模型是我推荐任何人在生产中使用此类东西的方式。但这就是能跑,这相当史诗。这样的能力完全改变了有决心的工程师团队可以从事的工作的奥弗顿窗口。它应该意味着,如果你能把模型指向正确的方向,全新类型的想法(科学发现、产品、初创公司)都是可能的。我很兴奋看到大家构建什么。
来源:Hacker News · ankitg.me