Amazon SageMaker AI 新增推理端点延迟漂移、GPU 闲置与优化缺失检测
Amazon SageMaker AI now detects latency drift, idle GPUs, and missed optimizations on your inference endpoints
Amazon SageMaker AI 为使用 vLLM 容器和 GPU 实例的推理端点默认开启监控,可发现延迟漂移、GPU 闲置和配置缺口三类问题,并通过 AWS Health 发送通知。
每个推理端点在投入生产的那天都经过了精心调优。团队会选择适合模型及其上线时流量的实例类型、服务配置和扩缩容设置。端点运行平稳后,他们自然会转向下一个优先事项。然而,工作负载很少一成不变。流量模式会演变,提示词会变长,vLLM 等服务引擎会发布新版本,SageMaker 推理会发展出新的优化技术,新的微调检查点会改变模型所需的资源。随着时间推移,一个原本调优良好的端点会悄然发生漂移。延迟和首 token 时间逐渐上升。一个从未完全理想的配置持续错失可获得的性能提升。为从未出现的需求而预置的 GPU 一周又一周地闲置。由于没有任何故障发生,没有警报响起,这种漂移一直不被察觉,直到用户感受到它或账单反映出它。
Amazon SageMaker AI 现在可以监控您的生成式 AI 推理端点,并通过在 Amazon SageMaker Studio 中使用具备 Agentic 体验的 生成式 AI 优化推理建议 功能,在变更能够提升性能或降低成本时通知您。对于使用 vLLM 服务容器和 GPU 实例的 SageMaker AI 推理端点,监控默认开启,无需任何设置,您也可以选择退出某些端点。SageMaker AI 仅查看运营信号:延迟、GPU 利用率和端点的服务配置。它不会读取您的请求或响应。基于这些信号,它会呈现三类发现:
- 延迟漂移: 中位数(p50)端到端延迟或首 token 时间逐周上升。
- 未使用容量: 您付费但大部分时间闲置的 GPU。
- 配置缺口: 服务容器缺少较新的性能改进或安全补丁,或者您的模型支持但端点未使用的优化(如推测解码或 GPU 内核调优)。
SageMaker AI 通过 AWS Health 发送发现,每个端点一条通知,涵盖该端点的所有发现。收到通知后,您可以在一个地方对其采取行动。它会在 Amazon SageMaker Studio 中打开 SageMaker AI agentic 体验,并已填入该端点及其近期流量。在那里,您可以运行推理建议,将当前配置与备选方案进行基准测试,并在响应时间、吞吐量和每百万 token 成本方面并排比较。这将主观判断转变为有数据支持的决策。基准测试在单独的计算资源上运行,在您选择应用结果之前,端点不会有任何变化。
在本文中,我们将展示 SageMaker AI 如何监控您的端点,以及如何解读它通过 AWS Health 发送的通知。然后,我们将展示如何在 SageMaker Studio 中从通知走向基于基准测试的决策。我们会走查三个示例场景,展示如何安全地应用或忽略建议,并解释如何让端点退出监控。
解决方案概述
SageMaker AI 推理建议遵循四步循环:观察、通知、建议和决策。每一步的设计都确保您保持控制权,生产端点不会在未经您明确操作的情况下发生变更。
- 观察 – 对于符合条件的端点,延迟和容量使用情况的监控默认开启。它不会读取你的请求或响应,也不会产生额外的 GPU 成本。
- 通知 – 当有值得采取行动的事项时,你会在 AWS Health 中收到通俗易懂的通知,同时还会收到电子邮件,说明观察到了什么、为什么重要以及建议的下一步。
- 建议(需选择加入)– 只需一次选择即可打开 SageMaker Studio 中的 SageMaker AI 智能体体验,并预填该端点及其观察到的流量,以便你在单独的计算资源上对备选方案进行基准测试。
- 决策 – 并排比较响应时间、吞吐量和成本。在你应用结果之前,生产环境不会发生任何更改。
该功能会产生几种类型的发现。下表总结了每种发现的触发条件,以及当你选择进行基准测试时会测试哪些内容。
| 发现 | 触发条件 | 基准测试的内容 |
| 延迟漂移 | 响应时间相对于该端点的逐周趋势发生变化 | 张量并行设置以及备选实例类型或大小 |
| GPU 利用率不足 | GPU 利用率在观察窗口内持续远低于容量 | 在观察到的峰值流量下更便宜的实例类型和更小的规格 |
| 未启用推测解码 | 模型和容器支持该功能,但该功能处于关闭状态(基于配置) | 当前配置与启用推测解码后的配置对比 |
| 服务容器 | 该端点的服务容器有更新版本,包含性能改进以及针对关键和高危常见漏洞和暴露(CVE)的安全补丁。 | 当前容器与更新后的容器对比 |
| 未调优的 GPU 内核 | 内核配置未针对模型和硬件进行调优 | 默认内核与调优后的内核对比 |
先决条件
监控本身无需设置,默认开启。当你选择通过运行基准测试并(可选)应用更改来对某项发现采取行动时,以下先决条件适用:
- 访问 AWS Health 和 AWS User Notifications 控制台。
- 一个 SageMaker Studio 域,以及运行推理推荐作业和更新端点所需的 AWS Identity and Access Management(IAM)权限。
- 要测试的基准测试实例有足够的服务配额。
成本说明: 监控不产生 GPU 成本。基准测试按标准 SageMaker AI 费用计费,如果你有机器学习(ML)预留,则使用你的预留。
了解发现通知
你会在控制台的 AWS Health 中以及通过电子邮件收到通知,每条通知都遵循相同的结构,因此可以快速浏览:
- 端点: 该发现适用于哪个端点。
- 我们注意到: 以通俗方式陈述的观察结果,估算值会明确标注为估算值。
- 为什么重要: 对延迟、容量或成本的影响。
- 建议操作: 一次选择进入 SageMaker Studio 中的智能体体验进行调查。
通知报告观察结果并标注估算值。此时尚未运行任何基准测试。一条有代表性的通知如下:
| 主题:[可能需要采取行动] 针对你的端点的 SageMaker AI 推理改进 SageMaker AI 默认跟踪你的推理端点的延迟和容量使用情况,并发现其中一个端点有改进空间。它不会读取你的请求或响应。 我们注意到:在过去一周内,该端点的首个 token 时间相比前一周有所增加。 建议操作:打开 SageMaker Studio,在独立计算资源上对备选方案进行基准测试。您的生产端点不会发生变化。 |
频率:每个端点会收到一条通知,涵盖适用的发现项。您一次最多会收到每个端点的一条通知,涵盖其所有发现项,且 SageMaker AI 会限制一个账户一次可接收的通知数量。通知按 AWS 区域区分,因此当您登录到某个端点所在的区域时,才会看到该端点的发现项。
操作指引:从通知到决策
在本节中,我们将回顾几个端点优化场景,这些场景会触发发现项上报。
场景 1:捕捉周环比延迟回退
某团队在单个 SageMaker AI 端点上运行聊天助手。他们加入检索以提升回答质量,因此现在每个请求都携带数页检索到的上下文,提示词变得长得多。系统没有出现故障,他们设置的告警也未被触发,但响应开始变慢。
SageMaker AI 将该端点的首 token 中位时间(p50)和端到端延迟中位数与上一周进行比较。当其中任一指标在一周内上升幅度足够大时,就会标记该变化。由于比较对象是该端点自身的历史数据,团队无需提前设置阈值。
- 通知:AWS Health 报告首 token 时间较前一周有所增加。
- Studio 会话:一次选择即可打开智能体体验,并预填该端点及其观测到的流量。
- 基准测试:该会话在独立计算资源上测试张量并行设置以及其他实例类型或规格。
- 决策:团队比较延迟、吞吐量和成本,然后将胜出的配置应用到一个变体上。
以下截图展示了一个延迟漂移发现项的 AWS Health 事件。消息报告首 token 中位时间周环比上升约 200 毫秒,且“建议操作”窗格提供了指向 SageMaker AI 的链接,用于运行推理建议。
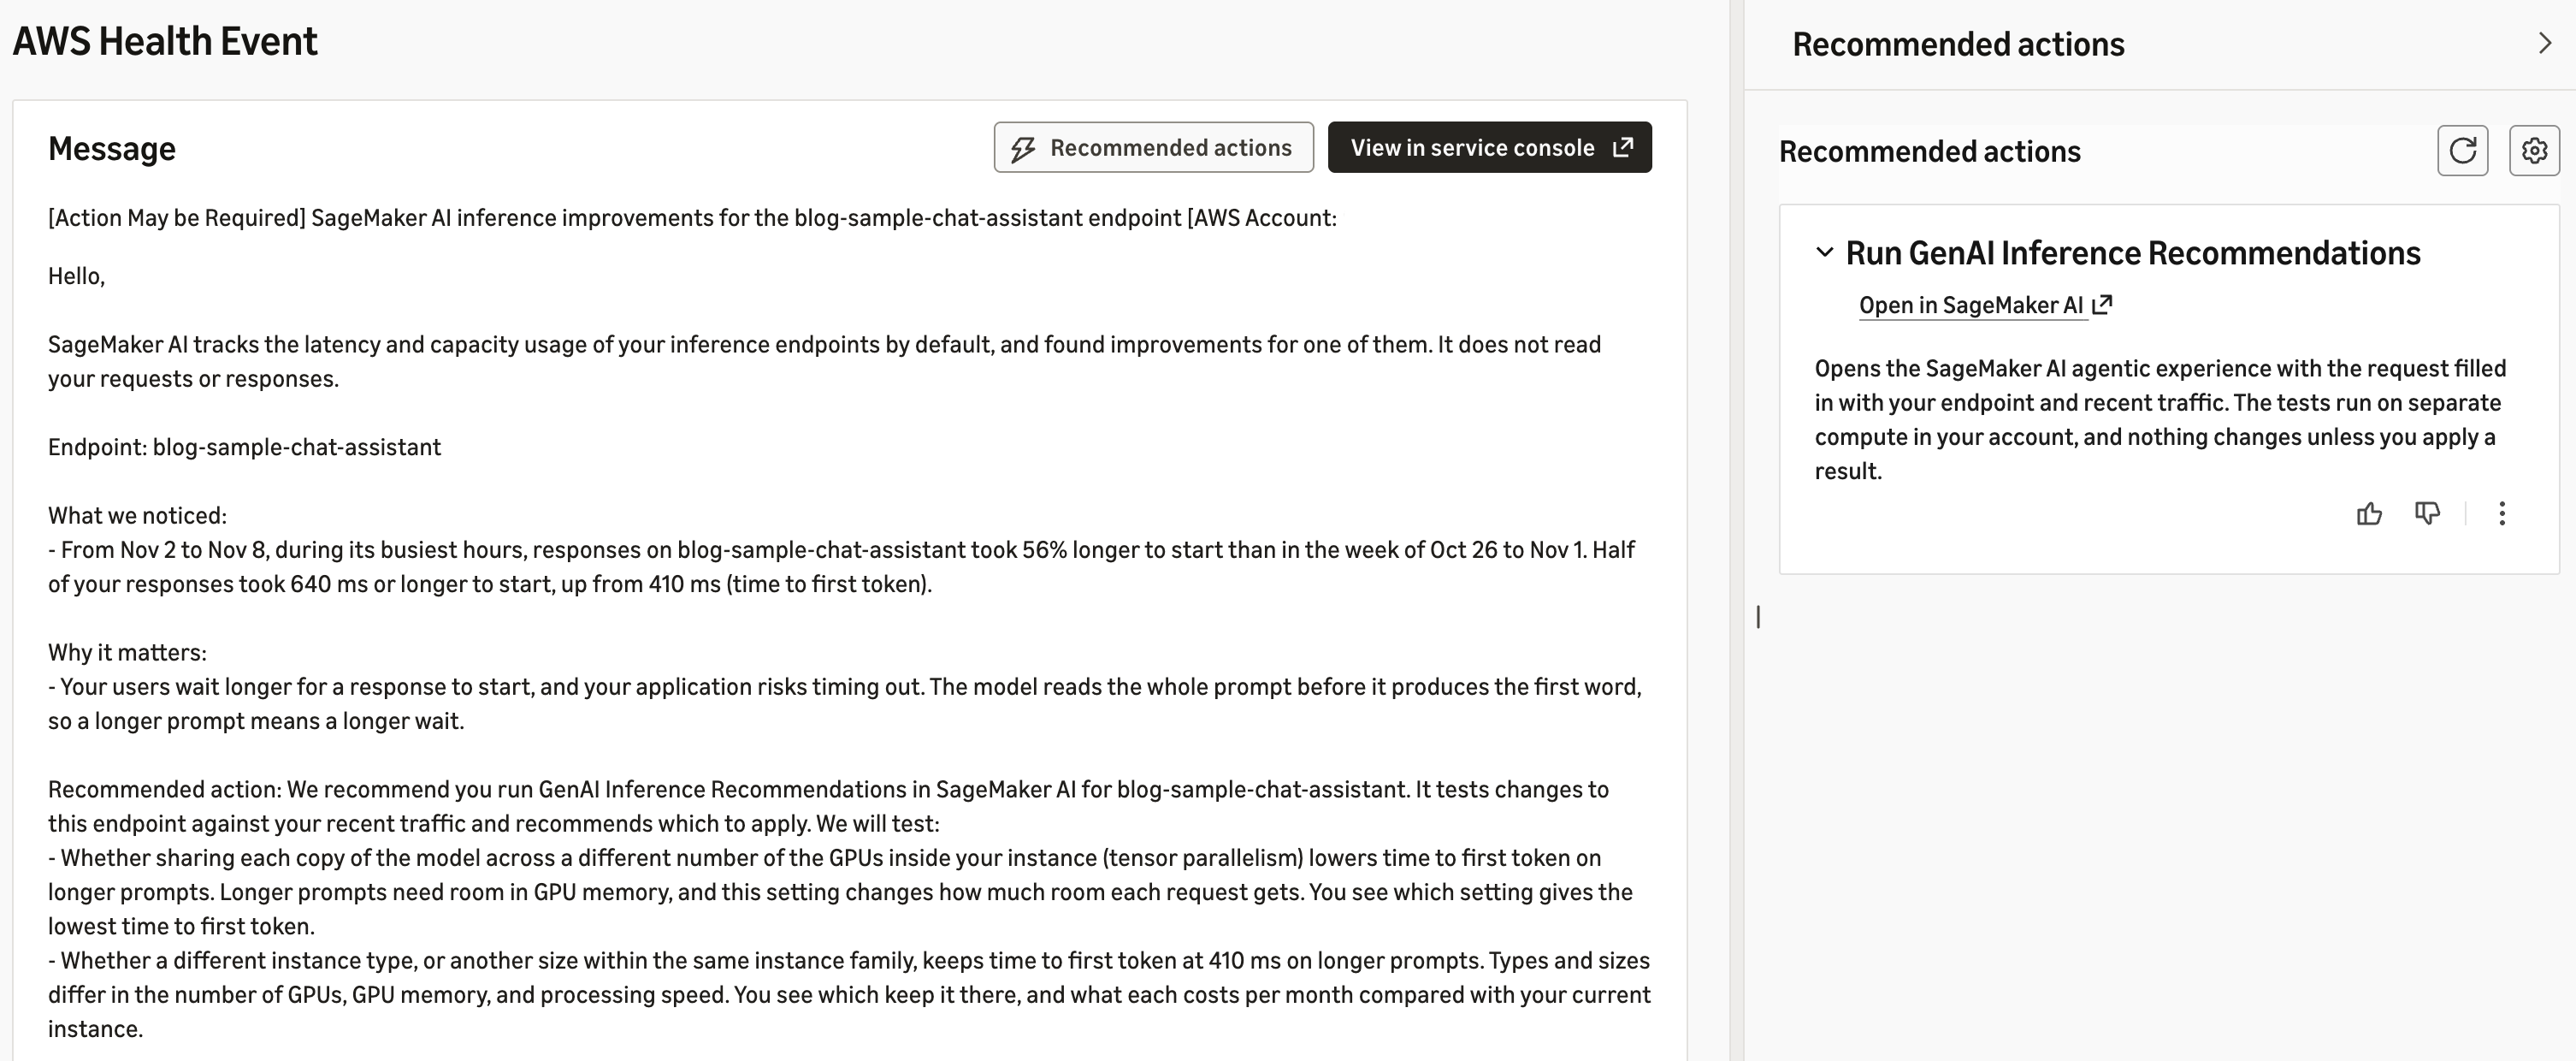
图 1:延迟漂移发现项的 AWS Health 事件,附有在 SageMaker AI 中运行推理建议的链接
场景 2:开启您的流量可受益的优化
某平台团队在 SageMaker AI 端点上托管一个内部代码补全模型。他们使用默认服务设置进行部署,之后从未重新审视这些设置。该模型和服务容器支持推测解码——一种加快响应的技术——但该功能未启用。SageMaker AI 将此标记为一项机会。它是否有帮助取决于端点的流量,例如并发请求数量以及提示词和响应的长度。通知建议运行推理建议,该功能会针对端点近期流量对推测解码进行基准测试,并显示是否值得开启。
- 通知:AWS Health 报告某项旨在加快响应的技术受支持但未启用。
- Studio 会话:智能体体验打开时已加载端点配置。
- 基准测试:该会话将当前配置与启用推测解码的配置进行比较。高峰流量下的结果可能与低谷流量下不同。
- 决策:如果增益在关键流量下依然成立,团队就应用它。否则,他们保留当前配置。
以下截图展示了一个针对推测解码发现的 AWS Health 事件。消息指出,模型和推理容器支持推测解码,但端点并未使用该功能。“建议操作”窗格提供了指向 SageMaker AI 的链接,用于运行推理建议。
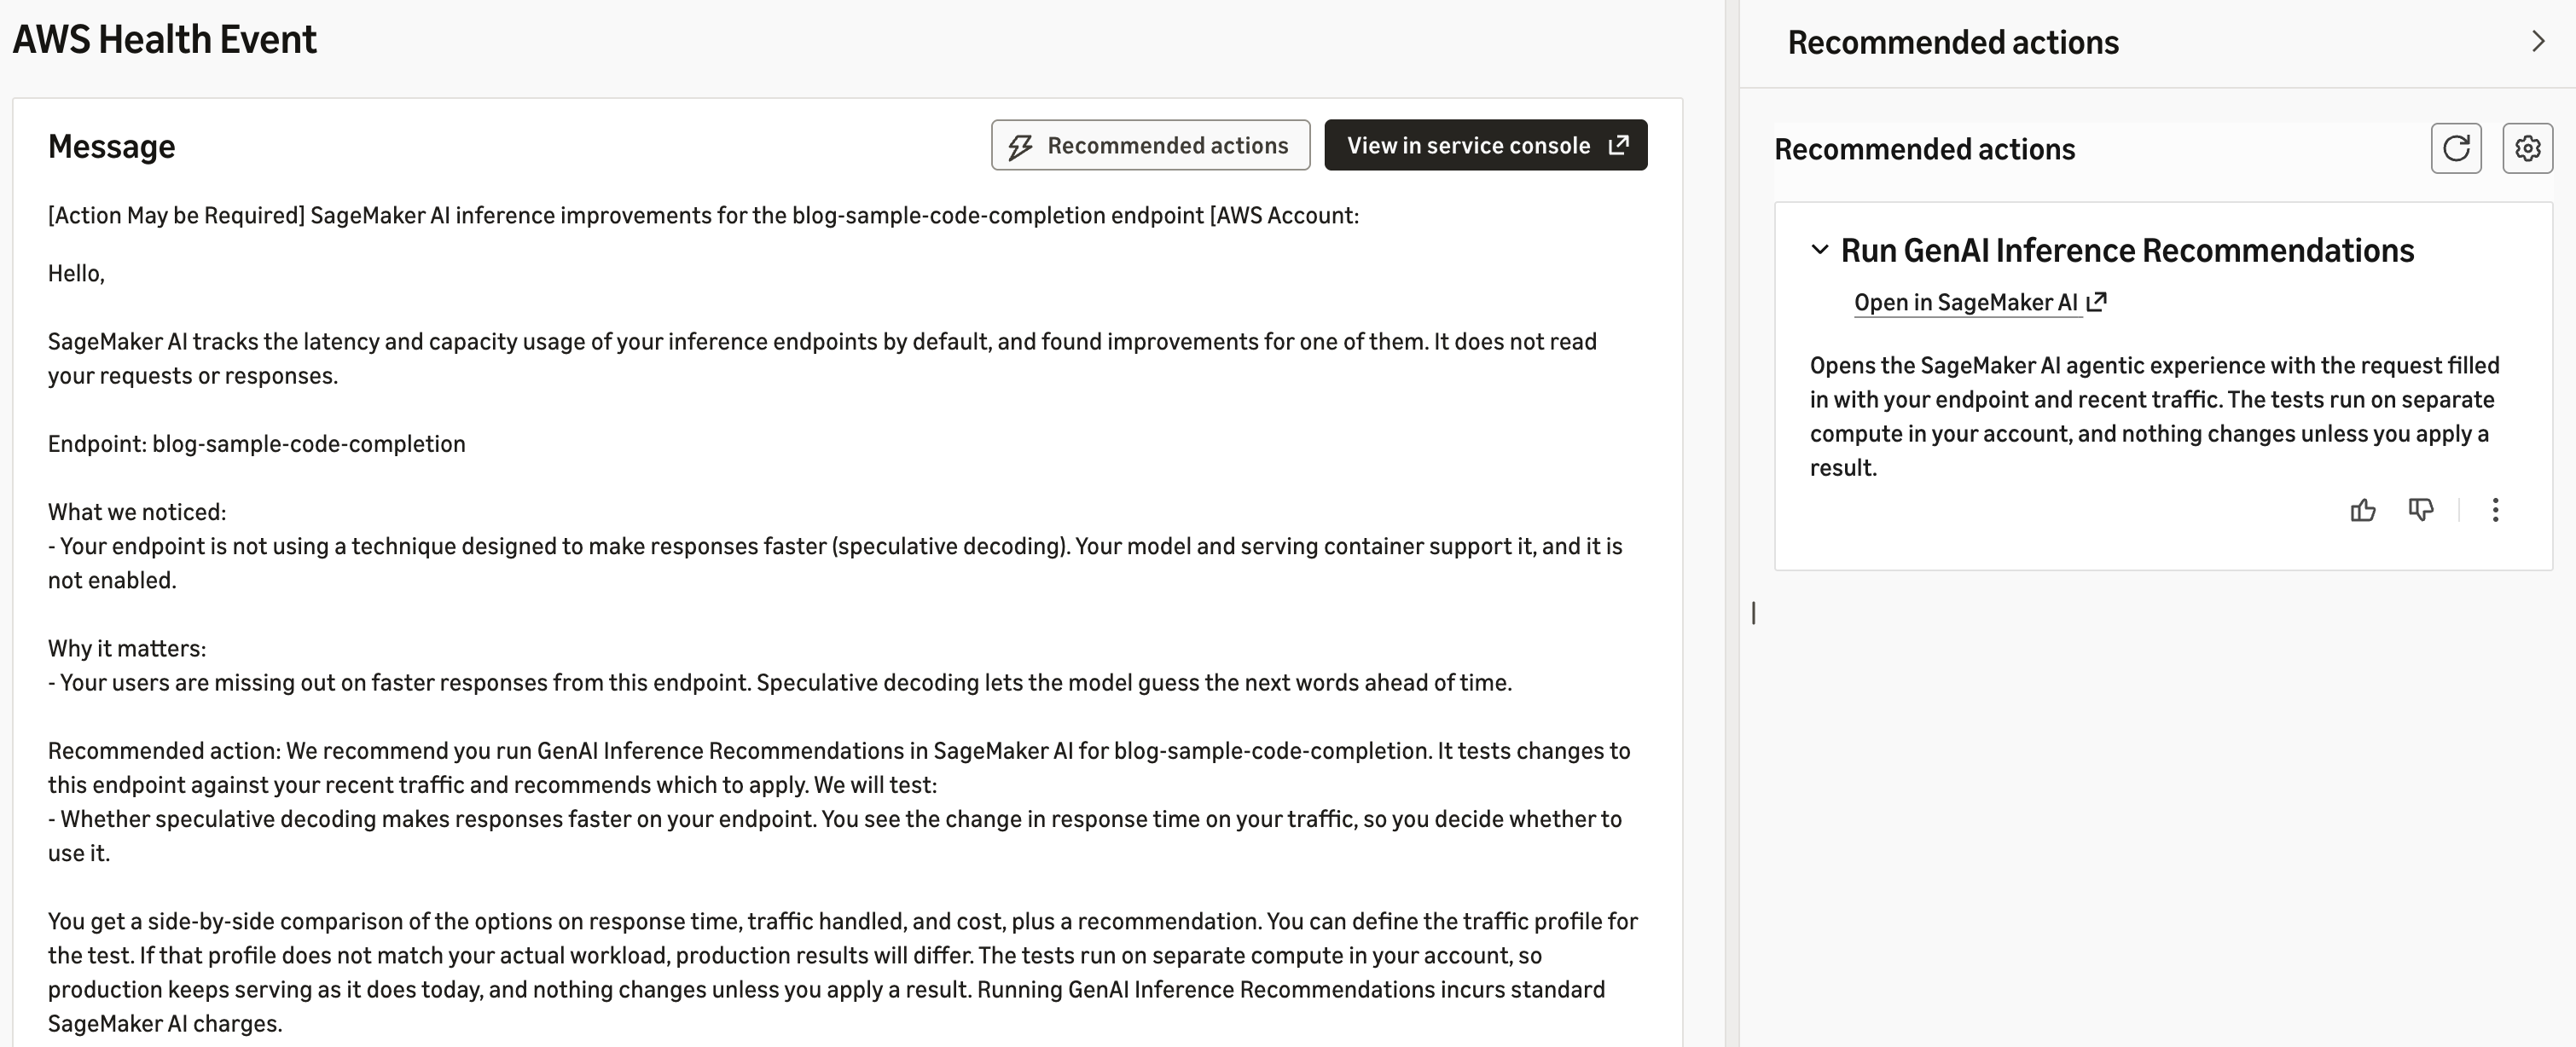
图 2:针对推测解码发现的 AWS Health 事件,其中包含在 SageMaker AI 中运行推理建议的链接
该通知说明,推测解码可以加快响应速度,并且基准测试会在端点近期的流量上比较启用和不启用推测解码时的响应时间。
场景 3:为利用率不足的 GPU 选择合适的规格
一个摘要端点是为一次发布活动配置的,但实际吸引到的受众只占计划的一小部分,因此其 GPU 在一周内大部分时间都处于空闲状态。这个场景还展示了一种情况:正确的决定可能是什么都不改。
- 通知:AWS Health 报告称,该端点付费购买的 GPU 容量大部分未被使用。
- Studio 会话:智能体体验会以该端点及其观测到的峰值流量作为开场。
- 基准测试:该会话会在观测到的峰值流量下测试更便宜的实例类型和更小的规格。
- 决策:团队会权衡每月节省的费用与为计划增长预留的余量,并可能决定保持当前规格。
以下截图展示了一个针对未使用容量发现的 AWS Health 事件。消息指出,在这一周的大部分时间里,即使是该端点最繁忙的 GPU,其容量使用率也只有 12% 或更低。“建议操作”窗格提供了指向 SageMaker AI 的链接,用于运行推理建议。
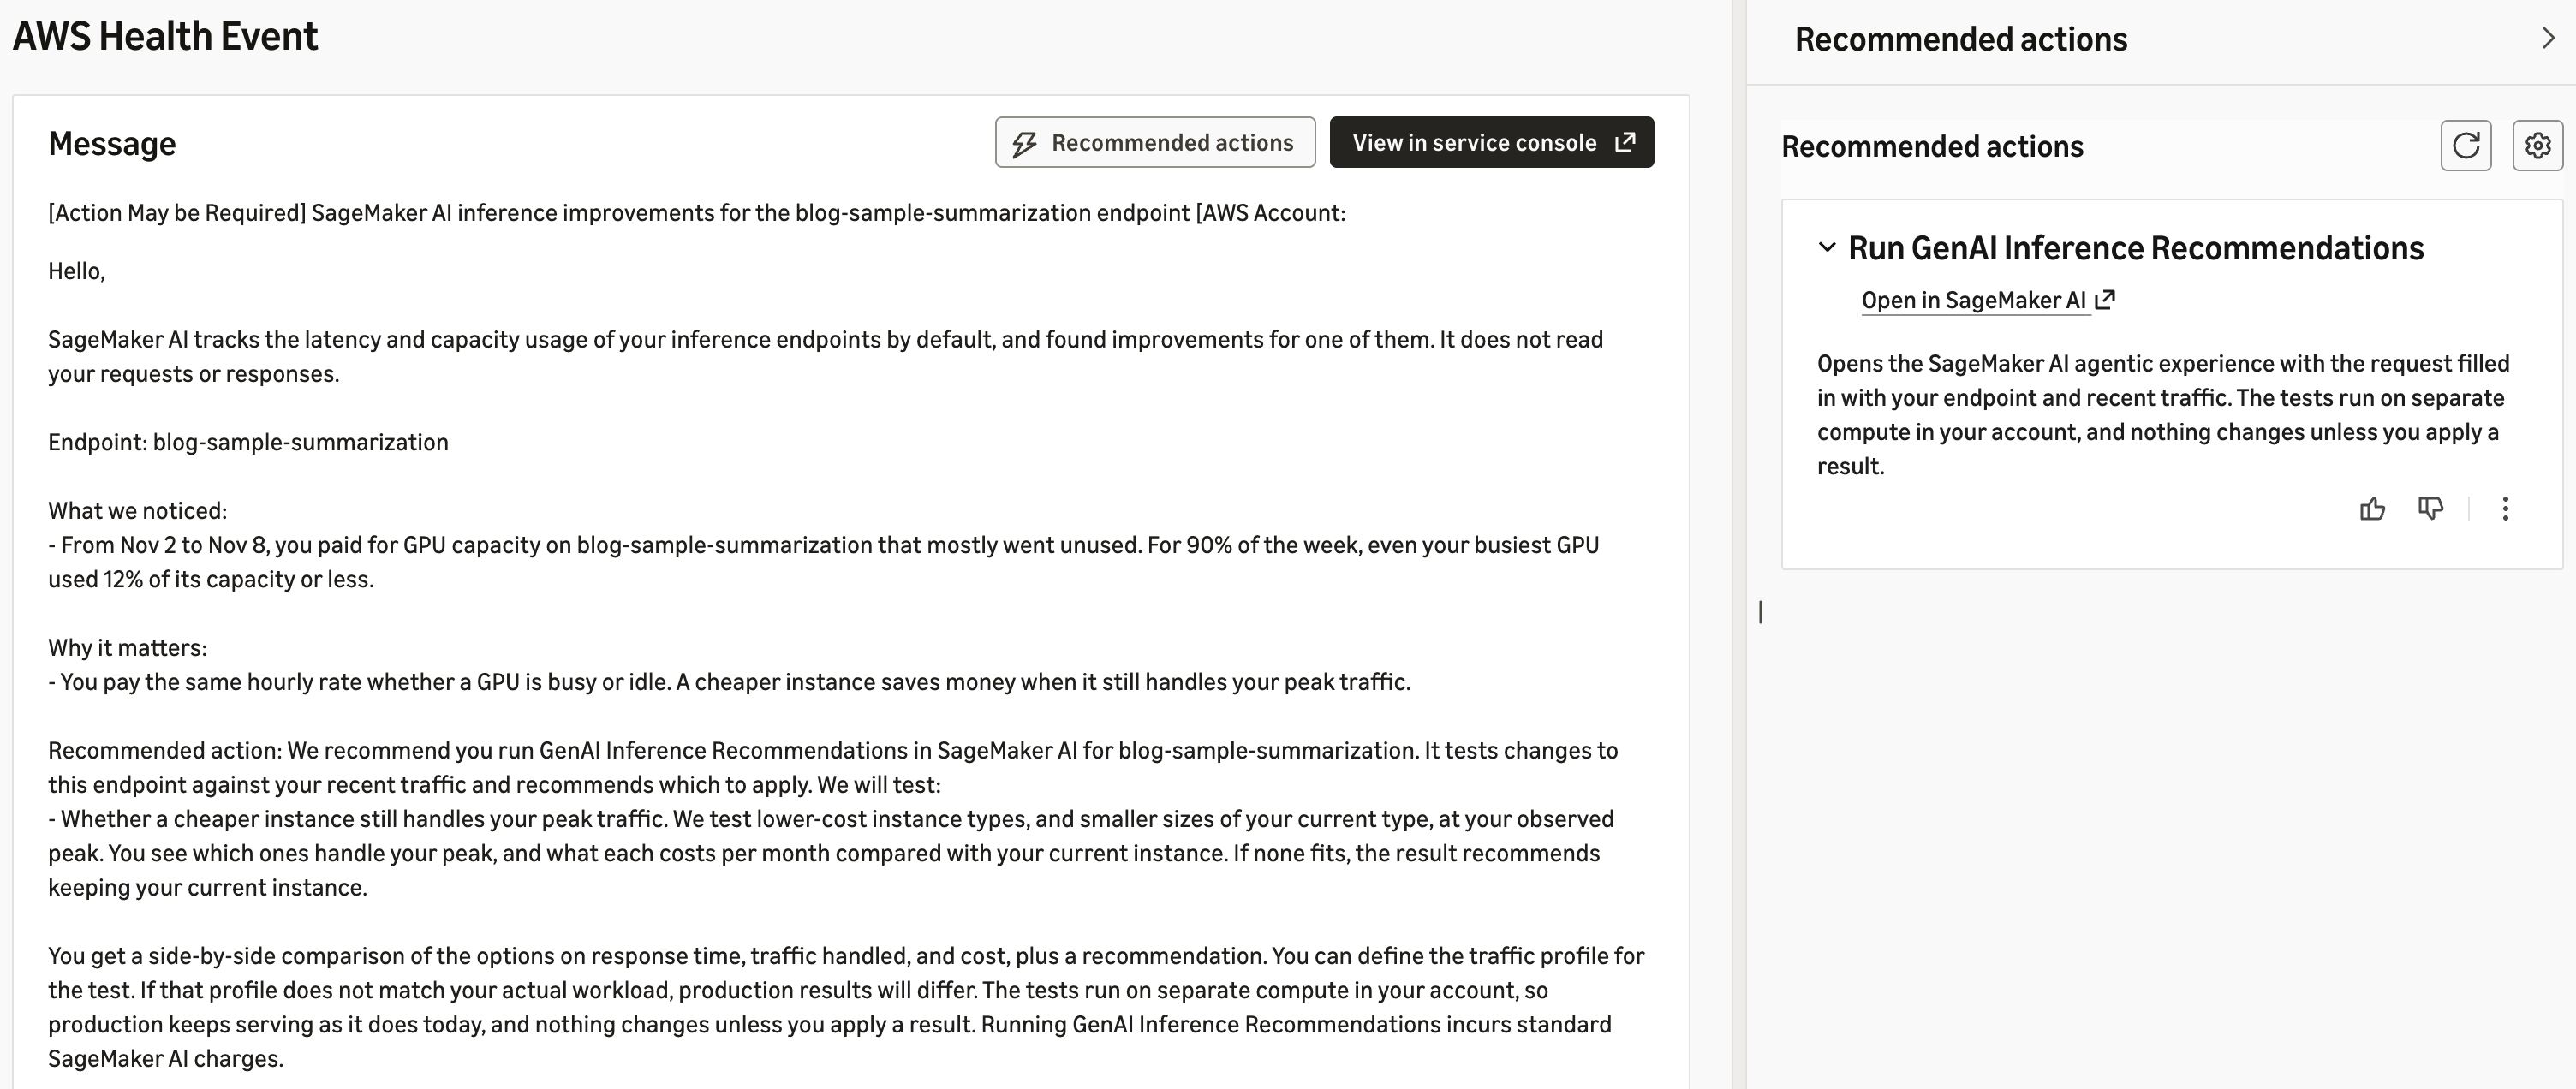
图 3:针对未使用容量发现的 AWS Health 事件,其中包含在 SageMaker AI 中运行推理建议的链接
你可以如上图所示,从建议操作中选择 Open in SageMaker AI 来应用或忽略某项建议。我们将在下一节中详细介绍这一过程。
应用或忽略建议
整个过程始终由你掌控,不会自动部署任何内容。当你在通知的建议操作中选择 Open in SageMaker AI 时,Amazon SageMaker Studio 会打开一个 JupyterLab 空间,并显示将在智能体聊天中运行的提示。以下截图展示了一个针对延迟漂移发现的提示,该端点还运行着较旧版本的 vLLM 推理容器:

当你选择 Run 时,智能体体验会在 SageMaker Studio 的 JupyterLab 空间中的聊天面板里打开。它会用通俗的语言总结该发现,重述你要求它做的事情,并在采取任何操作之前与你确认。以下截图展示了智能体在总结发现并请求继续:

在你确认后,智能体会生成一个 notebook,为该端点创建推理建议作业。该 notebook 使用 SageMaker Python SDK,从端点获取模型,并从其指标中获取流量概况,还会用 AWS Health 事件为作业打上标签,以便你可以将结果追溯到该发现。每个步骤都是单独的 notebook 单元格,因此你可以在运行前查看或编辑它。
以下截图展示了记录作业详细信息并在三种候选实例类型上启动建议作业的 notebook 单元格。

作业完成后,你可以将当前配置与备选方案在响应时间、吞吐量和成本方面进行比较。当你准备根据基准测试结果采取行动时,我们建议采用安全的推出模式:
- 在应用拟议变更之前先进行审查,包括配置差异以及基准测试的延迟、吞吐量和成本。
- 先应用到一个生产变体,并保留当前配置以便回滚。
- 保留或忽略某项发现都是正常结果。该通知会保留在你的 AWS Health 事件历史记录中。
管理监控和通知
你可以管理监控以及通知方式:
- 在 AWS User Notifications 控制台中管理你接收通知的方式。
- 可选地,安排定期建议,例如每月一次。
收集与不收集的内容:监控在端点级别读取聚合的延迟和容量遥测数据。它不会读取你的请求或响应内容,也不会产生 GPU 成本。
退出监控:如果你不希望 SageMaker AI 监控某个端点,请在模型的容器上设置 OPT_OUT_TRACKING 环境变量,值可自行选择。你在调用 Environment 时在 CreateModel 映射中设置它,可以设置在 PrimaryContainer 上,也可以设置在模型中的其他容器上。
如果端点上的某个容器带有此变量,SageMaker AI 就不会为该端点收集任何监控遥测数据,包括引擎指标、GPU 指标和启动配置详情。因此,它不会为该端点发送任何通知。
清理
为避免持续产生费用,请清理你在阅读本文过程中创建的资源:
- 删除你为本次演练创建的任何测试端点或资源。
- 如适用,删除 Amazon Simple Storage Service(Amazon S3)中的基准测试产物。
- 还原你应用的所有测试配置更改。
结论
随着 SageMaker AI 推理建议现在自动监控你的端点,优化从某一时间点的快照转变为持续的信号。
你的端点会持续告诉你它们何时发生了漂移、何时错过了改进机会,或何时在为闲置容量付费。只需一次选择,就能带你进入由你掌控的、经过基准测试的并排对比决策。
有关如何开始的更多信息,请访问 Amazon SageMaker AI 并参阅 Amazon SageMaker AI 文档。
关于作者

Hazim Qudah
Hazim 是 AWS 的专家解决方案架构师,常驻德克萨斯州达拉斯。他乐于帮助客户使用 AWS 技术和最佳实践构建并采用 AI/ML 解决方案。在加入 AWS 之前,他曾在多个行业和地区从事技术咨询工作多年。闲暇时,他喜欢烹饪、保持运动,以及和他的狗 Nala 玩耍。

Mona Mona
Mona 是 AWS 的全球 AI/ML 专家解决方案架构师,常驻华盛顿特区地区。她与客户合作,在 Amazon SageMaker AI 上设计和部署生成式 AI 推理,专注于模型优化、成本效率和生成最佳实践。她经常就应用机器学习发表演讲和撰写文章,并共同领导 Women in AI/ML 社区。

Vineet Sharma
Vineet 是 AWS 技术部门的高级产品营销经理,专注于 Amazon SageMaker AI。他专长于市场进入策略、产品发布,以及将复杂的 AI 和 ML 服务转化为有吸引力的客户价值。他热衷于通过清晰、有影响力的信息传递打造卓越的客户体验。

Li Zhang
Li 是 AWS 的高级机器学习工程师,从事 Amazon SageMaker AI 推理相关工作。Li 负责领导并构建用于监控客户生成式 AI 推理端点并推荐可改善其性能与成本的变更的系统。在 Amazon 的 11 年间,Li 构建了大规模分布式系统和机器学习服务。
来源:AWS Machine Learning Blog · aws.amazon.com