Kimi K3.1 Pro Highspeed 上线 Amazon Bedrock
Introducing Kimi K3.1 Pro on Amazon Bedrock
Moonshot AI 的 Kimi K3.1 Pro Highspeed 已在 Amazon Bedrock 上线,沿用 Kimi K3 的 3T 级开放权重架构和 100 万 token 上下文窗口,经更多后训练算力优化长程智能体任务与事实准确性。
文章给出接入方式、Flex 档与显式提示词缓存的具体用法,可据此估算成本与延迟取舍。
来自 Moonshot AI 的 Kimi K3.1 Pro Highspeed 现已在 Amazon Bedrock 上推出。它是 Moonshot AI 全新 K3.1 系列的一员,是 Kimi K3 的后训练版本,拥有相同的 3T 级开放权重架构和 100 万 token 上下文窗口,并使用大幅增加的后训练算力进行训练。据 Moonshot AI 称,额外的训练针对长程智能体任务,并减少事实性错误。它还提升了金融建模和办公文档等专业任务,以及面向游戏引擎、3D 场景和计算机辅助设计(CAD)脚本的编码能力。Kimi K3.1 Pro Highspeed 的输出 token 生成速率更高,Moonshot AI 报告其速度是 Kimi K3.1 Pro 的 2–3 倍。
Kimi K3.1 Pro Highspeed 使用与 Amazon Bedrock 上 Kimi K3 相同的端点、API 和功能。如果你已经基于 Kimi K3 构建应用,只需在现有代码中更改模型 ID 即可试用。
Kimi K3.1 Pro Highspeed 支持工具调用、结构化输出、可配置推理、图像输入和流式传输。你可以在不改变安全态势的情况下采用 Kimi K3.1 Pro Highspeed。你的数据在 AWS 数据边界内处理,不会与 Moonshot AI 共享,也不会用于训练模型。推理请求始终启用零数据保留,并且通过零操作员访问,AWS 操作员在推理期间无法查看你的提示和补全内容。
在本文中,我们将向你展示如何在 Amazon Bedrock 上开始使用 Kimi K3.1 Pro Highspeed。我们还会介绍如何通过 Flex 层级降低成本、针对重复上下文使用显式提示缓存,以及如何在 OpenCode 中将该模型用作编码助手。
在 Amazon Bedrock 上开始使用 Kimi K3.1 Pro Highspeed
如需在不编写代码的情况下试用该模型,请打开 Amazon Bedrock 控制台,选择 Test,然后选择 Playground,并选择 Kimi K3.1。
在代码中,Kimi K3.1 Pro Highspeed 可通过 OpenAI 兼容的 Chat Completions 和 Responses API,以及 Amazon Bedrock 的 Converse 和 Invoke API,在 bedrock-runtime 端点上使用。我们推荐使用 Chat Completions API。你可以通过跨区域推理配置文件访问该模型:
global.moonshotai.kimi-k3.1将请求路由到任何受支持的商业 AWS 区域,且每 token 成本低于地理配置文件。我们建议将其用于大多数工作负载。us.moonshotai.kimi-k3.1将处理限制在美国区域内,in.moonshotai.kimi-k3.1将其限制在印度区域内,适用于有数据驻留要求的工作负载。
先决条件
要跟随示例操作,你需要:
- 一个可访问 Amazon Bedrock 的 AWS 账户。
- Python 3.11 或更高版本,并安装 OpenAI SDK、aws-bedrock-token-generator 和 boto3(
pip install -U openai aws-bedrock-token-generator boto3)。 - 一个被允许在 Kimi K3.1 Pro Highspeed 推理配置文件上调用
bedrock:InvokeModel和bedrock:InvokeModelWithResponseStream的 AWS Identity and Access Management (IAM) 身份。如果你使用 bearer token 进行身份验证,请添加bedrock:CallWithBearerToken。
使用 Chat Completions API 调用 Kimi K3.1 Pro Highspeed
如果你的应用程序已经使用 OpenAI SDK,请将其指向 Amazon Bedrock 端点并更改模型名称。以下示例根据你的 AWS 凭证创建一个短期 bearer token,并发送一个请求:
from openai import OpenAI
from aws_bedrock_token_generator import provide_token

REGION = "us-west-2"
MODEL_ID = "global.moonshotai.kimi-k3.1"

# A short-term token derived from your AWS credentials, so no long-lived key is stored in code
client = OpenAI(
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    api_key=provide_token(region=REGION),
)

completion = client.chat.completions.create(
    model=MODEL_ID,
    messages=[
        {"role": "system", "content": "You are a concise senior engineer."},
        {"role": "user", "content": "When should I prefer a queue over a stream?"},
    ],
    reasoning_effort="high",
)
print(completion.choices[0].message.content)
Kimi K3.1 Pro Highspeed 在回答前始终会进行推理。使用 reasoning_effort,你可以控制推理量:low、high 或 max。如果你不设置,模型将使用 max,因此在较简单的任务上,较低的值是降低延迟和输出 token 的最直接方式。
使用 Responses API 调用 Kimi K3.1 Pro Highspeed
同一个客户端也可用于 Responses API,该 API 使用 reasoning.effort 进行相同的设置:
response = client.responses.create(
    model=MODEL_ID,
    input="Summarize the trade-offs between optimistic and pessimistic locking.",
    reasoning={"effort": "low"},
)
print(response.output_text)
使用 Converse API 调用 Kimi K3.1 Pro Highspeed
如果你已经在使用 Amazon Bedrock Converse API,那么只需更改模型 ID:
import boto3

bedrock = boto3.client("bedrock-runtime", region_name="us-west-2")
response = bedrock.converse(
    modelId="global.moonshotai.kimi-k3.1",
    messages=[{"role": "user", "content": [{"text": "Explain idempotency keys in two sentences."}]}],
)

# The model can return a reasoning block before the answer, so pick the text block
content = response["output"]["message"]["content"]
print(next(block["text"] for block in content if "text" in block))
使用 Flex 层级降低成本
Flex 层级以标准价格的一半提供 Kimi K3.1 Pro Highspeed,代价是响应时间可能更长。它非常适合成本效率优先于响应时间的工作负载,例如模型评估、内容摘要以及智能体工作流中的后台任务。由于你可以为每个请求选择层级,一个应用程序可以混合使用多个层级。例如,同一个应用程序可以对延迟敏感的请求使用 Priority,对日常流量使用 Standard,对成本敏感的工作使用 Flex。你的按需配额在 Standard、Priority 和 Flex 层级之间共享。
要使用 Flex,请将 service_tier 设置为 flex。以下示例复用了前面的 Chat Completions 客户端:
completion = client.chat.completions.create(
    model=MODEL_ID,
    messages=[{"role": "user", "content": "List edge cases to test in a function that parses ISO 8601 dates."}],
    service_tier="flex",
)
print(completion.choices[0].message.content)
print(completion.service_tier)  # The tier that served the request
在 Converse API 上,请改为将 serviceTier 设置为 {"type": "flex"}。要查看每个层级处理了多少流量,请使用 Amazon CloudWatch 中的 ServiceTier 和 ResolvedServiceTier 维度。我们建议先将一小部分流量放在 Flex 上,比较延迟和成本后再扩大用量。
使用显式提示缓存优化推理
智能体和编码助手在每一轮都会重新发送相同的大型前缀:系统指令、工具定义、仓库约定和参考文档。Kimi K3.1 Pro Highspeed 会自动缓存重复的前缀,而通过显式提示缓存,你可以标记稳定前缀的结束位置,以提高缓存命中率。后续请求会复用该前缀,而不是再次处理它,从而降低长且重复上下文的延迟和输入成本。
适用以下几条规则:
- 显式缓存适用于 Chat Completions、Responses 和 Invoke API,但不适用于 Converse。
prompt_cache_breakpoint之前必须至少有 256 个 token 的稳定内容。- 缓存内容至少保留 30 分钟。
- 缓存写入的计费费率高于标准输入。缓存读取按折扣费率计费,且不计入你的每分钟输入 token 配额。
以下示例缓存一个较长的系统提示,并在用户内容之后添加第二个断点,这样针对同一文档的后续问题就可以复用这两层缓存:
from pathlib import Path

LONG_STATIC_PROMPT = Path("repo_guidelines.md").read_text()  # stable content, at least 256 tokens
QUESTION = "Which of these guidelines apply to database migrations?"

def cached_text(text):
    # Marks the end of a cacheable prefix
    return {"type": "input_text", "text": text, "prompt_cache_breakpoint": {"mode": "explicit"}}

response = client.responses.create(
    model=MODEL_ID,
    extra_body={"prompt_cache_options": {"mode": "explicit"}},
    input=[
        {"type": "message", "role": "system", "content": [cached_text(LONG_STATIC_PROMPT)]},
        {"type": "message", "role": "user", "content": [cached_text(QUESTION)]},
    ],
)
details = response.usage.input_tokens_details
print(f"Cache read: {details.cached_tokens} tokens") # greater than 0 on a cache hit更多信息,请参阅提示缓存以加快模型推理。
Kimi K3.1 Pro Highspeed 实践:使用 OpenCode 进行编码
OpenCode 是一个开源、与模型无关的编码智能体,可在你的终端中运行。你可以通过 Amazon Bedrock Chat Completions API,使用 OpenCode 的 OpenAI 兼容提供程序和 Amazon Bedrock API 密钥将其连接到 Kimi K3.1 Pro Highspeed。要创建密钥,请在 baseURL 中设置的 AWS 区域打开 Amazon Bedrock 控制台,然后选择 API keys。短期密钥最长有效期为 12 小时,仅在生成它的区域中有效,建议用于生产环境。长期密钥用于探索。
将以下内容添加到 ~/.config/opencode/opencode.json,并将 baseURL 中的区域替换为你自己的区域:
{
  "$schema": "https://opencode.ai/config.json",
  "providers": {
    "amazon-bedrock-chat-completions": {
      "name": "Amazon Bedrock (Chat Completions)",
      "package": "@opencode/ai/providers/openai-compatible",
      "settings": {
        "baseURL": "https://bedrock-runtime.us-west-2.amazonaws.com/openai/v1"
      },
      "models": {
        "global.moonshotai.kimi-k3.1": {
          "name": "Kimi K3.1 Pro Highspeed",
          "capabilities": {
            "reasoning": { "supported": true, "effort": ["low", "high", "max"] }
          }
        }
      }
    }
  },
  "model": "amazon-bedrock-chat-completions/global.moonshotai.kimi-k3.1"
}
在项目目录中启动 OpenCode,输入 /connect,选择 Amazon Bedrock (Chat Completions),然后如图 1 所示粘贴你的 API 密钥。OpenCode 会存储该密钥,因此每个密钥只需连接一次。要在会话期间在 Kimi K3.1 Pro Highspeed 和其他模型之间切换,请输入 /models。
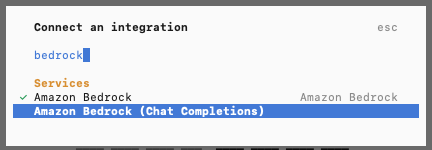
图 1:将 OpenCode 连接到 Amazon Bedrock(Chat Completions)提供商
配置中的 capabilities 条目列出了模型支持的推理强度级别,因此 OpenCode 提供 low、high 和 max 作为该模型的变体,如图 2 所示:
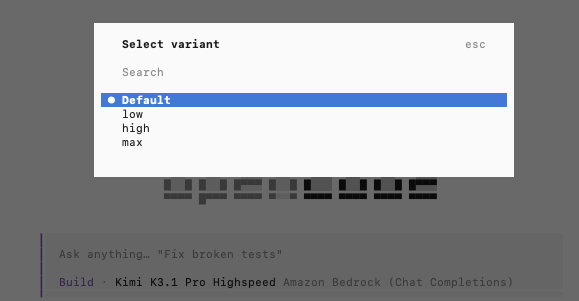
图 2:OpenCode 中 Kimi K3.1 Pro Highspeed 的推理强度变体
在智能体编程中,输出速度最为关键。为完成单个任务,编程智能体会连续发起多次模型调用。它读取文件、规划变更、编辑代码、运行测试并修复失败之处。每次调用都必须在下一次开始前完成,而其中大部分时间用于生成推理内容和代码。更高的输出 token 速率可缩短每一步,因此整个“编辑—测试—修复”循环能更快完成,迭代之间的等待也更少。
可用性
Kimi K3.1 Pro Highspeed 可通过 global.moonshotai.kimi-k3.1、us.moonshotai.kimi-k3.1 和 in.moonshotai.kimi-k3.1 跨区域推理配置文件在 Amazon Bedrock 上使用。有关支持的区域和模型详情,请参阅 Kimi K3.1 Pro Highspeed 模型卡 和 区域可用性。有关定价,请参阅 Amazon Bedrock 定价。
要开始使用,请在 Amazon Bedrock 控制台 中试用 Kimi K3.1 Pro Highspeed。要与 Amazon Bedrock 团队讨论您的用例,请联系我们。
关于作者

Aris Tsakpinis
Aris 是生成式 AI 高级专家解决方案架构师,专注于 Amazon Bedrock 上的开放权重模型以及更广泛的生成式 AI 开源生态系统。在职业角色之外,他正在雷根斯堡大学攻读机器学习工程博士学位,研究方向为科学领域的应用自然语言处理。

Chaitanya Manani
Chaitanya 是 Amazon Bedrock 的软件开发经理,也是该服务的创始成员。他领导设计和构建 Amazon Bedrock 模型托管基础设施的团队,目前负责运营该基础设施,为开放权重和专有模型提供服务。工作之余,他喜欢徒步和户外活动。

Saurabh Trikande
Saurabh 是 Amazon Bedrock 和 Amazon SageMaker Inference 的高级产品经理。他热衷于与客户和合作伙伴合作,并以推动 AI 民主化为动力。他专注于部署复杂 AI 应用、多租户模型推理、成本优化以及让生成式 AI 模型的部署更易获取等核心挑战。业余时间,Saurabh 喜欢徒步、了解创新技术、关注 TechCrunch 以及与家人共度时光。

Alex Thewsey
Alex 是 AWS 的 AI 专家解决方案架构师。他专注于开源技术和开放权重模型如何帮助全球客户构建创新的 AI 解决方案并应对 AI 治理挑战。
来源:AWS Machine Learning Blog · aws.amazon.com