多智能体设计模式分类、反模式与制造业实践教训
Taxonomy of multi-agent design patterns, anti-patterns, and lessons from manufacturing
AWS 博客梳理多智能体系统的两层协调模式,Tier 1 为开发者定义路径的顺序流水线、条件工作流、条件路由和并行工作流,Tier 2 为模型在运行时决定路径的计划编排、交接、对话驱动和辩论共识。
企业团队正在构建多智能体系统,而当早期实现效果不佳时,原因很少出在模型上。多智能体协调是一个分布式系统问题,而许多着手处理这一问题的团队尚未建立起分布式系统的直觉。
各来源的数据一致:约88%的AI试点项目从未进入生产环境。斯坦福HAI证明,当协调开销超过收益时,两个模型协作的表现可能比各自单独工作更差。模式很清晰:团队增加复杂度的速度快于他们建立理解的速度。十个每一步可靠性为95%的步骤,端到端可靠性仅为59.9%,而20个步骤则降至35.8%。这个示例模型假设严格顺序链且无重试,但方向是成立的:每一次依赖性的交接都会成倍放大风险。
在本文中,你将了解如何判断一个用例是否需要多个智能体、如何选择协调模式,以及如何及早发现代价高昂的反模式。你还会看到节拍时间、安全边界、边缘数据和班次周期如何塑造架构。
多智能体协调模式
协调模式根据谁控制流程分为两个层级。在第一层中,由你定义路径。
在第二层中,模型在运行时选择路径。这种灵活性可以处理那些你无法预先定义步骤的工作,但代价是更高的token消耗、延迟和调试成本。实用的默认做法是从第一层开始,只有当子任务在工作过程中浮现时,才将任务迁移到第二层。
第一层:模式(确定性控制流)
1.1 顺序流水线:实现线性执行的编排模式,每个节点的输出馈入下一个节点(A -> B -> C),支持具有可预测执行时序的有序处理
在下图中,输入流向智能体A(提取),然后流向智能体B(转换),再流向智能体C(验证),最后输出。用户在构建时定义该顺序,运行时不做任何决策。因此,流水线易于调试和测试,成本也可预测。典型适用场景包括文档处理、提取-转换-加载(ETL)链以及保修索赔分诊。
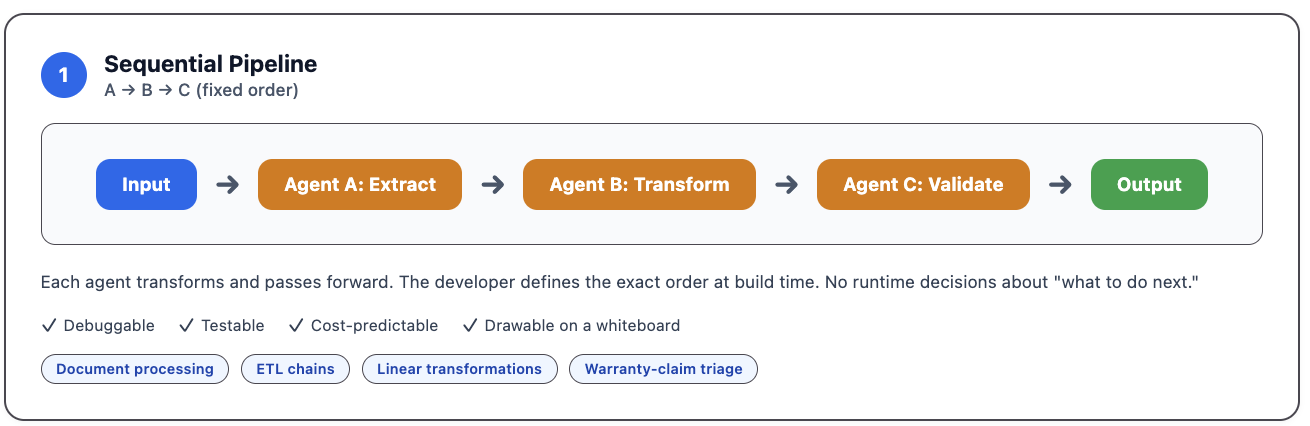
图1:顺序流水线,每个智能体的输出馈入下一个,从提取到转换再到验证
1.2 条件工作流:基于逻辑的边按条件选择下一个节点,因此工作流可以分支,将每个案例送入不同路径。
在下图中,用户请求先流向智能体A(编写代码),然后流向智能体B(测试代码)。通过/失败检查将通过的工件发送给智能体D(部署)。失败的工件循环回智能体A进行重试,最多N次,然后升级给人工处理。编排层强制执行该上限,例如通过AWS Step Functions的迭代限制,从而防止循环变成本文后面描述的无界迭代反模式。
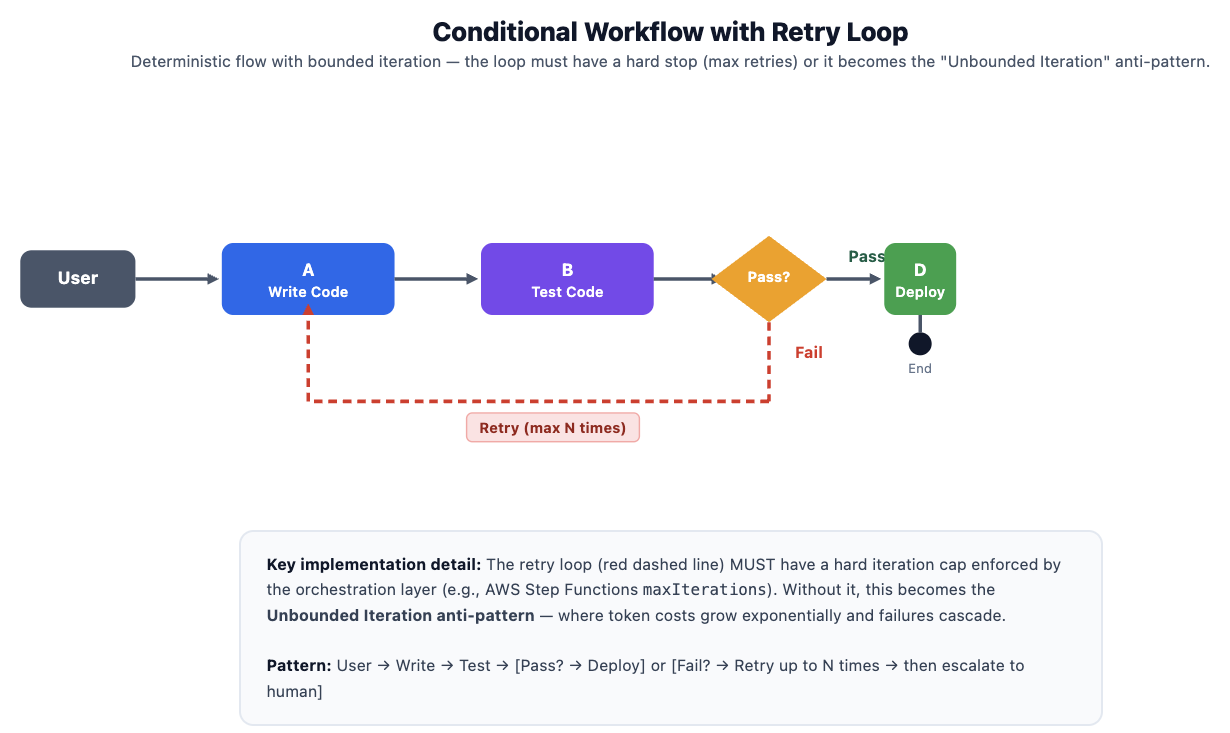
图2:条件工作流,失败时最多重试N次,然后升级给人工处理
1.3 条件路由器:
分类步骤检查输入并将其导向适当的处理路径。每个请求只执行一条路径。最适合意图驱动的分派、质量门决策、客户咨询路由和异常分诊。
下图展示了一位工厂主管的请求被分类器读取,并发送给恰好一位专家。关于零件是否符合规格的问题交给质量代理,逾期设备维护交给维护代理,班次变更交给排程代理。这一决策在入口处完成。
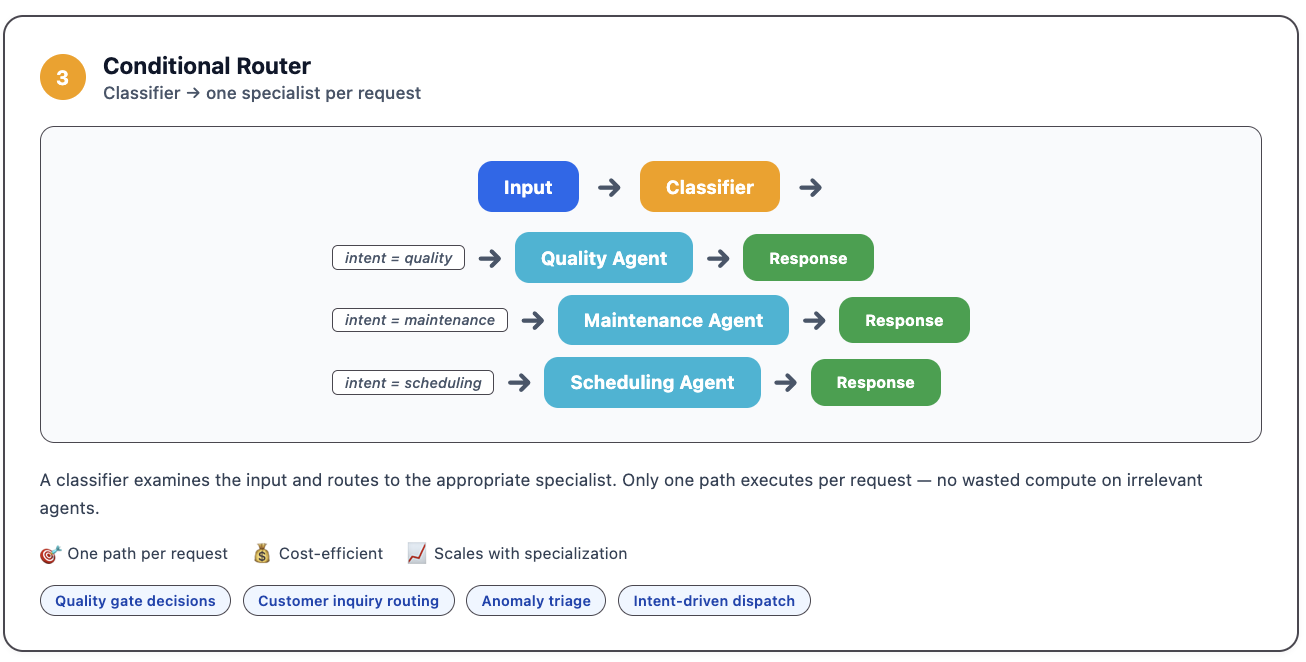
图 3:条件路由器,每个请求只运行一条路径,并在升级至人工之前进行有限次重试
1.4 并行工作流:任务被拆分为多个独立的子任务,在各处理器上同时运行,每个子任务处理自己的数据。当所有处理器完成后,一个扇入步骤将结果合并;某条路径失败时只重试该路径。最适合多源分析、批处理以及可分解为独立部分的工作。
下图中,一个研究编排器将任务分解,并分派给三个并发运行的专家代理:一个金融数据代理、一个地缘政治代理和一个物流代理,各自分析自己的来源。一个合并步骤等待三者全部完成,然后综合结果、解决冲突并对发现进行排序。延迟等于最慢的单个代理,而不是三者之和。
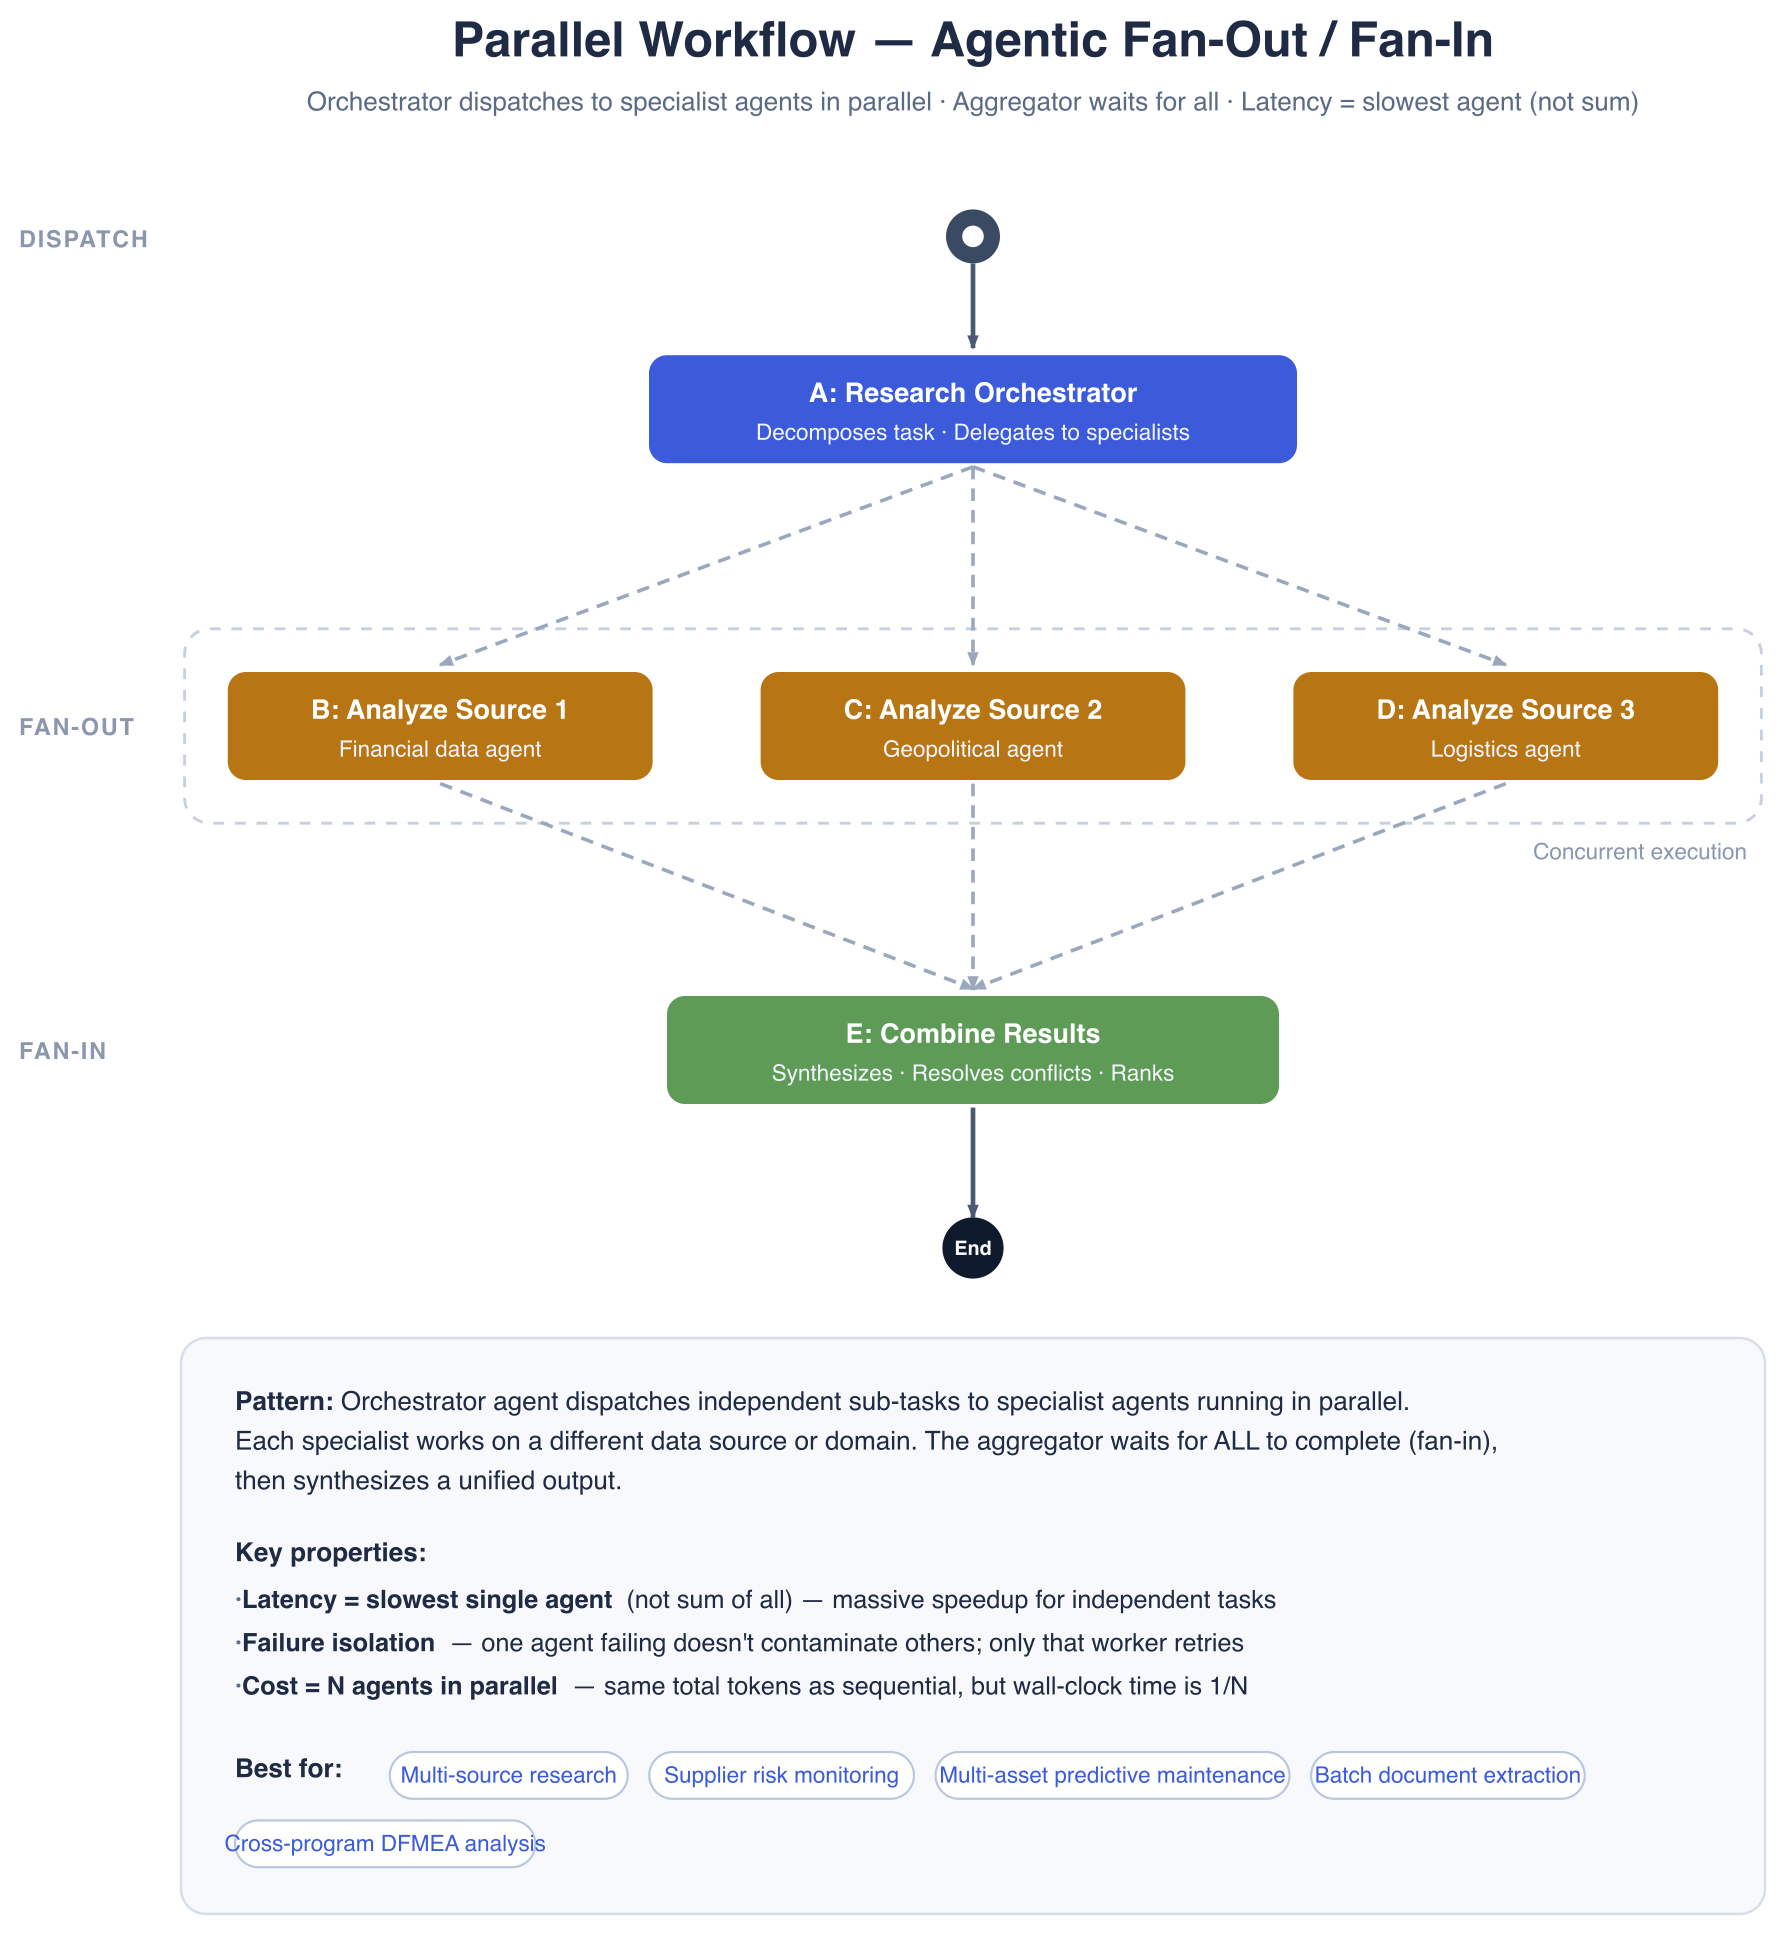
图 4:并行扇出到专家代理,随后通过扇入步骤综合并排序结果
第 2 层:自主模式(由 LLM 决定控制流)
在自主模式中,控制流由 AI 模型自身在运行时决定,而非由开发者预先定义。代理读取任务状态,推理所需内容,并通过共享上下文进行协调,而不是依赖固定路径,其范围从结构化编排一直延伸到完全涌现的行为。
2.1 基于计划的编排
在基于计划的编排中,单个编排器代理充当项目经理。编排器维护一份包含分配和依赖关系的显式任务计划,能看到全部上下文,而每个工作者只收到自己那部分;它根据当前计划动态分配工作,并集中监控进度。关键设计选择是工作者无状态且相互独立。如果一个失败,不会污染其他工作者。编排器只重试失败的工作者,而不是整个工作流。
下图展示了规划代理如何将任务分解为显式计划,并将每一步分派给工作者代理。每一步都交给一个专用工作者(研究代理、分析代理和报告代理),它只能看到分配给自己的那部分。
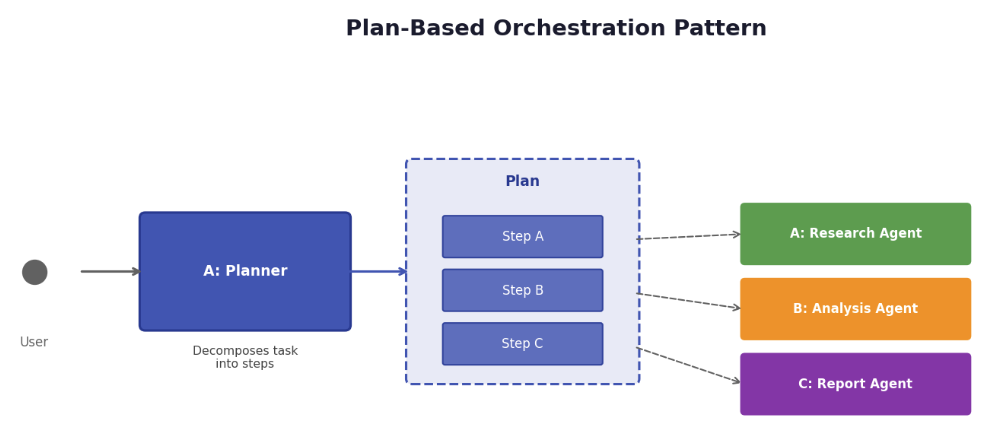
图 5:基于计划的编排,规划代理将每一步分配给无状态的工作者代理
2.2 交接模式
代理以有限的局部知识运作,并通过点对点委派进行协调。每个代理根据任务及其所知的代理,就何时转移控制权以及转移给谁做出局部决策。控制权随状态一起传递:每次转移都携带经过验证的任务状态、其背后的证据以及任何未解决的问题,因此接收代理是继续工作,而不是重新解读一份摘要。仅通过对话传递的交接不算交接。
下图中,客服代理将控制权连同其上下文转移给技术支持代理或账单代理,技术支持还可以进一步交接给高级工程师。每个代理只知道它可以转移给的那一小部分同伴。
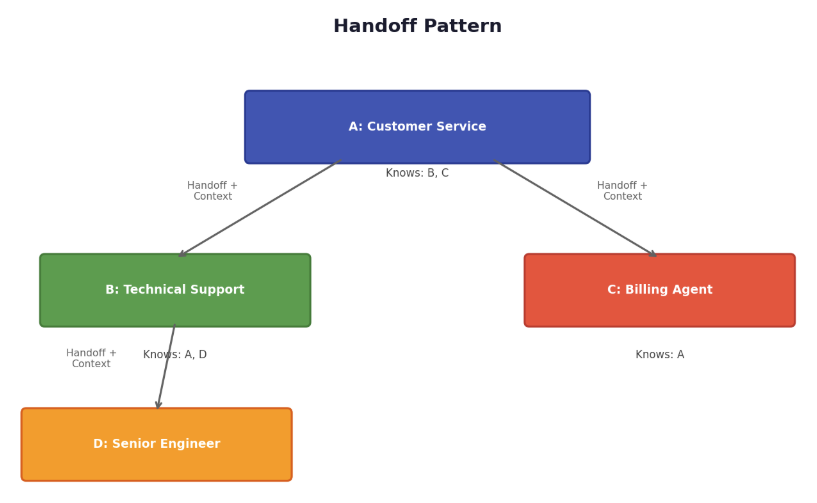
图 6:交接模式通过局部委派在同伴代理之间传递经过验证的状态
2.3 对话驱动模式
在对话驱动的模式(也称为群聊模式)中,所有智能体参与一个共享对话,编排通过轮流发言而非显式计划或结构化交接来实现。这映射了人类团队协作,每个人都能看到讨论并在适当时机贡献。
在下图中,一个智能体选择机制决定轮到谁发言,智能体 A、B 和 C 各自向一个共享对话中添加内容,每一轮都是一条消息加一次工具调用。选择机制设定轮流规则,状态隐式地存在于对话历史中。
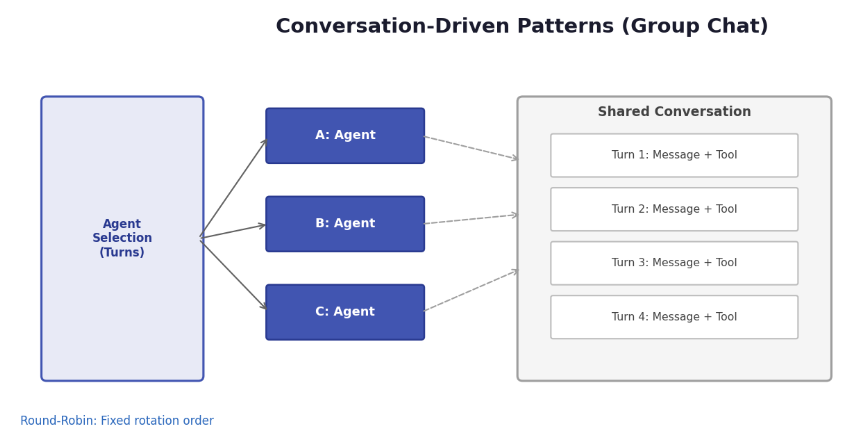
图 7:对话驱动模式,轮流发言选择下一个智能体,状态存在于对话中
控制流特征:
- 可见性:广播,所有智能体观察共享对话中的所有消息。
- 决策:根据对话上下文选择下一个发言者,而非预定计划。
- 状态管理:隐式存在于对话历史中。
- Turn-taking: Determined by selection mechanisms (round-robin, AI-driven)
- 轮询。智能体按固定、重复的顺序轮流发言,直到满足终止条件,这使其可预测。
- AI 驱动。模型从对话上下文中选择下一个发言者,而非固定顺序。
2.4 辩论/共识
多个智能体独立评估同一输入,其结论通过多数投票、裁判智能体或在分歧时升级来协调。与对话驱动模式不同,智能体在表明立场前看不到彼此的推理,这正是使分歧具有信息价值而非社会趋同的原因。
谨慎使用。辩论是这里最昂贵的模式,在感知任务上它换来的是延迟而非准确率(参见后文反模式 3 中的质量检测案例)。将其保留给高风险、低数量的决策,在这些决策中出错的代价高于深思熟虑。
混合方法
在实践中,大多数生产系统根据任务分解组合多种模式:
- 对可预测、理解充分的组件使用工作流模式。
- 在灵活性和适应性至关重要的地方应用自主模式。
- 在所有编排类型中一致地实现任务管理模式(终止、委托)。
- 设计分层组合,让复杂智能体在不同层内部使用不同模式。
治理原则:模式与任务对齐。将编排方法匹配到每个任务的固有特性和系统的可靠性要求,而不是强制所有事情都通过单一模式。
消耗预算的反模式
以下五种反模式在设计时看起来都合理,但每一种后来都会表现为膨胀的 token 成本、错过的节拍时间窗口,或一个悄悄与车间实际脱节的决策。
1. 上帝智能体
一个智能体在单个提示词和 15 个或更多工具的背后负责整体设备效率(OEE)分析、可编程逻辑控制器(PLC)诊断和维护。随着工具增多,工具选择会退化,故障变得难以归因。
修复方法:有界智能体,工具不超过五个,例如 OEE 分析师、故障诊断员和维护起草员。
2. 无界迭代
智能体在“再试一次”上循环,没有硬性停止。一个四智能体系统在单次重试之前就可能消耗显著更多的 token,而且没有任何一次调用会触发警报。重试会放大协调失败,而不是修复它们。
修复方法:在代码中设置硬性迭代上限、每个智能体的 token 上限、连接到自动停止的预算警报。由基础设施强制执行限制。模型不会自己停下来。
3. 自然语言契约
智能体之间传递自由文本散文,没有 schema。解释在每一跳都会变得更硬:“可能表明磨损”变成“确认磨损”变成维护工单。漂移发生在智能体之间,而那里的追踪最薄弱。
4. 过早多智能体
一个带工具组的智能体就能完成的事,却用了多智能体。每个智能体都会增加非线性的协调税,而收益在四个左右趋于平缓。大多数“专家”只是同一个模型换了不同的装扮。
修复方法:至少需要两个不同的模型、不同的工具访问权限、并发执行和真正的相互依赖。少于两个,一个带动作组的智能体就能完成。
测试:一个智能体能否通过切换工具来处理各个阶段?如果可以,那就不是多智能体问题。
5. 无防护的客户接触
智能体在没有审批步骤的情况下触发现实世界动作(电子邮件、服务访问、机器参数)。幻觉跨越到物理世界,不可逆动作会叠加,责任从退款升级到产品责任。
修复方法:纵深防御:推荐 → Amazon Bedrock Guardrails → schema 验证 → 业务规则 → 人工审批 → 执行。
智能体输出到达客户或安全系统的每一个点都是信任边界。
选择架构
在了解了模式和反模式之后,架构选择归结为一系列简短的问题。
- 任务是否需要文本生成之外的动作?将直接模型调用视为基线,只在有可衡量理由时才添加编排。总结文档或根据规范生成代码很少提供这样的理由。
- 解决方案路径是否提前已知?如果你能写下什么按什么顺序发生,你根本就没有“多少个智能体”的决策。你真正的选择更简单:一个调用工具的智能体,或一个 Tier 1 工作流。
- 工作是否需要真正不同的专业知识?具有既定交接的独立领域才值得使用专门智能体。单一领域属于一个智能体,无论它需要多少工具。
- 解决方案是否只能通过探索浮现?当动作序列已知且可以作为“行动并验证”循环运行时,它属于单个智能体,即使是动态规划步骤的智能体。只有当子任务本身是在工作过程中被发现时,Tier 2 才值得其增加的成本、延迟和调试负担。
下面的决策树将这四个问题转化为一条你可以从上到下遵循的路径。
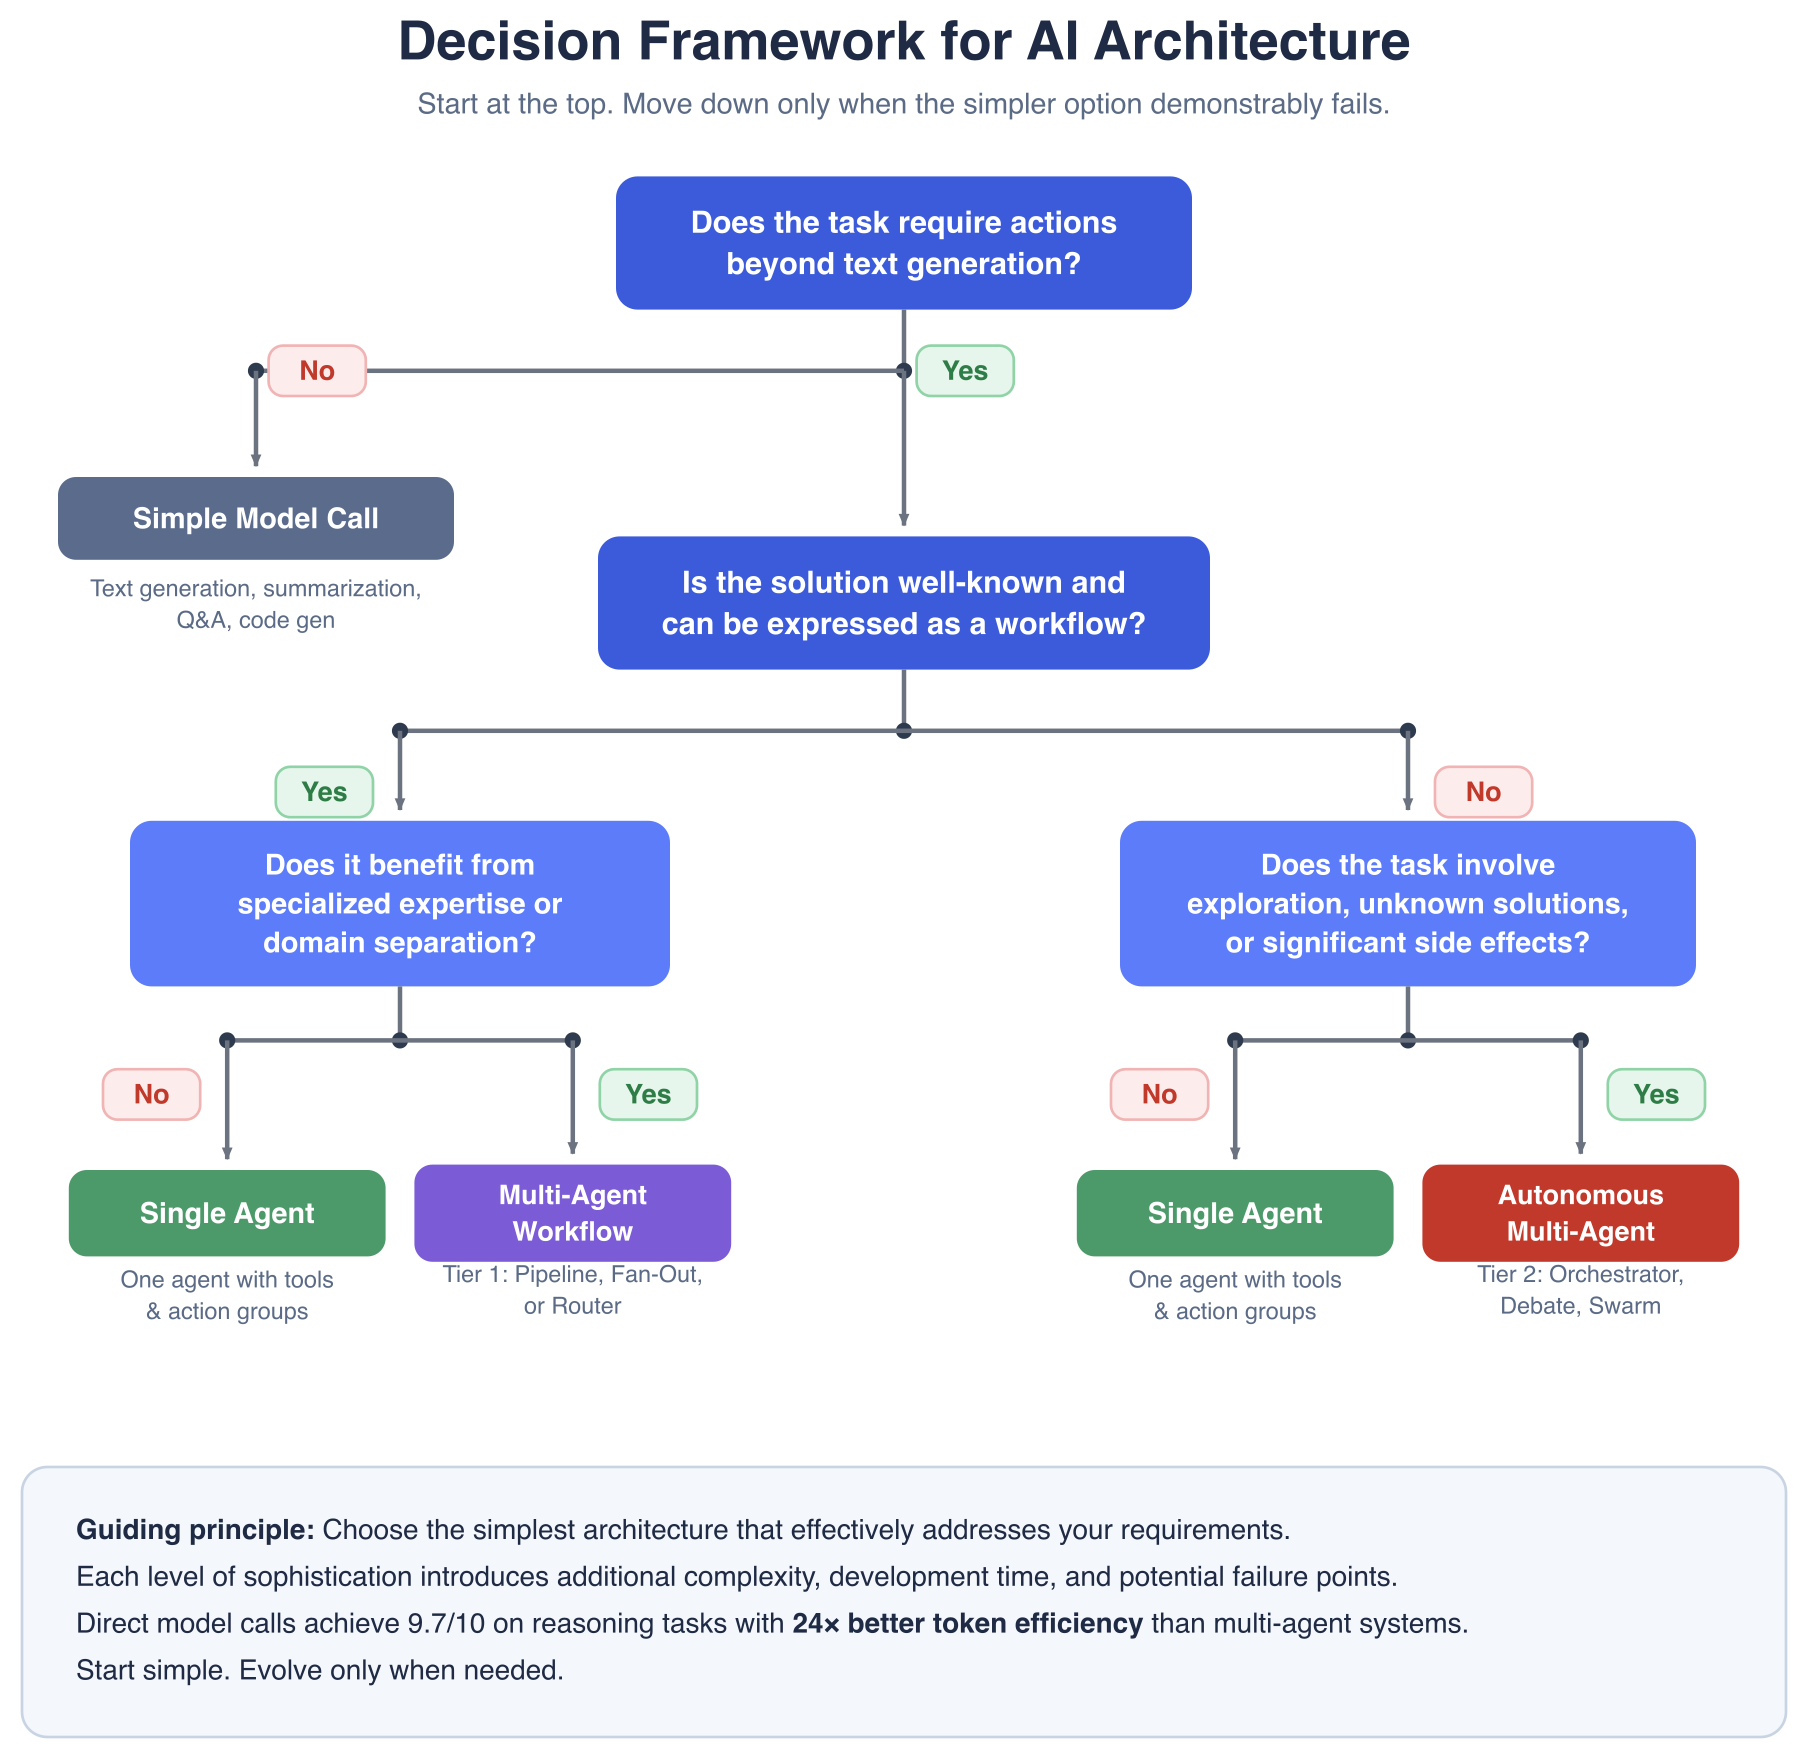
图 8:选择最简单架构的决策树,从单次模型调用到 Tier 2 多智能体模式
这棵决策树首先询问该任务是否需要超出文本生成的动作。如果不需要,一次简单的模型调用就足够了。如果需要,决策树会询问该解决方案是否众所周知、能否表达为工作流。在已知解决方案一侧,受益于专业知识或领域分离的工作会进入 Tier 1 多智能体工作流(流水线、扇出或路由器)。其余的都交给带工具和动作组的单智能体。在未知解决方案一侧,只有涉及探索或显著副作用的任务才会进入 Tier 2,采用自主多智能体模式。其余仍由单智能体处理。指导原则是选择满足需求的最简单架构。
下图从四个方面比较了这些模式:何时采用每种模式、智能体之间的控制流如何传递、结果的确定性如何,以及构建和运行的成本。构建成本是相对尺度,不是估算值。
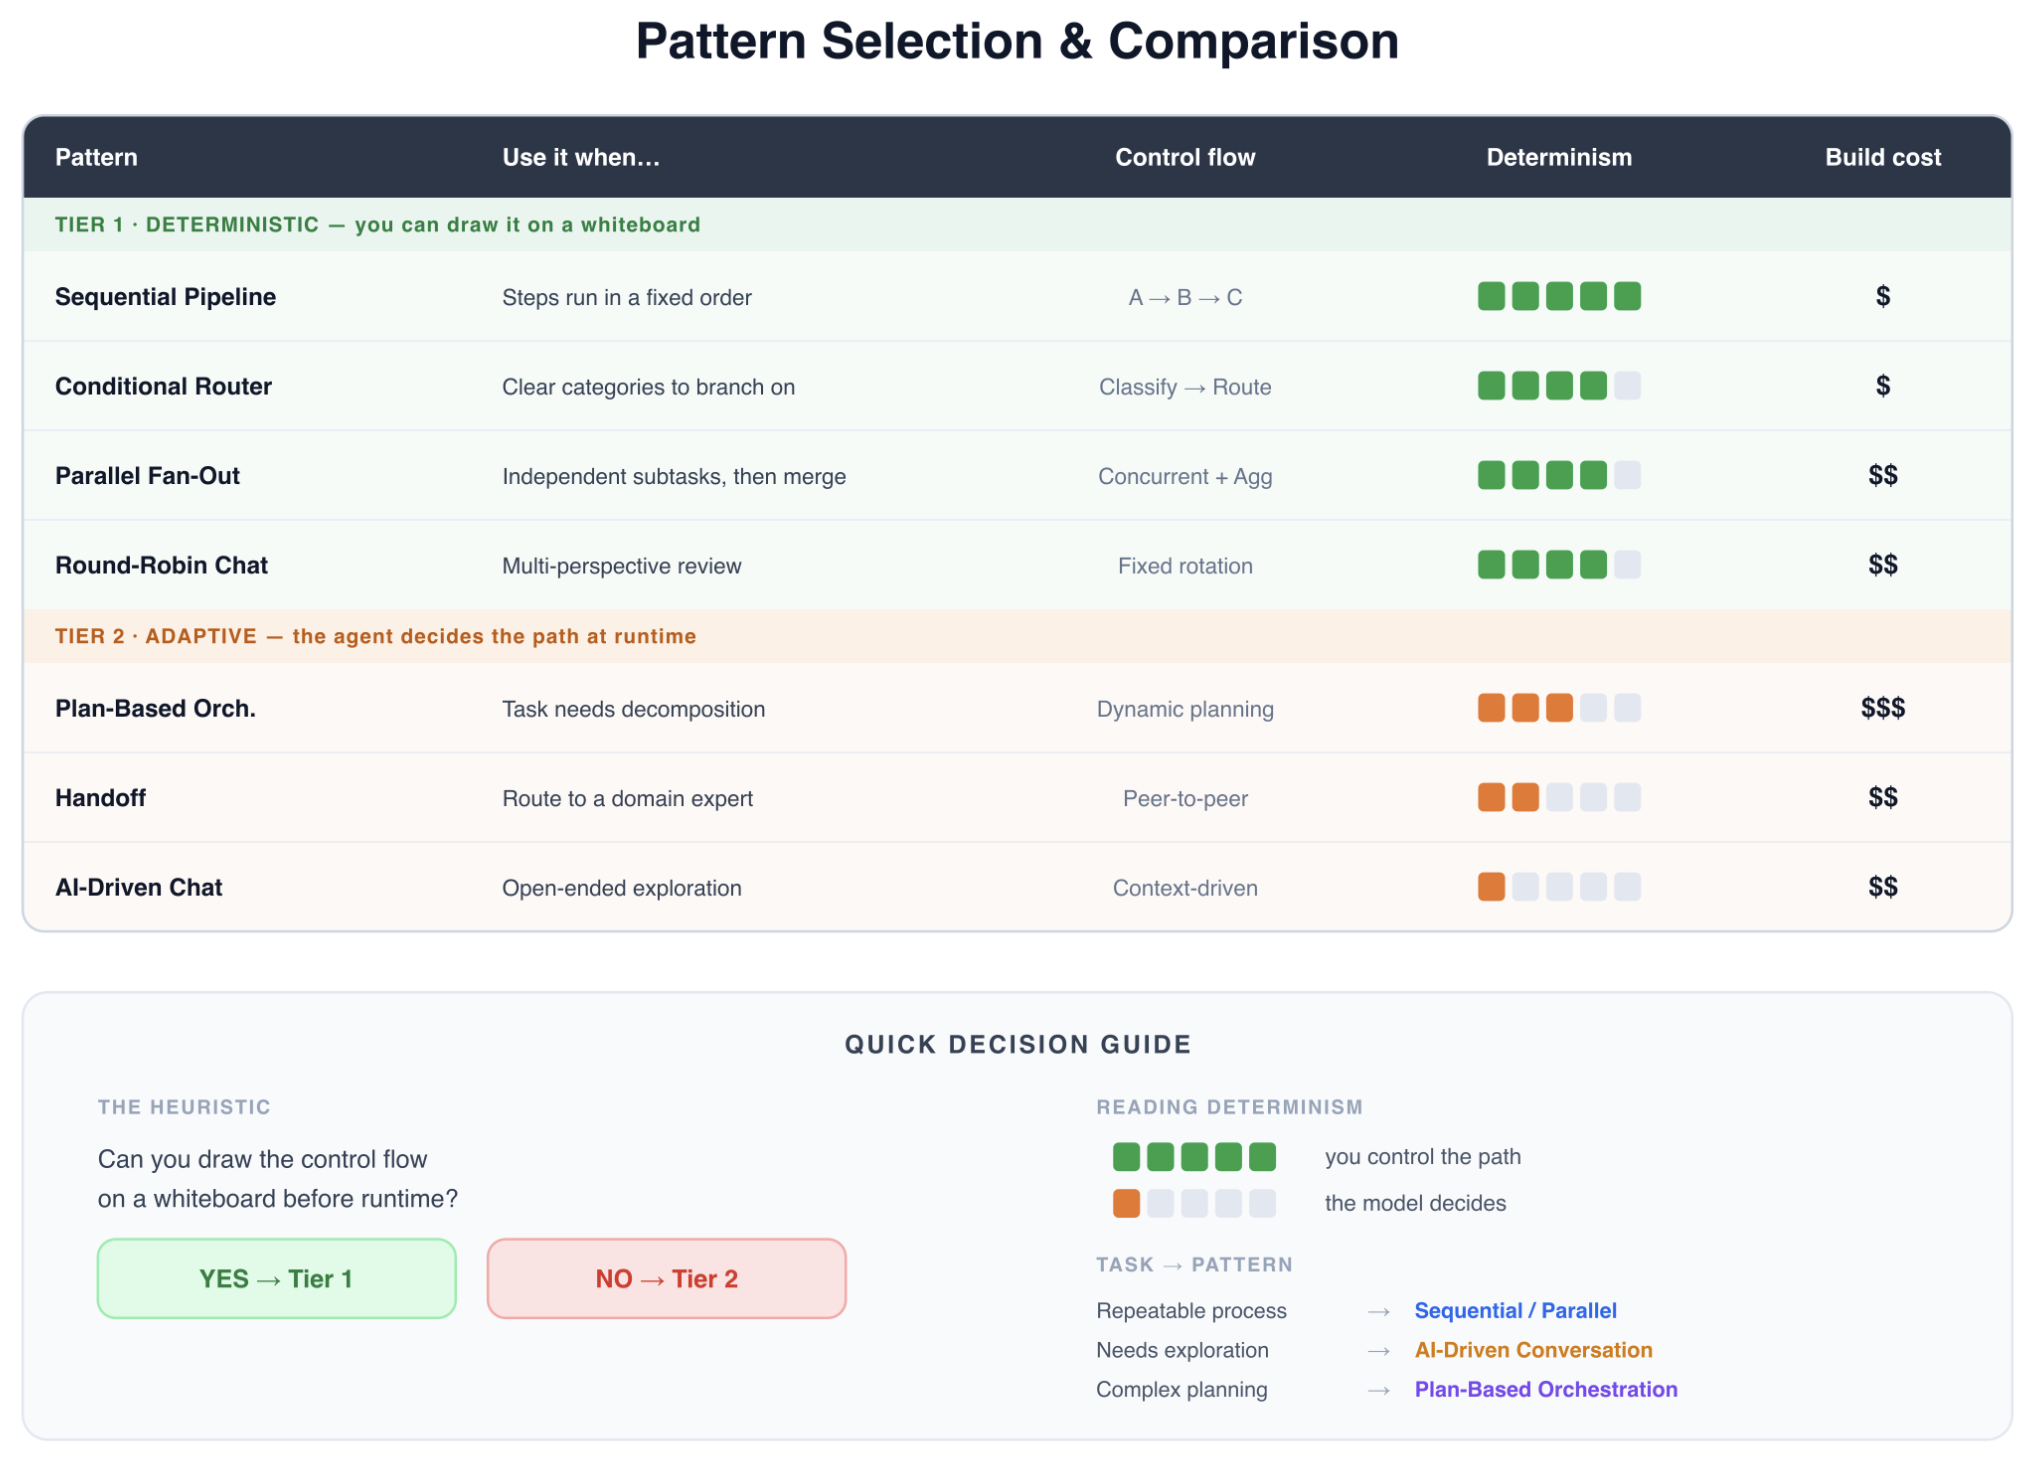
图 9:按用例、控制流、确定性和相对构建成本比较各模式
Tier 1 模式在确定性上得分高,构建成本低到中等。Tier 2 模式把更多路径交给模型,而基于计划的编排构建成本最高。如果你能在运行前在白板上画出控制流,就从 Tier 1 开始。
应用:将模式映射到制造业用例
| 用例 | 模式 | 理由 |
| 交接班摘要 | 顺序流水线 | 线性:原始日志 → 摘要 → 报告 |
| 多工位根因分析 | 基于计划的编排器 | 动态:分析过程中发现子任务 |
| 实时质量门 | 条件路由器 + 边缘智能体 | 周期内:本地模型决策。智能体推理不在路径上 |
| 预测性维护调度 | 并行扇出/扇入 | 按资产类别独立建模 |
| 工程变更单影响 | 辩论/共识 | 高风险:对抗性审查合理 |
| 供应商沟通起草 | 顺序 + 人工门 | 不得自动发送(见无防护客户接触) |
| 跨工厂优化 | 基于计划的编排器 | 多源:动态查询。求解器负责分配 |
制造业视角:改变算式的四个约束
制造业不是通用的企业 IT 环境,四个约束让这笔算术变得毫不宽容。
约束 1:产线延迟 = 直接收入损失
汽车车身车间中,机器人将车身焊接在一起,通常以每小时 60 个工件的速度运行。其 40 多个工位中,每个工位在产线推进前都有 60 秒的节拍时间。位于工位周期路径上的推理延迟会侵蚀这 60 秒,而瓶颈工位的延迟会拖慢整条产线。即使吞吐量下降 2%,也可能转化为显著的年度收入影响。
架构含义:按 p99 而非平均值来预算延迟。尾部延迟才是让产线停下的原因。为每个智能体提供亚秒级的确定性回退,并使其与风险相匹配:
- 建议/质量标记:放行零件并标记,供下线审查。
- 安全关键:遏制或确定性停止,而不是继续。
- 在部署前按工位决定这种映射。
约束 2:安全具有物理后果
聊天机器人产生幻觉会带来尴尬。焊接参数产生幻觉则会造成结构缺陷,这些缺陷会在碰撞测试或现场失效中暴露出来,并可能导致安全召回。有两种失效模式反复出现:
- OT/IT 边界状态不同步:智能体读取制造执行系统(MES)时看到 12 号工位正在运行 A 号零件,但手动 PLC 覆盖已将其切换为 B 号零件,因此它为错误的零件调整参数。
- 安全边界幻觉:维护智能体从零开始推理上锁/挂牌流程,并在相邻的 6 号工位运行时宣布 7 号工位可进入,破坏了联锁区域。
架构含义:
边界:保持确定性核心不变,包括 PLC、数据采集与监控系统(SCADA)以及 MES,并在其周围包裹一个建议层。
- 智能体负责观察、分析和建议。它们不执行动作。
- 安全约束作为确定性护栏存在于外部服务中,由智能体查询,而非由智能体推理。它们永远不会嵌入提示词中,因为在提示词里它们可能被争辩掉。
验证与批准:建议需通过模式验证和物理仿真,并在执行前立即对照 OT 真实源进行检查,绝不使用超过一个周期缓存的 OT 状态。然后按其范围匹配的级别进行批准:
- 级别 0:智能体自主解决。
- 级别 1:操作员一键确认。
- 级别 2:工程师根据呈现的分析做出决定。
- 级别 3:管理层评估停线建议。
只有到那时,经过验证的命令接口才会将允许的命令传递给确定性控制。大语言模型(LLM)提出建议。物理引擎和人类操作员做出决定。
约束 3:数据驻留在边缘
单台冲压机每天产生 50+ GB 的传感器数据,其价值在毫秒内衰减。将其传输到云端的带宽成本高于计算成本,而且等到云端给出答案时,冲压机早已进入下一工序。
架构含义:混合边缘-云是实际默认方案,约束 2 的边界在边缘同样成立。
- 边缘(AWS IoT Greengrass):在源头进行亚节拍异常检测、阈值监控和停止或继续信号:边缘智能体提出建议,PLC 执行动作。
- 云端:边缘无法完成的工作:跨班次分析、跨工厂趋势关联,以及基于车队数据的模型再训练。边缘只提炼并传输关键信息。
约束 4:与班次对齐的智能体生命周期
无界上下文会使智能体漂移,因为过时的观察会挤占当前现实。完全重置会丢失班次之间的连续性。制造业已经通过结构化交接班为人类解决了这个问题,智能体也需要同样的纪律。
架构含义:将智能体记忆限制在班次周期内。
- 初始化:班次上下文,包括人员名册、生产目标和上一班次交接。
- 累积:仅在班次窗口内的工作记忆。
- 交接:生成班次结束摘要,包含未解决问题、标记的异常和建议,为下一班人员提供种子,模仿人类仪式而不导致无界上下文增长。
基于 AWS 构建
以下托管服务对应本文前面提出的关注点。每一行都指明了机制,而不仅仅是服务。
| 需求 | 服务 | 机制 |
| 运行时 | AgentCore runtime,Amazon Bedrock AgentCore 的一项能力 | 智能体的运行位置,其控制流由确定性逻辑或模型决定。可接入 Strands、LangGraph 或 CrewAI。 |
| 按班次限定的记忆 | AgentCore memory,Amazon Bedrock AgentCore 的一项能力 | 托管的短期与长期上下文,因此约束 4 中按班次限定的记忆只需配置,而无需自定义状态管道。 |
| 类型化交接 | AgentCore Gateway,Amazon Bedrock AgentCore 的一项能力 | 将 API 和 AWS Lambda 函数转换为具有经过验证的 schema 的 Model Context Protocol (MCP) 工具,因此交接携带类型化字段而非自然语言文本。 |
| 智能体权限 | AgentCore Identity,Amazon Bedrock AgentCore 的一项能力 | 为每个智能体提供唯一且可验证的身份,并具备细粒度访问控制。它是执行点,用于确定哪个智能体可以访问哪个系统,以及代表谁访问。 |
| 智能体之间的追踪 | AgentCore Observability,Amazon Bedrock AgentCore 的一项能力 | 通过 Amazon CloudWatch Transaction Search 和 AWS Distro for Open Telemetry (ADOT) 跨运行时、记忆、网关和工具进行 span 与追踪。交接是多智能体系统中最难观测的部分,也是无类型契约静默失败之处。 |
| 人工审批界面 | AWS Quick | 升级层级落地之处。AWS Quick Automate 运行审批工作流,支持在 Slack 中一键审批,其操作连接器可以调用 Amazon Bedrock AgentCore 智能体。 |
| 分层模型选择 | Amazon Bedrock | 跨模型系列的统一 API,因此成本分层只需配置:小模型用于路由器的分类,更强的模型用于编排器的综合。 |
结论
多智能体系统改变了汽车制造商大规模编排智能的方式,但前提是建立在正确的基础之上。
这里的模式与反模式来自真实部署,在这些部署中,糟糕的架构表现为失控的 token 成本、节拍时间违规,最坏情况下还会带来人身安全风险。工厂规模下的经济性毫不宽容,因为 token 量会随着每个智能体、机器人和班次而增长。分层模型选择、上下文压缩和边缘-云分布是以一小部分成本交付同等价值的主要杠杆。
这里的建议是从 Tier 1 模式开始,验证价值后再扩展。大多数制造用例,例如班次交接摘要、质量门决策和预测性维护,都适合用确定性工作流来满足。将自主编排保留给真正开放式的问题,在这类问题中,动态子任务发现足以证明额外的成本、延迟和调试复杂性是合理的。
关于作者

Kamlesh Mariwala
Kamlesh 是 AWS 的高级 GenAI ML 解决方案架构师,专注于汽车和制造业。他帮助客户设计可扩展、安全且经济高效的架构,利用 AWS 智能体 AI 和机器学习解决复杂业务问题并加速实现价值。

Malini Sethi
Malini 是 Amazon Web Services (AWS) 的解决方案架构师,专注于汽车与制造行业。她与大型汽车和工业客户合作,设计并实施云原生解决方案,加速其在 AI 应用方面的数字化转型,即 AWS 生成式 AI。在担任现职之前,她曾担任 AWS ProServe 顾问,与客户紧密合作,将复杂的技术挑战转化为可扩展、可投入生产的系统。她曾在 MIT 学习机器学习。

Deepesh Koppunuru
Deepesh 是 AWS 的高级 GenAI ML 解决方案架构师,他与大型企业客户合作,通过 AWS 生成式 AI 服务释放创新潜力。Deepesh 热衷于展示 AI 的变革力量,帮助组织重新构想其业务流程,并实现可衡量、能带来真正影响的成果。

Sandy Hsieh
Sandy 是 AWS 全球专家组织中的高级数据与 AI 专家,支持汽车与制造客户采用生成式 AI、代理式 AI 和 Physical AI 解决方案。Sandy 拥有超过 10 年的全球汽车行业经验,涵盖供应链、车辆规划和信息娱乐等领域。她拥有卡内基梅隆大学机械工程硕士学位。
来源:AWS Machine Learning Blog · aws.amazon.com