Modem 从 pgvector 迁移到 turbopuffer,搜索 p90 降低 76%
Modem 将向量搜索从 Postgres 的 pgvector 迁移到 turbopuffer,p90 搜索时间降低 76%,并把大部分负载从数据库上卸下。此前共享 pgvector 表导致最小客户等待长达十秒,2026 年 8 月中位搜索约 0.8 秒、最慢 1% 达 28 秒;测试中 HNSW 索引在多租户过滤场景下反而更慢,小客户中位数慢 89 倍。
Modem:Blog·2026-11-13 22:00· 3 小时前AI 评分63
将 pgvector 换成 turbopuffer 后,搜索变得更快、更便宜
AI 导读
Modem 团队复盘了将向量搜索从 Postgres 的 pgvector 迁移到 turbopuffer 的过程。小型客户因共享内存被挤出而搜索等待长达十秒;测试发现 pgvector 的 HNSW 索引在多租户过滤场景下更慢,小客户中位数慢 89 倍。
正文 · 原文
了解我们共享的 pgvector 表如何让最小的客户变得最慢、为什么 HNSW 索引反而让情况更糟,以及迁移到 turbopuffer 如何让搜索变得更快、更便宜。
和许多其他 AI 产品一样,Modem 使用嵌入向量。当新的客户消息进来时,我们想知道是否有客户在任何渠道、用任何措辞说过类似的话。嵌入向量是我们回答这个问题的方式之一。
起步时,我们希望尽可能少地管理各种组件。因此这些嵌入向量就存放在 Postgres 中,使用 pgvector 扩展。很长一段时间里,这都没问题。
后来我们的搜索开始以一种莫名其妙的方式变慢。一些最小的客户要等上十秒才能拿到结果,而我们最大的客户(要扫描的数据最多)却能立刻得到答案。与此同时,我们的数据库计算成本一路飙升。
在这篇文章中,我将解释是什么拖慢了我们的速度、为什么标准修复方案对我们这样的产品不起作用,以及我们最终如何妥协并切换到 turbopuffer——它把我们的 p90 搜索时间缩短了 76%,并卸掉了数据库的大部分负载。
为什么我们一开始选择 Postgres
Modem 会读取你的团队和用户交流的场所(支持工单、问题跟踪器、通话记录、Slack),并把发现的内容归入主题。每当它从对话中提取出一个新的客户关注点,就会问数据库:最近是否有任何客户说过类似的话?
为了回答这个问题,我们使用嵌入向量。嵌入向量是一长串数字(称为向量),由模型根据一段输入文本生成。含义相似的字符串会得到指向相似方向的向量。
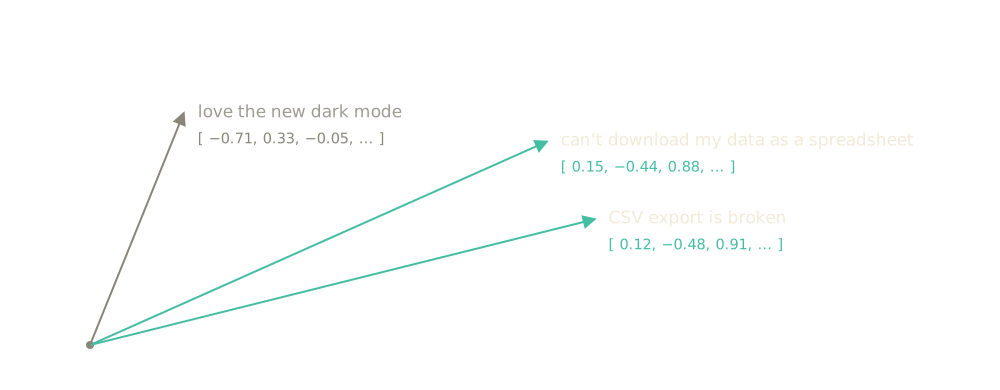
起步时,我们的数据非常少,也没有费心为嵌入向量建索引。因此执行这个查询时,Postgres 会查看该客户的近期行,并把每一行与新嵌入向量逐一比较。
这种暴力方法奏效的时间远超预期。我们的数据库提供商 Neon 慷慨地赠送了免费计算额度,让我们可以超额配置而不是优化,于是我们就这么做了。而且由于这些向量搜索作为数据摄取的一部分在多个后台任务中运行,慢查询对用户来说大多难以察觉。
但随着我们增加更多客户、摄取更多数据,嵌入向量的数量开始快速增长。到 2026 年 8 月,搜索中位数耗时约 0.8 秒,最慢的 1% 长达 28 秒。我们的 Neon 计算资源不断扩容以跟上节奏,其中相当大一部分就花在这一个查询上。最终免费额度用完了,数据库账单到期了,我们很快意识到自己正坐在一个什么样的问题上。
数据库中慢查询的标准修复方案是加索引。但在测试中,这个索引不仅没有提升性能,反而让性能明显变差。
HNSW 索引如何工作
pgvector 中的标准向量索引是 HNSW,全称是 Hierarchical Navigable Small World。许多向量数据库都支持它,向量搜索正是靠它变快的。
HNSW 不会将你的查询与每一行逐一比较,而是构建一个图,其中每个向量都链接到其最近的邻居,并按从稀疏到完整的层次堆叠。搜索从顶层开始,向最接近的目标跳跃,然后下降一层并重复。你只需查看几百行而不是整张表,答案是近似的,但通常非常好。
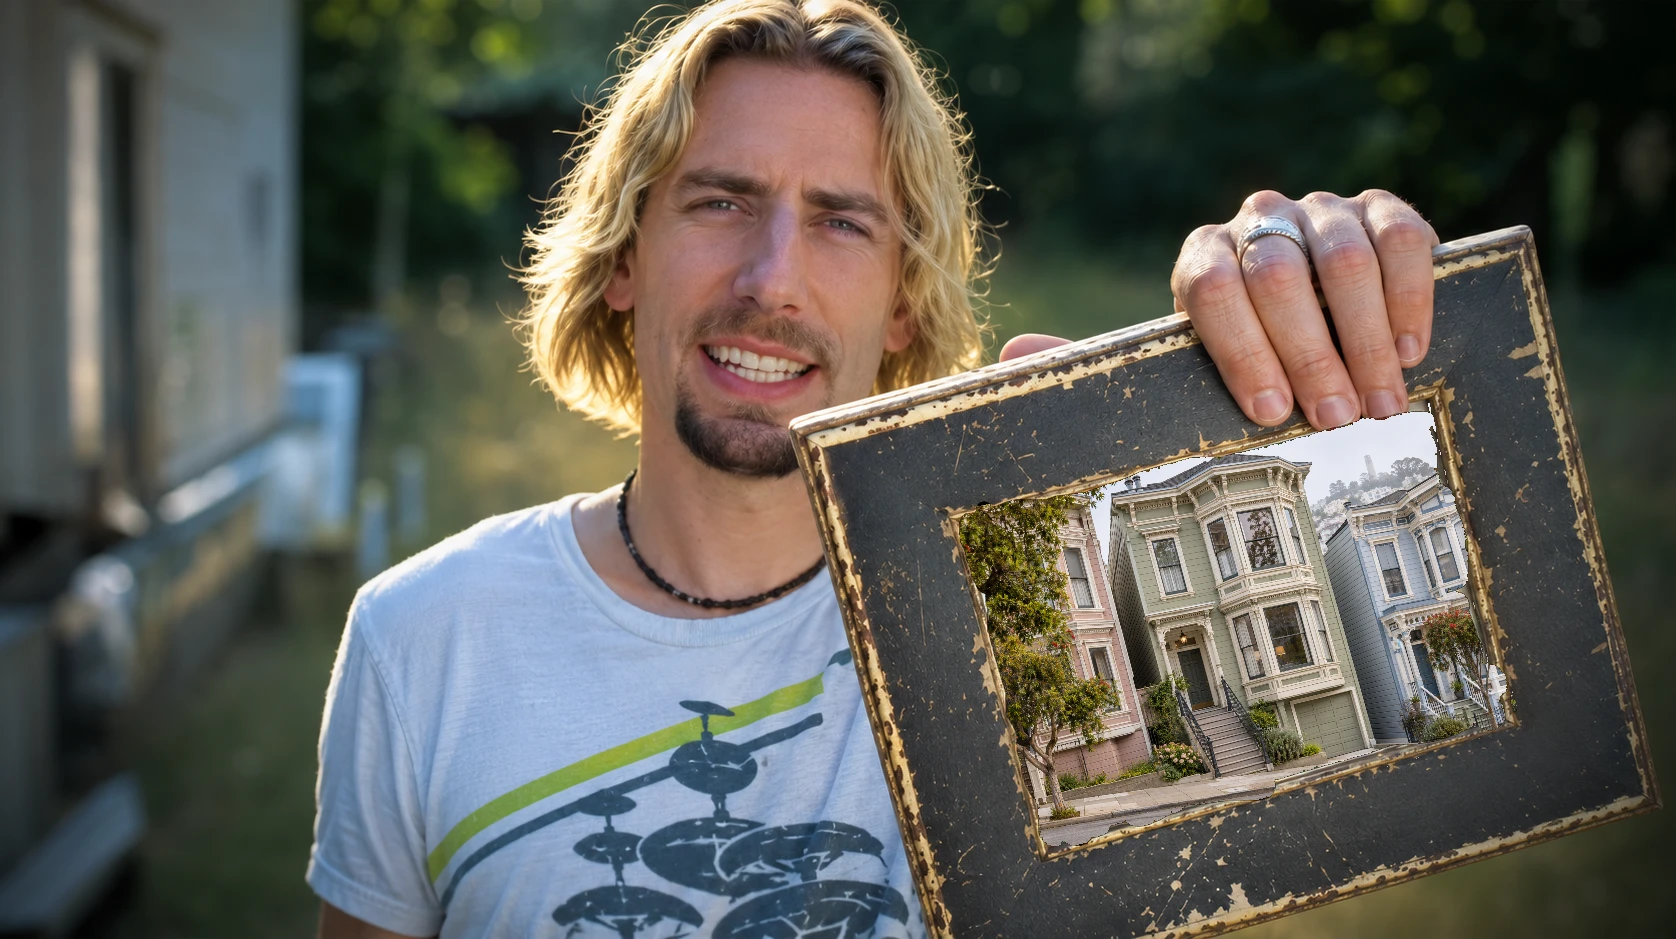
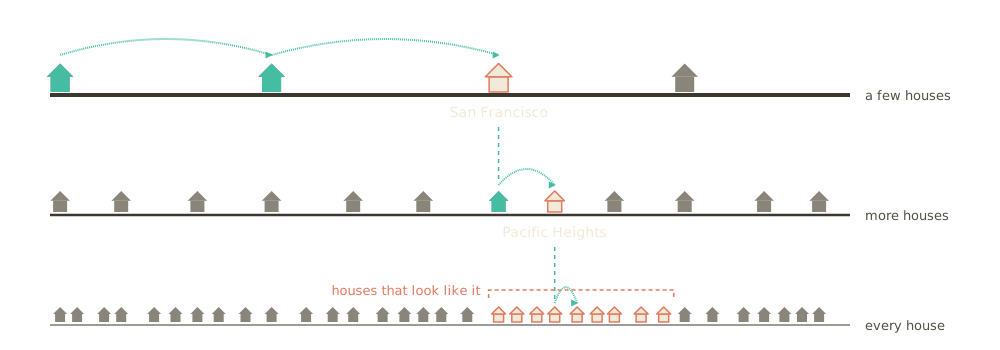
让我给你举个例子。想象你拿到一张房子的图片,并被要求找出一组看起来像它的房子。你会从分布在世界各地的几栋房子开始,然后走向最像你图片的那一栋。
假设第一个命中是旧金山的一栋房子。然后你会查看旧金山附近更多、更密集的房子,并移动到最像它的那一栋,这可能会让你来到像太平洋高地这样的街区。最后,你会在那里的街道上行走,直到周围都是看起来像你图片的房子。这大致就是 HNSW 找到相似向量的方式。
意外:HNSW 可能让性能变差
如果 HNSW 能自行回答你的查询,那很好。但我们的查询有两个额外的过滤条件:
- 数据所属的
organization_id - 一个时间范围(用于时效性)
通常,Postgres 会为你组合索引。你有一个用于 organization_id 的索引,一个用于 timestamp 的索引,规划器从每个索引中取出匹配的行,保留同时属于两者的行,然后继续。这一切都会自动发生,你无需考虑。
SELECT ... FROM semantic_groups
WHERE organization_id = $org_id        -- Organization filter
  AND timestamp > now() - $time_window -- Time range
ORDER BY embedding <=> $candidate
LIMIT $count;
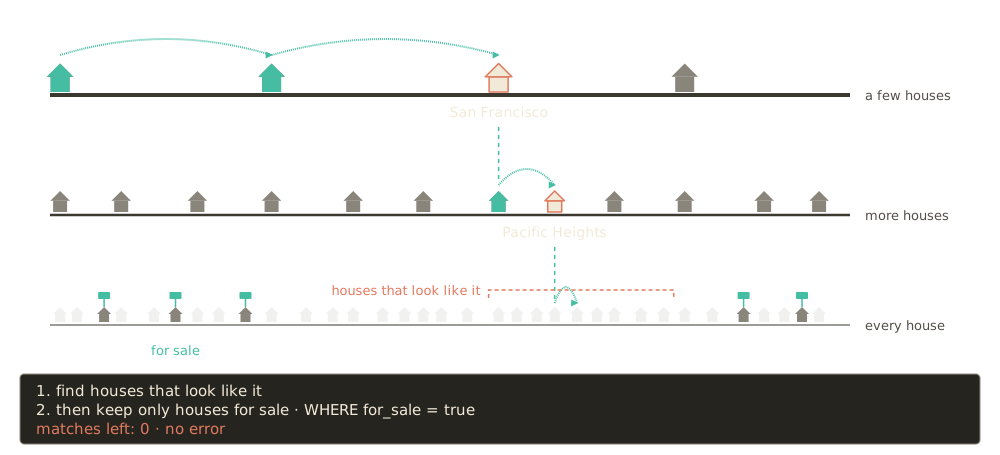
但 HNSW 不是这样工作的。常规索引回答的是“哪些行匹配?”HNSW 回答的是“哪些行最接近?”而“最接近”适用于向量空间中的所有内容,忽略任何其他过滤条件。换句话说,Postgres 首先在整个表上遍历图,之后再应用你的常规列过滤条件。
在由许多客户共享的多租户表上,这是一场灾难。向量查询从整个表中返回固定数量的候选匹配,然后 organization_id 和时间过滤器会丢弃所有不属于目标组织或时间范围的内容。这通常意味着原本看起来有希望的候选结果被缩减为空集。
回到找房子的例子。假设你仍然想找到看起来像输入图片的房子,但你有一个新条件:你只想考虑待售的房子。你像之前一样进行搜索:旧金山、太平洋高地、一条满是看起来像你图片的房子的街道。只有到那时你才检查标志。那些房子没有一栋待售,所以你一无所获,尽管沿街往下几栋有几栋是待售的。
这是 pgvector 的一个已知问题。以至于它有一个设置 hnsw.iterative_scan,会不断扩大遍历范围,直到有足够的行通过过滤条件。
我们在几千次真实生产搜索中将其与暴力扫描进行了对比测试。
- 拥有少于 500 个组的客户中位数速度慢了 89 倍,9.1 秒对 103 毫秒。
- 大约 7% 的结果发生了变化,包括数十个之前被人确认相关的匹配。
- 最慢的搜索耗时 178 秒。
- 这些索引几乎使表的存储空间翻倍。
客户越小,遍历需要跋涉的图就越多才能找到其行。而且由于我们是一个提供免费套餐的自助服务产品,我们的大多数客户都是小客户。
于是我们撤掉了索引,回到暴力扫描。但最初的问题依然存在:它一开始为什么这么慢?
按组织分别建 HNSW 索引?
为什么不使用部分索引,为每个组织单独创建一个 HNSW 索引?
这只解决了一半的过滤条件,我们还没有覆盖时间范围。你可以把组织固化进索引,因为
organization_id永远不会变,所以每个客户各自的索引就只是一个带WHERE organization_id = …的部分索引。但你无法把“最近”固化进去,因为它每天都在变。在(organization_id, timestamp)上建一个普通的 btree 索引能很好地找到这些行,但 Postgres 不会把它和 HNSW 索引结合起来。它要么遍历图之后再过滤,要么使用 btree 并与找到的每一行逐一比较,这又回到了暴力扫描。
为什么向量让缓存变得困难
随着我们不断深挖,我们发现了一件奇怪的事。
一个整天给我们发送反馈的大客户,检索时间中位数约为 1 秒。一个定期给我们发送数据的小得多的客户,中位数却超过 10 秒。这感觉是反过来的,因为在数据库领域,更常见的情况是大账户(要扫描的数据更多)查询更慢。
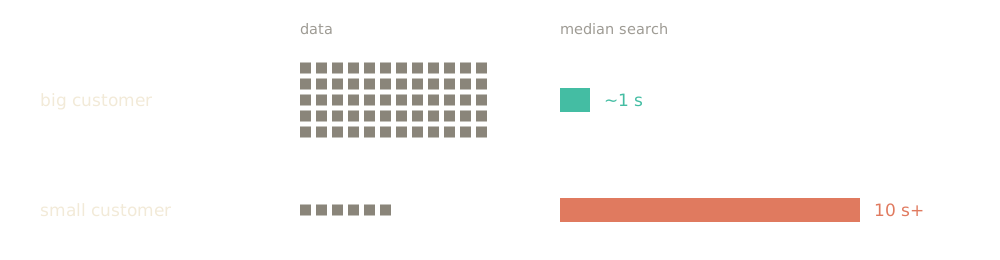
那么到底发生了什么?
繁忙的客户和安静的客户运行的是完全相同的查询。区别在于查询运行时他们的数据恰好位于何处。
Postgres 会把最近使用的数据保留在内存中,而所有客户共享这块内存。我们的嵌入向量足够大,一次只有一小部分能放进内存。繁忙的客户搜索得足够频繁,使其数据行一直留在内存中。安静的客户回来时发现自己的数据行已被其他人挤了出去,于是每次搜索都要访问磁盘。
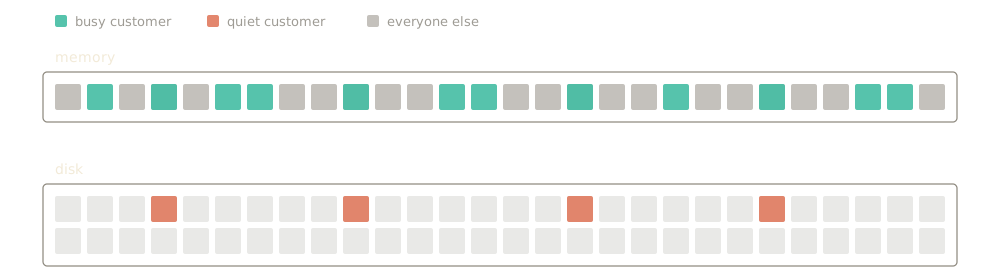
扫描本身没有问题。它总是给出正确的答案。问题在于每一行的读取成本都很高,而其中大部分现在都来自磁盘。
一个嵌入向量有多大?
有两个因素决定嵌入向量的大小:它包含多少个数字,以及每个数字占多少字节。
我们使用 OpenAI 的 text-embedding-3-small,每个嵌入向量返回 1,536 个数字(text-embedding-3-large 返回的是它的两倍)。它们以 32 位浮点数形式返回,但每个值都能用 16 位精确表示。
pgvector默认的vector类型用 32 位存储每个数字,这会使每个嵌入向量约为 6 KB。我们将其存储为halfvec(每个数字 16 位),精度没有损失,因此每个约为 3 KB。事后进一步缩小嵌入向量被称为量化。3 KB 仍然会迅速累积,因为我们为每个输入组保留多个嵌入向量。我们尝试过减少每个嵌入向量的数字数量,但在测试中观察到整体准确率下降,损害了产品体验。有待重新审视。
让 pgvector 奏效的最后一次尝试
此时我们已经怀疑 pgvector 能否跟上 Modem 的增长。我们只是想在我们需要更换基础设施之前为自己争取时间。
如果 HNSW 行不通,而问题在于我们的嵌入向量太大、无法留在内存中,那我们能不能用小得多的量化嵌入向量来创建一个替代索引?
其论点是:一个足够小的向量索引可以完全留在内存中,磁盘上什么都不放。于是我们走到了尽可能小的地步:二值量化。
pgvector 有一个用于此的函数 binary_quantize(),它通过只保留其 1,536 个数字各自是正还是负来缩小嵌入向量。这用一个比特表示,即 1 或 0。
embedding  [ 0.021, -0.013,  0.008, -0.044,  0.017,  0.030, -0.002, ... ] // N = 1,536
quantized  [     1,      0,      1,      0,      1,      1,      0, ... ] // N = 1,536
这将 3 KB 缩减为 192 字节,比较两个向量只需快速统计比特数,而不再是 1,536 次乘法。这显然会损失大量精度。但是,由于嵌入占用的空间小得多,且比较速度极快,你可以多取一些候选,并比较规模大得多的候选集。
最后再回到房子的例子。这就像快速翻看一叠每栋房子的微小模糊照片,挑出一批看起来大致合适的,然后开车过去看看这些匹配是否真的合适。
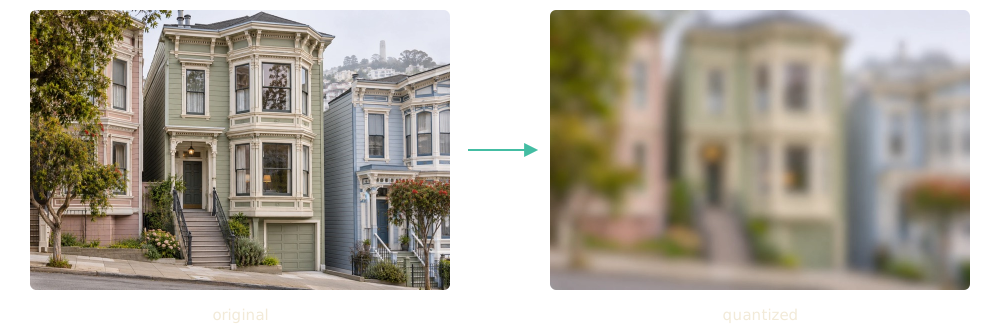
我们将这些量化嵌入保存在它们自己的小表中,它装入内存后还有富余空间。而且由于这只是一张普通的 Postgres 表,我们可以为 organization_id 和 timestamp 等列建立索引,这样查询规划器就能像你预期的那样生成高效的查询。
所以每次搜索都像这样:
- 与客户最近的每一个量化嵌入进行比较,并保留最接近的 N 个候选,其中 N 大约是你最终想要的实际目标数量的 50 倍。
- 对全精度嵌入运行我们最初的精确查询,但只针对那个候选短名单。
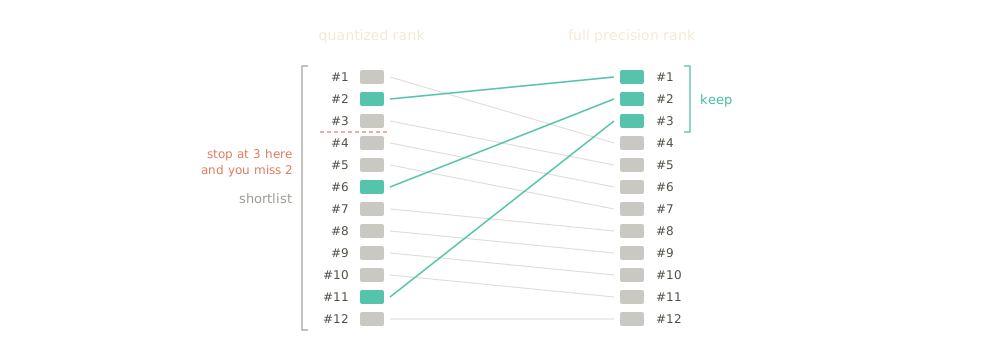
它奏效了。一个回放测试工具用两种方式运行了数千次真实的生产搜索,量化索引返回的结果与暴力扫描相同。它还削减了长尾延迟。在一周的生产流量中,p90 从 7.6 秒降至 3.5 秒,p99 从 28.1 秒降至 6.3 秒。中位数则相反,从 0.81 秒升至 1.16 秒,但造成麻烦的正是那些慢速搜索。
这是一次真正的胜利。搜索变快了,结果没有变化。但完整的 halfvec 嵌入仍然在 Postgres 中,而且即使有了候选短名单,每次搜索仍必须读取大量嵌入。要保持这些读取快速,就得把它们留在内存中,所以我们仍然在为远超应用其余部分所需的数据库付费。换句话说,查询变快了,但我们的 Neon 账单并没有变小。
迁移到 turbopuffer
那时我们不再试图让 pgvector 成真。
是时候做我们内心一直知道必须做的事了:切换到专用的向量数据库解决方案。我们选择了 turbopuffer。
turbopuffer 是一个专有搜索数据库,由两位前 Shopify 工程师于 2023 年创建,以付费 SaaS 服务的形式提供。它支持向量搜索和全文搜索,并将所有内容保存在 S3 等对象存储上,前面配有内存和 SSD 缓存,用于当前正在搜索的数据。这使得保留大量向量的成本很低,并且搜索正在使用的向量速度很快。
turbopuffer 解决了我们问题的两个方面。它在应该在的地方处理过滤——在搜索内部,而不是在搜索之后。并且它将嵌入移出 Postgres,放入一个围绕“大多数向量大多数时间都是冷的”这一理念构建的系统中。
每个客户都有自己的命名空间,因此他们的向量位于自己的索引中。所以一开始我们就只查看该客户的搜索空间。这还带来了额外的好处:账户之间的数据隔离更好。
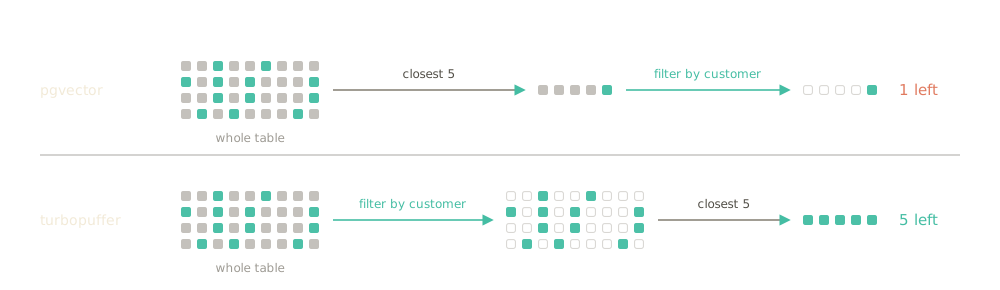
我们为每个向量存储一个时间戳,因此 turbopuffer 只搜索时间窗口内的向量。pgvector 的 HNSW 索引做不到这一点。它先找到最近的若干行,然后再检查它们的日期,而迭代扫描会持续查找,直到有足够多的行通过筛选。我们的量化表把日期处理对了,但为此不得不与窗口内的每一行进行比较。
切换本身改动很小,这要归功于我们在量化索引上花了一个月。我们的搜索已经分两步运行:先构建候选列表,再对其精确排序。而且我们有回放测试框架来判断候选列表是否足够好。我们唯一改变的是候选列表的来源。
我们把每个向量都写入两个系统,并让每位客户在影子模式下运行。Postgres 仍然负责真实响应,turbopuffer 在旁边运行相同的搜索,以便我们比较每一个结果。88% 的结果完全一致。另有 11% 存在细微差异,比如两个几乎相等的匹配以不同顺序返回。
最后 1% 主要来自拥有一个超大主题的客户。关于同一件事的数百条消息会占满一次搜索,把其他内容挤出去。要求 turbopuffer 每个主题只返回一个结果解决了这个问题,剩下的 0.43% 是同样优秀的匹配之间的平局。
在确认无误后,我们把所有客户都切换了过去。以下是三种方案下每条新反馈的搜索时间,每种方案都基于约一周的生产流量测量。
| 百分位 | 每条新反馈的搜索时间每种方案约一周的生产流量 |
|---|---|
| p50 | 暴力扫描0.81 秒量化1.16 秒turbopuffer0.86 秒 |
| p90 | 暴力扫描7.6 秒量化3.5 秒turbopuffer1.8 秒 |
| p99 | 暴力扫描28.1 秒量化6.3 秒turbopuffer4.1 秒 |
中位数几乎没有变化,因为大多数搜索从来就不是问题所在。变化发生在尾部。与暴力扫描相比,p90 下降了 76%,p99 下降了 85%:最慢的 10% 搜索快了约四倍,最慢的 1% 快了近七倍。
关于这些数字的说明。它们是我们管道所见的完整往返时间,包含网络,而不是数据库在查询上花费的时间。而且我们有些搜索要求 turbopuffer 返回精确结果,这意味着要与该客户最近的每一行进行比较,因此客户数据越多,这些搜索耗时越长。对于后台任务,我们宁愿准确而不是快速。
以下是切换那一周的情况,按小时展示。
请注意,此时 Postgres 比我们最初引入量化索引时更慢了。表已经增长,而且我们为一个新功能增加了第二个搜索,它仍然以暴力扫描方式运行,并争夺同一份内存。这说明为什么我们需要一个更好的长期解决方案;针对一种查询模式写一个临时修补,无法顾及我们沿途引入的新查询。
除了查询更快之外,Postgres 还找回了它的内存。在最初的 24 小时内,我们生产数据库的 CPU 下降了 62%,缓存未命中下降了 82%,该表上的慢查询下降了 95%。Postgres 中的其他一切也都变快了,因为这条昂贵的向量查询不再占用全部内存。我们得以缩减 Neon DB 实例规模,并降低了数据库账单。
尽管我们现在还要为 turbopuffer 付费,但切换到这套双系统后,我们的整体存储账单——涵盖所有 Modem 数据,而不只是嵌入——下降了约 10%。
为什么不用另一个向量数据库?
市面上的向量数据库很多,开源的、商业的都有。你大概听说过 Pinecone,或者 Cloudflare 的 Vectorize。
我们很想告诉你,我们做了一场精心设计的横向评测,仔细评估了每一个。但我们没有。turbopuffer 口碑很好,有 Anthropic 这样的知名客户,而且额外的好处是,它和我们一样总部在加拿大。我们把它接进来,对结果很满意,然后就回去专注业务的其他部分了。
我们会告诉另一个使用 pgvector 的团队什么
这一切都不在计划之中。我们一开始只想要一个数据库,最后却有了两个。
我们仍然会从 Postgres 起步。一个数据库要运维的东西更少,而且对小表做暴力扫描,能撑的时间比你想象的要长。但回头看,有三件事本可以让我们更早走到这一步:
查清楚是谁慢,而不只是有多慢。我们的中位数看起来没问题。只有当我们按客户拆分搜索时间时,才发现那些小而安静的客户等待时间长了十倍。如果你最慢的搜索属于你最小的客户,先看内存,再看查询。
在信任索引之前,用真实搜索来测试它。带过滤条件的 HNSW 可能返回不同的结果,或者更少的结果,而且不会报错。我们之所以发现,是因为我们拿它跑了真实的生产搜索并对比了答案。先为此搭一个测试框架。我们的框架比本文提到的所有方案都活得久。
算一算向量让数据库其余部分付出了什么代价。量化索引让我们的搜索足够快。它做不到的是阻止嵌入把其他一切挤出内存,而我们一直在为数据库的超额配置买单。
真正解决问题的是,把嵌入迁移到不会与其余数据争抢内存的地方。
结果证明,多一个数据库比多一个过滤器更简单。
来源:Modem:Blog · modem.ai
来源:RadarAI · aihot.news