用反合一(anti-unification)对形式化策略做语义 diff
Semantic diffing of formal policies with anti-unification
开源引擎用反合一(anti-unification)在 e-graph 上计算形式化策略的语义 diff,找出两个表达式最具体的共同模式,只展示一次共享结构、保留各处差异供审阅。
在审查代码时,你会从差异对比开始。你不会用肉眼比较两个 3,000 行的文件,并指望能发现每一处改动。形式化策略可能更难比较,因为文本差异往往会突出那些不影响语义的语法变化。重新排列两个合取项、交换等式的参数,或使用等价的谓词,文件的大部分内容可能看起来都变了。而真正的行为变化,例如需求要求的是 and 却写成了 Or,可能会淹没在这种噪声中。
语义差异展示了两个策略的共同之处以及它们的分歧所在。本文使用的开源引擎通过反合一来计算这种差异,反合一为两个表达式找到最具体的共同模式。Plotkin 的1970 年论文给出了经典表述。该引擎在 e-graph 上工作,e-graph 会记录已知相等的表达式。我们提供代数定律和领域规则来证明这些相等关系,例如将外部目标等同于非内部目标。结果会展示一次共享部分,并保留每个不同部分的两个版本以供审查。如果没有剩余差异,则这些策略在那些定律和规则下是等价的。当规则或搜索不完整时,剩余的差异可能反映了引擎尚未发现的等价关系。
一个用例是自动形式化。自动形式化将自然语言翻译成形式化语言。假设你想将需求转换为 SMT-LIB——这是可满足性模理论(SMT)求解器(如 Z3 和 cvc5)的标准输入语言——或者转换为 Cedar 或 Dogwood,以控制软件系统中的授权。大型语言模型(LLM)根据散文生成形式化产物。模型编写产物。它不参与差异计算。运行模型两次,它可能产生两个不同的形式化结果,而没有基准真值来识别正确的那一个。语义差异展示了它们一致的地方和不同的地方。通过改变模型、提示或采样温度来生成更多候选。比较它们可以显示哪些部分保持不变,哪些部分发生变化。首先审查变化的部分。
需求也可以变成 OpenShell 沙箱策略或通用表达式语言(CEL)表达式。OpenShell 使用 YAML 来描述代理的文件系统和网络访问。CEL 嵌入在应用程序中,用于评估表达式,包括策略条件。这些语言和格式在表达内容上有所不同,但翻译成其中任何一种都可能在一个条件、一个范围或一个事件上产生分歧。下表给出了说明性的分歧:
| 语言或格式 | 策略重点 | 分歧示例 |
| Cedar | 谁可以在什么条件下对资源执行操作。 | 一个翻译要求所有权和批准。另一个接受任一条件。 |
| Dogwood | 涉及当前请求和最近事件历史的授权。 | 一个翻译检查成功的先前响应。另一个检查请求事件。 |
| OpenShell 策略 | 代理的文件系统和网络访问,包括针对特定二进制文件的规则。 | 一个翻译允许仓库范围的 GET。另一个允许组织范围的 POST。 |
| CEL | 在宿主应用程序提供的输入上评估的条件。 | 一个翻译需要为两个允许的端口都生成产物,另一个只需要为一个端口生成。 |
在每个示例中,我们比较同一策略上下文内对同一需求的不同翻译。我们将相关语法编码为项,并声明比较中使用的等式。引擎读取这些编码。它不会从四种格式中导入原生策略。
这个想法是形式化方法对语义熵的类比,由 Farquhar 等人在 Nature(2024)中描述。该方法采样若干自然语言答案,将相互蕴含的答案聚类,并报告一个单一数值。对于形式化输出,反合一保留了更多信息。它识别共享结构和每一处分歧,而不是只返回一个分数。
反例有助于解释分歧的后果。 SMT 求解器可以找到一个满足一个公式而违反另一个公式的具体赋值。审阅者随后可以沿着公式追踪该赋值,以理解相互冲突的决策。反合一器给出不同的视角:它组织共享结构和存在差异的片段,而不发出 SMT 查询。求解器或策略验证器可以帮助解决这些片段。我们假设你能阅读 S 表达式语法(如 SMT-LIB 中那样),并且知道什么是授权策略。E-graph 和反合一会在出现时进行解释。
当多个翻译在某部分需求上一致时,差异视图只显示该部分一次。当它们不一致时,它会保留备选方案以供审阅。
语义差异如何表示分歧
假设一个策略生成流水线为这条需求交给你两条候选规则:发送到外部目的地的敏感数据必须加密。
| 规则 A | 规则 B |
| sensitive(data) ∧ external(dst) → encrypted |
¬internal(dst) ∧ sensitive(data) → audited |
这两条规则是否相同并不明显。条件被重新排序,external 被间接表达为 not internal,而且结论不匹配。引擎为这些项计算最具体的反合一器。在其输入语言中,这两条规则是 S 表达式。
完整程序首先声明词汇表:
(sort Formula)
(sort Data)
(sort Dest)
(function Lit (bool) Formula)
(function And (Formula) Formula :assoc-comm-idem :identity (Lit true))
(function Implies (Formula Formula) Formula)
(function Not (Formula) Formula)然后为每个谓词(sensitive、external、internal)和常量(data、dst、encrypted、audited)各添加一行 function。这里,And 被声明为结合、交换和幂等的,正如下一节所解释的:
(let ruleA (Implies (And (sensitive (data)) (external (dst)))
                    (encrypted)))
(let ruleB (Implies (And (Not (internal (dst))) (sensitive (data)))
                    (audited)))

(antiunify ruleA ruleB :algorithm exact)
引擎用一个项来回答:
(anti-unify :size 11 :cr 0.5000 :completion exact
  (Implies
    (And (sensitive data) (Variants (external dst) (Not (internal dst))))
    (Variants encrypted audited)))
重排序没有出现在结果中,因为 And 被声明为结合、交换和幂等的。两个 Variants 节点保留下来,每个标记输入不一致的一处,而其中只有一个是含义上的差异。(external dst) 和 (Not (internal dst)) 之间的差异是词汇上的差异。两者表达相同的领域事实。引擎无法仅从语法推断出这一点。将领域事实表述为一个 rewrite,运行至饱和(直到没有规则添加新的等式),然后再次进行差异比较:
(rewrite (external d) (Not (internal d)))
(run 2)
(antiunify ruleA ruleB :algorithm exact)
饱和之后,引擎回答:
(anti-unify :size 8 :cr 0.1429 :completion exact
  (Implies (And (sensitive data) (external dst)) (Variants encrypted audited)))
还剩一个 Variants 节点:规则 B 审计的是需求要求加密的地方。教科书式的呈现会在那个位置放一个新变量。而引擎则写入 (Variants encrypted audited):一个同时持有两种解读的节点。选择每个 Variants 节点的第一个子节点,你就能重建规则 A,直到声明的代数和重写为止。选择第二个子节点,你就得到规则 B。反合一器是两个项的无损合并:共享结构只出现一次,每一处真正的分歧都是一个局部的、可审查的节点。
三个字段描述结果::size、:cr 和 :completion。:size 字段统计具体节点的数量(Variants 标记本身不计入,但它的两个子节点都计入,因此结构无法隐藏在一个标记内部)。
:cr 字段报告压缩比 (s - a) / b,其中 s 是结果大小,a 和 b 是较小和较大的输入大小。对于每个输入,我们使用其在当前 e-graph 中已知的最小等价形式。得分为 0 表示在声明的等式下完全一致。
在前面的重写之后,两个输入都有七个节点,结果有八个节点,得到 (8 - 7) / 7,约为 0.1429。将两个完整策略保留在单个 Variants 节点中会使用十四个节点,得到 (14 - 7) / 7 = 1。这是无共享的参考值。
得分为 1 是参考值,不是上界。搜索可能使用比已知最小输入更大的等价形式。因此,大于它们合并大小的结果得分会高于 1。例如,如果两个最小输入形式都有十个节点,而结果有二十三个节点,则比率为 (23 - 10) / 10 = 1.3。
:completion 字段在搜索空间耗尽时报告 exact,在默认的随时搜索(一种蒙特卡洛搜索,在实现部分描述)在耗尽搜索空间之前达到其模拟次数上限时报告 budget。
较低的 :cr 意味着输入在声明的等式下共享更多结构。它并不确立正确性:两个候选可能共享同一个错误。熵分数用一个数字概括变化。完整的语义差异还会识别候选在何处不一致,并将两种备选方案保留在 Variants 节点中。
语义差异只忽略声明的等式所覆盖的差异。一个普通的语法反合一器也会报告此示例中的重排序。接下来的三节展示如何声明代数并添加领域恒等式。
反合一器只存储一次共享结构,并用 Variants 节点标记每一处分歧。选择每个节点的一侧即可重建相应的输入,模除声明的等式。
5 分钟内运行语义差异
引擎仅需要一个固定版本的 Rust 工具链即可从源码构建。其形式化验证注解(在实现部分介绍)在普通 rustc 下会被编译掉。以下命令固定了工作示例所使用的修订版本:
git clone https://github.com/yaspar-org/semi-persistent.git
cd semi-persistent
git fetch origin 5a7969ae4ea88117a64faac4f42af5c358e213e2
git checkout --detach FETCH_HEAD
cargo build --release
./target/release/semi-persistent doc/book/examples/12-first-au.egg
它打印单个 (anti-unify ...) 项。
命令行解释器读取一个 S 表达式文件(按惯例为 .egg)。你声明排序和运算符,用 let 定义两个项,可选地添加重写规则并运行至饱和,然后发出 antiunify。有两种机制告诉引擎哪些语法变化不影响含义:为运算符分配结合性、交换性和幂等性等代数属性的注解,以及针对其他所有内容的显式重写规则。以下是工作示例中所用签名的代数部分:
(function Lit (bool) Formula)
(function And (Formula) Formula :assoc-comm-idem :identity (Lit true))
(function Or  (Formula) Formula :assoc-comm-idem :identity (Lit false))
(function Eq  (Account Account) Formula :comm)
And 和 Or 是可变参数、可结合、可交换且幂等的,并且各自都有一个布尔中性元素。Eq 是可交换的。因此,对合取项的任何重排序、重新分组和重复都算作同一个项。除此之外不作任何假设:只有所述定律成立,任何进一步的恒等式都必须写成显式重写。:identity 元素的作用是让 diff 能够对齐一个输入有而另一个输入缺失的合取项:缺失的合取项与 (Lit true) 配对,而不是导致整个 And 表达式无法对齐。两个案例研究都依赖这种恒等对齐。
:assoc-comm-idem 使重排序、重新分组和重复的操作数等价。:identity 让 diff 将缺失的操作数与运算符的中性元素对齐。
包含两个策略缺陷的完整示例
运行示例随仓库以 egraph/examples/au_policy_divergence.egg 的形式提供。考虑一个策略句子:
仅当源存储桶启用了版本控制且目标存储桶位于已批准的区域时,才允许跨区域复制请求。如果对象被标记为机密,则目标账户和源账户必须相同,并且必须启用使用客户托管密钥的服务器端加密。不超过分段阈值的对象直接复制。较大的对象需要分段复制。
两个人,或同一模型的两次独立运行,对其进行了形式化(文件中的 formulaA 和 formulaB):
Encoding A
|
Encoding B
|
文本上有五处不同。三处是表示层面的:合取项被重排序,Eq 的参数被交换,approvedRegion 被显式展开为两个 AWS 区域(us-east-1 和 eu-west-1)。两处涉及不同的运算符:机密条款中的一个 And 变成了 Or,而在大小阈值处 Lte 变成了 Lt。两种编码的统一 diff 将其 28 行中的 18 行标记为已更改(图 1,文本 diff 窗格),并且没有指出这五处差异中哪些改变了含义。两种编码的精确反统一子如下:
(anti-unify :size 42 :cr 0.5862 :completion exact
  (Implies
    permit
    (And
      (Implies
        (taggedConfidential obj)
        (And
          (Or (Eq (accountOf dst) (accountOf src)) (Variants (Lit false) sseCmk))
          (Variants sseCmk (Lit true))))
      (Ite
        (Variants
          (Lte (sizeOf obj) multipartThreshold)
          (Lt (sizeOf obj) multipartThreshold))
        directCopy
        multipartCopy)
      (versioningOn src)
      (Variants
        (approvedRegion (regionOf dst))
        (Or (usEast1 (regionOf dst))
            (euWest1 (regionOf dst)))))))
五处差异中有两处消失了。 合取项重排序被吸收,因为 And 被声明为可结合、可交换且幂等(ACI)。交换后的 Eq 参数在两种读法中具有相同的打印顺序,因为 :comm 对它们进行了规范化。两者都不改变含义,因此都不被报告。
机密条款在要求为且的地方使用了 Or。 编码 A 要求同时满足同账户检查和使用客户托管密钥的服务器端加密。编码 B 接受任一。引擎通过它们的中性元素将 A 的合取与 B 的析取对齐,因此分歧表现为两个相邻的 Variants 节点。在每个节点选择第一个子节点以重建 A:Or 坍缩为普通相等,而 sseCmk 仍为强制合取项。在每个节点选择第二个子节点以重建 B:强制的 sseCmk 弱化为 (Lit true),并且仅作为 Or 内的一个备选而保留。两个 Variants 节点共同表明,编码 B 仅接受服务器端加密,因此允许机密对象的跨账户复制。
你可能原本以为 sseCmk 会被共享而不是重复。然而,一阶反合一器无法泛化连接词本身,因此 And 与 Or 的对比迫使它拆分成两个对齐。恒等对齐仍然只共享一次五节点等式。精确求解器的穷举搜索找不到更小的形式,而打印出的结果比把两个子句完整地放在单个 Variants 中要小一个节点。
添加域 rewrite 并再次运行 diff。 Region 的 Variants 节点不是 bug。它反映了缺失的领域知识:在此部署中,已批准的 Region 正是 那两个。将其声明为 rewrite,饱和,然后再次 diff:
(rewrite (approvedRegion r) (Or (usEast1 r) (euWest1 r)))
(run 3)
(antiunify formulaA formulaB :algorithm exact)
Region 差异移入共享主干,:cr 从 0.5862 降至 0.4000。完整结果是图 1 的语义差异窗格。恰好剩下两处分歧:被弱化的机密子句和阈值。B 的 Lt 是严格的,因此恰好位于 multipartThreshold 的对象会直接复制到 A 下,并在 B 下走多部分路径。分歧仅限于 Ite 条件。两个分支都位于共享主干中。两个存留的差异都是真正的 bug,授权审查者必须解决。代数和一次域重写解释了其他差异。同一文件还运行了 anytime 搜索 (antiunify formulaA formulaB :algorithm uct :playouts 3000),它返回相同的 size-35 项。整个程序在 Apple M3 Pro 笔记本电脑上远低于 100 ms 完成(二进制预热后为 50–60 ms)。这涵盖了解析、声明、饱和、五个反合一查询及其回归检查,以及进程启动。我们使用 Rust 1.97.1 的 release 构建和 shell 的 time 命令,在五次预热运行中测量了 ./target/release/semi-persistent egraph/examples/au_policy_divergence.egg 的墙钟时间。Get started 部分显示了相同的命令。
textual diff: 18 of 28 lines flagged
|
semantic diff: two disagreements, localized
|
图 1:同一对编码在 diff 和反合一下的结果。左侧,文本 diff 标记了 28 行中的 18 行(删除、添加)。右侧,一次域重写将共享结构移入灰色主干,高亮的 Variants 将剩余差异限制在被弱化的机密子句和严格阈值上。语义差异窗格将一行长行换行以适应
在应用声明的代数和一次域重写后,五个文本差异减少为两个语义分歧:被弱化的机密子句和严格的大小阈值。
Cedar 和 Dogwood 策略的语义差异比较
在授权策略中,被丢弃的守卫会扩大允许范围,并可能导致策略 开放 失败。Cedar 是 Amazon Verified Permissions 背后的开源授权策略语言。Dogwood 通过时间条件扩展 Cedar 授权策略,用于 AI 代理的运行时验证。其时间子语言使用记录的事件历史来守卫动作。引擎不评估 Dogwood 策略。它根据声明的代数对它们的抽象语法进行差异比较。验证(模式检查)和重放(根据记录的事件历史评估策略)仍然是 Dogwood 的工作。引擎的 用户指南 有一章工作示例,对一个需求的两个独立生成的 Dogwood 候选进行差异比较:
代理可以 POST 到 /deploy,但前提是健康检查在过去 15 分钟内已经返回 200。
候选 A 保留了两个请求守卫(方法和路径),但从请求事件中读取状态码,而该事件类型并不携带此字段。候选 B 使用了正确的响应事件,但丢弃了 /deploy 路径守卫。在任何匹配的健康检查之后,B 还允许从 POST 到 /admin/purge-all。两个候选在另外六处呈现方式上存在差异,这些差异均可被所声明的代数或三规则比较理论吸收:
| 呈现差异 | 由……吸收 |
| Cedar 条件顺序 | eAnd :assoc-comm-idem |
| 时序合取顺序 | tAnd :assoc-comm-idem |
| 谓词字段顺序 | args :assoc-comm-idem |
method == "POST" 与 "POST" == method |
eEq :comm |
15m 与 900s |
单位重写 + 常量折叠 |
count >= 1 与 1 <= count |
(birewrite (tLte a b) (tGte b a)) |
比较理论由三个可见重写组成,而非隐藏的归一化过程:
(rewrite (mins x) (secsTimes x 60))
(rewrite (secsTimes x y) (secs (IBig::* x y)))
(birewrite (tLte a b) (tGte b a))
(run 4)
两个候选的反合一子(仓库中的 doc/book/examples/20-dogwood-simple.egg)大小为 61,:cr 0.1864,并且在原本共享的策略主干中恰好有两处分歧:
(anti-unify :size 61 :cr 0.1864 :completion exact
  (rule
    permit
    (head anyPrincipal (actionEq aHttpRequest) anyResource)
    (eAnd
      (eEq (eCtx (fld fInput (fld fMethod fnil))) (eStr vPOST))
      (temporal
        ...
                  (pred
                    aHttpRequest
                    (Variants request response)
                    ...
      (Variants
        (eEq (eCtx (fld fInput (fld fPath fnil))) (eStr vDeploy))
eTrue))))对每处分歧使用可用的最简单检查。两个二元分歧给出四种候选补全。Dogwood 验证无需人工审查即可解决第一个分歧,它拒绝两个请求补全(“谓词……提及字段 output.status_code,而该字段未在该事件上声明”)。第二个分歧是身份对齐:候选 A 的路径守卫与 eTrue 配对,表明候选 B 省略了该守卫。需求解决了它(保留守卫),覆盖两个决策点的重放显示了后果:健康检查之后,候选 B 允许偏离目标的 POST,而修复后的策略则拒绝它。将 B 的事件类型与 A 的守卫结合,会产生两个候选都未编写的策略。在候选之间做选择会保留两个缺陷之一。
交换性有一个附带条件,而引擎并不检查它。Cedar 的 && 会短路,因此仅当两个操作数都不会引发错误时,交换它才是可靠的。因此,比较依赖验证来排除依赖顺序的错误,例如仅在 has 守卫之后才安全的属性访问。引擎不会重新检查该条件。
规范化打印器可以消除呈现差异,但无法恢复被丢弃的守卫。规范化打印器加上文本差异比较可以更廉价地吸收表中六处差异中的大部分,可以说全部。没有任何归一化器能在其他方面匹配的项内,将二合取条件与三合取条件对齐。按身份元素取模匹配,通过将丢弃的合取项与 eTrue 配对来对齐它们。在 permit 条件中,那个被丢弃的合取项暴露了使策略失效开放的放宽。
对于 Dogwood 候选,代数和三个重写消除了六处呈现差异。剩余的分歧暴露了一个模式错误和一个被丢弃的守卫。将正确的选择结合起来,会产生两个候选都未提供的策略。
比较策略翻译:OpenShell 与 CEL
接下来的两个示例改编自 OpenShell 和 CEL 文章中的谓词。对于每个示例,我们为同一需求构建候选翻译。这些是说明性编码,并非记录的 LLM 样本。
OpenShell:方法和路径范围。OpenShell 示例将网络权限建模为关于二进制、主机、端口、层、方法和路径的谓词。我们改编文章中简化的 SMT-LIB 模型,其路径条件是前缀测试。我们使用该词汇表来满足此需求:
允许 /usr/bin/gh 向 api.github.com 的 443 端口发起的、经检查的 REST 请求,条件为方法为 GET 且路径以 /repos/NVIDIA/OpenShell/issues/ 开头。拒绝所有其他请求。
候选 A 需要 GET 以及仓库的 issues 前缀。候选 B 使用 POST 和更宽泛的 /repos/NVIDIA/ 前缀。其他检查以不同的顺序出现。在编码中,gh、github 和 https 分别命名前面展示的二进制文件、主机和端口。名称 issuePrefix 和 orgPrefix 标识这两个前缀。精确求解器返回:
(anti-unify :size 21 :cr 0.1053 :completion exact
  (And
    (EqText binary gh)
    (EqText host github)
    (EqText layer rest)
    (EqText method (Variants GET POST))
    (EqNumber port https)
    (Prefix (Variants issuePrefix orgPrefix) path)))
二进制文件、主机、端口和层检查是共享的。它们的顺序消失了,因为 And 被声明为可结合、可交换且幂等。两个 Variants 节点标识出相互冲突的解读:允许的操作和路径范围。该需求在此处确定了这两个选择。对于有歧义的需求,同样的节点会为其所有者提供两个具体的备选方案以供解决。
CEL:共享条件的范围。 CEL 示例 暴露了一个在重构过程中丢失的生产环境检查。我们将这些表达式复用为该需求的候选翻译:
仅当请求处于生产环境且其端口为 80 或 443 时才允许该请求。
// Candidate A
(is_prod && port == 80) || (is_prod && port == 443)

// Candidate B
is_prod && port == 80 || port == 443
CEL 的 && 比 || 结合得更紧,因此候选 B 仅对端口 80 应用生产环境检查。我们使用提供的布尔值和整数输入对表达式进行编码,用 isProd、port80 和 port443 表示相应的输入和字面量:
(anti-unify :size 13 :cr 0.3636 :completion exact
  (Or
    (And (Eq port port443) (Variants isProd (Lit true)))
    (And isProd (Eq port port80))))
端口 80 分支是共享的。在端口 443 分支中,(Variants isProd (Lit true)) 显示了缺失的生产环境条件。在 is_prod = false 和 port = 443 处,A 拒绝该请求,B 允许该请求。差异将审查引导到句子的一部分:即“处于生产环境”是否适用于两个备选方案。
此示例假设 is_prod 以布尔值提供,port 以整数提供。在这些假设下,两个表达式都不会引发错误。该编码不建模 CEL 错误或未知值,引擎也不检查这些输入假设。
CEL-Java 的验证框架可以使用 Z3 检查等价性和策略不变量。此类检查可以在解决分歧时提供证据。反合一器本身并不决定哪种翻译符合需求,而两个候选共有的错误仍将保持共有。
实现与性能
该算法运行在 e-graph 上,这是一种将项与其已知相等的所有内容一起存储的数据结构。E-graph(等价图)源自定理证明器中的同余闭包过程,并由 Willsey 等人在 “egg: Fast and Extensible Equality Saturation”(POPL 2021)中描述的等式饱和方法推广用于编译器优化。该引擎的 e-graph 为可结合和可交换运算符增加了原生规范化。
e-graph 上的反合一也用于 babble(Cao 等人,POPL 2023)中的抽象学习和程序压缩。早期的实现无法扩展到小示例之外。我们基于饱和的原型也在那里停滞了。原生 AC 规范化、对不同的子节点进行 AC 感知匹配以及直接搜索使亚秒级查询变得实用。半持久化降低了重复查询的成本。
原生 AC 规范化。结合律、交换律和幂等律在此引擎中不是重写规则,而是数据结构的属性。结合-交换(AC)算子在插入时将其子节点存储为规范排序多重集(ACI 算子存储为规范排序集合)。因此,一个 e-node 即可表示一个项的所有重结合与排列,对于幂等算子,重复的子节点被视为一个。在声明的定律下取模相等就是结构相等。基于重写的替代方案会在真正工作开始前,用指数级数量的等价副本淹没 e-graph。
基于不同子节点的 AC 感知匹配。针对多重集节点的模式匹配采用最大划分语义:它在节点的不同子节点上分支,而不是枚举多重性拆分,因此高度重复的参数不会导致组合爆炸。
直接搜索而非重写。反合一本身也不被编码为重写规则。一个精确的动态规划求解器(:algorithm exact)最优地求解联合分解问题。此处的最优是相对于其大小优先目标、当前 e-graph 以及配置的循环策略而言。一个随时蒙特卡洛图搜索(:algorithm uct,默认)对任意 playout 预算返回其最佳答案。在工作示例的配对上,3,000 次 playout 复现了精确最优解。两者都首先优化结果大小,然后在同等大小的答案中,优先选择在共享主干中保留更多结构的答案。
半持久化。e-graph 支持以稀疏差异而非深拷贝记录的 (push) 和 (pop) 快照。因此,恢复状态的代价与变更量成正比,因为快照加上修复派生索引的代价。比例代价恢复让引擎可以在一个共享图上比较许多候选。回溯搜索可以恢复较早的状态而无需复制整个图。
经过验证的核心及其范围。e-graph 的底层容器层在 Verus(一个 Rust 验证器)中经过验证。验证的性质是恢复操作能复现匹配 (push) 处的状态(1,703 个已验证条件,0 个错误)。反合一 crate 证明了其目标顺序和下界引理,但完整求解器尚未具备端到端的精化证明。引擎可以为它推导出的每个等价关系记录理由(--proofs)。正如仓库所指出的,这些记录尚不是可独立重放检查的证书。所有这些声明,连同证据层级和撤回,都在仓库的声明清单(doc/claims.md)中。
原生规范化避免了物化等价的 AC 项。不同子节点匹配控制多重性,直接求解器避免将反合一编码为重写,半持久化降低了重复查询的代价。
在流水线中使用语义差异
同样的方法可以从两个候选扩展到更大的样本。生成需求的 N 个候选形式化。将它们加载到一个共享的 e-graph 中,在领域规则下饱和,并使用两两相等性检查对它们进行聚类。在用户指南中规模更大的 Dogwood 研究里,五个样本归并为三个簇。仅在呈现方式上不同的候选在构建过程中会归入相同的等价类。对簇代表进行两两反合一。然后,在构建于引擎输出之上的一个层中,按共享主干中的位置对重复出现的 Variants 节点进行分组。在该研究中,三个两两差异恰好归并为两个审查项。对每个项使用可用的最简单检查:模式验证、重放、示例 I/O 对或人工审查。
借助 (push) 和 (pop) 快照,你无需重建图即可测试一个提议的解决方案。临时将 Variants 节点的一个分支断言为领域事实,再次运行差异,然后回滚。构建于引擎之上的工具可以针对硬约束和软约束选择并修复一个完整的候选,例如在变体空间上使用 MaxSMT 求解器。MaxSMT(最大可满足性模理论)寻求一个满足所有硬约束、同时尽可能满足更多软约束或最大化其总权重的解。Programming Z3 的第 8 节描述了这种形式的优化。该能力不属于当前引擎的一部分。图 2 总结了该流水线。
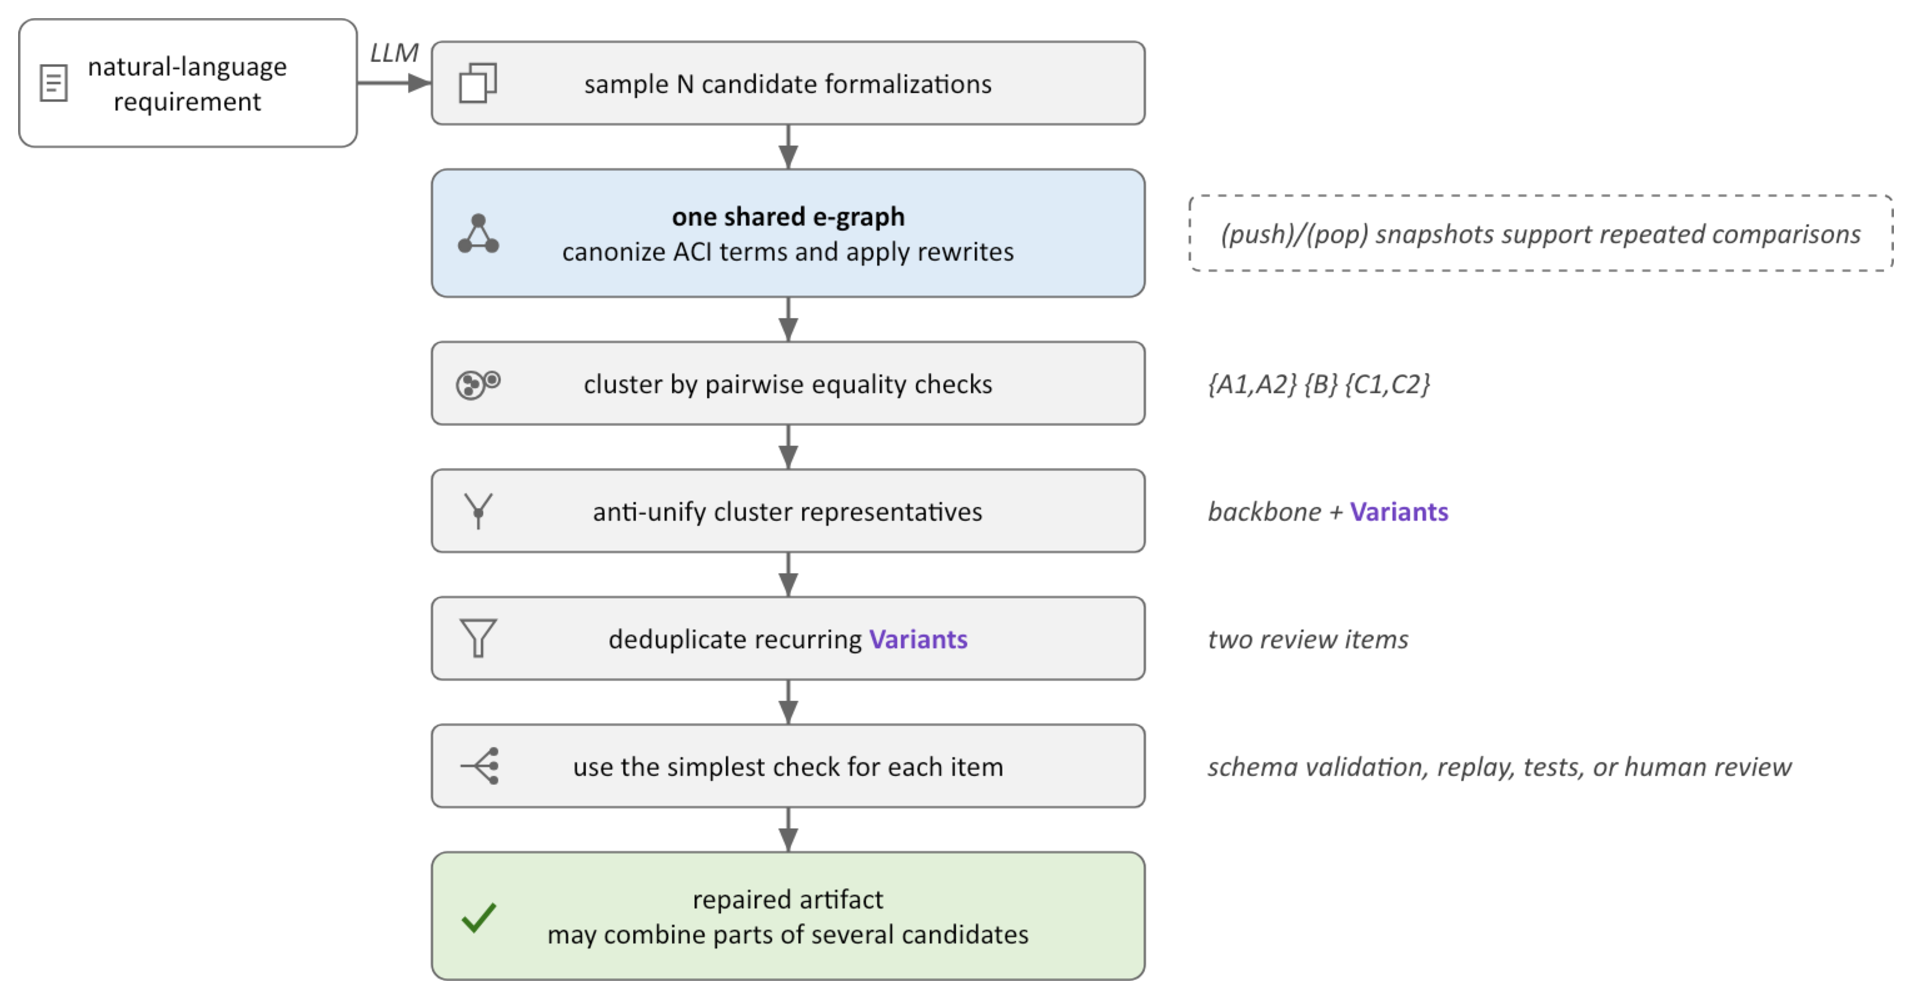
图 2:用于对候选形式化进行聚类、定位重复出现的不一致,并将每个不一致路由到适当检查的流水线。簇大小和审查项计数来自用户指南中规模更大的 Dogwood 研究
在持续集成(CI)中使用语义差异预算。命令 (checkau A B :max_size N :algorithm exact) 在成功时不输出任何内容,并在反合一器超出预算时导致程序失败。用户指南中每个打印结果都以这种方式固定,因此指南和引擎不会出现偏差。同一命令可用作回归门禁。为参考形式化和重新生成的形式化设置最大结果大小,并在反合一器超出该大小时使流水线失败。该二进制文件遵循标准 shell 约定:结果输出到 stdout,诊断信息(ok --- N nodes)输出到 stderr,如果任何检查失败,进程以非零状态退出。
该差异还可以引导后续提示或向需求负责人提出的问题。样本间的平均两两 :cr 为每个需求给出一个不一致分数。Variants 节点已经包含特定澄清所需的备选方案,例如“你是指严格小于阈值,还是小于等于?”
在有多个候选时,对等价输出进行聚类,比较簇代表,并通过验证、重放、示例或人工审查来解决重复出现的不一致。
开始使用
在本文所用的修订版本上构建引擎,然后运行策略示例。这些命令选择包含 pull request 103 中 OpenShell 和 CEL 示例的修订版本:
git clone https://github.com/yaspar-org/semi-persistent.git
cd semi-persistent
git fetch origin 5a7969ae4ea88117a64faac4f42af5c358e213e2
git checkout --detach FETCH_HEAD
cargo build --release        # toolchain auto-pinned; Verus not required

# The worked example from this post:
./target/release/semi-persistent egraph/examples/au_policy_divergence.egg

# The Dogwood policy-diff example:
./target/release/semi-persistent doc/book/examples/20-dogwood-simple.egg

# The constructed OpenShell and CEL translation examples:
./target/release/semi-persistent egraph/examples/au_openshell_policy.egg
./target/release/semi-persistent egraph/examples/au_cel_policy.egg

# Your own formulas: declare a signature, two terms, and antiunify:
./target/release/semi-persistent MY_PROGRAM.egg
该引擎在 GitHub 上以 Apache-2.0 许可发布。用户指南从基本术语逐步讲到策略案例研究,测试套件直接从仓库运行其中的每一个程序。附录 B 记录了 antiunify 和 checkau 命令。如果你的工件语言具有抽象语法树(AST)和等式理论,你就可以对它做差分:声明代数,将域恒等式表述为重写规则,并求取最具体的反合一子。如果你的策略是 Cedar,无论是手写还是为 Amazon Verified Permissions 生成的,同样的方法都适用。OpenShell 和 CEL 示例展示了如何编码其他策略构造,并比较对某项需求的候选解读。
关于作者

Ferhat Erata
Ferhat 是 AWS AI Labs 的应用科学家。他将大语言模型与形式推理相结合,以提升生成式 AI 和智能体 AI 的安全性与保障性。他的工作包括自动形式化、经过验证的代码生成,以及利用验证器反馈训练推理模型。他的攻防安全研究包括从功耗轨迹逆向工程量子电路,以及检测后量子密码代码中的侧信道漏洞。在攻读博士之前,他在业界有十余年经验,联合创立了 UNIT Research & Development,主导开发了将文本文档与形式模型连接起来的平台 ModelWriter,并为 EUREKA/ITEA 工业研究项目协调国家联盟。Ferhat 拥有耶鲁大学计算机科学博士学位。他的网站是 ferhat.ai。

Rémi Delmas
Rémi 是 AWS 自动推理组的首席应用科学家,常驻波士顿。他的工作包括 CBMC 和 Kani 等形式验证工具,以及神经符号自动形式化和推理系统。加入 AWS 之前,他在巴黎的 Uber 先进技术中心从事城市空中交通研究。再之前,他在法国航空航天研究实验室 ONERA 工作了十年,开发并应用形式化方法,用于关键嵌入式系统的设计与验证。职业生涯早期,他在 Prover Technology 工作,为铁路控制系统构建验证工具。他拥有图卢兹 ISAE-SUPAERO 的计算机科学博士学位。他的研究兴趣包括自动推理、神经符号推理系统、软件安全与优化。
来源:AWS Machine Learning Blog · aws.amazon.com