Amazon Bedrock tokenomics 数据湖:集中观测每次模型调用
Amazon Bedrock tokenomics data lake
AWS 发布 Amazon Bedrock 调用日志数据湖方案,通过 CloudWatch 订阅过滤器将多账户调用日志汇聚到中心账户,经 Lambda 清洗、Data Firehose 转 Parquet 写入 S3,最终用 Athena 以单表 SQL 查询。
如果你需要为 Amazon Bedrock 工作负载构建可观测性数据湖,你并不孤单。当你每天跨多个账户运行数千次模型调用时,在请求发出之后,你可能会想:到底发生了什么?你能看到汇总账单,却看不到每次调用内部发生了什么。
你可能会开始追问:发送了什么提示词、模型返回了什么、用了多少 token、由哪个模型处理,以及响应质量如何!如果你是一名平台或机器学习(ML)工程师,负责跨团队管理一批 Amazon Bedrock 工作负载,这就是一个实实在在的问题。你无法调试突增,无法发现浪费性的提示词,也无法区分一个团队与另一个团队的使用情况。
我们构建了一个解决方案来提供帮助:一个针对 Amazon Bedrock 调用的集中式可观测性数据湖。在本文中,我介绍你拥有哪些原生数据,以及我们如何设计这个数据湖。我还会展示如何使用它来查看你的提示词,并推导出每次调用的成本。AWS CloudFormation 模板、AWS Lambda 代码和 SQL 查询都在 AWS Sample Bedrock Invocation Data Lake GitHub 仓库中。本文会逐步讲解架构和部署步骤。仓库中包含部署它所需的一切。
你目前拥有哪些 Amazon Bedrock 可见性?
Amazon Bedrock 提供模型调用日志记录,而且它确实很强大。你在使用 Bedrock 的每个 AWS 账户的设置中开启调用日志。它会将请求和响应的完整记录投递到 Amazon Simple Storage Service(Amazon S3)或 Amazon CloudWatch。
数据是存在的,但它被锁在各个账户内部。你真正想要的是一个单一、快速、可查询的视图,覆盖整个组织中的每一次调用。这正是数据湖为你提供的。
什么是 Amazon Bedrock 可观测性数据湖?
集中式 Amazon Bedrock 调用日志数据湖会将来自你关联账户的原始模型调用日志拉取到 Amazon CloudWatch。随后,订阅日志筛选器会将这些记录转发到你的中央账户。中央账户通过 Amazon Data Firehose 处理数据,并通过 Amazon Athena 将其作为一个干净的表暴露出来,你可以跨整个组织查询该表。
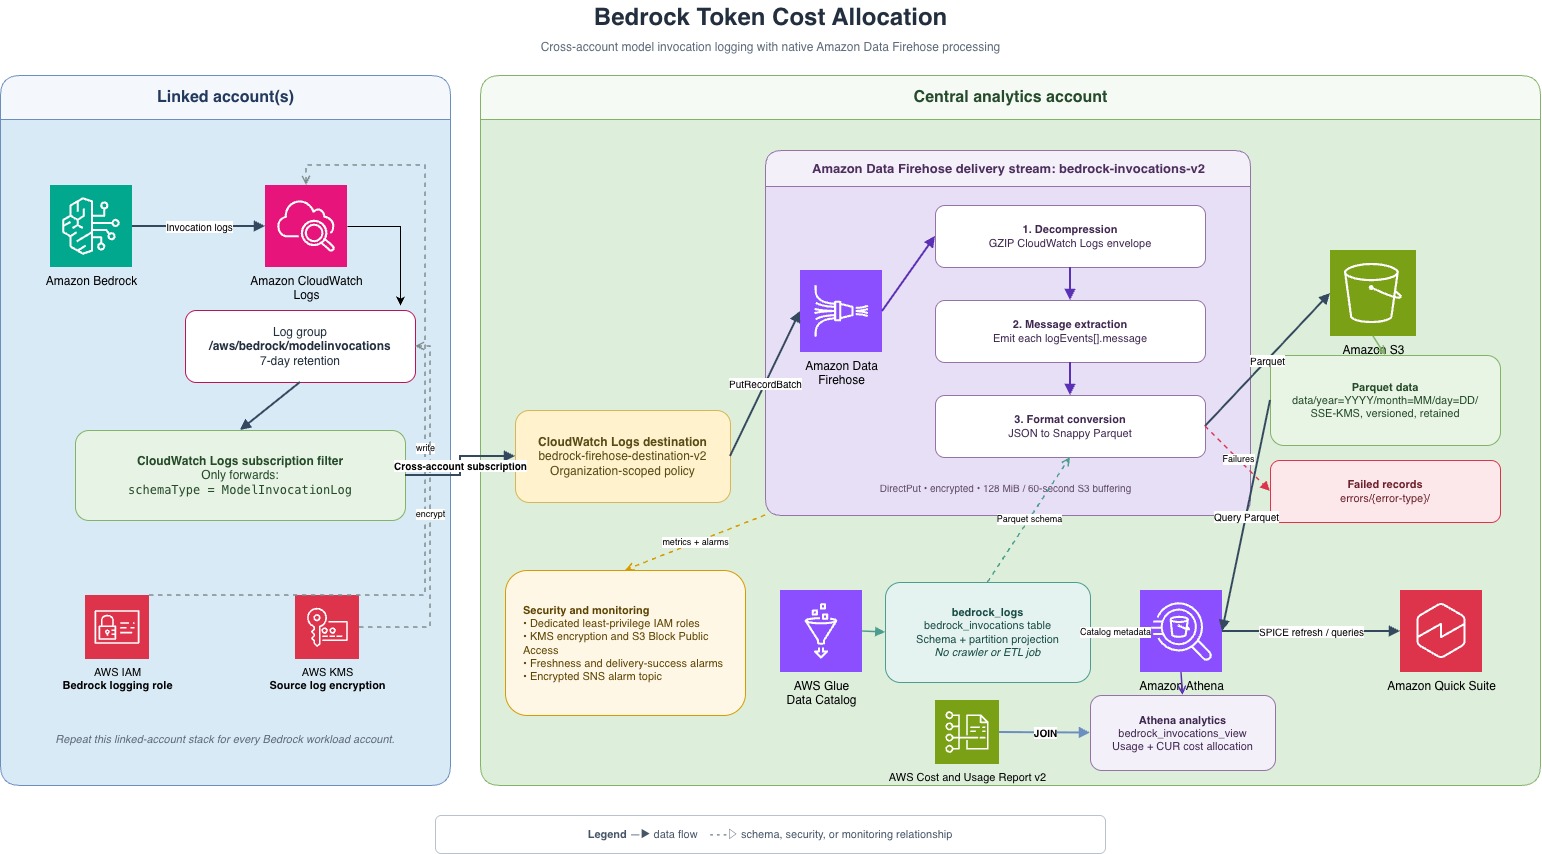
图 1:跨中央账户和关联账户的 Amazon Bedrock 调用可观测性数据湖架构
所有内容都使用两个 AWS CloudFormation 模板以基础设施即代码的方式部署,因此你可以可重复地在组织中的每个账户中推广它。这可以在 AWS Sample Bedrock Invocation Data Lake GitHub 仓库中找到。
每条 Amazon Bedrock 调用日志会捕获什么?
运行此解决方案后,你将拥有一组跨所部署关联账户的合并数据,可以使用 Athena 进行查询。当日志被展平到处理后的表中后,每次调用你会得到:
- 用户或应用程序发送的提示词。
- 返回的模型响应。
- 输入和输出 token 数量,因此你可以衡量每次调用的真实权重。
- 所使用的模型,因此你可以了解各团队对模型的使用情况。
- 停止原因(例如
max_tokens),它告诉你响应何时被截断。 - 账户和时间戳,这样你就可以归属并切分所有内容的时间。
- AWS Identity and Access Management (IAM) 角色,这样你就可以看到是谁发送了提示词。
在每次调用都这样被捕获之后,你就从“我们在 Amazon Bedrock 上使用了 X 个 token”变成了“这里是每次模型调用具体包含的内容,以及它的效率如何。”这正是平台和 ML 团队一直缺失的可见性。
Amazon Bedrock 数据湖是如何设计的?
数据湖让每次调用经过五个阶段,从 Amazon Bedrock 写入日志的那一刻,到你能在 Athena 中查询它为止。
1. Amazon Bedrock 写入调用日志
每当应用程序调用 Amazon Bedrock 模型时,Amazon Bedrock 都可以记录发生了什么:哪个模型、哪个账户、哪个 IAM 身份发起了调用、使用了多少输入和输出 token,以及提示词和响应文本。你只需在每个账户中通过一次 API 调用开启此功能,将 Amazon Bedrock 指向一个 CloudWatch 日志组,并给它一个可以写入该日志组的角色。
2. CloudWatch 将日志转发到中央账户
每个源账户都会在其 Amazon Bedrock 日志组上获得一个订阅筛选器。可以把它看作一条永久转发规则,意思是“将每个新事件发送到这个地址”。该地址是位于你中央账户中的 Amazon CloudWatch Logs 目标。源账户不会获得中央管道上的权限。它们将事件交给目标,然后由中央账户自己的角色接手处理。
3. 一个小型 Lambda 整理每条记录
CloudWatch 交出的并不是干净的 JSON。它将事件打包成批次,并对其进行压缩和编码包装,因此在你解包之前,收到的内容看起来就像乱码。一个小型 Lambda 函数完成三项工作:
- 将批次解包回单独的日志记录。
- 丢弃噪声。CloudWatch 会发送偶尔的日常维护消息和纯英文通知,例如“Permissions are correctly set for Amazon Bedrock logs.”。这些不是调用数据,让它们通过会破坏下一阶段。
- 展平一个棘手的字段。调用者的身份以嵌套一层的结构到达。Lambda 将其提升到顶层,以便之后查询起来更简单。
4. Amazon Data Firehose 转换为 Parquet 并写入 S3
Amazon Data Firehose 缓冲记录并将它们写入 Amazon S3 存储桶,在写入过程中从 JSON 转换为 Parquet。Firehose 还会将每个对象归档到日期路径下(year=2026/month=08/day=27/)。
5. 使用 Athena 查询数据并将其与成本数据关联
一个 AWS Glue 表告诉 Athena 如何读取这些文件,这样你就可以用普通 SQL 查询数据湖。你可以看到哪些用户使用了最多的 token、哪些模型最常被选择,以及人们在提示什么。如果你愿意,还可以将其与 AWS Cost and Usage Report (CUR) 关联,以获取按天统计的用户提示词支出。
开始之前你需要什么?
部署之前需要准备好几件事:
- 已配置好各账户凭证的 AWS Command Line Interface (AWS CLI)。
- CloudFormation
CAPABILITY_IAM和CAPABILITY_NAMED_IAM权限。 - 至少一个关联账户(运行你的 Amazon Bedrock 工作负载的账户)和一个中央账户来接收复制的日志(这些可以是同一个账户)。
- Python 3 与 Boto3(
pip install boto3),用于端到端测试脚本。 - 已克隆的仓库,其中包含所有资源。
如何部署它?
这里的顺序很重要。必须先存在中央账户堆栈,关联账户堆栈才能引用它。
阶段 1:部署中央数据湖堆栈
首先将中央 CloudFormation 堆栈部署到将拥有该管道的账户中。继续之前,请记下堆栈输出中的两个值:CloudWatch Logs 目标 ARN(每个源账户都需要)和 AWS Quick Sight 角色 ARN(如果之后部署仪表板则需要)。
阶段 2:在每个源账户中部署日志记录堆栈
部署关联账户 CloudFormation。对每个运行 Amazon Bedrock 工作负载的账户重复此操作。源堆栈很小,只需一个输入:阶段 1 中的目标 ARN。
阶段 3:开启 Amazon Bedrock 模型调用日志记录
部署堆栈并不会启动日志记录。Amazon Bedrock 日志记录是账户级设置,而不是 CloudFormation 资源。在每个源账户中激活一次,将 Amazon Bedrock 指向阶段 2 中的日志组和日志记录角色。仅开启 CloudWatch 交付。
阶段 4:验证数据是否到达
在源账户中运行一次测试调用,等待 Amazon Data Firehose 刷新其缓冲区(大约一分钟,有时更长),然后确认 Parquet 对象已出现在数据湖的 data/ 前缀下。最后,检查您的 S3 存储桶以查看数据。
阶段 5:创建 Athena 视图并查询数据
中央堆栈将视图定义保存为命名 Athena 查询,但不会运行它。执行该已保存的查询一次以创建扁平化视图。在专用 Athena 工作组中,针对原始表或扁平化视图运行查询。该视图很直接:token 计数、缓存 token、停止原因以及提示/响应预览已经是扁平列。
如何查看 Amazon Bedrock token 的成本?
当您想要针对这一切的美元数字时,将处理后的表与您的 CUR 2.0 数据连接。连接键是 IAM ARN。您可以在 Bedrock Data Lake SQL 文件中使用以下示例查询。
这一个连接将可观测性数据湖也转变为成本归因:哪些提示成本最高、按天按团队或账户的成本,以及您最低效的调用实际花费了多少。这是一个很好的补充,但数据湖在您达到这一步之前就已经物有所值了。
什么是 tokenomics,为什么这个数据湖对它很重要?
Tokenomics,即管理人工智能(AI)token 消费经济性的实践,在 2026 年 FinOps Foundation 大会上被宣布为正式的 FinOps 领域。它建立在与云财务管理相同的 See、Save、Run 和 Plan 支柱之上,但应用于 token 而非基础设施。挑战在于,您无法优化您无法衡量的东西。当今大多数组织缺乏回答基本 tokenomics 问题所需的细粒度数据:哪些团队消耗的 token 最多,哪些提示是浪费的。通过每次调用的 token 和成本可见性,团队可以将每个工作负载匹配到适合它的模型。这正是这个数据湖为您提供的。通过每次调用对提示、响应、token 计数、模型和 IAM 身份的可见性,您拥有了开始运行 tokenomics 实践的基础,而不仅仅是跟踪 Amazon Bedrock 账单。
创建 Amazon Bedrock 调用日志仪表板
如果你想可视化你的 token 消耗,我们有一个 AWS Quick Sight 仪表板。它会向你展示表中随时间变化的数据,以便你可以与组织中的利益相关者分享。使用 AWS Quick Sight,你可以自定义仪表板并添加组织元数据(例如团队信息),使其成为你自己的仪表板。要部署此内容,请使用 cid-cmd deploy CLI 命令。完整的分步部署说明位于 repository README 中,包括 AWS Quick Sight 角色配置和数据源设置。
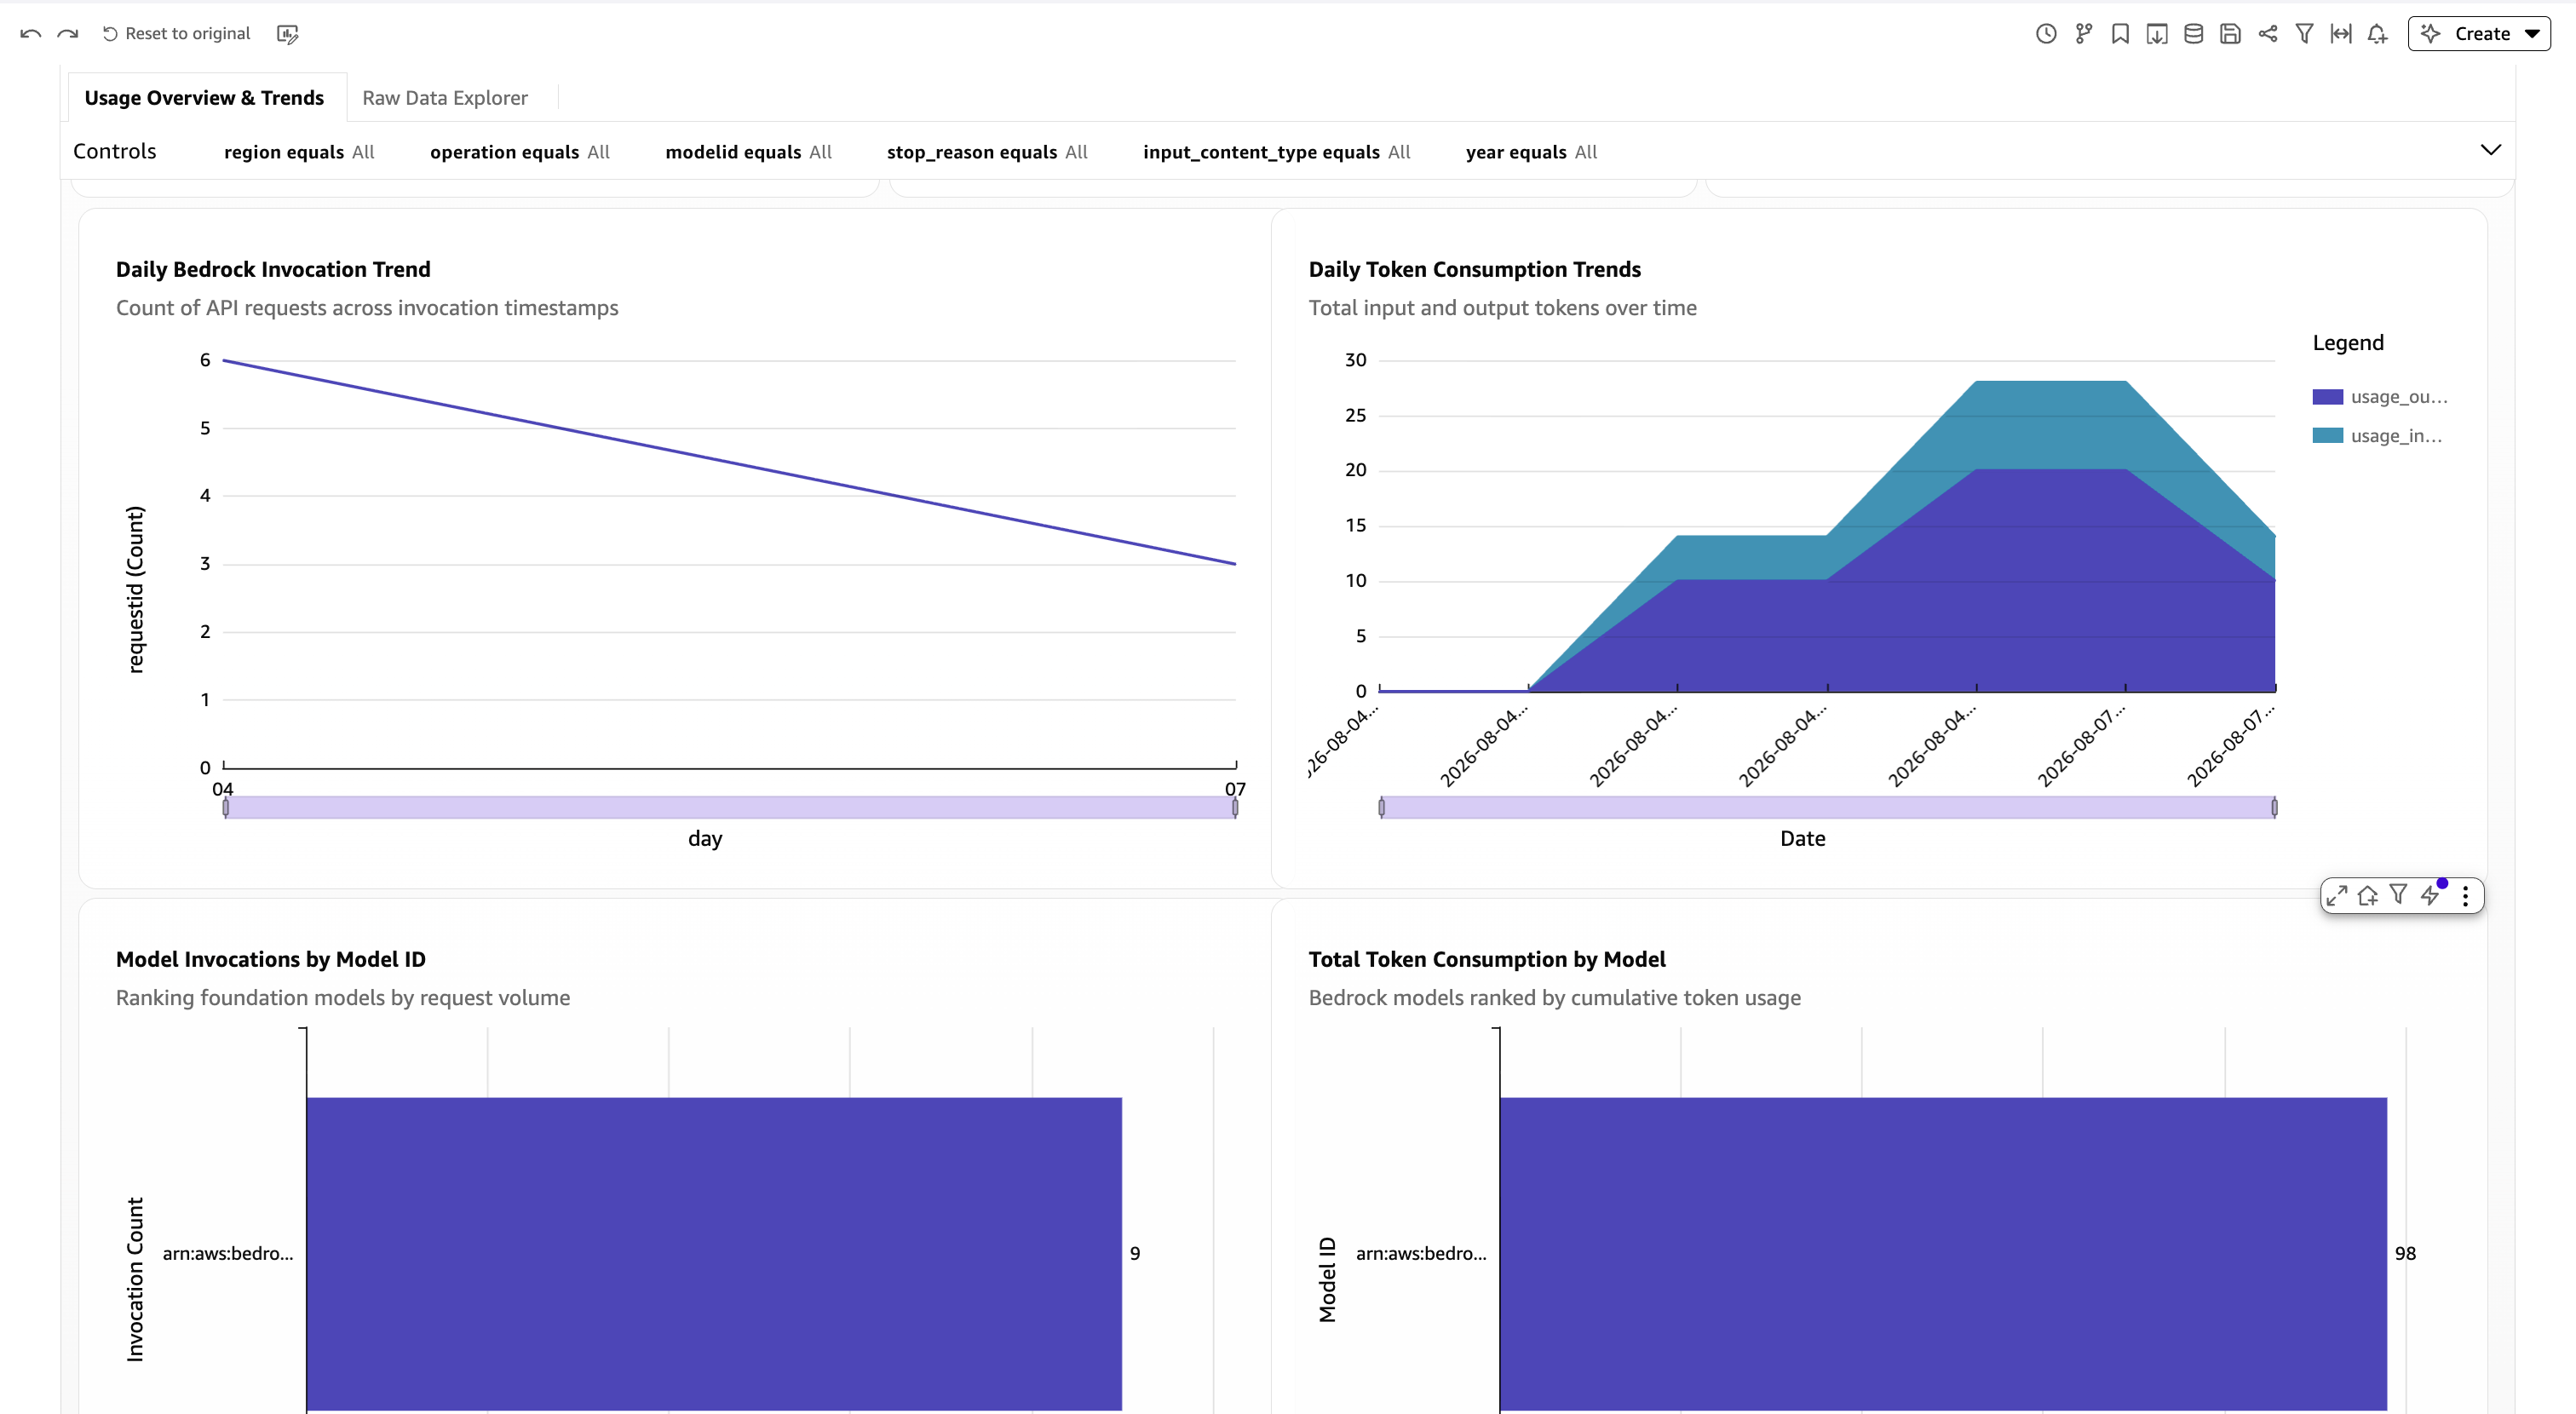
图 2:AWS Quick Sight Amazon Bedrock 仪表板
现在你可以用 Amazon Bedrock 调用日志做什么?
将每次调用都放在一个快速、可查询的表中,你终于可以回答那些过去令人头疼的问题:
- 调试和审计调用 – 在某个账户中,无需翻查原始日志文件,即可提取特定调用的确切提示和响应。
- 衡量 token 效率 – 跨团队比较
input_tokens与output_tokens以及模型选择,找出你在无谓消耗 token 的地方。 - 发现提示工程机会 – 查找响应被截断的请求(
stop_reason = max_tokens),这很好地表明提示或配置需要改进。 - 审查模型系列 – 数据会显示每种模式由哪个模型提供服务,以便团队确认每个模型都与其工作负载相匹配。
- 跨团队治理使用情况 – 每次调用都与一个账户关联,因此你可以知道谁在运行什么。
数据治理
由于此解决方案将来自每个团队的完整提示和补全内容集中到单个 Amazon S3 存储桶中,安全性和治理从一开始就内置于架构中。该存储桶受 AWS Key Management Service(AWS KMS)的服务器端加密保护,因此数据默认在静态时加密。对存储桶和 Amazon Athena 查询结果的访问通过 AWS Identity and Access Management(IAM)策略进行控制。你可以将权限限定为需要它们的团队和角色。根据用户与 Amazon Bedrock 的交互方式,提示可能包含个人身份信息(PII)。我们建议你审查 IAM 策略和 Amazon S3 存储桶策略,以确认只有经过授权的主体才能访问数据。
清理
如果你想删除所创建的资源,请清空存储桶中的对象,然后删除 CloudFormation 模板。请注意在删除前清空 S3 存储桶,并手动删除 Athena 工作组。
总结
你现在有了一种方法,可以将 Amazon Bedrock 的原始调用日志转化为一个快速、覆盖全组织的单一可观测性层。你不再面对一个封闭系统,而是可以清晰查看各账户中的每个提示、响应、token 计数和模型选择。当你需要时,你还可以直接了解每一项的成本。
与任何系统项目一样,不要试图一口吃成胖子。先从一两个关联账户开始,熟悉查询调用表,然后再扩展到整个组织。你的 Amazon Bedrock 使用量只会增长,因此你越早建立这种可见性,未来每次关于调试、效率和成本的对话就会越简单。
如果你有任何问题,或想分享你如何在自己的工作负载中构建可观测性,请访问 AWS Sample Bedrock Invocation Data Lake GitHub repository。
关于作者

Steph Gooch
Steph 是一位首席技术布道师。她是指导客户优化当前和未来 AWS 支出的主题专家。她帮助客户整理和解读账单与使用数据,从中识别可付诸行动的洞察,并制定可持续的策略,将成本意识融入企业文化。
来源:AWS Machine Learning Blog · aws.amazon.com