ELIZA 程序谱系研究:用系统发生学方法重建 27 个实现版本的家族树
The Genealogy of Eliza
ELIZAGen 项目把 1965–2025 年间 8 种语言的 27 个 ELIZA 实现当作生物标本,用 13 项二元特征描述其架构,并借助进化生物学软件 PAUP* 做简约法分析,重建程序谱系树。
ELIZA 的谱系
我们能否仅从代码本身构建出 ELIZA 程序的家族树?本页报告 ELIZAGen 代码系统发育项目的当前进展,该项目将 ELIZA 的各种实现视为生物标本,并对其应用系统发育学的工具。
六十多年来,ELIZA 被重新实现了数百次:被复制、跨语言移植、根据已发表的描述重建、为教学而简化,以及被重新构想为艺术。软件没有那种锚定生物或手稿谱系的物质连续性,因此我们比较的不是源文本,而是架构。每个程序由一组抽象特征来描述(它是否对关键词排序?它是否有回溯匹配器?它是否保留对先前输入的记忆?),由此得到的特征矩阵用 PAUP* 进行分析,这是来自进化生物学的标准简约法软件。
当前语料库包含 27 个标本,时间跨度为 1965–2025 年,涵盖八种语言,由 13 个二元特征描述。这项工作仍在进行中,并已写成一篇论文草稿,Reconstructing Program Genealogies from Abstract Program Descriptions: The ELIZA Case Study(Jeff Shrager,2025 年 12 月)。
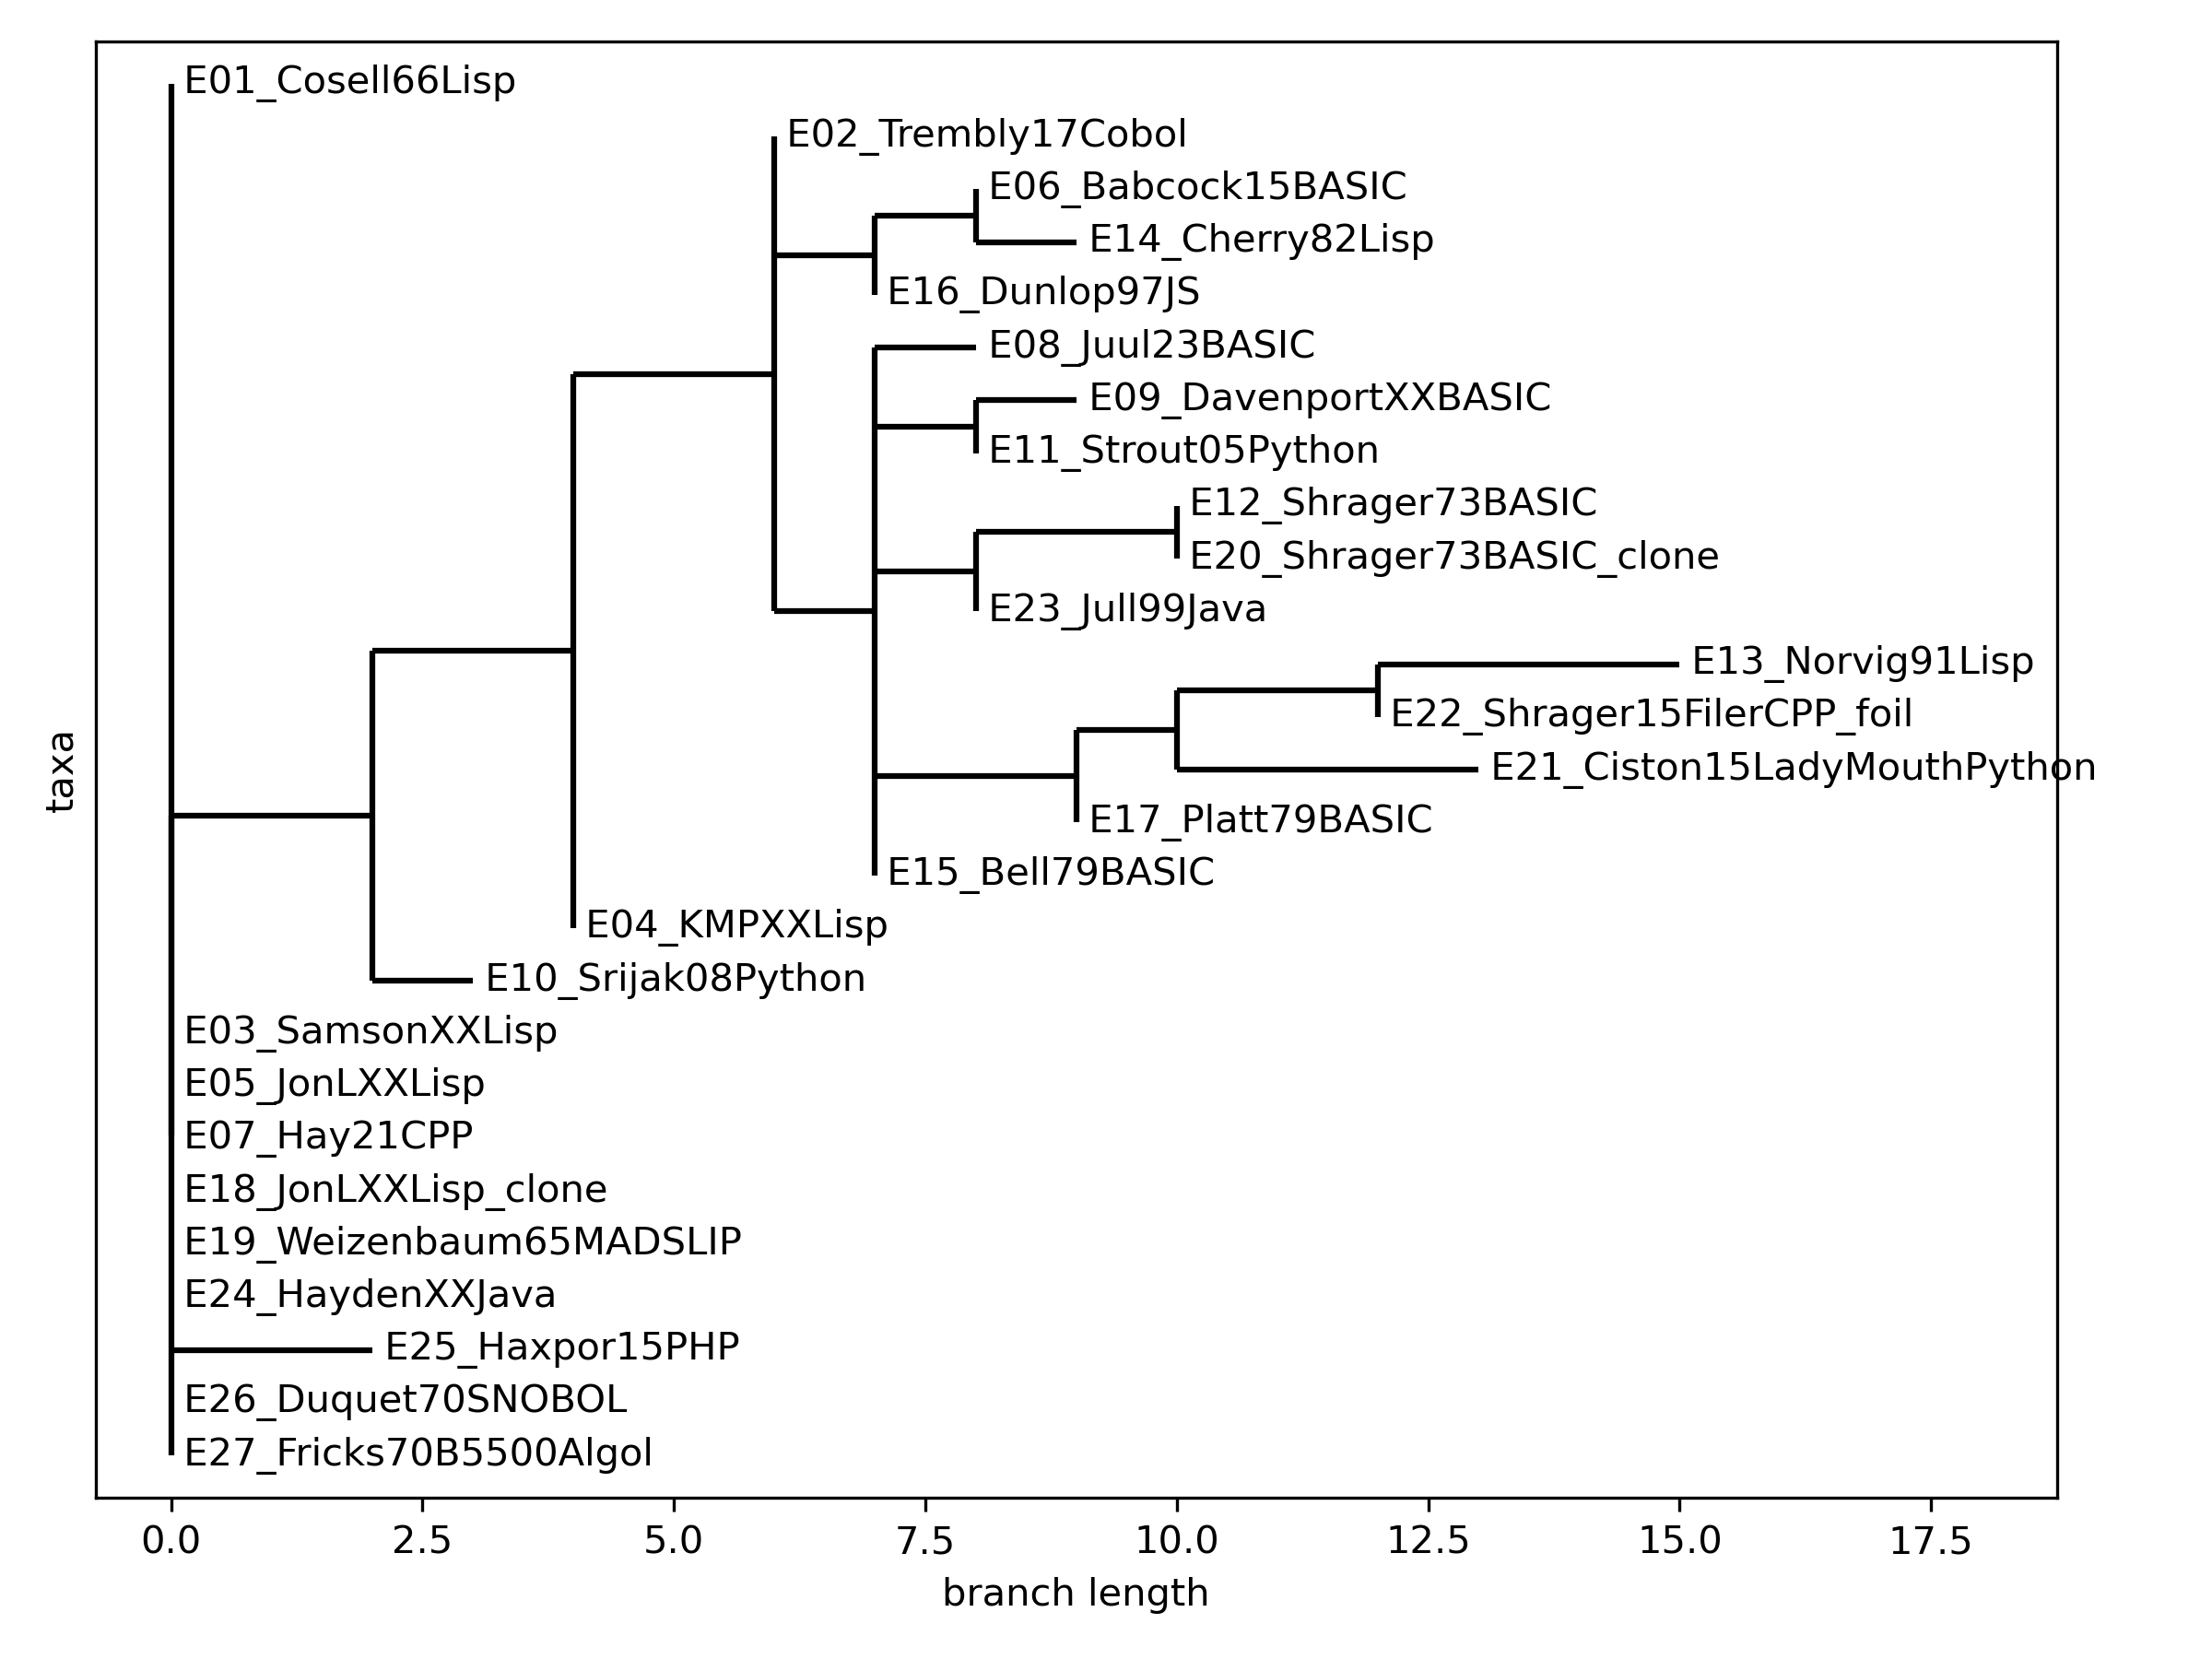
解读这棵树
完整 ELIZA 的基部分支多歧。根部是那些保留了整个 ELIZA 架构、且在这些特征上无法区分的程序:Weizenbaum 1965 年的 MAD-SLIP 原版、Bernie Cosell 1966 年的 BBN Lisp(根据 CACM 论文编写,未见过 Weizenbaum 的代码)、其他几个 Lisp 版本、1970 年的 SNOBOL 和 Burroughs B5500 Algol 版本、一个 Java 版本,以及 Anthony Hay 2021 年的 C++ 重建版。六十年,语言迥异,但设计相同。
一个衍生出的简化分支。从这个核心分支出去的主要是微型计算机时代的 BASIC 版本(Jeff Shrager 1973 年 BASIC ELIZA 的后代,该版本于 1977 年发表在 Creative Computing 上),以及 Python、JavaScript 和一些简化版 Lisp 版本。这些版本通常去掉了回溯、记忆和关键词优先级,原因可能是早期微型计算机的限制、教学目的(例如 Norvig 1991 年在 PAIP 中的 Lisp),或者仅仅是因为不同的编程文化。
验证标本。三个标本用于检验该方法:
- 一对逐字节完全相同的克隆(E18、E20)以零分支长度聚在一起,符合预期。
- 一个对照(E22,一个与对话无关的模式匹配文件工具)嵌套在 ELIZA 分支内部。因此,当前的特征捕捉的是通用的模式匹配架构,而非任何专门对话性的东西,需要更好的对话特征。
- LadyMouth(E21,Sarah Ciston 的女性主义批判艺术聊天机器人)在所有特征上得分均为零。它处于最大距离处:从角色和批判角度看,它是一个类似 ELIZA 的程序,但从架构角度看并非如此,并作为一个已确认的离群值。
论文认为,这一结果最好不应被解读为一条字面意义上的传承谱系,而应被解读为一张文本传统的地图,展示各实现之间如何通过保留、改编、趋同式重新实现和批判而产生关联。
它是如何制作的
- 收集并规范化。 样本从档案、出版物和代码库中收集,然后进行轻度规范化(空白、注释、元数据)。
- 用 LLM 提取特征,再人工整理。 语言模型为第一个程序提出结构和行为特征。词汇表经人工编辑,然后对所有样本进行轮询式扩展,直到不再出现新特征,每轮之后都进行人工整理。
- 分类。 每个样本都按冻结的词汇表打分,生成一个程序×特征矩阵。
- 推断树。 该矩阵被转换为 NEXUS 格式,并在 PAUP* 中以简约法分析(启发式搜索、TBR 分支交换),所得树用 Biopython 绘制。
特征
- 基于规则的模式匹配
- 行为由一组显式规则驱动,每条规则都有模式和相应的响应,而不是纯粹的过程式或统计式逻辑。
- 关键词优先级
- 关键词或规则带有数值优先级,决定应用哪条规则。
- 同义词转换
- 在应用规则之前,通过映射将表层形式(同义词、屈折变化)规范化为规范词元。
- 回溯匹配器
- 匹配器可以消费可变长度的输入片段,并在其上回溯以满足复杂模式。
- 通配符与字符类
- 模式语言支持通配符(例如数字片段占位符)以及词元类或基于属性的匹配。
- 片段存储
- 匹配到的输入片段会被存储起来,供后续在生成响应时引用。
- 模板重组
- 响应通过填充模板来构建,模板按位置引用匹配到的片段。
- 记忆规则
- 选定的过往输入会被存储,之后由专门的记忆规则检索。
- 兜底规则
- 当没有更具体的规则匹配时,会应用一条显式的默认(“最后手段”)规则。
- 标点敏感
- 输入使用一组显式的分隔符和断字符进行分词,因此标点会影响词元和短语的划分。
- 有序记忆
- 记忆按顺序回忆(而非随机)。
- 列表/符号处理
- 程序主要使用列表和符号处理,而非字符串处理。
- 可分离脚本
- 脚本本质上与语言处理代码分离(无论是否位于单独文件中)。
样本及其特征
✓ = 存在该特征,空白 = 不存在,? = 无法确定。每个样本名称都链接到所分析的(规范化)源代码。
| 样本 | 基于规则的模式匹配 | 关键词优先级 | 同义词转换 | 回溯匹配器 | 通配符与字符类 | 片段存储 | 模板重组 | 记忆规则 | 兜底规则 | 标点敏感 | 有序记忆 | 列表/符号处理 | 可分离脚本 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| E01 Cosell66Lisp | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E02 Trembly17Cobol | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||
| E03 SamsonXXLisp | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E04 KMPXXLisp | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||||
| E05 JonLXXLisp | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E06 Babcock15BASIC | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||
| E07 Hay21CPP | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E08 Juul23BASIC | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||
| E09 DavenportXXBASIC | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||||
| E10 Srijak08Python | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||
| E11 Strout05Python | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||
| E12 Shrager73BASIC | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||
| E13 Norvig91Lisp | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||||
| E14 Cherry82Lisp | ✓ | ✓ | ✓ | ✓ | ✓ | ? | ✓ | ✓ | |||||
| E15 Bell79BASIC | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||||||
| E16 Dunlop97JS | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||||||
| E17 Platt79BASIC | ✓ | ✓ | ✓ | ✓ | |||||||||
| E18 JonLXXLisp clone | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E19 Weizenbaum65MADSLIP | ✓ | ✓ | ? | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E20 Shrager73BASIC clone | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||
| E21 Ciston15LadyMouthPython | |||||||||||||
| E22 Shrager15FilerCPP foil | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||||
| E23 Jull99Java | ✓ | ✓ | ✓ | ✓ | ✓ | ||||||||
| E24 HaydenXXJava | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E25 Haxpor15PHP | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||
| E26 Duquet70SNOBOL | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| E27 Fricks70B5500Algol | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
数据、代码与论文
所有内容都在 ELIZAGen GitHub 仓库的 genealogy 文件夹中:
- 论文草稿:PDF · LaTeX 源码 · 参考文献
- 结果:特征矩阵(CSV) · 特征词汇表(YAML) · NEXUS 文件 · 树 · PAUP* 日志
- 流程:操作指南与 README · elizagen_library.py · cvs2nexus.py · draw_paup_trees.py
- 样本:全部 27 个程序的源代码
- 工作笔记:分析过程中的 LLM 对话
本项目源于 2022 年的博客文章 A Code-Based ELIZA Phylogeny。如果您知道有应该纳入该语料库的 ELIZA 实现(尤其是微型计算机之前的、非英语的或艺术性的实现),请写信给 Jeff Shrager(jshrager@gmail.com)。
来源:Hacker News · elizagen.org