用 Strategy Mosaic 和 Amazon Bedrock AgentCore 在 AWS 上为智能体 AI 构建语义层
Build a semantic layer for agentic AI on AWS with Strategy Mosaic and Amazon Bedrock AgentCore
本系列第三篇用 Strategy Mosaic 作为语义层,在 Amazon Redshift 与 Amazon Aurora 上以两个链接模型建模 C360 域,无需 ETL。
本文由 Strategy 首席产品经理 Zhili Cheng、AI 工程总监 George Earle 和销售工程师 Kyler K 共同撰写。
在本系列的第一篇文章中,我们在 AWS 上基于 Amazon Aurora 和 Amazon Redshift 使用 Stardog 知识图谱构建了一个语义层,并在 Amazon Bedrock AgentCore 上运行 Strands 智能体来访问该语义层。第二篇文章沿用相同的客户 360(C360)模式,换用了 Denodo 的数据虚拟化平台,并将数据源组合扩展到包含本地 PostgreSQL 集群。本文再次使用相同的 C360 模式,以 Strategy Mosaic 作为语义层。
Stardog 的语义层基于本体:概念和关系建模为 RDF,以 IRI 作为联邦单元,以 SPARQL 作为查询语言。Denodo 的语义层是数据虚拟化:基础视图和派生视图用 VQL 组合。Mosaic 的语义层是维度式的:属性、层级、事实和度量通过 Strategy 的度量表达式语法组合,以链接模型作为联邦单元。该模型从单一定义出发,原生支持四种协议:面向 AI 智能体的模型上下文协议(MCP)、面向 SQL 客户端的基于 Trino 的 JDBC/ODBC、面向 Power BI 和 Excel 的 XMLA,以及面向自定义应用的 REST。这些协议背后是一份长长的认证数据源列表。支持的系统中包括 Snowflake 和 Databricks 等云数据仓库。运营数据库包括 Amazon Relational Database Service(Amazon RDS)、Oracle 和 SQL Server。分析引擎包括 Amazon Athena、Trino 和 SAP HANA,软件即服务(SaaS)数据源包括 Salesforce。链接模型模式并不局限于本演练所用的 Amazon Redshift 和 Amazon Aurora 组合。在本演练中,托管在 AgentCore 运行时(Amazon Bedrock AgentCore 的一项能力)上的 Strands 智能体通过 MCP 端点访问 Mosaic。连接、度量定义以及按调用方设置的行列过滤都位于 Mosaic 内部,而不是在智能体提示词中。
我们假设您已熟悉本系列第一篇文章中的语义层架构。如果其中有任何新内容,Stardog 那篇文章已涵盖相关基础。
读完本文后,您将了解:
- 如何在 Strategy Mosaic 中跨 Amazon Redshift 和 Amazon Aurora 使用两个链接模型对 C360 领域建模,且无需 ETL。
- Mosaic 的度量语法(基础、带命名过滤对象的高级、层级限定符和复合)如何捕获智能体必须推理的业务定义。
- 如何通过 Mosaic MCP 服务器将模型暴露给托管在 AgentCore 上的 Strands 智能体,以及用户身份如何传播,从而使按用户的行级安全(RLS)和对象级安全(OLS)端到端生效。
- 如何为智能体流量在实时下推和内存执行之间进行选择。
- 如何将同一套受治理的定义发布到 Power BI、Tableau、笔记本和自定义应用,以及如何以 Apache Ossie 格式导出,供 Mosaic 之外的工具使用。
本演练的事实来源是 Strategy One(2026 年 3 月),该版本中通过 MCP 服务器访问 Mosaic 的功能默认可用。
本文使用的 Strategy Mosaic 术语
在进入模型之前,先做一个简短参考。
- Mosaic Schema 与 Mosaic Models。 一个通用语义层内的两条建模路径。Mosaic Schema 是集中治理的企业模型。Mosaic Models 是 Mosaic Studio 中自助式、AI 辅助的建模路径。模型可以映射到 Schema 属性,并继承维度、对象 ACL 和 RLS。本演练使用 Mosaic Models。
- 模型。 任一建模路径中的顶层工件。在物理表之上发布属性、指标、层级和安全规则。本演练使用两个 Mosaic Models,一个基于 Amazon Redshift,一个基于 Aurora,二者相互链接。
- 属性。 诸如 Customer 之类的业务实体。携带多种形式:用于连接的 ID 形式和用于读取的显示形式。Mosaic 使用这些形式将“Carolyn Inworth”之类的名称解析为底层的
cid。 - 层级。 属性之间的父子关系。Category 通过 parent 向上汇总到 Department。Address 向上汇总到 City 再到 State。
- 事实与指标。 事实是数值列。指标对其进行聚合。
Purchase Amount = price * quantity是基础指标。指标还可以是高级指标(由命名条件限定的聚合)或复合指标(基于其他指标的公式)。 - 筛选器对象。 由指标以尖括号引用的命名条件。
[Large Orders]是一个筛选器,其限定条件为Purchase Amount > 500。指标引用<[Large Orders]>而不内联谓词。 - 级别限定符。 固定聚合粒度的指标表达式语法。无论查询如何切片,
{~+, !Customer+}都将粒度设置为 Customer。 - 模型链接。 基于共享属性(Customer、Time)跨模型组合。Mosaic 将聚合下推到每个源,并在链接属性上连接中间结果。
- 认证模型。 只有认证模型才能通过 MCP 服务器访问。
- 实时或内存中。 两种按模型的执行模式:实时下推到源,或从 Mosaic 驻留的立方体返回答案。详情见本文后续内容。
示例:跨 Amazon Redshift 和 Amazon Aurora 的 Customer 360
前两篇文章中的 C360 模式保持不变。该 schema 改编自 Stardog 的 C360 Knowledge Kit,因此跟随本系列的读者会看到相同的实体、键和锚点问题由不同的语义层来回答。一家零售组织的运营侧有客户记录、地址、信用卡和奖励注册信息,而仓库中则有订单、产品和产品类别。业务用户希望获得跨越两者的答案,而无需知道哪个系统持有哪个事实。
本文的不同之处在于 Mosaic 如何到达这两个源。Mosaic 不会在查询时跨引擎联合行。它为每个源规划一个查询,下推原生 SQL,并在 Mosaic 引擎中基于通过模型链接声明的共享属性连接中间结果集。C360 演练将分析侧建模为基于 Amazon Redshift 的 Purchase 模型,将运营侧建模为基于 Amazon Aurora PostgreSQL 兼容版的 Customer 模型。
两个数据库中的 schema:
Amazon Aurora PostgreSQL 兼容版(运营)
| 表 | 键列 |
customer |
cid(主键)、first_name、last_name、email、ssn、phone、location |
address |
id(主键)、city、state、zip、street_name |
credit_card |
id (PK), cid, card_num, card_type |
rewards_account |
id (PK), cid, account_id, create_date |
Amazon Redshift(分析型)
| 表 | 键列 |
purchase |
id (PK), cid, pid, date, quantity, price, card |
product |
id (PK), name, brand, price, dept |
category |
id (PK), dept_name, parent |
vendor |
id (PK), vendor_name, industry |
共享的 ID 是 cid,一个整数,它在 Aurora 上的 customer 中作为主键出现,在 Amazon Redshift 上的 purchase 中作为普通列出现。没有任何 SQL 约束将它们关联起来,也不可能有,因为它们位于不同的引擎中。每一个将客户与其订单关联起来的查询,都必须在某处协调这个整数。Mosaic 通过模型链接而非物化的跨引擎连接来吸收它。
一个能检验整个模型的代表性问题是:在我们按生命周期消费额排名前 20 的客户中,哪些尚未注册奖励计划? 这就是 Denodo 文章中的自动注册问题。它需要来自 Aurora 的客户资料、来自 Amazon Redshift 的聚合消费额,以及来自 Aurora 的注册状态,并基于语义层中的定义进行排名和筛选。
参考架构
图 1 展示了端到端的运行时。入站身份验证路径从客户端经过 AgentCore Gateway(Amazon Bedrock AgentCore 的一项能力)到达运行时。出站查询路径从 Strands 代理经过 Mosaic MCP 端点到达 Amazon Redshift 和 Amazon Aurora。
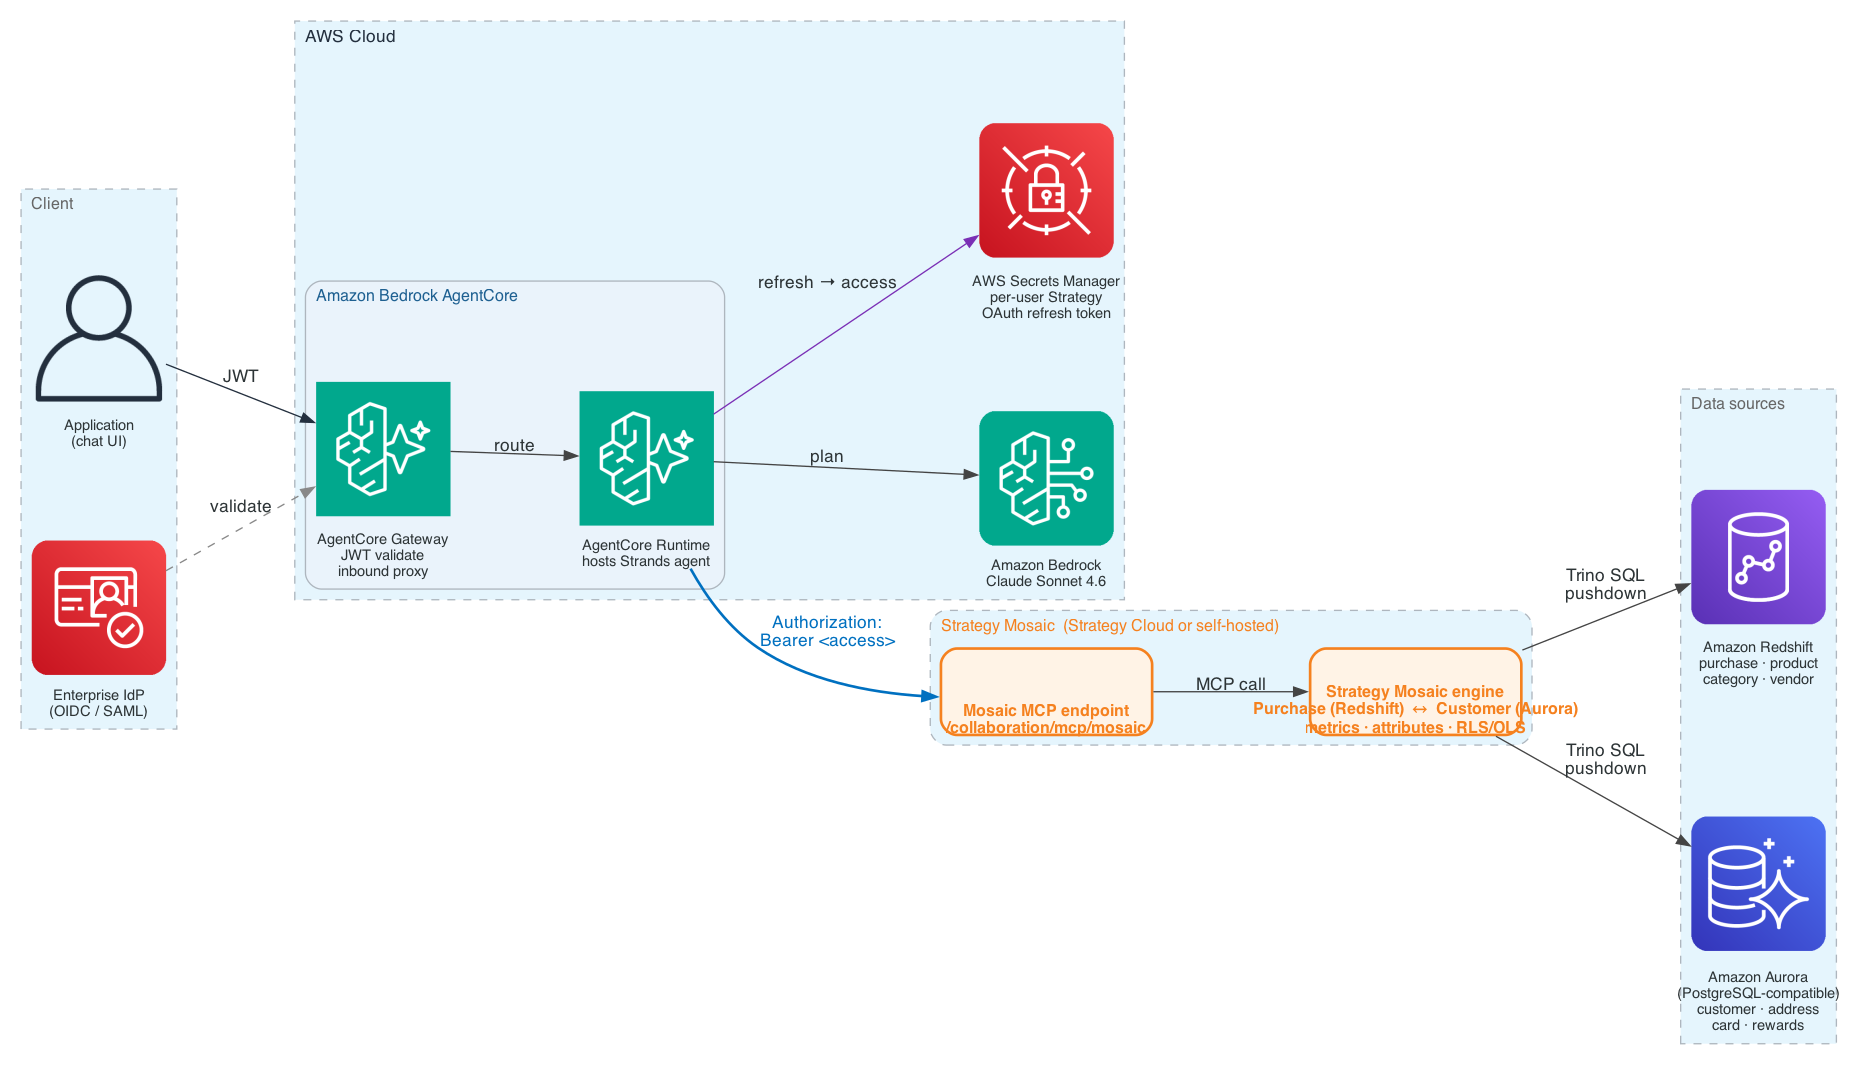
图 1:参考架构。客户端、Amazon Bedrock AgentCore 组件、Strategy Mosaic MCP 端点、Mosaic 引擎以及 Amazon Redshift 和 Amazon Aurora 之间的入站身份验证路径与出站查询路径。
运行时分为入站路径和出站路径。
入站。 客户端通过 Amazon Bedrock AgentCore Gateway 发送用户的问题。Gateway 根据企业身份提供商(IdP)验证标识人类用户的 JSON Web Token(JWT)。然后它将请求路由到托管 Strands 代理的 Amazon Bedrock AgentCore 运行时。该代理调用 Amazon Bedrock 上的 Anthropic Claude Sonnet 4.6 来解释提示并规划查询。
出站。 当代理决定查询语义模型时,其 MCP 工具通过 HTTPS 直接连接到位于 https://<env-domain>/collaboration/mcp/mosaic 的 Mosaic MCP 端点。代理在 Authorization: Bearer 头中出示 OAuth 2.0 访问令牌。Mosaic 根据其内置的 OAuth 授权服务器验证该令牌,并将调用方解析为 Strategy 用户。然后它应用 Use MCP Server 权限和认证模型门控,评估该用户的行级和列级安全性,并跨链接的 Purchase 和 Customer 模型规划查询。Amazon Redshift 和 Amazon Aurora 响应 Mosaic 引擎按源发出的源原生 SQL。
有两个特性对后续的演练很重要。跨源连接之所以发生,是因为建模者声明了链接,而不是因为两个源恰好可达。代理只能遍历模型中存在的链接。到达 Mosaic 的令牌代表人类用户,而不是服务账户,因此 RLS 和 OLS 会端到端地针对调用方的身份进行评估。AWS Secrets Manager 在调用之间保存调用方的刷新令牌,而“受控访问”部分会走完整个身份链。
构建语义层
本演练使用两个 Mosaic 模型,即 Mosaic Studio 中自助式 AI 辅助建模路径,它们通过共享属性进行关联。Mosaic Studio 是创作套件,本文中的截图来自其 Design Center 建模工作区。共分三遍:先处理各侧的数据集与连接,再处理属性与层级,最后处理承载业务逻辑的指标。如果团队已有受集中治理的 Mosaic Schema,可以将模型的属性映射到该 Schema,并从企业级 Schema 继承维度、对象 ACL 和 RLS,而无需另行进行安全审查。如果你的数据架构师已经维护了受治理的 Schema,请尽早执行此操作。
两个关联模型
每个 Mosaic 模型连接到一个实时数据源。模型关联将它们组合起来。
- Purchase:实时连接 Amazon Redshift。事实数据位于
purchase表(price * quantity),维度位于product、category、vendor以及购买日期上。 - Customer:实时连接 Amazon Aurora PostgreSQL 兼容版。维度位于
customer、address、credit_card、rewards_account上。
在每个模型内部,物理连接针对源 Schema 声明一次。Purchase 模型解析 purchase.pid = product.id、product.dept = category.id 和 product.brand = vendor.id,以及 category.parent = category.id 上用于部门汇总的自引用。Customer 模型解析 customer.location = address.id、customer.cid = credit_card.cid 和 customer.cid = rewards_account.cid。这些就是 Mosaic 用来规划其下推的源原生 SQL 的关系。Purchase 与 Customer 之间没有任何物理对象跨越。
两个模型在 Customer 和 Time 上关联。当问题需要同时使用两者时(例如 威斯康星州支出最高的客户 从 address 获取州信息,从 purchase 获取支出信息),Mosaic 会将相应的聚合下推到每个数据源,并在关联属性上合并结果。无需 ETL,无需第三份副本。
领域所有权遵循模型边界。CRM 团队拥有 Customer,数据系统团队拥有 Purchase。双方都不交出各自的数据源。他们就关联属性达成一致,安全性会自动从底层模型传播。Amazon Redshift 与 Amazon Aurora 之间没有物化的跨引擎连接,也没有共享的物理 Schema。连接就是关联属性协议。
属性与层级
属性承载多种形式。Customer 使用 cid 作为 ID 形式,使用 first_name + last_name 作为显示形式,因此智能体可以询问“Carolyn Inworth”,而 Mosaic 会在关联的两侧将其解析为正确的键。图 2 展示了在 Mosaic Studio 中创作的 Customer 属性,其中 cid 为 ID 形式,Full Name、First Name 和 Last Name 为显示形式。
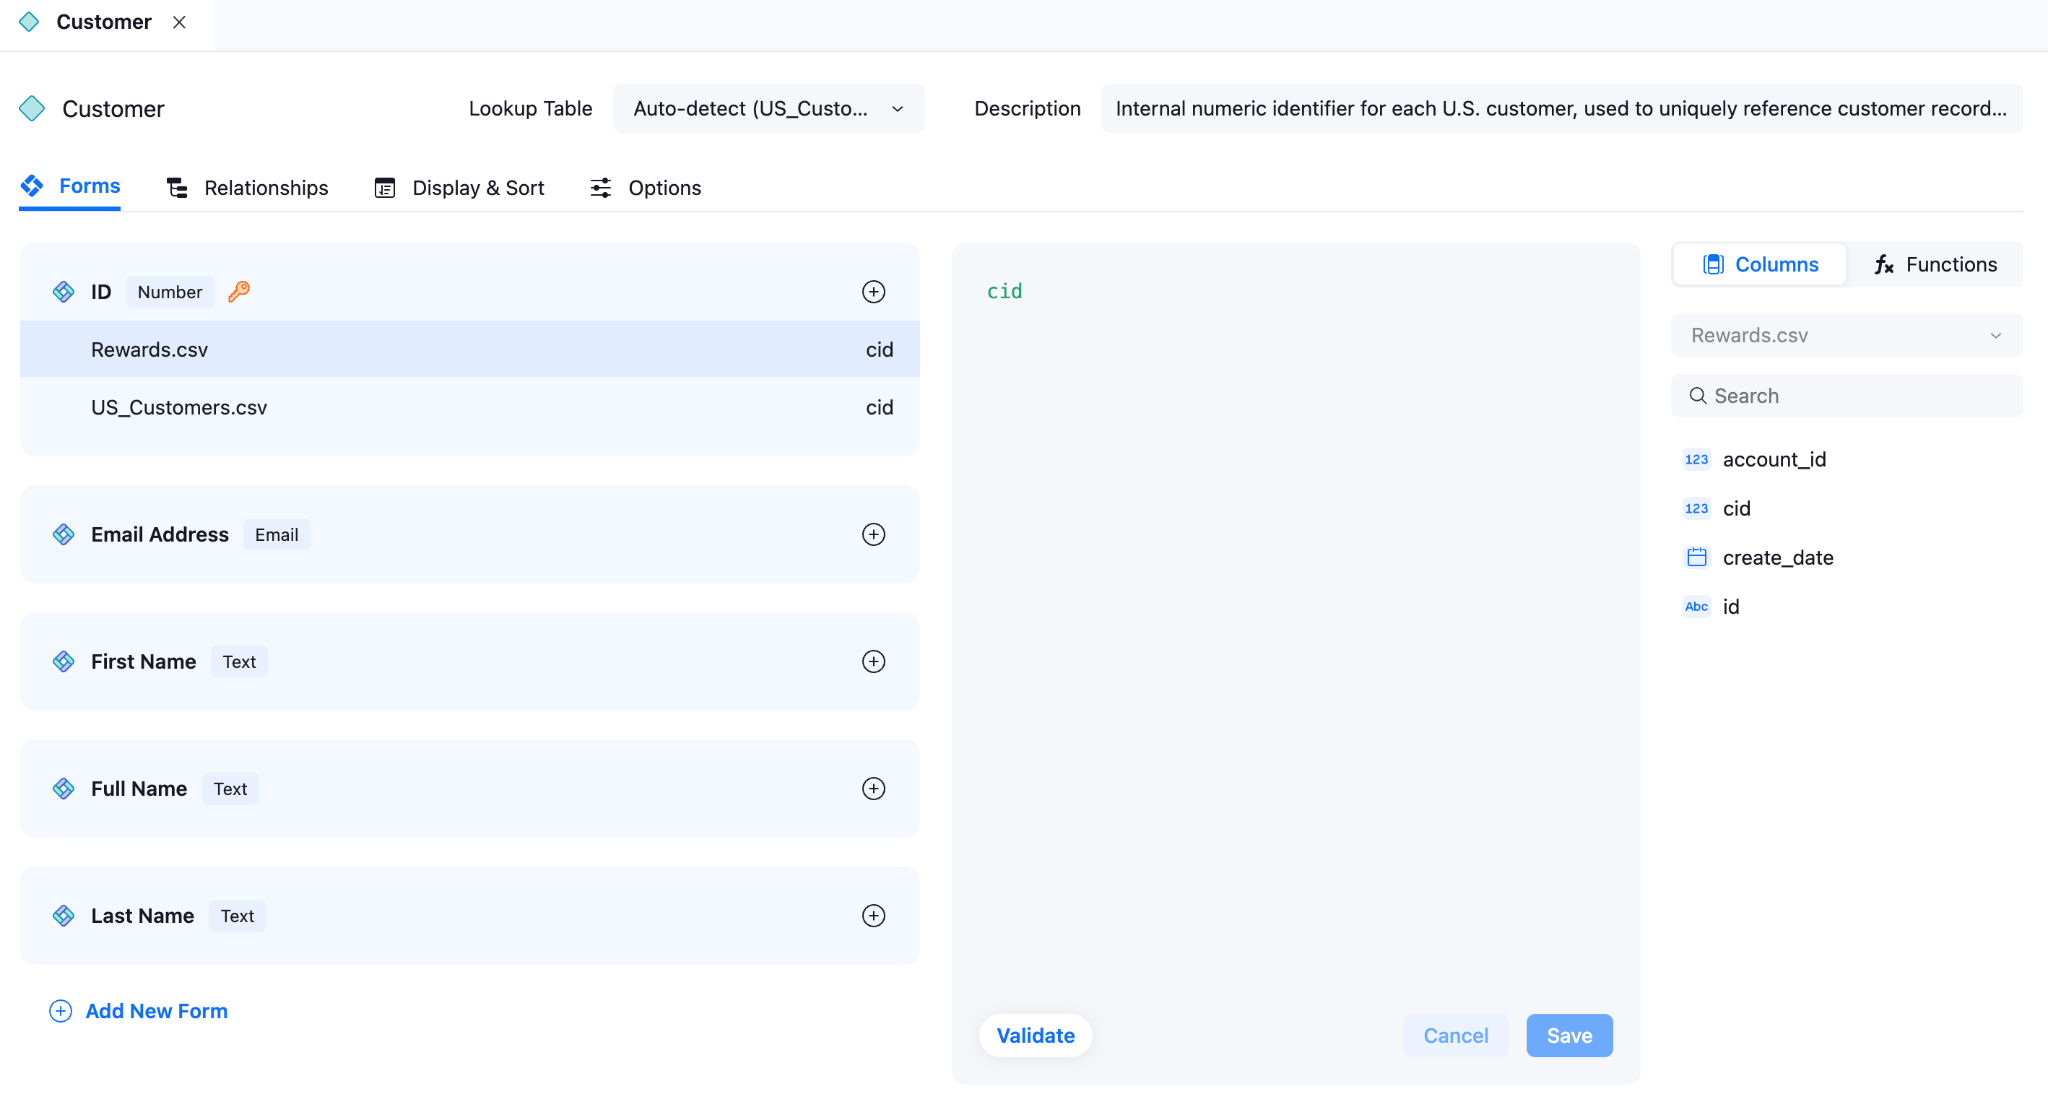
图 2:Design Center 中的 Customer 属性定义。cid 是用于连接底层键的 ID 形式。Full Name、First Name 和 Last Name 是显示形式。
C360 涉及两个层级:
- Category 层级通过 parent 向上汇总到 Department。
category.parent自引用意味着部门级问题会以一致的方式聚合。 - Address 以相同模式通过 City 向上汇总到 State。 这使得
State = 'WI'成为单个属性限定,而不是智能体必须构建的连接。
图 3 展示了在 Design Center 中创作的地理层级,将 State 通过 City 和 ZIP Code 链接到 Customer。
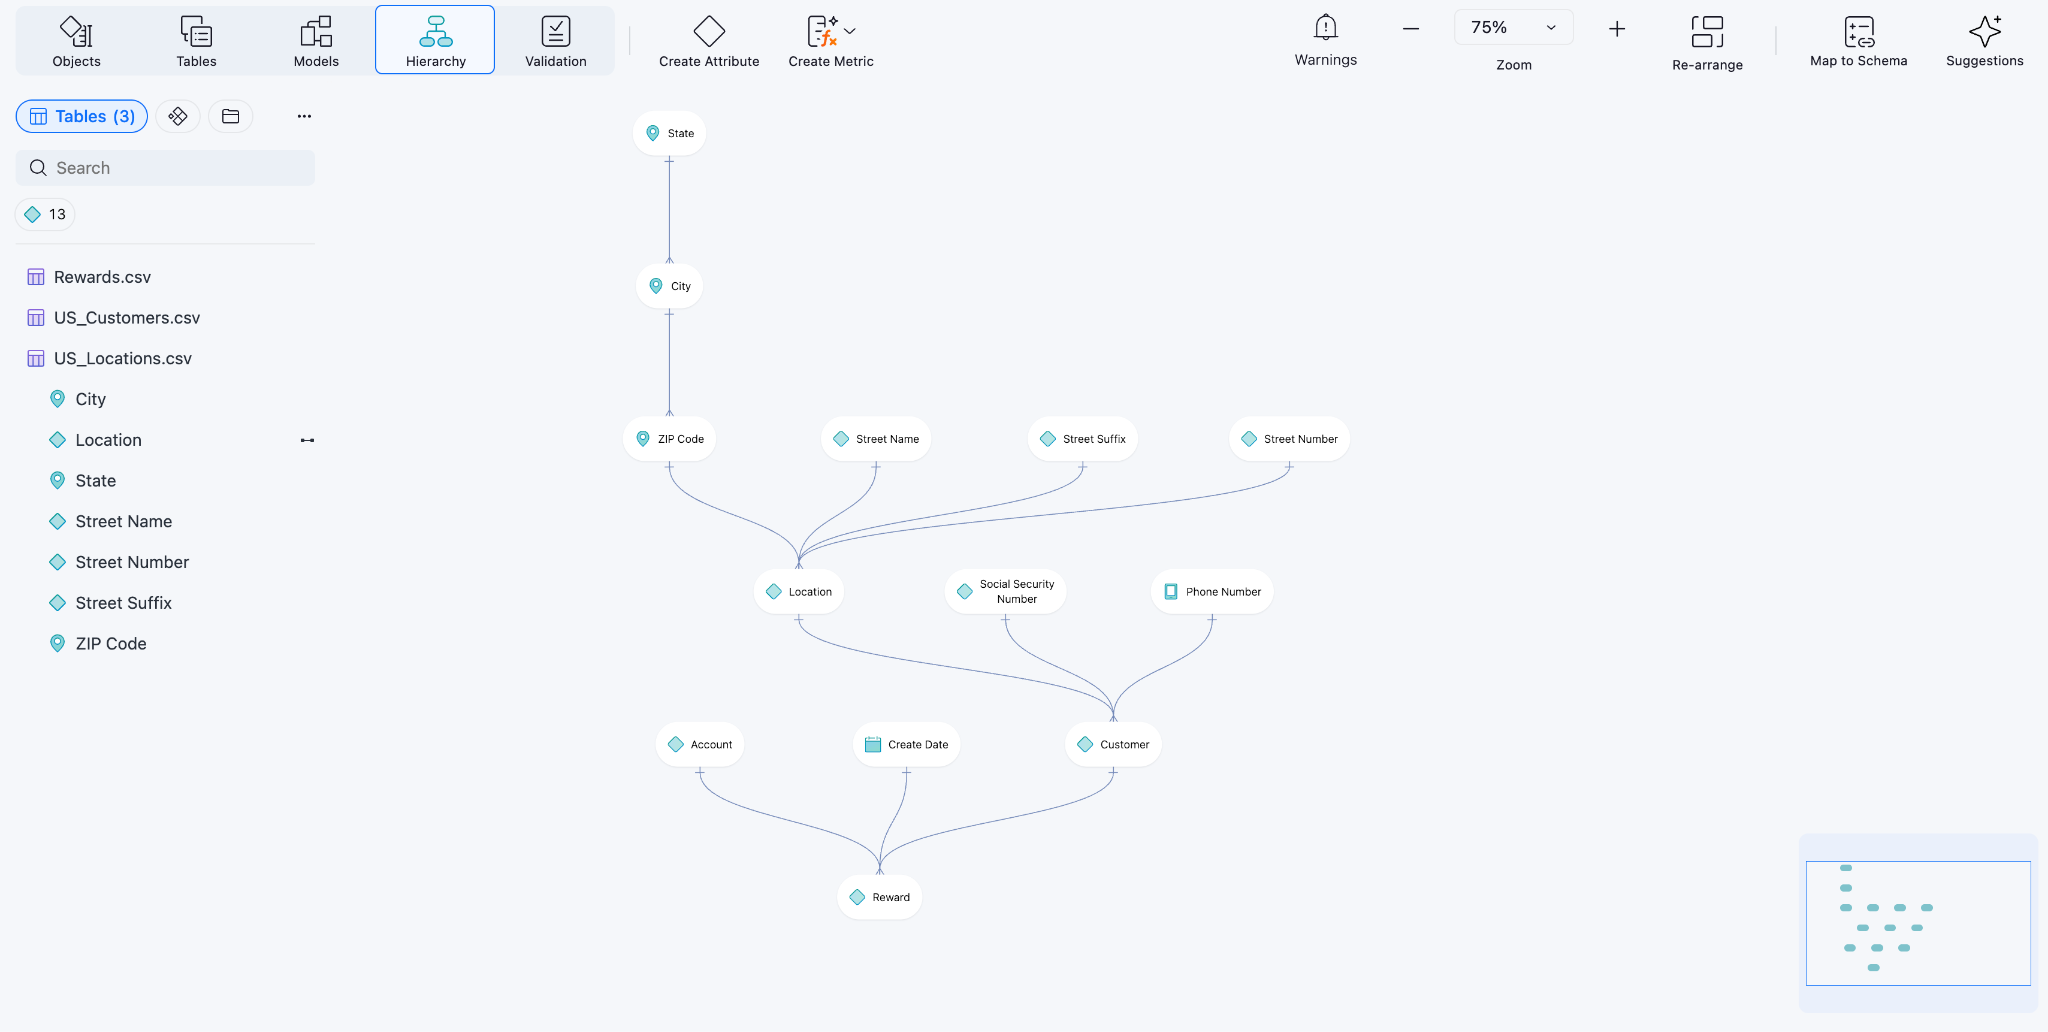
图 3:Customer 模型在 Design Center 中的地理层级。State 通过 City 和 ZIP Code 向上汇总到 Location,Location 链接到 Customer。
智能体请求的是 State = 'WI',而不是 address.state。物理列名不会离开模型。语义层的每个使用者都能看到属性形式及其显示形式,层级会自动承载汇总。
指标:基础、高级、复合、时间智能
基础指标将分组函数应用于事实。Purchase Amount 是 Sum(price * quantity) 在 purchase 表上。
图 4 展示了在 Mosaic Studio 中编写的 Purchase Amount 基础指标:公式为 Price * Quantity,并带有一个描述字段,用于告诉代理该指标在业务层面的含义。
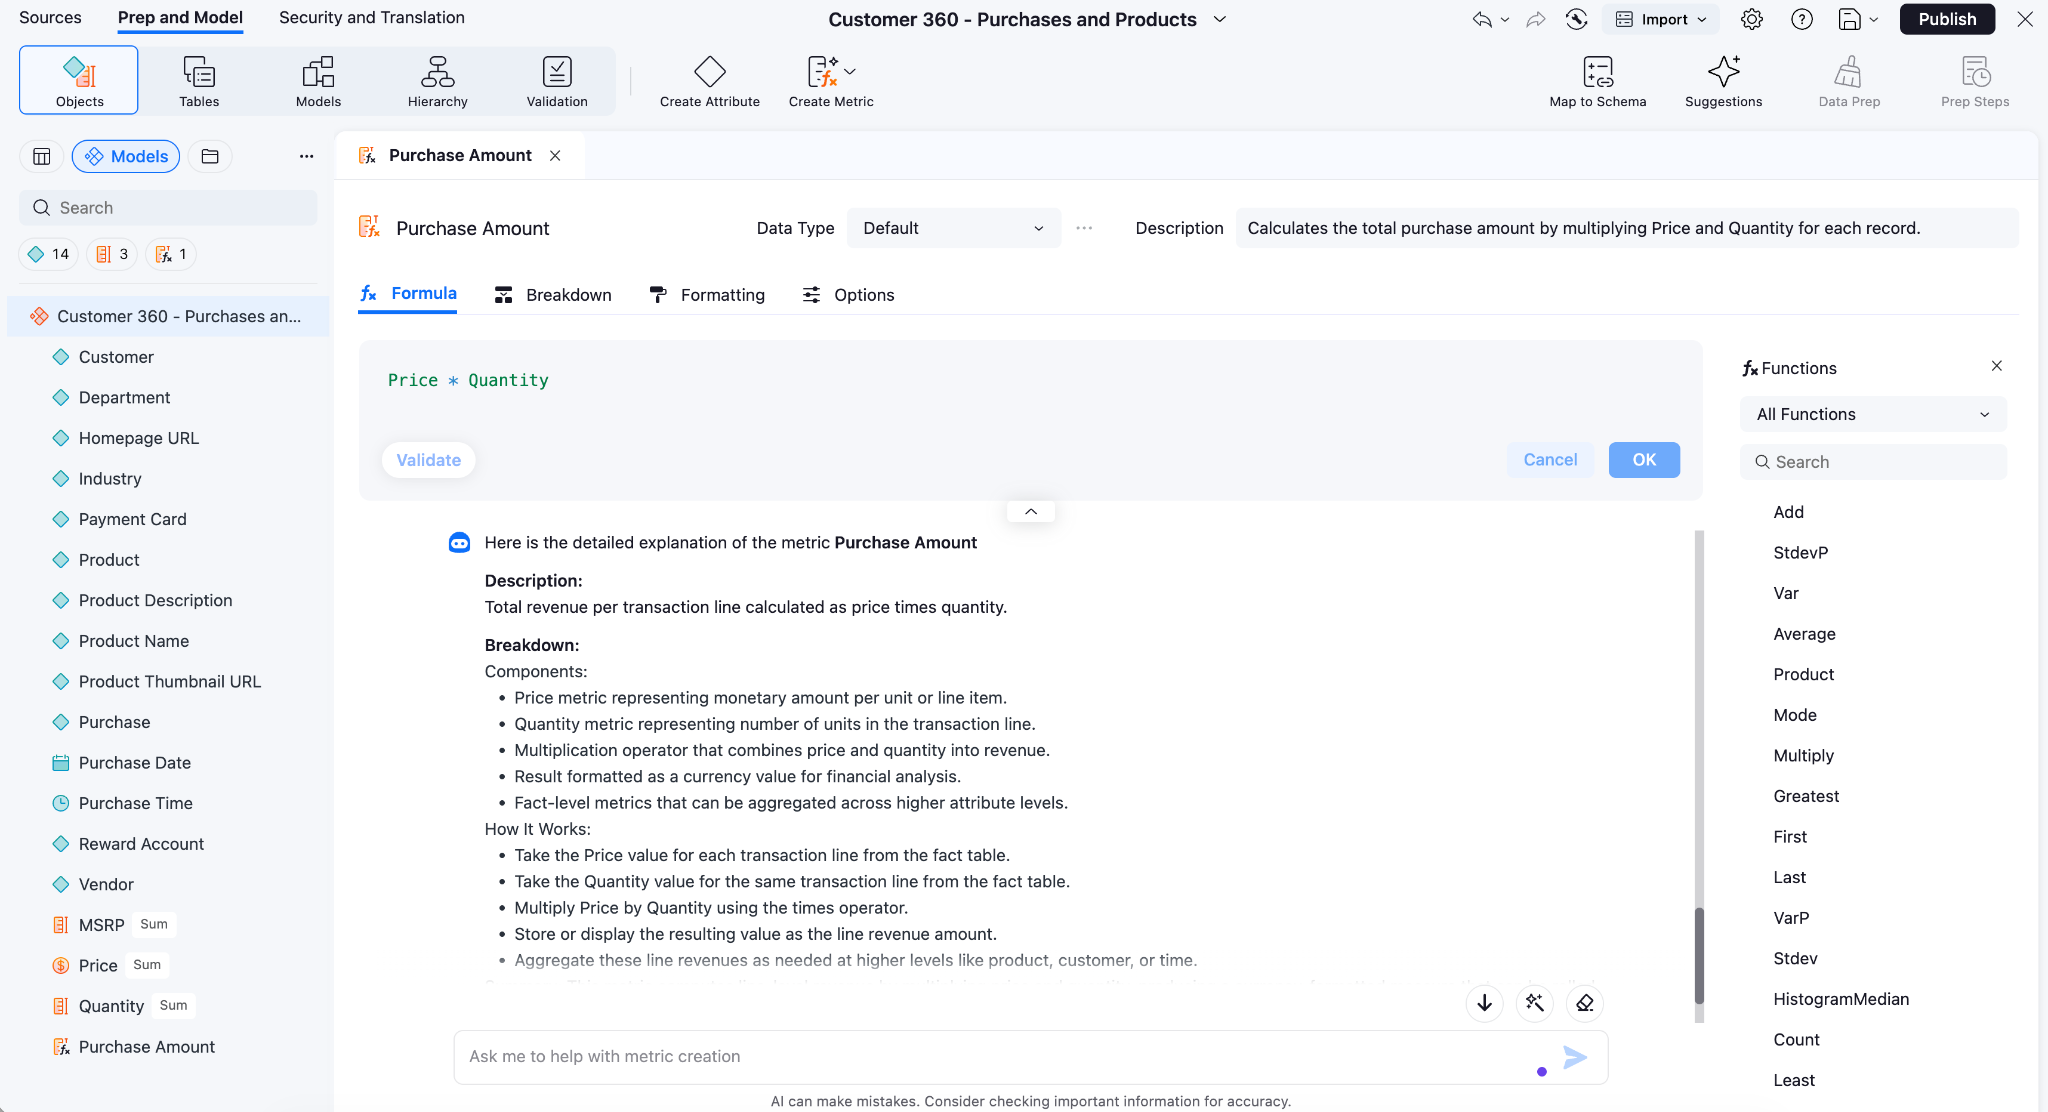
图 4:在 Design Center 中编写的 Purchase Amount 指标。公式将价格乘以数量,描述则告诉代理该指标在业务层面的含义。
C360 中有趣的概念是高级指标:由命名条件限定的聚合。在 Strategy 中,条件是对尖括号中筛选对象的引用,而不是内联谓词。筛选对象是拥有自己的名称、描述和权限的模型对象,因此它们可以在共享定义的指标之间复用和审计。
一次性定义筛选器:
| 筛选对象 | 限定条件 |
[Large Orders] |
Purchase Amount > 500 |
[Sports Category] |
Category = "Sports" |
[Rewards Members] |
Rewards Account is not null |
[Card Present] |
Purchase Card is not null |
[Big Spender] |
Customer Lifetime Spend > 10000 |
每个筛选对象都带有名称、描述、限定条件和访问权限。建模者为 [Large Orders] 编写或导出的结构如下所示:
name:          [Large Orders]
description:   Purchases whose net line amount exceeds $500.
               Referenced by Large Order Spend and any metric that
               scopes to high-value transactions.
qualification: Purchase Amount > 500
permissions:   read:   Everyone
               modify: Data Modelers
然后在指标表达式中引用这些筛选器。其中每一个都是高级指标:由命名筛选器限定的基础聚合。
Large Order Spend    Sum([Purchase Amount]) {~+} <[Large Orders]>
Sports Spend         Sum([Purchase Amount]) {~+} <[Sports Category]>
Rewards Spend        Sum([Purchase Amount]) {~+} <[Rewards Members]>
图 5 展示了应用筛选条件的高级指标在 Design Center 中的视图。它使用与前面 Large Order Spend 相同的编写模式。
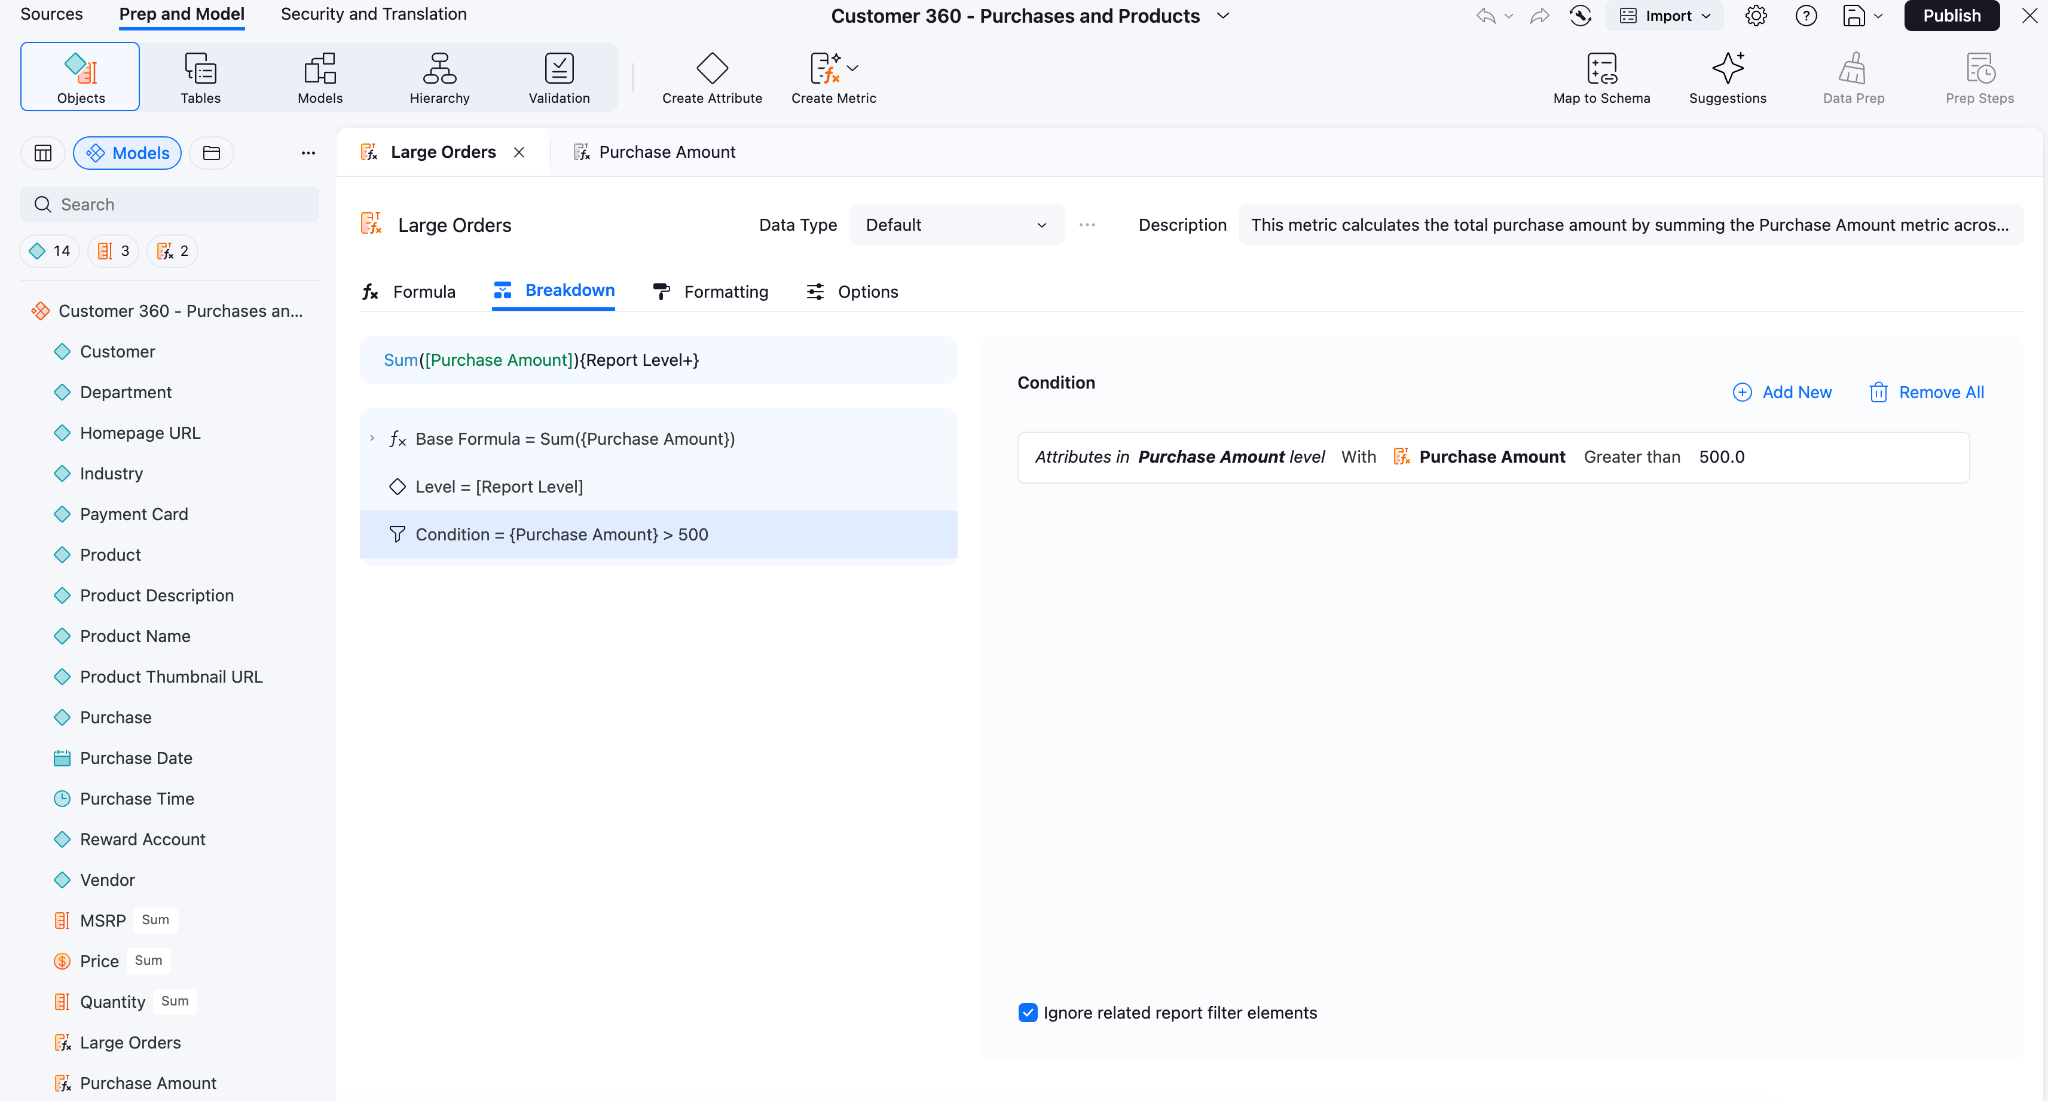
图 5:Design Center 中的高级指标编写,展示了基础公式以及从 Large Orders 筛选对象引用的筛选条件。
Customer Lifetime Spend 还需要一个级别限定符,因为 lifetime 意味着整个历史,无论当前问题如何切片:
Customer Lifetime Spend Sum([Purchase Amount]) {~+, !Customer+}Customer 之前的 ! 将分组设置为无,因此该指标在每一行返回每个客户的完整总计,而不是折叠为每个客户一行。完整语法请参见 Strategy Metric Level Symbols。
请注意,筛选器表中的 [Big Spender] 是基于指标表达式而非属性谓词进行限定。筛选对象可以基于两者中的任意一个进行筛选。钱包份额是一个复合指标,由其他指标构建而成:
Sports Share of Wallet [Sports Spend] / [Customer Lifetime Spend]级别和条件从组件中原样传递。钱包份额是一个比率,因此它不会相加或求平均。某个 AWS 区域内的份额不是每个客户份额的平均值,指标描述会告诉代理这一点。请参见 Strategy Conditional Metrics。
除了基础、高级和复合指标之外,Mosaic 还将受治理的时间智能指标作为一等表达式提供。Previous Year、Previous Quarter、Year-to-Date 和 Quarter-to-Date 在模型上声明一次,并在切片过程中保留,因此像 Sports 今年支出与去年相比如何 这样的问题就变成了属性选择和两个指标引用,而不是手写的 SQL 日期筛选器。自定义日历在模型级别附加,因此相同的同比表达式既适用于 9 月结束的财年,也适用于 12 月结束的日历年。请参见 Governed Time-Intelligence Metrics in Mosaic。
编辑一次筛选对象,Power BI 仪表板、SQL 提取和代理都会同步变化。这就是命名且受治理的模型产物所能带来的、内联 SQL 谓词无法提供的能力。
Mosaic 如何规划和执行查询
Mosaic 引擎将每个 MCP query 调用解析为 Trino 方言的 SQL,将维度引用解析到底层的 Purchase 和 Customer 模型,应用调用方所受的 RLS 或 OLS,并按数据源规划物理 SQL。该方言与 Strategy 为 MCP query tool 发布的方言一致,因此 agent 发出的 SQL 可跨连接到同一认证模型的 MCP 客户端移植。
对于自动注册问题,规划过程如下:
- 下推到 Amazon Aurora:在
cid上连接customer和rewards_account,投影 profile 和rewards_account.create_date,筛选 enrollment 为 null 的记录。每个未注册客户返回一行。 - 下推到 Amazon Redshift:按
cid分组的SUM(price * quantity)。每个客户返回一行,包含总支出。 - 在 Mosaic 内部合并:在
cid(关联属性)上连接两个中间结果集,按生命周期支出排序,返回前 20 条。
Aurora 执行事务性 profile 连接。Amazon Redshift 执行事实聚合。Mosaic 在小规模中间集上处理跨引擎连接(每个客户一行,而非每个订单一行)。手写管道大致模拟相同形态,然后必须永远保持同步。
一个 SQL 细节很重要。指标是受治理的值,但 Trino 将其视为选中的列,因此当查询使用 GROUP BY 时,指标需要聚合包装,例如 SUM(metric_name)。指标的定义、条件和连接路径仍由 Mosaic 解析。外层聚合由调用方负责。因此,像钱包份额这样的非可加比率需要在其描述中说明这一点。
实时下推还是内存内
每个 Mosaic 模型都以两种模式之一运行。
| 模式 | 行为 | 最适合 |
| 实时 | 查询时下推到 Redshift 或 Aurora | 持续最新的数据。源安全直接适用 |
| 内存内 | 从 Mosaic 驻留的立方体回答 | 有界近期窗口。可预测的延迟。无每查询仓库计算 |
两种模式都执行相同的安全规则。RLS 和 OLS 在模型上设置一次,无论答案来自何处都会进行评估。选择是性能和成本问题。
Agent 流量是重复且突发的。一个 agent 将 威斯康星州支出最高者 分解为多个探索性后续查询,会在同一近期切片上触发许多小查询。从内存中提供这些查询将可变的每查询仓库支出转化为固定的 Mosaic 容量,而且通常更快。对于有界窗口上的交互式 agent 工作负载,内存内往往既更快又更便宜。在将模型切换到内存内之前,配置 Mosaic 侧的权限,并在用于验证数字的同一测试过程中验证它们。
一个定义,四个接口
上一节中构建的指标、属性、层次结构和安全规则通过原生协议到达每个消费者。无需连接器转换,无需指标重新实现,无漂移。
| 协议 | 典型消费者 | 使用 Mosaic 的目的 |
| MCP | AI agents(Strands、Claude、Copilot、ChatGPT、Gemini) | 语义发现 + 受治理查询 |
| SQL / JDBC / ODBC (Trino) | Tableau、SQL 客户端、Python notebooks | 灵活性和临时分析 |
| DAX / XMLA | Power BI、Excel 数据透视表 | BI 的语义保真度 |
| REST | 自定义应用程序、数据科学 | 程序化访问 |
本演练中 Strands agent 所消费的同一个经过认证的 Mosaic 模型,也服务于在 Amazon Quick 中工作的业务分析师,后者将 Mosaic MCP 注册为经 OAuth 认证的连接器。无需第二次集成。
受治理的访问:身份传播与运行时强制执行
Mosaic 在语义层强制执行访问控制,即在查询到达 Amazon Redshift 或 Aurora 之前。HR 和欺诈相关角色可以看到 ssn 和 card_num 等个人可识别信息(PII)字段。营销和分析角色则看不到。无论调用方是通过 MCP 访问的 Strands agent、通过 XMLA 使用 Excel 的分析师,还是通过 JDBC 使用笔记本的用户,强制执行方式都完全相同。一套 RLS 和 OLS 对象、一道认证模型关卡、一次权限检查。标记为敏感的属性和指标还会输入到 Mosaic Sentinel Risk Management,后者会对触及被标记对象的查询发出告警,并检测行为异常,作为 OLS 旁边的纵深防御层。
图 6 展示了跨两条通道的身份传播链:每个用户运行一次的前门 OAuth 握手,以及每次 agent 工具调用时运行的逐请求路径。每条通道都端到端携带用户身份,因此 Mosaic 可以针对调用方而非服务账户强制执行 RLS 和 OLS。
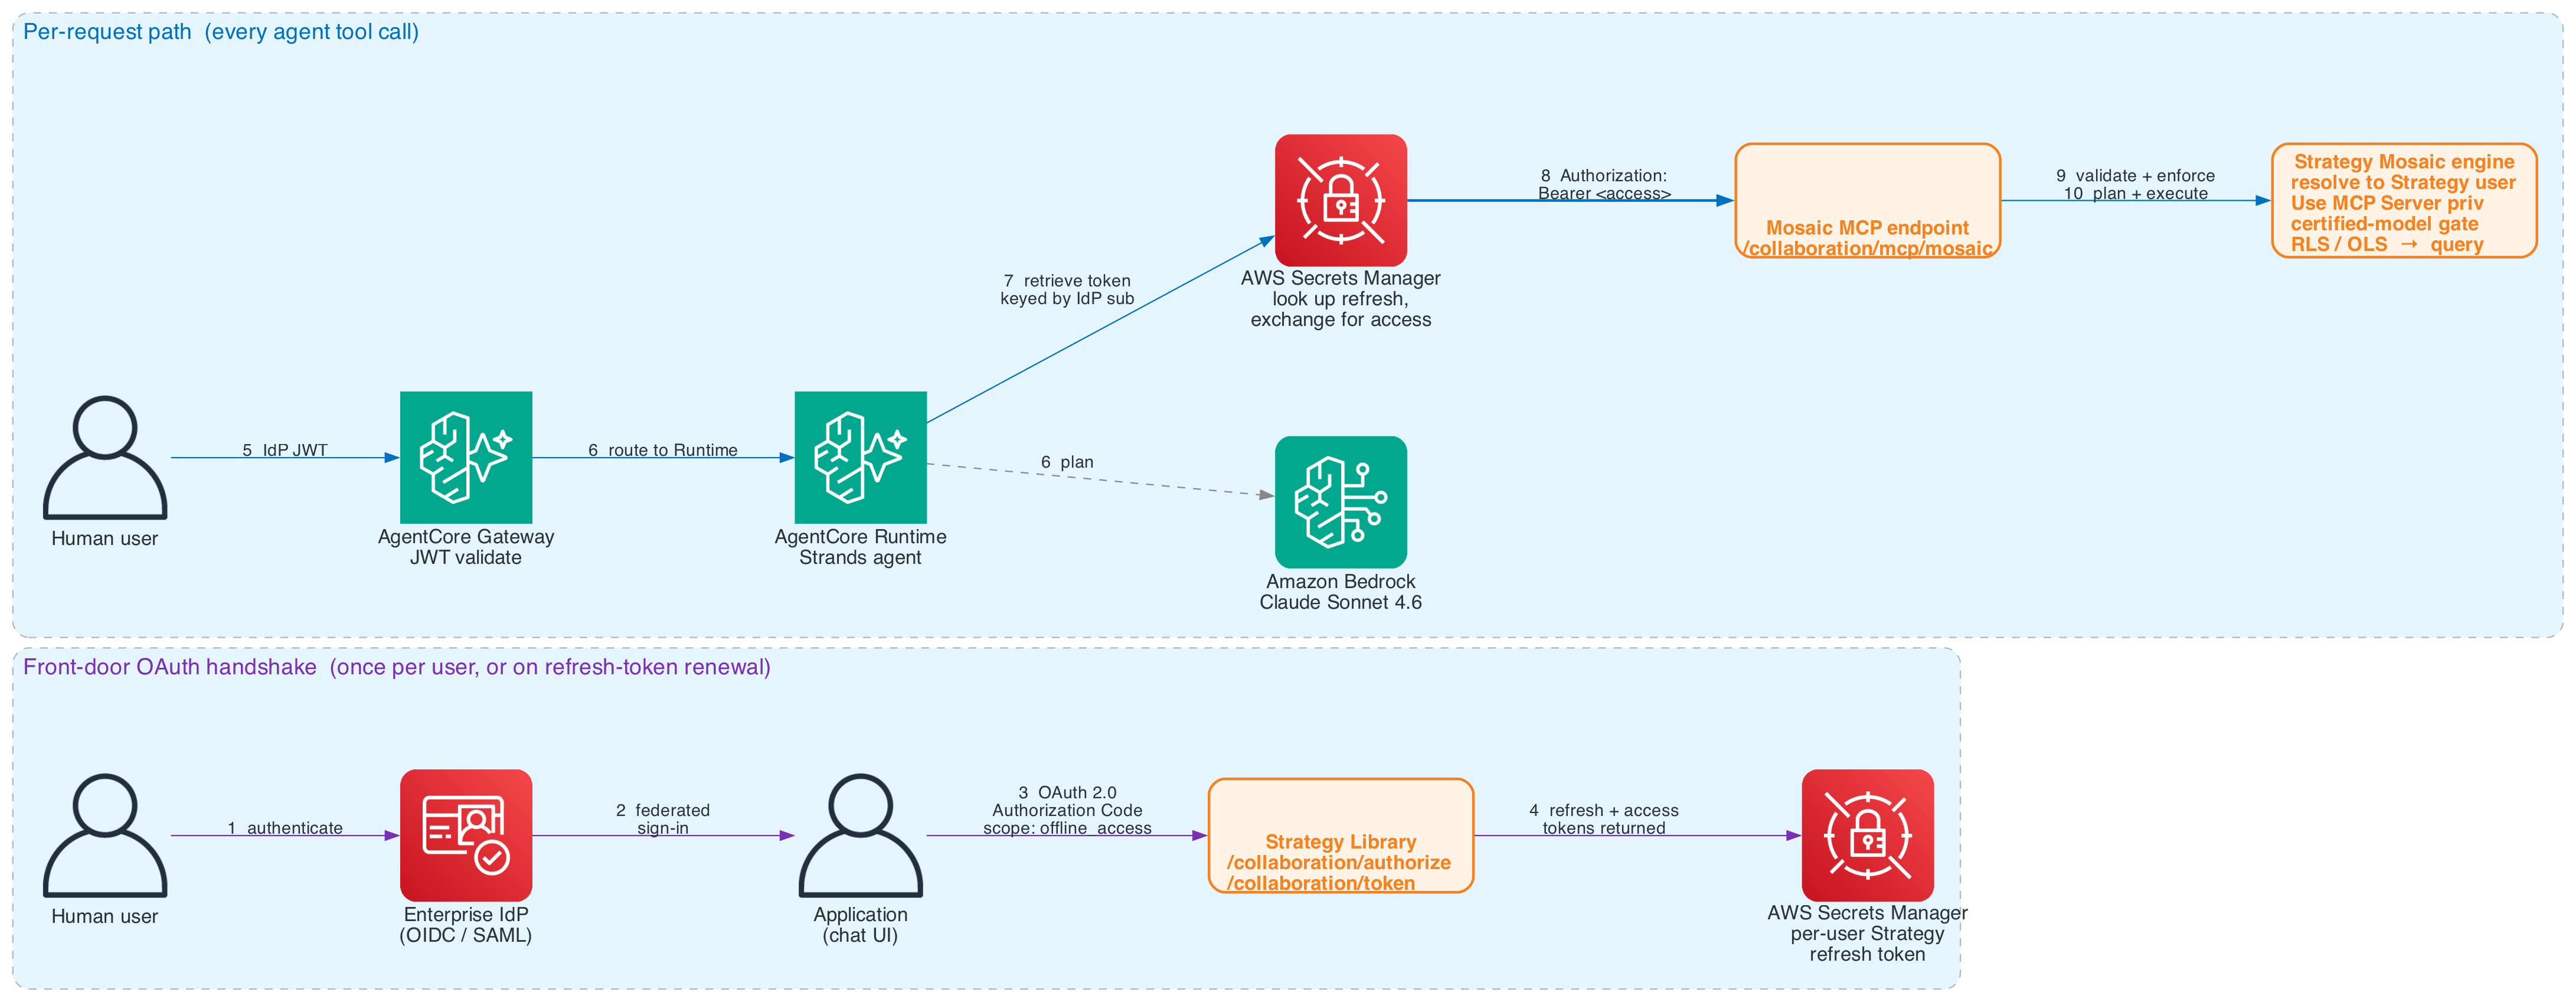
图 6:身份传播链。前门 OAuth 握手每个用户运行一次,或在刷新令牌续期时运行(步骤 1-4)。逐请求路径在每次 agent 工具调用时运行(步骤 5-10)。链中没有任何环节重新限定为服务账户。Mosaic 基于调用方的 Strategy 用户身份评估治理。
该链遵循两条通道。
前门 OAuth 握手(每个用户一次)。人类用户针对企业 IdP 进行身份验证。应用程序针对位于 /collaboration/authorize 的 Strategy Library 启动 OAuth 2.0 授权码流程,作用域为 offline_access。Strategy Library 通过 SAML 或 OIDC 联合到同一 IdP,在 /collaboration/token 返回刷新令牌和访问令牌对。应用将刷新令牌持久化到 AWS Secrets Manager,以用户的 IdP sub 声明为键。
逐请求路径(每次 agent 工具调用)。AgentCore Gateway 验证 IdP JWT 并路由到 AgentCore 运行时,后者托管 Strands agent,在 Amazon Bedrock 上调用 Claude Sonnet 4.6。agent 的 MCP 工具从 Secrets Manager 检索用户的刷新令牌,将其换取新的访问令牌,并将 Authorization: Bearer <access_token> 呈现给 /collaboration/mcp/mosaic。Mosaic 将令牌解析为 Strategy 用户,强制执行 Use MCP Server 权限、认证模型关卡以及 RLS 和 OLS,然后针对 Purchase 和 Customer 进行规划和执行。营销分析师看不到 ssn 或 card_num。欺诈分析师则可以看到。
链中没有任何环节重新限定为服务账户。治理从 IdP 到 Mosaic 引擎全程基于调用方身份进行评估。
通过 Mosaic MCP 服务器暴露该层
Strategy Library 暴露两个 MCP 端点:
| 端点 | 路径 | 功能 |
| Agents MCP | /collaboration/mcp/agent |
将问题路由到经过认证的 Strategy agent,后者使用自己的数据和指令作答 |
| Mosaic MCP | /collaboration/mcp/mosaic |
直接查询 Mosaic 模型和启用 AI 的 cube,无需 Strategy agent |
两者独立工作。本演练使用 Mosaic MCP。将语义层直接置于 Strands agent 之前可跳过一次推理跳转。
工具链
四个工具,从项目到模型到语义再到查询依次链接。
| 工具 | 功能 | 参数 |
get_projects |
列出调用方可访问的 Strategy 项目 | 无 |
get_models |
列出项目中已认证的 Mosaic 模型和数据集 | project |
get_semantics |
返回模型的完整定义:属性和指标,包括数据类型、描述和指标公式 | model |
query |
运行只读的 Trino SQL 查询。写入和 DDL 会被拒绝,并返回 MOSAIC_SQL_WRITE_REJECTED |
sql |
智能体会自动串联这些调用。get_projects 和 get_models 会先按描述缩小到正确的模型,然后智能体再读取列名。get_semantics 返回受治理的定义,智能体随后用这些定义针对真实对象名编写 SQL:Sports Share of Wallet 作为复合指标,Customer Lifetime Spend 限定到 Customer、Category 层级,以及每个指标的公式。
有两个 Mosaic 特有的 SQL 约定很重要。列标识符遵循 <form>__<name> 模式,必须用双引号包裹("customer__customer name")。时间属性既以基础列的形式暴露,也以预先分桶的区间列的形式暴露((day interval)、(month interval)),文档明确说明,对于按时间分组的聚合,应使用区间列,而不是 date_trunc。
元数据才是让它准确的关键
get_semantics 返回定义,但智能体仍然必须选择正确的指标。如果没有描述,Total Spend 和 Customer Lifetime Spend 看起来可以互换,但实际上并非如此。有四个属性发挥了主要作用:对象描述(指标的含义以及何时不应使用它,包括非可加指标的聚合行为)、语义定义(复合指标如何组合)、关系(哪些属性是有效的切片维度),以及治理上下文(这样智能体就能说明它看不到什么,而不是把一个经过过滤的数字当作完整结果呈现)。模型描述是 get_models 返回的第一项内容,智能体正是据此选择正确的模型。Mosaic 可以从上游目录导入元数据,因此已经维护好的列描述会直接流入,而无需重新录入。
部署智能体
Strands 是一个用于构建智能体的小型框架。一个简短的 Python 入口点将 Amazon Bedrock 上的 Claude Sonnet 4.6 连接到 Mosaic MCP 端点,作为工具来源。AgentCore 运行时托管该进程。AgentCore Gateway 终止入站请求,并转发人类用户的 JWT。
系统提示词很重要。给智能体明确的指令,要求在编写 SQL 之前遵循三步调用模式:先 get_projects,再 get_models,然后对目标模型执行 get_semantics。告诉它只引用 get_semantics 返回的属性和指标名称。加入一小节关于目标模型中业务术语的说明(Customer Lifetime Spend 是客户在其整个历史中的总计,与当前切片无关。Sports Share of Wallet 是一个比率。以此类推)。这是对准确性回报最大的提示词工程。
为系统提示词中重复使用的部分开启 Amazon Bedrock 提示词缓存。get_semantics 载荷达到数千个 token,且在同一模型版本内不会变化,因此缓存可以降低重复调用时每次调用的输入 token 成本。针对稳定语义层的智能体流量,正是最能从中受益的重复性、突发性模式。
在 MCP 路径上有两种效果叠加。第一,get_semantics 返回的是压缩后的业务上下文(指标定义、层级、属性形式),而不是原始 schema DDL,因此模型在更小、信号更强的载荷上进行推理。Strategy 的已发布基准衡量了提供语义上下文与原始 schema 相比对输入 token 和每次查询成本的影响。第二,Bedrock 提示词缓存让这个已经压缩的载荷在多次调用之间保持热缓存。对于重复性的智能体流量,两种效果在每次调用时都会生效:模型在压缩后的上下文上进行推理,而重复调用会命中缓存。
验证
为了确认语义层、代理和身份流程按预期工作,我们通过代理运行了三类查询,然后以不同角色对其中一类查询进行了治理重跑。
查询 1,仅 Aurora。 列出我们在威斯康星州的客户及其所在城市。
代理针对 Customer 模型生成查询,投影 Customer 和 City 的显示形式,并将 state 过滤为 WI:
SELECT "customer__customer name", "city__city name"
FROM   "Customer"
WHERE  "state__state name" = 'WI'
ORDER BY "customer__customer name"
Mosaic 向 Aurora 推送单个查询并返回行。Amazon Redshift 未被触及。
查询 2,仅 Amazon Redshift。 按销量计算,我们排名前 10 的产品是什么?
SELECT "product__product name", SUM("Units Sold") AS "total_units"
FROM   "Purchase"
GROUP BY "product__product name"
ORDER BY "total_units" DESC
LIMIT 10
整个查询推送到 Amazon Redshift。Aurora 未被触及。
查询 3,跨模型。 按生命周期支出排名前 20 的客户中,哪些尚未注册奖励计划?
SELECT "customer__customer name",
       "state__state name",
       SUM("Customer Lifetime Spend") AS "lifetime_spend"
FROM   "Customer"
WHERE  "rewards_account__account_id" IS NULL
GROUP BY "customer__customer name", "state__state name"
ORDER BY "lifetime_spend" DESC
LIMIT 20
Mosaic 跨两个模型进行规划。Profile 和注册状态来自 Aurora,支出聚合来自 Amazon Redshift,在 Mosaic 引擎内按 Customer 链接属性进行连接,然后过滤并取前 N 名。 代理无需定义 Customer Lifetime Spend。它按名称引用指标,Mosaic 解析了公式、级别限定符和链接路径。
治理重跑。 我们以两个调用者的身份运行查询 1,并将 ssn 添加到投影中。作为欺诈分析师,get_semantics 返回了 SSN 属性,查询返回了这些值。作为营销分析师,get_semantics 返回了一个不含 ssn 的 Customer 属性,因此代理没有可投影的属性。相同的请求、相同的查询文本,从一个定义得到两个正确的答案。
跨界面确认。 我们通过 Mosaic XMLA 端点,在 Excel 中打开同一个已认证的 Customer 模型,并将 State 和 Customer Lifetime Spend 拖到数据透视表上。州级总计与代理的数字完全一致。
在运行初期,代理对客户的钱包份额进行了平均,这是经典的非可加性错误。在指标描述中添加一行(“比率指标。不要跨客户平均,从组件重新计算”)就阻止了它。这就是为什么要在第一个冲刺而不是最后一个冲刺中编写指标描述。
跨数据源扩展
相同的链接机制扩展到第三个来源:通过 Amazon Athena 查询的 Amazon Simple Storage Service(Amazon S3)中的点击流事件、Amazon S3 Tables(Amazon S3 的一项能力)上 Apache Iceberg 中的表,或诸如 CRM 之类的 SaaS 来源。在 Mosaic 中为来源建模,在 Customer 和 Time 上链接它,浏览到购买的问题就会组合到同一个客户视图中,而无需第三条管道。添加来源不会改变已存在的指标定义。代理只能沿着建模者声明的路径行进。AWS Lake Formation 管理对底层湖表的访问。Mosaic 的 RLS 和 OLS 在此基础上应用。
相同的实时来源模式适用于 Strategy 支持的数据源目录中的每个系统,涵盖本地数据库(如 PostgreSQL 和 MySQL)以及本文中已提到的仓库和引擎。
与 Apache Ossie 的互操作性
有些工具不会依赖单一语义层。Apache Ossie(孵化中)正是为填补这一空白而生的开放规范,于 2025 年 9 月 23 日以 Open Semantic Interchange 之名发布,现已在 Apache 孵化器中,名为 Apache Ossie(孵化中)。它定义了一种厂商中立的格式,用于描述指标、维度、关系和业务概念,使定义能够在工具之间迁移而无需重新录入。Strategy 与 Snowflake、Dremio、dbt Labs、Salesforce 等一同参与其中。
Mosaic 可导出和导入 Ossie 工件。在 Amazon Redshift 上建模的指标和维度定义可发布为 Ossie YAML,供支持 Ossie 的工具直接使用,无需 Mosaic 连接器。在别处编写的定义(在 dbt 中维护的指标、在目录中标准化的维度)可流入 Mosaic,而无需重新实现。这些工件是纯文本,因此可以存放在 Git 中,并像其他代码一样在各环境间推广。
Apache Ossie 尚处早期。请在可移植性最重要、保真度要求最低的地方使用它,例如公式、维度、描述和归属元数据,同时将治理策略、执行策略和安全配置保留为 Mosaic 原生。
部署:Strategy Cloud
Mosaic 作为托管服务运行在 Strategy Cloud 上。Strategy 负责运营该应用。与 Amazon Redshift 和 Amazon Aurora 的连接经由 Strategy Cloud 的出站网络发起。您需要在源安全组中将 Strategy Cloud 的 CIDR 加入允许列表。
可观测性
两个可观测性平面覆盖从提问到回答的路径。
Sentinel 和 Platform Analytics 覆盖查询侧。Sentinel 捕获近实时的查询时长、慢查询,以及按用户、工具和模型划分的使用情况。
AgentCore Observability,Amazon Bedrock AgentCore 的一项能力,覆盖智能体侧:规划步骤、工具调用、每轮延迟。Sentinel 和 Platform Analytics 展示请求到达 Mosaic 之后发生了什么。AgentCore Observability 展示智能体在到达之前做了什么。
结论
可靠的智能体分析结合了强大的推理能力、可信的业务上下文和安全执行。Amazon Bedrock 提供模型,Strategy Mosaic 提供基于实时数据的受治理语义层,Amazon Bedrock AgentCore 托管智能体并终止身份验证。智能体与语义层对话,而非直接与 Amazon Redshift 或 Aurora 对话。模式会演进,语义模型吸收变化,同一套定义服务于 Power BI、Tableau、notebook、Strands 智能体和 Amazon Quick。通过 Apache Ossie,它们还能触达不连接 Mosaic 的工具。
从哪里开始
- 选择一个目前存在争议的指标(NRR、贡献毛利、活跃客户是常见候选)。一个指标,却有不止一种定义在流传。
- 围绕它写出三到五个业务问题。这些将成为你的验收测试。
- 在 Mosaic 中为你的主要数据源建模,让该指标返回一个站得住脚的数字。
- 基于模型中已有的属性,一次一个地增量关联其他数据源。
- 为智能体将看到的每个指标和属性撰写描述。准确性的提升主要来自这里。
- 通过 Mosaic MCP 连接 Strands 智能体,并运行你的验收问题。
- 观察真实查询模式几周,然后将热点迁移到内存中。
- 将稳定的定义导出为 Apache Ossie 并纳入版本控制。
延伸阅读
- Strategy Mosaic – 通用语义层
- 使用 MCP 服务器与 Agents、Mosaic 模型和 Cubes 交互
- Strategy 高级指标:报表数据与计算
- Strategy 条件指标
- Strategy 指标级别符号
- Strategy 复合指标
- Amazon Bedrock AgentCore 开发者指南
- Amazon Bedrock 提示缓存
- Apache Ossie(孵化中)
- 使用 Stardog 和 Amazon Bedrock AgentCore 在 AWS 上为代理式 AI 构建语义层
- 使用 Denodo 和 Amazon Bedrock AgentCore 在 AWS 上为代理式 AI 构建语义层
关于作者

Zhili Cheng
Zhili 是 Strategy 的首席产品经理,负责领导 Strategy 的通用语义层 Mosaic,拥有 17 年以上工程和产品经验。

George Earle
George 是 Strategy 的 AI 工程总监,负责领导公司的 AI 工程工作。

Kyle K
Kyle 是一位经验丰富的企业软件销售工程师,专注于售前、解决方案架构和概念验证工作。他拥有东华盛顿大学计算机科学学士学位。

JP Boreddy
JP 是 AWS 的高级解决方案架构师,与企业客户合作开展云架构、数据和 AI 工作负载相关项目。

Sahil Thapar
Sahil 是 AWS 的首席解决方案架构师,与 ISV 客户合作在 AWS 云上构建高可用、可扩展且具有韧性的应用程序。他专注于容器、机器学习和生成式 AI,帮助企业设计生产级解决方案。
来源:AWS Machine Learning Blog · aws.amazon.com