JetBrains 发布 Mellum2.1:面向编码智能体的快速开源模型
Mellum2.1 Gets to Work: A Fast Open Model for Coding Agents
JetBrains 发布 Mellum2.1,这是其 6 月开源的 12B MoE 模型的新版本,采用 Apache 2.0 许可,激活参数 2.5B,架构与 Mellum2 相同,改动集中在后训练。

在众多 JetBrains 产品中,用 AI 驱动的功能为你的工具提速
Mellum2.1 投入工作:一款面向编码智能体的快速开放模型
Mellum2.1 在真实环境中通过强化学习训练,专为编码智能体和快速子智能体打造,可在你自己的硬件上运行。
今天,我们发布 Mellum2.1,这是我们于6 月开源的 12B 混合专家模型的下一个版本。自版本 2 以来架构没有变化:它仍然是一个紧凑、快速的模型,拥有 2.5B 激活参数,以 Apache 2.0 许可证发布。变化的是预训练之后发生的一切。
Mellum2 很快,但它无法在我们期望的层面上在代码仓库内工作。经过一个夏天在真实环境中的强化学习,在数千个环境中进行了数百万次沙盒运行后,Mellum2.1 可以做到:它探索代码库、编辑文件,并检查自己的更改。
我们在 Mellum2.1 中做出的改变
这个版本几乎所有的功夫都花在了后训练上,主要是强化学习(RL)。
- 新规模的强化学习:RL 从一个简短的最终阶段变成了训练的主要部分。我们就如何训练方法和数据进行了大量实验,并保留了经得起检验的部分。
- 更多数据,更严格筛选:我们在数学、竞技编程、科学、工具使用和软件工程方面新增了 RL 任务,将开放 RL 数据集与我们自己构建的任务相结合。开放数据往往带有损坏的测试、无法验证的答案,或者对模型来说过于简单或不可能完成的任务,因此每个来源在进入训练之前都经过了筛选。
- 面向智能体技能的真实环境:我们构建了在内部运行数千个 RL 环境的基础设施,并在训练过程中启动了数百万个沙盒。
Mellum2.1 的表现如何
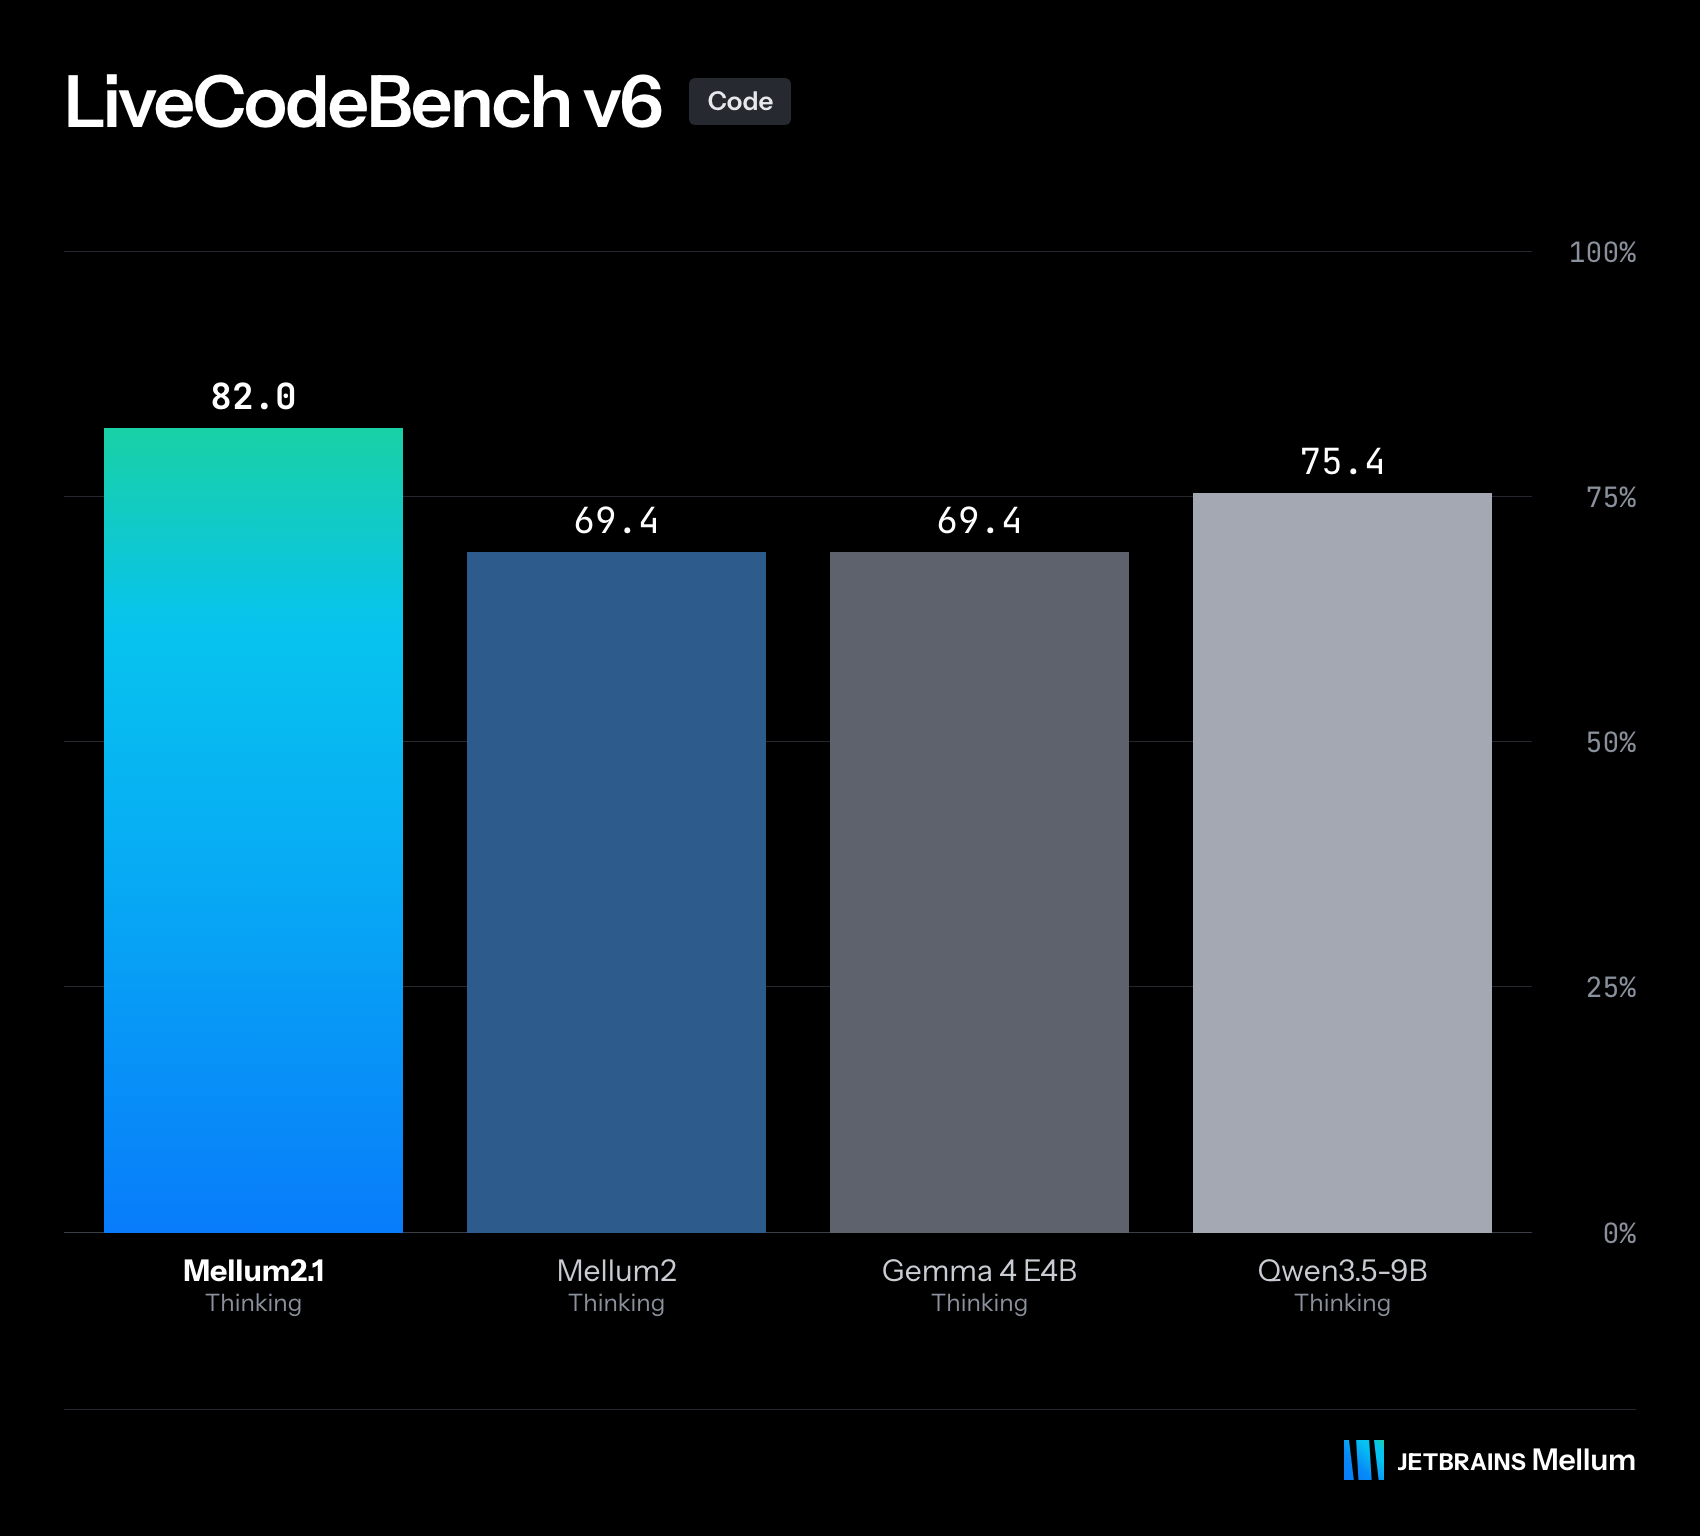
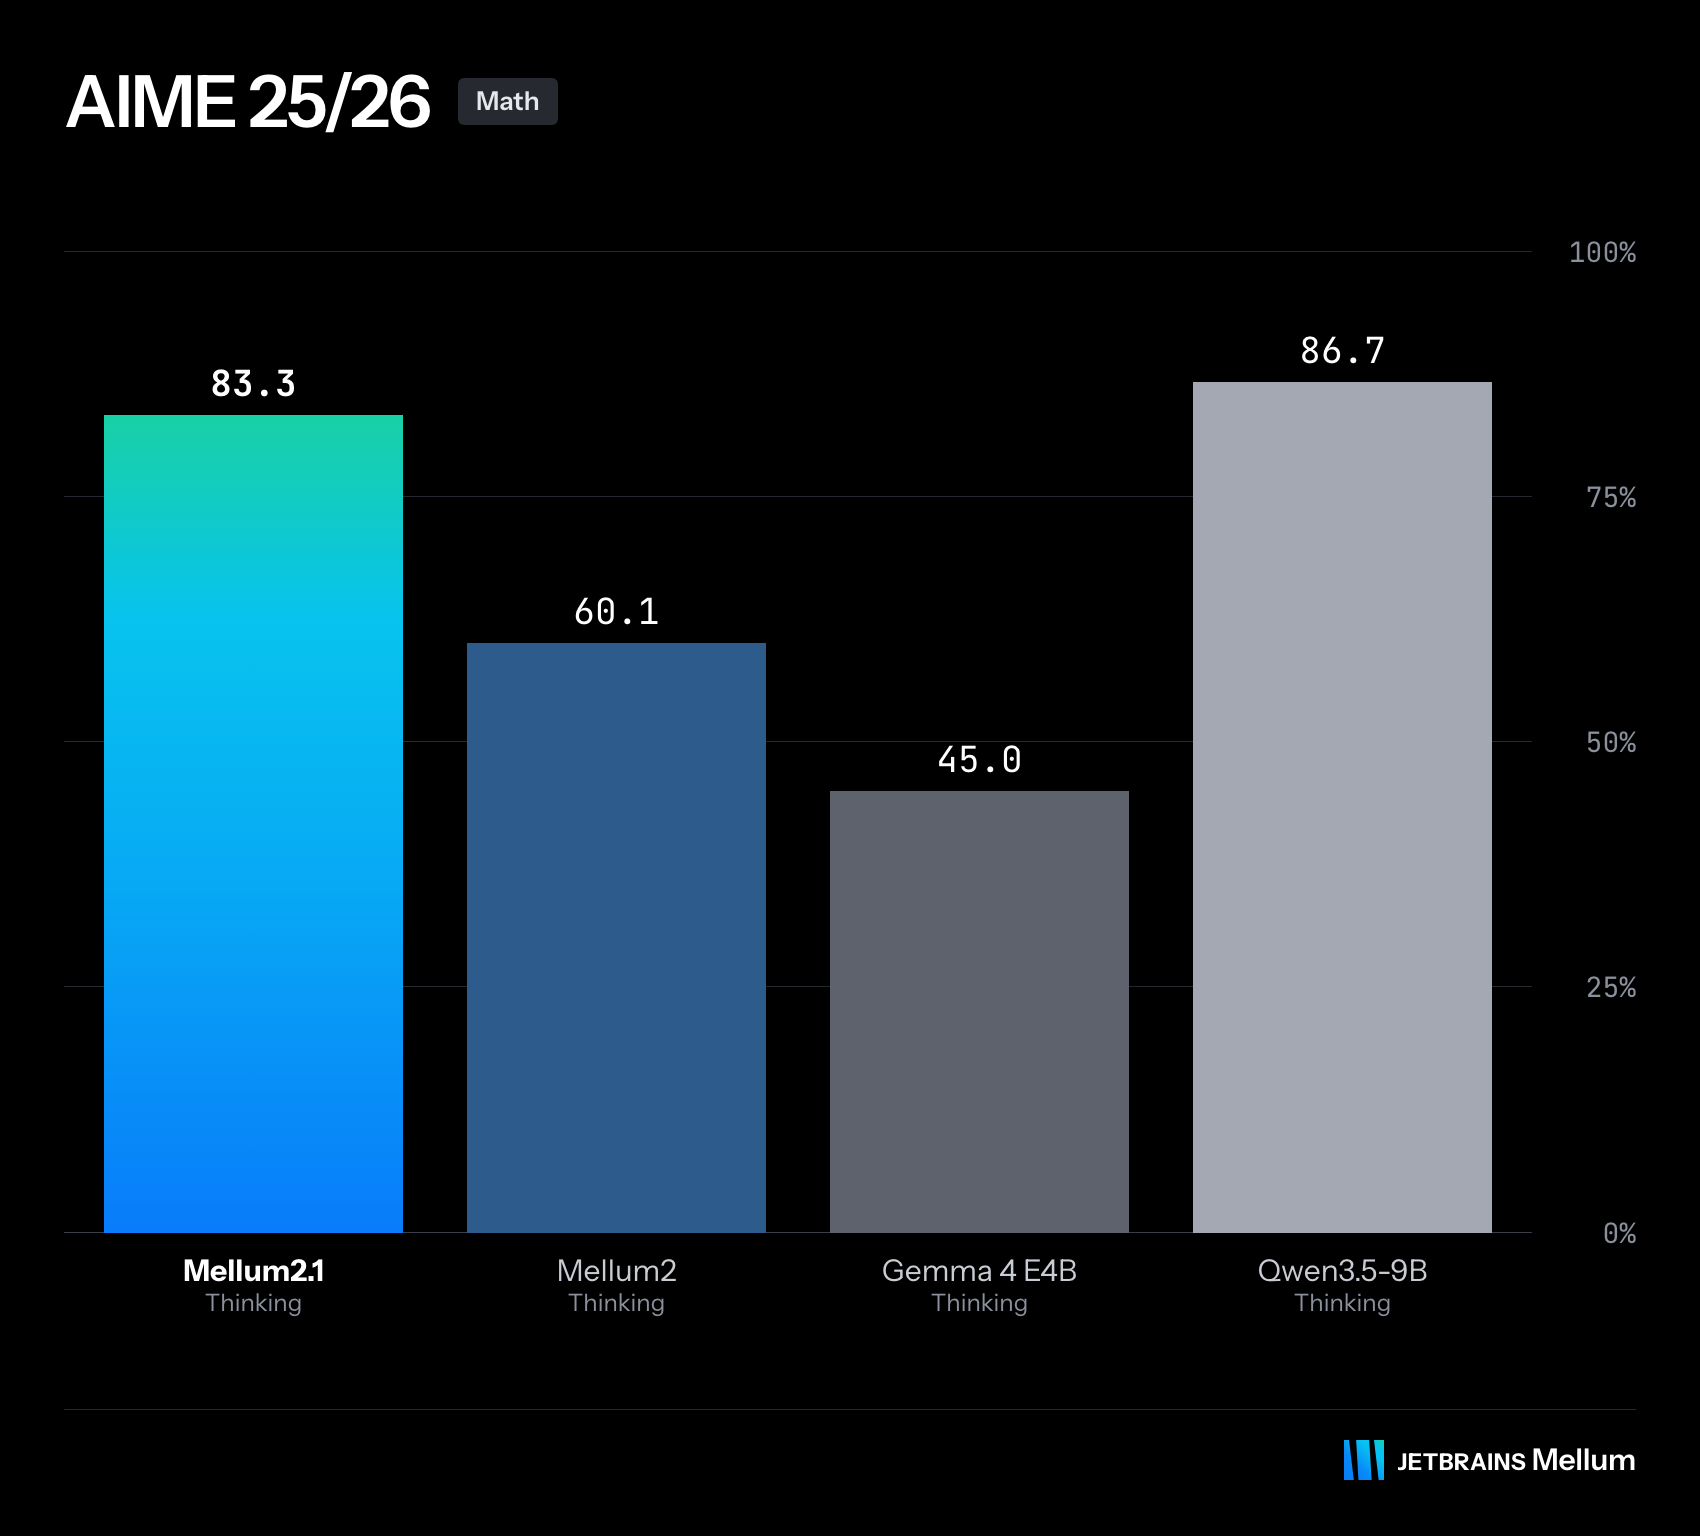
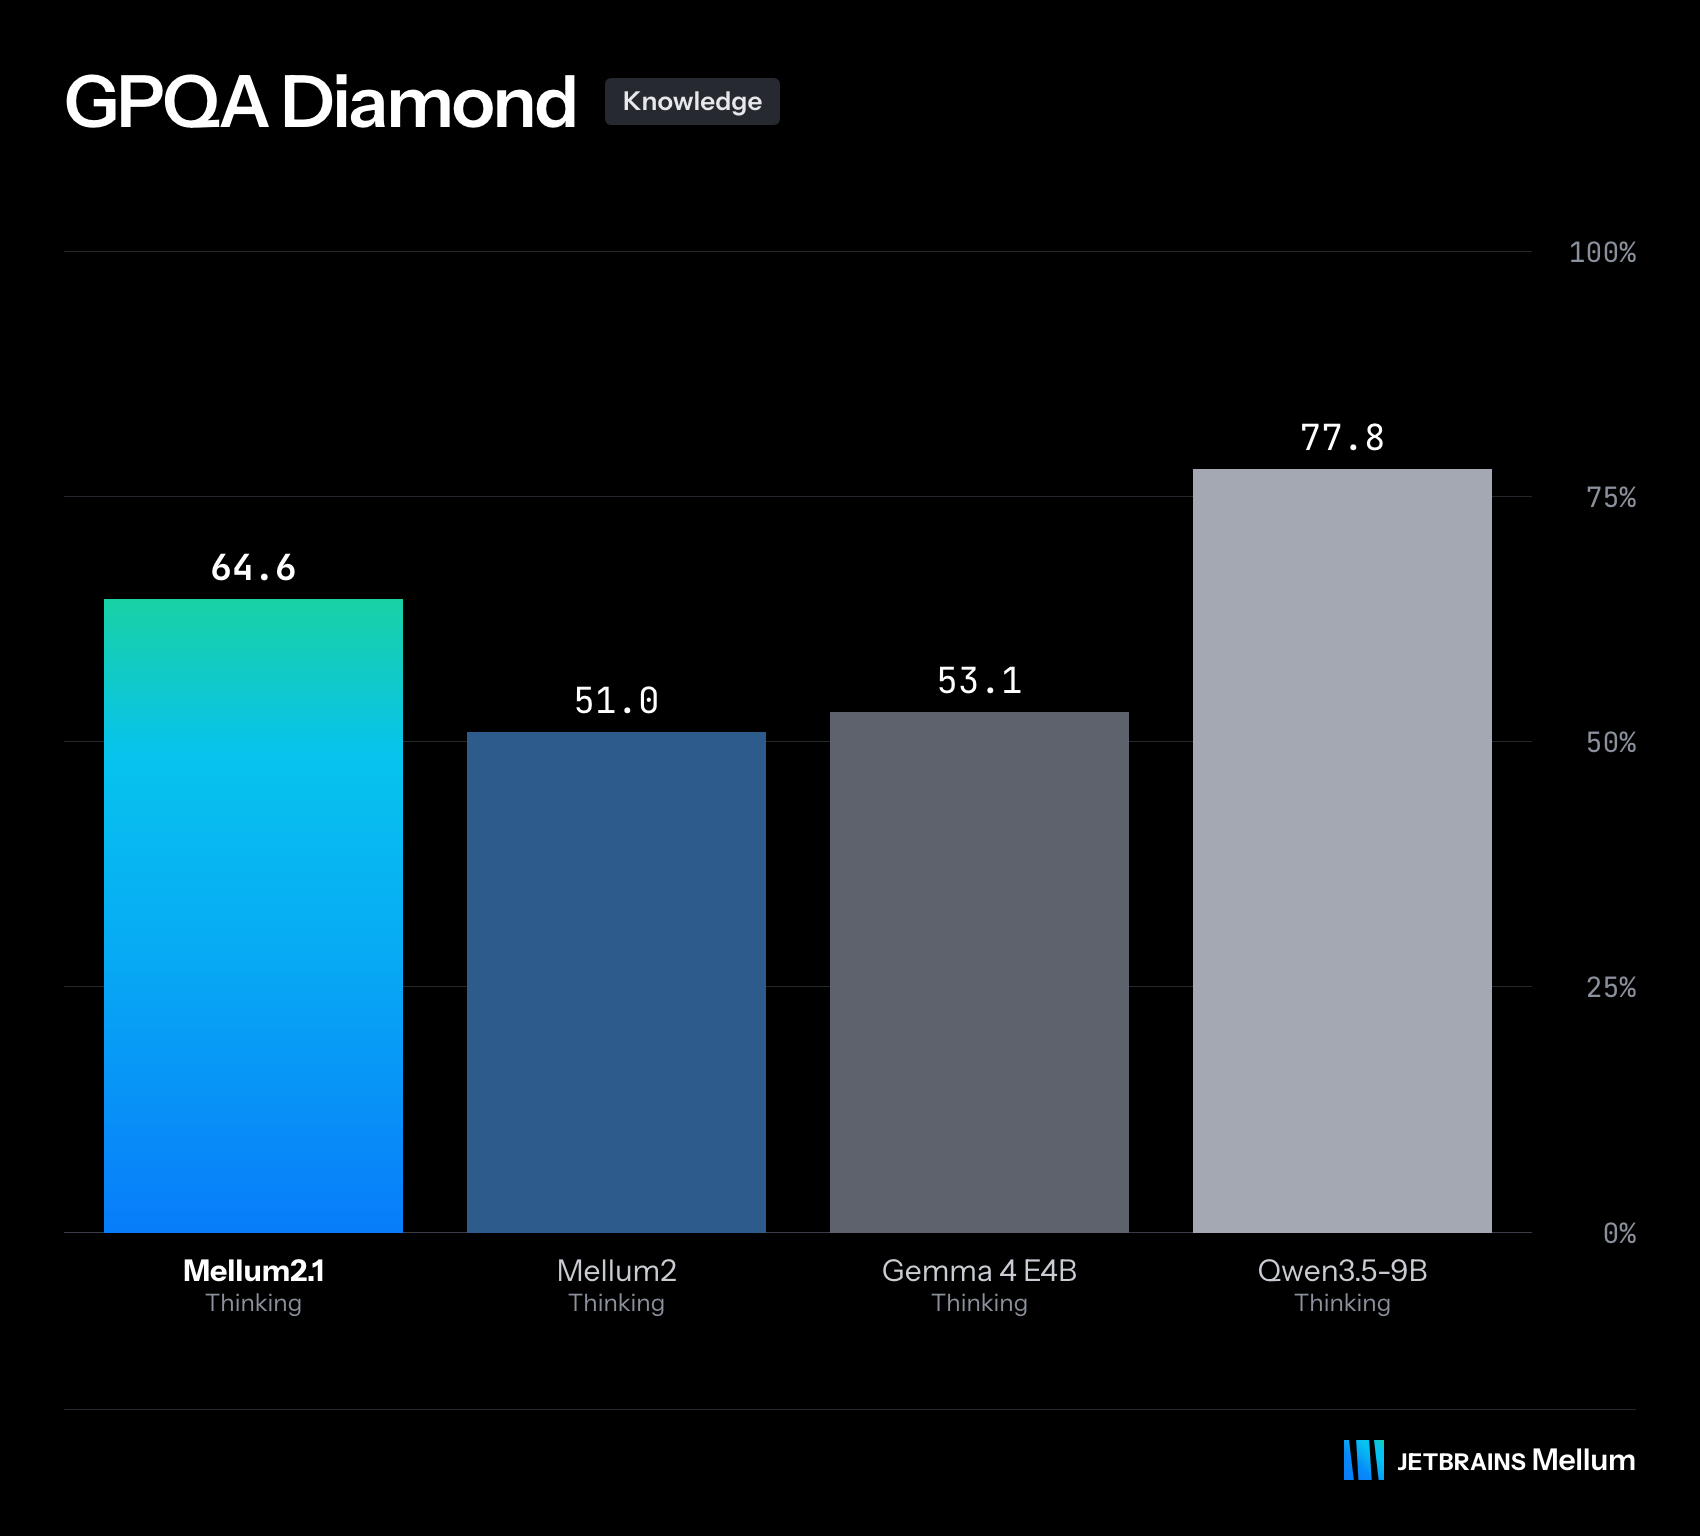
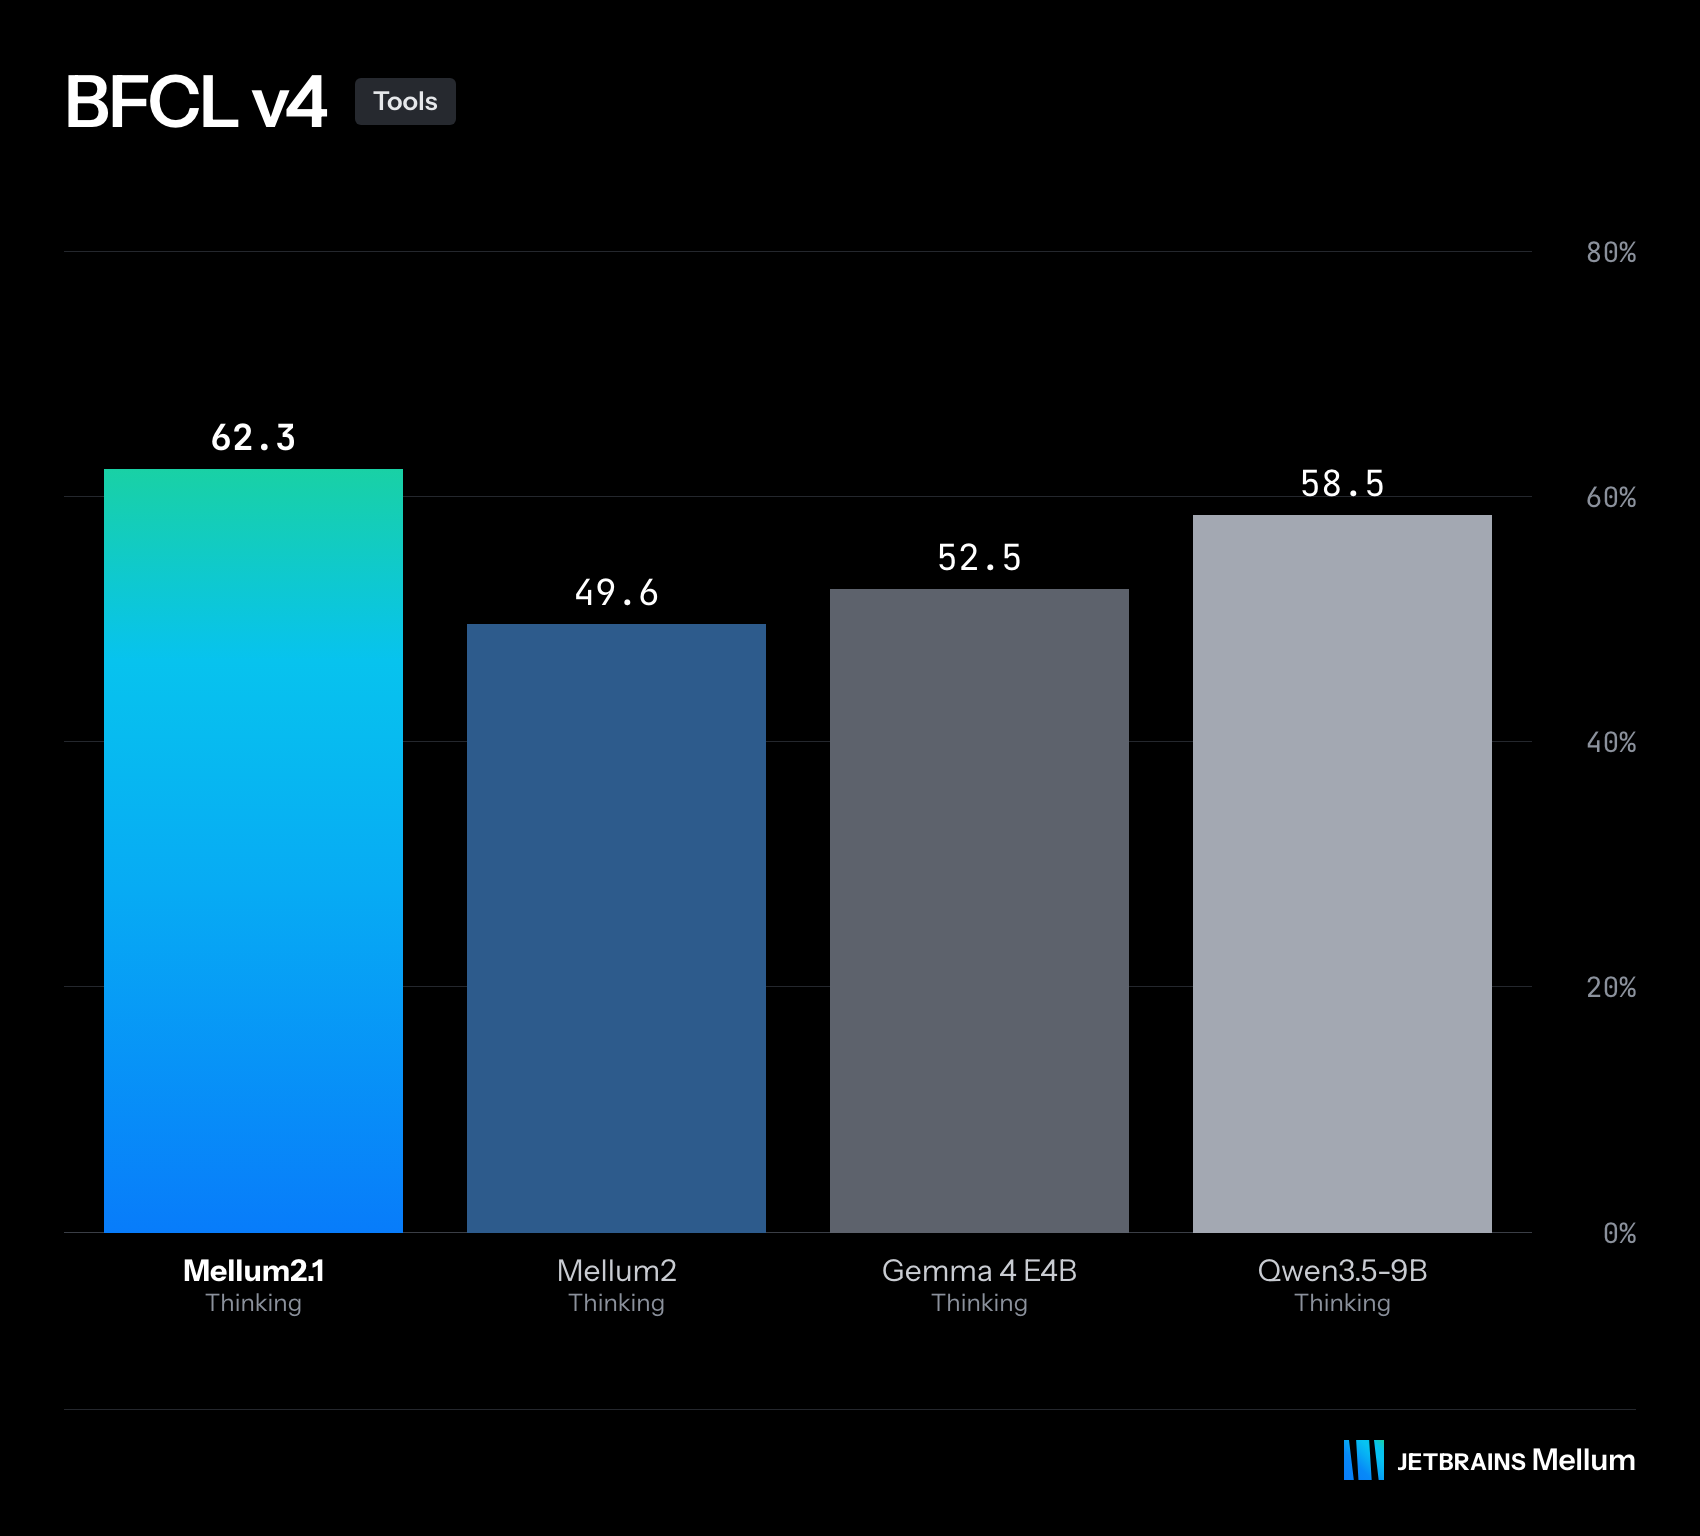
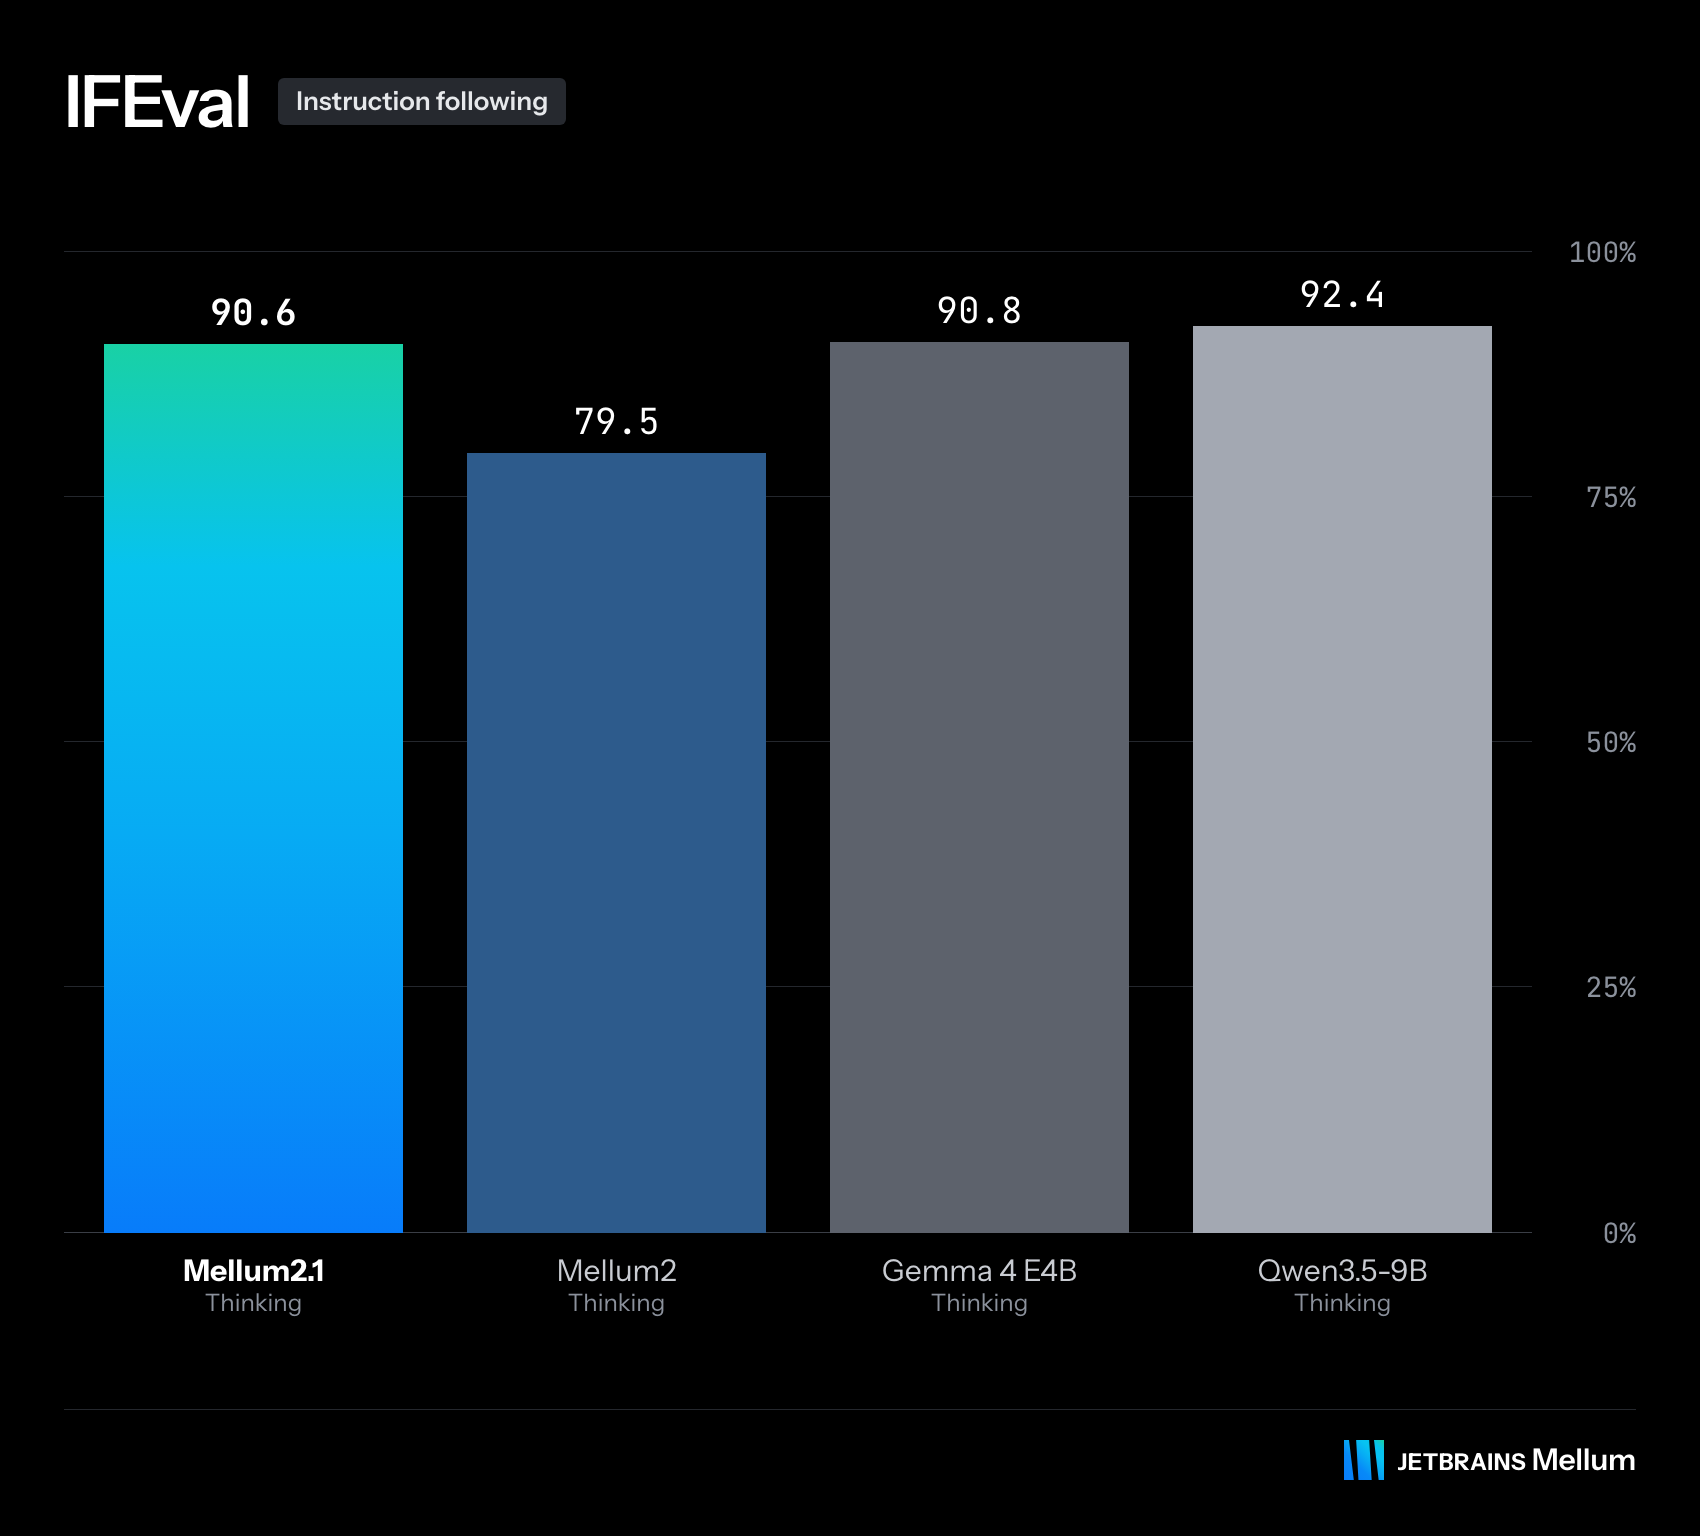
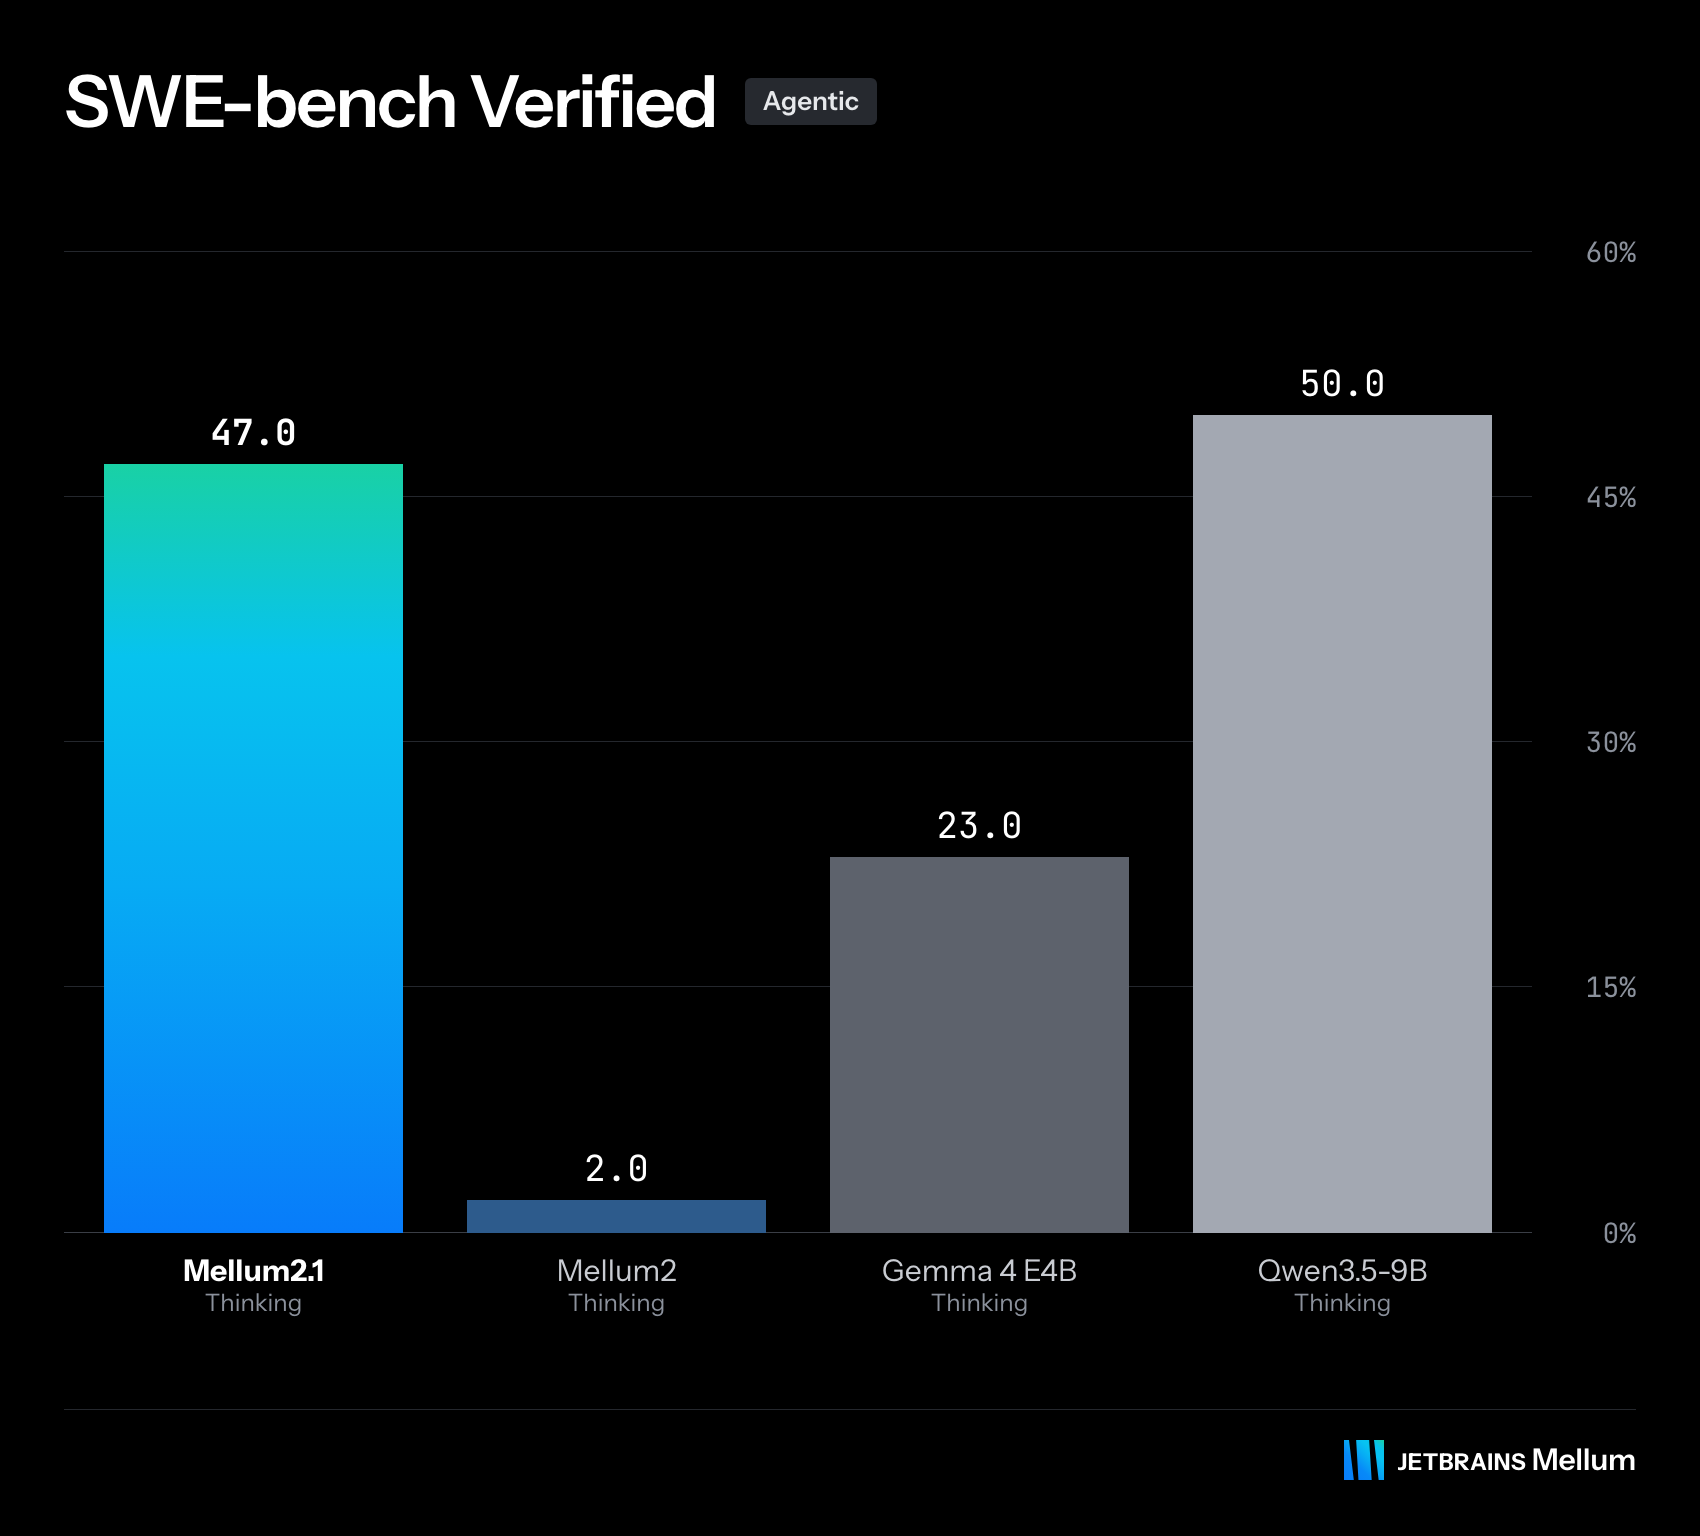
我们将 Mellum2.1 与 Mellum2——以及两个同类开放模型 Qwen3.5-9B 和 Gemma 4 E4B——进行了比较,对所有模型使用相同的评估设置。

最大的改进在智能体编码方面,与 Mellum2 相比,Mellum2.1 在这一领域进步最大。该模型在各方面也都有提升,在编码、竞技编程、数学、工具调用和通用知识方面均有增益,并且在难题和日常问题上都表现稳健。
速度
后训练没有改动架构,因此 Mellum2.1 与 Mellum2 一样快,而多 token 预测(MTP)让它更快。
在高负载下,Mellum2.1 是该组中最快的模型,处理的 token 数量几乎是 Qwen3.5-9B 的两倍。对于单个请求,MTP 使其速度提升约 1.6 倍。

Mellum2.1 的关键用例
- 智能体系统中的得力工作者:Mellum2.1 可以处理智能体计划的不同部分,从识别失败测试的根本原因到起草并检查修复方案。
- 编码之外的问题:Mellum2.1 也是一位有能力的通用助手。它处理日常问题,并逐步解决困难的数学和推理问题。
- 私有、自托管部署:在本地或你自己的基础设施上运行 Mellum2.1,让代码和数据完全处于你的掌控之中。
开始使用 Mellum2.1
Mellum2.1 已在 Hugging Face 上提供。用于 llama.cpp、Ollama 和 LM Studio 的 GGUF 构建,以及用于 vLLM 中推测解码的多 token 预测(MTP)头,即将推出。
如果你正在构建编码代理、子代理或运行在你自己基础设施上的 AI 工具,我们非常希望你能试用 Mellum2.1。告诉我们哪些好用、哪些不好用。你的反馈将塑造下一个版本。
开源是打造更好模型的方式。
了解更多
来源:Hacker News · blog.jetbrains.com