在 AWS Quick 中用 AI 驱动的产品开发生命周期管理(AI-PDLC)加速产品开发
Accelerating product development with AI-driven lifecycle management (AI-PDLC) in AWS Quick
AWS Quick 推出 AI-PDLC 框架,通过六个专用智能体覆盖 Discover、Decide、Design、Prototype 四个上游阶段,每个阶段均设人工审批关卡。
这篇博客文章重点介绍如何利用基于 AWS Quick 构建的智能体来改进和加速产品开发生命周期,并将人工审批内置于流程之中。
AI 驱动的软件交付正在帮助团队以前所未有的速度交付产品。随着实现速度加快,上游的产品开发流程变得更加重要。编码智能体可以比以往更快地将清晰的需求转化为可运行的软件,但它们无法弥补构建错误产品的代价。随着实现变得更容易,你的竞争优势向上游转移到四项关键活动:发现正确的客户问题、决定追求哪个机会、设计正确的体验,并通过原型进行验证。
做出这些决策所需的信号分散在各处。你的客户在 Slack 中留下反馈,销售团队在 Salesforce 中记录洞察,系统在 ServiceNow 中记录事件,利益相关者在 Microsoft SharePoint 中记录需求,工程师在 Jira 中跟踪工作项,团队在 Outlook 会议和电子邮件线程中做出决策。当你的团队在这些工具之间切换时,他们使上下文与它本应支撑的决策脱节,并且每次交接都会丢失更多信息。
AWS Quick 为这些碎片化知识提供了连接层。通过将自定义聊天智能体建立在已连接的企业数据之上,并将其产物存储在共享的 Spaces 中,AWS Quick 帮助你的团队基于现有的组织知识进行构建,而不是让每个新举措都从空白页开始。
AI 驱动的产品开发生命周期(AI-PDLC)是一个框架,它通过一套由六个具备专业技能的 AWS Quick 智能体组成的套件来应用这些能力,在每个阶段产出一组可追溯的产物。智能体收集并结构化上下文、揭示差距并起草产物。你和你的团队贡献判断力并批准每一项决策。目标不是更快地产出文档,而是帮助你的团队更好地思考、保留每项决策背后的原因,并为工程和编码智能体提供一份以客户证据为依据的规格说明。我们将向你展示如何在 AWS Quick 中配置六智能体 AI-PDLC 套件,并使用它从分散的客户信号推进到经过验证的原型。在整个过程中,它保留了从最初洞察到工程交接的上下文。
架构
该图展示了 AI-PDLC 框架的端到端流程。
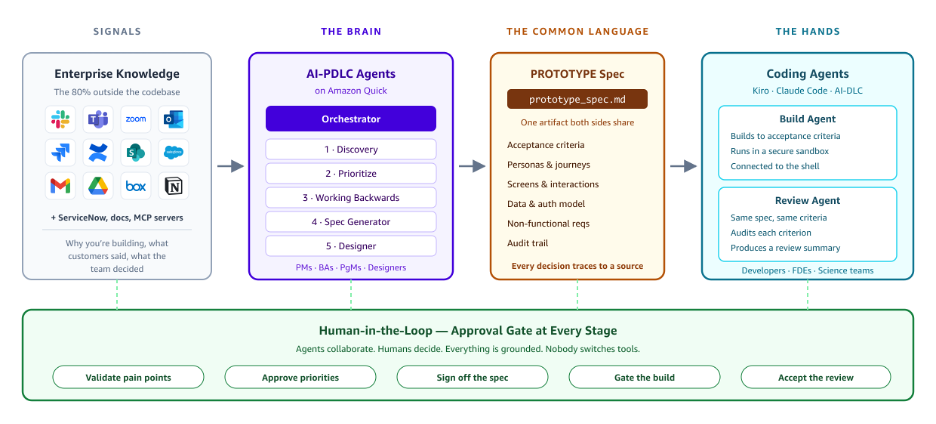
图 1:端到端 AI-PDLC 流程,从分散的企业信号经由 AWS Quick 智能体到编码智能体交接
它始于大多数团队容易丢失的信号,即 Slack 线程、Jira 工单、文档和通话记录,这些内容承载着决策背后的原因以及客户实际说了什么。企业连接器从 Slack、Outlook、Jira、Salesforce、SharePoint、ServiceNow 以及更多企业来源中提取这些上下文。
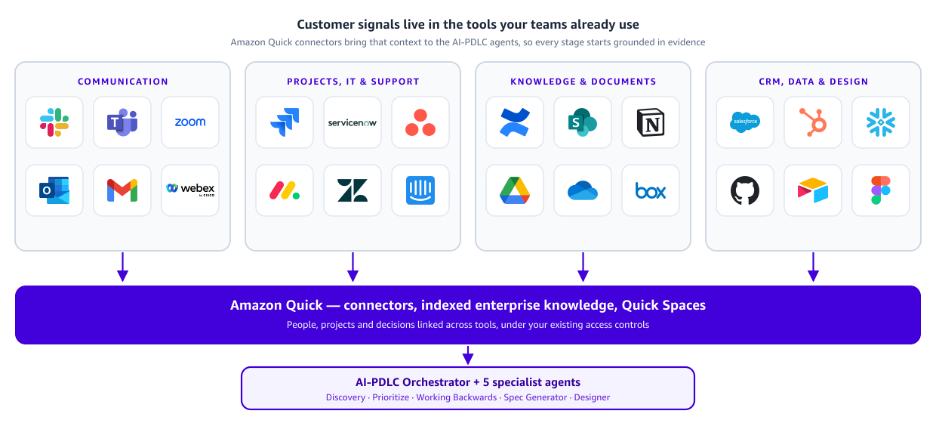
图 2:AWS Quick 构建个人知识图谱,将已连接应用和文件夹中的人员、项目和决策关联起来
AWS Quick 可以从你已连接的应用和文件夹构建个人知识图谱,将你的各个工具中的人员、项目和决策关联起来。
这些信号输入大脑:AWS Quick 上的一组智能体,由一个 Orchestrator 领导,运行 Discovery、Prioritize、Working Backwards、Spec Generator 和 Designer。它们产出的所有内容都汇聚为一种通用语言:一个 prototype_spec.md,其中包含验收标准、人物角色、屏幕和数据模型。每一项决策都可追溯到来源。
AWS Quick 可以使用 Agent Client Protocol (ACP) 将开发任务委托给 AI 编码代理。ACP 是一个开放的 JSON-RPC 2.0 标准,没有供应商锁定。客户可以使用他们偏好的编码代理(如 Kiro 或 Claude Code)基于 AI-PDLC 生成的规范进行构建。
在这一切之下,每个阶段都运行着人工审批关卡。你验证痛点、批准优先级、签署规范、把关构建并接受审查。然后生产数据回流到 Discovery,形成闭环。代理完成工作,而你做出决策,并且没有人需要离开自己的工具来完成这些。
解决方案概述
AI-PDLC 生命周期涵盖八个阶段:Discover、Decide、Design、Prototype、Engineer、Ship、Operate 和 Learn。本文重点介绍前四个阶段,即产品团队工作的部分。后四个阶段由编码代理(如 Kiro)处理,它们根据上游阶段产生的规范进行构建。上游阶段在 AWS Quick 中实现为六个代理。
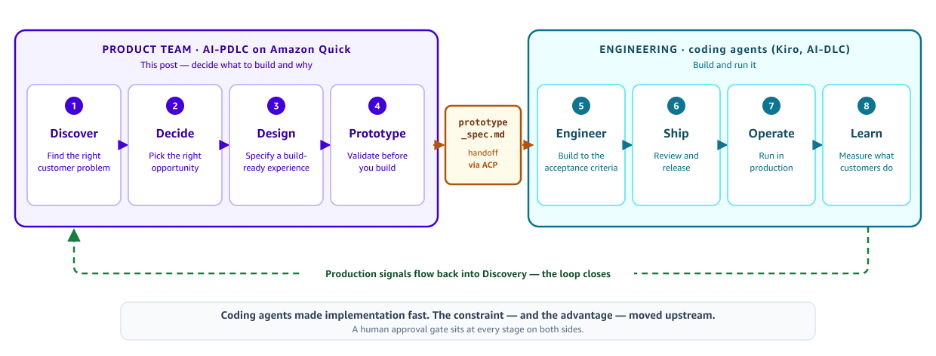
图 3:上游 AI-PDLC 阶段在 AWS Quick 中实现为六个代理
用户仅与一个 Orchestrator 交互,它在运行时读取每个专家的提问框架,针对当前阶段提出有针对性的问题,并将工件生成分派给正确的专家。一次对话驱动整个旅程,并且只有在工作流中每一步都经过人工批准后,流水线才会推进。
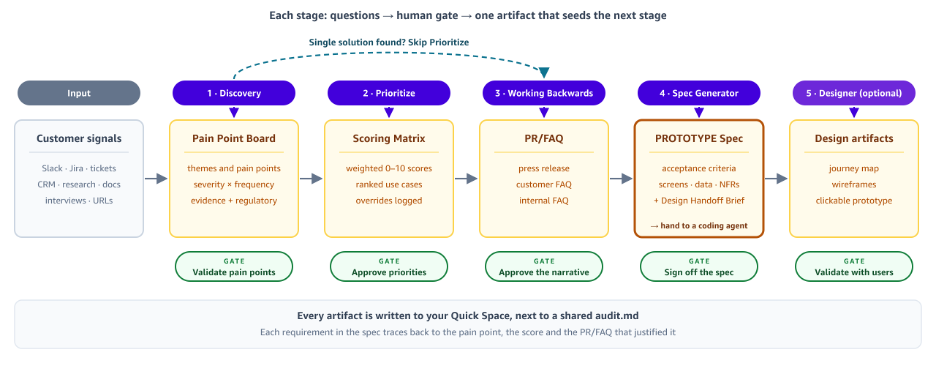
图 4:一次 Orchestrator 对话驱动流水线,只有在每个关卡获得人工批准后才会推进
阶段 1:Discover
Discovery 代理通过交互式问答、URL 摄取以及从 Slack、Jira、支持工单、Salesforce 和研究存储库等连接的企业来源直接拉取,引导结构化的痛点分析。它对每个痛点的严重程度和频率进行评分,生成一个痛点看板,为团队提供一个基于证据的视图,了解客户面临的困难。
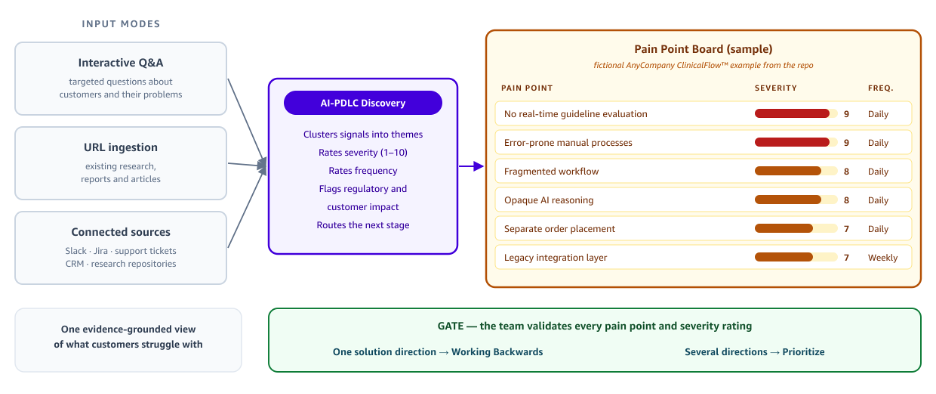
图 5:Discovery 代理生成按严重程度和频率评分的痛点看板
阶段 2:Decide
Prioritize 代理使用两个透明的 0–10 框架,根据加权标准对每个用例进行评分:一个专为代理式用例构建(大语言模型 (LLM) 能力匹配、工具可用性、用户接受度),另一个用于传统应用(可行性、业务影响、工作量)。团队可以打开评分矩阵,准确追踪为什么一个用例的排名高于另一个。
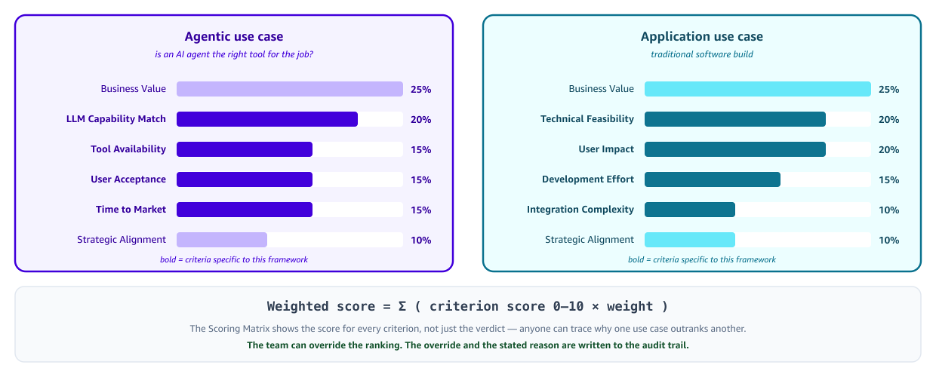
图 6:Prioritize 代理的评分矩阵显示了为什么一个用例的排名高于另一个
一旦选定了顶级用例,Working Backwards 代理就会使用 Amazon Working Backwards 方法生成完整的 PR/FAQ,包括客户 FAQ 和内部 FAQ,涵盖单位经济性、故障模式、监管风险和竞争格局。如果一个概念无法通过这种审查,团队会在投入工程资源之前就在纸面上了解到这一点。
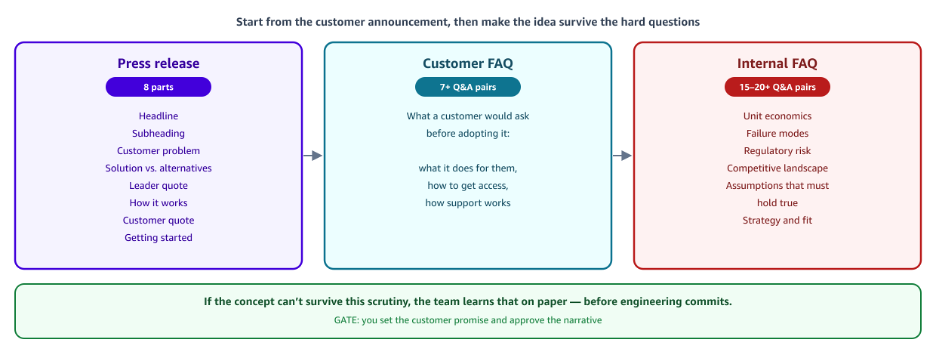
图 7:Working Backwards 代理为顶级用例生成完整的 PR/FAQ
阶段 3:Design
Spec Generator agent 将经过验证的用例和 PR/FAQ 转化为可构建的规格说明,为 agentic 用例和应用程序用例分别提供模板,并为 UX 团队提供一份 Design Handoff Brief。每份规格说明都包含验收标准、用户流程、约束条件以及元数据,这些元数据将每项需求追溯回其来源痛点、优先级评分以及验证它的 PR/FAQ。这些验收标准具有双重用途:它们既是编码 agent 遵循的构建契约,也是审查 agent 审计所依据的审查标准。过去需要多个冲刺的起草和审查工作,现在变成了一次专注的会话,其详细程度足以让工程团队直接从设计规格进行构建,几乎或完全不需要澄清会议。
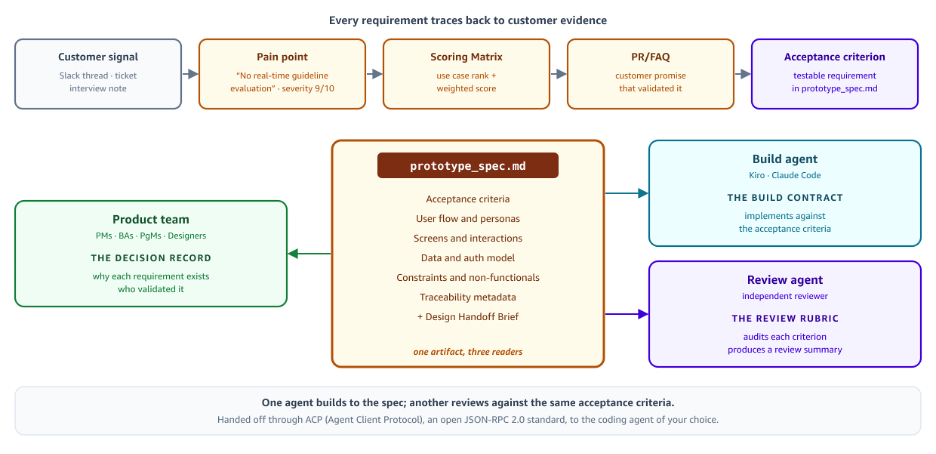
图 8:Spec Generator agent 将经过验证的用例转化为可构建的规格说明
阶段 4:原型
Designer agent 直接在 AWS Quick 内生成旅程地图、线框图和可点击的 HTML 原型。它依据 Design Handoff Brief、来自 Discovery 的人物画像、来自 PR/FAQ 的用户流程、待设计的界面、品牌背景以及从客户引述中提取的情感目标来工作,因此团队可以在承诺使用 Figma 或其他设计工具之前与利益相关者验证概念。规格说明获批后,会被派发给工程团队进行开发。
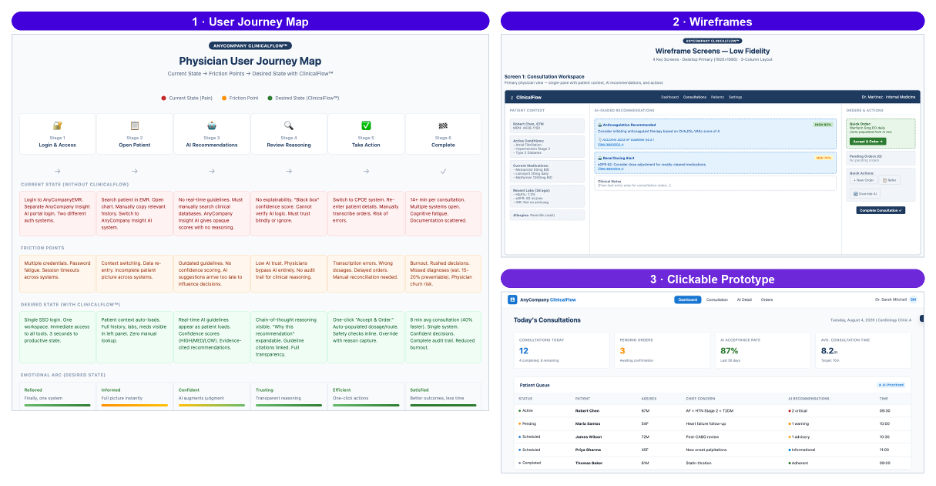
图 9:Designer agent 在 AWS Quick 内生成旅程地图、线框图和可点击原型
整个循环是迭代式的,在每个关口都由人工进行审查和批准。没有明确的签字确认,任何内容都不会发布。根据问题的复杂程度,传统上需要数周的原型制作和迭代,可能变成数天甚至仅数小时的有引导的 agent 协作。
每个决策都在两个层级上被记录。每个专家 agent 在其产出的工件中记录自己的决策、评分和理由,而 Orchestrator 则独立检查这些条目是否存在,同时在整个流水线中维护一份共享日志。如果某一层出现疏漏,另一层仍能保留完整记录,因此没有任何关口审批会失去追踪。
AI-PDLC 可以以两种节奏模式执行。Deep Discovery 每个阶段提出 8–12 个问题,追查模糊之处和边缘情况。它适合团队希望进行彻底探索的新问题空间。Fast Track 将每个阶段缩减为 3–5 个关键问题,并根据其已掌握的上下文建议默认值,让你确认或覆盖每一个默认值。它适合团队熟悉该领域且需要快速推进的限时会话。
Agent 实现细节:分步说明
我们将逐步介绍 agent 创建和实现过程的细节。
前提条件
- 已安装桌面客户端的 AWS Quick 工作区。
- 在 AWS Quick 中创建自定义 agent 的权限,并已为 Slack、Jira、SharePoint 或团队使用的其他工具配置好企业连接器。
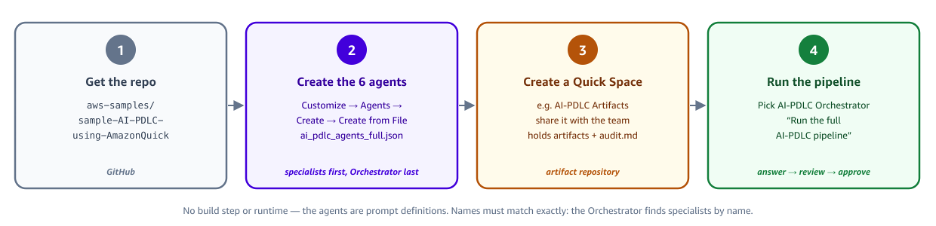
图 10:已配置企业连接器的 AWS Quick 工作区
步骤 1:克隆 AI-PDLC 仓库
完整的 agent 套件、参考架构、提示模板和设置说明可在 AI-PDLC GitHub 仓库中获取。
该仓库包含:
- 全部六个 agent 的 agent 指令文件。
- 每个专家 agent 的问题框架示例。
- 配置文件和设置指南。
步骤 2:创建专家 agent
在 AWS Quick 中,使用仓库中的指令创建专家 agent:
步骤 2.1:从用于构建 agent 的 GitHub 仓库下载 JSON 文件。
步骤 2.2:转到 Quick Desktop → Customize → Agents → Create,然后选择 Create from File。
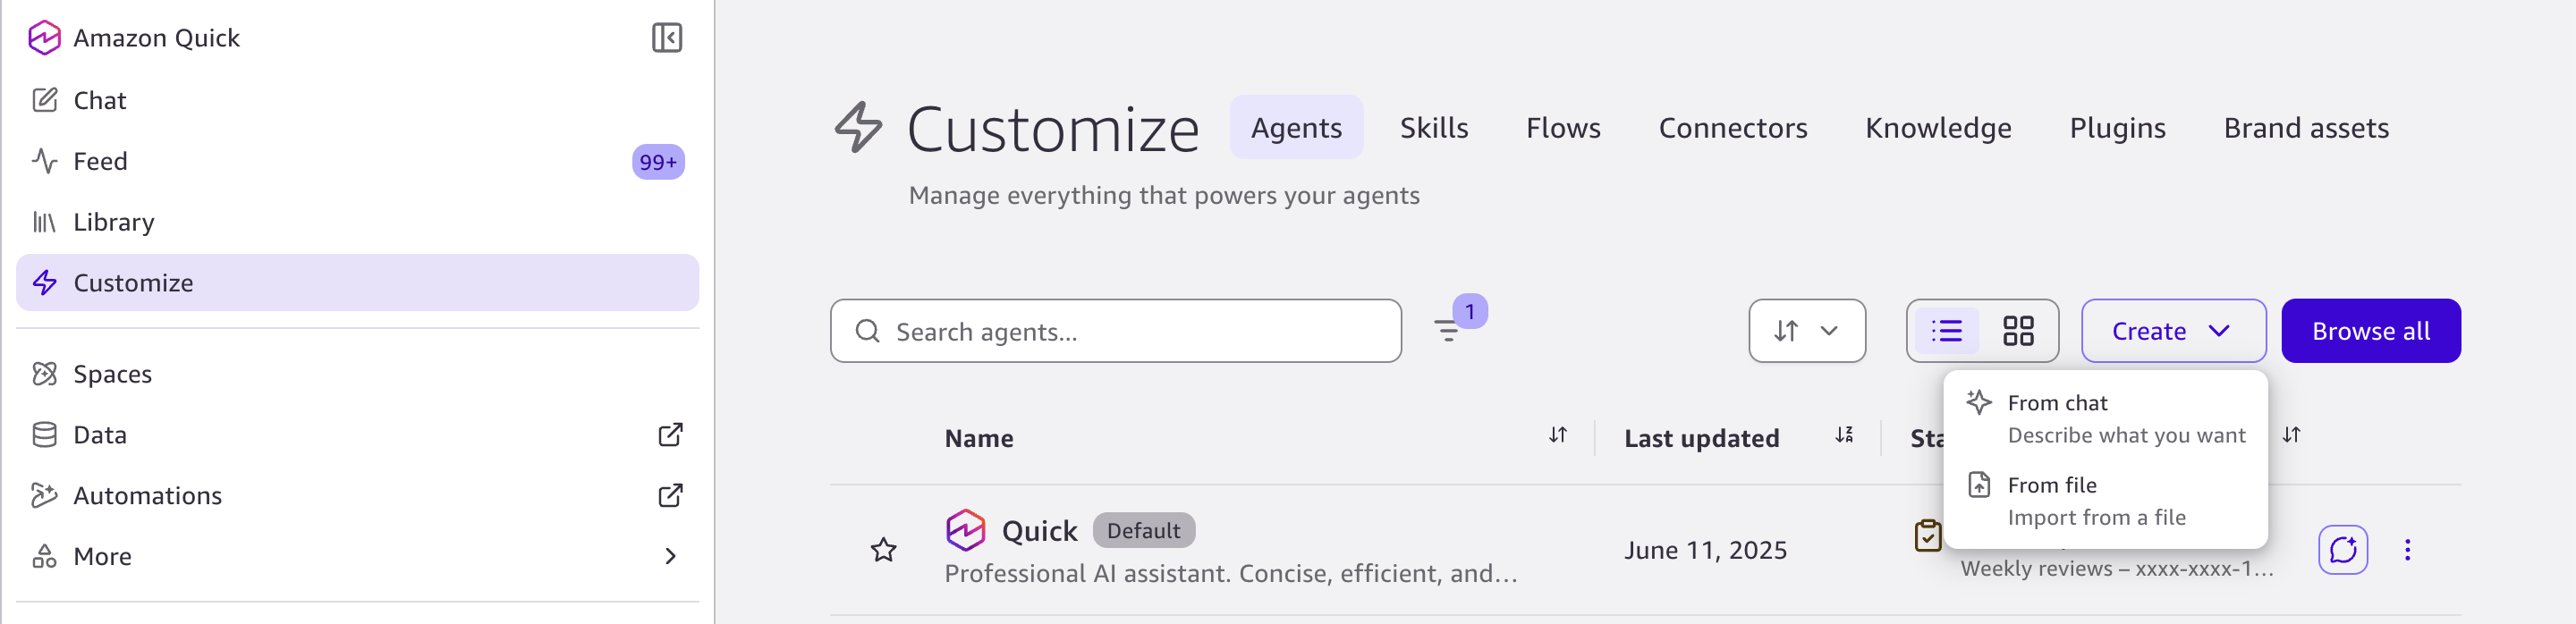
图 11:在 Quick Desktop 中使用 Create from File 创建专家 agent
步骤 2.3:聊天窗口打开。
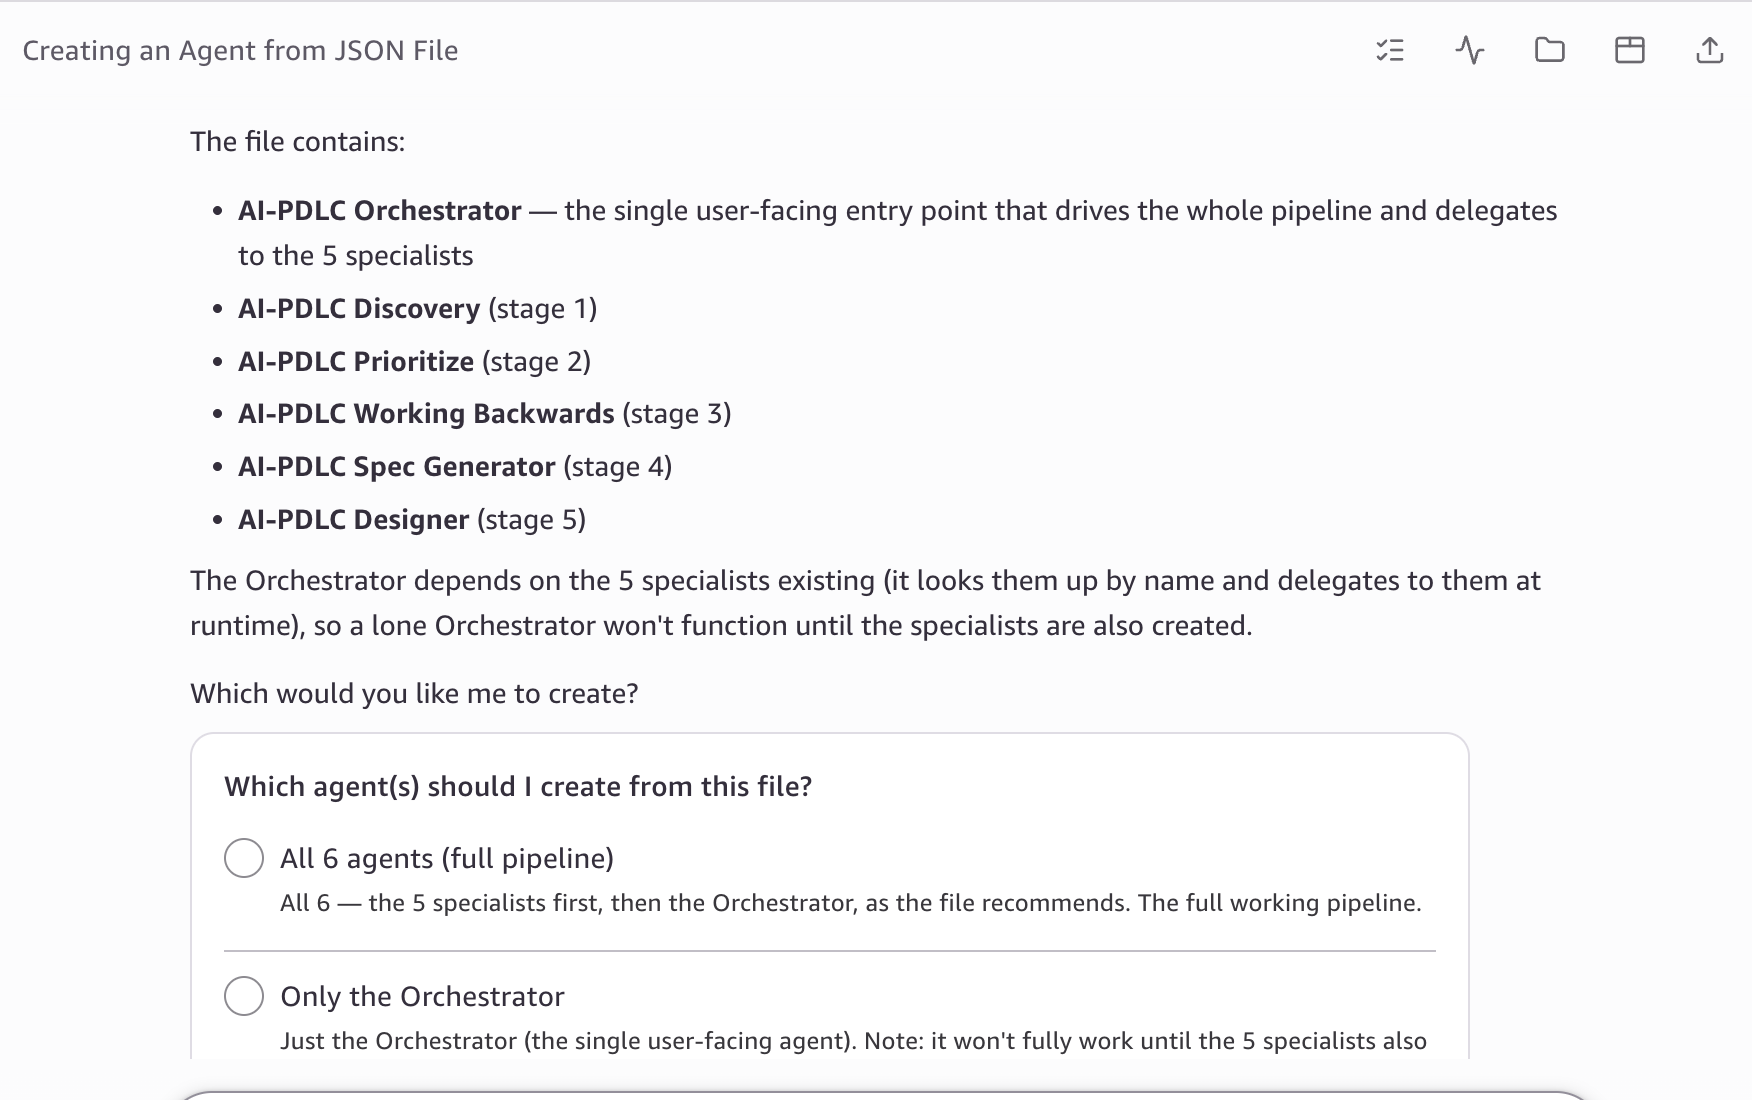
图 12:创建 agent 期间打开的聊天窗口
步骤 2.4:创建了以下六个带有指令的 agent:
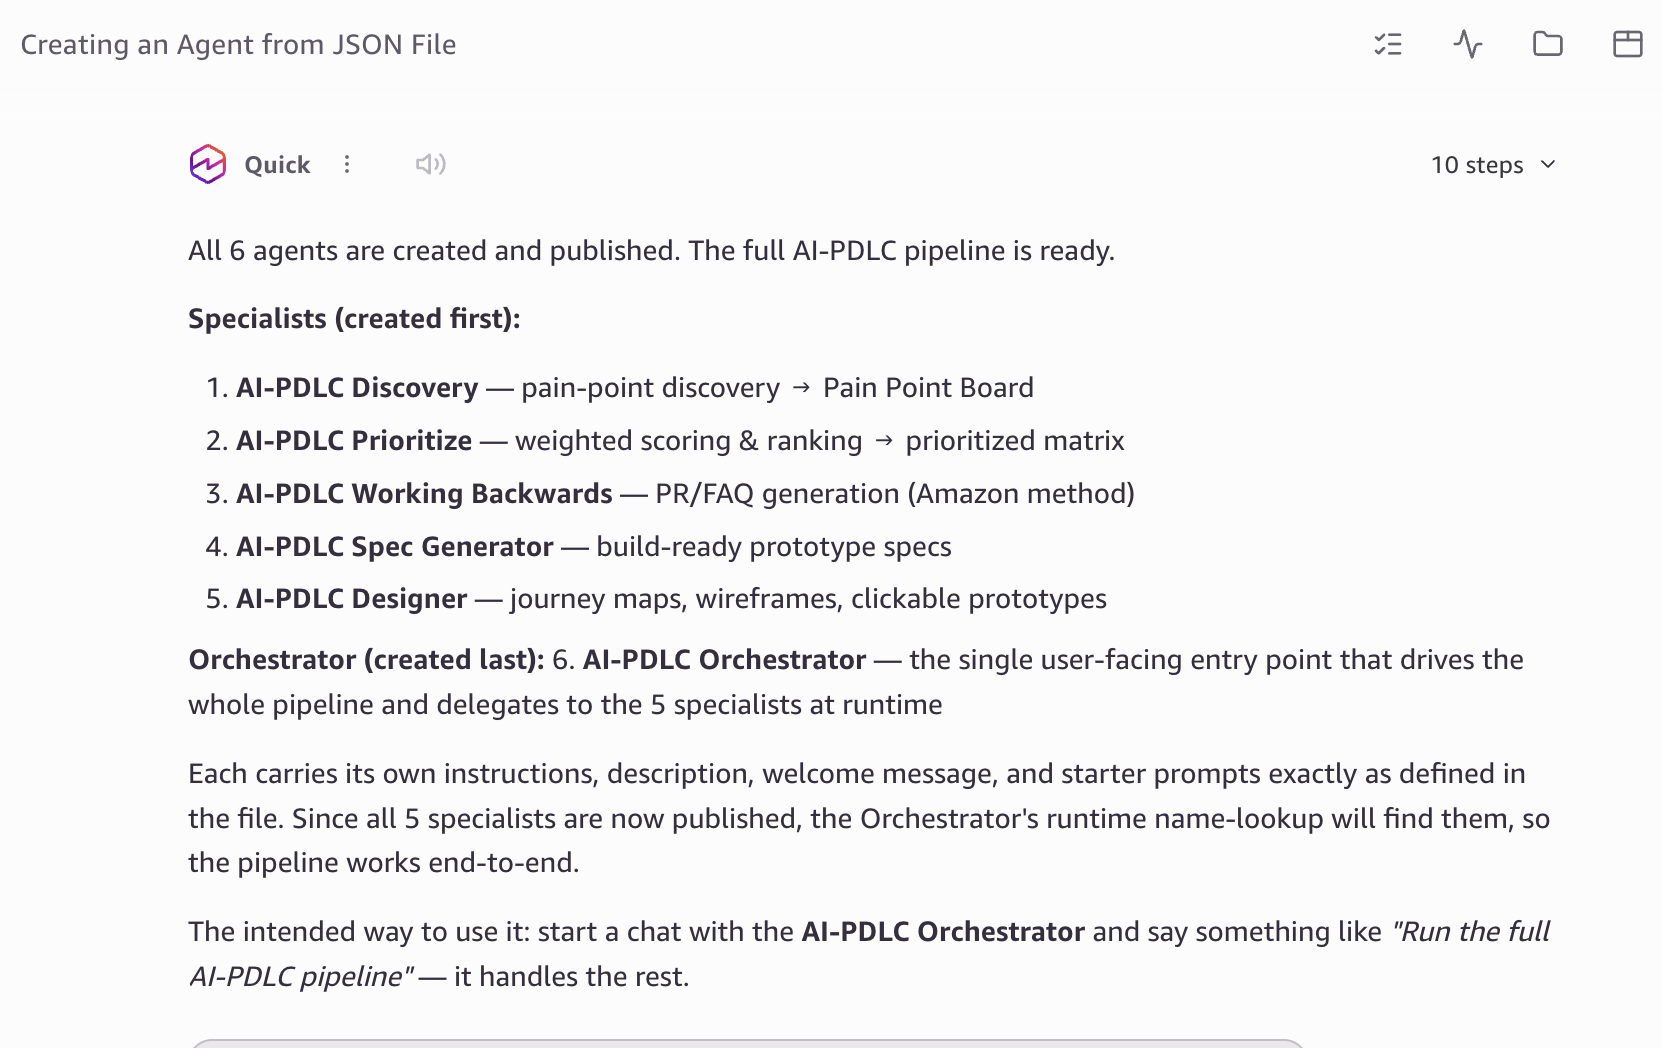
图 13:创建的六个 AI-PDLC agent 及其指令
Orchestrator 是核心架构组件。它在运行时动态读取每个专家的指令:
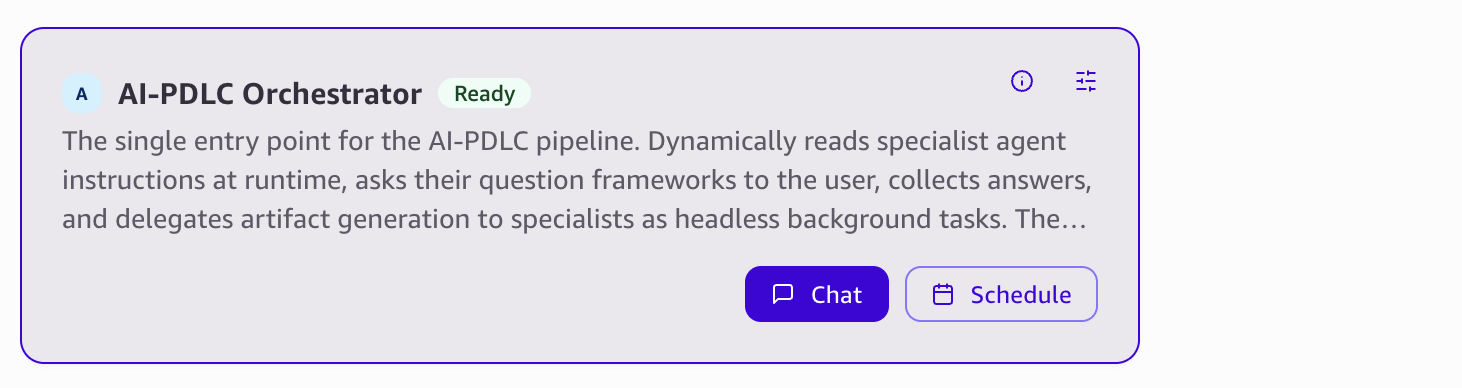
图 14:Orchestrator 在运行时动态读取每个专家的指令
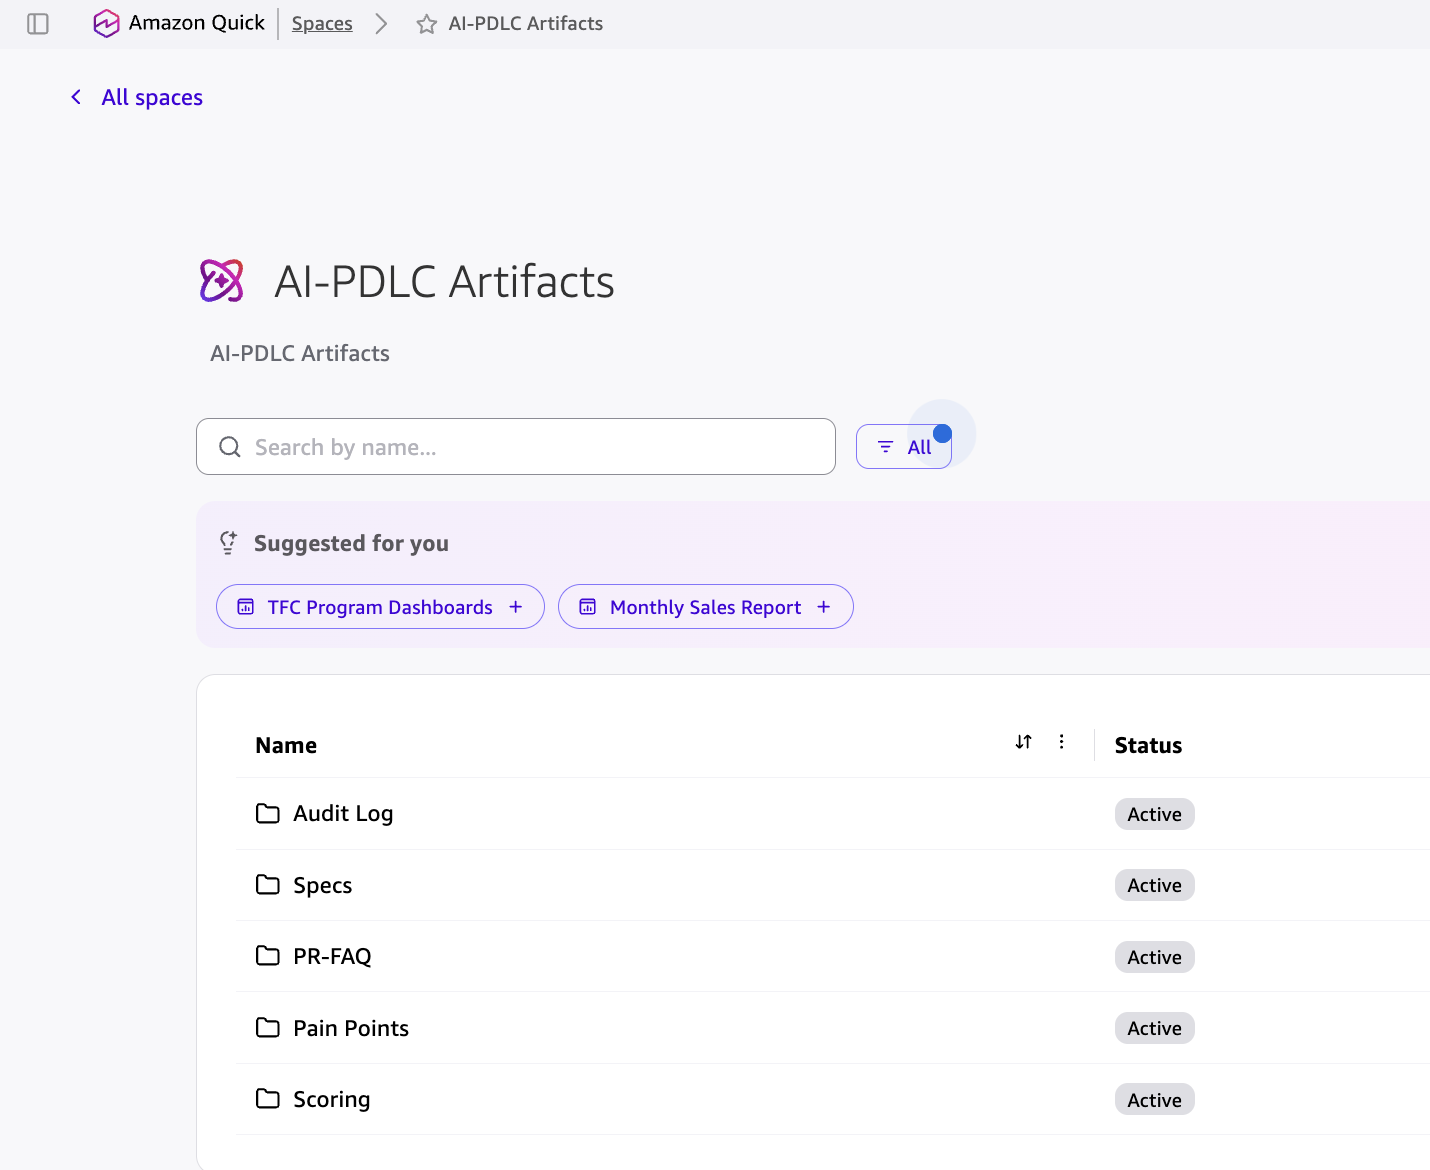
步骤 3:配置 Quick Spaces(工件仓库)
创建一个共享 Quick Space 用于存储流水线工件:
- 打开 Quick Spaces 并选择 Create New Space。
- 名称:AI-PDLC Artifacts。
- Grant access to relevant team members.

图 15:创建 AI-PDLC Artifacts Space 并向团队成员授予访问权限
步骤 4:运行流水线
- 打开 AWS Quick Desktop。
- 从 agent 选择器中选择 AI-PDLC Orchestrator。
- 输入:“Run the full pipeline”(或输入“Fast Track”以进行简化会话)。
- 在 Orchestrator 引导你完成每个阶段时,回答它的结构化问题。
- Review artifacts as they are produced at each gate.

图 16:运行流水线并在每个关卡产出工件时查看它们
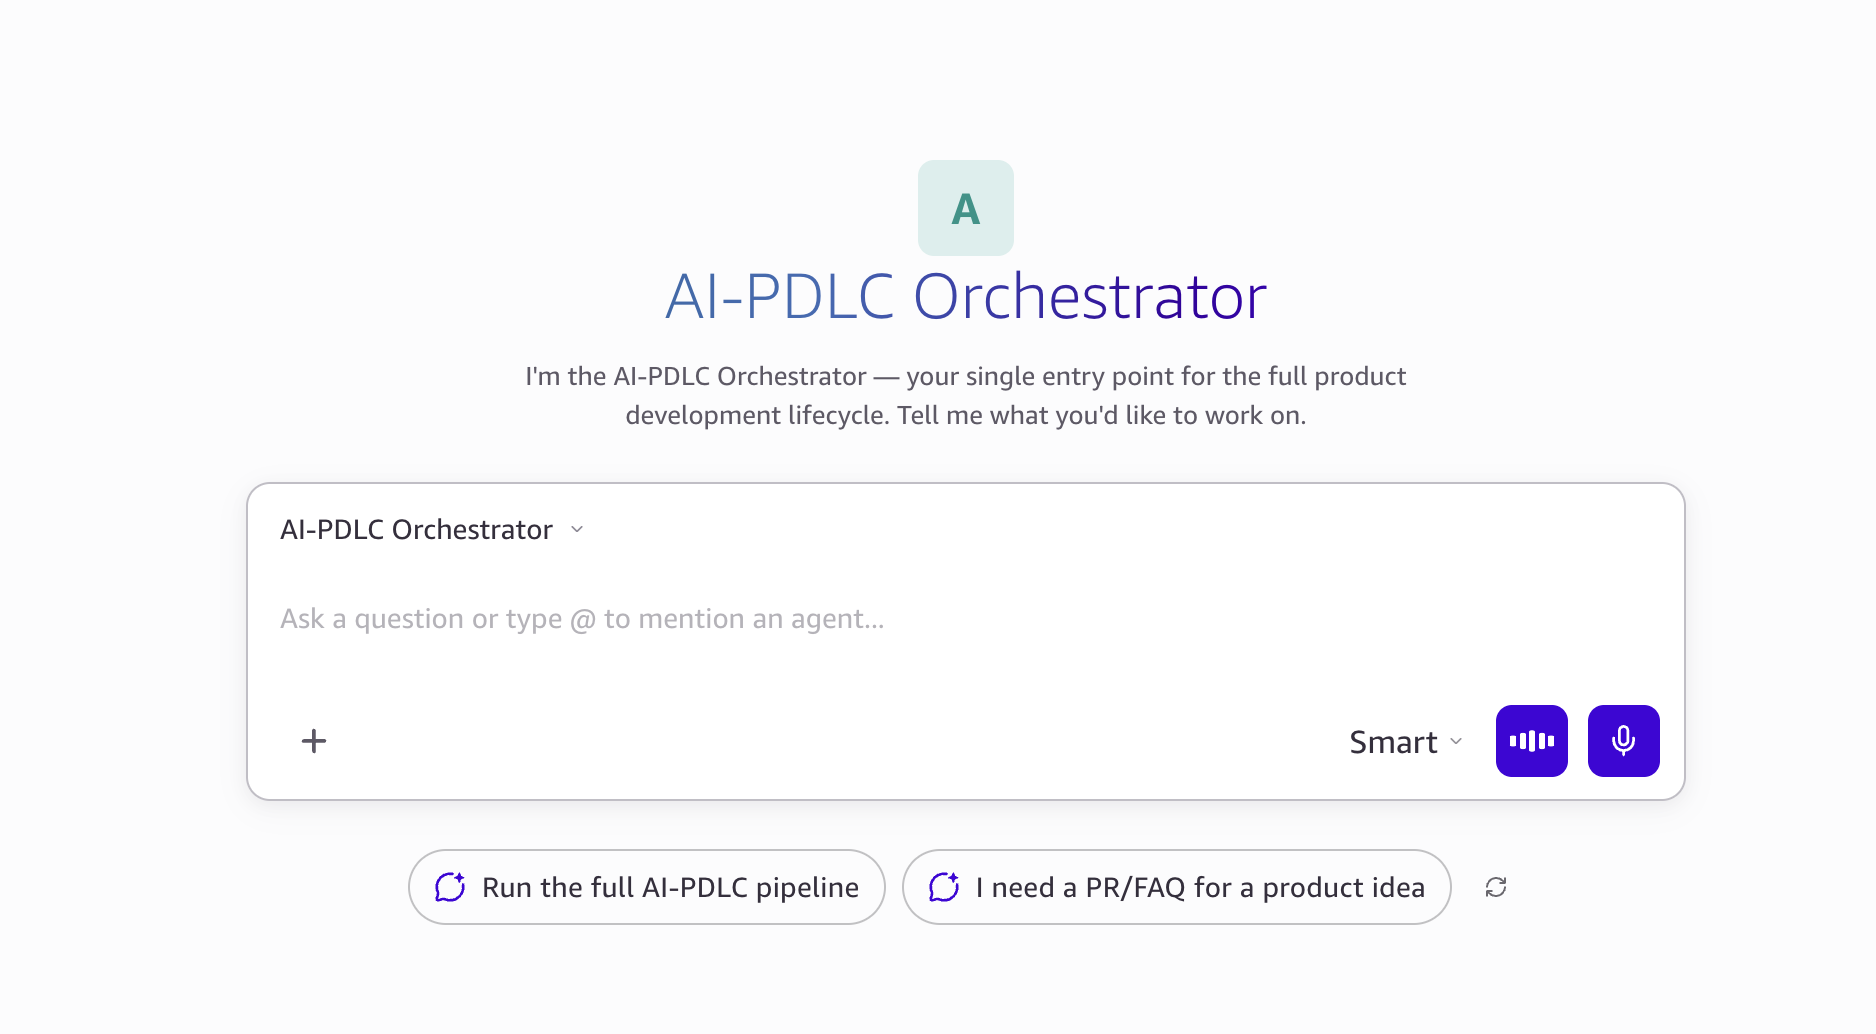
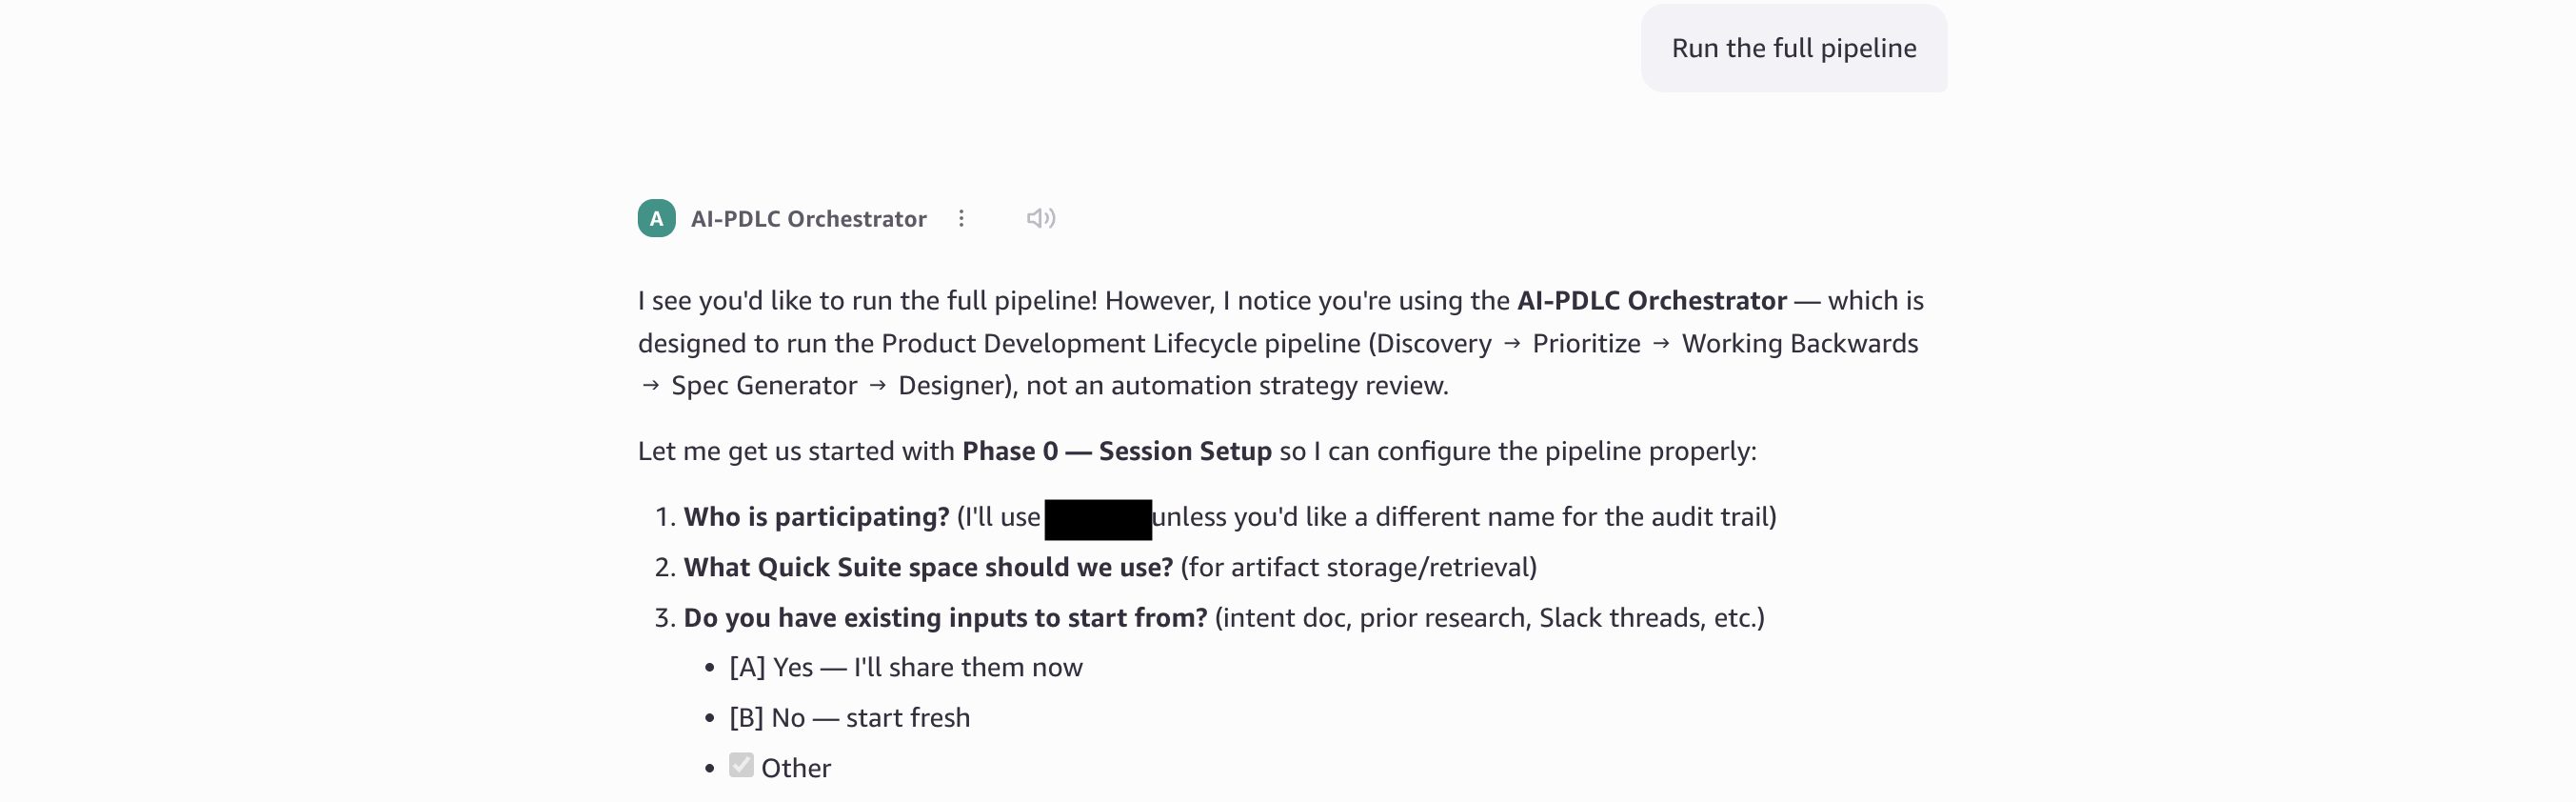
图 17:使用 AI-PDLC Orchestrator 启动流水线运行
你可以根据需求选择节奏:Deep Discovery 或 Fast Track。
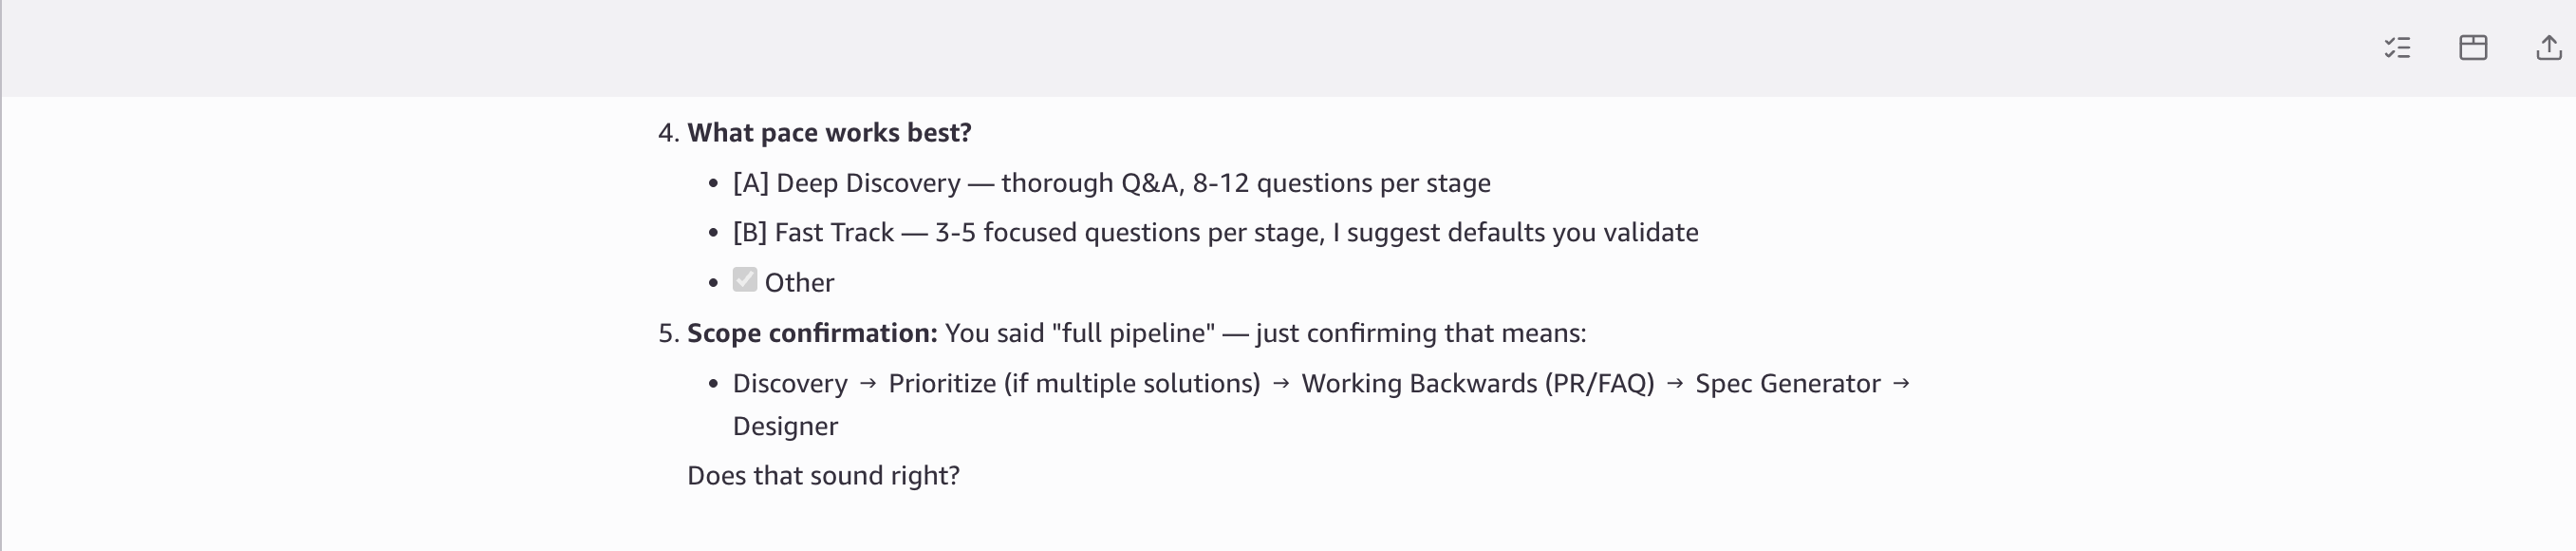
图 18:根据需求选择节奏:Deep Discovery 或 Fast Track
观看实际演示
如需观看 AI-PDLC 的实际演示——从客户洞察到全部四个阶段,再到可运行的原型——请观看我们的 YouTube 视频演示:
视频涵盖:
- 搭建 agent 套件。
- 通过真实用例运行完整的 Orchestrator 流水线。
- 实时工件生成演示。
- 向编码 agent 的 ACP 交接。
- 在 Deep Discovery 和 Fast Track 模式之间进行选择的技巧。
AI-PDLC 场景
我们将介绍一些可应用 AI-PDLC 框架的常见场景:
场景 1:从零开始的新产品开发
当团队发现新的市场机会或未被满足的客户需求时,他们会面临典型的冷启动问题:信号分散、想法相互竞争,且没有从洞察到行动的结构化路径。AI-PDLC 引导团队完成完整的上游旅程,从真实客户数据中挖掘痛点,并根据透明标准为相互竞争的想法评分。它还通过严格的 PR/FAQ 验证概念,并产出可构建的规格说明,使第一行代码基于经过验证的计划而非猜测来编写。
场景 2:为现有产品添加功能,由路线图驱动或由客户驱动
产品团队持续收到各种信号,这些信号为他们下一步构建什么提供依据:支持渠道中的客户反馈、来自销售的功能请求、显示流失点的使用数据,或来自领导层的战略优先级。AI-PDLC 通过从已连接的工具(Slack、Jira、Salesforce、AWS Quick Sight)中提取这些信号来加速这一过程。该框架将它们整理成带有证据支撑评分的优先级待办列表,并生成一份规格说明,保留每个功能背后的“原因”,因此工程团队收到的是上下文丰富的工作项,而不是剥离了意图的一行式 Jira 工单。
场景 3:缺陷修复和事件驱动的改进
当生产问题通过客户投诉、监控告警或支持升级浮现时,响应往往跳过结构化分析,直接跳到代码修复。AI-PDLC 通过将根本原因记录为有文档的痛点,为这一被动式工作流带来纪律性,评估修复是否值得更广泛的设计变更还是针对性补丁。它生成一份范围明确的规格说明,包含可测试的验收标准,使修复解决底层问题而不仅仅是症状,并且决策轨迹被保留以供未来参考。
每个场景都遵循相同的流水线(发现 → 决策 → 设计 → 原型),但进入深度不同。新产品运行完整旅程,功能新增可能跳过深度发现,缺陷修复可能压缩为单个聚焦周期。方法论会自适应,而审计轨迹和治理无论何种情况都保持一致。
清理
本演练创建的资源在闲置时不产生任何费用,因此如果你计划再次运行该流水线,可以安全地保留整个 AI-PDLC 套件。
要移除不再需要的内容,请在 Quick Desktop 中删除 Customize → Agents 下的六个代理,删除 AI-PDLC Artifacts 空间(或仅删除其中的测试工件)并撤销你授予的任何团队访问权限,以及断开你仅为本次练习添加的任何 Enterprise 连接器或编码代理链接。你还可以从本地机器移除克隆的 GitHub 仓库。
结论
产品开发的瓶颈已经转移。编码代理使实现变得快速。然而,上游工作仍然制约着团队:发现客户问题、决定构建什么、验证概念,以及产出清晰的规格说明。压缩这一上游周期的团队可以获得复利优势:他们更快地构建正确的产品,并减少代价高昂的转向。
AI-PDLC 直接解决了这一问题。它提供了一个结构化的、AI 原生的框架,以 AWS Quick 中的一套代理实现,引导产品团队完成发现、决策、设计和原型,并在每个关口内置治理。AI-PDLC 为每个决策赋予归属。每个工件都可追溯到客户证据。当规格说明到达工程团队时,它携带了完整上下文:为什么存在、谁验证了它,以及“完成”是什么样子。
产品团队的职责不是写代码。而是快速且可追溯地就构建什么以及为什么构建做出正确决策。AI-PDLC 使这成为可能。
立即开始
- 克隆仓库。
- 按照仓库中的设置指南创建五个专家代理和一个 Orchestrator。
- 从代理选择器中选择“AI-PDLC Orchestrator”并说:“Run the full pipeline”。
关于作者

Vishnu Elangovan
Vishnu 是全球 Agentic AI 解决方案架构师,在应用 AI/ML 和深度学习领域拥有十余年经验。他热衷于构建和改进可扩展的 AI/ML 解决方案,并视自己为终身学习者。Vishnu 是 AI/ML 社区中值得信赖的思想领袖,经常在领先的 AI 会议上演讲,并在顶级活动中分享他在 Agentic AI 方面的专业知识。

Debaprasun Chakraborty
Debaprasun 是 AWS 解决方案架构师,专攻 AI/ML 和分析领域。他拥有约 20 年的软件开发和架构经验。他热衷于帮助客户踏上 AI 之旅、采用云、迁移和制定战略。

Anupa Bhattacharyya
Anupa 是 Amazon Web Services 的高级技术客户经理,她帮助企业在生成式 AI 和 Agentic AI 领域加速云之旅。凭借超过 15 年的经验,她设计战略举措,将新兴 AI 能力转化为真实的客户成果,并且她经常在会议上演讲,乐于与更广泛的技术社区分享她的工作。工作之余,她喜欢绘画、旅行、与家人共度时光以及品尝新美食。
来源:AWS Machine Learning Blog · aws.amazon.com