用 Denodo 和 Amazon Bedrock AgentCore 在 AWS 上为智能体 AI 构建语义层
Build a semantic layer for agentic AI on AWS with Denodo and Amazon Bedrock AgentCore
AWS 博客演示用 Denodo Platform 替代 Stardog 作为语义层,通过 Denodo MCP Server 向托管在 Amazon Bedrock AgentCore 上的智能体暴露受治理视图,并新增本地 PostgreSQL 数据源与 Aurora、Redshift 联邦为单一 customer 360 视图。
Agentic AI 应用需要对实时企业数据进行受治理的访问。这些数据可能位于运营系统、分析型数据仓库、SaaS 应用、其他云或本地环境中。在本系列的上一篇文章中,我们在 AWS 上构建了一个语义层,使用 Stardog 的知识图谱覆盖 Amazon Aurora 和 Amazon Redshift。Amazon Bedrock AgentCore 上的 Strands 智能体查询了该语义层。Amazon Bedrock AgentCore 是一个用于大规模构建、连接和优化智能体的平台,支持任意框架或模型。本文沿用相同的客户 360 模式,但换用了不同的语义层实现,并扩展了数据源组合。
这里有两处变化。第一,语义层改为 Denodo Platform:一个 AI 数据层,提供主动上下文以及对分布式企业数据的实时、零拷贝访问。智能体使用 VQL(Denodo 的 SQL 方言)与其交互。第二,数据源组合中除了 Amazon Aurora 和 Amazon Redshift 之外,还包含一个本地 PostgreSQL 数据库,因此联邦查询问题不再局限于 Amazon Virtual Private Cloud(Amazon VPC)之内。
该模式的其余部分保持不变。Amazon Bedrock 上的基础模型负责规划并编写查询。Denodo MCP Server 通过 Model Context Protocol(MCP)向智能体暴露受治理的视图。Amazon Bedrock AgentCore 托管智能体,终止入站身份验证,并管理智能体向 Denodo 出示的出站凭证。模型推理所依赖的一切都位于语义层中,而非提示词中:连接、指标定义,以及适用于调用方的行级和列级过滤器。
读完本文后,你将了解:
- 如何在 Denodo 中将 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库联邦为智能体可查询的单一客户 360 视图。
- 如何通过 Denodo MCP Server 将该语义视图暴露给由 AgentCore 托管的智能体,以及如何将 MCP Server 注册为 AgentCore Gateway 目标。
- 最终用户身份如何从企业身份提供商经由 AgentCore Identity 的 On-Behalf-Of 令牌交换流转到 Denodo。
- 全局安全策略如何在查询时应用行级和列级过滤器。
- Denodo 在 AWS 上的两种部署选项:Agora(全托管云服务),以及在 Amazon Elastic Compute Cloud(Amazon EC2)或 Amazon Elastic Kubernetes Service(Amazon EKS)上的自管理安装。
我们假设你已熟悉上一篇文章中的语义层架构:它是什么、用途是什么,以及为什么模型负责规划查询而不拥有连接。如果这些内容对你来说是新知识,上一篇文章已涵盖相关基础。
示例:数据源位于 AWS 之外的客户 360
我们沿用上一篇文章中的客户 360 模式。上一篇文章使用的 Stardog C360 Knowledge Kit 为一个电商零售商建模,包含两个驱动用例:理解客户流失,以及识别可自动注册奖励计划的客户。本文中模式不变。变化的是其中一张表的位置:rewards_account 位于本地 PostgreSQL 集群上,而非与其他客户资料数据一起存放在 Amazon Aurora 中。
这个位置并非特例。企业数据源可能位于 AWS 之外:本地部署、CRM 这类 SaaS 工具中,或另一个云上。语义层必须能够触达适用的任何位置。我们在演练中使用本地部署的 PostgreSQL 来表示来自第三方应用的数据。扩展到其他数据源一节介绍了当数据源是 SaaS 工具、CRM 或大型机时会有哪些变化。它还涵盖了 Denodo 默认支持的其他数百个数据源。
Amazon Aurora(兼容 PostgreSQL):客户档案
| 表 | 关键列 |
| customer | cid(主键)、first_name、last_name、email、ssn、phone、location |
| address | id(主键)、city、state、zip、street_name |
| credit_card | id(主键)、cid、card_num、card_type |
Amazon Redshift:订单历史
| 表 | 关键列 |
| order | id(主键)、cid、pid、order_date、quantity、price、card |
| product | id(主键)、name、brand、price、dept |
本地部署 PostgreSQL:奖励计划
| 表 | 关键列 |
| rewards_account | id(主键)、cid、account_id、create_date |
共享标识符是 cid,一个普通整数,作为 Aurora 客户表中的主键出现。它在 Amazon Redshift 订单表和本地部署的 rewards_account 中作为非外键列出现。在 Aurora 内部,customer.location 列是指向 address.id 的整数外键,档案正是通过它关联到地址记录。没有任何外键跨越两个引擎,也没有 ETL 作业来构建这样的外键。将客户与其购买记录及奖励计划注册情况关联起来的查询,必须在查询时协调 cid。
这套设置能够回答的一个典型问题是:“在我们按生命周期消费额排名前 20 的客户中,哪些尚未注册奖励计划?”这是 Stardog 套件中的自动注册场景,需要来自 Aurora 的档案数据、来自 Amazon Redshift 的生命周期消费额,以及来自本地集群的注册状态才能回答。
Denodo 在执行时规划联邦查询,决定将哪些内容下推到 Aurora、哪些下推到 Amazon Redshift、从本地集群获取哪些内容,以及如何合并结果。数据不会在数据源之间移动,语义层只需声明一次,供每个使用方复用。
本文中使用的 Denodo 术语
Denodo 以数据虚拟化平台的形式实现语义层。Denodo Virtual DataPort (VDP) 是核心的查询引擎:语义层对象存放在这里,VQL 在这里执行,访问策略也在这里评估。Design Studio 是 VDP 基于浏览器的创作界面。本文中建模的每个对象都在那里定义。
有三种对象类型反复出现。
- 基础视图是源系统中的物理表、API 或文件与 VDP 中的逻辑视图之间的映射。一张 Aurora 表映射到一个基础视图。
- 派生视图是对一个或多个基础视图或其他派生视图的 VQL 查询。本文中的
customer_360视图就是一个派生视图。 - 指标视图一次性定义业务度量(例如
lifetime_customer_value),并允许其他派生视图引用它。指标视图将度量的定义与使用它的任何具体查询分离开来。
VQL 是 Denodo 的 SQL 方言。它是与 ANSI 对齐的 SQL,外加一组 Denodo 特有的构造,尤其是用于表示数据源的 DDL 构造,以及语义指标视图的语法。在智能体场景中,VQL 的具体语法由一项技能提供,LLM 在使用 Denodo 工具时会调用该技能,以帮助正确使用 Denodo 的语法。
全局安全策略(GSP)是一种运行时访问控制规则,适用于带有特定标签的视图或列。GSP 是行过滤器和列掩码在查询时强制执行的方式,并按调用者逐一评估。
如需更完整的参考,请参阅 Denodo Platform 文档。
参考架构
运行时包含两条流程。入站:客户端通过 Amazon Bedrock AgentCore Gateway 将用户请求发送给智能体。Gateway 会针对企业身份提供方(IdP)验证标识人类用户的 JSON Web Token(JWT),然后将请求路由到 Amazon Bedrock AgentCore 运行时,后者托管 Strands 智能体进程。智能体调用 Amazon Bedrock 上的基础模型(本演练中为 Anthropic Claude Sonnet 4.6)来解释提示并规划查询。
出站:AgentCore Gateway 还充当智能体工具调用的出站代理。Denodo MCP Server 作为 MCP 目标注册在 Gateway 上,因此智能体为企业数据发起的工具调用会经由 Gateway 路由到 MCP Server。在请求到达 Denodo 之前,AgentCore Identity 会执行 On-Behalf-Of 令牌交换,将人类用户的入站令牌转换为一个作用域受限的访问令牌,该令牌代表同一用户,并以 Denodo 为受众。Denodo MCP Server 接受交换后的令牌作为持有者凭证,并通过 JDBC 将 VQL 请求转发给 Denodo Virtual DataPort(VDP)。VDP 独立验证令牌,将调用者解析为 Denodo 角色,应用访问策略,并针对 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 集群规划联邦查询。
只有 VQL 请求会向下传到 VDP,结果集则向上返回。引擎之间不移动任何源数据。Aurora、Amazon Redshift 和本地集群响应的是由 VDP 联邦优化器重写的原生 SQL。以下各节将详细介绍身份传播和策略执行。其他章节涵盖 MCP Server 注册和智能体部署步骤。
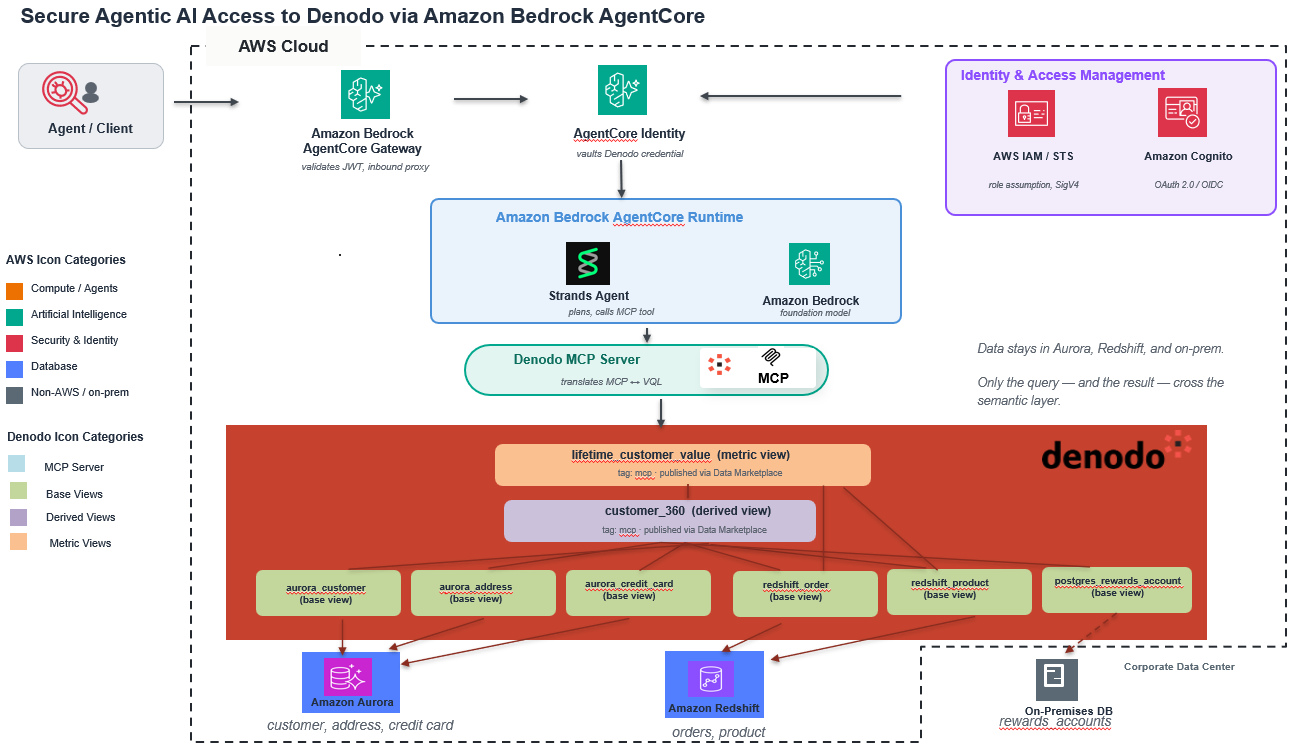
图 1:调用者、Amazon Bedrock AgentCore 组件、Denodo MCP Server、Denodo Virtual DataPort 和三个数据源之间的入站身份验证路径与出站查询路径
构建语义层
Denodo 中的语义模型并非单一产物。它是 VDP 中基础视图、派生视图、指标视图和标签的集合,共同向消费者呈现具有业务意义的数据。在本文中构建语义模型意味着创建上述每一部分。
我们分三轮构建:为每个源表建立基础视图;建立一个派生视图(customer_360),在客户级别按 cid 连接各基础视图;以及建立一个指标视图(lifetime_customer_value),定义可复用的支出聚合,查询在需要时可连接该视图。
在实践中,这种建模是在 Denodo Design Studio 中通过可视化方式完成的。你将 Aurora、Amazon Redshift 和本地 PostgreSQL 数据源拖到画布上,在它们之间绘制连接,并通过表单而不是手写 DDL 来重命名字段或更改字段类型(例如,将 cust_ref 映射为 customer_id)。本文后面介绍的安全策略附加也是在同一个 UI 中完成的。
指标视图与引用它们的派生视图放在一起,定义一次即可复用。如果两个团队在同一基础数据之上构建两个不同的客户级视图,两者都会呈现相同的指标定义。
基础视图
每个源表都会成为 VDP 中的一个基础视图。对于 Aurora 客户表,这意味着在 Design Studio 中使用特定连接器引入 Aurora,指向 schema,并让 VDP 内省列。Design Studio 负责处理内省。生成的基础视图是物理列与其 VDP 对应列之间的一对一映射,并且不会转换源数据。
创建过程中还会进行两项额外配置:
- 用于治理的列标签。 customer 基础视图上的
ssn获得标签pii_sensitive。credit_card基础视图上的card_num获得相同的标签。这些标签正是 受治理的访问 一节中定义的全局安全策略所绑定的对象。 - 主键和连接字段。
cid在aurora_customer上被标记为主键,并在redshift_order和postgres_rewards_account上被标记为连接字段。当源元数据可用时,Design Studio 会从中推断主键。否则,你需要在基础视图定义中设置一次。
对前面介绍的源表重复此操作。最终得到六个基础视图:Amazon Aurora 上的 aurora_customer、aurora_address 和 aurora_credit_card;Amazon Redshift 上的 redshift_order 和 redshift_product;以及本地 PostgreSQL 上的 postgres_rewards_account。
Design Studio 还通过 Denodo Assistant 支持自然语言编写。开发者可以用通俗英语描述一个视图(例如,“在 cid 上将 Aurora 的客户资料与 Amazon Redshift 的订单总额连接起来”),然后得到一个候选 VQL 定义,以便在同一画布中审查和优化后再保存。优化是迭代式的:后续提示会在定义最终确定之前调整过滤器、连接或字段映射。本节所述的治理和类型规则仍然适用于以这种方式创建的对象。
派生视图:客户 360
customer_360 是跨三个数据源的客户级视图,每个客户一行。订单详情和聚合单独存放在我们接下来定义的指标视图中。
CREATE OR REPLACE VIEW customer_360 AS
SELECT aurora_customer.cid,
aurora_customer.first_name,
aurora_customer.last_name,
aurora_customer.email,
aurora_customer.ssn,
aurora_address.city,
aurora_address.state,
aurora_credit_card.card_num,
aurora_credit_card.card_type,
postgres_rewards_account.account_id,
postgres_rewards_account.create_date AS rewards_since
FROM (
(
aurora_customer AS aurora_customer
LEFT OUTER JOIN aurora_address AS aurora_address
ON aurora_customer.location = aurora_address.id
)
LEFT OUTER JOIN aurora_credit_card AS aurora_credit_card
ON aurora_customer.cid = aurora_credit_card.cid
)
LEFT OUTER JOIN postgres_rewards_account AS postgres_rewards_account
ON aurora_customer.cid = postgres_rewards_account.cid;
此定义的两个属性对架构的其余部分很重要。首先,连接位于 Denodo Platform 中,而不是在管道中。没有 ETL 作业维护物化的 customer_360 表。VDP 在执行时解析连接:Aurora 返回资料以及卡信息,本地集群返回奖励注册记录,VDP 在 cid 上将它们组合起来。其次,派生视图包含所有列,包括 ssn 和 card_num。
为了治理和 AI,我们还添加了元数据:用于个人可识别信息 (PII) 字段的列标签,以及记录视图和每个字段的描述。Denodo 的 Assistant 可以使用 LLM 来建议这些内容。后面的章节将说明这些元数据为何重要。
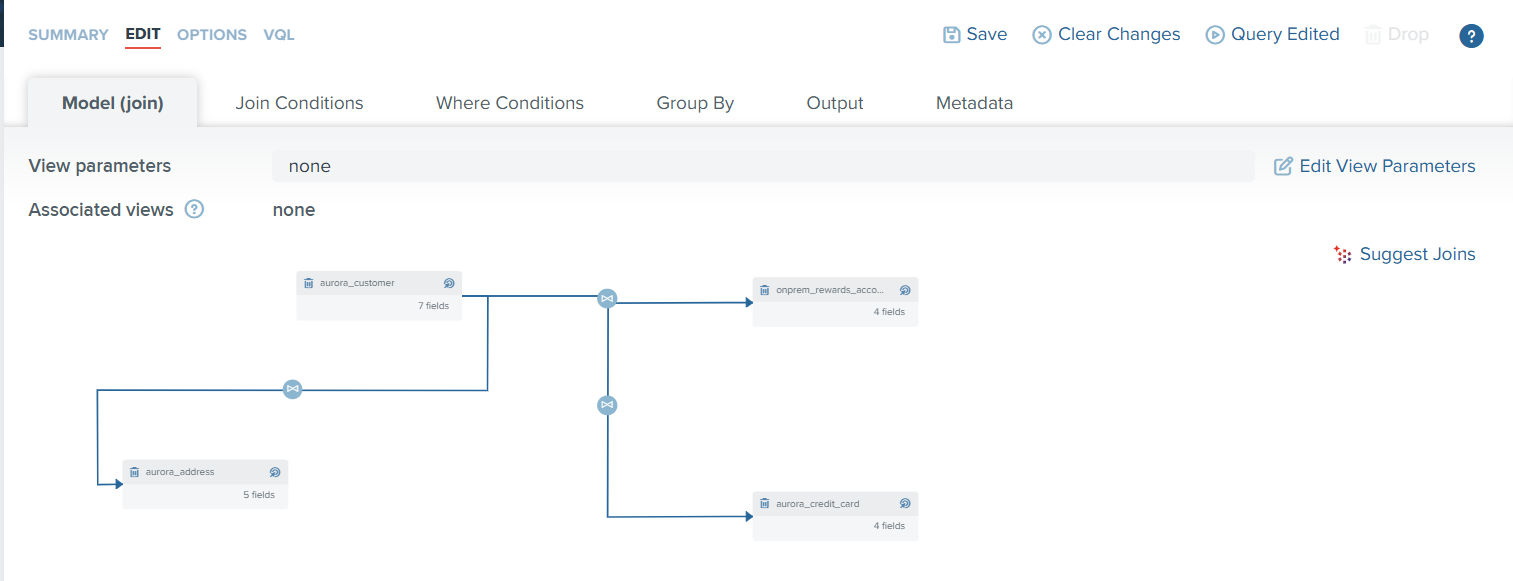
图 2:Denodo Design Studio 中的 customer_360 派生视图。画布上显示了来自三个数据源的四个基础视图,它们按 cid 和 location 进行连接。aurora_customer 上的 ssn 列和 aurora_credit_card 上的 card_num 列带有 pii_sensitive 标签,该标签由“受治理的访问”一节中的全局安全策略引用
指标视图:客户终身价值
指标视图以特定的 SOURCES/DIMENSIONS/METRICS 结构定义可复用的业务度量。完整语法请参阅 VQL 指南中的 定义指标视图 参考。lifetime_customer_value 并不位于 customer_360 内部,而是作为独立对象与它并列存在:
CREATE OR REPLACE METRIC VIEW lifetime_customer_value
(
first_name, last_name, state, rewards_since, lifetime_spend, order_count, product_id,product_name, product_brand,product_dept, units_sold
)
SOURCES (
customer_360 AS customer_360,
redshift_order AS redshift_order,
redshift_product AS redshift_product
)
ASSOCIATIONS (
customer_360 redshift_order assoc_customer360_orders,
redshift_product redshift_order assoc_product_orders
)
DIMENSIONS (
customer_360(
first_name AS customer_360.first_name,
last_name AS customer_360.last_name,
state AS customer_360.state,
rewards_since AS customer_360.rewards_since
),
product(
product_id AS redshift_product.id,
product_name AS redshift_product.name,
product_brand AS redshift_product.brand,
product_dept AS redshift_product.dept
)
)
METRICS (
lifetime_spend AS sum((redshift_order.price*redshift_order.quantity)),
order_count AS count(redshift_order.id),
units_sold AS sum(redshift_order.quantity)
);
其他视图和外部报表工具可以引用 lifetime_customer_value,方式与它引用其他视图相同。当业务规则发生变化时(例如 lifetime_spend 应排除已取消的订单),只需在指标定义中更新一次。每个使用方都会在下次查询时获得该变更,无需改动派生视图或下游应用。不同团队可以建立各自的派生视图,以体现其业务线看待世界的方式。基础数据保持共享,而语义解释保持独立,因此任一团队的修改都不会干扰另一方。
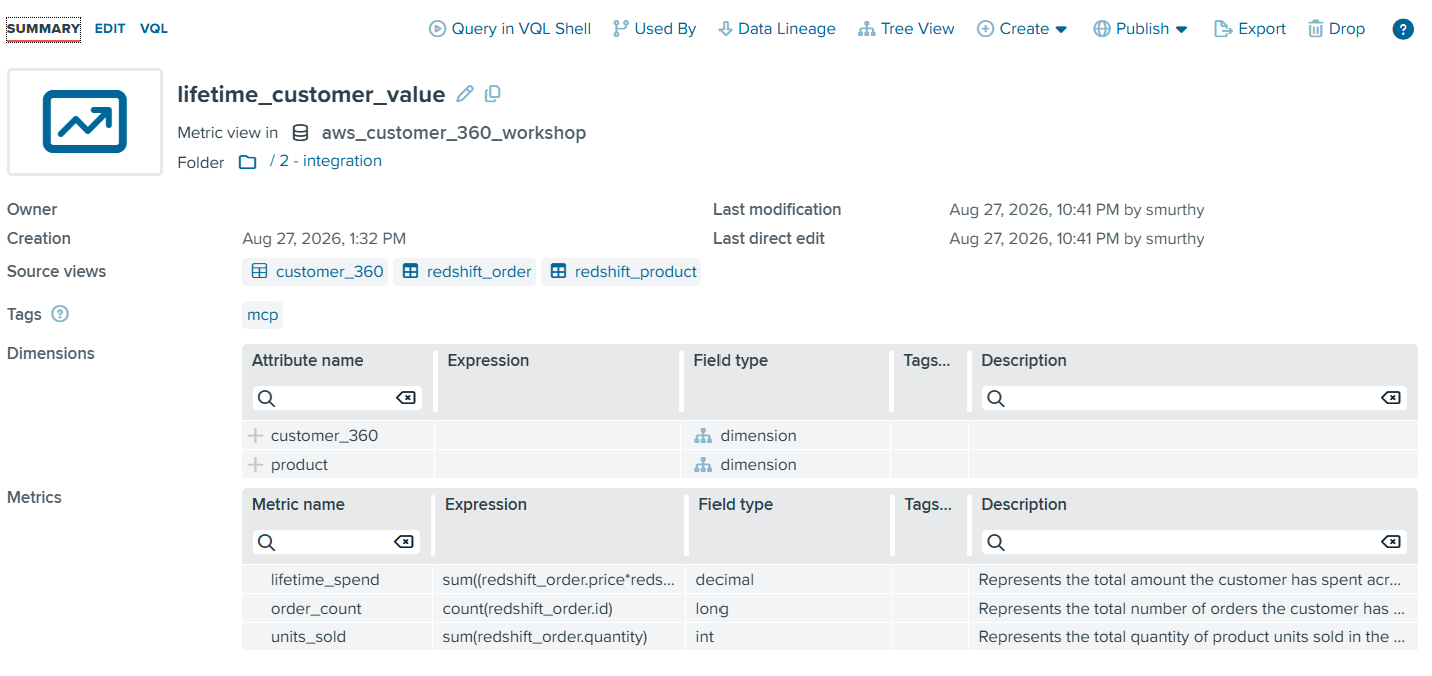
图 3:Design Studio 中的 lifetime_customer_value 指标视图,展示了定义 lifetime_spend、order_count 和 units_sold 的 SOURCES、DIMENSIONS 和 METRICS 面板
VDP 如何执行联邦查询
当代理运行 示例 中的自动注册问题(“按终身消费排名前 20 的客户中,哪些尚未注册奖励计划?”)时,相应的 VQL 会使用指标视图来计算结果集并评估目标指标:
SELECT first_name, last_name, state, EVALUATE_METRIC(lifetime_spend) AS lifetime_spend
FROM lifetime_customer_value
WHERE rewards_since IS NULL
GROUP BY first_name, last_name, state
ORDER BY EVALUATE_METRIC(lifetime_spend) DESC
LIMIT 20;
尽管此查询只引用了指标视图,VDP 的基于成本的优化器仍会规划跨三个引擎的联邦执行,这些引擎正是相应数据的来源。生成的计划大致如下:
- 下推到 Amazon Aurora:Denodo 将 customer、address 和
credit_card的连接下推到 Aurora,返回客户资料字段,包括first_name、last_name、state 和cid。 - 下推到本地 PostgreSQL:Denodo 将
rewards_account的投影下推,返回cid和create_date。 - 下推到 Amazon Redshift:Denodo 将消费聚合下推到 Amazon Redshift,形式为按
cid分组的SUM(price * quantity)。 - 在 Denodo 内部合并:Denodo 按
cid将 Aurora 资料结果与 PostgreSQL 奖励结果进行左连接,然后按cid将该结果与 Amazon Redshift 的聚合消费进行右外连接。Denodo 筛选出rewards_sinceIS NULL 的行,将指标作为外层分组聚合(sum(sum) AS lifetime_spend)进行评估,按first_name、last_name和 state 分组,按lifetime_spend降序排序,并最多返回 20 行。
该计划体现了各数据源的优势。Amazon Redshift 负责聚合,Aurora 负责客户资料连接,因为三个资料表都位于那里,而本地集群返回一小部分奖励记录。VDP 处理最终的跨引擎连接和 top-N 筛选,使用三个紧凑的中间结果集,每个结果集每客户一行,而不是每订单一行。手写管道通常近似实现同样的形态,然后必须永远保持同步。
VDP 还会在最经济的位置处理类型协调。如果同一个标识符在一个源中存储为整数,在另一个源中存储为字符串,VDP 会将类型转换下推到仍能对结果谓词进行过滤的源中,而不是跨引擎拉取数据并在之后协调类型。
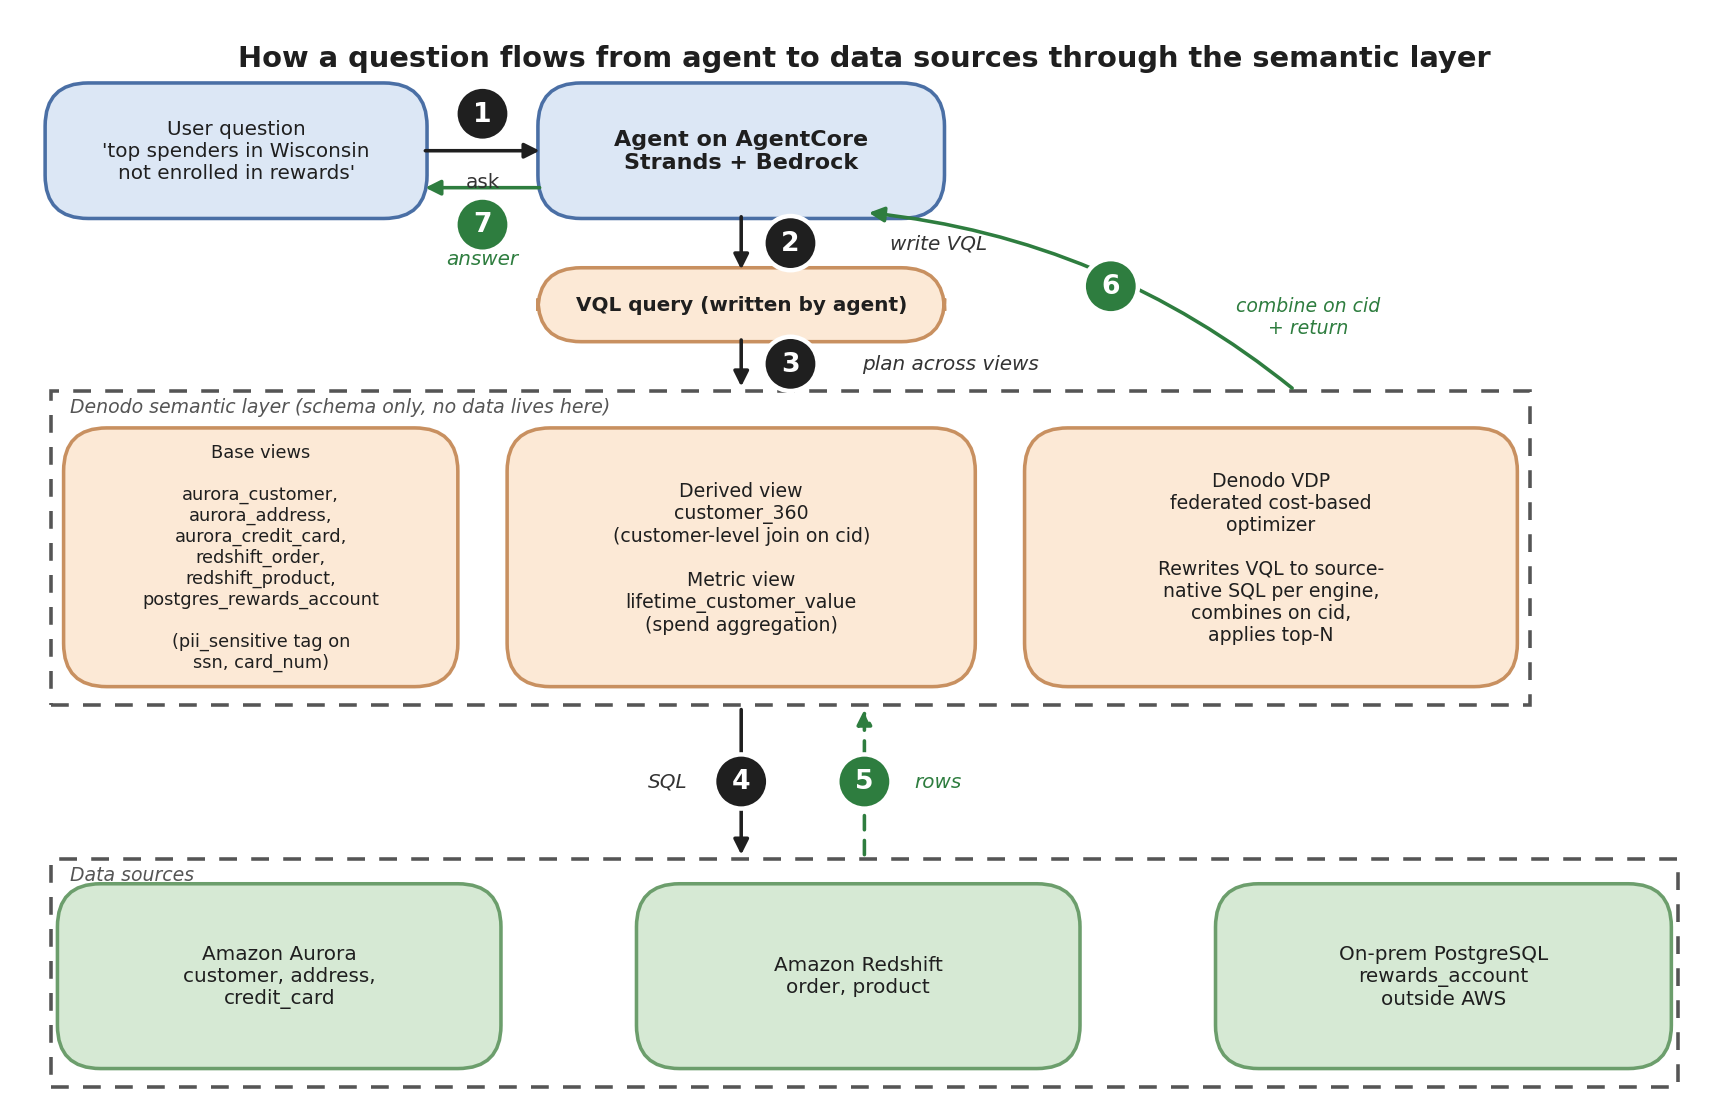
图 4:从 C360 代理到 Amazon Aurora、Amazon Redshift 以及本地 PostgreSQL 再返回的查询流程。VDP 将针对 customer_360 与 lifetime_customer_value 联接的单个 VQL 请求重写为各引擎的原生 SQL,收集中间结果集,并在 VDP 内部按 cid 联接它们,然后将最终行返回给代理。
除了查询下推和按需联邦之外,VDP 还提供缓存、聚合感知加速和点对点复制。这些技术在下推能力的基础上,适用于可能需要预先计算复杂转换的场景,同时保留访问控制规则和数据血缘。
发布以供发现
一个仅作为可查询端点存在的语义视图会留下可发现性缺口。下一个需要“客户生命周期价值”度量的团队无从得知 lifetime_customer_value 已经存在、它建立在什么之上,或者还有谁依赖它。将 customer_360 和 lifetime_customer_value 发布到 Denodo Data Marketplace 可将其转变为可复用、受治理的企业数据产品,并弥合这一缺口:两个对象都会显示其 VQL 定义、所有权、业务描述、自定义属性以及回溯到基础视图的血缘。消费者按业务含义搜索,而无需了解模式。Denodo Data Marketplace 还提供其他面向非技术用户自助服务的功能,包括数据准备向导、管理员给出的认可与弃用说明,以及向数据产品所有者提出请求和问题的能力。
Denodo 通过 360 图谱对此进行了扩展,这是一种围绕业务概念的关系视图。该图谱附上已经使用 customer_360 的报告、仪表板、笔记本或代理工具,以及定义表中数据含义或使用条件的术语表等。消费者可以在编写查询之前检查数据集的周边上下文。
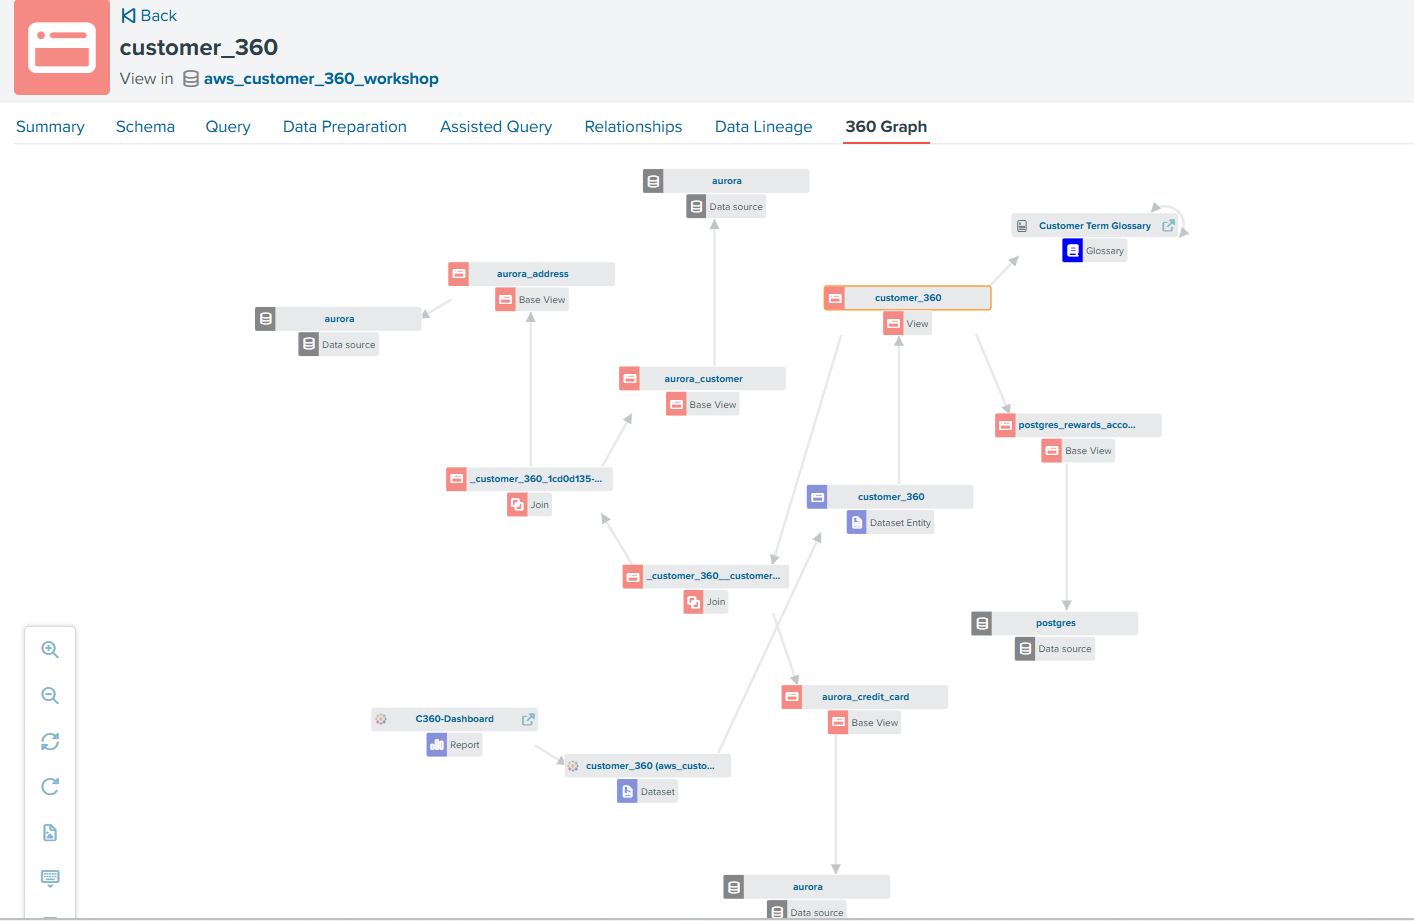
图 5:Denodo Data Marketplace 中的 customer_360 图谱视图列表。详情面板显示 Tableau 中一个消费该视图的 BI 工具,以及链接到该视图的术语表定义。
关于互操作性的一点说明
Denodo 中的语义模型以 VQL 定义,但 Denodo 原生通过多种开放协议暴露任何视图。同一个 customer_360 视图可以通过 JDBC、ODBC 或 ADBC 以 SQL 访问,通过 Denodo GraphQL Service 以 GraphQL 访问,通过 Denodo OData Service 以 OData 2.0 或 4.0 访问,或通过 Denodo MCP Server 以 MCP 工具访问。在本演练中选择 MCP 适合 AgentCore。同一个视图可供 Power BI 仪表板、Tableau 工作簿或 Java 应用程序使用,而无需额外建模。
Denodo 还于 2026 年 3 月加入了 Apache Ossie(孵化中),其前身为 Open Semantic Interchange (OSI),这是一个厂商中立的语义元数据开源规范。Apache Ossie 尚处于早期阶段,但其意图是让语义定义在采用它的应用程序之间可移植。尽管如此,Denodo 已经通过 Denodo Connects 提供集成,可与其他数据目录(如 SageMaker Catalog、Collibra、Purview 等)共享元数据。
受治理的访问:身份传播与运行时强制执行
跨数据源的广泛覆盖是企业级语义层的核心特征之一,但正是这种广泛覆盖在缺少运行时访问控制时会带来真实风险。如果按用户过滤的逻辑存在于智能体的代码中,那么一次提示注入就足以将其绕过。如果它存在于 LLM 中,那它实际上并不存在于任何地方。如果它只在各个源系统中强制执行,策略可能不一致,而且可能无法顾及跨源创建的业务含义。Aurora 不知道语义层中“top spender”是什么意思,堡垒主机后面的本地 PostgreSQL 集群也不知道。而且很多时候,尤其是在混合本地与云系统的场景中,让所有这些系统共用身份提供商甚至都不是一个可选项。
该架构采用的方法是在语义层强制执行访问控制,使用发起请求的人类用户的身份,从 IdP 经 Amazon Bedrock AgentCore 一路传播到 Denodo Virtual DataPort。
身份传播链
图 6 放大了图 1 参考架构中的身份部分,将从应用发往 Denodo VDP 的出站路径展开为八个跳转的序列。以下编号步骤与图中编号箭头一一对应。
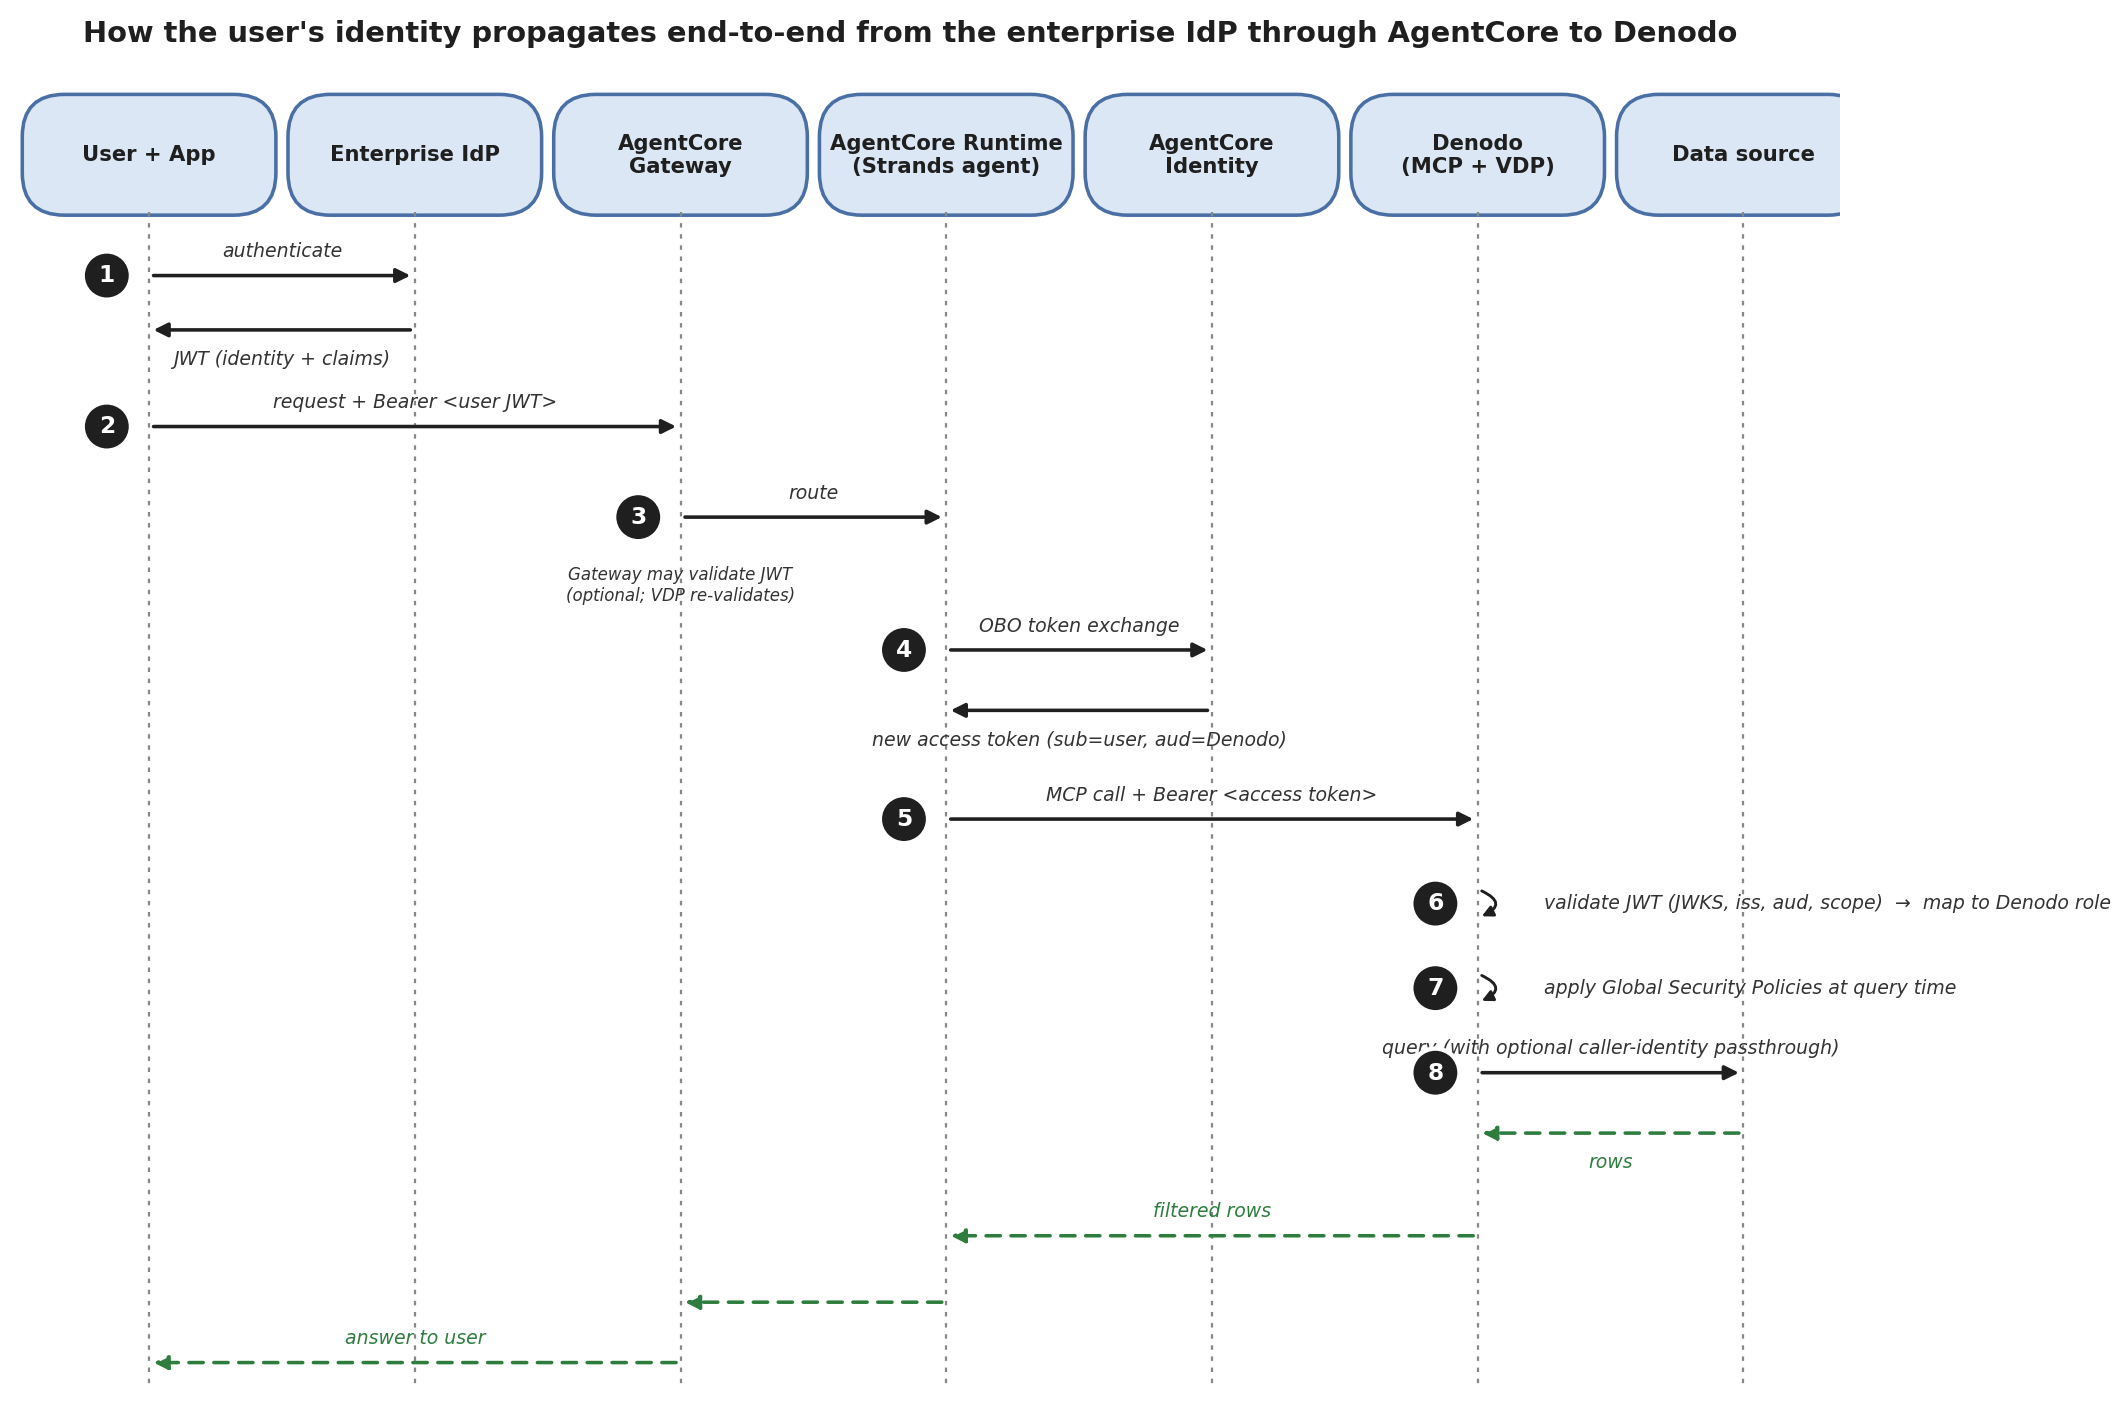
图 6:从用户登录经 Amazon Bedrock AgentCore 到 Denodo(MCP Server 和 VDP)及底层数据源的身份传播与查询流程。黑色箭头显示出站身份与查询路径。绿色虚线箭头显示带有过滤结果集的返回路径
- 用户针对企业 IdP 向应用进行身份验证。IdP 返回一个 JWT,其中携带用户身份和属性声明——角色、区域、部门,以及 IdP 配置发出的其他任何内容。
- 应用以用户的 JWT 作为持有者令牌,通过 AgentCore Gateway 调用智能体。
- Gateway 将请求路由到 AgentCore 运行时,后者托管 Strands 智能体进程。
- 当智能体发起出站工具调用时,AgentCore Identity 执行 On-Behalf-Of 令牌交换,并返回一个新的访问令牌,其 sub 声明为人类用户,aud 声明为 Denodo。
- 智能体将新的访问令牌作为
Authorization: Bearer <access_token>在 MCP 请求中提交给 Denodo MCP Server。 - Denodo VDP 根据配置的 JWKS URL 验证 JWT,检查签发者和受众,提取 scope 声明,并将调用方映射到 Denodo 角色。
- VDP 在查询时评估全局安全策略,并向智能体返回过滤后的结果集。
- VDP 查询数据源以满足请求,并在返回前合并结果。
第 2 步中的 Gateway JWT 验证是可选的,因为 VDP 会在第 6 步重新验证令牌。开启 Gateway 验证后,格式错误的令牌会在请求路径中更早失败。
第 4 步中的令牌交换根据凭证提供方配置,使用 RFC 8693 令牌交换授权或 RFC 7523 JWT 持有者授权。凭证本身不会进入智能体代码。AgentCore Identity 在调用时注入它。
第 8 步中的调用方身份透传选项按数据源启用,并要求 Denodo 与源共享同一 IdP。当它适用时,调用方的身份会被端到端转发,从而在源处提供完整的审计。
在 Denodo 中应用访问策略
Customer 360 数据受到监管。例如,部分用户(HR、欺诈分析师)可能需要查看 PII,如社会安全号码(SSN)和完整信用卡号。但大多数用户(营销、分析)不得查看。
Denodo 的机制是采用基于属性和角色的访问控制的全局安全策略。全局安全策略是一条规则,适用于带有特定标签的视图或列,在查询时根据调用者的角色和会话属性进行评估。底层视图不会被重构。
为说明这一点,我们在 Aurora 之上的基础视图中将两列(ssn 和 card_num)标记为 PII。我们创建一条全局安全策略 mask_pii_columns。
- 受众:调用者的角色不是
hr_user。 - 元素:适用于带有
pii_sensitive标签的列。 - 操作:用星号掩码(
****)。
然后我们定义两个 Denodo 角色。
hr_user:拥有对customer_360的 Execute 权限。可查看所有列。marketing_user:拥有对customer_360的 Execute 权限。由于策略生效,将看到ssn和card_num显示为****。
当 marketing_user 运行 VQL 查询时:
SELECT cid, first_name, last_name, state, ssn
FROM customer_360
WHERE state = 'WI';
VDP 在规划查询之前评估全局安全策略。它发现 ssn 带有 pii_sensitive 标签,且调用者的角色不是 hr_user,因此重写投影,为 ssn 返回 ***。
对于行级过滤(例如,一位美国东部分析师只应看到东海岸客户),同样的机制可以扩展。策略条件甚至可以依赖于从 JWT 令牌映射的会话属性,或从外部表动态拉取。
关于负责任 AI 的说明
Denodo 的全局安全策略在语义层过滤 PII,因此对于不应查看的调用者,模型永远不会看到 ssn 或 card_num。即便如此,代理响应仍可能以自然语言回显客户标识符、位置或消费模式。请对代理输出采用与底层受监管数据相同的处理和保留策略:限定日志记录和转录存储范围,应用 Amazon Bedrock Guardrails 进行内容和敏感主题控制,并限制可读取响应的人员。有关更广泛的指导,请参阅Amazon Bedrock 中的负责任 AI。
跨层审计与可观测性
请求路径的每一层都独立记录日志。AgentCore 运行时将调用记录发送到 Amazon CloudWatch。AgentCore Gateway 记录入站 MCP 请求,包括调用者的 JWT sub 声明。Denodo MCP Server 将工具调用记录到其自己的日志中。Denodo VDP 的审计日志捕获完整的 VQL 请求、映射的 Denodo 角色、解析后的联邦计划以及策略评估结果。
这些日志也可以纳入 Amazon CloudWatch。当需要按源审计并关联到人类用户时(例如,为满足 HIPAA 或 SOX 合规要求),请为这些源的基础视图配置直通会话凭据,以便 Denodo 在源系统支持的情况下将调用者身份转发到源系统,而不是依赖服务账户。
通过 Denodo MCP Server 暴露该层
Denodo MCP Server 是一个附加组件,位于 MCP 客户端和 VDP 之间:下载发行版,解压,编辑 config/application.properties,然后启动它。该服务器在 http://<mcp-host>:8080/<database>/mcp 监听可流式 HTTP MCP 请求,并通过 JDBC 将其转发到 VDP。
本演练中有三个配置值很重要。
mcp.security.oauth2.enabled=true:在入站 MCP 请求上接受 OAuth 2.0 持有者令牌。与 VDP 的 OAuth 身份验证器配置配合使用时,令牌会转发到 VDP 进行验证和角色解析(另请参阅受治理的访问部分)。vdp.datasource.jdbcUrl=jdbc:vdb://<vdp-host>:9999/:访问 VDP 所用的 JDBC URL。每个请求所针对的具体数据库来自 MCP 端点路径。mcp.visibility.tags=mcp控制 MCP Server 中可见的视图。如果定义了该参数,则只有至少带有其中一个标签的视图才可见。
该服务器实现了 MCP OAuth 2.0 授权流程,包括 RFC 9728 受保护资源元数据和 RFC 7591 动态客户端注册。
关于 IdP 兼容性的说明
Denodo MCP Server 文档说明其支持与 Okta、Ping Identity 和 Keycloak 的自动动态客户端注册流程。对于其他身份提供方,MCP Server 也接受手动客户端配置,即通过带外方式获取 OAuth 令牌,并将其作为静态 Authorization 头转发到 MCP 请求中,具体如 Denodo MCP Server 用户手册所述。
使用 Application Load Balancer 为服务器提供前端
如果 Denodo MCP Server 运行在与 VDP 同一 VPC 中的 Amazon EC2 或 Amazon EKS 上,请通过带有 HTTPS 监听器和来自 AWS Certificate Manager 的证书的 Application Load Balancer 将其暴露出来。这样可为 AgentCore Gateway 提供稳定的 HTTPS 端点,并将 TLS 终止从 MCP Server 进程中卸载。目标组:HTTP,端口 8080。健康检查路径应同时接受 200 和 404 作为健康响应,因为根路径返回 404,而服务器已启动并连接到 VDP 时 /health 返回 200。
注册为 AgentCore Gateway 目标
完整的分步操作说明(包括 AgentCore Gateway 创建、IAM 服务角色配置和 Gateway 目标验证)见 Denodo 的 Integrating Amazon Bedrock AgentCore with Denodo via MCP Server 集成指南。
在 harness 中添加 Denodo VQL 技能
Denodo VQL 技能充当 agent 框架(如 Strands 或 Bedrock AgentCore)中 LLM 的系统提示扩展。当在 agent harness 中注册后,它会指示模型了解 VQL 语法规则以及如何帮助防止 SQL 错误。
部署并运行 agent
Denodo AgentCore 文档参考在 Denodo KB 中提供了完整的 agent 代码。该模式很简短:Amazon Bedrock 上的基础模型、指向 Denodo MCP Server 的 MCP 客户端,以及将它们连接在一起的 AgentCore 运行时入口点。
验证
为了确认语义层、agent 和身份流程按预期工作,我们通过 agent 运行三类查询,并额外运行一次治理重跑,以演示受治理访问部分中“同一查询、两个用户”的特性。我们可以使用 Denodo 的 Data Marketplace 助手(其背后依赖等效工具)来对我们的场景进行快速验证。
查询 1,仅 Aurora
“列出我们在威斯康星州的客户及其所在城市。”
agent 生成并运行:
/* The query needs to retrieve first_name, last_name, and city from the customer_360 view where state = 'WI', ordered by last_name. The output will be multiple rows with 3 columns. The table is at customer granularity (one row per customer). No obligatory columns are present, so a simple WHERE filter on state suffices. */
SELECT "first_name",
"last_name",
"city"
FROM "customer_360"."customer_360"
WHERE "state" = 'WI'
ORDER BY "last_name"
VDP 的优化器确定投影和过滤只需要 Aurora 侧数据,并将单个查询下推到 Amazon Aurora。基于探测查询,agent 可以将威斯康星州过滤条件转换为谓词 state = 'WI'。Amazon Redshift 和本地集群不会被访问。
查询 2,仅 Redshift
“按销量计算,我们的前 10 大产品是什么?”
agent 生成:
/* The user wants top 10 products by total units sold from a metric view. I need to use EVALUATE_METRIC for units_sold, GROUP BY product_name, ORDER BY the metric descending, LIMIT 10. The output will be multiple rows (up to 10) with two columns: product_name and total_units_sold. */
SELECT "product_name",
EVALUATE_METRIC("units_sold") AS "total_units_sold"
FROM "customer_360"."lifetime_customer_value"
GROUP BY "product_name"
ORDER BY "total_units_sold" DESC
LIMIT 10
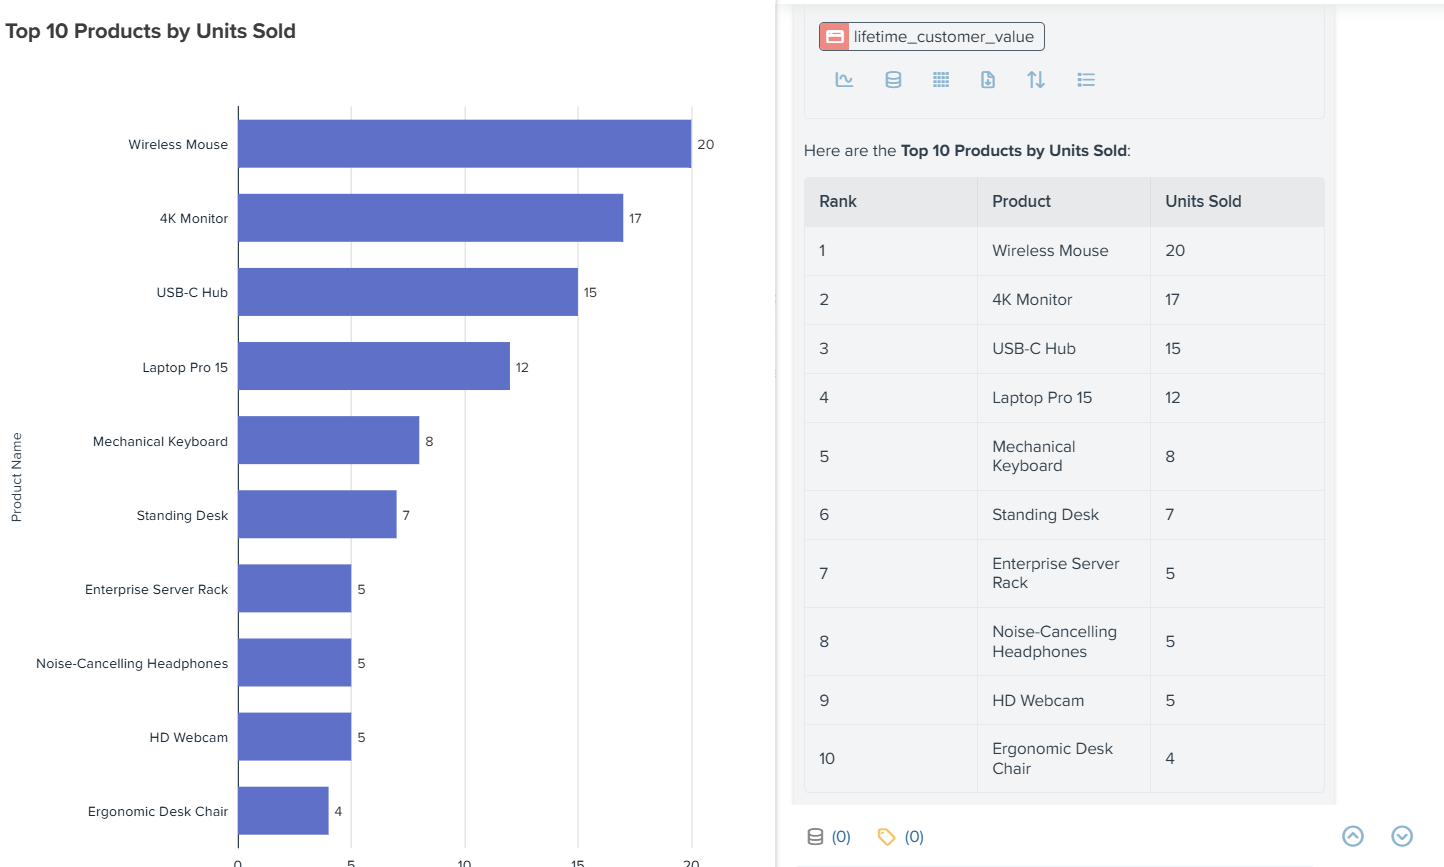
图 7:VDP 将整个查询(连接、聚合、排序和限制)下推到 Amazon Redshift,因为产品和订单数据都位于那里。Aurora 和本地集群不会被访问
查询 3,三方联邦
“我们按生命周期价值排名前20的客户中,哪些尚未加入奖励计划?”
智能体生成:
/* This is a metric view, so I need to use EVALUATE_METRIC for lifetime_spend and order_count. The query needs to: 1. Aggregate by first_name, last_name, state, rewards_since to get total lifetime_spend and order_count 2. Rank top 20 by total lifetime_spend 3. Filter those top 20 where rewards_since IS NULL I'll use a CTE with ROW_NUMBER() to get top 20, then filter for NULL rewards_since in outer query. */
WITH "ranked_customers" AS (
SELECT "first_name",
"last_name",
"state",
"rewards_since",
EVALUATE_METRIC("lifetime_spend") AS "total_lifetime_spend",
EVALUATE_METRIC("order_count") AS "total_order_count"
FROM "customer_360"."lifetime_customer_value"
GROUP BY "first_name",
"last_name",
"state",
"rewards_since"
ORDER BY "total_lifetime_spend" DESC
LIMIT 20
)
SELECT "first_name",
"last_name",
"state",
"rewards_since",
"total_lifetime_spend",
"total_order_count"
FROM "ranked_customers"
WHERE "rewards_since" IS NULL
ORDER BY "total_lifetime_spend" DESC
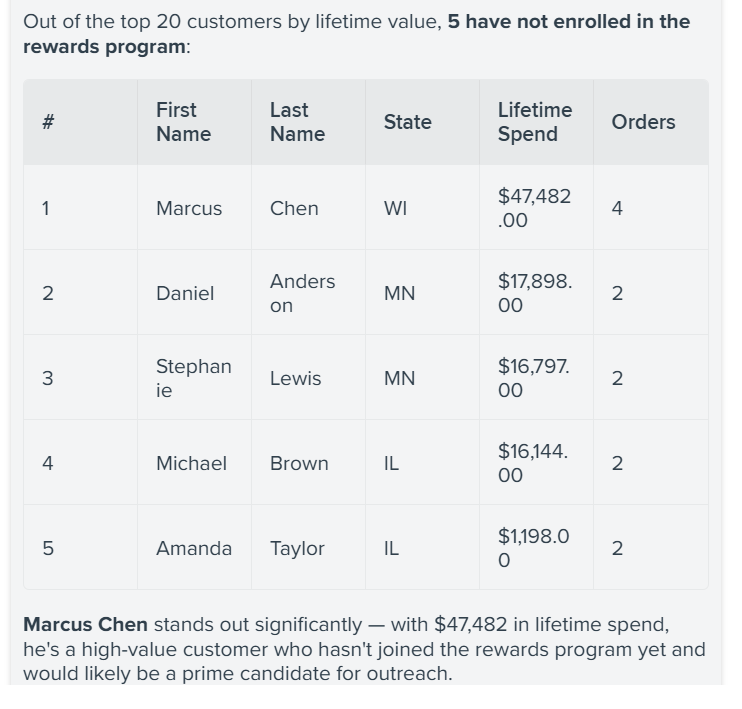
图8:三方联邦查询的智能体结果,列出按生命周期价值排名、尚未加入奖励计划的高价值客户
如构建语义层一节所述,VDP 在三个引擎上规划:来自 Aurora 的客户画像、来自 Amazon Redshift 的聚合消费、来自本地集群的注册记录,以及 VDP 内部的最终连接和 top-N。POC 数据中的最高结果是来自威斯康星州密尔沃基的 Marcus Chen,生命周期消费为 $47,832,这是一位高消费且未注册奖励的客户,正是示例中示例问题所针对的自动注册目标。请注意,LLM 无需自行给出 lifetime_spend 的定义,因为该公式已作为指标视图中定义的语义模型的一部分。
治理重跑
我们将 ssn 添加到投影中运行查询 1,分别以两个不同的调用者身份:
SELECT cid, first_name, last_name, state, ssn
FROM customer_360
WHERE state = 'WI';
以 hr_user 身份运行时,结果包含 ssn 值。以 marketing_user 身份运行时,结果返回相同的行,但 ssn 以星号作为掩码值。两次运行之间,查询文本、智能体代码、MCP Server、VDP 或 Aurora 均无变化。受治理的访问一节中的全局安全策略 mask_pii_columns 在查询时根据调用者的角色进行评估,VDP 相应地重写投影。card_num 也适用相同行为。
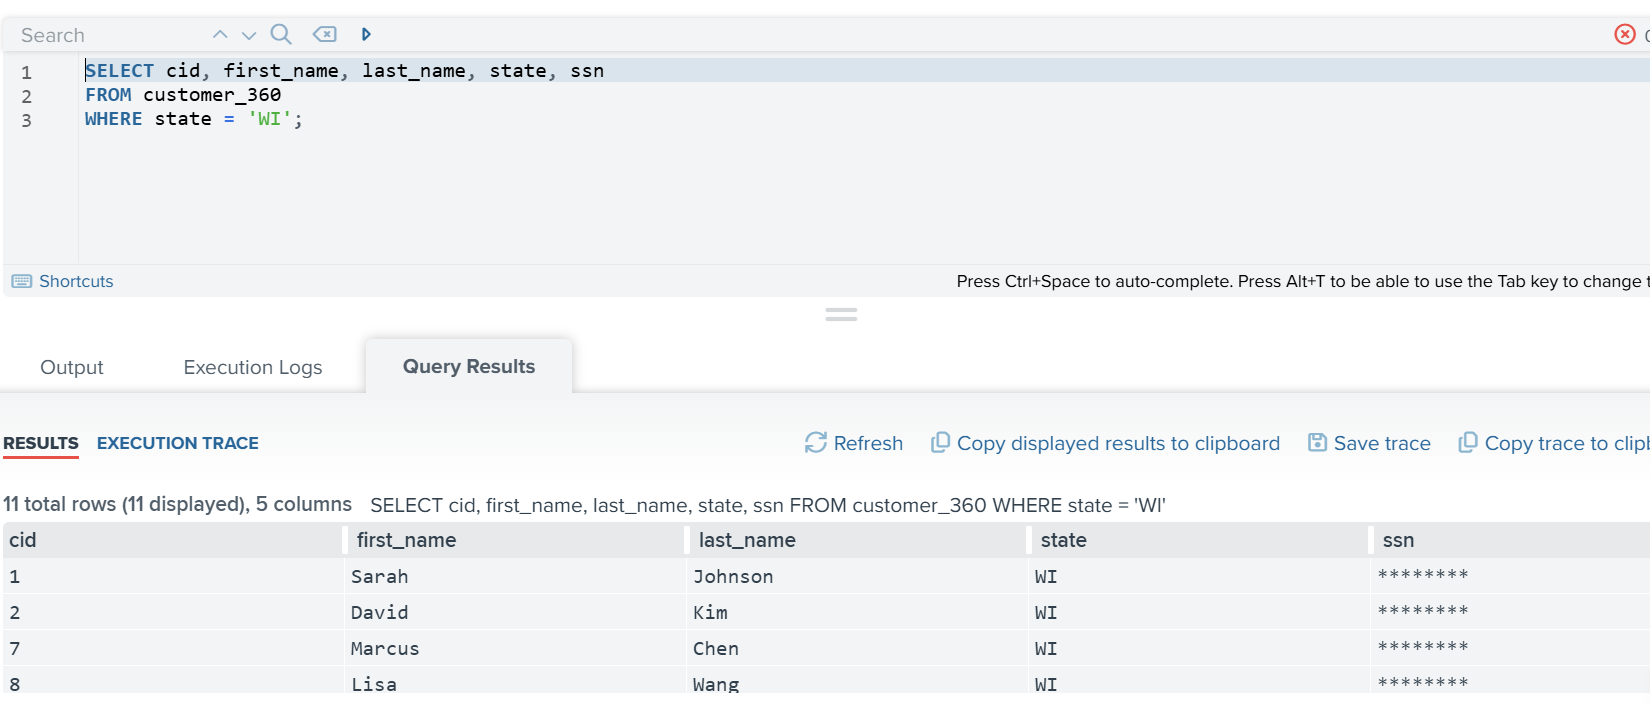
图9:同一查询的治理重跑,ssn 对 hr_user 完整返回,对 marketing_user 则被掩码
扩展到其他数据源
向 customer_360 添加 AWS 之外的数据源,无论是用于 CRM 记录的 Salesforce、用于客户服务数据的 ServiceNow,还是用于 ERP 表的 SAP,都与 Aurora、Amazon Redshift 和本地集群是相同的建模工作。创建一个基础视图,在 cid 上将其连接到派生视图,并标记敏感列。指标视图、全局安全策略和智能体的 VQL 均不变。变化的是 VDP 用于访问数据源的封装器。例如:
- Salesforce 通过 Denodo Salesforce 连接器连接,使用 OAuth 2.0 认证,并在 REST 或 Bulk API 之上进行
VQL-to-SOQL转换。 - ServiceNow、Microsoft Dynamics 365 和其他 SaaS 工具使用 Denodo 的 SaaS 向导模板,这些模板已针对常见 API 预配置。
- SAP ERP 通过使用 SAP Java Connector 的 BAPI 数据源连接。VDP 调用 SAP RFC 并将响应塑造成行。
智能体并不知道底层是其中哪一种。它用 VQL 查询 customer_360。Denodo 的封装器处理源原生转换,并且无论行来自 JDBC 引擎、REST API 还是 RFC 调用,Denodo 的全局安全策略都统一适用。
有一个部署时的决策因数据源而异:是将调用者的身份透传到数据源,还是以服务账户连接。透传可在数据源支持时(例如对 SAP 使用 Kerberos,或对 Salesforce 使用 OAuth)在数据源处提供端到端审计。服务账户连接更简单,数据源的审计会将查询显示为来自 Denodo。
部署:Denodo Agora 与自管理
AWS 上的 Denodo 以两种形态之一运行。两者使用相同的 Virtual DataPort、相同的 VQL、相同的全局安全策略、相同的 MCP Server。选择在于运维层面。
Agora:全托管
Denodo Agora 是 Denodo 的全托管云服务,可在 AWS Marketplace 上获取。Agora 采用分离平面架构运行。控制平面(Solution Manager、Design Studio、Scheduler 管理、监控/诊断)运行在 Denodo 的云账户中,而执行平面(VDP、Scheduler、Data Catalog)运行在客户自己的 AWS 账户内。接触数据的计算资源位于客户的 VPC 中。管理界面由 Denodo 运营。
当你不想自行运维应用,且 Denodo 发布的更新节奏适合你的组织时,请选择 Agora。
在 Amazon EC2 或 Amazon EKS 上自管理
自管理部署将 Denodo Platform 完全安装在客户的 AWS 账户中。Denodo 在 AWS Marketplace 上发布 VM 镜像,并为 Amazon EKS 提供附带 Helm chart 的容器镜像。集群、升级和备份由你负责。
当合规要求特定的部署形态、当你希望控制版本节奏,或当参考架构要求在特定 VPC 内部署 Denodo 集群时,请选择自管理。
访问 AWS 之外的数据源
两种部署形态都将 VDP 放置在客户的 AWS 账户中。访问本地数据源在两种情况下都是同一个问题:从承载 VDP 的 VPC 到本地集群的网络路径,需通过组织已在使用的任一混合连接方案来打通。对于 Salesforce 或 ServiceNow 等 SaaS 数据源,无需额外设置,因为执行平面默认具备出站互联网访问能力,足以完成 OAuth 2.0 认证和 REST API 调用。
结论与从哪里开始
可靠的智能体对企业数据的访问需要三件事协同工作:一个能够规划并生成查询的基础模型、一个在实时源系统之上呈现业务含义数据的语义层,以及一个承载智能体并管理身份流转的运行时。Amazon Bedrock、Denodo Platform 和 Amazon Bedrock AgentCore 各自承担其中一个角色。
智能体与语义层对话,而不是直接与底层数据库对话。基础视图、派生视图、指标视图、标签和全局安全策略都位于 VDP 中。当源架构发生漂移、新数据源上线或治理规则变更时,更新发生在语义层,所有使用方会在下一次查询时自动获取。语义层携带的额外元数据(文档、描述、指标公式和 360 图谱)为模型提供了更多有依据的业务上下文以供推理,而不仅仅是原始架构。
从哪里开始
试用 AWS 上的 Agora 并按照说明进行部署。Agora 是 Denodo 的全托管云服务,用于在 AWS 上部署 AI 数据层,提供对分布式企业数据的实时、受治理的访问。
大多数团队通过从小范围开始并逐步扩展来让这套方案运转起来。
- 选择一个智能体工作流,它跨越两到三个不同的源系统,且目前回答所需时间超出应有水平。
- 写下三到五个具体问题,即该工作流需要回答的问题。这些是语义层在第一天就必须支持的查询。
- 连接数据源并创建基础视图,覆盖该工作流涉及的源表。在创建过程中为 PII 列打上标签。
- 构建派生视图和指标视图,以满足这些问题所需。
- 实施全局安全策略,帮助保护 PII、受保护健康信息(PHI)、支付卡行业(PCI)或其他敏感信息。
- 将 Denodo MCP Server 注册为 AgentCore Gateway 目标,并使用前文所述的模式将 Strands 代理连接到它。使用
agentcore deploy进行部署。
延伸阅读
- 通过 MCP Server 将 Amazon Bedrock AgentCore 与 Denodo 集成:Denodo 社区参考实现。
- Denodo MCP Server 用户手册。
- Denodo VQL 指南,包括定义指标视图。
- Denodo 全局安全策略。
- Amazon Bedrock AgentCore 开发者指南。
关于作者

Suntosh Murthy
Suntosh 是 Denodo 的合作伙伴解决方案架构师,他与战略合作伙伴合作设计和实施云数据架构、语义层解决方案和企业参考架构,帮助客户做出数据驱动的决策。

Pablo Alvarez-Yañez
Pablo 是 Denodo 的全球产品管理副总裁,他负责定义产品战略、为产品组合设定方向和优先级,并将客户需求转化为需求规格。他负责制定产品战略、收集客户反馈,并与工程、市场和销售团队协调以执行该战略。他目前的优先事项围绕云部署、大数据和数据科学。

JP Boreddy
JP 是 AWS 的高级解决方案架构师,他与企业客户合作处理云架构、数据和 AI 工作负载。

Sahil Thapar
Sahil 是 AWS 的首席解决方案架构师,他与 ISV 客户合作,在 AWS 云上构建高可用、可扩展且有弹性的应用程序。他专注于容器、机器学习和生成式 AI,帮助企业设计生产级解决方案。
来源:AWS Machine Learning Blog · aws.amazon.com