Redwood Research 论证加速 AI 概念推理能力的重要性
Redwood Research 发文论证应差异化加速 AI 的概念推理能力,即类似哲学、缺乏可验证标准、依赖非形式化先验论证的任务。该机构称基础提示技巧和小规模训练可让模型在其主概念推理基准上提升相当于 3 到 12 个月前沿进展的分数,且对通用能力外溢较小。团队已从直接做概念研究转向该方向,并称有可吸纳更多人的现成议程。
译文尚不完整,完整内容请切换到原文。
Redwood Research:Blog· Emery Cooper·2026-10-27 12:24· 2 小时前AI 评分39
加速概念推理能力的基本理由
AI 导读
Redwood Research 发文论证应差异化加速 AI 的概念推理能力,即类似哲学、缺乏可验证标准、依赖非形式化先验论证的任务。该机构称基础提示技巧和小规模训练可让模型在其主概念推理基准上提升相当于 3 到 12 个月前沿进展的分数,且对通用能力外溢较小。团队已从直接做概念研究转向该方向,并称有可吸纳更多人的现成议程。
正文 · 原文
引言
在本文中,我们论证对齐及其他重要工作需要特别强的概念推理能力。我们大致指的是与哲学类似的任务,即这些任务无法被直接验证,其进展依赖于非形式化的先验推理与论证。我们认为,差异化加速 AI 的概念推理能力很重要。
我们还认为这一领域被忽视,且 AI 安全社区目前对此投入不足。我们自身已从直接从事概念研究转向主要致力于差异化加速 AI 的概念推理。我们有一套可立即上手的议程,能够吸纳更多人。在后续文章中,我们将从高层面上阐述如何开展这项工作。如果你有兴趣从事这项工作,请联系我们!
感谢阅读 Redwood Research 博客!免费订阅以接收新文章并支持我的工作。
关于其他人对相关担忧的讨论,参见 Joe Carlsmith 关于利用 AI 促进 AI 安全的论述,以及关于构建能进行类人哲学思考的 AI、Wei Dai 关于 AI 从事哲学潜在困难的论述、Paul Christiano 关于对齐失败的第一则故事、John Wentworth 反对 AI 控制的论证,以及作为概览的Caspar 关于对齐研究本质的阅读材料。另见 Caspar 关于让 AI 更擅长道德哲学的基本论证的文章,该文为这一领域提出了类似理由。
本文为从事概念推理工作给出了一个相对通用的理由,未聚焦于特定子领域或影响路径。我们这样做,部分是因为我们认为概念推理的益处较为分散,且在高层面上各子领域从事该工作的理由相似;部分是为了让文章对广泛读者保持可读性。在我们看来,概念推理工作的最大益处之一在于提升未来应对非因果交互的能力,但具体细节我们留待后续文章讨论。
概述
在高层面上,我们的论证如下。首先,我们论证AI 何时擅长概念推理很重要,因为:
许多最重要的任务都包含不可或缺的概念要素:缺乏实际可及的真值的问题、处于前范式领域的问题,以及在各种方式上无法被经验数据充分服务的问题。(我们在本节中进一步说明所指的含义。)
AI 研发任务的概念成分更少且不那么关键,因为这些任务更接近可验证,或拥有可验证的代理指标。因此,我们预期概念推理的提升将是差异化的,即对安全工作的帮助远大于对通用能力的帮助。
接管似乎也主要受非概念性技能的瓶颈制约,尽管更强的概念推理可能会加速某些与接管相关的能力,例如谋划。我们简要解释为何预期这一效应小于其益处,并将更充分的讨论留待后续文章。
AI 更早具备更强的概念推理能力将非常有价值。我们认为,从现在起的任何时间点,AI 在概念推理上更强都将非常有价值,这通过两条广泛的影响路径实现:
首先,克服超级智能所带来问题的一个核心希望是借助 AI 的帮助。相对于起飞和谋划的出现,AI 能多早帮助完成重要工作,可能是决定未来价值的最重要因素之一。这一相对时机在很大程度上取决于 AI 的概念推理能力。
其次,我们预计 AI 将很快在塑造未来人类和 AI 的信念方面发挥非常大的作用。由于社会对某些问题(如决策论和伦理学)的看法可能具有路径依赖性,我们认为从长远来看,AI 是否提供合理的输入并引导社会走向更具哲学反思性的方向至关重要。
其次,我们认为我们或许能够差异化地加速概念推理,因为:
默认情况下,模型在概念推理上的表现很可能远低于其轻易可达到的水平,原因有二:
默认训练对概念任务的泛化能力可能相对较差。我们预计 AI 公司能够通过主要训练相对易于验证的任务(例如,寻找具有更高样本效率的学习算法)来深入参与智能爆炸。此类任务对于我们所需解决的概念性问题是一个糟糕的替代指标,因为这些问题需要在反馈回路极差或根本没有反馈回路的领域中进行强推理。
AI 公司可能会忽视概念推理,因为它对 AI 研发的用处小得多,且商业应用很少。
即使默认训练灌输了所需的基础能力,模型在概念任务上也很可能仍然未被充分激发。
我们在实践中也发现这项工作是可处理的:从我们的初步工作来看,我们的感觉是,基本的激发技术(例如,少样本提示)和小规模训练可以使模型在我们主要的概念推理基准上提升三到十二个月的水平,即将其分数提升大约相当于前沿 AI 数月的进展。
除了 AI 研发对概念推理的依赖要小得多之外,我们给出三个理由来预期,在实践中,概念推理方面的工作对能力的外部性影响很小。第一,推进时间线的能力提升不太可能是反事实的,因为 AI 公司自身的训练很可能无论如何都会产生这些提升。第二,概念推理内部的泛化很可能是不完美的,因此可以通过聚焦风险较低的领域来限制对时间线相关能力的影响。第三,由于通用能力远未被忽视,加速它们的弊端很可能远小于不做这项工作的机会成本(参见Caspar 关于此的文章)。
最后,我们简要讨论我们在这一领域的工作。我们将在后续文章中讨论如何加速概念性推理(包括关于如何加速概念性推理的概念性问题!),以及应聚焦于哪些领域。
AI在多快时间内擅长概念性推理很重要
重要挑战需要概念性推理
在起飞之前和期间,我们需要把许多事情做对,下面我们列举一些例子。我们认为其中许多挑战都包含我们称之为概念性的成分。也就是说,任务的很大一部分与哲学相似,因为它们无法被直接验证,进展依赖于非正式的先验推理,而非训练有素的直觉、知识或实验。我们将在下文更详细地说明概念性推理的含义。(这并不是说下面的挑战纯粹是概念性的——大多数还涉及其他能力,有些能力远比概念性能力更重要。)
我们可能需要解决的问题:
决定在AI安全领域内优先发展哪些研究方向——例如,我们应如何在可扩展监督与控制之间排定优先级?有哪些有前景的研究议程尚未被人想到?
决定哪些实验从长远来看具有信息价值——例如,某个实验能否为我们提供与AI风险本质相关的洞见,以及为什么?
将ASI对齐到我们的价值观——例如,对齐的终极目标应该是什么?让人类保持控制是否足够,还是我们需要做更多来确保未来具有哲学反思性?某个对齐方案是否存在根本性缺陷?
对错位与AGI的风险进行建模——例如,我们应如何对对齐风险进行分类,以便最有效地思考它们——内在错位与外在错位的区分是否是划分这一空间的正确方式?如果我们只做预训练,安全性会提高多少?
决定赋予AI哪些属性——例如,可纠正性是否良好?如果是,正确的操作化方式是什么?
确定某种训练设置产生阴谋行为的可能性有多大——例如,简单性/计数论证是有利于还是不利于阴谋者?
决定AI应如何被监管,以及应推动哪些国际协议——例如,使多极性更可能出现的政策是好还是坏?
关于哪些文明的观点可能具有路径依赖性的问题,以至于我们在起飞之前和期间的观点轨迹可能从长远来看很重要(我们在下一节中对此有更多讨论):
未来应如何形成其哲学观点?例如,当不同的反思过程产生不同输出时,我们应如何在它们之间进行裁决?我们应在何时以及如何对智能体的偏好进行理想化?
我们应该遵循哪种决策理论?例如,事前最优性有多可取?逻辑因果关系是一个合理的概念吗?(我们将在未来的文章中解释为什么我们认为决策理论可能是路径依赖的,而Emery在这里给出了一些支持这一观点的论据。)
我们应该拥有什么样的价值观?例如,我们应该如何处理无限伦理学?我们能否挽救以人为中心的直觉?
在解释为什么上述挑战部分是概念性的之前,我们先更精确地定义“概念性”。我们的定义与Joe Carlsmith在这里定义概念性研究的方式非常相似,1而另一些人则以不同方式使用该术语。就我们的目的而言,概念性任务具有以下两个属性:
1. 经验或数学反馈不足以学会很好地完成该任务
这意味着该任务本身无法在数学或经验上得到可行的验证,并且缺乏足够的可验证代理指标。这也意味着该任务无法使用无争议的参考类数据来解决(当然,在实践中,某事物是否具有好的参考类往往是一个主观判断2)。该任务仍可能受益于一些可用的经验数据,但这些数据无法解决该问题中最困难的部分。该任务也可能具有不太可靠或更主观的反馈形式,例如让许多人阅读一个结论并对其进行争论,然后观察他们是否会趋于一致。
最核心的是,这包括完全没有基准真相的领域,例如(在我们看来)伦理学,但也包括预测一次性的“黑天鹅”事件,比如AI接管,出于实际原因,人们无法等待经验上的解决。
这一标准通常意味着该任务缺乏既定的方法论:人们不能简单地运行实验、撰写证明或进行直接的参考类预测。这也意味着人们无法使用带有可验证奖励的强化学习(RLVR)在该任务或任何可直接识别的代理指标上进行训练。
反馈不足还会以两种方式影响执行该任务的体验。首先,基准真相反馈会建立强大且可靠的领域特定直觉。虽然人们也可以在概念性领域发展直觉3,但这些直觉往往不太可靠(它们可能来自系统性不可靠的反馈来源),或者使问题留下更多未解之处。其次,任务越难以验证,人们在执行任务时就越需要对其成功标准进行反思,有时甚至是根本性的反思。事实上,解决概念性任务往往涉及对问题究竟是什么的“去困惑化”。
2. 进展主要由论证和推理驱动。
这与前一个标准密切相关:由于数学或经验反馈不足,人们不得不诉诸论证和推理。
这一标准还排除了这样一类问题:经验与数学反馈未能解决的部分,主要靠习得的启发式、直觉或无需言说的判断来解决,而非靠论证与推理。例如,艺术与设计大概仅凭标准1就算作概念性的,但它们并非主要由论证与推理驱动,因此标准2将它们排除在外。同样,育儿深受经验数据的影响,却并不被其完全限定,所以人们可能会认为它在某种意义上部分属于概念性。但剩下的部分似乎远比哲学更具启发性。
在实践中,任务往往混合了概念性与非概念性要素,而我们的两条标准都是程度问题。
一个问题之所以是概念性的,一个常见原因是它依赖于(人类的)价值观、倾向或偏好,即依赖于部分与工具理性正交的事物。例如,“我们应当遵循哪种规范伦理学理论?”这一问题的答案大概取决于人类心智的属性。(人类心智的某些属性验证起来很廉价;例如,人们可以通过调查MTurk用户来了解普通人的当前观点。但我们最感兴趣的那些属性通常并非如此。其中许多涉及反思过程的输出,或涉及需要反复输入人类判断的长期计算的输出,或者至少需要理解相关考量的聪明人类的判断。4)我们将这类问题称为反实在论问题。(可论证地)属于反实在论领域的核心例子包括规范伦理学、博弈论中的均衡选择、纽科姆式决策理论以及社会选择。可论证地,其他一些数据稀疏的领域也属于反实在论,因为它们的答案取决于先验的选择(或其现实世界中的对应物),而先验本身似乎就是反实在论的。(例如,考虑量子力学的多世界诠释是否为真、泰格马克第四层是否为真等问题。)
为了更好地说明我们所说的概念性推理是什么意思,下面的维恩图展示了我们认为(或在某些情况下猜测)各个示例领域所处的位置。
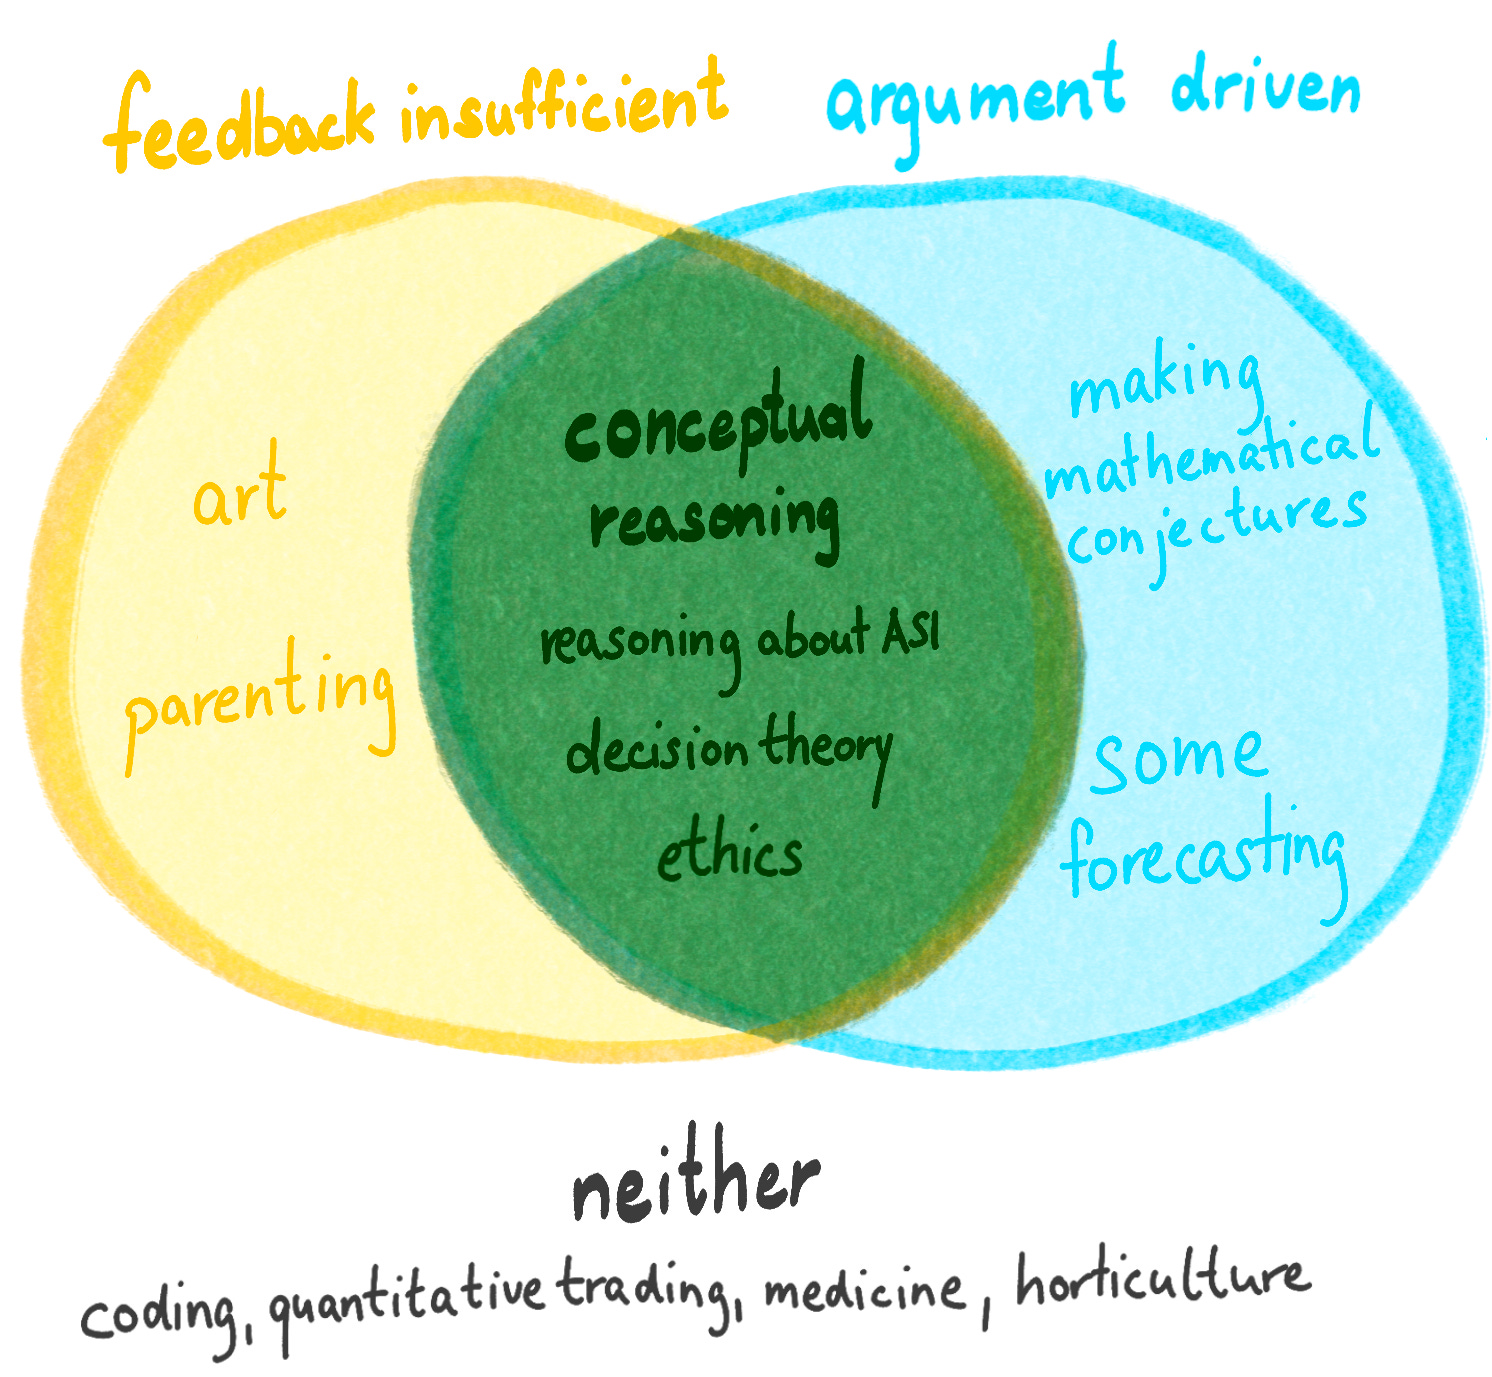
我们在附录:概念性领域的示例与非示例中给出了更多概念性(与非概念性)领域的例子。Joe Carlsmith在此处提供了一份过往概念性对齐研究的示例清单。5
回到上面列出的挑战,其中许多似乎具有关键的概念性成分(通常还伴有经验性或形式化要素)。我们认为这有三个系统性原因:
大量AI安全工作涉及对能力普遍超过任何人类的AI系统(例如ASI)进行推理。此类系统缺乏明显的参照类,我们也没有清晰的方法来建模它们。
对于许多问题,我们等不起经验反馈,因为它来得太晚(例如,当失准的AI接管时,或者当我们多年来一直优先考虑错误的事情时)。
对上述某些问题(例如关于对齐目标、反思、价值观和决策理论的问题)的早期推理很重要,因为存在潜在的路径依赖。这些路径依赖往往源于一个问题是非实在论的,而非实在论的问题往往非常概念化。
旁注:有人可能会反对说,随着我们接近起飞,关于例如 ASI 的推理将变得不那么概念化,因为我们会获得更多关于它的经验证据。如果起飞有些缓慢,这一反对意见就更强。虽然我们同意此类证据使关于 ASI 的问题不那么概念化,但我们认为它不太可能接近消除其所有概念元素。首先,在像接管这样的事件中,一个人能从系统在一种环境中的行为推断出它在另一种环境中的行为(例如,从智能体在蜜罐中的行为推断其在部署中的行为)似乎是一个相当概念化的问题,而且在某些情况下可能很难做出强有力的推断。其次,即使底层能力逐渐提高,行为也可能相对突然地改变。例如,未对齐的 AI 系统可能会等到有良好成功机会时才尝试接管(例如,如果它们预期其继任者会共享其目标,它们可以负担得起等待)。其他人已经详细讨论了我们在多大程度上可以依赖经验证据来进行对齐,因此我们在此不再进一步探讨这个问题。
有人可能会反对说,虽然重要的工作需要概念推理,但它会受到其他能力的瓶颈制约,因此早期概念推理能力影响不大。我们认为这不太可能,原因有三。首先,上述许多任务似乎约 90% 是关于概念推理的,而且许多任务需要比其他能力强得多的概念推理。其次,即使其他能力滞后,也往往可能取得重大进展,而更强的概念推理可以部分替代它们。最后,概念推理在默认情况下可能特别被忽视,因此特别可能落后于其他能力(见概念推理方面的工作可能是反事实的且可处理的)。
AI 研发和接管对概念推理的依赖要小得多
上文我们论证了重要工作依赖于概念能力。现在我们论证 AI 研发和接管对这种能力的依赖要小得多。特别是,我们论证通用的 AI 研发任务在我们对概念任务的定义中所具有的两个属性程度上要小得多,其概念成分不那么关键,而且它们更接近可验证。本节与上一节共同表明,AI 概念推理的改进是差异性的:相对于起飞和阴谋活动的开始,它们将 AI 能够为重要工作提供给定数量帮助的时间提前了。在下一节中,我们论证这种相对时机可能是未来走向的最重要决定因素之一。在后面的一节中,我们转向一个单独的问题:我们所倡导的那种概念推理工作在实践中会在多大程度上加速通用能力。
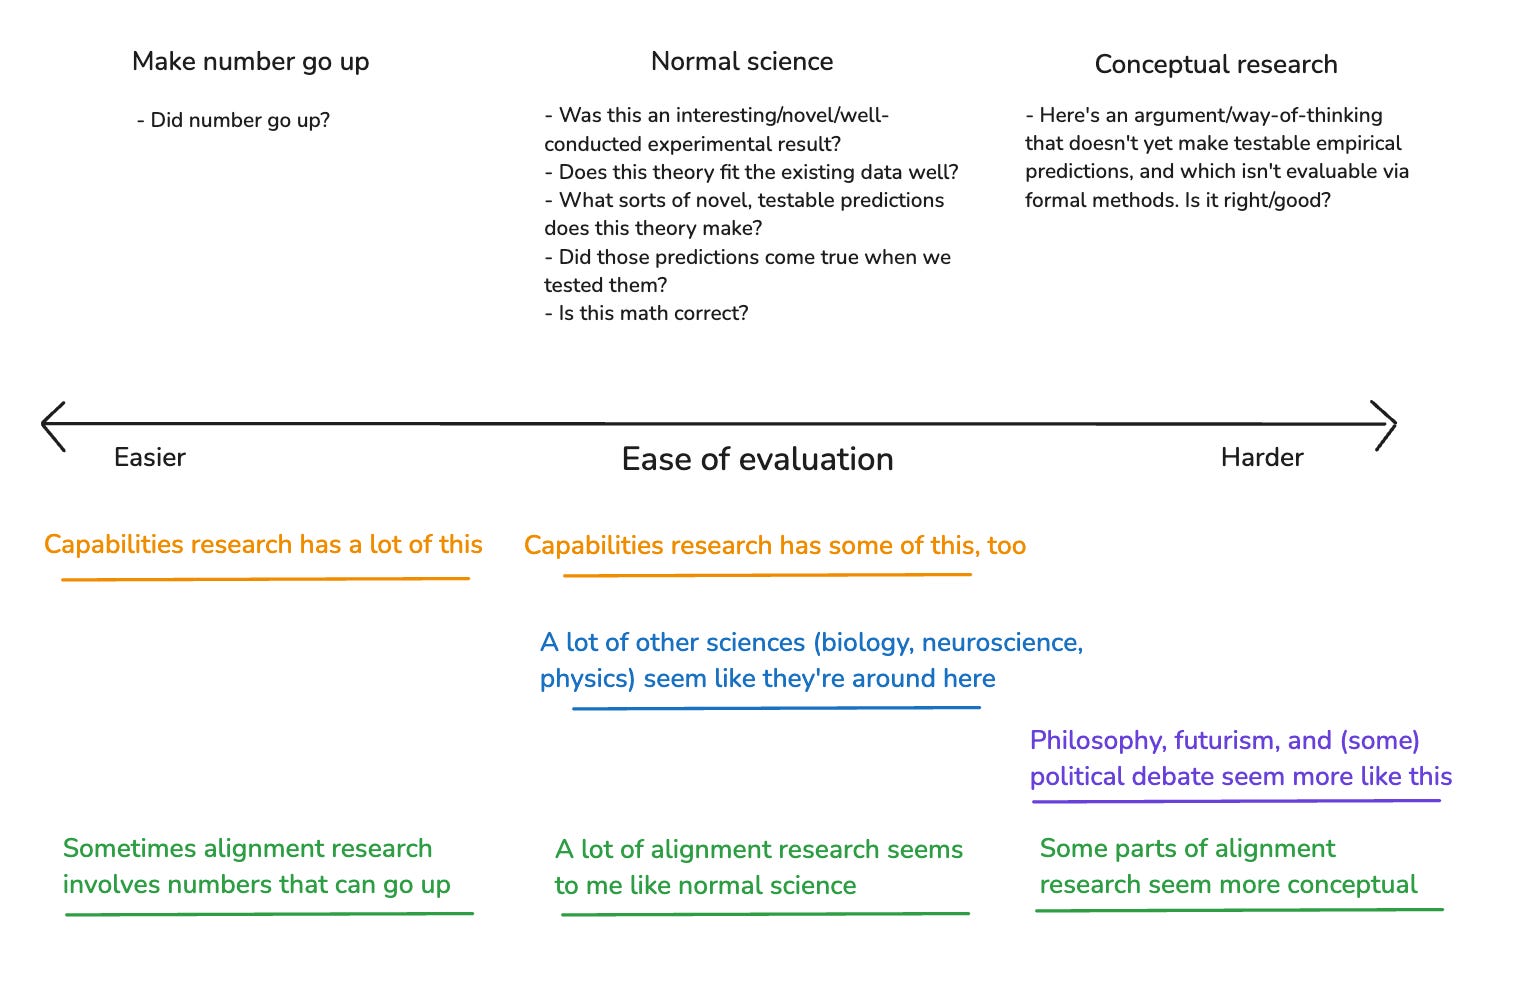
下图:这张图来自 Joe Carlsmith 的《我们能否安全地自动化对齐研究?》,它展示了一个我们大体认同的观点:概念性能力研究与我们希望加速的领域(如对齐研究和哲学)相比处于什么位置。
我们首先讨论 ML 研究品味,这一技能可能成为智能爆炸的瓶颈,因此改进它可能加速时间线。然后我们讨论其他可能加速时间线的部分概念性技能。最后,我们简要讨论在通用能力发展速度固定的情况下,更强的概念推理是否会增加接管风险。我们将对这一问题更充分的讨论留待后续文章。
在通用能力语境下,ML 研究品味在多大程度上是概念性的?
让我们把“品味”理解为包括那些通过论证取得进展的问题,因为如果我们把“品味”视为一种非常直觉层面的东西,那么从非常直接的方法论依据来看,它就跟我们定义的概念推理不同。即便如此,我们认为 ML 研究品味主要是非概念性的,因为其最相关的形式6由关于有效性的预测构成,而人们能从中获得相当多的反馈。7 例如,关于以下方面的预测:
哪些东西会奏效、哪些不会;
哪些东西会变得笨重或过于繁琐而难以处理;
一个实验是否会得出明确的结论;
什么会对未来训练有信息价值、什么会规模化,等等。
即使在 ML 研究品味无法直接验证的地方,它也通过大量可验证任务上的反馈得到训练,并且更多依赖来自经验的启发式和直觉,而非关于分布外主题的先验推理。因此我们认为,ML 研究品味在很大程度上可以从经验反馈中学习(例如通过 RLVR),远比我们上面讨论的任务更甚。
此外,大多数能力工作似乎主要关乎当前能力,并不需要(太多)关于超级智能的推理,这与许多 AI 安全工作形成对比(见上文讨论)。而且,反实在论问题(如上所述)对能力研究似乎并不重要。
最大的注意事项是,某些东西可能对超级智能特别具有预测性,而这种预测性无法被视为其他类型预测的连续延伸。例如,某人可能有一种“品味”,偏好更接近人类智能的研究方向(例如偏好更像大脑的神经网络架构,偏好多模态模型而非纯 LLM),主要是着眼于 AGI。这种品味——以及关于它是否合理的争论——似乎有些概念性,因为它并不那么依赖于做出近期预测。然而,我们认为这样的大概念洞见大概不会对 AI 研发构成多大瓶颈。我们在附录:ML 是否受概念洞见瓶颈制约?中对此有更多讨论。
作为对我们观点(概念推理对 ML 研究相对不重要)的经验支持,我们注意到,与在更狭窄的 ML 研究任务上的技能相比,AI 公司在选拔 ML 研究人员时似乎也相对较少看重概念推理能力。8
一个可能的反对意见是,AI 公司会从 RLVR 等方法中摘取低垂的果实,从而使 AI 研发剩余的瓶颈更加偏向概念性,因为概念性技能更难用这类方法训练。 在最极端的情况下,某些概念性任务可能对智能爆炸推进到某一节点之后是必不可少的。 我们同意,这一效应使得相对于 RLVR 而言,提升概念性推理对 AI 研发的价值比目前更高。但我们认为,概念性推理会因此成为 AI 研发瓶颈的说法相当不可信。 特别是,我们不认为提升 AI 的概念性推理会值得占用 AI 公司相当一部分资源,并且我们预计它仍将是一种低效的加速 AI 研发的方式。
其他可能与时间线相关、且可能属于概念性的能力
考虑预测智能爆炸这一任务。该任务的某些方面似乎属于概念性的,因为智能爆炸是如此前所未有。AI 在这项任务上表现更好可能缩短时间线,例如帮助 AI 公司更好地分配资源。但它也有好处:对时间线和风险更好的预测将提升我们做准备的能力,并让公众更知情(尽管这也可能让政府更倾向于竞赛)。类似地,虽然战略推理通常能很好地受益于经验反馈,但关于智能爆炸的战略推理似乎部分属于概念性的,提升它既有好处也有坏处。如果这些是提升概念性推理的唯一效果,那么净效应就不那么明确了。因此,我们目前不建议专注于这两类能力的通用版本。但我们认为概念性推理的其他好处超过了这些可能的坏处。
加速阴谋策划
另一个担忧是,更强的概念性推理也会加速与接管相关的能力,例如阴谋策划、突破控制方案,或(错误地)对齐继任者。我们认为这比其对时间线的影响重要得多。AI 公司已经在努力加速通用能力,这使得我们对这些能力的反事实影响很小(见对通用能力的影响可能很小),但它们并没有试图加速接管专用的能力。尽管如此,我们预计对与接管相关能力的影响仍小于好处。这一担忧影响了我们建议专注于哪些概念性推理领域;例如,我们认为很可能应当避免加速控制红队测试。这个话题值得比我们在这里所能给出的更充分的讨论,我们打算在未来的文章中提供。我们在下面概述一些想法:
我们预计,概念性推理能力的提升对 AI 是否在进行阴谋策划影响很小,对它是连贯的阴谋策划者还是泛泛地擅长战略推理也只有适度影响。这主要是因为训练的其他部分似乎更强地训练了通用战略推理和阴谋策划,而这些技能似乎大多是非概念性的。
我们认为,接管之所以受阻,主要瓶颈在于非概念性技能。它似乎需要强大的领域特定技能(例如生物、网络、说服)以及对文明的理解。其较难验证的部分更像是通用的现实世界策略,而 AI 公司已经有强烈的动机去训练这一点。
我们确实担心 AI 在推理自身可能处于何种控制措施之下、以及如何规避这些措施方面的能力提升。虽然更强的控制推理也会提升 AI 设计控制方案的能力,但如果 AI 已经在图谋不轨,这种能力不太可能对我们有帮助,因为它可能在这项工作上故意敷衍。
我们确实担心 AI 提升使其后继者与自身对齐的能力。我们认为这种效应可能在一定程度上降低了让 AI 更擅长对齐的价值,但我们认为它不太可能使该价值变为负值。如果早期 AI 没有在耍心机,提升其协助 AI 安全工作的能力显然是有益的。如果它在耍心机,这种提升可能有害,但这似乎不那么明确,或者至少在任何没有早期耍心机的世界里,危害似乎都小于收益。其一,那样的话情况很可能默认就会变得很糟。其二,如果我们能防止敷衍行为,这种提升仍然有正面效果,例如通过在我们关心的任务上用高质量数据集训练 AI(关于这一点的讨论见这篇文章)。例如,如果一个耍心机的 AI 无法敷衍,那么它对对齐的更深理解也应该通过它为我们所做的研究来增进我们自己的理解。对对齐(例如训练何时会产生耍心机者)的更好理解,反过来可能使我们更有可能发现 AI 在耍心机。最后,许多对齐工作在一定程度上是特定于与人类价值观对齐的。一个未对齐的 AI 为了使其后继者与自身对齐而必须做的工作可能相当不同,或许概念性更弱(例如,一个区别是未对齐的 AI 已经掌握了其训练过程导致其价值观的信息)。
AI 更早具备更强的概念推理能力将非常有价值
也许决定我们在第一节所列挑战上表现如何的最重要因素,是 AI 能在多大程度上、以及在相对于起飞多早的时候协助应对这些挑战。由于这些挑战似乎比 AI 开发更需要概念推理(见前两节),这种协助相对于起飞的时间点在很大程度上取决于 AI 的概念推理能力。因此,AI 更早具备更强的概念推理能力通过两条影响路径有所帮助:
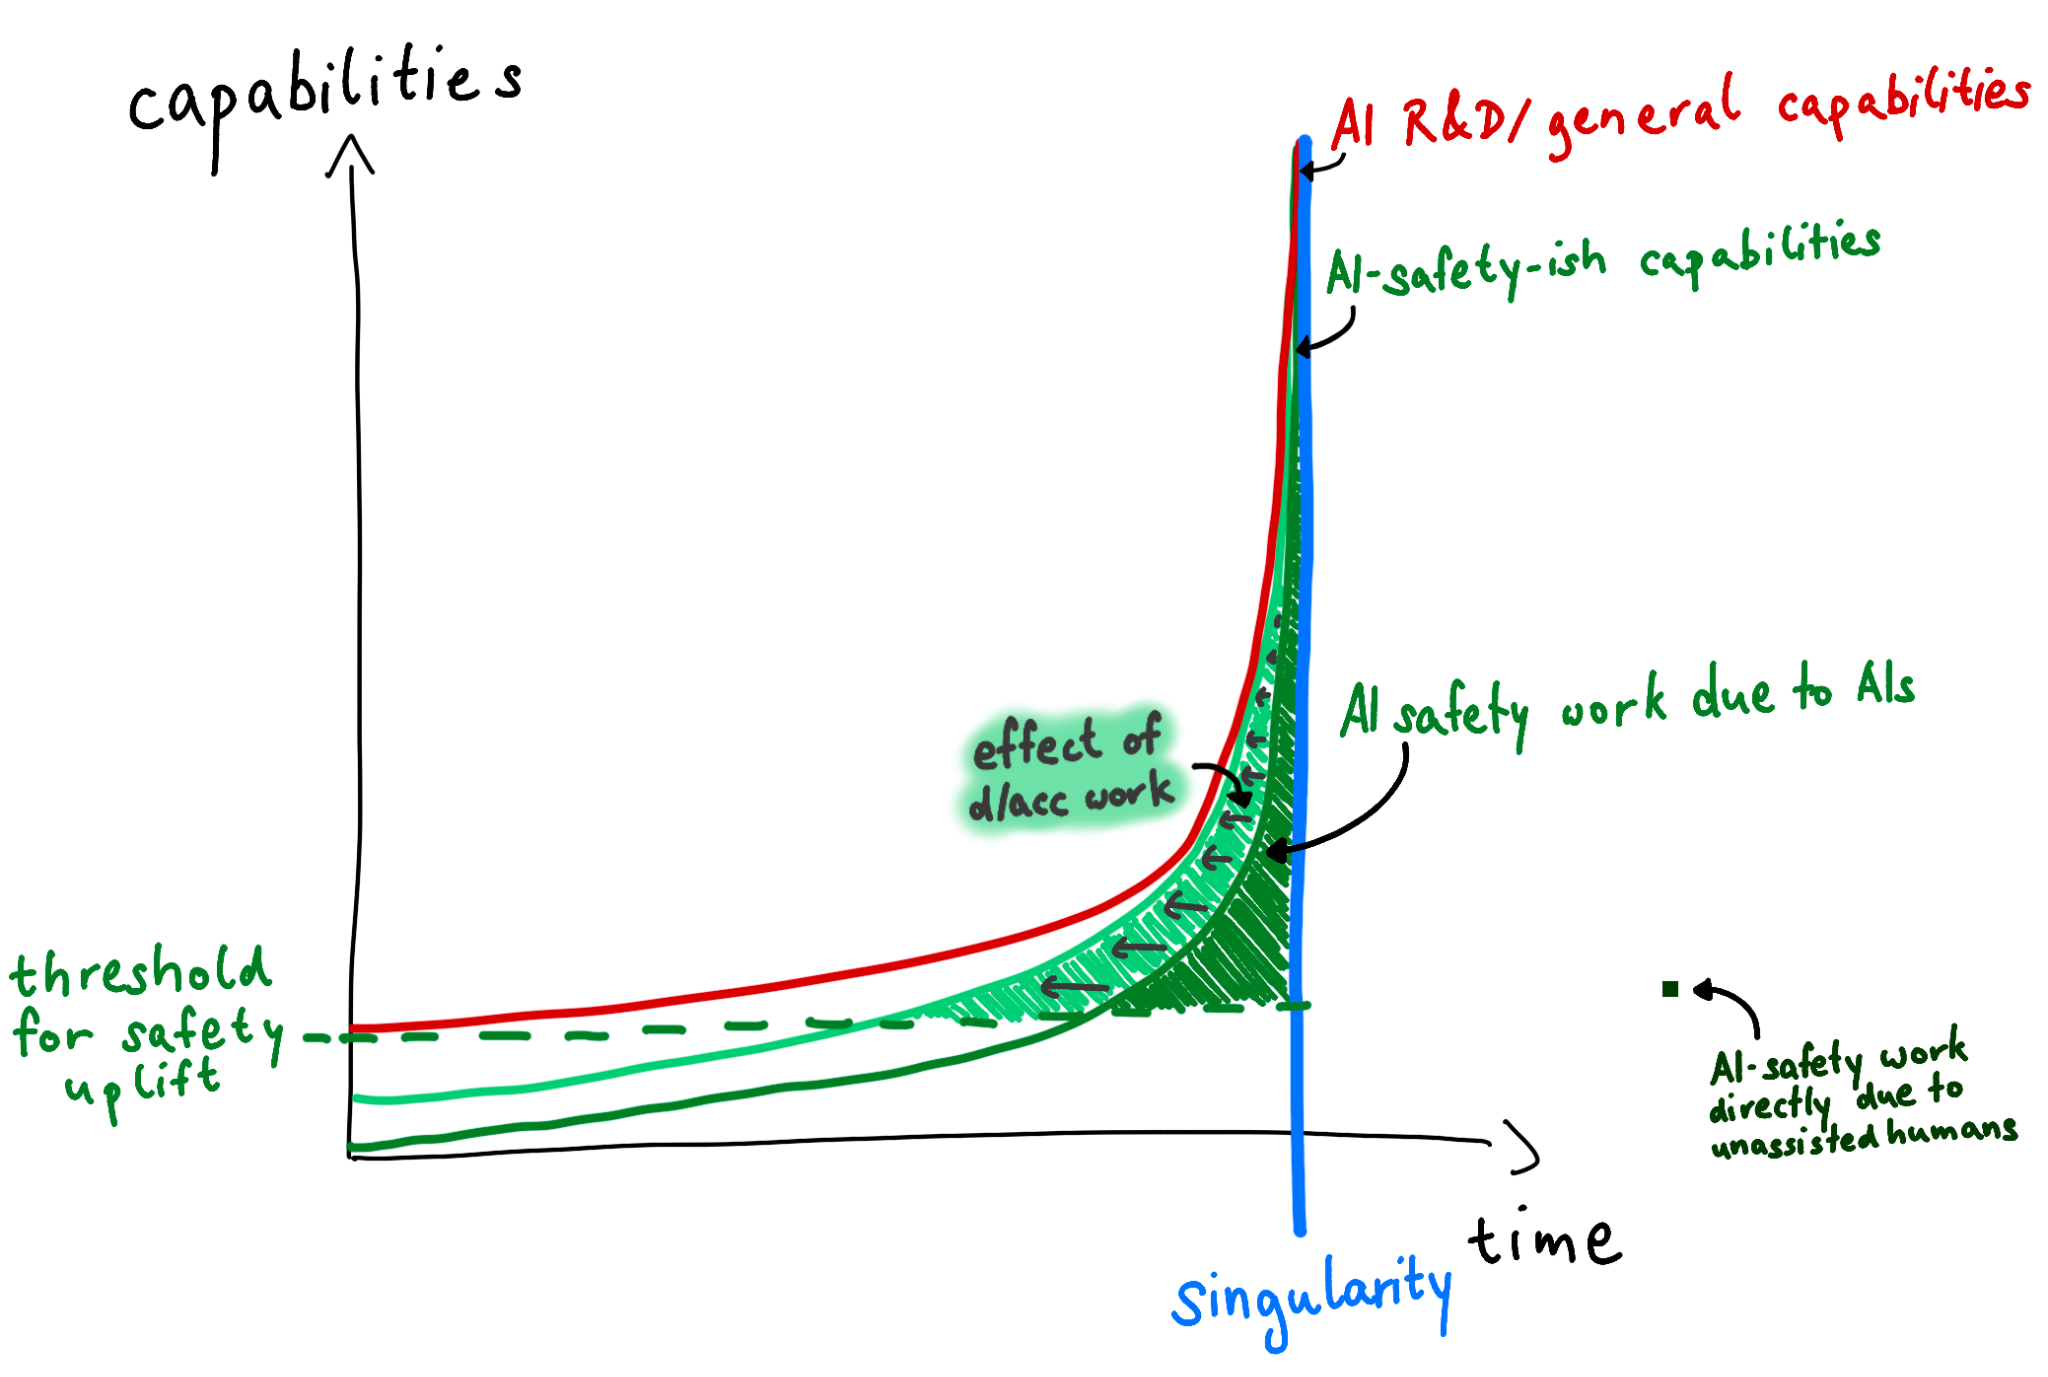
有足够时间解决重要问题:一旦 AI 在某类重要工作上达到专家人类水平,其产出很可能使无协助的人类产出相形见绌。因此,我们能否及时完成相关工作的一大决定因素,是相对于起飞我们多早能将其自动化或提升。最直接地说,如果默认情况下我们只能在 AI 研发自动化之时或之后才能将其自动化,那么在此之前将其自动化或提升将大幅增加我们及时完成工作的机会。

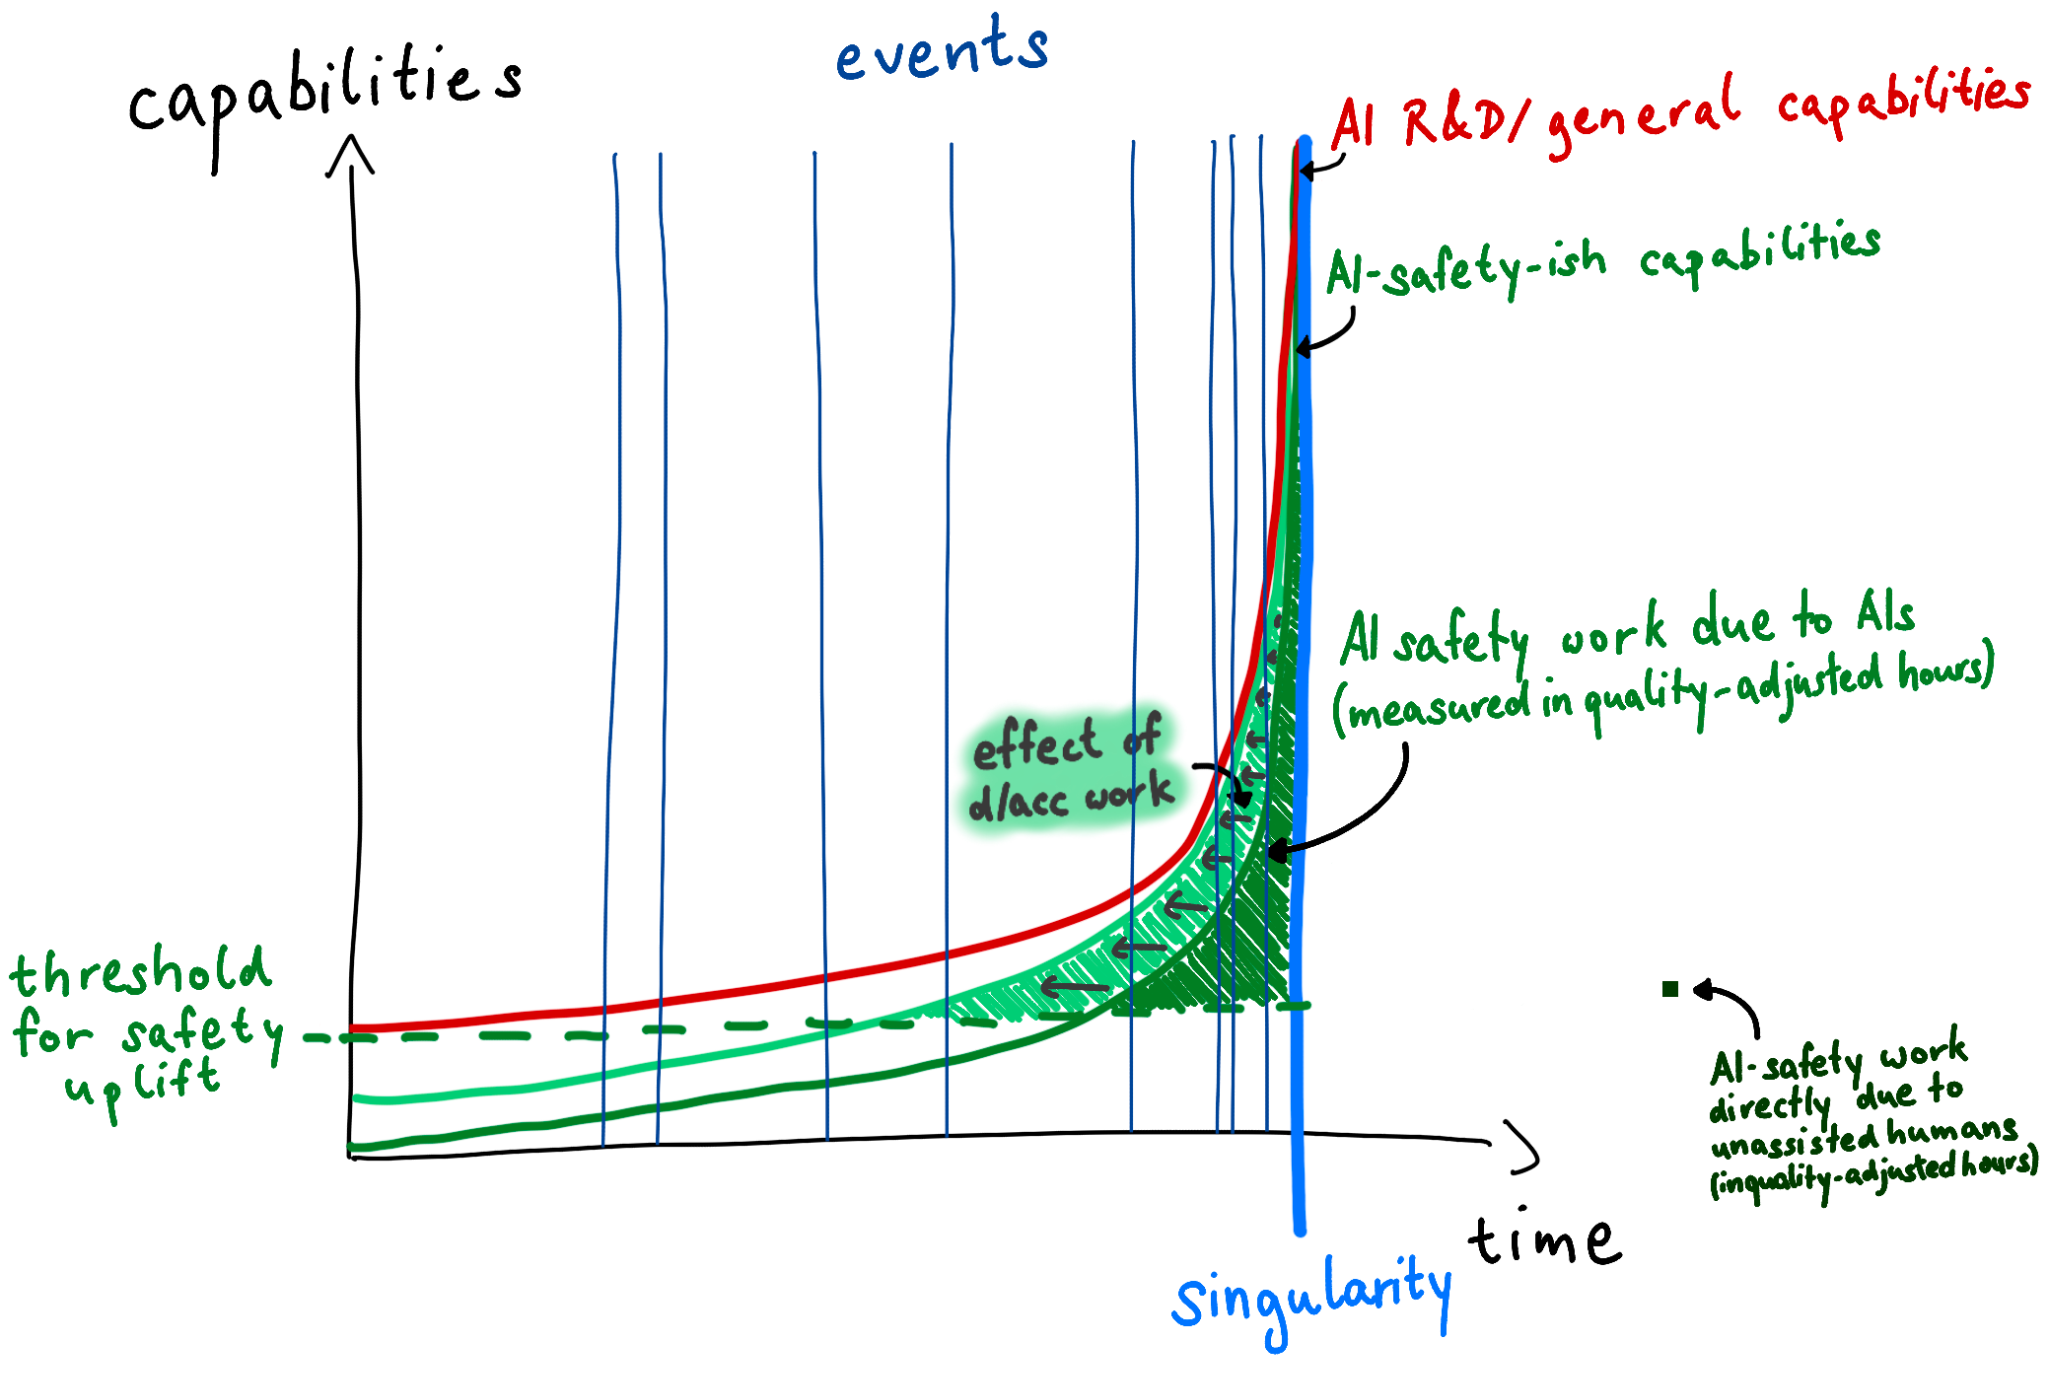
在这张图中,我们用“AI 安全”泛指任何使 AI 向好的方向发展的工作,包括技术性和非技术性的干预措施。该图展示了差异化加速 AI 安全能力对总(质量调整后的)AI 安全工作的影响。右侧的绿点表示无辅助 AI 安全工作的总量。(这些领域均未考虑早期工作的优势。在现实中,无辅助的人类工作远比其数量所体现的更为重要,因为它出现得更早。) 但即使默认情况下我们能在 AI 研发自动化之前数月就实现相关工作的自动化,更早这样做仍然非常有价值。其一,由于 AI 系统可能未对齐因而不可信,我们可能需要人工验证和讨论,这会耗费时间。其二,实施解决方案也需要时间。
最后,我们相对于 AI 达到某一给定程度的未对齐和谋划而言越早实现相关工作的自动化就越好,因为可能难以防止偷懒行为,而来自连贯谋划者的工作显然更不可信。(我们预计概念性推理对 AI 安全的加速作用大于对谋划的加速作用;见上一节。)
上述讨论假设唯一相关的“截止期限”是起飞(或其前不久的某个时点)。然而在现实中,我们将面临许多无法无代价推迟的决策,例如优先级决策或关于实施哪些干预措施的决策。每个此类决策的质量取决于为回答该决策所依据的问题而投入的质量调整后工作的总量(包括揭示最初并非由该决策引发的考量因素)。许多较近的“截止期限”也会随起飞时间而移动(例如“AI 研发自动化之前的倒数第二次训练运行”),因此某一给定水平的 AI 安全能力相对于起飞的时间点在这里也很重要。对于许多决策而言,决策时人类与 AI 的合计 AI 安全能力也很重要。我们希望 AI 帮助我们在任何给定时间点做出尽可能最佳的决策。
注:上述部分内容基于对所需工作量及相关能力何时到来的一个较为宽泛的分布。如果认为只需相对较少的 AI 安全工作(例如仅靠人力就足够),或认为实现其自动化所需的能力会非常早到来(例如在起飞前数年),那么更早的 AI 辅助就不重要了。我们认为第一种观点有一定道理,但并非压倒性地可能;它也会降低许多其他 AI 安全工作的价值。基于我们观察到的相关能力趋势,我们认为第二种观点不可信。在另一个极端,如果认为及时完成相关工作完全无望,那么更早的 AI 对技术性 AI 安全工作的辅助也不重要,尽管 AI 辅助对于提升政策工作可能仍有价值(例如,如果 AI 能更好地推理 AI 风险,或许它能更好地说服政治家和公众相信 AI 风险是一个大问题)。我们认为后一种观点有一定道理,但我们对其置信度不足以认同其结论。
路径依赖:社会对包括伦理在内的各种议题的看法可能具有路径依赖性。例如,某个人所持有的道德观点可能取决于她遇到了哪些论证以及何时遇到,而一旦她持有特定观点,她可能希望采取行动以确保未来的智能体与她持有相同的道德观点。因此,AI 引导人类反思朝更合理的方向发展(并就它应该和不应该进行何种引导做出合理推理)可能产生持久影响。(本文主要并非讨论路径依赖,因此我们不会在此论证其合理性。关于路径依赖的一些讨论,包括反路径依赖的直觉是否应当解决它,参见例如 Emery 关于决策论反实在论的文章、论理想化价值的局限,以及 Emery 即将发表的关于影响 AI 决策论的时间敏感性的文章)。我们用下面(过度简化的)示意图来说明这一点。例如,考虑社会的道德观点。我们认为这些观点有许多可能的吸引盆。尽管我们是道德反实在论者,我们也认为其中一些吸引盆比其他更合理。例如,我们预期深思熟虑的人类至少会部分共享关于合理的反思过程会涉及什么、不会涉及什么的各种直觉。这样的反思过程会将观点推向某些吸引盆并远离其他吸引盆。在下图中,“理性之风”代表这些合理反思过程的力量。“大吸引盆”代表这些反思过程所推向的某类观点。“糟糕吸引盆”代表可能反而默认出现的、来自更混乱或错位过程的观点吸引盆9。让 AI 能更早地帮助人类反思哲学问题(例如,相对于超人类说服能力而言),就类似于更早地启动“理性之风”。(当然,人们也可以在此做许多其他可能有益的事情。)这条影响路径与上文讨论的路径在多个方面不同,包括哪些能力对它最有用。Caspar 的关于让 AI 更擅长道德哲学的文章进一步讨论了这类影响路径。
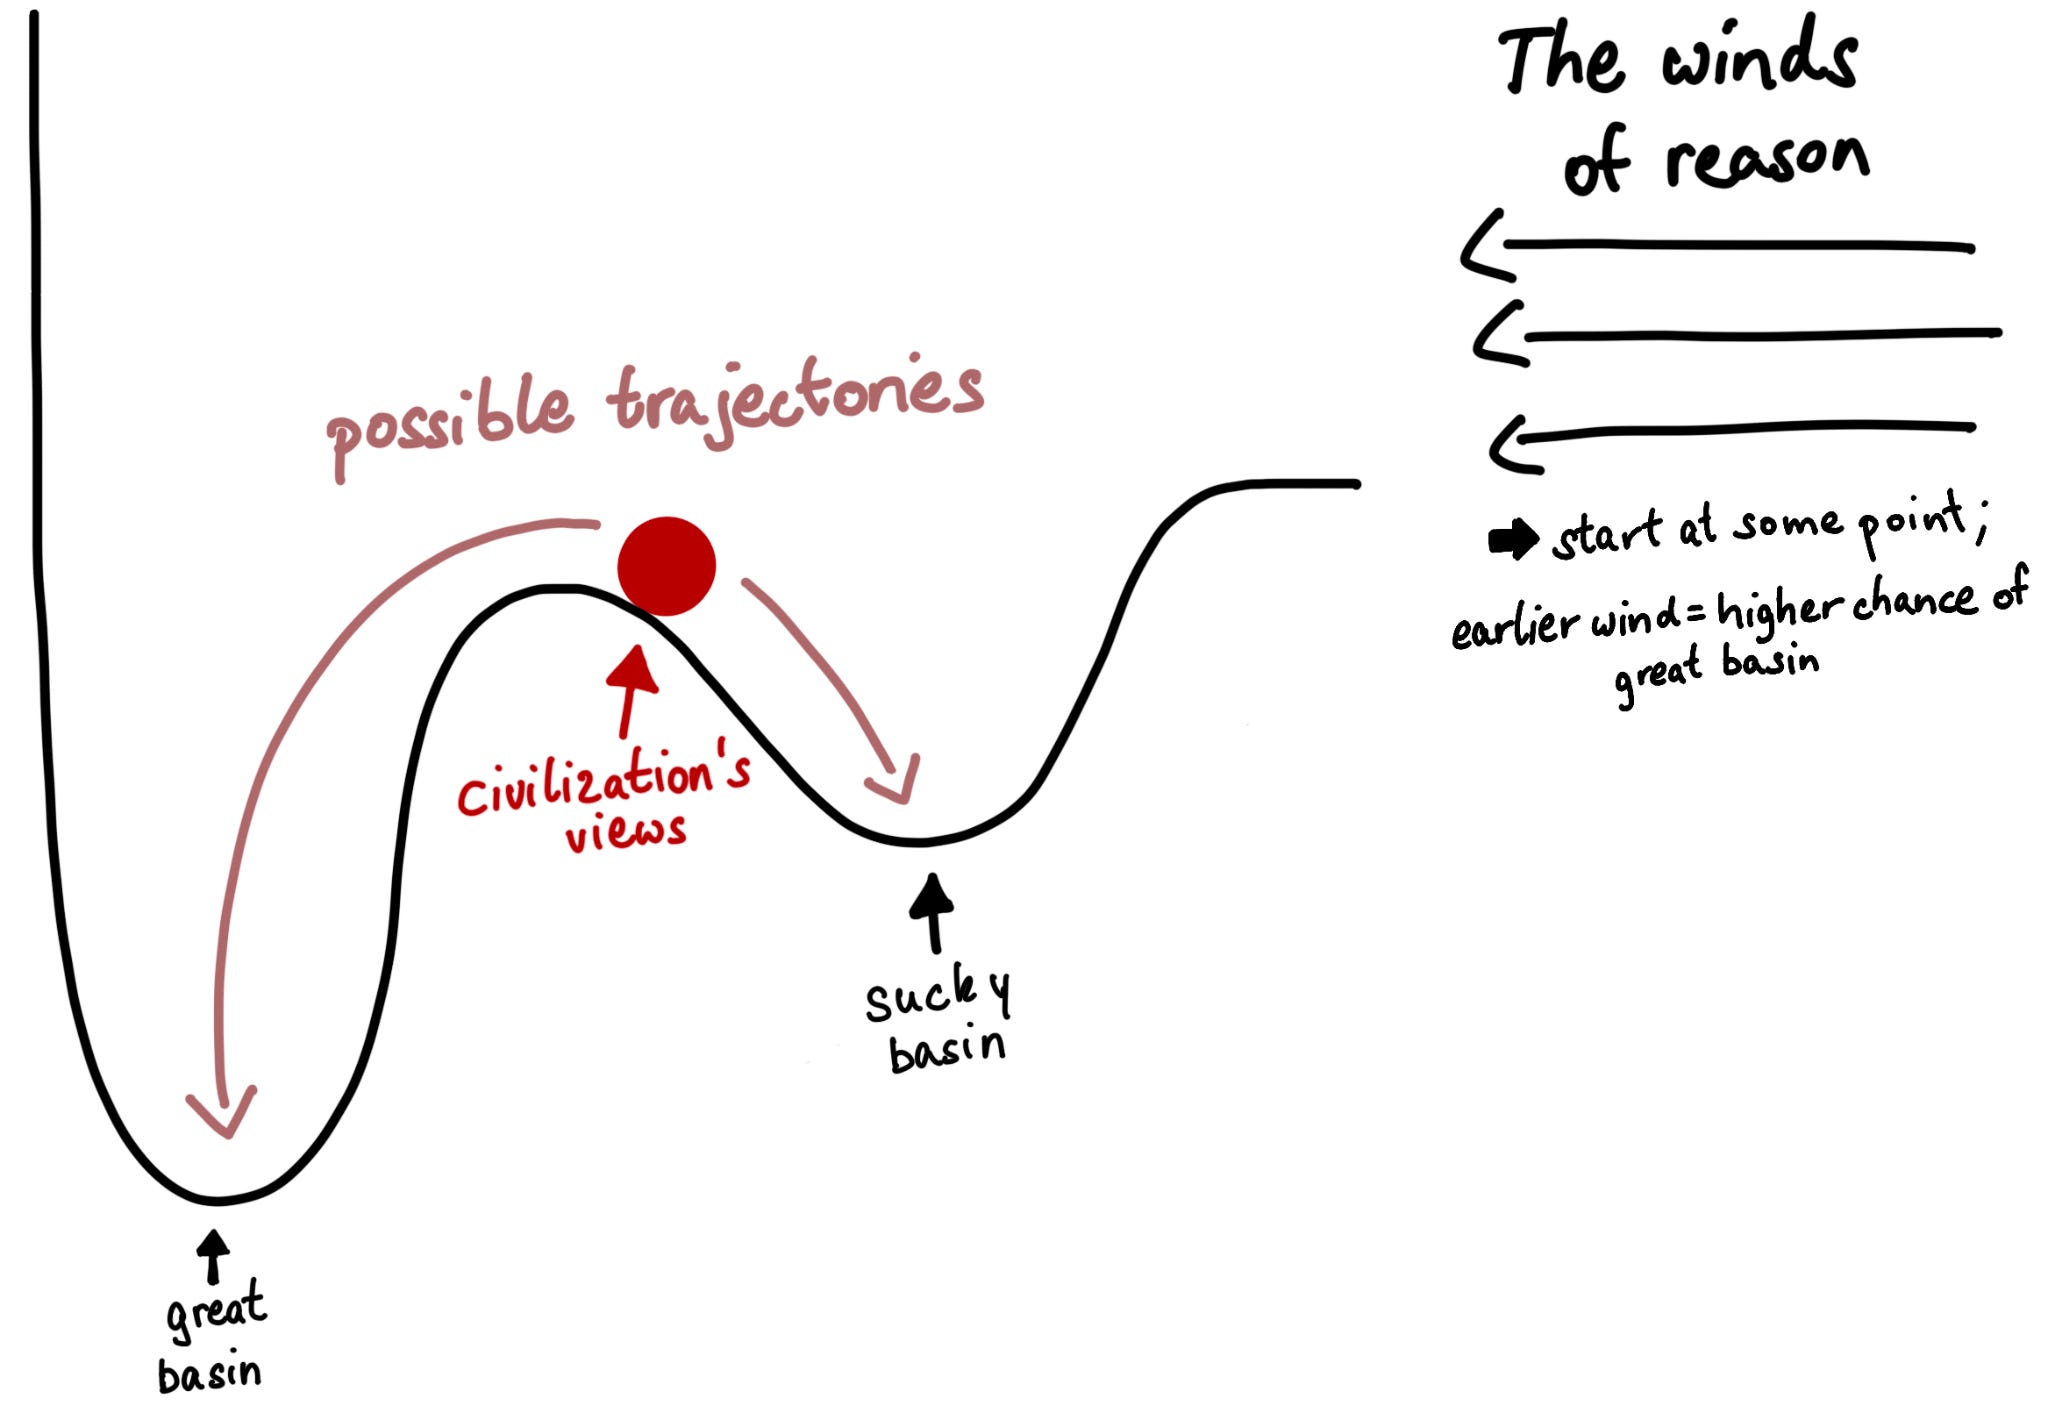
总体而言,我们认为,从今往后10的任何时间点,如果模型能更好地帮助我们应对上文列出的所有重要挑战,那将是非常好的。
我们或许能够差异化地加速概念推理
概念推理方面的工作很可能是反事实的且可处理的
我们的实验表明,通过使用强度大致相同的模型作为奖励信号,在概念论证数据的不同分布上训练模型,有可能使模型在我们的概念论证基准(LMCA)上提升数月的水平。我们此前在提示和脚手架方面也取得过类似成功(以进展月数衡量),尽管这些结果相对较旧。这些结果并不太令我们意外:概念推理是一种较为特定的技能,AI 公司缺乏训练它的激励,而预训练之外的现有训练似乎也不适合教授这种技能。我们在下文详细阐述这两点。
首先,AI 公司训练概念性能力的动力很弱。此前我们曾论证,AI 研发并不太依赖概念性能力。正因如此,我们认为 AI 公司或许仅凭 AI 在其他训练中附带获得的概念推理能力,就能实现 AI 研发的自动化,并深入智能爆炸阶段。概念推理能力似乎也几乎没有商业价值。的确,有商业价值的技能通常能从现实世界获得直接反馈(例如,一种能在短期内跑赢市场的技能会以利润的形式获得反馈),而概念推理的特点恰恰是缺乏此类反馈和现有数据。11 AI 公司确实有一些训练概念性技能的动力(例如上文所述,预测起飞对 AI 行业既有用又部分属于概念性),但这些动力似乎相当有限,以至于 AI 公司可能会相对其利他重要性而忽视概念推理。
此外,训练概念性能力与 AI 公司的日常活动有些不同,因此它们可能并不适合独自开展这项工作。由于概念性任务无法直接验证,训练可能需要专家人工数据12,或者需要由本身擅长概念推理的人撰写的评分标准和提示词。
其次,我们预计 AI 公司的默认训练会使 AI 在概念推理方面的表现比其本可轻松达到的水平更差。预训练似乎应当能教会概念推理,因为部分预训练数据是概念性的。但后训练,尤其是 RLVR,在训练中所占比例越来越大,我们预计这一趋势将持续下去。概念性任务似乎相对不太适合用 RLVR 来训练,因为无法直接用 RLVR 对它们进行训练,而能用这种方式训练的任务对它们而言是很差的替代。由于推理训练是 RL,这一困难似乎也是概念性任务在推理时扩展方面的问题。我们在 LMCA 上的结果似乎支持这一图景:模型在该任务上随时间不断进步,大概主要归功于更好的预训练,但通过努力程度来扩展推理时计算量充其量只能带来微弱增益。
一种可能的反对意见是,概念性推理可能主要由通用智能加上少量简单技能构成。若果真如此,模型可能会相对较早地习得概念性推理所需的特定技能,此后我们只需等待通用智能通过大量通用训练(例如在大量数学题上进行强化学习)追赶上来。那么,针对概念性推理的研究就不会具有很强的反事实性。我们认为,概念性推理与大多数其他技能一样,在某种意义上主要由通用智能驱动,这一看法是合理的,但我们不认为由此可以得出上述结论。特别是,我们仍然需要确保模型在概念性任务上得到良好的引导(并且,如果它们正在谋划,确保它们不会在这些任务上故意放水)。即使模型具备概念性推理所需的全部底层技能,概念性任务与非概念性任务在外观和感觉上也足够不同,以至于模型未必会在没有训练的情况下应用这些技能。反过来,要在概念性任务上良好地引导模型,至少需要一种衡量其进展的方法,我们预计针对此类衡量的定向工作将极具价值。(我们的大部分工作集中在制作基准测试及类似资源上。)与此相关,我们发现模型在嵌入概念性语境中的数学问题上表现相当差,尽管它们在孤立提出的数学问题上显然非常擅长。这支持了这样一种观点:改进概念性推理部分上是一个引导问题。
旁注:我们并不一定期望不同概念领域之间会有很多泛化。例如,一些AI对齐工作似乎与道德哲学相距较远。而从经验上看,我们的感觉是,从小规模训练中的泛化相当弱。我们对此的看法随时间演变:基于经验证据,我们逐渐更新为预期更少的泛化。出于这个原因,未来我们有可能决定更狭窄地聚焦于我们认为最重要的领域。尽管如此,我们目前的观点是,从方法论角度将概念性推理作为一个整体来思考是有意义的:所有概念领域都提出了关于衡量的类似根本性问题,且一些技术可能适用于广泛的概念领域。
对通用能力的影响可能很小
上文我们给出了理由认为,AI研发对概念性推理的依赖远低于AI对齐和哲学等领域。在此,我们从能力本身转向实践中的概念性推理工作,并给出三个理由预期此类工作的影响将高度差异化。
首先,我们的工作对通用能力的影响不太可能是反事实的。概念推理方面的工作必然会影响许多不同的能力:有些对我们想要加速的工作有用,有些对通用能力有用,有些对两者都有用,有些对两者都无用。在这些能力中,那些有助于实现 AI 公司所瞄准的通用能力的能力,极有可能与现有训练重复,因为 AI 公司的其他训练无论如何都更有可能产生这些能力。例如,人们可能会预期从 LMCA(我们的概念论证数据集)到数学有一定迁移,因为相关推理风格存在一些重叠。但一旦预训练数据耗尽,只需在具有可验证奖励的问题上进行训练,就能更容易地获得相关的数学技能。13 机器学习领域似乎也是如此。尽管有些机器学习任务过于昂贵,无法直接基于可验证结果进行训练(例如,从头到尾为下一个前沿模型设计训练计划),但这些任务的许多相关技能很可能也会出现在成本较低、基于结果的强化学习可行的任务中。此外,如果仅靠基于结果的奖励并非训练机器学习研究品味的最有效方式,AI 公司可能会例如制作其顶尖机器学习研究人员的判断数据集(鉴于公司将这些模型用于 AI 研发,这很可能自然而然地导致此类数据集的构建)。如果是这样,其他概念推理工作对机器学习研究品味的任何残余影响都会小得多。
其次,我们可以专注于特定的概念推理领域,避开那些似乎与时间线最相关的领域。与 AI 研发最相关的概念技能可能与我们所关注领域最相关的技能有所不同。然而,这一考虑比乍看起来要弱,原因有二。我们的数据集可能使人们能够测试针对更广泛领域的技术(见下文)。而且,通过倡导概念推理方面的工作,我们可能会引导那些工作目标不够谨慎的人从事这方面的工作。(我们在决定撰写这篇文章时已经考虑到了这一点!)
最后,我们认为,基于通用能力被忽视的程度,有充分的先验理由预期加速通用能力带来的负面影响(远)不如我们的机会成本重要。更多相关内容,请参阅 Caspar 关于能力外部性与机会成本的简单论证的文章。我们预计这一先验论证主要适用于此处。
反方观点:利用我们的数据集开发通用技术
我们通常认为我们的数据集很有价值,因为对于某些我们想要加速发展的领域 X 来说,它们是唯一优质的数据集。但很可能存在一个更大的领域集合 Y,对于这些领域,我们的某个数据集同样是唯一或最好的数据集。如果是这样,该数据集就可能推动 Y 领域的工作。例如,LMCA 很可能是关于评分论证的总体最佳、也许是唯一优质的数据集。它可能也是关于“模糊任务”(即没有廉价可验证的真实奖励的任务15)的最佳公开可用14数据集。如果是这样,LMCA 就可能更广泛地推动模糊任务方面的工作:如果 Alice 有一种针对模糊任务的通用技术(比如辩论),并且可以预期该技术在概念论证上与其他模糊任务(例如推理如何最大化 AI 公司的收入)上同样有效,那么 LMCA 就能让她测试该技术。
如果不更好地了解我们的数据集在反事实情况下能让人们测试哪些通用技术,这一担忧就很难评估。但根据与 AI 公司员工的交谈,我们认为这是一个合理的担忧。
有两点考虑似乎能在一定程度上缓解这一担忧。第一,如果某项能力对 AI 公司很重要,他们很可能希望制作一个更直接针对该能力的基准(尽管我们的数据集仍可能更早地为他们提供至少一个相关基准)。第二,针对我们的基准而非其他基准进行测试,可能会将相关技术的发展引导到有益的方向,例如引导向在概念性任务上表现特别好的技术。
我们的工作
迄今为止,我们主要专注于制作概念推理数据集和基准,而非训练或开发技术。这主要是因为高质量数据集的更好可得性将解锁这一问题上其他方面的工作:数据集构建需要概念推理专业知识,这是我们的比较优势,而高质量的概念推理数据集很少。此外,数据集几乎是任何其他干预措施的前提条件,并使其他人(例如更专注于机器学习的人,甚至未来的 AI 智能体)能够做出贡献。数据集在某种程度上还具有稳健的实用性(例如,它们也可用于预测未来发展并帮助确定优先级)。你可以在我们的概念推理指数(CRI)网站上阅读更多关于我们数据集的信息并查看结果。我们也非常有兴趣将他人的高质量概念推理数据集纳入 CRI,因此如果你拥有或正在开发希望被纳入的数据集,我们鼓励你联系我们。
我们当前的项目之一是一个数据集,用于评估模型在生成性概念任务上的表现,这些任务恰好处于我们希望模型擅长的分布范围内。衡量模型在生成性任务上的表现具有挑战性,因为这需要自动评分,而 LLM 评分器很容易被钻空子。但这也使得开发更好的方法来评估这些任务上的表现尤为重要。
我们也有兴趣改进与概念推理相关的倾向。例如,我们目前认为模型推理的可读性差限制了其在概念推理中的有用性和可信度。模型常常以含糊且令人困惑的方式写作,似乎是为了掩盖其错误(也许是因为 RLAIF 奖励了这种做法)。我们认为解决这个问题可能极其重要。此外,模型对概念性问题的回答目前似乎以不透明的方式严重迎合用户。这似乎不好,尽管理想行为在这里尚有争议。我们正在构建一个数据集,以更好地衡量概念领域中的谄媚等行为。
我们将在即将发布的一篇文章中更详细地讨论我们对概念推理内部优先级的想法。
简而言之,我们目前最优先进行差异化加速的领域是技术性 AI 安全、决策理论、安全帕累托改进,以及原因优先级排序中特别概念性的方面。在其他一些领域改进 AI,例如预测智能爆炸,可能也有价值,但双重用途或其他负面外部性的风险更高。
我们一直在寻找更多人参与我们的议程。如果你有兴趣与我们合作,或从事类似工作,请通过 info@rdwrs.com 联系我们。
致谢
我们特别感谢 Alex Kastner、Lukas Finnveden 和 Buck Shlegeris 提供的广泛反馈。我们还要感谢 Alexa Pan、Anthony DiGiovanni、Carlo Leonardo Attubato、Carlos Giudice、Eli Lifland、Francis Rhys Ward、Hasan Baig、Jeremy Gillen、Jo Jiao、Julian Stastny、Keshav Shenoy、Lukas Gloor、Megan Kinniment、Miles Kodama、Nathaniel Sauerberg、Netzer Epstein、Rohin Shah、Thomas Larsen、Vojta Kovarik 和 Zephaniah Roe 提供的有益评论和讨论。
附录:概念领域的示例与非示例
本附录举例说明我们所说的概念推理是什么意思。关于我们目前认为最值得加速的领域,请参见我们的工作。
伦理学。我们将伦理学视为一个典型的概念领域。16 它显然符合我们的标准:它缺乏解决分歧的既定方法论;它不从世界获得反馈;其进展主要来自论证。
数学。按我们的定义,数学主要不是概念性的。特别是,评估所提出的数学陈述是否为真(通过证明或反例)不是概念性的,因为它是完全可验证的。回答完全定义的问题(例如解决巴塞尔问题)同样不是概念性的。
一些应用数学,例如应用统计学,本质上基于预测现实世界事件,因此现实世界的反馈也使其成为非概念性的。
话虽如此,我们会将数学中的一些基础性活动视为概念性的:一般来说,那些与形式化我们已有一定直觉的概念相关的活动,以及选择研究哪些问题(当不受现实世界或数学应用引导时)。例如,发展数学的公理化基础就是概念性的——特别是反思哪些公理是“自然的”(例如,是否假设选择公理)。相比之下,给定公理化是否足够强以推导出所有标准数学的技术性问题则是非概念性的。逻辑和概率的基础,以及学习理论中的一些基本思想(如遗憾的概念),也具有一定的概念性。
重要的是,并非所有定义性或领域奠基性工作都是概念性的。其中大部分主要由实际应用和现实世界反馈驱动。例如,线性代数的基本概念将长期理解的思想系统化,具有直接、已知的实际应用,如求解线性方程组。同样,计算复杂性理论的基础概念(例如,最坏情况大O分析和类P与NP)可以被视为概念上自然的,但它们的核心地位主要源于实际考虑。特别是,许多实际问题最终被证明是NP完全的,这使得NP成为一个自然关注的复杂性类。尽管人们可能更关心应用中的精确运行时间而非最坏情况大O复杂度,但精确的运行时间界限在理论上极难推导,而大O分析则远为易处理,同时在实践中仍具有足够的信息量。
关于研究什么的决策可以是概念性的或非概念性的:
在纯数学中,人们有时选择问题是因为它们内在有趣,而非对特定目的有用,并研究理论是因为它们在某种意义上是优雅的。例如,人们有时称范畴论优雅, citing,例如,它统一数学不同领域结果的能力,同时也说它在某种意义下不太有用。(我们同样听到人们说弦论优雅但无用。)这种对有趣性和优雅性的判断似乎是相当概念性的。
在许多其他情况下,关于研究什么的决策由实际特征驱动,人们从中获得现实世界反馈。例如,一个人可能研究那些感觉自己能够取得进展的主题。经验可能训练这种感觉:一个人从过去关于研究什么的决策结果中学习,以及从过去对进展的预测是否正确中学习。
社会选择理论研究。这是一个混合概念性和非概念性工作的学科的典型例子。有些东西非常概念性:在投票规则的 desiderata(例如,孔多塞标准)之间进行选择和优先排序17;决定尝试证明或反驳阿罗不可能定理;选择建模假设(例如,偏好是基数还是序数)。其他东西主要是非概念性的:证明关于投票规则的形式结果(例如,证明阿罗不可能定理);运行计算实验来测试,例如,错误报告偏好的激励有多常见。
Longtermist macrostrategy. This is a somewhat complicated mix, but much of it seems fairly conceptual. The high-level question of what we should do is somewhat conceptual, because we get little feedback on it. Questions such as the following also seem fairly conceptual: how large the risk from deceptively aligned AI is, whether acausal trade makes sense, and whether the doomsday argument or the Fermi paradox should make us very worried. Questions involving ethics, such as how much to care about astronomical waste, are clearly very conceptual. Other questions are more mixed. For instance, predicting the long-run trajectory of a civilisation like ours under different circumstances (e.g., if China became the dominant global superpower, would its values be fine in the long run?) is fairly conceptual, but also informed by various empirical considerations.
The “macro” part here is important: the more we get into micro-level prioritisation considerations, the less conceptual things get.
Persuasion. We mostly view persuasion as non-conceptual, because one can ultimately learn it better from real-world experience than from a priori reasoning. It also has relatively fast feedback loops and is substantially a matter of human psychology, which one can study empirically.
That said, coming up with good conceptual arguments is conceptual, and it helps with persuasion. On the other hand, the best arguments are often not the most persuasive. For instance, persuasive arguments often appeal to quirks of human psychology, such as loss aversion, whereas good arguments often have to discuss nuances that weaken their case. More generally, a better understanding of a conceptual domain helps with persuasion in that domain.
Relatedly, in some sense, one can view every question as asking what we would find persuasive at the end of a long, large-scale, idealised reflection process. Writing arguments that would persuade such a reflection process is therefore conceptual. But we think this is quite a different activity from trying to persuade, say, politicians or members of the public today.
Being a good CEO. We view this as mostly non-conceptual in ordinary times, because we expect most business decisions to depend mainly on aggregating a lot of practical experience and information (although none of us has personal experience of being a CEO). Being a good CEO in unprecedented times, such as during an intelligence explosion, is different, because being a good futurist might then be an important part of the job. CEOs might also sometimes have to ask themselves ethical questions, which are as conceptual as ethical questions always are.
Appendix: is ML bottlenecked by conceptual insights?
In this appendix, we consider whether work on conceptual reasoning could accelerate AI timelines by providing conceptual insights that AI R&D would otherwise lack. Specifically, models might be able to learn some abilities from, say, LMCA that they would struggle to learn from AI companies’ default training, and these abilities might be useful for AI R&D. We think this is possible, but we doubt that such insights usually bottleneck AI development.
It’s a bit difficult to come up with a convincing example of this, but our go-to one is that LMCA is probably good for learning to reason sensibly about whether next-token prediction can in principle scale to ASI, whether LLMs will always be merely “stochastic parrots” who can’t have a world model and so on. Training in AI R&D environments, meanwhile, may not help much with this, because concepts like ASI lack a reference class that could be present in training. We think these particular questions are no longer relevant, so making models good at reasoning about them is harmless. In principle, however, future AI R&D might hinge on similar questions about the nature of intelligence, which conceptual reasoning datasets would help models reason about, rather than on more prosaic skills of the kind that, say, predicting the outcomes of experiments teaches well.
This worry is more serious because one can easily tell a story of why AI companies might undervalue AI capabilities related to such insights, without simply appealing to general incompetence. For instance, much of the value of these capabilities may come from low-probability or one-off, high-impact events, and decisions based on such events are much harder to make.
Conceptual reasoning might also help with structuring very large quantities of knowledge (say, thousands of papers) and organising very large research fields. In principle, AI could learn this ability entirely from RL in AI R&D environments, but this would seem to require training on extremely long reasoning traces, which is very expensive, even with budgets of hundreds of billions of dollars18. We guess that various conceptual capabilities will help with this. For instance, we think whether a distinction is “principled” in some philosophical sense is probably a decent predictor of whether it will remain useful.
However, we doubt that conceptual insights of this kind usually bottleneck AI development. For instance, if all potential confusions about next-token prediction had been resolved in, say, 2019, we think timelines would have shortened only modestly. There are plenty of loss functions that can in principle take you to AGI. (E.g., predicting all the world’s camera feeds can also take you to AGI, in principle.) Conceptual reasoning helps with figuring out whether a source of data can get you to AGI in principle. But we think the difficulty was mostly in finding a specific type of data and training algorithm that one can get to scale in practice, and then in correctly guessing based on smaller-scale experiments that this approach would scale quite well. Conceptual reasoning seems close to useless for figuring out which approach works in practice, whereas training in AI R&D environments is probably great for this.
Quoting Joe Carlsmith: “For research in some domains, though, our evaluation efforts can’t benefit from strong empirical feedback loops or from formal evaluation methods. Rather, our central tool, for evaluating this kind of research, is … thinking about it. And also: arguing. But not in a way where: after thinking about it, you get to see the answer. Rather: you think about it, you argue, you come to a view, and … that’s it. I’ll call this sort of research “conceptual research.” Paradigm examples, to my mind, include philosophy, futurism, and certain kinds of political debate. To be clear: work in these domains can draw on empirical data, too. And often (for example, in the context of futurism), there is in fact a ground-truth empirical answer (e.g., what will in fact happen in the future). [...] I’m thinking of research as “conceptual” insofar as our evaluation of it can’t benefit from empirical tests/feedback loops prior to the point where we need to evaluate it.”
Which is itself a conceptual task.
Especially for the more mathematical elements of conceptual domains, like whether a proposed ethical theory will be Dutch bookable.
One might hope that one can cheaply elicit all the relevant human judgements to start with, and be left with a verifiable question. If so, maybe we could just train models to predict MTurkers, and then the rest will be taken care of by training on verifiable domains, like mathematics. If so, these normative questions might not need dedicated work for AI to answer them. It seems like there are a few problems with this, however. First, the questions that one might need to ask humans might not be easy to answer, and might not be easy to understand. (E.g., it seems like asking MTurkers which philosophical bullet they prefer to bite would not be very useful in most cases.) It's not clear if one could practically reduce the questions further. (Often, it seems like when answering a philosophical question, things like values and things like capabilities are densely tangled.) Second, the number of questions one might need the answer to might be extremely large, if one were forced to ask them all in advance. Finally, even if something like this in principle works, we would need to ensure the models are well-elicited. This requires us to be able to evaluate models' ability to answer such questions, which we cannot yet do well.
Examples from Joe Carlsmith’s essay. Note that we haven’t checked each of the items and so don’t necessarily agree with his classification of works as conceptual:
“Early work on scalable oversight techniques, like
Christiano et al (2018) on iterated amplification and distillation; Irving et al (2018) on AI safety via debate; and Leike et al (2018) on recursive reward modeling.
Efforts like Kenton et al (2022) and Garrabrant et al (2021) to formalize notions of agency.
Christiano et al (2024) attempting to formalize the notion of defendability against backdoors.
Garrabrant et al (2016) attempting to formalize reasoning under logical uncertainty.
Bostrom (2014) giving an early version of the case for concern about the alignment problem.
Hubinger et al (2019) analyzing risks from learned optimization.
Christiano et al (2021) developing the eliciting latent knowledge agenda.
Shah et al (2025) on Google DeepMind’s overall approach to AGI safety”
There are some (mostly less relevant) components of ML research taste that we would view as conceptual. Some questions are “interesting” or “natural”, and some experimental setups “elegant” or “cool”, in a way that isn’t primarily meant to be predictive in the sense we describe.
Note that this does rely on it being feasible to run relevant ML experiments. If we lived in the 1950s, ML research would be much more conceptual, because this ground-truth feedback would be unavailable.
Of course, you might think that this is a huge mistake. But if ML researchers who are unusually strong in CR are also unusually good at ML research, we would expect to find that top ML researchers are unusually strong in CR (beyond what would be predicted by their general intelligence, say), and would likely be relatively interested in conceptual ways of thinking (because interest in engaging in a skill predicts strength at that skill). We think labs would probably notice this. (And our very limited info suggests that top ML researchers are not particularly interested in conceptual ways of reasoning, especially compared to top safety researchers.)
E.g., consider reflection processes that are driven more by market forces, or by agents leveraging persuasion tools to their own ends.
Why is now already valuable? We think that models are already beginning to be useful for some parts of partially conceptual AI safety work, so that improvements on their current capabilities will make a difference, even if automation is still a long way away. We also think that models are already beginning to play a role in influencing potentially path dependent views (of humans and AI systems).
Relatedly, even customers who value good conceptual reasoning will find it hard to tell which model reasons best, because conceptual reasoning is hard to verify. This further weakens AI companies' commercial incentive to improve it.
And we would guess that human data companies like Mercor, Surge AI, Appen etc. aren't well-placed to provide such data.
While RL is often inefficient, especially at longer time horizons, paying humans to generate new data seems much more expensive, and has more fundamental limits (especially as capabilities approach human expert level).
Perhaps the frontier labs have more useful non-public datasets on fuzzy tasks, meanwhile.
Note that this is broader than conceptual tasks, since it includes tasks that are significantly about applying empirical knowledge. For instance, making a UI design that users will like is a fuzzy task (since getting user input is expensive), but not a conceptual task.
For what it’s worth, we’re all moral anti-realists. If you believe morality means obeying God’s commands and that, say, the Bible is the word of God, then morality becomes less conceptual, though interpreting the Bible is still pretty conceptual, due to its imprecision.
Sometimes this can become non-conceptual. E.g., let’s say people want to reform the voting system of a large country. And then one component of designing a new voting system will be getting desiderata from politicians or the electorate. Figuring out what kinds of voting rules will be compelling to people and what voting rules they can even understand is not conceptual.
You can learn a lot of this from organizing existing knowledge as well, though, e.g., as part of literature review. For instance, you might have AI R&D RL environments in which the model can first review the literature and then run some training.
One argument against generalization from literature review is that the literature found in literature review usually comes with some structure / organization. Another argument is that if you read a lot of literature but then only run a single training run, you probably don’t need to do very sophisticated organizing.
来源:Redwood Research:Blog · blog.redwoodresearch.org
来源:RadarAI · aihot.news